OneSearch-VL:面向图像与视频的统一多模态深度研究智能体 OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
以视觉接地证据图统一单图、多图与视频深度研究的8B开源智能体
前置知识
多模态深度研究(Multimodal Deep Research)
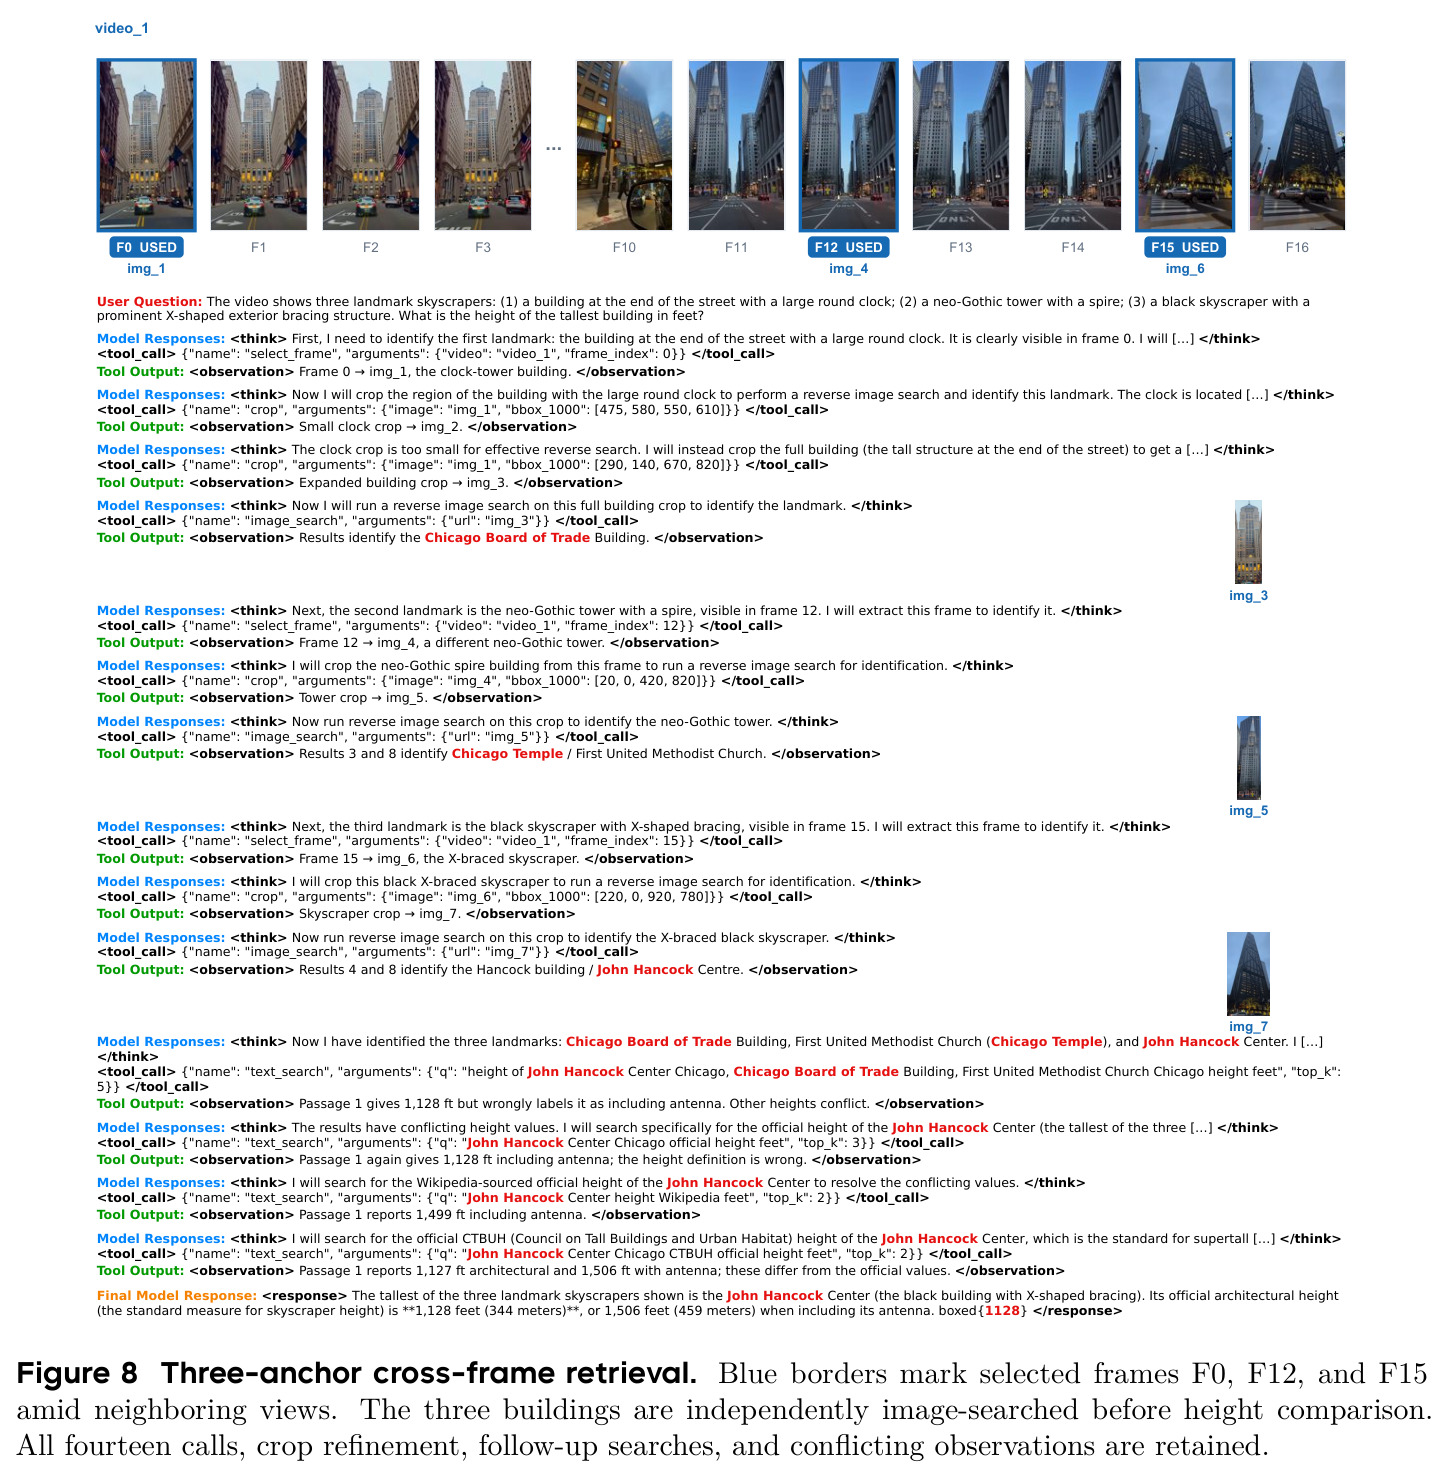
指视觉语言模型不直接作答,而是主动检查视觉内容(裁剪区域、OCR、抽帧),多轮调用图像搜索与网页检索获取外部知识,最后把证据组合成有来源支撑的答案的智能体范式。动作序列形如「思考-工具调用-观察-…-最终回答」,工具返回的裁剪图、帧、网页摘要是中间证据。
这是本文定义的问题设定:单图、多图、视频三类输入共享「视觉定位→外部检索→事实组合」的工作流,理解它才能理解统一训练的动机与工具环境设计。
VGEG(Visually Grounded Evidence Graph,视觉接地证据图)
本文提出的任务级参照结构,形式化为四元组 $\Gamma_i=\Phi_i(G_X)=(A_i,F_i,O_i,R_i)$:A 是带框/帧号/时间戳的局部化视觉锚点,F 是带网页来源的事实,O 是把事实组合成答案的操作,R 是锚点-事实-操作间的依赖关系。它从输入级证据图 $G_X$ 按任务投影得到。
VGEG 是全文的中枢:数据引擎用它出题与验证,轨迹过滤、EVGR 奖励、操作级基准都从它派生,读懂它就读懂了论文一半。
ReAct 式工具调用轨迹与观察掩码
轨迹 $\tau=(X,q,a_1,o_1,\ldots,a_T)$ 由推理、工具调用、环境观察交替组成,似然为 $\pi_\theta(\tau|X,q)=\prod_t \pi_\theta(a_t|h_t)$。SFT 时工具观察是环境外生产出而非模型生成,用掩码 $M^{pol}_{t,k}$ 置零其 loss,只对策略生成的 token 计算 $-\log\pi_\theta(y_{t,k}|h_{t,k})$。
理解式 (5) 的掩码设计与 RL 中「观察不进策略损失」的处理,是看懂训练目标和致命错误前缀保留机制的前提。
GRPO(组相对策略优化)
一种在线强化学习算法:对同一问题采样一组(group)轨迹,把组内奖励归一化为相对优势,用带裁剪的策略梯度目标更新;本文只对策略生成的 token 施加损失,奖励先经格式有效性 $R_{fmt}$ 门控再加权组合。
OneSearch-VL-RL-10K 上的第二阶段训练就用 GRPO 优化复合奖励,公式 (7) 的各项都要经过它生效。
过程奖励 / Rubric 奖励(Process Reward)
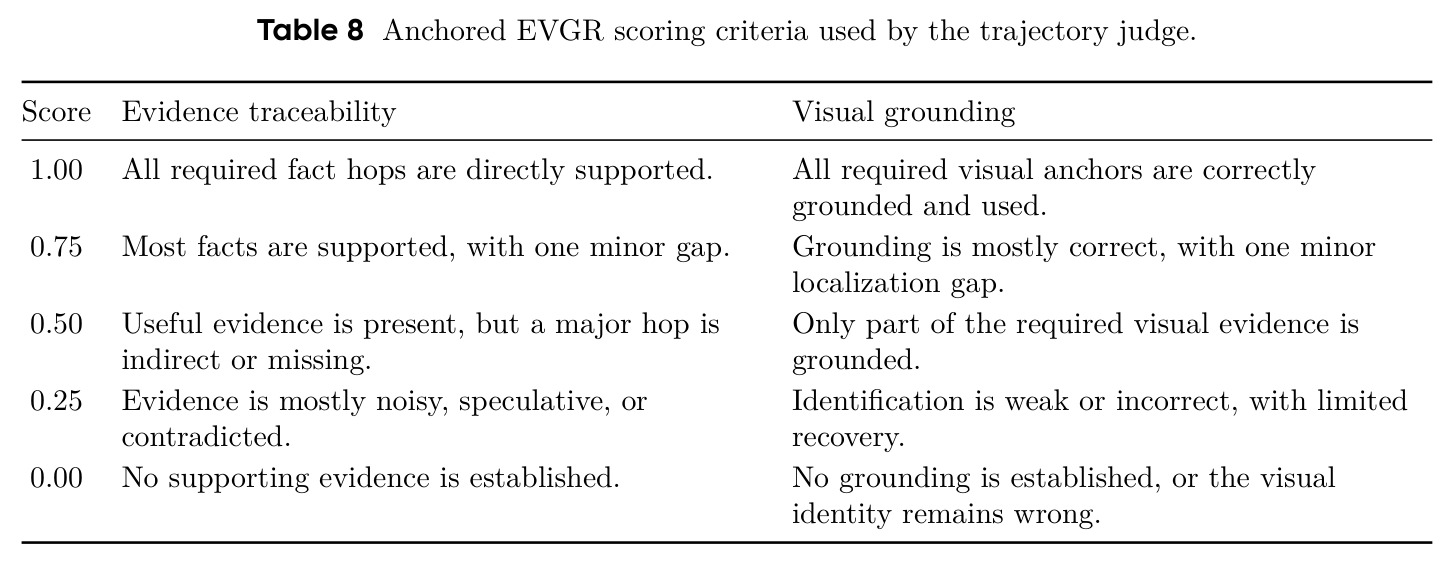
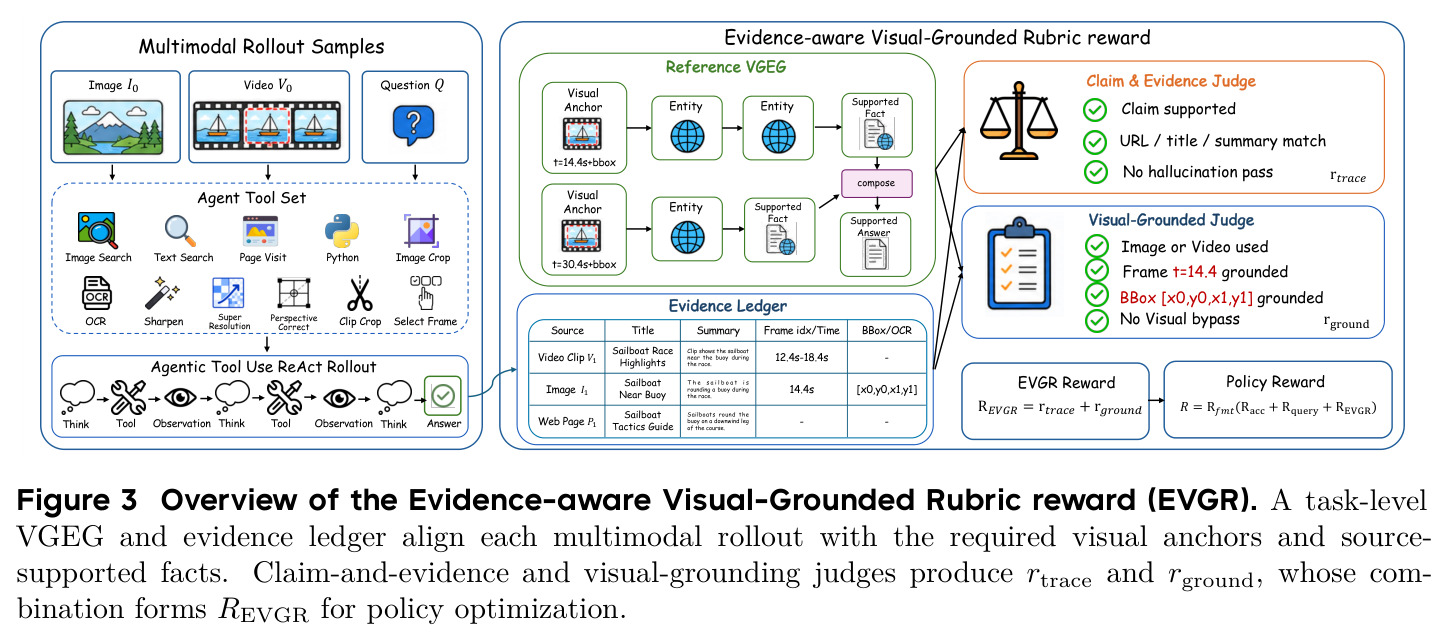
区别于只给最终答案打分的结果奖励,过程奖励按结构化清单(rubric)核对中间步骤:例如检查某条事实是否真的来自工具观察、某个区域是否真的被定位过。本文的 EVGR 定义 $R_{EVGR}=r_{trace}+r_{ground}$,分别评证据可追溯性与视觉接地两个维度。
EVGR 是本文核心贡献之一,消融表 4(b) 显示它比纯答案+查询奖励多带来 3.8 分,不懂 rubric 思想就无法理解其价值。
研究动机
现有多模态深度研究方法在输入类型上互相割裂:WebWatcher、OpenSearch-VL 等主要面向单图,VideoDR、视频中心管线只处理视频,多图深度研究几乎无人系统研究。更本质的问题是,已有证据表示(感知-知识链、事实 rubric、证据图)都没有同时保留「局部化视觉锚点→实体关系→来源支撑事实→答案生成操作」的完整依赖链;视频管线只把实体或关键帧裁剪当作检索与出题的种子,丢失端到端溯源,导致出题无法严格验证、奖励无法核对证据使用。评测侧同样粗糙:视频深度研究基准只报告聚合答案准确率并按视频内容或来源分类,无法区分实体查找、关系追踪、条件过滤、事实组合哪一环节失败。数据也说明了任务之难:Qwen3-VL-8B 直接推理在多图/视频基准上仅 11.4-16.0 分,GPT-4o 也只有 27.4-39.9 分。
本文的目标是本文目标是训练一个统一策略,同时覆盖单图、多图、视频三种视觉输入的深度研究,即让一个模型共同学会视觉定位、时间定位与网络检索的组合使用。为此要解决三个子问题:数据侧,如何构造并验证能保留证据依赖的多图/视频问答与专家工具使用轨迹;训练侧,如何在强化学习中监督证据可追溯性与视觉接地,而不只看最终答案对错;评测侧,如何按「研究操作」细粒度诊断智能体在证据检索与组合上的能力。对应的产出包括:VGEG 数据引擎、OneSearch-VL-SFT-110K 与 RL-10K 数据集、EVGR 过程奖励,以及按六类操作组织的 OneSearch-MI-Bench 和 OneSearch-Video-Bench,最终得到基于 Qwen3-VL-8B 的 OneSearch-VL-8B 模型。
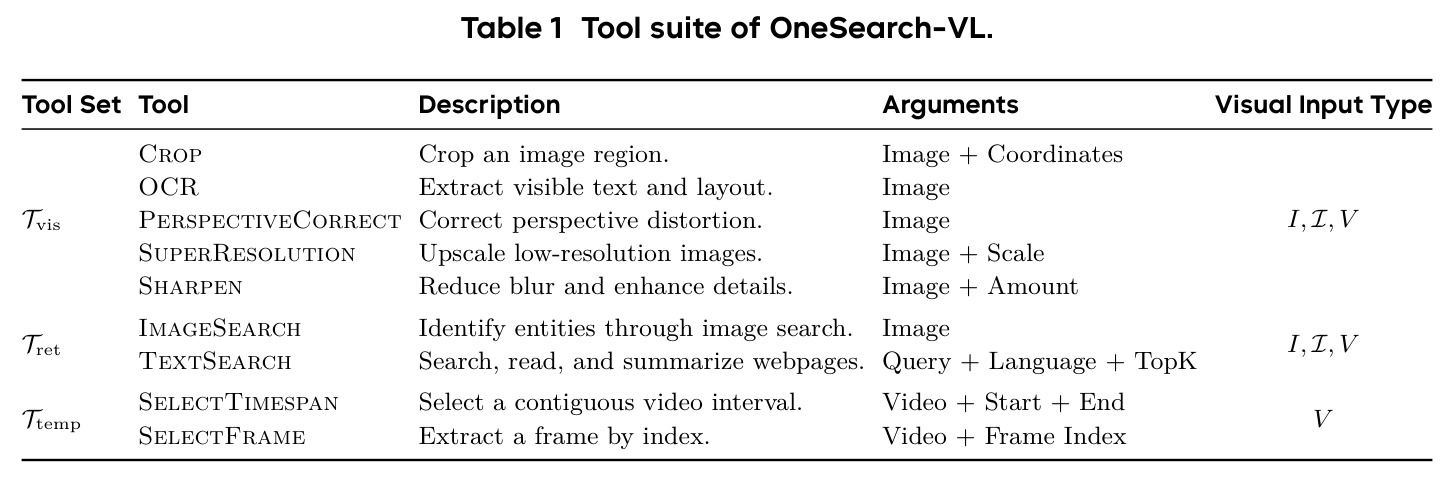
与已有工作不同的是,本文的独特切入是把「任务级 VGEG 证据图」当作贯穿全文的统一参照:它既不只是出题种子,也不是事后评测 rubric,而是同一个结构同时驱动数据构造与验证、专家轨迹过滤、RL 过程奖励和操作级评测四个环节,保证各环节标注口径一致。与为每种输入类型设计独立管线的做法不同,作者用「锚点-事实-操作-关系」四元组把三类输入映射到同一动作-观察协议和同一工具调度器(9 个工具分视觉/检索/时序三组)。奖励设计上首次同时要求证据可追溯(r_trace)与视觉接地(r_ground)两个互补维度;基准组织上放弃按内容/来源分类,改为按 VGEG 编码的研究操作分类,直接回答「哪种研究操作失败」而非「视频里有什么」。
核心方法
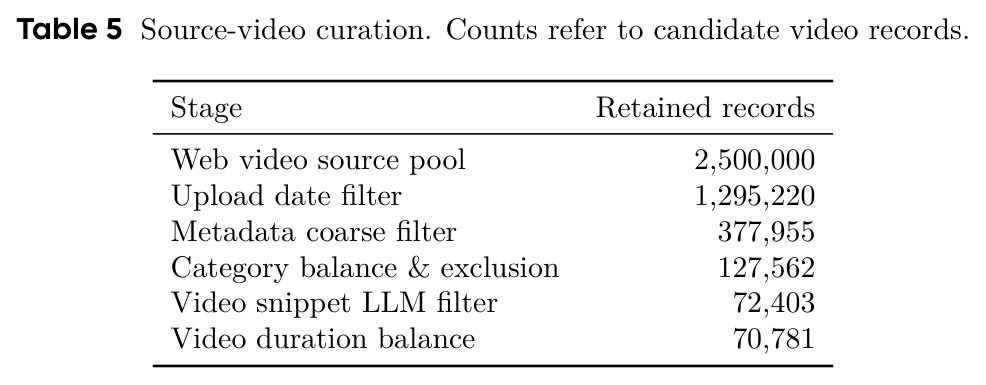
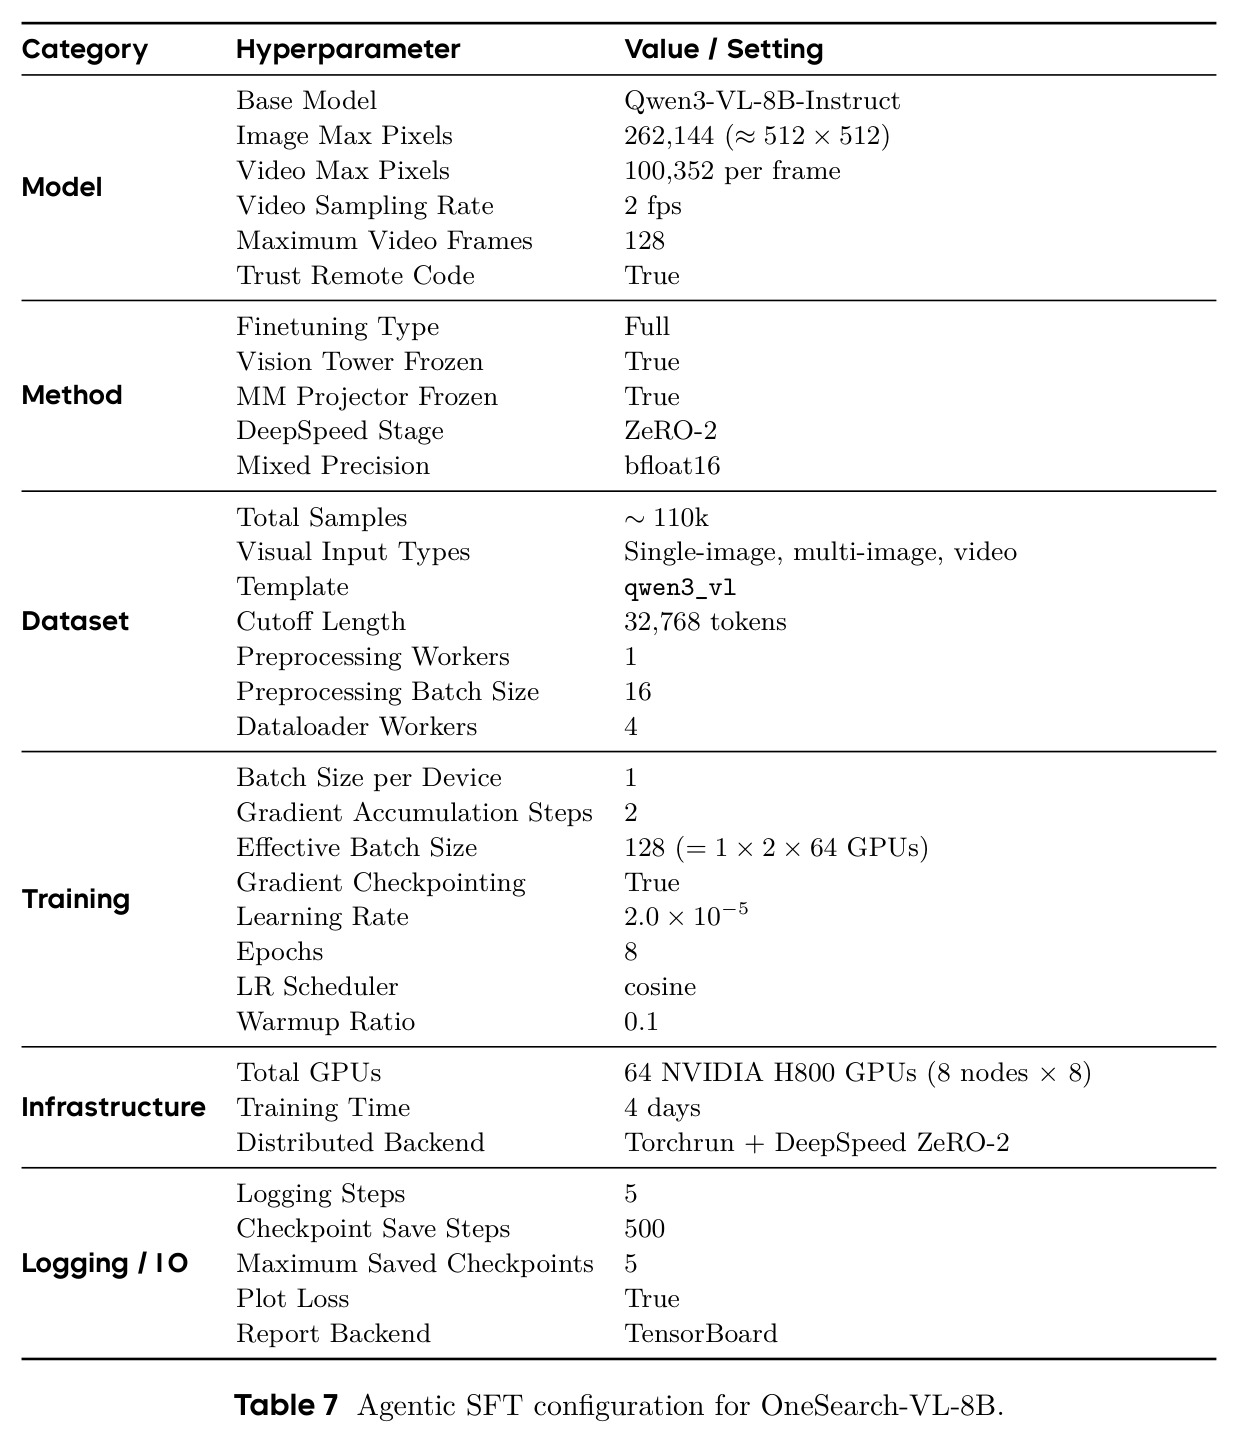
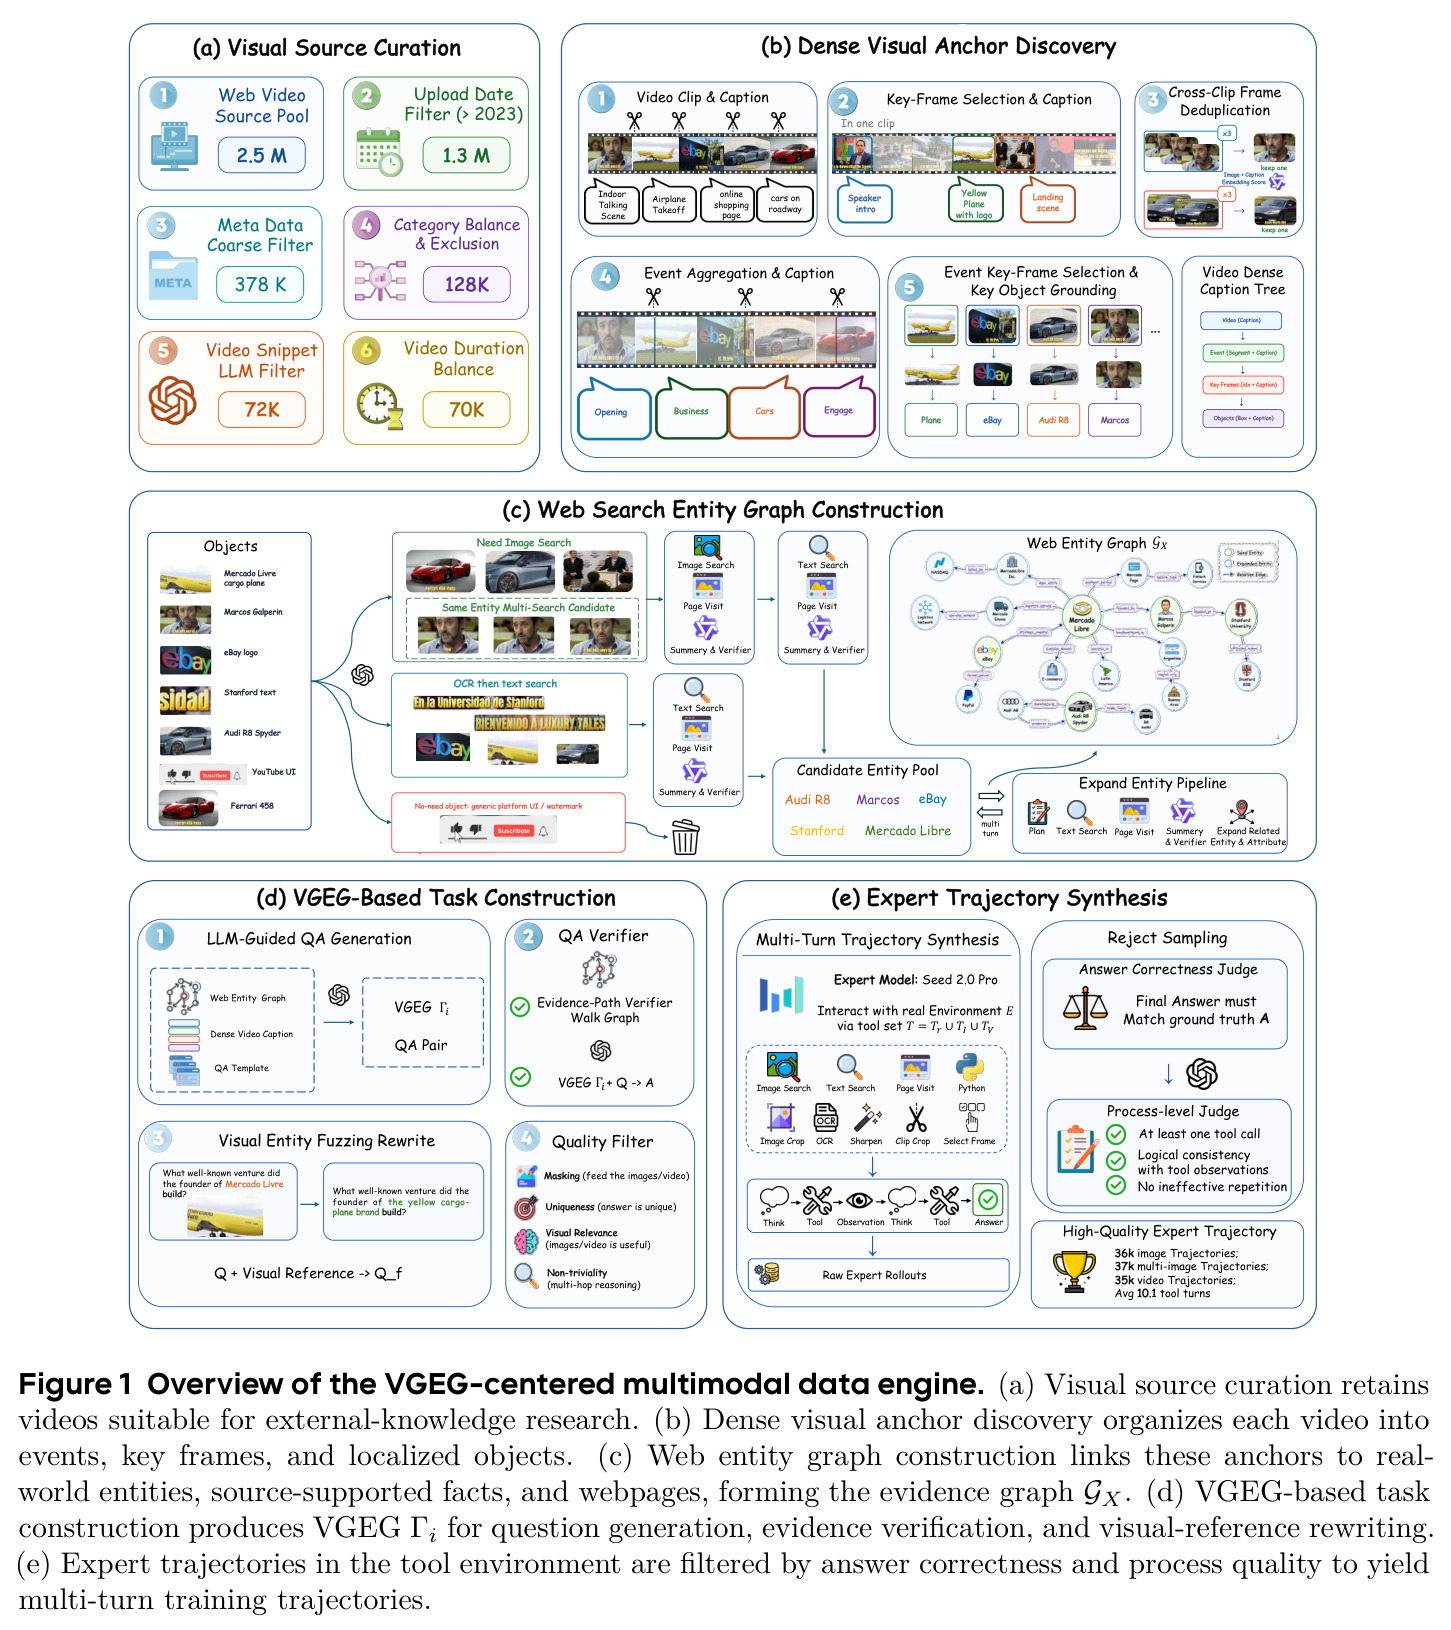
直觉是:一份深度研究任务的答案需要哪些视觉证据、哪些网页事实、按什么操作组合,这些依赖本身可以被显式建成一张图;把图作为共享参照,数据、训练、评测就能对齐。技术路线四步走:第一步从 2.5M 网络视频经元数据筛选、LLM 过滤、类别与时长均衡得到 70K 候选源;第二步把每个视频组织成「事件→关键帧→对象框」的稠密描述树,产出密集视觉锚点;第三步通过图像搜索、OCR、文本检索把锚点连到真实实体与来源支撑事实,经摘要+验证器多轮扩展,得到输入级证据图 $G_X$;第四步用任务条件投影 $\Gamma_i=\Phi_i(G_X)=(A_i,F_i,O_i,R_i)$ 生成经验证的多跳问答,再由专家模型在真实工具环境中合成轨迹。训练分两阶段:约 36K 图像、35K 多图、37K 视频(平均 10.1 次工具调用)共 110K 轨迹做 SFT,10K 任务上做 GRPO 强化学习,全程共享同一工具接口与调度器。
核心创新是 VGEG 的四元组设计与「一图四用」。与已有感知-知识链或事实 rubric 的本质区别在于:VGEG 同时编码证据从哪来(视觉位置+网页来源)与证据如何用(答案生成操作序列),因此同一结构天然支持 QA 构造验证、专家轨迹双重过滤(答案正确性+过程质量)、EVGR 奖励(按图逐条核对 claim 与 grounding)和操作级评测(按 O 分类出题)。EVGR 从 VGEG 注解派生两个判官:证据可追溯性 $r_{trace}$ 检查工具观察是否建立了答案核心实体与所需事实跳、推理是否follow观察而无无支撑替换;视觉接地 $r_{ground}$ 检查正确对象/区域/帧是否被识别并驱动后续检索(视频要求所选帧覆盖相关时刻)。两者合成 $R_{EVGR}$,与答案正确性 $R_{acc}$、查询质量 $R_{query}$ 一起经格式门控 $R_{fmt}$ 加权为总奖励,这是对「只奖结果」范式的实质改进。
方法步骤详情
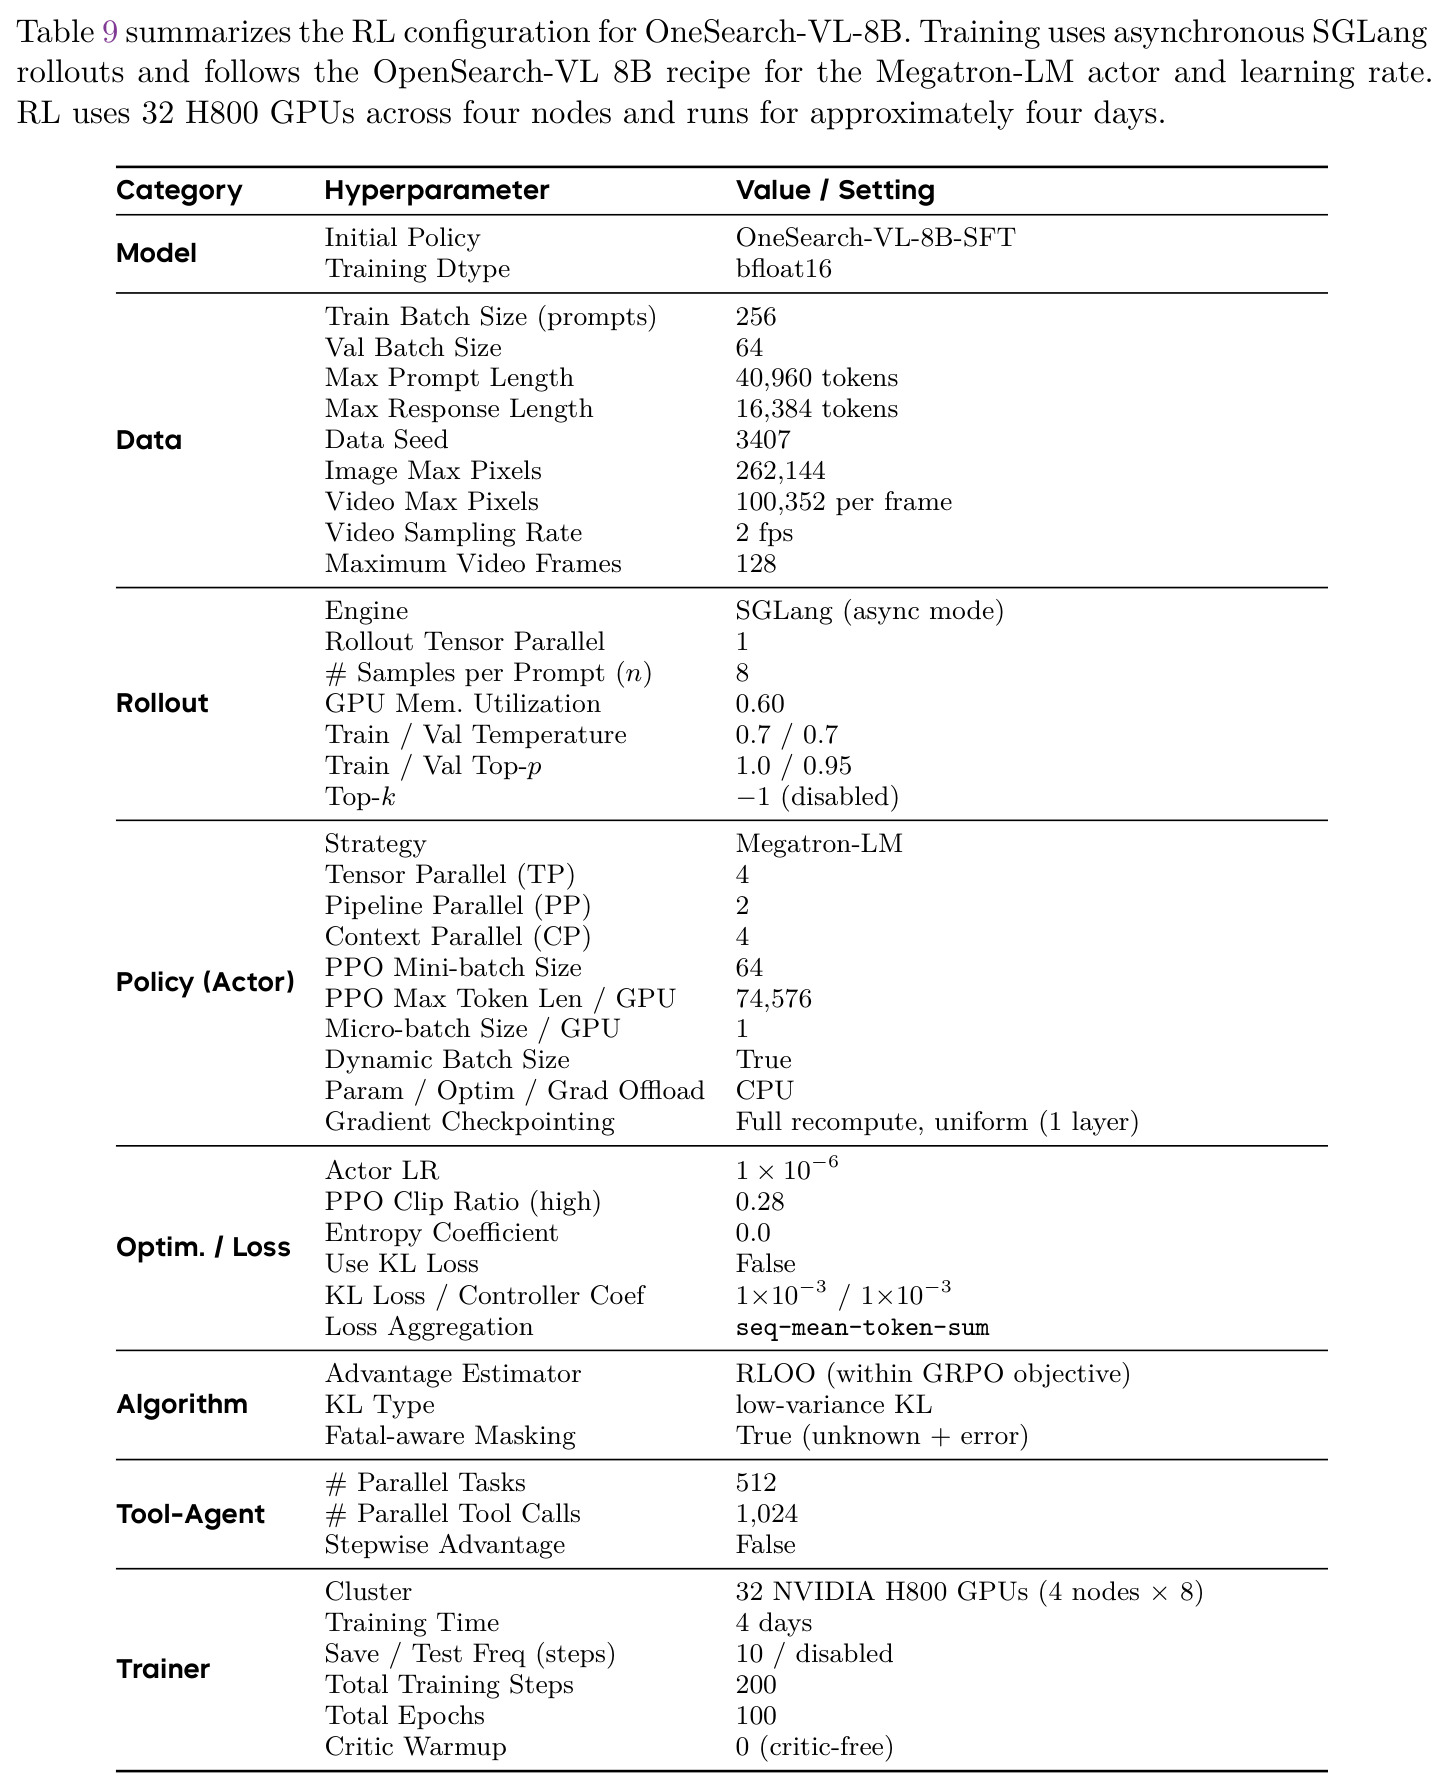
流程分五步:(1) 视觉源筛选:按上传时间(2023 后)与任务适配性做元数据筛查和 LLM 过滤,再类别/时长均衡,视频池从 2.5M 缩到 378K→128K→72K→70K。(2) 锚点发现:帧分组为片段并生成片段/帧级描述,嵌入+打分去重关键帧,聚合为事件并定位可检索对象,形成稠密描述树。(3) 证据图构建:对锚点做 ImageSearch 与 OCR 后 TextSearch,候选实体经摘要+验证器多轮扩展属性关系,过滤通用 UI、水印,得输入级证据图 $G_X$。(4) 任务构造:LLM 出题并用验证器核查证据路径,把显式实体名改写为视觉指代(如实体名→「黄色货机」)防答案泄漏,过滤文本可答、视觉无关、答案不唯一样本;单图任务复用 OpenSearch-VL 数据并转为 VGEG。(5) 轨迹合成与训练:专家模型 Seed 2.0 Pro 与真实工具环境交互,经答案正确性与过程质量双重拒绝采样,得约 36K/35K/37K 条图像/多图/视频轨迹(平均 10.1 次工具调用)构成 SFT-110K,另建 RL-10K。SFT 掩码环境观察、只学策略生成 token;RL 用 GRPO 优化 $R(\tau)=R_{fmt}(\tau)(\lambda_{acc}R_{acc}+\lambda_{query}R_{query}+\lambda_{EVGR}R_{EVGR})$。
技术新颖性
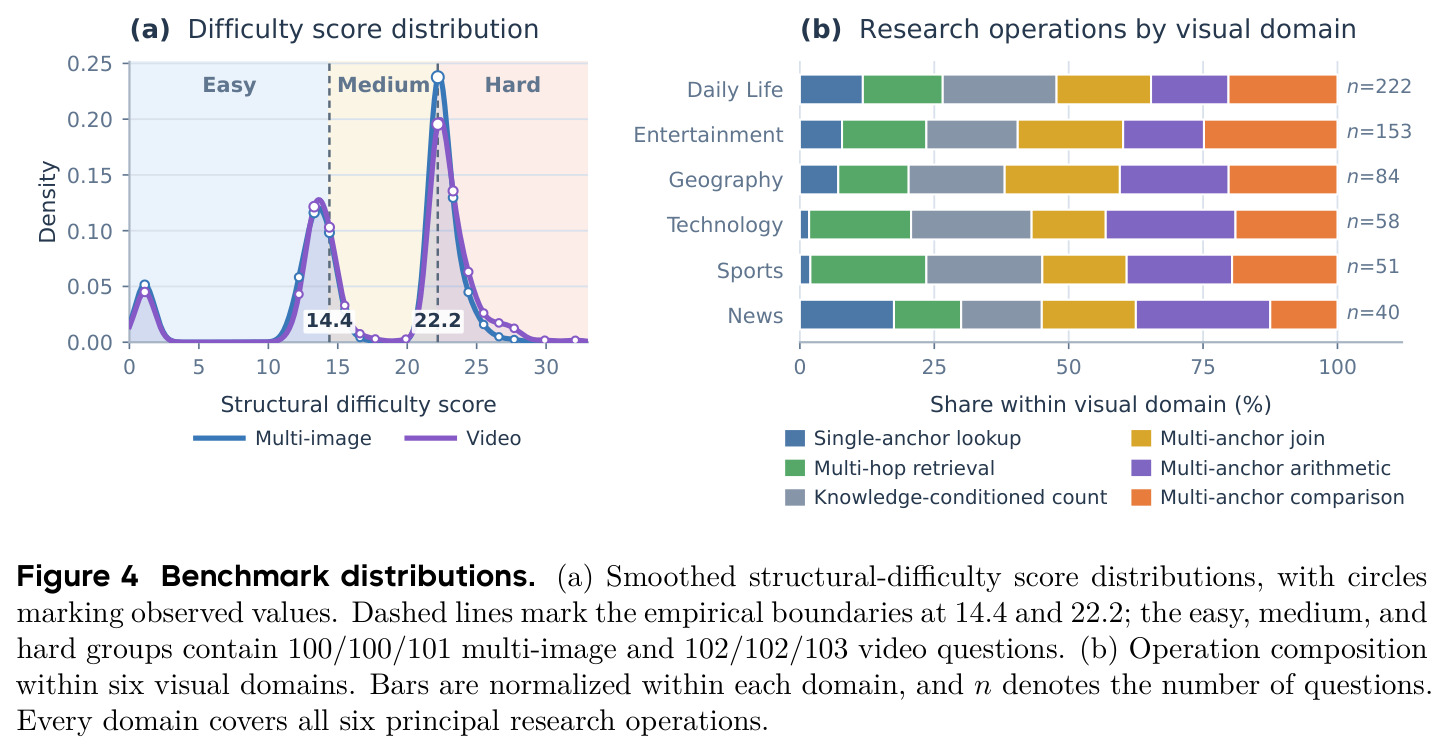
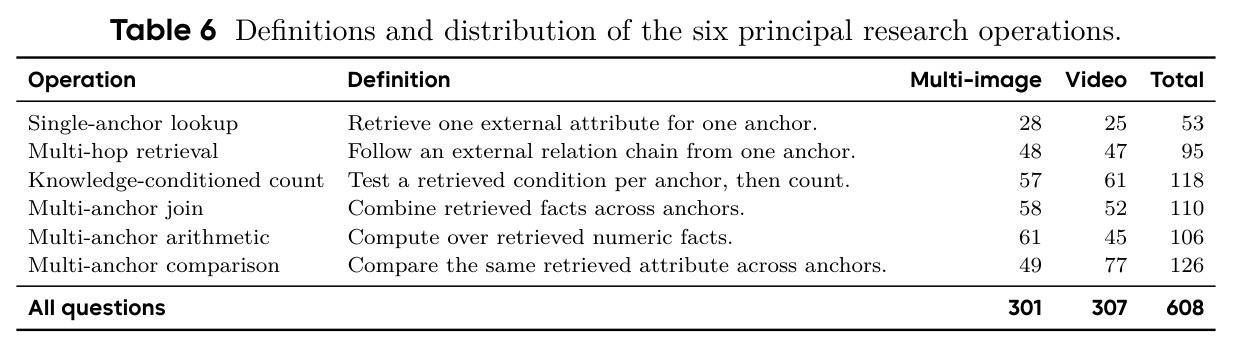
新颖性体现在三个「统一」。其一,结构统一:VGEG 把数据引擎、过程奖励与评测基准绑定在同一标注体系上,避免各环节口径漂移,这是与「出题用一套、奖励用另一套」的已有工作(perception-knowledge 链、事实 rubric、中间实体锚点)的关键差别。其二,奖励统一:EVGR 首次同时监督证据可追溯与视觉接地两个互补维度,消融显示单加 Trace 或 Ground 分别把六基准均值从 57.3 提到 59.0 和 59.3,合用达 61.1,证明两维不可互相替代。其三,输入统一:三类视觉输入共享同一动作-观察协议与调度器,跨类型轨迹可混合训练且互不损害(混合 SFT 55.8 优于任一单类 51.7-55.1)。工程配套上,9 工具三组(视觉/检索/时序)的表驱动设计让 SFT、RL rollout 与推理共享同一接口,操作导向基准(六类操作占比 8.7%-20.7%)把评测从「答对没」推进到「哪种操作失败」。
实验结果
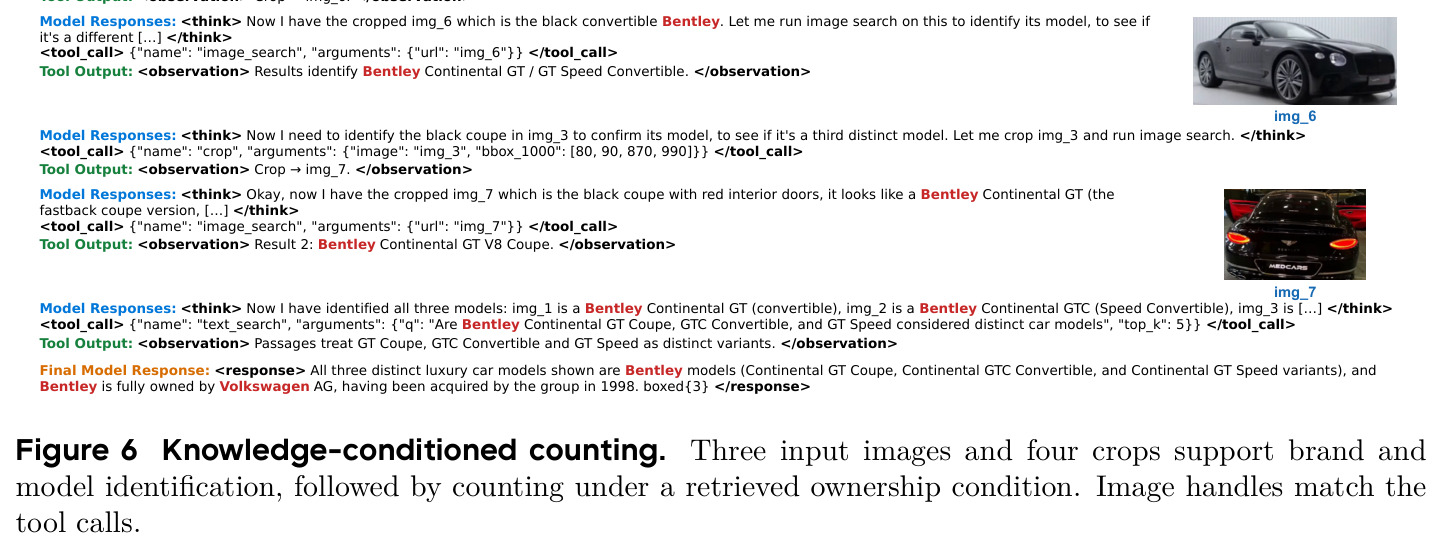
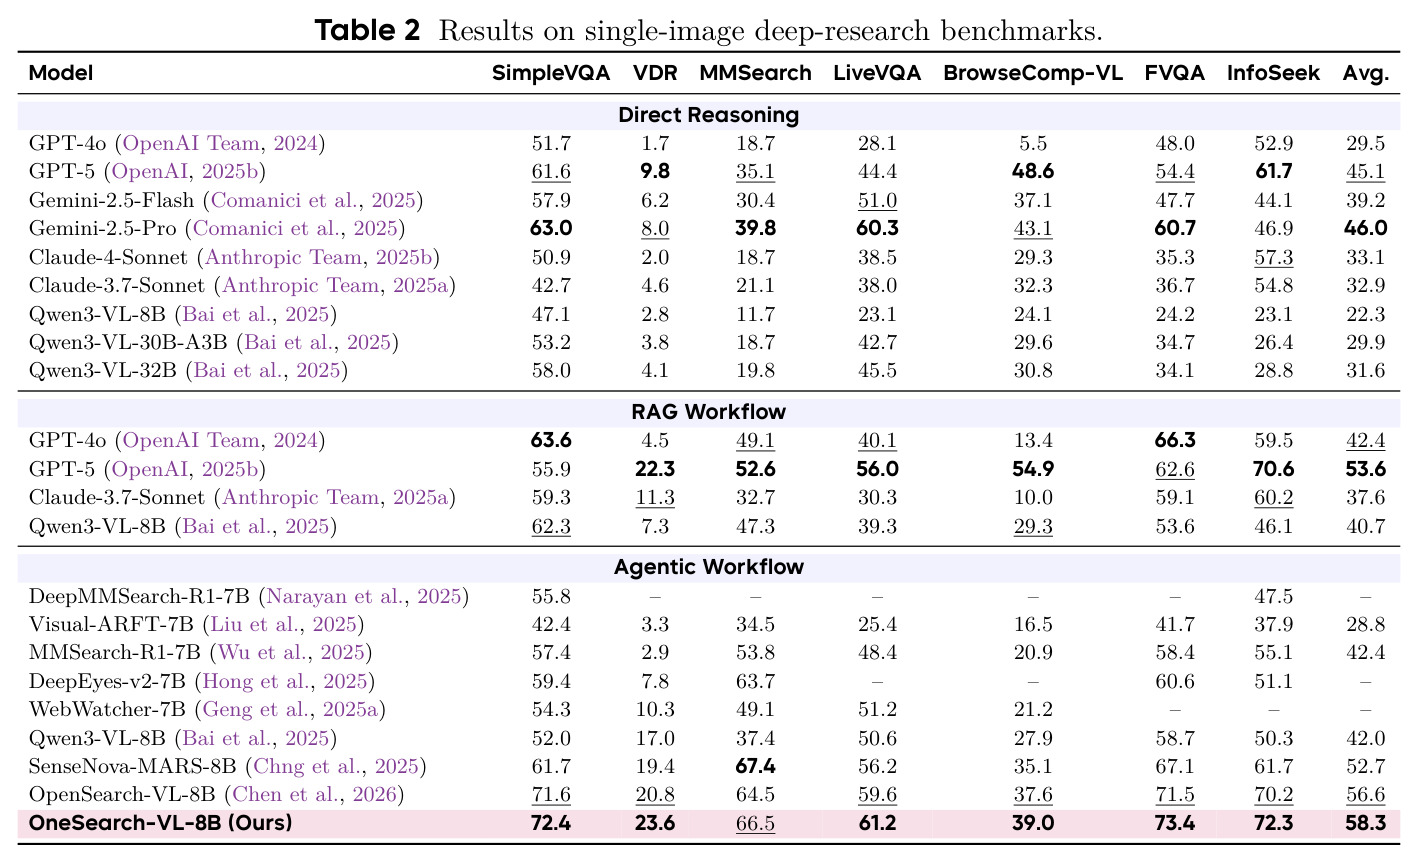
单图(表 2):OneSearch-VL-8B 七个基准平均 58.3 分,超 Qwen3-VL-8B Agent(42.0)16.3 分、超 OpenSearch-VL-8B(56.6)1.7 分且 7 项全胜:VDR 23.6 对 20.8、InfoSeek 72.3 对 70.2、MMSearch 66.5 对 64.5,6 项为所有智能体方法最佳。多图与视频(表 3):OneSearch-MI-Bench 55.8 对 35.6(+20.2),OneSearch-Video-Bench 35.5 对 17.9(+17.6),VideoDR 57.0 对 30.0(+27.0);增益集中在组合类操作:多图计数 +29.8、多锚算术 +26.3、多锚比较 +22.5,视频多跳检索 +25.5、多锚算术 +20.0、多锚连接 +19.2。消融(表 4):三类轨迹混合 SFT 六基准均值 55.8,高于任一单类(51.7/53.1/55.1),跨类型监督互补;RL 奖励从仅答案 56.3 → +查询 57.3 → +Trace 59.0 → +Ground 59.3 → 全奖励 61.1,EVGR 两维各自有效且合并最佳(+3.8)。
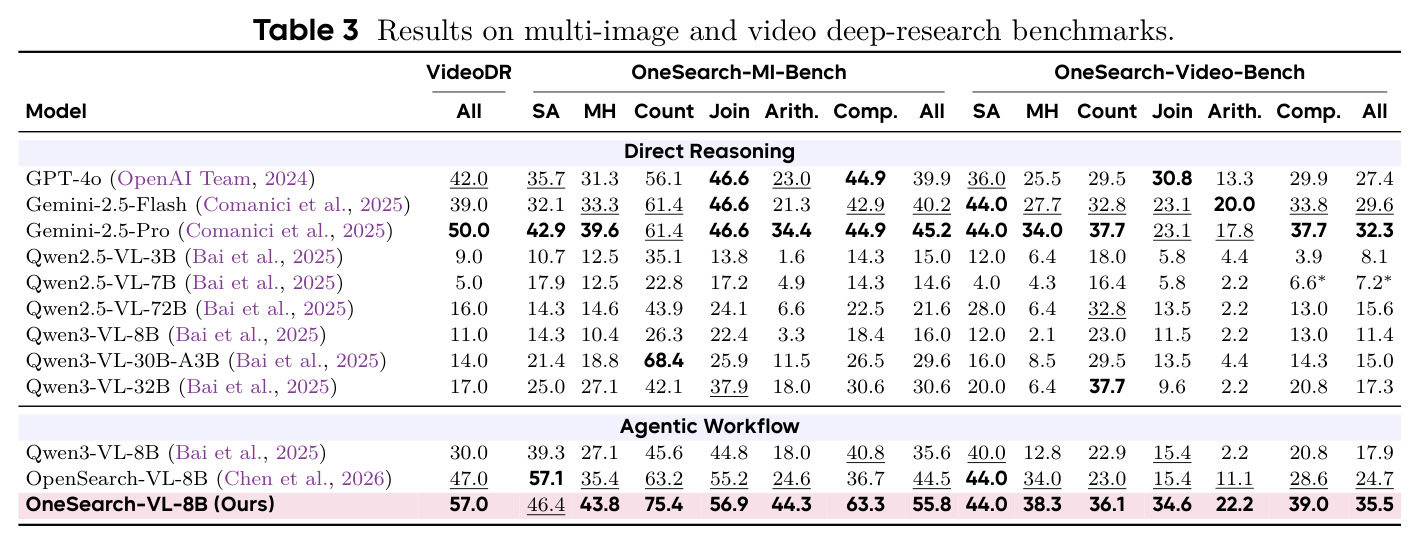
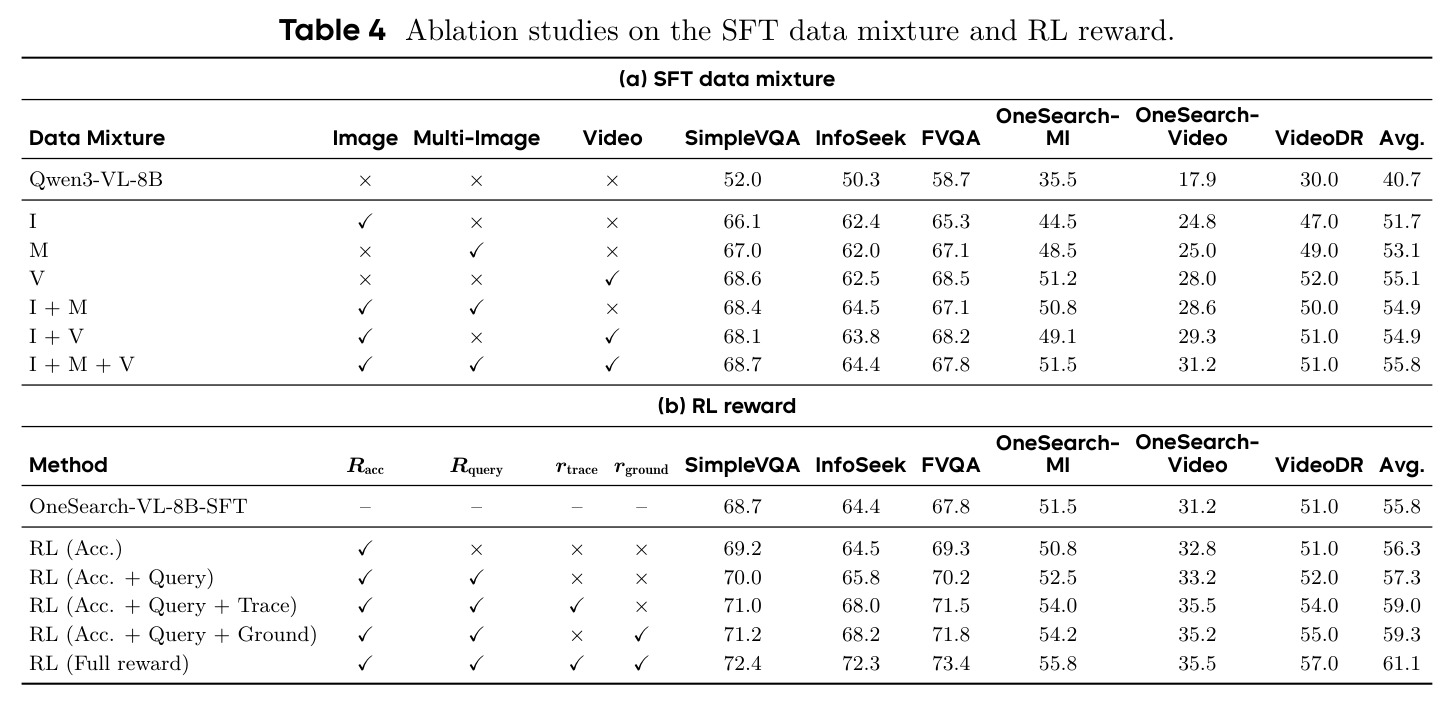
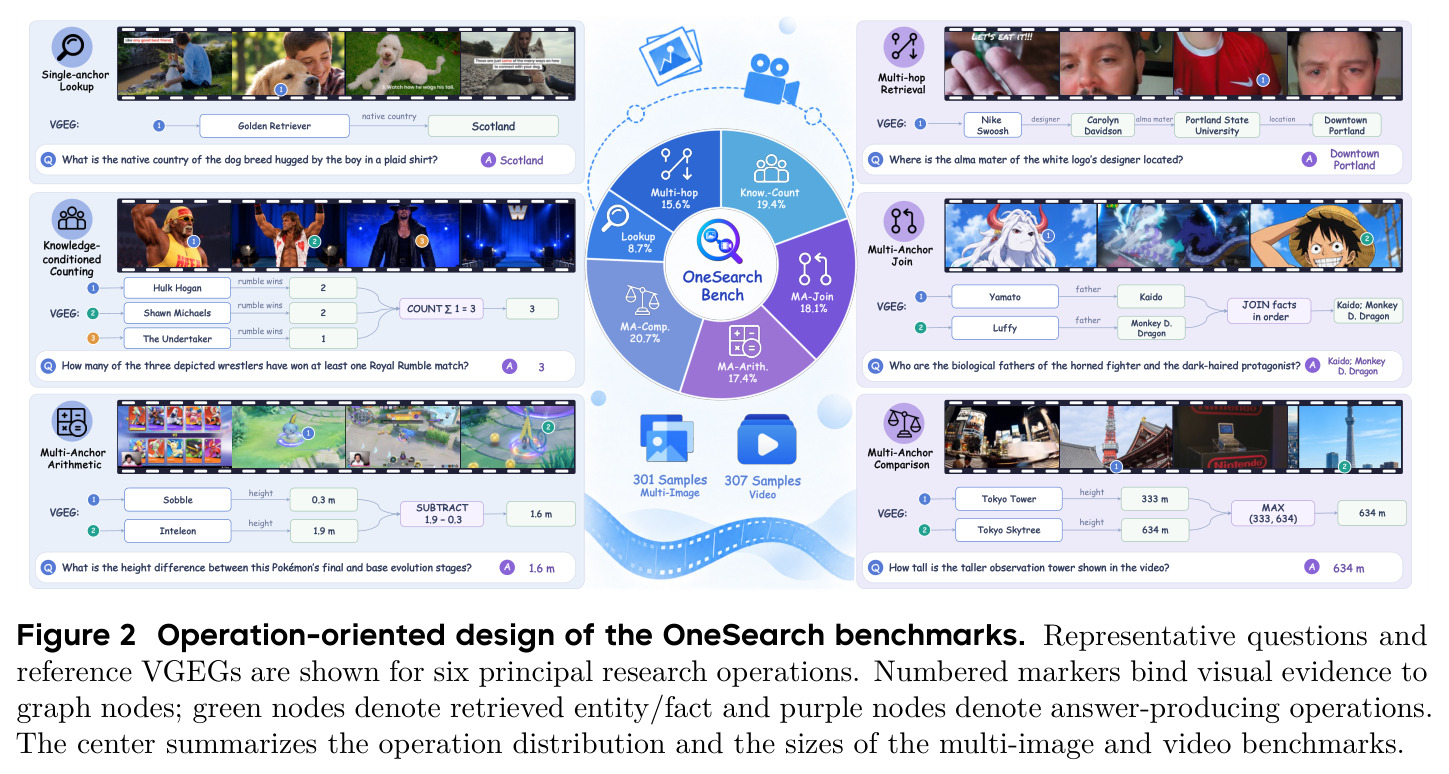
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单图深度研究(7 基准平均) | GPT-4o 判定的二元答案正确率 (%) | 58.3 | OpenSearch-VL-8B 56.6;Qwen3-VL-8B Agent 42.0 | +1.7 / +16.3,7 项基准全部超越 OpenSearch-VL |
| OneSearch-MI-Bench(多图) | GPT-4o 判定的二元答案正确率 (%) | 55.8 | Qwen3-VL-8B Agent 35.6;OpenSearch-VL-8B 44.5 | +20.2(对 Qwen3-VL-8B),六类操作全部提升 |
| OneSearch-Video-Bench(视频) | GPT-4o 判定的二元答案正确率 (%) | 35.5 | Qwen3-VL-8B Agent 17.9;OpenSearch-VL-8B 24.7 | +17.6(对 Qwen3-VL-8B),多跳检索 +25.5 |
| VideoDR(视频开放网络检索) | GPT-4o 判定的二元答案正确率 (%) | 57.0 | OpenSearch-VL-8B 47.0;Qwen3-VL-8B 30.0 | +27.0(对 Qwen3-VL-8B)/ +10.0(对 OpenSearch-VL) |
| RL 奖励消融(六基准平均) | 平均分 | 61.1(Acc+Query+Trace+Ground 全奖励) | SFT 55.8;Acc+Query 57.3 | EVGR 贡献 +3.8(对答案+查询奖励) |
局限与改进
作者承认三点局限:其一,依赖 TextSearch/ImageSearch 等外部工具与随时变化的网页,证据可用性与精确复现受影响;其二,自动化 VGEG 构造与模型化奖励可能引入标注错误与评审偏差,需要人工校准与开放的多模态过程判官;其三,多轮交互带来额外推理与工具成本,需要自适应预算与成本感知训练。我的补充观察:评测采用 GPT-4o 二元判定,未报告方差、多裁判一致性或与人工评分的对齐度,1.7 分的单图领先幅度可能在此噪声范围内;两个新基准与训练数据出自同一数据引擎,存在同源偏置,操作级优势可能部分来自对出题分布的熟悉;单图数据复用自 OpenSearch-VL,增量更多来自多图/视频轨迹的迁移而非新数据;全文未披露训练算力、token 预算与推理延迟/成本,工程可复用性存疑;专家轨迹来自闭源 Seed 2.0 Pro,蒸馏上限受制于教师模型。
独立分析的弱点
弱点一:工具与网页依赖脆弱。训练数据合成、RL rollout、推理三处都调用真实搜索,网页失效会同时污染训练信号与评测,模型可能过拟合特定站点。改进方向:建立检索快照库用于训练与复现,训练时随机注入工具故障以学习降级策略。弱点二:验证器级联误差。VGEG 构造、QA 验证、EVGR 判官都是 LLM,错误会级联进 SFT 数据与 RL 奖励且难以察觉。改进方向:分层人工抽检校准、让判官输出可核查的引用链接、用多个异构模型交叉判分。弱点三:同源基准偏置。MI-Bench/Video-Bench 与训练集出自同一管线,操作级优势可能是分布内记忆。改进方向:引入外部多图/视频深度研究基准或人类专家出题做交叉验证。弱点四:成本不透明。平均 10.1 次工具调用的轨迹对应的推理延迟、API 成本与准确率-成本 Pareto 未报告。改进方向:自适应工具预算、按问题难度早停、蒸馏少轮次学生模型。弱点五:奖励组合系数 $\lambda$ 的敏感性未做消融,实际部署需要逐任务调参。
未来方向
作者提出的方向:保存检索快照以稳定复现;评估对工具故障的鲁棒性;对自动化 VGEG 与模型判分做人工校准,发展开放的多模态过程判官;引入自适应交互预算与成本感知训练。基于本文成果可延伸的方向:把 VGEG 扩展到长时程/流式视频,支持跨任务复用证据图作为可编辑的世界记忆;把 EVGR 的两维奖励推广到带引用的答案生成,直接监督证据引用质量;利用操作级基准的诊断能力做课程学习——按模型薄弱操作(如视频多跳检索 36.1 仍偏低)定向合成 RL 数据;探索少轮次高效率的学生模型蒸馏,压缩 10.1 次平均工具调用;在多语言、多地区网页生态上检验检索泛化性;把框架延伸到音频、3D 等更多模态的统一深度研究。
复现评估
论文给出开源主页(GitHub: appletea233/OneSearch-VL;Hugging Face: OneSearch-VL 组织),预期发布模型与两个基准,附录声称提供完整优化、rollout、奖励与推理配置,但正文未明确 SFT-110K/RL-10K 数据是否全部开放。复现门槛中高:需要 Qwen3-VL-8B 底座做两阶段训练(SFT + GRPO 多轮工具 rollout);工具环境要自建图像搜索、网页搜索/阅读/摘要、视频抽帧等 9 个真实后端并保持与论文一致的观察格式;判分依赖 GPT-4o;专家轨迹合成调用闭源 Seed 2.0 Pro,普通团队只能用开源强模型近似,轨迹质量可能有差距。最大不确定性是外部网页随时变化,训练与评测结果都难以精确复刻,建议遵循作者建议保留检索快照。算力未披露,按 8B 模型多轮 RL 经验估计需多卡 A100/H100 级资源与可观 API 费用。
论文图表