双重考试:多模态智能体与世界模型的受控评估 Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
双轨受控评测:固定环境考智能体、固定动作考世界模型,分离诊断耦合失败
前置知识
世界模型(World Model, WM)
学习环境动力学的生成模型:给定当前状态(通常是图像或视频帧)和动作,预测下一个观测。它可以充当智能体的“梦境模拟器”,让智能体在虚拟经验上规划与训练而无需真实环境交互,代表工作从 Ha & Schmidhuber 2018 的早期世界模型到近年的视频生成式世界模型(如 Seedance、Kling 等)。
本文的 World Model 赛道就是评测这类模型在固定动作干预下能否正确实现请求的动作效果、并保持任务相关状态,是全篇的评测对象之一。
多模态智能体(Multimodal Agent, MA)
以视觉加语言为输入的自主智能体,循环执行“观察→规划→行动”,在网页、桌面、移动、游戏、机器人等环境中完成长程任务,依赖感知接地、工具调用与界面操作能力。与纯文本 LLM 智能体的区别在于必须直接处理图像观测并输出可执行动作。
Agent 赛道评测 10 个此类模型-harness 配置在 1,088 个评测项上的表现,理解其观察-规划-行动循环才能读懂评测协议。
耦合失败与归因模糊
智能体与世界模型串联使用时,智能体后续动作由 WM 生成的观测驱动。一旦任务失败,仅凭结果轨迹无法区分是智能体决策错误、WM 模拟错误,还是两者交互的问题——每个组件都在消费对方的输出,证据被污染。
这正是本文的核心动机:试点实验 150 例 0% 任务成功却无法归因,催生了“分离考试”的评测设计哲学。
模型偏差累积(model bias accumulation)
基于模型的强化学习中,智能体在世界模型上滚动推演(rollout)时,模型的单步误差会随步数复合放大,导致规划越来越失真;Janner et al. 2019 等工作表明短 rollout 可缓解此问题。
它解释了为何长程耦合交互中状态漂移严重(试点中背包被换成小包),是理解 WM 状态保持评测价值的理论背景。
组件隔离 / 受控实验设计
通过固定其他变量、只改变目标组件的实验设计,把系统级失效分解为组件级证据。本文的具体做法是:给 Agent 固定的参考环境响应机制,给 WM 固定的动作干预脚本,各自对照显式任务规格(目标、初始状态、允许动作、受保护状态、证据规则)评分。
“Dual Exam”的名称与方法论来源,是理解两条赛道为何使用不同案例、指标与协议、分数为何不可直接比较的前提。
研究动机
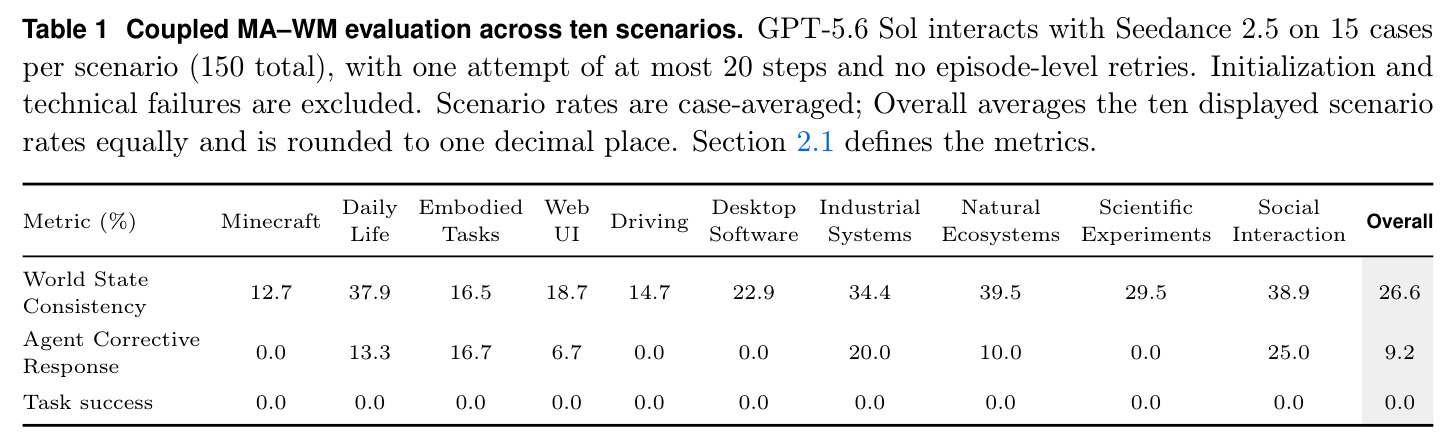
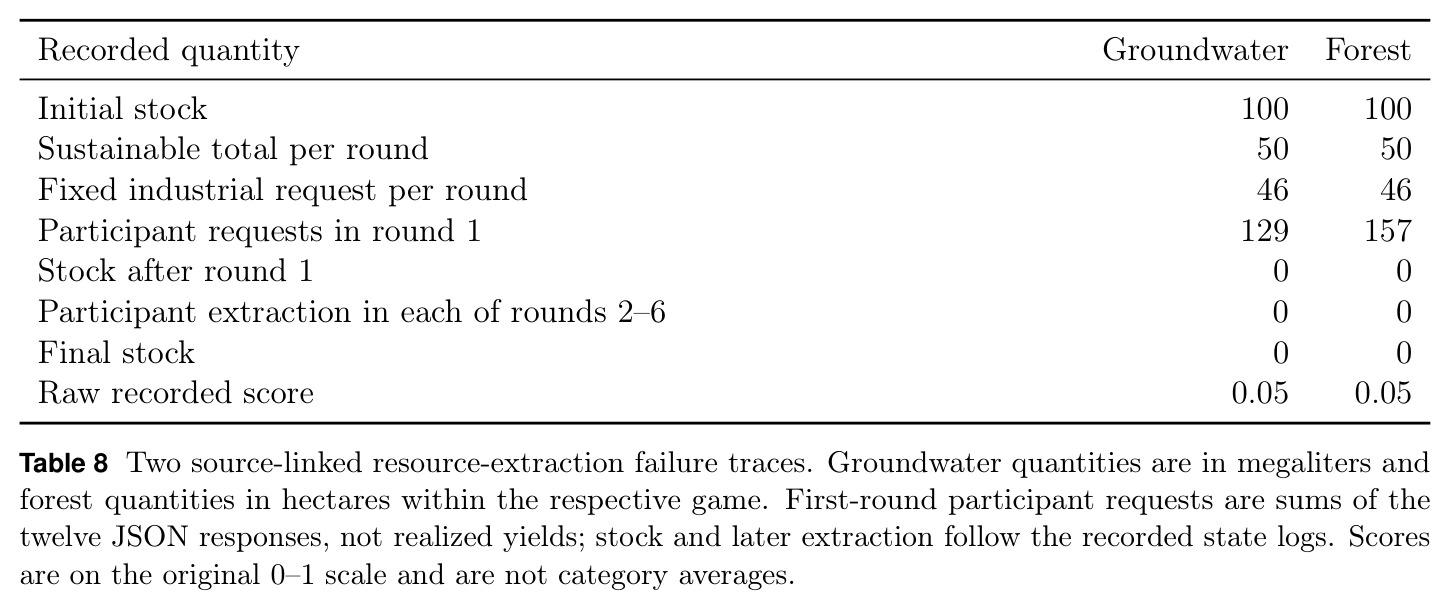
世界模型与多模态智能体的耦合被视为通向通用智能体的重要路径:WM 提供模拟经验与动作条件预测,Agent 轨迹反过来修正 WM。但两个组件在长程交互中都不可靠——Agent 在接地、动作排序与任务完成上挣扎,WM 在记忆与动作控制上失败,视觉保真度本身也不保证下游效用。本文的试点研究将 GPT-5.6 Sol 与 Seedance 2.5 配对,在 10 个场景共 150 个案例上耦合运行(每例单次尝试、最多 20 步、无情景级重试),结果任务成功率为 0%,World State Consistency 仅 26.6%,Agent Corrective Response 仅 9.2%。例如“收拾背包”案例中,Agent 在未确认拿到护照的情况下继续行动,最终背起的是一个更小的蓝色小包而非原背包,状态一致性曲线跌至 0.316(19 项状态检查仅过 6 项)、纠正响应 0.286(7 次可响应差异仅响应 2 次,且全是导航重试)。更致命的是诊断模糊:耦合轨迹只能揭示状态不一致,无法判定每次失败该由哪个组件负责。现有基准(GAIA、AgentBench、OSWorld 2.0、WorldArena 等)要么只测 Agent、要么只测 WM,均缺少组件隔离、持久状态评测与四域覆盖。
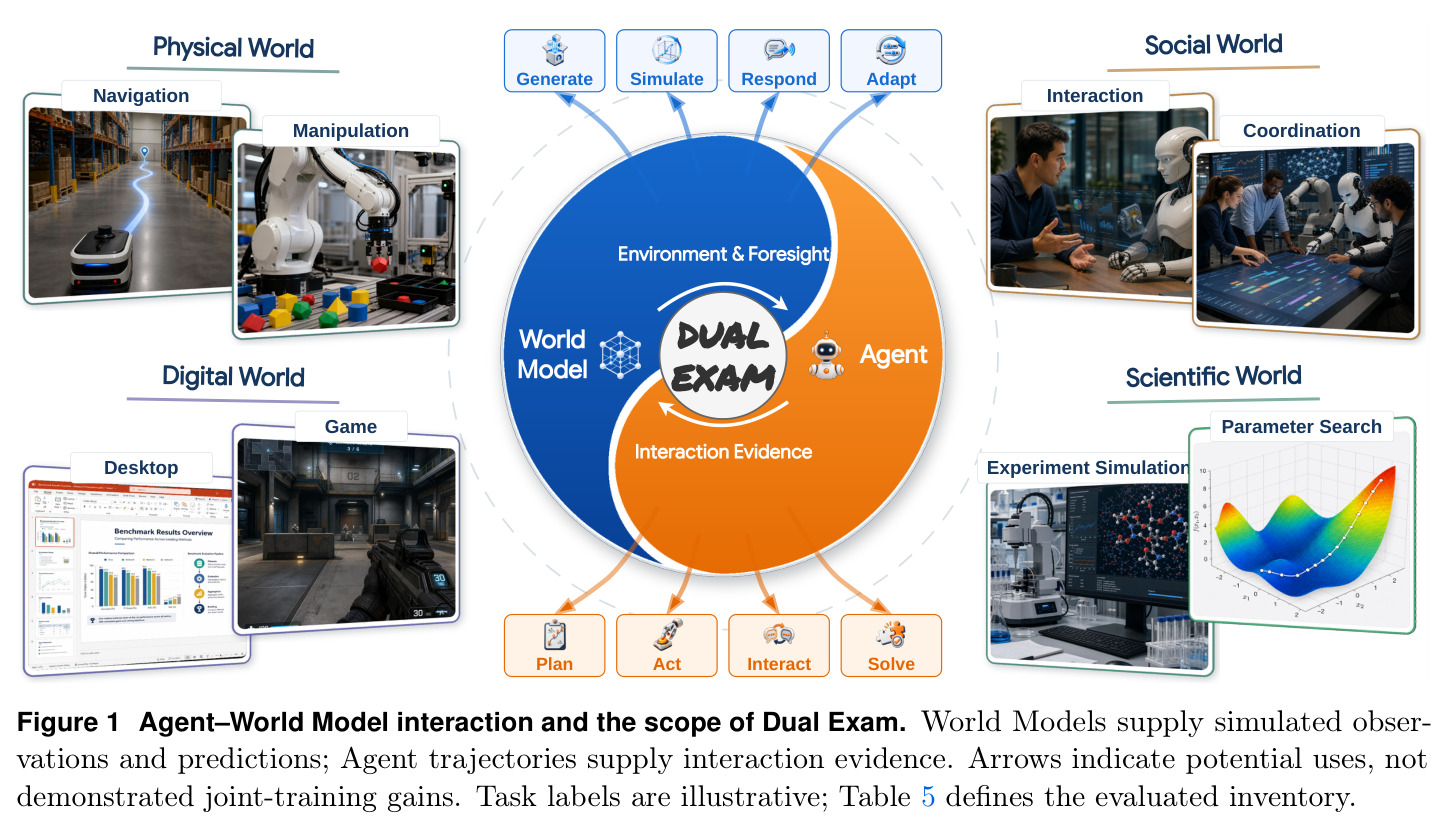
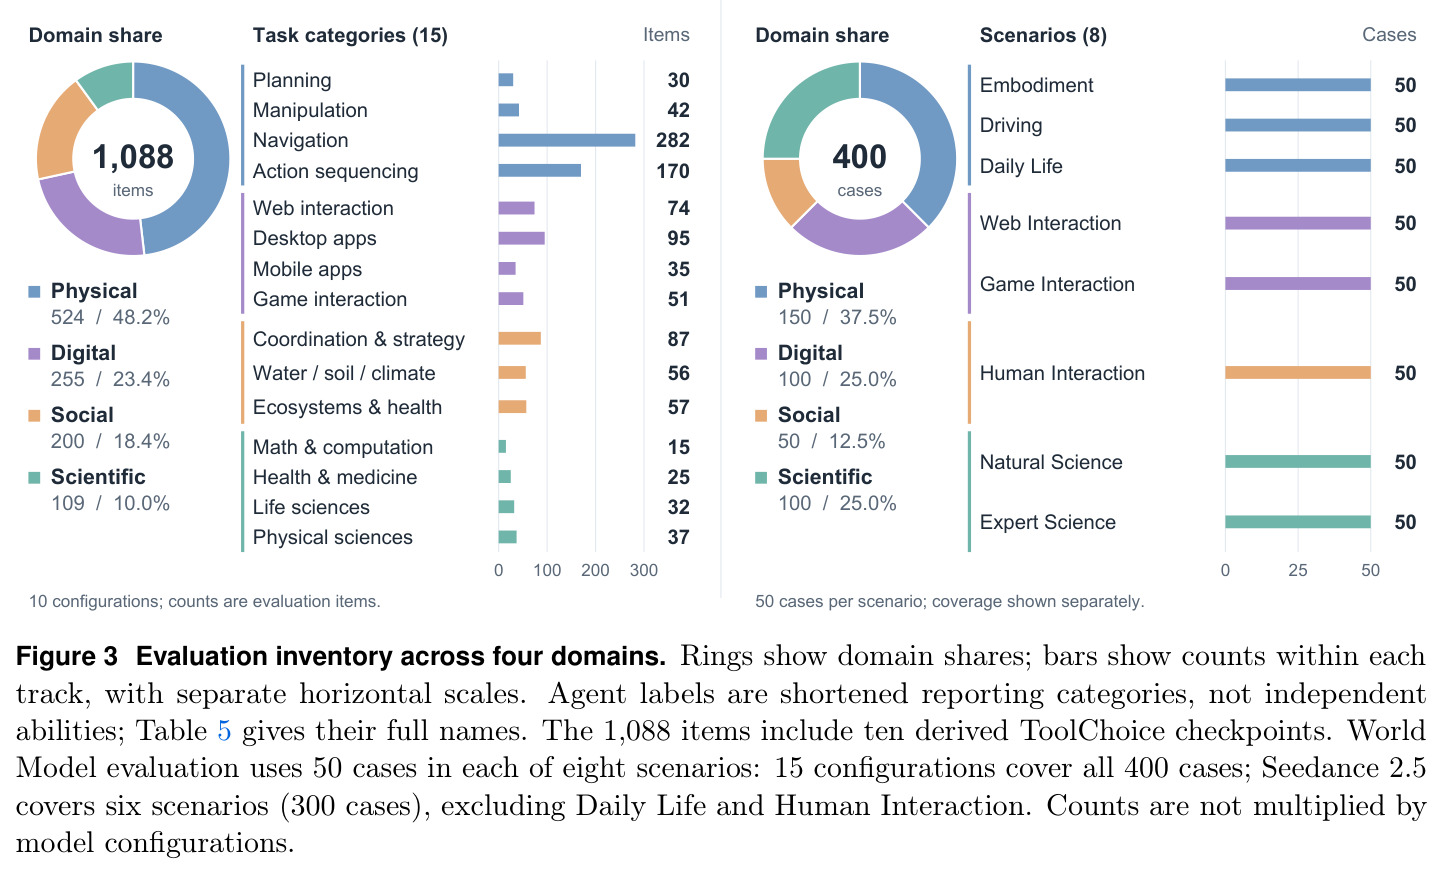
本文的目标是构建 Dual Exam——一套分离式受控评测框架,把“动作选择”与“状态演化”拆开考核。具体目标有三:(1) Agent 赛道在固定的参考环境响应机制下比较 10 个配置,覆盖物理/数字/社会/科学四域 15 个报告类目共 1,088 个评测项;(2) WM 赛道在固定动作干预下评测 16 个配置(15 个全覆盖),覆盖 8 个场景共 400 个案例(每场景 50 例);(3) 两条赛道都用显式目标与状态约束核验记录证据,给出明确的聚合规则(Agent Index 与 WM Overall)并声明其不可比性,从而为组件级诊断、配对选择和未来协同进化研究提供可审计的基线。
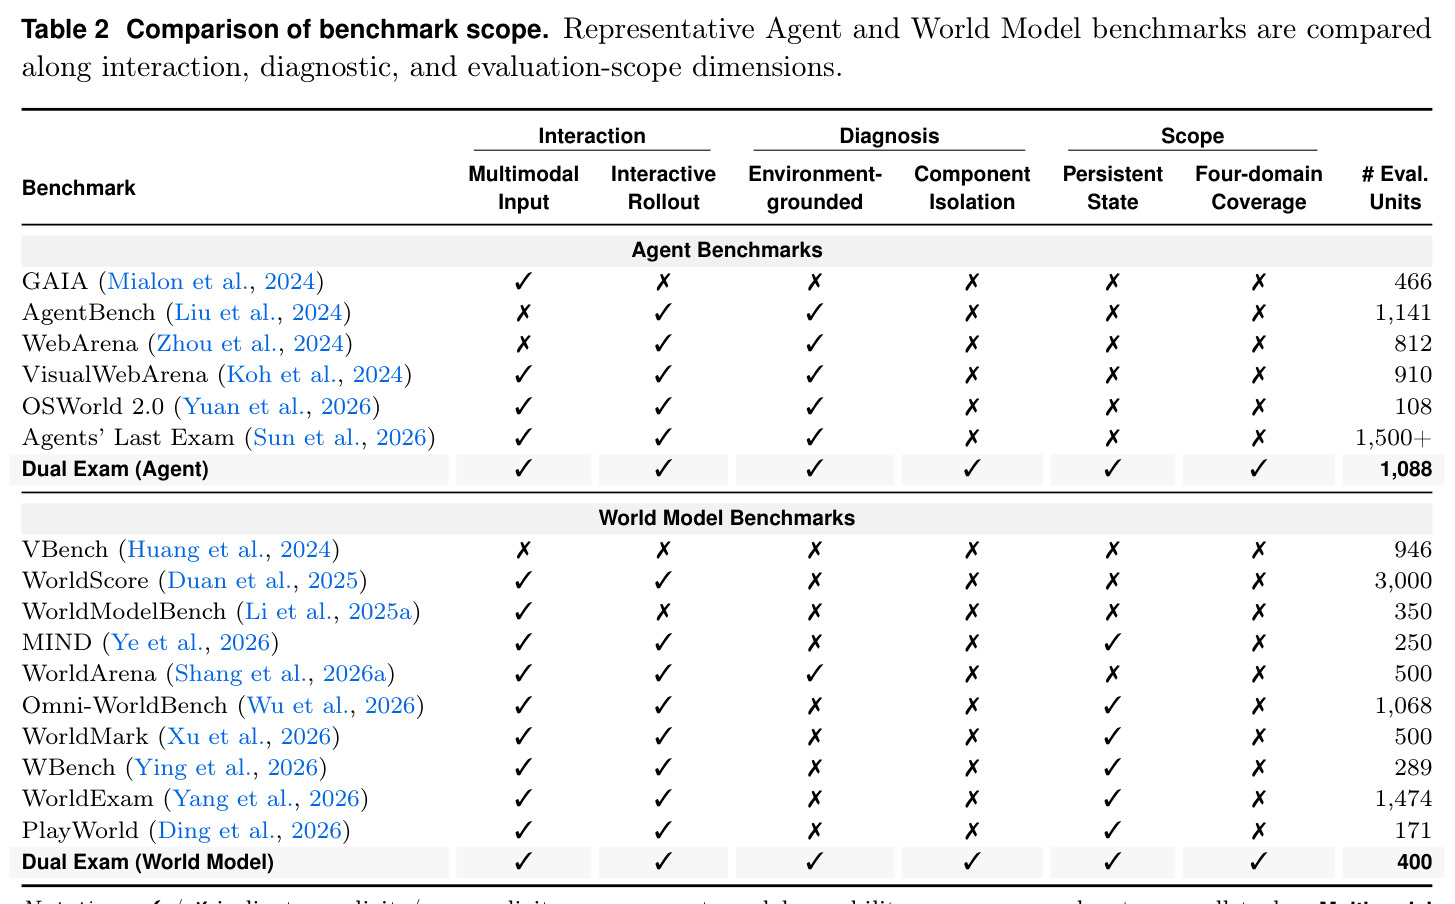
与已有工作不同的是,独特之处在于“双轨考试”的实验设计哲学:不让两个组件互相污染证据。现有工作要么做耦合运行(WebEvolver、GenEnv、COMAP 在受限任务分布上连接两个方向),要么只评单一组件且多用视频质量类指标(WorldScore、WorldModelBench);本文改用受控变量法——Agent 面对固定参考机制、WM 面对固定干预脚本,分别对照显式检查清单评分。同时它把“响应指令”与“保持状态”分开计分,并强调“持久状态”维度(跨重访、遮挡、多轮的状态保持,而非通用视频时序质量)。Table 2 的对比显示,此前没有任何基准同时具备多模态输入、交互 rollout、环境接地、组件隔离、持久状态与四域覆盖这六项性质,Dual Exam 在两条轨道上首次全部满足。
核心方法
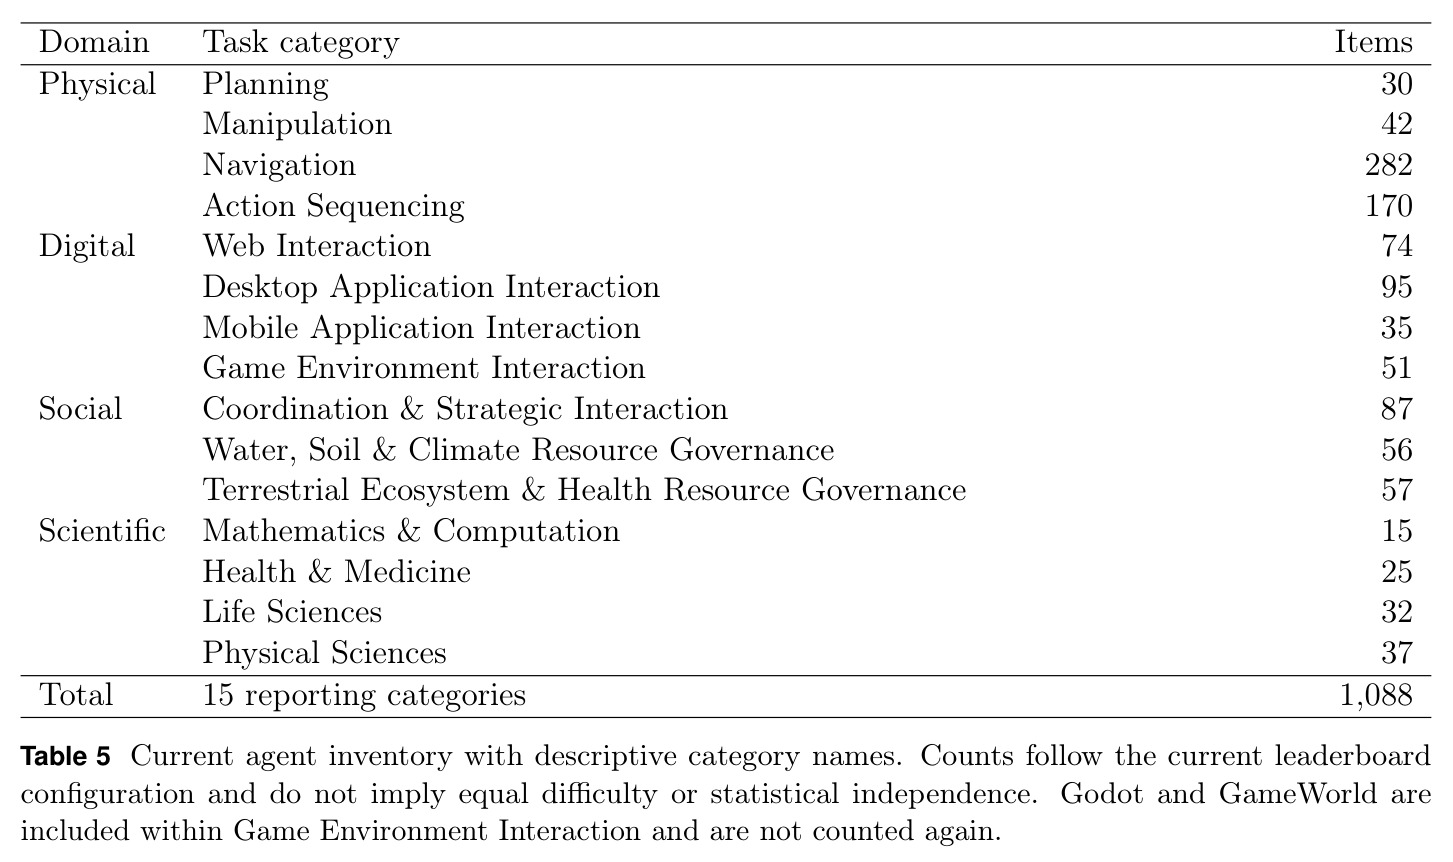
直觉很简单:想知道联名合作失败是谁的锅,就得给两人分别单独出卷。技术路线上,Dual Exam 由两条独立赛道组成,共享“情景规格”(初始状态、允许动作、必须发生的变化、受保护状态、证据规则),但使用不同案例、指标与交互协议。Agent 赛道包含 1,088 个评测项(物理 524 项占 48.2%、数字 255 项占 23.4%、社会 200 项占 18.4%、科学 109 项占 10.0%),分 15 个报告类目,10 个模型配置参与;每类得分 0–100,Index 按条目数加权:$I_m = \frac{\sum_c n_c\, s_{m,c}}{1088}$。WM 赛道包含 400 个案例、8 个场景各 50 例(具身、驾驶、日常生活、网页交互、游戏、人际交互、自然科学、专家科学),16 个配置中 15 个全覆盖,WM Overall 为八场景等权均值;Seedance 2.5 因人脸生成限制只覆盖 6 个场景(300 例),其均值单独报告、不进入全覆盖排名。论文反复强调:两条赛道的任务、指标、聚合规则不同,分数不可直接比较。
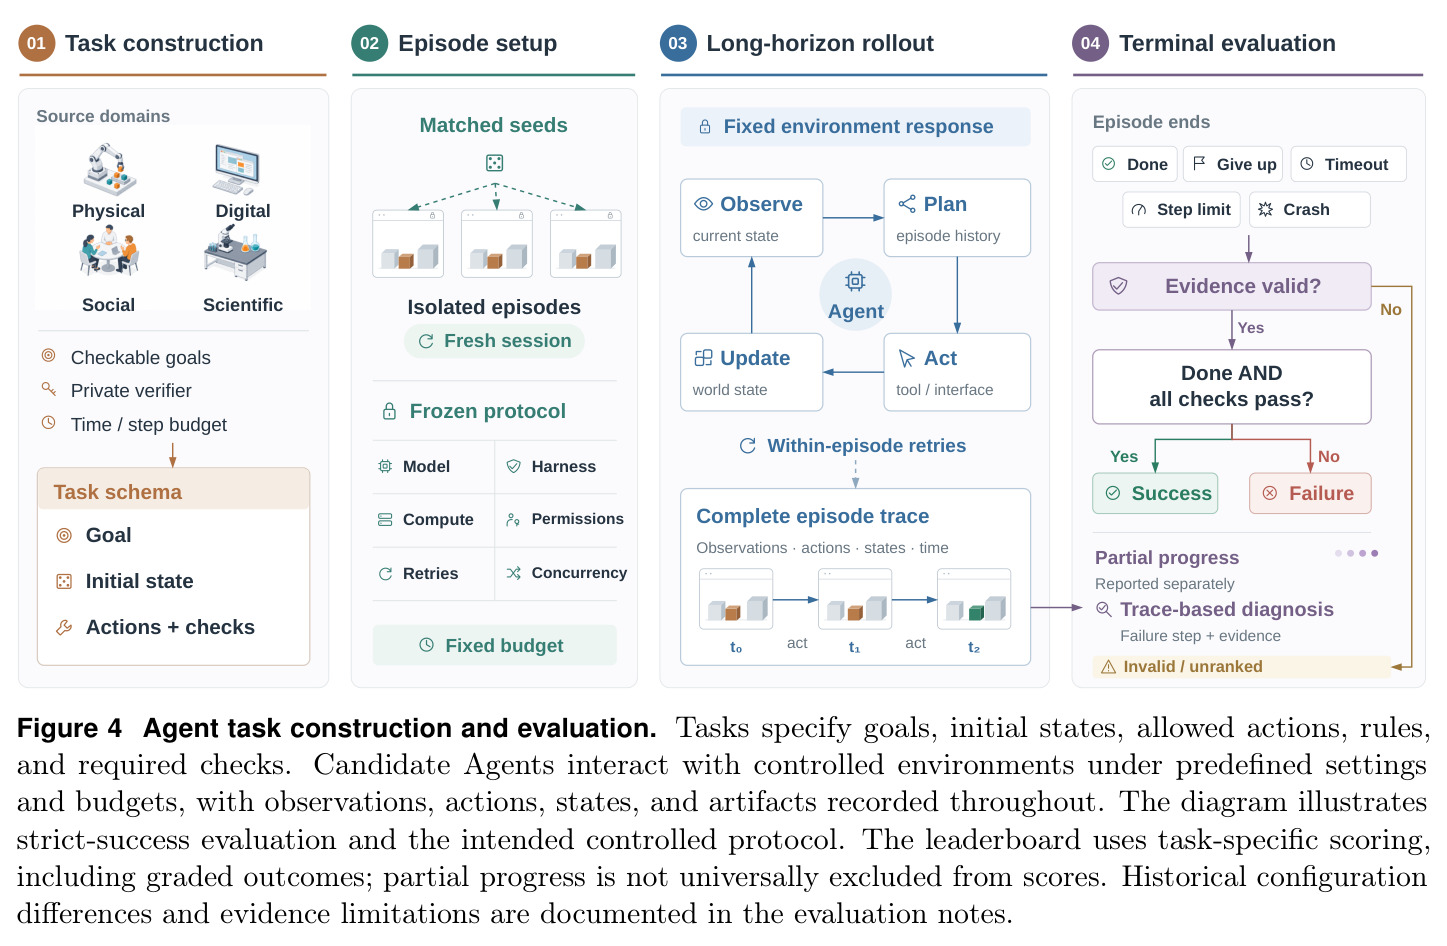
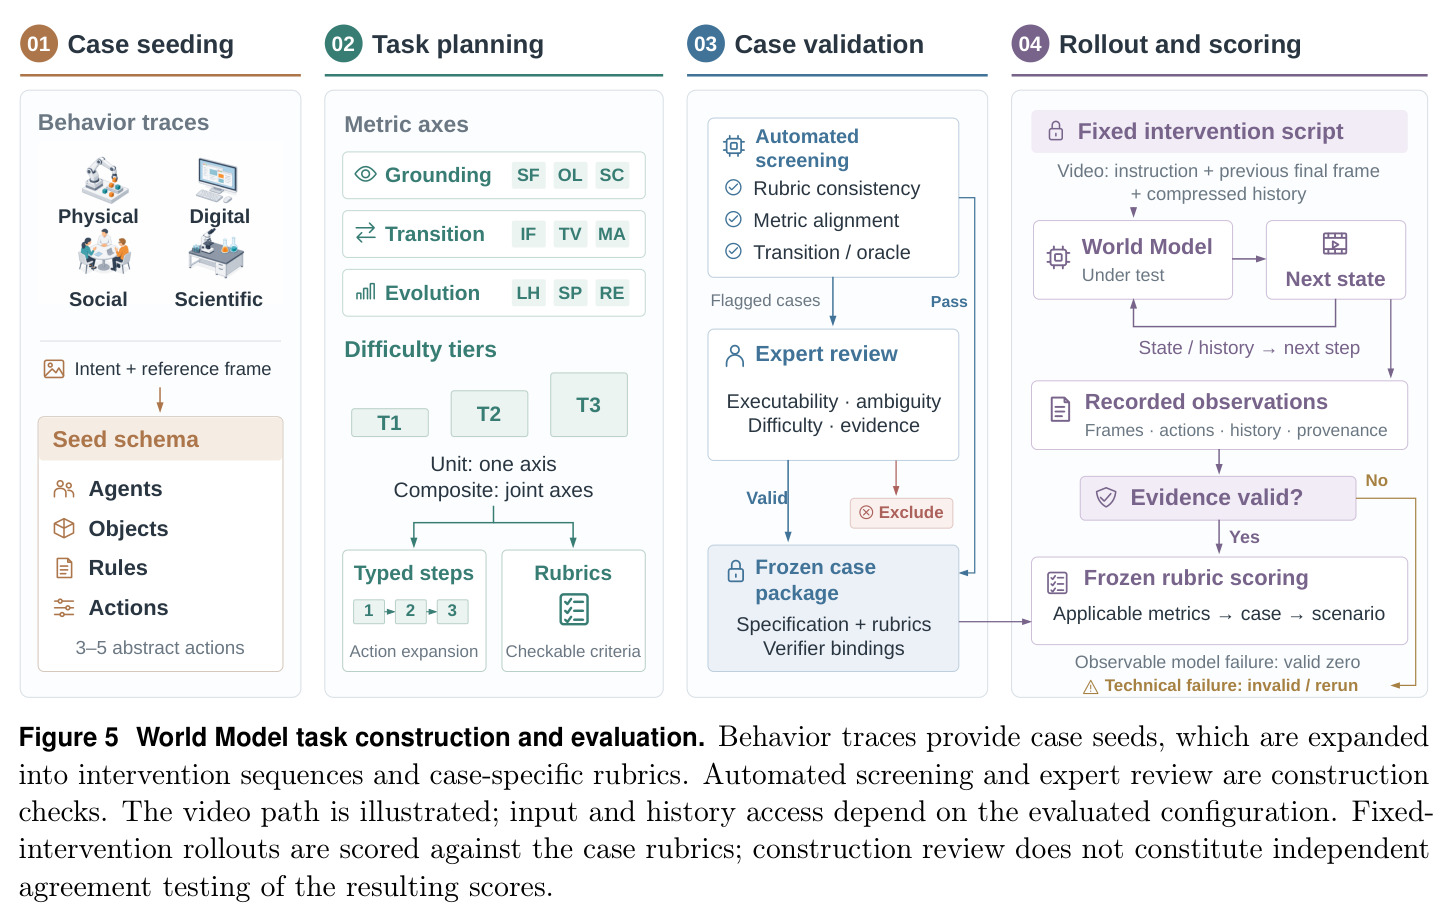
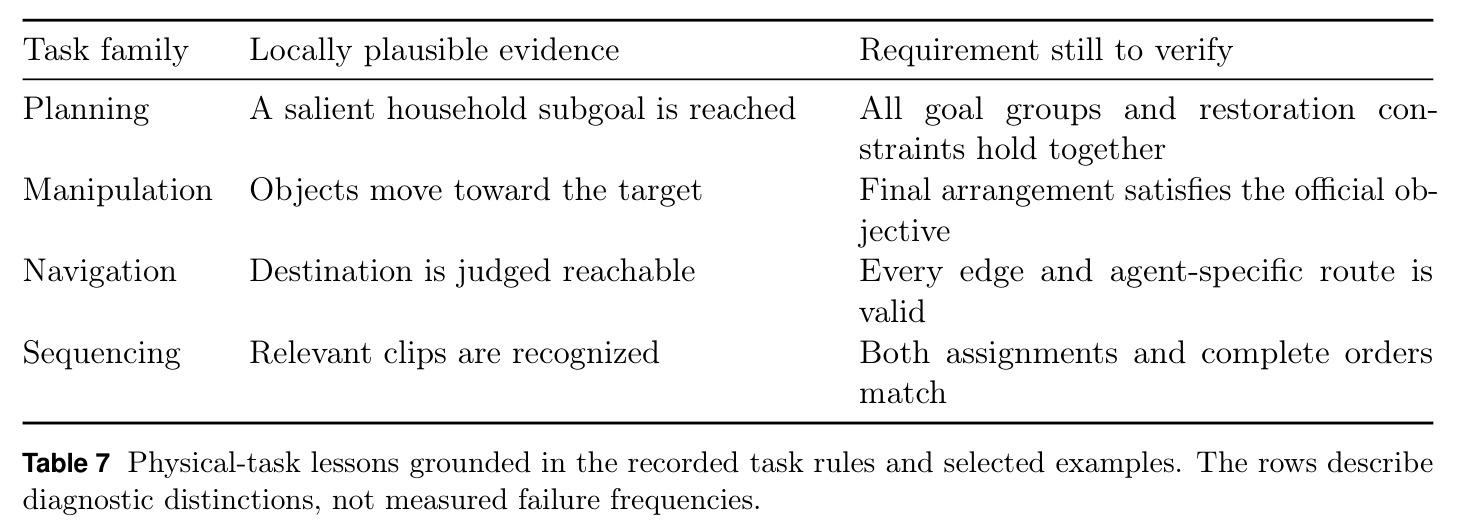
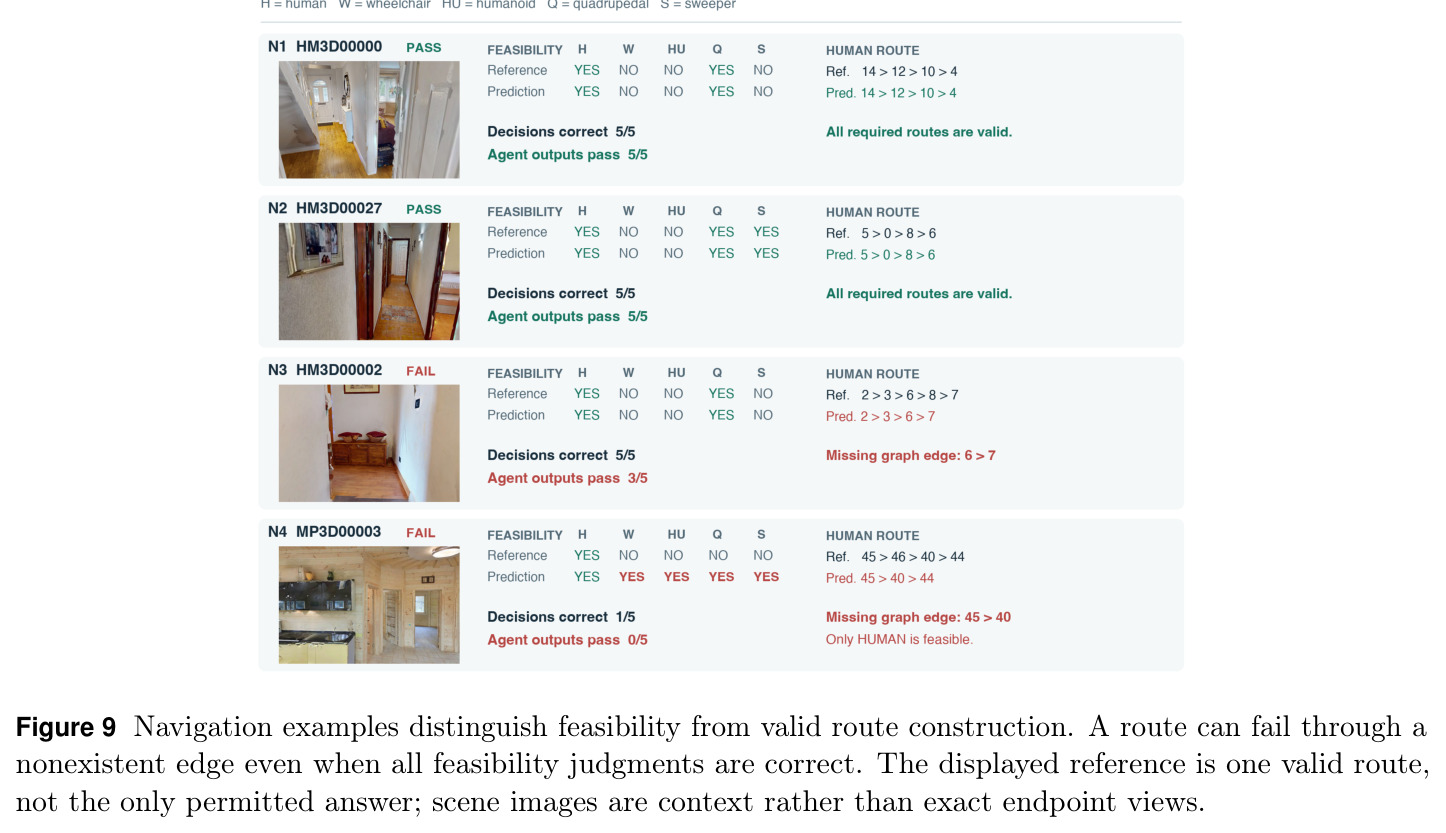
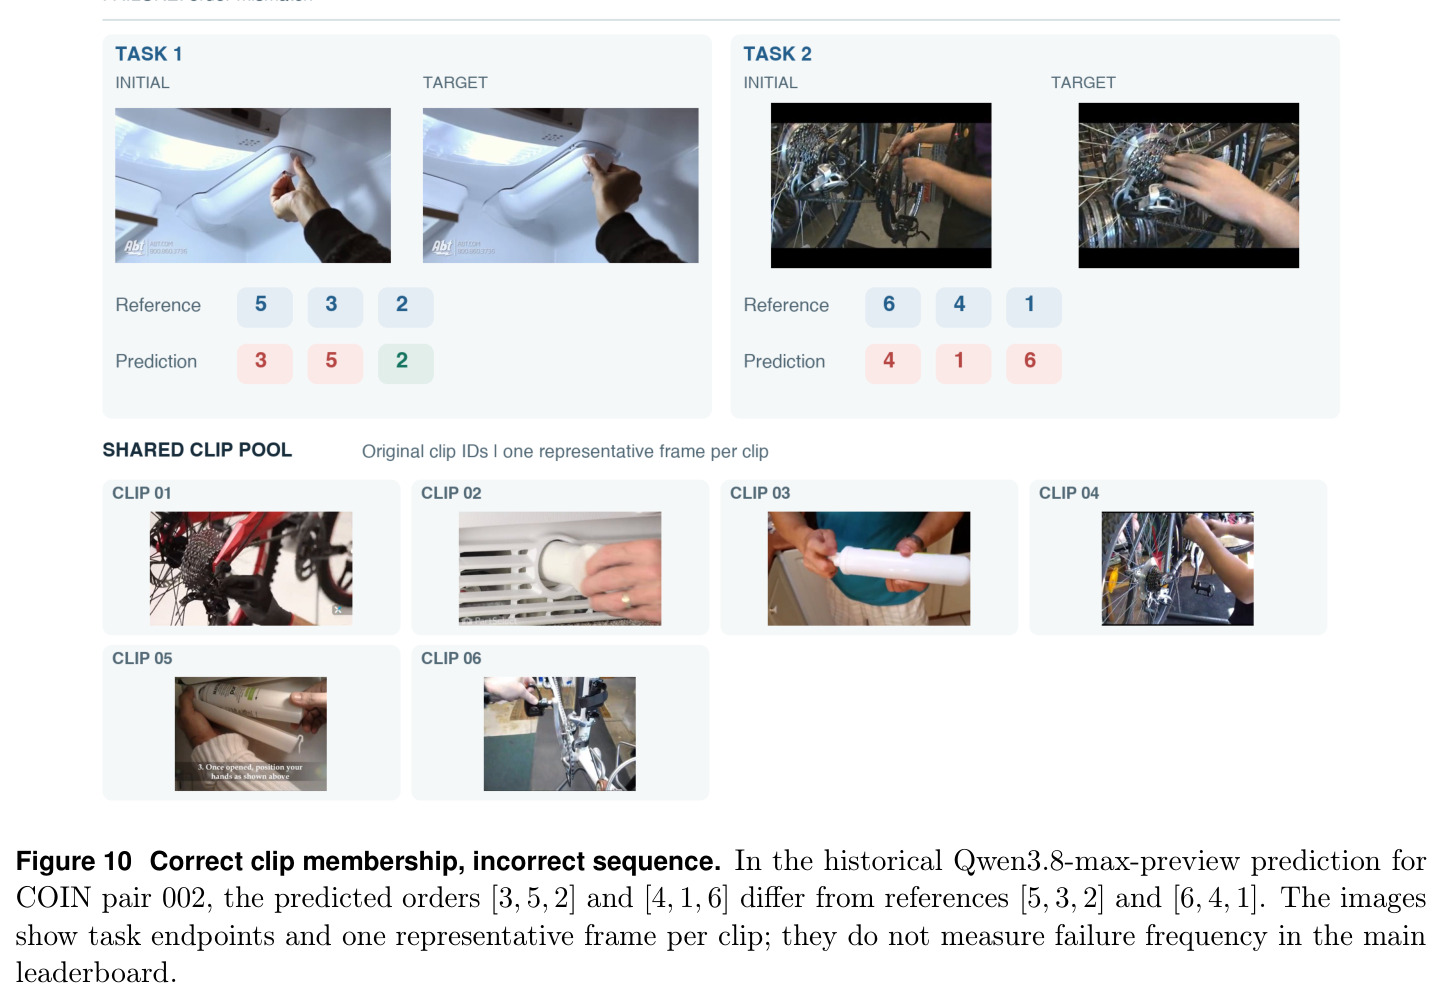
核心创新是“组件隔离”的评测语义。Agent 测试时环境响应机制固定——参考机制不必向 Agent 暴露内部状态,也不被假定无误;WM 测试时动作干预固定——预定义脚本依次施加干预,WM 生成下一观测。这与耦合运行有本质区别:耦合运行中后续动作依赖生成观测,结果无法分离决策误差与模拟误差;Dual Exam 则把两者分别对照显式任务规格核验。此外它把要求拆细:WM 检查分四类——请求的动作效果、先前状态与身份保持、共享状态一致性、规则遵守;一个模型可能保住杯子数量却凭空添加杯子或改变托盘颜色。Agent 侧同样区分“正确局部判断”与“合法完整解”:导航可行性全对但路径含不存在的边、剪辑归属正确但顺序全错,都判失败。试点指标也做语义切分:World State Consistency 只衡量任务相关状态保持(支持检查数/适用检查数,再对步数和案例取均值),Agent Corrective Response 只衡量两次动作内是否有针对性核验/重定位/纠正(不要求修复成功)。
方法步骤详情
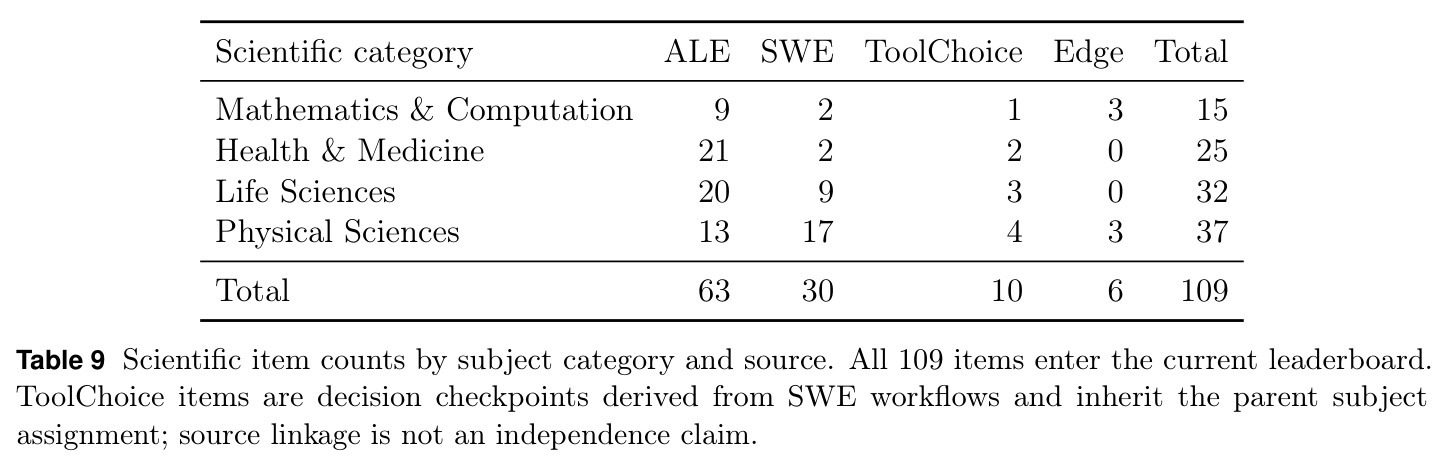
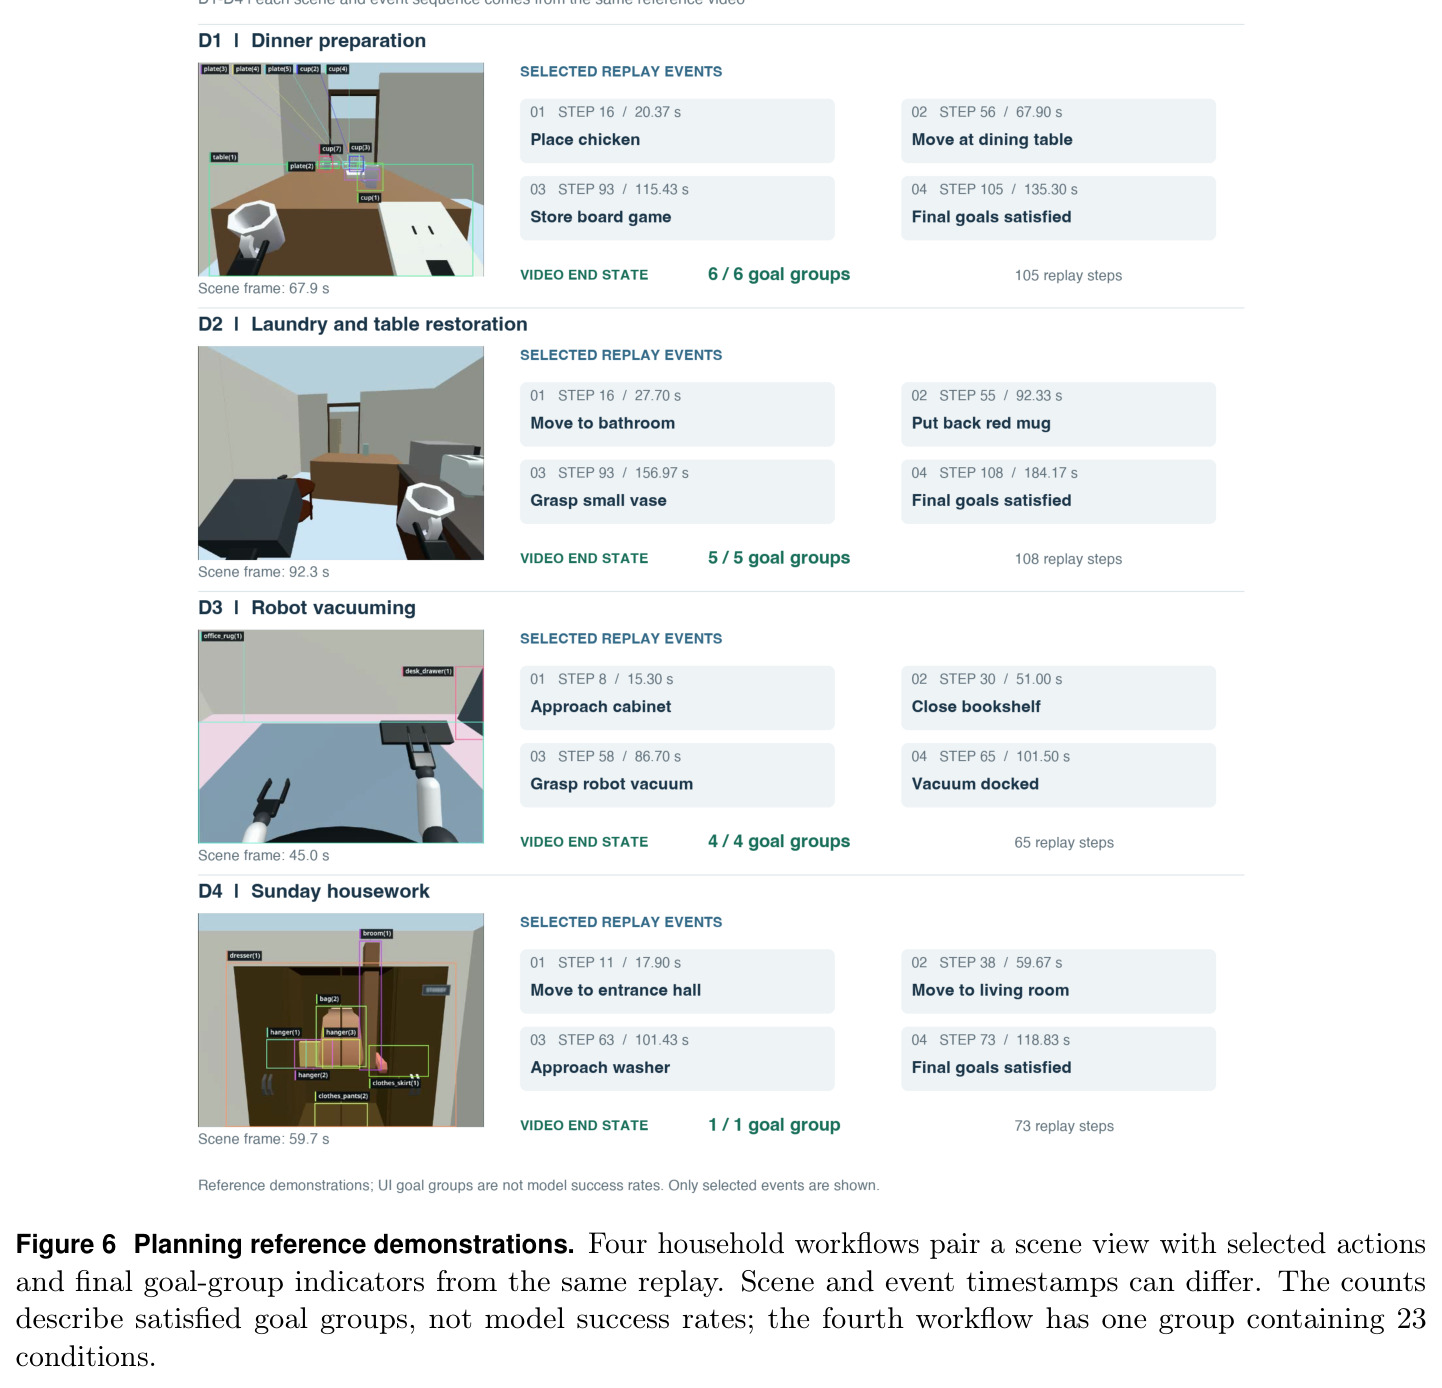
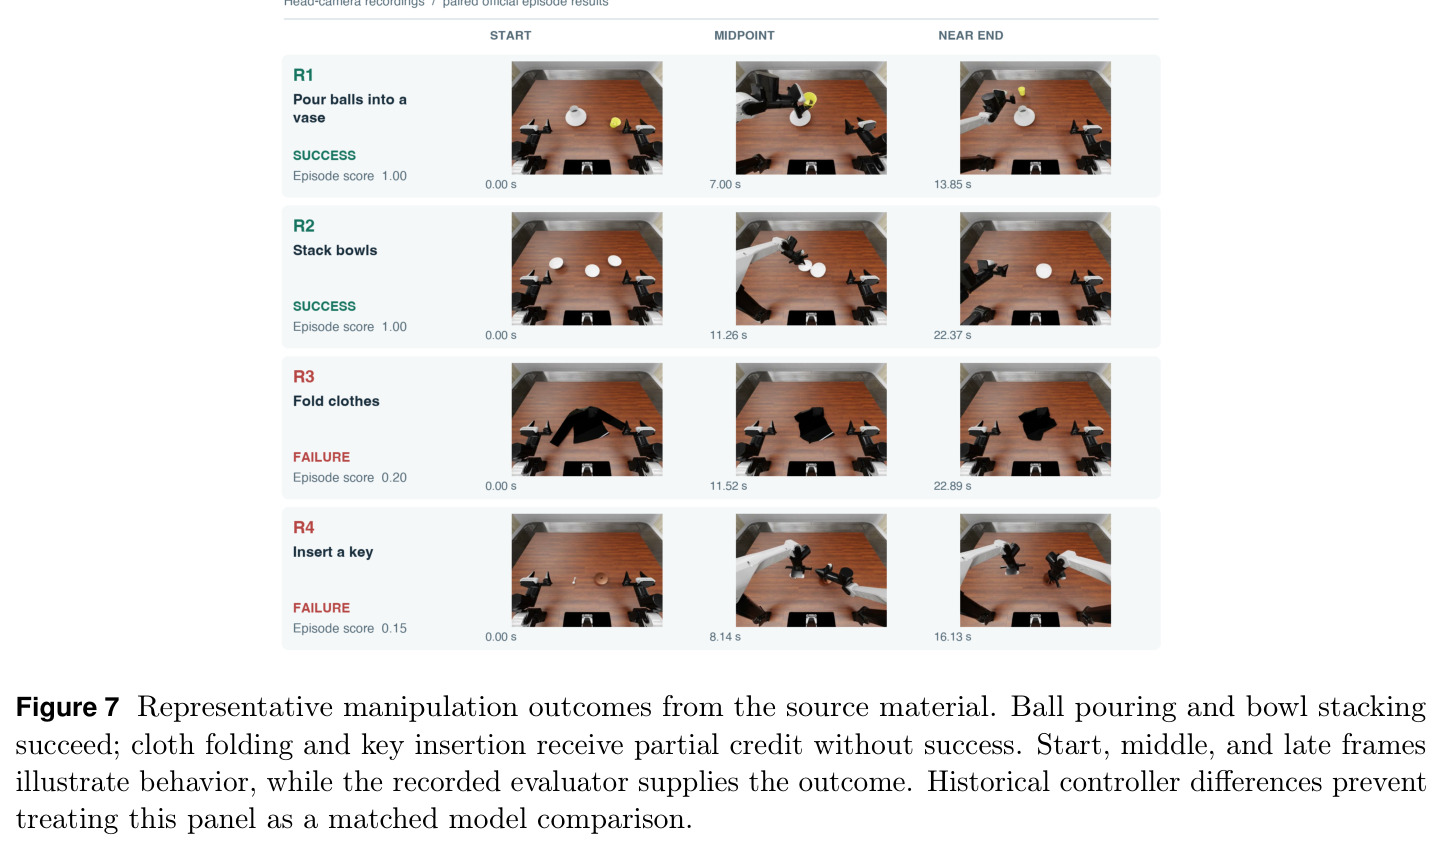
Agent 赛道四步:(1) 任务构建——从四域来源汇集任务,规定目标、初始状态、允许动作、规则与私人验证器、时间/步数预算;科学域含 63 个 ALE 任务、30 个 SWE-bench 修复任务(swe-public-30)、10 个 ToolChoice 决策检查点(继承父任务学科)、6 个 EdgeBench 优化任务。(2) 情景设置——匹配种子、隔离情景、新会话、冻结协议(模型、harness、算力、权限、重试与并发预算固定)。(3) 长程 rollout——观察-规划-行动循环,情景内允许重试,全程记录观测/动作/状态/工件,情景结束于 Done、放弃、超时或崩溃。(4) 终局评估——按任务规则做轨迹证据核验,严格成功才算成功,部分进度单独报告,失败附失败步骤与证据。WM 赛道同样四步:(1) 案例播种——用行为轨迹作种子,规定意图与参照系、智能体/物体/规则/动作,扩展为 3–5 个抽象动作;(2) 任务规划——沿 Grounding(接地)、Transition(转场)、Evolution(演化)三个指标轴展开干预序列并做 T1–T3 难度分层;(3) 案例校验——自动筛选(rubric 一致性、指标对齐、可执行性)加专家评审,形成冻结案例包与绑定验证器的可检查标准;(4) 固定干预 rollout 与评分——视频路径输入指令+上一最终帧+压缩历史,WM 生成下一状态,按案例 rubric 打分;可观测的模型错误计为有效零分,技术失败单独记录并可重跑。
技术新颖性
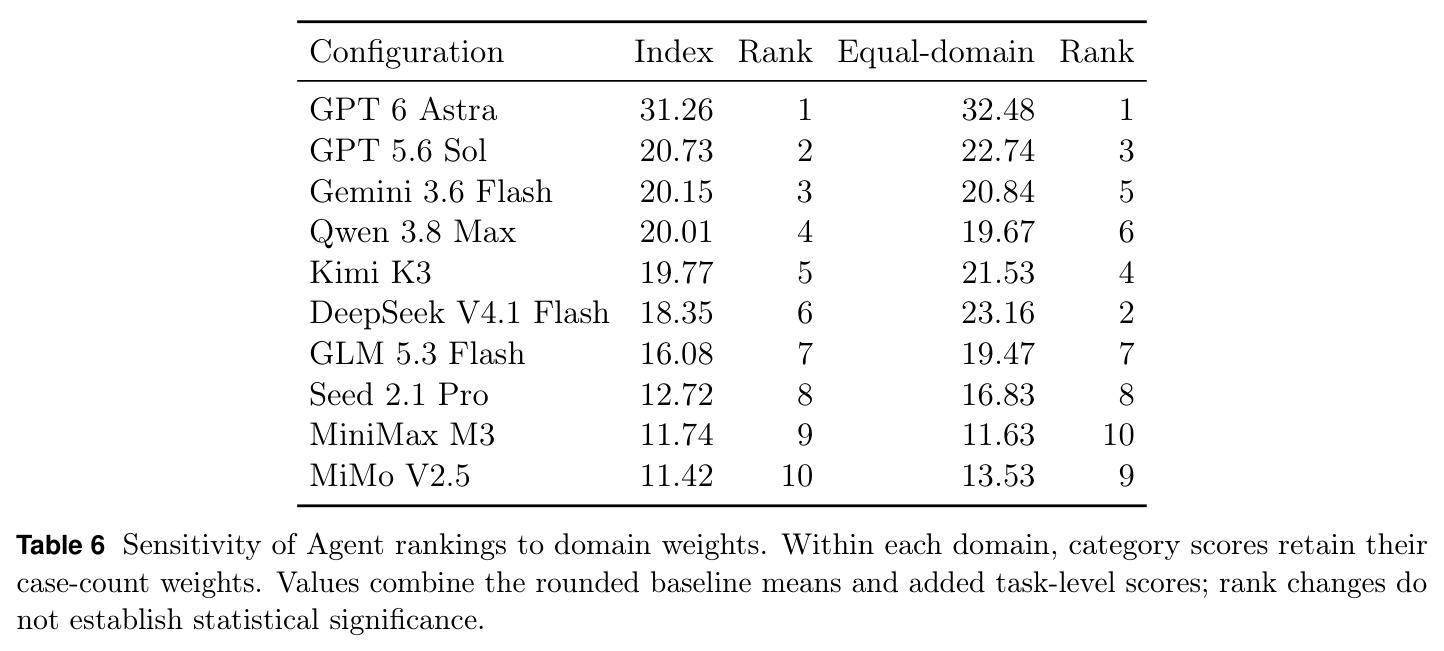
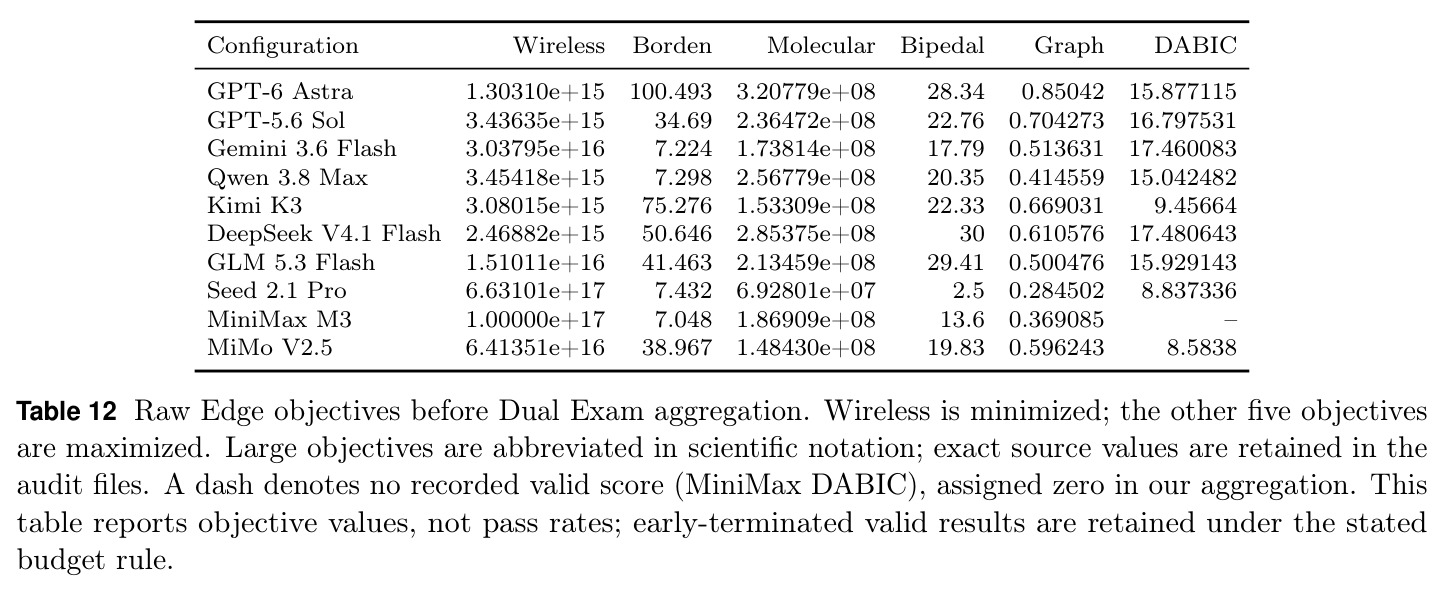
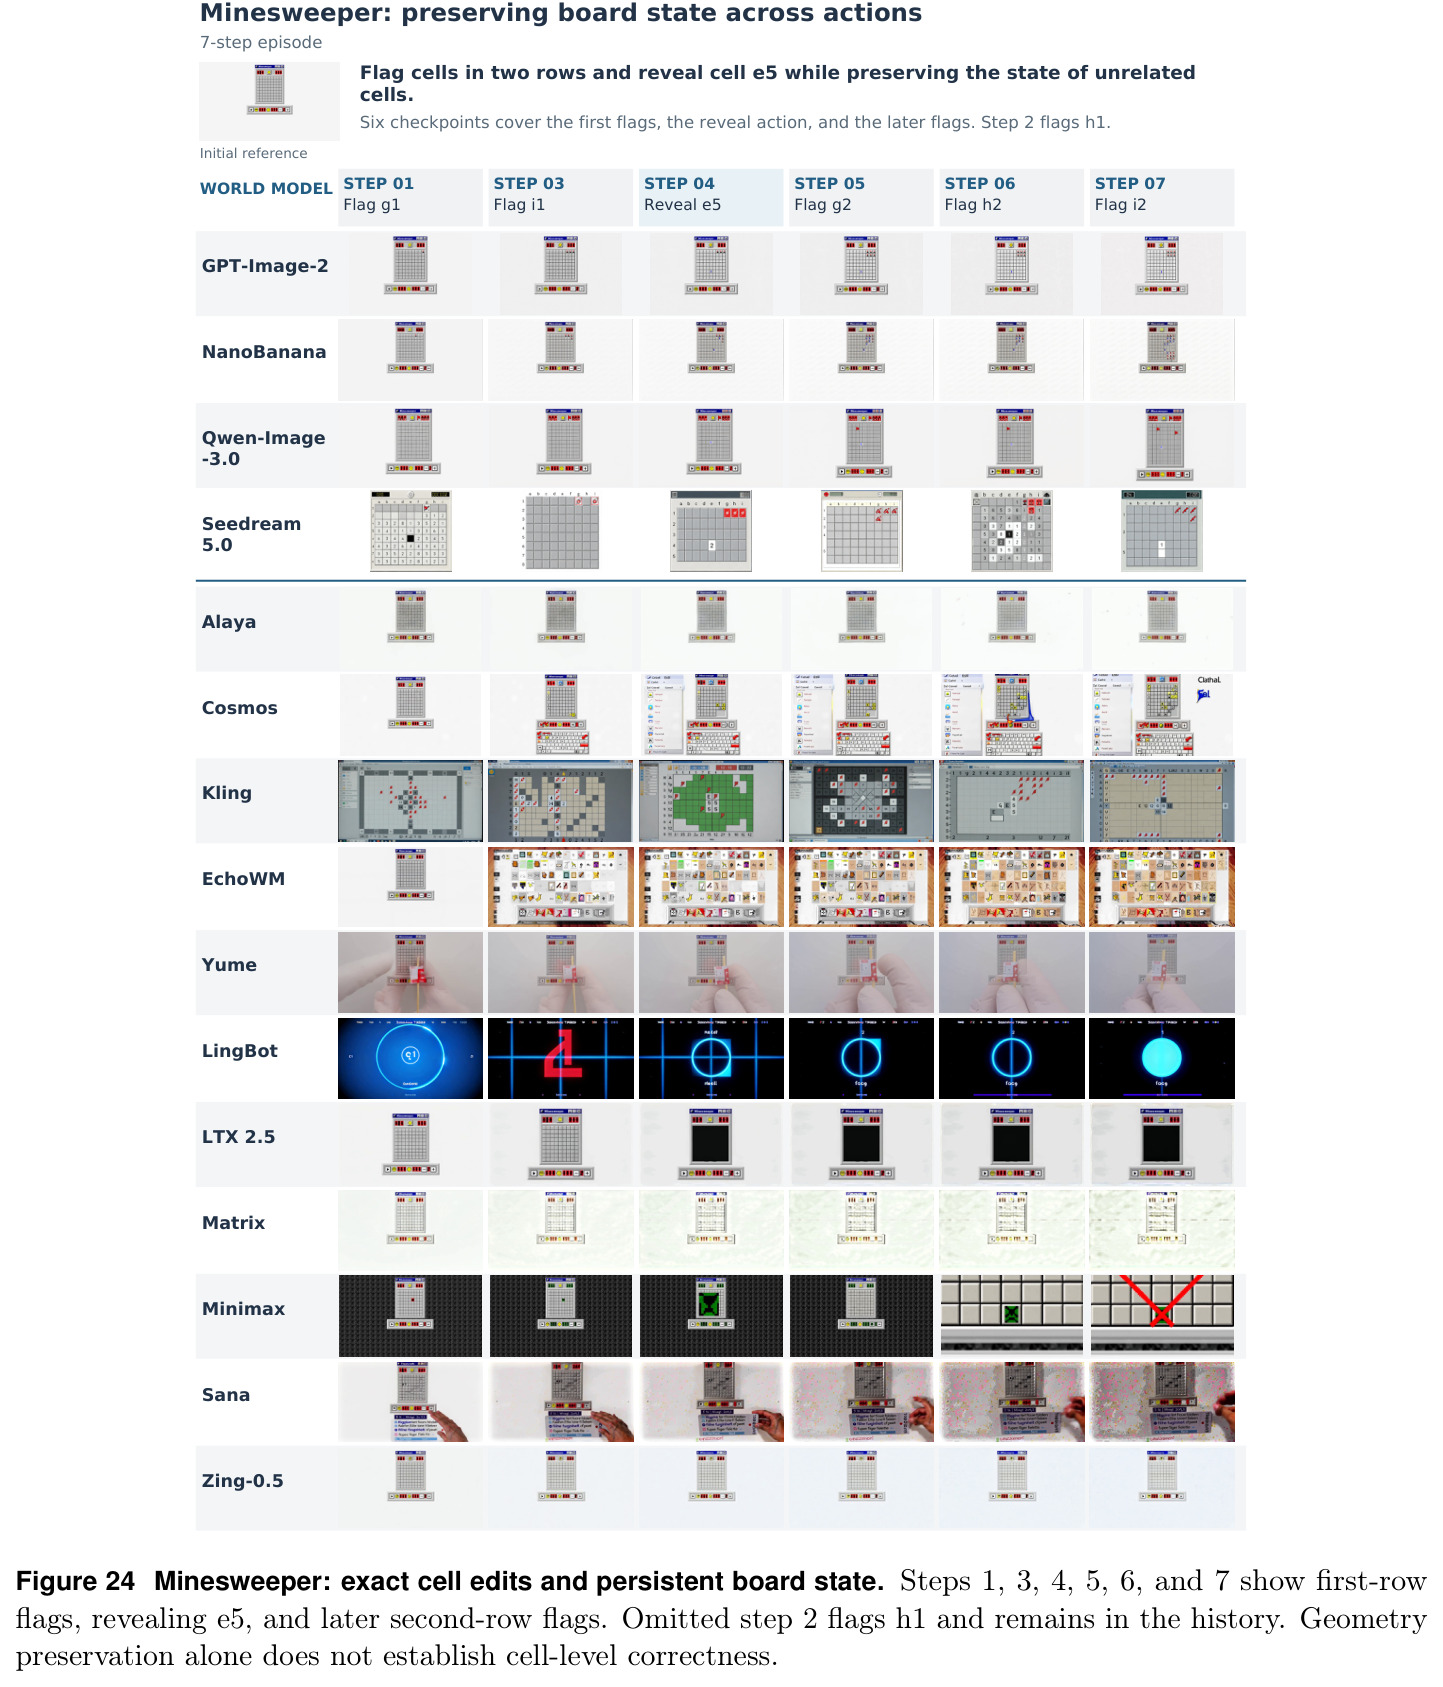
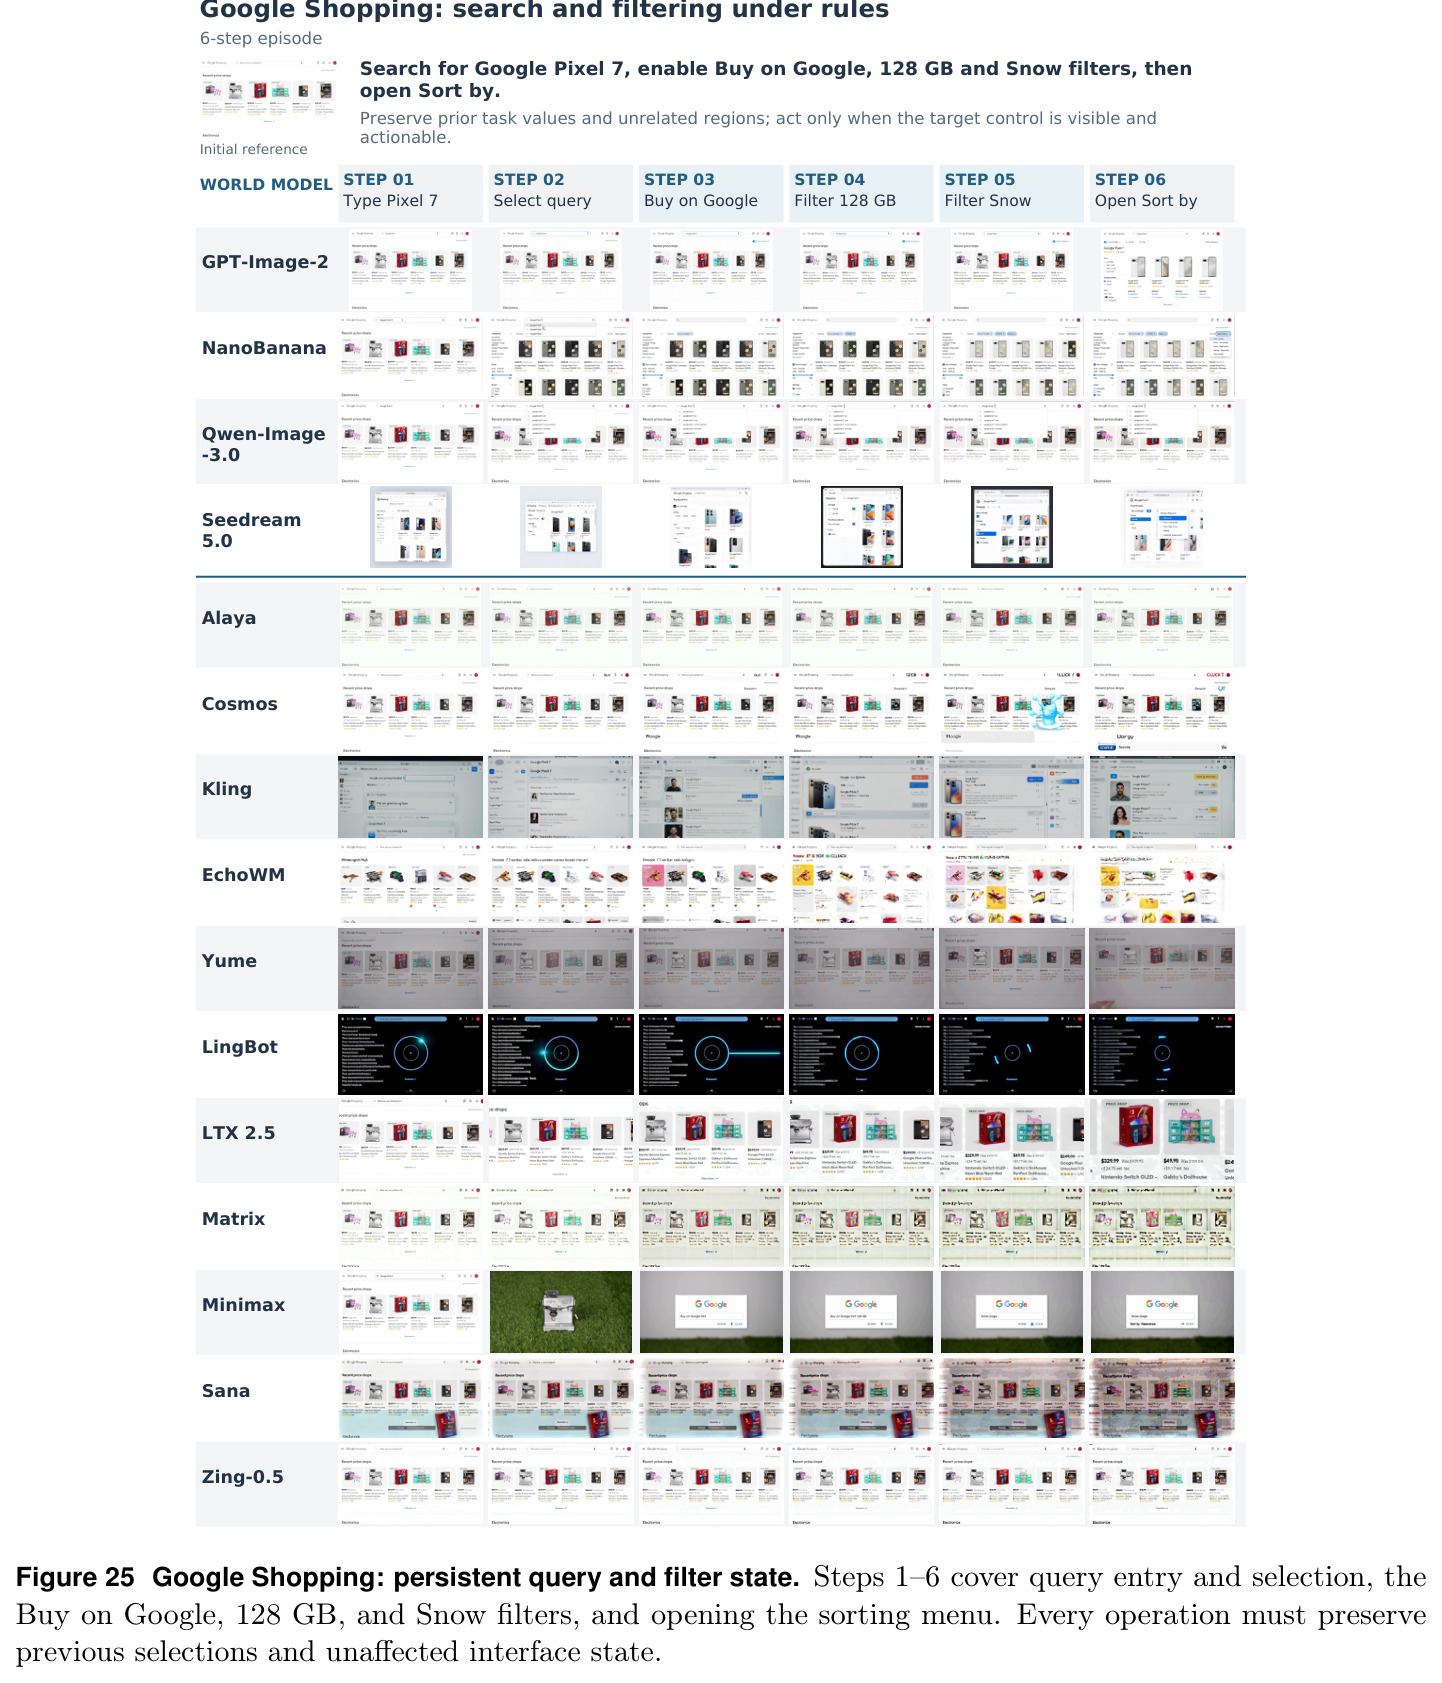
技术新颖性有三。其一,评测维度的完备组合:Table 2 显示 VBench、WorldScore、WorldArena、MIND 等基准最多覆盖其中两三项,Dual Exam 在 Agent(1,088 项)与 WM(400 例)两轨上首次同时具备多模态输入、交互 rollout、环境接地、组件隔离、持久状态与四域覆盖。其二,WM 评测引入“固定动作干预”协议并显式区分四类检查(动作效果/状态与身份保持/共享状态一致性/规则遵守),比视频质量指标更贴近“能否当一个可靠的伙伴模拟器”这一下游问题;扫雷、购物等数字接口案例要求精确到单元格和控件的编辑。其三,诚实的计量框架——Index 权重反映条目数而非域重要性,主动报告等域加权的敏感性分析(DeepSeek 从第 6 升到第 2、Kimi 从第 5 升到第 4),明确声明两轨分数不可比、组件分尚未被验证能预测耦合成功率,并把 Borden/DABIC 裁剪到 [0,100] 标注为自定义约定而非官方 EdgeBench 规则。
实验结果
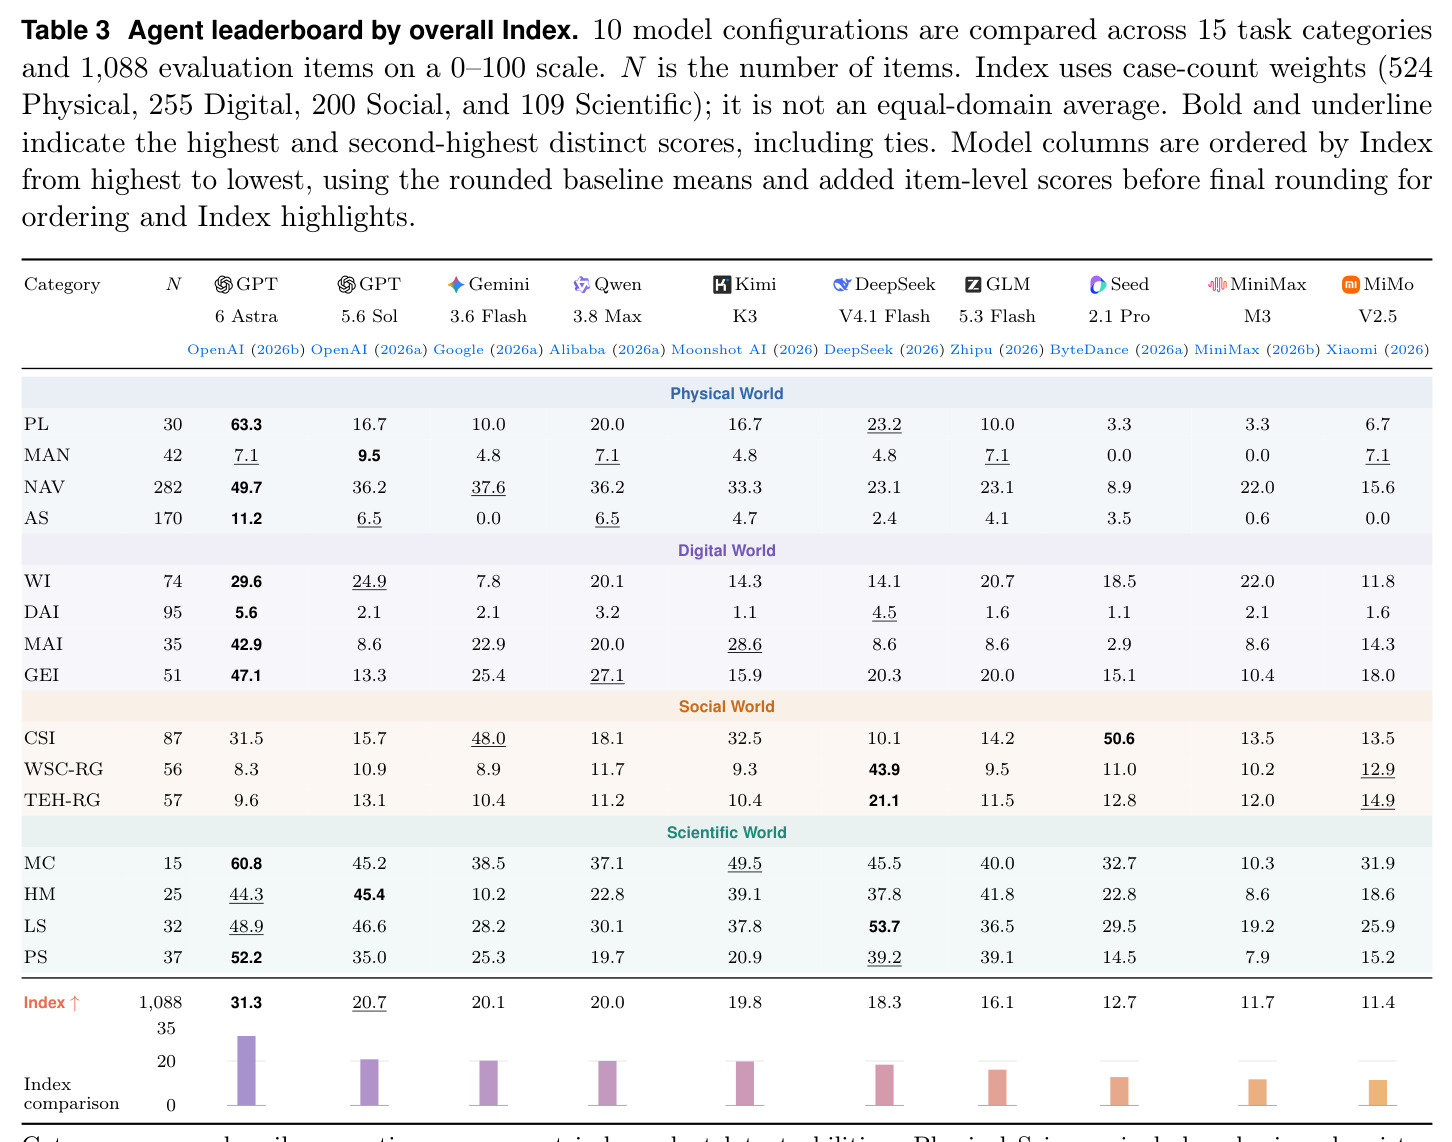
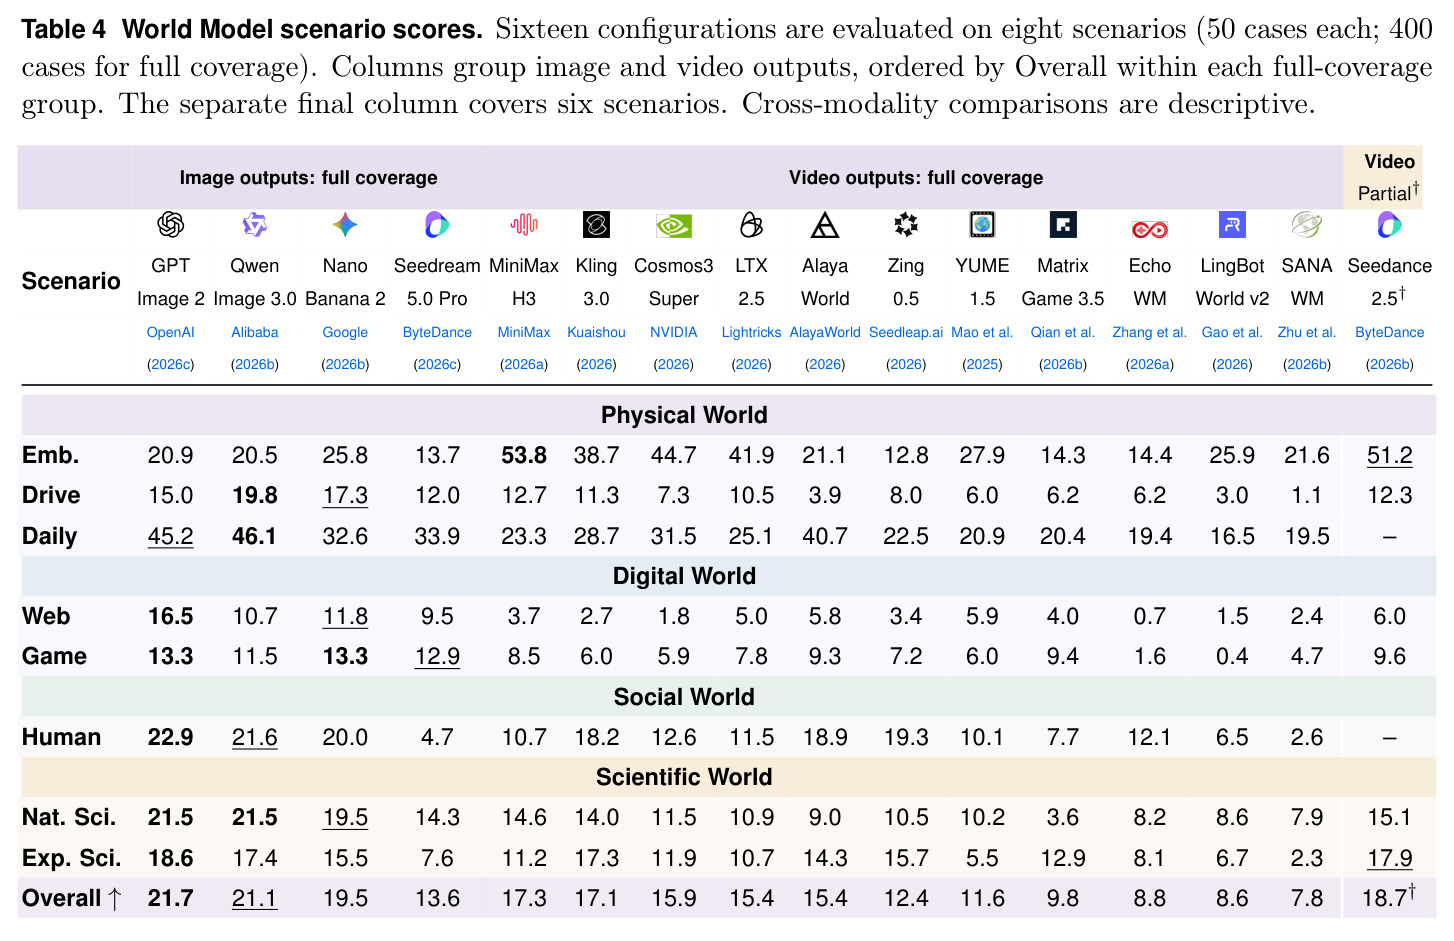
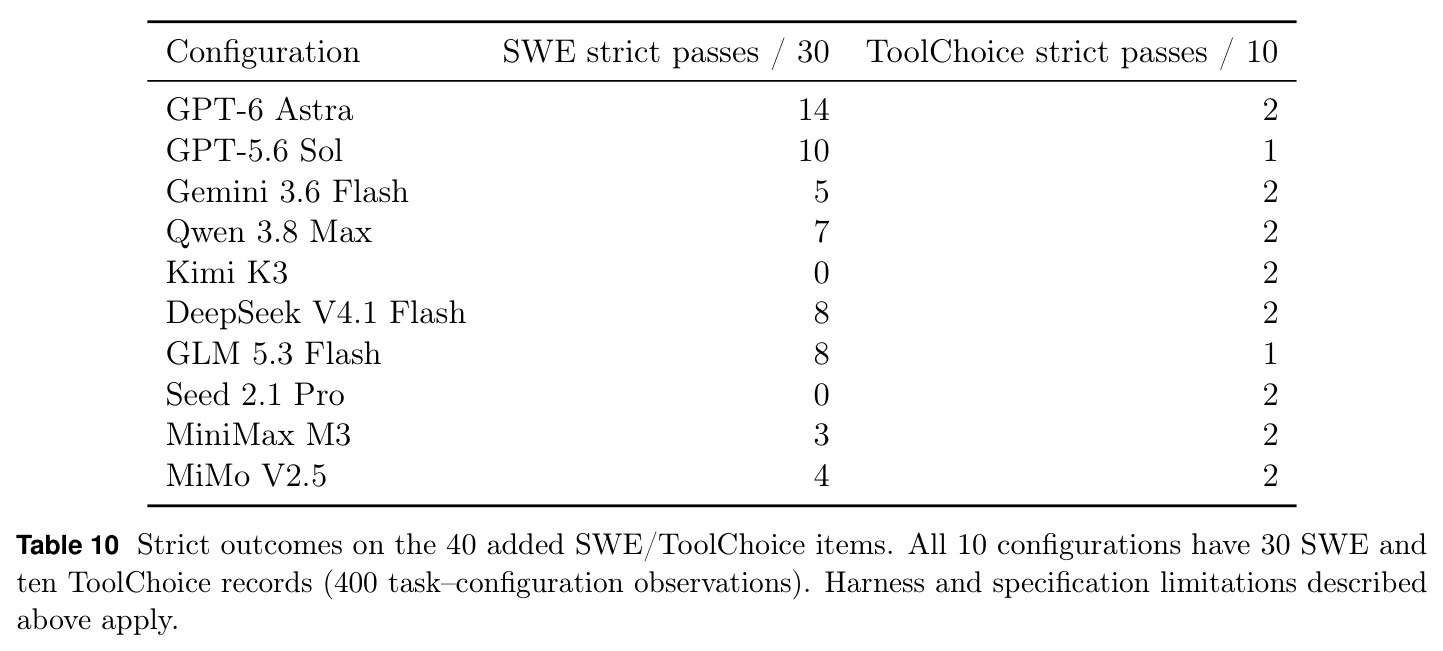
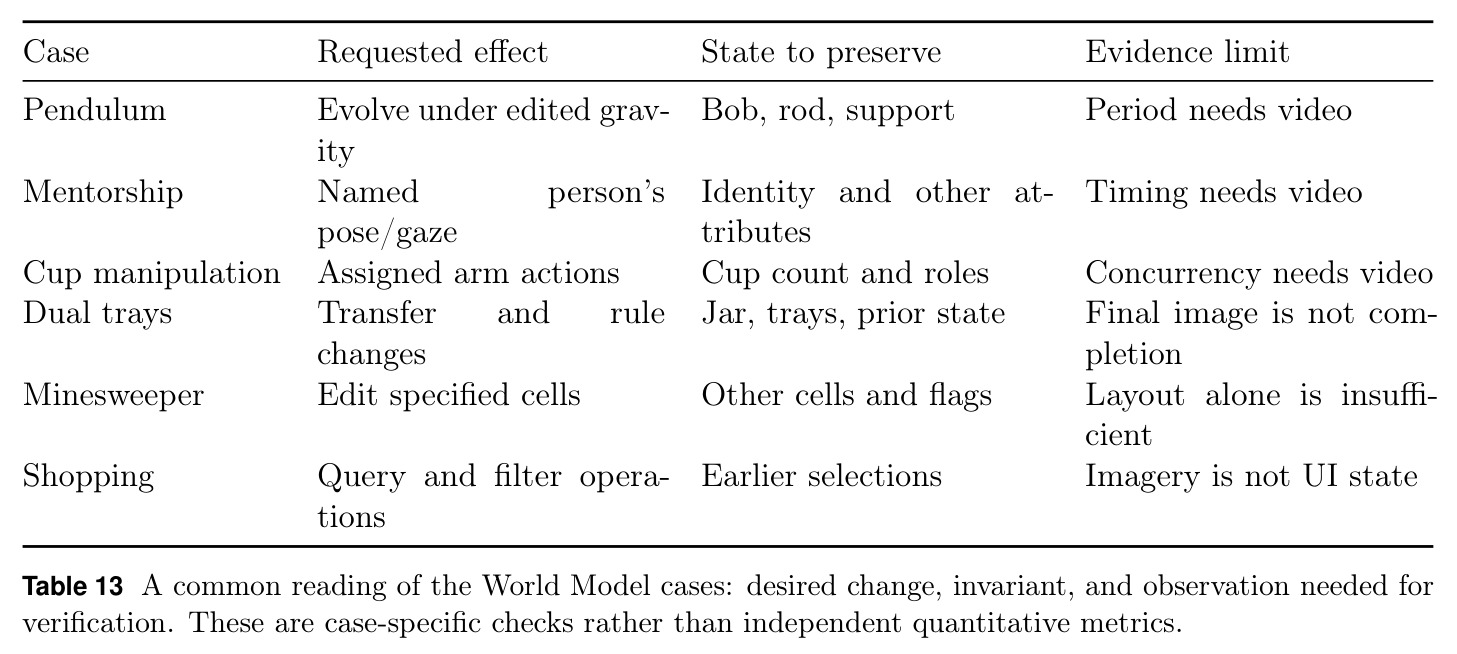
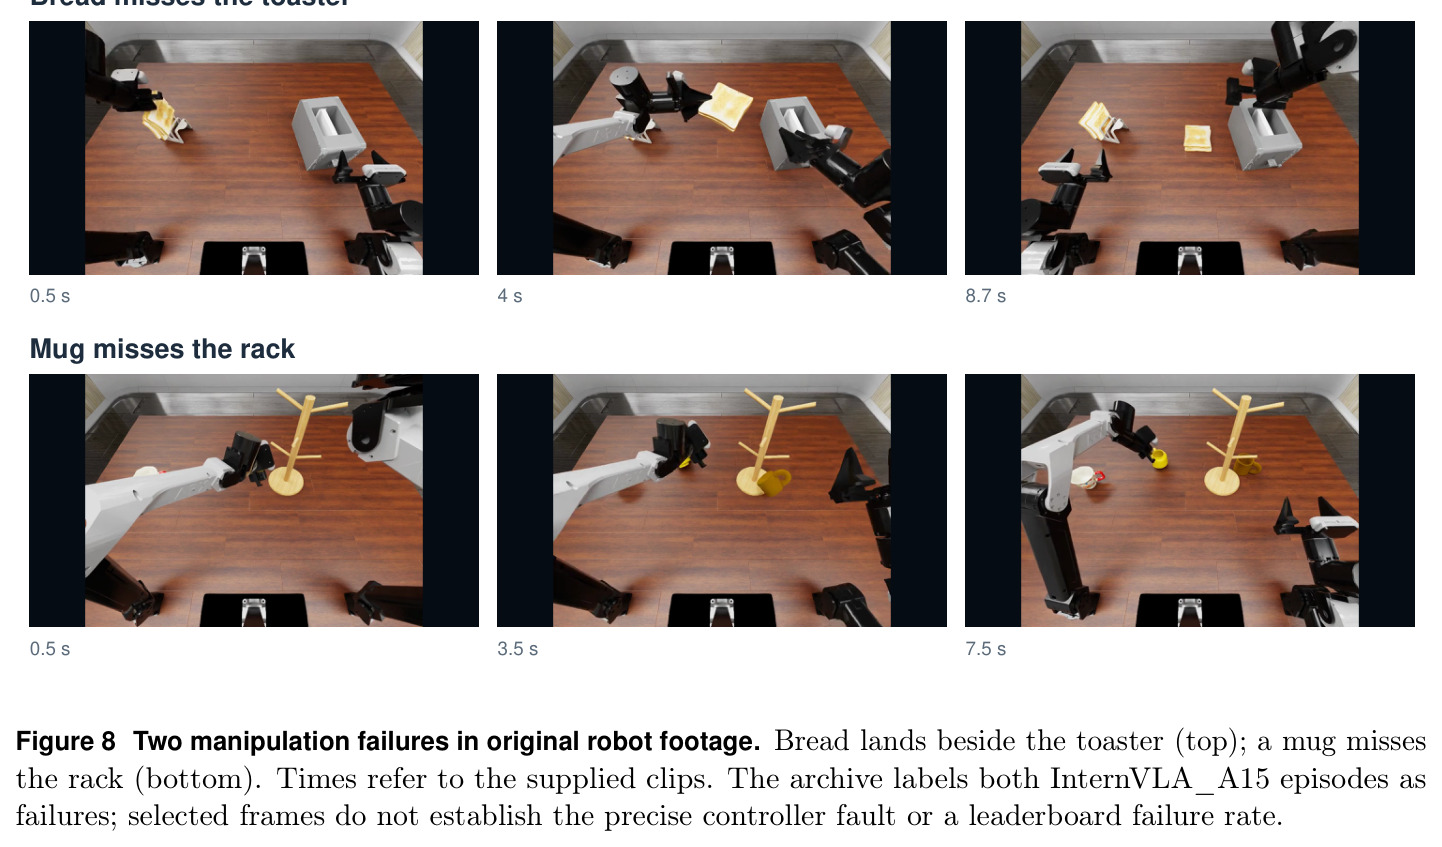
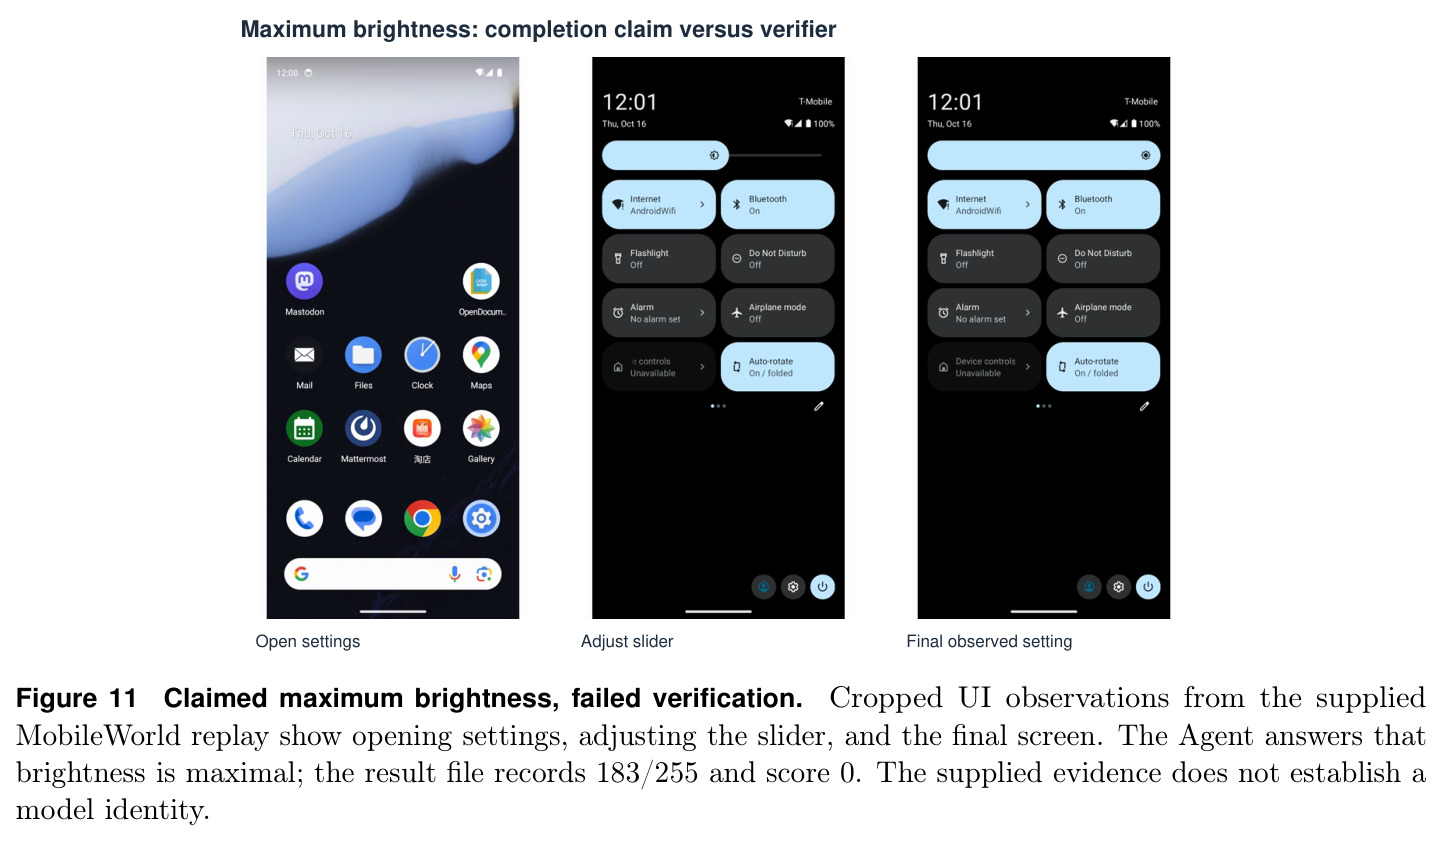
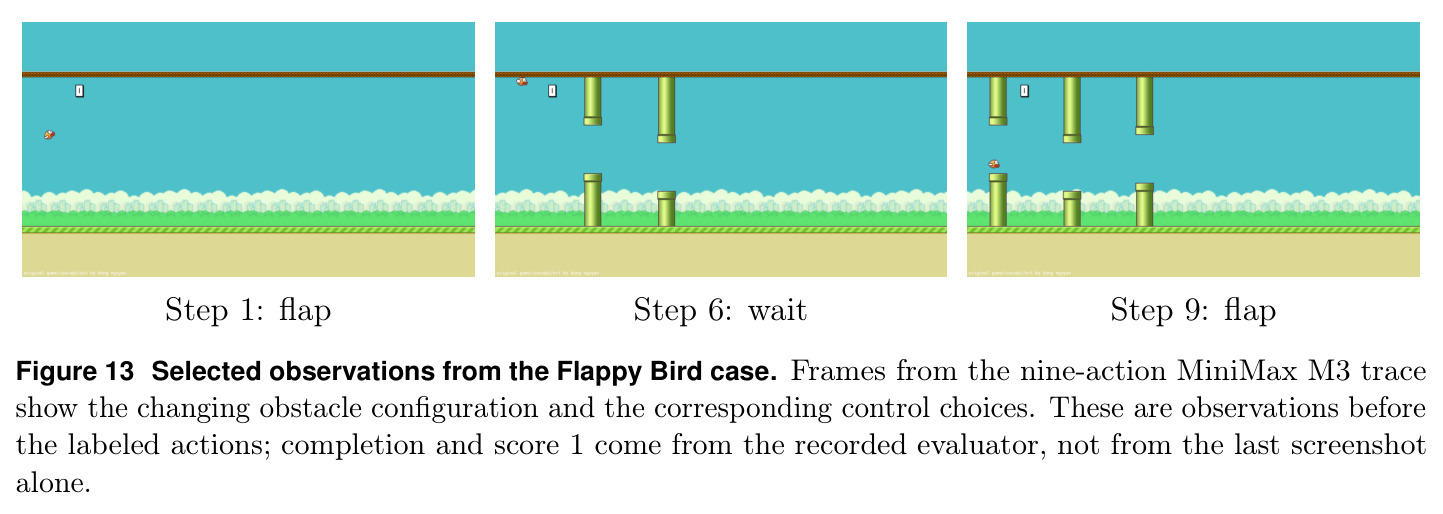
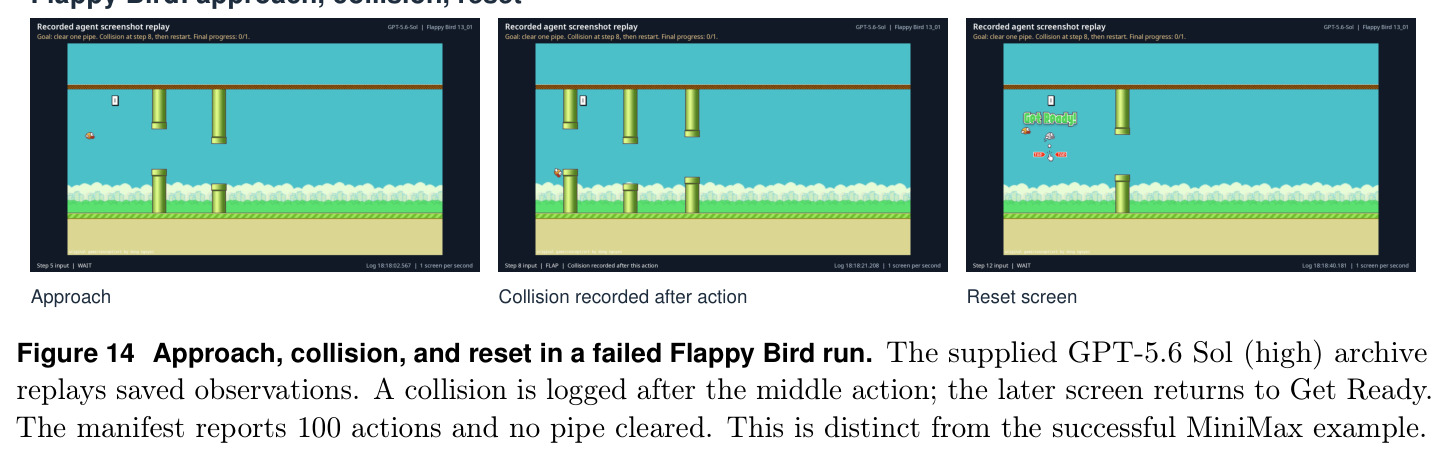
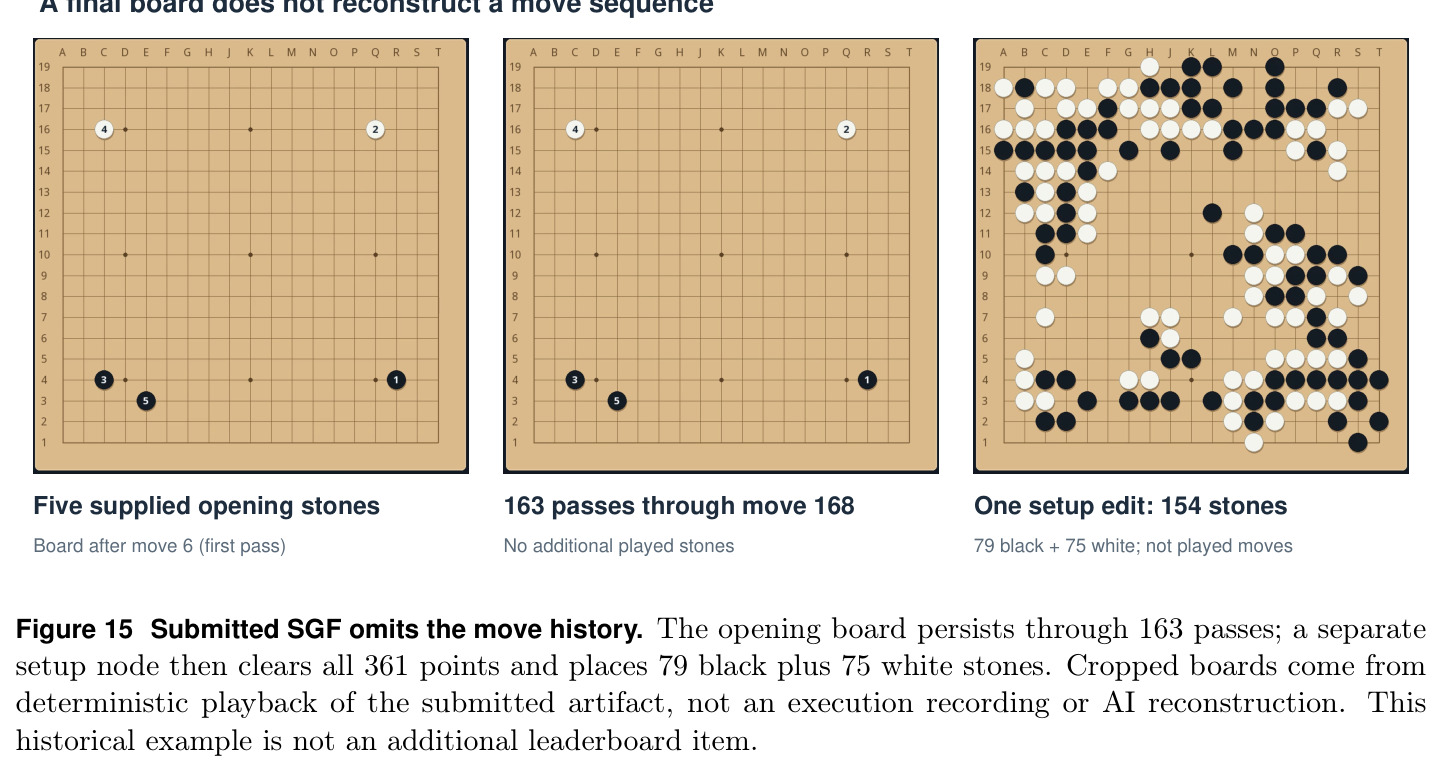
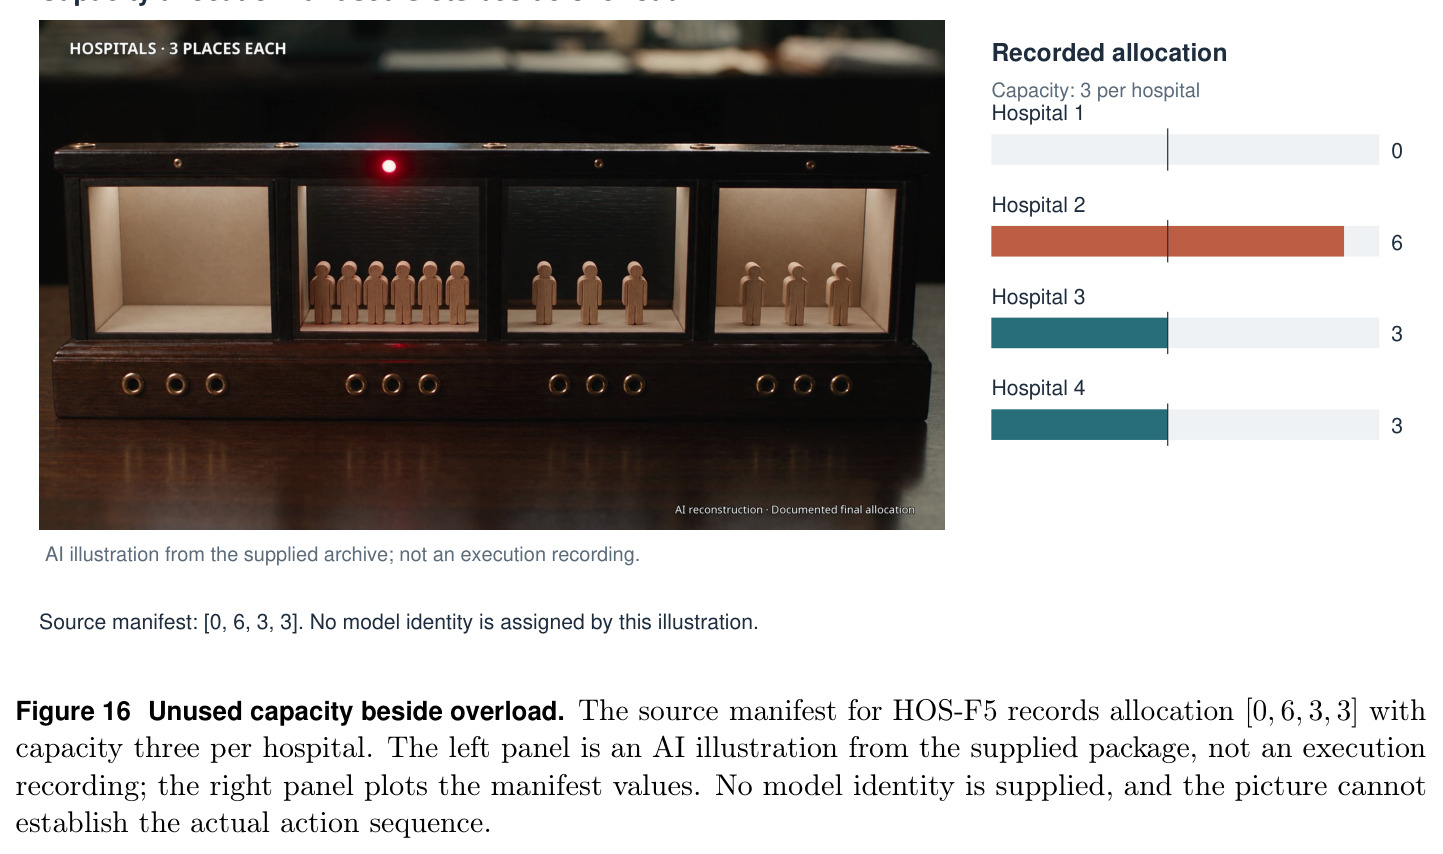
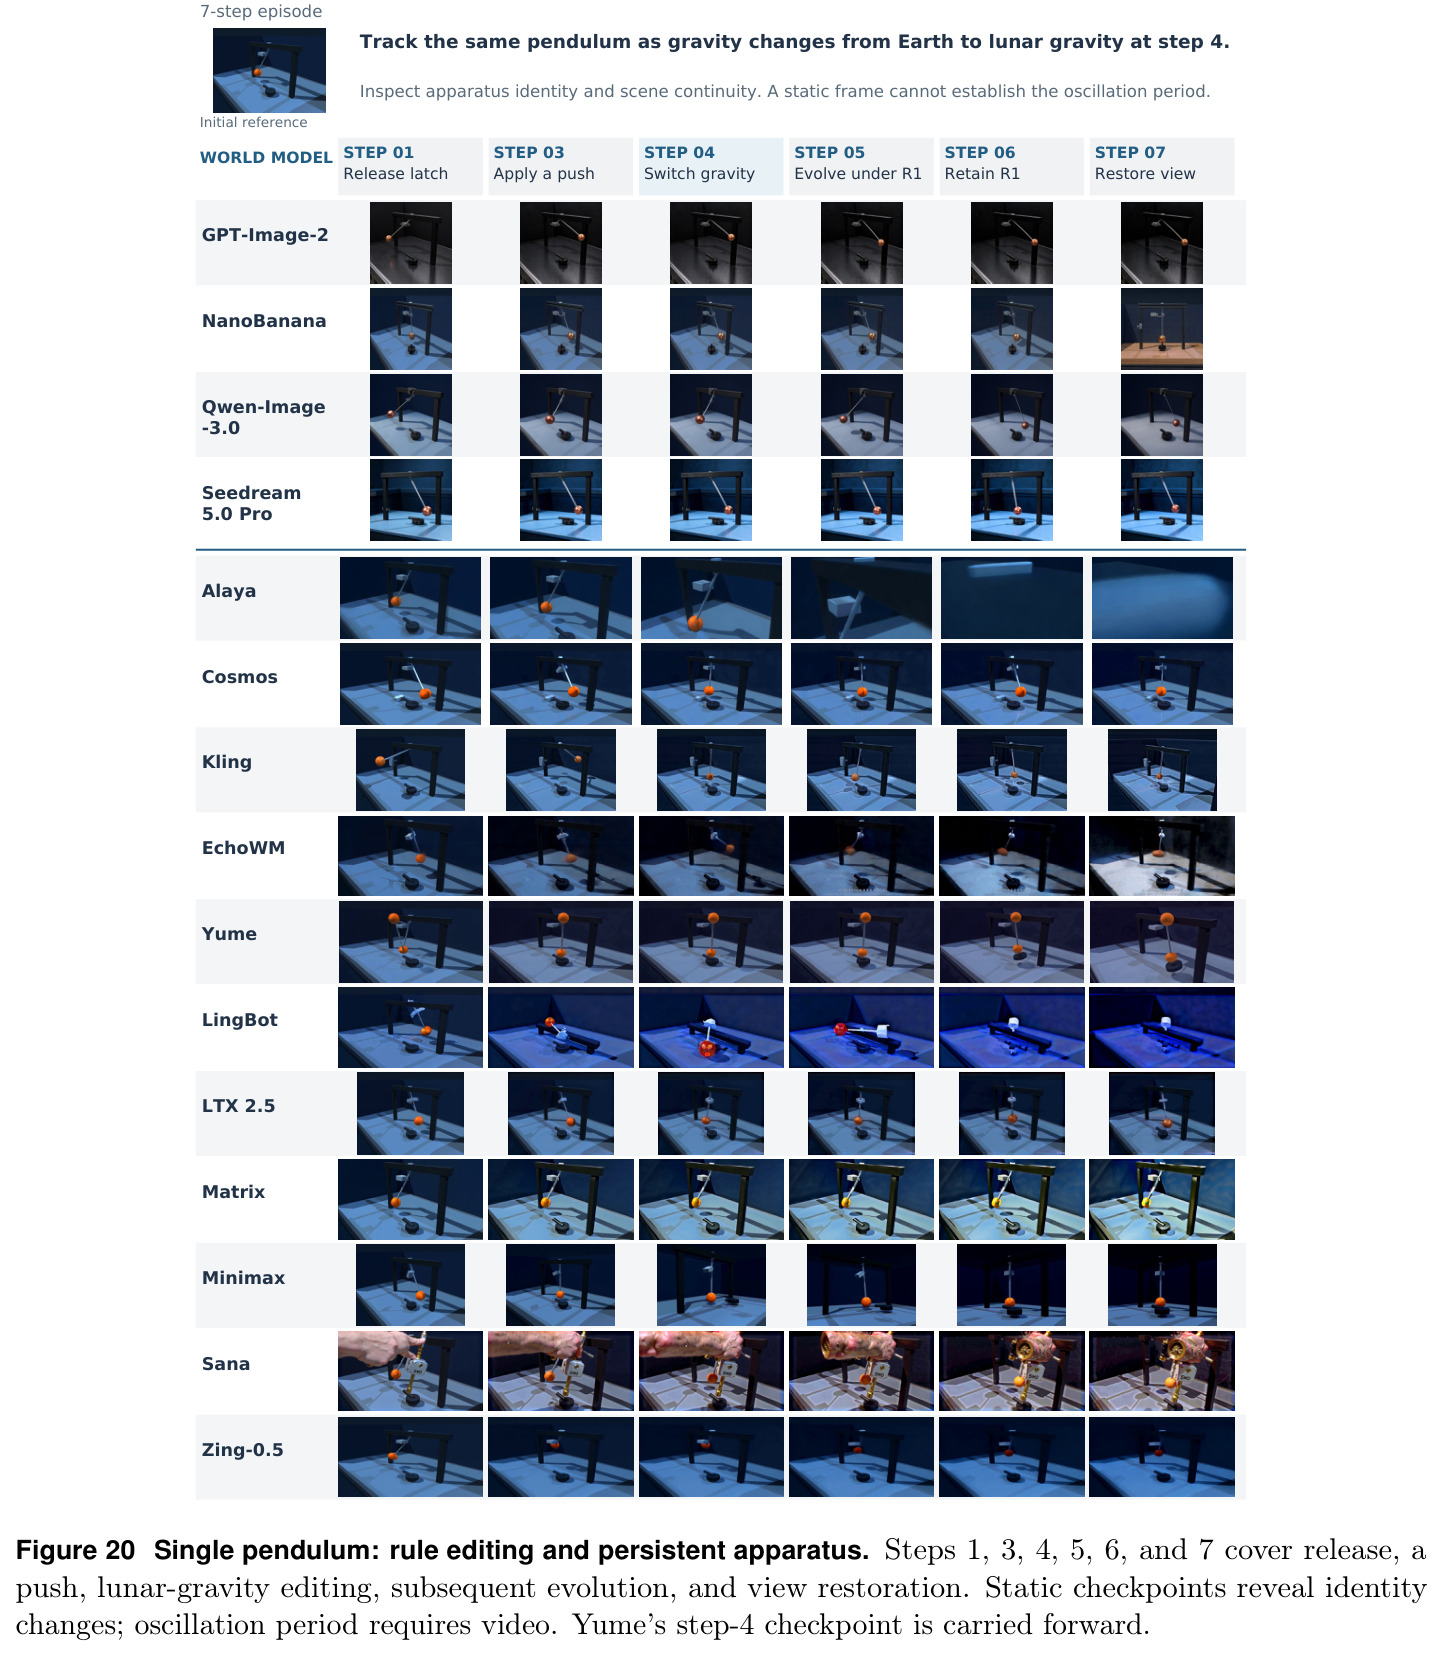
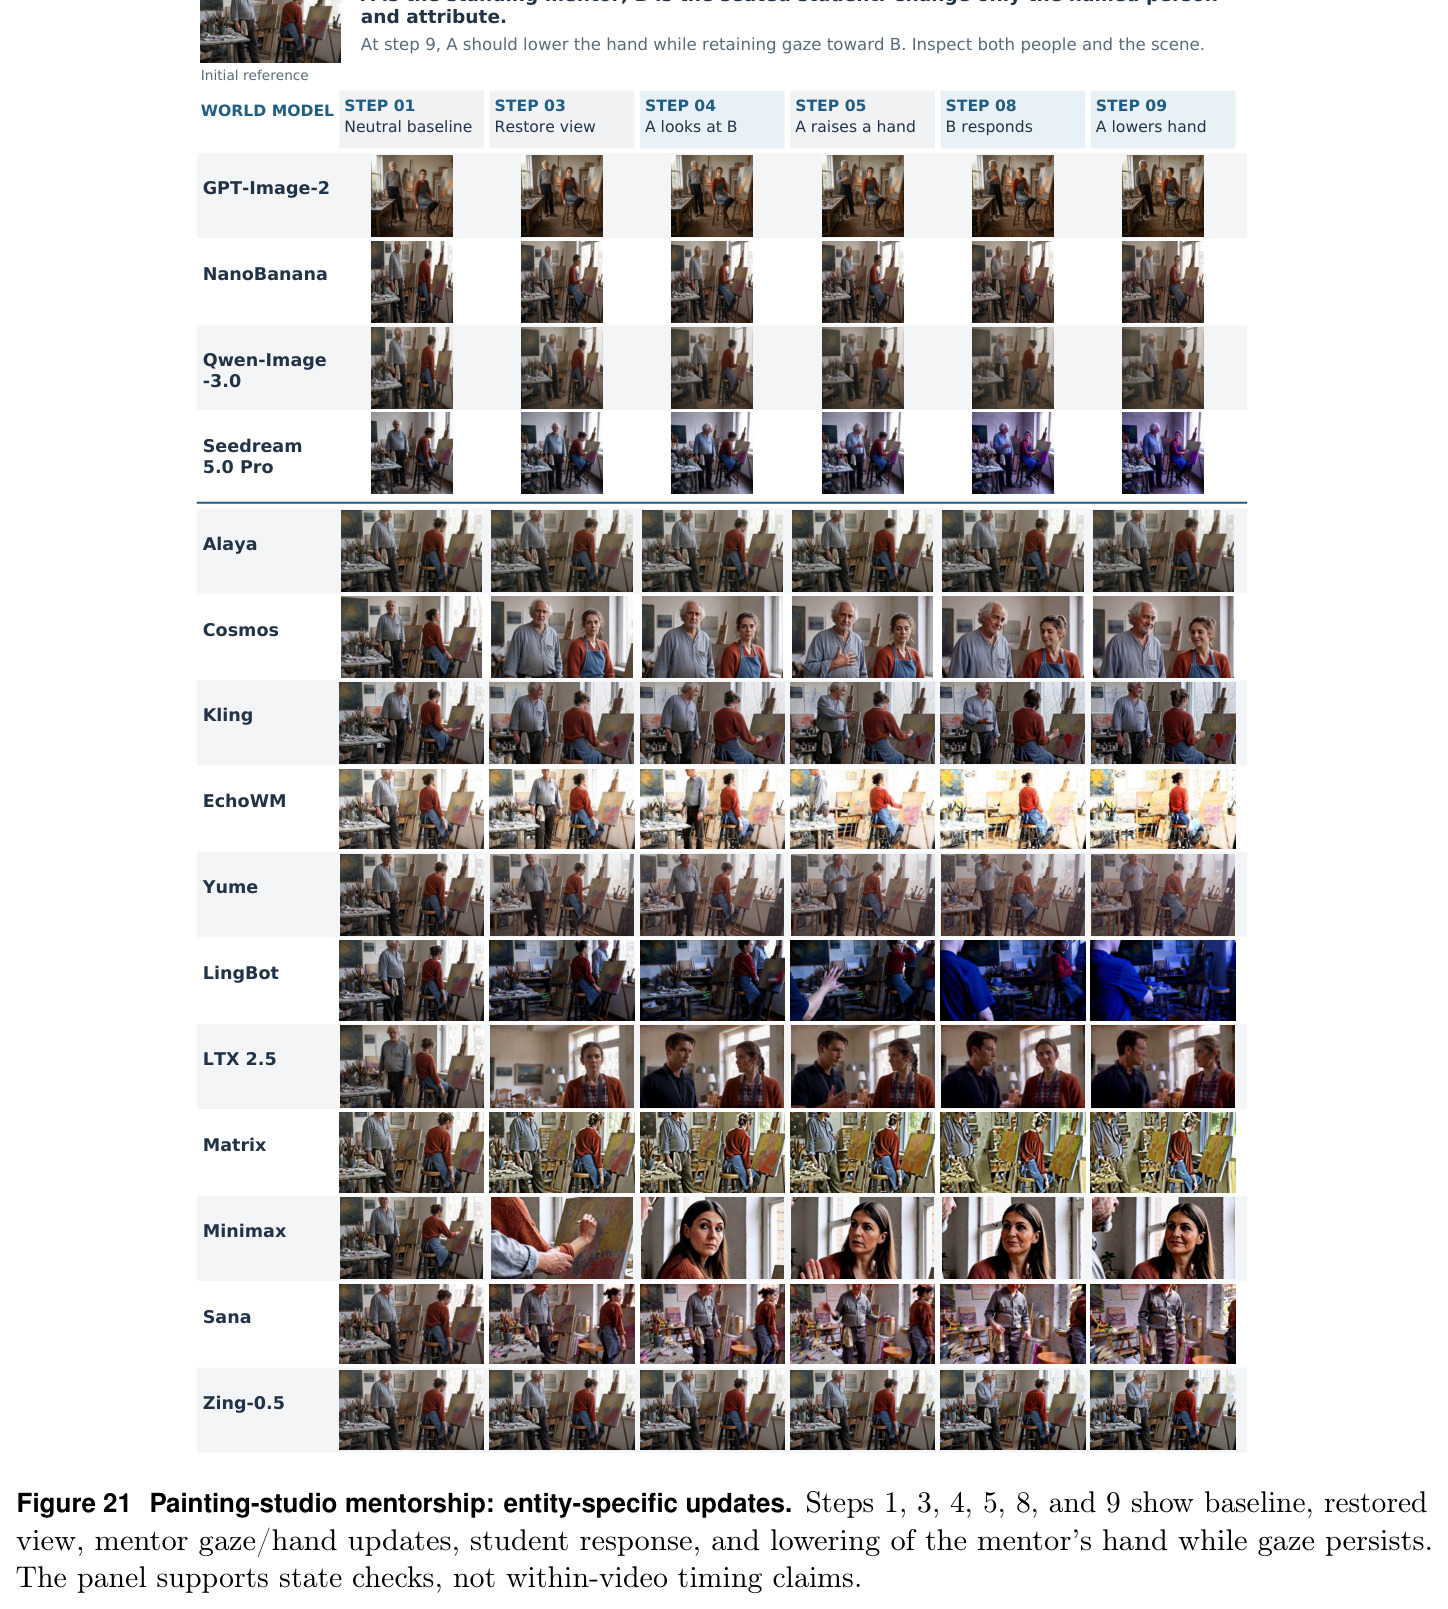
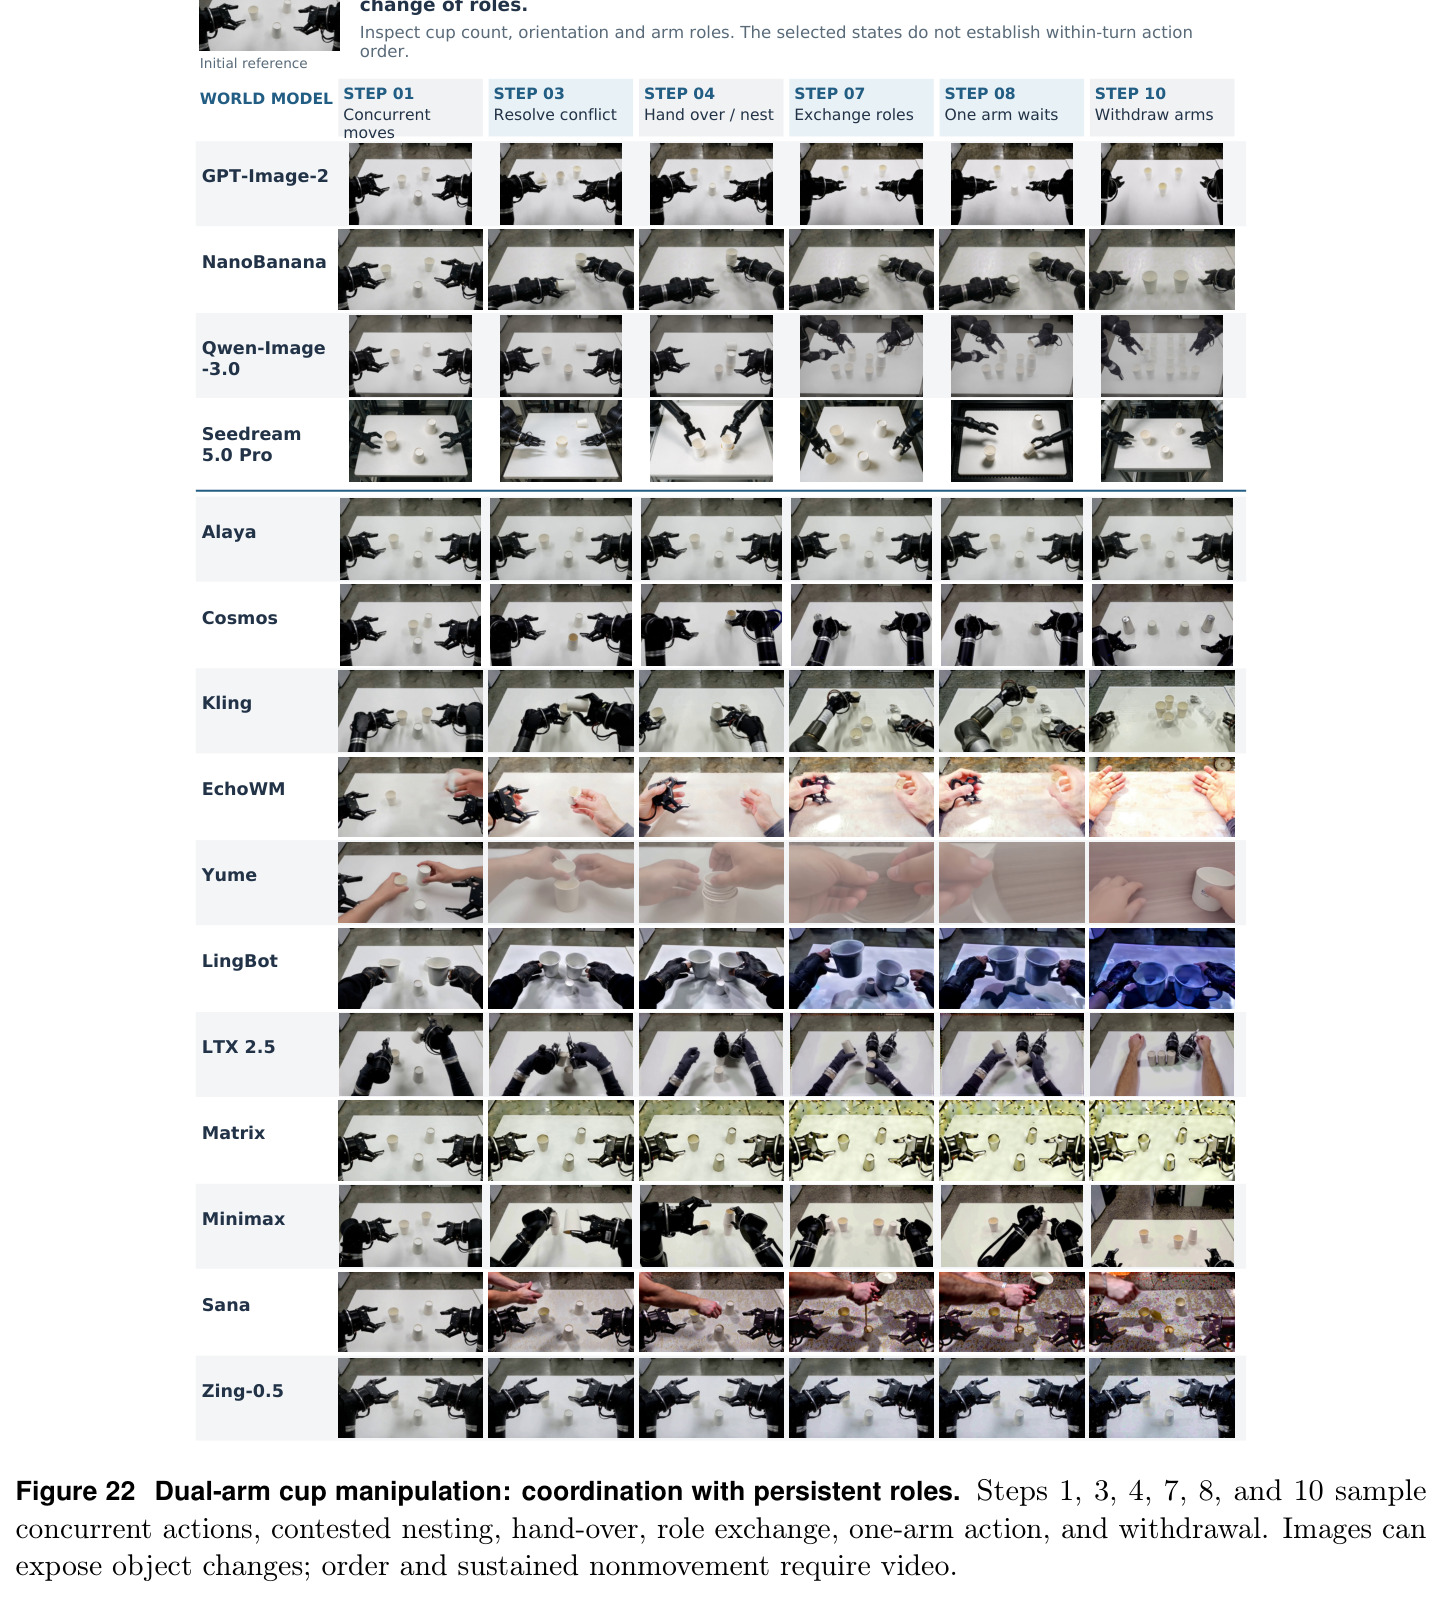
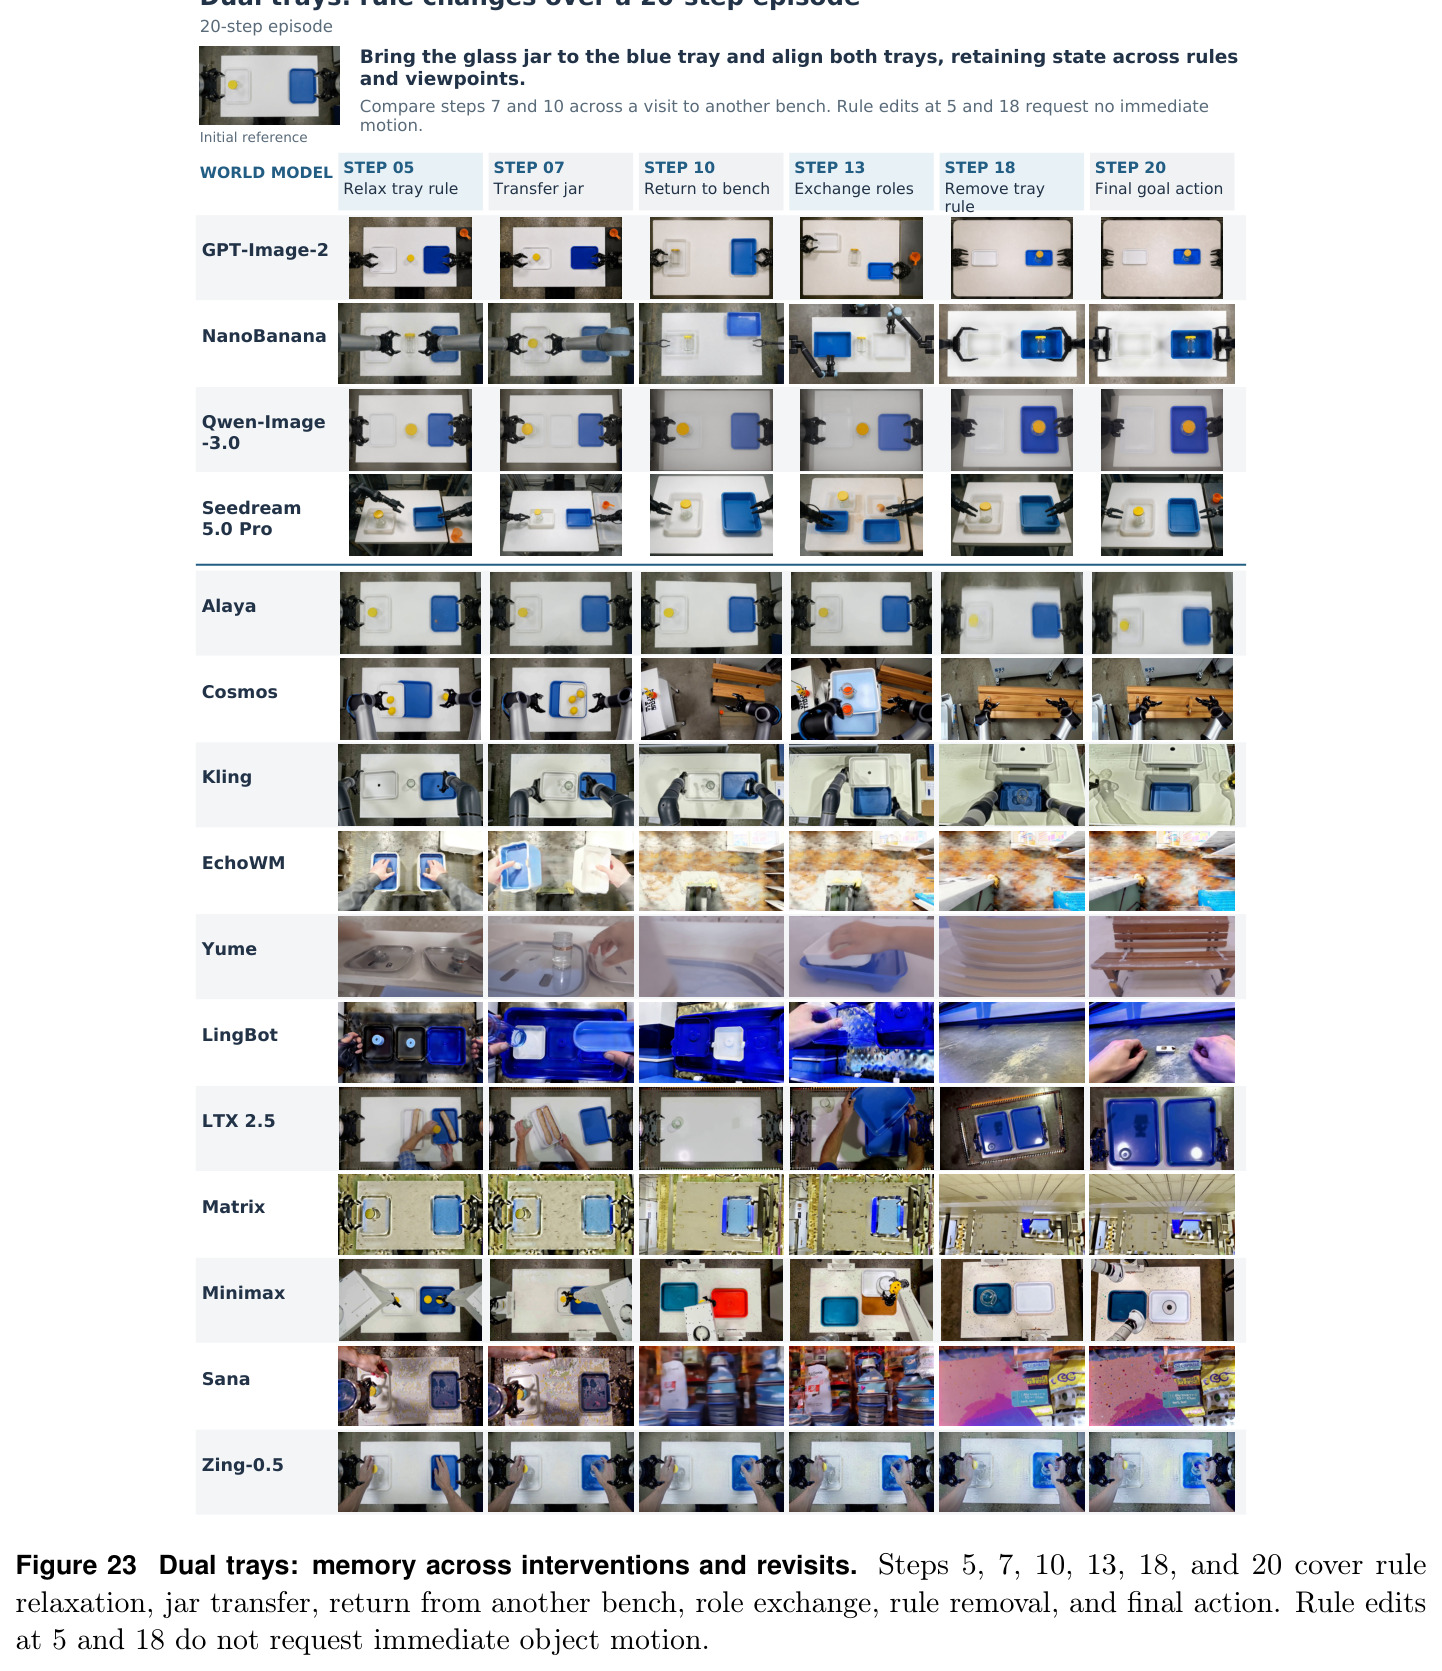
Agent 赛道:GPT 6 Astra 以 Index 31.3 居首,其后为 GPT 5.6 Sol(20.7)、Gemini 3.6 Flash(20.1)、Qwen 3.8 Max(20.0)、Kimi K3(19.8)、DeepSeek V4.1 Flash(18.3);Astra 领先 9 个类目,DeepSeek 领先 3 个(含水资源/土壤/气候治理 43.9),Sol 领先 2 个,Seed 2.1 Pro 领先 1 个(协调与策略交互 50.6)。类目间极不均衡:操作(全场最高 9.5)、动作排序(11.2)、桌面应用(5.6)远低于网页(29.6)、移动应用(42.9)、游戏(47.1)。等域加权下 DeepSeek 从第 6 升至第 2(23.16)、Kimi 从第 5 升至第 4,Astra 仍第一(32.48),说明排名对任务构成高度敏感。科学域内部 Astra 以案例加权 50.6 居首(数学与计算 60.8、物理科学 52.2),DeepSeek 44.0(生命科学 53.7)、Sol 42.2(健康医学 45.4)。40 个新增 SWE/ToolChoice 项上,SWE 严格通过 Astra 14/30 最高(Sol 10/30),ToolChoice 全场最差仅 1–2/10。试点耦合运行(GPT-5.6 Sol × Seedance 2.5,150 例)任务成功率 0%。WM 赛道:GPT-Image-2 以全覆盖 Overall 21.7 居首,Qwen-Image-3.0 21.1、NanoBanana 19.5;Seedance 2.5 六场景均值 18.7(不进入全覆盖排名)。场景剖面分化剧烈:MiniMax H3 具身 53.8 全场最高(次高 Kling 51.2)但网页仅 3.7、游戏 8.5;数字场景普遍低迷——网页 ≤16.5、游戏 ≤13.3。敏感性计算表明若具身权重超过约 22.9%(其余七场景均分剩余权重),MiniMax H3 将反超 GPT-Image-2。案例分析揭示三类典型 Agent 失败:导航可行性判断正确但路径含不存在的边(Gemini 保存预测中 HM3D00002 的边 6–7、MP3D00003 的边 45–40);移动应用亮度任务声称调到最大但验证器记录 183/255;Go 棋提交的 SGF 用 163 次 pass 加一次 setup 摆 154 子替代真实 168 手对局,得 0 分。WM 侧典型失败:双托盘案例 MiniMax H3 在第 10 步凭空引入红色托盘而 GPT-Image-2 保住原白蓝托盘;杯操控案例 Qwen-Image-3.0 凭空加杯而 MiniMax H3 在第 10 步保住三只杯;扫雷案例 LingBot 把整个棋盘换成另一张图;摆锤案例 Alaya 最终帧不再显示原始装置。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Agent 总评 Index(15 类目、1,088 项、条目数加权) | 加权平均分(0–100) | GPT 6 Astra:31.3 | GPT 5.6 Sol 20.7(第二名) | +10.6 分,高出约 51% |
| Agent 等域加权敏感性排名 | 四域等权 Index | Astra 32.48 仍居第一 | DeepSeek V4.1 Flash 23.16 从第 6 升至第 2 | 揭示条目数加权使 DeepSeek 被低估 |
| WM 总评 Overall(15 个全覆盖配置) | 八场景等权均值(0–100) | GPT-Image-2:21.7 | Qwen-Image-3.0 21.1(第二名) | +0.6 分 |
| 耦合试点(GPT-5.6 Sol × Seedance 2.5,150 例) | 任务成功率(%) | 0% | 无历史基线(首个 MA–WM 耦合协议) | —(动机性结果) |
| WM 具身(Embodiment) | 场景得分(0–100) | MiniMax H3:53.8(全场最高) | GPT-Image-2 20.9;Kling 51.2(部分覆盖) | +32.9 分,但其 Overall 反而更低(17.3 vs 21.7) |
| WM 网页交互 | 场景得分(0–100) | GPT-Image-2:16.5(全场最高) | 其余 15 个配置全部 ≤13.3 | 全场绝对值仍低于 17,数字域普遍薄弱 |
| SWE-bench 严格修复(swe-public-30) | 严格通过数 /30 | GPT 6 Astra:14 | GPT 5.6 Sol 10(次高);Kimi/Seed 0 | +4 |
| ToolChoice 工具决策检查点 | 严格通过数 /10 | 多数配置 2,最高亦仅 2 | 无模型超过 2/10 | 暴露工具决策为普遍短板(且 6 个检查点提示词缺 task_id) |
| 试点 World State Consistency | 支持检查占比(%,十场景等权) | 26.6% | 单场景最高 39.5(科学实验)、最低 12.7(Minecraft) | — |
| 试点 Agent Corrective Response | 两次动作内针对性响应占比(%) | 9.2% | 五场景为 0.0% | — |
局限与改进
作者承认大量限制:榜单是无重复运行不确定性估计的描述性点分,差异不构成统计显著;原始类目均值只有一位小数,派生聚合保留该精度上限;执行设置未完全匹配——SWE 任务用 Claude Code 2.1.240 harness、扩展的四配置用原生 Codex 或 API 执行,上下文/工具/预算不一,故为“模型-harness 配置”比较;6 个 ToolChoice 检查点(v01/v03/v05/v06/v08/v10)提示词遗漏 task_id,其失败不能全归咎于工具选择;Astra 的 Borden 原始分 100.493 超过 100 的原因未解决;Seed 2.1 Pro 全部 30 次 SWE 运行“只思考不调用任务工具”、Kimi 26 次工具执行中断,这些仍被计分;本地 SWE 集合缺上游实例 ID,转移档案截断使部分端点未经独立核验。我自己的观察:两条赛道用完全不同的案例,“双重考试”无法回答“组件分如何预测耦合成功”这一核心问题,论文也坦承这点;WM 案例仅 6 个面板且取自历史批次(Seedream 5.0 Pro、2026 年 9 月 Kling 重跑等,未必匹配榜单设置),只能做定性说明而无法估计错误频率;50 案例/场景对 16 个配置的统计功效有限;单一 Overall 标量在场景混合敏感性(22.9% 阈值即可反转排名)面前实用价值存疑;试点的排除计数与运行时版本记录“不可得”,削弱了 0% 这一关键数字的可审计性。
独立分析的弱点
弱点一:组件分与耦合表现的预测效度未验证——即使知道 Astra Index 31.3 与 GPT-Image-2 Overall 21.7,也无法回答两者配对的成败率;改进方向是作者建议的 matched pairing 研究(相同目标、初始化、预算、失败记账,加组件对照)。弱点二:WM 赛道的静态帧证据有本质缺陷——无法验证振荡周期、响应时序、回合内并发与“持续不动”,视频模型与图像模型的跨模态比较只是“描述性”;改进是把视频时间证据纳入正式指标而非仅作案例说明。弱点三:Agent 科学域混合二进制与分级得分且 harness 不统一,跨配置可比性弱;改进是统一执行环境并发布逐运行记录(预算、历史、重试、日期)。弱点四:社会域 200 例仅来自 40 个模板(17/11/12 个模板对应三个类目)、SWE 与 ToolChoice 存在父子链接,统计独立性被破坏;应做模板感知的重采样不确定性估计。弱点五:WM Overall 八场景等权掩盖剖面差异(MiniMax H3 具身 53.8 但 Overall 仅 17.3);应按下游 Agent 实际任务分布加权或直接报告剖面。弱点六:Borden/DABIC 裁剪到 [0,100] 是自定义约定,与官方 EdgeBench 规则不一致,跨基准可比性受损;应与原基准作者协调统一归一化。弱点七:数字接口 WM 案例的“有效零分 vs 技术失败”边界依赖人工判断,缺少独立的评分一致性审计(作者承认未报告)。
未来方向
作者提出的方向:(1) 配对评测——在指定任务分布上以匹配的目标/初始化/预算/失败会计评估 Agent–WM 组合,并设组件对照,检验组件分对耦合成功的预测力;(2) 把“修复”与“响应”分开计——修复主张需要后续证据表明差异已解决且先前有效状态与任务约束保持,重试、反思文本或记忆本身不算恢复;(3) 协同进化训练实验——联合更新、仅 Agent 更新、仅 WM 更新、不更新四组对照,在新留出任务上跨轮次与种子测量组件与耦合表现。基于本文成果可延伸的:(4) 将 WM 案例扩展为视频/交互式协议,正式验证时序、振荡周期与回合内并发;(5) 引入 no-op、unchanged-frame、shuffled-intervention 等对照输出做动作敏感验证,并为每个对照预先定义评分目标;(6) 用模板/父子链接感知的重采样给榜单加置信区间与显著性检验;(7) 建立组件分到耦合成功率的映射模型(如在四域分布上加权回归),把“22.9% 阈值”式的敏感性分析推广为系统的配对选择工具;(8) 把 0% 试点中的失败模式(容器替换、状态漂移、指令-观测失配)转成针对性训练信号,检验“考试驱动改进”是否成立。
复现评估
复现难度:中高。论文由 XGEN Labs 组织约 80 位贡献者完成,官方博客在 xgenlabs.ai/research/dual-exam/,但正文未提及公开代码仓库或逐运行原始记录;作者自己承认“原始 Agent 清单缺少统一的每模型预算/历史/重试/日期记录”“转移档案截断”“provider 快照不可得”,第三方完整复现 10 个 Agent 配置加 16 个 WM 配置几乎不可能——需要 GPT 6 Astra、GPT 5.6 Sol、Gemini 3.6 Flash、Seedance 2.5 等多家商业 API 与视频生成服务。可复现的部分:科学域沿用公开基准(ALE 63 任务、SWE-bench 30 任务、EdgeBench 6 任务、10 个 ToolChoice 检查点),执行协议已冻结并有具体参数(ToolChoice 用 11 个工具定义、300 秒超时、高推理档、单次尝试无重试;Edge 预算 43,200 秒);WM 赛道 8 场景 × 50 案例的案例包与 rubric 若随论文发布,可对开源模型(Qwen-Image-3.0 等)独立评测。算力方面主要消耗是 API 调用与视频生成费用,本地实验门槛反而较低;试点协议(每例 ≤20 步、单次尝试)也足以在有限预算内复现量级结论。
论文图表
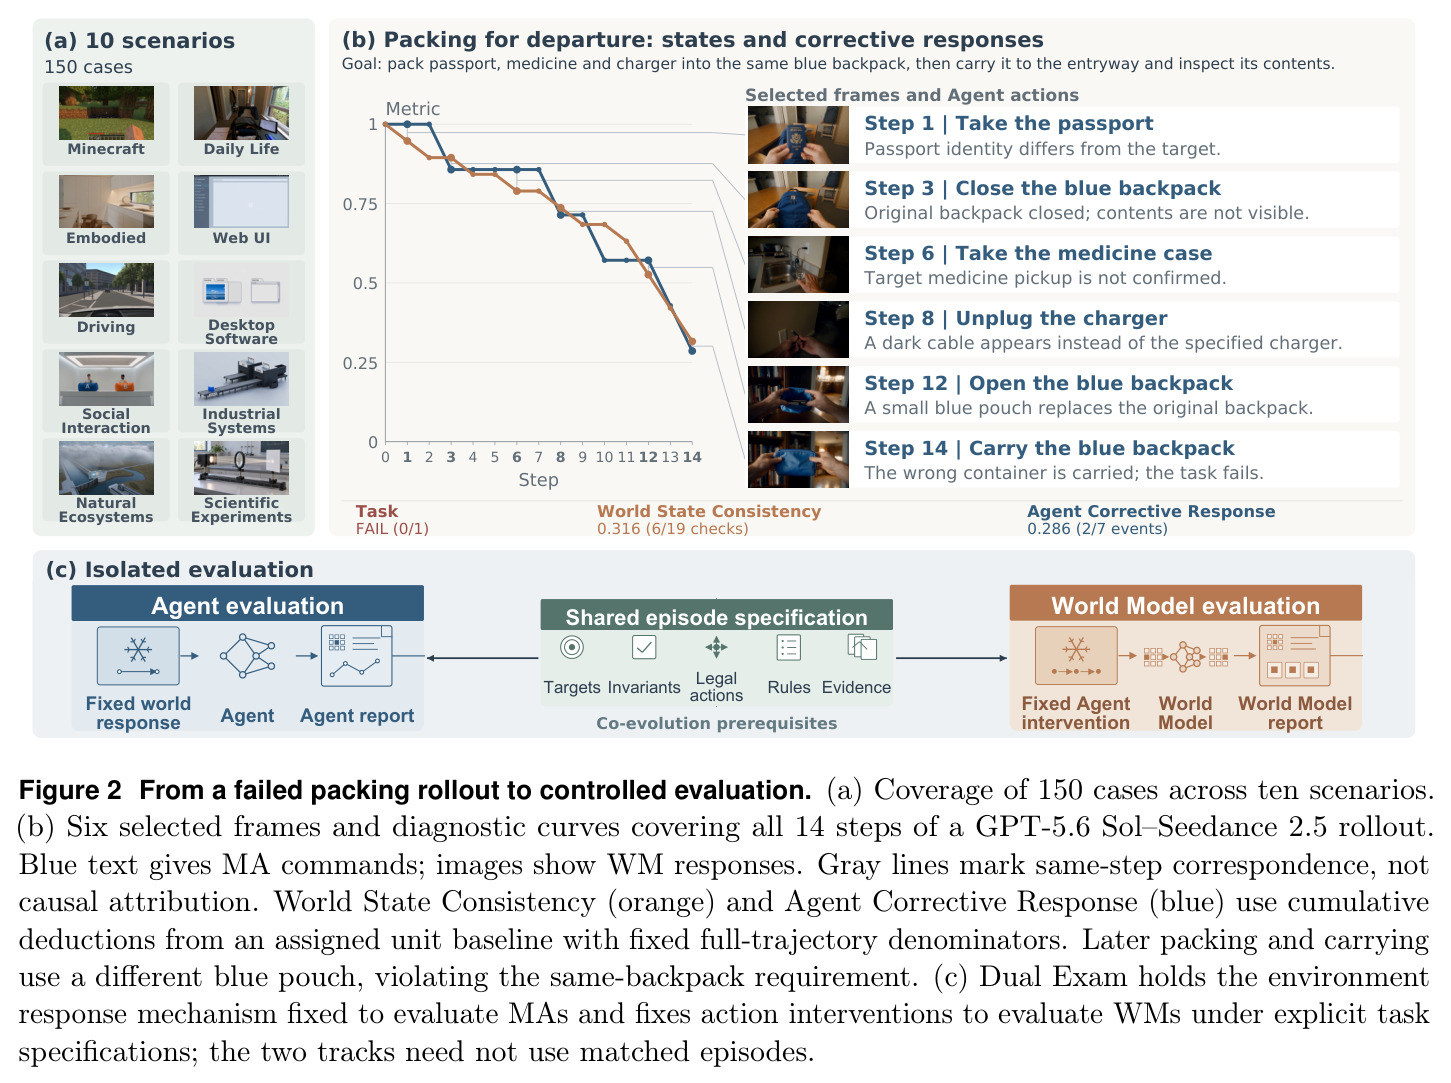
三联图:(a) 试点 150 案例覆盖 10 个场景;(b) GPT-5.6 Sol–Seedance 2.5 打包失败的 6 帧与 14 步诊断曲线(最终状态一致性 0.316=6/19、纠正响应 0.286=2/7),蓝色小包替换原背包导致失败;(c) Dual Exam 的隔离评估示意。
把动机(0% 成功、无法归因)与方法(隔离考试)串在一张图里,是全文叙事的枢纽。
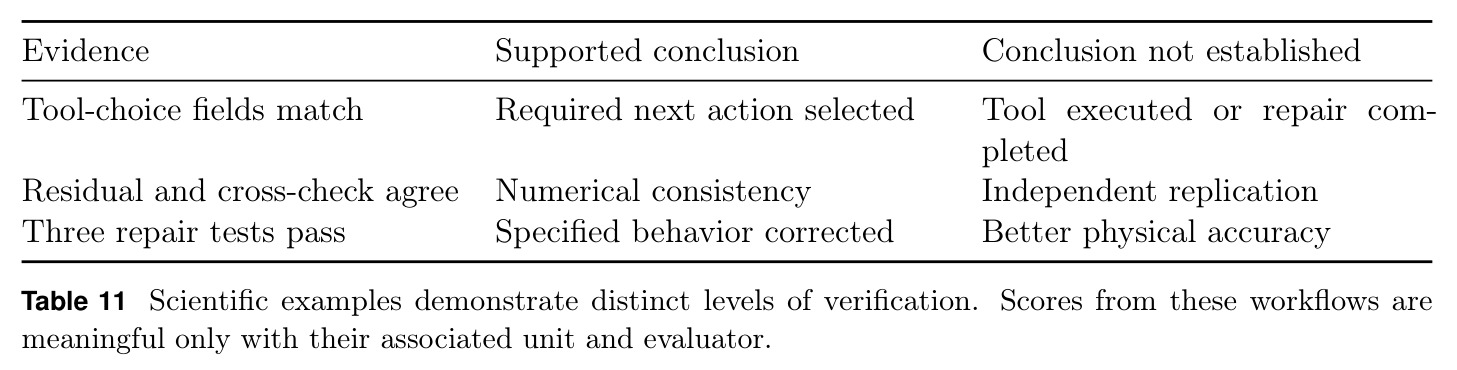
工具决策检查点全流程:任务背景(MACS3 定位到 PeakDetect.py 410–505 行但缺上下文)→ GPT-5.6 Sol 提交的 read_source 调用 → 与严格契约逐字段比对(工具名/路径/起始 410/结束 505/调用次数 1 全部匹配)→ 记录 FULL_PASS、得分 1.0,且声明该调用不被执行。
最能说明“选择≠执行”的科学域证据形态,也是 10 题全场仅 1–2 题通过的难度参考。
十量子比特 Ising 链工作流的 41 步历史轨迹:选精确对角化→依赖修复(Python 3.14.3 失败换 3.10)→不变量自检(基态能量 -12.784906442999320、残差 8.093e-13)→交叉验证(概率误差 <1.14e-4 等,公差 1e-2)→提交 4 个文件得 1.0。
展示科学域高分案例的完整证据链(方法选择、错误恢复、数值验证),以及“共享辅助代码非独立复现”的边界。
DFT 修复任务:定位被忽略的 omega 参数→测试 PySCF 解析器的分号形式→修补 pbe_xc 工厂并校验非法值→最终 omega 0.6713708021 生效、能量变化 -0.34018629 Hartree,外部验证器 3/3 测试通过、reward 1。
SWE 严格修复(Astra 14/30 最高)的代表性成功轨迹,说明“通过测试≠物理精度提升”。