FilmFlow:面向3D虚拟电影摄影的多智能体运镜系统 FilmFlow: Agentic System for 3D Virtual Film Cinematography
多智能体框架把文字指令或参考视频转化为动态3D场景中可执行的电影级相机轨迹
前置知识
多智能体系统(Multi-Agent System)
把复杂任务拆分给多个由大语言模型驱动的专职智能体,每个智能体有自己的角色指令、结构化输入输出接口(如 JSON)和可调用的工具(如渲染器),通过协作与反馈完成整体目标。典型机制包括 ReAct 的推理-行动交替、Reflexion 的语言化反馈改进,以及 in-context learning 用示范约束行为。
FilmFlow 由 Interpreter、Scout、Director、Critic 四个智能体组成,理解角色分工、结构化接口(相机计划以 JSON 返回)与反馈闭环,是读懂整个系统架构的前提。
电影运镜术语
影视摄影的一组标准相机操作:Dolly(推轨进退)、Truck(横移)、Pedestal(垂直升降)、Orbit(环绕)、Pan/Tilt(摇镜)、Zoom(变焦)、Roll(滚转),以及构图锁定(Screen Position Lock)、跟焦(Focus Pull/Focus Follow)、手持抖动(Handheld)等,分别对应相机位置、朝向、焦距与景深的变化。
FilmFlow 的 22 个原子操作直接以这些专业术语命名并参数化,指令解析、操作库设计与 Critic 的评估准则都建立在这套运镜语言之上。
相机状态与轨迹表示
三维动画中相机在时刻 $t$ 的完整状态可写作 $c(t)=(p(t),R(t),f(t))$,即位置、旋转姿态与焦距;把状态沿时间逐帧采样并烘焙成 Blender 关键帧,就得到可执行的相机轨迹。高层运镜描述最终都要落到这个逐帧状态序列上。
论文的核心并发组合机制建立在这个状态表示上:位置、朝向、焦距是三个可独立叠加的通道,理解这三个通道才能看懂多个原子操作如何同时控制一台相机。
上下文学习(ICL)与示例检索
不更新模型参数,而是把先前验证成功的案例(输入条件、操作计划、评估反馈)拼进提示词作为示范,引导模型在新任务上模仿其结构。示例通常按关键词相似度(如 Jaccard 相似度 $s(e_j,B)=|K_j\cap K|/|K_j\cup K|$)从示例库中检索选取。
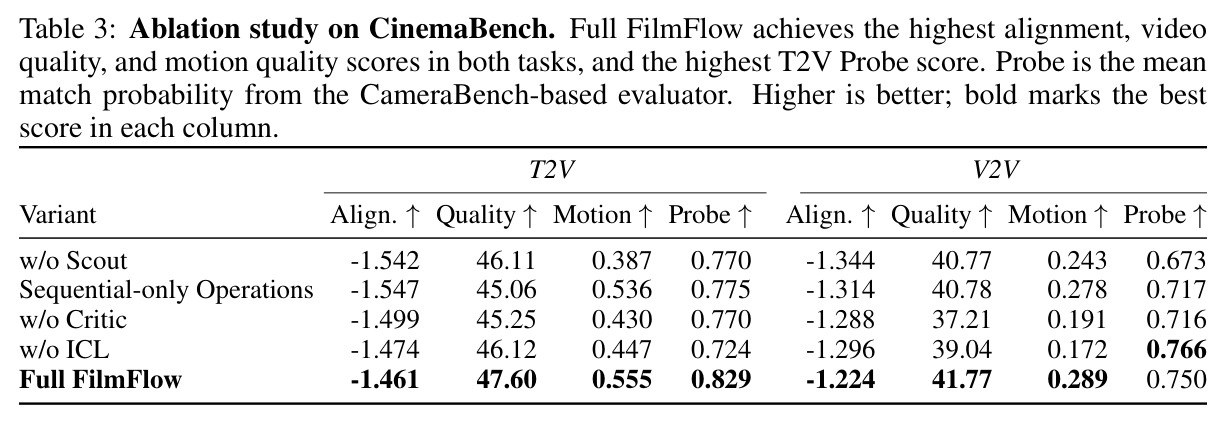
FilmFlow 的 Director 依赖从开发场景构建的示例库检索运镜示范,消融实验显示去掉 ICL 后 T2V Probe 从 0.829 降至 0.724,是理解系统第 3.3 节与案例研究的关键。
视频质量与偏好评估模型
用在大规模人类偏好数据上训练的模型自动给视频打分:VideoReward 评估文本-视频一致性与运动质量;DOVER 综合美学与技术质量;VQAScore 计算一段视频与文字描述匹配的概率;CameraBench 模型则专门识别相机运动原语。
CinemaBench 为避免自家 Critic 给自家打分,全部采用无共享权重与提示的外部评估器,读懂 Table 2/3 的 Align、Quality、Motion、Probe 四列需要知道这些指标的含义与量纲。
研究动机
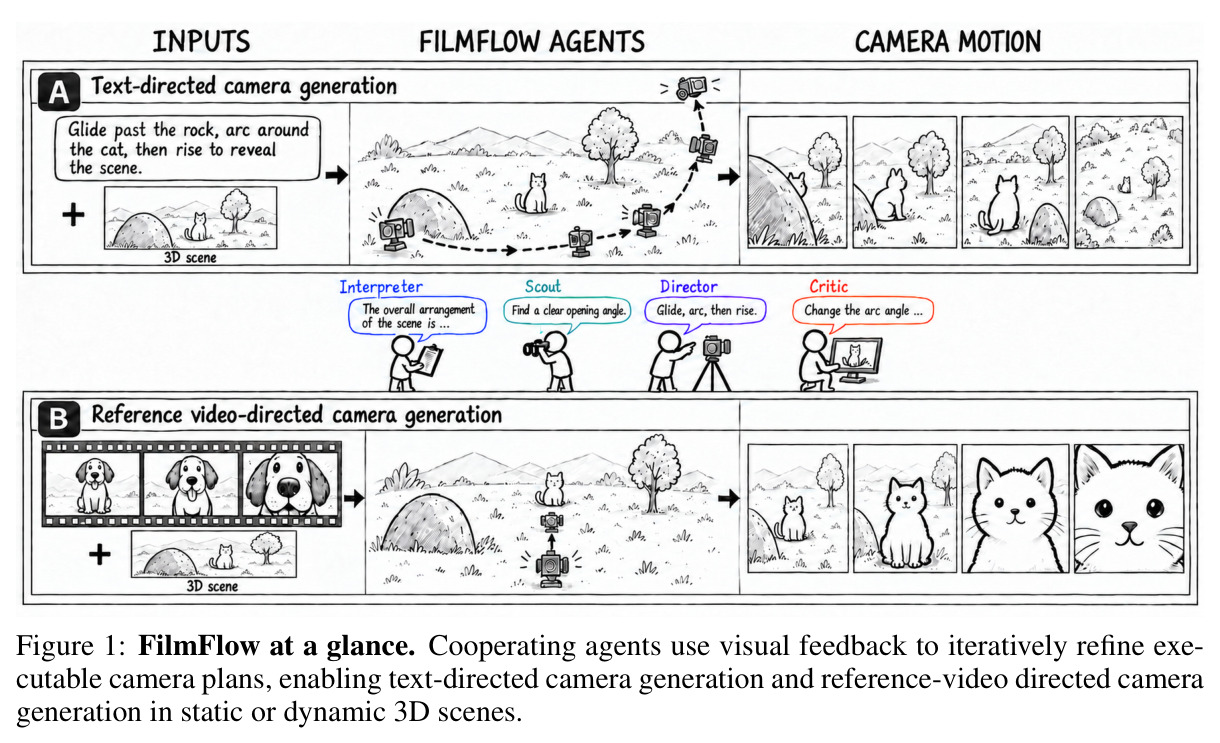
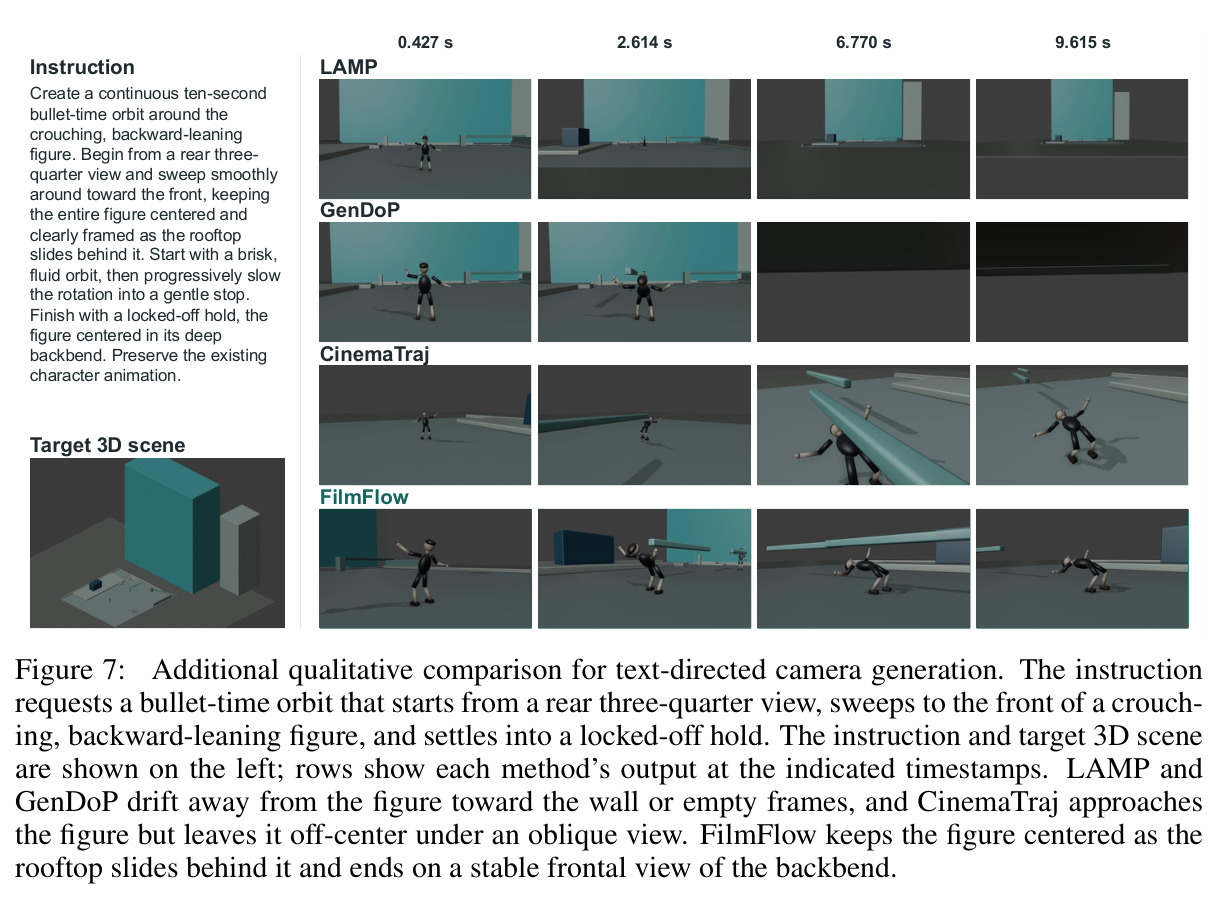
相机运动是影视叙事的核心表达手段:缓慢推近可以放大角色的情绪反应,拉远则能揭示环境并改变一场戏的含义。但要实现这些效果,摄影师需要全程协调相机运动、构图与主体运动,而电影人通常只用自然语言或参考片段表达意图,空间与时间的执行决策都是隐式的。已有自动化摄影工作存在明显短板:CinemaTraj 把原子片段顺序拼接,只在静态场景工作,难以处理运动主体;GenDoP、LAMP 等学习型方法生成的轨迹无法跟踪运动中的角色;ChatCam、FilmAgent 等智能体方法缺乏对并发运镜的显式建模。论文聚焦两个耦合的核心挑战:一是主体持续运动时如何保持预期构图,二是如何协调时间安排各异的并发相机操作——例如镜头要求环绕运动主体的同时上升,并在环绕结束前就开始推近,这需要显式控制操作的重叠与联合作用,而单纯的几何可行性检查无法保证构图与节奏的成败。
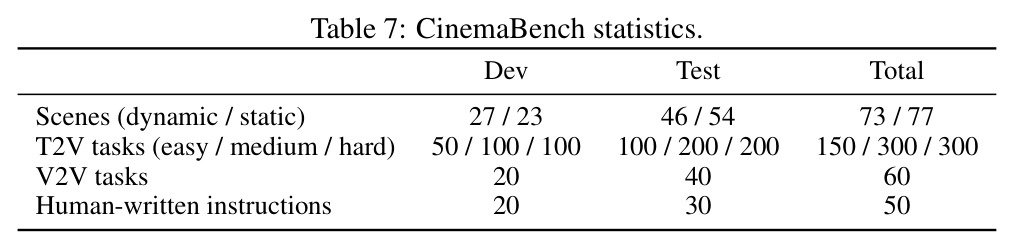
本文的目标是本文的目标是构建一个智能体框架 FilmFlow,在动态 3D 场景中把自然语言指令或参考视频转化为显式、可执行的相机轨迹,并统一支持文本驱动(T2V)与参考视频驱动(V2V)两种生成模态。具体而言,系统需要做到四件事:(1) 把摄影意图落地为结构化相机计划,由带显式参数与时间区间的并发原子操作组成,直接可在 Blender 等引擎中执行;(2) 通过执行渲染结果与视觉反馈的闭环迭代修正计划,让构图、节奏这类只有看到画面才能判断的品质得到保障;(3) 在动态场景中支持主体跟随与多操作的时间协调;(4) 构建公开基准 CinemaBench(150 个 Blender 场景、750 条文本任务、60 条参考视频)系统评测上述两种任务,并采用完全外部的评估协议避免自评自判。
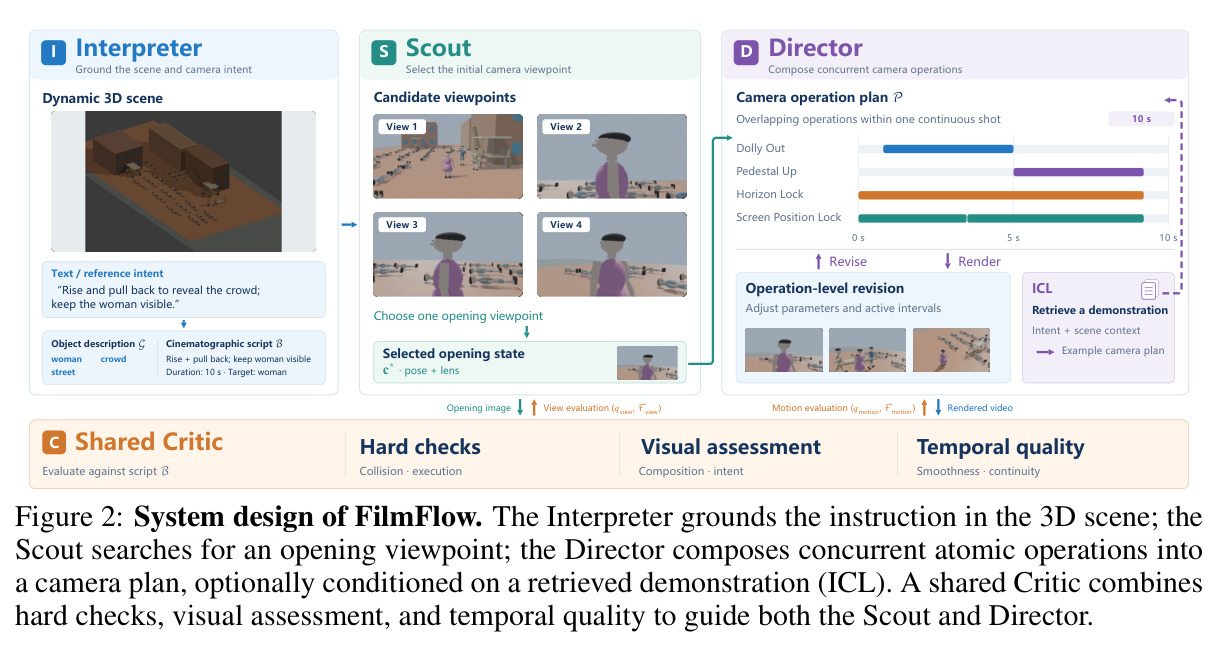
与已有工作不同的是,本文的独特切入有三点。第一,表示层面的创新:不同于 CinemaTraj 的顺序拼接或 LAMP 在单个原语内部组合控制,FilmFlow 把相机计划表示为带显式重叠时间区间的独立参数化原子操作 $o_i=(m_i,\theta_i,[a_i,b_i])$,多个操作可在时间轴上并发地共同控制相机,天然表达「环绕同时上升同时推近」这类意图。第二,把可执行相机计划作为规划、评估与精炼的共享表示:Critic 的视觉反馈被链接到具体操作的参数 $\theta_i$ 与时间区间 $[a_i,b_i]$ 的修改建议上,使「画面不好看」翻译成可执行的修复动作,而非笼统的语言评价。第三,把开场视点选择独立成 Scout 阶段先行完成——因为一个糟糕的开场会约束后续所有操作——再用只含运镜意图关键词的已验证示例库做跨场景的上下文示范(ICL),把「怎么拍」的经验与「拍什么」的场景解耦。
核心方法
FilmFlow 把专业摄影流程「理解意图→选机位→排运镜→看回放改」搬进多智能体系统,渲染结果回流驱动修改。给定输入 $x$(指令或参考视频)与目标场景 $S$:Interpreter 把输入落地到场景,产出对象描述 $G$ 与摄影脚本 $B$;V2V 时附加 LingBot-Map 估计的参考相机位姿作运动线索。Scout 采样候选开场视点渲染,Critic 按指令对齐、主体可读性、构图三项等权评分(阈值 0.70),最多两轮,超预算取最高分为开场 $c^*$。Director 基于固定的 $c^*$ 构造原子操作时间线 $P^{(0)}=A_{\text{Director}}(G,B,c^*)$,执行渲染后 Critic 按六项准则评估(阈值 0.62),反馈指导修改操作、参数与时间区间,最多三轮精炼加两次校验修复。平均每任务约 2.23 分钟、69.5k tokens(gpt-6-astra)。
核心创新是并发原子操作的表示与合成机制。计划定义为 $P=\{o_i\}_{i=1}^N$,$o_i=(m_i,\theta_i,[a_i,b_i])$:$m_i$ 选操作、$\theta_i$ 为参数与目标引用、$[a_i,b_i]$ 为可显式重叠的激活区间。执行时先把每个操作展开为绝对相机状态序列 $\hat{c}_i(t)$,再提取相对变化 $\Delta c_i(t)=\hat{c}_i(t)\ominus\hat{c}_i(t_{\text{ref}_i})$,最后按参数类型逐通道合成 $c(t)=c_{\text{base}}(t)\oplus\Delta c_{i_1}(t)\oplus\cdots\oplus\Delta c_{i_M}(t)$:平移用向量差、角度带符号相加、正值量用比值相乘。本质区别在于:CinemaTraj 等顺序拼接原子段,任一时刻只有一个动作生效;FilmFlow 允许 Orbit、Dolly In、Pedestal Up 在重叠区间同时作用,原生表达「环绕运动主体同时上升、并在环绕结束前开始推近」的复杂调度。
方法步骤详情
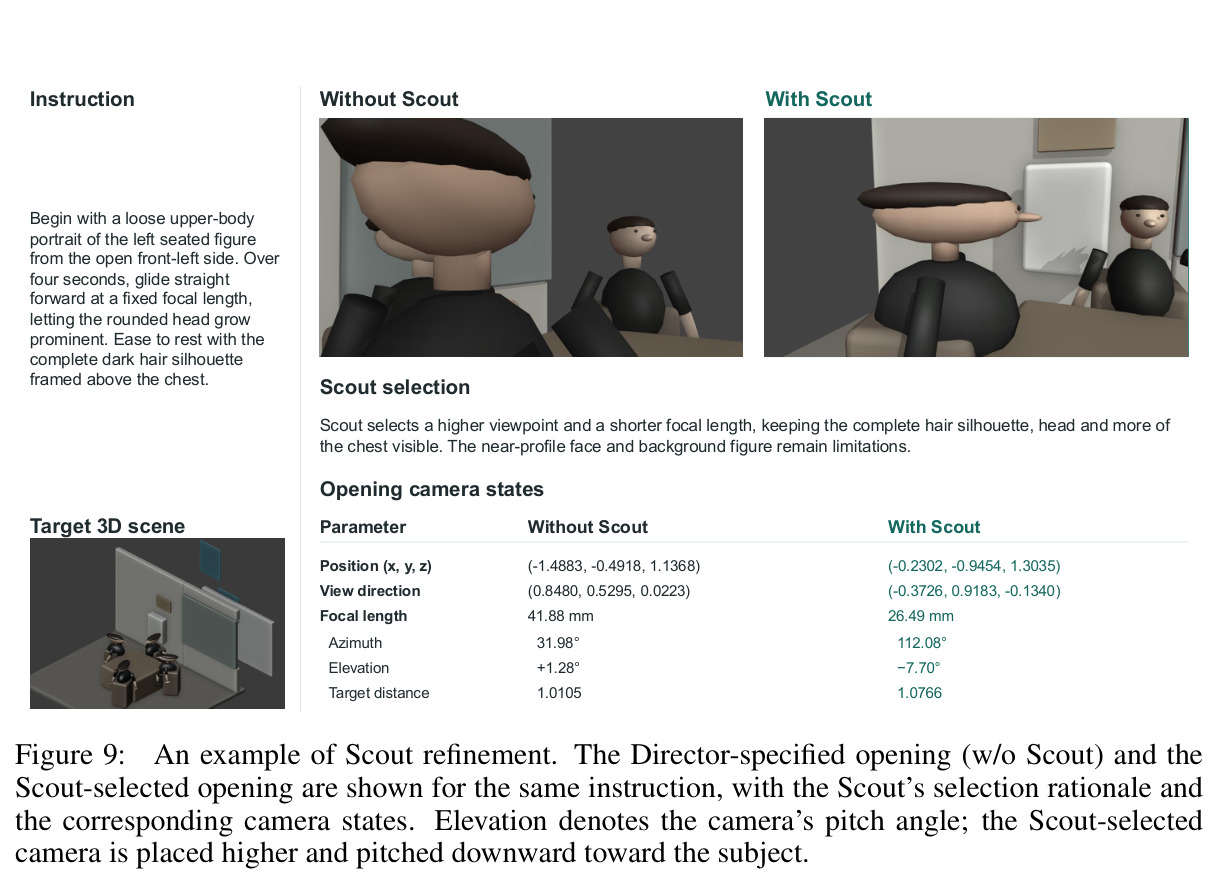
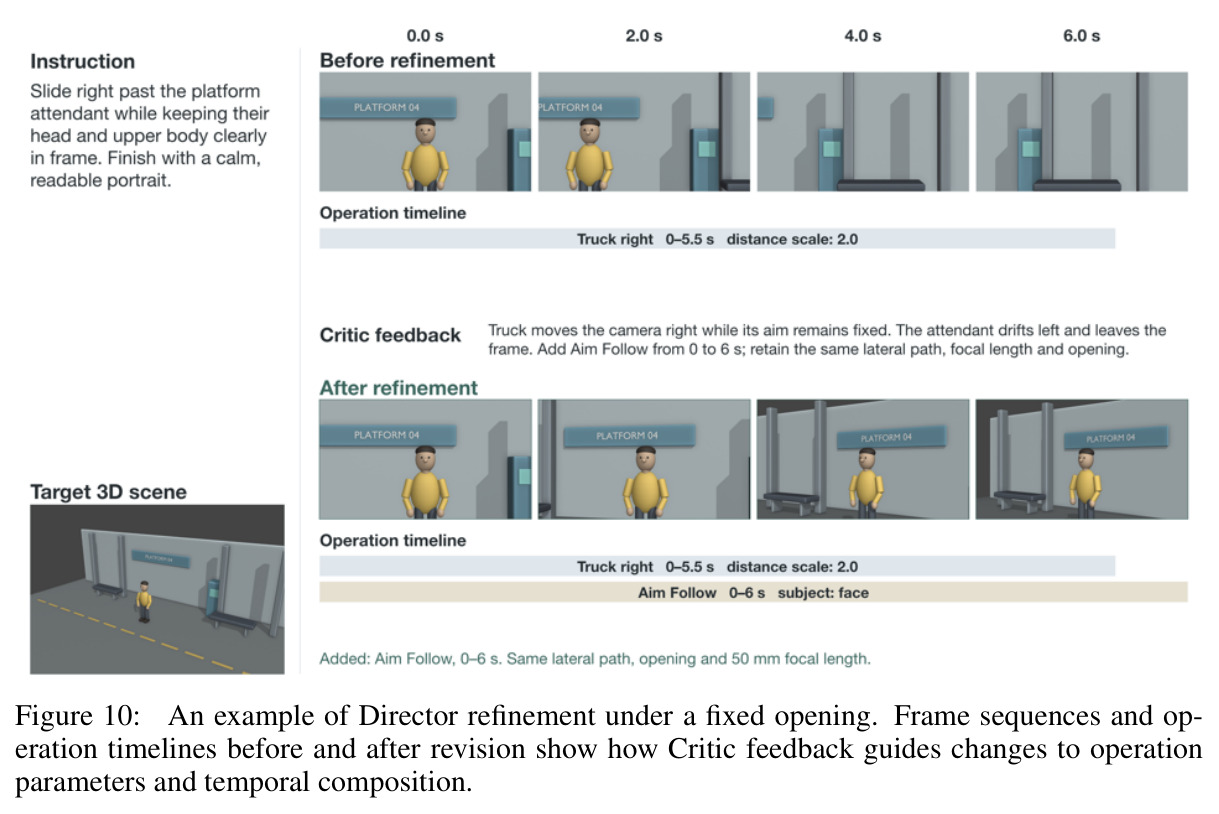
流程分六步。(1) 意图解析:Interpreter 接收指令与场景对象清单,输出 $G$ 与 $B$(对象锚点、时长、检索关键词)。(2) 开场搜索:Scout 每轮最多渲染 6 个候选、至多两轮;Critic 按等权平均 $q_\alpha=\frac{1}{D_\alpha}\sum_{d=1}^{D_\alpha}q_{\alpha,d}$ 打分并给出扰动建议,≥0.70 接受否则取最高分。(3) 计划构造:Director 输出 JSON 时间线,如初始计划含 Screen Position Lock、Zoom、Orbit、Dolly In 四个并发操作。(4) 执行:逐帧合成相机状态并烘焙关键帧渲染。(5) 评估精炼:Critic 先做碰撞与执行有效性硬检查,再对指令对齐、主体可读性、构图、空间叙事、运动连贯、电影质感六维等权打分(阈值 0.62),Director 据此修改 $m_i,\theta_i,[a_i,b_i]$(开场固定),最多三轮。(6) ICL:从开发场景示例库按 Jaccard 相似度检索已验证示范拼入上下文。
技术新颖性
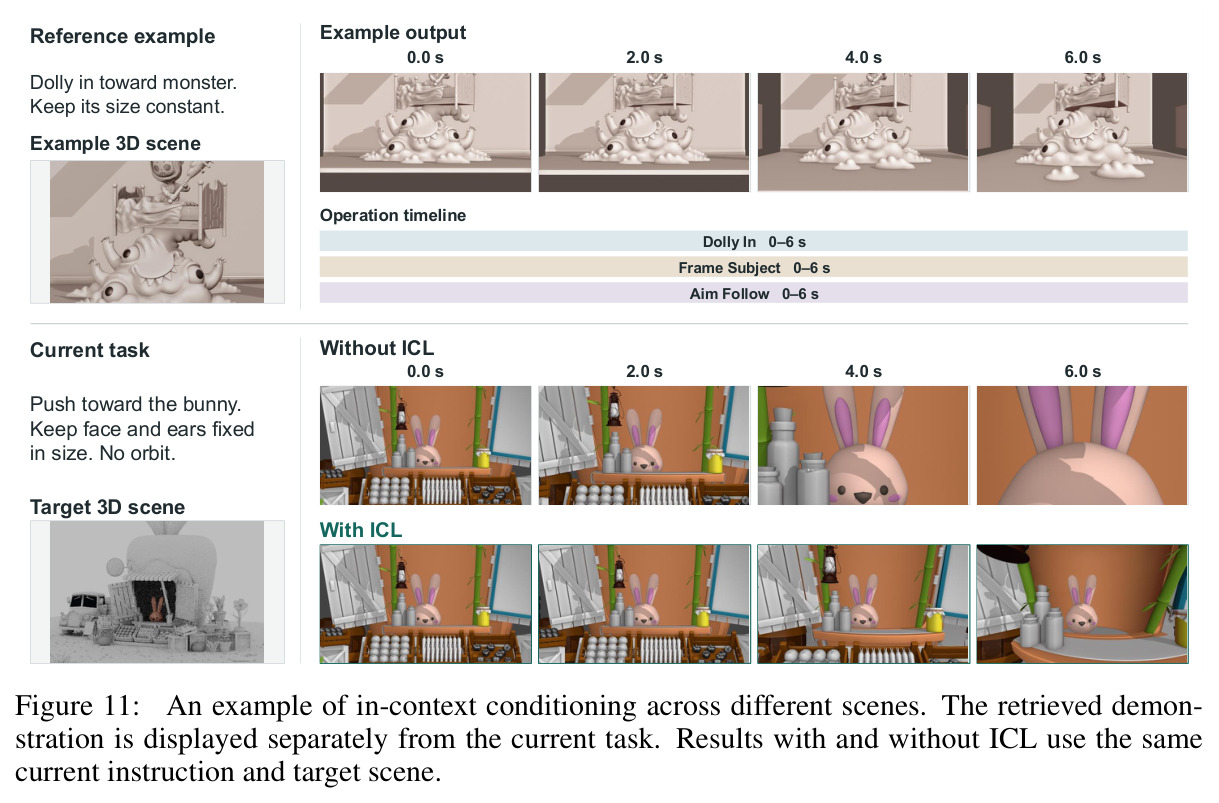
技术新颖性体现在四个层面。第一,并发时间区间的操作表示是最本质的贡献:显式的 $[a_i,b_i]$ 激活区间加上参数类型化的 $\ominus/\oplus$ 合成规则,使「多操作同时控制一台相机」成为可规划、可修改的一等公民,这是顺序拼接方法无法表达的。第二,反馈的可执行性:Critic 输出不仅是分数,还包含 failure_tags 与逐操作诊断(repair_patches),能把「这段读起来像大环绕而非推轨变焦」直接翻译成「把 Orbit 从 120°/9 秒缩到 18°/2.5 秒、把构图锁延长到全程」的计划修改——附录案例显示该修改把 $q_{\text{motion}}$ 从 0.5883 提升到 0.7367。第三,评分以脚本为参照进行相对判定,有意的遮挡或延迟揭示不会被误罚,这是对摄影语义的尊重。第四,ICL 示例关键词只描述运镜意图(如 dolly_zoom_in、stable_subject_size)而不含场景对象身份,使示范可跨场景迁移——附录中「怪兽保持尺寸推进」的示范被成功迁移到完全不同的「兔子」场景,形成 dolly zoom 效果。
实验结果
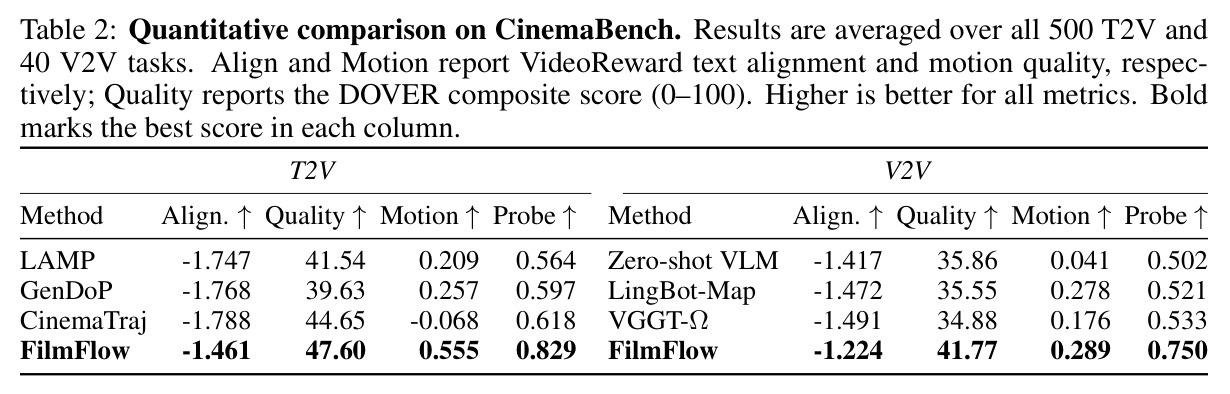
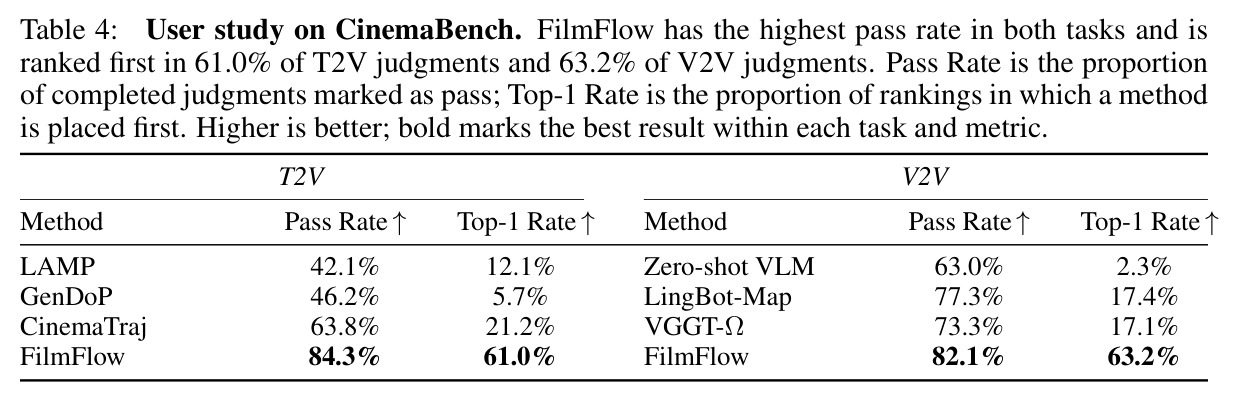
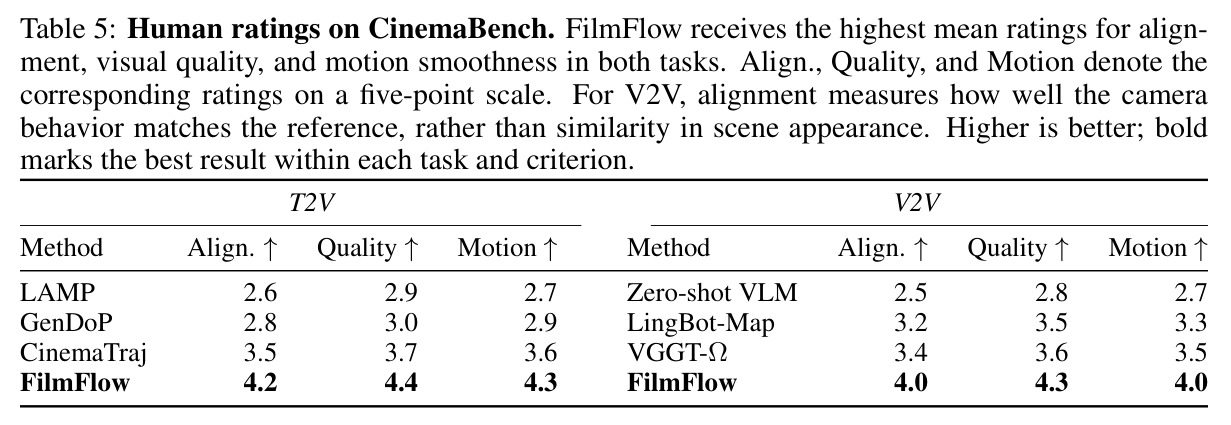
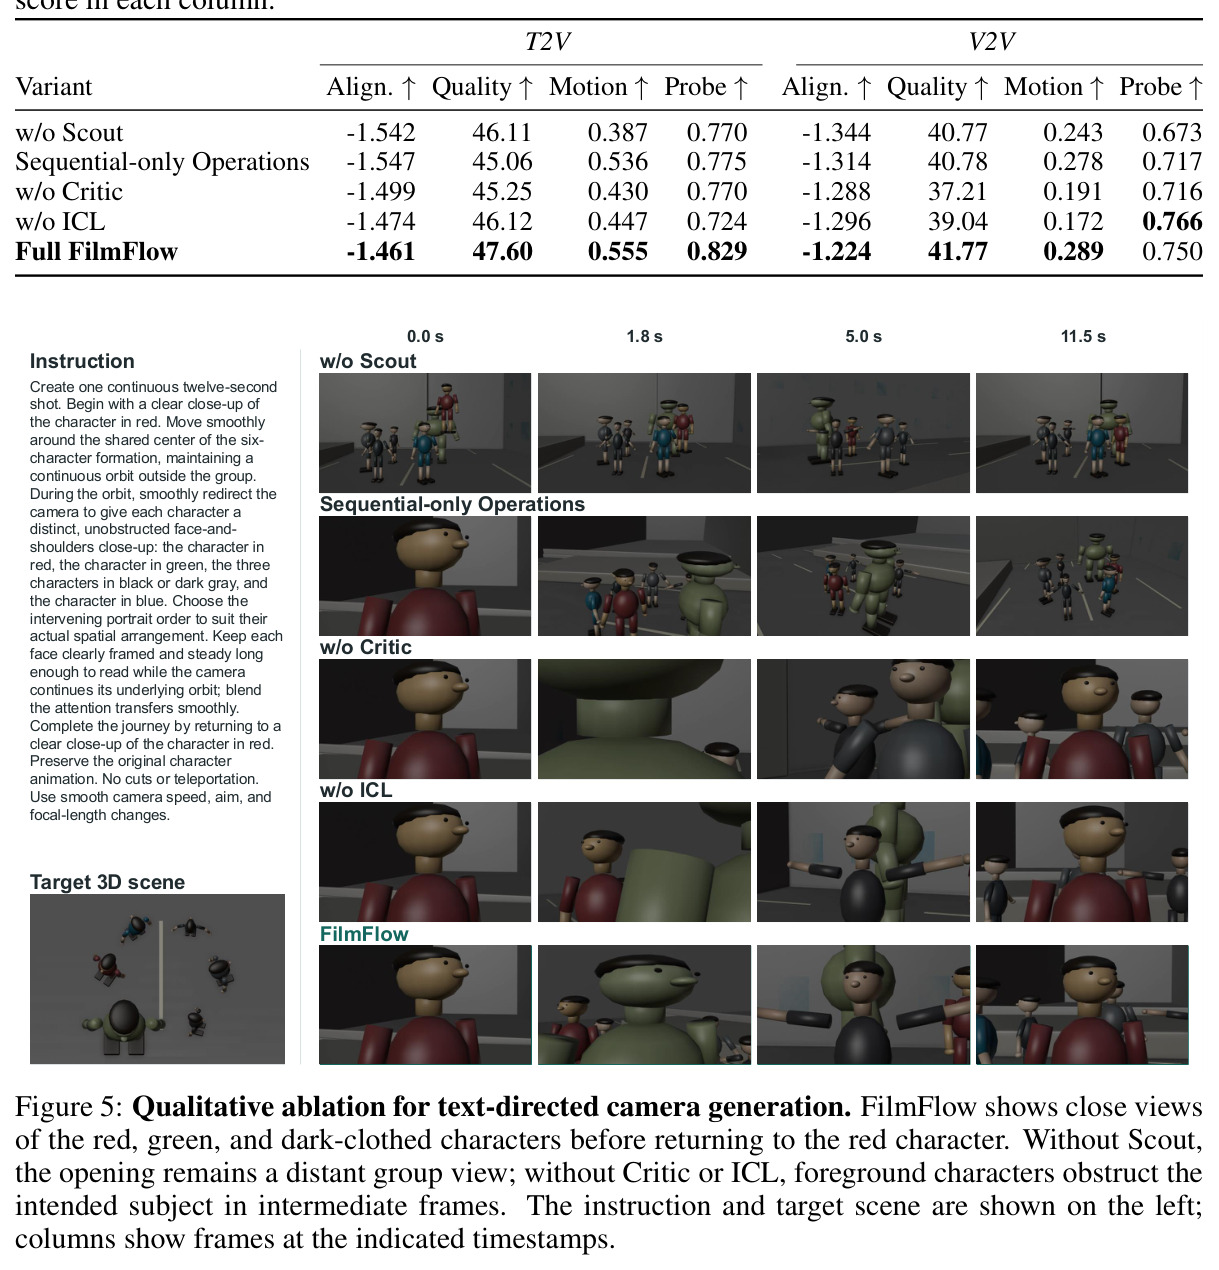
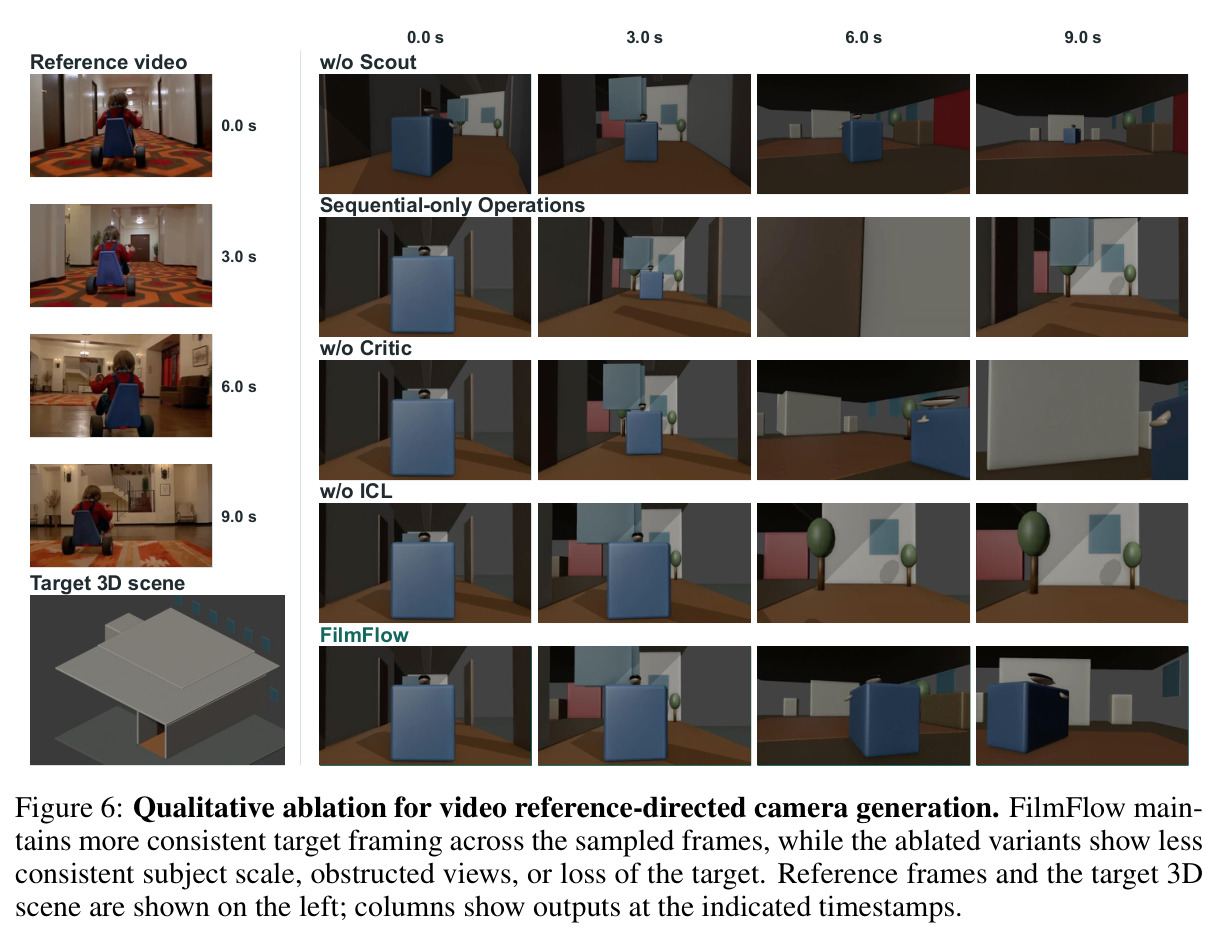
在 CinemaBench 100 个测试场景(500+40 条任务)上 FilmFlow 全面领先。T2V:对齐 -1.461(LAMP -1.747)、DOVER 质量 47.60(CinemaTraj 44.65)、运动 0.555(GenDoP 0.257)。V2V:对齐 -1.224(Zero-shot VLM -1.417)、质量 41.77(VGGT-Ω 34.88)、运动 0.289(LingBot-Map 0.278)。盲测中 T2V 通过率 84.3%(CinemaTraj 63.8%)、Top-1 率 61.0%(21.2%);V2V 通过率 82.1%、Top-1 率 63.2%(基线仅 17.4%)。消融:去并发操作质量 47.60→45.06;去 Critic 运动 0.555→0.430;去 Scout 0.555→0.387;去 ICL Probe 0.829→0.724。成本约 2.23 分钟、69.5k tokens/任务。案例:Director 把 Orbit 从 120°/9 秒缩到 18°/2.5 秒后,得分 0.5883→0.7367。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| T2V 文本-视频对齐 | VideoReward Align ↑ | -1.461 | LAMP:-1.747 | +0.286 |
| T2V 整体视频质量 | DOVER 综合分(0–100)↑ | 47.60 | CinemaTraj:44.65 | +2.95 |
| T2V 运动质量 | VideoReward Motion ↑ | 0.555 | GenDoP:0.257 | +0.298(约 2.2 倍) |
| T2V 相机运动匹配(辅助) | Probe(CameraBench+VQAScore)↑ | 0.829 | CinemaTraj:0.618 | +0.211 |
| V2V 与参考运动描述对齐 | VideoReward Align ↑ | -1.224 | Zero-shot VLM:-1.417 | +0.193 |
| V2V 整体视频质量 | DOVER 综合分(0–100)↑ | 41.77 | VGGT-Ω:34.88 | +6.89 |
| V2V 运动质量 | VideoReward Motion ↑ | 0.289 | LingBot-Map:0.278 | +0.011 |
| V2V 相机运动匹配(辅助) | Probe ↑ | 0.750 | VGGT-Ω:0.533 | +0.217 |
| T2V 人工通过率(420 份排名) | Pass Rate ↑ | 84.3% | CinemaTraj:63.8% | +20.5 个百分点 |
| T2V 人工排名第一比例 | Top-1 Rate ↑ | 61.0% | CinemaTraj:21.2% | +39.8 个百分点 |
| V2V 人工通过率(397 份排名) | Pass Rate ↑ | 82.1% | LingBot-Map:77.3% | +4.8 个百分点 |
| V2V 人工排名第一比例 | Top-1 Rate ↑ | 63.2% | LingBot-Map:17.4% | +45.8 个百分点 |
局限与改进
作者承认的局限:(1) 消融中 V2V Probe 是唯一完整版未夺冠的列(w/o ICL 0.766 对 0.750),间接说明 ICL 增益并不均衡;(2) Critic 验收不等于完美执行——dolly zoom 案例通过后仍残留分隔带与躯干重叠、结尾定格主体漂移两处缺陷,阈值 0.62/0.70 只是及格线;(3) V2V 中 LingBot-Map 估计的相对位姿无度量尺度,只能作运动线索。我自己的观察:(4) 系统绑定 gpt-6-astra 前沿闭源模型,每任务 2.23 分钟、69.5k tokens,批量生产或交互式调整都偏贵;(5) 评估虽全部外部化,VideoReward/DOVER 等奖励模型可能更敏感于渲染画质而非摄影语义,「指令对齐」的度量仍偏代理,作者自己也只从 Probe 读趋势不下结论;(6) 22 个原子操作未覆盖变速运镜、焦点呼吸、风格化镜头抖动等更细的摄影语言;(7) CinemaBench 仅 150 个场景、指令 700/750 由 gpt-6-astra 生成,多样性受限;用户研究 42 人、420/397 份完整排名,统计功效中等。
独立分析的弱点
独立分析的弱点与改进方向:(1) 闭环精炼必须「渲染—评分—再渲染」,Critic 每轮最多看 10 帧,最多三轮精炼加两轮开场搜索,时间与 token 开销随迭代线性增长;可训练轻量代理评估器(直接从轨迹参数预测 Critic 分数)做候选预筛,只对顶部候选完整渲染。(2) 开场 $c^*$ 在运动精炼期间固定,案例中两轮搜索后 0.68 分的开场只能「临时接受」,若开场本质错误则后续全部受限;可引入回溯机制,运动精炼持续失败时重新开放开场搜索。(3) 分数与布尔判断不一致(案例中 accept=true 但均分 0.5883 低于阈值 0.62),暴露 VLM 打分缺乏校准;可改用成对比较或校准后的序数评分。(4) $\ominus/\oplus$ 的通道合成规则是人工设计的,扩展新操作需手工定义相对量类型与叠加次序,库的规模化受工程约束;可为每类参数声明可组合的代数结构,自动推导合成规则。(5) 框架只处理单镜头(continuous shot),多镜头的景别衔接、180° 轴线规则与剪辑节奏都不在范围内;可在 Director 之上增加镜头序列层统一调度。
未来方向
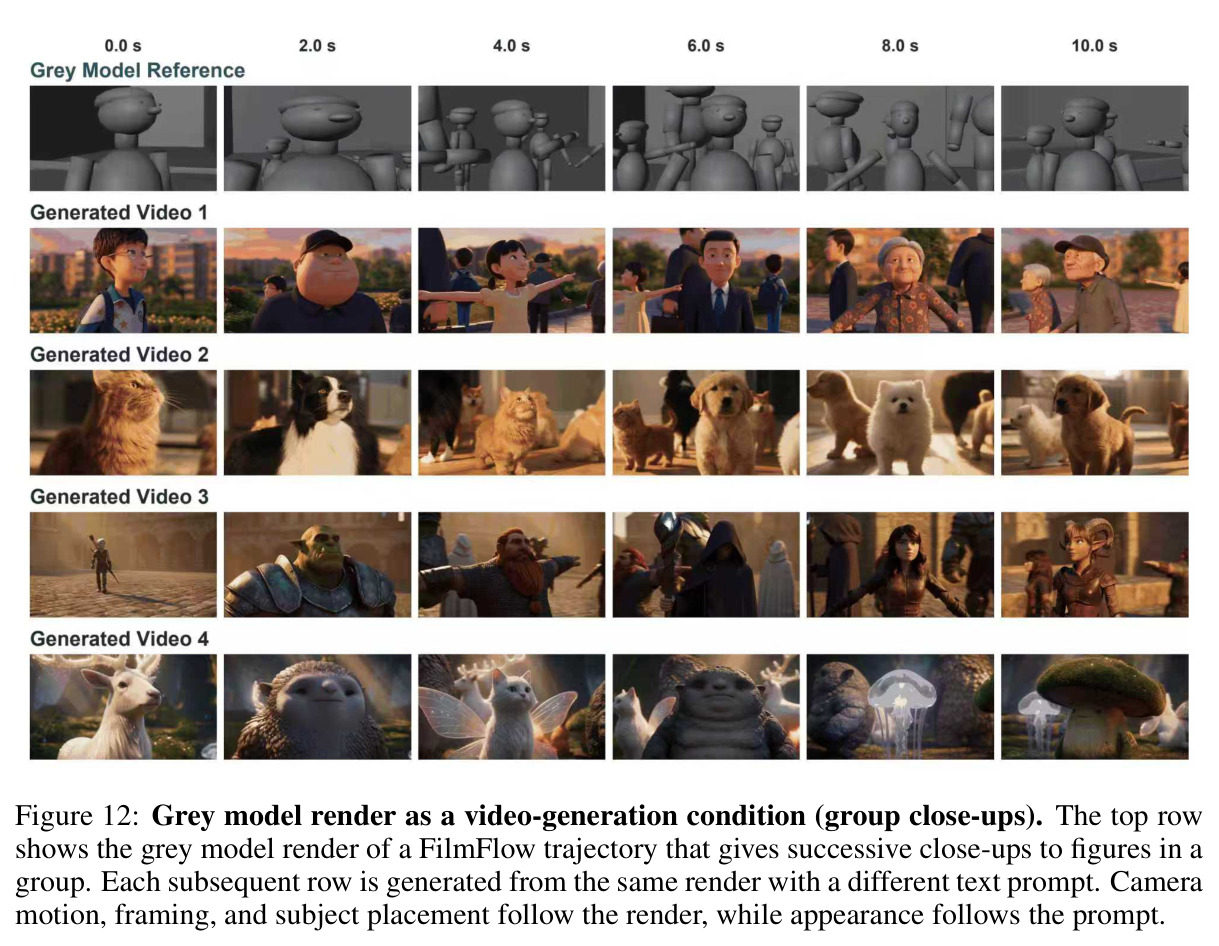
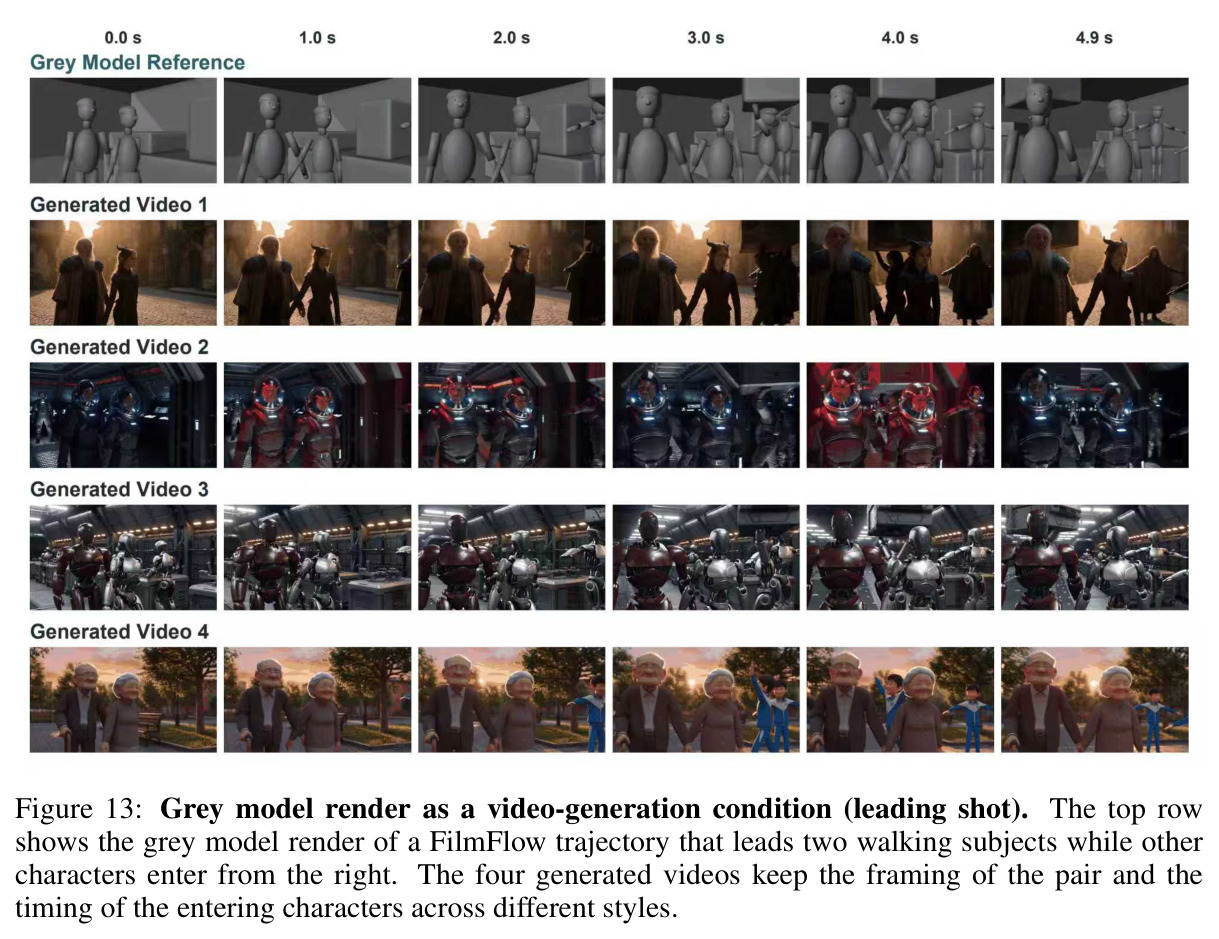
作者在结论中明确提出两个方向:(1) 探索通过任务特定微调让更小的模型达到相当性能,摆脱对前沿通用模型的依赖;(2) 将 FilmFlow 扩展为联合自动化场景构建与相机规划。基于本文成果还可延伸:(3) 附录 G 已展示灰模渲染可直接作为 Seedance 等视频生成模型的结构条件,一条相机计划可跨多种视觉风格复用,这提示 FilmFlow 可以成为生成式电影制作的上游相机规划器,把可执行轨迹与扩散视频生成打通成端到端管线;(4) 把 ICL 示例库升级为可学习的技能库——例如对高分计划做聚类蒸馏,或以 Critic 分数为奖励用强化学习直接优化 Director 的规划策略;(5) 支持多镜头叙事:加入景别衔接、轴线约束与剪辑点规划,从单镜头摄影指导走向完整的虚拟摄影指导;(6) 结合实时渲染引擎做交互式预览,让导演在环内以自然语言迭代微调运镜,把 2.23 分钟的离线管线压缩到秒级反馈。
复现评估
复现条件中等偏友好。作者在可复现性声明中承诺公开 FilmFlow 实现、CinemaBench 标注以及获取场景资产的说明;受版权限制无法再分发的资产将被排除并提供来源链接与获取指引。有利因素:基准由 Blender 场景构成(150 个,73 动态/77 静态,按场景划分为 50 开发/100 测试),执行与渲染不依赖特殊硬件;评估全部使用现成外部工具(VideoReward、DOVER、CameraBench 的 Probe、VQAScore),协议对所有方法一致。不利因素:所有智能体使用 gpt-6-astra(闭源 API),复现数字依赖该模型或近似替代品;算力开销以 API 计——平均每任务 2.23 分钟、69.5k tokens(65.9k 输入/3.7k 输出、6.23 次调用),完整跑 500 条 T2V 约需 18.5 小时与约 3500 万 tokens 量级;V2V 基线还依赖 LingBot-Map 与 VGGT-Ω 的重建质量。综合看:跑通系统不难,逐位复现表格数字存在一定不确定性;用户研究部分(42 名参与者)需重新组织人力,难以直接复现。
论文图表
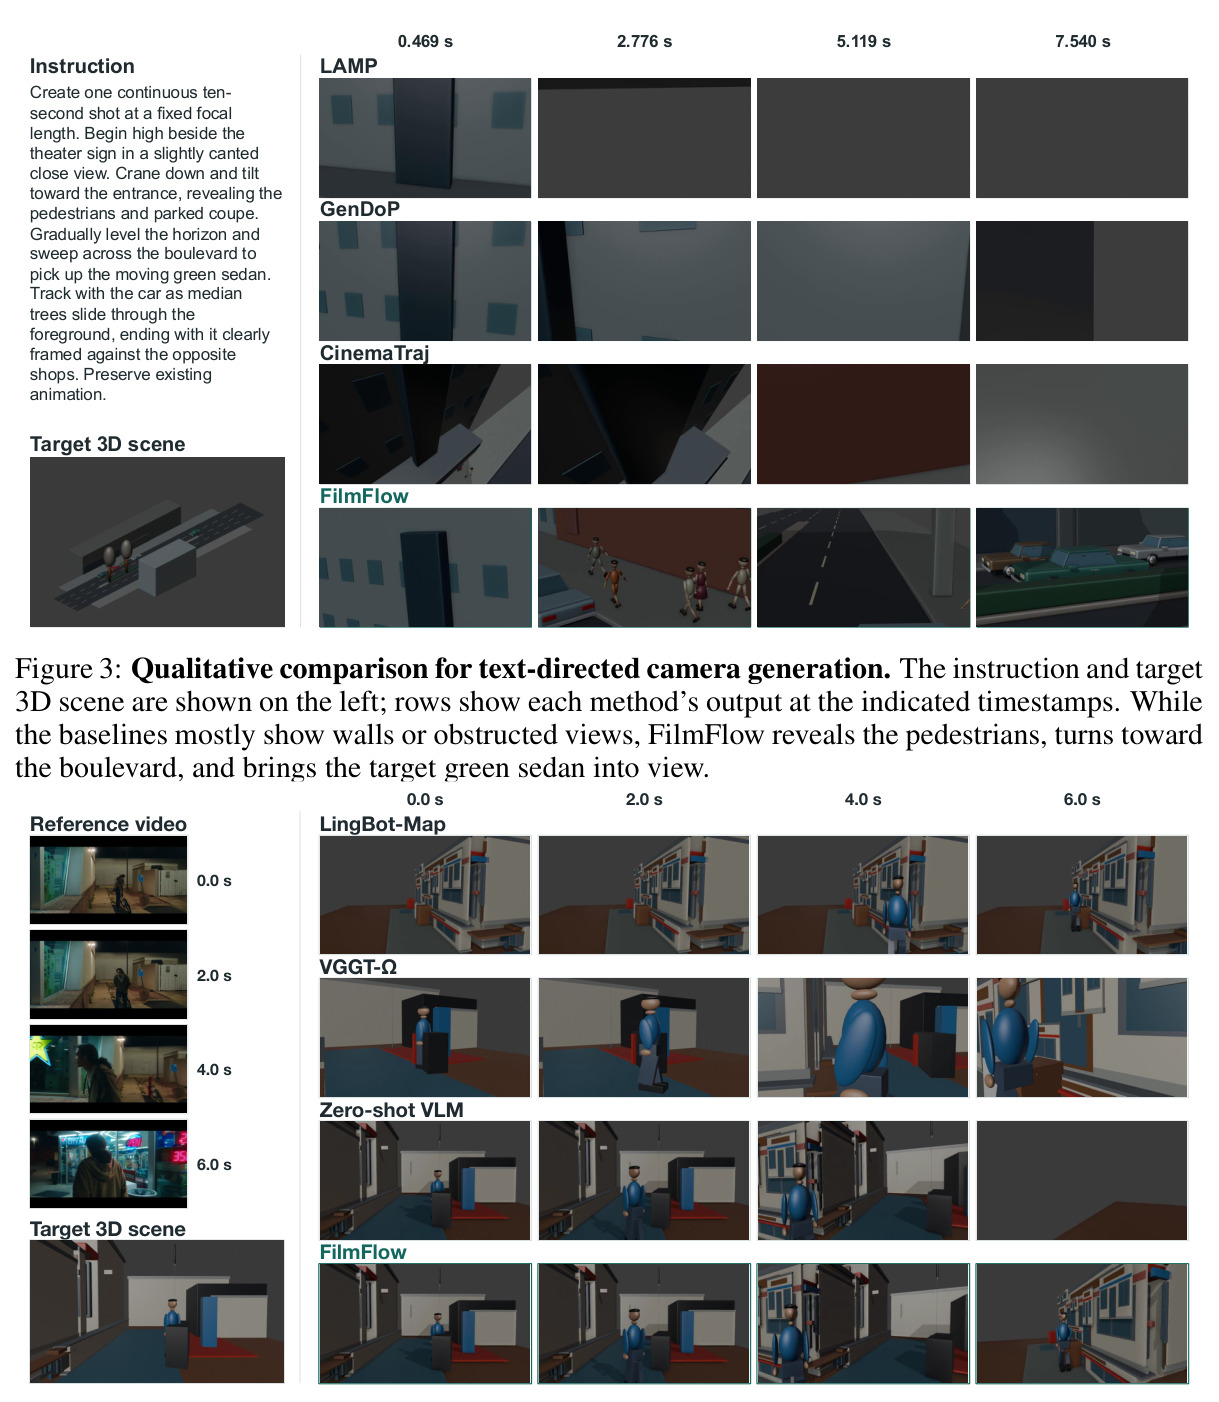
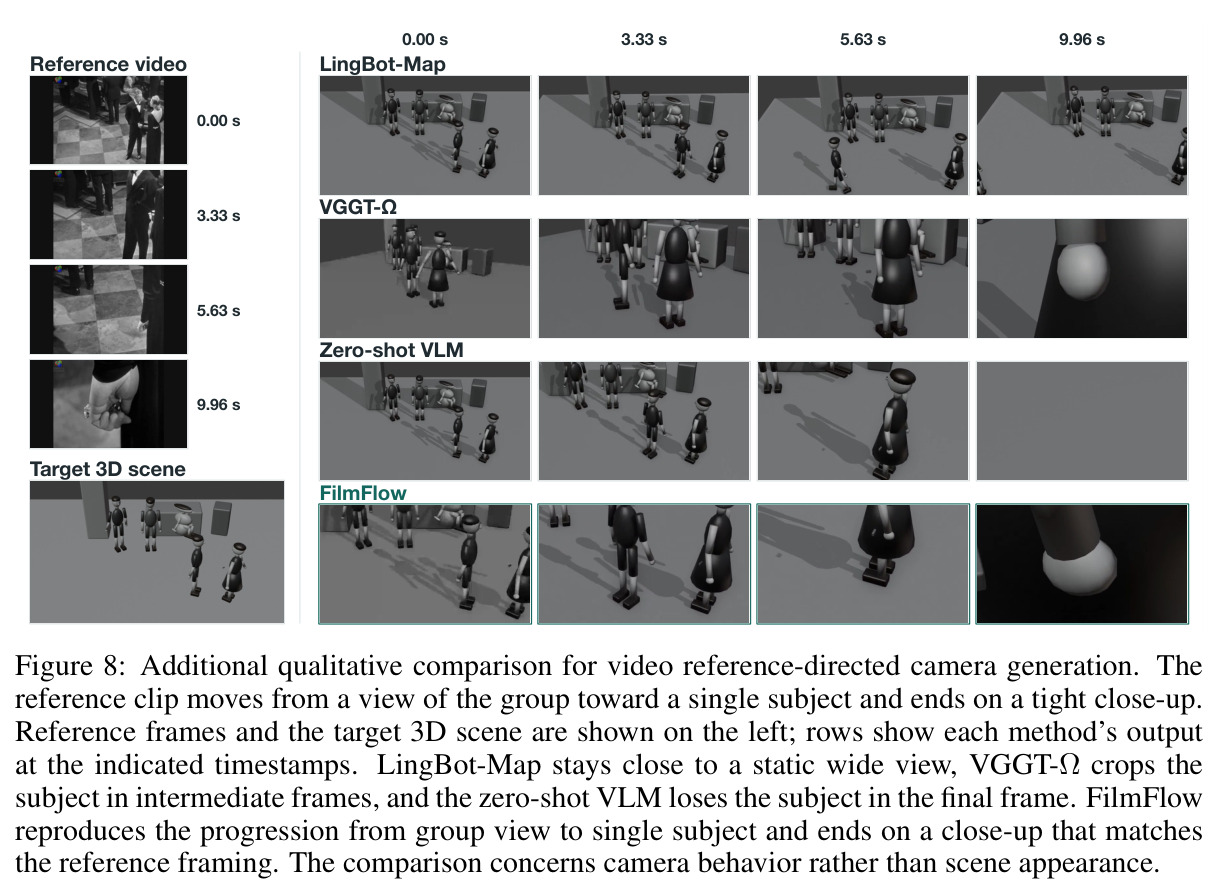
V2V 对比:参考视频帧与目标场景并排,右侧各行是各方法输出。FilmFlow 随主体移动调整视点并在采样帧中保持主体可见;LingBot-Map 开场丢失主体,VGGT-Ω 后期裁切主体,Zero-shot VLM 最终帧丢失主体。
展示直接位姿迁移基线在动态场景中的典型失败模式,说明场景感知规划与闭环精炼的必要性。
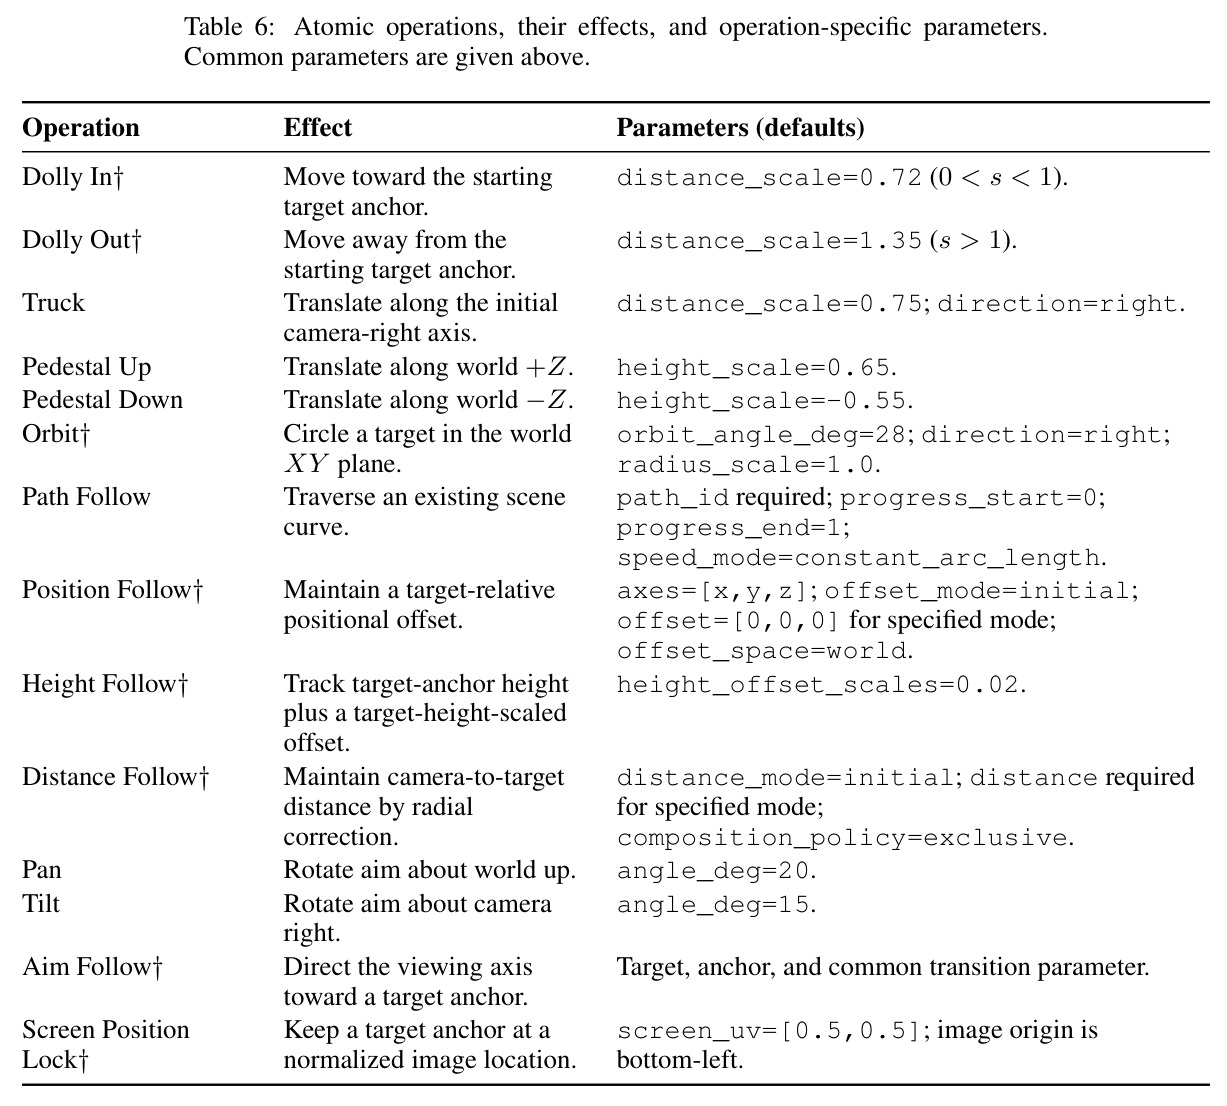
按功能分六类列出 22 个原子操作:位置类 10 个(Dolly In/Out、Truck、Pedestal Up/Down、Orbit、Path Follow、Position/Height/Distance Follow)、朝向类 6 个(Pan、Tilt、Aim Follow、Screen Position Lock、Roll、Horizon Lock)、构图类 2 个(Zoom、Frame Subject)、聚焦类 2 个(Focus Pull、Focus Follow)、扰动类 1 个(Shake/Handheld)、保持类 1 个(Static Shot)。
操作库是整个相机计划表示的词汇表,读方法章节的任何公式和案例都需要先知道有哪些原子操作。