LLM2Cert:结合 SMT 与 Lean 验证的 LLM 动力系统证书合成框架 LLM2Cert: LLM Synthesis of Certificates with SMT/Lean Verification
LLM 合成证书,按义务路由 SMT 快验、Lean 兜底,严格验证 77.1% 实例
前置知识
李雅普诺夫函数与稳定性证书
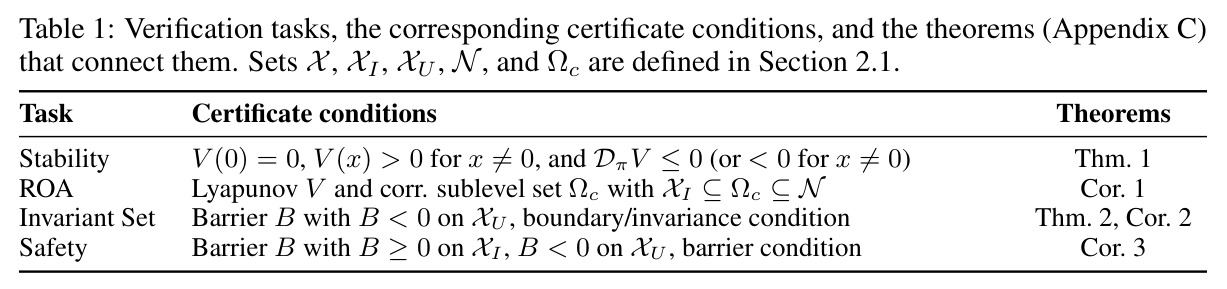
李雅普诺夫函数 $V(x)$ 是刻画系统“能量”的标量函数:若在平衡点满足 $V(0)=0$、$V(x)>0$,且沿轨迹单调不增(连续时间下李导数 $D^\pi V(x)=\nabla V(x)^\top f_\pi(x)\le 0$),则可断定原点稳定;若在非零处严格递减则渐近稳定。它把“所有轨迹都收敛”这类无限时间性质压缩为对全状态空间的不等式检查,是控制理论中稳定性的标准数学见证,避免了显式的轨迹积分。
本文四大任务(稳定性、吸引域、不变集、安全性)全部归结为寻找满足此类条件的标量证书 $W$,读懂任务定义与验证义务离不开它。
屏障证书(Barrier Certificate)
屏障证书 $B(x)$ 通过定义前向不变的超水平集 $C_B=\{x: B(x)\ge 0\}$ 来保证安全:要求初始集上 $B\ge 0$、危险集上 $B<0$,且在边界 $B(x)=0$ 处李导数严格为正(离散时间为一步差分非负),从而轨迹无法穿越边界进入危险集 $X_U$。它与李雅普诺夫函数互为对偶:一个证“收敛”,一个证“永不越界”。
DYNACERTBENCH 中 54 个安全任务与 13 个不变集任务都依赖屏障条件(如运行实例的四条义务 $O_1$–$O_4$),是理解实验设置的核心。
SMT 求解与 δ-完备判定(δ-sat)
SMT(可满足性模理论)求解器如 Z3、cvc5、Yices 在可判定的算术片段上给出精确判定:把全称条件取反编码为存在性反例查询,unsat 即证明原条件成立。但对含 $\cos$、$\arctan$ 等超越函数的非线性实数公式,dReal 只能做 δ-完备搜索:返回 δ-sat 仅说明 δ-松弛后的公式可满足,对原公式既不证实也不证伪,结论是不确定的。
δ-sat 与超时是本文把义务升级到 Lean 的直接动因,也是以往工作“悄悄放松验证目标”的根源,理解这点才能看懂论文的可靠性论证。
Lean 证明助手与内核检查
Lean 4 是基于依赖类型论的证明助手:用户构造证明项,由一个极小的可信内核做类型检查,通过即确认命题为真;还可审计公理依赖(本文只接受 $\{$propext, Classical.choice, Quot.sound$\}$,禁止 sorry)。与 SMT 的模型论路线(证伪:不存在反例模型)不同,Lean 走证明论路线(证实:存在形式推导),对任意非线性表达式原则上都能给出精确证明,但自动化程度低、搜索代价高。
本文首次把 Lean 作为 SMT 的兜底后端用于证书验证,“内核检查的证明”是全文端到端可靠性的基石,必须理解其与求解器判定的本质差别。
CEGIS(反例引导的归纳综合)
CEGIS 是“生成—验证—反例反馈”的循环范式:先从模板或学习器中提出候选解,再用验证器全局检查;一旦发现反例,就把反例喂回生成器修正候选,直至候选通过全部检查。FOSSIL、SMT-CEGIS 等经典证书合成工具都遵循这一模式,本文的 Proposal Agent 外层循环本质上是它的 LLM 智能体版本,但验证目标从不放松。
LLM2CERT 的外层搜索就是 CEGIS,理解它才能分清消融实验中“反例反馈”与“Lean 证明修复”各自贡献了什么。
研究动机
安全关键系统(机器人、自动驾驶、航空航天)需要超越有限仿真与测试的形式化保证,而李雅普诺夫函数与屏障证书的合成与验证在非线性、高维系统上仍是开放难题。现有验证路线各有硬伤:SOS(平方和规划)依赖浮点运算,存在数值不稳定;SMT 路线中 Z3/Yices 不支持超越函数,dReal 返回的 δ-sat 只保证“δ-松弛后可满足”而非原公式可满足;实践中普遍采用 ad-hoc 放松,如排除原点邻域(FOSSIL 2.0 在 Torus 域上排除 $B_{0.01}(0)$,RL 方法在 $D\setminus B_{\epsilon_R}(0)$ 上验证)、用泰勒近似替换超越项。这些放松改变了实际被证明的命题。更深远的是,验证瓶颈还扭曲了基准设计:现有数据集以低维无参数多项式系统为主。本文从 15 篇论文和 BarrierBench 收集 233 条候选记录,名义上高维($n\ge 5$)的 29 条经去冗余筛选后仅 7 条存活——BarrierBench 的 9 个高维实例全部因反馈线性化、被动状态填充等“结构注水”被剔除,可见已有基准是围绕求解器能力而非工程需求设计的。
本文的目标是本文采取“基准 + 方法”双管齐下的策略。基准侧:构建 DYNACERTBENCH,共 105 个实例——80 个从文献精选的非冗余核心系统、11 个扩展实例(升维、扩大域、加控制约束或扰动)、14 个全新构造的 5–10 维非线性耦合系统,覆盖稳定性、吸引域(ROA)、前向不变集、安全性四大任务及连续/离散时间两类系统,每个实例都以精确、无放松的证书条件表述;高维($n\ge 5$)实例占比从文献核心层的 8.75%(7 个)提升到整体的 23.81%(25 个)。方法侧:提出 LLM2CERT 智能体框架,让 LLM 合成候选证书与反馈控制律,把候选诱导的每条证明义务路由给 SMT 求解器或 Lean 证明修复智能体,目标是每条义务要么由 SMT 的 unsat 判定闭环、要么由 Lean 内核检查的证明闭环,在不放松任何验证目标的前提下实现端到端高覆盖率(实测 81/105,77.1%)。
与已有工作不同的是,本文的独特切入角度是把“验证目标的严格性”当作不可妥协的约束,并用两个互补后端按义务粒度分层消化证明义务。据作者所知,此前没有工作把 Lean 定理证明器集成进连续与离散时间动力系统李雅普诺夫/屏障证书的端到端合成与验证:既有工作要么用 SOS 数值证书、要么用 δ-完备 SMT 判定,都会悄悄替换被证明的命题;LLM2CERT 则保持候选及其义务全程冻结——只搜索证明,从不放松命题。第二个被忽视的观察是后端互补性:SMT 在可判定片段上秒级出结果(多项式证书平均 1.65 秒)但处理不了超越函数与径向无界性;Lean 恰好擅长这些硬义务(非多项式系统上 34/40 对 SMT 的 18/40),但每个证书平均要 512–638 秒。让 SMT 快速筛掉 85.5% 的义务、把剩余 14.5% 升级给 Lean,是兼顾覆盖率与成本的杠杆点,这一互补结构此前未被系统化利用。
核心方法
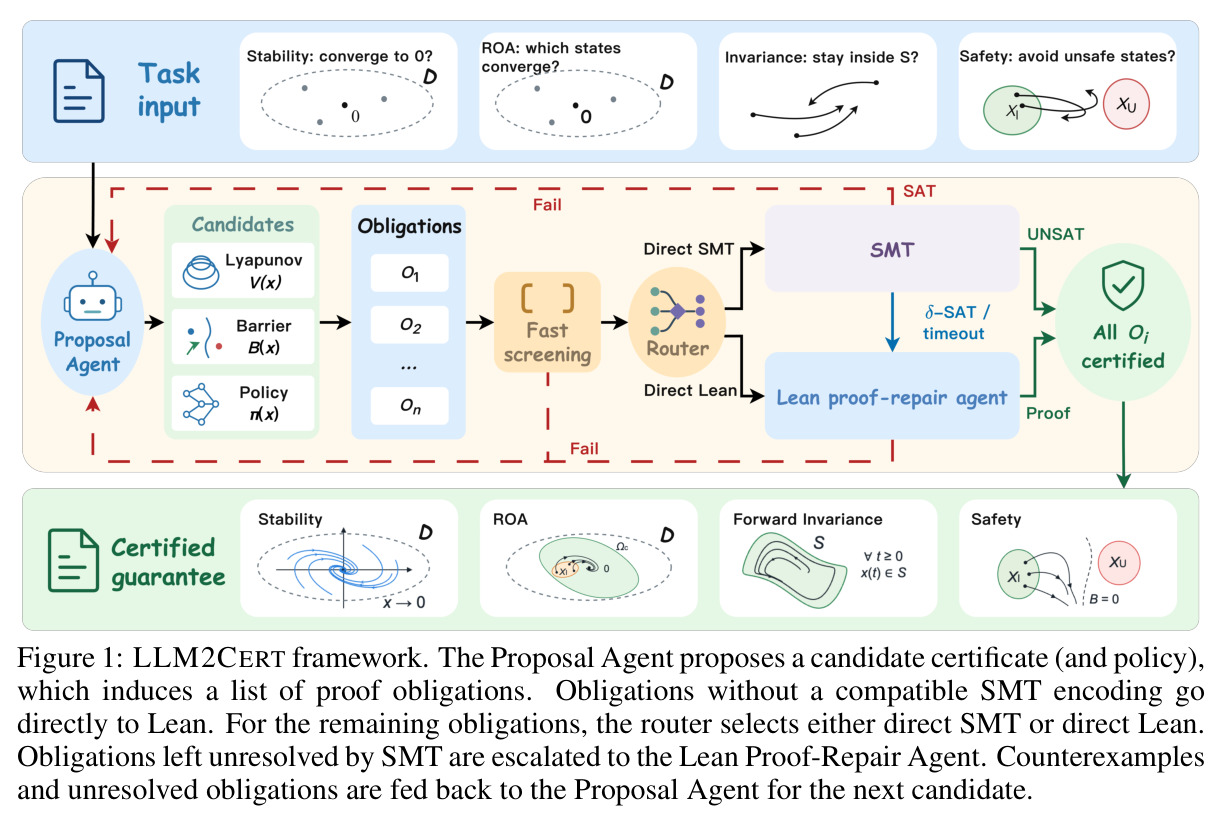
直觉上,LLM2CERT 把“找一个能证明整个安全/稳定命题的证书”拆成两类子问题:LLM 擅长的“猜”(提出有希望的候选证书与控制律)和验证器擅长的“查”(逐条核对有限条不等式义务)。技术路线是外层 CEGIS 循环加内层混合验证:给定类型化规范 $R=(f/F, X, N, X_I, X_U, U, \text{Task})$,Proposal Agent 每轮提出候选 $C^{(k)}=(W^{(k)}, \pi^{(k)})$,编译为类型化表达式树后按任务定理(如安全性 Cor. 3)实例化出义务列表 $\mathcal{M}(A^{(k)})=\{O_1,\dots,O_n\}$,每条形如 $O_i: \forall z,\, P_i\Rightarrow Q_i$。快速筛查先在有限采样点上否决明显错误的候选并回传反例;随后 Verification Router 逐条路由:无 SMT 编码的义务(如径向无界性)直送 Lean,其余交给 Z3/cvc5/Yices/dReal(各 30 秒超时),SMT 留下的 δ-sat 或超时义务升级给 Lean Proof-Repair Agent 构造核检查证明。候选只有在全部义务闭环后才被标记 verified。全文用系统 88(含 $\cos x_1$ 的二维安全实例)贯穿演示。
核心创新是“义务级路由 + 冻结目标”的混合验证协议,与已有方法有两点本质区别。第一,双层可靠性:本文先在 Lean 中形式化并证明每个任务“条件⇒定理”的蕴含(Table 1 的 Thm. 1、Cor. 1–3,全部经 Lean 内核检查),再由 LLM2CERT 保证候选满足条件(每条义务由 SMT unsat 或核检查的 Lean 证明闭环),形成“候选 → 已验证候选 → 定理成立”的端到端保证链,杜绝了 SOS 浮点误差、δ-sat 不确定性、泰勒近似与排除原点邻域等一切放松。第二,SMT 与 Lean 按义务特长分工而非二选一:对 81 个冻结证书的 296 条义务,SMT 以 unsat 快速解决 253 条(85.5%),Lean 处理 43 条(14.5%),其中 21 条来自 SMT 超时或 δ-sat 升级、19 条路由直派、3 条径向无界性无 SMT 编码;非多项式系统上 Lean 兜底把覆盖率从 18/40 拉到 40/40。单用 SMT 只有 59/81、单用 Lean 只有 64/81,路由拿到 81/81——两个后端互补而非冗余,这是“既快又严”的关键。
方法步骤详情
流程分五步。(1)候选生成:Proposal Agent 收到含动力学、集合与任务画像的规范 $R$,输出 JSON 候选 $C^{(k)}=(W^{(k)},\pi^{(k)})$,要求精确有理常数;格式检查失败则回传解析错误重试。(2)义务实例化与快筛:候选编译为表达式树 $A^{(k)}$ 并实例化义务列表;快筛在 1500 个初始集样本、1500 个危险集样本、2000 个分析域/边界样本上评估,发现违反即拒绝候选并回传至多 5 个反例;通过快筛不提供任何形式保证。(3)路由:无 SMT 编码的义务(如径向无界性)直送 Lean;多项式义务走确定性能力分析,含超越函数的询问模型(如系统 88 的 $O_4$ 指派给 cvc5)。(4)SMT 验证:四个求解器并发查反例查询 $\exists z,\,P_i\wedge\neg Q_i$;unsat 即闭环,sat 且模型经独立重放确认则拒绝候选,δ-sat 或 30 秒超时则升级。(5)Lean 证明修复:智能体只能写证明体(定理陈述、定义、候选哈希全部锁定),每轮在固定的 Lean 4.32.2/Mathlib 环境编译;失败反馈按类型分类并附 Mathlib 检索结果;接受条件是编译通过且公理审计仅含标准公理、无 sorry。预算:至多 5 个候选、每义务 6 轮修复 900 秒、每系统总时限 2400 秒。
技术新颖性
与已有技术的具体区别:(1) 相比 SOS/LMI 数值路线(SynNLF 用 MOSEK 做浮点可行性检查),本文的证明全部由 Lean 小内核机械检查,可信基础极小、无浮点误差;(2) 相比 δ-完备 SMT 路线(FOSSIL 2.0、dReal 配置),δ-sat 不再被当作“通过”,而是升级为对原始未松弛命题的 Lean 证明;(3) 相比 BarrierBench 的“SMT 反例 + LLM”闭环,本文增加 Lean 后端、义务路由与结构化修复——消融显示 SMT-only 仅 57/105、Lean-only 60/105、完整框架 81/105;(4) 相比 Vertovec et al. 的 $\forall x\,\exists u$ 神经 CBF 验证,本文对具体反馈策略 $\pi(x)$ 的闭环系统逐条验证;(5) 相比既有证明助手工作(Coq 倒立摆、Minlog SOS 构造性检查、Lean 稳定性理论形式化),本文首个覆盖连续+离散时间、四大任务、端到端“合成—义务分解—证明—审计”的框架。LLM 在其中只提出候选与证明项,从不改变验证目标,安全边界清晰。
实验结果
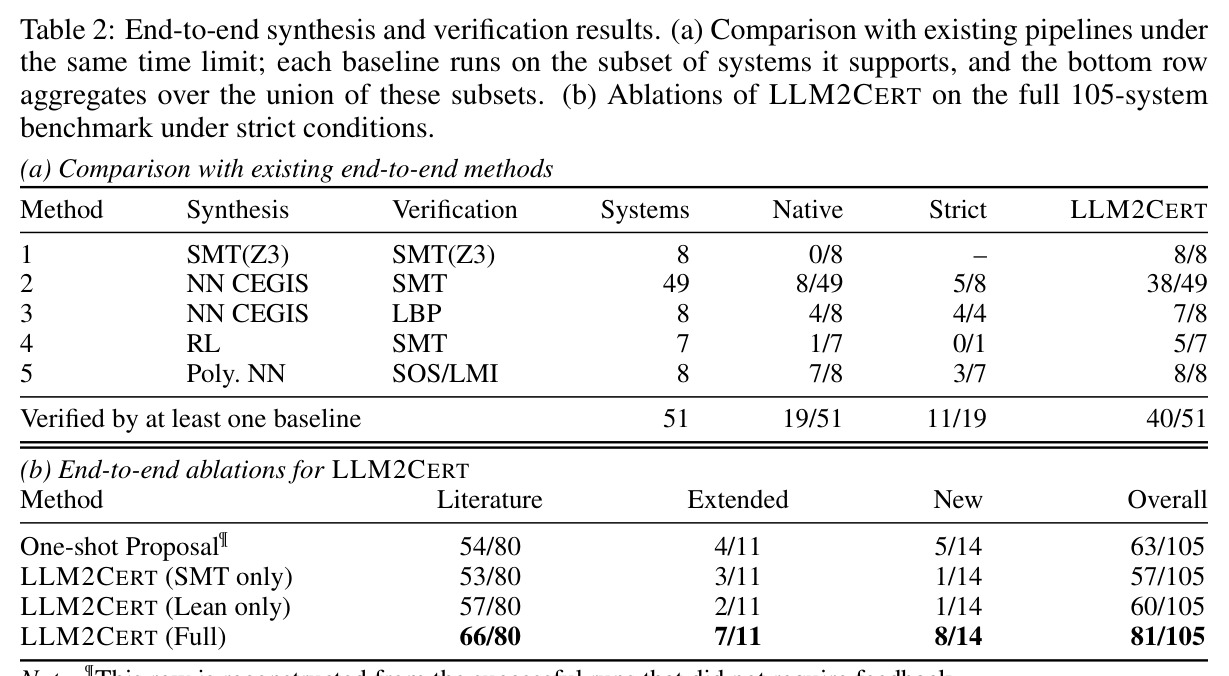
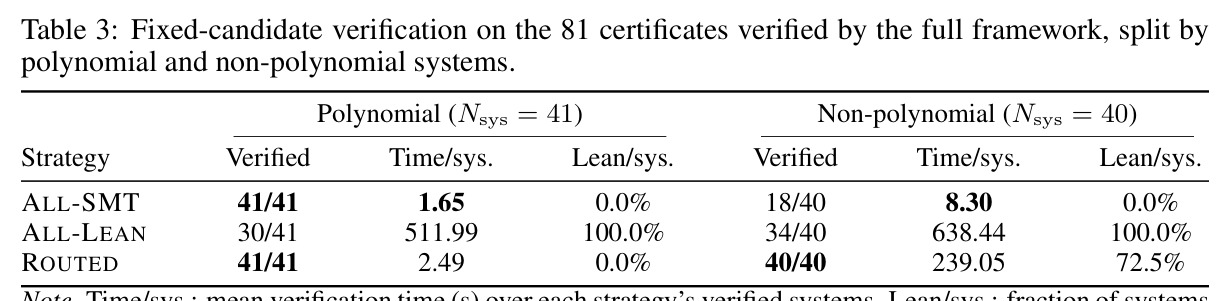
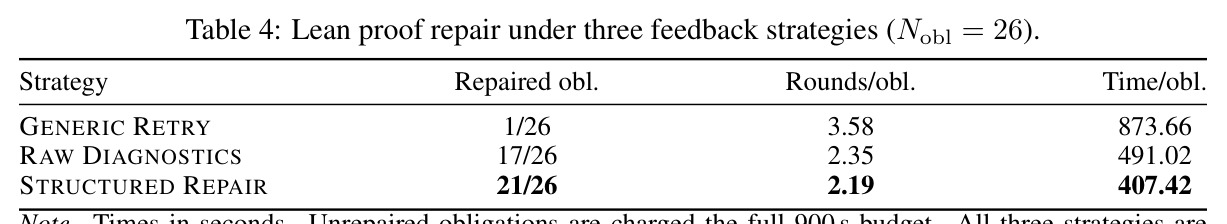
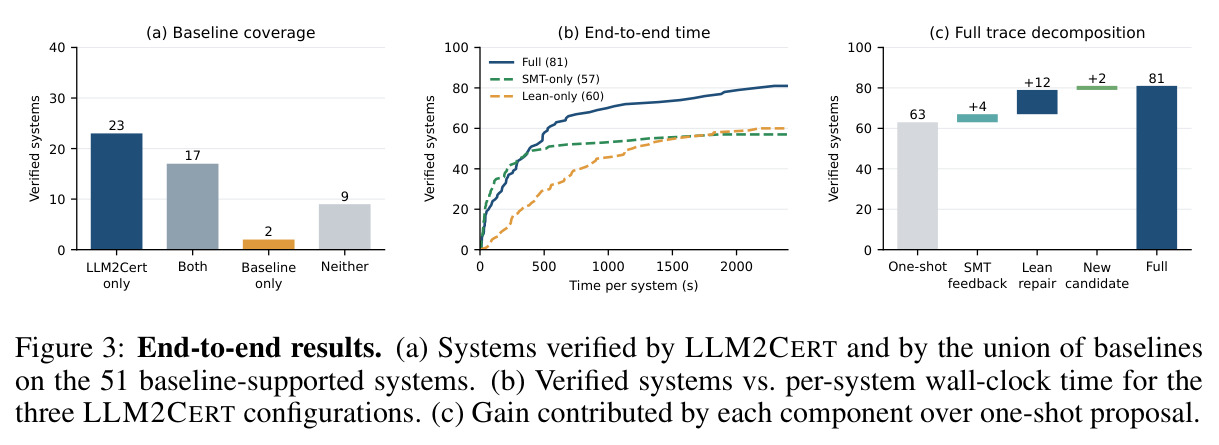
主实验(Table 2a):在 51 个基线可运行系统上,五条基线原生只验证 19/51,严格复检后仅 11/19 存活(4 个 δ-sat 证书、4 个 SynNLF 证书失效),LLM2CERT 达 40/51,并验证了 23 个无基线能原生验证的系统;基线也解决 2 个 LLM2CERT 未决系统,说明神经综合与 LLM 互补。消融(Table 2b):one-shot 仅 63/105,完整框架 81/105(77.1%),提升 17.1 个百分点,三层分别 +15.0(66/80)、+27.3(7/11)、+21.4 pp(8/14);SMT-only 57/105、Lean-only 60/105;图 3(c) 将增益分解为 SMT 反馈 +4、Lean 修复 +12、新候选 +2。按任务:稳定性 21/26、ROA 8/12、不变集 7/13、安全 45/54;并解决 BarrierBench 未决的 10 个系统中的 8 个。固定证书分析(Table 3):All-SMT 59/81(多项式 41/41、1.65 秒;非多项式仅 18/40),All-Lean 64/81(511.99/638.44 秒),Lean 独占的 21 个证书全部非多项式;ROUTED 拿下 81/81,均时 2.49 秒(多项式)/239.05 秒(非多项式)。修复反馈(Table 4):结构化修复 21/26 义务、15/19 系统,均时 407.42 秒;原始诊断 17/26;泛型重试仅 1/26。成本:全程约 6.2 小时、7.83M tokens,成功系统平均 471.96 秒;24 个未决系统中 10 个卡在 Lean 超时、6 个从未产出可解析候选。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端合成+验证(105 实例,严格无放松条件) | 验证系统数 | LLM2CERT Full:81/105(77.1%) | One-shot 63/105;SMT-only 57/105;Lean-only 60/105 | +17.1 个百分点(相对 one-shot) |
| 与五条已有流水线对比(51 个基线可运行系统) | 验证系统数 | 40/51 | 基线原生 19/51,严格条件复检后仅 11/19 存活 | 约为严格条件下基线覆盖的 3.6 倍;23 个系统无基线可验 |
| 非多项式系统固定证书验证(40 个) | 验证证书数 / 均时 | ROUTED 40/40,239.05 秒/证书 | All-SMT 18/40(8.30 秒);All-Lean 34/40(638.44 秒) | 覆盖率相对 All-SMT +55 pp,耗时约为 All-Lean 的 37% |
| 多项式系统固定证书验证(41 个) | 验证证书数 / 均时 | ROUTED 41/41,2.49 秒/证书 | All-SMT 41/41(1.65 秒);All-Lean 30/41(511.99 秒) | 与 All-SMT 同覆盖率,仅慢 0.84 秒,远快于 All-Lean |
| Lean 证明修复(26 条失败首证义务) | 修复义务数 / 均时 | 结构化修复 21/26,407.42 秒/义务 | 泛型重试 1/26(873.66 秒);原始诊断 17/26(491.02 秒) | 比原始诊断多修复 4 条且更快;比泛型重试多 20 条 |
局限与改进
作者承认三点:DYNACERTBENCH 只是 105 个精选实例而非穷举样本,未覆盖混合(hybrid)与不确定动力学;框架目前只针对确定性系统,未处理随机扰动与概率保证;综合回路只验证给定域上的证书,不显式优化被认证集合的大小(如最大化吸引域)。我的补充观察:(1) ROA 与不变集任务成功率明显偏低(66.7%/53.8%),说明候选搜索在这些任务上缺乏模板先验;(2) 24 个未决系统中 10 个死于 Lean 超时或共享时限耗尽、6 个从未生成可解析候选,瓶颈在证明搜索与输出格式而非数学不可行;(3) 全流程依赖 gpt-5.6-sol(reasoning effort high),既带来成本与复现不确定性,也使结果与特定闭源模型绑定;(4) 有一次运行因 API 速率限制失败,说明工程健壮性有待加强;(5) 基线对比中每条基线只在各自支持的子集上运行(union 共 51 个系统),横向可比性受子集划分影响;(6) 快筛的有限采样无法覆盖连续域,真正的保证仍完全押在 SMT/Lean 上,若两者都超时则一无所获。
独立分析的弱点
独立分析四个弱点。(1) Lean 后端昂贵且是主要瓶颈:All-Lean 均时 511.99–638.44 秒/证书,未决系统的末事件 10/24 是 Lean 超时;改进方向是接入更强的自动策略搜索(Lean Copilot 式检索增强、基于证明进度预测的神经引导),或对常见不等式模式预编译策略库,把 407 秒/义务的修复均时进一步压缩。(2) 候选生成有时连格式都过不了(6 个系统无可解析候选),且 LLM 输出表达式语言受限;改进方向是采用带语法约束的解码或 AST 级输出协议,从源头消除解析失败。(3) 对单一商业模型的依赖使成功率与该模型的控制论先验强耦合,换模型可能大幅波动;改进方向是在开源模型上系统评估,并蒸馏成功轨迹微调小型专用模型。(4) 框架验证的是“给定候选是否满足条件”而非“最优证书”,不能回答“最大吸引域有多大”;改进方向是把子水平集常数 $c$ 或域参数纳入搜索目标,做约束优化式综合,让验证器反过来指导候选改进。
未来方向
作者提出的方向:把基准扩展到高维混合与不确定动力学;推广到带随机扰动的随机系统与概率保证(作者团队已有随机系统屏障条件的工作);在综合回路中引入区域大小目标,形式化合成更大的吸引域与不变集。基于成果可延伸的:作者自己指出基线(神经/RL 综合)与 LLM2CERT 互补——基线能验证 2 个 LLM2CERT 未决的系统,级联或集成两条流水线值得尝试;把 RQ3 的结构化编译器反馈思想迁移到其他形式化领域(已验证代码生成、自动形式化);将本文的 Lean 形式化定理库(Table 1 的条件⇒定理及配套引理)作为社区资产,扩展指数稳定性、鲁棒性、随机屏障等更多证书类型;探索更便宜的模型配更强检索,降低单系统 471.96 秒的均时,使框架可用于安全关键系统的在线监控与运行时认证。
复现评估
复现条件较好。代码与数据已在 GitHub 开源(FormalCert-AI/llm2cert),DYNACERTBENCH 的 105 个实例(每个系统的动力学、集合与任务定义在附录 F 逐条列出)随代码发布,附录 D 给出全部提示词模板与一条完整运行轨迹(系统 88 的六步 trace)。工具链完全钉死:Lean 4.32.2、Mathlib 905b95818eb3、Z3 4.15.4、cvc5 1.3.3、Yices 2.7.0、dReal 4.21.06.1($\delta=10^{-3}$),Linux x86_64 单机即可,全程约 6.2 小时墙钟时间,无需 GPU。主要门槛是 LLM:报告实验使用 gpt-5.6-sol(OpenRouter,reasoning effort high,输出上限 16384 tokens),总量 7.83M tokens,API 费用不高但结果可能随模型版本漂移;此外需搭建固定的 Lean/Mathlib 环境并实现公理审计。总体复现难度中等:有 Lean 经验的团队几天可复跑,无 Lean 背景则需一至两周熟悉环境与审计流程。
论文图表
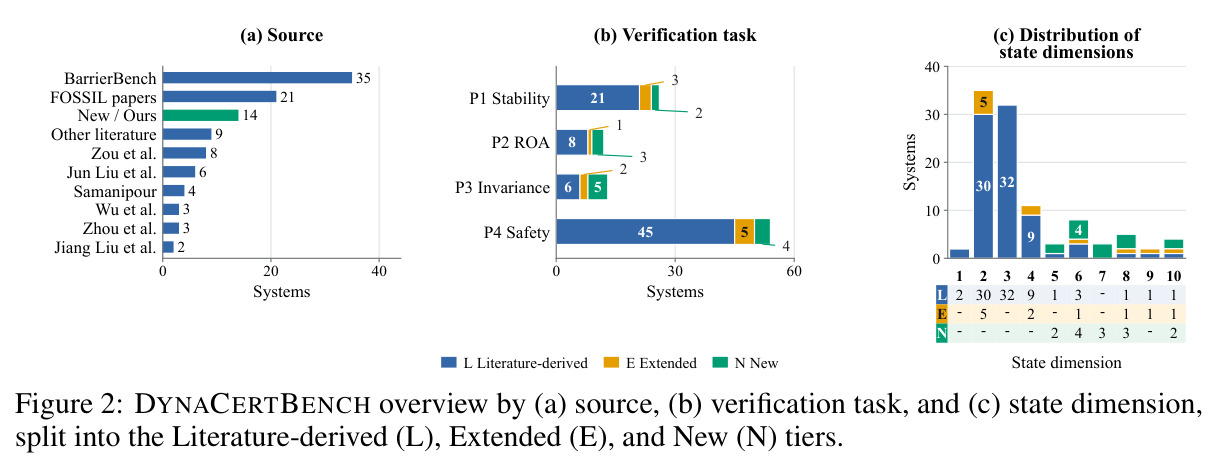
基准构成三联柱状图:按来源(BarrierBench 35、FOSSIL 论文 21、New/Ours 14、其他文献 9 等)、按任务(稳定性 26、ROA 12、不变集 13、安全 54)、按状态维度(1–10 维)统计,并区分文献层 L、扩展层 E、新构层 N 三个层级。
它直观呈现现有基准的稀缺性(高维实例极少)与本文的补齐方式(E/N 层把 $n\ge 5$ 实例从 7 个拉到 25 个),是理解实验设计动机的关键。