ALPS:面向世界模型的视觉状态编码器 ALPS: Visual State Encoders for World Models
仅用静止图像与文本预训练单一冻结编码器,同时支持状态感知、语言对齐与像素重建。
前置知识
图文对比预训练(CLIP/InfoNCE)
把图像和文本分别编码成向量,用 InfoNCE 对比损失拉近匹配图文对的嵌入、推远不匹配对,使图文共享一个语义空间。SigLIP 用 sigmoid 损失替代 softmax 版 InfoNCE。这样训练出的模型可做零样本分类和图文检索。
ALPS 第一阶段的语言对齐目标 $\mathcal{L}_{itc}$ 就建立在 InfoNCE 上,理解它才能理解语言接口如何建立、以及为何会被后续精炼破坏。
ViT patch token 与冻结特征评测
视觉 Transformer 把图像切成 16×16 patch,每个 patch 编码为一个 token,$z = E(x) \in \mathbb{R}^{N imes d}$。冻结特征评测指不微调编码器,只在固定的 token 上训练轻量探针或策略,检验表征本身的质量。
本文的全部对比(状态探针、策略、世界模型、解码器)都在冻结 token 上进行,patch token 是贯穿全文的基本数据单元。
自蒸馏与教师-学生框架(DINO 式)
让一个可训练的学生网络去预测一个冻结(或 EMA 更新)教师网络在另一视图上的输出,从而把教师的知识蒸馏回自身。DINO 用多裁剪自蒸馏学习空间特征,无需标签。
ALPS 第二阶段正是教师-学生式的跨视图自蒸馏:教师是第一阶段编码器自身的冻结副本,目标 token 完全来自自己,不依赖任何外部教师。
潜空间世界模型(DINO-WM 式)
世界模型在冻结编码器的 token 空间中训练一个动力学预测器:给定当前帧 token 和动作序列,预测未来帧的 token;规划器在该潜空间中搜索使预测 token 逼近目标图的动作。
本文的下游规划与预测实验完全沿用 DINO-WM 协议,编码器 token 的质量直接决定潜空间动力学可学性和规划效果,这是论文动机的出发点。
LIBERO 基准与行为克隆
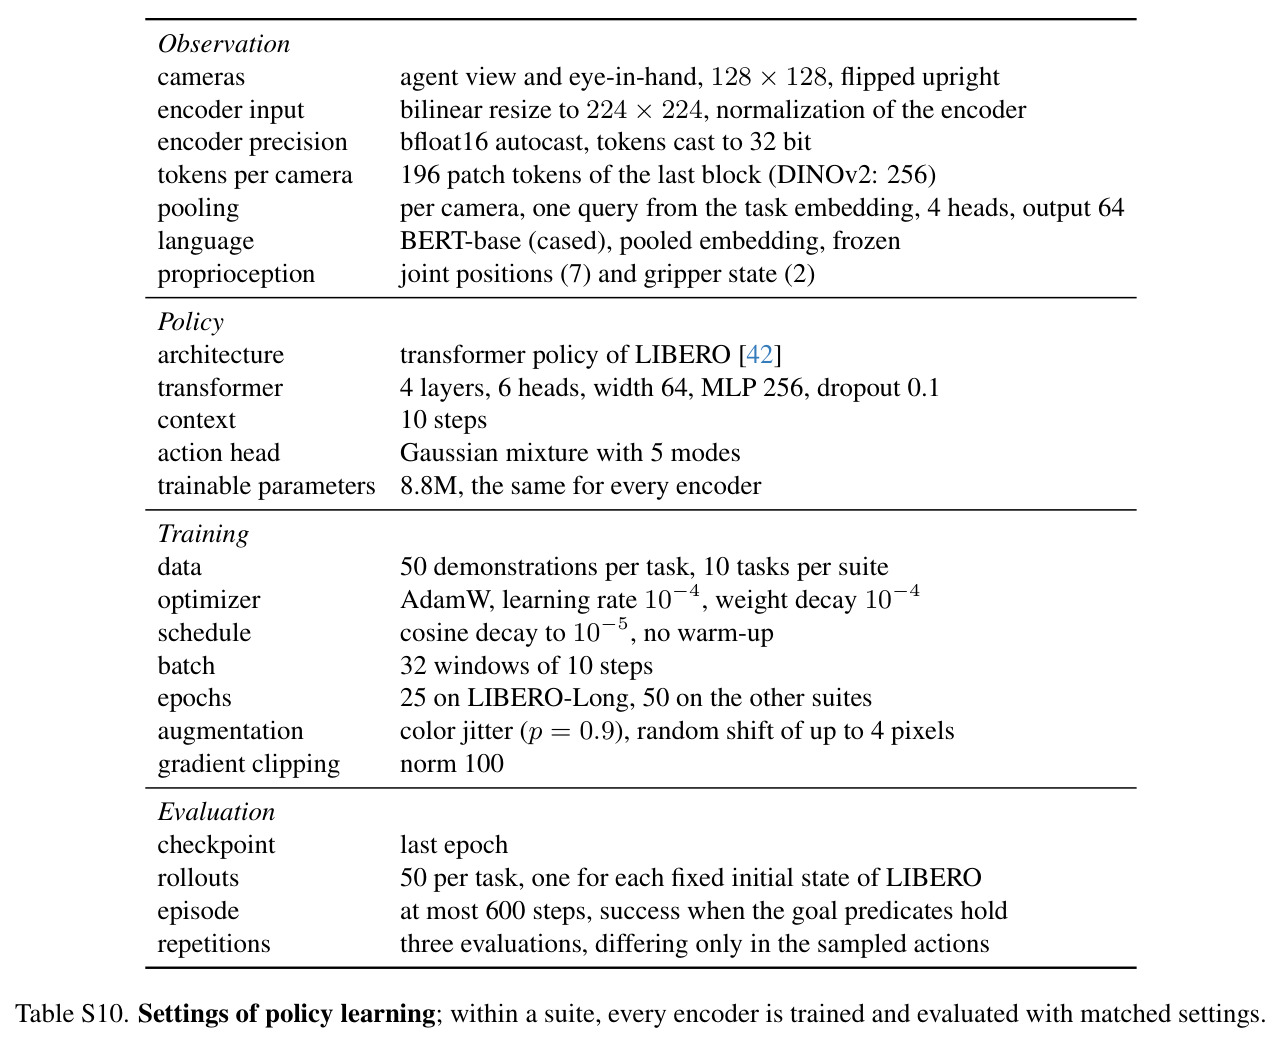
LIBERO 是机器人操作仿真基准,含 Object/Spatial/Goal/Long 四个套件,每任务提供 50 条演示。行为克隆用这些演示训练策略(如 transformer 策略)模仿专家动作,以任务成功率评估。
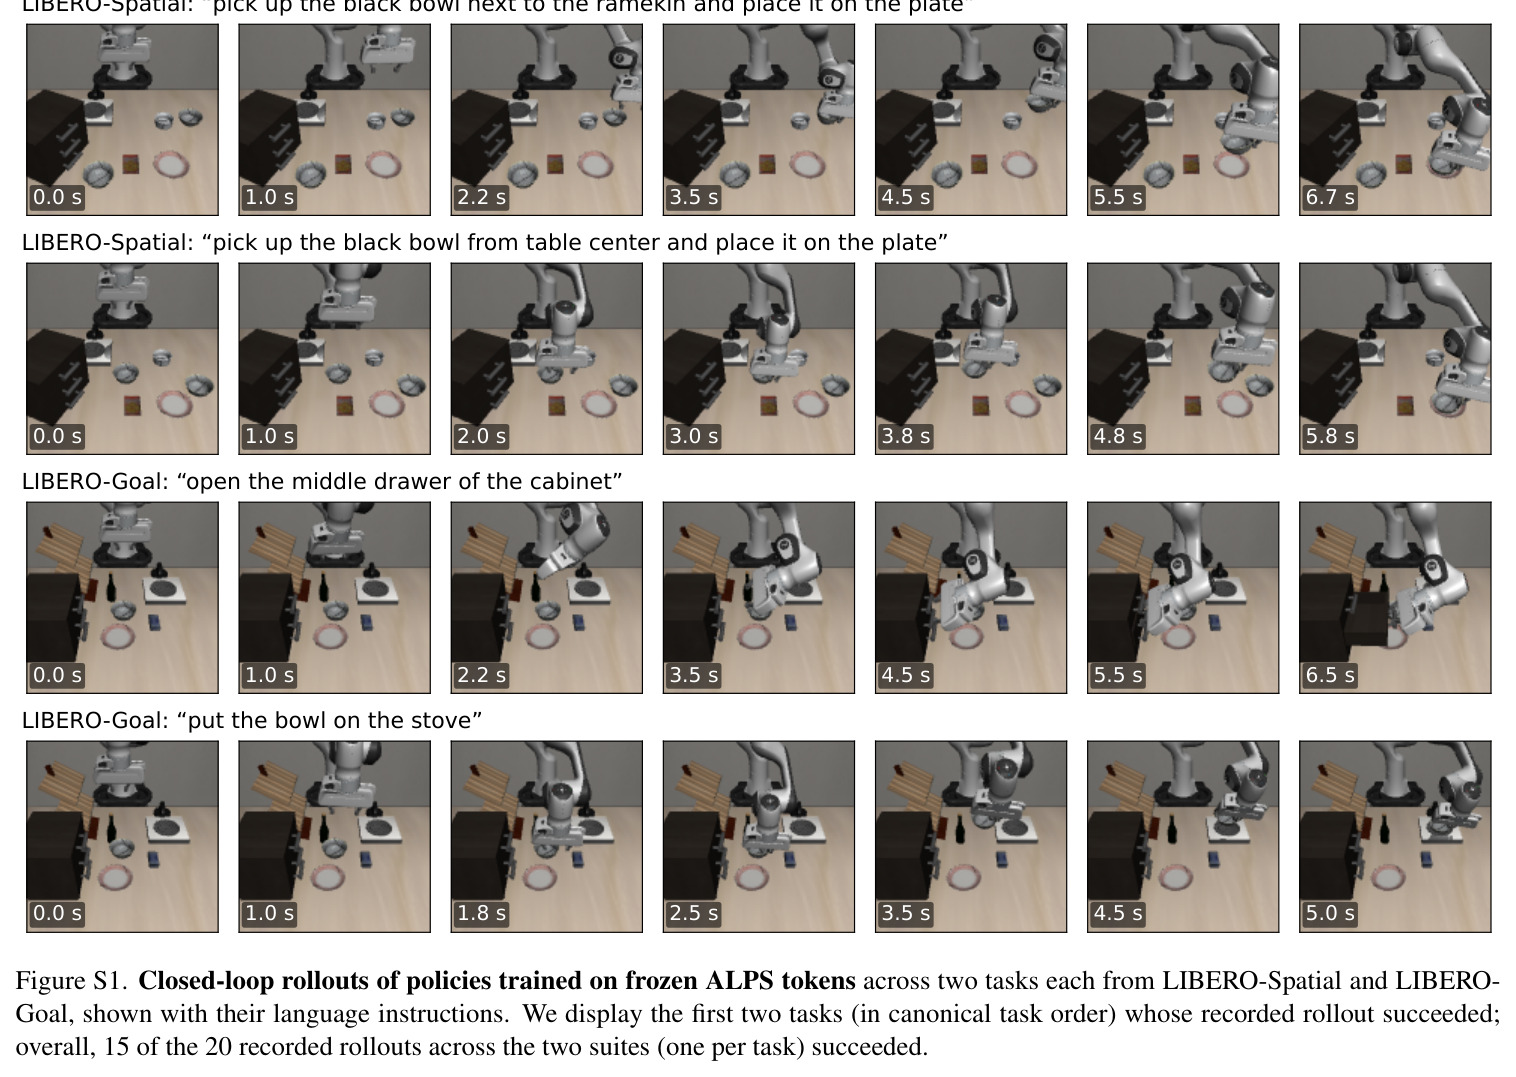
LIBERO 既被用来构建状态探针(回归物体 3D 位置与朝向),又被用来训练下游策略,是验证'状态信息'与'控制能力'两条主线的主战场。
研究动机
世界模型通常在冻结视觉编码器的 token 空间中学习"场景如何随动作变化",因此编码器决定了模型能看到什么。现有公开编码器各守一隅:DINOv2、DINOv3、C-RADIOv3 提供可迁移的空间特征但几乎没有语言接口;V-JEPA 2 用视频潜空间预测学时空表征,但它是参数量 3.5 倍的 ViT-L;CLIP、SigLIP 2、PE-Core 擅长图文对齐,对物理状态却很不敏感——在作者的 LIBERO 状态探针上 CLIP 相对误差高达 1.194、SigLIP 2 为 1.160,而 DINOv3 只有 .870;MAE、VC-1、OpenVision 3 保留像素细节但同样没有文本塔。更棘手的是能力之间互相冲突:把作者的第二阶段精炼配方直接套在 SigLIP 2 或 CLIP 上,状态误差虽下降,但 ImageNet 零样本分别掉 4.3 和 10.2 个点,Flickr30k 图到文检索掉 7.5 和 10.9 个点,语言能力几乎被摧毁。
本文的目标是本文的目标是:仅用静止图像和文本(不用任何视频或机器人交互数据),从零预训练一个 ViT-B/16 的"视觉状态编码器",让同一组 patch token 同时具备三个接口——(1) 物理状态信息:下游探针能从 token 读出并预测可移动物体的三维位置、朝向和二元谓词;(2) 原生语言对齐:保留自己的文本塔,指令与目标可直接映射到场景,无需第二个视觉编码器;(3) 像素重建:token 能被轻量解码器还原成图像,使观测场景和想象出的未来都可被渲染检查。作者同时建立了覆盖十五个公开编码器的统一评测协议,把状态、语言、像素三种能力以及下游控制、规划、动力学预测放到同一把尺子下比较,希望让视觉预训练成为世界模型"理解、预测、行动"的共享基础。
与已有工作不同的是,已有的统一化尝试走两条路:dino.txt 把语言能力事后适配到冻结的自监督主干上,OpenVision 3 则编码生成式自编码器的潜变量——都不是从源头让 patch token 同时承载三种监督。ALPS 的独特切入是"先多任务、后自精炼"的两阶段课程:第一阶段在共享 patch token 上联合训练对比对齐、字幕生成、像素重建与稠密对应四个目标,形成统一初始化;第二阶段完全依赖第一阶段自己的冻结副本作教师,做几何条件化的跨视图自蒸馏,在不引入任何外部视觉教师的前提下强化状态信息。作者还给出机制层面的解释:ALPS 用"线性投影+平均池化"做图文读出,该操作与局部更新可交换,零均值的 patch 更新会在池化时互相抵消,这解释了为什么精炼几乎不伤语言。
核心方法
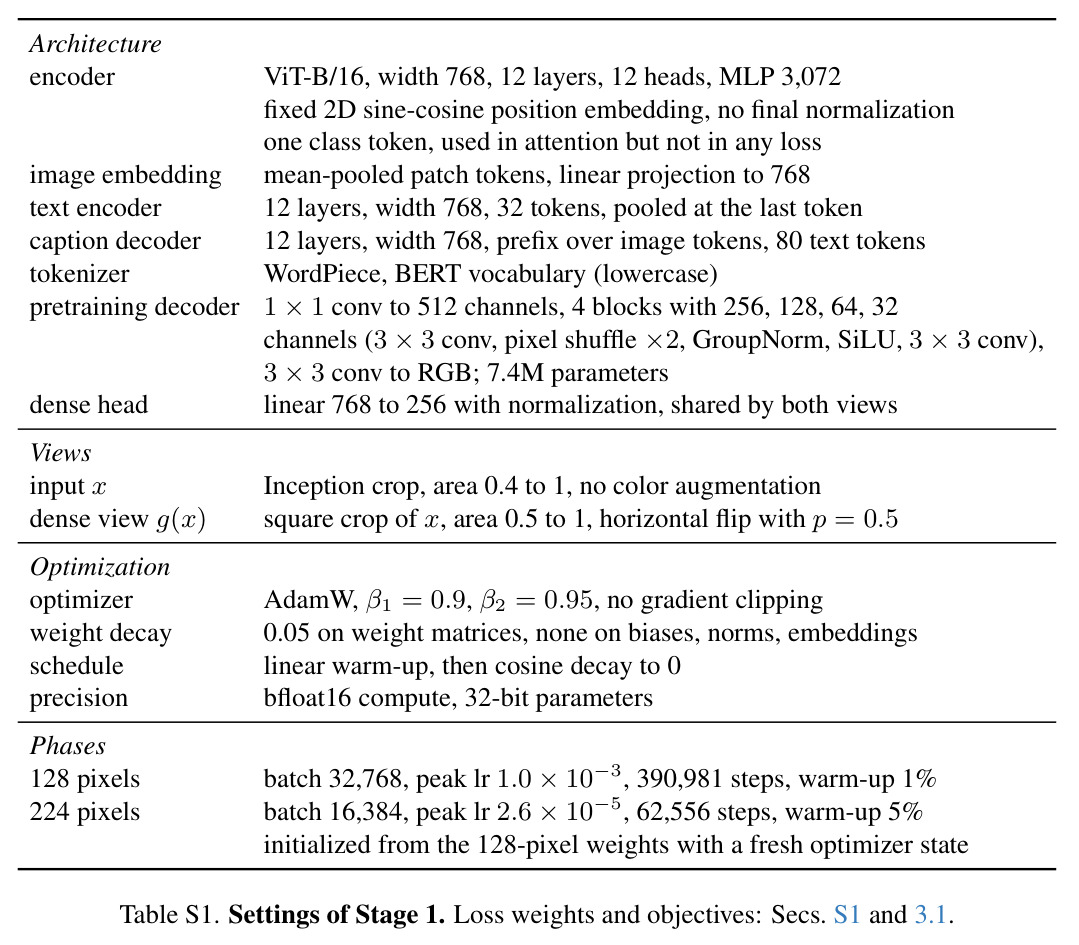
直觉上,ALPS 想让一组 196 个 patch token 同时"会说话、会还原、会预测状态"。技术路线分两阶段。第一阶段从零联合预训练:ViT-B/16 编码器输出未经最终归一化的原始 patch token,配上同宽深的文本编码器与字幕解码器,以及一个 7.4M 参数的轻量卷积解码器 $D$ 用于重建,总损失为 $$\mathcal{L}_1 = \mathcal{L}_{itc} + \mathcal{L}_{cap} + w_{rec}\,\mathcal{L}_{rec} + 0.25\,\mathcal{L}_{dense}$$ 四个目标分别是:图文对比(对网络字幕与合成字幕各算一个 InfoNCE 后取平均)、自回归字幕生成、像素重建(对干净与加噪 token 各解码一次,$\rho$ 混合 ℓ1、SSIM 与图像梯度项)以及跨裁剪/翻转视图的 patch 级稠密对应。数据用 DataComp-1B 及 LLaMA-3 captioner 重写的合成字幕,先以 128×128 分辨率训练 128 亿样本,再以 224×224 训练 10 亿样本。第二阶段做跨视图自蒸馏:学生从第一阶段权重初始化,冻结的第一阶段副本作教师,学生从增强裁剪 A 预测教师在干净裁剪 B 上对应位置的标准化 token;训练结束后丢弃预测器,留下精炼后的编码器即 ALPS,配原封不动的第一阶段文本塔与图文投影。
核心创新有二。其一是几何条件化的跨视图自蒸馏:学生编码器从增强裁剪 A(面积 10%–40% 的局部裁剪或 40%–100% 的全局裁剪,加光度增强)提取特征,冻结的第一阶段教师从干净裁剪 B(40%–100%)提取目标 token;四层 transformer 预测器接收几何查询 $q_i = m + \mathrm{PE}(p_i) + W_r[\ln r, (\ln r)^2]$,其中 $p_i$ 是 B 中第 $i$ 个 patch 中心在 A 坐标系(以 patch 为单位)中的位置,$r = s_B/s_A$ 是相对尺度;预测器回归教师 token 的标准化版本 $\bar{z}$,损失只统计中心落在 A 内的 patch:$$\mathcal{L}_2 = \frac{1}{|V|}\sum_{i\in V}\left\| P(E(A), q_i) - \bar{z}_i^{\text{teacher}}(B) \right\|_2^2$$ 这与掩码预测不同:它在裁剪、尺度、外观变化下训练局部 token 保持一致,并与冻结教师对齐。其二是语言保持机制:ALPS 图文对齐采用线性投影后平均池化($v = \mathrm{norm}(\frac{1}{N}\sum_i W_{\text{img}} z_i)$),线性投影与平均池化可交换,局部 patch token 的零均值更新在池化后互相抵消,因此第二阶段即使不含任何语言约束,检索指标漂移也在 0.5 点以内——而 SigLIP 2 的非线性注意力池化和 CLIP 的类别 token 读出不具备这种结构。
方法步骤详情
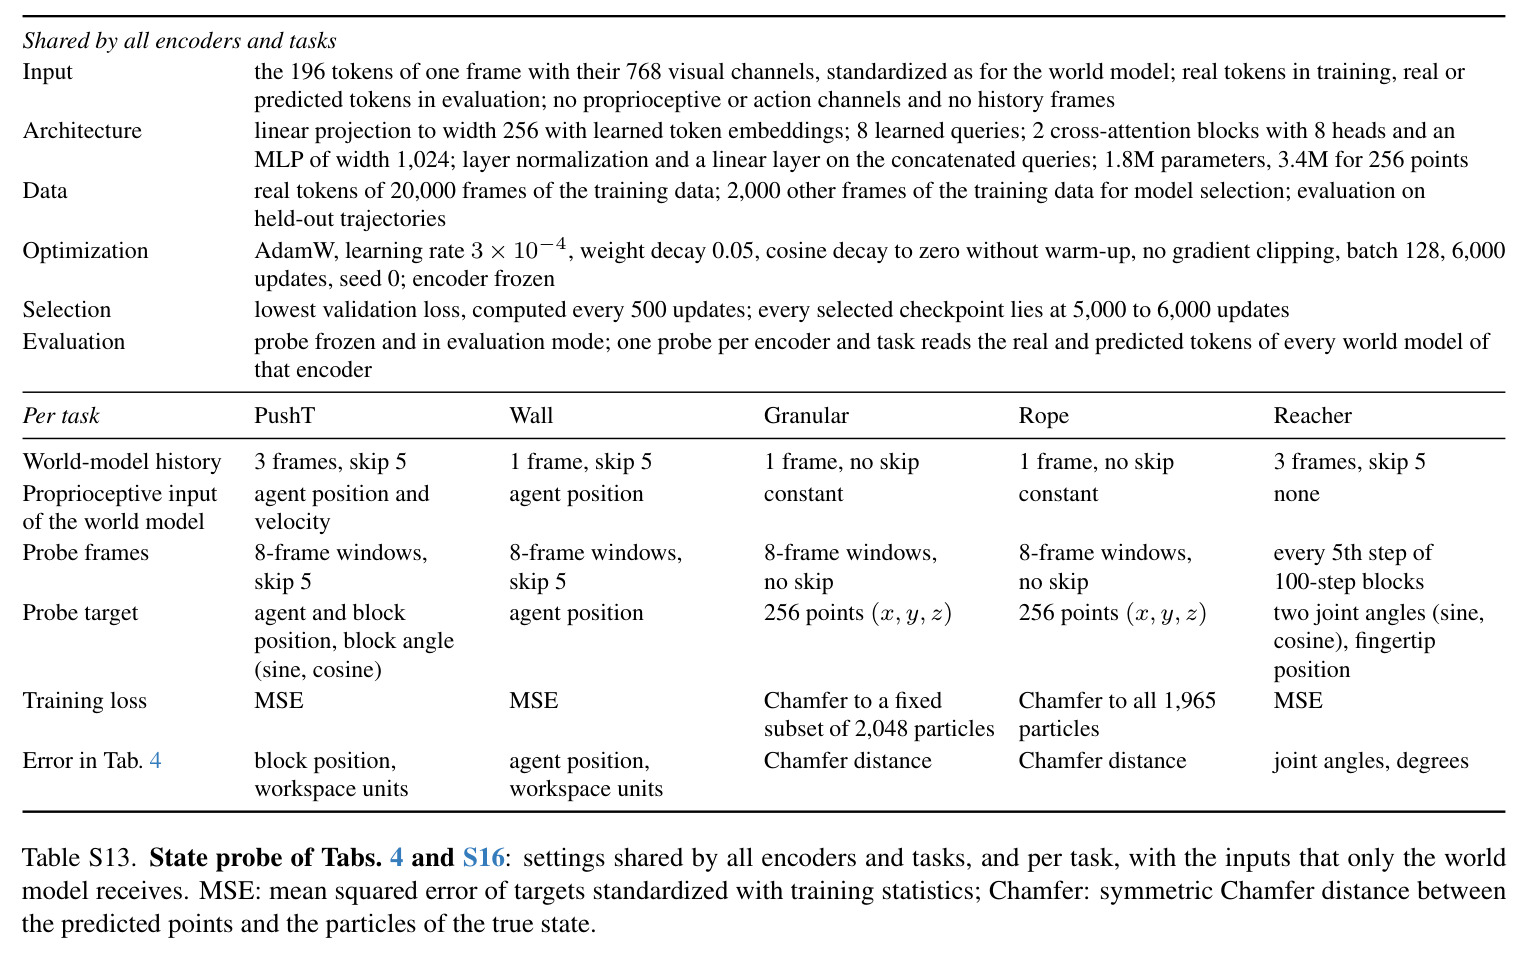
第一步,架构与数据:图像编码器 ViT-B/16(12 层、宽 768,固定正弦-余弦位置编码,无最终归一化层),文本编码器与字幕解码器均为 12 层 768 宽;训练数据为 DataComp-1B 的网络字幕加 LLaVA-LLaMA-3 生成的合成字幕(Recap 流程)。第二步,第一阶段多任务预训练:按上述 $\mathcal{L}_1$ 联合训练;重建目标对原始 token 与加噪副本 $\tilde{z} = z + 0.05\,\mathrm{rms}(z)\,\epsilon$ 各解码一次,$\mathcal{L}_{rec}=\rho(D(z),x)+0.25\,\rho(D(\tilde{z}),x)$;稠密对应把两视图 token 投影到 256 维做 InfoNCE,负例来自同图其他位置(权重 0.75)与其他图像(0.25);优化分两档——128px、批 32768、$w_{rec}=2$ 训 128 亿样本,224px、批 16384、$w_{rec}=1$ 训 10 亿样本。第三步,第二阶段跨视图精炼:学生与教师同初始化,教师冻结并预先按通道标准化 token;学生视图 A 以 0.5 概率取面积 10%–40% 的局部裁剪、否则取 40%–100% 的全局裁剪并加光度增强,教师视图 B 取面积 40%–100% 的干净裁剪;预测器(4 层、宽 512)为 B 的每个 patch 生成一个几何查询,先在查询间自注意、再交叉注意学生 token,输出回归标准化教师 token;若 B 中中心落入 A 的 patch 少于 16 个则重采样。训练 500 万样本(4883 步、批 1024),预测器学习率 $10^{-4}$、编码器 $10^{-5}$。第四步,丢弃预测器与辅助头(字幕解码器、稠密头、预训练解码器),保留精炼后的学生编码器,与第一阶段文本塔、图文投影一起构成 ALPS。
技术新颖性
与已有方法的本质区别:(1) 与 CLIP/SigLIP 的单一对比目标不同,ALPS 从预训练源头就让未归一化 patch token 同时承载四种互补监督,为第二阶段提供统一初始化;(2) 与 dino.txt 事后适配冻结主干、OpenVision 3 编码自编码器潜变量不同,ALPS 第二阶段的目标全部来自第一阶段自身的冻结副本,是纯粹的自我精炼,不需要任何外部视觉教师或视频数据;(3) 几何查询把已知裁剪几何(位置加相对尺度)显式注入预测器,监督集中在视图重叠区,相比 DINO 的多裁剪自蒸馏多了显式位置/尺度条件与标准化回归目标;(4) 机制层面的发现——"线性投影+平均池化"的语言读出与局部 token 更新可交换——是对"状态精炼为何不伤语言"的首个结构性解释,此前文献未指出;(5) 首次对十五个公开编码器在状态、语言、像素、控制、规划上做统一协议评测,评测协议本身就是社区贡献。
实验结果
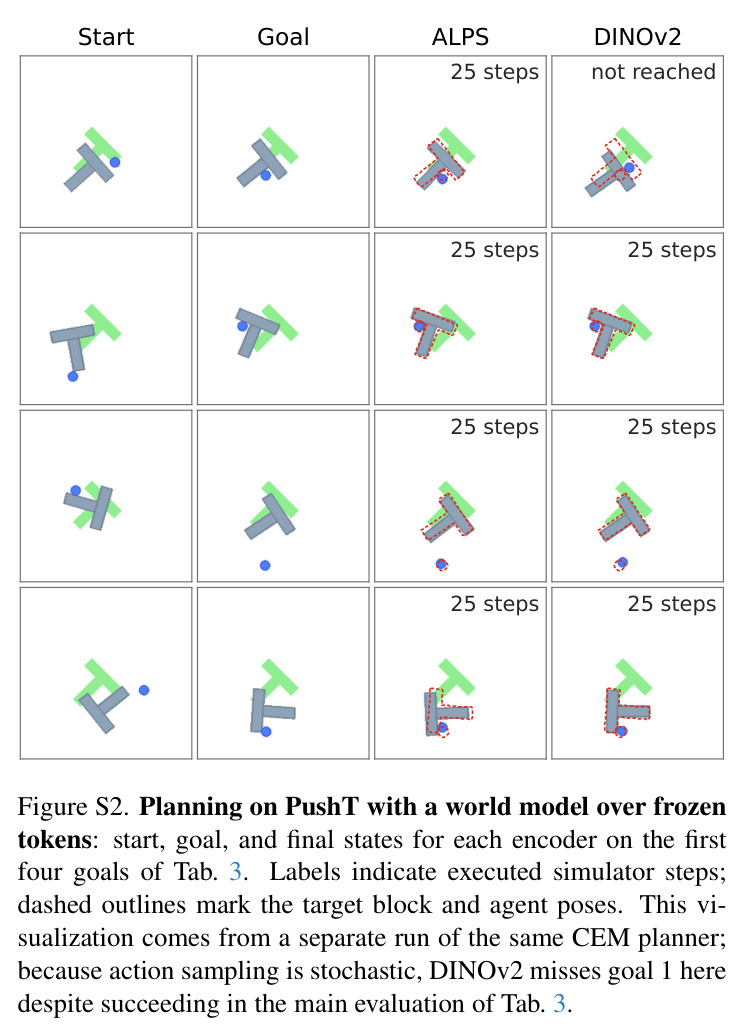
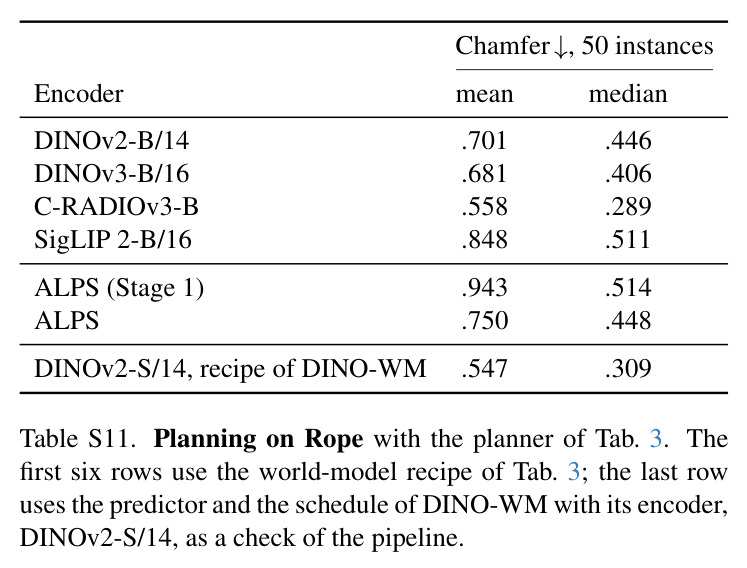
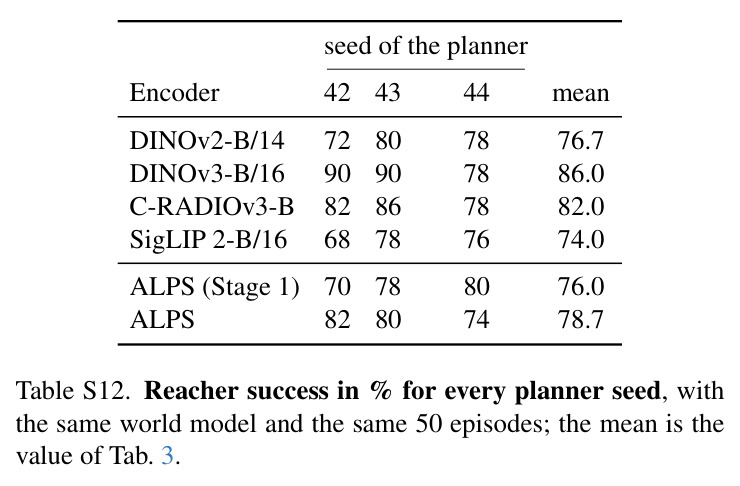
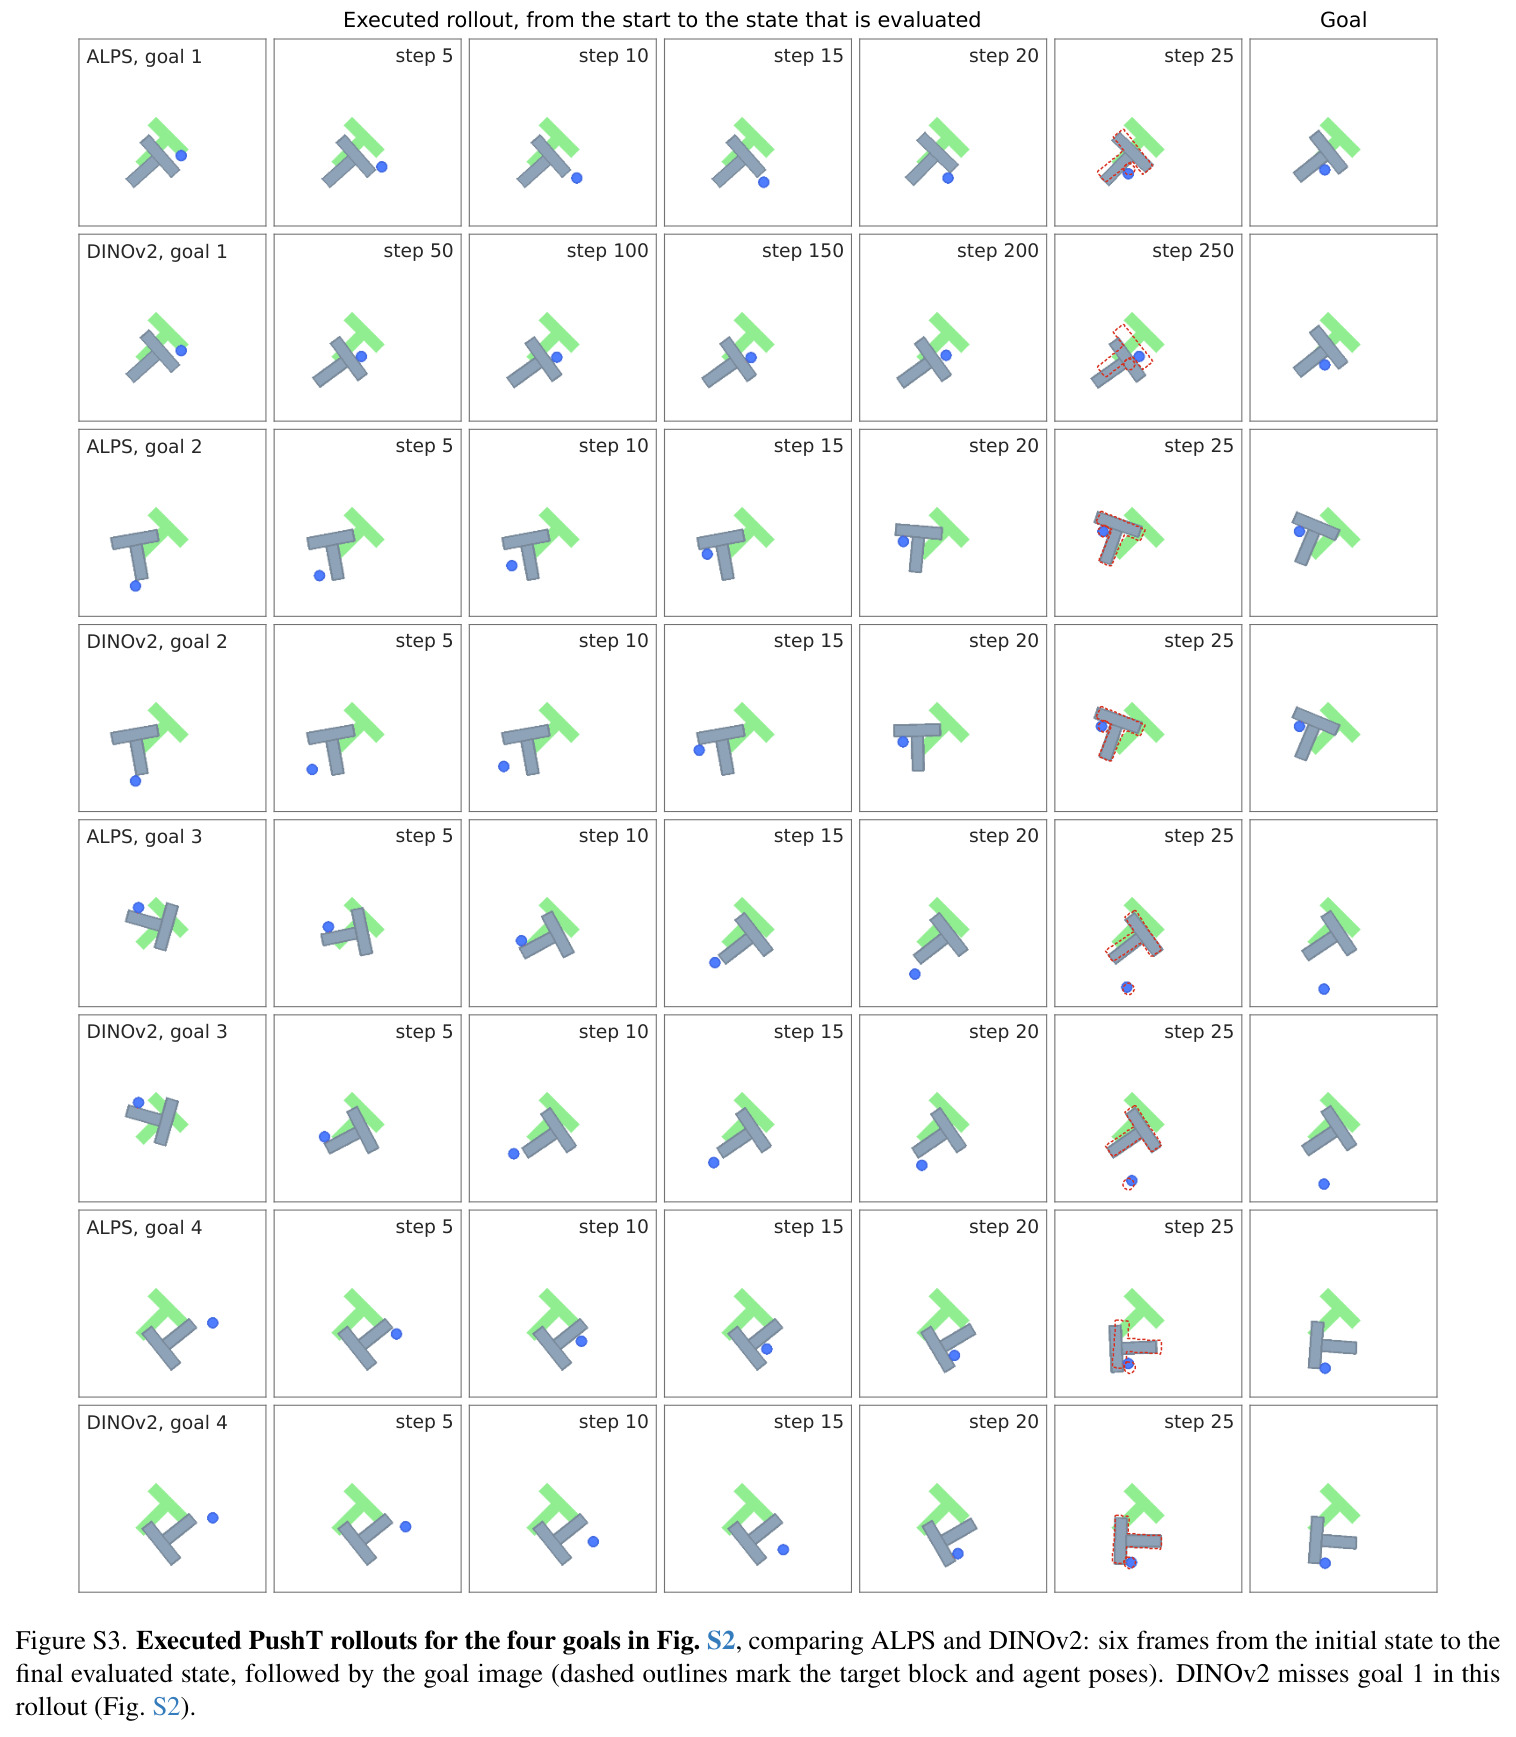
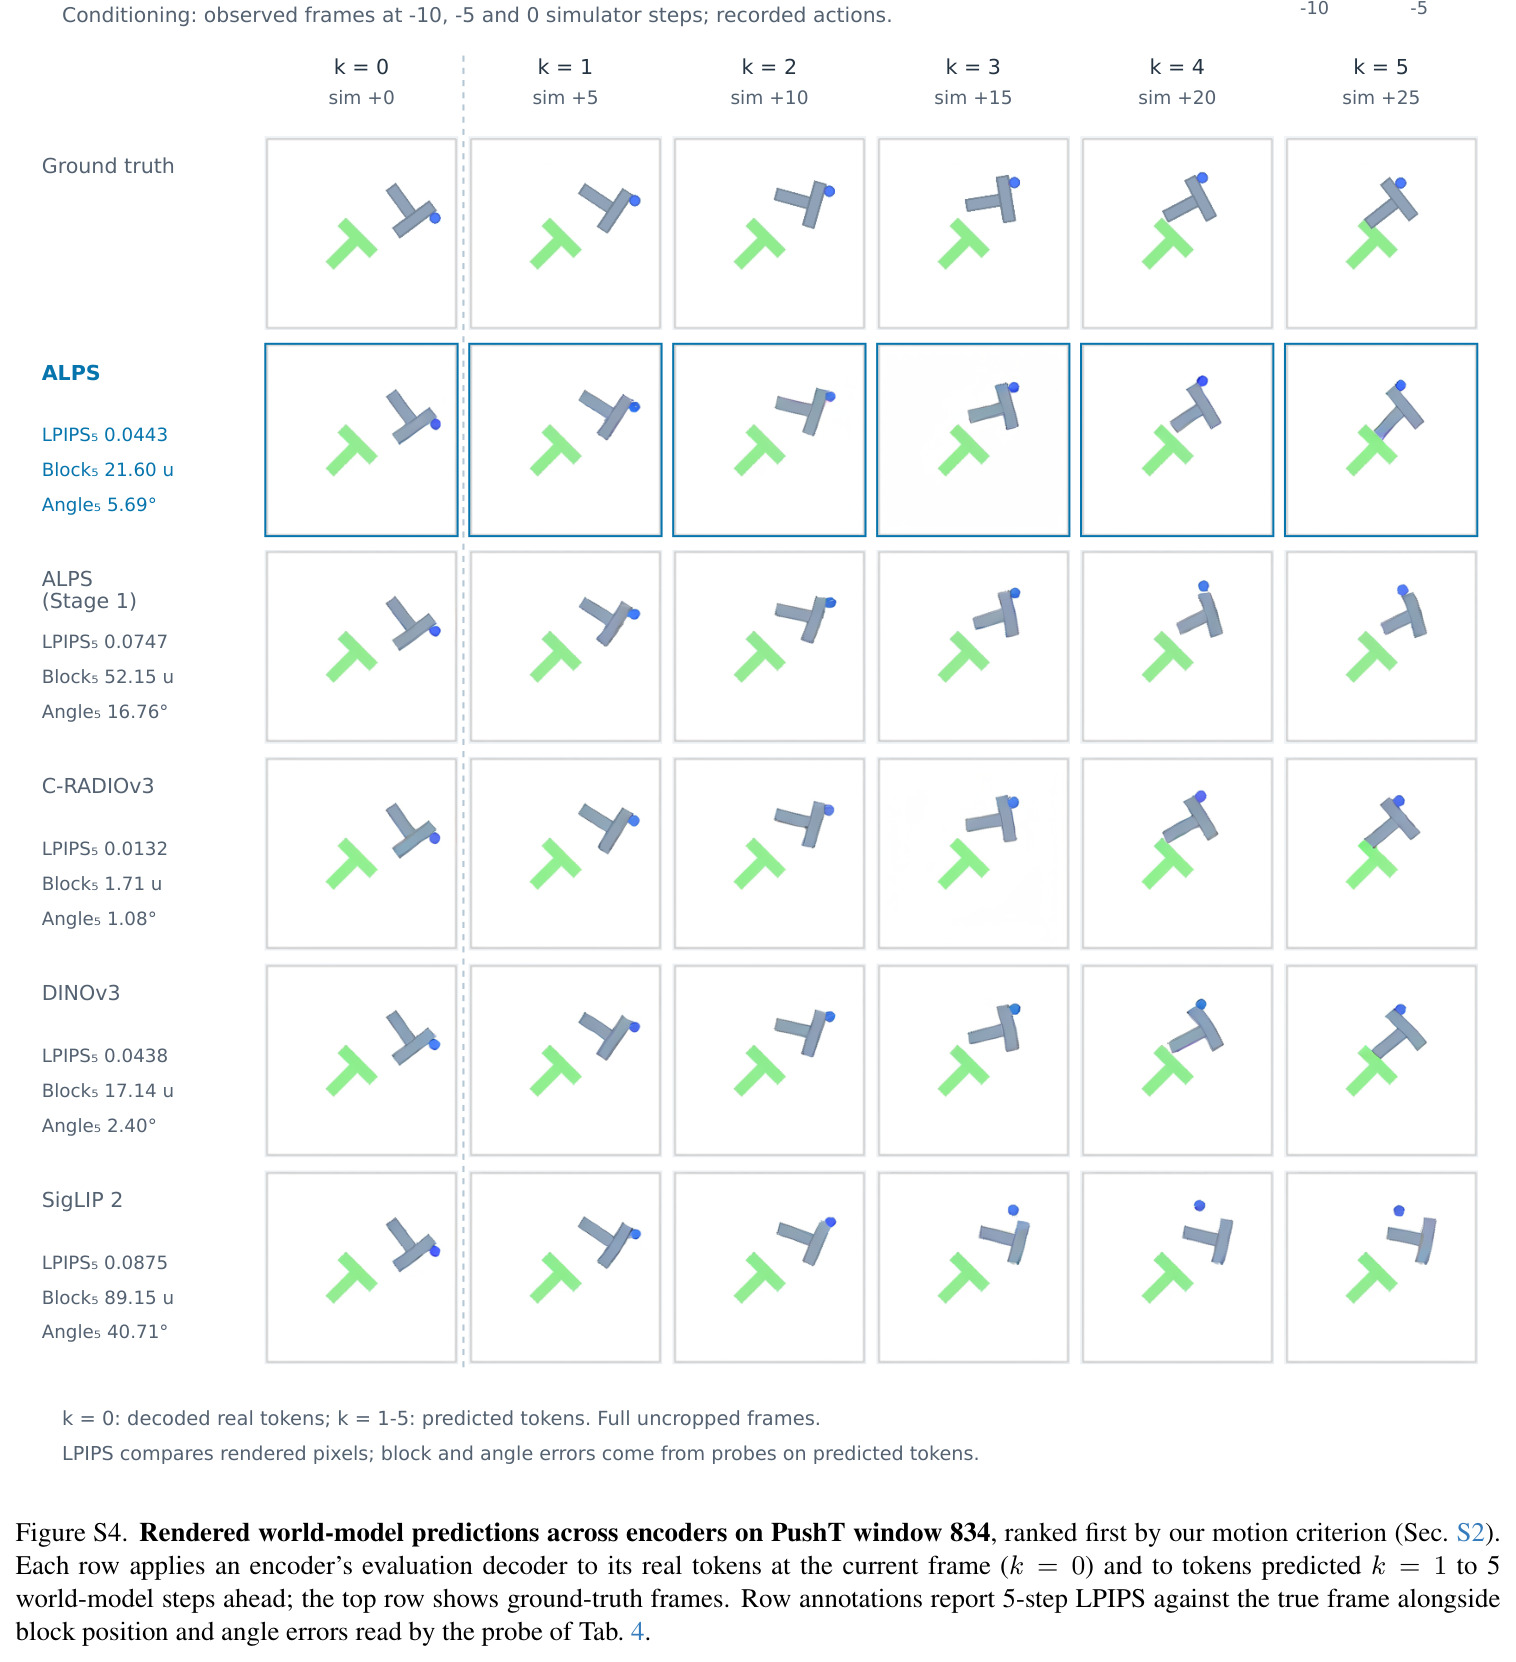
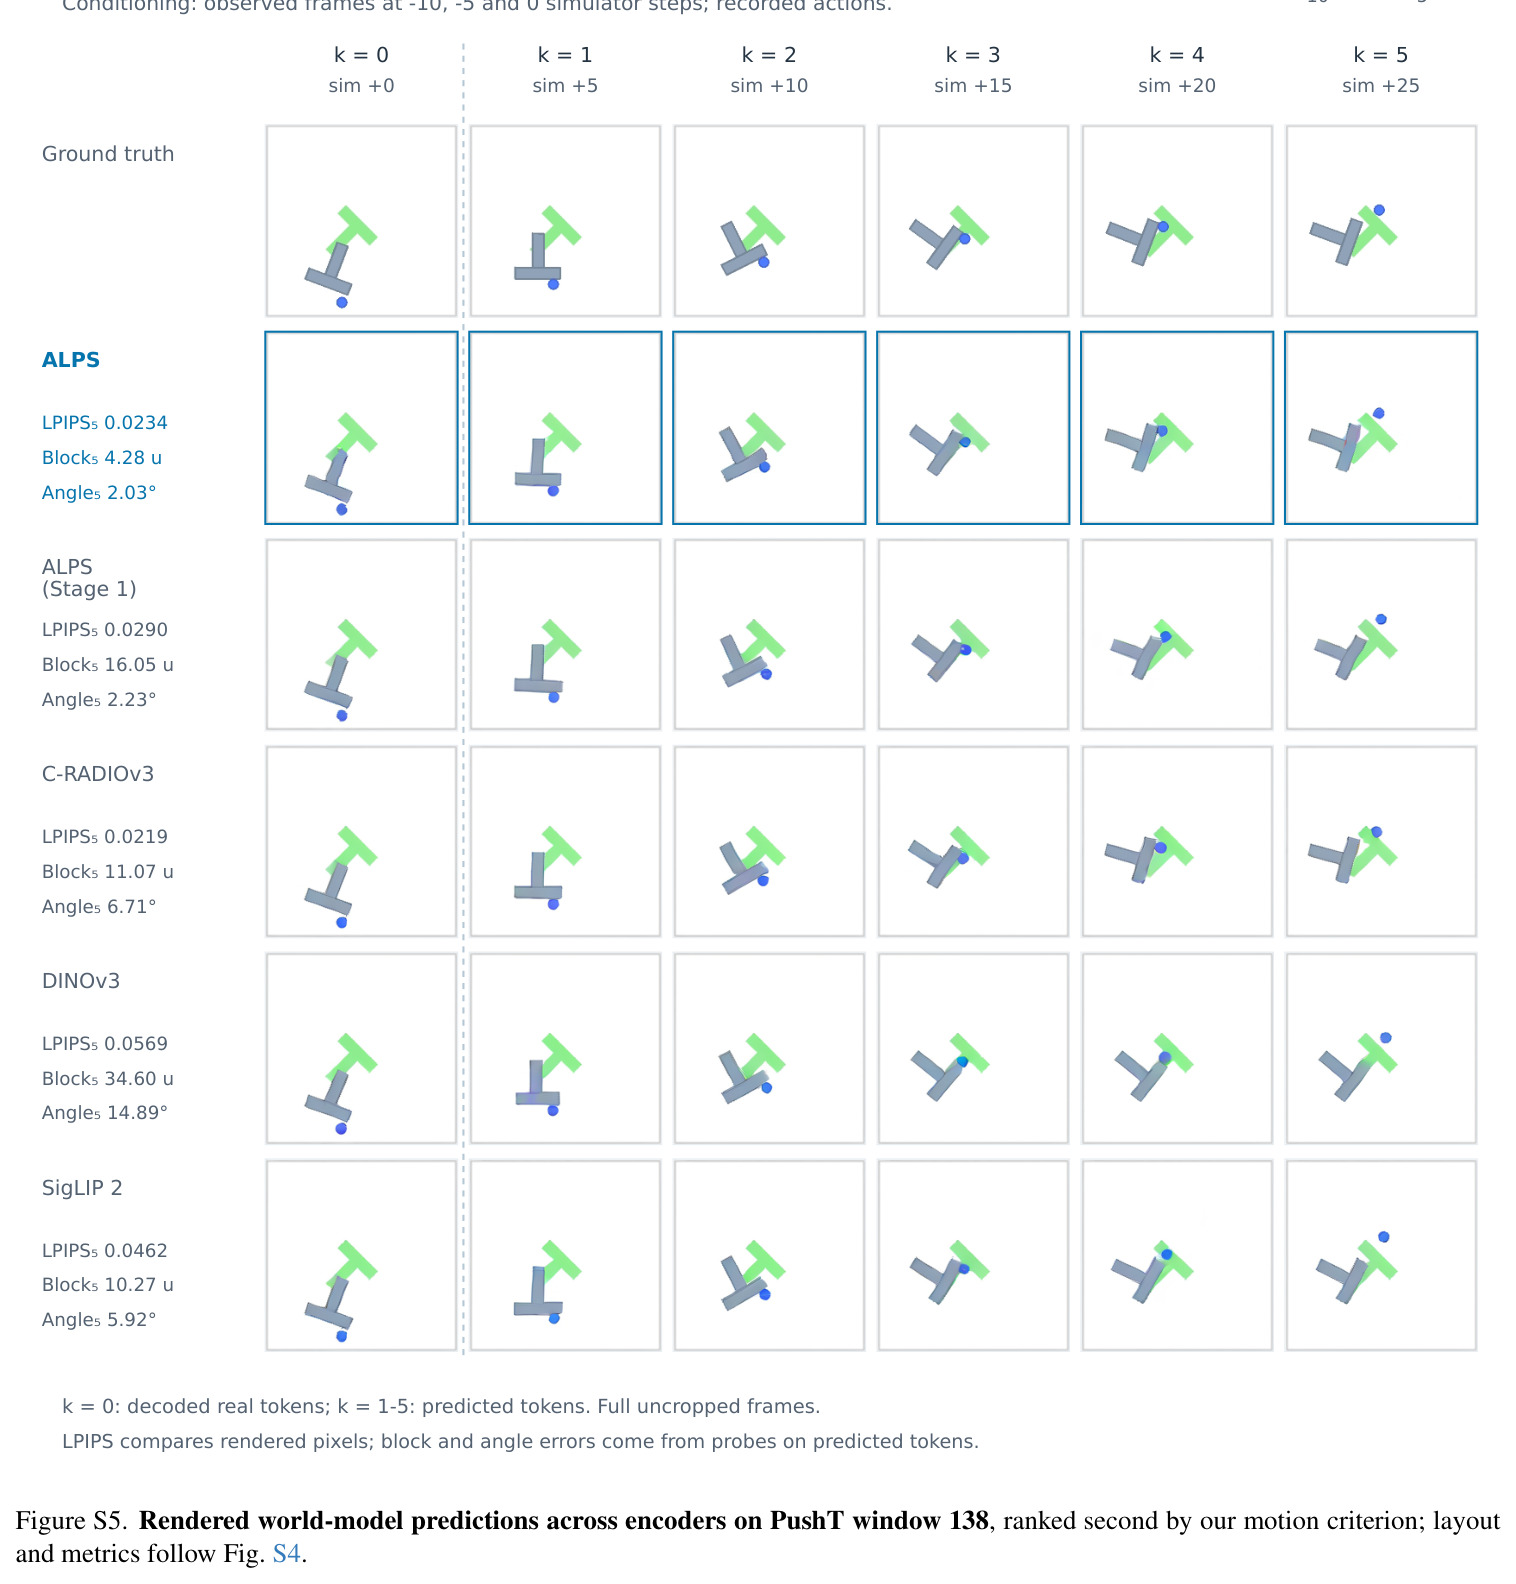
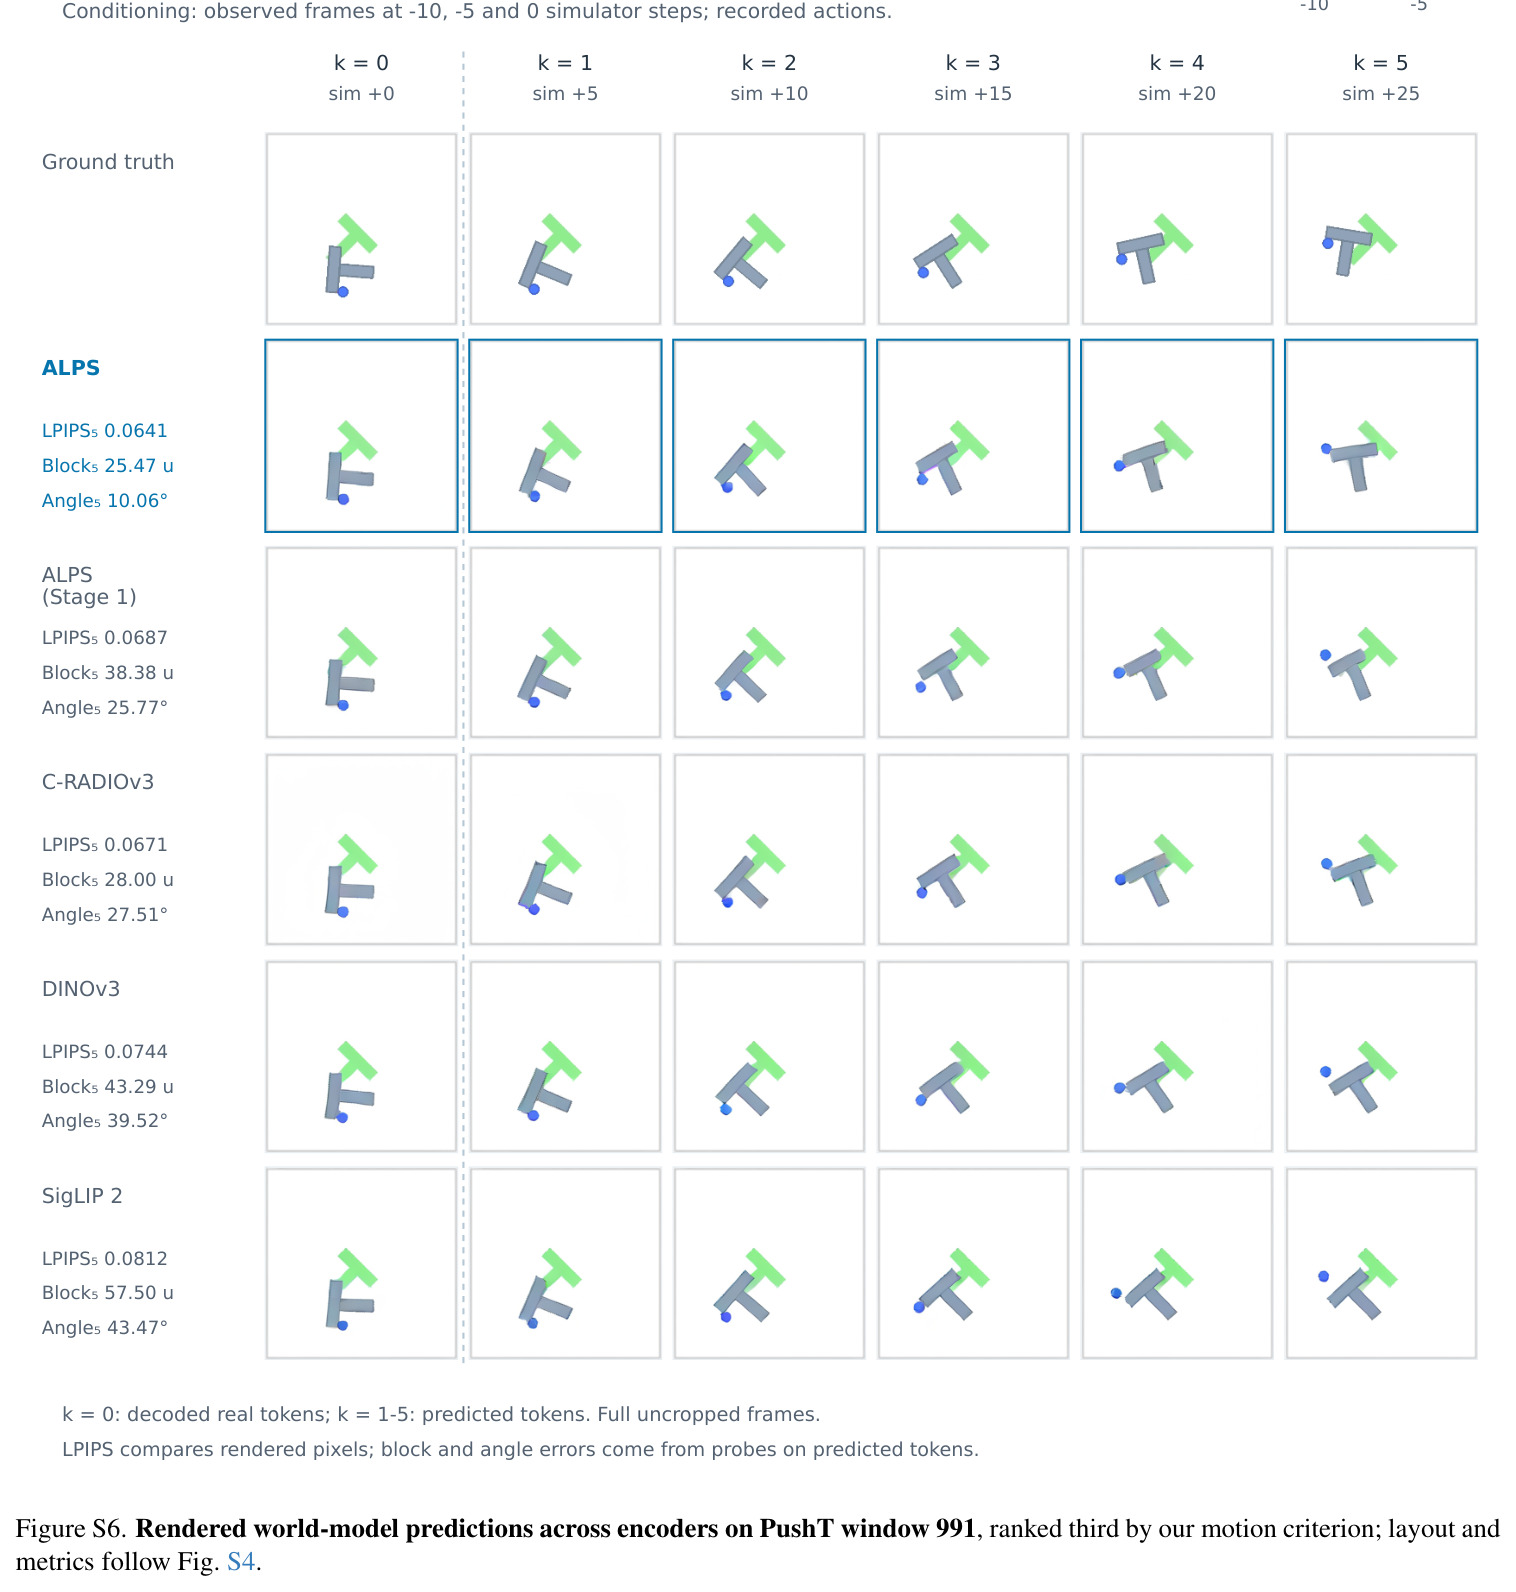
状态:LIBERO 状态探针(读出、+1 秒、+3 秒共 6 项平均的相对误差)上,ALPS 以 .829 取得 ViT-B 最低,优于 C-RADIOv3 (.864) 与 DINOv3 (.870),追平参数量 3.5 倍的视频编码器 V-JEPA 2-L (.829);三项设置 .842/.834/.813 全部最低,比 SigLIP 2 (1.160) 与 PE-Core (1.170) 低约 29%。V-JEPA 2-L 当前帧读出更准 (.741 vs .842),3 秒预测却更差 (.904 vs .813)。语言:Flickr30k I→T/T→I R@1 为 93.2/78.9、COCO 为 70.2/51.9,四项均距最佳不到 2 点;ImageNet 零样本 73.4,落后最强的 PE-Core (78.4) 5 点。像素:评测解码器下 ℓ1=.120、LPIPS=.372,较 C-RADIOv3 (.161) 低约 25%、较 DINOv3 (.196) 低约 39%;重建专精的 MAE (.109)、VC-1 (.106)、OpenVision 3 (.104) 略优但状态探针误差高 14%–22%;更强解码器下 ALPS ℓ1 .107 vs C-RADIOv3 .141(低 24%)。精炼:第二阶段把自身状态误差降 17%,DAVIS 视频分割 .456→.533,检索漂移≤0.5 点;同配方下 SigLIP 2 状态误差 1.160→.893 但 ImageNet 掉 4.3、Flickr30k 掉 7.5、COCO 掉 11.4 点,CLIP 掉 10.2/10.9/11.8 点。控制:LIBERO 行为克隆策略(每任务 50 条演示)BERT 指令下 83.4% 最佳,换原生文本塔升至 85.5%(SigLIP 2 84.8%),LIBERO-Spatial 76.8%→86.5%。规划与预测:PushT 90%、Wall 92% 并列最佳,Granular Chamfer .324→.176 最佳;Reacher (78.7%) 与 Rope (.750) 逊于 DINOv3 (86.0%) 与 C-RADIOv3 (.558);五步预测状态误差较第一阶段降 28%/17%/13%/11%(PushT/Reacher/Granular/Rope);PushT 预测渲染 LPIPS .020,仅次于 C-RADIOv3 (.018)。消融:去掉重建目标 ℓ1 从 .113 恶化至 .194/.200(+72%/78%),去掉重建或字幕使状态误差降 8.5%/4.3%,去掉稠密对应使跨视图 patch 匹配降 6.0 点(37.4%→31.4%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO 状态探针(6 项设置平均) | 相对位置误差 ↓ | .829 | 最佳公开 ViT-B:C-RADIOv3 .864;参考:SigLIP 2 1.160、V-JEPA 2-L .829 | ViT-B 中最低;较 SigLIP 2 低约 29%;以 3.5 倍更少参数追平视频编码器 V-JEPA 2-L |
| Flickr30k 图到文检索 | Recall@1 ↑ | 93.2 | 最佳:OpenVision-B 94.5;SigLIP 2 91.7、PE-Core 93.9 | 距最佳 1.3 点;第二阶段精炼后仅降 0.2 点,而 SigLIP 2 同配方掉 7.5 点 |
| 像素重建(统一评测解码器) | ℓ1 误差 ↓ | .120 | C-RADIOv3 .161、DINOv3 .196、CLIP .291;重建专精模型 MAE .109 | 较 C-RADIOv3 低约 25%、较 CLIP 低约 59%;更强解码器下 .107 vs .141(低 24%) |
| LIBERO 策略(原生文本塔指令) | 平均任务成功率 ↑ | 85.5% | SigLIP 2 84.8%、C-RADIOv3 81.8%、CLIP 79.2% | 全场最高;BERT 指令下亦最高(83.4%);三次运行平均比 BERT 提升 3.1 个点 |
| PushT / Wall 世界模型规划 | 成功率 ↑ | 90% / 92% | PushT 与 C-RADIOv3 并列;Wall 与 DINOv2 并列 | 并列最佳;Granular Chamfer .176 为单独最佳(第一阶段为 .324) |
局限与改进
作者承认的局限:只在 ViT-B/16 与仿真基准(LIBERO、DINO-WM 环境和 Reacher)上做受控比较,未验证更大规模和真机部署;两阶段课程是必要妥协,能否合并为单阶段训练仍是开放问题;预训练完全没用视频与交互数据,对细粒度时序动作不够敏感(尽管 DAVIS 跨帧对应从 .456 升至 .533)。我的补充观察:(1) 状态探针误差以第一阶段编码器归一化,便于内部公平比较,但削弱了与外部论文的横向可比性;(2) ImageNet 零样本落后 PE-Core 5 点(73.4 vs 78.4),作者归因于合成字幕与类名提示的分布差异,但未给出混合监督的补救实验;(3) 世界模型想象的渲染保真度(PushT 五步 LPIPS .020)仍略逊 C-RADIOv3 (.018),像素接口离生成级质量还有差距;(4) Reacher/Rope 等精细时序任务不敌专用编码器,暴露静态图像预训练的动力学上限;(5) 第二阶段数据取自公开图像编辑数据集这一选择颇为特别——换成 DataComp 网络图会使状态误差变差(.886 vs .829),但为什么编辑数据更好只有场景内容与原生分辨率的初步分析,缺系统性研究。
独立分析的弱点
弱点一:分类/零样本识别偏弱(ImageNet 73.4 vs PE-Core 78.4),对以识别为主的应用不够友好;改进方向是在字幕分布中混入短类名提示,或在第二阶段加轻量对比正则。弱点二:两阶段流程复杂且总样本量达 138 亿,工程与算力成本高;可探索单阶段交替训练、目标权重课程或周期性自蒸馏替代显式两阶段。弱点三:静态图像预训练缺乏动力学先验,Reacher(关节角误差 1.18 度 vs DINOv3 的 1.03)和 Rope(Chamfer .750 vs C-RADIOv3 的 .558)落后;改进方向是把第二阶段扩展到视频或交互数据,用动作条件化的跨帧自蒸馏弥补时序短板。弱点四:想象的渲染质量略逊 C-RADIOv3(LPIPS .020 vs .018),且评测解码器只有 7.4M 级轻量结构;可为像素接口配置更强的生成式解码器(如扩散头)。弱点五:状态探针只覆盖可移动物体的位置/朝向/谓词,对关节、接触力等更丰富的物理量没有检验;状态信息的"覆盖面"证据还比较窄。
未来方向
作者提出的方向:把骨干扩展到更大规模并做真机部署验证;将跨视图精炼延伸到视频与交互数据,使编码器获得动作与时间感知;把第二阶段合并进单阶段训练;将状态、语言、像素解码整合为一个语言引导、像素可验证的规划器。基于本文成果可延伸的研究:用 V-JEPA 2 等视频模型做跨模态蒸馏教师,在保留语言接口的同时注入动力学先验;把像素接口用于世界模型的想象校验——策略先在解码出的未来帧上做视觉一致性检查再执行动作;以 ALPS token 作为 VLA(视觉-语言-动作)大模型的视觉骨干,检验原生文本塔能否简化指令注入;在状态探针中加入接触、关节、力等物理量,系统刻画"视觉状态信息"的边界。
复现评估
开源情况很好:项目页 ucsc-vlaa.github.io/ALPS,代码在 github.com/UCSC-VLAA/ALPS,权重在 huggingface.co/UCSC-VLAA/ALPS;附录 S1/S2 给出完整超参(优化器、批大小、学习率、裁剪与增强设置、数据配方)。数据全部公开:DataComp-1B 与 Recap 合成字幕流程(LLaVA-LLaMA-3),第二阶段所用图像编辑数据集均为公开来源。算力方面,完整第一阶段(128 亿样本@128px、批 32768,再加 10 亿样本@224px、批 16384)需要大规模多节点集群,小团队难以复现;但第二阶段仅 500 万样本、4883 步、批 1024,单机多卡即可完成。评测协议清晰且便宜:状态探针仅 2.5M 参数、评测解码器在 1.9 万张 ImageNet 验证图上训练、LIBERO 每任务 50 条演示训练策略。总体判断:直接用发布权重做下游研究和复现 Stage 2 容易(难度低到中),完整复现 Stage 1 预训练则需要可观算力预算(难度高)。
论文图表
(a) 概念示意:ALPS 一个冻结编码器提供状态、语言、像素三个接口,一组共享 patch token 支持全部三种用途。(b) 把 Table 1 中每个编码器放在 LIBERO 状态探针误差、Flickr30k I→T R@1、重建 ℓ1 三个轴上的条形对比图(条形方向统一为越长越好,n/a 表示未发布文本塔)。
一图看懂论文核心论点:十五个现有编码器没有一个能在三项能力上同时与 ALPS 抗衡,空间/自监督编码器缺语言、图文编码器状态误差高、重建编码器状态也偏弱,只有 ALPS 三项均衡。