RealMe:从极少拍摄生成沉浸式2K体积视频 RealMe: Immersive Volumetric Video from Minimal Captures
用高分辨率视频扩散模型把稀疏低清拍摄增强为2K、4D一致的视频,再重建体积视频
前置知识
体积视频与自由视点渲染
体积视频是用多个同步相机从不同视角同时拍摄动态场景,重建出随时间变化的3D表示(如4D高斯、动态神经场),观看者可在任意虚拟机位自由环绕回放画面,是元宇宙、远程呈现、VR/AR与游戏的有效媒介。重建质量高度依赖相机数量、分辨率与标定精度,传统方案需要密集受控的多相机阵列。
本文的最终产物就是体积视频,全文围绕'如何用极少的相机拍出原本需要密集相机阵列才能达到的质量'展开,理解这一应用背景才能明白各模块的设计动机与评测协议。
4D高斯泼溅(4DGS)与FTGS
4DGS用随时间变化的3D高斯基元表示动态场景,通过可微光栅化直接优化,支持实时新视角渲染。FTGS(FreeTimeGS)进一步允许高斯基元在任意时刻、任意位置自由放置,是当前高质量体积视频重建的代表方法之一。
RealMe的粗重建初始化、条件视频渲染以及最终体积视频输出全部建立在FTGS之上;论文中'8路原始视角+40路生成视角共同监督4DGS'的重建流程,需要理解4DGS的优化机制才能读懂。
潜空间扩散模型与流匹配
现代扩散模型先用VAE把图像/视频压缩到低维潜空间,再用扩散Transformer(DiT)逐步去噪。流匹配(flow matching)用线性插值 $z_\tau = (1-\tau)z_0 + \tau z_1$ 构造数据-噪声路径,训练网络预测速度场 $(z_1 - z_0)$,比传统DDPM训练更稳定高效。
RealMe的生成核心是把14B的FLUX.1图像扩散模型改造成视频扩散模型,其训练目标就是流匹配损失加潜空间频率损失,公式(6)(7)(9)(10)的理解都依赖这一背景。
ControlNet与LoRA微调
ControlNet是给预训练扩散模型加条件的旁路网络,从预训练权重初始化,向主干逐块注入条件残差;LoRA在冻结权重旁挂低秩矩阵,只训练极少量参数即可适配新任务。二者结合可在数据与算力有限时,把图像模型高效改造为条件视频模型。
RealMe训练时只更新ControlNet分支和部分DiT模块上的rank-32 LoRA,VAE、文本编码器与其余DiT权重全部冻结,这是理解其训练成本(8张H100训96小时)与实现细节的关键。
旋转位置编码(RoPE)
RoPE通过对token的位置索引施加旋转变换,使注意力得分只依赖相对位置,天然支持长度外推。FLUX原本用三轴位置ID描述单张图像的token(一个轴固定为图像标识,另两轴是潜网格坐标)。
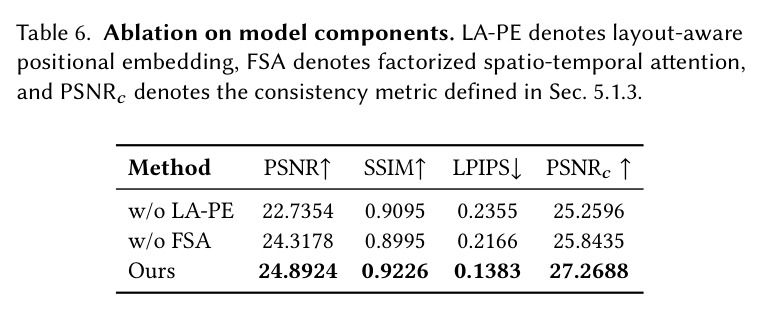
RealMe把位置ID从3轴扩展为(时间 $t$、视角 $s$、网格 $u,v$)4轴并对每轴分别做RoPE后拼接,这是其'布局感知位置嵌入'的核心实现;消融表6显示去掉它PSNR_c下降约2 dB。
PSNR/SSIM/LPIPS与TWE指标
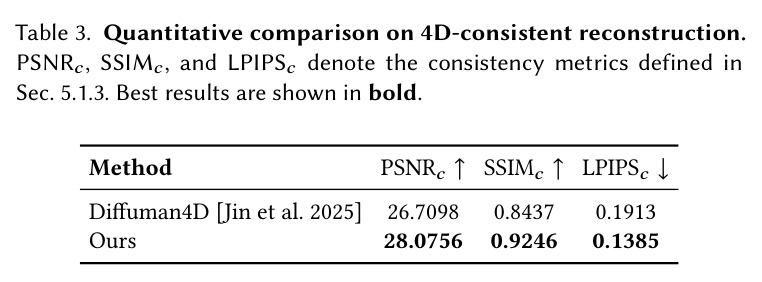
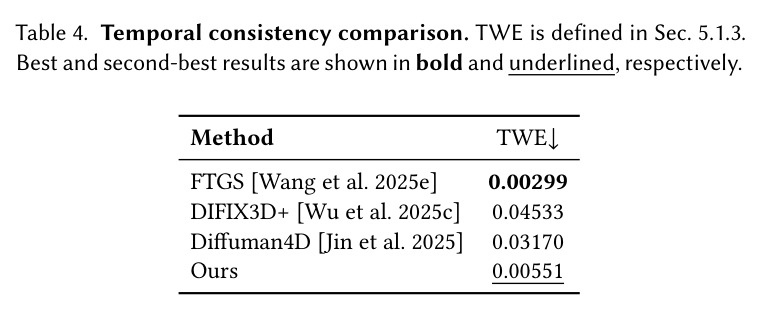
PSNR衡量像素级保真度(dB,越高越好),SSIM衡量结构相似性(0-1),LPIPS用深度特征衡量感知差异(越低越好)。TWE(Temporal Warping Error)基于光流衡量相邻帧扭曲后的残差,评估时间稳定性;下标c的一致性指标(如 $\mathrm{PSNR}_c$)衡量增强视频与用其重建的4DGS渲染之间的吻合度。
论文所有对比与消融都用这些指标量化,理解指标含义才能正确解读表格中27.27 dB、LPIPS 0.1621、TWE 0.00551等数字,以及一致性指标'自洽性验证'的本质。
研究动机
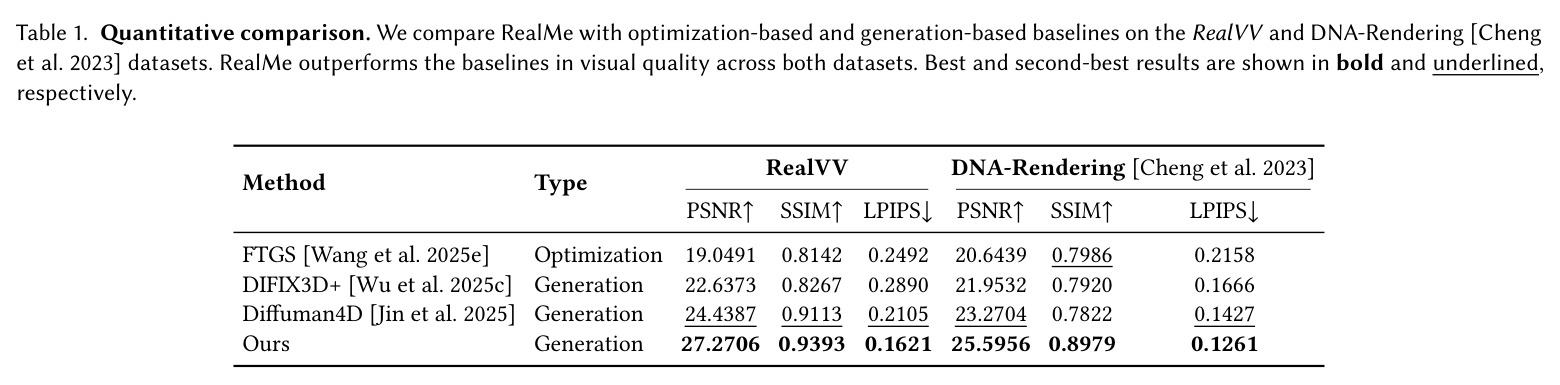
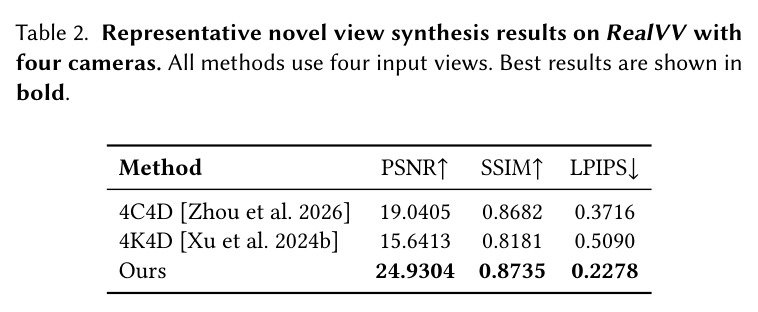
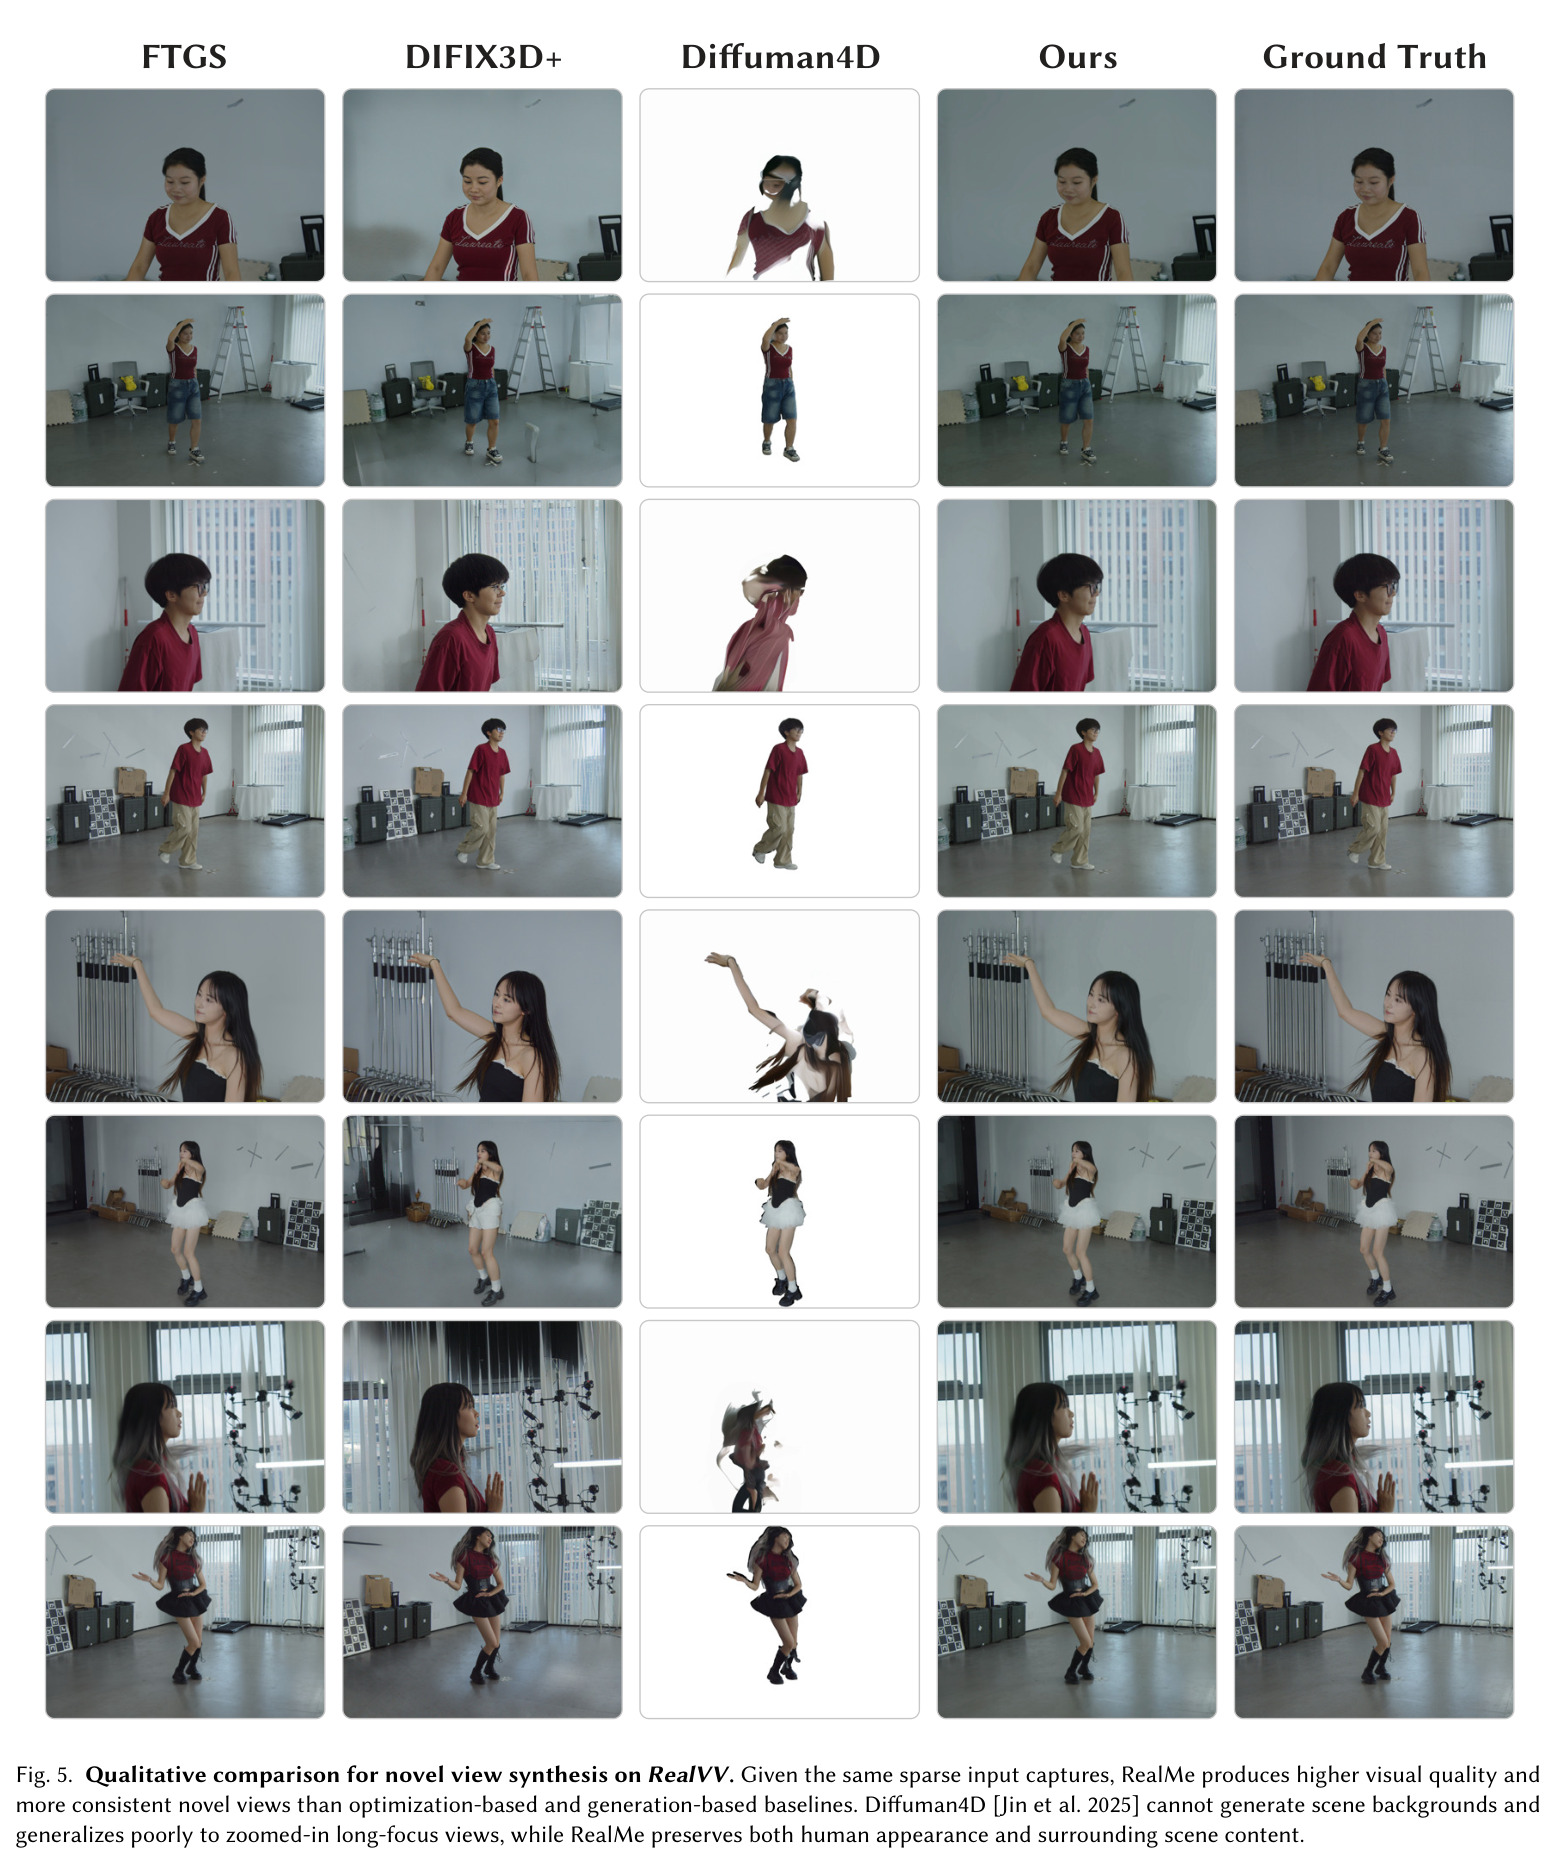
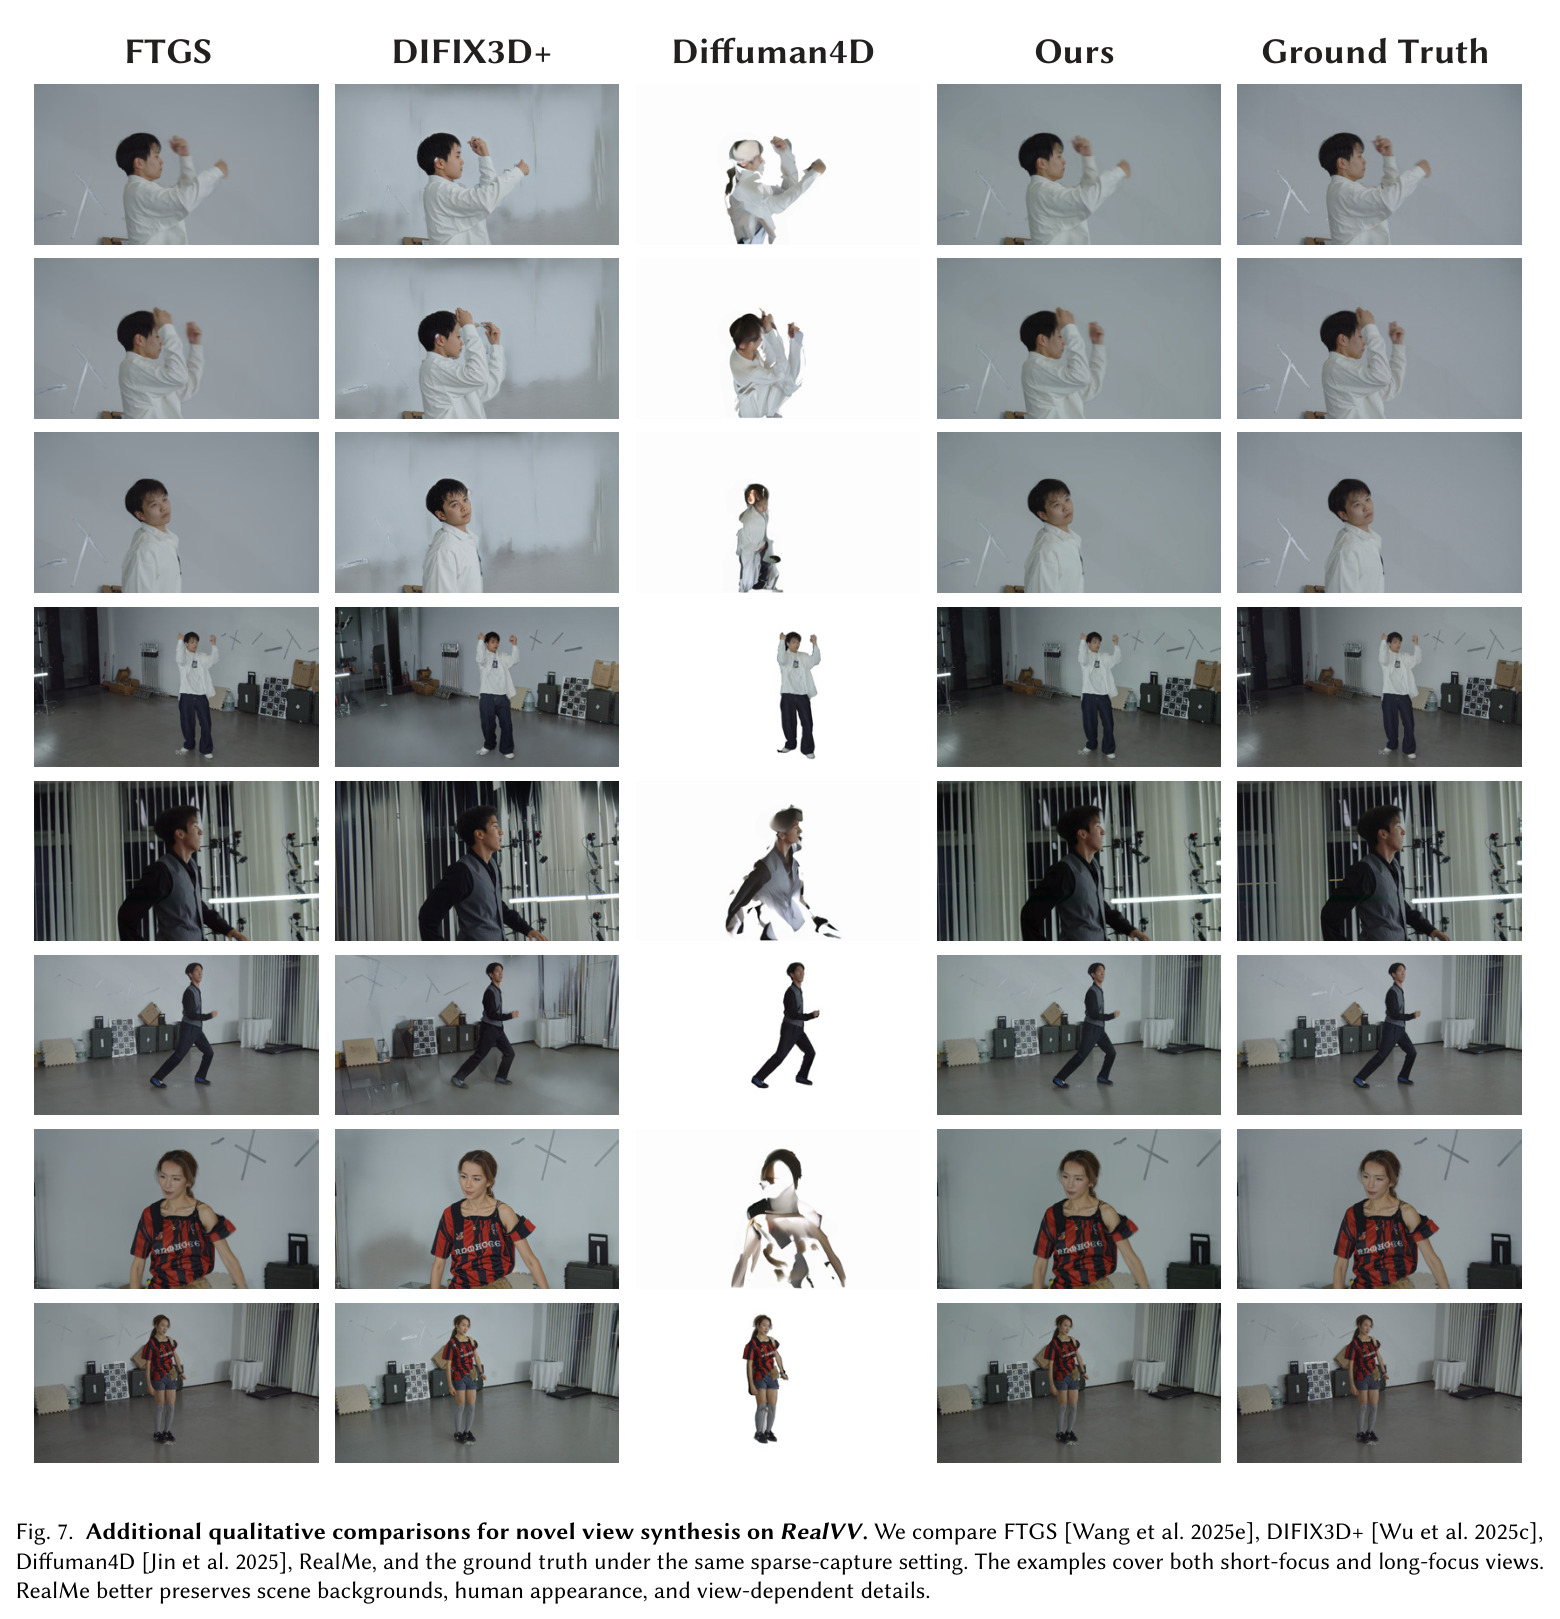
高质量体积视频通常依赖密集、受控的多相机阵列:以论文自采的RealVV数据为例,单序列就有48~80个视角、每视角300帧。当拍摄条件受限——比如只有8个空间分布的720p相机——直接用FTGS这类优化式4DGS方法重建时,未见区域和视角相关外观缺乏约束,RealVV上新视角PSNR仅19.05 dB、LPIPS 0.2492;四相机设置下4K4D更是掉到15.64 dB、LPIPS 0.5090。另一类做法用生成模型补全缺失观测,但现有视频扩散骨干原生分辨率普遍低于1K,满足不了2K体积视频管线的需求;且逐视角独立生成(如DIFIX3D+)忽略多视角关联,造成跨视角外观漂移与几何错位,两阶段流水线还会误差累积——DIFIX3D+在RealVV上LPIPS反而劣化到0.2890。
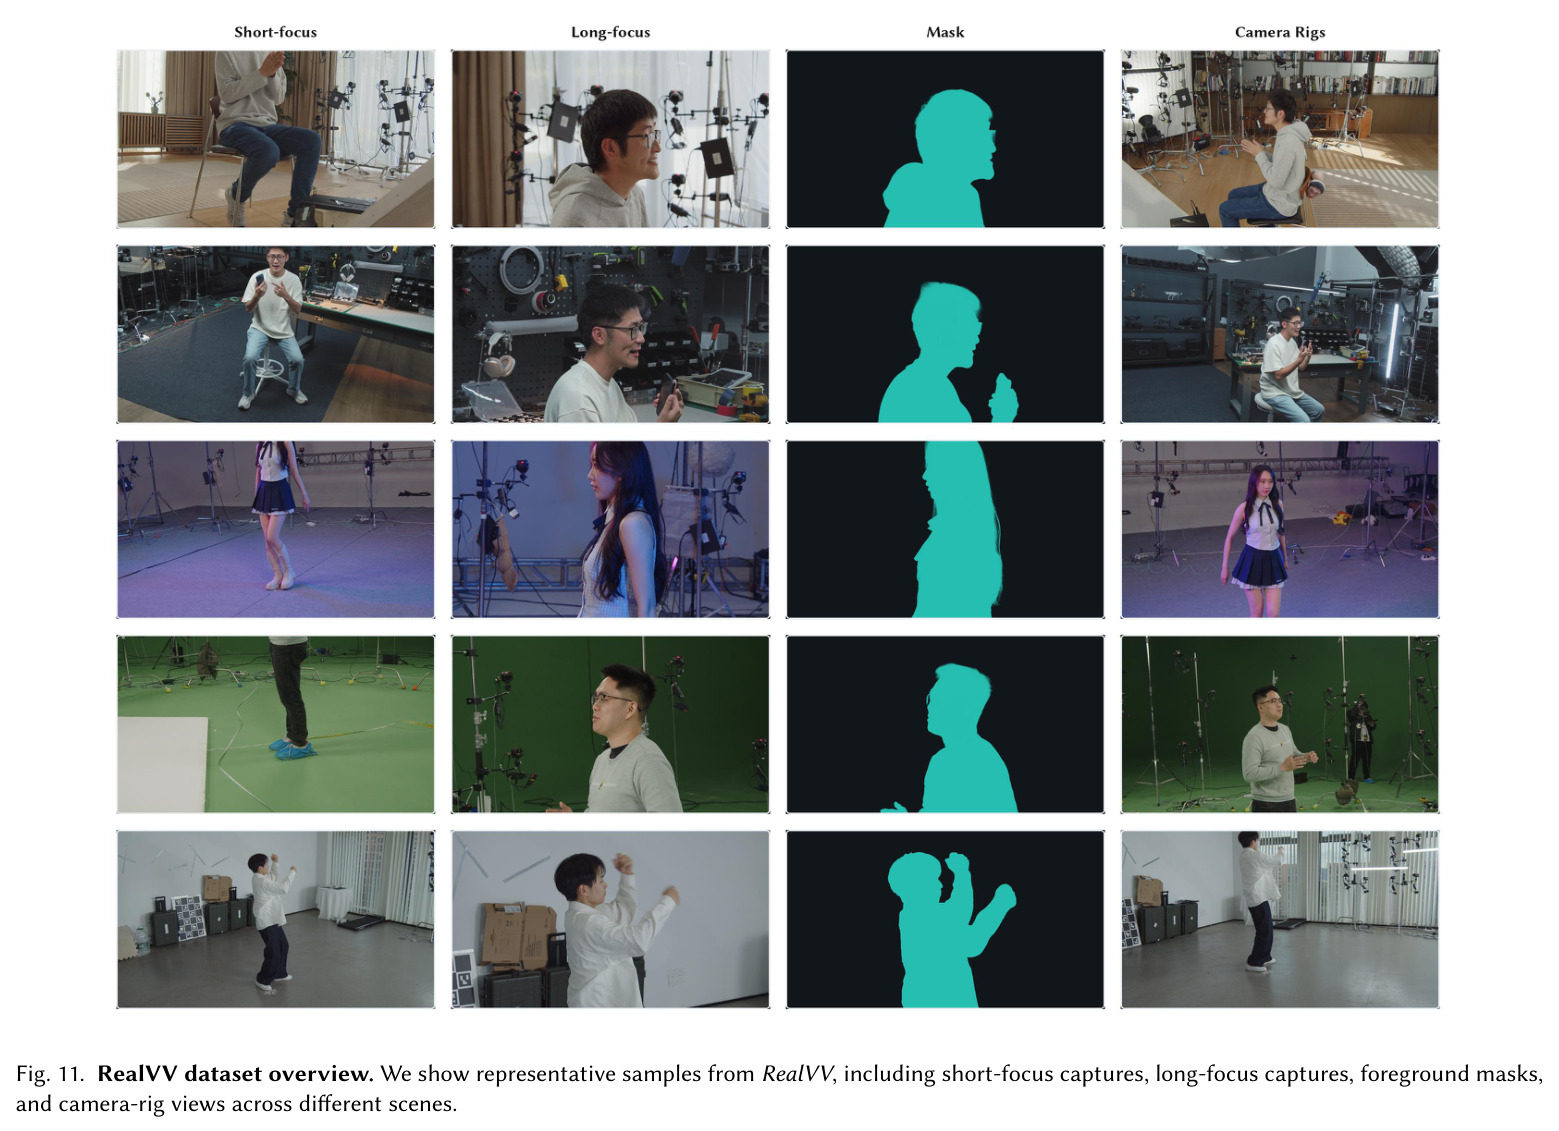
本文的目标是本文要构建一个统一的4D增强框架RealMe:给定稀疏(如8视角)且低质量(如720p)的拍摄视频,先用高分辨率视频扩散模型将其增强为2K(2560×1440)分辨率、时间与多视角一致的增强视频,再与原始拍摄一起优化4D高斯表示,重建出可自由视点渲染的体积视频,使其视觉质量与4D一致性逼近密集拍摄的效果;同时贡献自采的RealVV多视角数据集与完整评测协议,推动稀疏拍摄条件下体积视频的可比评测。
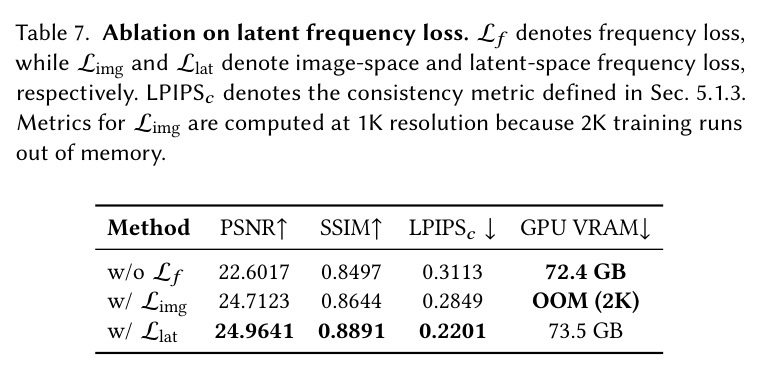
与已有工作不同的是,已有工作的切入角度要么是更强的重建先验(稀视角4DGS、人体结构先验),要么用视频模型补帧率或修复单体视频流。RealMe的独特之处是三点组合:(1)选14B高分辨率图像扩散模型FLUX.1 [dev]而非低分辨率视频模型做骨干,走'改造图像模型为多视角视频模型'的路线,绕开视频骨干1K分辨率天花板;(2)提出布局感知4D位置编码与面向采样组的分解式时空注意力,让去噪过程按'相机-时刻'布局结构化传播信息,而非扁平token的全注意力;(3)提出潜空间频率损失,在latent域做FFT频域监督弥合生成视频与真实拍摄的数据差距,同时规避图像域2K监督的显存爆炸(表7显示图像域在2K下OOM)。
核心方法
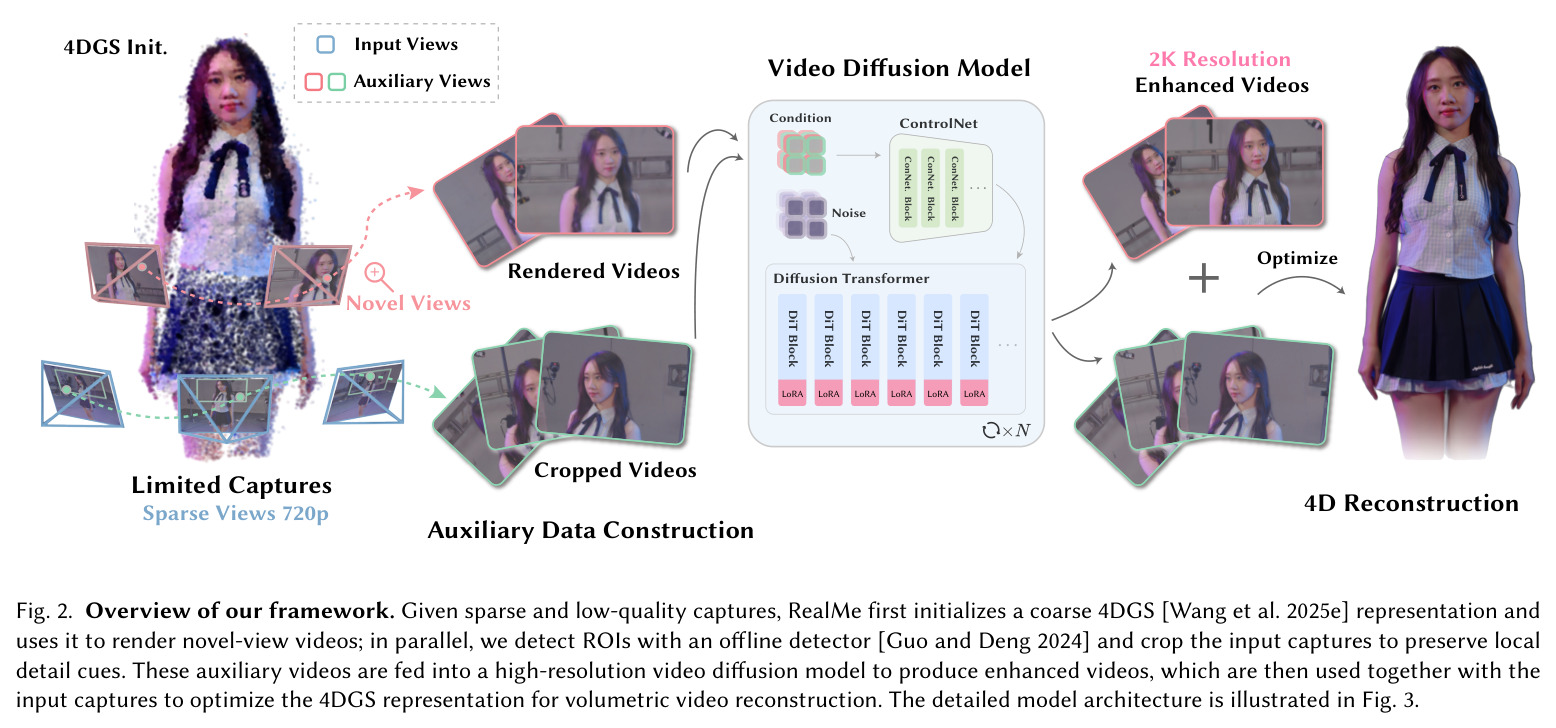
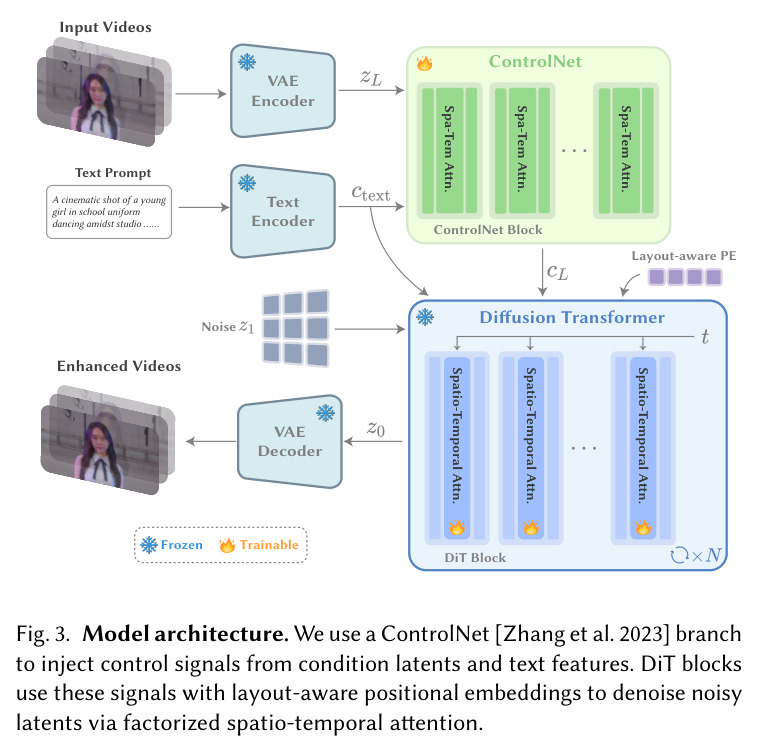
直觉上,稀疏低清拍摄虽信息不足,仍包含场景结构与运动动态的线索,值得先'榨干'再交给生成模型补全。技术路线分四步:第一步辅助数据构造——用稀疏输入拟合粗4DGS $G_c$,沿插值相机轨迹渲染 $N_v$ 个新视角视频 $V_{nv}=\mathrm{Render}(G_c, P_{nv})$,提供近似多视角几何引导;同时用离线检测器检测ROI并裁剪输入,得到保留原生局部细节的ROI视频 $V_{crop}$。第二步条件注入——辅助视频经冻结VAE编码为条件潜变量,连同文本特征经ControlNet分支注入14B FLUX.1 DiT。第三步去噪生成——DiT以布局感知4D位置编码和分解式时空注意力对噪声潜变量去噪,VAE解码出2K增强视频。第四步4D重建——8路原始拍摄与40路增强视频(新视角+ROI)共同监督FTGS,重建统一4D高斯表示。训练时从RealVV高清多视角数据用三种退化策略合成'退化条件-干净目标'配对,以流匹配加潜空间频率损失优化。
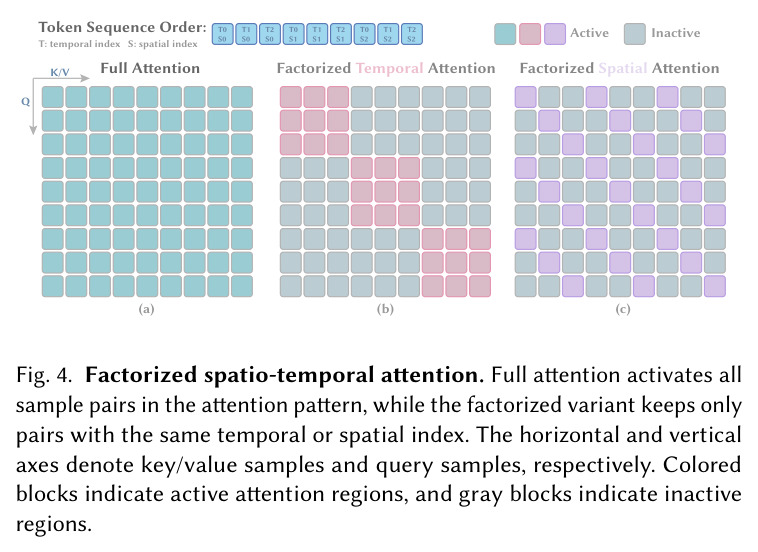
核心创新是'高分辨率图像扩散模型的多视角视频化改造'。已有生成式4D增强要么逐视角独立处理导致时空不一致,要么受限于视频骨干的原生低分辨率。RealMe的本质区别在于不把多视角视频当作扁平token序列做全注意力,而是显式建模'时刻-视角-像素'三维布局:4轴位置ID $(t,s,u,v)$ 消除不同帧/视角共享同一网格坐标的歧义;分解式时空注意力把信息传播拆成时间注意力和空间(跨视角)注意力两条通路(3个时间注意力块配1个空间注意力块的3:1配比,因时间建模在拍摄设置下更难),让同一时刻不同视角之间、同一视角不同帧之间的相关性被结构化利用——相当于把多视角一致性约束内置进去噪过程的连接拓扑,而非靠事后正则或两阶段修复来补。再配合时间步加权的潜空间FFT频率损失(噪声大时强调低频结构、接近干净时强调高频细节),生成结果既贴近真实拍摄分布又保留2K细节。
方法步骤详情
第一步(辅助数据构造):输入 $M$ 路视频 $V=\{V_i\}$ 与位姿 $P$。先用FTGS从稀疏视角拟合粗4DGS $G_c$,按式(1)沿轨迹插值采样新视角位姿 $P_j^{nv}=\mathrm{Interp}(P, j/(N_v-1))$,按式(2)渲染新视角视频;再用InsightFace检测ROI框 $B=\mathrm{Det}(V)$ 并裁剪出ROI视频 $V^{crop}$。第二步(条件注入):辅助视频经冻结VAE编码为 $z^L$,文本经冻结文本编码器得 $c_{text}$,二者送入从预训练DiT初始化的ControlNet分支,产生逐块条件残差 $c^L$。第三步(去噪生成):采样高斯噪声 $z_1$,DiT块在注意力层施加4轴RoPE嵌入 $\mathrm{PE}(id_{t,s,u,v})=\phi_t(t)\|\phi_s(s)\|\phi_u(u)\|\phi_v(v)$,用分解式时空注意力去噪 $N$ 步得 $z_0$,VAE解码为2560×1440增强视频。第四步(训练目标):按流匹配构造 $z_\tau=(1-\tau)z_0+\tau z_1$,损失 $\mathcal{L}_{fm}=\|v_\theta(z_\tau,\tau,z^L,c_{text})-(z_1-z_0)\|_2^2$;潜空间频率损失 $\mathcal{L}_{freq}=\|\Phi_L(z_{pred})-\Phi_L(z_0)\|_1+\|\Phi_H(z_{pred})-\Phi_H(z_0)\|_1$,其中 $z_{pred}=z_\tau-\tau v_\theta$,高/低频分量由潜变量FFT幅度的80分位软掩码划分并按 $c_t=t^2/T^2$ 时间步加权;总损失 $\mathcal{L}=\mathcal{L}_{fm}+\lambda_{freq}\mathcal{L}_{freq}$,$\lambda_{freq}=0.1$。第五步(4D重建):8路原始拍摄+40路增强视频共同监督FTGS,ROI视频按记录的裁剪框映射回全幅相机坐标,优化全场景统一4D高斯表示。
技术新颖性
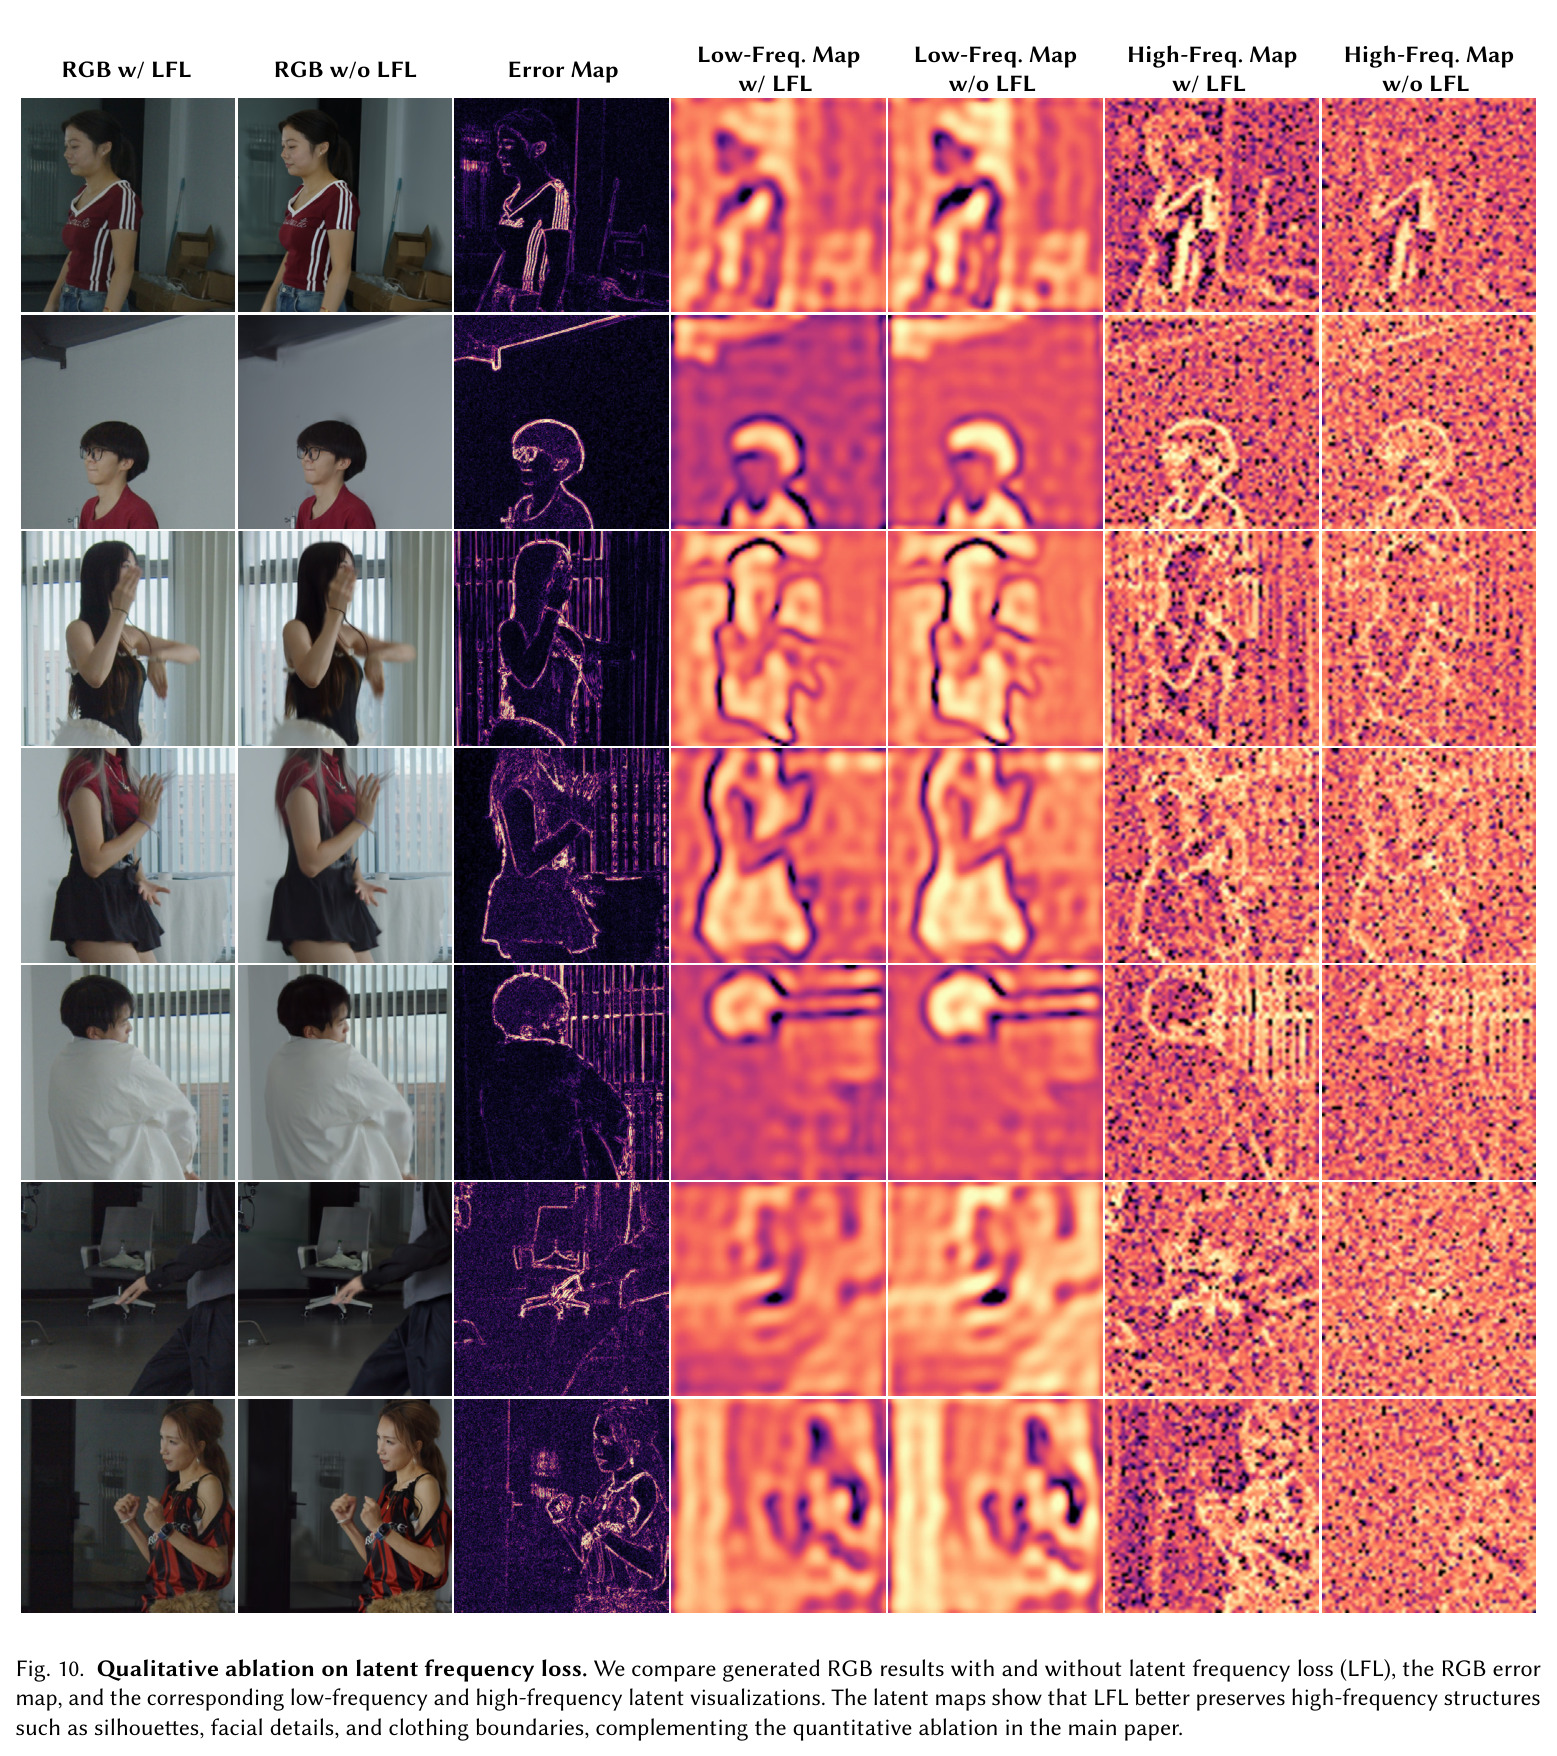
技术新颖性体现在四处:(1)骨干选择——把14B级高分辨率图像扩散模型FLUX.1改造成多视角视频扩散模型用于体积视频增强,输出2560×1440,远超现有视频骨干<1K的原生分辨率;(2)布局感知位置嵌入——把图像模型三轴位置ID扩展为(时间、视角、网格)四轴并逐轴RoPE编码,以最小代价把任意拍摄布局编入模型,消融显示其对下游4D一致性贡献最大(表6:去掉后 $\mathrm{PSNR}_c$ 从27.27降到25.26);(3)面向采样组的分解式时空注意力——把Bertasius等人的视频注意力分解思想迁移到'空间轴=视角'的多视角组,证明在采样组上全注意力不如分解式(表6:换成全注意力后LPIPS从0.1383劣化到0.2166);(4)潜空间频率损失——在latent域做FFT频域监督,达到相近增益时显存友好(图像域2K训练OOM,latent域仅73.5GB),并以时间步加权实现'先结构后细节'的课程式监督。四点合起来构成一套可复用的'图像扩散模型→多视角可控视频模型'适配配方。
实验结果
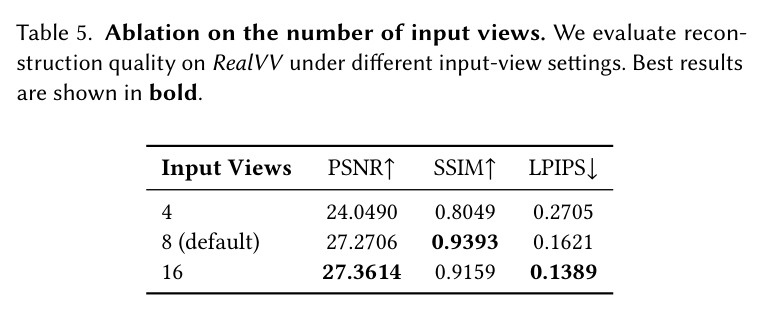
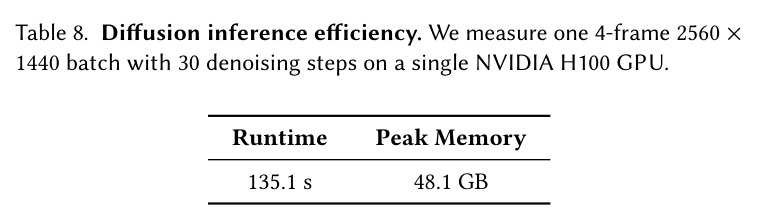
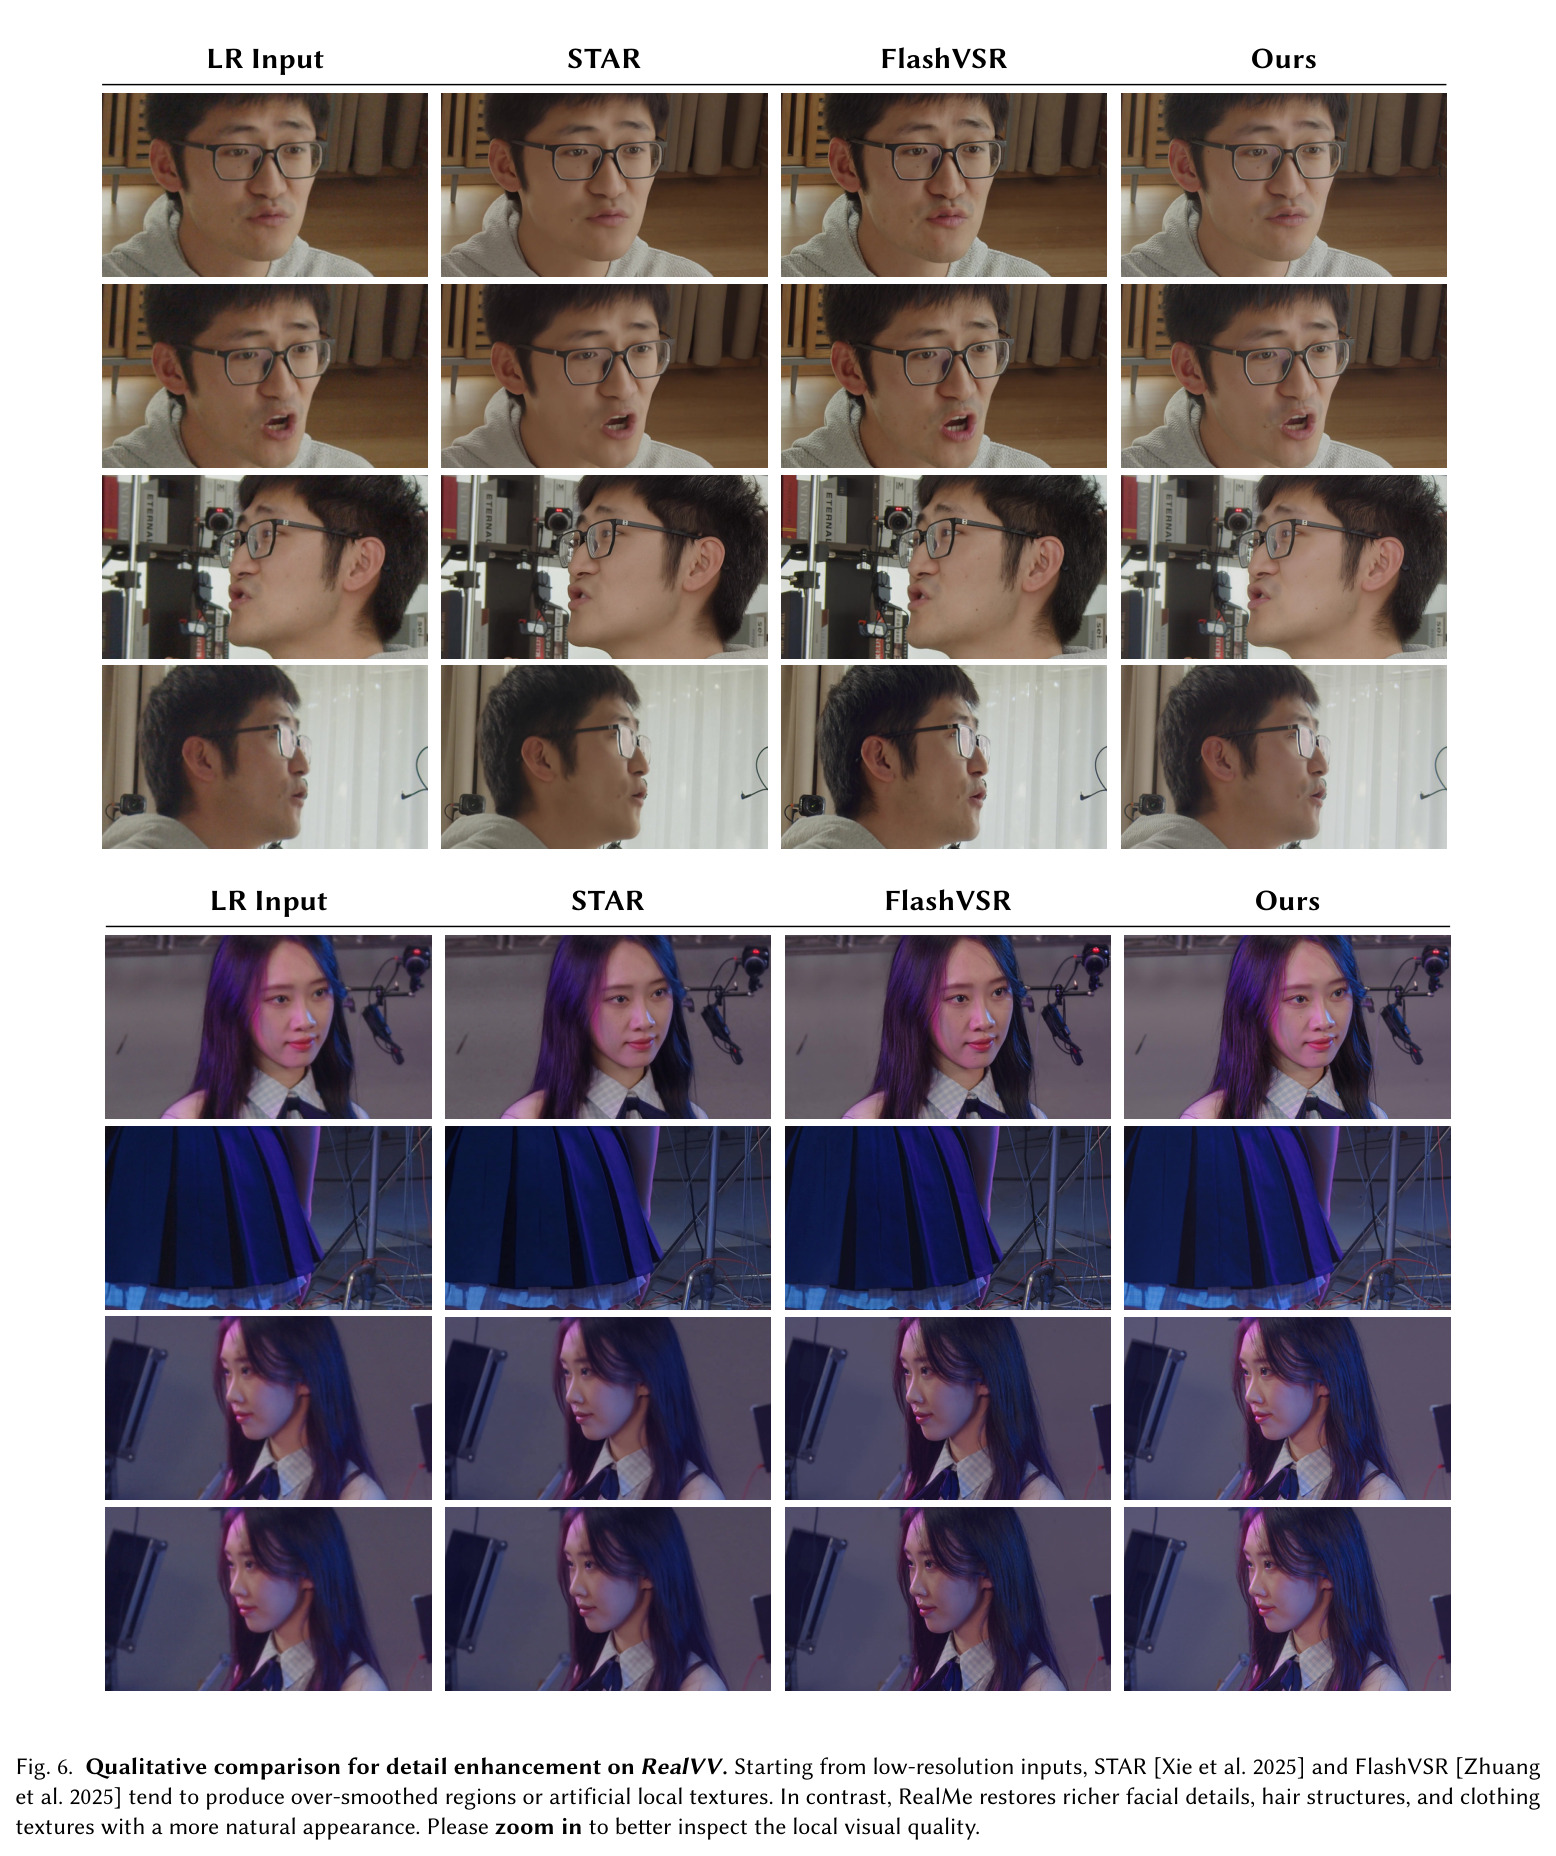
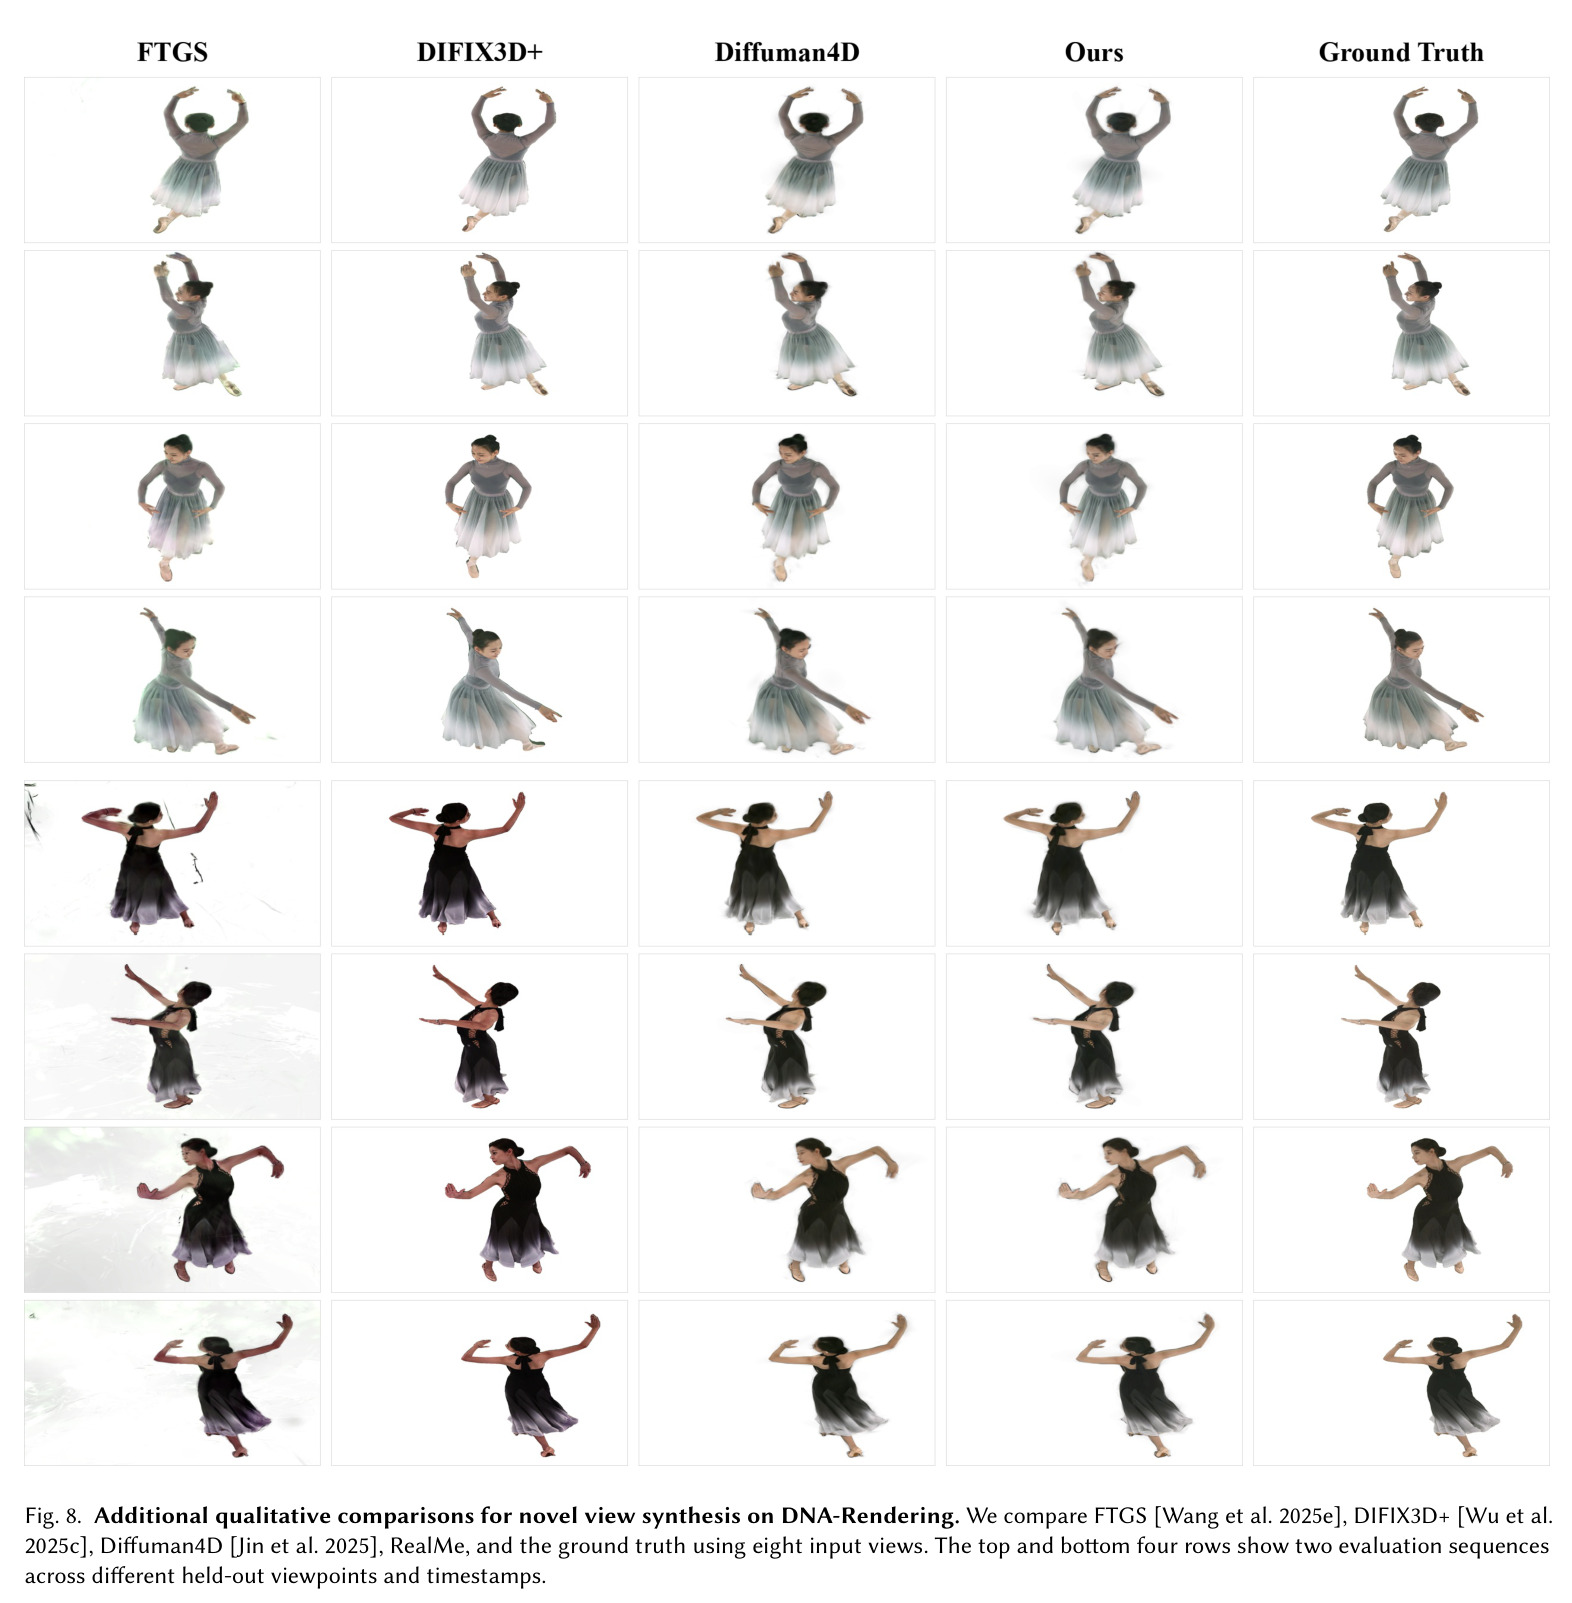
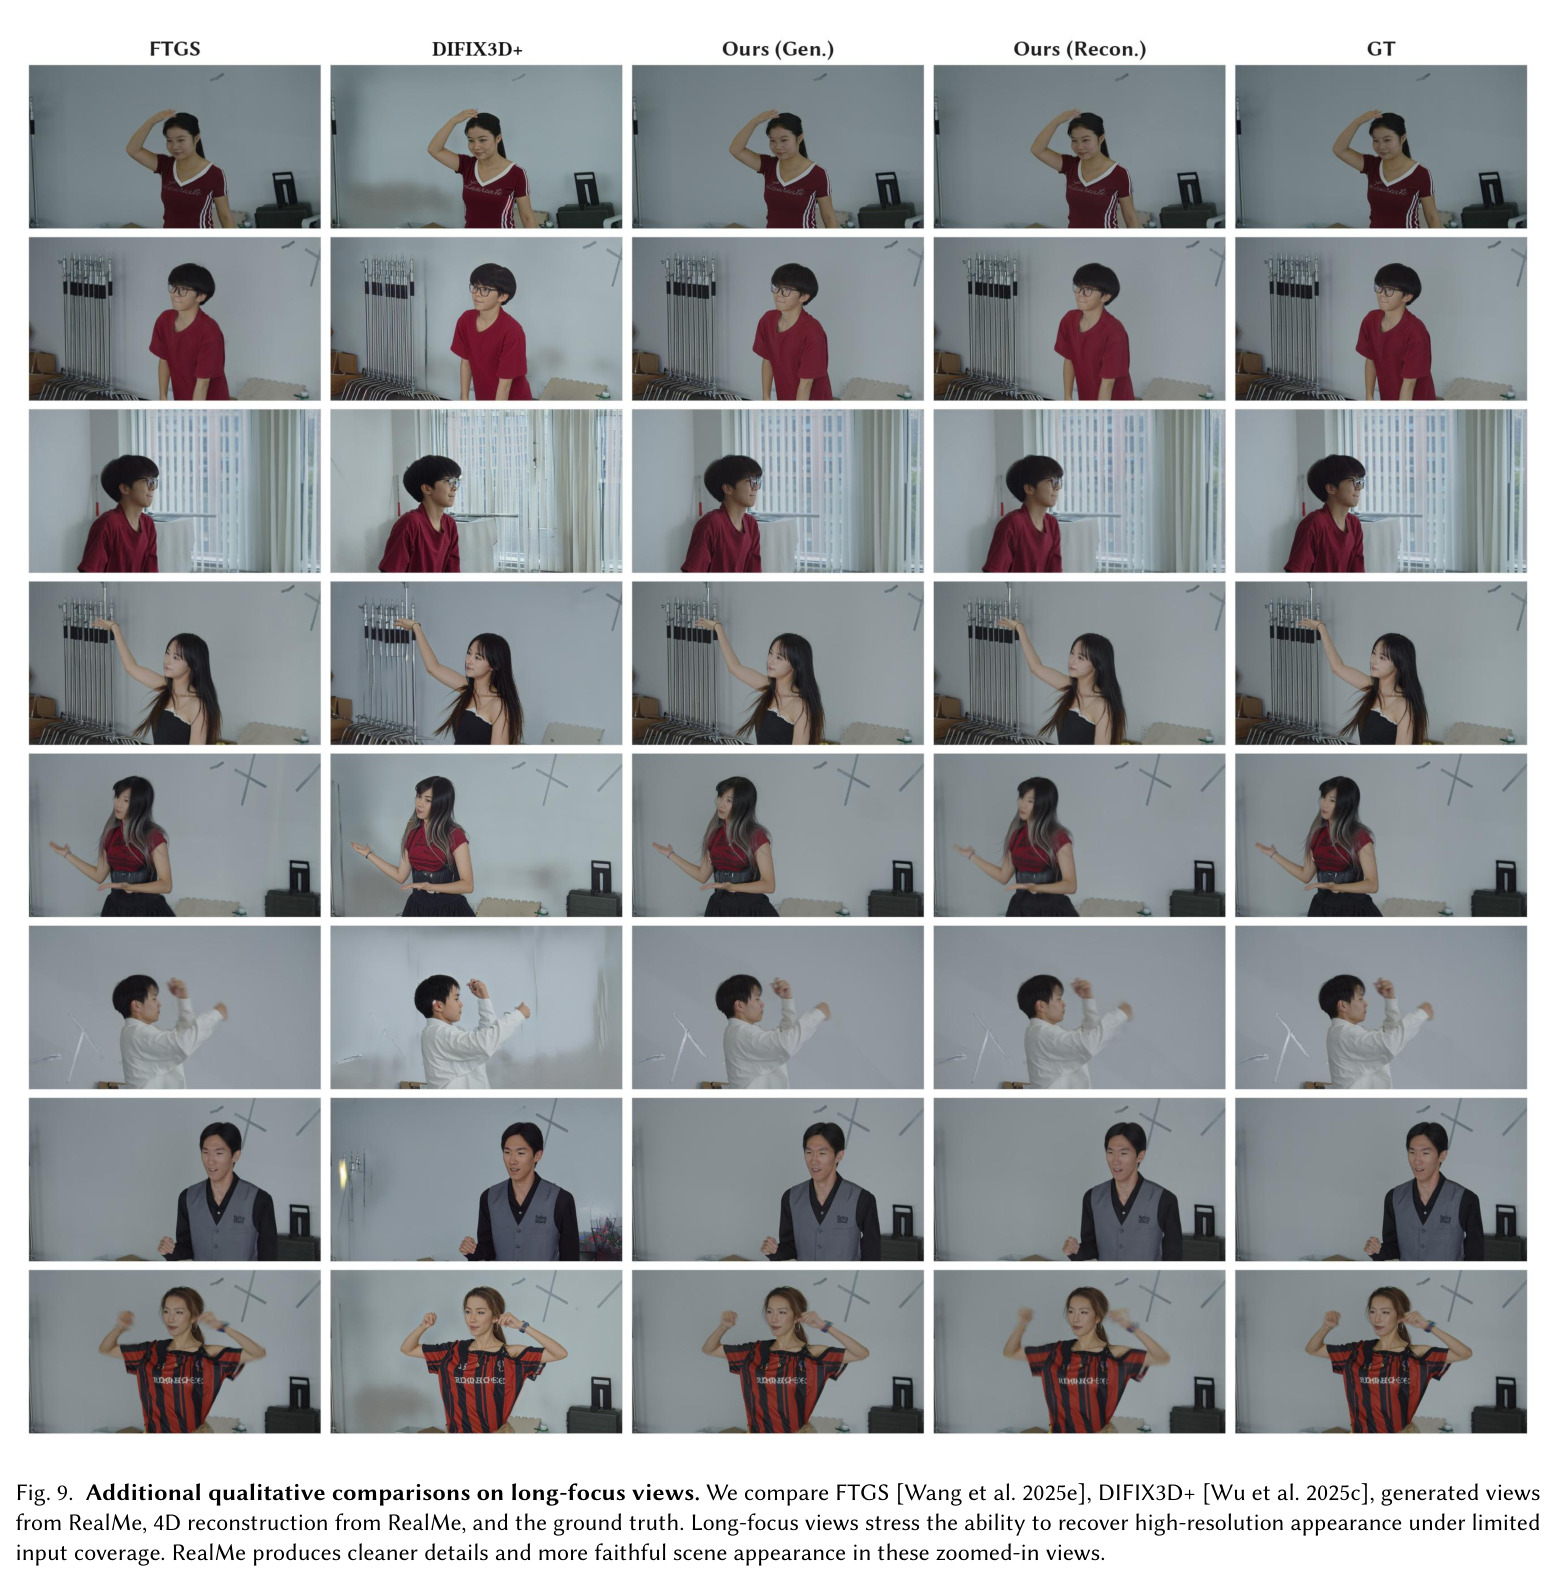
主实验(表1,RealVV 8视角输入、2560×1440评测):RealMe达到PSNR 27.2706 dB、SSIM 0.9393、LPIPS 0.1621,全面优于优化式基线FTGS(19.0491/0.8142/0.2492,PSNR提升8.2 dB)与生成式基线DIFIX3D+(22.6373/0.8267/0.2890)、Diffuman4D(24.4387/0.9113/0.2105)。零样本迁移到DNA-Rendering(1024×1024)同样最佳:25.5956/0.8979/0.1261,比Diffuman4D高2.33 dB。四相机苛刻设置(表2):RealMe 24.9304/0.8735/0.2278,大幅领先4C4D(19.0405/0.8682/0.3716)与4K4D(15.6413/0.8181/0.5090)。4D一致性重建(表3):$\mathrm{PSNR}_c$ 28.0756、$\mathrm{SSIM}_c$ 0.9246、$\mathrm{LPIPS}_c$ 0.1385,优于Diffuman4D的26.7098/0.8437/0.1913,说明生成视频与原始拍摄更对齐。时间一致性(表4):TWE 0.00551,略逊于纯优化式FTGS的0.00299,但远好于DIFIX3D+(0.04533)与Diffuman4D(0.03170)。细节增强(图6):STAR与FlashVSR出现过平滑面部、发丝软化或人工纹理,RealMe恢复更自然的面部、头发与服装细节。视角数消融(表5):4视角24.05 dB→8视角27.27 dB→16视角27.36 dB,8视角是性价比拐点。组件消融(表6):去掉布局感知PE后PSNR从24.89降到22.74;换成全注意力后降到24.32。频率损失消融(表7):无频率损失22.60 dB,图像域损失24.71 dB(2K下OOM只能1K训练),潜空间损失24.96 dB、显存73.5GB。推理效率(表8):单张H100上4帧2560×1440、30步去噪需135.1秒、峰值显存48.1GB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 新视角合成(RealVV,8输入视角,2560×1440) | PSNR (dB) | 27.27 | 24.44 (Diffuman4D) | +2.83 dB(对FTGS +8.22 dB) |
| 新视角合成(RealVV,8输入视角) | LPIPS | 0.1621 | 0.2105 (Diffuman4D) | 降低23.0%(对FTGS 0.2492 降低34.9%) |
| 新视角合成(DNA-Rendering零样本,1024×1024) | PSNR (dB) | 25.60 | 23.27 (Diffuman4D) | +2.33 dB |
| 四相机稀疏重建(RealVV) | PSNR (dB) | 24.93 | 19.04 (4C4D) | +5.89 dB(对4K4D +9.29 dB) |
| 4D一致性重建 | PSNR_c (dB) | 28.08 | 26.71 (Diffuman4D) | +1.37 dB |
| 时间一致性 | TWE(越低越好) | 0.00551 | 0.03170 (Diffuman4D) | 降低82.6%(FTGS 0.00299 仍略优) |
局限与改进
作者承认的局限:高质量多视角训练数据稀缺,RealVV训练集虽有100段序列、20位演员、140万+多视角图像,仍显不足,模型对大场景或复杂相机设置泛化有限;当输入提供的几何线索不足以初始化有效粗4DGS时,整条流水线会失效;2K高分辨率扩散推理慢(单H100生成4帧2K需135.1秒),数据扩展与推理加速是明确的未来工作。我的补充观察:(1)方法依赖粗4DGS渲染的新视角视频做几何引导,粗重建的伪影会被当作条件传给扩散模型,可能被'美化'而非纠正,效果上界受粗重建质量限制;(2)一致性指标 $\mathrm{PSNR}_c$ 度量的是'增强视频 vs 用增强视频训练的4DGS渲染'的自洽程度,并非对真实场景物理一致性的验证;(3)TWE略逊于FTGS(0.00551 vs 0.00299)说明生成过程仍引入轻度时间抖动;(4)每个序列需生成40路增强视频再优化4DGS,端到端耗时和算力门槛对普通用户仍偏高;(5)训练数据以演播室单人/双人参演为主,对多人交互、动物、大空间户外场景的适用性未验证。
独立分析的弱点
(1)粗4DGS初始化是单点故障:输入视角过少或纹理贫乏时4DGS拟合失败,后续新视角条件视频全是伪影,扩散模型只能凭文本提示凭空补全——改进方向是引入前馈几何先验(如MASt3R/DUSt3R类点图回归)替代或校验粗4DGS,失败时回退纯生成模式并给出置信度提示。(2)分辨率受VAE瓶颈:FLUX的VAE在2560×1440下的潜空间压缩可能丢失微小细节,距离4K体积视频(如4K4D)还有一档——可探索分块潜空间或更高保真的视频VAE。(3)训练组窗口很小(时间组4帧、空间组4视角、联合组2×2),长序列跨组一致性靠4DGS优化阶段兜底,扩散阶段本身缺少全局时间一致性机制——可引入层级时间注意力或运动锚点约束。(4)ROI检测只针对人脸(InsightFace),手部、鞋跟、飘动裙摆等高频细节区域未被专门增强——可扩展为多类关键部位检测或多尺度ROI金字塔。(5)频率损失的软掩码(80分位阈值加 $\mathrm{sigmoid}(10\cdot)$)是手工设计超参,对不同数据分布的鲁棒性存疑——可学习化或改为小波域损失。每个弱点都对应明确的实验可验证性,适合作为后续论文的消融点。
未来方向
作者明确提出的方向:扩大训练数据规模以覆盖大场景与复杂相机设置;加速高分辨率扩散推理(当前30步135.1秒/4帧,可探索步数蒸馏、量化或并行去噪)。基于本文成果可延伸:(1)把'4轴RoPE+分解式时空注意力'的适配配方迁移到其他图像基座(SD3.5、Qwen-Image等)验证通用性,形成通用的多视角可控生成中间件;(2)与实时渲染结合,打造'拍摄→增强→重建→直播'一条龙的自动体积直播流水线;(3)在增强的4D表示上引入重光照与材质解耦,使稀疏拍摄内容可用于VR交互式光照;(4)RealVV开源后,建立跨数据集(DNA-Rendering等)的规模化训练与统一评测协议;(5)探索少步蒸馏与4DGS联合微调,让生成先验直接服务重建目标而非两阶段串联,从根上消除误差累积;(6)将一致性指标从自洽度量升级为基于物理多视角的验证协议。
复现评估
复现难度评估:中高。有利因素:基座FLUX.1 [dev]、ControlNet、LoRA、DiffSynth-Studio、EasyVolcap、FTGS全部开源可获取;评测协议清晰(8输入视角+其余视角评测,PSNR/SSIM/LPIPS/TWE与一致性指标定义明确);DNA-Rendering公开,零样本结果可直接对表;消融完整、超参披露充分(lr $10^{-4}$、有效batch 8、$\lambda_{freq}=0.1$、rank-32 LoRA、3:1注意力块配比、三档退化策略及模糊核概率 [0.45,0.25,0.12,0.03,0.12,0.03] 等细节)。不利因素:核心训练数据RealVV论文承诺开源但尚未正式发布,是当前复现的最大缺口;训练需8张H100共96小时(约768 GPU时),普通实验室难以承担;退化合成管线工程细节多,精确复现有工作量;推理端每个序列要增强40路视频(每批4帧2K需135秒),完整序列重建在小时级。若RealVV如期开源,第三方复现的主要门槛是算力而非信息缺失;仅做DNA-Rendering零样本评测则门槛显著更低。
论文图表
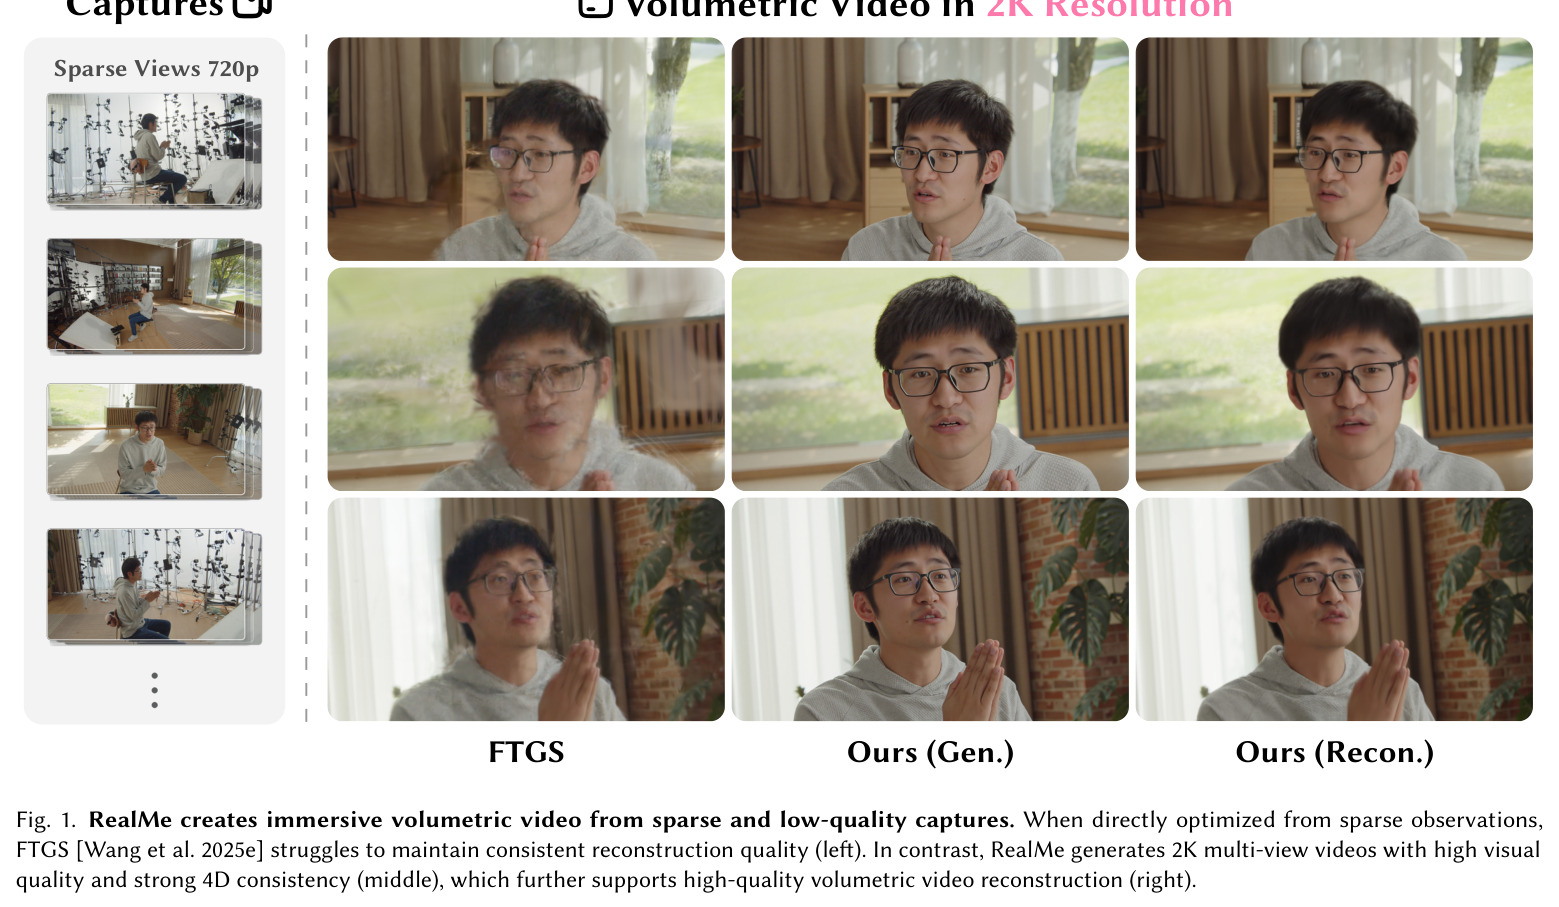
teaser图:左侧展示直接从稀疏观测优化的FTGS难以保持一致的重建质量,中间是RealMe生成的2K高画质、强4D一致的多视角视频(生成结果),右侧是用这些视频重建出的高质量体积视频(重建结果)。输入为720p稀疏视角。
一眼看懂论文要解决的问题(稀疏720p输入)和两级产出(2K增强视频→体积视频),以及与直接优化基线的直观差距,是理解全文叙事的入口。