HOLO4D:以整体式4D重建作为视频扩散模型的几何控制 Holo4D: Holistic 4D Reconstruction as Geometric Control for Video Diffusion
用持久3D轨迹作几何脚手架引导视频扩散,按新相机轨迹重拍单目视频
前置知识
视频扩散 Transformer(DiT)与整流流
现代视频生成器多为 DiT 架构:视频经 VAE 压成潜 token 序列,再用 Transformer 逐步去噪。本文基座为 Wan2.1-T2V-14B,采用整流流(rectified flow)训练:把干净目标潜变量 $x^{tgt}$ 与噪声 $\epsilon$ 线性插值为 $x_{\tau}^{tgt}=(1-\tau)\epsilon+\tau x^{tgt}$,网络学习预测速度场 $(x^{tgt}-\epsilon)$,推理时从纯噪声积分到目标潜变量。外部条件可在每个 Transformer 块内注入。
理解条件注入发生在每个 DiT 块的自注意力之前、以及训练目标是速度预测,才能明白轨迹特征如何进入生成过程。
前馈式4D重建与持久3D轨迹
指用神经网络对单目视频一次前向推断出相机位姿、深度与场景点的 3D 轨迹(如 VGGT、4RC、CoWTracker)。持久轨迹(persistent trajectory)把同一场景点在各帧的位置 $p_{n,j}$ 串成一条线并绑定其观测颜色 $c_n$;静态点就是世界坐标恒定的轨迹,因此静态与动态内容可共用同一表示与编码器,天然统一。
本文的全部条件信号就是这些轨迹,理解其结构(位置、颜色、深度、效度)是读懂方法的前提。
Plücker 射线相机条件
用 Plücker 坐标(6 维:方向向量与矩向量)编码每个像素的相机射线,是相机控制视频生成的标准做法(如 CameraCtrl)。它只告诉模型相机在哪、朝哪看,对场景内容没有任何约束;在无投影观测覆盖的画面区域,它是唯一的位置先验。
本文将 Plücker 射线作为辅助相机特征 $\mathbf{C}$,与承载场景内容的轨迹特征分工互补,混清二者会导致误读。
通道级注入与零初始化条件
ControlNet 式条件方式:把条件特征与隐藏特征沿通道拼接后再用可学习投影映回原宽度,$\hat{h}^{(\ell)}=W^{(\ell)}[h^{(\ell)};\mathbf{T}]$,且 $W$ 对条件通道零初始化,训练起点等价于原模型、不破坏预训练行为。相比把条件作为额外 token 序列拼进自注意力,它不增加序列长度与注意力开销。
这正是本文比 Vista4D(追加渲染视频 token 序列)取得 1.34 倍去噪加速的结构性原因。
视频重拍及其评估指标
视频重拍(video reshooting)指保持事件内容与运动不变、按指定相机轨迹重新渲染单目视频。评估上:新视角保真用 PSNR/SSIM/LPIPS 及掩码版(只评两视角共视区域,前缀 m);相机精度用 ATE(整体轨迹误差)与 RPE-T/RPE-R(相邻帧平移/旋转误差);生成质量用 VBench 与 FVD。
论文所有对比结论都建立在这些指标上,不弄清 ATE 与一致性类指标的分工,容易把「画面稳」误读成「相机准」。
研究动机
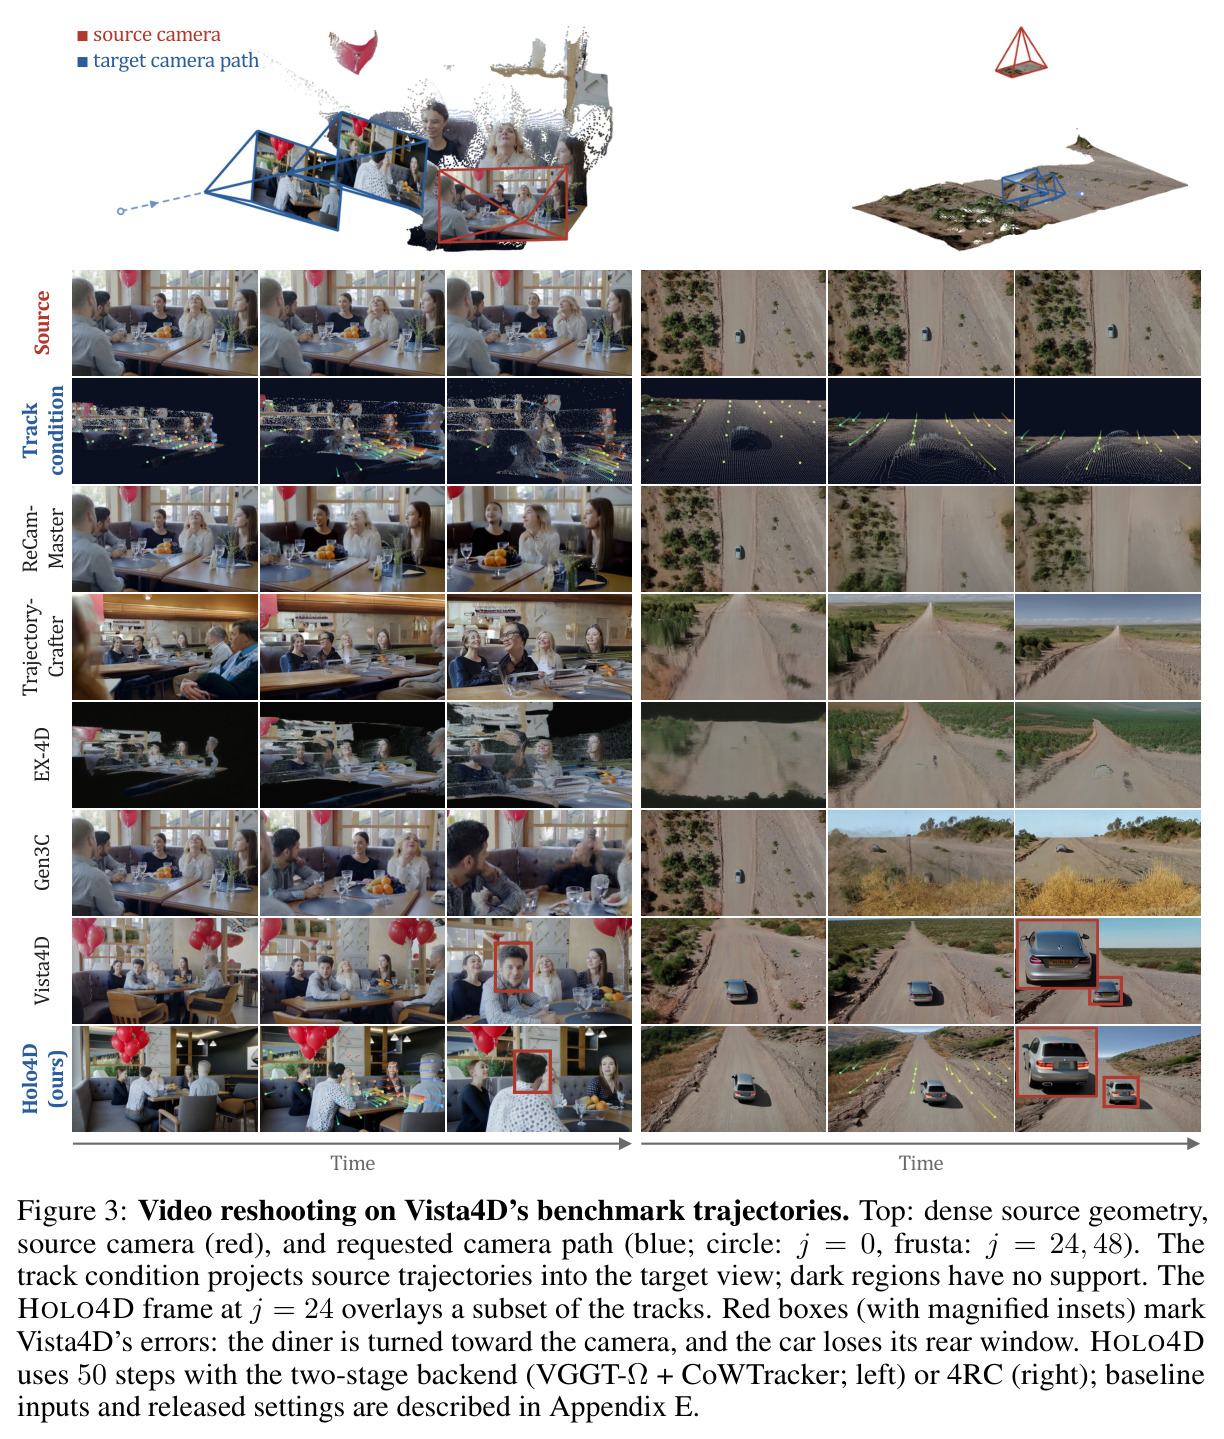
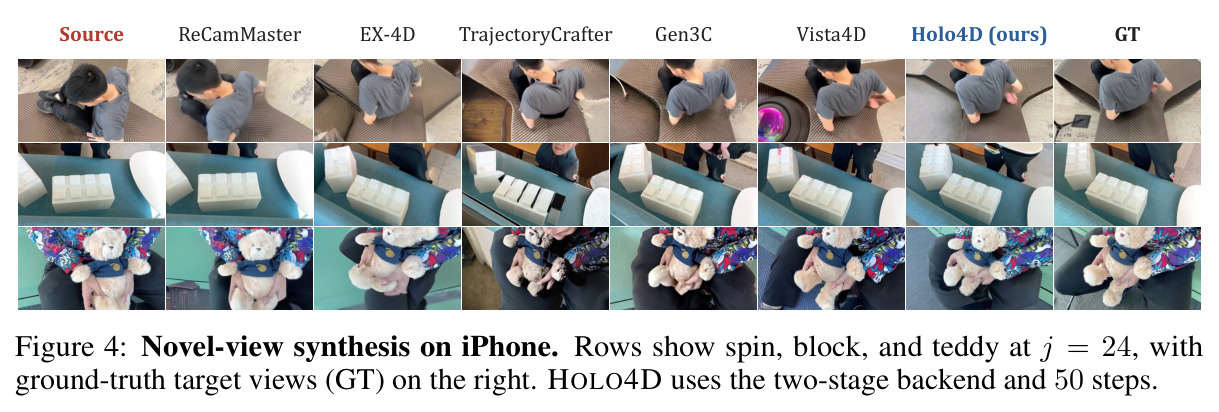
从一条新的相机轨迹重拍单目视频,需要同时完成两件相互制约的事:忠实保留已观测到的场景几何与运动,同时补全新视角下从未见过的区域。纯重建路线(用估计深度把每帧抬升成点云再重投影,如 TrajectoryCrafter、EX-4D、Gen3C)在新视点留下空洞,且动态区域各帧独立重建的点云没有跨帧对应,视角变化一大就扭曲;Vista4D 虽把静态像素持久化到世界坐标系累积观测,但运动表面无法同样累积,导致餐厅场景中人物朝向被拧转、汽车丢失后车窗等错误。纯生成路线(如 ReCamMaster 只条件于源视频加相机嵌入)画面合理却不必保持该场景的真实几何:DAVIS 上 ReCamMaster 的 ATE 高达 9.547(×10⁻²),输出倾向停在源视角附近;iPhone 实拍序列上其 mPSNR 仅 10.34 dB。核心难题因此是:应该用什么样的表示,把源视频的几何、外观、运动一次性、无歧义地暴露给视频扩散模型。
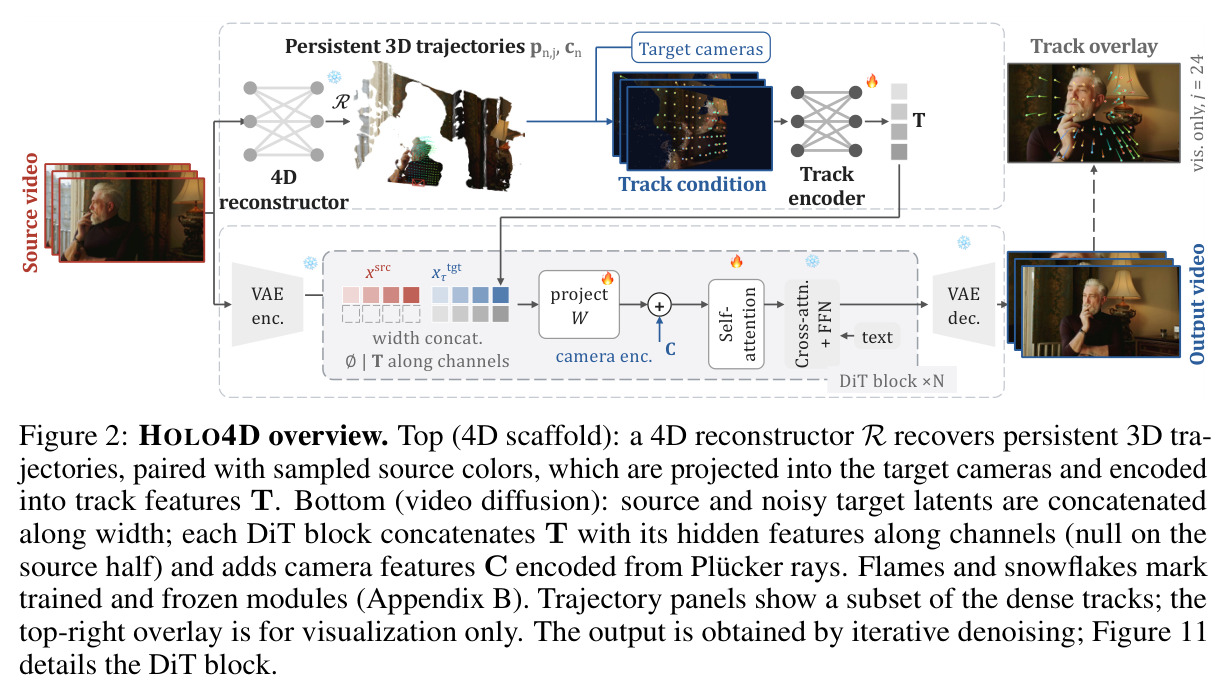
本文的目标是构建一个视频重拍框架 HOLO4D:用前馈式 4D 重建器从源视频恢复持久 3D 轨迹并绑定源外观颜色,作为「整体式」几何脚手架;将轨迹投影到目标相机、编码为轨迹特征 $\mathbf{T}$,沿通道维度注入预训练视频扩散 Transformer 的每个 DiT 块,配合源视频(宽度维拼接)与 Plücker 射线相机特征,生成遵循指定相机路径且保持源场景几何与动态的新视频。可量化目标:在 DAVIS 上取得最低的相机轨迹误差(ATE/RPE-T),在 iPhone/DyCheck 持有视角上取得最优 PSNR/LPIPS;不重训生成器即可更换上游重建器;同时不引入额外 token,使去噪速度不劣于现有渲染几何基线。
与已有工作不同的是,已有几何条件方法大多用「逐帧深度点云渲染」作条件(TrajectoryCrafter、Gen3C、EX-4D),或像 Vista4D 只把静态内容持久化、动态内容仍逐帧独立。本文抓住一个被忽视的统一点:持久 3D 轨迹天然把静态与动态纳入同一表示——静态点就是恒定轨迹的特例——因此一套编码器即可同时表达场景结构与运动对应关系;且颜色沿轨迹固定,把「内容在哪、如何动、长什么样」一起交给生成器,消融证明去掉轨迹颜色 ATE 恶化 44%。另一个关键选择在接口层面:条件用显式几何量(位置、深度、效度、颜色)而非重建器内部隐特征,因此可与任何提供轨迹的重建器即插即用组合,生成器无需重训,可持续受益于上游重建进展。
核心方法
直觉上,HOLO4D 给视频扩散模型配了一张「场景速记卡」:重建器从源视频挑出大量场景点,记下每个点每帧的三维位置与在源视频中的颜色;重拍时按目标相机把这些 3D 点投影到新画面,落点直接告诉扩散模型「已观测内容应出现在哪个像素、随时间如何移动、颜色是什么」。生成器在脚手架覆盖处忠实上色,无观测支撑的新暴露区域交给视频先验补全。上支路构建 4D 脚手架:重建器(默认 4RC,或 VGGT-Ω+CoWTracker 两阶段)输出相机位姿与持久轨迹 $p_{n,j}$ 及颜色 $c_n$,按目标内外参投影得像素位置与深度 $d_{n,j}$、效度 $v_{n,j}$,属性经正弦编码与共享 MLP 变成特征散布到目标视角网格,由因果 3D 卷积适配到 DiT 网格得到轨迹特征 $\mathbf{T}$。下支路是 Wan2.1-T2V-14B 视频扩散模型:源视频潜变量 $x^{src}$ 与含噪目标潜变量 $x_{\tau}^{tgt}$ 沿宽度拼接,$\mathbf{T}$ 与 Plücker 相机特征 $\mathbf{C}$ 沿通道注入每个 DiT 块,文本走预训练交叉注意力。
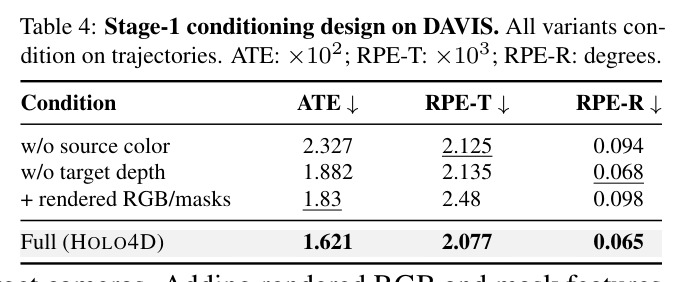
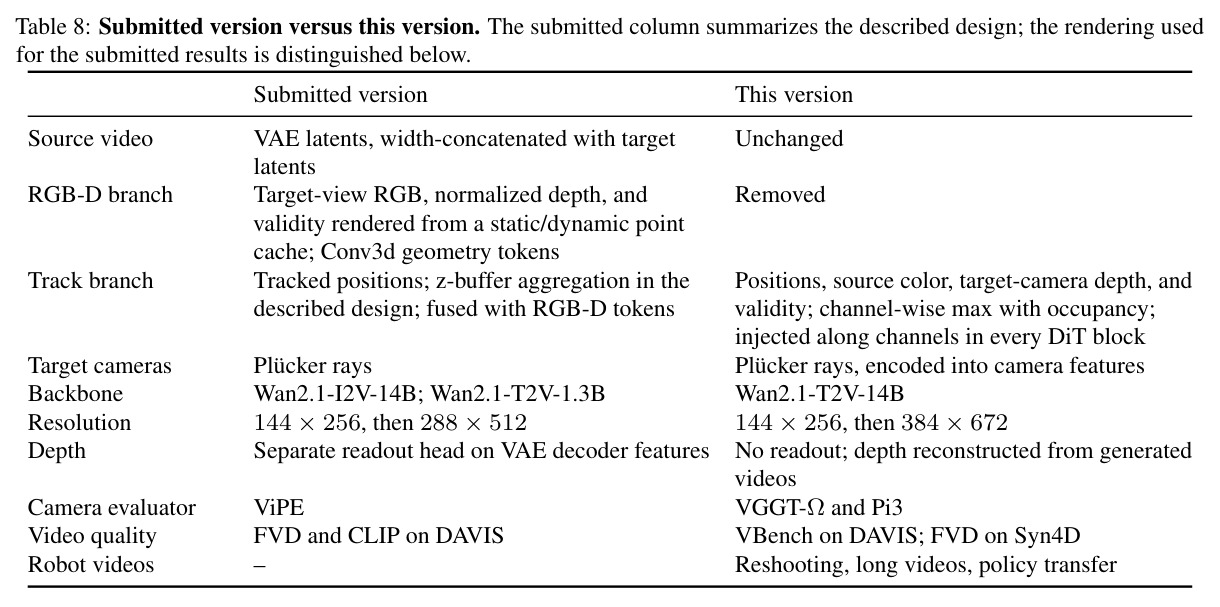
核心创新是把「持久 3D 轨迹 + 源外观」作为整体式条件表示。与逐帧深度点云相比,轨迹显式编码运动表面的跨帧对应:同一表面的点在时间上串成一条线,静态与动态统一在同一编码器下(静态=恒定轨迹);Vista4D 只持久化静态内容,动态点仍逐帧孤立,这正是它在 Vista4D 基准上把人物朝向拧转的根源。颜色沿轨迹固定看似小改动,消融显示去掉它 ATE 从 1.621 恶化到 2.327(+44%),说明轨迹绑定外观提供了源视频之外的判别信息,二者不冗余。第二层创新在注入方式:轨迹特征走通道维(零初始化投影 $\hat{h}^{(\ell)}=W^{(\ell)}[h^{(\ell)};\mathbf{T}]$)而非追加 token 序列,自注意力长度不变,对 Vista4D 取得 1.34 倍去噪加速(7.39 s vs 9.89 s)。第三层是接口解耦:条件是显式几何量而非 LaVR 式重建器隐状态,同一生成器零重训即可在 4RC、V-DPM、VGGT-Ω+CoWTracker 等后端间切换,实验证明换后端可把旋转误差降 59%-74%。
方法步骤详情
第一步,源视频 4D 重建:输入 49 帧源视频,重建器输出相机位姿与持久轨迹 $p_{n,j}$,首帧查询,每点绑定颜色 $c_n$ 与效度标志。第二步,目标视角投影:按目标相机 $K_j^{tgt},\pi_j^{tgt}$ 把观测投影为像素位置与目标相机深度 $d_{n,j}$,第三步,特征体构建:帧索引、位置、深度、效度、颜色经正弦编码与共享 MLP 得特征向量,散布到目标视角网格,同单元按通道最大值合并、占用通道记录覆盖,因果 3D 卷积对齐 DiT 网格得 $\mathbf{T}$。第四步,条件注入:每个 DiT 块自注意力前计算 $\hat{h}^{(\ell)}=W^{(\ell)}[h^{(\ell)};\mathbf{T}]$,$W$ 对轨迹通道零初始化;相机特征 $\mathbf{C}$ 同理注入;源/目标潜变量沿宽度拼接。第五步,训练与推理:以整流流目标 $\mathcal{L}_{FM}$ 训练速度预测,从 Wan2.1-T2V-14B 初始化,先 15k 步 144×256 再 4.5k 步 384×672,只训条件模块与自注意力。50 步去噪,。
技术新颖性
与最接近的 Go-with-the-Track 相比,后者条件于参考图像加参考帧锚定的 2D 轨迹,面向合成与运动控制;本文编码 3D 轨迹位置、目标相机深度、效度与颜色,面向大视角变化的视频重拍。与 Edit-by-Track(条件于成对源/目标 3D 点轨做编辑)任务设定也不同。与 Vista4D 的三点本质区别:(1)动态内容持久化而非仅静态;(2)通道注入而非追加渲染视频 token,带来 1.34 倍去噪加速;(3)显式几何接口而非重建器隐特征(LaVR 用潜重建状态,绑定具体重建器),后端可免费替换。与 ViDAR 等逐场景优化相比,HOLO4D 无需每场景约 5 小时 18 分钟(A6000)的优化,重建一次(4RC 8.8 s / 两阶段 11.8 s,warm A6000)即可跨目标轨迹复用,仅投影与编码按轨迹重算。这种「重建器不可知」的接口设计使框架能直接继承上游 4D 重建的进步。
实验结果
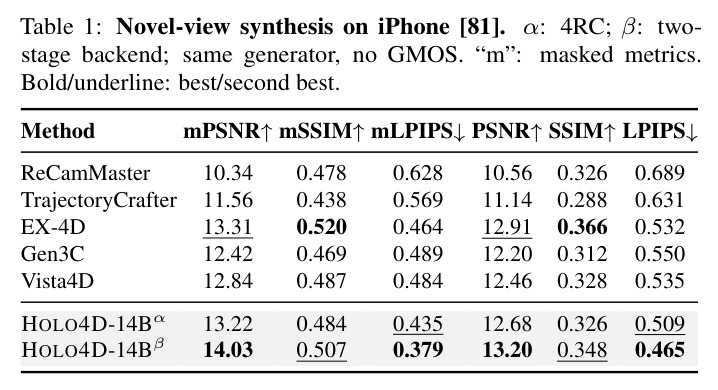
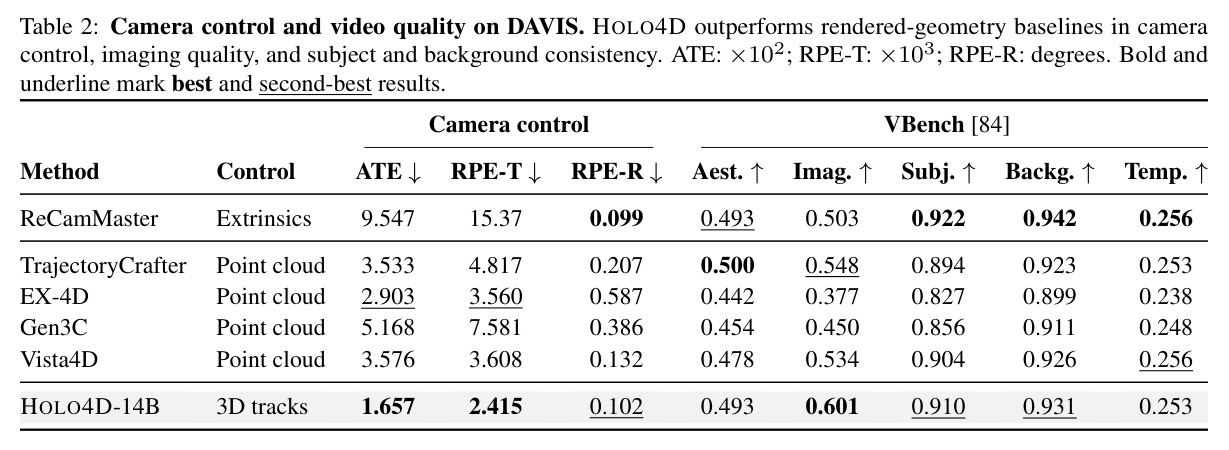
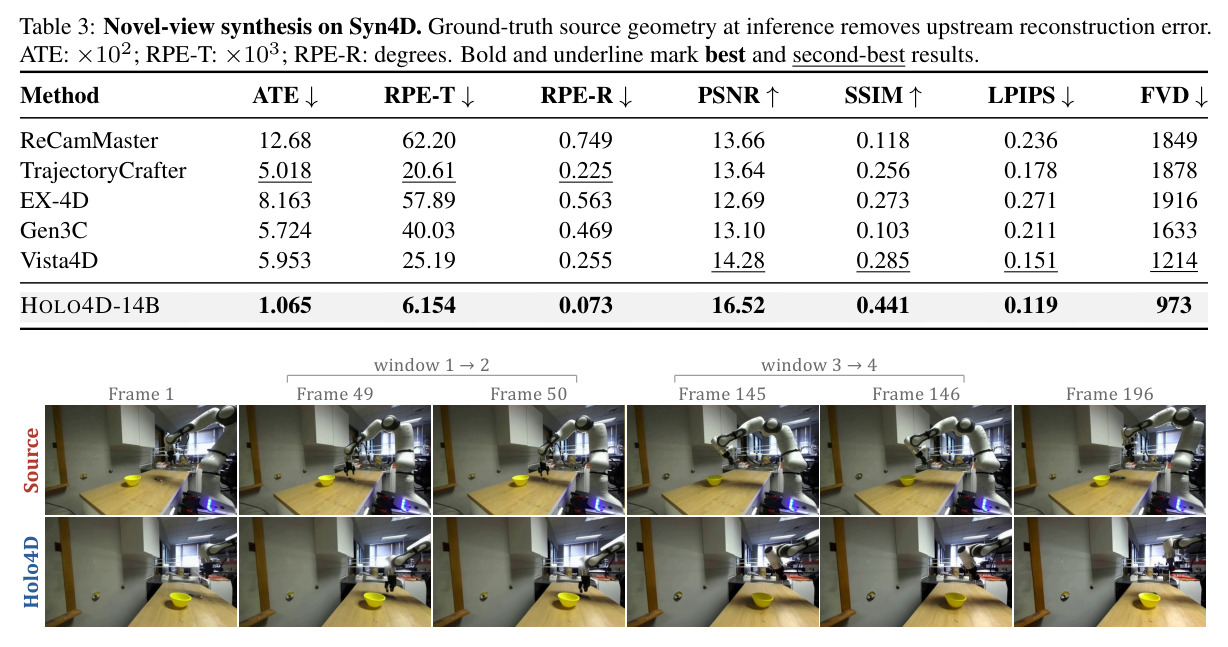
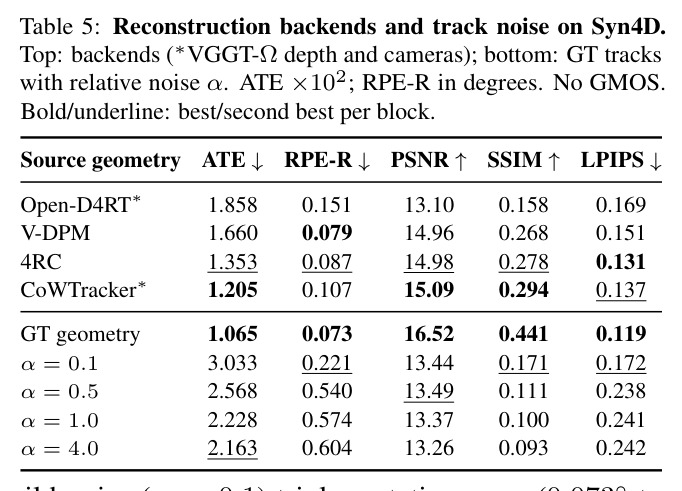
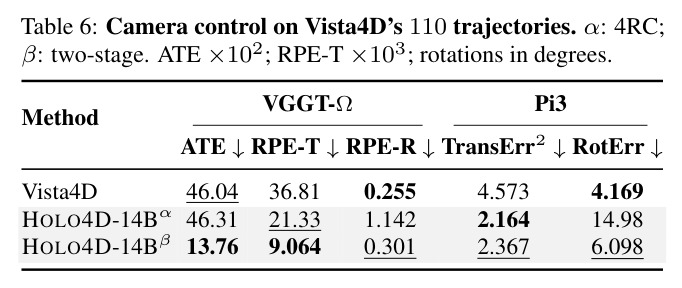
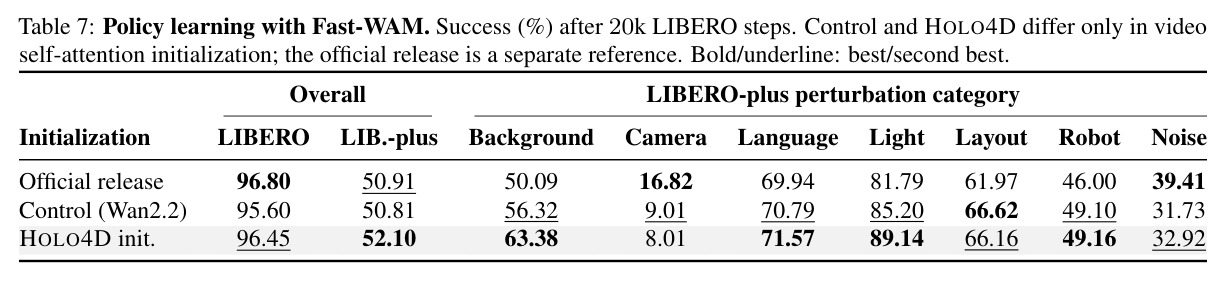
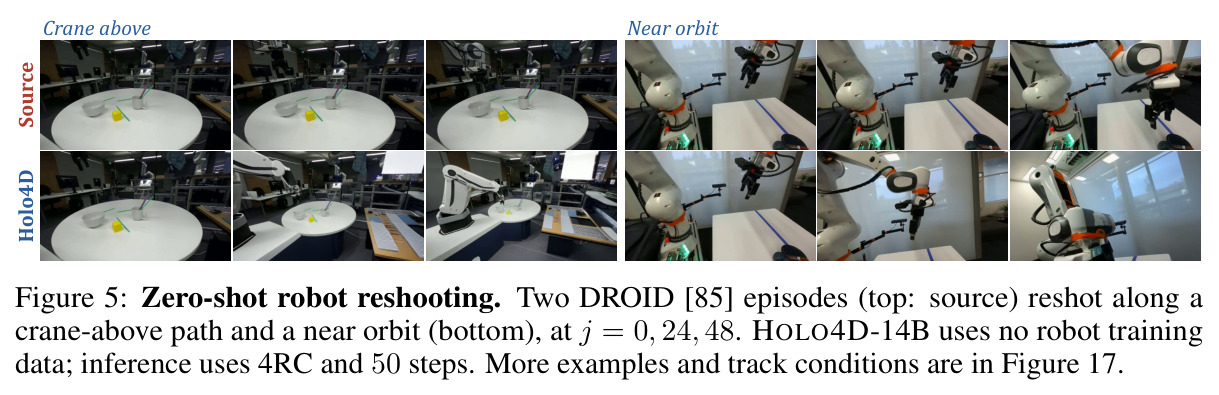
新视角合成(Table 1,iPhone):两阶段后端最优 mPSNR 14.03 dB、mLPIPS 0.379,EX-4D 仅在 SSIM 领先;两变体共用同一生成器未重训,收益来自源几何质量。相机控制(Table 2,DAVIS):ATE 1.657、RPE-T 2.415、RPE-R 0.102° 均最低,较 Vista4D 降 54% 与 33%;ReCamMaster 旋转略低(0.099°)但 ATE 高达 9.547,一致性高不等于相机准;VBench 成像质量 0.601 最高。Syn4D(Table 3,GT 几何):ATE 1.065、PSNR 16.52 dB、FVD 973 全指标第一。消融(Table 4):去源颜色 ATE +44%,加渲染 RGB/掩码无增益。后端(Table 5):换 CoWTracker 等重建器无需重训,GT 轨迹最好;轨迹加噪 α=0.1 即令 RPE-R 三倍到 0.221°。Vista4D 基准(Table 6):4RC 后端旋转偏高(1.142° vs 0.255°),换两阶段后端降 74% 与 59%。速度:H200 去噪 7.39 s vs 9.89 s(1.34 倍)。机器人:零样本重拍 DROID;LIBERO-plus 策略迁移 +1.29 个百分点。
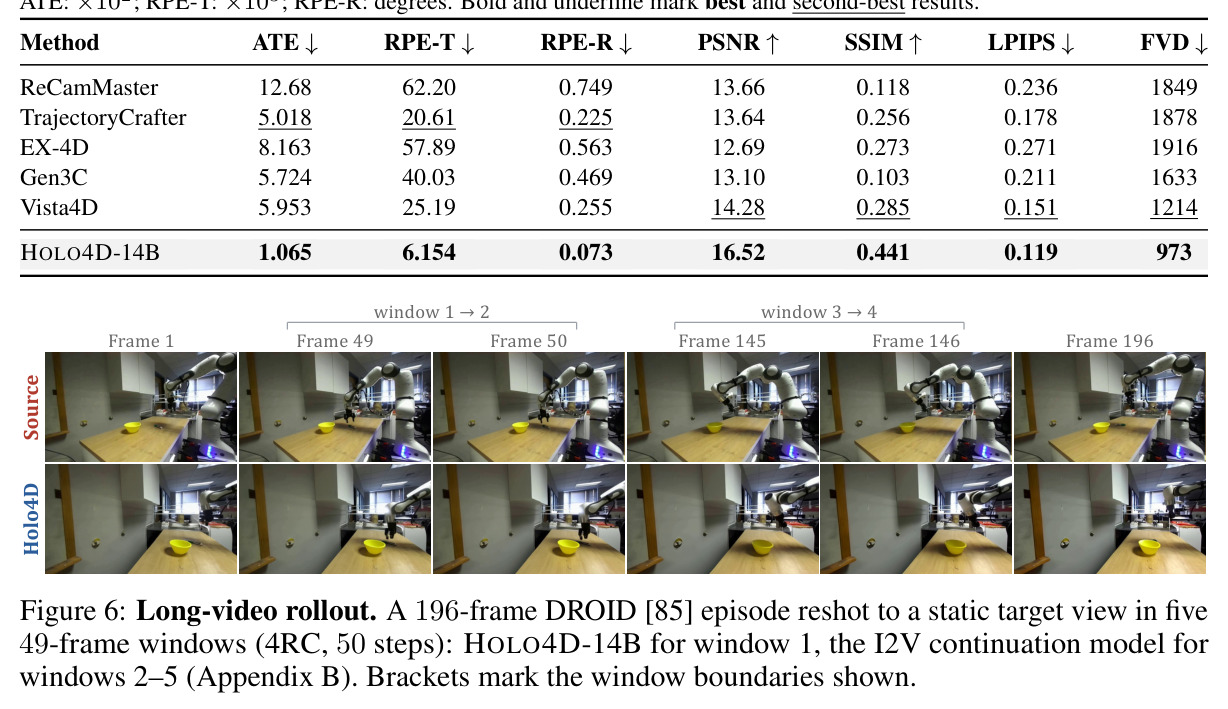
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 新视角视频合成(iPhone/DyCheck) | mPSNR ↑ (dB) | 14.03(两阶段后端 HOLO4D-14Bβ) | EX-4D 13.31 / Vista4D 12.84 | +0.72 dB(较最强基线) |
| 新视角视频合成(iPhone/DyCheck) | mLPIPS ↓ | 0.379 | EX-4D 0.464 | 降低 18.3% |
| 相机控制(DAVIS 100 对) | ATE ↓(×10⁻²) | 1.657 | Vista4D 3.576 | -54%(同为 4RC 几何时) |
| 相机控制(DAVIS) | RPE-T ↓(×10⁻³) | 2.415 | Vista4D 3.608 | -33% |
| 新视角合成(Syn4D,GT 几何) | PSNR ↑ / FVD ↓ | 16.52 dB / 973 | Vista4D 14.28 dB / 1214 | +2.24 dB / FVD 降约 20% |
| 去噪速度(384×672×49,50 步,H200) | 去噪耗时 | 7.39 s | Vista4D 9.89 s | 1.34 倍加速 |
| 条件消融(DAVIS,stage-1 配方) | ATE ↓(×10⁻²) | 1.621(完整条件) | 去源颜色 2.327 | 轨迹颜色贡献 44% ATE |
| 轨迹噪声鲁棒性(Syn4D,GT 轨迹加噪) | RPE-R ↓(度) | 0.073(无噪声) | α=0.1 噪声时 0.221 | 轻微噪声即致 3 倍旋转误差(敏感性) |
| 机器人策略迁移(LIBERO-plus) | 成功率 ↑ (%) | 52.10(HOLO4D 初始化) | Wan2.2 对照 50.81 | +1.29 个百分点(背景 +7.1、光照 +3.9,空间套件下降) |
局限与改进
作者承认的局限:对几何误差敏感(α=0.1 的轨迹噪声即令 RPE-R 三倍化、PSNR 降 3 dB);对源覆盖不完整与困难相机轨迹脆弱——脚手架无支撑区域完全依赖生成先验;在 Vista4D 110 轨迹基准上,用 4RC 估计几何时旋转误差高于 Vista4D(VGGT-Ω 1.142° vs 0.255°),需换两阶段后端才反超,且 Pi3 指标(6.098°)仍高于 Vista4D 的 4.169°,作者明确说明该对比未隔离生成器差异;机器人策略迁移结果混合、仅单种子,新视角训练是否助益具身策略仍是开放问题。我的补充观察:Syn4D 在训练混合数据之内,测试场景虽 held-out 但分布占优,且基线检查点未在该数据上适配,这部分领先应打折;轨迹只在首帧查询,后进入画面的内容无脚手架支撑;端到端每条约 570.9 s(14B、50 步),交互式使用成本高;轨迹颜色逐点固定,无法表达高光、透明等视角相关外观。
独立分析的弱点
(1)几何误差单点故障化:α=0.1 的轨迹噪声就让 RPE-R 从 0.073° 涨到 0.221°、PSNR 从 16.52 跌到 13.44,干净视频上下文不能补偿。改进:施加更强的条件 dropout 与噪声课程,给轨迹附加不确定性/置信通道,或多重建后端做多假设集成。(2)首帧查询导致覆盖不全:后出现的物体与新内容没有脚手架支撑,长视频会退化。改进:按 UniQueR 思路逐帧补查并合并去重,维护滚动轨迹池处理轨迹生灭。(3)全局旋转控制不稳:GT 换 4RC 时 source-aligned 旋转 0.242°→0.931°,而相对旋转几乎不变(0.051°→0.055°),暴露绝对朝向估计薄弱。改进:加入朝向对齐目标或相对旋转参数化,扩充大旋转轨迹样本。(4)视角相关外观缺失:固定颜色无法处理镜面高光与透明。改进:携带多帧多视角观测或让编码器输出视角相关残差。(5)成本:14B、50 步、端到端约 570.9 s/条,交互式应用不可行。改进:少步蒸馏,或直接使用文中已有的 5B 变体降低门槛。
未来方向
作者提出的方向:(1)让一个模型同时做 4D 重建与新视角合成,使两者互相促进——视频生成器本身是通用视觉学习器,重建与生成可以在同一网络中闭环;(2)逐帧查询轨迹(如 UniQueR)以覆盖后出现的内容;(3)换更强基座(如 MiniMax H3)提升视觉质量。基于本文成果可延伸:把轨迹脚手架当作可编辑接口,直接拖拽 3D 轨迹改变物体运动,实现几何层面的受控视频编辑;结合 GMOS 式前景/背景分离做物体级分离控制与场景重组;将「显式几何量 + 通道注入」接口推广到具身世界模型——LIBERO-plus 上背景(+7.1)与光照(+3.9)鲁棒性提升暗示几何条件有助于策略泛化,值得在大规模机器人数据上系统验证;以及不确定性感知的条件编码,缓解对上游重建误差的高敏感性。
复现评估
论文为 NeurIPS 2026 工作,项目页 nirvanalan.github.io/projects/holo4d 已公开(代码与权重开放程度以项目页为准,正文未逐一承诺)。复现链条上的组件基本都是公开的:基座 Wan2.1-T2V-14B、重建后端 4RC、VGGT-Ω、CoWTracker、GMOS 均有公开实现;训练数据为多数据集混合(合成多视角动态场景、真实静态视频、合成静态序列),具体名称、采样权重与标注来源在附录 C。算力门槛高:14B 模型两阶段训练(15k 步 144×256 加 4.5k 步 384×672,批大小 8/32),需 A100/H200 级多卡集群;推理需高端单卡(H200 上约 570 s/条,384×672×49、50 步),5B 变体可显著降低门槛。务实建议:小团队跳过训练,直接用公开权重做推理与下游实验;复现条件编码与消融(stage-1 的 144×256 配方)相对可行。总体评估:完整训练复现难度高,推理复现难度中等。
论文图表
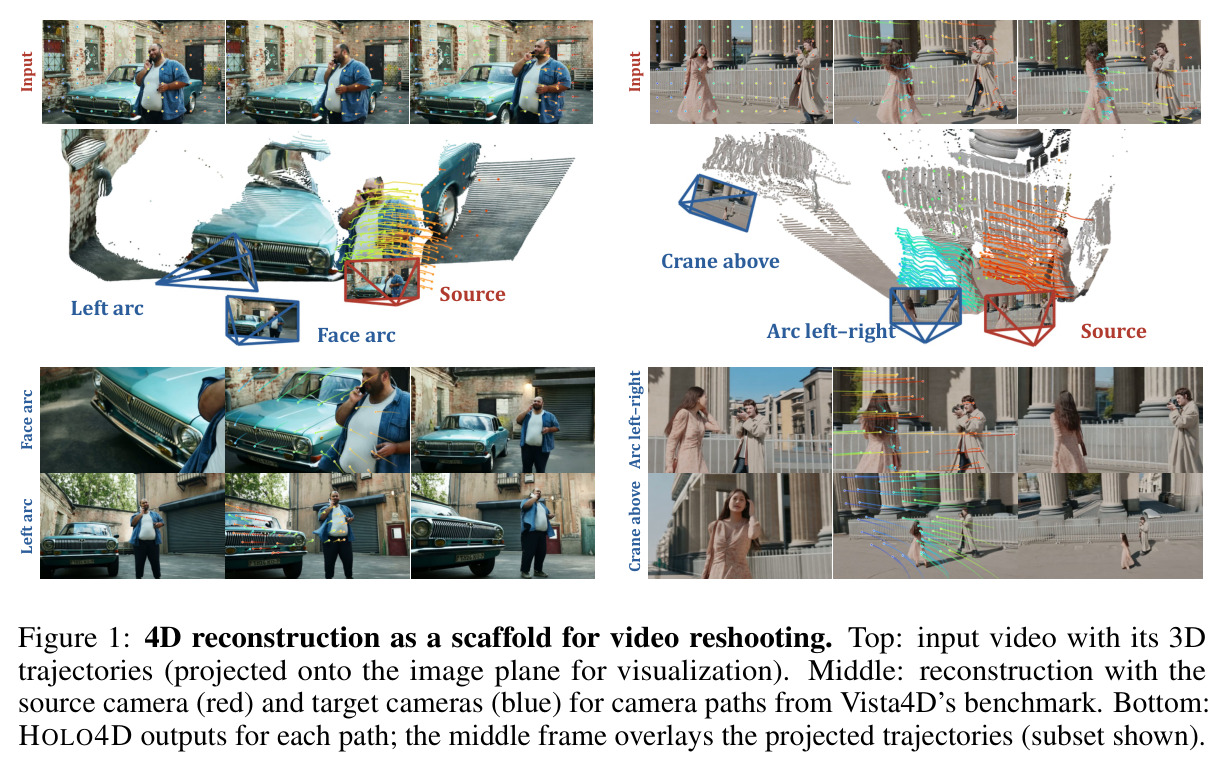
展示框架总览:输入视频及其投影到图像平面的 3D 轨迹,按 Vista4D 基准的源相机(红)与多条目标相机路径(蓝)重建,底部为 HOLO4D 在每条路径上的输出,中间帧叠加投影轨迹。
一图读懂任务设定与整体效果:同一事件、多条相机路径的重拍结果,是理解「轨迹作为脚手架」直觉的入口。