DONIC:从人类演示学习通用的双手灵巧跟踪控制 DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
首个通用双手灵巧跟踪策略,单 checkpoint 零微调跟踪未见轨迹与物体,大幅超越基线
前置知识
参考跟踪(Reference Tracking)
一种灵巧操作的训练范式:给控制器提供一段预先捕获的参考轨迹,包括手腕位姿、手指关节角和物体 6-DoF 位姿(合称 reference clip),策略在物理仿真中通过闭环控制让机器人手尽可能复现这段运动。与开环回放不同,策略每步输出对下一步参考的有界修正量,交给 PD 控制器执行,因此能抵抗物理接触带来的扰动。DexTrack、Dexplore、AdaDexTrack 都是这一范式的代表。
本文的 DONIC 就是一个参考跟踪器,理解参考条件化控制接口(观测含参考目标与误差、动作是参考修正)是读懂方法部分的前提。
PPO 与广义优势估计(GAE)
PPO(近端策略优化)是主流的策略梯度强化学习算法,通过裁剪概率比限制每次更新幅度。GAE 用指数加权的时序差分残差估计优势函数 $A_t$,即某动作相对价值基线的好坏程度:$\Delta_t = r_t + \gamma V(o_{t+1}) - V(o_t)$,再按 $(\gamma\lambda)^\ell$ 加权累加。优势决定 PPO 的更新方向与幅度,优势估计的系统性偏差会直接扭曲策略学习。
本文核心创新之一 Clip-Centered Advantages(CCA)就是在 GAE 之后按参考片段分组去均值,必须先理解 GAE 才能明白它解决了什么问题。
行为克隆(BC)
一种模仿学习:直接用监督学习让策略的输出回归专家演示动作,损失形如 $\mathcal{L}_{BC} = \|\mu_\theta(o_D) - a_D\|_2^2$。它不需要环境交互,但受限于演示分布、没有纠错能力。在参考跟踪中,纯探索很难发现精确的双手机接触序列,因此常用 BC 把验证成功的演示动作注入 PPO 训练,形成 RL+BC 混合目标。
DONIC 的训练循环是 PPO+BC:轨迹专属策略和共享策略自身的成功执行被验证后回收为演示库,理解 BC 才能看懂这个反馈回收机制。
人-机运动重定向(Motion Retargeting)
把人手运动映射到机器人灵巧手的过程。人手与机器人手运动学不同(人手约 24 自由度,Wuji Hand V1 每手 6 个手腕坐标 + 20 个手指关节),需要逐帧优化机器人关节角,使五指指尖、额外关键点和手腕对齐到人手对应位置,同时满足关节限位。常用 SmoothL1 位置损失 + NLopt 求解器,以前一帧解初始化保证时间连续性。
BiHOI 和公开数据集的人手动作都要经过重定向才能变成机器人参考,重定向质量决定了参考是否物理可执行,是整条数据流水线的关键环节。
MANO 手部参数模型
业界标准的人手统计网格模型,用低维参数表示手:45 个轴角姿态参数(15 个关节 × 3)加形状系数 β。给定参数即可输出包含 778 个顶点的手网格和 21 个关节位置。通过把多视角三角化的关键点拟合到 MANO 模型(形状在序列内固定),可以从图像恢复度量的人手网格轨迹,是手-物体交互数据集的通用交换格式。
BiHOI 重建流水线和公开数据统一格式都以 MANO 参数表示人手,重定向从 MANO 关键点出发拟合到机器人连杆。
Isaac Gym 并行物理仿真
NVIDIA 的 GPU 加速物理仿真器,把成千上万个环境实例放在同一块 GPU 上并行模拟,使 PPO 等需要海量采样数据的强化学习训练成为可能。本文用 8192 个并行环境、rollout 周期 64 步,每次迭代产生 524,288 条环境转移。物体密度、手摩擦系数、PD 控制参数等都在其中配置。
DONIC 的全部训练与评估都在 Isaac Gym 中进行,理解其并行采样规模有助于评估复现所需算力。
研究动机
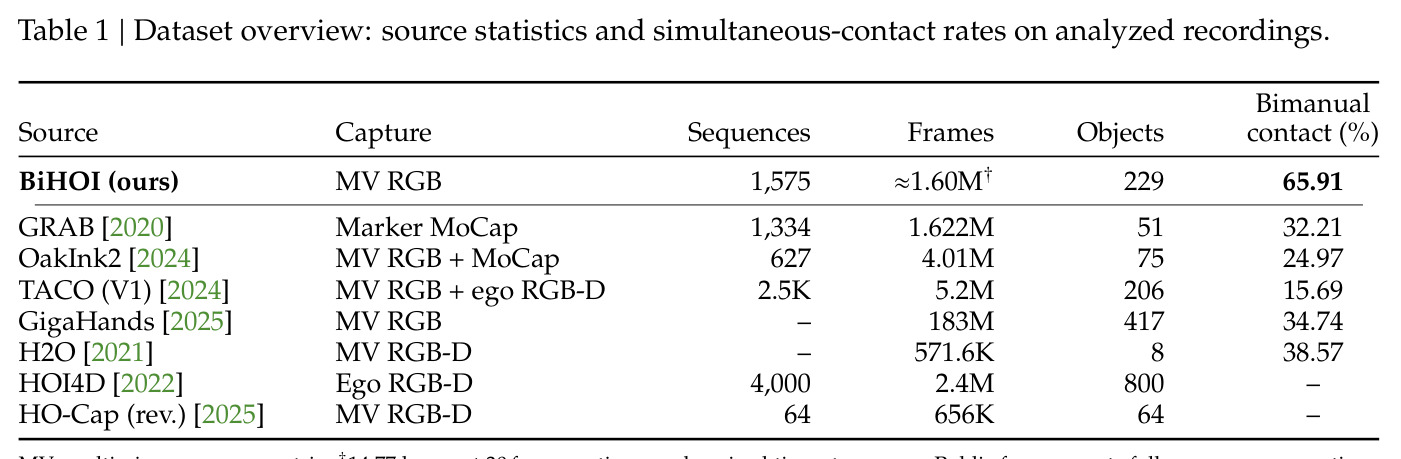
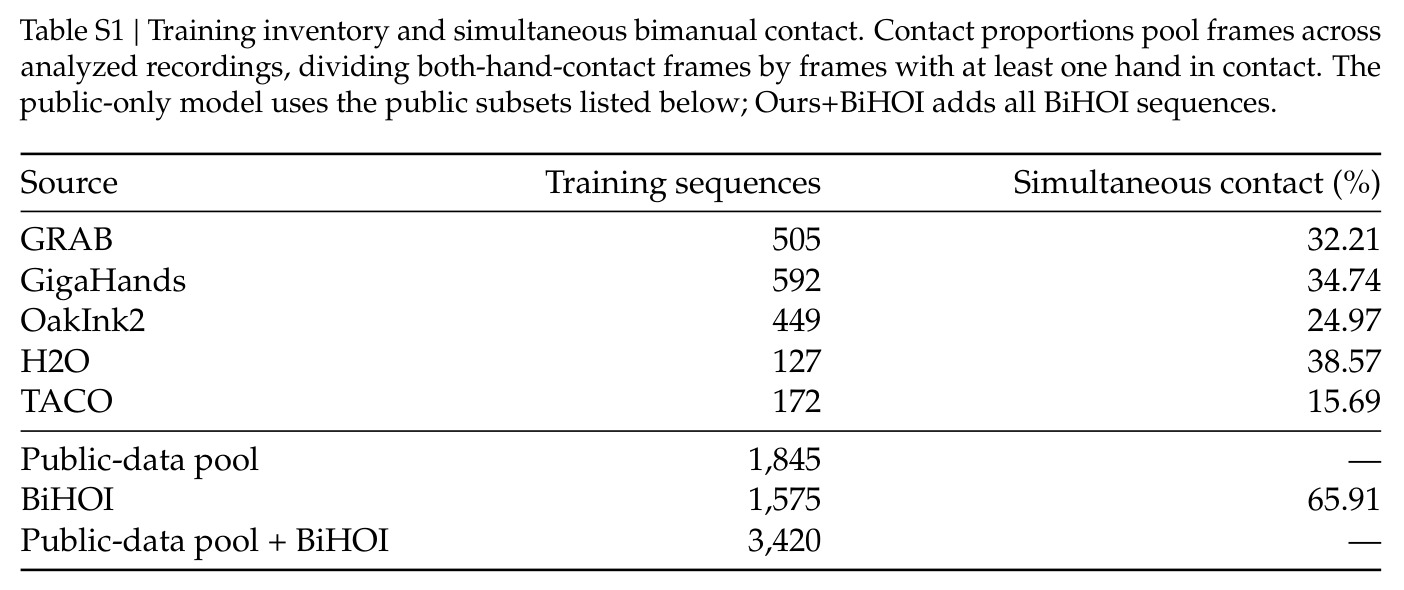
灵巧操作的参考跟踪近年进展迅速,但 DexTrack(ICLR 2025)、Dexplore(CoRL 2025)、AdaDexTrack 等模型几乎全部聚焦单手操作,交互类型有限,而真实生活中大量任务依赖双手不对称协调——一只手稳定物体,另一只手开盖、切割、翻转或重新放置(如扶碗削皮、双手拧开罐子)。构建通用双手跟踪器面临两个具体困难。其一,数据稀缺:公开数据集虽包含双手操作,但完整跟踪且具有持续双手接触的序列很少。论文统计了各数据集录制中的'双接触率'(双手同时接触物体的帧占接触活跃帧的比例):GRAB 32.21%、OakInk2 24.97%、TACO 15.69%、GigaHands 34.74%、H2O 38.57%,公开子池合计仅 31.40%,即超过三分之二的接触时间只有单手在物体上,协调模式覆盖不足。其二,训练信号设计困难:共享策略必须学习手部角色随时切换、接触时机异步的轨迹;手部位姿精度高不等于物体被成功操作,而要求双手同时满足接触条件的奖励结构会让一只手的失败乘掉另一只手的进步;此外不同参考片段难度差异悬殊,GAE 优势在难片段上系统性偏负,导致这些片段中真正有用的动作得不到强化。
本文的目标是本文要构建首个跨操作类别、跨人运动数据源联合训练的通用双手灵巧跟踪器 DONIC:给定一段包含双手腕坐标、手指关节角与物体 6-DoF 位姿的参考轨迹 $\tau=\{(\hat{q}_L^t, \hat{q}_R^t, \hat{p}_o^t, \hat{R}_o^t)\}_{t=0}^T$,一个策略同时控制两只 Wuji Hand V1 灵巧手,通过物理交互复现物体运动,并且在测试时无需任何微调即可跟踪训练物体的新轨迹(UNSEEN-TRAJ,53 条)和held-out物体(UNSEEN-OBJ,164 条)。配套地,构建多视角双手交互数据集 BiHOI:1,575 条序列、229 个物体、14.77 小时有效交互、32 个标定 RGB 相机,强调持续性双手接触(双接触率 65.91%,比最高公开子集 H2O 的 38.57% 高 27.34 个百分点),并经重建-重定向后与 5 个公开数据集筛选出的 1,845 条参考合并为 3,420 条训练池。成功标准扩展 AdaDexTrack 协议:双手各自独立满足 $\frac{1}{2}(T_o+T_h)\le 10$ cm、$\frac{1}{2}(R_o+R_h)\le \pi/3$、$E_{finger}\le 2\pi/9$ 才算成功。
与已有工作不同的是,已有工作切入角度各不相同:逐序列训练专属策略的有 ManipTrans(复用通用手部模仿器 + 任务专属残差策略)、DexMachina(逐步撤除虚拟物体辅助)、CHORD(接触旋量匹配)、ConTrack(每条片段单独训练);单手通用化的有 DexTrack(轨迹专属控制器挖掘演示再蒸馏)、Dexplore(参考范围内扩张探索)、AdaDexTrack(专家蒸馏 + 在线参考调制);双手方向最接近的是 BiDexHD——为每个操作类别单独蒸馏一个策略,只在类别内测试新物体-工具组合,以及 PhysGraph——把任务训练的策略迁移到新工具/物体几何。本文的独特之处有三:一是把'以物体为中心'的反馈作为奖励核心,物体运动对齐全程计分、接触监督按参考要求的接触角色门控启用,天然支持异步接触与角色切换;二是提出 Clip-Centered Advantages,按参考片段分组减去组内平均优势而不除以组内标准差,在保留片段内差异的同时消除片段间难度偏移;三是从数据侧切入,用 32 视角重建 + 重定向流水线把高双接触率的 BiHOI 转化为可训练参考,直接扩充协调模式覆盖。
核心方法
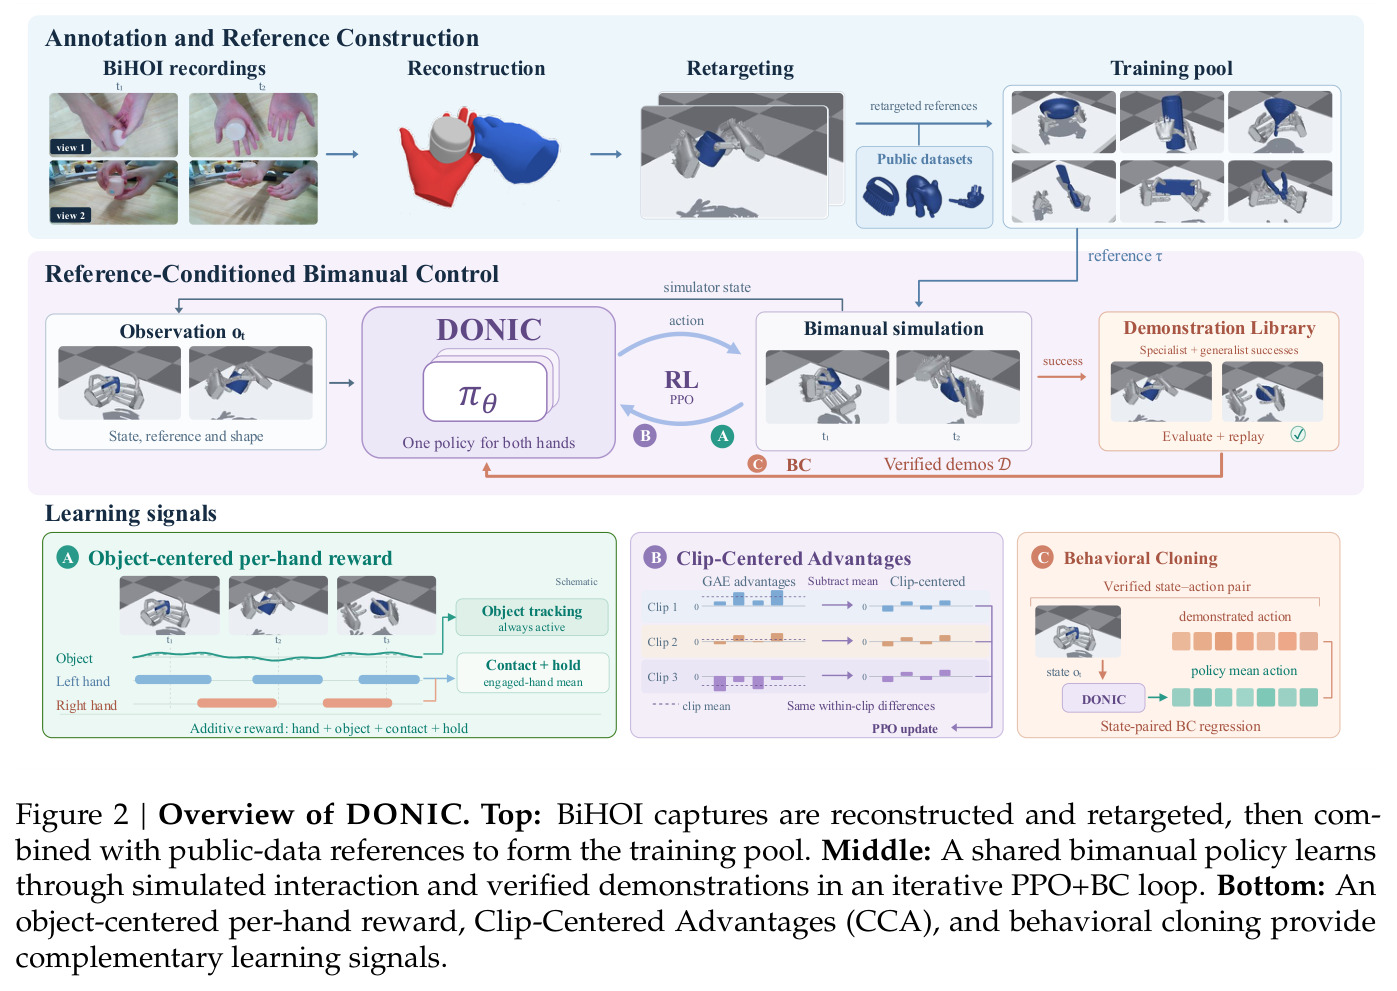
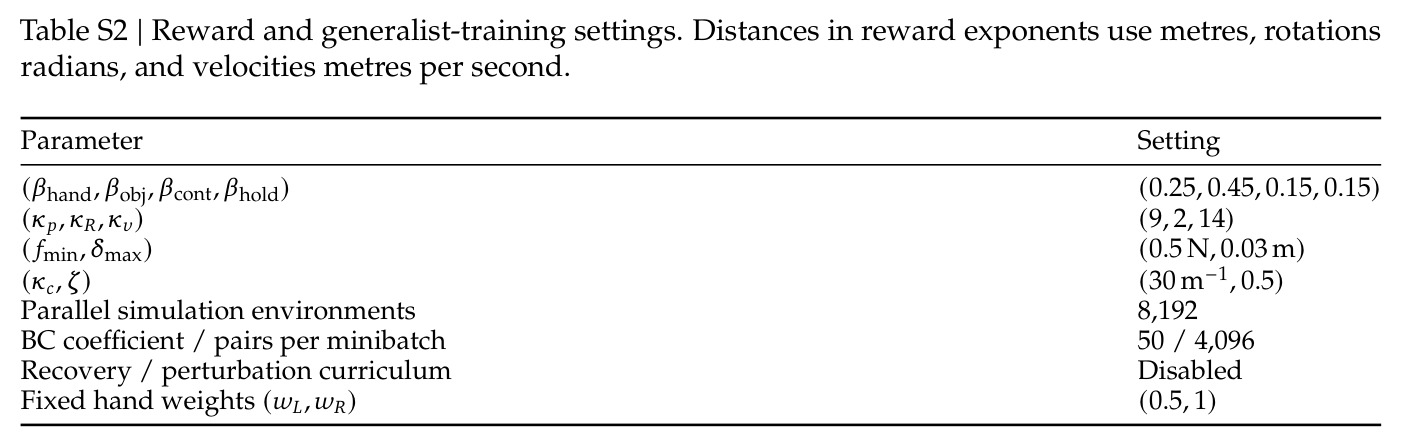
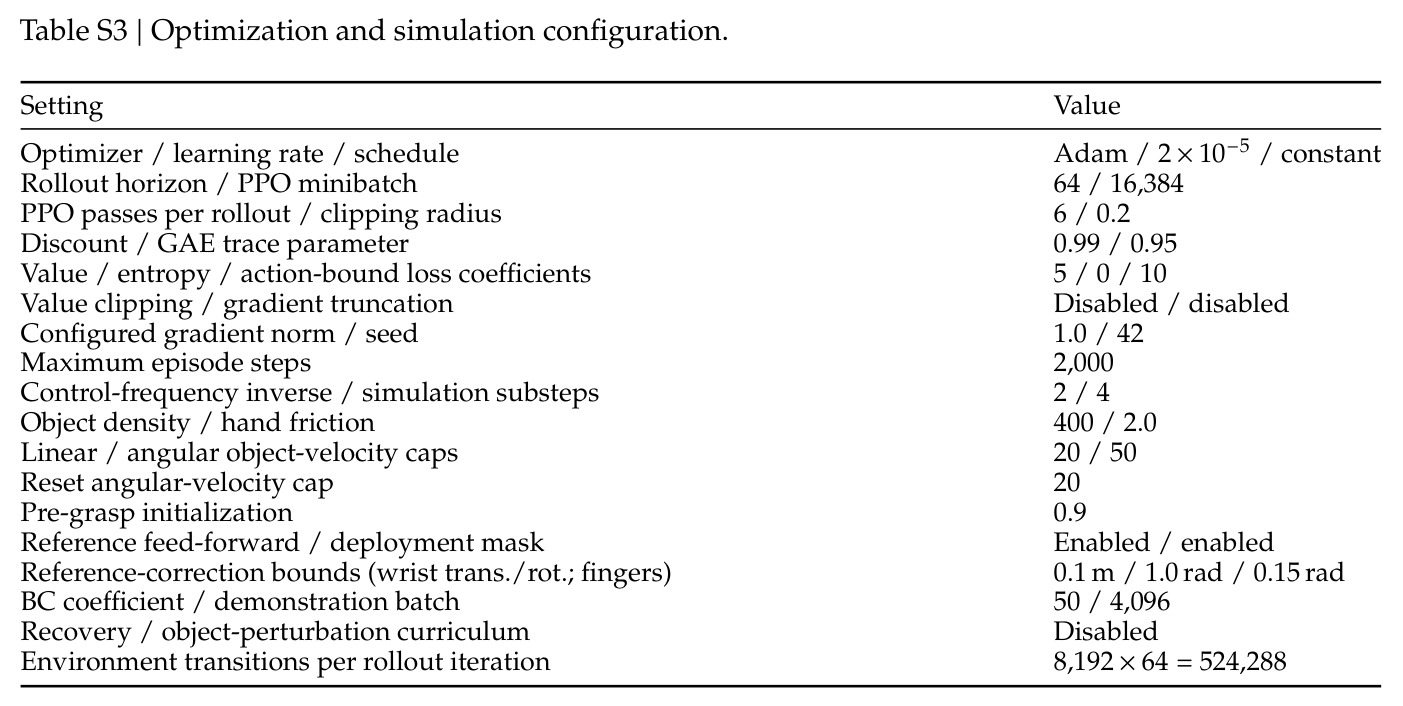
直觉上,跟踪一条双手+物体的参考轨迹就像双人舞编舞执行:舞步(参考)是给定的,执行者(策略)需要在物理世界中带着接触力矩把舞步走出来,允许微调但不允许脱离。技术路线上,DONIC 用一个随机策略 $\pi_\theta(a_t|o_t)$ 同时控制两只手。观测 $o_t$ 共 3,016 维(2,884 基础特征 + 132 维物体描述子),按手分块包含本体感觉、物体位姿与速度、未来参考目标、状态-参考误差、指尖到物体的距离向量,全部在各自手腕朝向坐标系下表达;物体描述子含 128 维 BPS(basis point set)形状编码、物体尺度与质心;另有手身份和固定的左手奖励权重 $w_L$。策略输出有界修正 $a_t\in[-1,1]^{52}$,PD 目标为 $q_t^{pd}=\mathrm{clamp}(\hat{q}^{t+1}+s\odot a_t,\ q_{min},\ q_{max})$,修正每步锚定在下一步参考、不累积(手腕平移 0.1 m、手腕旋转 1.0 rad、手指关节 0.15 rad)。训练采用 PPO+BC 的迭代循环:轨迹专属策略(specialist)先优化经回放筛选的参考,验证成功的 rollout 进入演示库 $\mathcal{D}$;共享策略的验证成功也回收入库,形成自我强化的反馈闭环。仿真用 Isaac Gym 8192 并行环境,actor/critic 为独立的 MLP $[1024,1024,1024,512]$,Adam 学习率 $2\times10^{-5}$。
核心创新有两个。其一是物体中心按手奖励(object-centered per-hand reward):总奖励 $r_t=(1+w_L)[\beta_{hand}r_t^{hand}+\beta_{obj}r_t^{obj}+\beta_{cont}r_t^{cont}+\beta_{hold}r_t^{hold}]$,系数 $\beta=(0.25,0.45,0.15,0.15)$。物体项 $r_t^{obj}=e^{-\kappa_p\|p_o^t-\hat{p}_o^t\|_2}e^{-\kappa_R\angle(R_o^t,\hat{R}_o^t)}e^{-\kappa_v\|v_o^t-\hat{v}_o^t\|_2}$($\kappa=(9,2,14)$)全程有效,速度因子专门惩罚'参考在动、物体静止'的偷懒解;接触项则只在参考要求某手接触时启用,指尖接触判定 $\alpha_{i,t}^h=\mathbb{1}[f_{i,t}^h>0.5N]\cdot\mathbb{1}[\delta_{i,t}^h<0.03m]$(力+距离双重门控),接触奖励混合接近度 $e^{-\kappa_c\delta}$ 与覆盖度($\zeta=0.5$),维持项 $r^{hold}$ 奖励所需指尖的瞬时接触覆盖、允许合法的滑动与滚动。聚合时按参与手集合 $\mathcal{E}_t=\{h:C_h^t\ne\emptyset\}$ 加权平均($w_R=1,w_L=0.5$)而非相乘,一只手失误不会抹掉另一只手的信号,参考释放阶段也不奖励'赖着不松手'。其二是 CCA:$\tilde{A}_j=A_j^{GAE}-\frac{1}{|G_{m(j)}|}\sum_{k\in G_{m(j)}}A_k^{GAE}$,按参考身份(而非环境实例或时间相位)分组去均值,消除困难片段的系统性优势偏移,同时保留片段内转移间的成对差异。
方法步骤详情
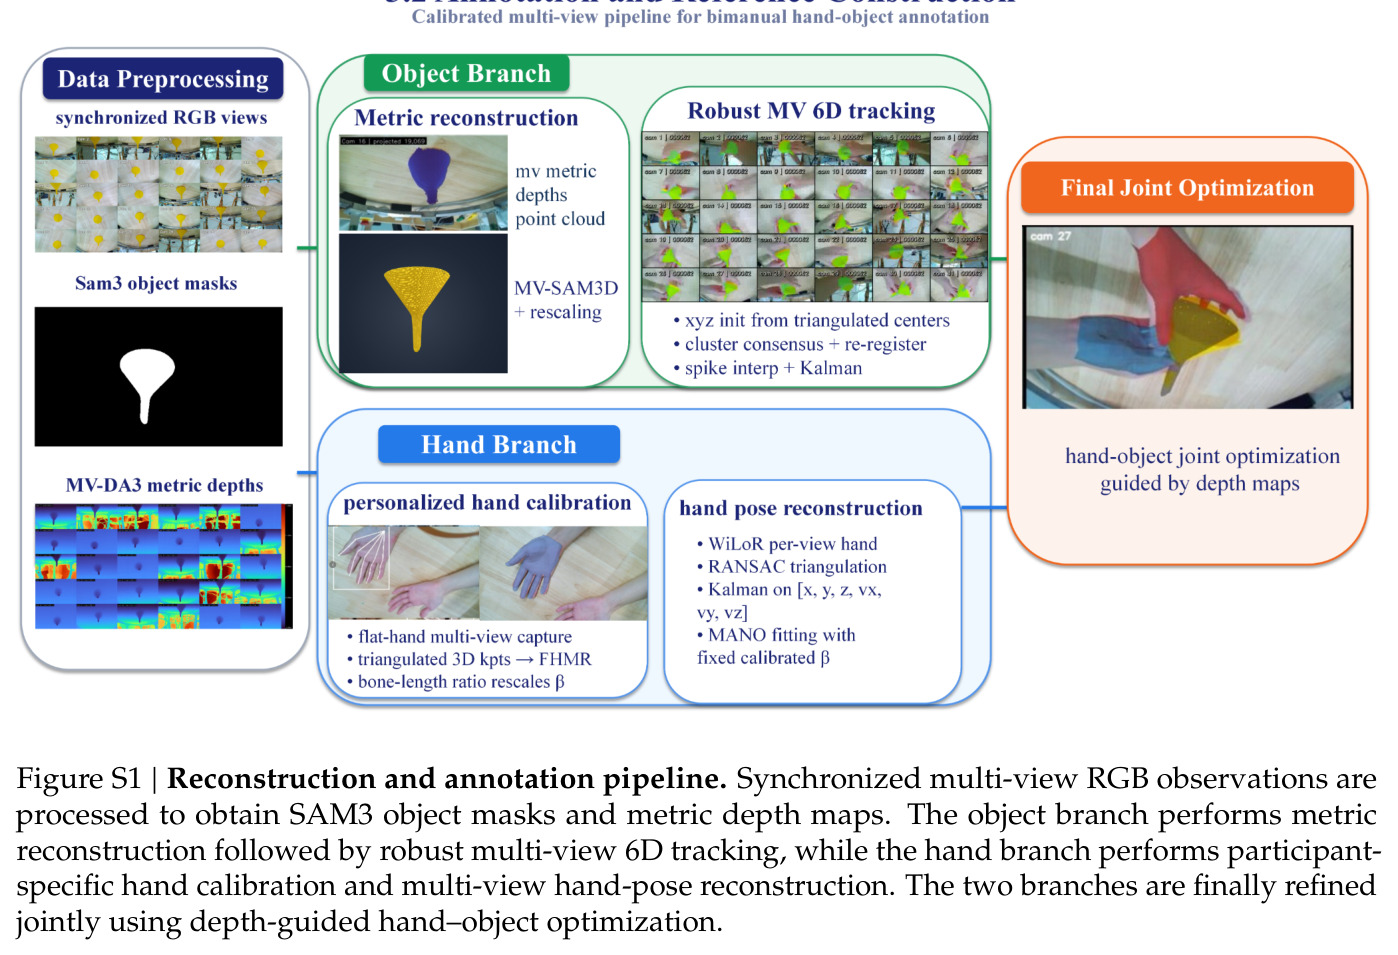
完整流程五步。第一步数据采集与重建:32 个标定 RGB 相机(1920×1232@30fps)环绕桌面;SAM3 生成物体掩码(首帧跨相机一致分割 + 时序跟踪),Depth Anything 3 用标定外参对齐到度量尺度生成深度,MV-SAM3D 从首帧多视角重建规范物体网格、用深度点云主轴范围中位数估计物理尺度,FoundationPose 以多视角位姿共识(旋转测地距离 <30°、平移 <5 cm、至少 4 视角一致)跟踪 6-DoF 并在共识失败时重注册;手部分为参与者特定 MANO 标定(平手序列三角化估计手尺度 $s_{hand}$)+ WiLoR 关键点三角化 + 常速卡尔曼滤波 + MANO 拟合,最后用 SDF(32 视角、3 mm 体素)联合精修手与物体。第二步重定向与筛选:帧级运动学拟合到 Wuji Hand V1(15 个目标点 = 5 指尖 + 5 额外关键点 + 手腕×5,SmoothL1 + NLopt 关节限位),10 fps 源转 30 fps 控制;开环零修正回放将参考分为 A-F 六类,排除 A(立即丢物)与 B(物体弹出),保留 C-F(含'接触但提不起'——反馈控制仍可挽回)。第三步组池:公开数据筛选得 1,845 条(GRAB 505、GigaHands 592、OakInk2 449、H2O 127、TACO 172),Ours+BiHOI 加全部 1,575 条至 3,420 条。第四步迭代训练:PPO 用 CCA 修正后的优势更新 actor,BC 以 $\lambda_{BC}=50$ 权重回归演示库中 4,096 对/批的动作;演示入库需经重放验证(检查物体位移与按需提举)。第五步评估:单一 frozen checkpoint 直接在 53 条未见轨迹 + 164 条未见物体上测试,用策略均值动作、从首帧启动。
技术新颖性
技术新颖性可从四个层面评估。第一,任务层面:这是首个跨操作类别、跨人运动数据源联合训练的双手参考跟踪 generalist——BiDexHD 按类别蒸馏独立策略、DexTrack/Dexplore/AdaDexTrack 限于单手、ManipTrans/DexMachina 是逐序列专属策略,'一个 checkpoint 零微调跨类别跟踪双手参考'的设定本身是新的。第二,奖励结构层面:单手跟踪通常把物体项与手部项耦合在一个乘法链里,双手异步场景下这会让未参与手污染奖励;本文的参与手集合加权平均 + 接触所有权门控(force+proximity 双条件)是针对双手互补角色的原创设计,'hand-pose accuracy does not ensure object manipulation' 这一观察落实到了具体奖励数学上。第三,优化层面:CCA 与批级 advantage normalization 本质不同——后者对所有样本施加同一平移与缩放,会压缩片段内差异;CCA 只减去每个参考组的均值、保留原始尺度,作用于 actor 学习信号而不修改 reward 或 critic 回归目标,作者也诚实地指出这是经验中心化,代数恒等式并不能证明梯度估计无偏。第四,数据层面:'接触率'指标(双接触帧/接触活跃帧)把各数据集的协调密度变成可比数字,并以 65.91% 的实测值支撑 BiHOI 的差异化定位;演示回收循环继承自 DexTrack,但扩展到了双手共享策略的成功验证回注。
实验结果
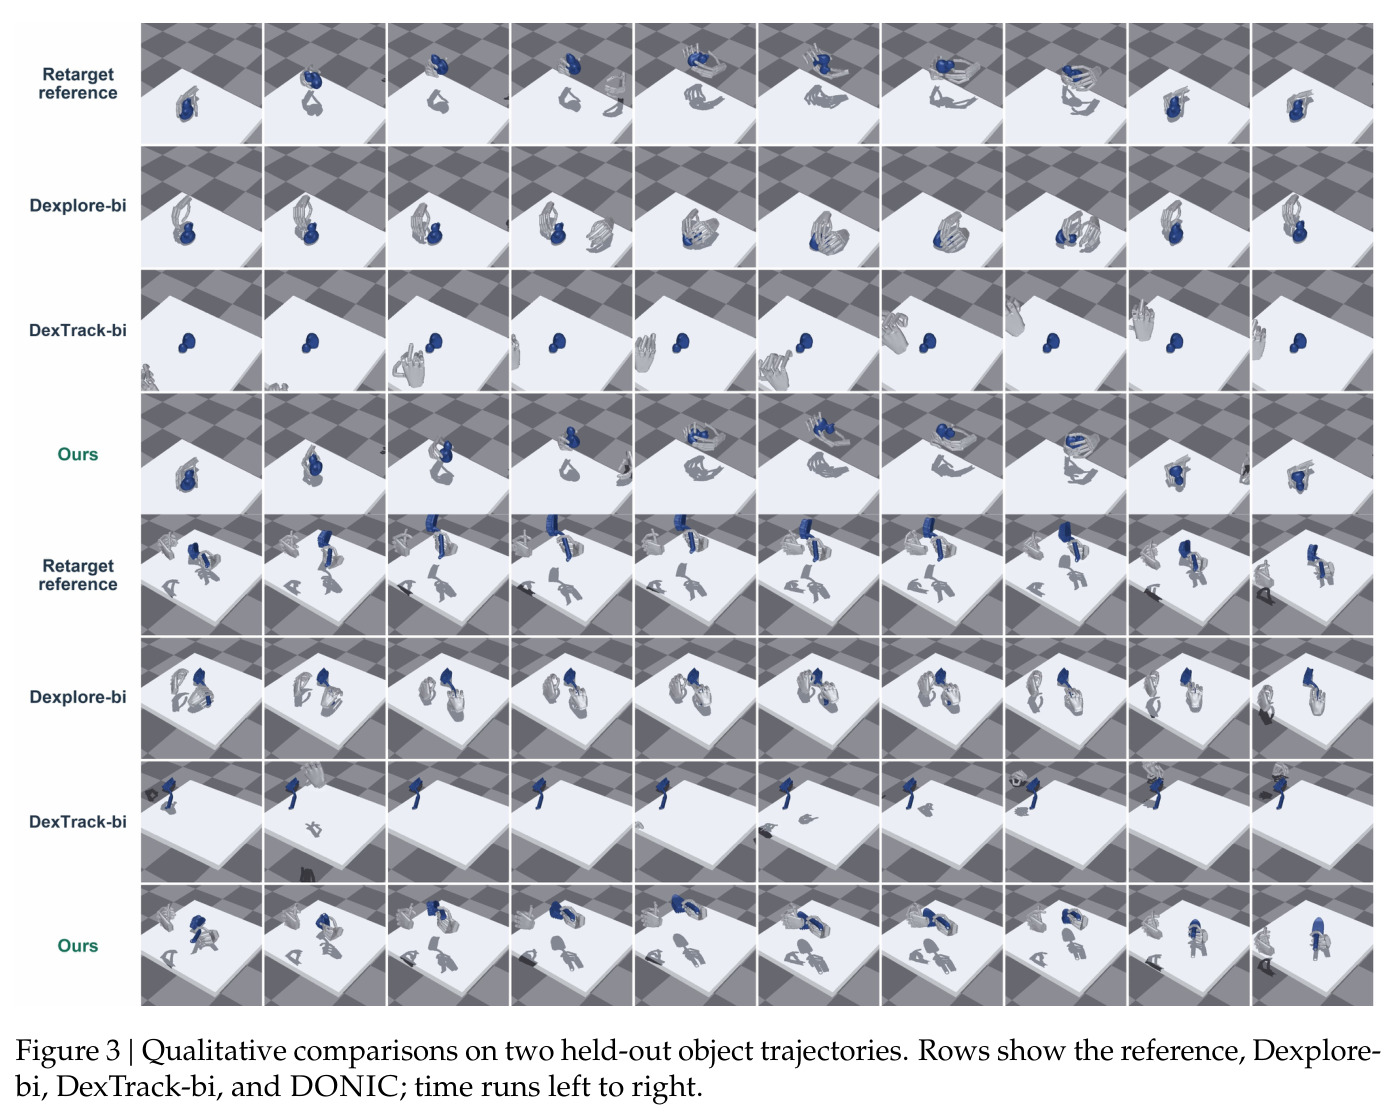
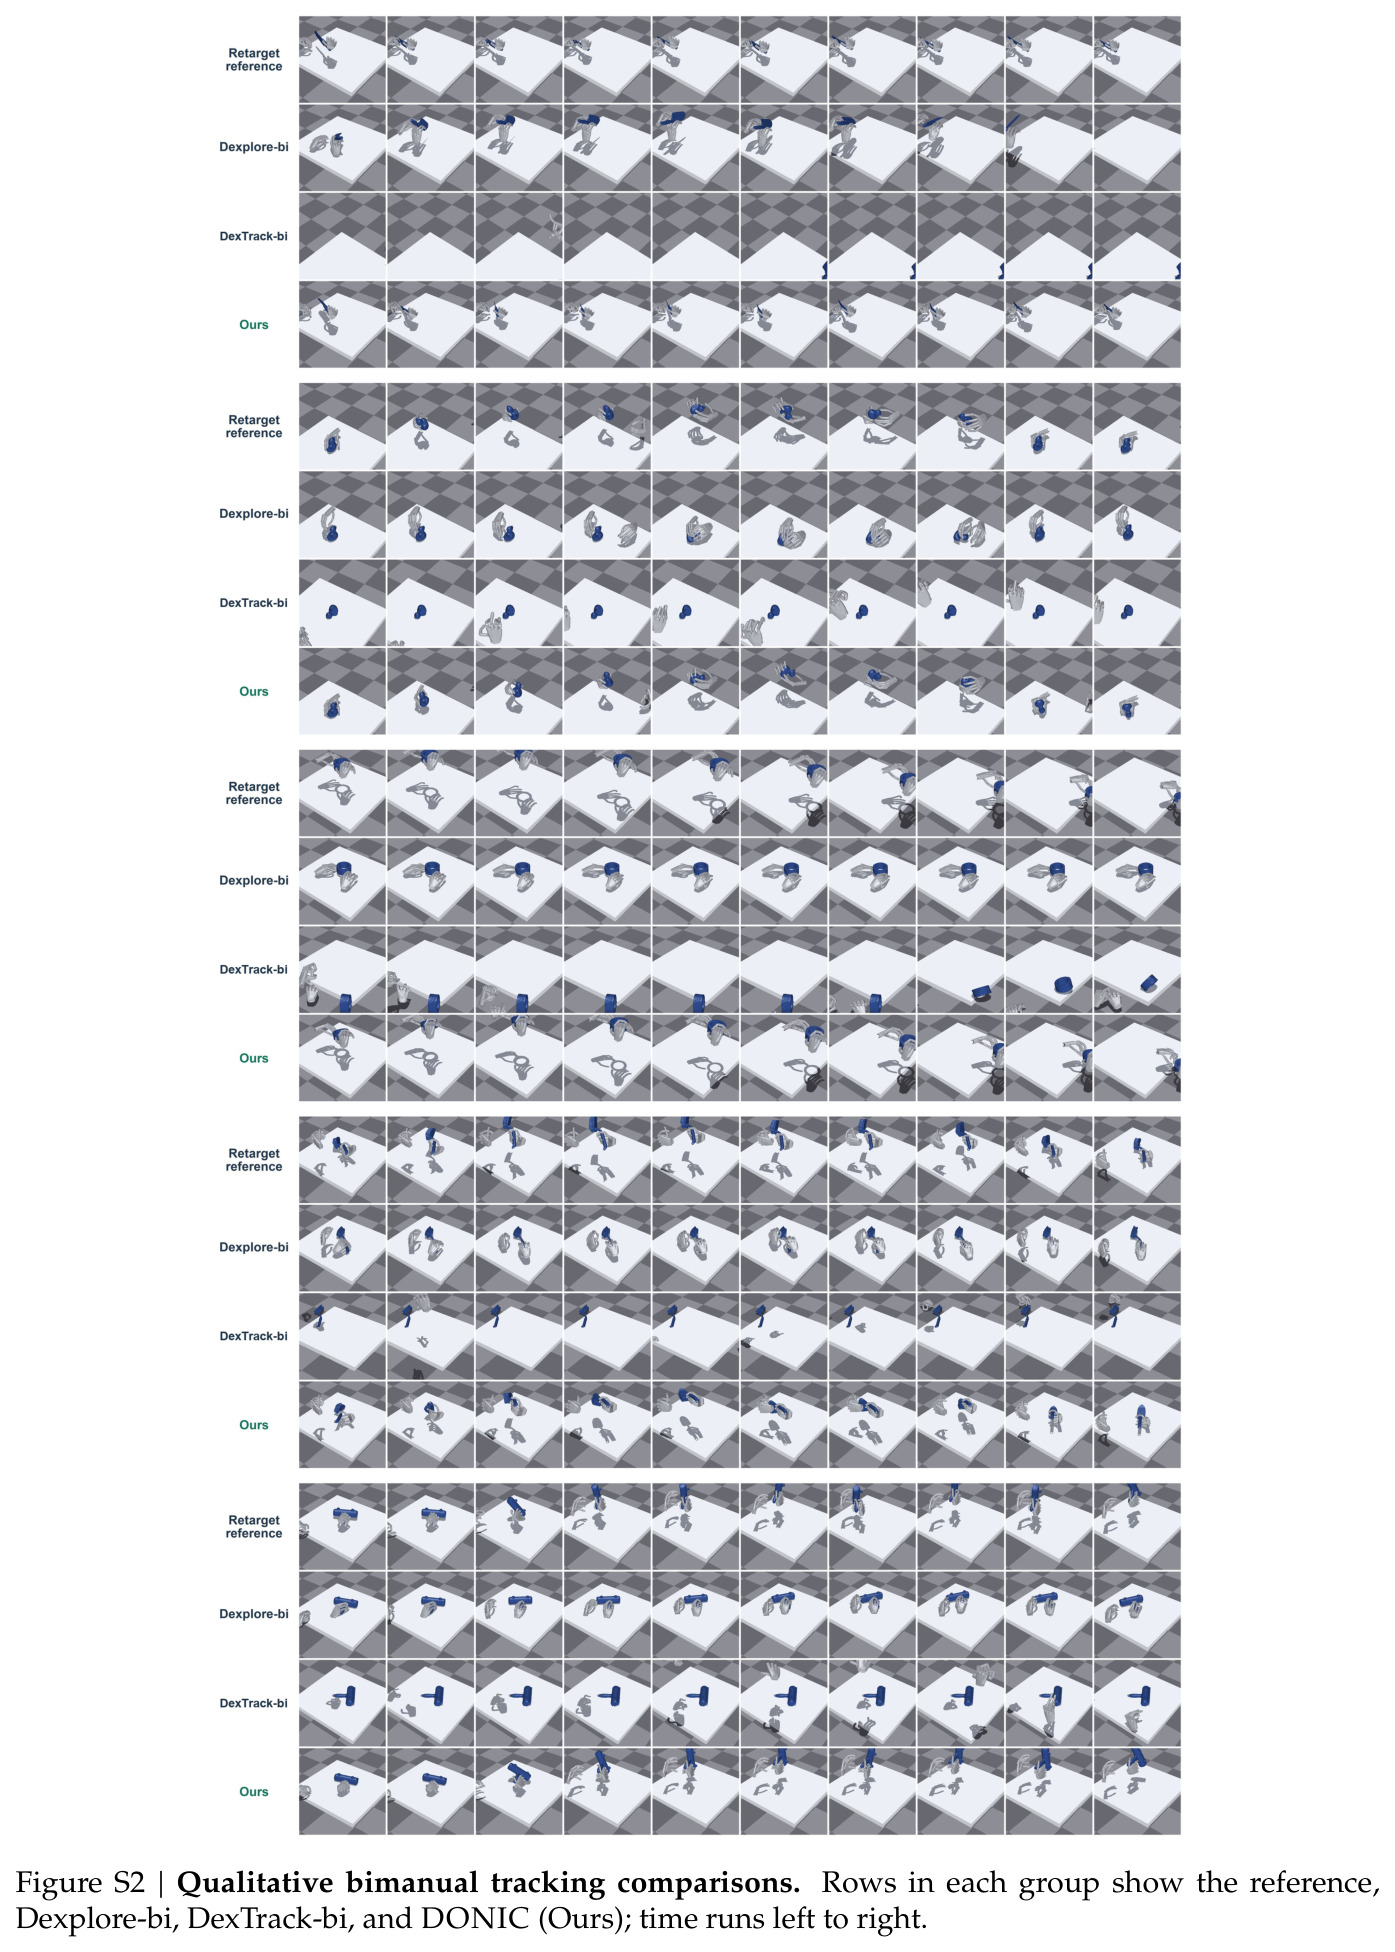
主实验(Table 2)在两个 held-out split 上用每个方法单一 checkpoint 零微调评测。UNSEEN-TRAJ(53 条训练物体新轨迹):DexTrack-bi 完全失败(SR 0.00%、Comp 1.30%、$T_o$=41.86 cm、$R_o$=2.3340 rad);Dexplore-bi SR 9.43%、Comp 27.87%、$T_o$=14.73 cm、$T_h$=21.88 cm;DONIC 达到 SR 86.79%、Comp 67.62%、$T_o$=10.27 cm、$T_h$=3.96 cm、$E_{finger}$=0.0372 rad——相对更强基线 Dexplore-bi,SR 提升 77.36 个百分点、Comp 提升 39.75 个百分点、腕部位移误差从 21.88 cm 降至 3.96 cm。UNSEEN-OBJ(164 条 held-out 物体):DexTrack-bi SR 0.00%、Comp 0.88%、$T_o$ 高达 127.87 cm;Dexplore-bi SR 11.59%、Comp 26.37%;DONIC SR 57.32%、Comp 54.69%、$T_o$=15.74 cm、$T_h$=4.58 cm(提升 45.73 pp)。Ours+BiHOI 进一步全面领先:UNSEEN-TRAJ SR 88.68%、Comp 68.72%、$T_o$=9.74 cm;UNSEEN-OBJ SR 59.76%、Comp 55.35%、$T_o$=15.74→13.96 cm(降 11.3%),在未见物体全部七项指标上排名第一。消融证实两个设计都必要:去掉 CCA 使 SR 跌至 81.13%/48.17% 且五项误差全部上升;去掉接触门控(改用纯力判定 $f>0.5N$)SR 跌至 81.13%/48.78%,个别误差反而略低但 Comp 双双下降,说明门控换来了更稳的双手协调。图 3 定性对比显示 Dexplore-bi 手在动但物体几乎不动、DexTrack-bi 丢失手-物对齐,DONIC 则双 Hand 协调复现参考物体运动。由于 SR/Comp 要求双手各自独立达标,这些提升反映的是真正的双手执行成功而非单手精度。
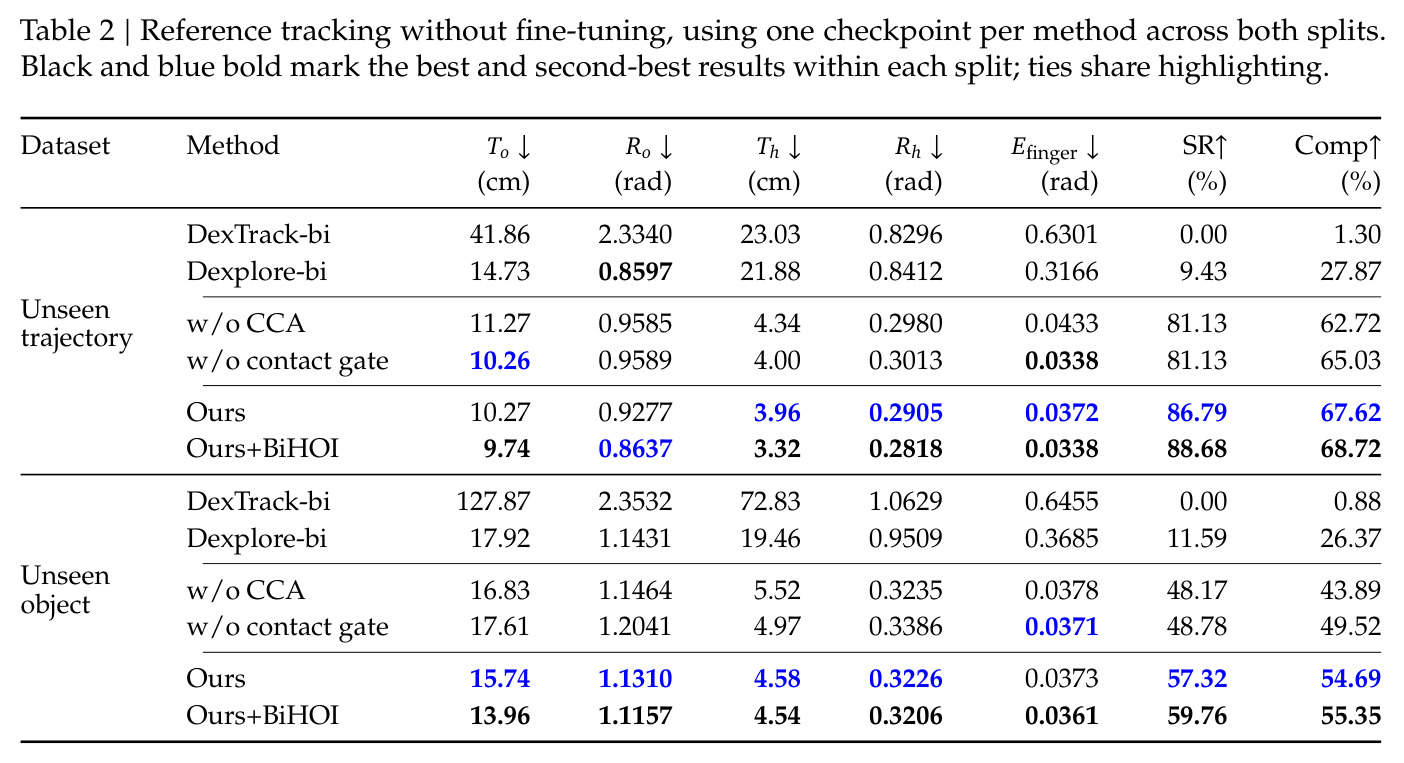
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 未见轨迹跟踪(UNSEEN-TRAJ,53 条训练物体新轨迹) | 成功率 SR(双手独立达标:½(T_o+T_h)≤10cm,½(R_o+R_h)≤π/3,E_finger≤2π/9) | 86.79% | Dexplore-bi 9.43%,DexTrack-bi 0.00% | +77.36 pp(相对 Dexplore-bi) |
| 未见物体跟踪(UNSEEN-OBJ,164 条 held-out 物体) | 成功率 SR | 57.32% | Dexplore-bi 11.59%,DexTrack-bi 0.00% | +45.73 pp(相对 Dexplore-bi) |
| 未见轨迹跟踪(UNSEEN-TRAJ) | 完成率 Comp(逐帧双手达标比例) | 67.62% | Dexplore-bi 27.87%,DexTrack-bi 1.30% | +39.75 pp |
| 未见轨迹跟踪(UNSEEN-TRAJ) | 腕部位移误差 T_h(取较差手的轨迹均值再平均) | 3.96 cm | Dexplore-bi 21.88 cm | 降低 17.92 cm(约 5.5 倍) |
| 未见物体跟踪(UNSEEN-OBJ) | 物体平移误差 T_o | 13.96 cm(Ours+BiHOI) | Ours(公开数据)15.74 cm,Dexplore-bi 17.92 cm | BiHOI 数据降低 11.3% |
局限与改进
作者明确承认的局限:定量评估完全在仿真中进行,只覆盖参考条件化的单刚性物体跟踪;没有真机实验,也没有评估长时程、多物体或目标条件操作;参考依赖'重建+重定向'流程,重建误差会传导为控制误差;接触监督使用合力+距离代理,而合力无法识别碰撞对象(手可能压在桌面却被记为接触物体);重建优化不含显式接触/穿透/碰撞损失;评估未覆盖对 held-out 操作类别的泛化(作者专门强调两个 split 只测试参考与物体泛化)。我自己的观察:第一,SR 与 Comp 存在明显落差(UNSEEN-TRAJ 86.79% vs 67.62%,UNSEEN-OBJ 57.32% vs 54.69%),说明相当比例的 clip 内存在逐帧失败的窗口,长片段中的接触维持仍是弱点;第二,UNSEEN-OBJ 上 57.32% 的成功率与 15.74 cm 的物体平移误差表明物体级泛化仍是瓶颈,未见物体的形状/尺度不匹配时策略会明显退化(基线 $T_o$=127.87 cm 是极端证据);第三,左手奖励权重 $w_L=0.5$、各 $\beta$ 系数均为手工固定值,论文没有给出敏感性分析或自适应方案的消融;第四,UNSEEN-TRAJ 上 DONIC 的物体旋转误差 $R_o$=0.9277 rad 反而略逊于去掉接触门控版本的 0.9589 rad,说明接触门控有时以牺牲部分轨迹保真度换取联合成功率;第五,接触'力+距离'代理在双手靠得很近的协调动作中容易把对方手的接触误归到自己头上,这是双手场景特有的系统性风险。
独立分析的弱点
独立分析几个具体弱点并给出改进方向。第一,接触归因代理不可靠:合力大小无法区分碰撞伙伴,在双手贴近操作(如共同托举盘子)或手-桌面接触时会误判,改进方向是利用仿真器提供的接触对(contact pair)标签做精确归因,或学习一个轻量接触分类头。第二,参考可行性筛选较粗:开环回放只排除立即丢物与弹出(A/B 类),C 类'接触但提不起'被保留,其中可能混有重定向误差过大、本质上不可执行的参考,改进方向是训练一个参考可行性预测器(输入参考统计特征输出可执行概率)提前过滤,减少 specialist 阶段的算力浪费。第三,物体表示过于简化:多物体录制只保留单一主物体(TACO 保工具、OakInk2 选主物体),铰接与形变物体被当作刚性网格处理,改进方向是把铰接自由度状态加入观测与奖励,向 ArtManip 类任务扩展。第四,仿真到真机的鸿沟完全未验证:手摩擦 2.0、物体密度 400、PD 增益等设定在真实 Wuji Hand 上难以精确复现,改进方向是加入域随机化 + 真机少量微调的 sim-to-real 流水线,先在少量真机 clip 上报告指标。第五,Comp 偏低暗示中段接触丢失:策略在长 clip 中段容易滑脱后难以恢复(恢复与扰动课程被禁用),改进方向是把片段难度(例如 CCA 前的组均值本身)作为课程信号调度采样比例,或启用自适应恢复采样。第六,固定非对称权重 $w_L=0.5$ 缺乏依据,可能系统性偏置右手主导的参考,改进方向是按参考中每手的接触时长自适应设定权重并做系统消融。
未来方向
作者提出的方向:把 DONIC 扩展到长时程与多物体操作;在一个独立基准上评估以避免自建 split 的偏差;研究向物理双手系统的迁移。基于本文成果可以自然延伸的研究:第一,与视觉感知闭环结合——当前观测使用仿真器真值物体位姿,把 FoundationPose 类的实时位姿估计接入观测可以做基于相机的闭环跟踪,进入真机部署路径;第二,数据飞轮自动化——BiHOI 的重建流水线(SAM3 + Depth Anything 3 + MV-SAM3D + FoundationPose + WiLoR)全部由现成模型组成,有望完全自动化并在 Internet 视频上运行,把训练池推向千小时级并结合语言标注实现'任务指令→参考轨迹→策略执行'的生成式操作;第三,CCA 的理论化——把按组优势中心化推广为一般性的'分组基线'框架,分析与 PPO 裁剪目标的交互、是否引入偏差,或与 per-reference critic heads 组合;第四,未见操作类别的 zero-shot 泛化与少样本快速适应(元学习或参考编码器预训练);第五,用可微接触模型或接触阻抗感知替代力+距离代理,让接触监督在真机上也可用;第六,与 world model 结合减少对 Isaac Gym 8192 并行环境的算力依赖,降低后续研究者的复现门槛。
复现评估
复现条件评估:论文附录非常详尽(Appendix B-D 覆盖全部超参数、奖励系数、筛选规则与评测协议),BiHOI 数据集与两个公开数据评测 split(53+164 clips)明确承诺公开,项目页为 ropedia.github.io/DONIC。训练端复现路径清晰:Isaac Gym 8192 并行环境、MLP $[1024,1024,1024,512]$、Adam $2\times10^{-5}$、PPO minibatch 16,384、rollout 64 步 × 6 次更新、$\gamma$=0.99、$\lambda_{GAE}$=0.95、$\lambda_{BC}$=50、固定策略尺度 sigma_init=-2.9、种子 42,每迭代 524,288 条环境转移——这属于中等偏大的 RL 算力,单节点多 GPU(如 4-8 张 A100 级别)可承担,但训练时长可能以天计。数据端复现难度高得多:完整重建流水线依赖 SAM3、Depth Anything 3、MV-SAM3D、FoundationPose、WiLoR 五个前沿模型且需要 32 相机标定采集棚,普通实验室难以重复采集 BiHOI,但可以只使用公开参考池(GRAB/GigaHands/OakInk2/TACO/H2O 筛选出的 1,845 条)复现 Ours 行。若作者发布代码与筛选后的参考池,复现 Table 2 主表结果是比较直接的;从零复现含数据采集的全流程则属于高难度。
论文图表
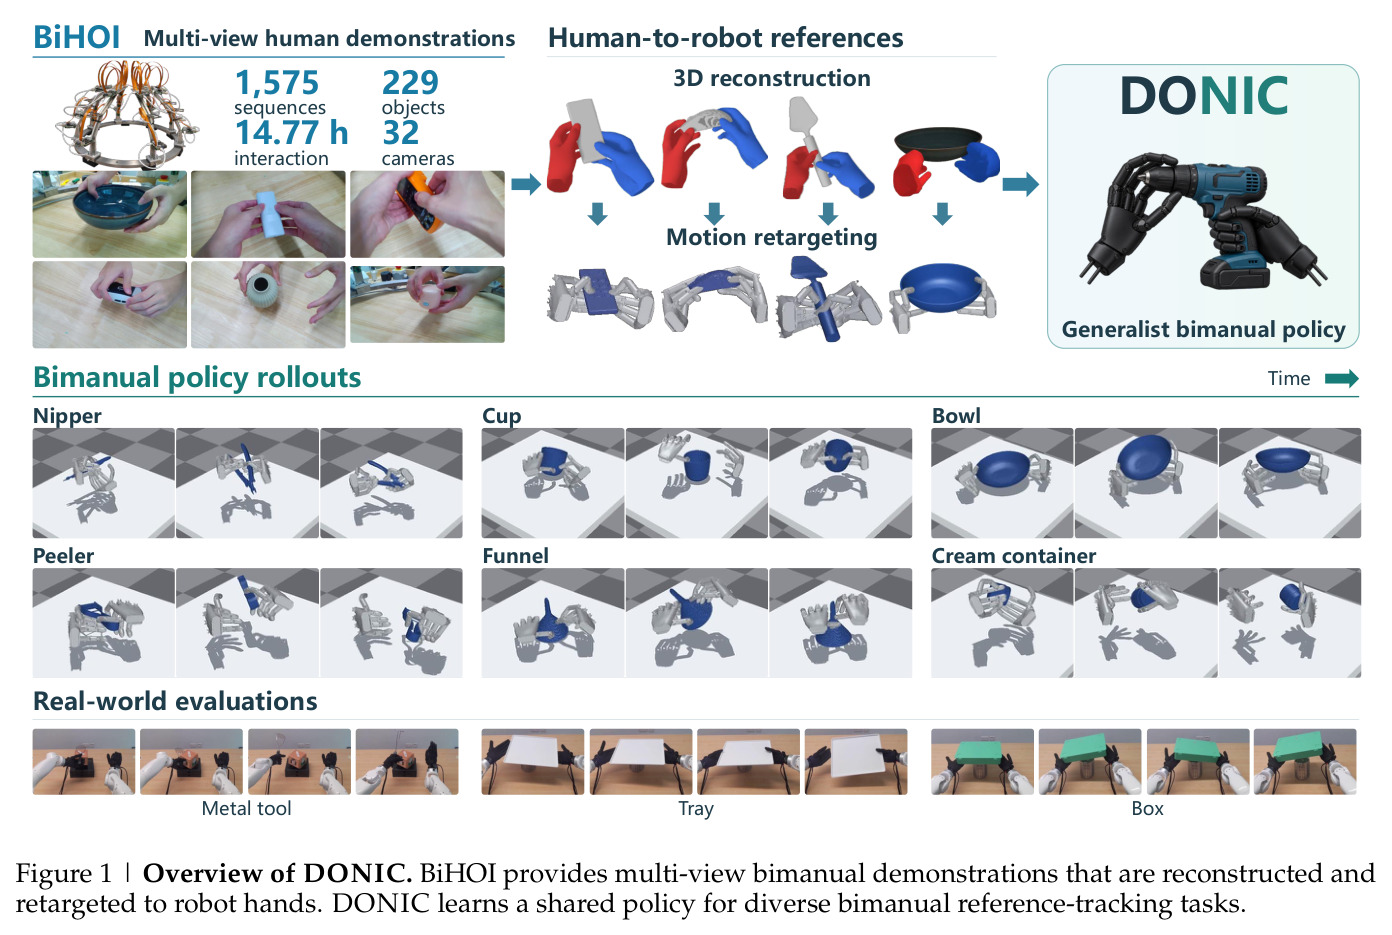
论文首页总览图:上半部分展示 BiHOI 数据采集(32 相机、229 物体、1,575 序列、14.77 小时)经 3D 重建与运动重定向变成机器人参考;下半部分展示通用双手策略在多个操作类别上的 rollout 示例(钳子、杯子、碗、削皮器、漏斗、奶油盒、金属工具、托盘、盒子)及真机评估场景。
一张图建立全文直觉:数据从哪来(人类演示→重定向)、学到什么(一个共享策略)、能做什么(跨物体类别的双手任务),适合作为读者进入论文的第一入口。