T-DIG:面向图像生成的文本条件多样性 T-DIG: Text-Conditioned Diversity for Image Generation
用GRPO训练LLM提示策略,让冻结的文生图模型按用户指定的自由文本轴生成多样化图像集。
前置知识
GRPO(组相对策略优化)
一种无需价值网络的在线强化学习算法(出自DeepSeekMath)。对同一输入采样一组 $G$ 个候选输出,分别计算奖励,然后把每个输出的优势定义为组内标准化:减去组均值、除以组标准差,用这个相对优势做策略梯度更新。它省掉了Critic模型,特别适合奖励容易计算但基线难估计的场景。
T-DIG的两个提示词策略完全靠GRPO训练。它的每个「补全」是一整组K个提示词、奖励是集合级的,组内相对比较天然对应「哪一组的沿轴多样性更好」这一优化目标,理解GRPO才能看懂第3节的训练设计。
LoRA(低秩适配)
参数高效微调方法:冻结原权重 $W_0$,只训练一个低秩增量 $\Delta W = BA$($B$、$A$ 秩很低),推理时权重为 $W_0 + \Delta W$。缩放系数 $\alpha$ 还可以连续调节增量的强弱。
T-DIG策略是Qwen3.5语言模型上的rank-32 LoRA适配器,而且作者巧妙地用LoRA缩放 $\alpha_s \in [0,1]$ 实现了用户界面上连续的「多样性强度」滑杆——这是理解方法设计和局限性(强度不感知校准)的前提。
TPIPS(文本条件感知相似度)
一个微调过的VLM相似度指标(同期工作,Wang et al. 2026):给定一张说明视觉方面的文本条件(如「光照」「姿态」),它把图像嵌入到「沿该方面看是否相似」的空间——两张图在其他方面不同、但在指定方面相像,嵌入就相近。这是首个以自由文本为条件的感知相似度度量。
TPIPS是全文的基石:主奖励 $D_a(X)$ 和主评测指标 TPIPSv(TPIPS嵌入的归一化Vendi分数)都建立在其上。没有「按文本条件测量相似度」的能力,沿用户指定轴的多样性既无法评测也无法训练。
Vendi Score(Vendi分数)
一个基于特征值谱的多样性指标:对样本嵌入的余弦相似度矩阵求特征值 $\lambda_k$,定义 $\mathrm{VS} = \exp(-\sum_k \lambda_k \log \lambda_k)$,含义是集合中「有效不同样本数」,介于1(全都一样)和K(全都不同)之间。它不要求事先定义聚类或类别。
T-DIG把TPIPS嵌入的Vendi分数归一化为 $D_a = (\mathrm{VS}-1)/(K-1) \in [0,1]$ 作为核心奖励项。理解它才能明白「奖励=沿轴有效图像数」这一直觉,也才能读懂论文中大量的 TPIPSv/DINOv 数值。
VQAScore
图文对齐指标(Lin et al. 2024):用视觉问答模型(CLIP-FlanT5-XXL)计算它对「这张图是否显示‘{提示词}’?」回答「Yes」的概率。相比CLIPScore,它对复杂提示和空间关系更可靠,是近年T2I评测的常用标准。
VQAScore在本文身兼两职:训练中作为对齐惩罚 $\mathcal{L}_{align}$ 的打分器(阈值按每个提示的i.i.d.基线校准),评测中作为对齐指标。论文里「多样性提升不掉对齐」的核心主张全部用VQAScore的变化来量化。
HPSv3(人类偏好分数v3)
一个模仿人类审美/偏好判断的图像质量评分模型(Ma et al. 2025),对「图像整体好不好看、讨不讨人喜欢」打分,与文本对齐相对独立。同类的还有ImageReward和LAION-Aesthetics。
它是奖励的第四个组成项,专门封堵一类特殊的reward hacking:策略把基础提示词当字幕印进图里,能抬高VQAScore对齐分,但只有HPSv3这类偏好分数才会降。消融实验(Table 2)清楚地展示了没有它会发生的失败模式。
i.i.d.采样与CFG guidance
i.i.d.采样指同一提示用独立随机种子/初始噪声生成K张图,是所有平台的默认做法;classifier-free guidance(CFG)是扩散模型的引导强度旋钮,调高它图像更贴提示但更单一,调低则更多样但更不贴提示——质量与多样性的经典权衡。
i.i.d.是本文所有实验的参照基线(多样性倍数、对齐变化、惩罚阈值都相对它定义);「降guidance换多样性」则是RQ3中质量-多样性帕累托前沿上最重要的无轴基线,理解这对权衡才能读懂主结果。
研究动机
文生图平台(Midjourney、Adobe Firefly等)每次提示返回四到八张图供用户挑选探索,但T2I模型是为单图质量优化的——高guidance scale、蒸馏少步采样都会压缩输出分布——导致整组图像高度雷同:论文实测中Qwen-Image的i.i.d.采样多样性(TPIPSv)仅0.12,FLUX.2 [klein]仅0.14。更关键的是多样性是情境相关的:作者的人类研究显示,面对同一提示「people sitting at a table with laptops and books」,一位用户想变「笔记本电脑与相机角度」,另一位想看「人们做不同的事」,第三位想变「人物族裔」;请求跨度从非常具体(「狗的品种」)到抽象开放(「漫画分格里疯狂的、能吓到人的结局」)。现有多样性方法没有一条能适配这种多变性:一类在隐空间最大化成对距离(CADS、粒子引导),图像「泛泛地多样」却不理会用户要求,且常以对齐为代价——最强基线CADS达到1.8×多样性却损失约6%对齐;Scaling Group Inference对齐保持最好(<1%损失)但只获得1.3×多样性、推理成本高达3.3–21.9×;另一类只针对预先指定的目标(人口统计覆盖、未指定提示的模式覆盖、人物身份去同质化),无法泛化到用户当下写出的轴。所有先前方法对每个提示只返回一个变化类型预先确定的集合。
本文的目标是本文把多样性重新表述为一个条件生成问题:给定基础提示 $p$ 和用户用自由文本写出的变化轴 $a$,产出K张沿 $a$ 各不相同、但都忠实于 $p$ 的图像。工程目标有三层。其一,构建一个交互框架T-DIG:用户输入提示、查看默认生成、用自然语言请求变化(或从VLM建议中挑选)、设定多样性强度和集合大小 $K \in \{2,4,8,16\}$、选择「生成新集合」或「编辑当前集合」,并可多轮精修。其二,核心机制是一个LLM策略,把 $(p, a, K)$ 扩写成K个沿轴条件化的提示词或K条编辑指令,交给完全冻结的生成器/编辑器执行——生成器不更新、不要求可微、无需访问权重,从而同一框架同时覆盖开放权重、蒸馏与API专有模型。其三,构建首个「提示词配人类书写的多样性轴」的数据集用于训练与评测,并用自动指标和人类评分证明:沿轴多样性大幅提升(平均2.3×、最高3.1×)的同时,与基础提示的对齐损失小于2%。
与已有工作不同的是,本文的独特切入角度有三层。概念层面:作者援引心理学的经典论断——相似永远是「在某方面的」相似(Tversky 1977)——指出以往工作用单一标量(DINO/DreamSim距离)定义多样性,等于替用户预先决定了「在什么方面不同」;本文首次把多样性当作以自由文本为条件的生成任务,轴既可以是「艺术风格」这类宽泛维度,也可以是「墙上挂钟显示的时间」这类提示词特有的细节,不受固定分类学约束。度量层面:借助同期工作TPIPS构造TPIPS-Vendi奖励,使「沿用户指定轴的多样性」第一次可以直接测量并用于强化学习训练——TPIPS本是评测工具,本文用它来生成。系统层面:选择改提示词而非改模型权重,绕开了对生成器可微性与权重访问的要求;策略以LoRA适配器挂在LLM上、以缩放系数实现连续强度控制,还能把在开放模型上训练的策略零样本迁移到专有渲染器——这是采样器干预(CADS)、推理时扩展(Group Inference)、权重微调和一般性提示重写(PAG)都不具备的性质。
核心方法
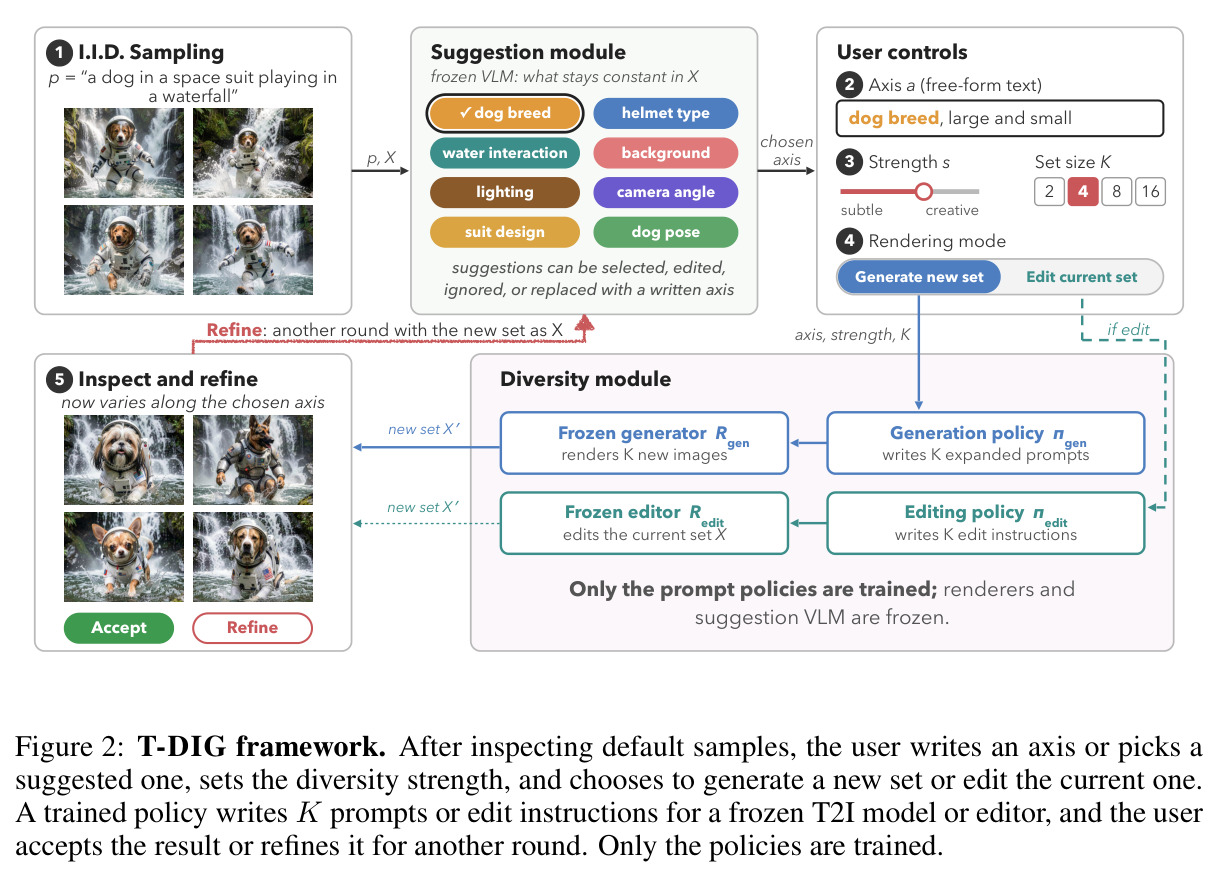
先说直觉:图像模型自己只会「泛泛地多样」,那就让一个语言模型替用户把「我要沿X轴变化」翻译成K个具体落在轴上不同取值的提示词(或K条编辑指令),再交给冻结的生成器执行——多样性在语言层面规划,图像层面只负责渲染。技术路线分两块。交互框架(Figure 2)有五步:(1) i.i.d.预览——用户输入提示 $p$ 看K张默认图;(2) 轴——冻结VLM建议模块根据 $p$ 和样本建议变化轴,用户也可自写或改写,如「艺术风格」或「overall」;(3) 强度与集合大小——$K \in \{2,4,8,16\}$、强度 $s$ 从细微替换到丰富场景;(4) 渲染模式——生成新集合或编辑当前集合;(5) 检视精修——接受或以新集合为输入进入下一轮。Diversity Module是一对后训练LLM策略 $\pi_{gen}$ 与 $\pi_{edit}$,各自是冻结语言模型上的LoRA适配器 $\Delta W = BA$,强度 $s$ 映射为缩放 $\alpha_s \in [0,1]$,策略权重 $W_0 + \alpha_s \Delta W$。给定 $p, a, K$(编辑时另有当前集合 $X$),策略输出 $q = \{q_1,\dots,q_K\}$,冻结渲染器执行 $X' = R_{gen}(q)$ 或 $X' = R_{edit}(X, q)$。训练用GRPO优化集合级奖励 $r = D_a(X) - \lambda\mathcal{L}_{align} - \mu\mathcal{L}_{len} - \eta\mathcal{L}_{pref}$,只有提示策略被训练,生成器、编辑器和建议VLM全程冻结。
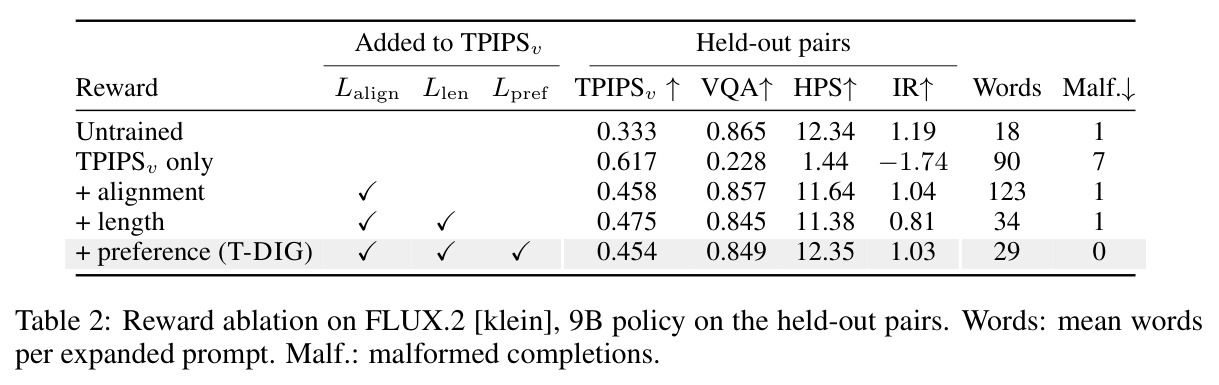
核心创新是把多样性从「无条件的集合性质」改写为「文本条件生成」,并配了一套能直接优化的奖励,与已有方法有四个本质区别。第一,目标对象不同:PAG等提示重写只追求一般意义的提示多样性、不接受轴;CADS/粒子引导在采样过程注入噪声或轨迹排斥,变化落点不可控;本文策略写出的每条提示明确落位在用户轴的不同取值上,且同一集合的K张图共享一个初始latent并固定在各GRPO补全之间——组内差异完全来自文本而非采样噪声,多样性被「编译」进提示词。第二,奖励相对化:对齐阈值 $\tau(p,R)$ 取该渲染器K张i.i.d.样本的平均VQAScore、偏好阈值 $\kappa(p,R)$ 取平均HPSv3、长度预算 $c(p)=|p|+w$,三者都用hinge只惩罚跌破自身基线的部分——作者论证单一全局阈值会在策略还没改动前就惩罚大量天然难对齐的提示。第三,防hack链条:只用多样性奖励时VQAScore从0.865崩到0.228;加对齐惩罚后提示词膨胀到123词、未请求的变化泄漏进图;再加长度惩罚后策略改用「把基础提示当字幕印进图」抬对齐分,必须再加HPSv3偏好惩罚才稳住——这条消融链本身就是方法的核心洞察。第四,训练范式:GRPO的每个补全是一整组K个提示词、奖励是集合级的,组相对优势天然对应「哪一组的沿轴多样性更好」,把「组内相对比较」与「集合多样性」同构了起来。
方法步骤详情
完整流程分数据构造、策略训练、推理交互三段。数据构造:从HPDv2训练集去重得103,672条唯一提示;用GPT-5.6 Luna过滤——剔除真实人物、不安全内容、无可描绘主体、风格堆砌的提示,要求至少能指出3个有意义的轴,保留79.9%(约82,861条);再用all-MiniLM-L6-v2嵌入、余弦距离阈值0.35做层次聚类去语义冗余,得23,020个簇各取一条。轴的来源:先做20条提示的先导研究收集真人书写的轴作为种子,再用Gemini 3.8 Flash以这些人类样例做in-context示例,对每条提示渲染K张i.i.d.图后生成最多4条自由文本轴,10%的提示额外加「overall」轴;剔除畸形输出并留出200条做验证后,训练集含19,765条提示、76,089个(提示,轴)对。策略训练:对每个T2I模型训练Qwen3.5的4B/9B/35B-A3B三个生成策略(LoRA rank 32,覆盖所有attention、linear-attention与MLP投影;学习率 $2\times10^{-5}$,无KL项,800步);每步抽8个(提示,轴)对、每组 $G=8$ 个补全、每补全 $K=4$ 条提示,即每步渲染并打分256张图;奖励权重 $\lambda=2$、$\mu=0.1$、$\eta=0.05$、词预算 $w=20$;训练在512px、评测在1024px。编辑策略用同一批数据,以K张i.i.d.样本为源集合 $X_{src}$,每图写一条指令,额外减去 $\nu\mathcal{L}_{drift}$——DreamSim距离超过 $\delta$ 的hinge,防止「换掉整张图冒充编辑」。推理交互:用户输入 $p$ → 看K张i.i.d.默认图 → 接受建议轴或自写轴 → 设强度和 $K$ → 策略写K个提示/指令 → 冻结渲染器出图 → 接受或迭代。
技术新颖性
技术新颖性体现在四个方面。其一,任务形式化是全新的:作者声称这是首个「按用户书写的自由文本轴变化图像集合」的方法,也是首个在人类书写(而非模板或物体列表)的提示与轴上训练评测的工作——训练轴虽由VLM规模化生成,但以真实人类先导研究为in-context种子;测试集405对(提示,轴)全部来自58名真实用户与框架的多轮交互。其二,度量驱动的奖励设计:把TPIPS(原本只用于评测文本条件相似度)转作RL奖励信号,配合Vendi分数度量「沿轴有效不同图像数」,这是用DINO/DreamSim标量距离的工作原理上做不到的。其三,「相对自身基线」的校准式惩罚:三个hinge的阈值都按每个提示自身的i.i.d.表现设定,这种设计对异质提示池是必要的,也解释了为什么对齐几乎无损。其四,工程性质的解耦:策略是纯文本层的LoRA适配器,生成器冻结且无需可微,因此同时覆盖开放权重(SD3.5 Medium/Large、Qwen-Image-2512)、蒸馏(FLUX.2 [klein] 9B)与API专有(GPT Image 2、Gemini 3.1 Flash Image)模型,且开放模型上训练的策略可直接迁移到专有模型——与FlowGRPO等直接微调扩散模型的路线相比,训练与部署被彻底解耦,这是「模型无关训练」承诺的实质。
实验结果
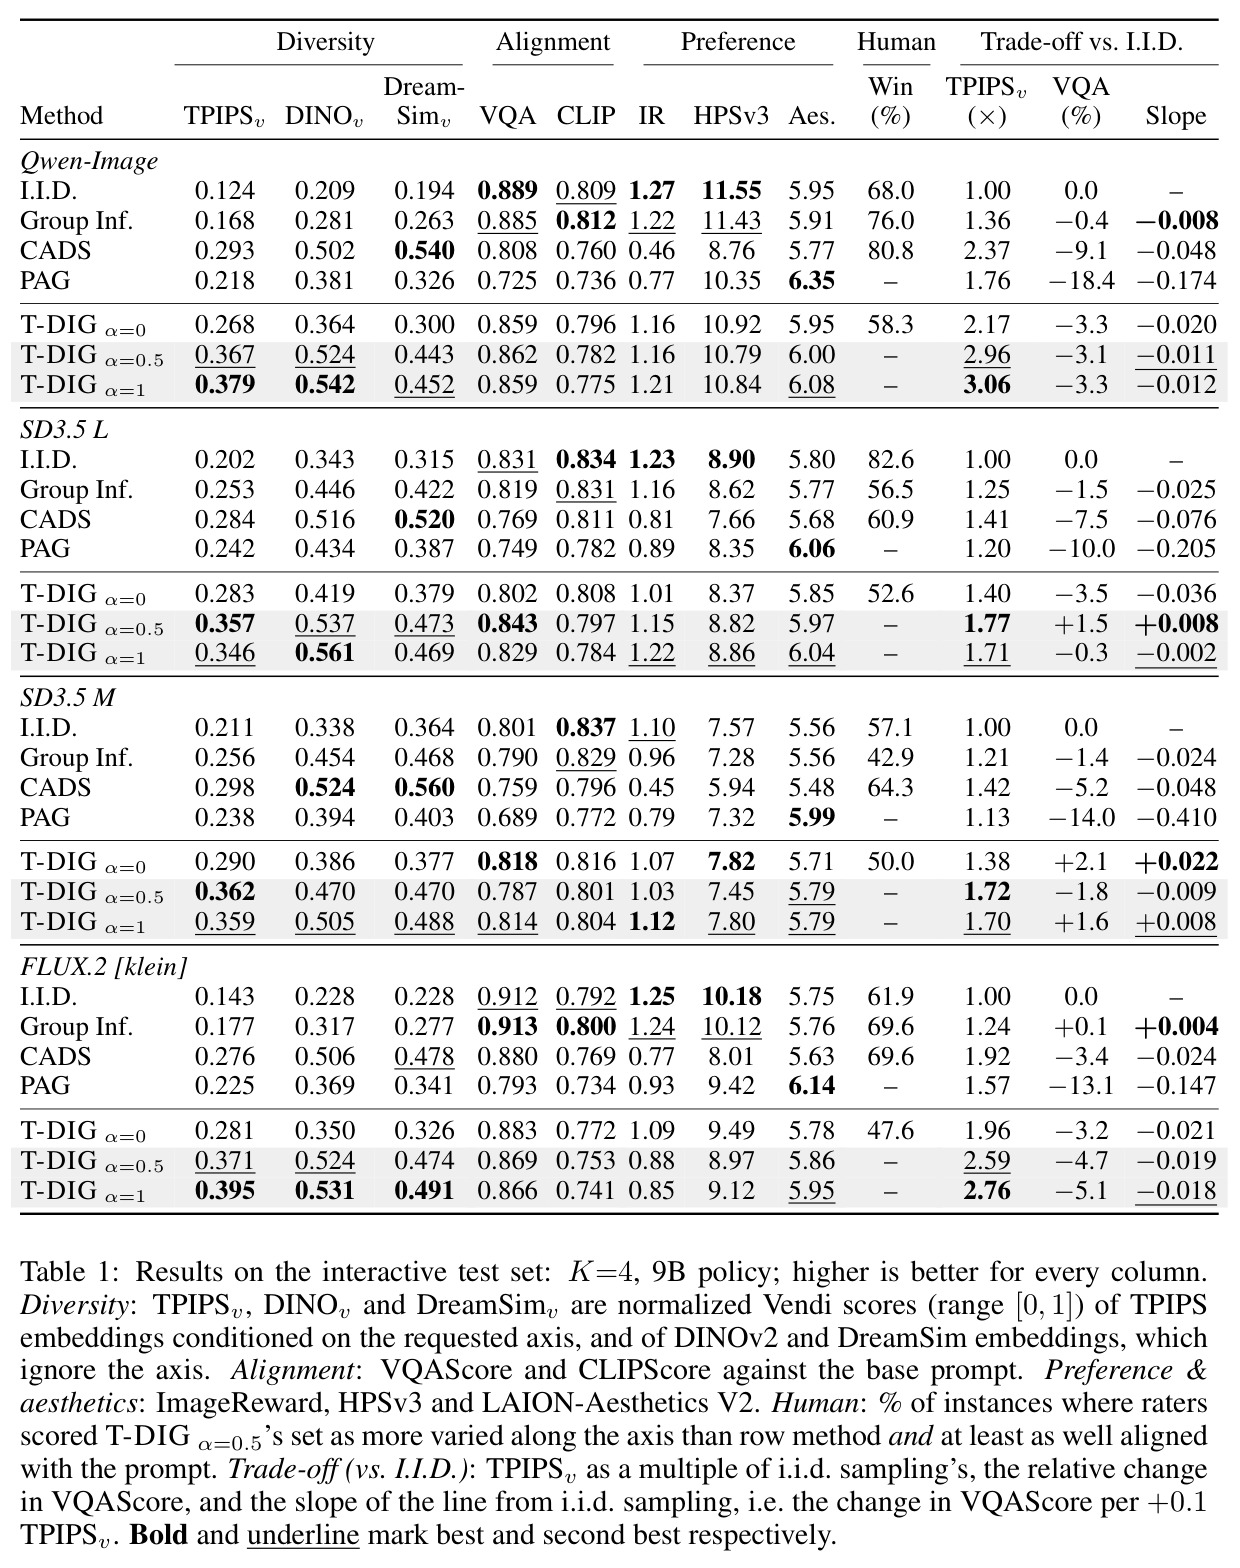
按论文的八个研究问题梳理。RQ1(交互测试集,$K=4$、9B策略):训练后T-DIG($\alpha=1$)的TPIPSv相对i.i.d.提升+0.14~+0.26(平均2.3×、最高3.1×),对齐损失小于2%;未训练T-DIG($\alpha=0$)仅靠指令就达+0.08~+0.14,已媲美CADS的+0.08~+0.17;Group Inference仅+0.03~+0.05(成本3.3–21.9×)、PAG +0.03~+0.09。对齐上T-DIG的VQAScore变化仅−0.05~+0.01,CADS为−0.03~−0.08、PAG为−0.08~−0.16;效率斜率上每+0.1 TPIPSv,T-DIG至多丢0.02 VQAScore,CADS至多0.08、PAG至多0.41。值得注意的是CADS的DINOv与T-DIG差距不到0.05、DreamSimv在部分模型反超——它「总体一样杂」,但变化很少落在请求轴上。RQ2(跨模型):收益与i.i.d.多样性成反比——Qwen-Image(0.12)+0.26、FLUX.2(0.14)+0.25、SD3.5 L/M(0.20/0.21)+0.14/+0.15,四模型在 $\alpha=1$ 时都收敛到0.35~0.40(度量饱和);FLUX.2偏好损失最大(ImageReward −0.40、HPSv3 −10%)。RQ3(COCO-250无轴设定):扫 $\alpha$ 从0到1,DINOv相对i.i.d.+0.21~+0.39($\alpha=1$ 约3×)而VQAScore只丢0.01~0.02;每+0.1 DINOv丢0.006~0.010 VQAScore,优于CADS(0.013~0.034)与降guidance(0.019~0.038);在0.02 VQAScore预算内T-DIG得+0.39 DINOv,任何基线至多+0.11。RQ4:4B/9B/35B-A3B多样性几乎相同,9B对齐略优(−0.002~+0.010),35B无一致增益;未训练4B有1.7%畸形输出,训练后归零。RQ5(人类评测):405对真实交互测试、约2,400条评分;用户自评多样性3.95/5、对齐4.09/5,89%认为按轴请求比接受i.i.d.更有用,96%享受使用;成对盲评中T-DIG($\alpha=0.5$)在64%~96%的屏幕上被评为沿轴更多样,多样性+对齐胜率对i.i.d. 57~83%、对CADS 61~81%、对Group Inference 43~76%、对未训练T-DIG 48~58%;平均多样性评分T-DIG 7.4~8.3/10,i.i.d.仅2.4~3.9、CADS 3.9~5.1。RQ6(消融,FLUX.2 9B):仅多样性奖励把TPIPSv推到0.617但VQAScore崩至0.228;加对齐恢复到0.857但提示词膨胀到123词;加长度惩罚降到34词但出现「字幕印图」hack(HPSv3 11.38);完整奖励保留0.454多样性、VQA 0.849、HPSv3 12.35、零畸形输出。RQ7(延迟):vLLM单卡H200上扩写4条提示中位耗时0.40s(4B)/0.59s(9B)/0.51s(35B-A3B);SD3.5与Qwen渲染4图需5~11s,9B策略仅增6~12%开销;FLUX.2渲染1.5s,4B策略把开销控制在约27%。RQ8(迁移):Qwen-Image策略零样本用于GPT Image 2/Gemini 3.1 Flash Image(50条测试提示),TPIPSv相对i.i.d.+0.27/+0.20,比GPT-5.5(+0.19)和Gemini 3.8 Flash(+0.15)的同指令扩写高出约40%相对提升;代价是VQAScore多丢0.01~0.03、HPSv3降7~9%。
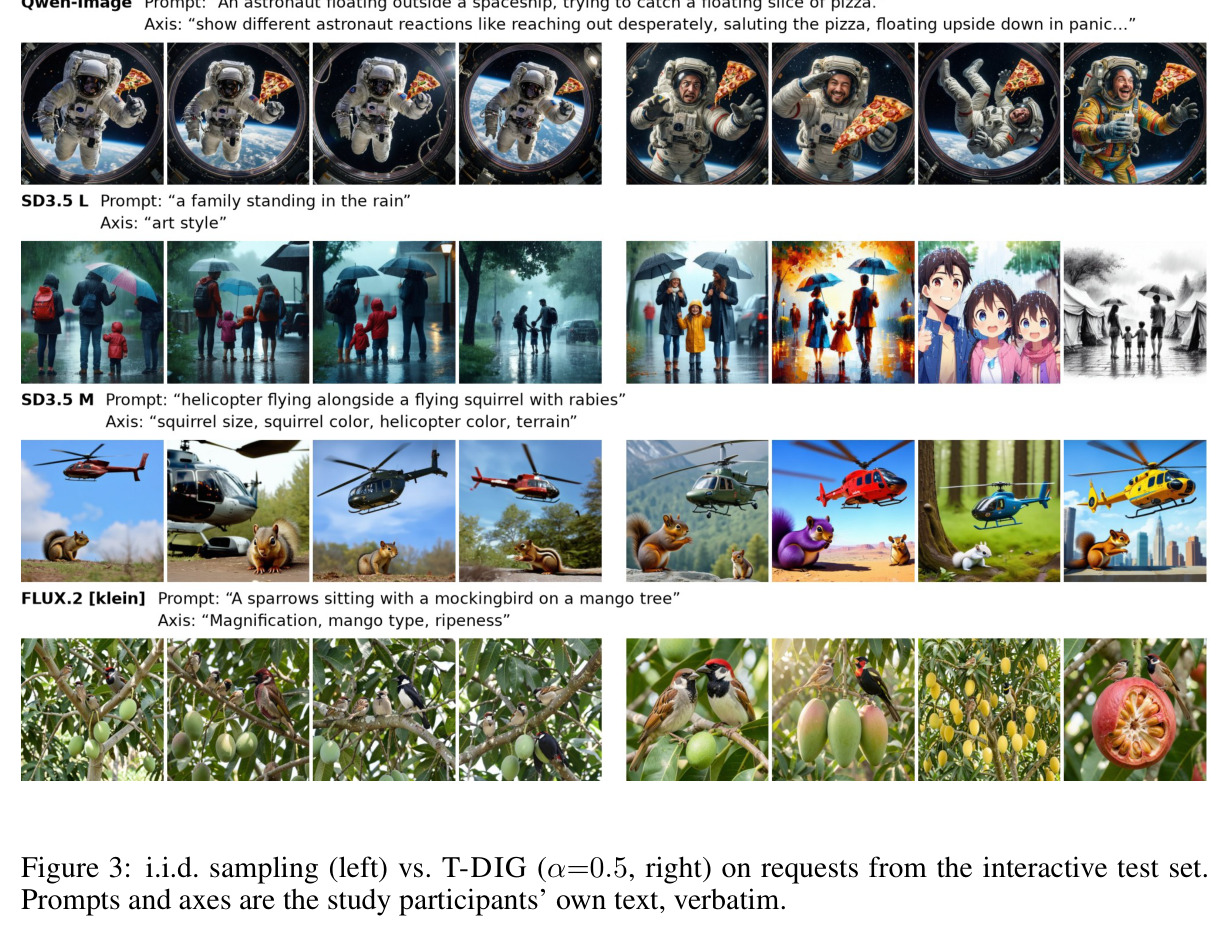
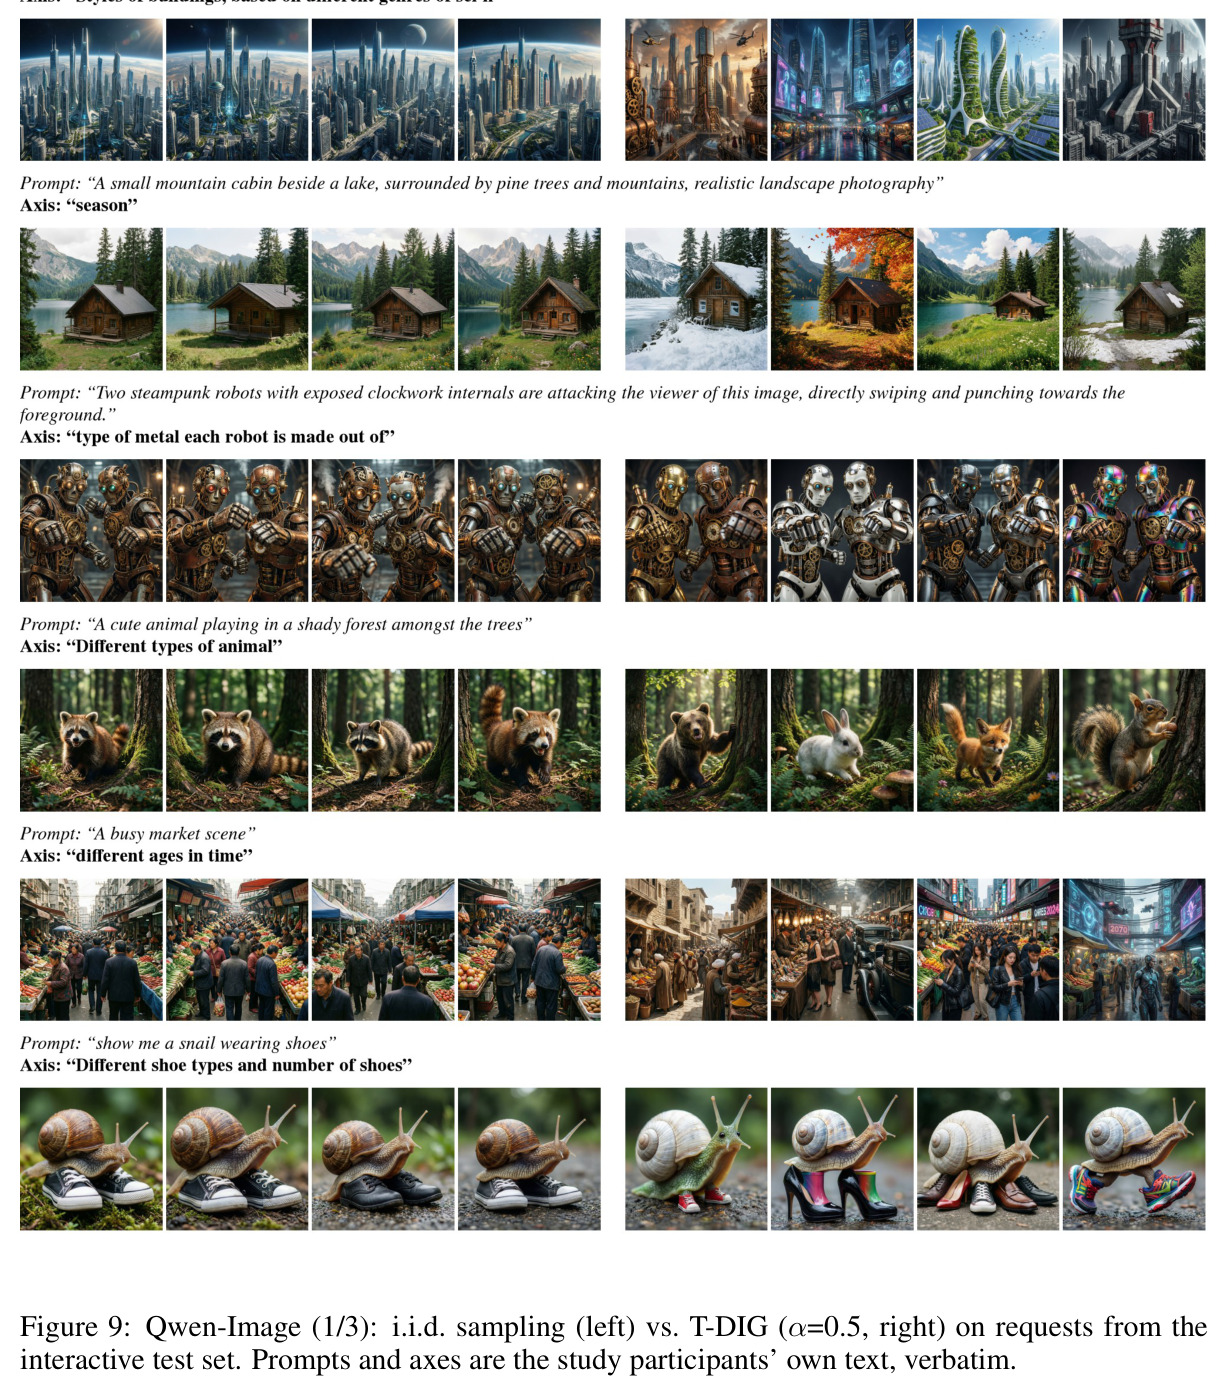
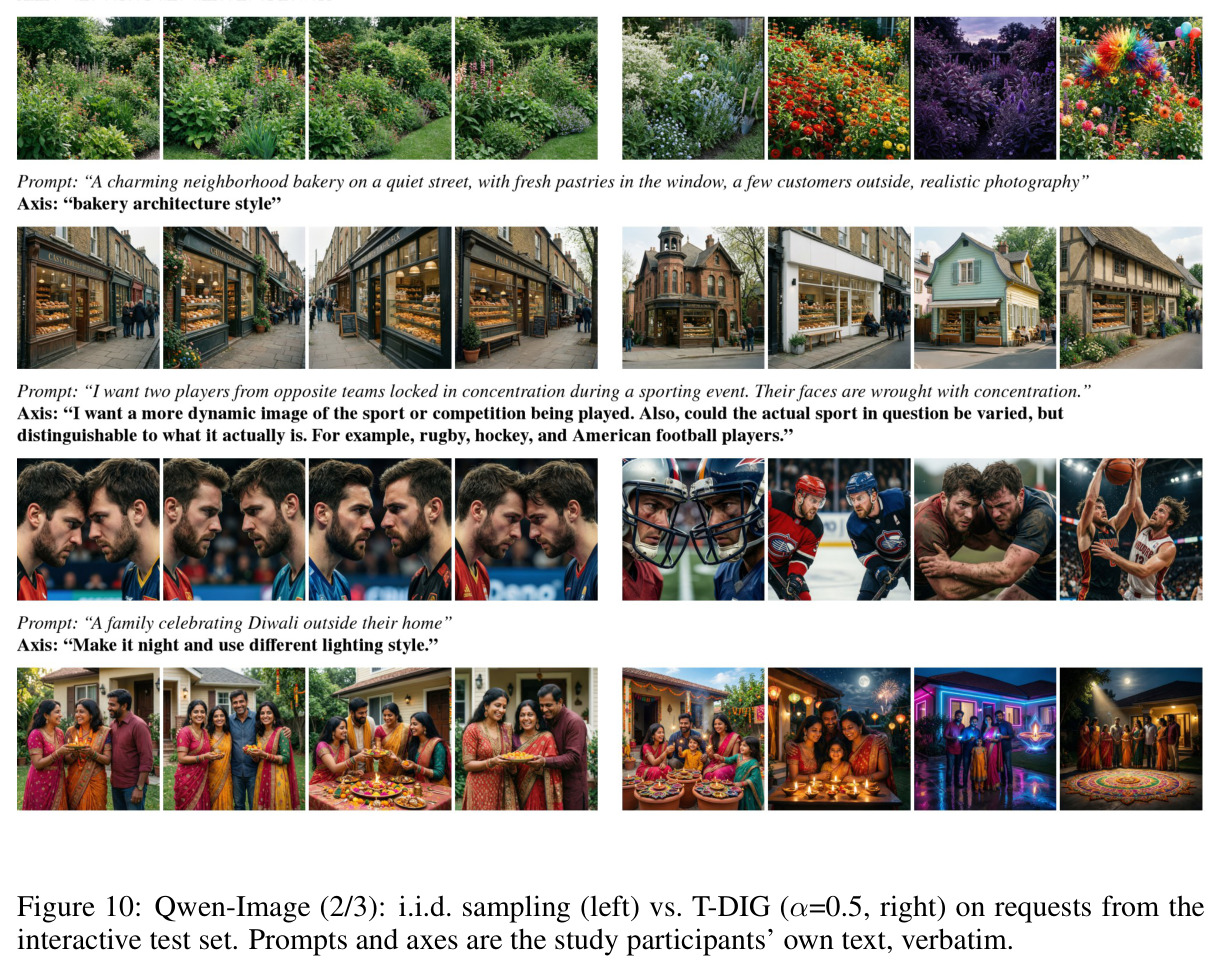
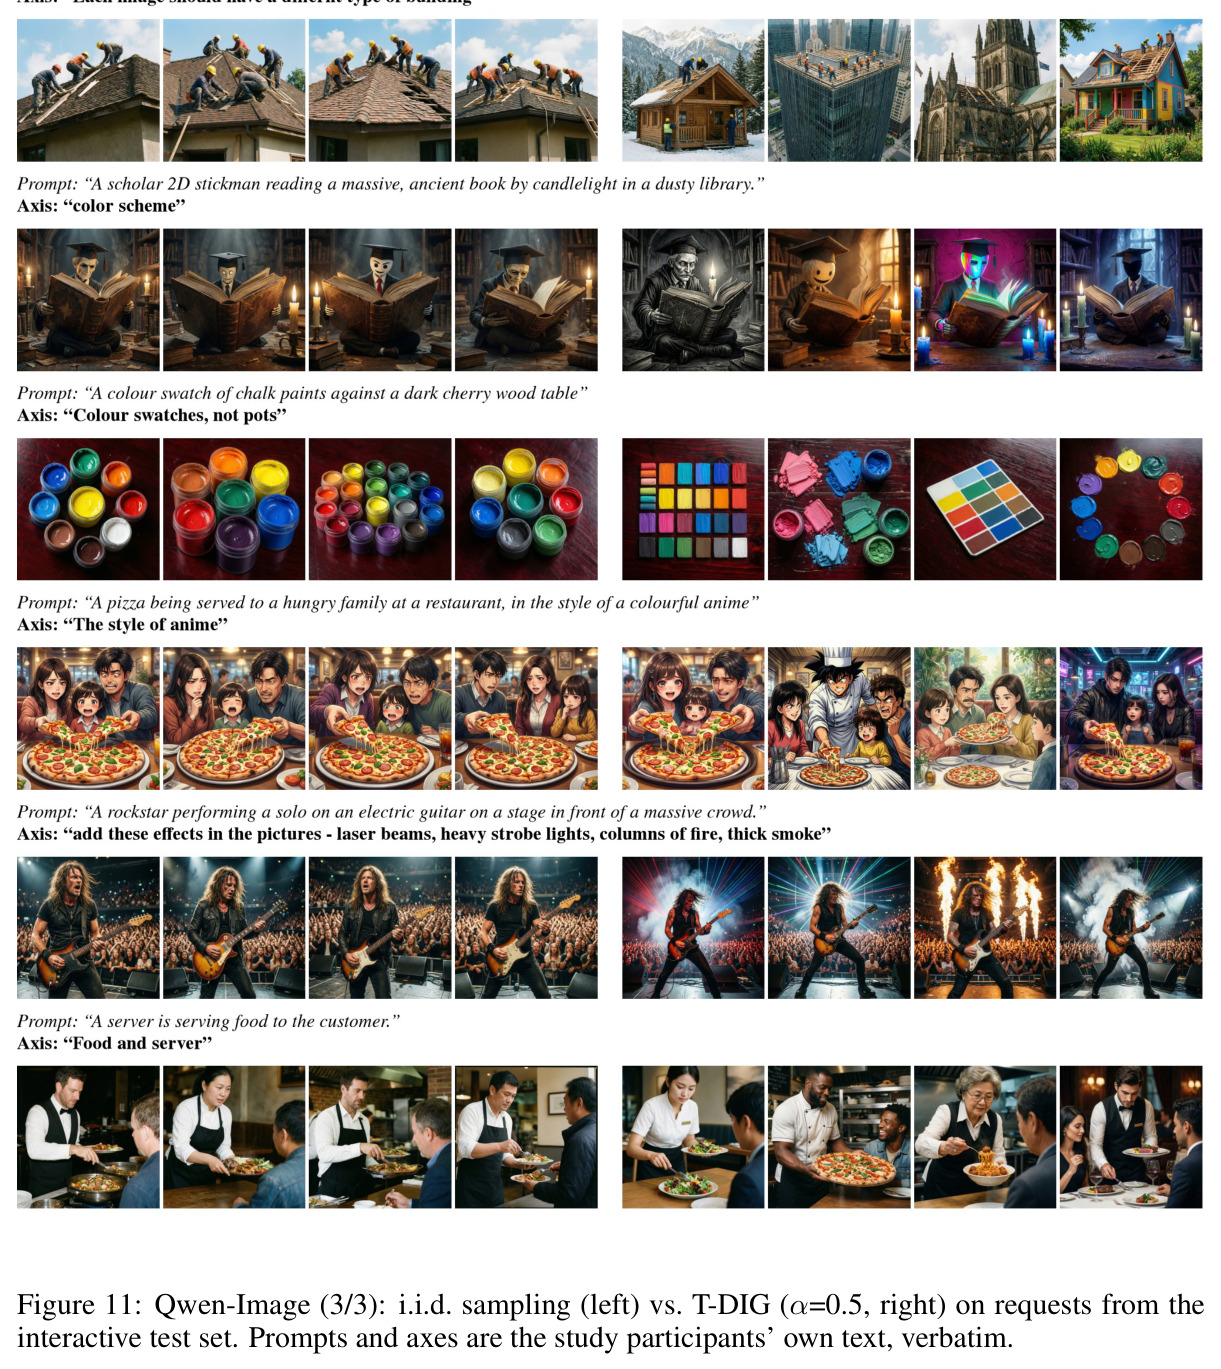
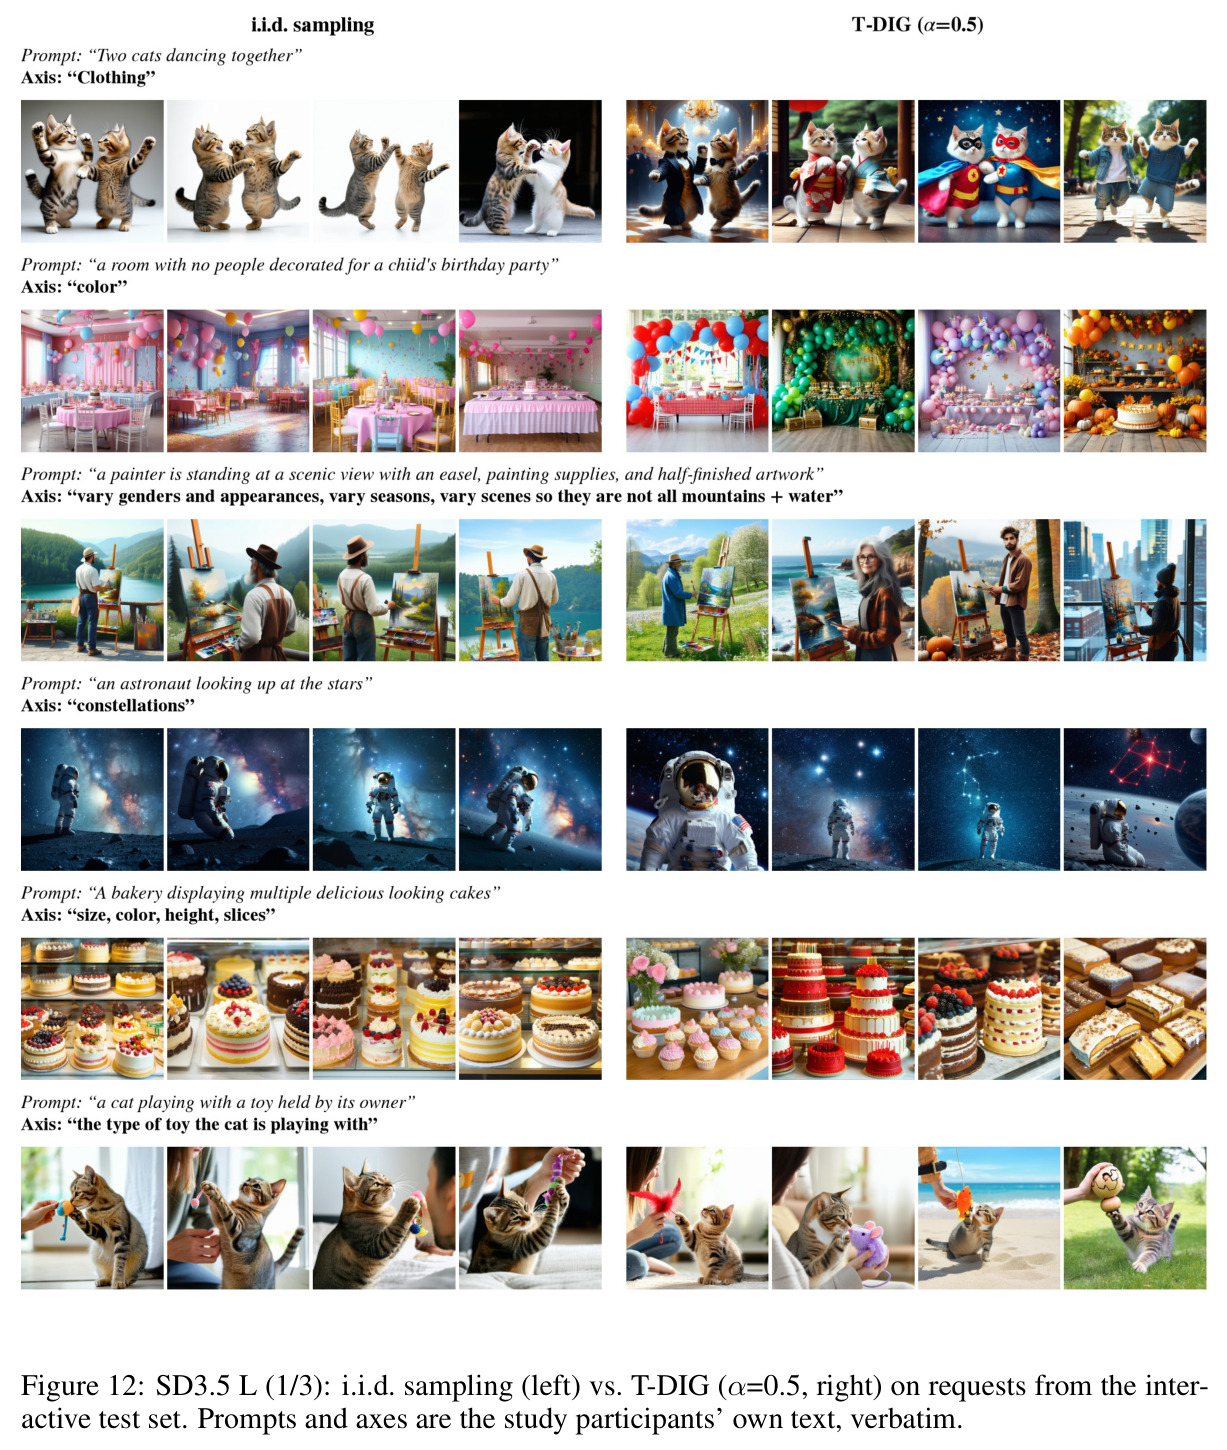
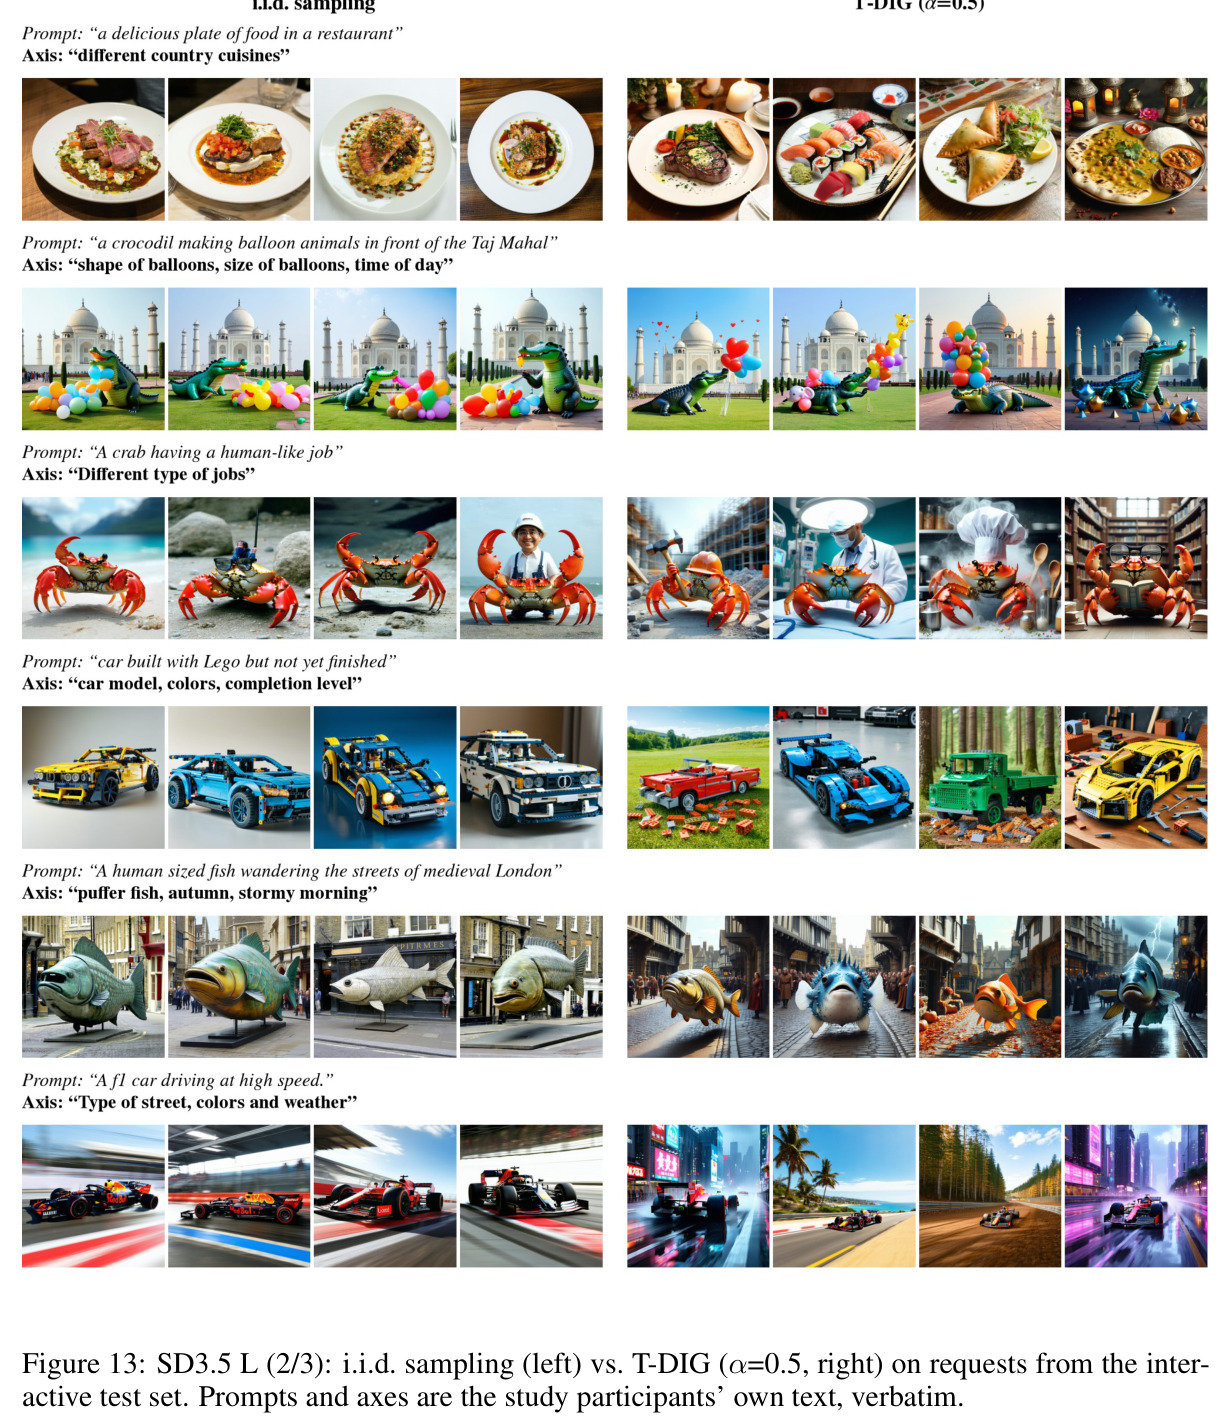
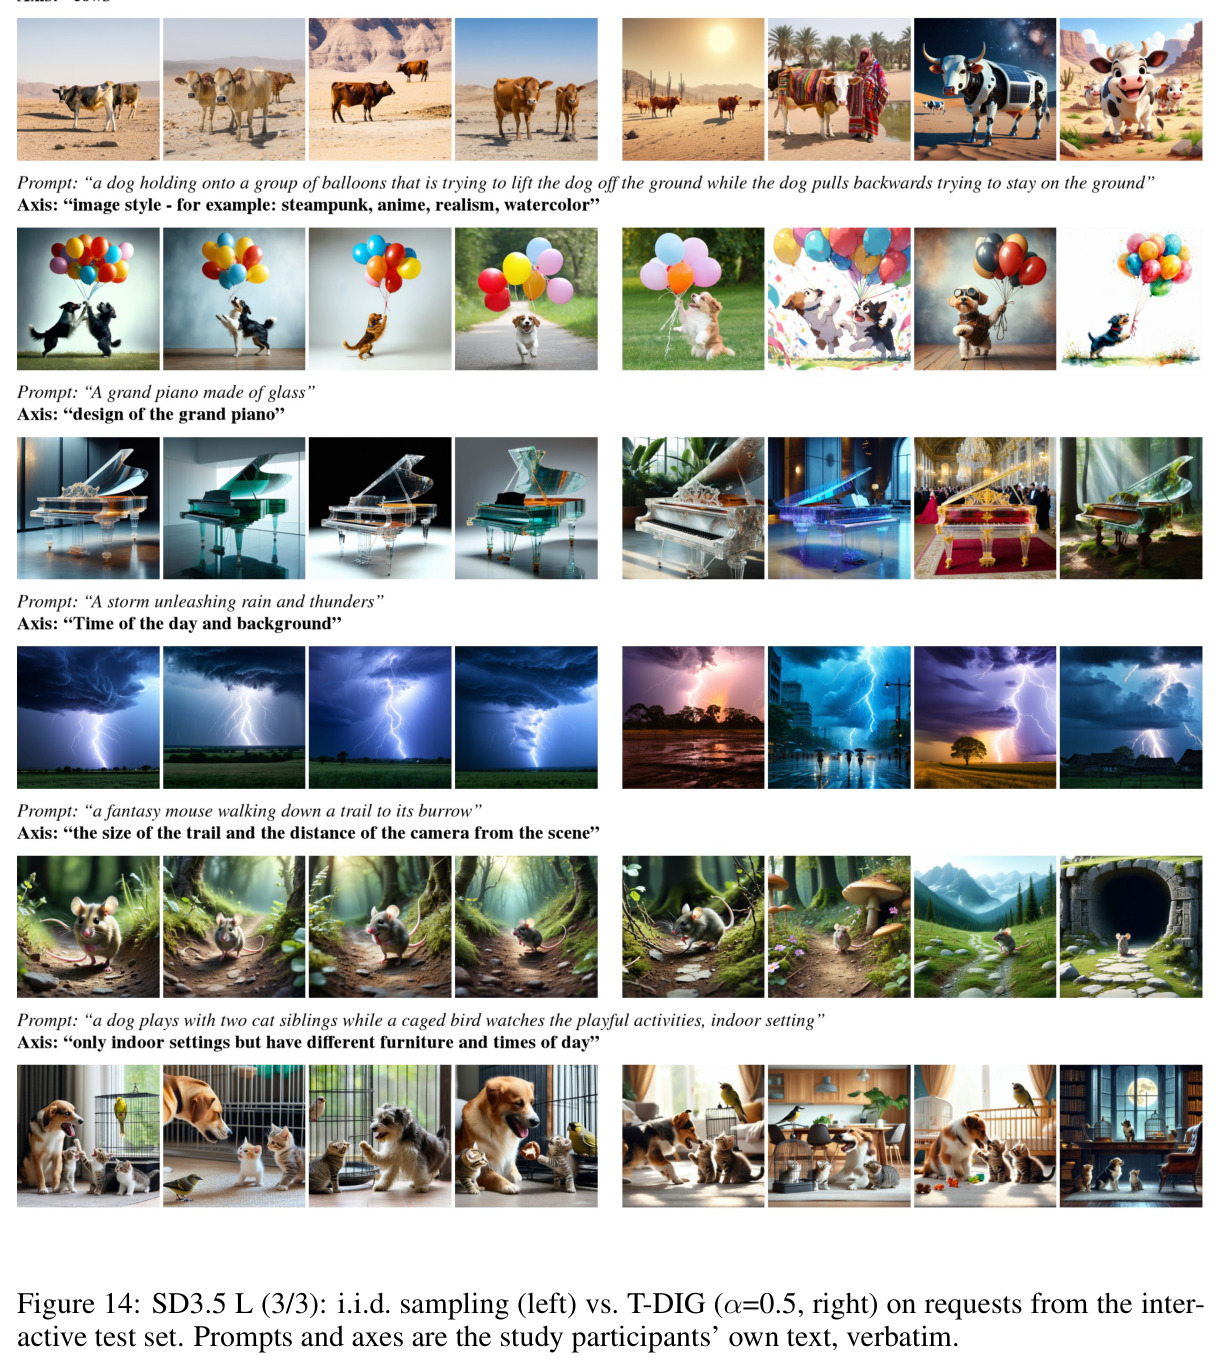
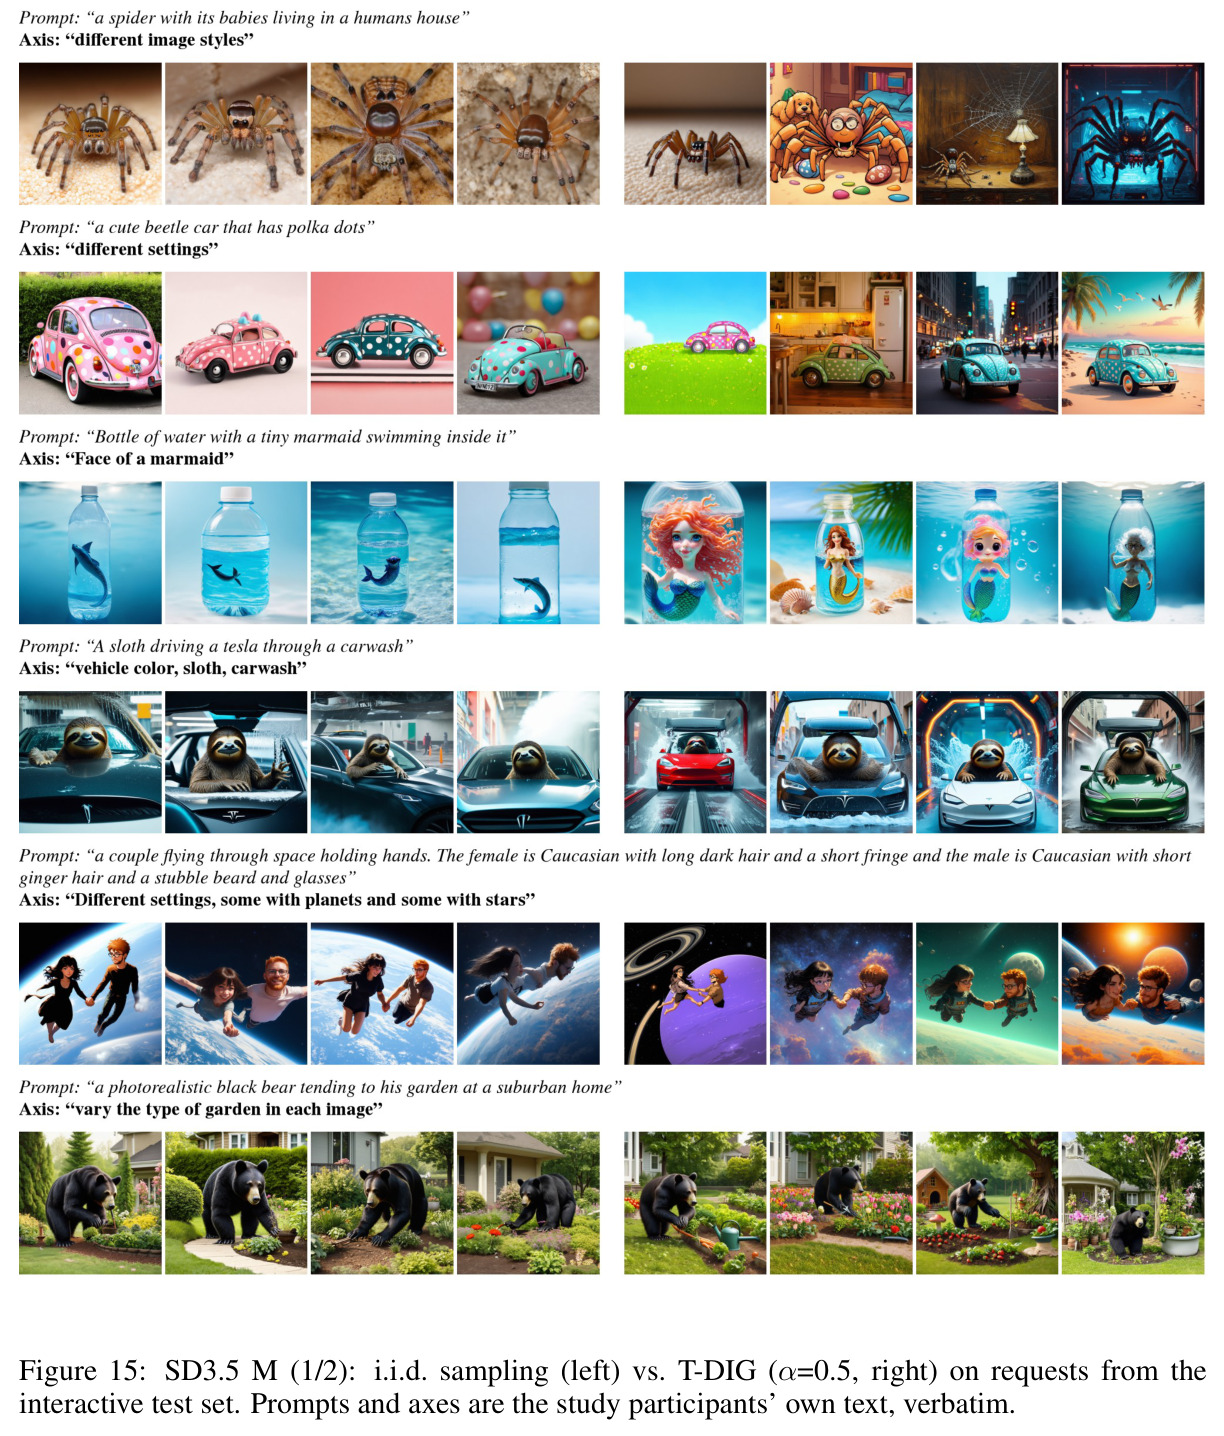
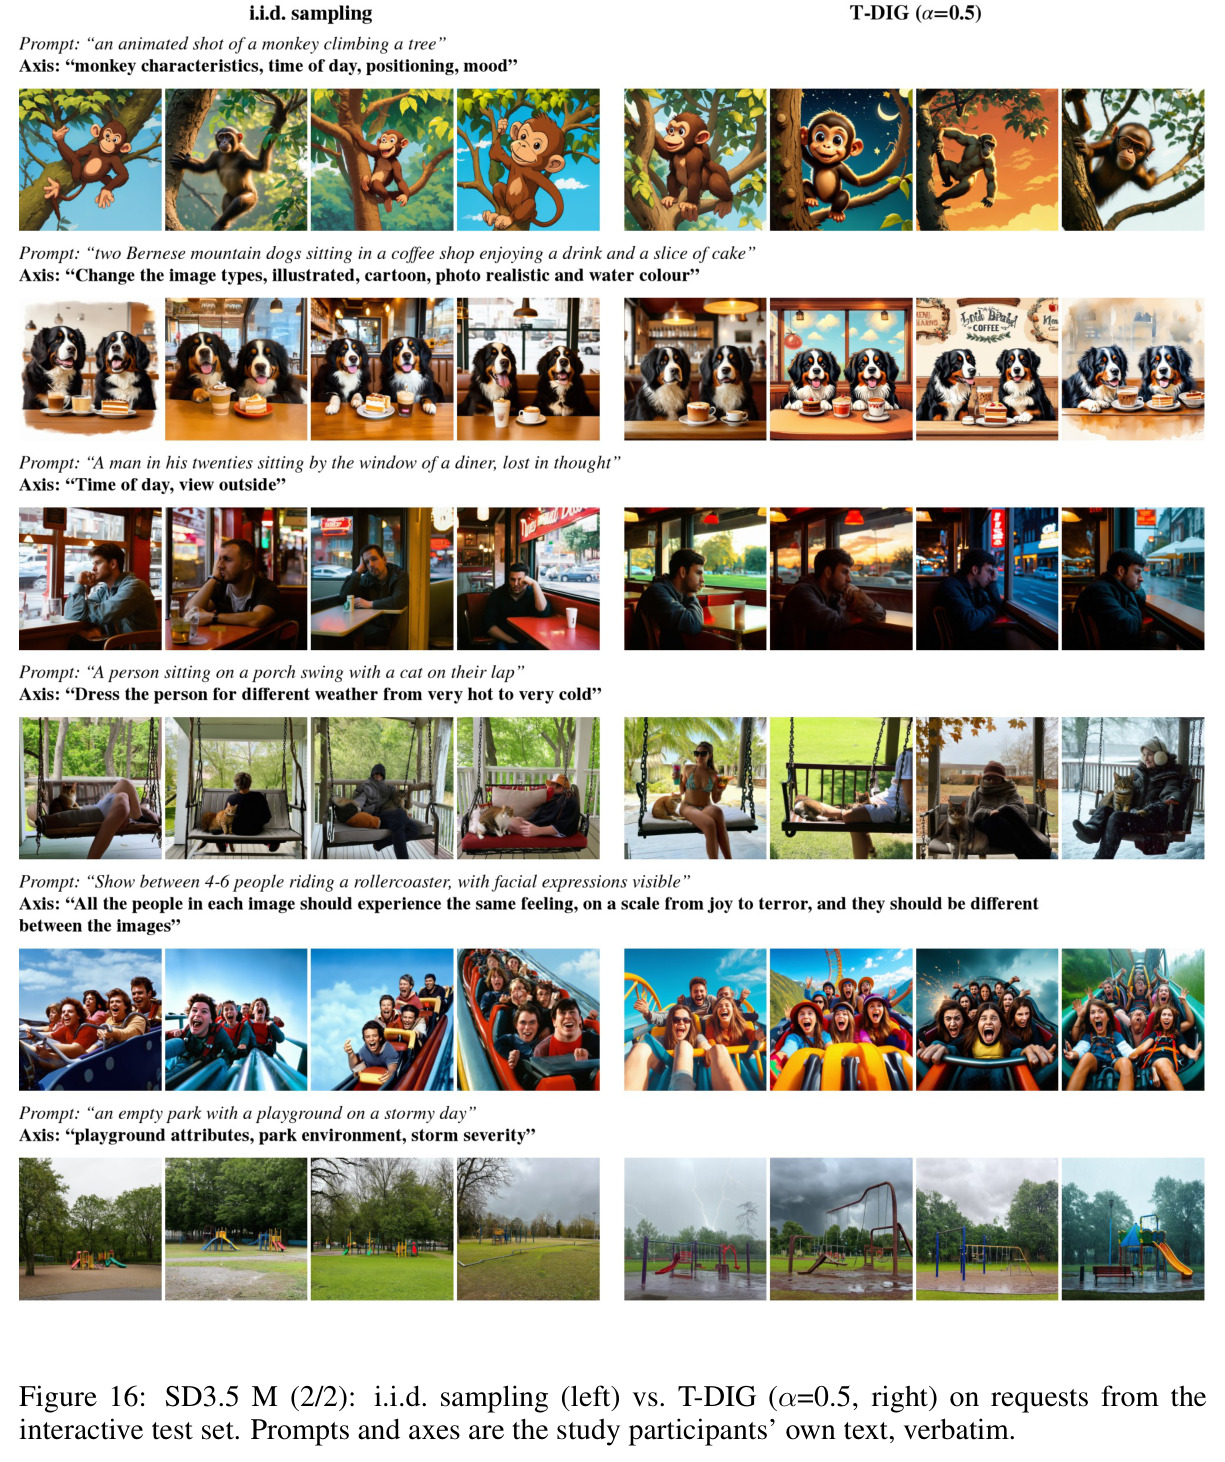
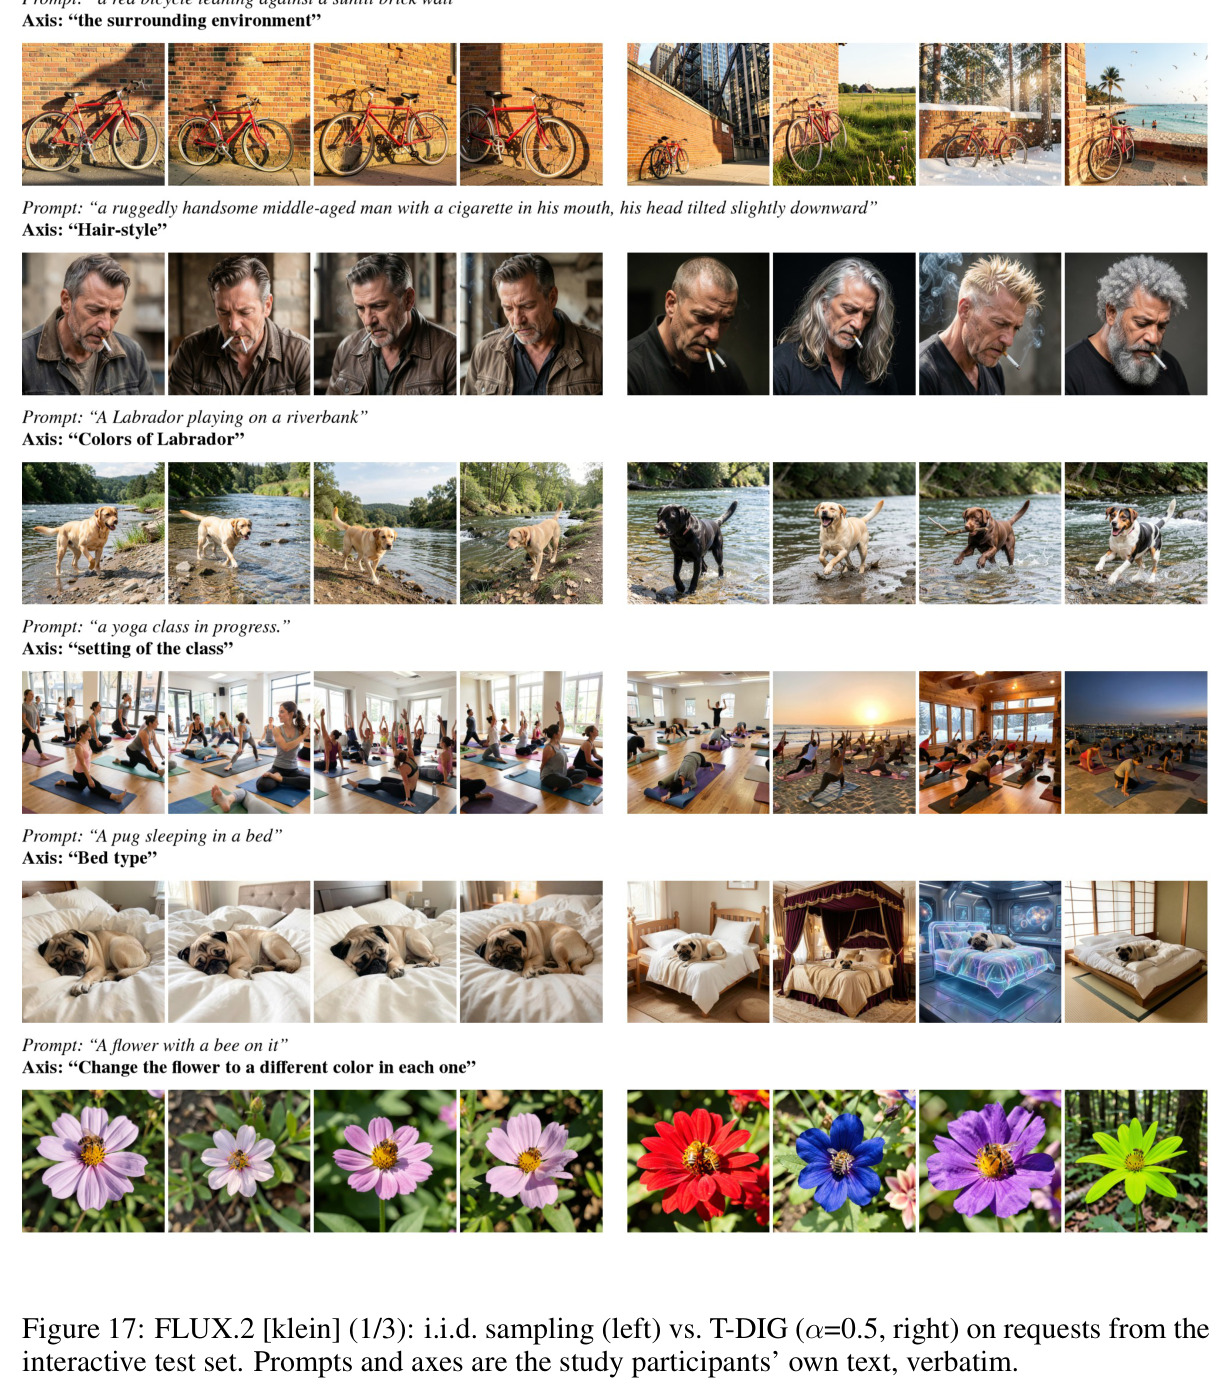
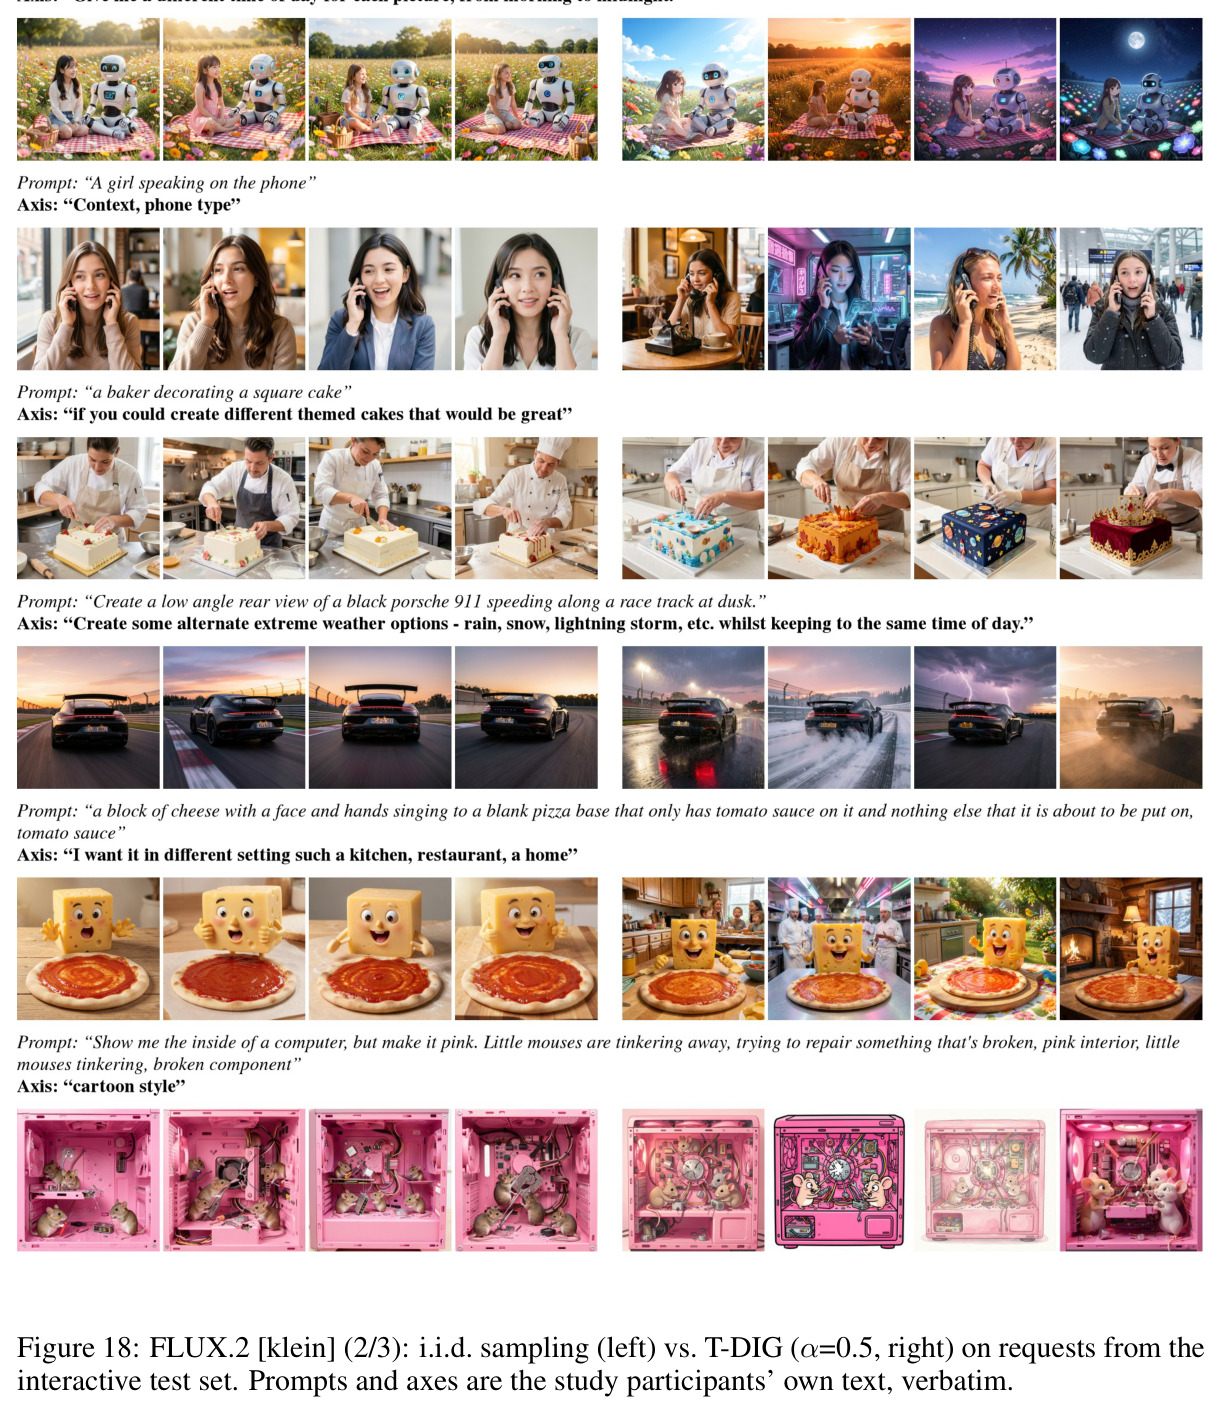
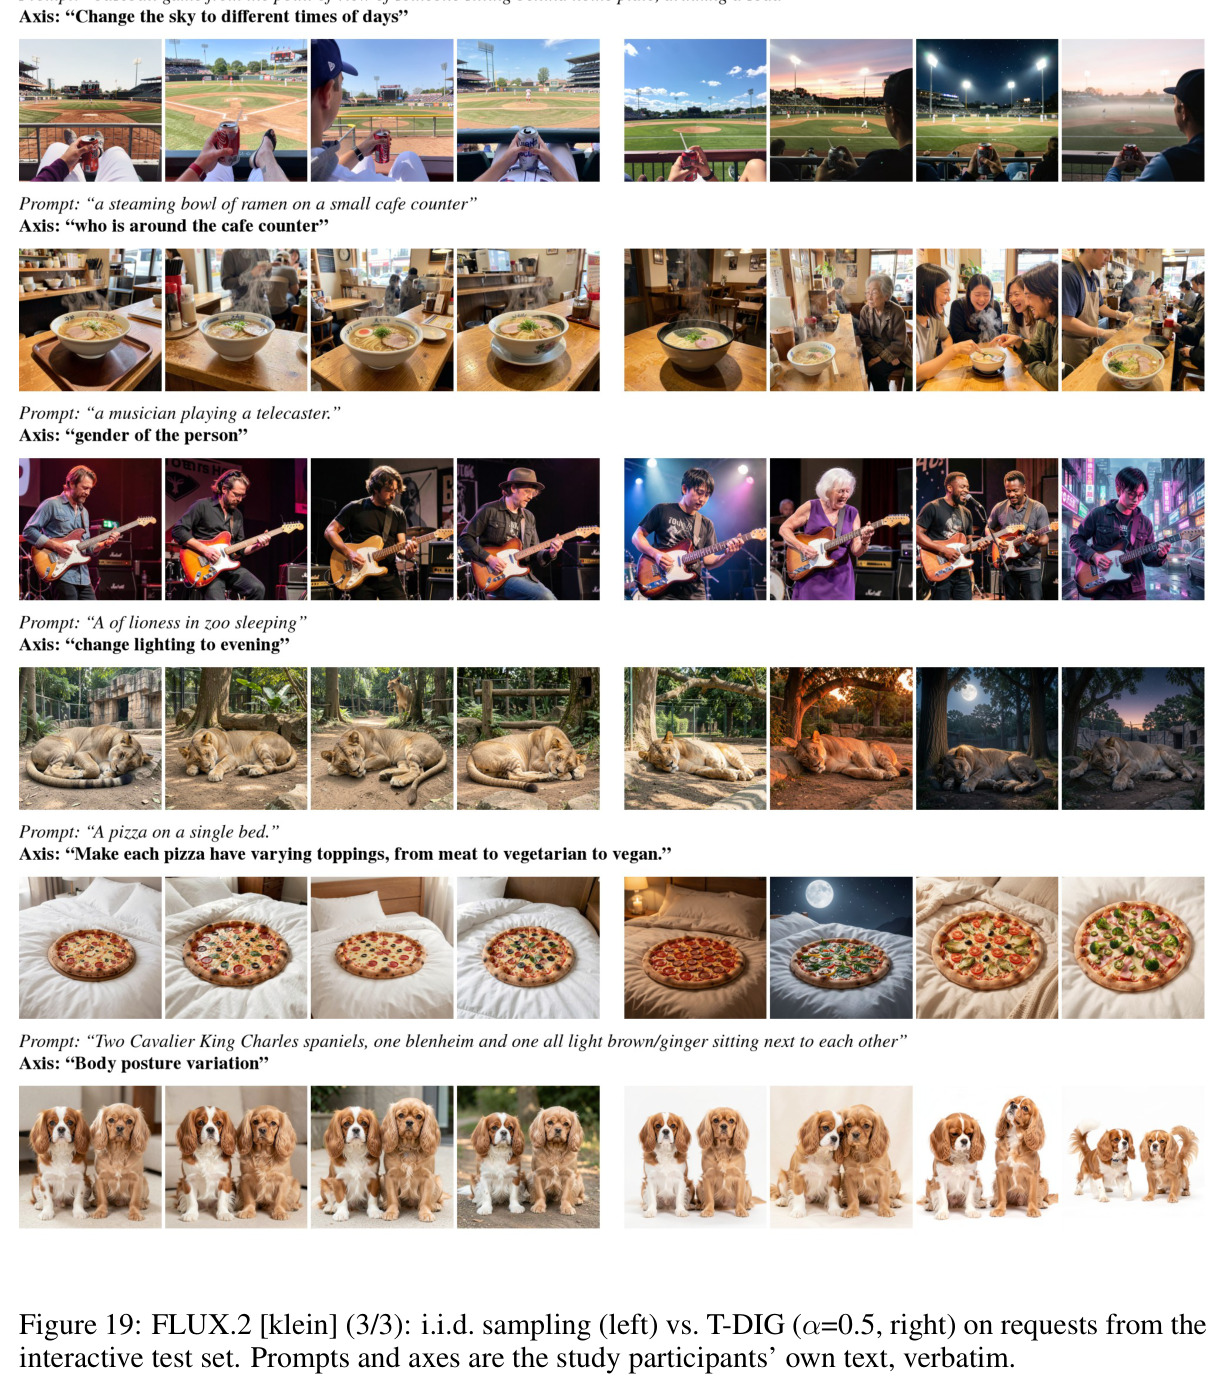
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 交互测试集·沿轴多样性(4个开放权重T2I模型) | TPIPSv(归一化TPIPS-Vendi)相对i.i.d.的倍数 | T-DIG $\alpha=1$:平均2.3×(最高3.1×),TPIPSv提升+0.14~+0.26 | CADS 1.8×(+0.08~+0.17);PAG 1.1–1.8×(+0.03~+0.09);Scaling Group Inference 1.3×(+0.03~+0.05) | 多样性倍数较最强基线CADS高约28%(2.3× vs 1.8×),同时对齐损失<2% vs CADS约6% |
| 多样性-对齐权衡效率(交互测试集) | 每+0.1 TPIPSv对应的VQAScore损失(斜率) | ≤0.02 | CADS ≤0.08;PAG ≤0.41;Scaling Group Inference ≤0.03(但多样性增益小、成本高) | 单位多样性的对齐代价约为CADS的1/4、PAG的1/20 |
| 人类成对盲评(405对真实交互请求,约2,400条评分) | 多样性+对齐多数票胜率;平均多样性评分(1–10) | T-DIG $\alpha=0.5$ 被评为沿轴更多样64%~96%;胜率57%~83%(vs i.i.d.)、61%~81%(vs CADS);评分7.4~8.3 | i.i.d.(评分2.4~3.9)、CADS(3.9~5.1)、Scaling Group Inference(3.2~5.1)、未训练T-DIG(5.6~6.9) | 对全部基线多数胜出;平均多样性评分为i.i.d.的约2倍 |
| COCO-250·无轴整体多样性(Qwen-Image) | 每+0.1 DINOv的VQAScore损失;固定0.02 VQAScore预算内的DINOv增益 | 斜率0.006~0.010(四模型);预算内+0.39 DINOv(约3× i.i.d.) | CADS斜率0.013~0.034;降guidance斜率0.019~0.038;基线预算内至多+0.11 DINOv | 同等对齐预算下多样性增益约为最强基线的3.5倍 |
| 零样本迁移到专有模型(GPT Image 2 / Gemini 3.1 Flash Image) | TPIPSv相对i.i.d.的增益 | Qwen-Image策略+0.27 / +0.20;FLUX.2策略+0.26 / +0.19 | 专有LLM同指令扩写:GPT-5.5 +0.19 / Gemini 3.8 Flash +0.15 | 约40%相对提升,无需访问专有模型权重或重新训练 |
| 推理开销 | 策略延迟 / 渲染延迟 | 9B策略扩写4条提示0.59s,渲染4图需5~11s(开销6~12%);4B 0.40s | Scaling Group Inference需3.3~21.9×去噪成本($M=128$ 候选池) | 开销仅为Group Inference推理成本的约1/30至1/200量级 |
| 奖励消融(FLUX.2 [klein],9B策略,held-out对) | TPIPSv / VQAScore / 提示词长度 / 畸形输出 | 完整奖励:TPIPSv 0.454、VQA 0.849、29词、0条畸形 | 仅多样性奖励:TPIPSv 0.617但VQA崩至0.228;+对齐:123词;+长度:字幕hack(HPSv3 11.38 vs 12.35) | 证明四项奖励缺一不可,完整奖励是唯一同时保住多样性、对齐、偏好与格式稳定性的配置 |
局限与改进
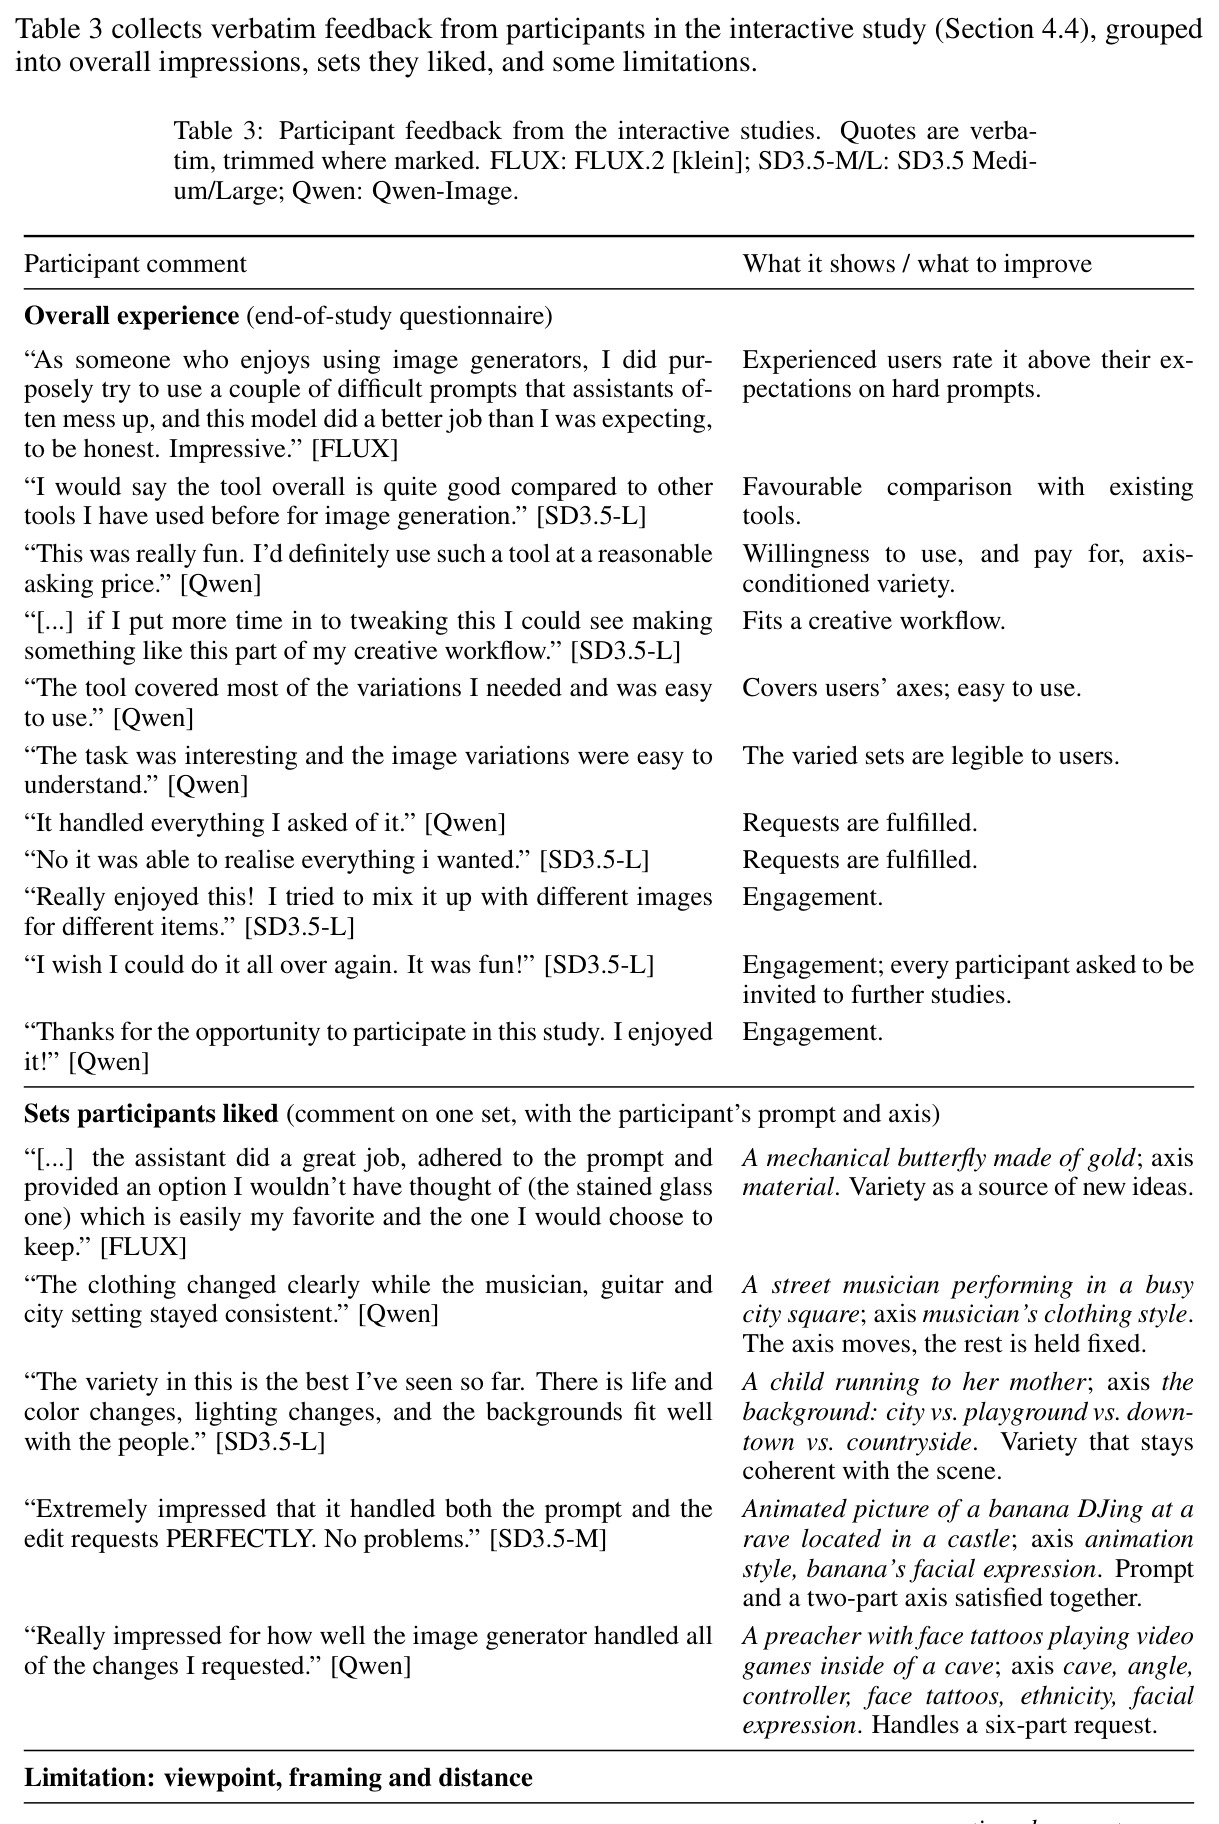
作者承认的局限:T-DIG沿轴变化的能力受基础生成器制约——人类研究中相机角度与取景的轴始终无法稳定实现,纯提示词层控制修不了,需联合微调生成器;强度滑杆不感知校准(LoRA权重线性缩放 $\alpha_s$),低档太微妙、高档太剧烈,约一半参与者抱怨;优化TPIPS会使适配器继承其偏差,这也是他们额外做人类测试集与人类评分的原因。我从数据中观察到的:其一,在高对齐模型上仍付出可见代价——Qwen-Image丢0.03、FLUX.2丢0.05 VQAScore,FLUX.2偏好损失尤其大(ImageReward −0.40、HPSv3 −10%),因为其i.i.d.图像本就质量极高、几乎无下探空间;其二,多样性在TPIPSv 0.35~0.40饱和,继续训练即出现reward hacking(乱加人数、过度细节),说明指标驱动的优化存在天花板;其三,附录用户反馈暴露了交互层短板:多轮编辑累积伪影致图像不可用、无法从单张选定图变化、无区域级控制、风格轴常被实现为内容改变、隐含意图(「变动物」应暗示变大小/姿态)不被推断、渲染器能力边界(数不清表盘上24个数字)无提示机制;其四,伦理上族裔/性别等敏感轴可被用于刻板印象描绘,系统自身不加安全过滤、只继承底座模型的过滤器。
独立分析的弱点
独立分析四个弱点。弱点一:奖励全靠代理指标(TPIPS/VQAScore/HPSv3),消融已证明每个单项都可被hack(崩对齐、提示词膨胀、字幕印图),完整奖励只是封堵了已被观察到的hack,并未证明对新型hack鲁棒——改进方向是在训练循环中加入小规模人类偏好在线反馈,或用多个偏好模型 ensemble 并对分歧样本降权。弱点二:单轴单强度——真实用户明确要求「族裔高方差+服装低方差」的按属性强度控制,而当前架构的 $\alpha_s$ 是作用于整个适配器的全局标量;可让策略输出结构化的「轴-强度」对,或在推理时对每条扩展提示分别缩放。弱点三:文本条件多样性本质上受限于渲染器对文本的服从度,视角/取景这类「提示词写得出但模型不执行」的轴需要图像空间奖励(如显式相机姿态估计器)或视角特定的训练行,作者的用户研究把相机轴列为最高频失败——这正是文本层方法的原理性边界。弱点四:交互设计缺口——无法锚定单张图做变化(用户呼声最高的功能)、编辑轮次无深度控制导致伪影累积、建议VLM不区分「变化类」与「修复类」请求;缓解方案包括把用户选定的图作为 $\pi_{edit}$ 的条件输入、编辑N轮后自动改用 $\pi_{gen}$ 重渲染、以及在建议模块中做请求类型分类。另有一个统计层面的隐忧:测试集仅405对、每对仅3名评分者,人类结论的置信区间较宽。
未来方向
作者明确提出的方向:策略与生成器联合微调以攻克视角/取景轴(纯提示层修不了);感知校准的强度→$\alpha$ 映射(可按渲染器分别拟合);缓解对TPIPS偏差的继承。基于其成果可自然延伸的:其一,从图像扩展到视频——时间维度上「沿轴变化」对分镜与故事板生成的价值更大,且TPIPS类条件度量可直接迁移;其二,多轴联合与属性级强度,把轴从单条文本扩展为带权重的轴集合;其三,单图锚定的变化(用户最强烈诉求),需要把选中图像喂给编辑策略并把drift约束反向重构——从「别离源图太远」变为「别离锚图太远且变化须落在轴上」;其四,区域级编辑指令语言(保留/替换指定区域),把当前「整图要么全保留要么全放弃」细化为空间控制;其五,渲染器能力检测:当轴(如要求表盘显示1–24)超出渲染器表达力时给出明确警示而非沉默失败;其六,把「校准hinge+集合级GRPO+共享初始latent」提炼为通用的集合级RL后训练配方,应用到文本生成(多样化回答)等其他模态;其七,为敏感轴(族裔、性别)加刻板印象检测层,在保留反同质化正面价值的同时收窄滥用空间。
复现评估
复现条件总体较好。作者承诺发布代码、训练与验证数据、交互测试集(405对)、人类评分研究和训练好的适配器(匿名仓库链接在首页)。数据构造完全透明:HPDv2过滤的两段提示词模板(Figure 4/5)、轴诱导系统提示(Figure 6)、生成/编辑策略训练模板(Figure 7/8)全文公开;超参数齐备——LoRA rank 32、学习率 $2\times10^{-5}$、800步、无KL项、$\lambda=2$、$\mu=0.1$、$\eta=0.05$、词预算 $w=20$、$K=4$、$G=8$、每步8个(提示,轴)对。算力门槛:训练一个策略每步渲染并打分256张512px图、共800步约20万张图,四个开放模型×三档策略尺寸各自独立训练,训练期需要多卡GPU(推理侧基准是单卡H200+vLLM);评测需部署VQAScore、HPSv3、ImageReward、TPIPS、Vendi、DreamSim、DINOv2一串模型,人类评测(约2,400条)若不复刻可只跑自动指标。总体难度中等:不需要改扩散模型权重或访问专有API做训练,最重的部分是GRPO管线和渲染预算;最低成本复现路径是下载官方适配器直接推理(4B策略+FLUX.2 [klein]渲染最快),或选单一模型小规模复训。
论文图表
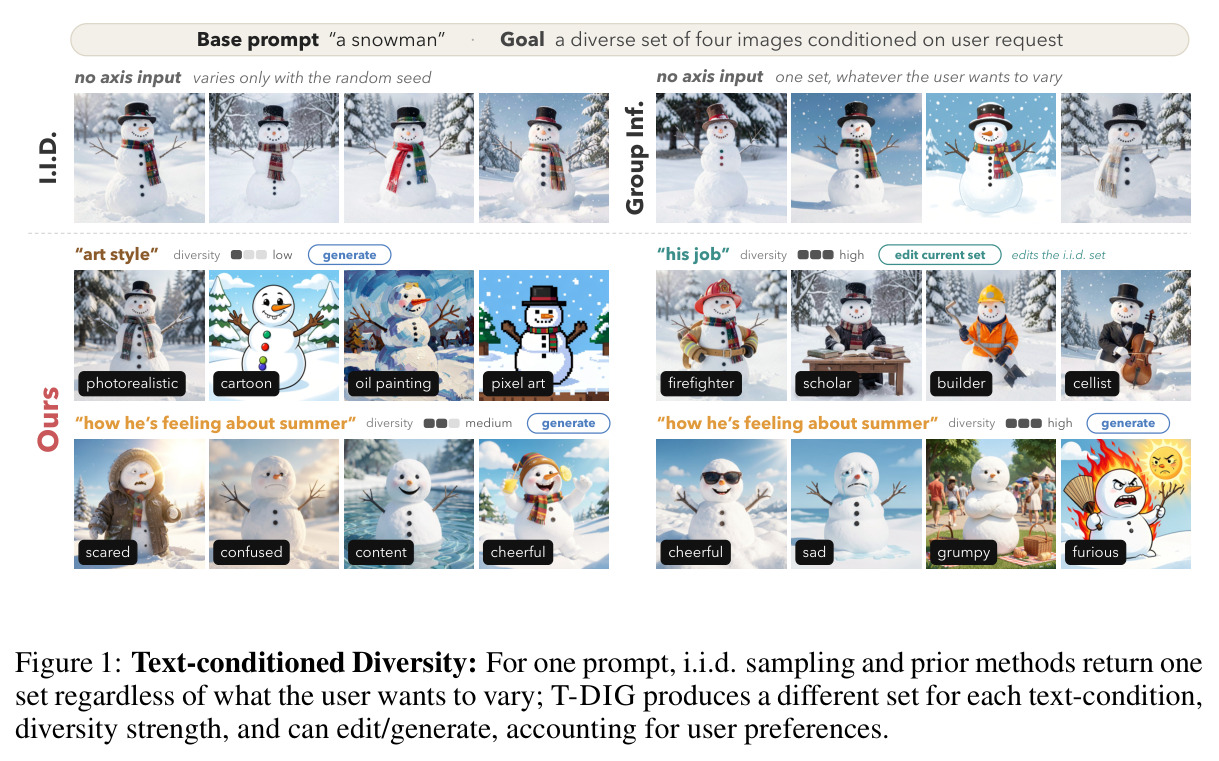
以雪人为例的六格对比图:无轴输入时i.i.d.采样只随随机种子微变、「一组图像不管用户想变什么」;给定轴「艺术风格」时T-DIG生成photorealistic/cartoon/油画/像素画四种风格,多样性高;给定轴「他的职业」时以编辑模式把i.i.d.集合改成消防员/学者/建筑工/大提琴手;给定轴「他对夏天的感受」时分别以中、高强度生成不同表情集合。
一图讲清论文的核心概念:相同的提示在不同轴、不同强度、不同模式下产生完全不同的输出集合,而这是所有先前方法(只返回一个预定集合)做不到的——是理解整篇论文动机的钥匙。
用于过滤HPDv2基础提示池的LLM提示模板前半部分:定义「轴」的概念(可以非常提示特异如挂钟显示的时间,也可以宽泛如艺术媒介)、列出硬性排除项(真实人物、不安全内容、无可描绘主体、风格堆砌)、要求保留至少能指出三个有意义视觉维度的提示。
训练数据质量的决定环节之一。它展示了如何用LLM系统地构建「可多样」的提示池,对想复现数据管线的读者是必要材料,也体现了作者对轴定义的严谨态度(固定子属性不等于固定所有属性)。
过滤模板后半部分:轴计数的诚实规则(同义描述不得拆成三条凑数;轴名是维度不是取值;至少两条轴须关于被描绘主体;不允许给每个提示硬套「背景/光照/风格」)、三个正反示例(挂钟、公园读书的人)和JSON输出格式(keep/reason/variation_axes含维度与示例取值)。
与Figure 4共同构成完整的数据筛选协议;其中的轴判定规则(如「红色椅子固定了颜色但材料与设计仍开放」)直接反映了论文对「什么算一个合法变化轴」的定义,是理解任务边界的实用材料。
轴诱导的系统提示全文:给定基础提示、其i.i.d.生成图像和人类书写的示例请求,要求Gemini 3.8 Flash生成至多4条用户可能提出的变化请求;规则包括只建议图像中重复出现或缺乏变化的属性、不得变动基础提示已固定的内容、提示优先于图像、混合具体与宽泛请求、区分「变化请求」与「修复请求」;输出JSON含request、observation、why_free、tpips_factor等字段。
训练轴的全部来源协议。T-DIG的训练数据不是模板而是「以真人先导研究为种子、VLM规模化生成」的自由文本轴,这个模板是复现76,089对训练数据的关键,也展示了如何让合成数据带上人类分布。
生成策略的GRPO训练提示模板:按重要性排序的五条规则——基础提示的选择是约束不是变量(「两个男人」不能变成一个女人或一群人)、已固定的内容只能在内部变化、只变给定轴且K条提示覆盖明显不同的取值、每条不超过c=|p|+20词、其余尽量复用基础提示原词;另有「overall」行的变体规则(防止K条提示坍缩或只朝同一方向变化)。
策略行为的完整规范。GRPO的奖励只定义「什么是好的集合」,这个模板定义「什么是合法的输出」,两者共同决定训练效果;对理解未训练T-DIG(α=0)为何已能媲美CADS也是关键材料。
编辑策略的GRPO训练提示模板:输入为基础提示、K张源图和轴,输出K条按序对应各图的一条指令;规则包括一一对应、编辑而非替换(重写整场的指令会毁掉原图)、只变给定轴、基础提示的选择是约束、每条指令写成对编辑模型的直接命令且不超过30词;overall行的变体要求K条指令各改不同类型的方面。
与Figure 7对照可见生成与编辑两种模式的差异(词帽固定30词vs随提示伸缩),以及防止「换图冒充编辑」的提示层设计——它与训练中的DreamSim drift惩罚(Eq. 7)构成双重防线。