Policy-Mask:面向判别任务的预算感知扩散特征选择 Policy-Mask: Budget-Aware Adaptation of Diffusion Features to Discriminative Tasks
用强化学习策略在预算下联合选择扩散特征的时间步、层与通道子集并蒸馏紧凑学生网络
前置知识
扩散模型中间特征表示
扩散模型(如 Stable Diffusion 的 U-Net)在去噪过程的每个时间步 $t$、每个网络层 $l$ 都会产生中间激活。已有研究表明这些激活携带丰富语义信息,可直接服务于分割、分类、语义对应等判别任务。可用特征由三个维度共同决定:去噪时间步 $t$(不同噪声水平下语义粒度不同)、网络层 $l$(浅层偏纹理、深层偏语义)、以及通道子集 $K$(每个特征图含数百到上千个通道,判别信号分布不均),三者组合的下游表现差异可达数个点。
本文的全部贡献就是把『选哪个 $t$、哪个 $l$、哪些通道』这个三维选择问题自动化,不理解特征的来源与维度结构,就无法理解策略在选什么、预算约束作用在哪根轴上。
知识蒸馏(Knowledge Distillation)
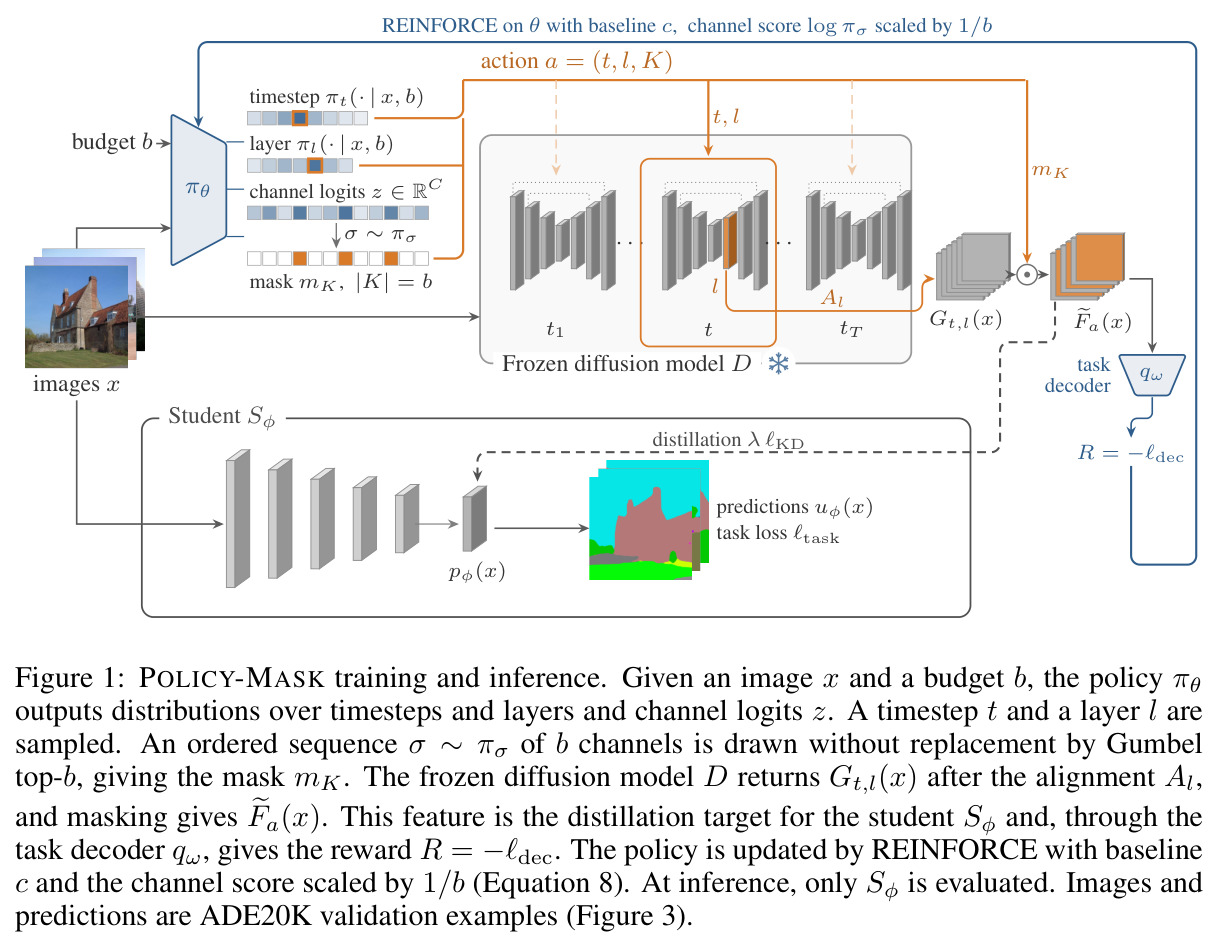
让小容量学生网络模仿大容量教师网络的输出以继承其能力。本文设定中教师是冻结的扩散模型,学生被训练去拟合策略选出的特征 $\hat{F}_a(x)$ 作为蒸馏目标,损失为 $\ell_{KD}(p_\phi(x), sg[\hat{F}_a(x)])$,其中 $sg$ 是停止梯度;推理时只运行学生,完全不再前向昂贵的扩散教师。这使紧凑表示(如 128/1280 通道)在部署时保持低开销。
POLICY-MASK 的训练框架是『策略选目标 + 学生学目标』双回路:蒸馏项是学生损失的组成部分,而选出的特征同时通过任务解码器产生策略奖励,理解师生分工才能看懂 Algorithm 1。
REINFORCE 与基线(Policy Gradient)
处理离散动作的经典策略梯度方法。对动作 $a$,梯度估计为 $\hat{g} = (R - c)\nabla_\theta \log \pi_\theta(a)$,其中 $R$ 是环境返回的标量奖励、$c$ 是与动作无关的基线(本文用停止梯度的移动平均)。减去基线不改变梯度期望但显著降低方差。子集选择是纯离散组合问题、无法直接反向传播,因此需要这类 score-function 估计器。
本文的训练信号完全来自 REINFORCE(公式 7、8),任务解码器的损失 $\ell_{dec}$ 就是奖励,若不理解策略梯度和基线的方差缩减原理,就无法理解为什么需要基线 $c$、以及 $\frac{1}{b}$ 因子改变了什么。
Plackett–Luce 分布与 Gumbel top-b 采样
从 $C$ 个候选中无放回地抽取恰好 $b$ 个的概率机制:给每个通道 logits 加独立 Gumbel 噪声 $g_c = -\log(-\log U_c)$ 后取前 $b$ 大,等价于从 Plackett–Luce 排序分布采样,其对数概率有闭式表达(本文公式 6),因而可以计算策略梯度。相比『稀疏正则』软约束,它硬性保证 $|K|=b$ 的精确基数,且梯度可估计。
这是实现『预算感知』二字的技术核心:预算 $b$ 是被精确执行的硬约束而非软惩罚,理解 Gumbel top-b 才能明白为什么通道得分是 $b$ 项之和、以及为何要除以 $b$。
mIoU 与 PCK 评估指标
mIoU(平均交并比)是语义分割标准指标:对每个类别计算预测区域与真值区域的交集/并比,再对类别取平均,对类别不平衡敏感。PCK(Percentage of Correct Keypoints)是语义对应任务指标:预测对应点与真值点距离小于阈值即算正确,PCK@0.1 表示阈值取图像尺寸(img 归一化)或物体包围盒尺寸(bbox 归一化)的 10%,两种归一化数值不可直接比较。
论文所有结论都用这些指标表述(如 ADE20K 38.9 mIoU、SPair-71k 76.3 PCK@0.1、多种子标准差 ±0.7),理解指标含义才能判断 1–1.6 点的提升在实际中是否显著、以及哪些对比因归一化方式不同而不可比。
研究动机
扩散模型的判别价值分散在去噪轨迹、网络深度和通道三个维度上:有用信号同时取决于时间步 $t$、网络层 $l$ 和通道子集 $K$ 的组合。现有方法只解决了这个问题的一小部分:DDAE 等固定规则方法手工固定提取点;最接近的 RepFusion 虽然学习选择时间步,但层与保留维度仍靠人工设定,并对全部 1280 维特征做蒸馏;另一些工作用 top-variance 或 Fisher proxy 等启发式选通道。代价是具体的:在同样的 SD-1.5 特征上,固定 $(t,l)$ 加固定 128 通道在 ADE20K 只有 33.8 mIoU,全通道 1280 也仅 37.4,而联合选择可达 38.9,固定通道子集比最优选择低 5 点以上;启发式通道选择在四个分割基准上全面落后。而且这些规则一旦确定就在所有输入、所有预算下复用同一配置,无法适应不同的通道预算约束,也没有回答『在给定预算下应该怎么选』。
本文的目标是本文要把『从冻结扩散模型提取特征』形式化为预算约束下的决策问题:给定输入图像 $x$ 和通道预算 $b$,一个策略联合选择时间步 $t$、层 $l$ 和恰好 $b$ 个通道组成的子集 $K$,选择质量由下游任务损失直接反馈(作为奖励)。选出的特征同时充当蒸馏目标,训练一个轻量学生网络;推理阶段完全脱离扩散教师、只跑学生。作者还要求该决策接口能从 U-Net 迁移到 DiT(PixArt-Σ)和 MMDiT(SD3.5)等 transformer 架构,把 U-Net 通道轴替换为图像 token 隐藏维度,并在约 10% 的匹配通道比例下验证有效性,最终证明紧凑的扩散表示可以在分割、分类和语义对应三类判别任务上同时超越全宽度和启发式筛选基线。
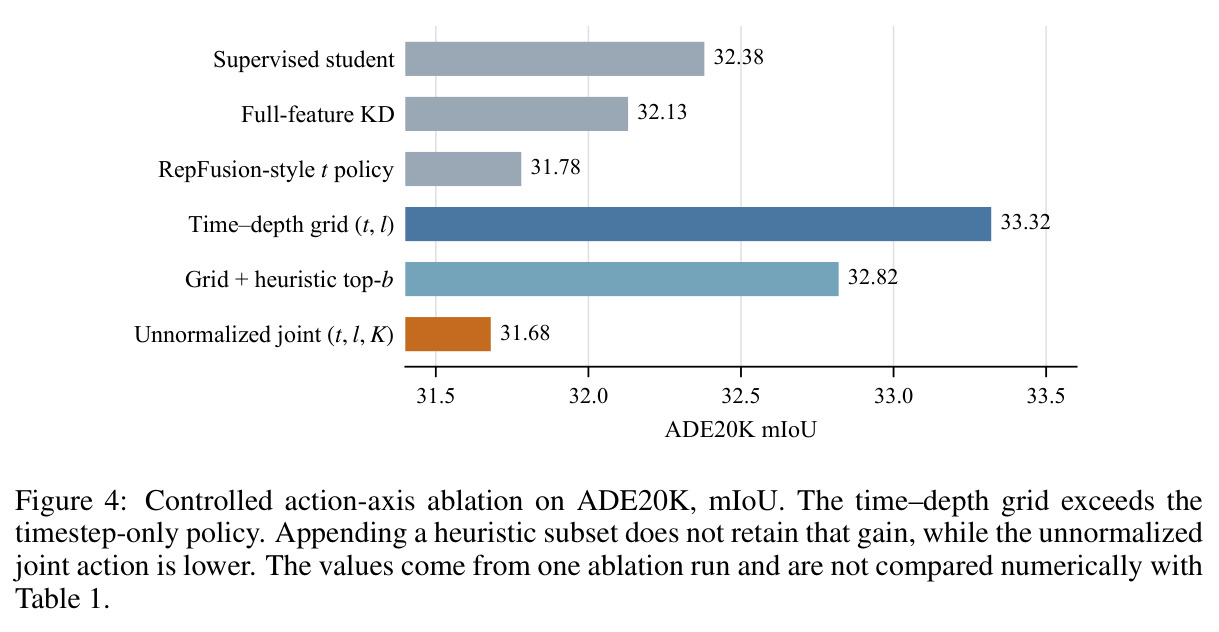
与已有工作不同的是,切入角度的独特性有三点。其一,把选择对象从单维(仅时间步)扩展为 $(t,l,K)$ 三维联合动作,且子集约束是精确基数而非稀疏正则:通过 Plackett–Luce 排序和 Gumbel top-b 无放回采样硬性保证 $|K|=b$,同时保留闭式对数概率以支持策略梯度,这是与 RepFusion(只选 $t$、全宽度蒸馏)的本质区别。其二,作者发现多动作头存在尺度失衡问题:通道项得分是 $b$ 项之和,时间步和层项各只有一项,无归一化时通道头主导联合更新,联合策略反而掉到 31.68 mIoU、低于仅时间步策略的 31.78;用 $\frac{1}{b}$ 因子把求和变成均值后问题消解,这个『动作轴梯度平衡』视角此前未见系统研究。其三,给出从 U-Net 到 DiT/MMDiT 特征格的形式化动作映射(公式 9),使同一策略范式适配不同架构,而非针对单一模型手工设计。
核心方法
直觉上,与其人工猜测哪个时间步、哪一层、哪些通道最有判别力,不如让策略网络在下游任务损失的反馈下自己学,并在规定预算内选。技术路线(Figure 1):策略 $\pi_\theta$ 接收图像与预算 $b$,分解为时间步分布 $\pi_t(t|x,b)$、层分布 $\pi_l(l|x,b)$ 和通道 logits $z\in\mathbb{R}^C$ 三个头;对 $z$ 加独立 Gumbel 噪声取前 $b$ 大,得到无放回的有序抽取 $\sigma$ 和掩码 $m_K$,动作 $a=(t,l,K)$ 的对数概率可完全分解(公式 4)。冻结教师 $D$ 在 $(t,l)$ 的响应经对齐映射 $A_l$ 投到公共 1280 宽度得 $G_{t,l}(x)$,掩码后得 $\hat{F}_a(x)=G_{t,l}(x)\odot m_K$。小任务解码器 $q_\omega$ 用 $\hat{F}_a$ 做预测,奖励 $R=-\ell_{dec}$;学生 $S_\phi$ 以 $\mathcal{L}_{stu}=\ell_{task}+\lambda\ell_{KD}(p_\phi,sg[\hat{F}_a])$ 训练,推理只跑学生。主实验教师为冻结 SD-1.5 U-Net,紧凑选择保留 128/1280 即 10% 通道。
核心创新有两点。第一,预算化 $(t,l,K)$ 策略配精确基数采样:通道子集不用稀疏惩罚等软约束逼近,而是通过 Gumbel top-b(公式 5)从 Plackett–Luce 排序分布无放回抽出恰好 $b$ 个通道,其得分有闭式表达(公式 6),因此 score-function 梯度估计 $\hat{g}=(R-c)\nabla_\theta\log\pi_\theta$(公式 7)保持无偏,预算被硬性执行。第二,通道得分归一化:$\log\pi_\sigma$ 是 $b$ 项之和,而 $\log\pi_t$、$\log\pi_l$ 各一项,无归一化时通道头梯度随 $b$ 线性增长并压制另两个头——消融中未归一化联合策略只有 31.68 mIoU,低于仅时间步策略的 31.78。将通道项除以 $b$(公式 8)把求和变成均值,三头回到可比尺度,固定对齐下三种子平均 mIoU 从 36.8 升至 37.7。作者诚实地把它定位为预条件子而非 $\nabla_\theta J_b$ 的无偏估计:共享主干与自适应优化器下它改变各头的相对贡献,思想接近 GradNorm,迁移到离散策略的动作轴平衡是新组合。
方法步骤详情
训练按 Algorithm 1 逐 minibatch 执行。(1) 输入 $(x,y)$ 与预算 $b$:策略采样 $t$、$l$(类别分布),通道侧对 logits $z$ 加 Gumbel 噪声 $g_c=-\log(-\log U_c)$ 取前 $b$ 大,得 $\sigma$ 与掩码 $m_K$。(2) 查询冻结教师 $D$ 在 $(t,l)$ 的响应,经对齐 $A_l$ 得 $G_{t,l}(x)\in\mathbb{R}^{1280\times H_s\times W_s}$,掩码得 $\hat{F}$;消融中 $A_l$ 固定于初始化(可训练时 KD 损失两 epoch 内缩到 0.005 以下)。(3) 任务解码器 $q_\omega$(输入 detach)输出预测,奖励 $R=-\ell_{dec}(q_\omega(\hat{F}),y)$。(4) 策略更新:$\hat{g}^{bal}=(R-c)\nabla_\theta[\log\pi_t+\log\pi_l+\frac{1}{b}\log\pi_\sigma]$,$c$ 为停止梯度的移动平均基线。(5) 学生更新 $\mathcal{L}_{stu}=\ell_{task}(u_\phi(x),y)+\lambda\ell_{KD}(p_\phi(x),sg[\hat{F}])$(ADE20K 另含 Dice),解码器以 detach 输入按 $\ell_{dec}$ 更新。推理只前向 $S_\phi$;选通道开销 $O(|T|+|L|+C)$,瓶颈在教师查询与对齐。transformer 教师上动作映射为 $(\lambda,d,K_{hid})$:$\hat{G}_{\lambda,d,K}=R_d A_d\,\mathrm{LN}(H^{img}_{\lambda,d})[:,K]$(公式 9),MMDiT 只作用于联合注意力后的图像流。
技术新颖性
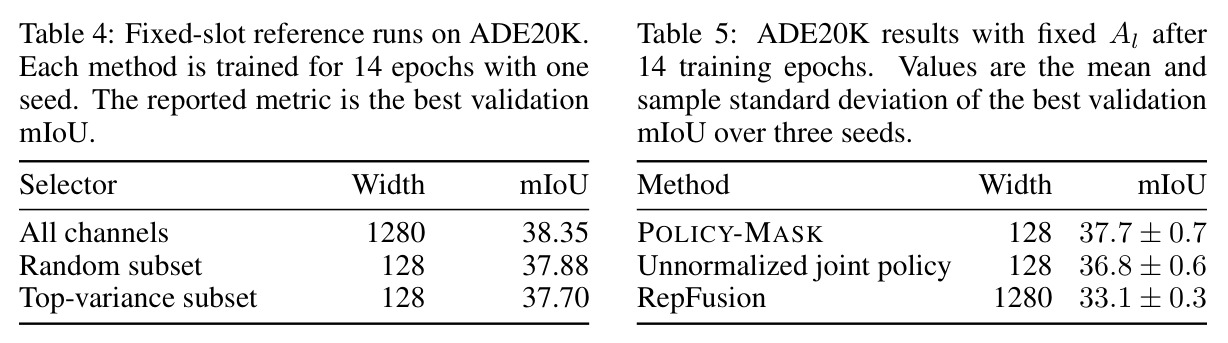
新颖性可从三个参照系评估。相对 RepFusion:后者只学习时间步、蒸馏全部 1280 维,本文首次把层与通道子集纳入可学习决策,且选择是输入与预算双条件化的;相对 DDAE、DIFT 等固定规则方法:本文用任务奖励端到端训练选择器,而非事后启发式(top-variance/Fisher proxy)。相对子集选择文献:传统 filter/wrapper/贪心方法不在训练回路内,本文用 Gumbel top-b 把无放回子集采样嵌入策略梯度,在扩散蒸馏特征选择场景首次系统应用精确基数采样,并细致处理了『奖励对顺序 $\sigma$ 不变、但计分须用生成掩码的那次抽取』这一细节。$\frac{1}{b}$ 通道归一化是本文独有的训练稳定技术,受控消融(Figure 4 单种子 31.68 vs 33.32;Table 5 三种子 36.8±0.6 → 37.7±0.7)支撑其必要性;作者把它明确归类为预条件子而非无偏修正,克制的形式化表述在应用型论文中少见。从 U-Net 通道到 DiT/MMDiT 隐藏维度的动作映射(公式 9)则提供了跨架构统一抽象,并以匹配容量比例(约 10%)的实验设计避免按原始宽度不公平比较。
实验结果
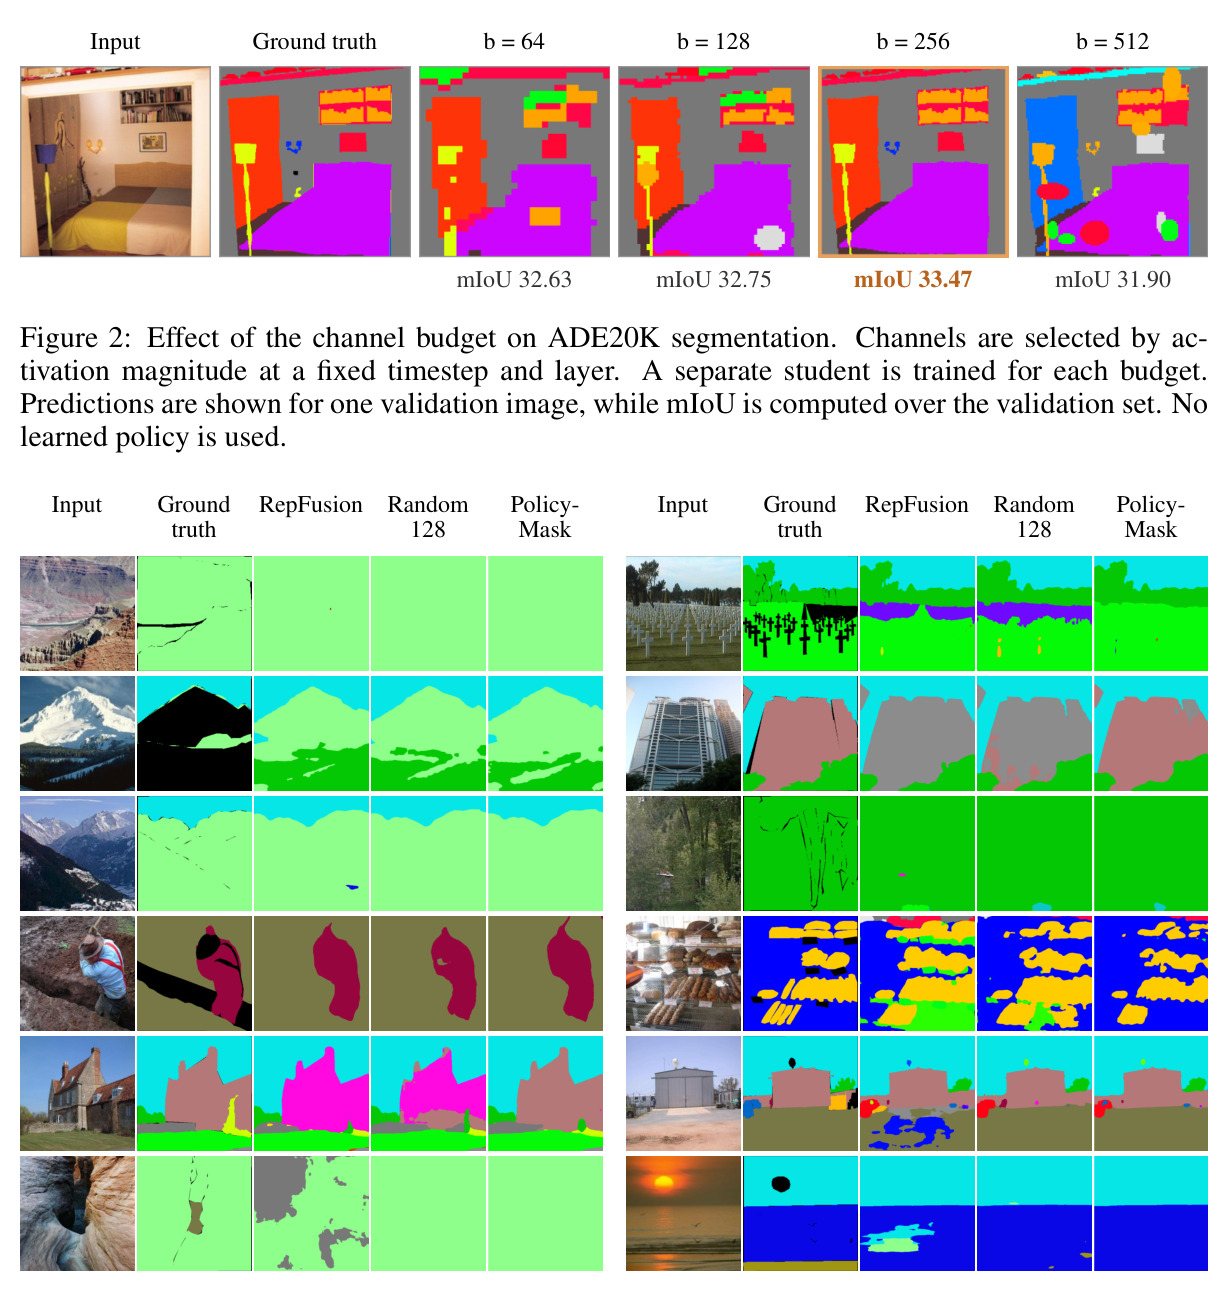
分割(Table 1,b=128/1280):ADE20K/Cityscapes/CelebA-HQ/Pascal VOC 达 38.9/70.2/79.1/74.8 mIoU,超过全通道固定 $(t,l)$ 的 37.4/68.6/77.9/73.5(+1.5/+1.6/+1.2/+1.3),也超过 Fisher proxy(36.4/65.7/75.3/71.0),只用 10% 通道。分类与对应(Table 2):CIFAR-10 95.2%、CIFAR-100 75.4%,比 RepFusion 高 1.0/1.3 点;SPair-71k PCK@0.1 达 76.3(img)/67.5(bbox)。动作轴消融(Figure 4,单种子):仅时间步 31.78 → 时间-层网格 33.32 → 加启发式 top-b 降至 32.82 → 未归一化联合 31.68,扩大动作空间不自动涨点。归一化消融(Table 5,三种子):归一化 37.7±0.7 vs 未归一化 36.8±0.6,RepFusion 仅 33.1±0.3。预算扫描(Figure 2):b=64/128/256/512 为 32.63/32.75/33.47/31.90,最高在 b=256,但 KD 损失尺度随 b 漂移(0.59→0.94→1.35),通道数与蒸馏强度无法解耦。变换器教师(Table 3,约 10% 匹配比例):SD3.5 MMDiT 36.4/72.9/74.6 高于 PixArt-Σ(35.0/71.6/73.5)与 SD-1.5(34.1/70.8/72.8),但每教师仅评一次。定性上 2000 张验证图中 39.1% 图像级 mIoU 超 RepFusion。
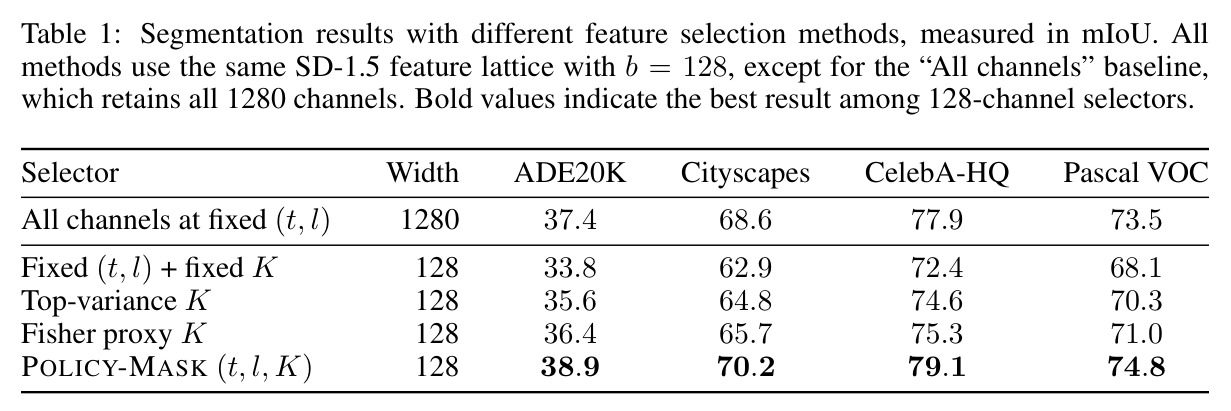
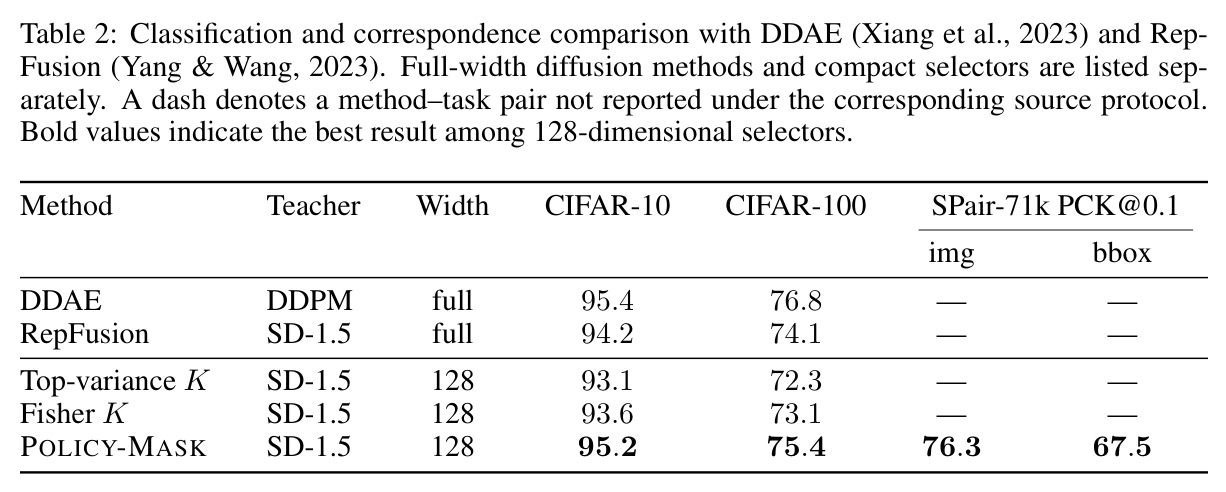
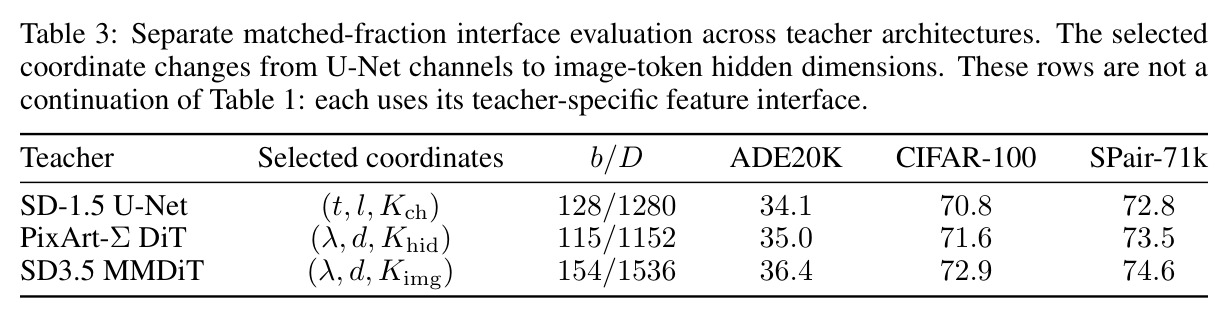
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语义分割 ADE20K | mIoU(b=128/1280) | 38.9 | 全通道 1280 固定 (t,l):37.4 | +1.5 |
| 语义分割 Cityscapes | mIoU(b=128/1280) | 70.2 | 全通道 1280 固定 (t,l):68.6 | +1.6 |
| 语义分割 CelebA-HQ | mIoU(b=128/1280) | 79.1 | 全通道 1280 固定 (t,l):77.9 | +1.2 |
| 语义分割 Pascal VOC | mIoU(b=128/1280) | 74.8 | 全通道 1280 固定 (t,l):73.5 | +1.3 |
| 图像分类 CIFAR-100 | top-1 准确率(128 维) | 75.4% | RepFusion(全宽):74.1% | +1.3 点 |
| 图像分类 CIFAR-10 | top-1 准确率(128 维) | 95.2% | RepFusion(全宽):94.2% | +1.0 点 |
| 语义对应 SPair-71k | PCK@0.1(图像归一化) | 76.3 | DDAE/RepFusion 未在源协议下报告 | 首个 128 维紧凑报告 |
| ADE20K 归一化消融 | mIoU(三种子均值±std) | 37.7±0.7 | 未归一化联合策略:36.8±0.6 | +0.9 |
局限与改进
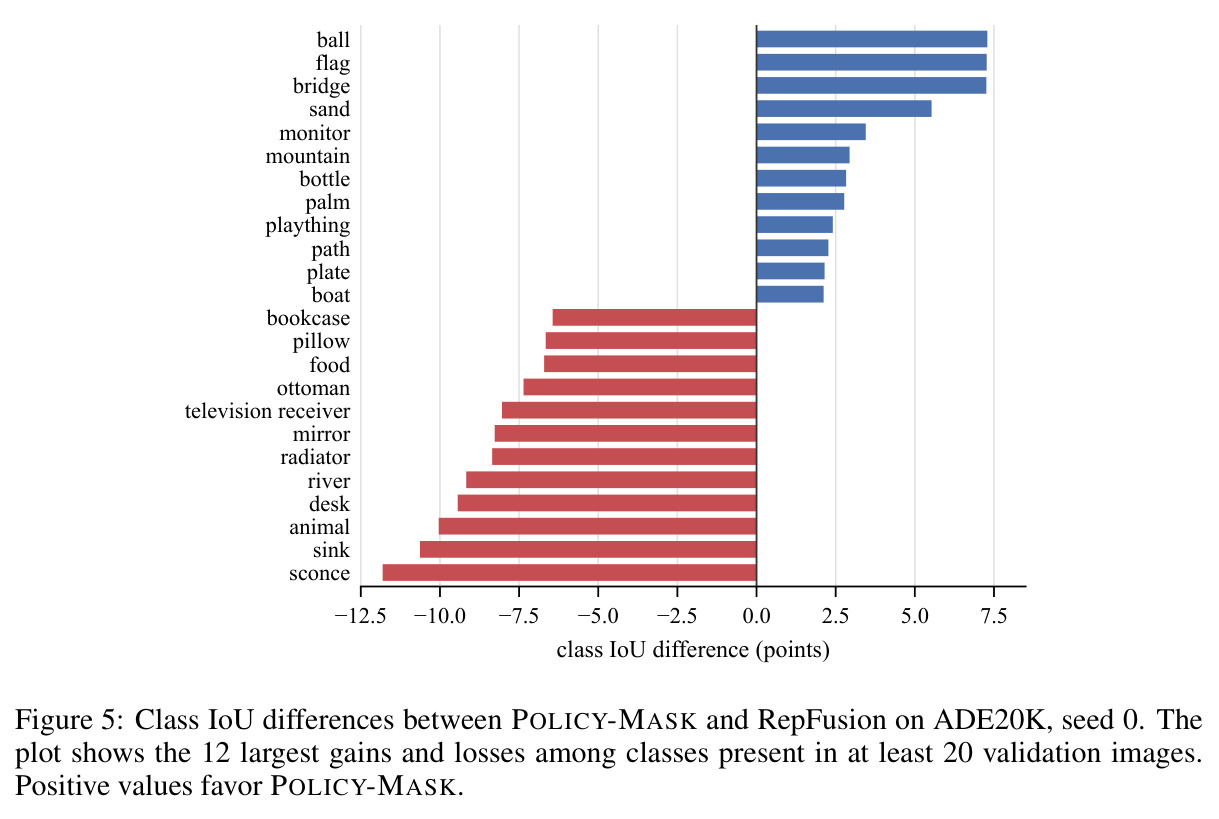
作者承认三点:(1) 预算扫描存在混淆变量——掩码 KD 损失在全部 1280 通道上平均,b 从 128→256→512 时其均值从 0.59 涨到 0.94 再到 1.35,b=512 的下降(31.90 mIoU)不能归因于通道冗余,『选多少通道』实际悬而未决;(2) 重复性不足:归一化消融与 RepFusion 对比有 3 种子,但动作轴消融、预算扫描和定性分析均单种子;(3) 变换器教师每架构只评一次,Table 3 只证明接口可迁移而非架构优劣。我的补充:(4) REINFORCE 方差高,每步需查询冻结教师,计算瓶颈在教师前向而非选择器,论文未报告训练总开销;(5) 蒸馏目标随输入变化(策略逐图像选 $(t,l,K)$),目标非平稳对学生收敛的影响未分析;(6) 可训练对齐 $A_l$ 会收缩到零(KD 损失低于 0.005)只得固定初始化,暴露该组件的退化风险;(7) 类别级结果(Figure 5)显示 sconce、sink、animal、desk 等类 IoU 下降可达 10 点以上,紧凑掩码对部分细粒度类有系统性伤害。
独立分析的弱点
独立分析出的弱点及改进方向:(1) 预算与蒸馏强度耦合是最大的方法学缺陷,改进方向是把 KD 损失改为仅在选中的 $b$ 个通道上归一化,或对目标范数做逐预算标准化后再扫描,才能真正回答『最优预算是多少』;(2) 关键消融的统计功效不足:Figure 4 中未归一化联合(31.68)与仅时间步策略(31.78)只差 0.1 点,小于三种子实验的 ±0.6–0.7 标准差,『归一化前联合策略更差』的结论在单种子下不可靠,应至少 3 种子重跑;(3) 策略梯度可换成可微替代(Gumbel-softmax 软掩码加温度退火)或方差更低的估计器,以减少教师查询次数与训练不稳定;(4) 固定 $A_l$ 是权宜之计,可对 $A_l$ 施加正交约束或谱范数正则避免收缩到零,让对齐可学习而不退化;(5) 输入条件化策略在推理期被整体丢弃,其学到的知识没有传承给学生——可让学生携带轻量路由头或做目标条件化,继承『不同图像适合不同提取点』的先验;(6) Table 3 每教师单次评估难以支撑教师间暗示性排序,应统一协议、多种子重测后再谈架构差异。
未来方向
作者明确指出的方向:用『仅在选中通道上归一化的 KD 损失』重做预算扫描,把通道数与蒸馏强度解耦,这是确定最优运行预算的主要开放问题;对 DiT/MMDiT 教师做多种子评估以支撑架构比较。基于成果可延伸的方向:(1) 多预算联合训练——策略已以 $b$ 为条件,可研究预算-精度帕累托前沿并让单一策略服务多个部署点;(2) 把 $(t,l,K)$ 扩展到视频扩散模型的时间-空间-通道三维联合选择;(3) 结合 CleanDIFT 等无噪声特征工作:若时间步维度可被消除,策略退化为 $(l,K)$,搜索空间与梯度方差都会显著降低;(4) 用分割、对应、深度等多任务奖励加权,检验最优提取点是否任务无关、是否存在跨任务的通用『感知最优层』;(5) 既然动作能迁移到 PixArt-Σ 与 SD3.5 MMDiT,可进一步探索特征选择策略的跨模型可迁移性,把策略作为冻结生成底座上的通用感知插件;(6) 类别级损失分析(Figure 5)提示可引入类别感知或不确定性感知的通道预算分配。
复现评估
有利因素:所有数据集公开(ADE20K、Cityscapes、CelebA-HQ、Pascal VOC、CIFAR-10/100、SPair-71k);三个教师(SD-1.5、PixArt-Σ、SD3.5 Medium)的模型卡均有链接;Algorithm 1 伪代码完整,核心公式(4–9)闭式可实现;Gumbel top-b、REINFORCE、知识蒸馏都有成熟开源实现;附录给出关键协议细节($A_l$ 固定初始化的原因、14 epoch 参考协议、三种子设置、各预算下 KD 损失数值)。不利因素:正文未提及官方代码发布;优化器类型、学习率、batch size、蒸馏权重 $\lambda$ 的具体取值未在正文给出;复现算力门槛高——每步都要前向冻结 SD-1.5 并在采样的 $(t,l)$ 取特征,相当于持续运行一个 U-Net 推理,训练成本接近微调扩散模型级别;多处关键结论(0.9 点级差异)依赖三种子平均,单卡复现者需多次运行才能确认。综合判断:协议描述诚实完整、可信度较高,但属于中等偏难复现,完整复现主表约需单张高端 GPU 数天时间。
论文图表
seed 0 下相对 RepFusion 图像级 mIoU 提升最大的 12 张 ADE20K 验证图,每块五列依次为:输入、真值、RepFusion、Random 128、POLICY-MASK。可见修正的外墙(facade)标签,以及墓地、面包房、海景等场景中误判区域的减少。
提供方法在像素级到底改变了什么的直观证据;特别是包含 Random 128 对照列,说明增益来自学到的通道/时间步/层选择,而不是单纯降维本身。
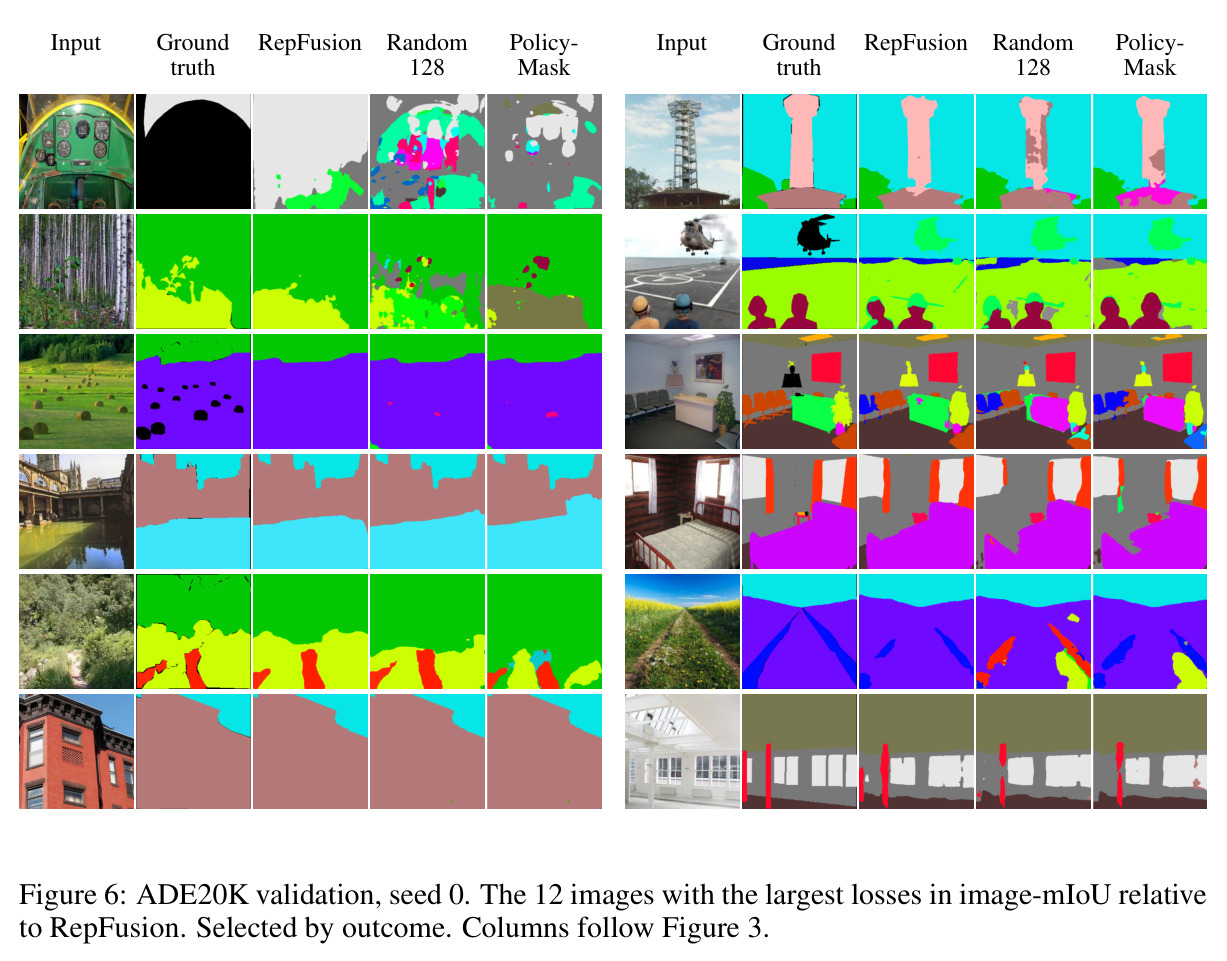
与 Figure 3 对称的失败案例分析:相对 RepFusion 图像级 mIoU 下降最大的 12 张验证图,列顺序相同(输入、真值、RepFusion、Random 128、POLICY-MASK),并附对应的损失面板。
平衡的定性评估:作者主动呈现方法失效的样例,与 Figure 5 的类别级损失互相印证,帮助读者了解紧凑选择在何种场景下会输给全宽度蒸馏。
固定槽位参考运行(14 epoch、单种子、独立协议):全通道 1280 最佳验证 mIoU 38.35,随机 128 子集 37.88,top-variance 128 子集仅 37.70;另与 Table 5 同协议的 RepFusion(1280)为 33.1±0.3。
提供不与主表直接比较的参考点:该协议下全通道并未显著优于随机子集,说明协议敏感性很高;同时帮助读者理解 Figure 2 预算扫描数值的来源背景。