大型流语言模型 Large Flow Language Models
Lafa用块级异步连续流适配预训练AR模型,自投机解码带来2.54倍吞吐
前置知识
流匹配(Flow Matching)
训练一个速度场 $v_t$,把高斯噪声 $x_0\sim\mathcal{N}(0,\sigma^2 I)$ 沿 ODE $\dot{x}_t=v_t(x_t)$ 输运到数据分布,标准插值为 $I_t=(1-t)x_0+tx_1$。相比扩散模型的迭代去噪,流路径更直、采样步数更少,且天然支持蒸馏成少步跳转的流图(flow map),这是图像生成中成熟的加速与控制工具箱。
Lafa 的全部机制都建立在词嵌入空间上的流匹配:看懂条件概率路径、插值和速度场,才能理解块去噪器与 ODE 速度之间的换算关系。
块自回归与前缀缓存
把生成分解为 $p(y|c)=\prod_r p(y_{rB+1:(r+1)B}\mid c,y_{\le rB})$:块之间自左向右串行生成,块内并行产生 $B$ 个 token;已生成前缀的 KV cache 跨块复用、无需重算。这是 block diffusion、MTP 等并行解码方法共享的效率骨架。
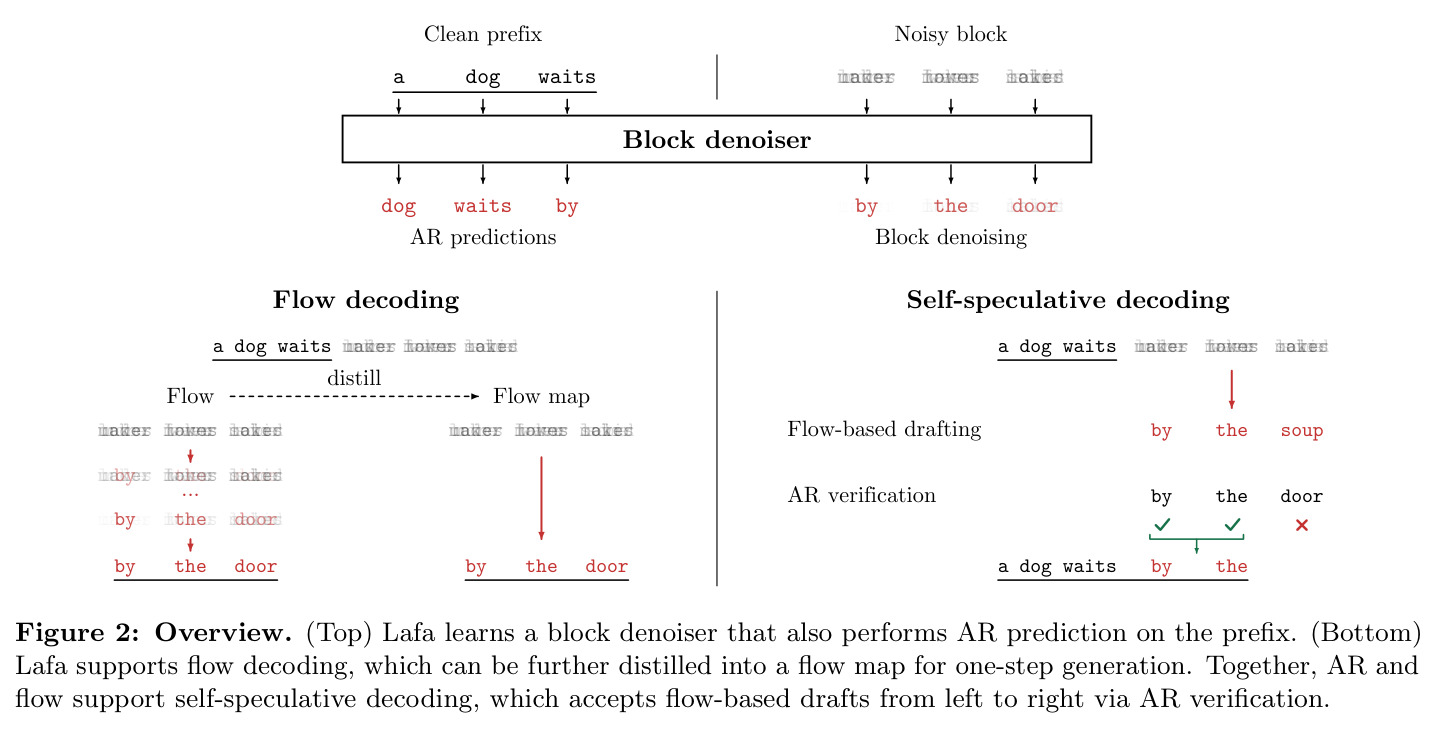
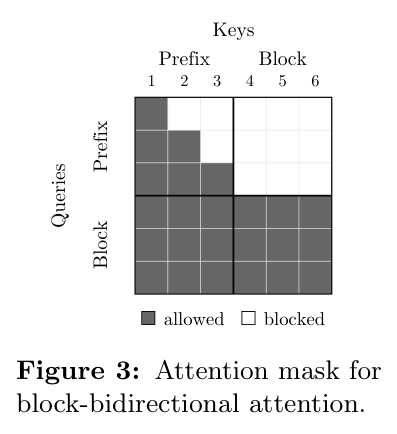
Lafa 刻意保留这种因果分解,因此能直接继承 AR 推理栈的前缀缓存;理解它才能明白为什么块内改双向注意力不会破坏缓存复用。
多token预测与投机解码
MTP(如 DeepSeek-V3)让模型一次前向预测多个未来 token,用作加速解码或增强训练信号;投机解码则由小模型起草、大模型逐 token 自回归验证,保证输出分布与目标模型一致。两者共享'并行草稿 + 自回归验证'的范式。
Lafa 把两种思想合并进同一个模型:流分支起草整块 token,保留的 AR 分支负责验证。这是理解其自投机解码与吞吐结果的前提。
adaLN 时间条件化
自适应层归一化用时间的嵌入回归出缩放与平移系数 $\gamma(t),\beta(t)$,把噪声水平注入网络,是 DiT 等图像扩散模型的标准组件。Lafa 给每个位置注入自己的 tokenwise 时间 $\tau^i(t)$,并把 adaLN 初始化为恒等映射,起步时不扰动预训练计算。
同一个网络要同时处理干净前缀(时间恒为 1)和块内各程度噪声的 token,全靠 adaLN 区分,这是看懂训练与推理设计的关键。
离散扩散语言模型
以 mask 或随机替换等离散腐蚀过程的逆过程生成文本,代表工作有 Dream 7B、LLaDA 8B、Efficient-DLM 8B 及其加速版 Fast-dLLM v2。它们已扩到数十亿参数,但训练动辄数百 B token,且离散空间难以直接套用图像领域的流图蒸馏与分类器引导技术。
这是本文最主要的对照组:理解离散扩散的优势与训练成本,才能体会连续流路线在数据效率与可蒸馏性上的差异化价值。
研究动机
自回归(AR)语言模型靠 transformer 并行与 teacher forcing 能高效训练到数十亿参数,但生成时每个前向只产出 1 个 token,推理延迟成为瓶颈。并行生成已有三条路线:多token预测(MTP)、离散扩散与连续流语言模型。离散扩散已被 Dream、LLaDA、Efficient-DLM 扩展到 7–8B 参数,但训练动辄需要数百 B token(最高约 500B),且离散空间用不上图像/视频生成中成熟的控制与加速工具。连续流模型在连续空间运算,天然支持流图蒸馏、引导采样等技术,但现有工作只在小规模、简单任务上验证过,此前一次扩展尝试还报告了训练效率低下的难题。因此,如何在十亿参数规模、用少得多的数据训练出性能不输 AR 的流语言模型,仍是未解问题。
本文的目标是本文目标是构建 Lafa(Large flow language model):一个扩展到 8B 参数、训练数据高效(<30B token)、生成质量持平或超过 AR 基线的连续流语言模型。具体包括四点:架构与归纳偏置贴近 AR,使其能直接适配 Qwen2.5 0.5B/7B Instruct 与 Qwen3 8B Base 等预训练权重;推理支持前缀缓存与块内并行流解码,并可蒸馏成流图实现一至数步生成;联合训练让流学习保留甚至提升预训练 AR 能力(多token预测效应);用保留的 AR 预测器验证流草稿实现自投机解码,最终在 7B 规模取得 AR 基线 2.54 倍吞吐、质量相当,全面优于 MTP 与离散扩散方法。
与已有工作不同的是,本文的独特切入是把块级异步流与 AR 的因果结构对齐,而非从头训练或照搬双向扩散。块间保持因果生成以继承前缀缓存;块内引入可学习的 tokenwise 时间 $\tau$,让靠前位置先完成去噪,把文本固有的从左到右方向性编码进连续流的进度调度。由于结构贴近 AR,可直接改造 Qwen 预训练权重——adaLN 恒等初始化、嵌入范数冻结只学方向——用不到 30B token 完成适配,比同类离散扩散适配(最高 500B token)节省 18 倍以上数据。更妙的是,联合训练意外地让流学习反过来提升 AR 精度,作者顺势把保留的 AR 头变成流草稿的验证器:同一模型内部完成起草—验证闭环,这是以往流模型和扩散模型都不具备的机制。
核心方法
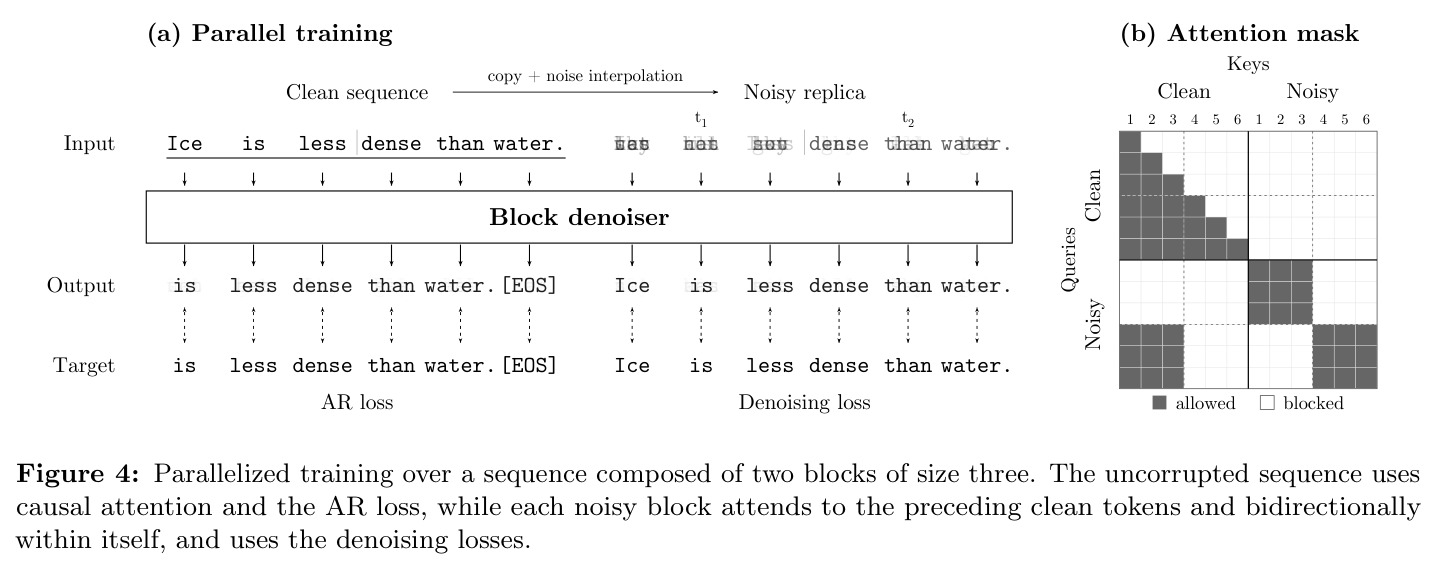
Lafa 的整体思路是'因果骨架 + 块内异步流'。先把生成按块分解 $p(y|c)=\prod_r p(y_{rB+1:(r+1)B}\mid c,y_{\le rB})$;每块的 $B$ 个 token 经嵌入矩阵 $E$ 映射为 $d$ 维向量(而非 $|V|$ 维 one-hot),由流匹配构造从噪声到数据嵌入的概率路径。与标准流匹配所有 token 共享时间 $t$ 不同,Lafa 给每个位置配可学习时间函数 $\tau:[0,1]\to[0,1]^B$,插值 $I_t^i=(1-\tau^i(t))x_0^i+\tau^i(t)x_1^i$ 让靠前位置进度更快。训练学的是块去噪器 $D_t(x;c)^i=p(y_i=\cdot\mid c,I_t=x)$,经恒等式 $b_t^i=\frac{\dot{\tau}^i(t)}{1-\tau^i(t)}(D_t^iE-x^i)$ 换算出 ODE 速度(式 5)。骨干从预训练 AR 模型初始化,加恒等初始化的 adaLN,块内注意力双向、前缀因果,损失为 AR 交叉熵、去噪交叉熵与嵌入平方误差之和(式 6)。
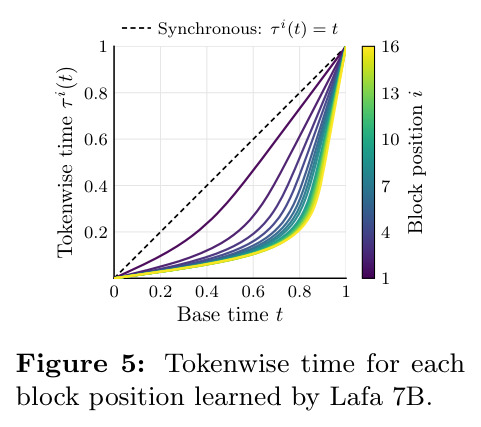
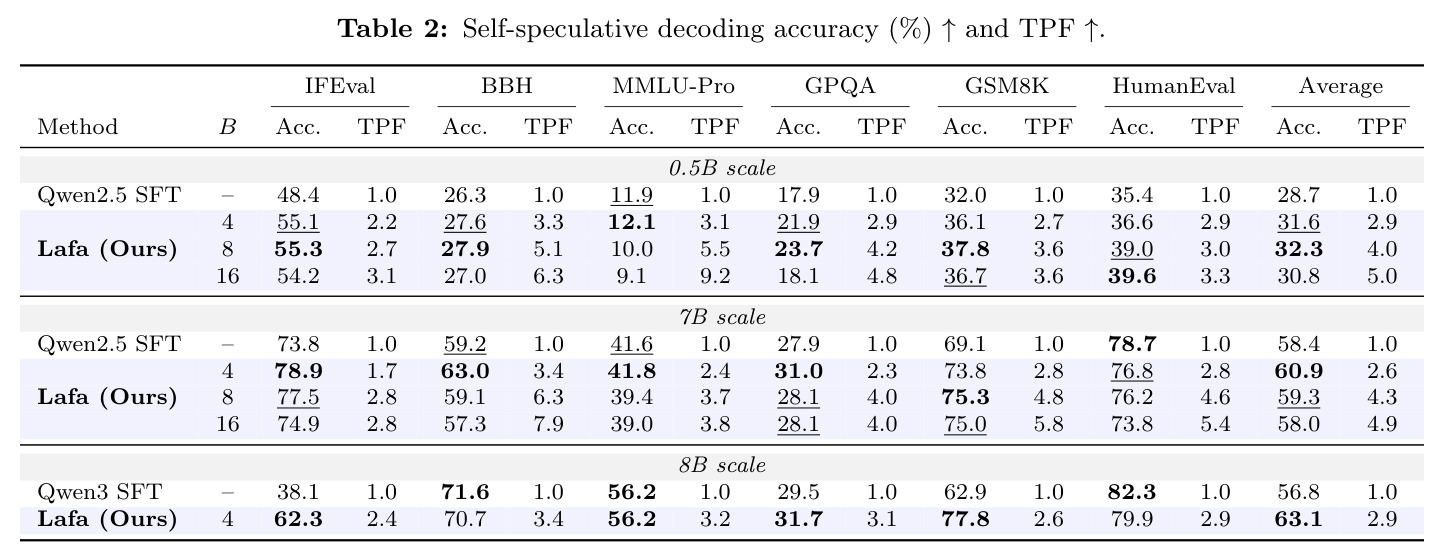
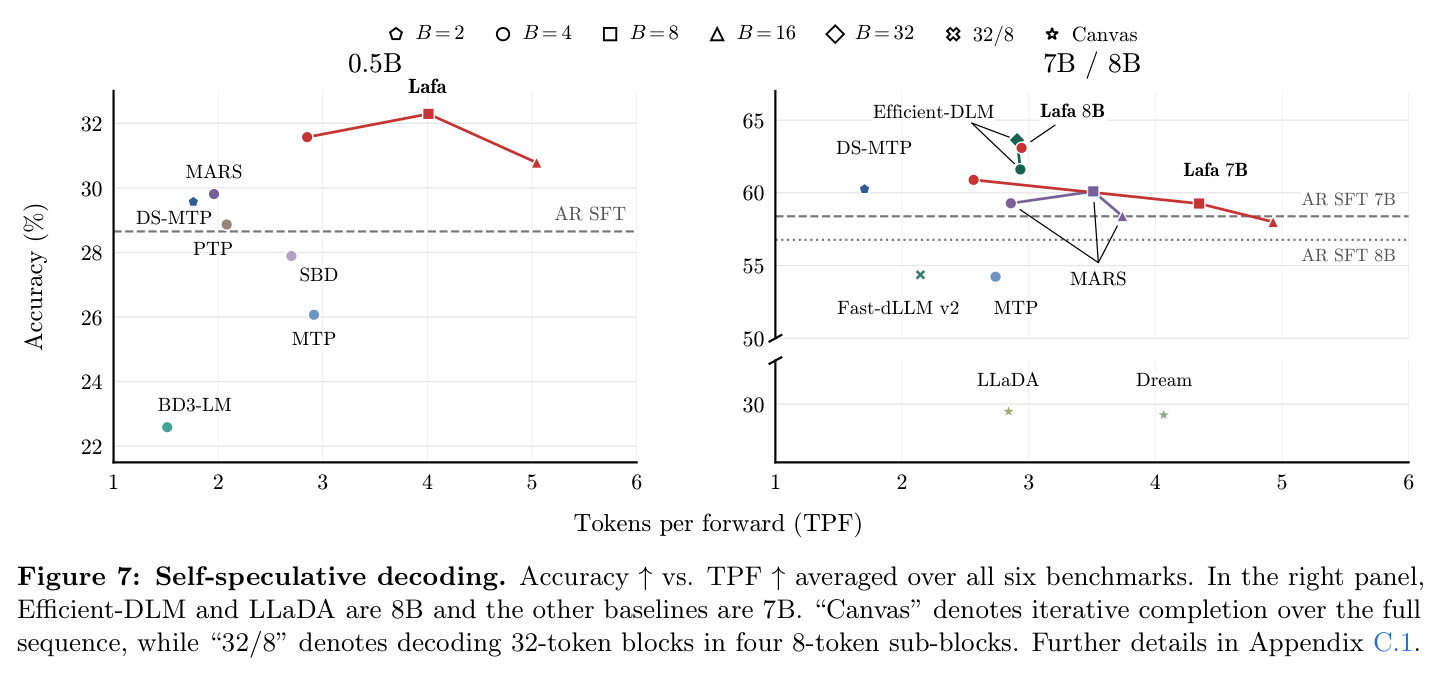
核心创新有三层。其一,异步流:tokenwise 时间 $\tau$ 从数据在线学习——把每个位置在各噪声水平上归一化去噪损失的逆 CDF 作为 $\tau^i$,让损失高的噪声水平分到更多训练样本与积分步;学出的调度自然满足 $\tau^i(t)>\tau^j(t)$($i<j$),不施加手工偏置就浮现从左到右倾向(图 5)。其二,一网两用:同一 transformer 在干净前缀上做 AR 预测、在噪声块上做去噪,流训练本身构成多token预测效应,不损害反而提升 AR 精度(7B 平均 60.9% vs AR SFT 58.4%)。其三,自投机解码:流分支单步去噪 $p^i=\hat{D}_0(\hat{x}_0;c)^i$ 起草整块,保留的 AR 头逐 token 贪心验证、提交最长一致前缀,输出严格等于 AR 贪心解码,却把每前向产出从 1 个 token 提升到约 2.5–5 个。这把'并行草稿 + AR 验证'的投机范式完整搬进了单个连续流模型。
方法步骤详情
训练与推理分六步。(1)架构改造:从 Qwen2.5 0.5B/7B Instruct 或 Qwen3 8B Base 初始化,加恒等初始化的 adaLN 注入 $\tau^i(t)$(前缀恒为 1);块内注意力双向、对前缀单向;嵌入与前缀共享并冻结范数只学方向。(2)训练:在 Dolci-Instruct-SFT 上训 5–15 epoch(9–27B token);每条干净序列配一份分块加噪副本,单次前向同时算 AR 损失与各噪声块的去噪损失(式 6、图 4)。(3)在线学时间:按位置用去噪损失逆 CDF 更新 $\tau$。(4)流解码:在 $t_k=k/K$ 网格做 $K$ 步 Euler 积分(式 8),每步自条件化,另加一次只算 $B$ 个块 token 的无前缀前向做 prefix guidance。(5)流图蒸馏:学生 $\hat{\delta}_{s,t}$ 从冻结教师初始化,半群式组合两次短跳为目标,KL 匹配(式 7、9),$K=1$ 即单步生成。(6)自投机:单步草稿与 AR 贪心比对,提交最长一致前缀;融合式设计单次前向内同时验证并生成下一草稿。
技术新颖性
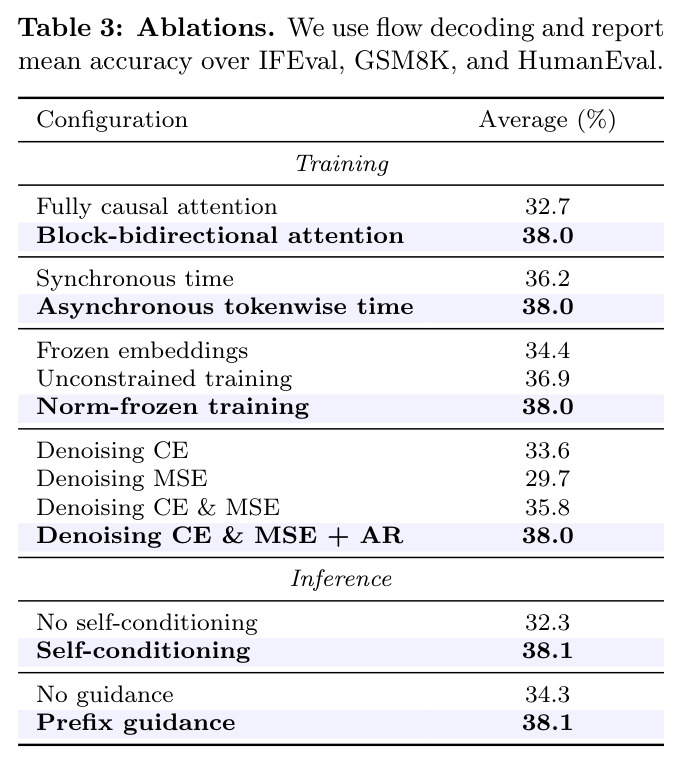
与已有工作的本质区别有四点。相对 MTP/DeepSeek-MTP:Lafa 的并行预测来自连续流的一次去噪,且与 AR 头共享参数、互相增益,而非外挂预测头。相对块离散扩散(BD3-LM、Block Diffusion):Lafa 在 $d$ 维嵌入空间而非 $|V|$ 维 one-hot/单形上运行,训练更省;噪声是高斯连续腐蚀而非离散掩码,天然支持流图蒸馏做一至数步生成——这是离散方法缺失的工具。相对早期连续扩散语言模型(CDCD、单形扩散):本文首次扩展到 8B 规模,提出嵌入空间上的两时间异步流图(式 7)、速度—去噪器换算恒等式(式 5)与范数冻结嵌入策略;消融(表 3)量化了各设计贡献:块内双向注意力 38.0 vs 全因果 32.7,异步时间 38.0 vs 同步 36.2,三损失联合 38.0 vs 单项 33.6/35.8/29.7,自条件化 38.1 vs 无 32.3。数据效率也是质变:不足 30B token 达到需要约 500B token 的离散扩散同档精度。
实验结果
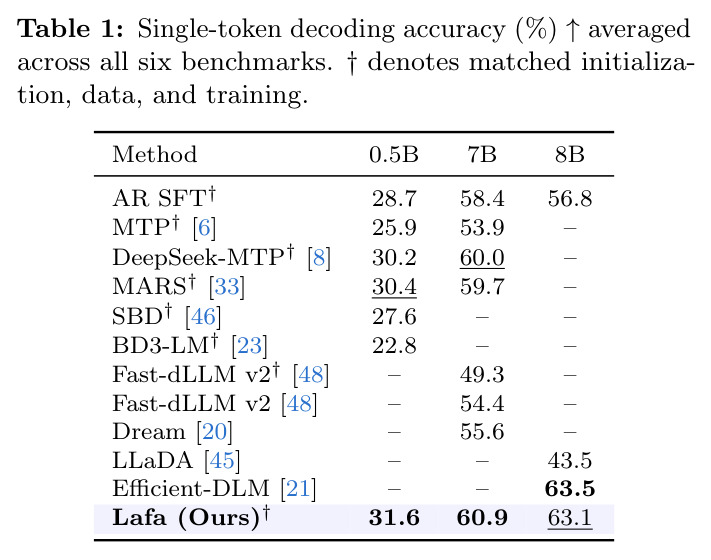
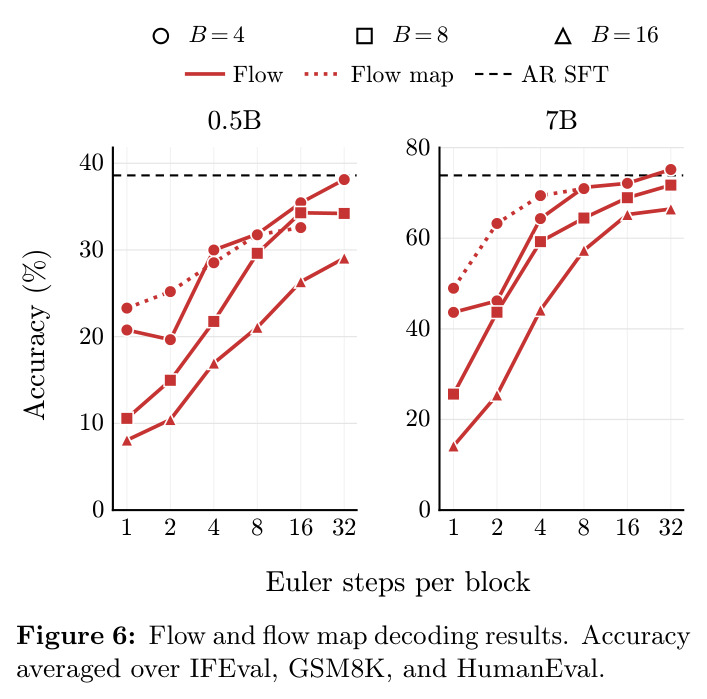
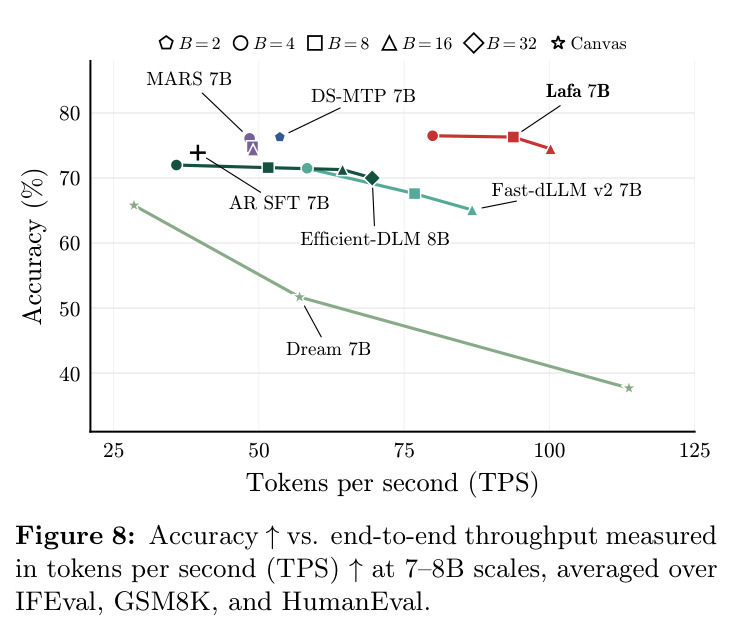
实验覆盖 0.5B/7B/8B、六个基准(IFEval、BBH、MMLU-Pro、GPQA、GSM8K、HumanEval)。单 token 解码(表 1):Lafa 平均 31.6%/60.9%/63.1%,均高于 AR SFT 的 28.7/58.4/56.8;7B 超 DS-MTP 60.0%、MARS 59.7%,8B 用 18 倍以上更少 token 逼近 Efficient-DLM 63.5%。流解码(图 6)精度随步数上升,7B $B=4$ 足够步数时超过 AR SFT;流图蒸馏在 7B 两步接近四步教师。自投机(表 2、图 7):0.5B $B=8$ 达 32.3%/4.0 TPF;7B $B=4$ 以 60.9%/2.6 双超 DS-MTP,$B=16$ 达 4.9 TPF、58.0% 仍接近 AR SFT;8B $B=4$ 达 63.1%/2.9。吞吐(图 8):7B $B=16$ 达 AR 的 2.54 倍且精度相当,$B=4$ 约 2 倍且更准;DS-MTP/MARS 至多 1.4 倍,扩散基线越快掉分越多。消融(表 3)确认每项设计贡献 1–6 个百分点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六基准平均·单token解码(0.5B) | 宏平均准确率 (%) | Lafa 31.6 | AR SFT 28.7;最强匹配基线 MARS 30.4、DeepSeek-MTP 30.2 | +2.9 个百分点,同时超过所有同预算训练的 MTP 与块并行基线 |
| 六基准平均·单token解码(7B) | 宏平均准确率 (%) | Lafa 60.9 | AR SFT 58.4;DeepSeek-MTP 60.0、Dream 55.6、Fast-dLLM v2 54.4 | +2.5 个百分点(vs AR SFT),训练 token 至少省 18 倍 |
| 六基准平均·单token解码(8B) | 宏平均准确率 (%) | Lafa 63.1 | Qwen3 SFT 56.8;LLaDA 43.5;Efficient-DLM 63.5 | +6.3 个百分点(vs AR SFT),与 Efficient-DLM 打平但数据省 18 倍以上 |
| 自投机解码精度与并行度(0.5B,B=8) | 平均准确率 (%) / 每前向 token 数 TPF | 32.3 / 4.0 | AR SFT 28.7 / 1.0;DeepSeek-MTP 30.2 / 约 2.0 TPF | 精度 +3.6pp、TPF 4 倍,并行度约为 DS-MTP 与 MARS 的两倍 |
| 端到端吞吐(7B,单卡 H100,batch 1) | 相对 AR SFT 的 tokens/sec 倍数 | B=16 达 2.54×;B=4 约 2× | AR SFT 1.0×;DeepSeek-MTP 与 MARS ≤1.4×;Dream/Fast-dLLM v2 更低且精度不足 | 吞吐 2.54 倍且六基准平均精度持平(58.0 vs 58.4) |
| 7B IFEval(自投机,B=4) | 严格准确率 (%) | 78.9 | AR SFT 73.8 | +5.1 个百分点;GSM8K 同由 69.1 升至 73.8 |
局限与改进
作者坦承的主要局限是流图蒸馏存在质量缺口:两步学生虽接近四步教师,但与充分积分步的流解码相比仍有差距,原因是自条件化与 prefix guidance 尚未并入蒸馏目标。我的补充观察:其一,流解码在少步数下精度明显下降,块越大精度越低(图 6),质量依赖迭代步数,快而不掉点的区间有限;其二,每种块大小需要单独训练的检查点(表 2 中 $B=4/8/16$ 各用对应模型),部署时无法灵活切换并行度;其三,置信度阈值解码的精度—速度权衡劣于 AR 验证,作者只放在附录 C.3;其四,prefix guidance 每步多一次前向,虽只算 $B$ 个块 token,在极短生成中开销占比不小;其五,评测生成长度上限 1024 token,吞吐结论对长文写作场景的外推存疑;其六,墙钟吞吐仅在单卡 H100、batch 1 测得,未覆盖大 batch 服务场景。
独立分析的弱点
独立来看有几个弱点。第一,块大小与训练耦合:每个 $B$ 一套权重,部署者必须在速度上限与质量间预先抉择;改进方向是训练支持可变块边界的单一模型,或在 $\tau$ 调度上做连续插值。第二,自投机输出严格等于贪心 AR 解码,无法借流的多样性提升采样质量,质量上限被 AR 贪心封顶;可探索放宽验证以支持温度采样或核采样下的投机。第三,蒸馏学生的缺口集中在中低步数区间,提示半群目标可能约束过强,可尝试分布匹配蒸馏或引入教师轨迹分布。第四,适配实验全部基于 Qwen 家族,对 Llama、Mistral 等架构及不同分词器的可迁移性未验证;嵌入范数冻结依赖预训练嵌入尺度合理,换初始化未必成立。第五,$\tau$ 的从左到右偏置是经验观察(图 5),缺乏理论保证,遇到后文关键、前文模糊的任务(如代码填空、文档修订)可能次优。第六,六个基准偏短程任务,长上下文与 agentic 任务缺席,多块串行时的误差累积未单独量化。
未来方向
作者明确提出的方向是把自条件化与 prefix guidance 融入流图蒸馏,缩小学生与多步教师的差距。由此可延伸:其一,若一致性式单步生成逼近多步质量,连续流路线将在延迟上全面超越离散扩散,值得投入分布匹配等更现代的蒸馏技术。其二,自投机框架天然可扩展到树形草稿或多次草稿重排,类似 SpecInfer 的思路在单模型内即可实现。其三,损失感知的时间扭曲可推广到块间调度,实现'难点多步、易点少步'的自适应算力分配。其四,流训练提升 AR 精度的多token预测效应值得单独刻画,或成为与 MTP 头正交的通用 SFT 增强手段。其五,prefix guidance 与可控生成技术(格式、情感、长度约束)结合,可发挥连续空间的优势。其六,在预训练混合数据(而非仅 SFT)上验证数据效率,并推进到 30B+ 规模,将回答连续流能否直接作为预训练目标。
复现评估
复现条件较好。代码开源于 github.com/lafa-gh/large-flow-lms,0.5B/7B/8B 权重发布于 huggingface.co/lafa-hf/models;训练数据 Dolci-Instruct-SFT 公开,仅需 9–27B token,适配 7–8B 模型的算力远低于从头训练(论文未给 GPU 时数,估计数十张 H100 数天量级);评测统一用 lm-evaluation-harness 标准协议。附录 A 给出速度换算恒等式与流图目标的推导,附录 B 提供并行训练、自条件化、融合草稿验证的算法细节,附录 C 有逐基准分数与推理协议,信息相当完整。整体难度中等偏上:需要熟悉流匹配与分布式训练;另外 DS-MTP、MARS、SBD、BD3-LM、Fast-dLLM v2 等标 † 基线为作者按同预算复训,与 Dream、LLaDA、Efficient-DLM 官方权重的可比性差异已在文中注明,复现对比时需区分。
论文图表
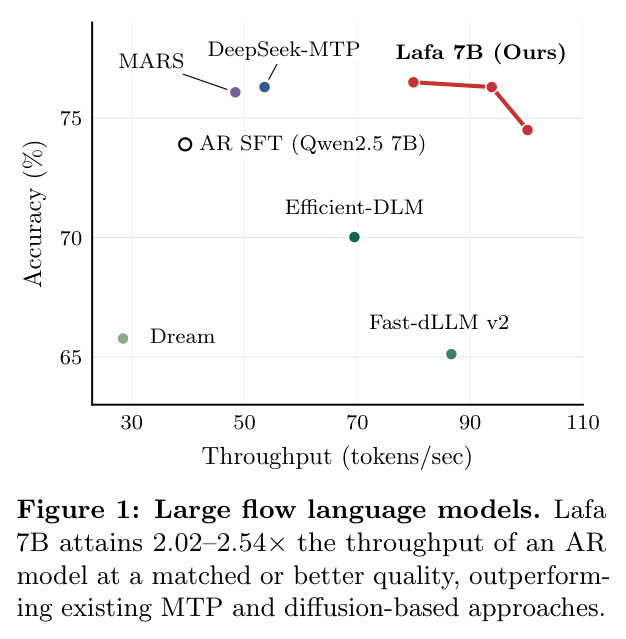
以吞吐量(tokens/sec)为横轴、六基准平均精度为纵轴的散点图,对比 MARS、DeepSeek-MTP、AR SFT (Qwen2.5 7B)、Efficient-DLM、Fast-dLLM v2、Dream 与 Lafa 7B。Lafa 位于右上方的质量—速度前沿:2.02–2.54 倍于 AR 的吞吐,精度持平或更高,明显优于 MTP 与扩散方法。
这是全文的'一图看懂':一眼看出本文主张——连续流可以在不牺牲质量的前提下大幅加速生成,且优势相对所有既有并行解码范式成立。