面向长上下文高效解码的联合子空间稀疏注意力 Joint Subspace Sparse Attention for Efficient Long-Context Decoding
训练无关的联合查询-键子空间打分加免聚集逐头注意力,逼近全KV精度并最高提速6.43倍
前置知识
KV 缓存与解码带宽瓶颈
自回归解码时,Transformer 把每个已生成 token 的键(K)和值(V)缓存下来,避免每步重算。解码每生成一个 token,都要用当前 query 与全部上下文的 K 做点积打分,再读取对应 V 加权求和;随上下文增长,KV 缓存读取量线性增加,而计算量相对很小,因此长上下文解码是典型的访存受限(memory-bandwidth-bound)负载,速度主要取决于显存带宽而非算力。
JSSA 的全部设计都围绕减少 KV 缓存读取展开:token 级稀疏注意力只读取被选中的 $B$ 个位置的 K/V,论文的吞吐收益(最高 6.43×)直接来自访存量下降,理解这一瓶颈才能理解方法为何有效。
GQA(分组查询注意力)
GQA 让多个 query 头共享同一个 KV 头以减小 KV 缓存体积,例如 LLaMA-3.1-8B 有 32 个 query 头但只有 8 个 KV 头,每 4 个 query 头绑定 1 个 KV 头。推理时 KV 缓存按 KV 头分区存储,这是 vLLM 等推理框架的标准布局。
JSSA 的选择粒度是每个 KV 头一个 token 集合(用其绑定 query 头的均值查询打分),其核心系统贡献——免聚集(gather-free)索引注意力内核——正是为了在标准 GQA 缓存布局下直接消费互不相同的逐头索引,理解 GQA 才能理解这一贡献的难度与价值。
MLA(多头潜在注意力)
MLA(DeepSeek 提出)把每个 token 的 KV 压缩成所有头共享的低维潜在向量(latent),外加一路 RoPE 位置分量,因此 token 选择只产生一个层级的索引集合而非逐头索引。DeepSeek 的原生稀疏注意力 DSA 就建立在 MLA 之上,使用 128 维打分表示(64 维 latent + 64 维 RoPE)。
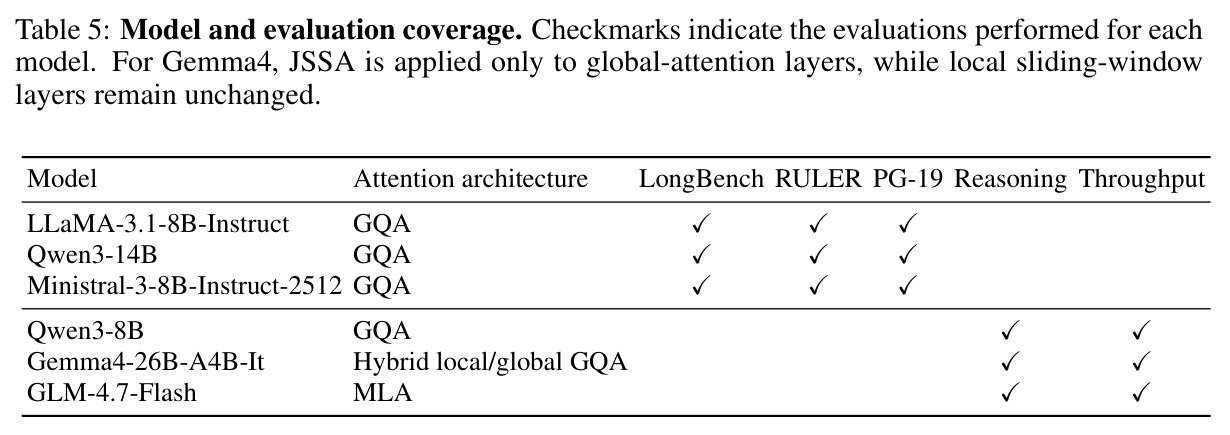
论文在 GQA、混合局部/全局注意力、MLA 三类架构上验证 JSSA;MLA 情形下 JSSA 复用 FlashMLA 稀疏内核,并与 700B 级 DeepSeek/GLM 的原生 DSA 直接对比,这是论文最有说服力的大规模实验。
低秩投影与谱方法(特征分解)
低秩投影用一个 $r\times d$ 正交矩阵 $M$($MM^\top=I_r$)把 $d$ 维向量压缩到 $r$ 维子空间,投影矩阵 $P=M^\top M$ 对称且幂等。正交约束下的优化一般没有闭式解,但若目标可写成迹形式 $\mathrm{tr}((I-P)A)$,其最优解恰是 $A$ 的前 $r$ 个最大特征向量(Rayleigh 商与谱定理的结论),一次特征分解即可求得。
JSSA 的核心数学就是把双线性打分误差这一非凸目标放松为可分离的边际上界 $\mathcal{L}_{marg}(P)=\mathrm{tr}((I-P)(\hat G_Q+\hat G_K))$,从而得到闭式谱解;不懂谱方法就无法理解校准为何只需几分钟。
token 级稀疏注意力
与按页/块选择的方法(QUEST、SeerAttention-R)不同,token 级方法每步为每个候选位置单独打分,选 top-$B$ 个位置参与注意力,可以表达任意细粒度的稀疏模式。代表工作有 Loki(在键重构低秩子空间中打分)、FASA(选取原始 RoPE 通道打分)、SparQ 等。
JSSA 属于 token 级阵营,论文的两大动机(低维打分目标错配、聚集开销)都是 token 级方法特有的问题,对比实验也主要在 token 级方法间展开,理解这一范式才能把握论文的定位。
研究动机
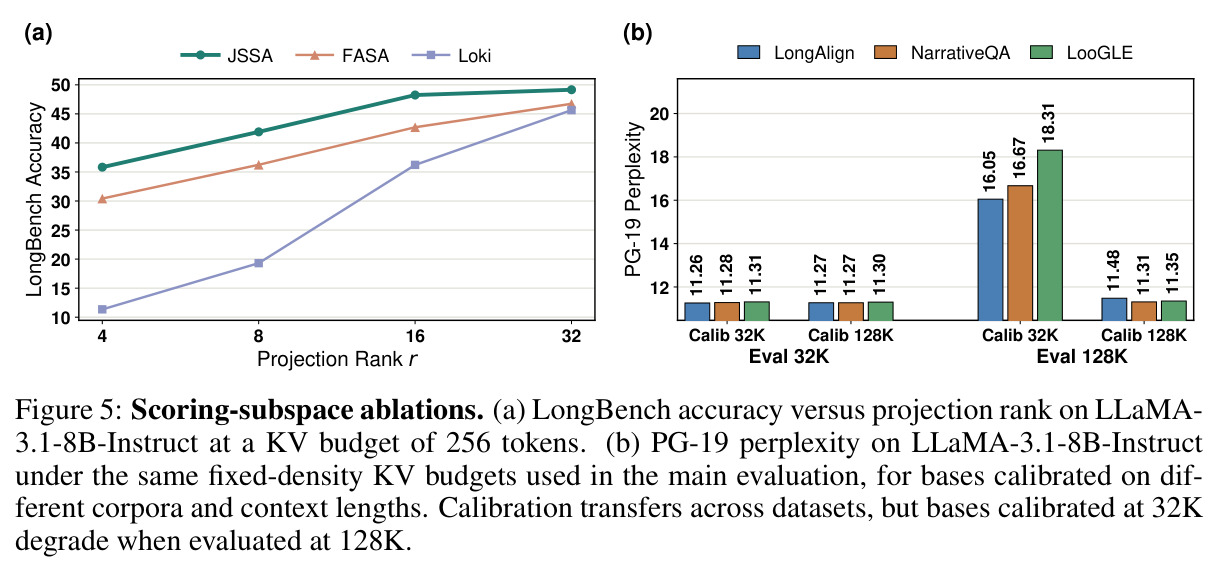
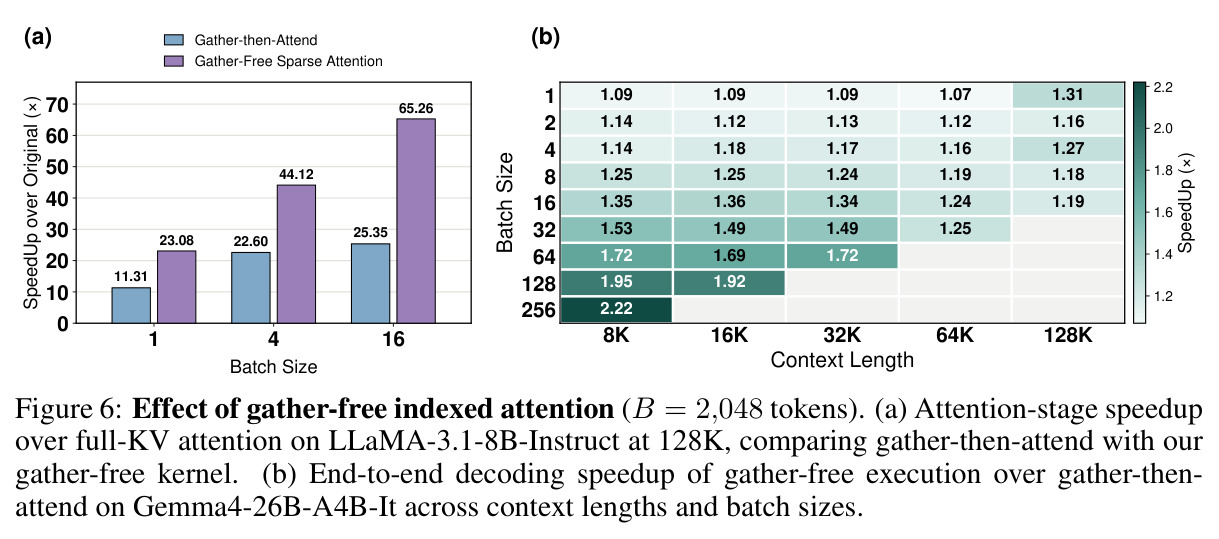
长上下文自回归解码的瓶颈在于每一步都要反复访问不断增长的 KV 缓存:全注意力下每个解码步要用当前 query 给整个上下文打分并读取所有对应 value,访存量随序列长度线性增长;由于此场景下注意力是访存带宽受限的,减少 KV 访问是最直接的加速手段。稀疏注意力由此而生,但现有 token 级方法(如 Loki、FASA)虽能表达更细的稀疏模式,却面临两个现实问题。其一,低维打分可能丢掉排序所需的 query-key 结构:Loki 只用键重构目标选子空间,FASA 只挑原始 RoPE 通道,二者都不直接保真注意力分数本身。论文 Figure 2(a) 显示,在 LLaMA-3.1-8B 上 FASA 在所有投影秩上都优于 Loki,$r=4$ 时二者 LongBench 准确率分别为 30.43 与 11.35,紧预算下差距尤其大。其二,token 级选择产生不规则索引集合,在 GQA 下每个 KV 头的索引互不相同,常规做法是先把选中的 KV 条目 gather 成连续缓冲再调用稠密注意力内核。Figure 2(b) 显示,在 128K 上下文、batch 16 时,gather 开销与稀疏注意力本身的计算耗时相当,占剩余延迟一半以上,把稀疏化省下的时间又吃了回去。
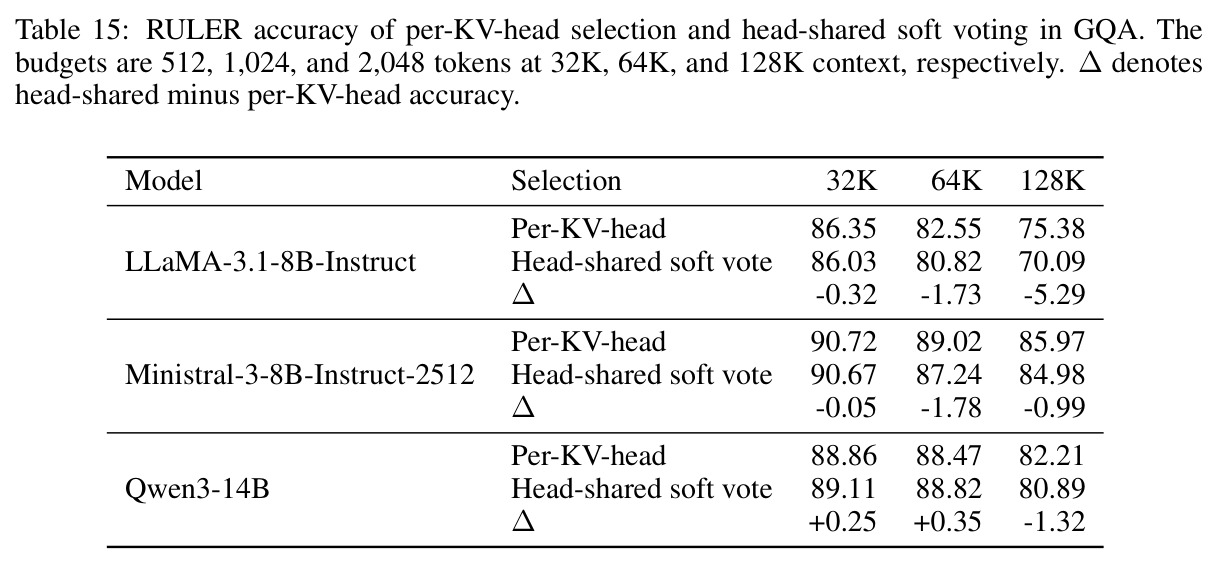
本文的目标是论文的目标是构建一个免训练(training-free)的 token 级稀疏注意力方法,同时解决上述两个挑战。在选择质量上,希望低维打分子空间不是近似查询或键的表示,而是直接保持决定 token 排序的双线性分数 $\hat{s}=\bar{q}^\top Pk$,使得用 $r$ 维(例如 32 维)打分选出的 top-$B$ 集合尽可能接近全维分数给出的 oracle 集合。在执行效率上,希望注意力内核能直接从标准 GQA KV 缓存布局中按不规则逐头索引就地读取选中的 K/V,免除物理 gather 与额外缓冲,同时保留每个 KV 头各自的选择集合——因为论文发现把所有头折叠成单一集合会在长上下文明显掉点,128K 时 RULER 最多差 5.29 分。最终目标是在 GQA、混合局部/全局注意力与 MLA 三类架构上都逼近全 KV 精度,并在真实吞吐上兑现稀疏化的理论收益,量化标杆是:128K 上下文下相对全 KV 最高 6.43× 解码吞吐,以及在 700B 级模型上免训练追平原生 DSA 的推理精度并达到其 96-99% 的吞吐。
与已有工作不同的是,已有工作的切入角度各有局限,JSSA 找到了一个此前未被同时占据的位置。在打分子空间方面,EigenAttention、KVTC、SWAN 等用低维变换压缩最终注意力所消费的 KV 表示;KQ-SVD 虽以注意力分数保真为目标,但采用查询/键各自独立的非对称分解且面向缓存压缩;Loki 只优化键重构;FASA 的离散通道选择等价于只在标准基向量里挑(正交投影的受限特例)。没有人把保持查询-键双线性打分误差作为 token 选择子空间的目标并给出闭式解。在执行方面,现有高效注意力内核要么面向规则块稀疏(QUEST、SeerAttention-R、NSA、MSA),要么面向 MLA 的共享潜在缓存(FlashMLA 稀疏内核),都不支持在标准 GQA 布局下对每个 KV 头不同的 token 集合做免 gather 的索引注意力。JSSA 独特地保留完整 KV 缓存、只用一个 FP8 小型投影缓存(约原缓存的 6.25%)做打分,把选得准与读得快当成两个可分离又必须同时解决的子问题,并用 700B 级事后校准对比训练时原生稀疏的实验,回应了稀疏注意力必须从预训练学起的流行假设。
核心方法
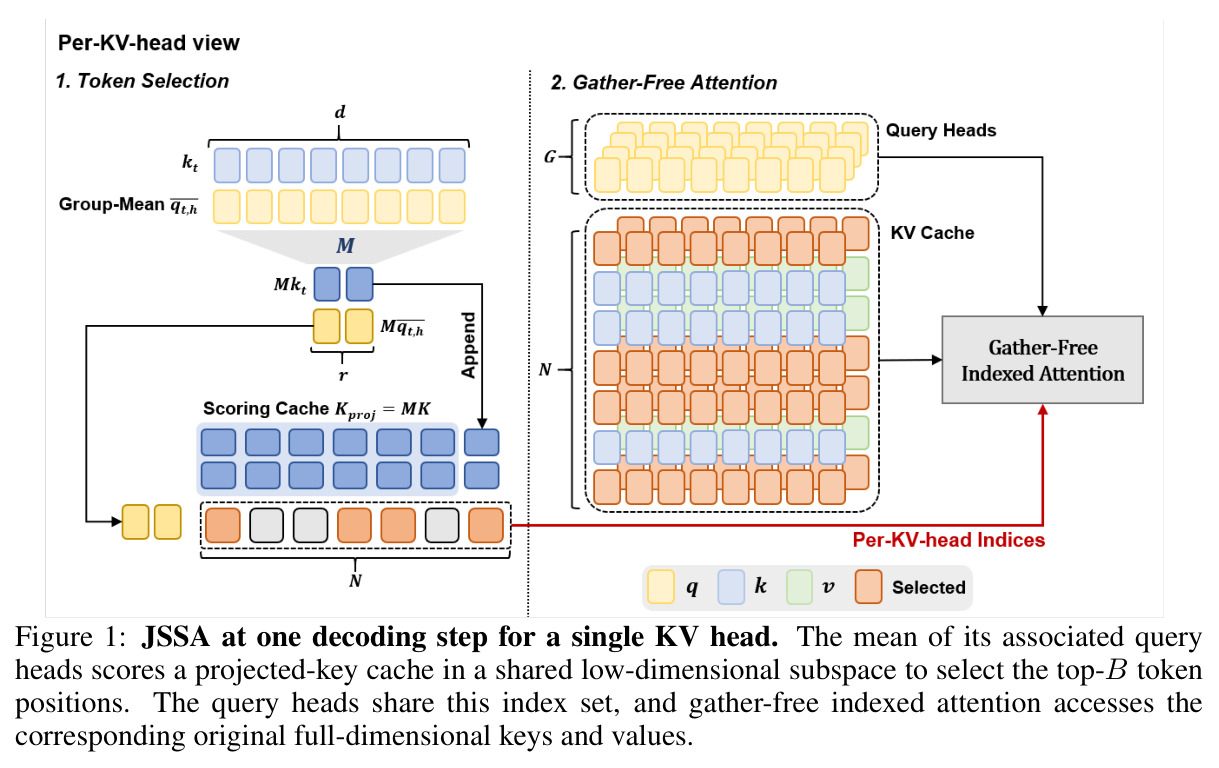
JSSA 的直觉很朴素:token 选择只需要排序对,不需要数值准,因此可以用一个极小的共享子空间来打分,而真正的注意力仍用原始全维 K/V 完成。整体流程分两块。选择侧:对每一层、每个 KV 头,校准阶段离线求出一组 $r\times d$ 正交基 $M$($MM^\top=I_r$),推理时维护投影键缓存 $K_{proj}=KM^\top$(FP8 存储,GQA 下不超过原 BF16 KV 缓存的 6.25%);每个解码步,把与该 KV 头绑定的 $G$ 个 query 头取平均得到组均值查询 $\bar{q}_{t,h}$,在 $r$ 维子空间中给全部 $N$ 个候选位置打分 $\hat{s}=\bar{q}^\top Pk$($P=M^\top M$),取 top-$B$。执行侧:GQA 用作者自研的 Triton 免聚集索引注意力内核,每层只启动一次,内部把每个 query 头映射到其所属 KV 头选出的索引,直接按索引就地读取全维 K/V 计算注意力;MLA 则复用 FlashMLA 的稀疏内核,对共享潜在缓存做单一索引集合的选择。最终注意力的数值完全来自原始 BF16 的 K/V,投影只服务打分,因此精度损失只来自选错 token 这一种来源。
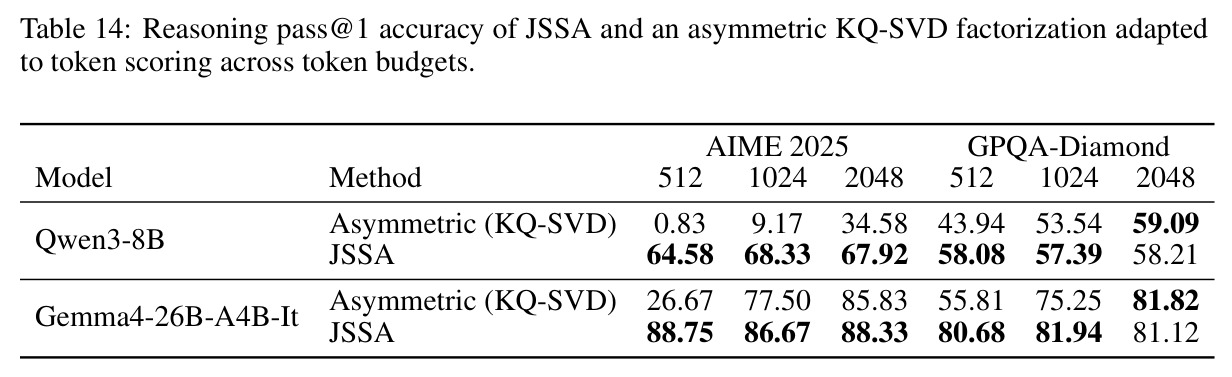
核心创新是联合查询-键子空间这一目标函数。打分误差为 $s-\hat{s}=\bar{q}^\top(I-P)k$,JSSA 直接最小化它的期望平方:校准的组均值查询与键的二阶矩经独立单位迹归一化后记为 $\hat{G}_Q,\hat{G}_K$,精确目标为 $\mathcal{L}_{sel}(P)=\mathrm{tr}\big((I-P)\hat{G}_Q(I-P)\hat{G}_K\big)$。该目标非凸且无一般闭式解,但论文用 Cauchy-Schwarz 不等式与 AM-GM 不等式推出上界 $\mathcal{L}_{sel}(P)\le\tfrac{1}{4}\mathcal{L}_{marg}(P)^2$,其中边际目标 $\mathcal{L}_{marg}(P)=\mathrm{tr}\big((I-P)(\hat{G}_Q+\hat{G}_K)\big)$ 有闭式谱解 $M^\star=\mathrm{TopEig}_r(\hat{G}_Q+\hat{G}_K)$。与已有方法的本质区别有三:Loki 的键重构只约束 $\hat{G}_K$,丢掉了查询侧分布;FASA 的通道选择是正交投影的受限特例;KQ-SVD 的非对称分解允许查询和键用不同基,实验表明它在激进稀疏下严重过拟合校准相关性(512 token 预算下 AIME 2025 仅 0.83%,JSSA 为 64.58%),而共享正交子空间自带正则化。同等重要的创新是免聚集执行:首个在标准 GQA 缓存布局下支持逐 KV 头不同选择集合的索引注意力内核,避免了 staging buffer 和逐头多次启动内核的开销。
方法步骤详情
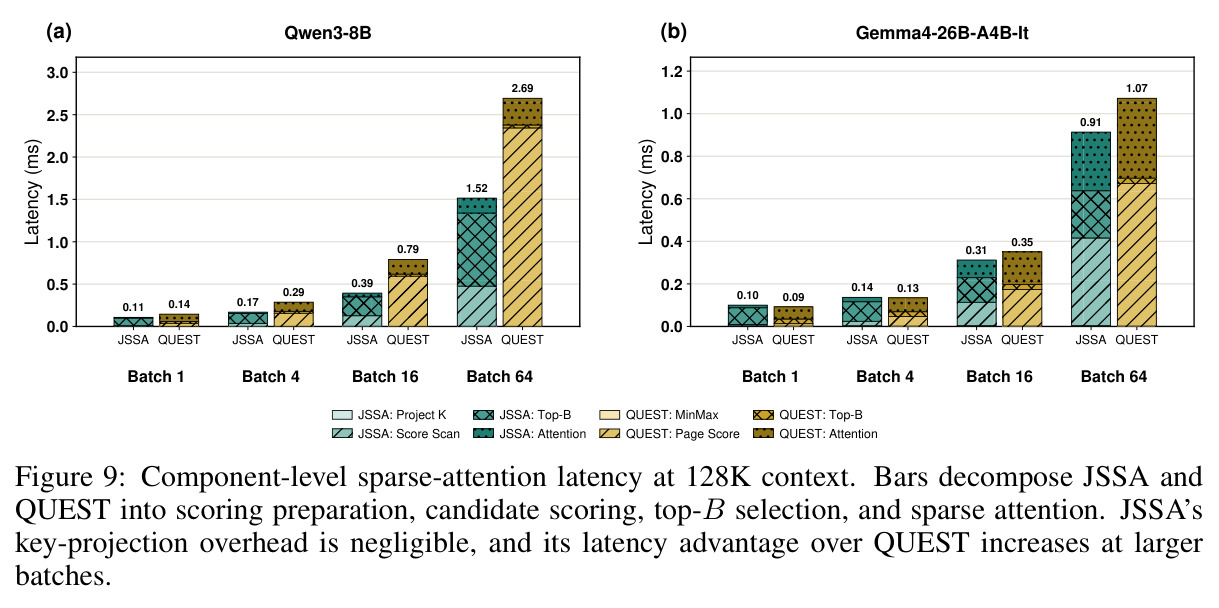
完整流程五步。第一步校准(离线一次性):从 LongAlign 语料过滤出至少 8K token 的文档,按顺序拼接至 150K 以上再中心裁剪为 131,072 token,构造 8 条校准序列;对每条序列做一次稠密 prefill,逐层逐 KV 头累积组均值查询与键的二阶矩,独立单位迹归一化后做一次特征分解得到每层每头的 $M^\star$;全流程在单张 B200 上耗时 129-365 秒,无任何梯度训练。第二步建投影缓存:计算 $K_{proj}=KM^\top$ 并以 FP8 存储,GQA 模型取 $r=32$(Gemma4 全局层 $r=64$),占用不超过原缓存的 6.25%;MLA 用 64 维 latent 加 64 维 RoPE 共 128 维打分表示,与 DSA 索引器等容量。第三步每步打分:新生成的 key 立即投影入缓存(开销占流水线延迟不足 3.2%),组均值查询对 $N$ 个候选做全量分数扫描取 top-$B$,GQA 下每个 KV 头得到各自的索引集合。第四步免聚集注意力:Triton 内核每层启动一次,把每个 query 头映射到所属 KV 头的索引,直接在原 BF16 缓存中按索引读取 K/V 计算注意力;MLA 调用 FlashMLA 稀疏内核。第五步精度与开销控制:FP8 打分缓存相对 BF16 的 LongBench 差异不超过 0.18 分;所有稀疏层统一 token 预算,不设 sink token 或最近窗口等特殊处理。
技术新颖性
技术新颖性体现在三个层面。理论层面:把 token 排序保真形式化为双线性打分误差的期望,这是首个以分数保持(score-preservation)为目标的 token 选择子空间构造;通过乘积分布假设、Cauchy-Schwarz 与 AM-GM 得到边际上界,把非凸问题化为一次特征分解。附录用 1600 步 Stiefel 流形梯度下降证明,从谱解出发继续优化精确目标最多降低 1.60% 的目标值、oracle 召回变化不超过 0.02 个百分点,闭式解即足够本身就是一个有价值的实证发现。系统层面:据作者所知,这是首个支持 GQA 下逐 KV 头不同选择且免 gather 的 token 级索引注意力内核;关键洞察是单个 token 的 K/V 切片在 head 维上本就连续,不规则索引只是增加事务数量而不劣化单次事务,因此可绕过物理聚集直接就地访问。实验层面:在 DeepSeek-V3.1-Terminus 上事后套用 JSSA,能与经继续预训练引入原生 DSA 的 DeepSeek-V3.2-Exp 打平推理精度(AIME 2025 双方 87.50)并达到其 96.1-99.2% 吞吐,说明低维索引器未必需要训练,这对理解模型原生稀疏注意力是重要证据。消融还显示逐头选择在 128K 比层共享软投票高 5.29 分,验证了内核设计的必要性。
实验结果
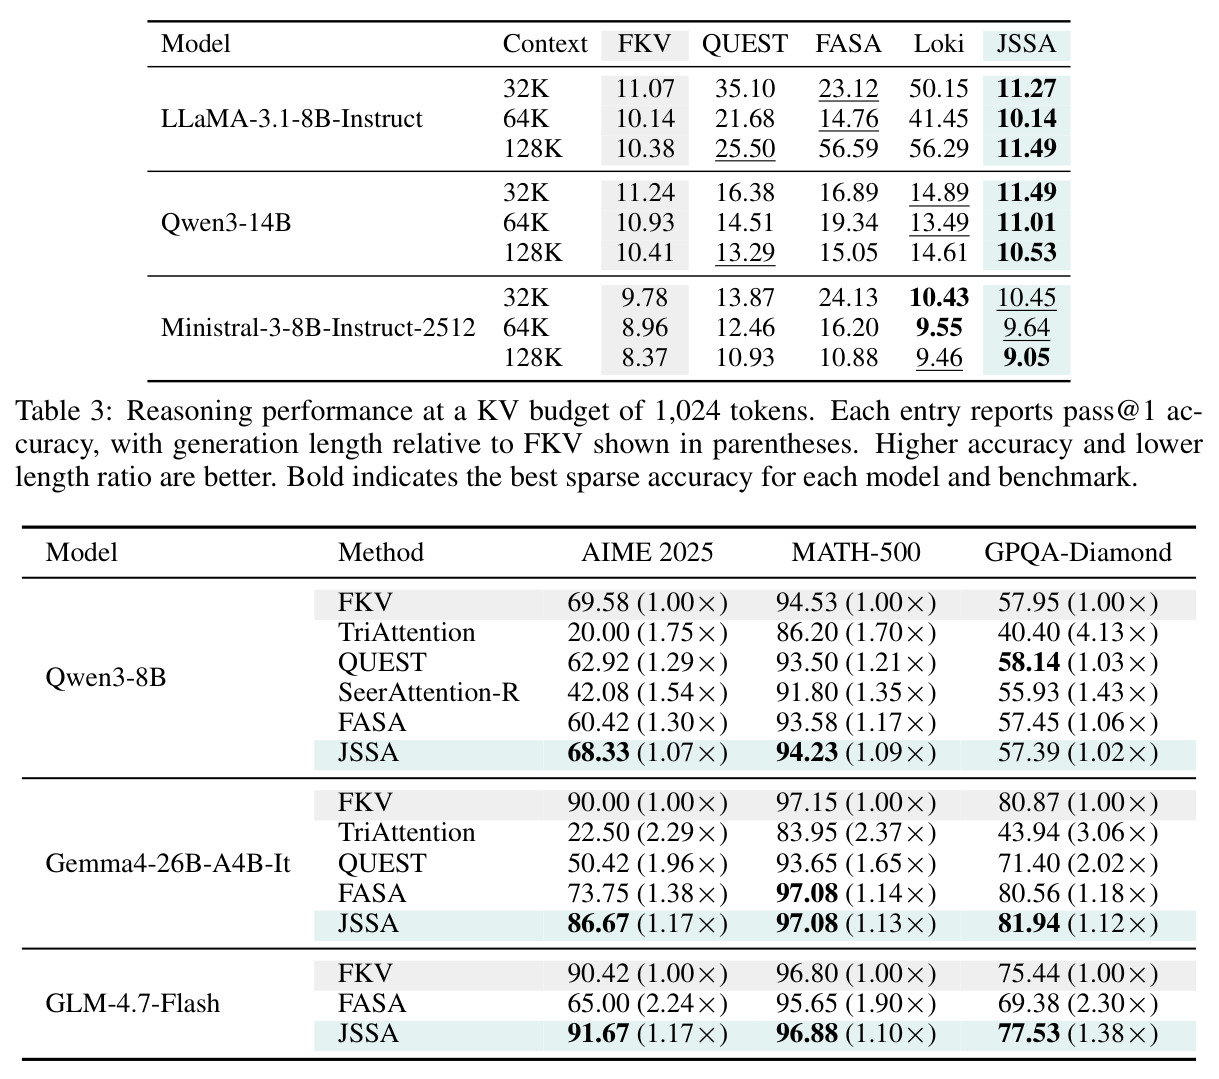
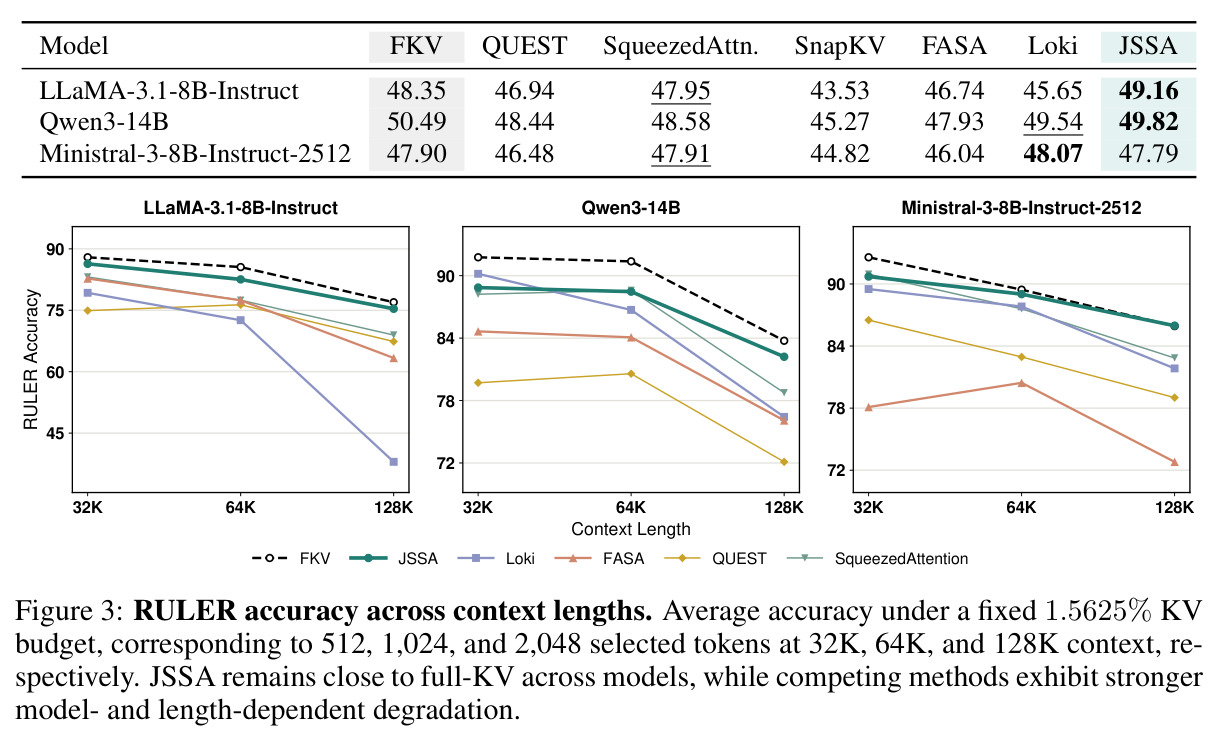
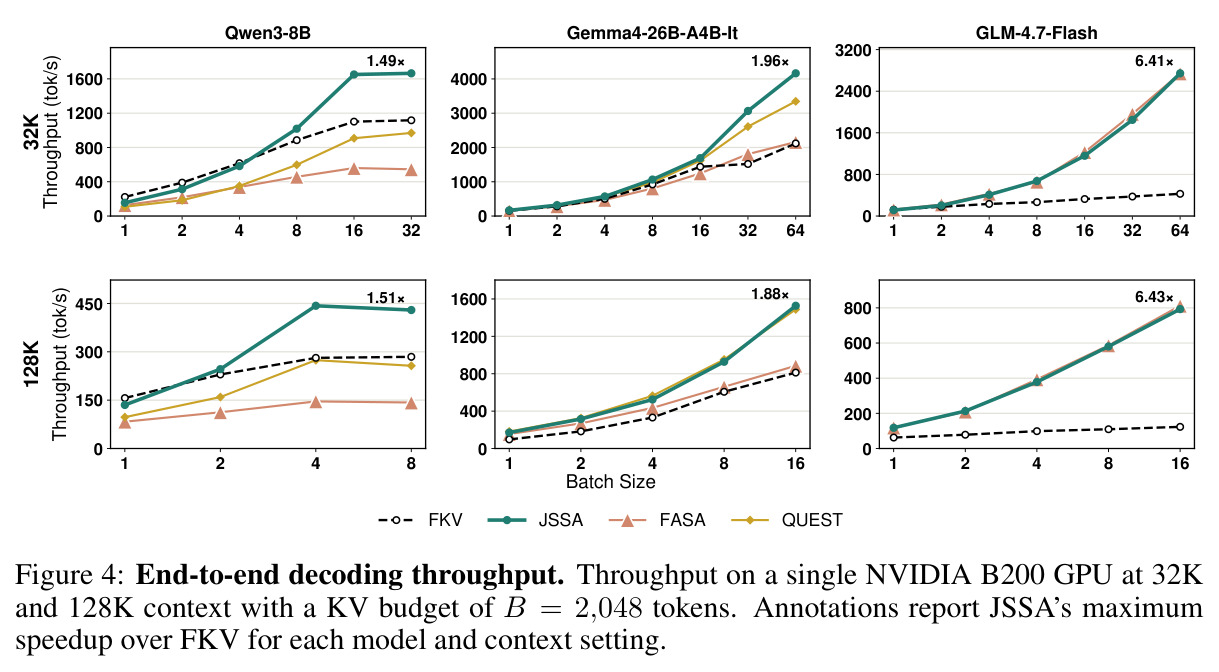
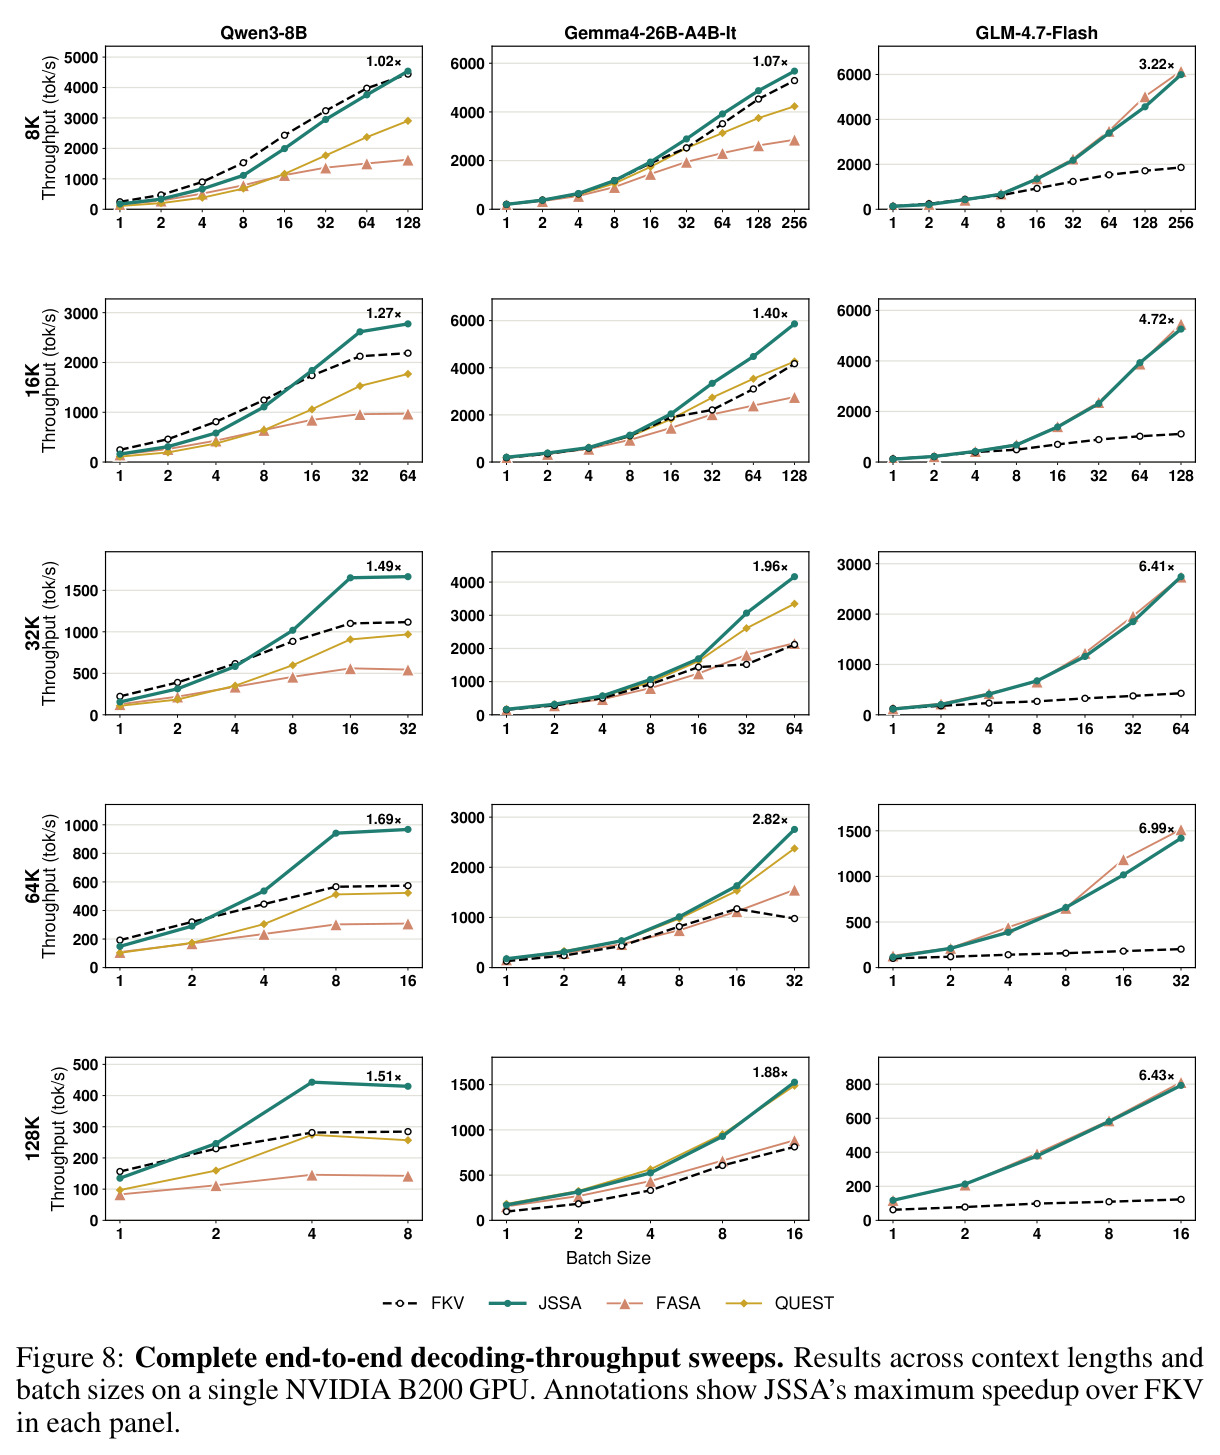
长上下文理解:LongBench 上 256 token 预算,JSSA 在三个模型取得 49.16/49.82/47.79(LLaMA-3.1-8B、Qwen3-14B、Ministral-3-8B),距全 KV(48.35/50.49/47.90)不超过 0.67 分,且是唯一在 LLaMA 上超过全 KV 的稀疏方法。RULER 在 1.5625% 固定预算下,128K 时 JSSA 于 LLaMA 得 75.38(FKV 76.97,FASA 63.36,Loki 崩溃至 37.98),Qwen3-14B 得 82.21(FKV 83.75),Ministral 得 85.97 与 FKV 的 85.93 持平。语言建模:PG-19 困惑度与 FKV 最大差距仅 1.11,而 FASA 在 LLaMA 128K 飙到 56.59、Loki 56.29。推理:1024 token 预算下 Qwen3-8B 的 AIME 2025 为 68.33(FKV 69.58,FASA 60.42,TriAttention 仅 20.00),生成长度膨胀仅 1.07×;Gemma4-26B AIME 86.67(FKV 90.00,FASA 73.75,差距 12.92 分);GLM-4.7-Flash 三项基准全部追平或超过 FKV(AIME 91.67 对 90.42)。吞吐:单张 B200、128K 上下文下相对全 KV 分别提速 1.51×、1.88×、6.43×(Qwen3-8B、Gemma4、GLM-4.7-Flash),完整扫描最高 6.99×。大规模验证:700B 级 DeepSeek 上免训练 JSSA 达到原生 DSA 的 96.1-99.2% 吞吐、128K batch 8 时 3.49× 于 FKV,AIME 2025 双方同为 87.50;GLM-5.2 上 AIME 83.33 对 82.50、GPQA 完全相同 90.91。机制证据:oracle top-$B$ 召回 71.34%,远超 Loki 35.97% 与 FASA 48.90%(LLaMA,$B$=256,$r$=32)。
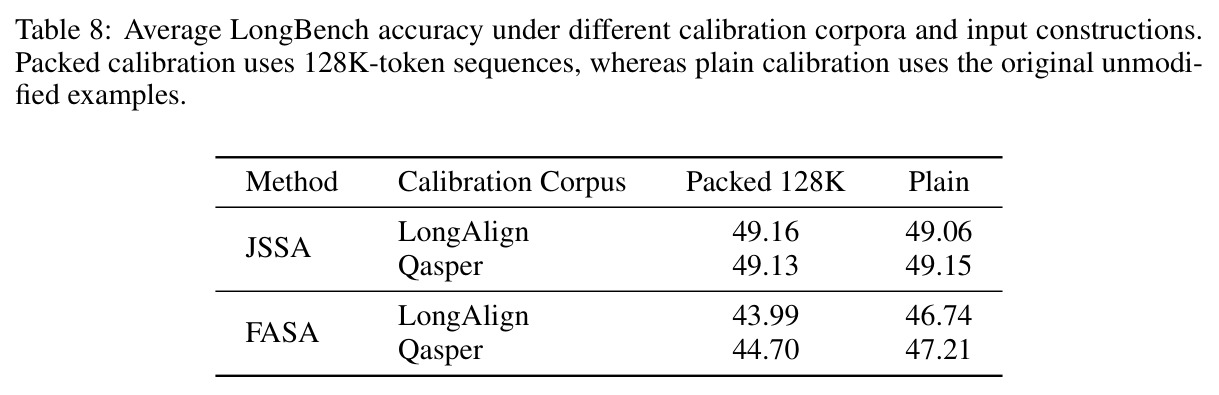
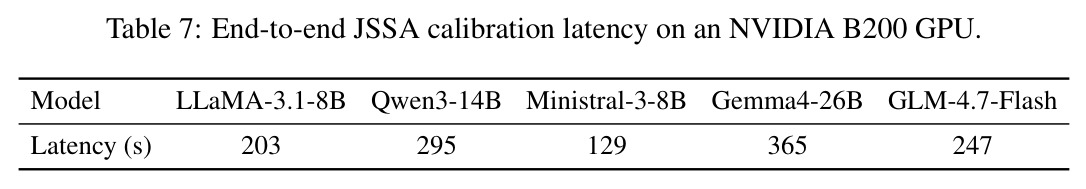
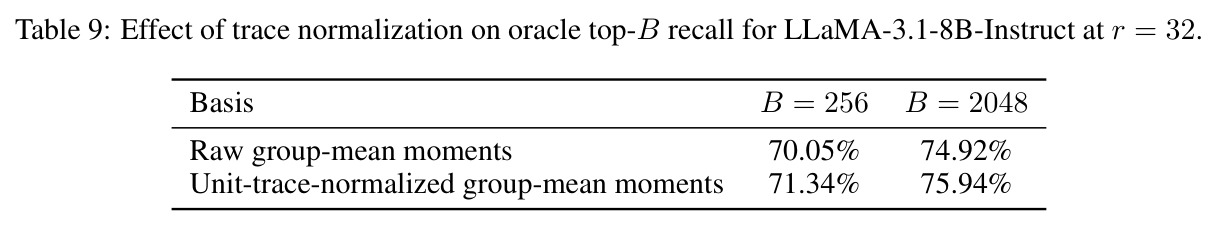
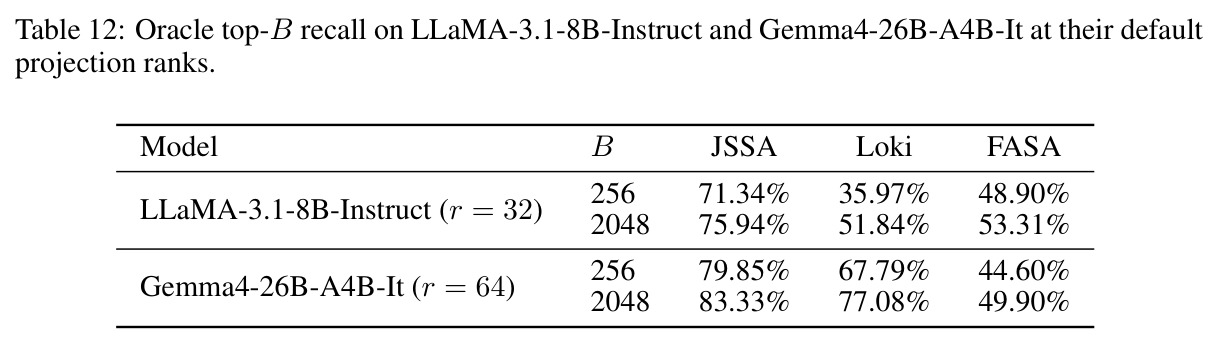
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LongBench 长上下文理解(KV 预算 256,LLaMA-3.1-8B-Instruct) | 16 项任务平均准确率 (%) | 49.16(超过全 KV) | FKV 48.35;SqueezedAttn. 47.95;QUEST 46.94;Loki 45.65 | 较全 KV +0.81,较最强稀疏基线 +1.21 |
| RULER 128K 上下文(1.5625% KV 预算,LLaMA-3.1-8B) | 13 项任务平均准确率 (%) | 75.38 | FKV 76.97;FASA 63.36;QUEST 67.38;Loki 37.98 | 距全 KV 仅 -1.59,较最佳稀疏基线 FASA +12.02 |
| PG-19 语言建模(128K 上下文,LLaMA-3.1-8B) | 困惑度(越低越好) | 11.49 | FKV 10.38;QUEST 25.50;FASA 56.59;Loki 56.29 | 与全 KV 差距仅 1.11,基线最大劣化达 46.21 |
| AIME 2025 数学推理(KV 预算 1024,Qwen3-8B) | pass@1 准确率 (%) | 68.33(生成长度 1.07×) | FKV 69.58;QUEST 62.92;FASA 60.42;TriAttention 20.00 | 距全 KV 仅 -1.25,较 FASA +7.91 |
| AIME 2025(KV 预算 1024,GLM-4.7-Flash / MLA) | pass@1 准确率 (%) | 91.67(生成长度 1.17×) | FKV 90.42;FASA 65.00 | 超过全 KV +1.25,较 FASA +26.67 |
| 端到端解码吞吐(单张 B200,128K 上下文,B=2048) | 相对全 KV 的吞吐倍数 | GLM-4.7-Flash 6.43×;Gemma4-26B 1.88×;Qwen3-8B 1.51×(全扫描最高 6.99×) | FKV 1.00× | 最高 6.43×(完整扫描 6.99×) |
| 700B 级 DeepSeek 推理(对照原生 DSA) | AIME 2025 pass@1 (%) 与吞吐保持率 | JSSA 87.50(DeepSeek-V3.1-Terminus,免训练),吞吐达 DSA 的 96.1-99.2% | 原生 DSA 87.50(DeepSeek-V3.2-Exp,继续预训练);FKV 86.67 | 精度持平 DSA;128K batch 8 时 3.49× 于 FKV |
| oracle top-B 召回率(LLaMA-3.1-8B,r=32,B=256) | Recall@B (%) | 71.34 | Loki 35.97;FASA 48.90 | 较 Loki +35.37、较 FASA +22.44 个百分点 |
局限与改进
作者承认的局限包括:边际上界只提供可解的代理目标,既不保证紧致也不保证全局最优,尽管附录实验显示继续优化无收益,但这只是在测试设置内成立;打分仍需每步扫描全部 $N$ 个候选,短上下文、小 batch 时选择开销会吃掉收益,例如 Qwen3-8B 在 8K 上下文仅 1.02× 加速;校准对序列长度敏感,32K 校准的基在 128K 评估时困惑度从 11.31-11.48 恶化到 16.05-18.31,必须用覆盖部署长度的数据校准;MLA 的优势部分来自 FlashMLA 现成稀疏内核与共享缓存,GQA 内核则需自行维护。我自己的观察:其一,RULER 的长程聚合类任务仍明显掉点,如 Qwen3-14B 128K 的 FWE 65.33 对 FKV 80.00、CWE 42.00 对 49.60,说明 top-$B$ 硬选择对需要均匀读全文的任务不友好;其二,LLaMA 128K 与 FKV 仍有 1.59 分差距且 CWE 全线走低,稀疏化在检索类任务上安全、在全文统计类任务上有系统性风险;其三,吞吐实验全部在 B200(700B 用 8×B200、TP=8)完成,未覆盖消费级卡或边缘设备;其四,与 DSA 的对比中两者分属不同 checkpoint(V3.1-Terminus 对 V3.2-Exp),虽是官方推荐的对比方式,仍非严格同模型消融。
独立分析的弱点
独立分析四点弱点。第一,每步全量分数扫描是 $O(N)$ 的,长上下文小 batch 时成为新瓶颈(Qwen3-8B 在 8K 上下文几乎无加速),改进方向是层级化筛选(先页级粗筛再 token 级细排)或跨层复用索引——GLM-5.2 的原生调度已证明相邻层共享索引可行,JSSA 的校准式打分完全可以照搬以摊薄扫描成本。第二,正交基是全局校准、逐层逐头固定的,无法适应分布漂移的请求(如代码、多语言等与校准语料差异大的场景),改进方向是在线或滑动更新二阶矩并周期性重做特征分解(单次成本仅毫秒级),或按请求域自适应微调基。第三,所有层所有头共用同一 token 预算 $B$,而不同层注意力熵差异巨大,改进方向是按层或按头分配自适应预算(如依据校准期分数分布的熵定容量),在总预算不变的前提下提升关键层精度。第四,组均值查询 $\bar{q}$ 打分牺牲了组内 query 头的个体偏好,虽然逐头选择已优于层共享软投票(128K +5.29 分),但仍低于理论上限;可在共享索引基础上为每个 query 头附加小的头部级补偿集合(如每头额外 $B/8$ 个专属 token),在内核事务数可控的前提下逼近个体化选择。此外,论文只处理解码阶段,prefill 仍为全注意力,长输入场景可结合 MInference、XAttention 等 prefill 稀疏化形成端到端方案。
未来方向
作者明确留下的方向:从理论上刻画共享正交子空间与非对称 KQ-SVD 分解在激进稀疏下鲁棒性差异的根源(附录 B.6 只给出过拟合校准相关性的猜想性解释);在 NSA、MSA 等原生可训练稀疏架构等更多注意力变体上检验事后校准的普适性。基于论文成果可自然延伸的方向:其一,把 JSSA 的谱基当作 DSA 索引器的初始化,用极少量继续预训练把免训练追平升级为少量训练超越,并研究训练与校准基的相互作用;其二,跨层索引复用加自适应预算的组合优化,GLM-5.2 实验已证明复用调度不损精度(AIME 83.33 对 82.50),配合按层预算可进一步压低打分开销;其三,与 KV 量化正交叠加——JSSA 保留全维缓存,若与 FP8/FP4 KV 量化结合,访存收益可以再乘一次;其四,把免聚集逐头索引内核推广到 prefill 阶段与投机解码场景,以及滑动窗口加全局混合架构中全局层的更细粒度调度;其五,在服务系统层面研究 chunked prefill、continuous batching 与 JSSA 的交互,并在 H100、消费级 GPU 等非 B200 硬件上验证收益曲线;其六,理论侧补全边际界的紧致性刻画,或构造使精确目标与边际目标最优解发散的反例,划清方法的适用边界。
复现评估
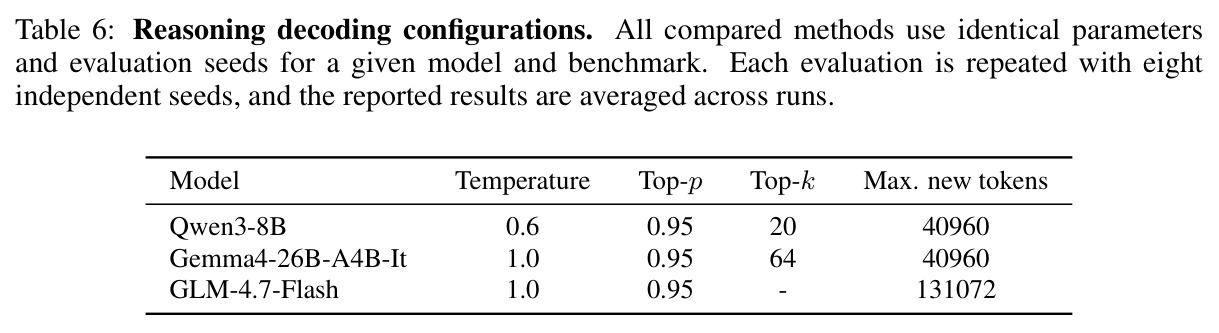
复现条件相当友好。代码已在 GitHub 开源(https://github.com/jiwonsong-dev/JSSA),基于 vLLM 的服务栈与 Triton 内核一并放出;基线中 Loki、FASA、QUEST 复现于同一 vLLM 栈,其余基线用 HuggingFace Transformers 官方实现,对比公平性有保障。所用模型均为公开权重:LLaMA-3.1-8B-Instruct、Qwen3-8B/14B、Ministral-3-8B、Gemma4-26B-A4B-It、GLM-4.7-Flash 的精度实验单张 B200 即可,DeepSeek-V3.1-Terminus/V3.2-Exp 与 GLM-5.2 的 700B 级实验需要 8×B200(TP=8),这是复现门槛最高的部分。校准数据用公开的 LongAlign,构造方法(过滤不小于 8K token 的文档、拼接裁剪到 131,072 token、8 条序列)写得非常具体,校准成本仅 129-365 秒且无需训练;推理评测给出完整采样配置(如 Qwen3-8B:temperature 0.6、top-p 0.95、top-k 20、最大 40960 新 token),每项推理评测跑 8 个随机种子取均值,统计上较扎实。主要风险点:吞吐数字依赖 B200 的带宽特性,其他硬件上倍数会缩水;Triton 内核可能与 vLLM 版本和 CUDA graph 行为耦合,工程复现需留意环境;论文未报告置信区间,AIME 这类 30 题小样本基准上几个点的差异应谨慎解读。总体评级:单卡精度复现中等偏易,系统级吞吐与 700B 复现偏难。
论文图表
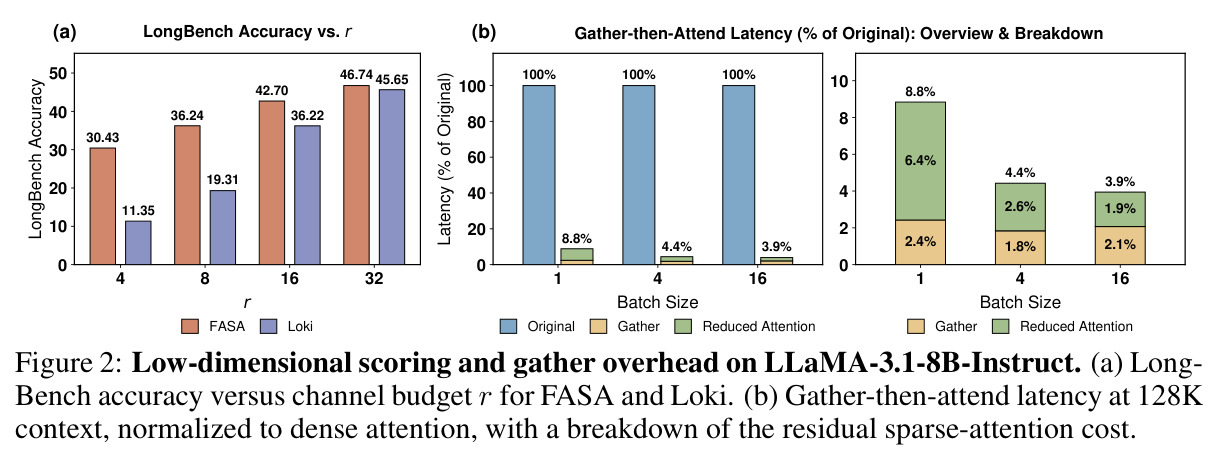
动机实验图。(a) 在 LLaMA-3.1-8B 上,FASA 的离散通道选择在所有投影秩 r=4 到 32 都优于 Loki 的键重构投影,r=4 时分别为 30.43 与 11.35,紧预算下差距最大;(b) 128K 上下文下 gather-then-attend 的延迟分解显示,物理 gather 的开销与稀疏注意力计算本身相当,batch 16 时占剩余延迟一半以上。
这是全文两大动机(打分目标错配、聚集开销吃掉收益)的直接经验证据,解释了为什么必须同时解决选择质量与执行效率两个问题。