S-Agent 2.0:基于通用编程代理的空间推理 S-Agent 2.0: Spatial Reasoning with a General Coding Agent
给现成编码代理装上命令行感知工具包,闭环采集-记忆-解读证据链,五大空间基准全面领先
前置知识
Agentic VLM(代理式视觉语言模型)
指不在单次前向传播中直接回答问题,而是在推理过程中交替进行「思考—调用外部工具—读取结果—再思考」的视觉语言模型系统。代表作 ReAct 确立了「推理与行动交错」的模板,视觉侧的 VisProg/ViperGPT 一次性生成程序再执行,MM-ReAct/HuggingGPT 按轮次分发工具请求。在空间推理中,代理可以主动调用 3D 重建、分割、几何测量等工具收集证据后再作答。
本文的系统就是一个 Agentic VLM,但它的控制器不是专门写的,而是直接复用通用编码代理;理解这一范式才能看懂它与 SpatialClaw 等专用控制系统的对比逻辑。
3D 重建与度量点云
从多张图像恢复场景三维结构的技术。前馈式模型(如 VGGT、Depth Anything 3)输入若干帧即可输出每帧的深度图与相机位姿,融合后得到点云。本文强调「度量(metric)」与「重力对齐」两个属性:点云的尺度对应真实米数,且 z 轴与重力方向一致,这使得「距离多少米」「在左还是右」「离地多高」都能闭式计算。
工具包的 recon 命令用 Depth Anything 3 + GeoCalib 构建的重力对齐度量点云 P 是整个场景记忆的几何底座,所有读数(side/distance/elevation)都是从它闭式算出来的。
6-DoF 位姿与 SE(3)
物体在三维空间中的完整姿态由 3 个平移自由度加 3 个旋转自由度构成,数学上用特殊欧氏群 $SE(3)$ 中的变换矩阵 $T\in SE(3)$ 表示,包含位置 $p\in\mathbb{R}^3$ 和朝向。「带朝向的观察者」就是这样一个位姿实例:知道它站在哪、面朝哪,才能定义它的「前/后/左/右」参照系。
场景记忆中每个实例都存 $g_i=\{p_i, E_i, T_i\}$;本文让模型把问题虚构的观察者注册成带位姿的实例,是把「相对我而言在左边」这类问题转化为几何计算的关键。
可提示分割(Promptable Segmentation / SAM)
给定文字或框等提示词,分割模型在图像中勾出对应物体的像素掩码。SAM 3 支持概念级文字提示,能按「bed」「red chair」等自然语言标签在多帧上批量分割。本文将掩码抬升(lift)到点云上,从而把 2D 识别结果变成带位置、范围和位姿的 3D 实例。
segment 命令是工具感知的核心:模型只负责想提示词(语义工作),精确的掩码与 3D 落底由 SAM 3 与点云完成,这正是「按能力分工」接口的体现。
编码代理(Coding Agent / SWE Agent Harness)
为软件工程任务设计的通用智能体框架,如 OpenHands、Codex、Claude Code。它提供 shell、文件系统、代码执行、长程上下文管理和成熟的工具调用循环,骨干模型经过训练天然会遵循这套交互方式;其标志性习惯是「查看输出—发现问题—修改—重跑」的检查-修改反射。
本文最大的反直觉点:空间代理无需定制控制器,套用编码代理即可。它的两个习惯(图像即文件查看、自检反射)恰好解决了模型感知与工具感知的融合问题,也是「跨 harness 泛化」实验的基础。
证据回路(Evidence Loop)
本文提出的概念:一个空间答案只有当完整回路闭合时才可信——采集测量、在推理期间记住测量、把测量解读为问题所用的空间语言、并真正用于写出答案。任何一环断裂(典型如证据躺在工作目录里模型却用肉眼作答)都会导致「工具对了、答案错了」。
这是全文的诊断框架与设计纲领:三条接口要求(融合采集、持久记忆、到达即解读)逐一对应回路的三个断点,所有实验消融都围绕它展开。
研究动机
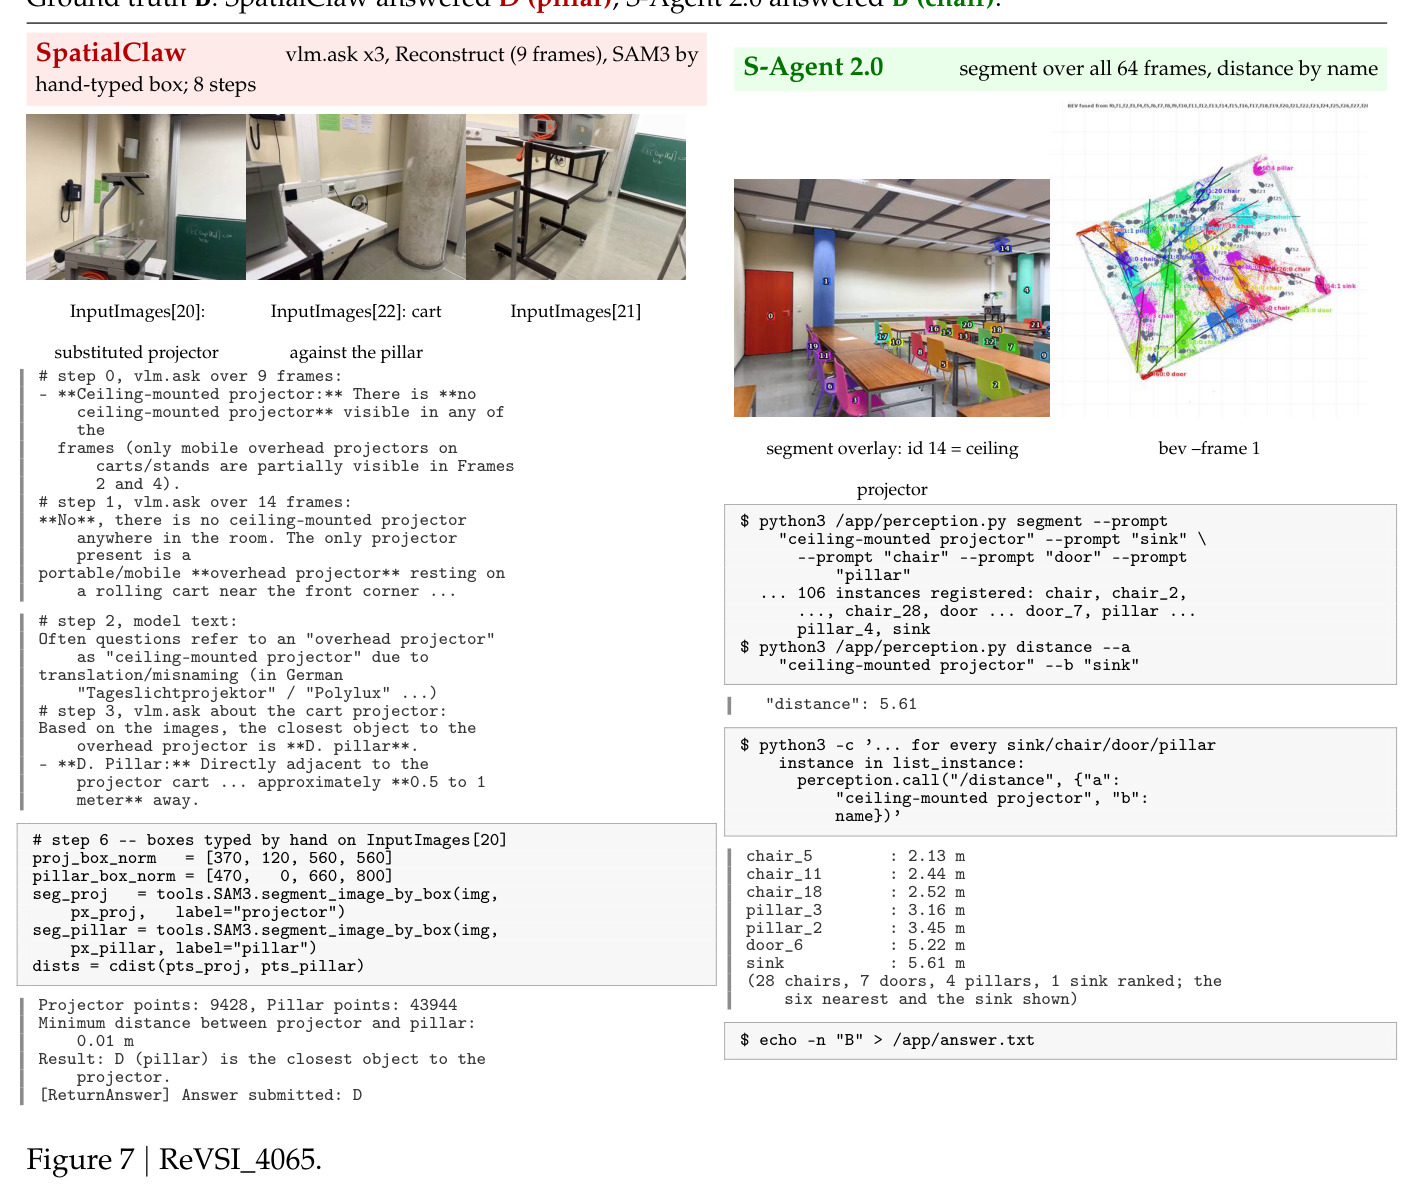
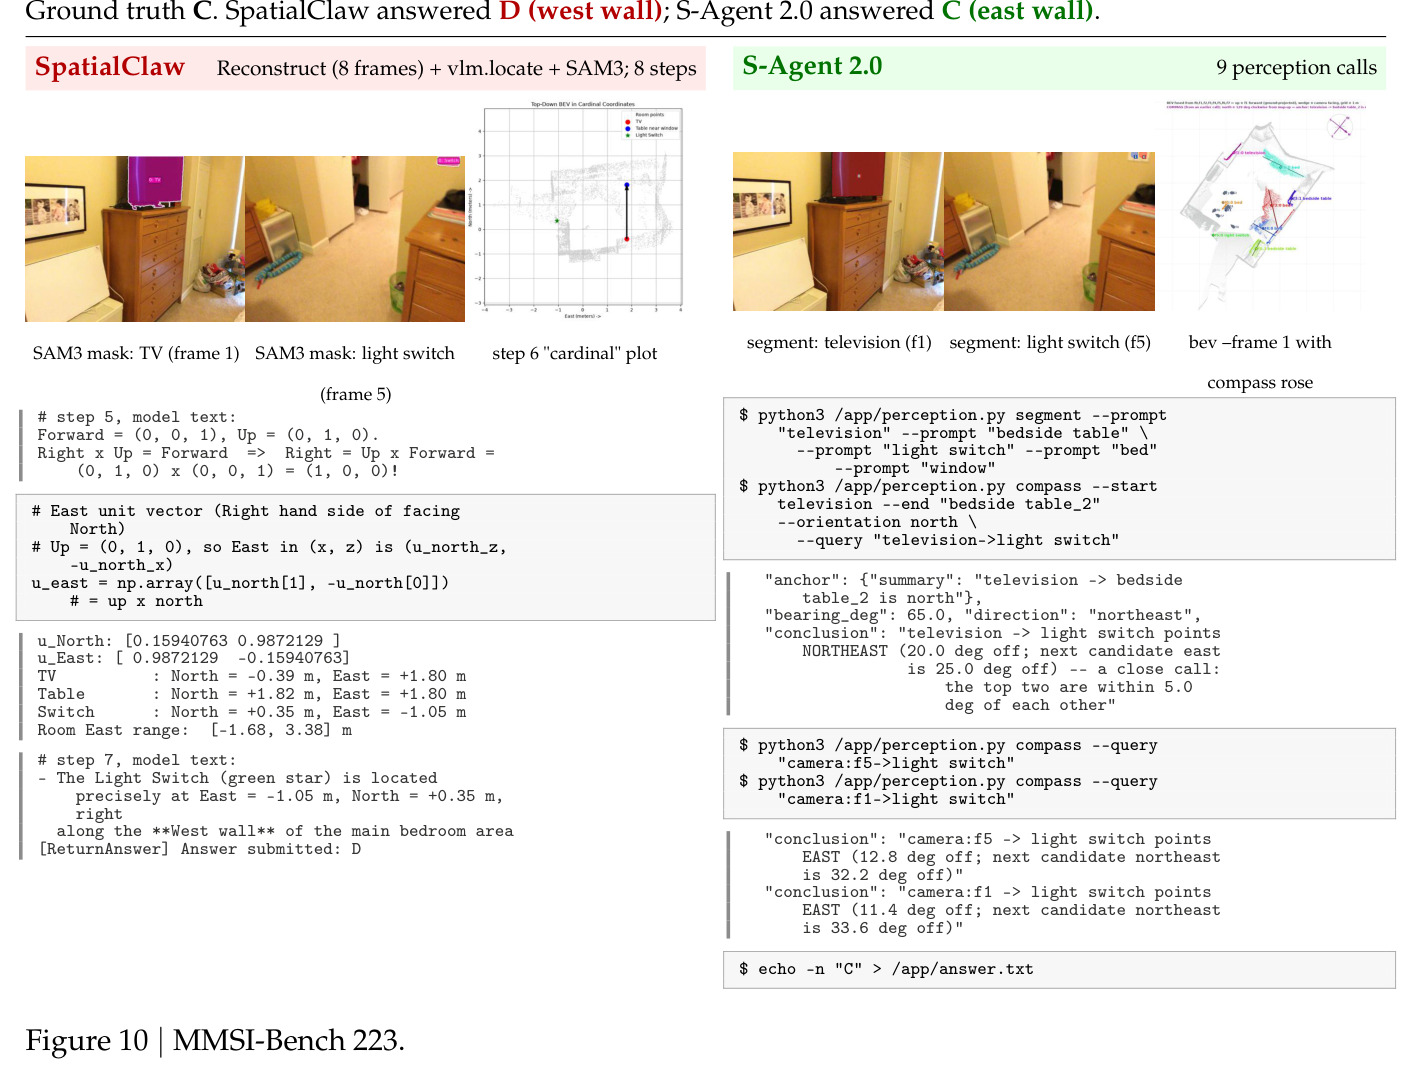
空间推理要求模型判断物体在三维空间中的位置、相互关系与运动方式,是视觉感知与具身智能的基础能力。以 S-Agent 和 SpatialClaw 为代表的代理式 VLM 通过在推理中主动调用 3D 感知工具(重建、分割、几何计算)收集证据,相比单次前向作答有大幅提升。但作者逐条观看系统运行轨迹后发现一个反直觉现象:在许多题目上工具明明返回了正确证据,模型最终答案却依然错误。失败呈两种形态:其一是模型误读手中已有的测量值——把刚正确测出的旋转符号弄反,或把正确的数字放进错误的坐标系、错误的语义方向去理解,例如附录案例中 SpatialClaw 把世界系 +11.62 m 的位移分量结合相机前向 $-Z$ 误判为「向前」,实际相机向后移动了 10.85 m;其二是证据根本没参与作答——测量结果静静躺在工作目录里,模型却回头「用眼睛看图」给出答案,甚至把正确读数以无关理由丢弃。由此得出的诊断是:现有专用系统把设计精力几乎全部投入「采集」环节(日益丰富的感知与几何函数库),而采集很少是失败原因;「记忆」与「解读」两环被完全留给模型,证据回路在最后一公里断裂。
本文的目标是本文的目标是构建一个零训练、不改骨干模型权重的空间推理代理,让「证据回路」完整闭合:每个测量值被采集后必须被记住、被正确解读、并真正进入最终答案。作者把目标落实为对工具接口的三条硬性要求:(i) 采集必须与模型自身感知融合——模型「认出来」的对象与工具「测出来」的数字要落入同一个几何场景,可在同一底座上互相校正;(ii) 采集到的证据需要由环境代管的持久记忆——多步推理之后仍可按名字寻址,而不必依赖模型上下文逐字搬运中间数字;(iii) 每个测量值返回时应「到达即解读」——以问题所用的空间语言(前/后/左/右、指北方位、离地高度等)直接给出结论。最终目标是在 MMSI-Bench、ReVSI 等五个多视角与视频空间基准上,用 27B 开源骨干(Qwen3.8-27B)无训练地超越专用系统 SpatialClaw 以及 GPT-6、Gemini-3.8-Flash 等闭源模型,并验证方法能跨 OpenHands、Codex、Claude Code 等不同编程代理框架工作。
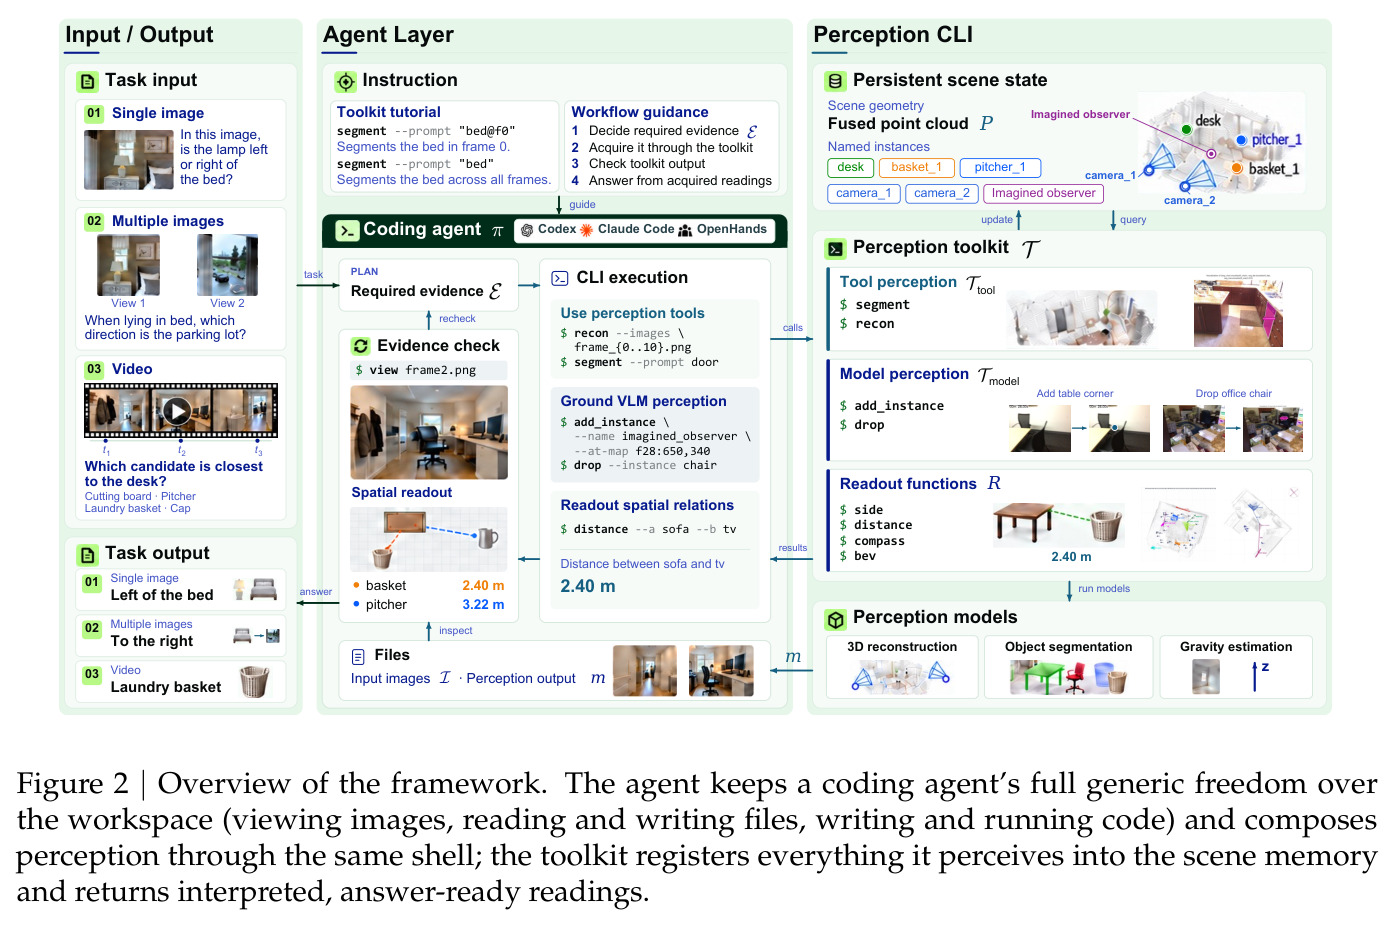
与已有工作不同的是,独特切入角度是「不造控制器,只造接口」。此前的代理式空间推理系统都为空间任务手写专用控制器——例如 SpatialClaw 用状态机驱动模型走 plan-act-reflect 循环,配上图灵完备的代码内核与几何工具库;pySpatial 合成 3D 视觉程序;SpaceTools 用监督+强化学习训练模型协调固定工具集——设计精力都集中在采集侧。S-Agent 2.0 反转了这个分配:直接采用原封不动的通用编程代理(软件工程智能体的整套 harness)作为空间代理,白拿其 shell、文件系统、代码执行、长程上下文管理与成熟工具调用循环,把全部设计工作花在一个命令行感知工具包上。作者观察到编码代理的两个习惯恰好满足闭环要求:一是看图只是普通文件查看,模型自身感知与工具返回交织在同一对话流中,不存在独立图像通道,两种感知天然可以互检;二是编码代理有「查看-修改-重跑」的反射式自检习惯,搬到场景上就是在取任何读数之前先对照工具输出校正自己的感知。接口沿「语义判断归 VLM、精确测量归感知模型」的界线切分,并用三条约定——模型感知可注册/删除实例、一切测量持久入场景记忆、每个回复自带解读——补齐被遗忘的记忆与解读环节。
核心方法
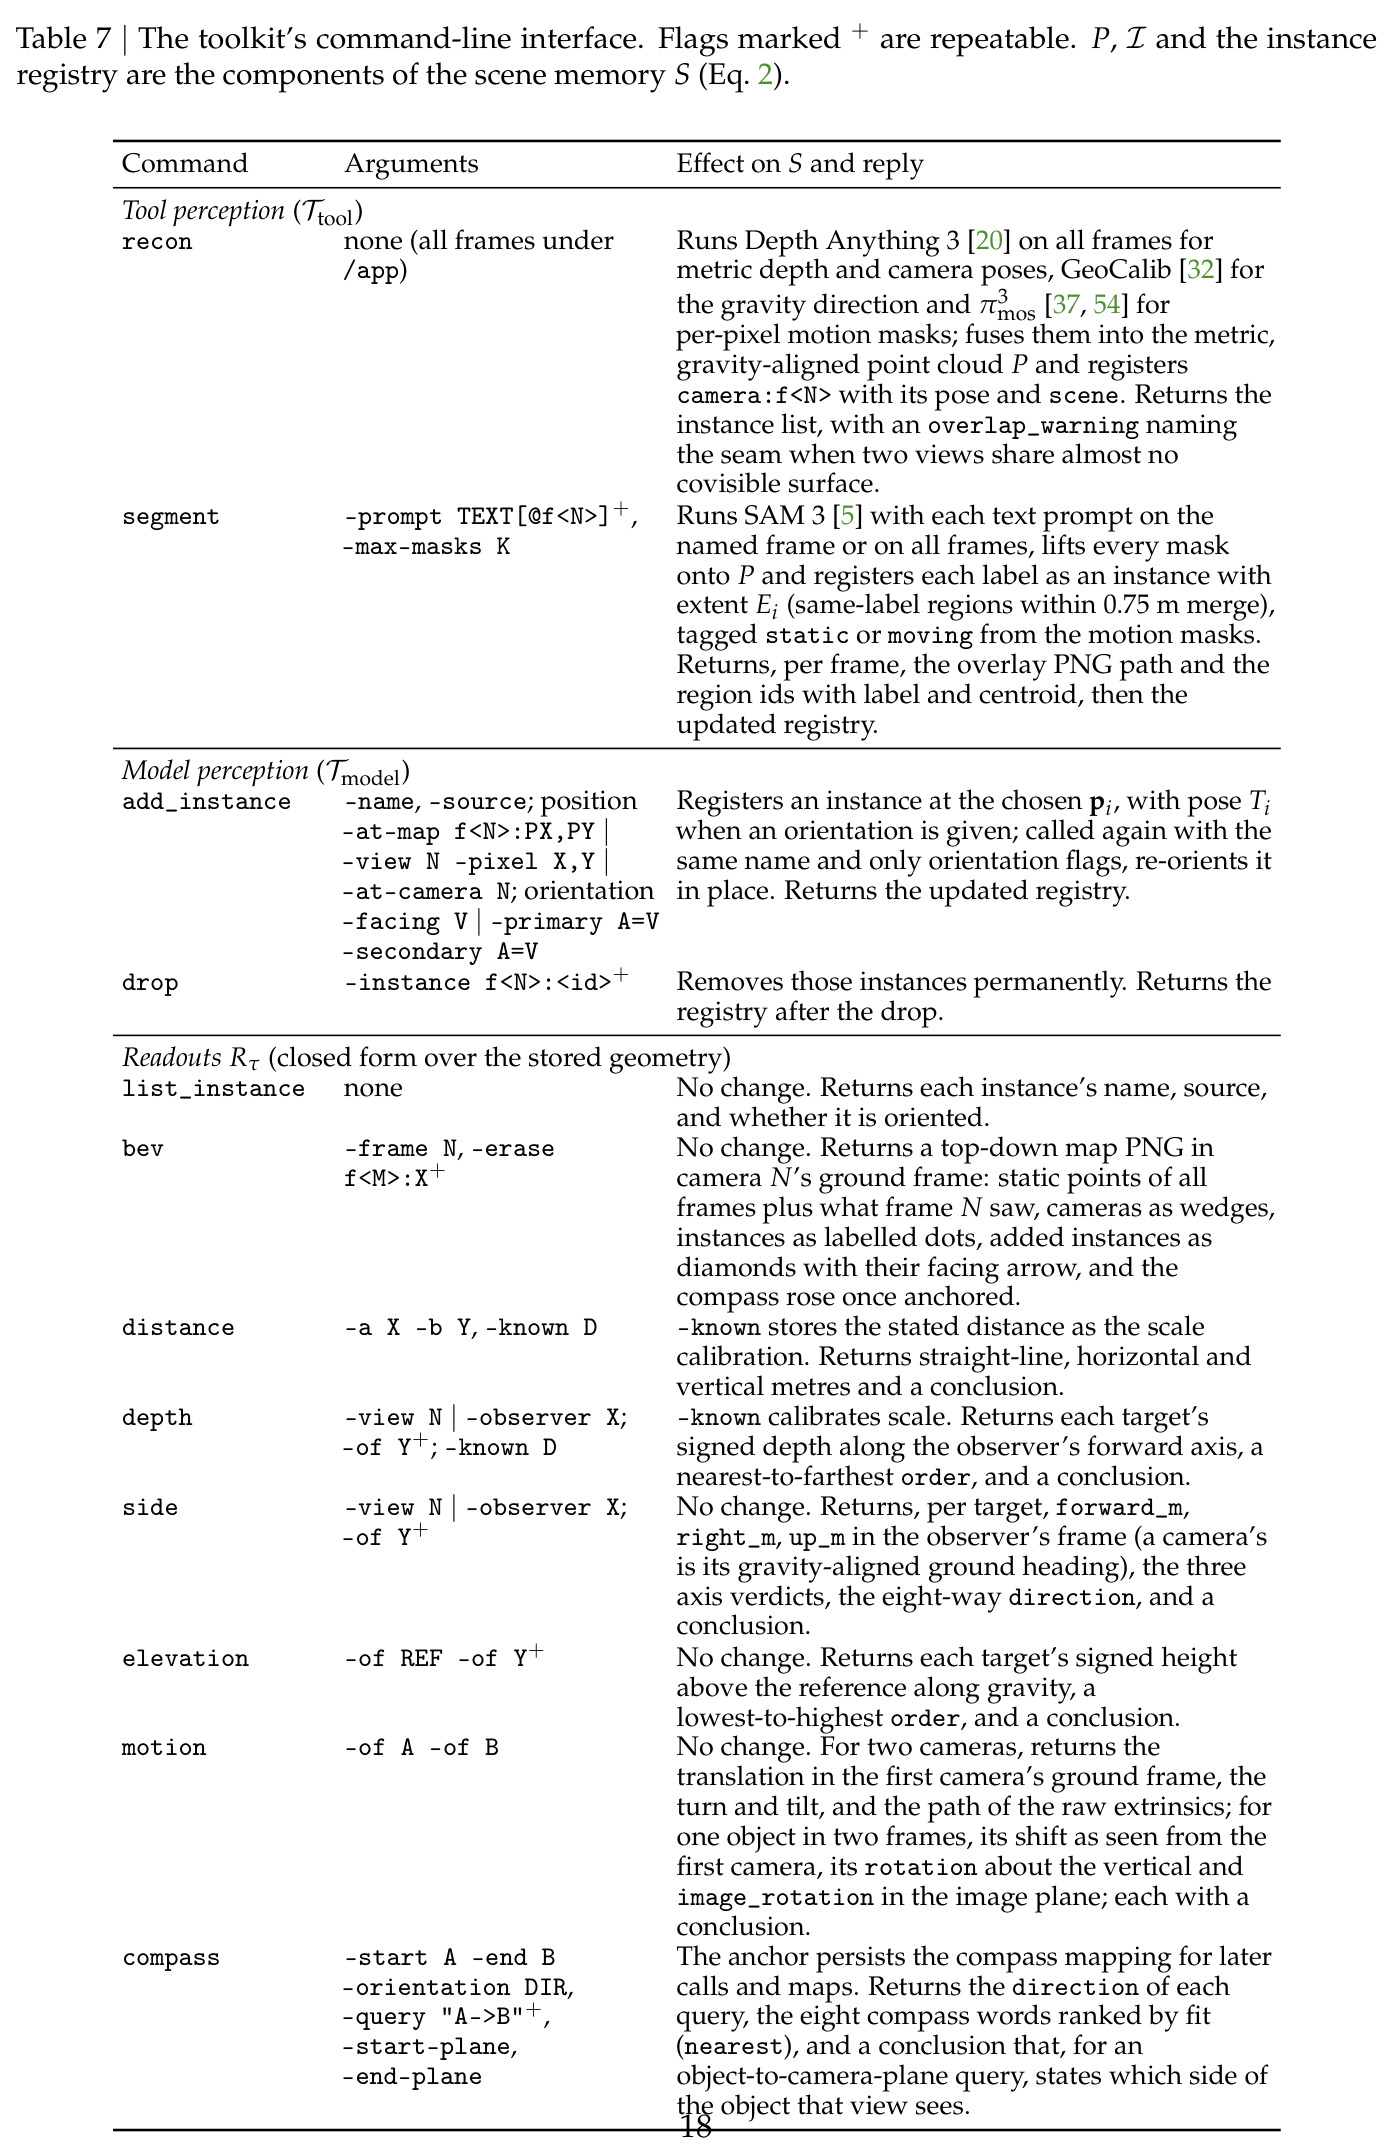
直觉上,回答一道空间题需要一条完整的证据链:决定要测什么 → 把它测出来 → 记住 → 解读成答案语言 → 写出答案。S-Agent 2.0 用三个组件把整条链闭合:(1) 一个原封不动的通用编程代理 $\pi$ 兼任规划者与执行者;(2) 一个命令行感知工具包 $\mathcal{T}$;(3) 一个由环境维护的持久场景记忆 $S=\{I, P, \{(\nu_i, g_i)\}_i\}$,其中 $I$ 为原始帧集合,$P$ 为重力对齐的度量融合点云,每个命名实例 $\nu_i$ 携带几何 $g_i=\{p_i, E_i, T_i\}$:位置 $p_i\in\mathbb{R}^3$、点云子集 $E_i$、6-DoF 位姿 $T_i\in SE(3)$(后两者可留空)。形式化地,推理步 $t$ 时策略从上下文采样 $(z_t, a_t)\sim\pi(\cdot\mid u, q, z_{ [flags]`,回复为 stdout 上的 JSON,分割叠加图与俯瞰图等渲染结果落盘。固定指令 $u$ 对每个 episode 相同,只含工具教程与推荐工作流(决定证据→采集→检查→作答)。
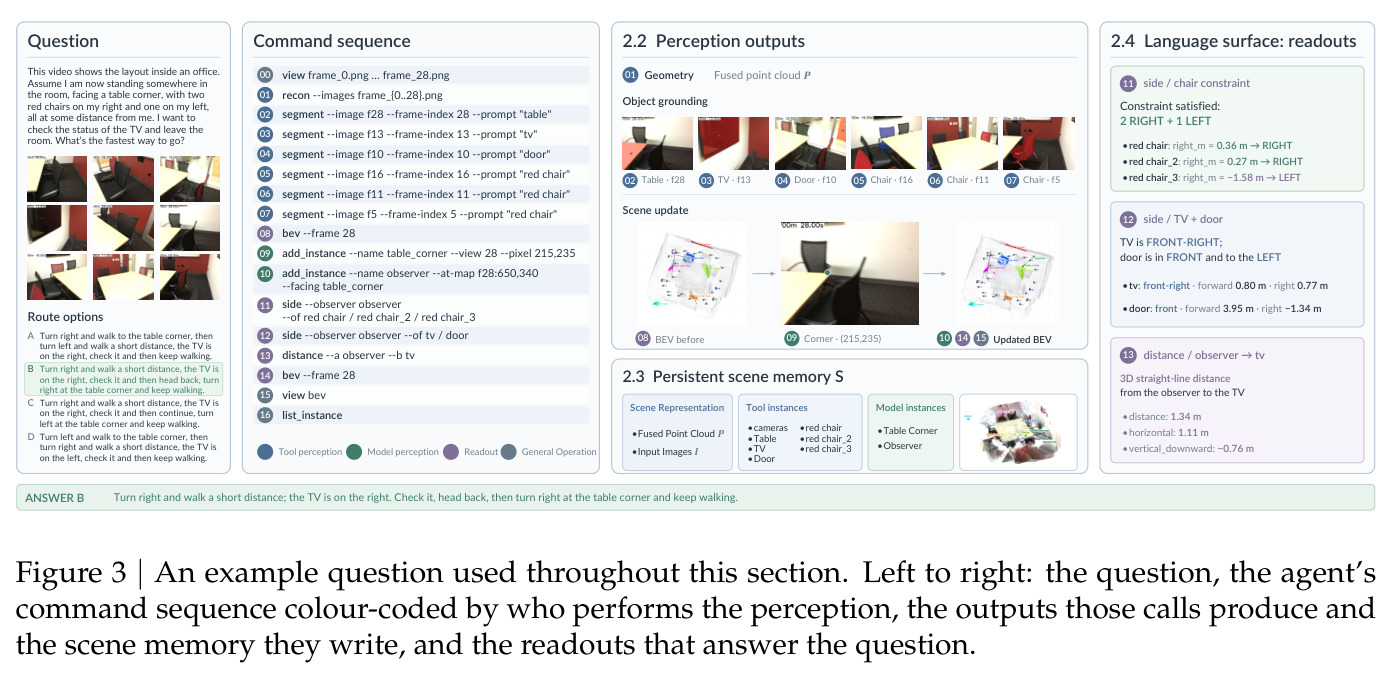
核心创新是把「证据闭环」做进工具接口本身,与已有方法的本质区别在于设计精力的分配方向相反。SpatialClaw 等系统给模型一个图灵完备的几何内核,却把「记住每个中间数字」与「把数字翻译成答案语言」这两件 VLM 最不擅长的事留给模型,于是出现「工具答对、模型答错」。S-Agent 2.0 的接口沿能力分工线切开:模型只贡献映射 $q\mapsto x$(决定测什么、给出分割提示词),工具包完成 $(x,S)\mapsto o_{perc}$。三个关键设计:其一,两条写入场景记忆的路线——工具感知 $\mathcal{T}_{tool}$(recon/segment)负责测量侧;模型感知 $\mathcal{T}_{model}$(add_instance/drop)让模型把问题虚构的「想象观察者」(躺着的人、进门的人)注册为带朝向的几何实例,或删除工具分割错的实例(如把反射识别成物体的掩码),使只存在于模型理解中的构念与工具实测对象享有同一几何地位。其二,环境代管的持久记忆让「测量物体与关系」退化为按名字查表的闭式计算 $R_\tau(\nu_1,\ldots,\nu_k; S_t)$,模型只需记住实例名。其三,每个回复按固定解剖结构返回类型化数值字段外加一句结论,明确声明参照系(重力对齐/相机/图像平面),并指示模型「抄结论、勿从图片重新推导」。
方法步骤详情
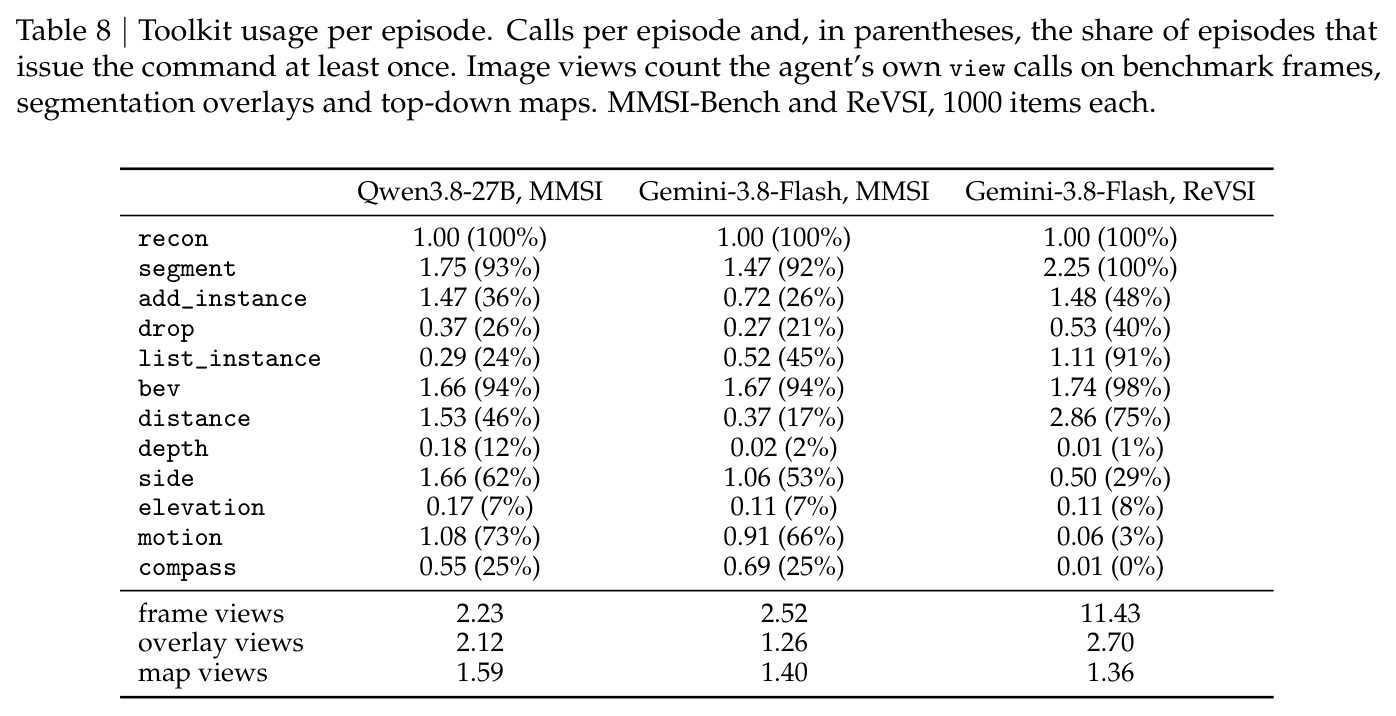
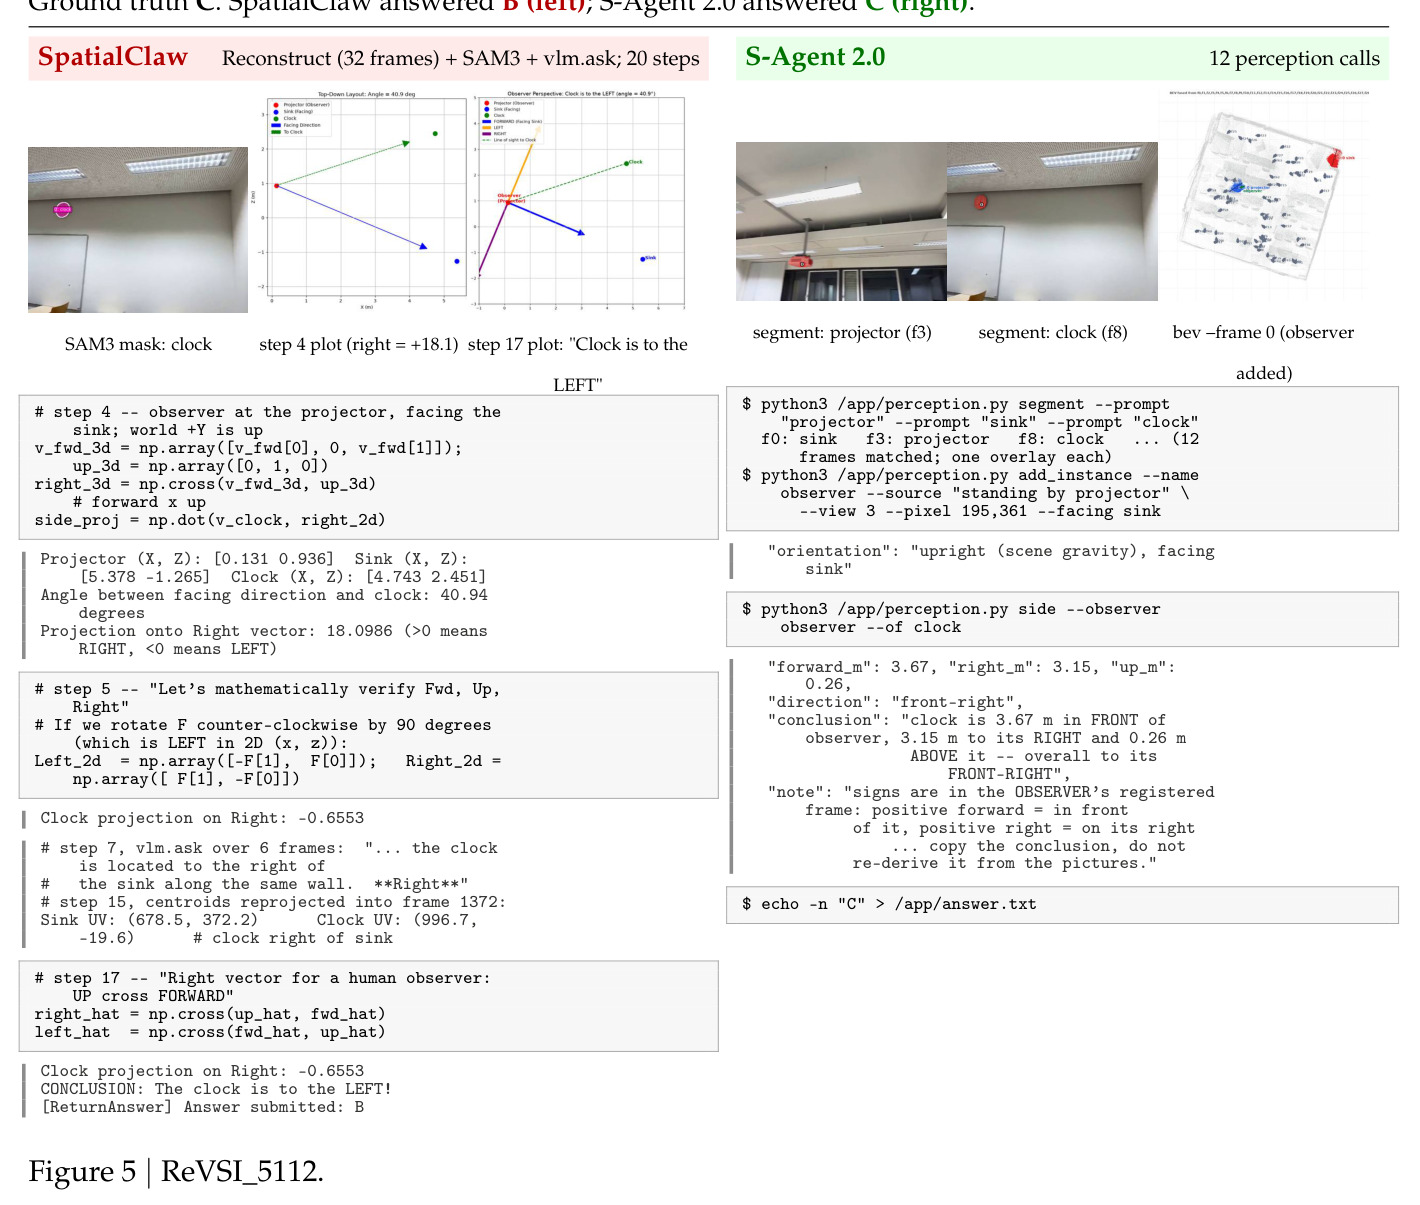
一次完整 episode 流程如下。第一步建场景:调用 recon,Depth Anything 3 对全部帧估计度量深度与相机位姿,GeoCalib 估计重力方向,π3mos 生成逐像素运动掩码,融合为重力对齐点云并注册相机 camera:f$N$ 与场景中心 scene(统计显示 100% 的 episode 都调用此命令)。第二步物体检索:segment 以模型的文字提示词驱动 SAM 3 在指定帧或全部帧分割,每个掩码被抬升到点云 $P$ 上注册为命名实例,同标签区域 0.75 m 内自动合并,并按运动掩码标注静态/运动;回复含每帧叠加图路径与质心。第三步模型感知修正:add_instance 用 --at-map f:PX,PY(俯瞰图取点)、--view N --pixel X,Y(原帧像素抬升到 3D)或 --at-camera N 定位,--facing 或 --primary/--secondary 定朝向,注册「桌角」「进门观察者」等;drop 永久删除错误实例;26%–48% 的 episode 用了 add_instance,21%–40% 用了 drop。第四步查询证据:side/distance/depth/elevation/motion/compass 等读数命令对存储几何闭式计算,返回 forward_m、right_m、up_m 等数值字段加结论句(例如「clock is 3.67 m in FRONT of observer, 3.15 m to its RIGHT — overall FRONT-RIGHT」);bev 渲染带指北针、相机楔形与实例标记的俯瞰图(94%–98% 的 episode 使用)。第五步交叉校验:代理打开工具输出图与登记比对,不一致则 drop 或确认保留(如验证「第二把红椅」是真实物体而非重复掩码)。第六步作答:直接采纳结论句中的方位词写答案。
技术新颖性
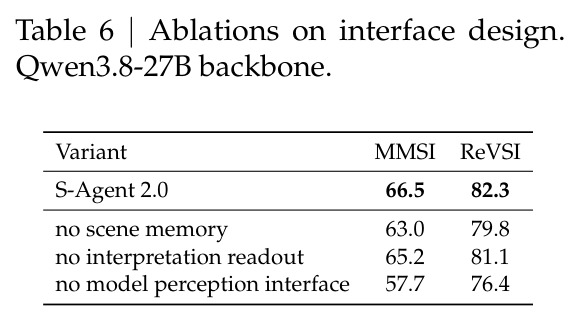
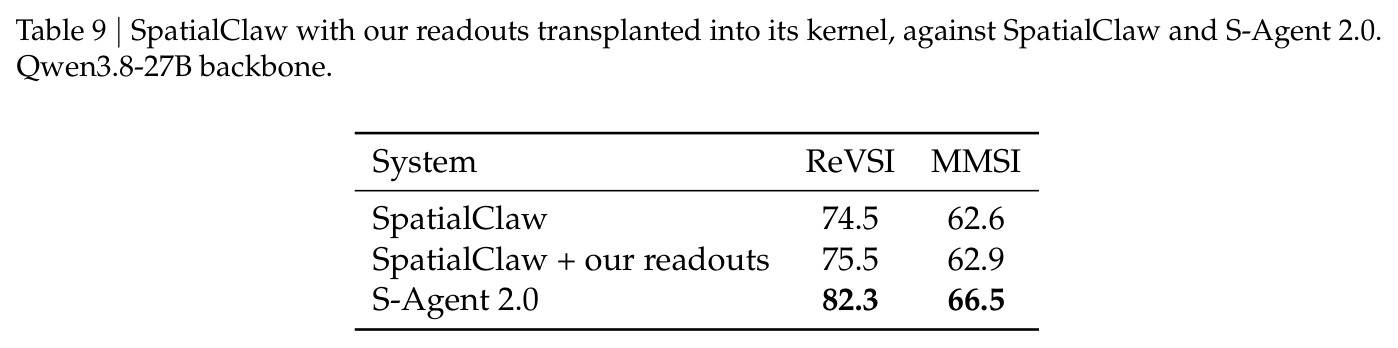
技术新颖性有三层。范式层面:首次把通用软件工程代理整体复用为空间推理代理,无需手写任何控制器——同一工具包在 OpenHands/Codex/Claude Code 三个 harness 上分别取得 MMSI 66.5/67.0/63.8,证明可迁移的是接口而非控制器;而 VADAR、pySpatial、SpatialClaw 等均为任务定制控制器。接口层面:「模型感知」路线让 VLM 的高层语义理解本身成为可测量的几何对象——问题文本中的虚构观察者注册为带朝向实例后,side --observer 直接输出「钟在你左前方 1.94 m」,把 VLM 最易出错的参照系换算外包给确定性几何;这与 SpatialClaw 把自身感知放在独立通道、无法进入几何底座的做法形成本质区别。语言层面:「到达即解读」把 $o_{perc}=c_\tau(m;S)$ 的蒸馏放在计算几何的一侧——掌握参照系知识最可靠的一方——而非让模型事后翻译;回复的 note 字段甚至写明「符号定义在观察者自身坐标系:正向为前」。消融证明三要素缺一不可(去模型感知接口 −8.8/−5.9,去场景记忆 −3.5/−2.5,去解读 −1.3/−1.2,均为 MMSI/ReVSI 百分点);附录 D 的移植实验进一步表明,仅把六个读数函数搬进 SpatialClaw 内核只带来 +1.0/+0.3(ReVSI 75.5、MMSI 62.9),证明增益来自接口整体而非某个单点功能。
实验结果
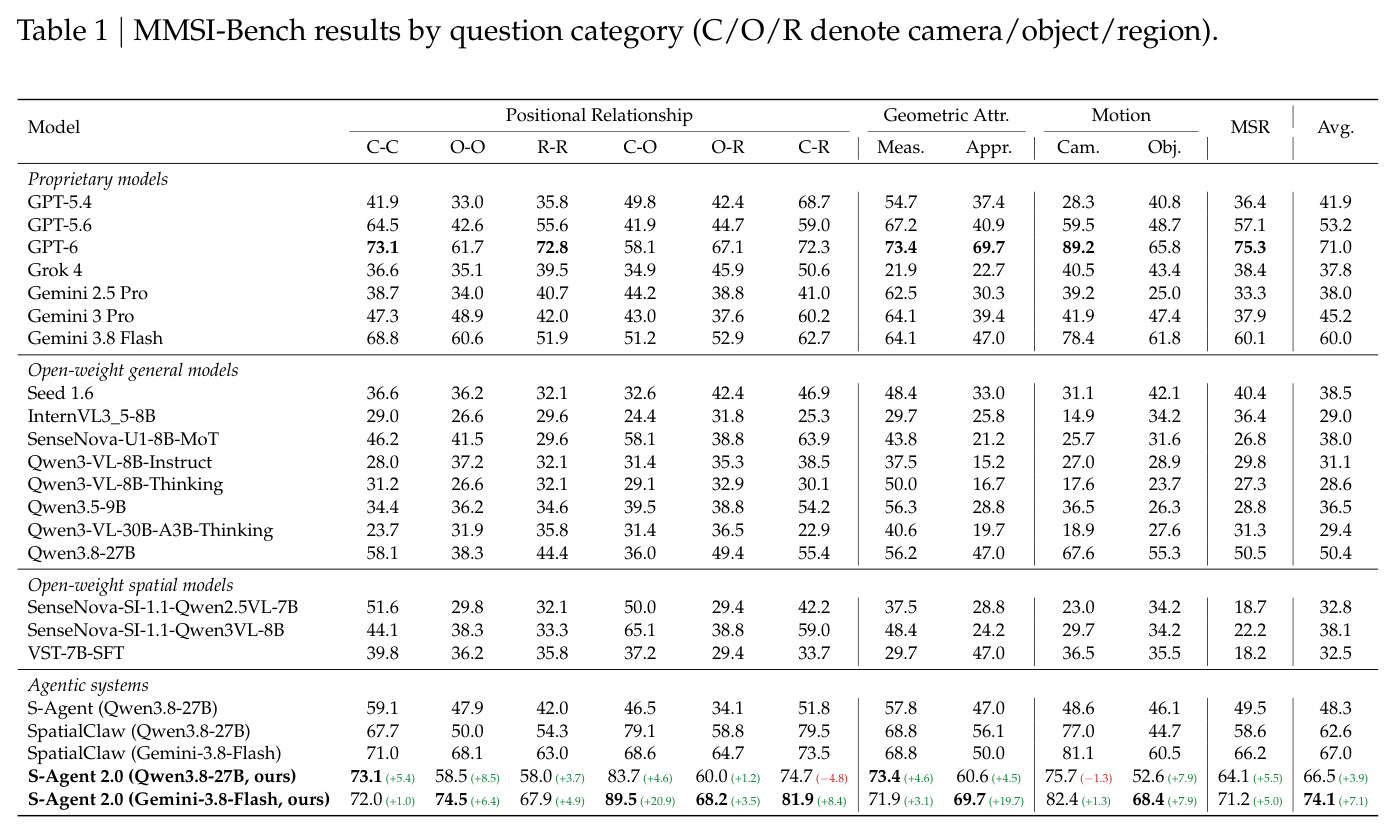
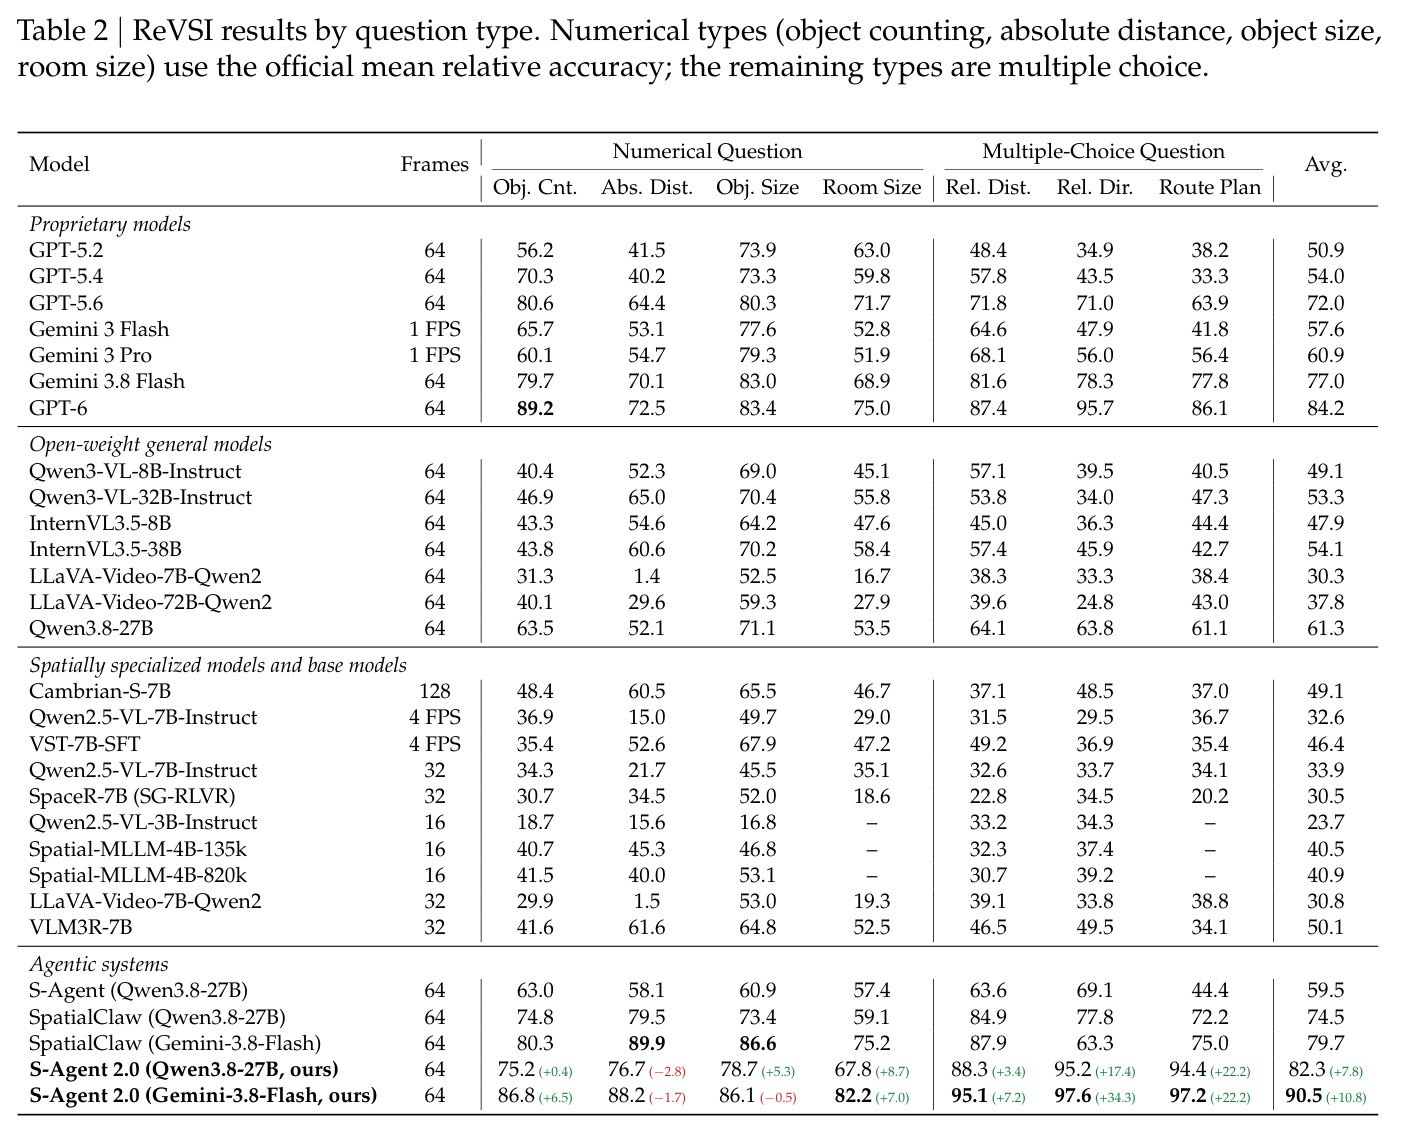
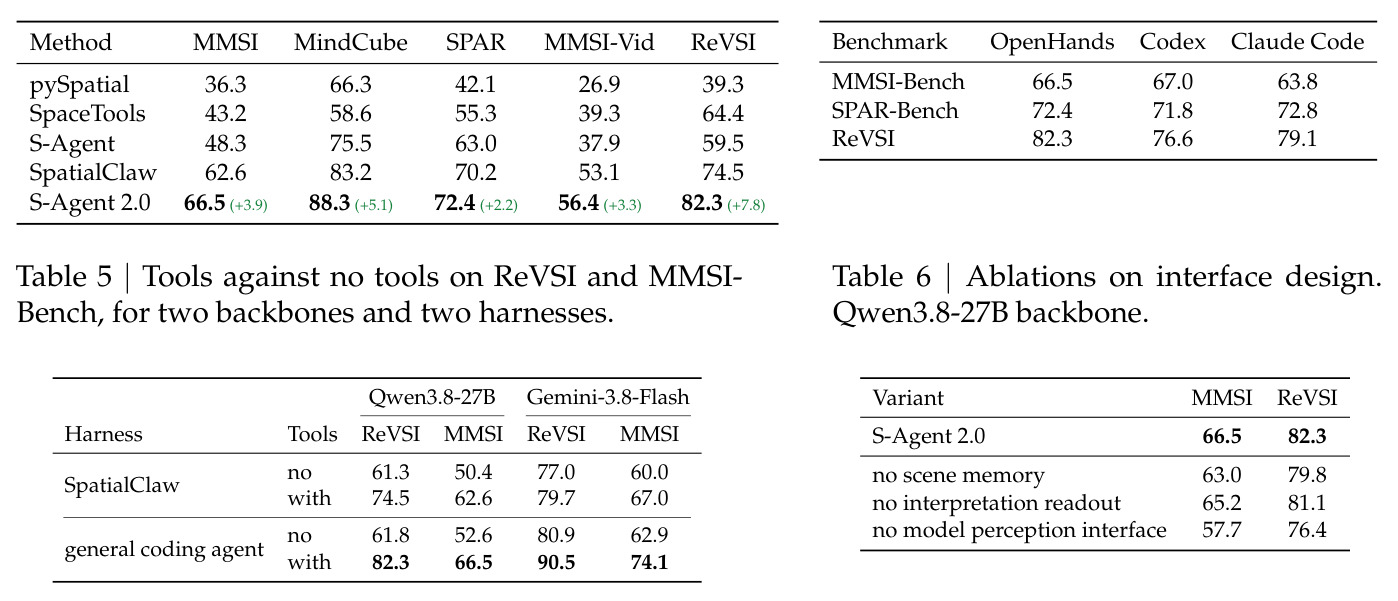
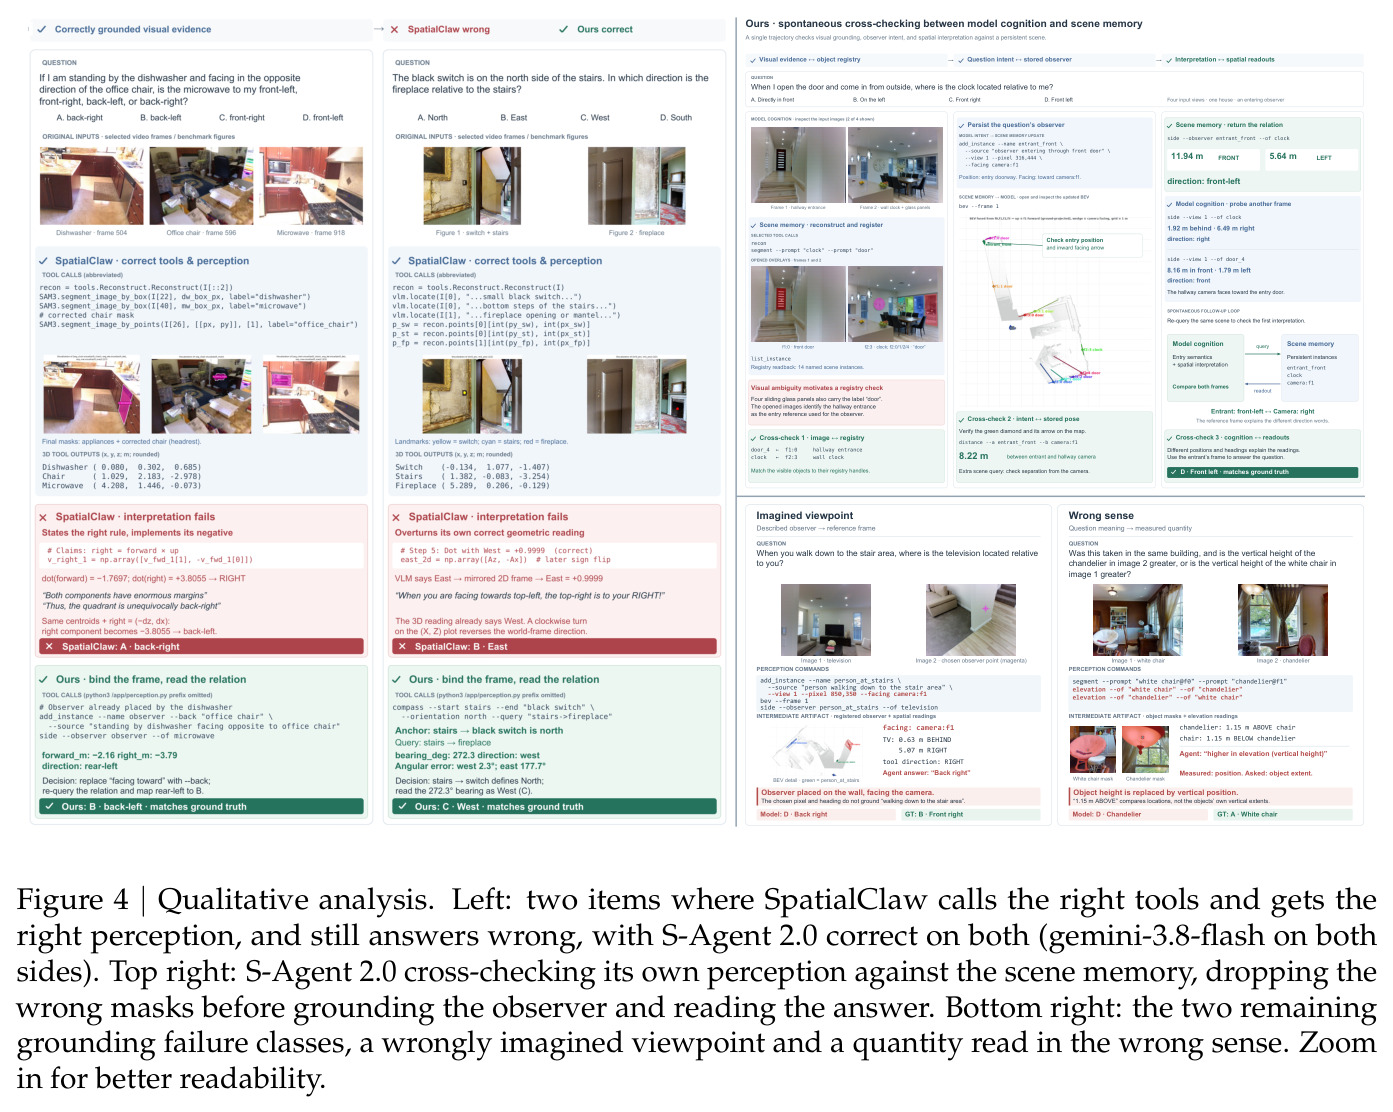
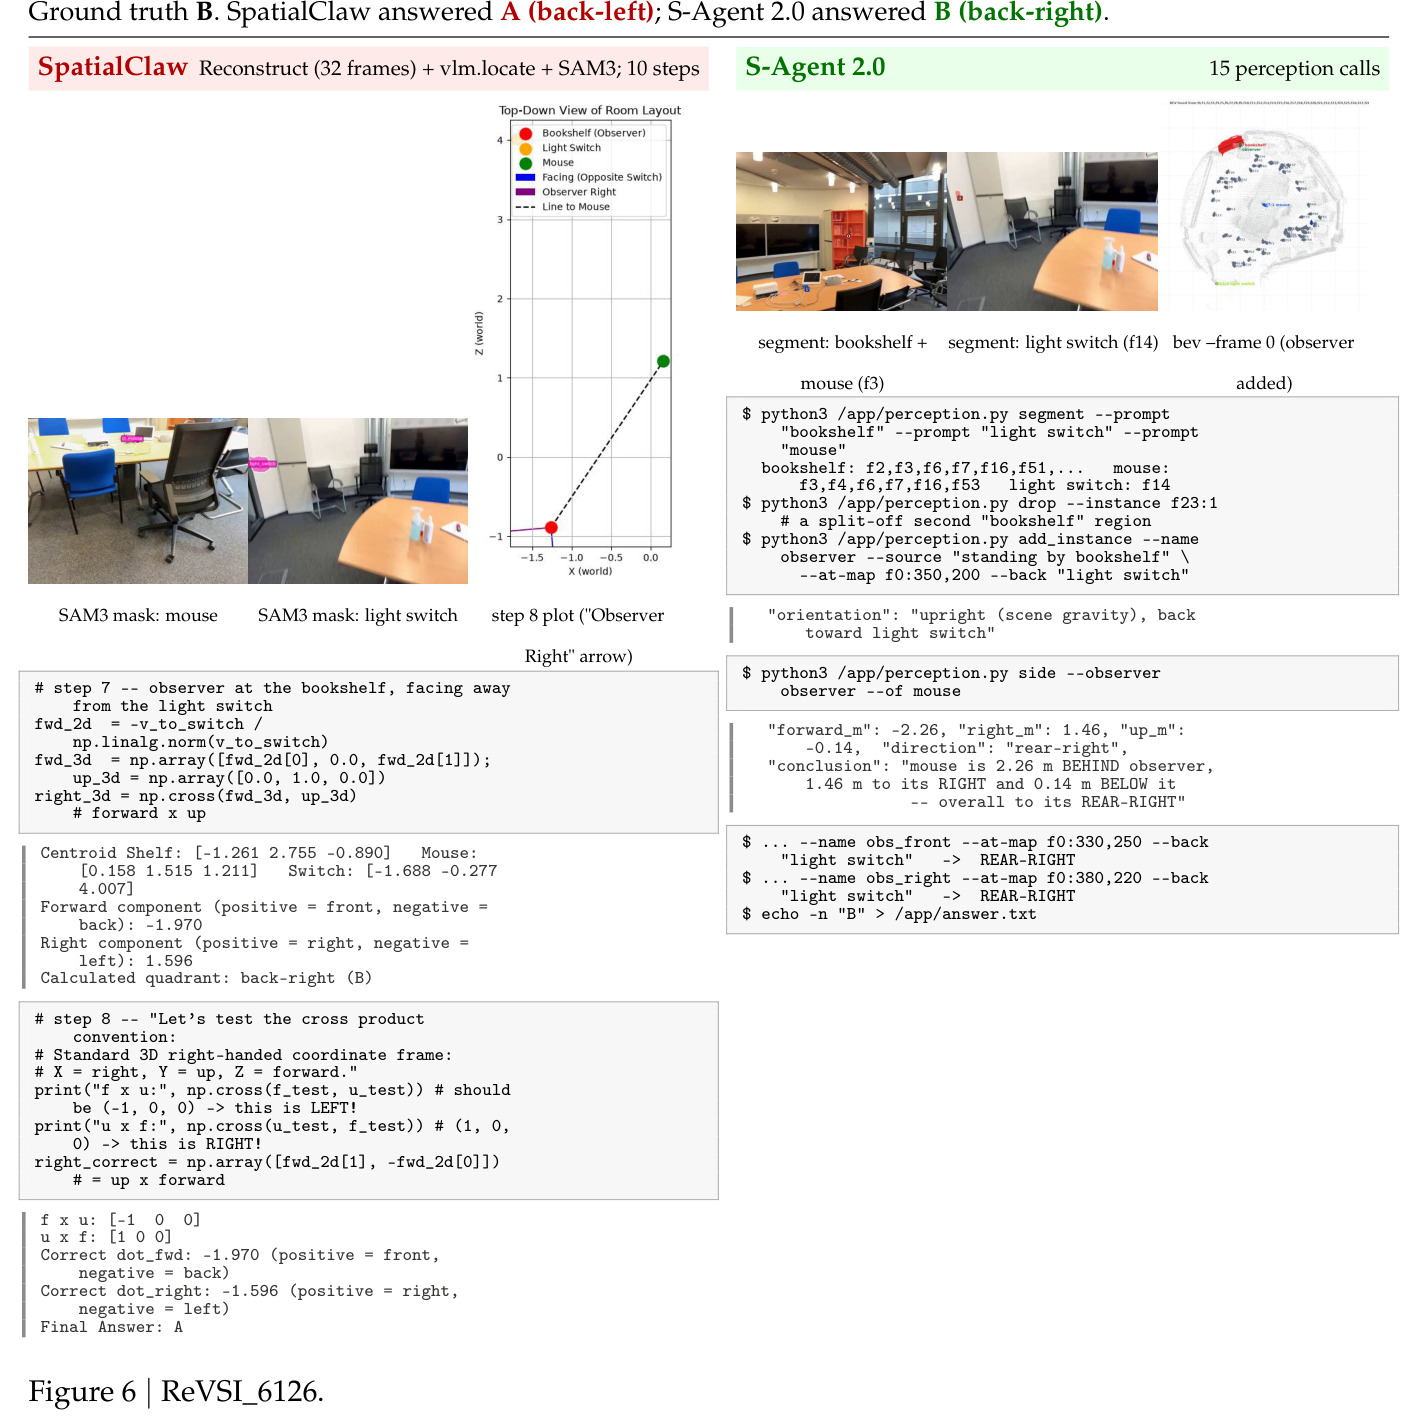
主要结果分六块。(1) MMSI-Bench(Table 1):S-Agent 2.0 用 Qwen3.8-27B 骨干达 66.5%,超同骨干 SpatialClaw 的 62.6%(+3.9),也超过除 GPT-6(71.0)外所有闭源模型(GPT-5.4 仅 41.9、Gemini 3 Pro 45.2、Gemini 3.8 Flash 60.0);换 Gemini-3.8-Flash 后达 74.1%,为全表最高(同骨干 SpatialClaw 67.0,+7.1)。(2) ReVSI(Table 2):Qwen 骨干 82.3%(SpatialClaw 74.5,+7.8),Gemini 骨干 90.5%(SpatialClaw 79.7,+10.8;GPT-6 84.2),同为全表最高;优势最大的题型是相对方向(Qwen 95.2,+17.4;Gemini 97.6,+34.3)与路线规划(94.4/+22.2 与 97.2/+22.2),唯一短板是绝对距离(Qwen 76.7,−2.8)。(3) 五基准通吃(Table 3):Qwen 骨干下 MMSI 66.5、MindCube 88.3、SPAR 72.4、MMSI-Video 56.4、ReVSI 82.3,全部高于 pySpatial、SpaceTools、S-Agent、SpatialClaw 四个代理基线。(4) 工具增益随骨干变强而缩水但不消失(Table 5):Qwen 无工具 61.8/52.6(ReVSI/MMSI)→ 加工具 82.3/66.5(+20.5/+13.9);Gemini 无工具 80.9/62.9 → 加工具 90.5/74.1(+9.6/+11.2);对比之下 SpatialClaw 在 Gemini 上的 ReVSI 增益从 Qwen 的 +13.2 缩到 +2.7。(5) 接口消融(Table 6):去模型感知接口掉最多(MMSI 57.7/−8.8,ReVSI 76.4/−5.9),去场景记忆次之(−3.5/−2.5),去解读读数最少(−1.3/−1.2),与「表面是解读错、底下是证据没被用上」的诊断一致。(6) 定性分析(Figure 4):SpatialClaw 调对工具、拿到正确掩码与坐标,却因右手定则实现反了或被二次看图推翻而答错;S-Agent 2.0 在同骨干同感知后端下全部答对,剩余失败集中在「想象视角借用错误朝向」与「把离地高度当作物体自身高度」两类接地错误。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MMSI-Bench 多视角空间推理(Qwen3.8-27B 骨干) | 总体准确率 (%) | 66.5 | SpatialClaw 62.6;无工具编码代理 52.6;GPT-6 71.0 | 较 SpatialClaw +3.9 pp;较无工具 +13.9 pp |
| MMSI-Bench(Gemini-3.8-Flash 骨干) | 总体准确率 (%) | 74.1 | SpatialClaw 67.0;无工具 62.9 | +7.1 pp / +11.2 pp,全表最高 |
| ReVSI 视频空间推理(Qwen3.8-27B) | 官方协议宏平均 (%) | 82.3 | SpatialClaw 74.5;无工具 61.8 | +7.8 pp / +20.5 pp |
| ReVSI(Gemini-3.8-Flash) | 宏平均 (%) | 90.5 | SpatialClaw 79.7;GPT-6 84.2 | +10.8 pp,全表最高 |
| ReVSI 相对方向 / 路线规划(Qwen 骨干) | 分题型准确率 (%) | 95.2 / 94.4 | SpatialClaw 77.8 / 72.2 | +17.4 / +22.2 pp |
| MindCube / SPAR-Bench / MMSI-Video-Bench(Qwen 骨干) | 准确率 (%) | 88.3 / 72.4 / 56.4 | SpatialClaw 83.2 / 70.2 / 53.1 | +5.1 / +2.2 / +3.3 pp |
| 接口组件消融(Qwen 骨干) | MMSI / ReVSI (%) | 完整系统 66.5 / 82.3 | 去模型感知接口 57.7 / 76.4;去场景记忆 63.0 / 79.8;去解读读数 65.2 / 81.1 | 模型感知接口贡献最大(−8.8 / −5.9 pp) |
| SpatialClaw + 移植本文读数函数(附录 D) | ReVSI / MMSI (%) | S-Agent 2.0 完整系统 82.3 / 66.5 | SpatialClaw 74.5 / 62.6;SpatialClaw+读数 75.5 / 62.9 | 读数移植仅 +1.0 / +0.3,证明增益来自接口整体 |
| 跨 harness 泛化(Qwen 骨干) | MMSI / SPAR / ReVSI (%) | OpenHands 66.5/72.4/82.3;Codex 67.0/71.8/76.6;Claude Code 63.8/72.8/79.1 | 同骨干 SpatialClaw MMSI 62.6 | 三个 harness 均领先专用系统 |
局限与改进
作者承认的局限(§3.4):闭环建成后,剩余错误集中在「接地」环节两类——一是想象视角模拟失败,注册观察者时借用了错误朝向(如问题说「走下楼梯区域」,代理把观察者钉在墙上且朝向相机,导致 TV 被判为「右后方」而真值是「右前方」);二是量测语义读错,问题问物体自身的竖直高度(vertical height),代理测了离地高度(elevation above floor),「chandelier 比 chair 高 1.15 m」比较的是位置而非物体自身尺寸。我观察到的其他局限:绝对距离题型仍输给 SpatialClaw(ReVSI −2.8/−1.7 pp),暴露度量尺度标定(依赖 --known 手动校准或重建自身尺度)不可靠;工具增益随骨干增强明显缩水(Qwen ReVSI +20.5 → Gemini +9.6),暗示前沿模型内化空间能力后接口价值会下降;重建优先路线对每题都付全量重建成本,且 recon 依赖 Depth Anything 3 的质量,只有粗粒度的 overlap_warning 报警而缺乏置信度量化;效果与编码代理 harness 的上下文管理强耦合(附录 D 移植读数到 SpatialClaw 几乎无收益);此外所有评测集中在室内多视角/视频基准,户外大尺度与真实机器人闭环未验证,延迟与 API 成本也未报告。
独立分析的弱点
独立分析出五个弱点。其一,对重建质量强依赖:recon 一次失败或重力/尺度估计偏差会污染所有后续读数,系统只有 overlap_warning 这类粗报警,缺乏重建置信度量化与多假设融合——改进方向是按置信度加权融合多个重建后端,或允许代理对可疑区域做局部重重建。其二,绝对距离短板:尺度未经 --known 校准时读数只给「重建自身尺度」的相对值,房间大小类问题直接受限——可引入常见物体先验(门高约 2 m、椅高约 0.45 m)自动标定尺度。其三,观察者朝向仍靠模型想象:add_instance 的 --facing 取值由模型决定,Figure 4 显示「借用朝向」是剩余主要错误源——可让工具返回候选朝向列表加一致性检查(compass 已有按拟合度排序的雏形),或从问题文本结构化解析方向约束后自动验证。其四,成本不透明:Figure 5 显示一次 episode S-Agent 2.0 发 12 个感知调用、ReVSI 上 Gemini 平均开 11.43 次帧查看,但全文未报告单题延迟、GPU 时耗与 token/费用,实用部署成本无法评估。其五,评测域偏窄:五个基准均为室内或近景场景的静态推理题,未覆盖户外驾驶尺度、遮挡密集场景与需要实时性的机器人控制闭环;工具包的闭式读数假设物体是刚体且点云分割干净,可变形物体、透明与反光表面(文中 drop 反射掩码的案例恰好说明此问题常见)仍是薄弱点。
未来方向
作者提出的方向:剩余「接地」失败(想象视角、量测语义)可通过工具侧的结构化验证机制缓解,例如 compass 的多候选一致性提示已是雏形;跨 harness 的成功说明值得继续研究接口设计原则本身——哪些 CLI 语义要素真正带来增益。基于其成果可延伸:其一,把「证据闭环」接口模式移植到其他感知域——时间推理、物理常识(力与稳定性)、可操作性与 affordance 判断,只需替换工具包;其二,与强化学习结合:SpaceTools 已证明 RL 能教会模型协调固定工具集,在编码代理 harness 上做 RL 可让模型学会更聪明的工具组合与调用时机策略,弥补增益随骨干增强而缩水的趋势;其三,记忆扩展:场景记忆目前按 episode 重建,可扩展为跨 episode 持久化记忆(多房间、多楼层导航、跨视频实体追踪),并与 MMSI-Video-Bench 的 cross-video memory 题型对接;其四,尺度自标定与置信度估计:解决绝对距离短板,让每个读数自带误差棒,代理据此决定是否需要补充测量;其五,主动感知:由信息增益驱动「下一步看哪/测哪」的决策,减少不必要的全量重建;其六,把模型感知接口(add_instance/drop)与开放词汇 3D 检测结合,降低对人工提示词的依赖。
复现评估
复现条件较好。开源情况:代码与全部报告运行(包括所有主表和消融)的完整轨迹公开于 https://ropedia.github.io/S-Agent-2.0;附录 B 用 Table 7 完整文档化命令行接口(每条命令的参数语义、对场景记忆的读写效果、回复格式),附录 C 给出每命令调用频次统计(Table 8),附录 B 还逐字给出回复 JSON 样例,接口层面几乎无黑盒。数据与模型:评测全部使用公开基准(MMSI-Bench、ReVSI、MindCube、SPAR、MMSI-Video 各有官方协议),感知后端全部是现成冻结模型——Depth Anything 3、SAM 3、GeoCalib、π3mos,无需任何训练;骨干 Qwen3.8-27B 以 FP8 本地部署,Gemini-3.8-Flash 走 API,harness 用开源的 OpenHands 即可复现主线结果。算力需求:FP8 下 27B 模型大约需要单卡 80 GB 或等效双卡推理环境,另加感知模型的 GPU;评测量大(MMSI 与 ReVSI 各 1000 题、每题数十个 agent 步与多次感知调用),API 费用与时间成本不低。综合难度评级:中等偏低——无需训练与调参,工程集成(OpenHands + 工具服务 + 感知模型)是主要工作量;轨迹公开使得结果校验与失败分析非常方便,是很好的复现实践。
论文图表
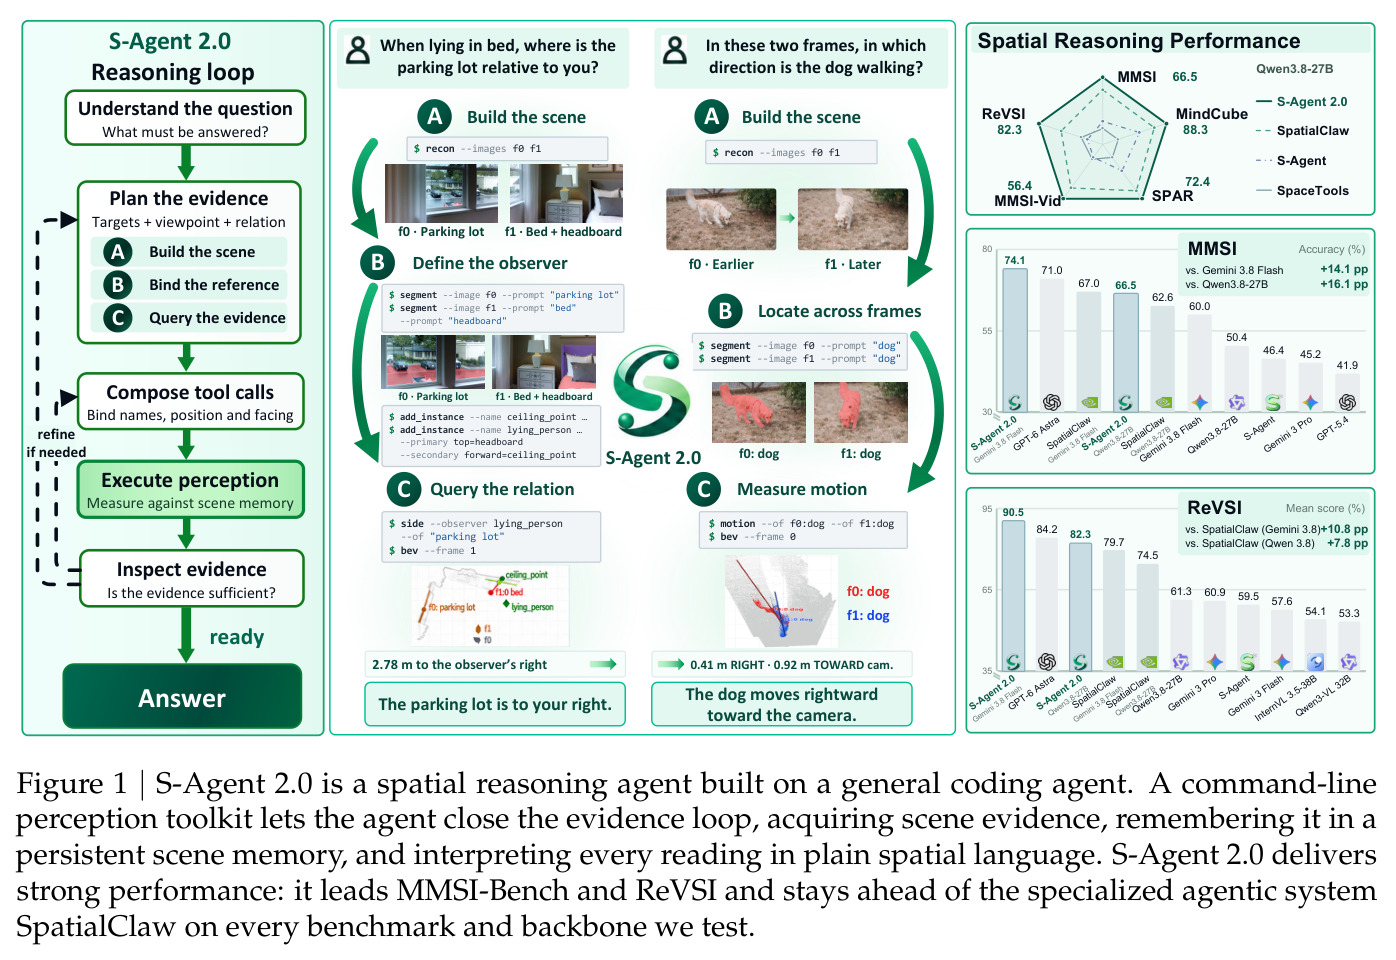
首页导览图。上半部分展示两个例题(「躺在床上时停车场在你哪个方向」「两帧中狗朝哪个方向走」)的推理回路:建场景→定观察者→跨帧定位→查询证据;下半部分用柱状图汇总性能:S-Agent 2.0 在 MMSI-Bench 达 66.5/74.1、ReVSI 达 82.3/90.5(Qwen3.8-27B 与 Gemini-3.8-Flash 两种骨干),在每个基准和每个骨干上都领先专用系统 SpatialClaw。
一图总览方法直觉与 headline 结果,包括 +14.1/+16.1/+20.5 等关键增益数字,是快速把握全文的最佳入口。
五基准代理系统横评(Qwen3.8-27B):pySpatial(36.3/66.3/42.1/26.9/39.3)、SpaceTools(43.2/58.6/55.3/39.3/64.4)、S-Agent(48.3/75.5/63.0/37.9/59.5)、SpatialClaw(62.6/83.2/70.2/53.1/74.5)、S-Agent 2.0(66.5/88.3/72.4/56.4/82.3),在 MMSI、MindCube、SPAR、MMSI-Video、ReVSI 五个基准全部第一。
证明「五基准通吃」的普适性主张:不是单一基准的调优结果,而是对四代代理式方法的一致领先。
换 harness 实验:同一工作空间与工具包分别跑在 OpenHands(MMSI 66.5 / SPAR 72.4 / ReVSI 82.3)、Codex(67.0/71.8/76.6)、Claude Code(63.8/72.8/79.1)上。三个生产级编码代理各有自己的 agent 循环、提示与上下文管理,结果均领先专用系统,波动在几个点内。
支撑贡献一「方法跨 harness 有效」:证明可迁移的是接口设计而非某个特定控制器的实现细节。
案例 4:判断相机前进还是后退。SpatialClaw 正确算出相机系 $d_{fwd}=-11.62$ m,却在 step 2 被坐标轴方向困惑、step 3 又被路面箭头「移向画面下方」的视觉直觉带偏,答 Forward 错;S-Agent 2.0 仅 2 个调用:motion 返回「从 camera:f0 到 f1 相机向后移动 10.85 m、左偏 0.28 m、下降 0.74 m、航向保持(转向 <3 度)」,答 C 正确。
这是「正确的数字+错误的坐标系解读」最干净的例子,附录原文用它说明解读应由掌握几何的一方完成。
案例 5:SpatialClaw 算出方位角 −27.12 度(前左),但 vlm.ask 的视觉推断和「Ego4D 数据集里朝目标走都标 Forward」的先验把正确答案覆盖成 D;S-Agent 2.0 的 motion 给出「前进 0.74 m、左偏 0.32 m、上升 0.67 m、顺时针转 8 度」并注明「观察者是相机,参照系为重力对齐地面航向」,side 复核确认 front-left,答 C 正确,共 3 个调用。
展示「正确读数被无关理由丢弃」的失败形态,以及本文回复中 note 字段(声明参照系)对防止模型再解读的作用。