从RL论文到框架代码:七个开源训练框架中的方法收录与评审 From RL Papers to Framework Code: Inclusion and Review in Seven Open-Source Training Frameworks
七个开源RL框架仅收录2.3%的通用方法,收录快但份额随论文激增而稀释。
前置知识
RL 后训练(RL post-training)
在预训练完成后用强化学习继续训练语言模型,使其对齐偏好或提升推理能力。典型流程:对每个提示采样多条回答,由奖励模型或规则打分,再用 PPO/GRPO 等策略梯度算法更新参数。verl、TRL、OpenRLHF、slime 等框架把这套流程封装成可配置的训练循环,方法一旦被收录,用户改一个配置项即可启用。
全文度量的就是这类方法从 arXiv 论文进入框架 main 分支的比例,不理解后训练的工作方式就无法理解『收录』对从业者的实际意义。
重要性采样比与裁剪目标
PPO 类算法复用旧策略采样的数据,需用比值 $r_t(\theta)=\pi_\theta(o_t|q)/\pi_{\text{old}}(o_t|q)$ 校正分布差异,并以裁剪目标 $\min(r_t\hat{A}_t,\ \text{clip}(r_t,1-\epsilon,1+\epsilon)\hat{A}_t)$ 限制单步更新幅度。clip-higher、GSPO、TIS/MIS 等被广泛收录的方法都是对这个比值或其系数的小改动。
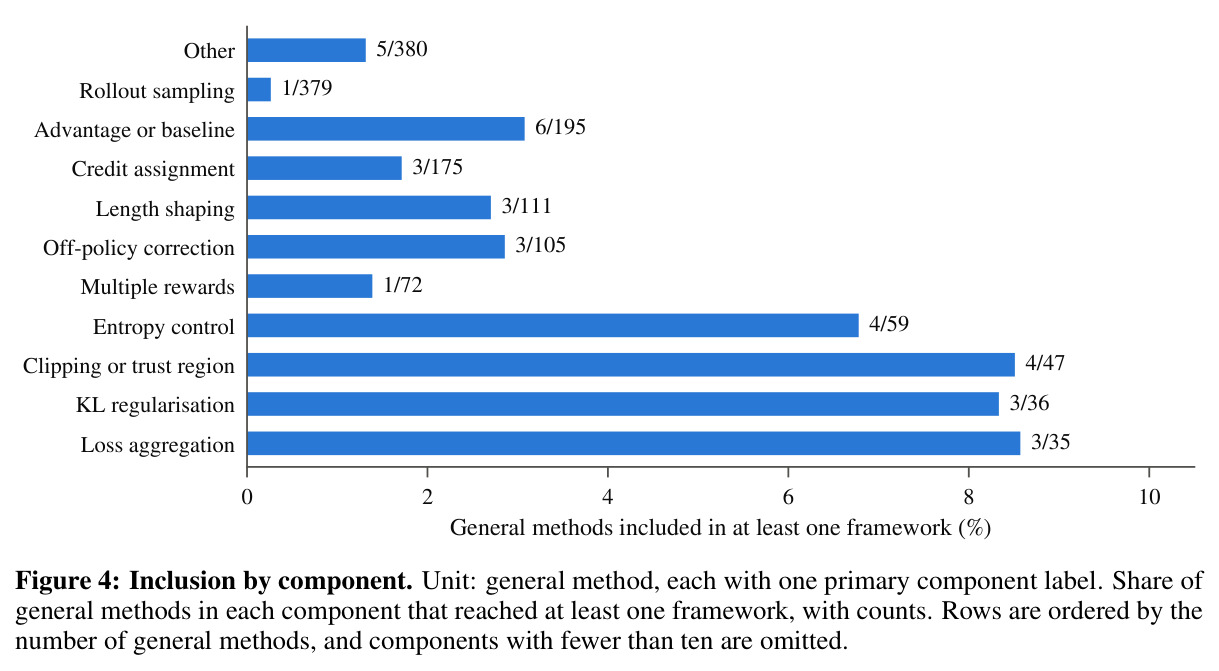
论文发现收录方法中 29% 是对现有损失的系数、裁剪、掩码或权重的修改,看懂这个比值才能理解『小改动』的确切含义。
GRPO 与组内相对优势
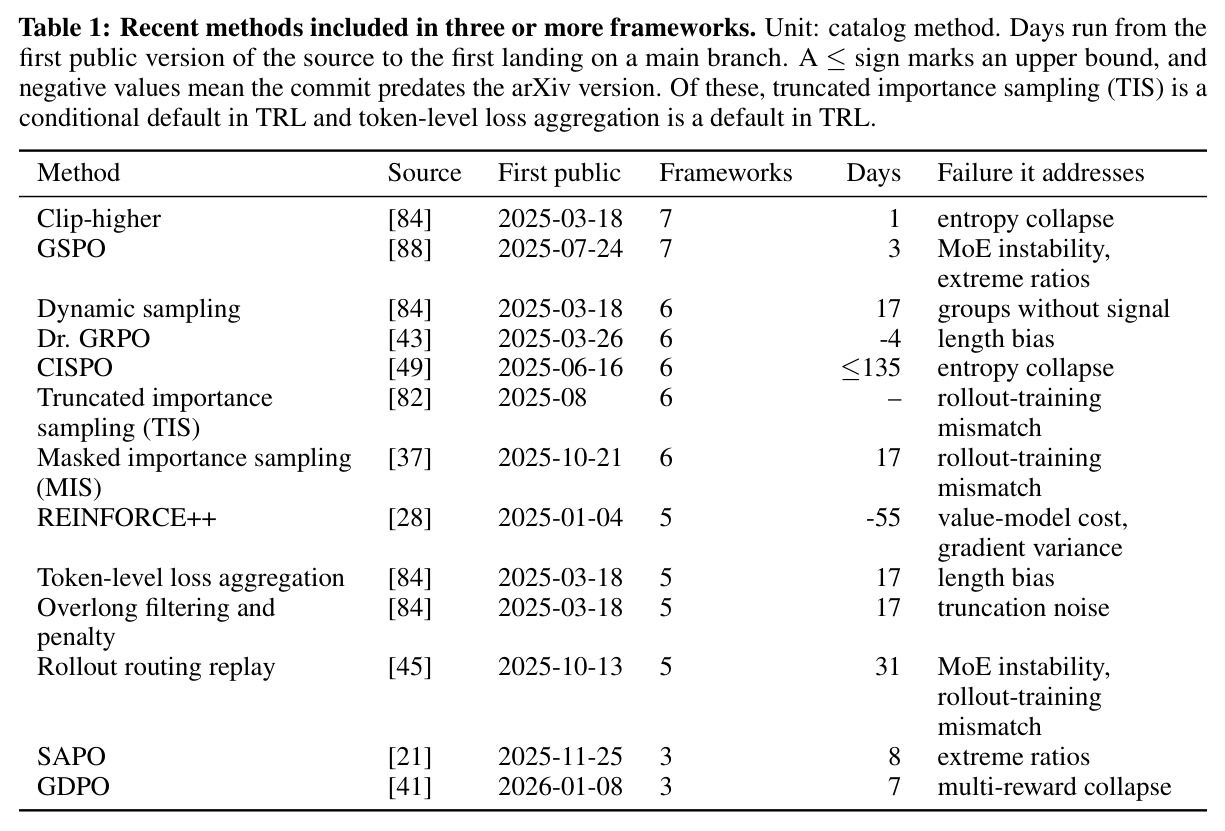
GRPO 去掉 PPO 的价值模型,对每个提示采一组回答,用组内奖励归一化得到优势 $\hat{A}_i=(r_i-\bar{r})/\mathrm{std}(r)$,直接做策略梯度更新。DAPO 的动态采样与 clip-higher、Dr. GRPO 的长度去偏、token-level loss 都是在 GRPO 框架上的修补,正是 Table 1 中收录最广的方法家族。
2025–2026 年的 RL 论文大多以 GRPO 变体形式提出方法,论文的 65 方法目录和收录榜几乎全部围绕这一家族展开。
RL 训练失败的常见模式
长程 RL 训练反复出现的不稳定现象:熵坍缩(策略过早收敛、探索消失)、回复长度漂移、MoE 路由不稳定、重要性比值极端化、rollout 与训练概率失配(采样引擎与训练引擎的数值实现不一致)。Table 1 里每个被广泛收录的方法都标注了它所针对的失败类型。
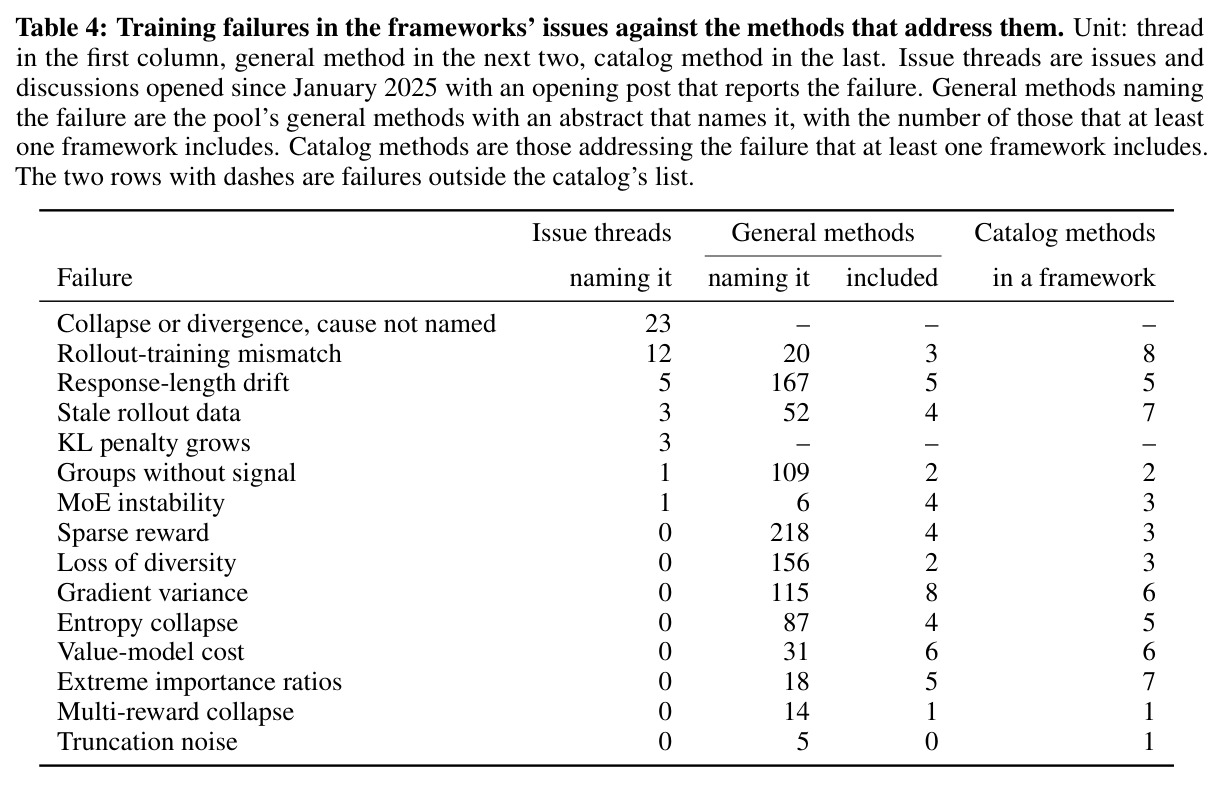
论文按『方法解决哪种失败』组织目录,并用 issue 中的失败报告与论文摘要声称解决的失败做错位对比(Table 4)。
main 分支与 PR 评审流程
开源项目的贡献路径是 fork → pull request → 维护者 review → 合入 main 分支,issue 是公开的 bug 报告与功能提议区。本文把『收录』严格定义为方法实现出现在框架 main 分支的第一次提交,并据此逐提交解析历史、统计 PR 的发起者身份、评审 concern 与开放时长。
收录率、426 个收录事件、评审记录和提议去向等全部核心指标都建立在 main 分支历史与 PR/issue 记录之上。
研究动机
RL 后训练方法正以前所未有的速度产出:2026 年上半年每个月至少有 144 篇论文提出新的 RL 训练方法。从业者使用这些方法的实际途径是 verl、TRL、OpenRLHF 等训练框架——被框架收录的方法,用户改一行配置就能启用;没被收录的方法则要自己实现、自己维护分叉。『论文发表 → 附代码开源 → 框架收录』是三个相互独立的关口,而已有研究只度量了前两步:产业界份额、代码可得性与引用量的关系、论文附代码仓库的 fork 行为,从未有人测量第三步。与此同时,框架 issue 区的用户需求信号极其稀薄:七个框架 2025 年以来的 7,075 条 issue/讨论中只有 48 条报告训练失败,59 条方法请求分布在 21 个月里,最热门的 DAPO 动态采样也只有 8 条请求。作者不知道自己的方法为何落选,维护者也缺乏可见的需求依据,这个信息真空正是本文要填补的对象。
本文的目标是本文的目标是首次系统量化『框架收录』这个从未被度量的环节,回答四个递进的问题。第一,收录率:以 2025 年 1 月至 2026 年 6 月 arXiv cs.LG/cs.CL/cs.AI 三个分类筛出的 6,939 篇 RL 论文为分母,其中 1,598 篇提出通用 RL 训练方法,有多少进入了 verl、TRL、OpenRLHF、NeMo-RL、ROLL、slime、AReaL 七个开源框架的 main 分支?第二,速度与趋势:从论文首发到收录滞后多少天,收录量随论文供给增长 5.4 倍如何变化?第三,差异:被收录的方法与落选的方法在实验规模、改动形式、失败动机等特征上有何系统性不同?第四,过程:未收录的方法在框架的 26,960 条 issue/PR/讨论中留下了什么痕迹,是被公开拒绝还是从未被提及?最终把全部数据发布为每周自动更新的 tracker(rl-method-tracker),作为作者与维护者的公共基础设施。
与已有工作不同的是,三条已有研究线都没有触及本文的对象。产业界与学术界关系研究停留在论文和主题层面;可复现性研究(如 PPO 的 37 个实现细节、大规模对照比较)问的是『方法是否有效』;开源贡献研究解释 PR 合并的一般规律(少数因素决定合并、拒绝很少出于技术原因)。本文的独特切入是把分析单位从『论文』或『代码贡献』缩到『论文提出的方法』:框架里同一方法的名字五花八门(clip-higher 在 verl 叫 clip_ratio_high、TRL 叫 epsilon_high、slime 叫 eps-clip-high),作者构建 65 个方法的目录把它们归一映射,逐提交解析收录事件,再用框架源码中的 arXiv 引用做审计补漏(解析只找到 28 个被实现的方法,审计后为 51 个)。这使收录率、收录速度、方法特征、公开评审记录四个维度能在同一框架下交叉观察,是此前任何研究都没做到的。
核心方法
整篇论文是一项测量研究,技术上由四条流水线组成。第一条构建论文池:通过 arXiv OAI-PMH 接口抓取 139,135 条 cs.LG/cs.CL/cs.AI 元数据(编号 2501–2606),按标题与摘要中的语言模型+强化学习关键词(含 RL、RFT 缩写)筛出 6,939 篇,用固定规则打上七类标签,其中 2,235 篇提出 RL 训练方法、1,598 篇提出面向一般场景的『通用』方法。第二条解析框架:对七个框架 main 分支的每个提交解析算法注册点(verl 的注册器、TRL 的 loss_type 字段、AReaL 的每算法示例配置等),得到 426 个选项事件,映射到 65 个方法的目录并记录收录层级(默认/条件默认/核心选项/开关/实验代码/示例配方)。第三条是引用审计:在框架全历史中搜索池内论文的 arXiv 编号,找到 51 个被引用的通用方法,其中 9 个补入目录。第四条检索公开记录:下载全部 26,960 条 issue/PR/讨论,匹配每个方法的痕迹;另在 7,075 条 issue 中筛出 648 条候选并人工确认训练失败报告。
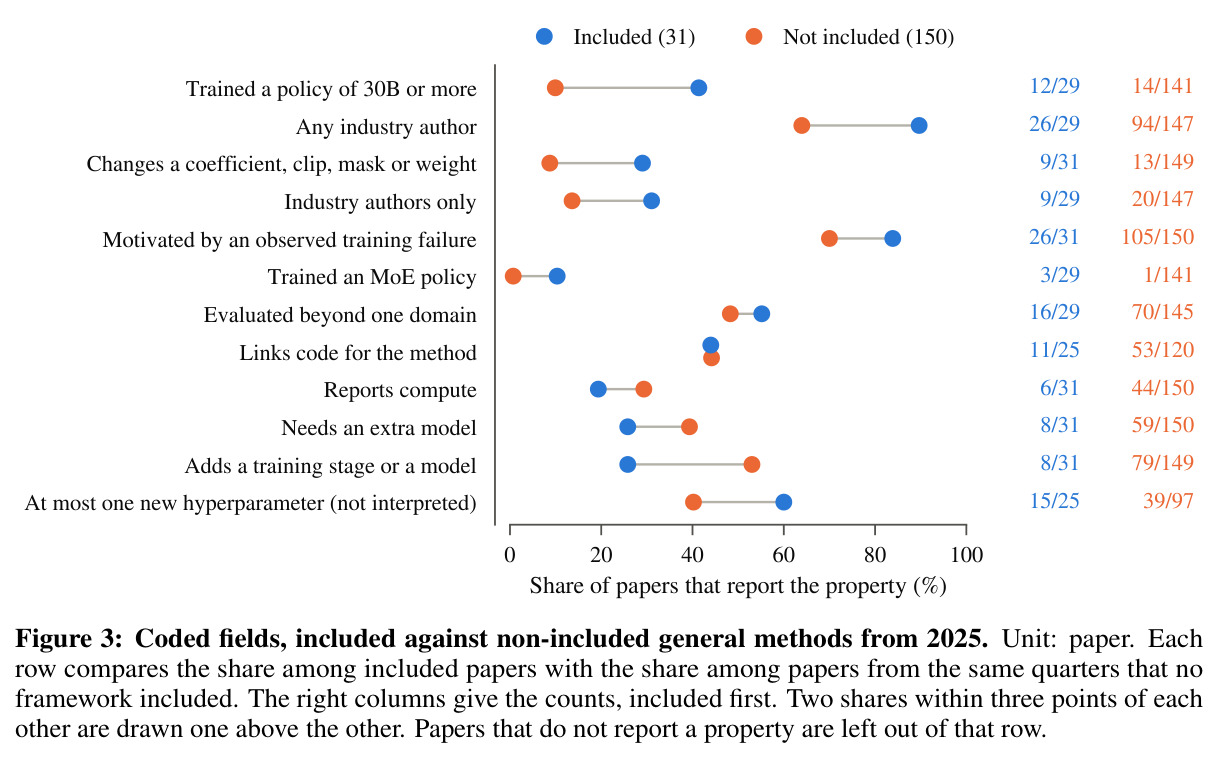
核心创新是把『收录』定义为一个可复现、可审计的代码级事件:某方法的实现选项第一次出现在框架 main 分支上的提交,而非引用量或访谈这类软指标。围绕这个定义有三个关键设计。其一,方法目录归一化:同一方法在不同框架中名字完全不同(clip-higher 在 verl 叫 clip_ratio_high、TRL 叫 epsilon_high、OpenRLHF 叫 eps_clip_low_high、slime 叫 eps-clip-high),65 条目的目录加『解析器发现未映射选项即构建失败』的校验,保证跨框架可比且新增需人工审核。其二,引用审计兜底:解析器只能看到注册点,作者又在框架全历史中搜索 arXiv 编号,把藏在注释、改名提交和非标准位置的实现捞出来(解析 28 个,审计后 51 个,其中 9 个确认有实现)。其三,多层对照与敏感性分析:同季度随机抽取 150 篇未收录论文做盲编码对照,排除框架维护公司论文、只看有产业作者论文等子集复检,用来区分『方法本身的特点』与『公司关系』的贡献。
方法步骤详情
第一步,构建论文池:抓取 139,135 条 arXiv 元数据,筛出 6,939 篇;三项校验保证标签质量——识别校验 29/30 个收录来源被标为方法、稳定性校验 140 篇重标 129 次一致、通用性规则在 200 篇分层样本上 188 次一致(加权估计通用方法约 1,590 个)。第二步,解析框架历史:逐提交解析七个框架的算法注册点,产出 426 个事件,快照日期 2026 年 10 月 13–17 日。第三步,引用审计:全历史搜索 arXiv 编号,51 个通用方法被框架文件引用,9 个有实现佐证者补入目录。第四步,确定日期与作者:收录日期取 main 分支提交时间(bulk release 记为上界),比对提交作者与论文作者列表,用 prior merger(曾合并过 PR 者)代理维护者。第五步,特征编码:对 2025 年 31 篇收录论文与 150 篇同季度随机对照盲编码 12 个字段。第六步,公开记录分析:26,960 条线程按 arXiv 链接/编号/标题匹配并逐条编码 48 条提议线程;7,075 条 issue 的 648 条候选中人工确认 48 条失败报告。
技术新颖性
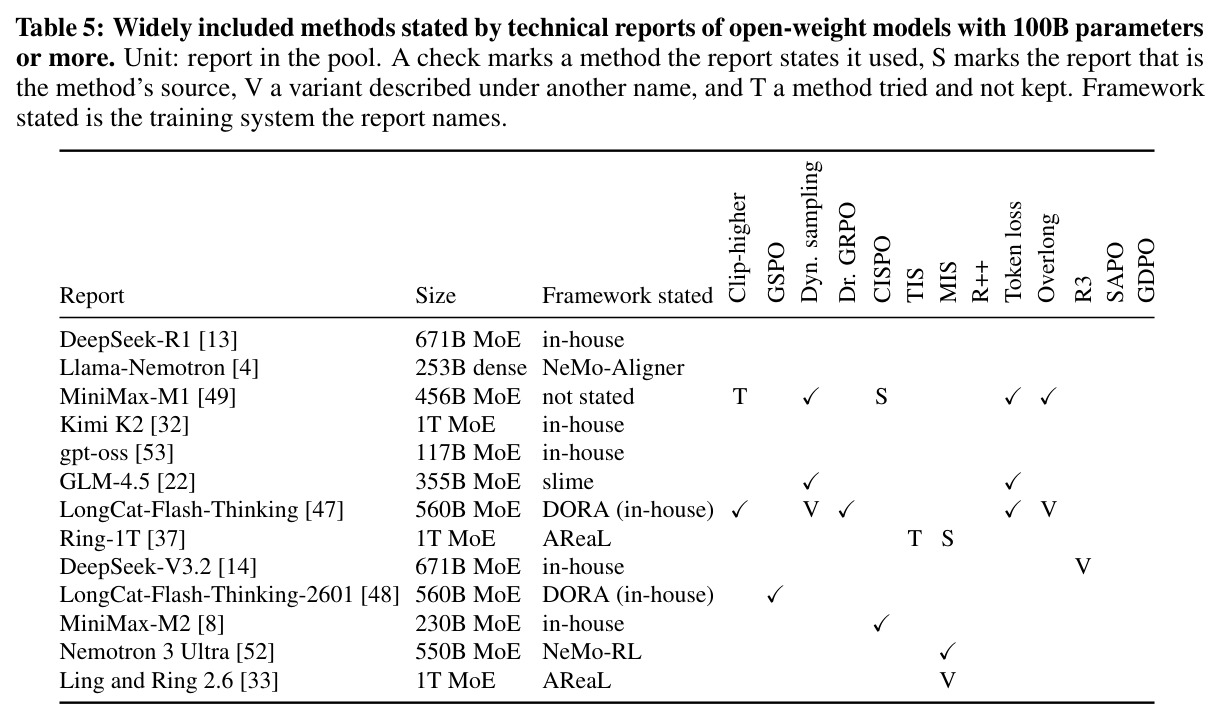
本文的新颖性不在算法而在测量设计。第一,它是第一个把『方法被框架收录』当作研究对象的工作,此前最接近的只有论文附代码的 fork 行为研究,而收录才是从业者真正消费方法的方式。第二,方法目录加『未映射即构建失败』的解析器设计解决了跨框架同名异写问题,使逐提交追踪成为可能,且作者明确指出这套『论文版本+实现历史+公开提议』的三件套可迁移到任何有共享训练或评测代码的领域。第三,把框架的 issue/PR 当作『需求的公开记录』来读,发现了一个反直觉的结构性空白:96% 的未收录方法(1,500/1,561)在七个框架的公开讨论中零痕迹,被公开拒绝的仅 12 个——沉默而非拒绝才是常态。第四,用 13 份 100B+ 开源模型技术报告做第三方验证:报告声明了 13 个广泛收录方法中的 8 个,且被六七个框架收录的稳定器正是报告声明的那些,为『框架代码反映真实训练实践』提供了独立证据链。
实验结果
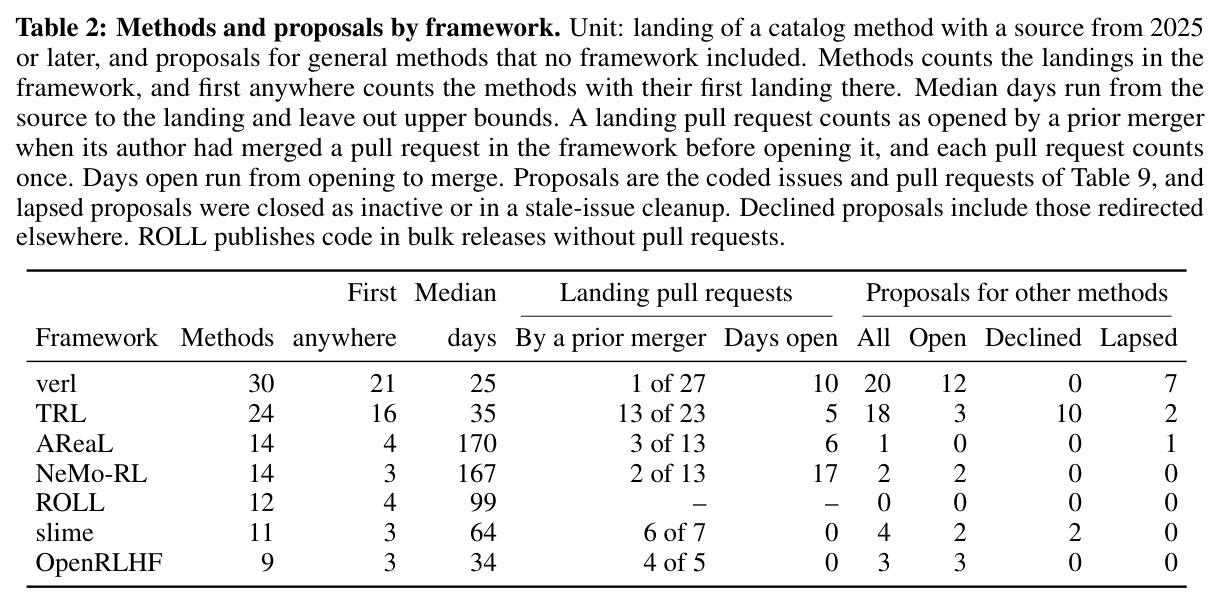
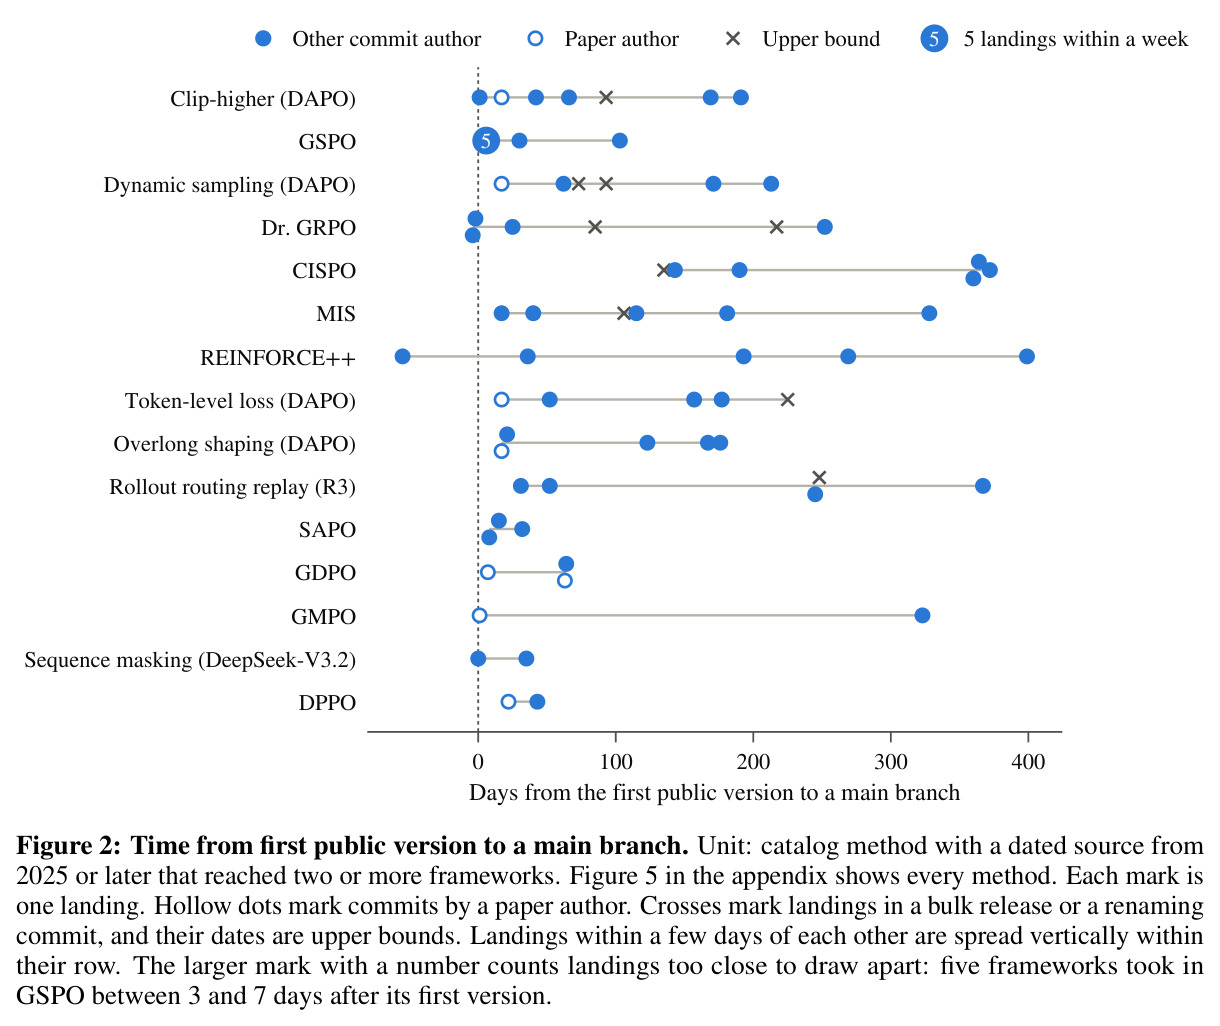
五个核心数字。① 收录极稀少:1,598 个通用方法中仅 37 个(2.3%)进入至少一个框架,7 个进入三个以上,1 个成为默认;补查另外四个同标准框架也只到 2.4%。② 收录快但份额在稀释:49 个精确首次收录中位滞后 30 天,GSPO 3 天进 5 框架、clip-higher 1 天进 7 框架;季度队列从 72 涨到 386 篇(5.4 倍)时,180 天收录数停在 5–7 篇,份额从 6.9% 跌到 1.3%。③ 收录方法有两个统计特征:41% 训练过 ≥30B 策略(对照组 10%),29% 修改现有损失的系数/裁剪/掩码/权重(对照组 9%);两组代码开源率相同(44%)。④ 公开记录近乎空白:1,561 个未收录方法中 1,500 个(96%)在公开线程零痕迹,被明确拒绝的仅 12 个;17 条开放 PR 中位等 196 天无维护者回复。⑤ 失败报告稀薄且错位:7,075 条 issue 仅 48 条报告训练失败,论文最常声称的稀疏奖励(218 个方法)与多样性损失(156 个)零报告;13 份 100B+ 模型报告声明了 8 个广泛收录方法。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 通用 RL 方法的框架收录率 | 收录方法数 / 通用方法总数 | 2.3%(37/1,598),其中 7 个进入 ≥3 个框架,1 个无条件默认 | 同期论文供给:季度队列从 72 篇增长到 386 篇(5.4 倍) | 收录量停滞在每季度 5–7 篇,180 天收录份额从 6.9% 降至 1.3% |
| 收录 vs 未收录论文:大规模实验 | 训练 ≥30B 参数策略的论文占比 | 41%(12/29) | 未收录对照组 10%(14/141) | 31 个百分点差距;排除维护公司论文后仍为 6/19 vs 9/119 |
| 收录 vs 未收录论文:改动形式 | 修改现有损失系数/裁剪/掩码/权重的占比 | 29%(9/31) | 未收录对照组 9%(13/149) | 20 个百分点差距;新增训练阶段/模型反而更低(26% vs 53%) |
| 收录速度 | 首个 arXiv 版本到 main 分支的中位天数 | 30 天(49 个精确首次收录;按论文计 30.5 天/42 篇) | 未收录方法无收录日期可比 | clip-higher 1 天进 7 框架、GSPO 3 天进 5 框架;最慢的 CISPO ≤135 天 |
| 公开拒绝率 | 被维护者明确拒绝/转向的未收录方法数 | 12 / 1,561(约 0.8%) | 96%(1,500 个)未收录方法在公开线程中零痕迹 | 表明瓶颈是『无人提议』而非『被拒绝』;另有 25 个实现 PR、15 个请求 |
局限与改进
作者坦承的局限:收录不等于使用,只观察 main 分支实现而不知道使用频率与效果;分子是下界,解析点之外及采样/奖励逻辑中的实现无法覆盖;论文池只来自三个 arXiv 分类,是筛查集而非普查;另有 4 个符合条件的框架未纳入;Section 6 的特征比较是观察性且样本小(31 vs 150),公司归属只按论文首页署名匹配到公司级;聊天群和内部仓库不可见;ROLL/AReaL 大量代码走 bulk release 无 PR 记录;线程文本可被事后编辑;全部线程由单一读者编码;失败报告只读标题和首帖,23 条未指明原因的崩溃可归属任何类别;13 份模型报告只覆盖 9 家机构,报告与框架代码的重叠不能证明影响方向。我的补充:37 个收录样本使所有亚组分析(如排除维护公司后仅 19 vs 119)统计功效很弱;『30B+ 实验』与产业背景高度共线(收录组 90% 有产业作者),残余混杂难以排除;2.3% 对『通用方法』的标注规则敏感(按正文判定会降到 2.1%)。
独立分析的弱点
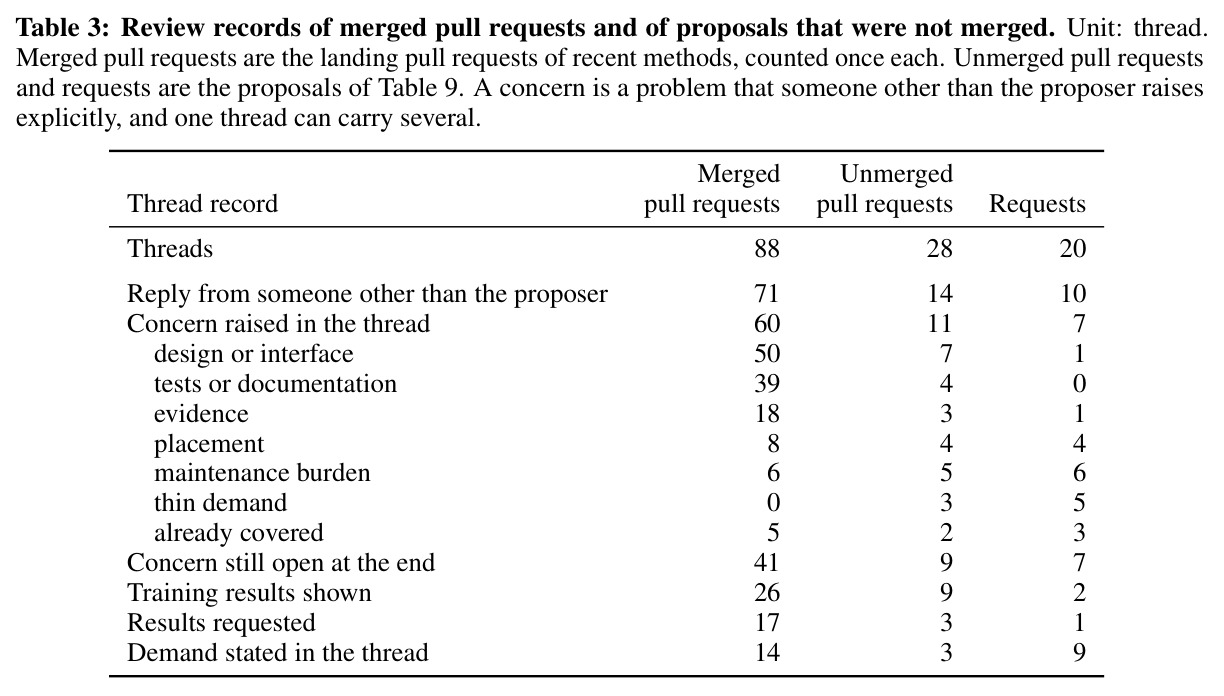
① 通用性判定依赖标题+摘要:作者自己的抽样显示 30 份方法类技术报告中有 25 份只在正文描述可迁移组件,若按正文判定,分母将上升约 13%、收录率降到 2.1%——标题数字 2.3% 对标注规则敏感,全文级的判定会更可靠。② 单一编码者:评审线程与失败报告全部由一人编码,只有标签层面的双重标注一致性(129/140、188/200),没有对『concern 属于 design 还是 demand』这类主观判断的 inter-rater 检验,而 Table 3 的核心结论恰恰依赖这个区分。③ 收录层级跨度太大:experimental code 与 unconditional default 都算『收录』,37 个收录中不少只是示例配方,若只算核心选项以上,比率会更低,但论文未给出该口径的数字。④ 因果解释缺位:30B+ 与损失微调为何导致收录只能给关联,对维护者的访谈或对 PR 文本的回归可以把『信号』做实。⑤ tracker 依赖每周重放 main 分支,框架重构(改名、目录迁移)会破坏解析,长期维护存在脆弱性。
未来方向
作者明确提出的延伸:其他拥有共享训练或评测代码的领域可以复用『论文版本+实现历史+公开提议』这套测量;tracker 每周自动重跑、开放纠错表单,有潜力长成社区基础设施。基于本文成果可继续做的:① 把 Section 6 的关联升级为因果研究,例如对被拒后修改再提交的配对样本做事件研究,或访谈 verl/TRL 维护者还原真实决策链;② 把收录细化为 tier 时间序列,观察 experimental→core 的晋升率与回撤率(本文只知 4/114 的收录被移除);③ 纳入 open-instruct、SkyRL、prime-rl、RLinf 四个同标准框架,并把 rollout-training 失配的修复追溯到 vLLM/SGLang 等推理引擎侧;④ 扩大技术报告池到 100B 以下,用『报告声明』做真实使用率的更细代理;⑤ 对 23 条未指明原因的崩溃 issue 做全文聚类,弥补『用户不命名失败』的记录缺口;⑥ 研究 41 个带未解决 concern 仍被合并的 PR,刻画开源 RL 生态的真实质量门槛。
复现评估
复现条件在实证研究中属于极好的一档:数据与代码发布在 GitHub(pth2002/rl-method-tracker),并存档于 Zenodo(doi:10.5281/zenodo.23495743),附 checksum 清单;release 固定了样本、标签、全文编码和框架 commit,一条命令即可离线复现报告的全部数字、表格和图。每周任务自动拉取七个框架、重放提交历史、对 arXiv 校验来源并开 PR,未映射选项会使校验失败,需人工审核后才进索引——这是可维护性的关键设计。算力需求几乎为零:全部是 git 历史解析、文本检索和人工编码,没有任何 GPU 训练;主要成本是人工(约 26,960 条线程的检索、648 条候选与 88+48 条线程的人工编码)。难点有三:框架 API 变动后解析器需跟着改;Zenodo 存档是 2026 年 10 月快照,之后的收录变化要看在线 tracker;若迁移到其他领域,需重建方法目录和注册点解析,工作量主要在领域知识而非工程。
论文图表
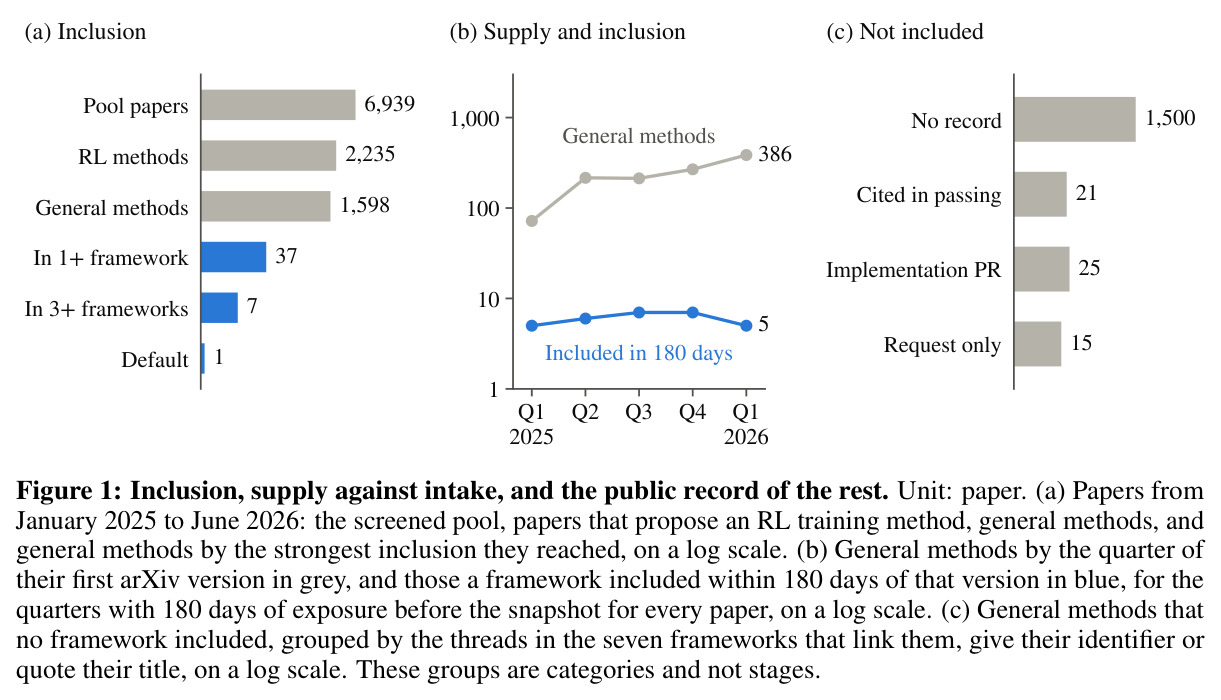
三联图。(a) 收录漏斗(对数刻度):6,939 篇筛查池 → 2,235 篇提出 RL 方法 → 1,598 篇通用方法 → 37 个进入 ≥1 框架 → 7 个进入 ≥3 框架 → 1 个默认。(b) 供给与摄入:灰色为各季度通用方法数(72→386),蓝色为 180 天内被收录数(稳定在 5–7)。(c) 1,561 个未收录方法的公开痕迹:1,500 个无记录、21 个顺带引用、25 个有实现 PR、15 个仅有请求。
一张图浓缩了全文的三个核心结论——收录率 2.3%、供给增长 5.4 倍而摄入停滞、96% 的方法从未进入公开讨论——是论文的摘要性证据。