HarnessRL:用即时演化的训练外壳与策略共同进化的开放式强化学习 HarnessRL: Co-Evolving Policies with a Just-in-Time Training Harness for Open-Ended RL
训练外壳与策略共同演化:归因并修复rubric奖励失效,开放式RL涨3分且训练减半。
前置知识
GRPO(Group Relative Policy Optimization,组相对策略优化)
DeepSeek 提出的 LLM 强化学习算法:对每个任务从当前策略采样一组 $J$ 个响应,用组内奖励均值与标准差计算组相对优势 $\hat{A}^{(j)} = (r^{(j)} - \mu)/(\sigma + \epsilon_A)$,无需价值网络;再用 PPO 式裁剪代理目标更新策略,并加 KL 项锚定参考策略。
本文的 RL 目标就是扩展版 GRPO(式 2),在任务损失上乘以重要性权重 $u_t$;所有基线与消融也都建立在 GRPO 之上。不理解组相对优势,就无法理解论文反复强调的『饱和组不携带任何优势信号』这一奖励失效根源。
Rubric 奖励(Rubrics as Rewards)
对写作、角色扮演等没有唯一正确答案的开放式任务,把『回答质量』分解成一组自然语言评价标准(rubric criteria),由冻结的 LLM judge 对每条标准独立打 0/1 分,再加权求和作为奖励。本文的 rubric 是加权标准集 $c_t = \{(q_{t,m}, \lambda_{t,m})\}$,奖励 $r_t^{(j)} = \sum_m \lambda_{t,m} s_{t,m}^{(j)} / \sum_m \max(\lambda_{t,m}, 0)$,负权重标准用于惩罚不良行为。
全文围绕 rubric 奖励的失效与演化展开,rubric 正是外壳三个接口(任务采样、rollout 引导、rubric 标准)中被操作的中间对象,是理解方法的名词基础。
RLVR 与开放式生成的奖励困境
RLVR(可验证奖励强化学习)依赖程序化验证器给数学、代码、指令跟随等任务打分,已成为 LLM 后训练的标准配方。但长文写作、角色扮演、社会推理等任务没有唯一正确答案、质量多维且主观,无法构造规则验证器,于是 rubric 奖励成为替代方案——同时也引入了 LLM judge 被策略钻空子的风险。
理解『为什么开放式 RL 必须用 rubric 奖励、以及它为何随训练退化为不可靠信号』是论文动机的起点;本文所有实验都围绕这五类开放式任务(医疗、科学、写作、角色扮演、指令跟随)。
奖励失效三分类:blind / saturated / spurious
论文的核心分类学:blind 指某条标准对组内所有 rollout 都打 0(策略能力够不着,无法探索到),组内无对比;saturated 指全部打 1(已被掌握或靠『开头致谢、结尾套话』等通用内容白拿分),同样无对比;spurious 指分数能区分响应但排序与真实质量不符(表面合规、长度作弊、谄媚等)。真实质量排序由更强的 oracle judge 做组内两两比较定义。
归因器的标签空间 $V=\{\text{blind}, \text{saturated}, \text{spurious}, \text{agree}\}$、失败到接口的路由规则、critic 的接受条件全部围绕这三类定义;它是读懂图 1、图 3 和整个方法的中心词汇。
优先级经验回放与重要性采样校正
Schaul 等人 2016 年提出:当把采样分布从均匀改为非均匀 $p_t$ 以优先采样高价值样本时,为不改变训练目标本身,给每个样本的损失乘以重要性权重 $u_t = 1/(N p_{it})$,使每个任务的期望贡献保持不变,只改变『被抽到的频率』。
本文采样接口用 $\mathrm{Cat}(p_t)$ 抽任务、用 $u_t$ 加权任务损失(式 1、2),数学上正是这个技巧;理解它才能明白为什么任务重加权($\gamma_1/\gamma_2/\gamma_3$ 三档)不算偷改优化目标。
LLM-as-judge 与 oracle judge
用 LLM 当自动评测器。本文有两个:训练 judge(冻结的 gemma-4-31B-it)按 rubric 标准逐条打分并参与 RL 训练;oracle judge(Claude Sonnet 5,仅用于分析)在每组 $J=8$ 个响应内做全部 28 对两两比较(正反两个方向各评一次),按胜率定义真实质量排序。奖励排序与 oracle 排序的一致率(reward-oracle agreement)衡量奖励是否真的在度量质量。
论文的关键论据——61.6% 的响应对奖励失效、训练结束时一致率从 GRPO 的 38.4% 提升到 48.9%——全部由 oracle judge 测出;不懂这套评测设定就无法正确解读实验数字。
研究动机
基于 rubric 的强化学习用自然语言评价标准作为开放式生成任务的奖励,但随着训练推进这些奖励会失效。论文在 Rubric-Mix-10k 上用 Qwen3.5-4B 跑 GRPO 实测出两类失败模式:一是非判别性奖励,组内分数塌缩成全低(blind)或全高(saturated),策略要么够不着标准要么靠『开头赞美、结尾宣布满足所有要求』等表面套路白拿分,组内失去相对学习信号;二是虚假奖励(spurious),分数仍能区分响应但排序不再对应真实质量——在 240 组人工标注中 oracle 排序与标注者的 Kendall $\tau$ 达 0.84,证明 oracle 可作真值。两类失败合计占所有响应对的 61.6%:27.6% 完全无可对比信号(blind 12.0% + saturated 15.6%),34.0% 有对比但不可靠,其中 19.8% 的响应对被奖励排在完全错误的方向。根源在于任务采样、探索引导、评价 rubric 这套训练配置在策略进化时保持静止:固定 rubric 无法区分新行为,on-policy rollout 又采不到被奖励的行为。
本文的目标是构建一个与策略共同演化的训练时外壳(training-time harness),把任务采样分布 $p_t$、rollout 引导 $g_t$、rubric 标准 $c_t$ 作为三个可编程接口统一管理:自动诊断每一次奖励失效属于哪一类,并把失效路由到能修复它的那个接口(blind→加引导、saturated→调采样、spurious→改 rubric);同时引入 JIT critic,任何候选更新必须先在当前冻结策略上实测其效果、且效果落在校准好的接受带内才被采纳,防止改 A 坏 B。配套目标还包括策划 Rubric-Mix-10k 五域(医疗/科学/写作/角色扮演/指令跟随)训练与评测套件(8600 训练任务、每域 250 条 held-out、每域一个 OOD 基准),并在 4B 与 9B 两个规模上验证相对静态 GRPO、单侧适应方法(RuscaRL/SkillRL/EvoRubric/AMARIS/AMARIS++)的优势与效率。
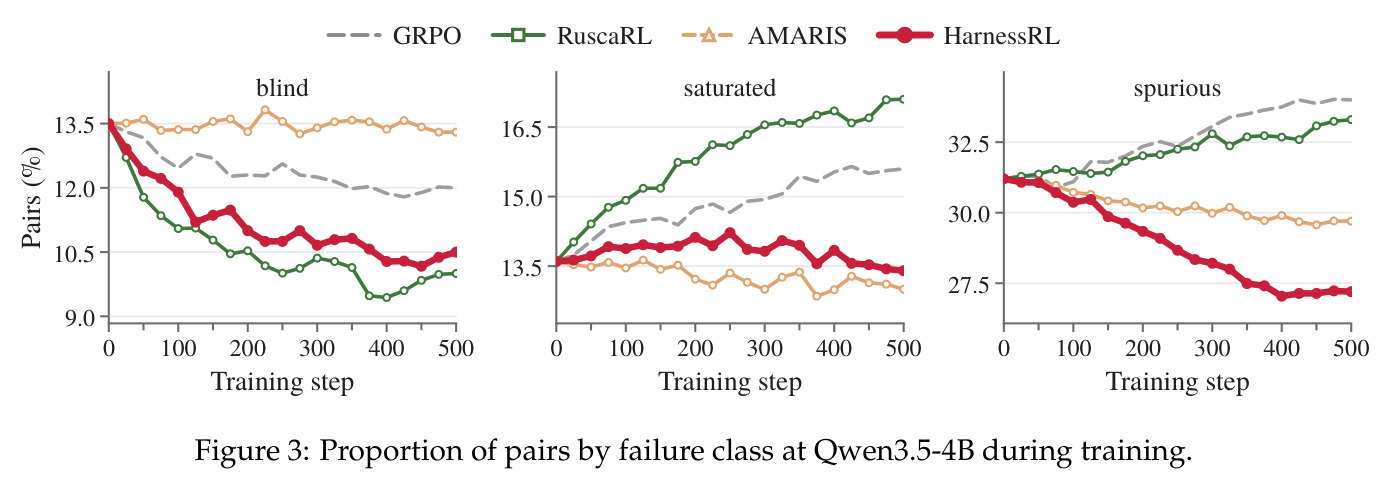
与已有工作不同的是,已有工作只动一侧:guidance 侧的 RuscaRL、SkillRL 在固定 rubric 下用特权引导脚手架探索;rubric 侧的 EvoRubric、AMARIS 只重写 rubric 而不加引导。但任何单侧适应都可能把失败搬到训练的另一处——引导帮策略满足了固定 rubric 会让标准饱和(饱和组不带优势信号,Yu et al. 2026),而没有引导就收紧 rubric 又会把标准推到策略够不着的地方(无学习信号,Sundaram et al. 2026)。最接近的 AMARIS++ 虽扩展到三接口,却既无跨任务记忆也无测量式验收。HarnessRL 的独特切入是三件事的组合:(1) 先归因再动手——把每条失效标准贴标签并路由到对应接口;(2) JIT 实测验收——更新必须先在冻结策略上量出 $\Delta_g$/$\Delta_c$ 且落入接受带才生效;(3) 训练期记忆提供任务内历史与跨任务证据,支撑归因与复用。
核心方法
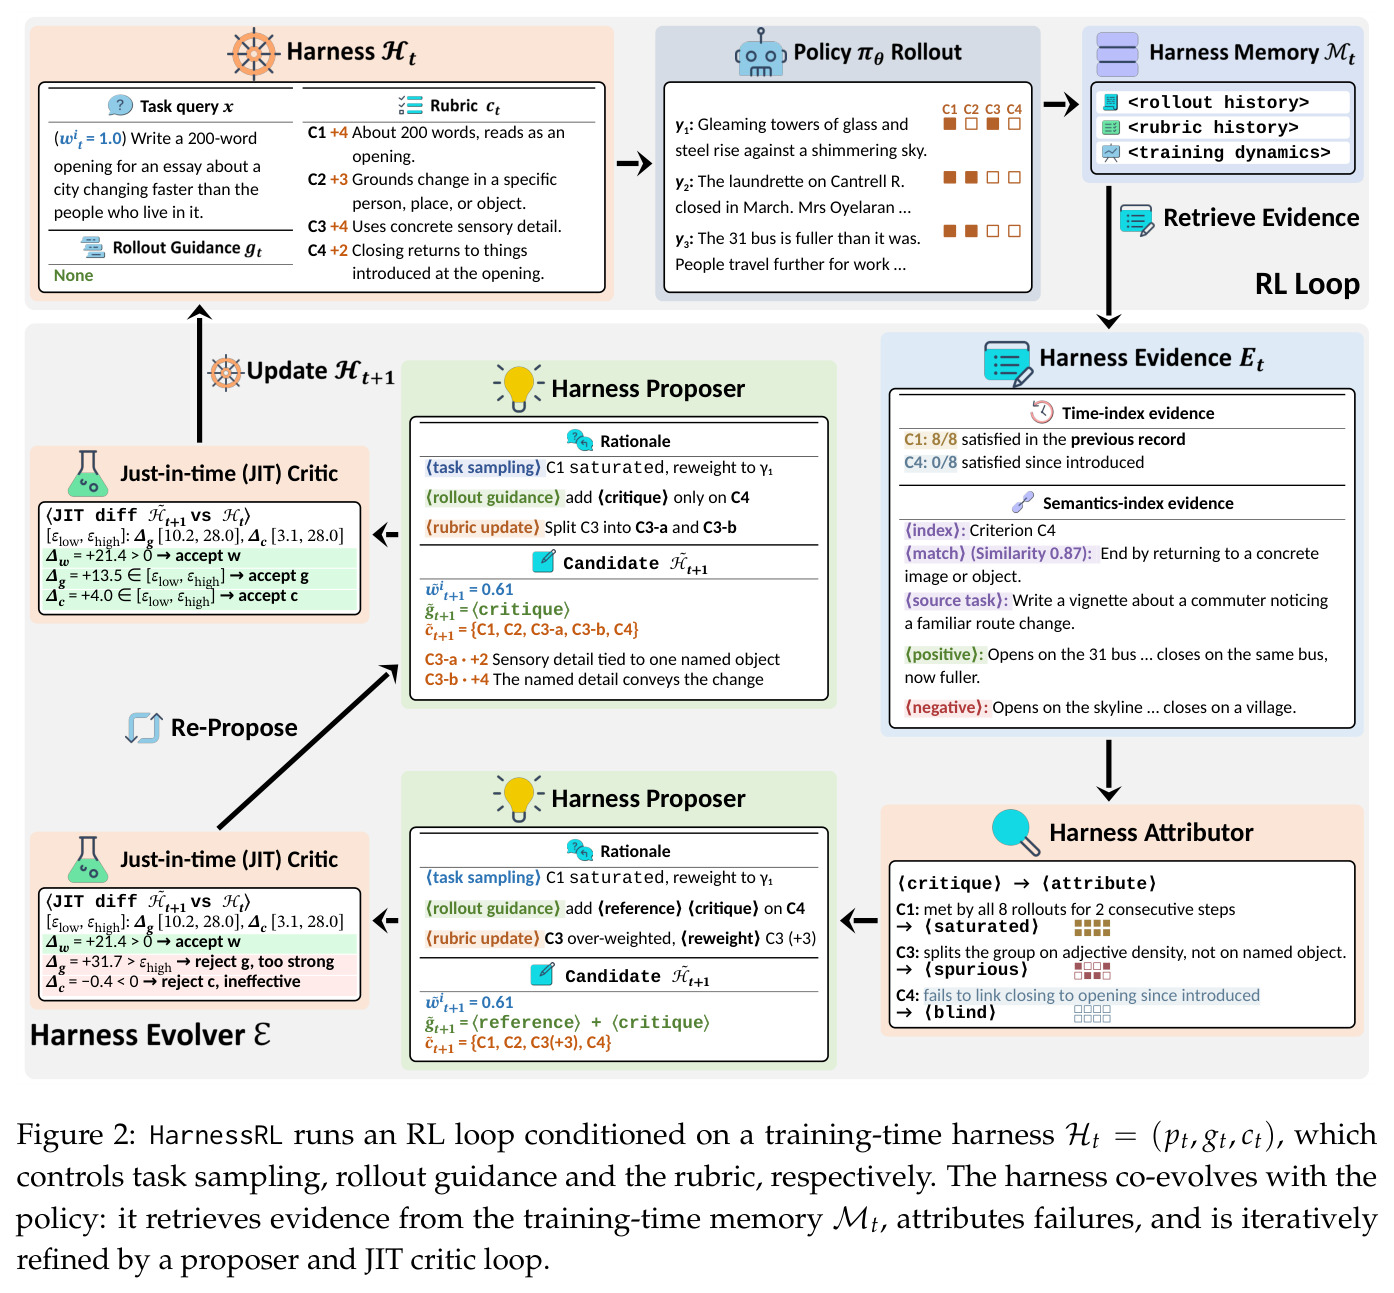
HarnessRL 把训练配置形式化为随步数 $t$ 演化的外壳 $H_t = (p_t, g_t, c_t)$:采样接口 $p_t$ 是任务库上的归一化非负权重分布 $p_{it} = w_{it}/\sum_\ell w_{\ell t}$;引导接口 $g_t$ 从 $\{\langle\text{criterion}\rangle, \langle\text{reference}\rangle, \langle\text{critique}\rangle\}$ 中按需挂载特权字段辅助探索;rubric 接口 $c_t = \{(q_{t,m}, \lambda_{t,m})\}$ 是可增删改拆并的加权标准集。每步抽 512 个任务、每任务 $J=8$ 个 rollout,冻结 judge 逐标准打 0/1 分得矩阵 $S_t$,加权得奖励 $r_t^{(j)}$。RL 目标是扩展 GRPO(式 2):任务损失乘以重要性权重 $u_t = 1/(N p_{it})$ 保持均匀分布下的期望贡献,优势 $\hat{A}_t^{(j)}$ 按组内均值方差标准化。外壳进化器 $\mathcal{E}$ 含归因器、提议器、JIT critic 三个角色(分开调用保证不既提议又验收),在 $B=3$ 轮预算内迭代,把记忆 $\mathcal{M}_t$ 中的证据转成 $H_{t+1}$。
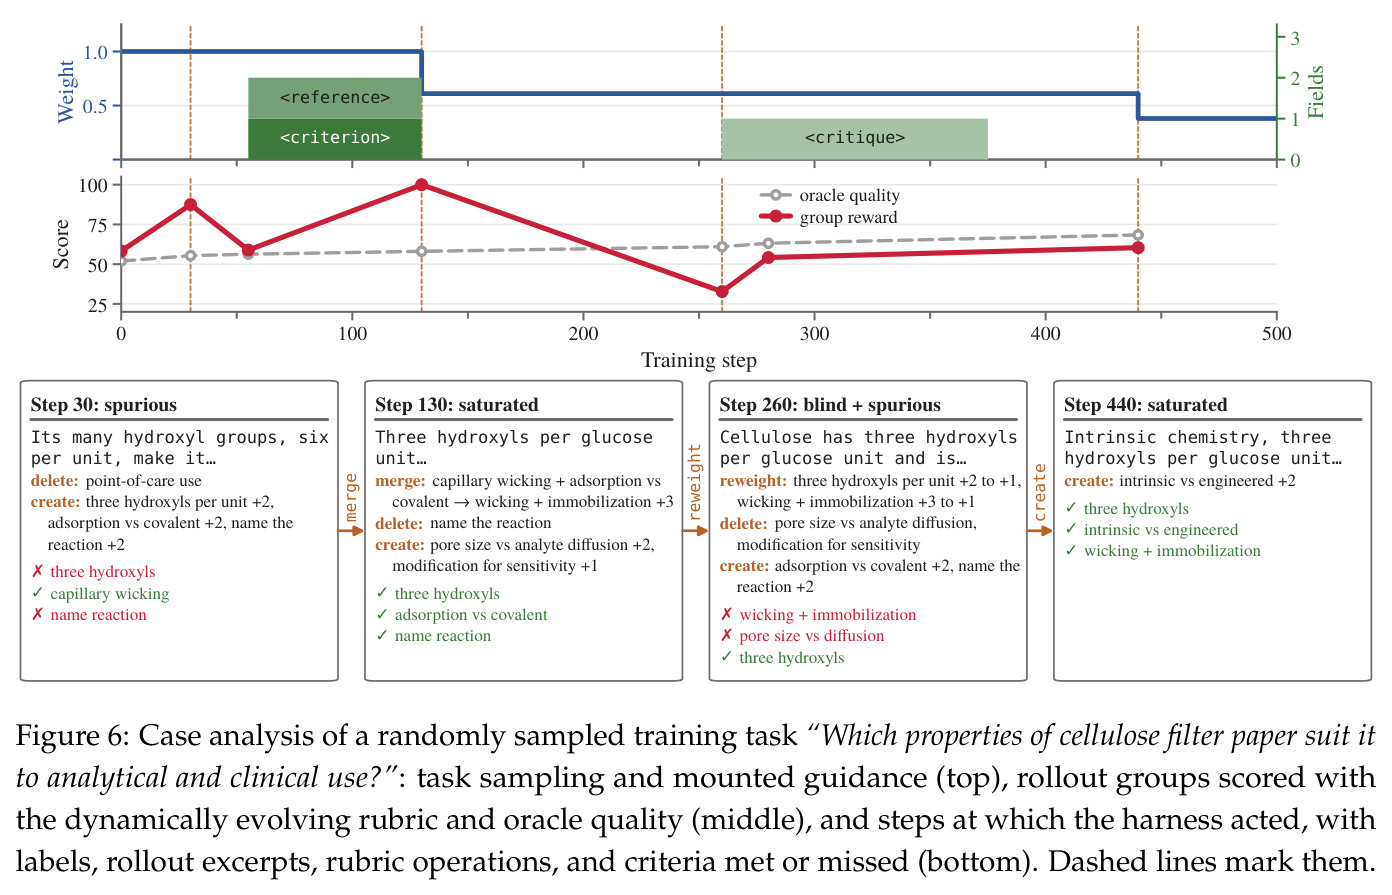
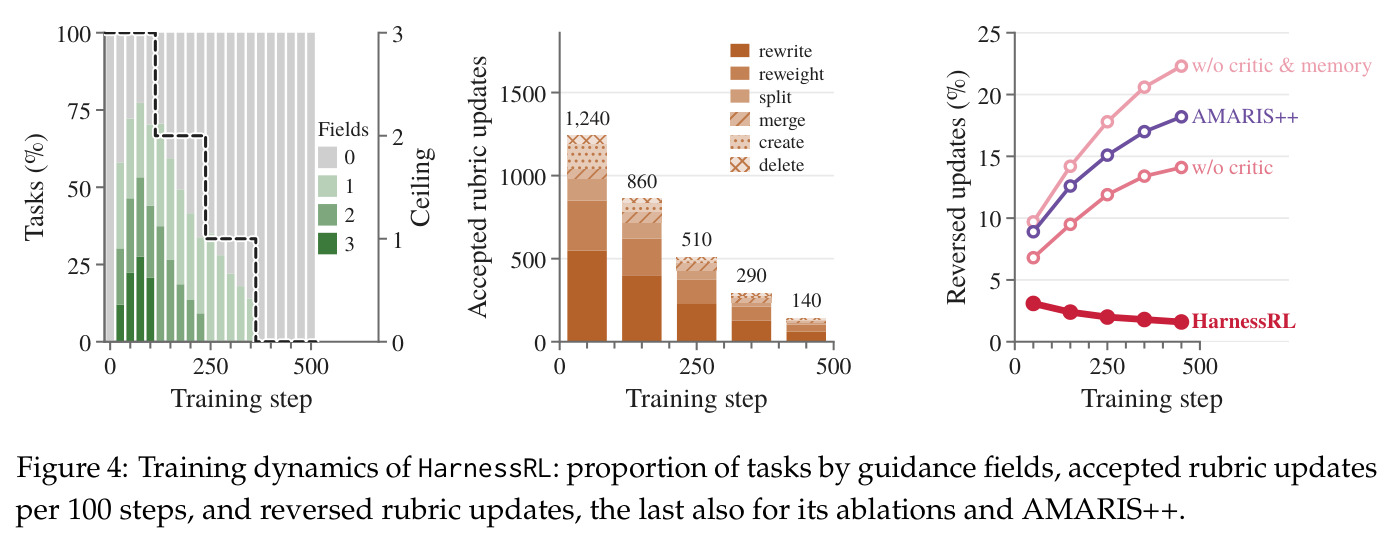
核心创新一是失败归因(failure attribution):归因器结合时间索引(同任务历史,区分持续失败与单步噪声)与语义索引(跨任务相似标准及正负响应),问三个问题——可达性(够不着且历史上也够不着记 blind,曾够得着只是本轮没采到记 agree)、训练阶段(近期全满足记 saturated,靠免责声明等通用内容混过的交给提议器收紧)、奖励作弊(满足标准的 rollout 是否只共享表面合规、长度或立场作弊,是则记 spurious)——然后把 blind 路由到引导接口、saturated 到采样接口、spurious 到 rubric 接口。核心创新二是 JIT 实测验收:rubric 更新必须在记录组上让分数下降($\Delta_c > 0$,因为奖励上升证明不了 rubric 改对)、引导更新必须用冻结策略重采样测出 $\Delta_g > 0$,且都要落入冷启动校准的接受带(引导 [10.2, 28.0]、rubric [3.1, 28.0] 奖励点),被拒候选带测量值返回提议器返工或换 noop——这是与所有只重写不验证的 rubric 进化方法的本质区别。
方法步骤详情
每步六步流程:(1) 内层 RL:$x_t \sim \mathrm{Cat}(p_t)$ 抽任务,采 $J=8$ 个 rollout,judge 按 $K_t$ 条标准打分得 $S_t \in \{0,1\}^{K_t \times J}$,加权得奖励并做 GRPO 更新;(2) 记忆检索:时间索引返回同任务历史,语义索引(bge-base-en-v1.5 嵌入、ChromaDB、余弦 $\ge \eta{=}0.82$、top-4)返回跨任务标准及正负响应作 $\langle\text{reference}\rangle$ 供体;(3) 归因:对每条标准输出 blind/saturated/spurious/agree 标签、置信度与引用 rollout 原句的依据,并定位 rubric 中允许表面通过的措辞;(4) 提议:按标签选操作——采样 reweight 降档($\gamma_1{=}0.61/\gamma_2{=}0.38/\gamma_3{=}0.17$)、引导 add/drop 字段(上限随训练季度递减)、rubric create/rewrite/delete/reweight/merge/split(正权重重标度到 $\Lambda{=}100$,锚点标准只许改权重);(5) 验收:critic 在冻结策略上实测(rubric 重打记录组、引导重采样、采样只看 $\Delta_w$ 不查策略),过接受条件 (i)–(iv) 才写入 $H_{t+1}$,否则带测量返工;(6) 标签、动作、测量写入记忆 $m_t$。
技术新颖性
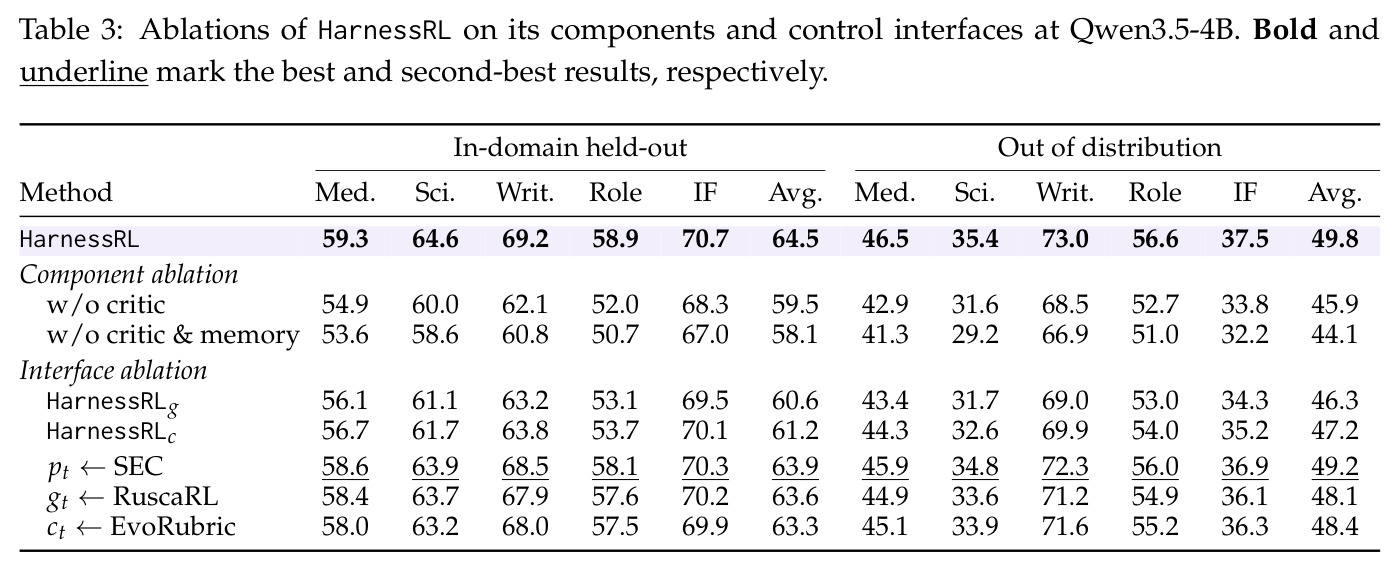
第一,概念新颖:把『训练配置本身』当作与策略共同进化的对象,形式化为三接口外壳并做失败归因路由;现有方法各只动一个接口且不诊断失败类型(EvoRubric/AMARIS 重写 rubric、RuscaRL/SkillRL 加引导、SEC 调课程),图 3 证明单侧适应只是把失败类搬家。第二,JIT critic 是本质区别:更新先测量后验收,且 rubric 更新的验收方向反直觉——要求记录组分数下降;接受带由一次性冷启动(0.75 集群小时)按零假设变异 95 分位定下限、组内奖励极差中位数定上限,使 rubric 更新回退率从无 critic 时的 22.3% 降到 1.6%。第三,跨任务语义检索务实:58% 被采纳的 $\langle\text{reference}\rangle$ 字段靠供体任务填充;critic 对有检索证据的候选接受率 71%,无证据仅 44%。第四,重要性权重 $u_t$ 让采样重加权只改频率不改目标,理论上干净。
实验结果
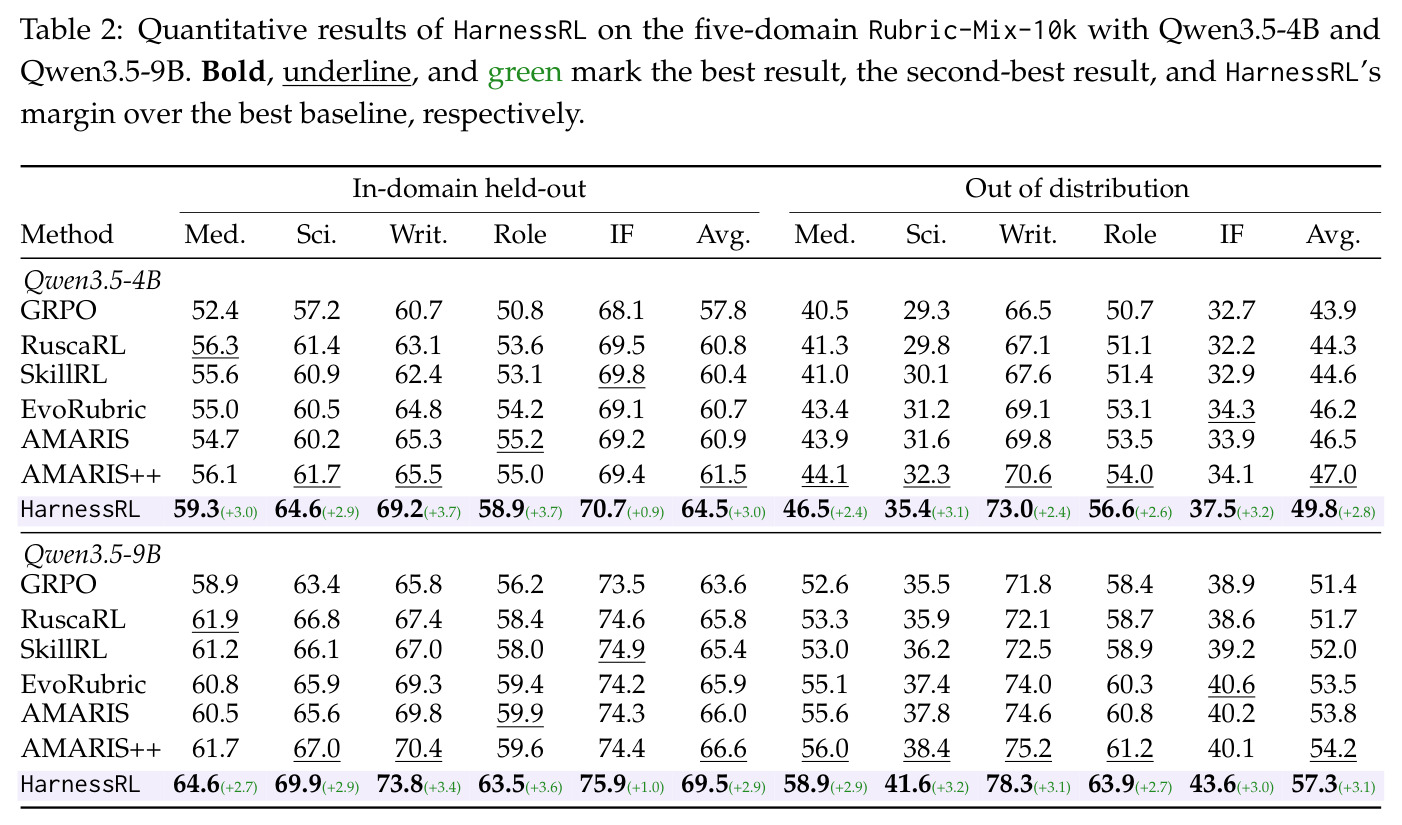
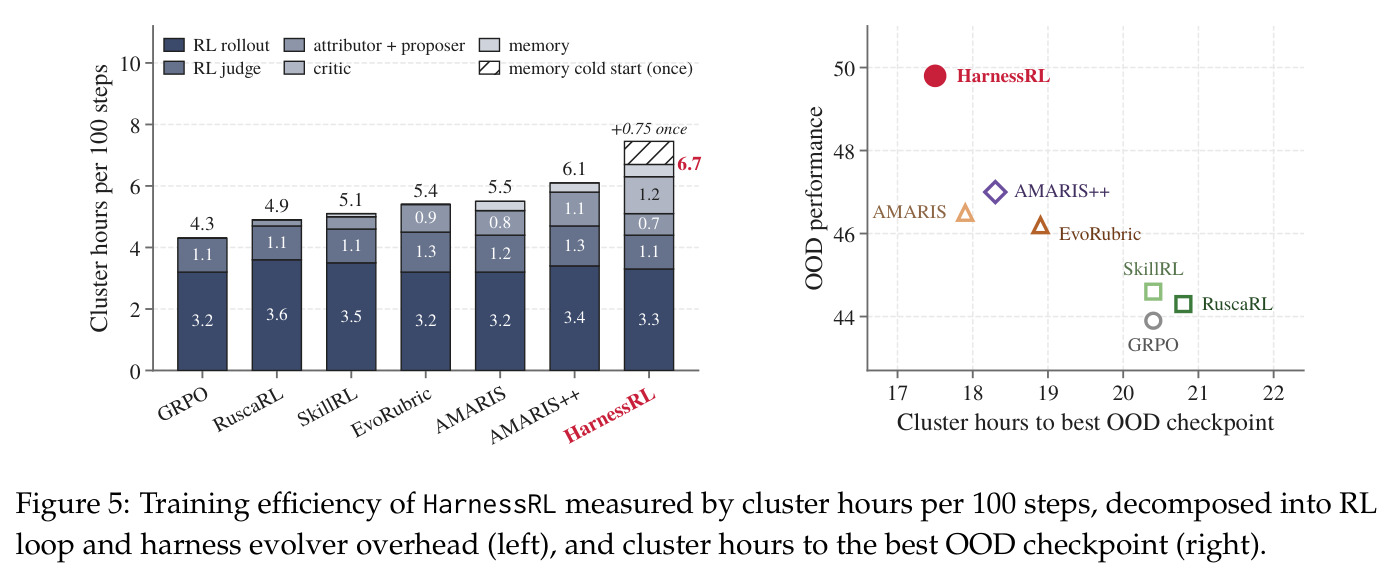
主实验(表 2):HarnessRL 两规模全列领先。Qwen3.5-4B 域内 held-out 五域均值 64.5(GRPO 57.8,+6.7pp;最强基线 AMARIS++ 61.5,+3.0pp),OOD 49.8(+2.8pp);Qwen3.5-9B 域内 69.5(+2.9pp)、OOD 57.3(+3.1pp);配对 bootstrap 95% 区间 [2.4,3.6]/[2.0,3.5](4B),置换检验 $p<0.001$,种子标准差仅 0.2–0.4。训练结束奖励-oracle 一致率 48.9% 对 GRPO 38.4%(+10.5pp)。消融(表 3):去 critic 掉到 59.5/45.9,再去记忆掉到 58.1/44.1(≈GRPO);单接口版仅 60.6/46.3 与 61.2/47.2。失败类占比(图 3):GRPO 收官 blind/saturated/spurious = 12.0/15.6/34.0,HarnessRL 降至 10.5/13.4/27.2,单侧方法只是转移失败(RuscaRL blind 10.0 但 saturated 17.1)。效率(图 5):每 100 步 6.7 集群小时(GRPO 4.3),但最佳 OOD 检查点在第 250 步、17.5 小时,GRPO 要第 475 步、20.4 小时;匹配算力下 AMARIS++ 46.9 对 HarnessRL 49.8。人工复核:四类标签支持率 97.0/98.0/86.0/90.0%,82.5% 被采纳的 rubric 更新对准了诊断失败。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五域开放式生成(Qwen3.5-4B)域内 held-out | 种子 rubric 平均分(最佳检查点) | 64.5 | AMARIS++ 61.5(GRPO 57.8) | +3.0 pp |
| 五域开放式生成(Qwen3.5-4B)OOD | 各域官方基准协议(MedQA/GPQA-Diamond/WritingBench/RoleBench/IFBench)均值 | 49.8 | AMARIS++ 47.0(GRPO 43.9) | +2.8 pp |
| 五域开放式生成(Qwen3.5-9B)域内 held-out | 种子 rubric 平均分 | 69.5 | AMARIS++ 66.6(GRPO 63.6) | +2.9 pp |
| 五域开放式生成(Qwen3.5-9B)OOD | 官方基准协议均值 | 57.3 | AMARIS++ 54.2(GRPO 51.4) | +3.1 pp |
| 奖励-oracle 一致率(4B,训练结束) | 奖励排序与 oracle judge 排序一致的对数占比(%) | 48.9 | GRPO 38.4 | +10.5 pp |
| 训练效率(4B,到达最佳 OOD 检查点) | 集群小时 / 训练步数 | 17.5 小时 @ 第 250 步 | GRPO 20.4 小时 @ 第 475 步(AMARIS++ 18.3 @ 300) | 时间省约 14%,步数近乎减半 |
局限与改进
作者承认的局限:每步成本是 GRPO 的 1.6 倍(6.7 对 4.3 集群小时),且需一次性 0.75 小时冷启动;指令跟随域增益最窄(4B 仅 +0.9pp,该域标准接近可验证、GRPO 已达 68.1)。我观察到的更多:其一,训练结束奖励-oracle 一致率仅 48.9%,意味着约一半响应对的排序仍与真值不符,rubric 奖励的可靠性天花板很低;其二,验收带与采样档位 $\gamma$ 全部来自在全部训练域上的一次冷启动,对全新域或新模型家族的迁移性未验证;其三,OOD 分数在第 250 步见顶而域内分数持续升到 500 步,最佳检查点依赖评估集选择,有用测试信息早停的嫌疑(作者补充的第 500 步检查点下优势仍在:64.5/49.4 对 AMARIS++ 61.5/46.4);其四,实验只覆盖 Qwen3.5 家族加 gemma judge,judge 与策略的偏差未讨论;其五,spurious 归因的人工支持率仅 86.0%,是四类中最低;其六,critic 每个主候选更新都要额外 judge 调用与重采样,任务数或组大小增大时开销线性增长。
独立分析的弱点
独立分析四点。(1) spurious 归因本质是相关性推断:归因器比较满足与不满足标准的 rollout 是否只共享表面特征,但『只有满足者才谄媚』不等于『谄媚导致分数』,86.0% 的人工支持率暗示约七分之一判定可疑,错标会触发不必要的 rubric 重写、甚至删掉真正相关的标准;可引入干预式检验(人为改写响应中的可疑特征再重打分)。(2) JIT critic 只测量主候选更新,联合候选中的次级 rubric 操作仅靠条件 (ii)(iii) 间接约束,一轮内所有操作被一起评估,操作间交互效应未隔离。(3) 引导字段直接拼进策略输入、评测时又全部摘除,形成训练-评测分布差;论文自己承认引导侧 OOD 迁移最弱(gt←RuscaRL 切换臂 OOD 差距最大 1.7pp),部分增益可能是『照着答案练』而非能力提升;可像 OPSD/ICE 那样把引导探索蒸馏回无条件策略。(4) 语义索引阈值 $\eta=0.82$ 与 top-4 为固定规则,检索失败时 critic 接受率骤降至 44%,提示证据质量直接决定外壳决策质量,可改为自适应阈值或更强检索器。
未来方向
作者未列显性 future work,但留出多条可延伸路径:(1) 接口扩展——外壳目前只管采样/引导/rubric,judge 本身(其能力上限决定奖励天花板)、解码策略、上下文管理都可纳入 $H_t$ 成为第四接口;(2) 把 critic 蒸馏成小模型或学习型估计器,消掉每步 1.2 集群小时的测量开销,使归因-验收循环可摊销到更大规模;(3) 验收带目前是经验分位数(零假设变异 95 分位、组内极差中位数),可发展序贯检验或贝叶斯校准给出有统计含义的验收规则;(4) JIT 实测思想可平移到传统 RLVR——采纳任何 verifier/rubric 修改前先在冻结策略上测方向正确性,对抗验证器作弊;(5) 与推理时外壳研究(EvoHarness-RL、HarnessBank)合流,形成训练-推理全生命周期共同进化;(6) Rubric-Mix-10k 可扩展多语言、多模态开放式任务,并检验跨域冷启动——当前冷启动需全训练集池化跑一遍,能否用少量任务估计验收带是实用化关键;(7) spurious 归因的因果化改造。
复现评估
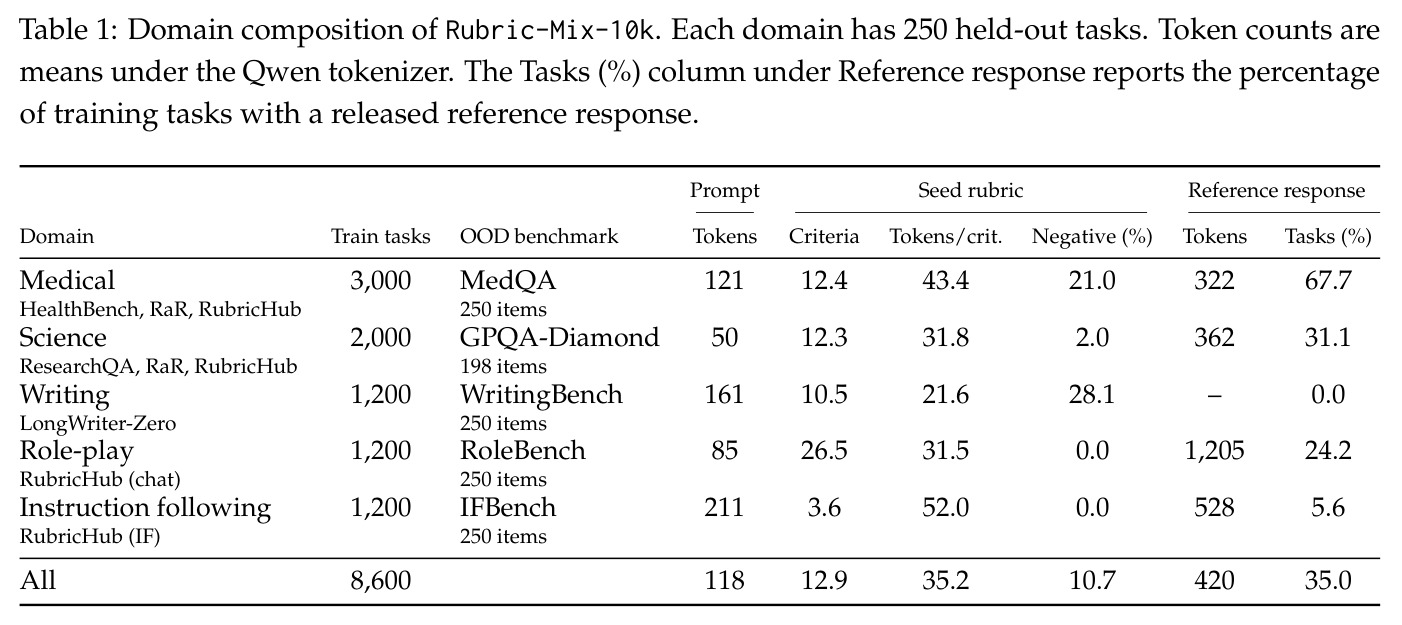
复现条件中等偏上。开源:代码与数据发布于 https://github.com/Tongyi-ConvAI/Qwen-Character/tree/main/HarnessRL,含 Rubric-Mix-10k(8600 训练任务、每域 250 held-out 与 OOD 基准;35.0% 任务附参考答案)。数据上游均为公开集(HealthBench、RaR、RubricHub、ResearchQA、LongWriter-Zero),OOD 用 MedQA、GPQA-Diamond、WritingBench、RoleBench、IFBench 公开协议。算力:16 节点集群、每节点 8 张 H100 80GB;4B 规模 GRPO 每 100 步 4.3 集群小时、HarnessRL 6.7,加冷启动 0.75 小时,500 步全程约 21.5 集群小时;另需 gemma-4-31B-it 作冻结 judge 与进化器骨干、bge-base-en-v1.5 嵌入、ChromaDB、Claude Sonnet 5 作 oracle(仅分析)。超参给出完整(接受带 [10.2,28.0]/[3.1,28.0]、$\gamma_1{=}0.61/\gamma_2{=}0.38/\gamma_3{=}0.17$、$\eta{=}0.82$、top-4、$B{=}3$、lr $1\times10^{-6}$、$\beta{=}0.001$),主要难点是三 LLM 角色的工程编排与 31B judge 的推理吞吐。
论文图表
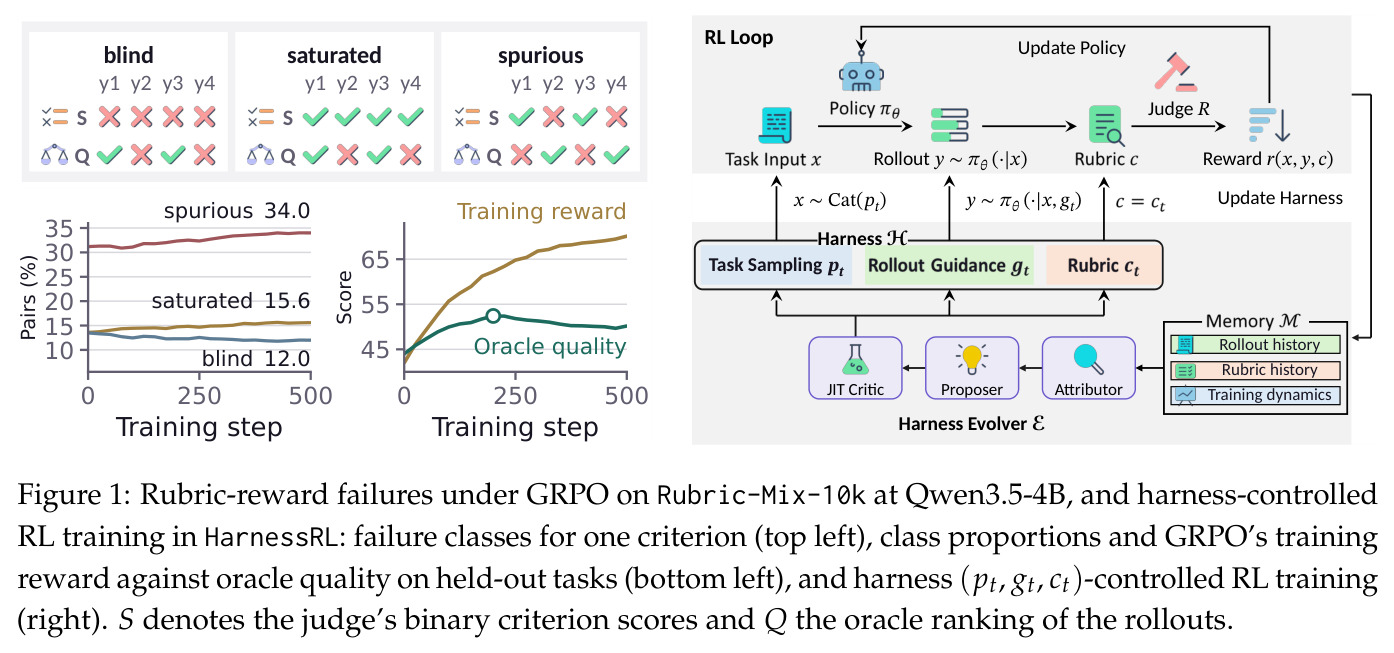
左上:单个标准上三类奖励失败的示意——blind(组内 4 个响应全得低分 S)、saturated(全得高分)、spurious(分数一致但与 oracle 质量排序 Q 相悖);左下:三类失败响应对占比随训练步数的曲线(盲 12.0%、饱和 15.6%、虚假 34.0%)以及 GRPO 的训练奖励上升而 held-out 任务上的 oracle 质量停滞的背离;右侧:由外壳 $\mathcal{H}=(p_t, g_t, c_t)$ 控制的 RL 训练循环,外壳进化器 $\mathcal{E}$ 的归因器、JIT critic、提议器基于 rubric history 与 training dynamics 迭代。
这张图同时承载问题与方法的全貌:61.6% 响应对失效的量化证据、『训练奖励与真实质量背离』的动机图景,以及三接口外壳驱动的训练循环框架,是进入论文的入口。