规模的天花板:视觉语言模型中的逆缩放现象 On the Limits of Scale: Inverse Scaling in Vision-Language Models
对19个VLM逐题配对分析发现:不少子任务上小模型反而比大模型更准
前置知识
缩放定律(Scaling Laws)
Kaplan 等(2020)和 Hoffmann 等(2022)发现的经验规律:语言模型的损失和多数下游能力随参数量、训练数据量、计算量按幂律可预测地改善。这一规律奠定了"更大模型更好"的行业共识,也是厂商按 2B/8B/32B/235B 等档位发布模型家族的依据。
全文检验的正是这条定律在 VLM 子任务层面是否成立,所有"逆缩放"的判定都以"准确率应随规模非递减"这一单调性假设为参照系。
逆缩放(Inverse Scaling)
指模型规模增大后某些任务上的表现反而变差的现象。McKenzie 等(2023)的 Inverse Scaling Prize 在纯文本构造任务上首次系统发现它,归因包括强先验、干扰物任务等;Wei 等(2023)进一步指出许多曲线其实是 U 形而非持续下降。
这是论文的研究对象:本文要回答的是逆缩放是否也出现在 VLM 的标准基准评测里,而不需要人为构造对抗任务。
逐题翻转分析(Per-Question Flip Analysis)
论文提出的核心度量:对同一对模型在每道题上比较正误。$\mathrm{Flip}_{\mathrm{Inv}}$ 统计"小模型对、大模型错"的题数,$\mathrm{Flip}_{\mathrm{Norm}}$ 统计"大模型对、小模型错"的题数,净差 $\mathrm{Net} = \mathrm{Flip}_{\mathrm{Inv}} - \mathrm{Flip}_{\mathrm{Norm}}$ 为正即小模型在分歧题上占优。
聚合准确率会把"大模型在某类题上变差"的信息平均掉,翻转分析才能把具体的失败题目枚举出来,是识别 375 个逆缩放案例的基础工具。
MoE(Mixture-of-Experts,混合专家)
一种稀疏架构:模型总参数很大,但每个 token 只激活其中一小部分(如 Qwen 30B-A3B 总参 30B、激活仅 3B)。MoE 变体让"总参数"和"激活参数"不再一一对应,使规模比较需要区分两个口径。
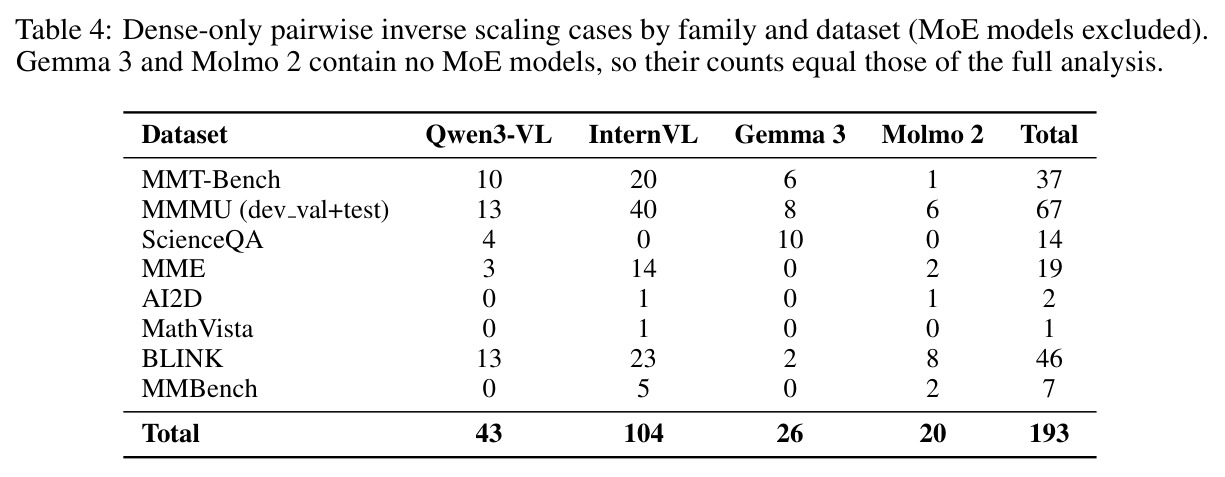
被测家族含多个 MoE 变体,它们频繁出现在逆缩放对的"大模型"一侧;论文专门做了 dense-only 重分析(保留 193 案例)以排除"MoE 伪影"这一替代解释。
McNemar 精确检验
针对配对二元结果(对/错)的统计检验,用于判断两个模型在同一批题上的正误分歧是否显著偏离对称:只看两者不一致的题目,检验不一致中偏向某一方的程度是否超出了随机波动。
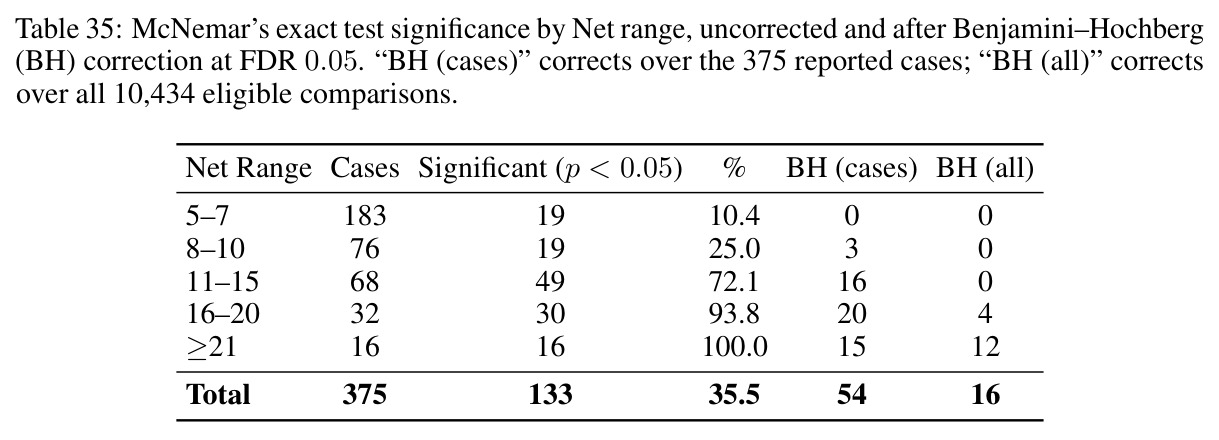
论文用它给每个候选案例报告单侧 p 值作为描述性证据(35.5% 未校正 p<0.05,Net≥21 时 100% 显著),帮助区分真回归与抽样噪声。
U 形缩放曲线
指子任务准确率随规模先降后升(或多次起伏)的非单调形态。Wei 等(2023)发现 LLM 的许多逆缩放任务在更大规模时反弹,说明失败可能是阶段性而非永久性的。
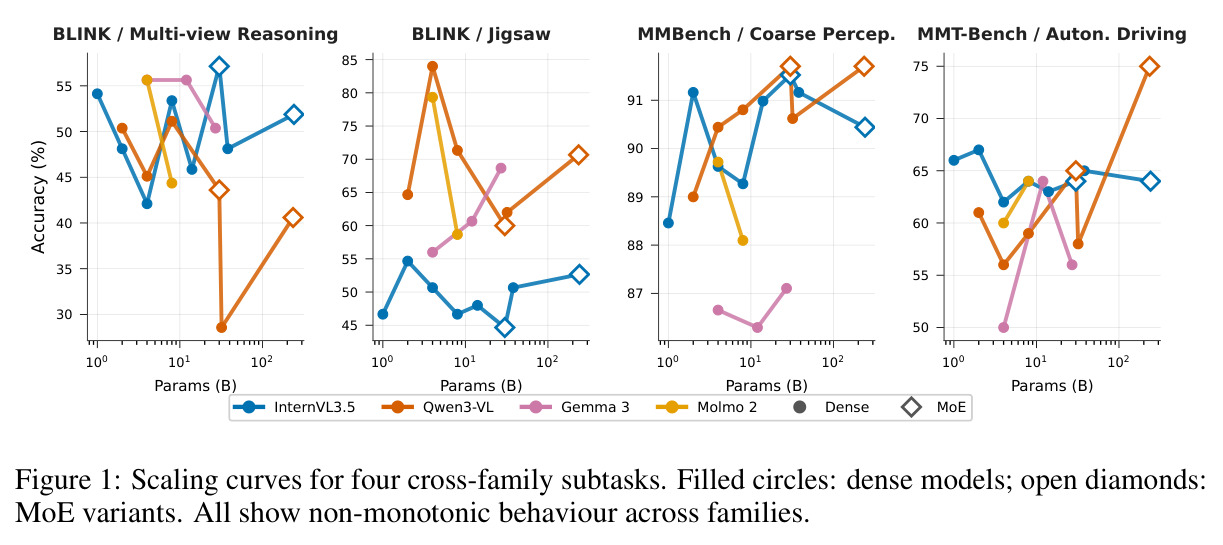
本文 87% 的家族-子任务组合呈非单调曲线而非持续退化,说明"大模型不行"往往只在特定档位发生,这直接塑造了"任务感知选型"的实践结论。
研究动机
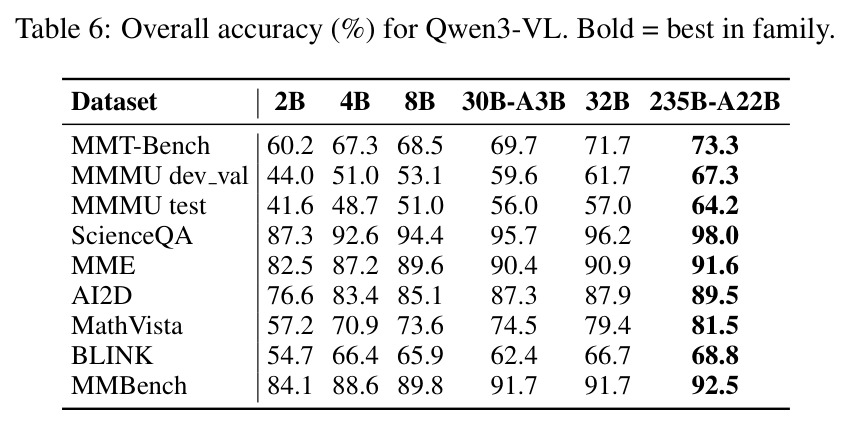
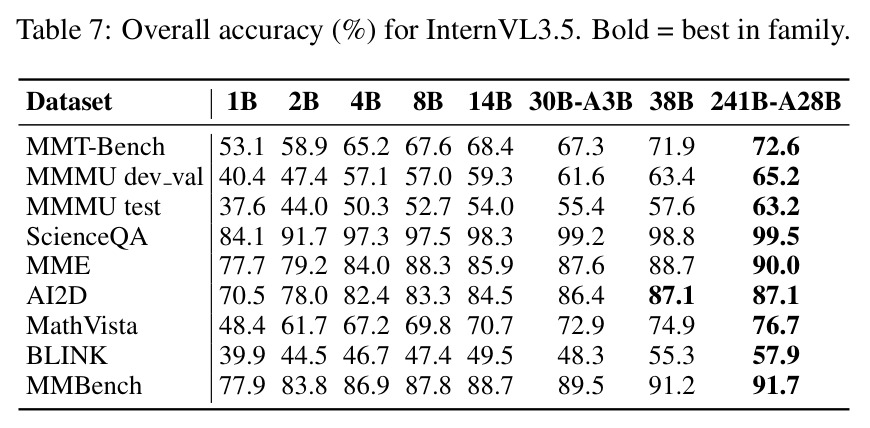
缩放定律让"增加模型规模、数据与算力带来单调提升"成为默认假设,厂商和用户都倾向选最大的模型。但这条假设已在多个维度出现裂缝:McKenzie 等(2023)在纯文本任务上发现逆缩放并给出强先验、干扰物等成因;Wei 等(2023)指出许多曲线实为 U 形;Gema 等(2025)发现推理模型增加测试时算力也会降准确率;Bae 等(2025)证明人为加入视觉干扰物可让 VLM 出现类逆缩放行为——但那是构造出来的设定。更微妙的是,回归其实早已藏在厂商自己的技术报告里而无人指出:Qwen3-VL 报告中 8B instruct 在 BLINK 上得 69.1,反而高于 32B 的 67.3 和 30B-A3B 的 67.7;32B 在 VLMs-Are-Blind 上 87.0 高于 235B-A22B 的 80.4;CountBench 准确率从 2B→4B→8B 依次为 88.4、84.9、80.5 单调下降。常规的聚合评测只记录这些数字,既不识别哪些能力在退化,也不知道具体在哪些题目上失败,部署者据此选型可能在关键能力上踩坑。
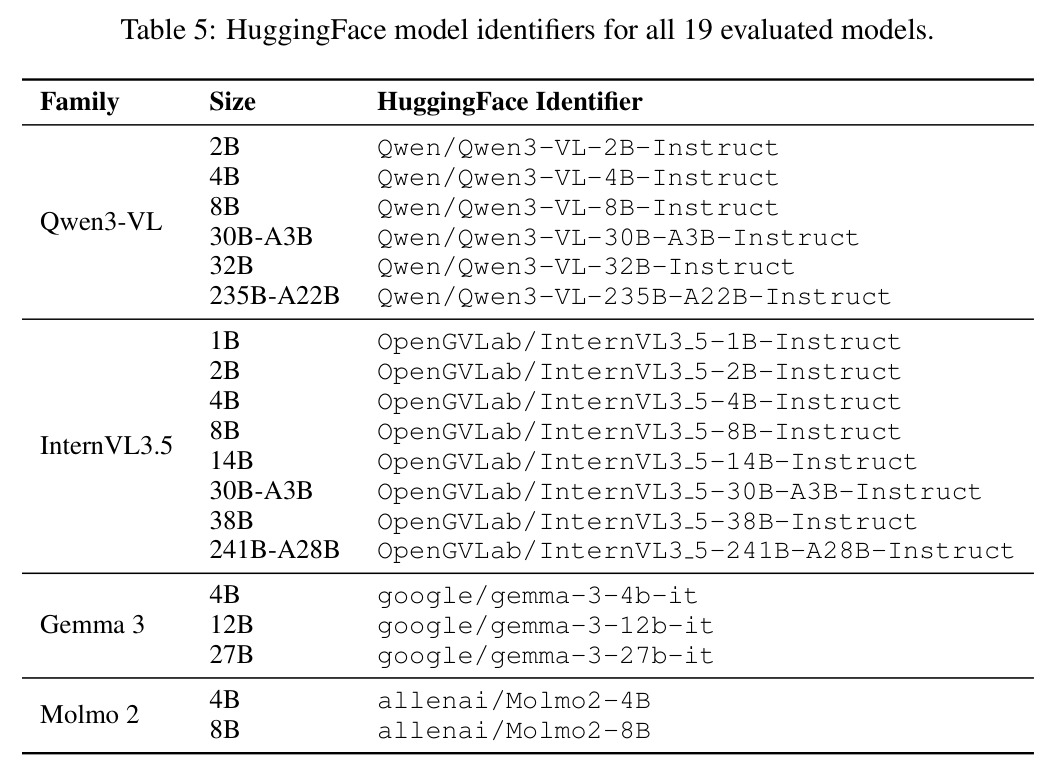
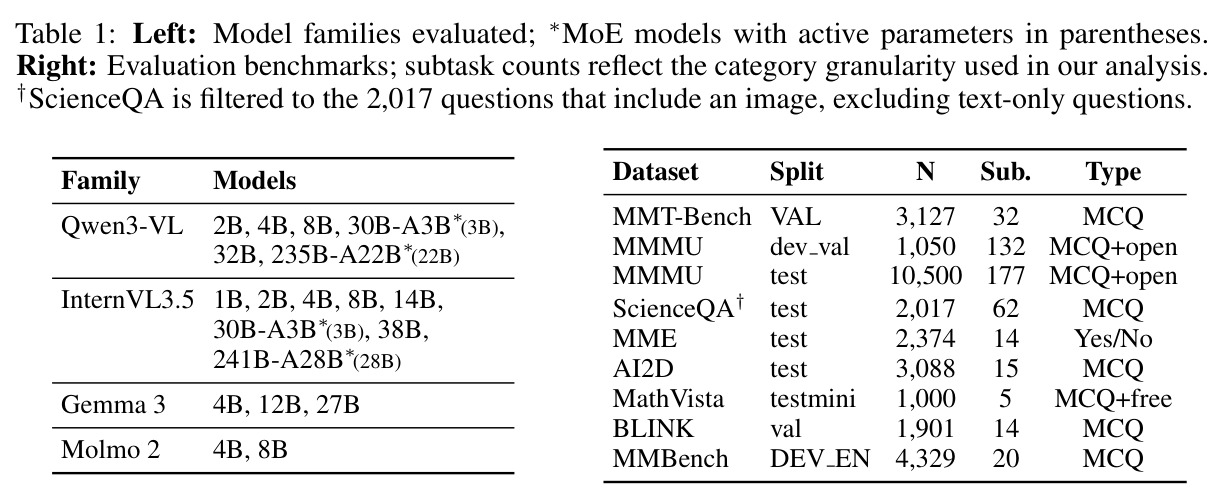
本文的目标是本文要系统回答一个此前无人检验的问题:在标准多模态基准、不人为构造干扰物的条件下,VLM 是否在子任务级别存在逆缩放?具体目标包括四点:(1)在同家族内做受控比较——选 Qwen3-VL、InternVL3.5、Gemma 3、Molmo 2 四个开放权重家族共 19 个模型,覆盖约 1B 到 235B 总参数、dense 与 MoE 变体;(2)在 8 个常用基准的 9 个评测划分上统一评测,每模型 29,386 道题,共 558,334 次模型-题目评测、171 次推理运行;(3)以基准自带类别标签为"子任务"(如 BLINK 的 Jigsaw、MMMU 的 Organic Chemistry),用逐题翻转分析量化"小模型对、大模型错"的不对称性并筛选显著案例;(4)检验这些模式能否跨独立开发的家族复现,找出受影响最重的能力域,并判断错误是真实模型失败还是标注噪声。
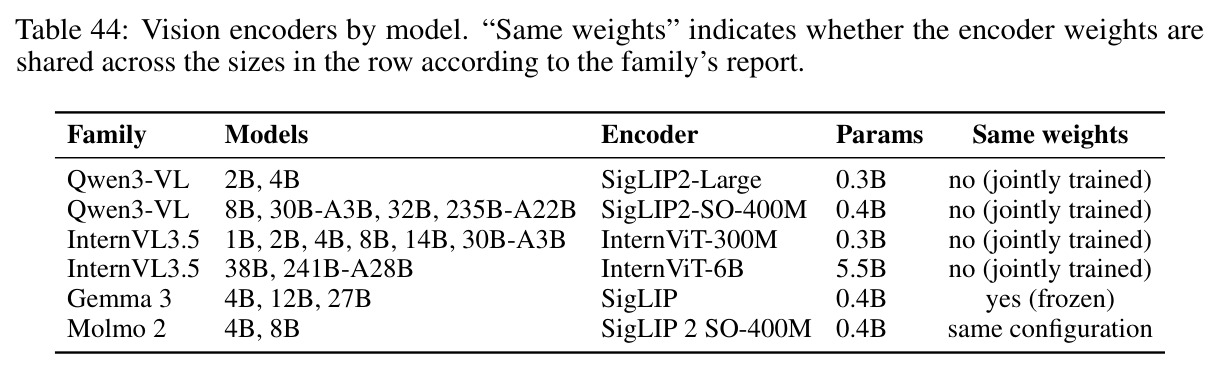
与已有工作不同的是,此前所有逆缩放研究都没有落在"标准 VLM 基准的常规评测"上:Inverse Scaling Prize 用专门构造的文本任务;Gema 等在推理算力维度构造任务;Bae 等在多模态侧人为注入干扰物。本文的独特切入有三点:第一,提出逐题翻转分析,比较配对模型在同一道题上的正误分歧,而非只看子任务聚合准确率——后者会把"大模型在少数题上灾难性失败但总体仍占优"的情形完全掩盖;第二,采用同家族比较(家族内共享高层架构与训练配方),比跨家族比较有更强的控制变量属性,并用附录 K 单独量化视觉编码器差异这一残余混杂(72.3% 的案例比较的是同编码器层级的模型);第三,用"至少 3 个独立家族在同一子任务上复现逆缩放"作为任务驱动而非模型特异的证据标准。这三点合起来,把逆缩放从构造任务的珍奇标本变成了部署中真实会遇到、可检测、可定位到具体题目的现象。
核心方法
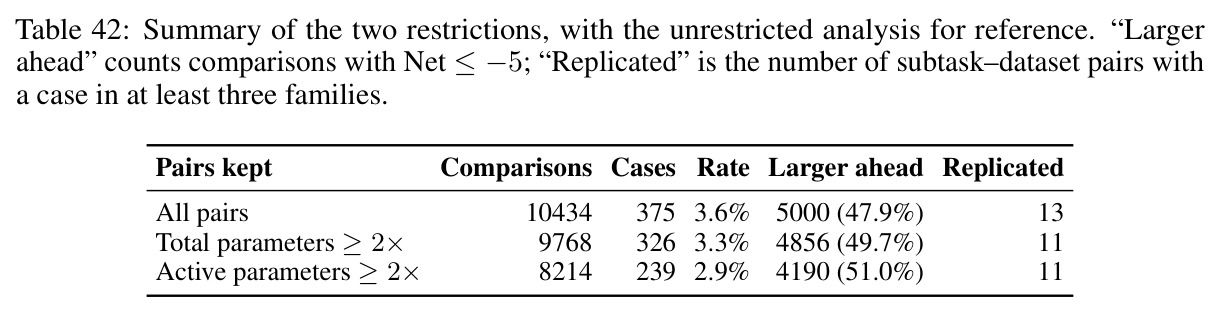
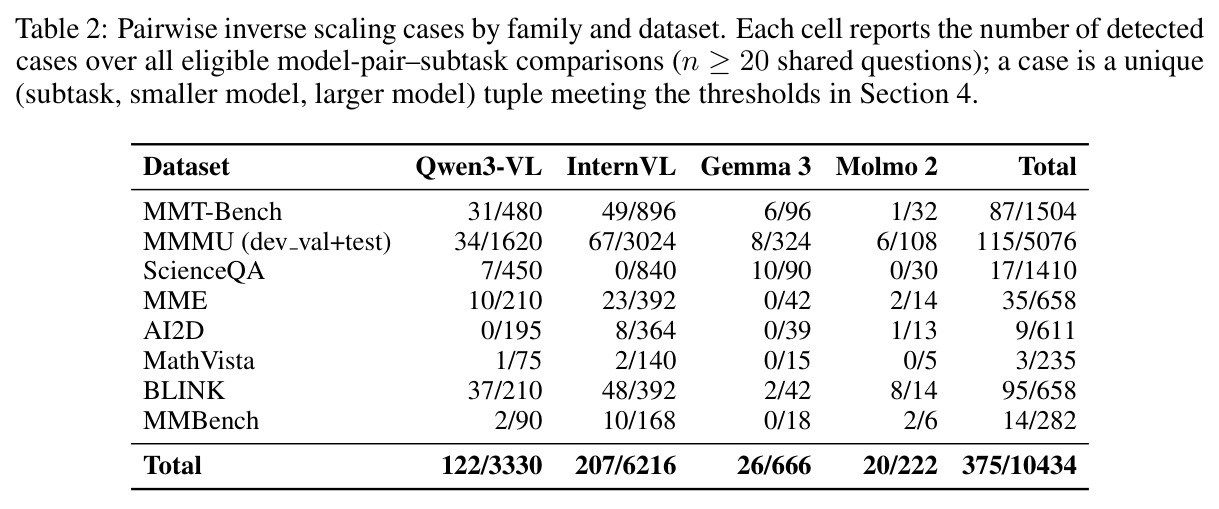
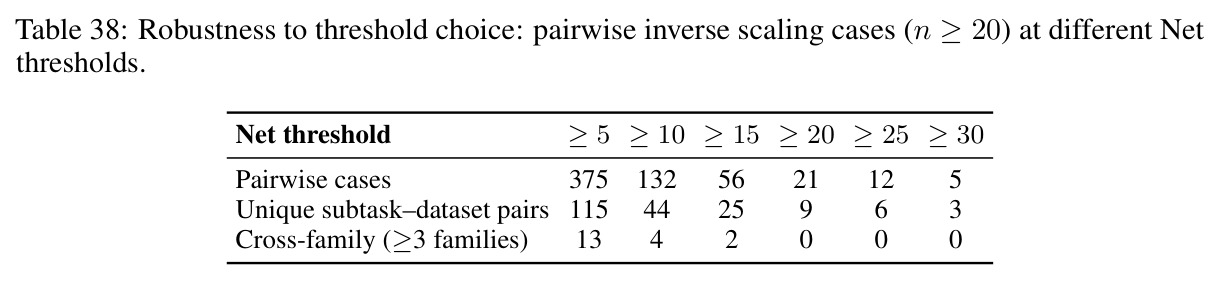
直觉上,聚合准确率是"平均值",大模型只要在多数题上略胜,就能掩盖它在某一类题上的系统性退步;要看到这类回归必须下钻到单题正误层面。技术路线分四步:第一步,统一评测——19 个模型 × 9 个评测划分 = 171 次推理,全部 zero-shot 直接提示、贪心解码、关闭思考模式(以隔离模型规模与测试时算力),答案校验沿用 VLMEvalKit 的确定性字母抽取与精确/数值匹配,无法判定时(0.4% 的回答)用 GPT-5.4 做多模态裁决。第二步,把每个基准按官方类别标签切成子任务(MMT-Bench 32 个、MMMU test 177 个、MME 14 个等,ScienceQA 过滤到 2,017 道含图题)。第三步,对家族内每对模型 $(f_i, f_j),\ i<j$ 在子任务共享题目上计算 $\mathrm{Flip}_{\mathrm{Inv}}$、$\mathrm{Flip}_{\mathrm{Norm}}$ 与 $\mathrm{Net} = \mathrm{Flip}_{\mathrm{Inv}} - \mathrm{Flip}_{\mathrm{Norm}}$,当共享题数 $n \ge 20$ 且 $\mathrm{Net} \ge 5$ 时记为一个逆缩放案例,共扫描 10,434 个合格比较。第四步,五重稳健性检查:阈值敏感性、dense-only 重分析、两倍参数量限制、BLINK 案例的选项重排序、双模型 CoT 对照,外加 McNemar 检验和 GPT-5.4/Claude Opus 4.6/人工三方错误标注。
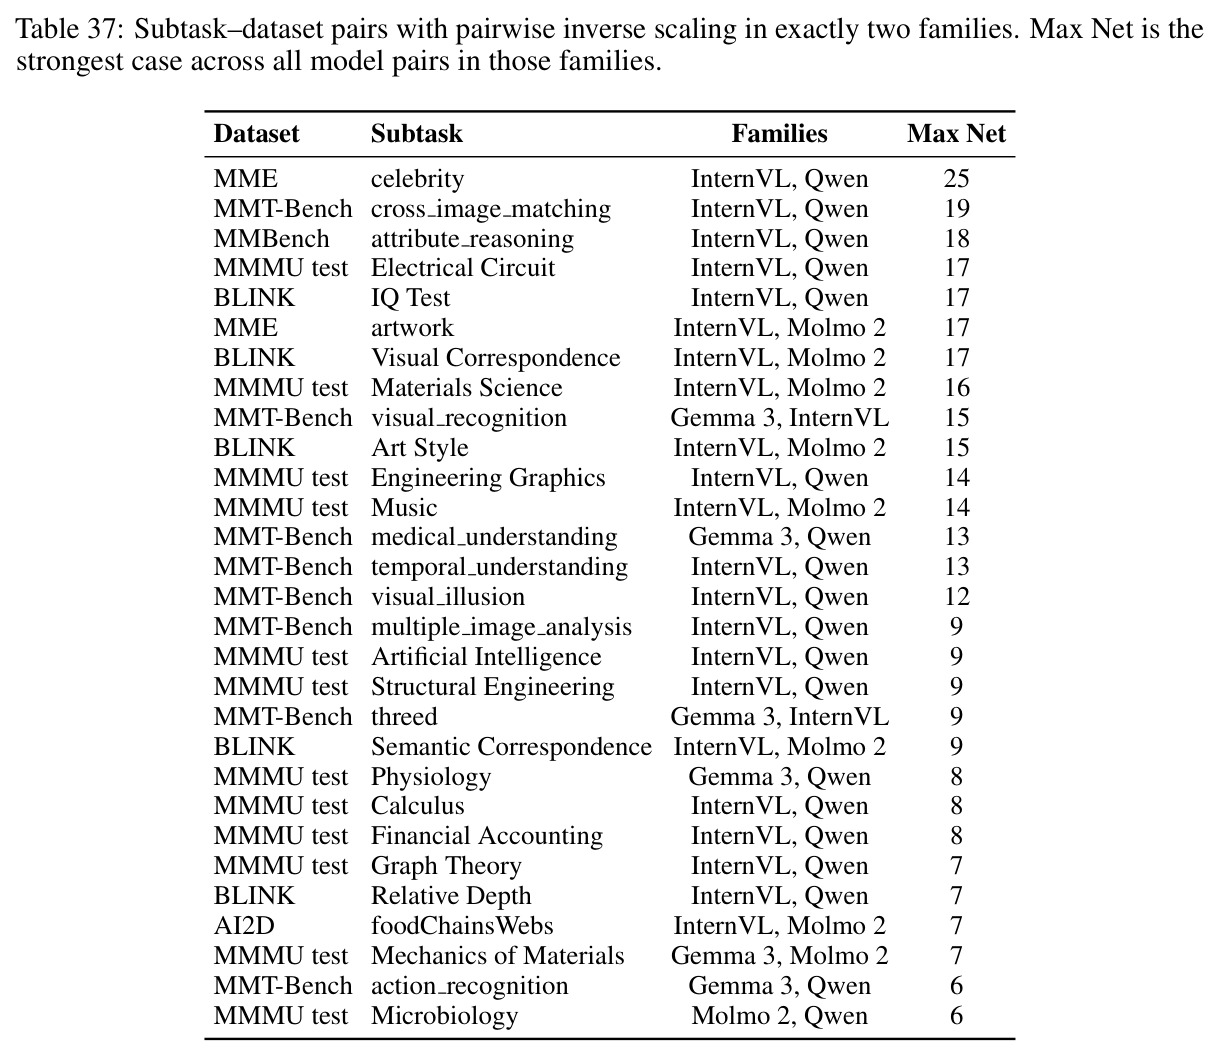
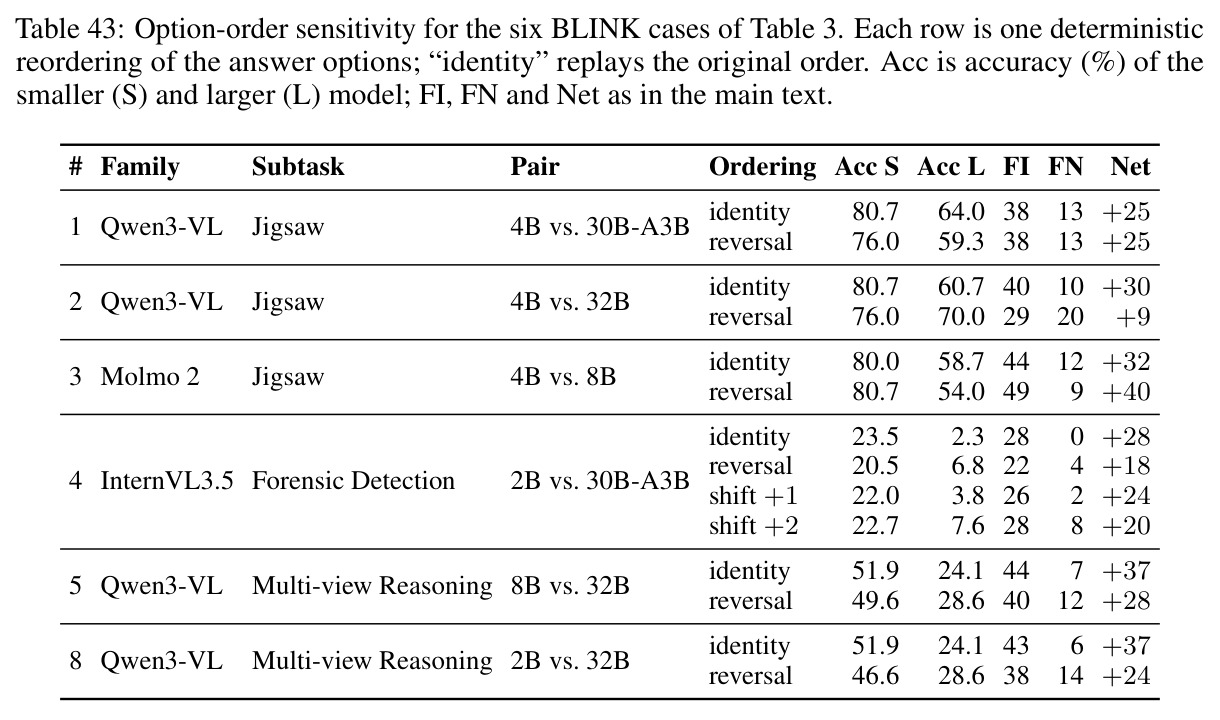
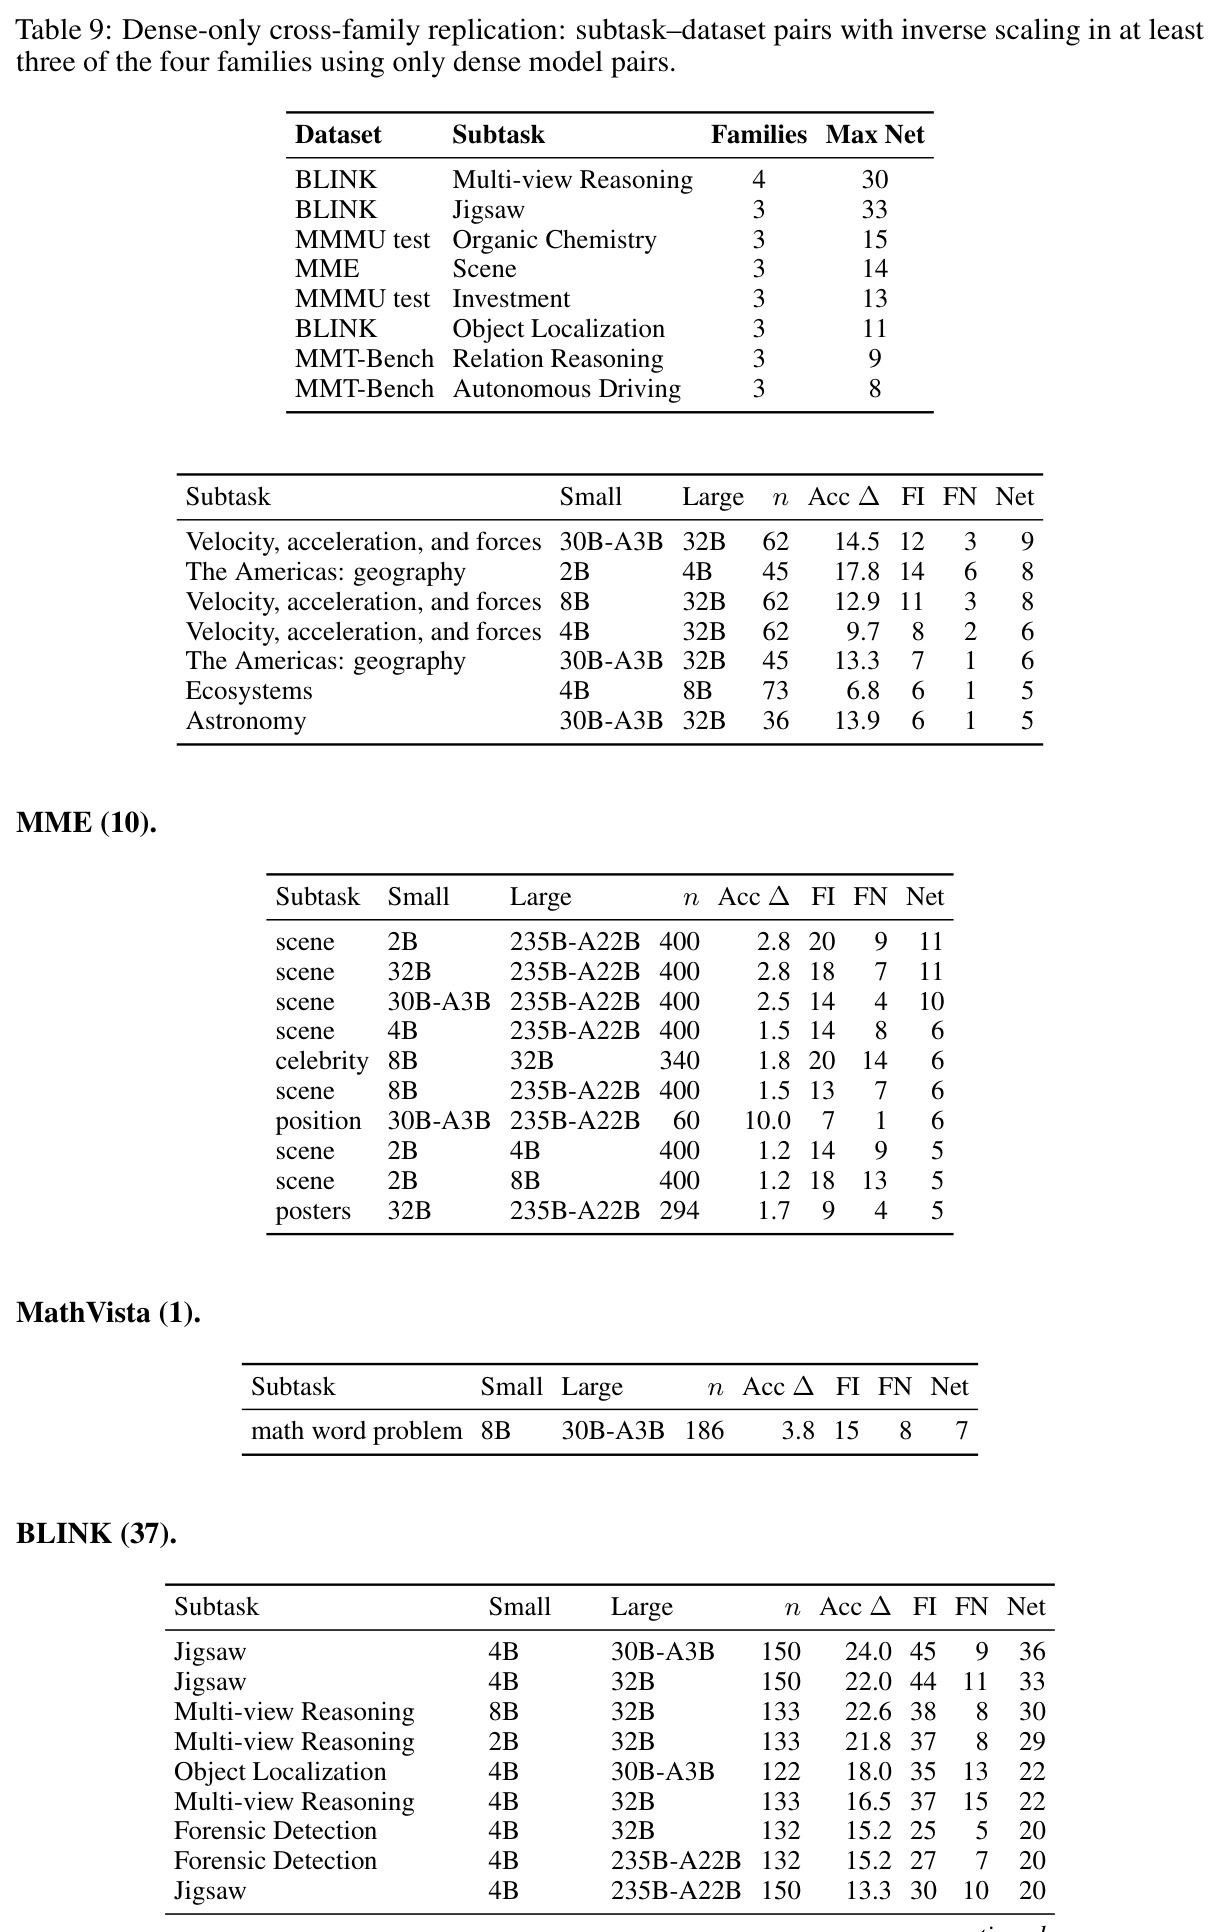
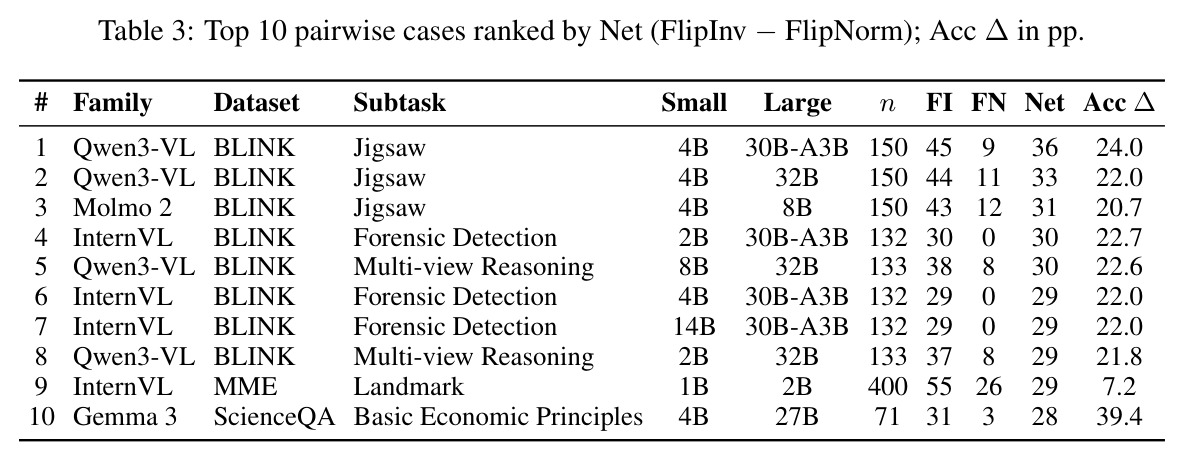
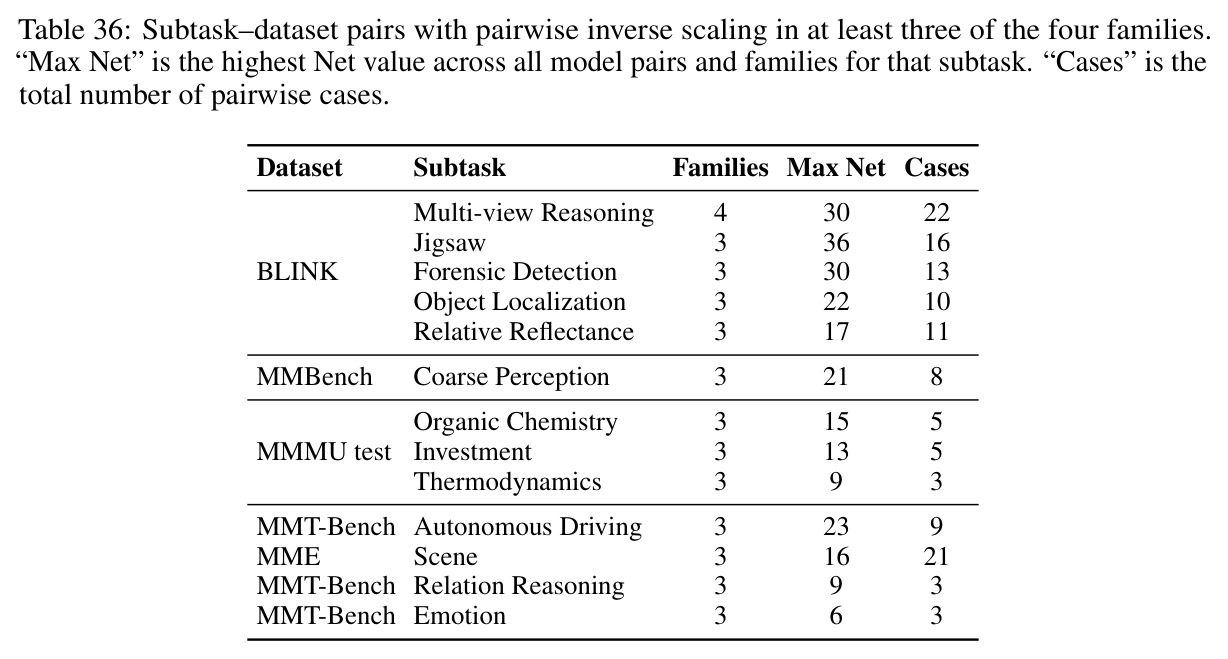
核心创新是把逆缩放检测从"子任务聚合准确率的比较"升级为"逐题正误翻转的配对分析"。聚合比较只能告诉你谁的总分高;翻转分析通过 $\mathrm{Net}$ 直接度量分歧题目的不对称性——例如 InternVL 2B 对 30B-A3B 在 BLINK Forensic Detection 上 $\mathrm{Flip}_{\mathrm{Norm}} = 0$,即 30 道分歧题全部是小模型对、MoE 大模型错,一道都没翻盘,这种结构性不对称在聚合分数里完全不可见。它还把 4,342 道"小模型对、大模型错"的具体题目枚举出来,使后续的错误类型学分析成为可能。第二个关键设计是同家族比较加跨家族复现的双重标准:家族内比较控制训练配方,回答"是不是规模相关的因素";"≥3 个家族在同一子任务复现"回答"是不是任务本身的性质"。13 个子任务-数据集对通过这一标准(BLINK 的 Multi-view Reasoning 更是出现在全部 4 个家族),支持"任务驱动而非模型特异"的结论。这与 McKenzie 等 2023 的构造任务法形成互补:本文在真实基准上观测,他们 in 实验室里制造。
方法步骤详情
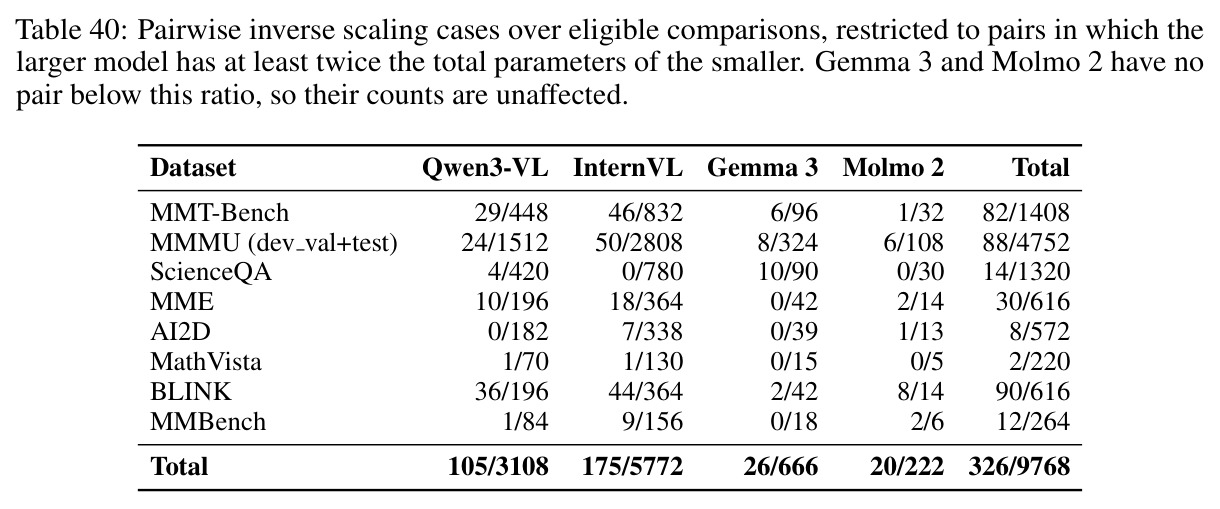
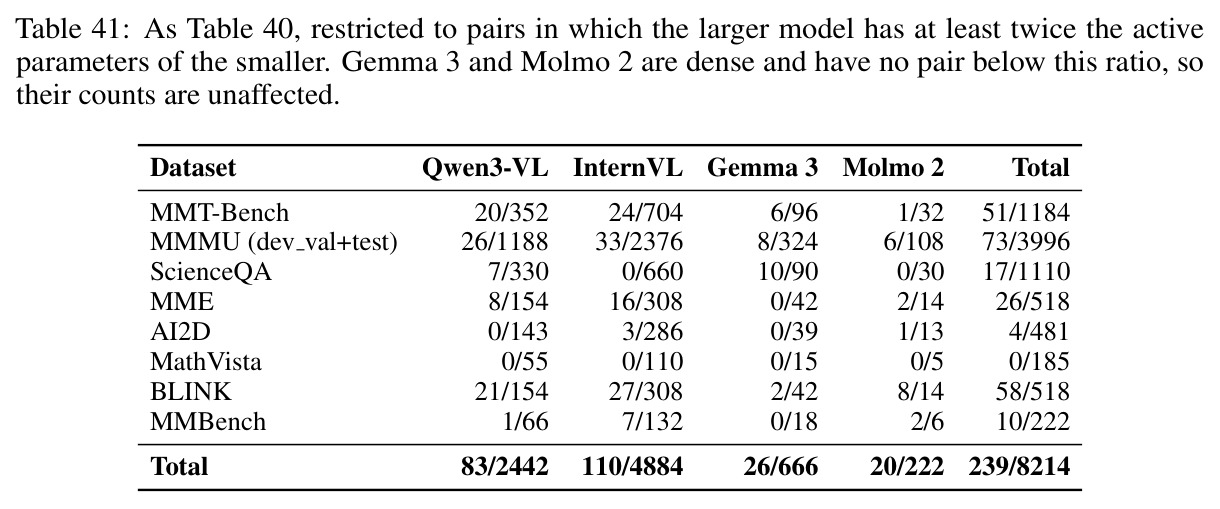
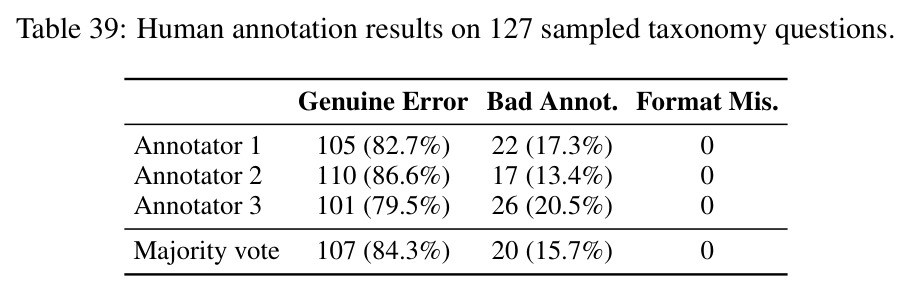
步骤一(评测执行):19 个开放权重模型 × 9 个评测划分共 171 次推理运行;zero-shot 直接提示,MCQ 只要求输出选项字母,开放式题要求简洁作答;贪心解码、思考模式关闭。步骤二(子任务划分):8 个基准按官方标签切成子任务,如 BLINK 14 个、MMBench 20 个、AI2D 15 个、MMMU test 177 个;每模型共评测 29,386 道唯一题目(558,334 次评测)。步骤三(翻转分析):每个 $K$ 个模型的家族贡献 $\binom{K}{2}$ 个配对,在每个子任务的共享题上计算 $\mathrm{Flip}_{\mathrm{Inv}}$(小对大错)、$\mathrm{Flip}_{\mathrm{Norm}}$(大对小错)、$\mathrm{Net}$;阈值 $n\ge 20$、$\mathrm{Net}\ge 5$ 筛出 375 个案例(涉及 115 个子任务-数据集对);阈值提高到 Net≥10 时仍剩 132 案例、4 个跨家族子任务。步骤四(稳健性):McNemar 单侧精确 p 值(133/375 即 35.5% 未校正 p<0.05,从 Net 5–7 的 10.4% 升到 Net≥21 的 100%,附录 D 做 Benjamini–Hochberg 校正);dense-only 重跑保留 193 案例、8 个跨家族子任务;限定大模型参数至少两倍保留 326 案例(按激活参数为 239);BLINK 六个强案例在所有确定性选项重排序下 Net 保持为正(附录 J)。步骤五(错误归因):每个案例最多抽 10 道翻转题,得 1,300 题,GPT-5.4 盲标(模型匿名化为 A/B、温度 0)判 97.4% 为真实错误;Claude Opus 4.6 复核一致率 90.8%(Cohen's κ=0.30);三位作者人工标注 127 题子样本(Fleiss κ=0.65、成对一致率 87–92%),保守估计 ≥84% 的翻转是真实模型失败。
技术新颖性
技术新颖性体现在四个层面。第一,对象新颖:作者声称这是首个对 VLM 在标准基准上系统研究逆缩放的工作——此前的证据要么来自构造的文本任务(McKenzie 等 2023),要么来自测试时算力维度(Gema 等 2025),要么来自人工干扰物(Bae 等 2025),没有工作在真实部署会用的基准里找这个现象。第二,度量新颖:$\mathrm{Net} = \mathrm{Flip}_{\mathrm{Inv}} - \mathrm{Flip}_{\mathrm{Norm}}$ 是一个对题目难度不敏感、只看配对分歧方向的统计量,配合 $n\ge 20$ 的样本量下限,能从 10,434 个合格比较中筛出可复核的 375 个案例并逐一列举失败题目——这是任何聚合指标做不到的。第三,验证设计严密:不依赖单一证据链,而是阈值敏感性(表 38)、dense-only(表 4)、两倍参数限制(附录 I)、选项重排序(附录 J)、跨家族复现(表 36)五重稳健性,加上 McNemar 检验与多重比较校正意识。第四,归因管线新颖:双 LLM 评审加三位作者人工校验的三方标注(Fleiss κ=0.65)量化了"翻转确实是真实错误"(保守 ≥84%),并用双模型 CoT 重跑(66,698 次配对评测)排除"小模型只是没推理"的替代解释——因为小模型也重跑了,Persistence 无法用推理深度差异解释。
实验结果
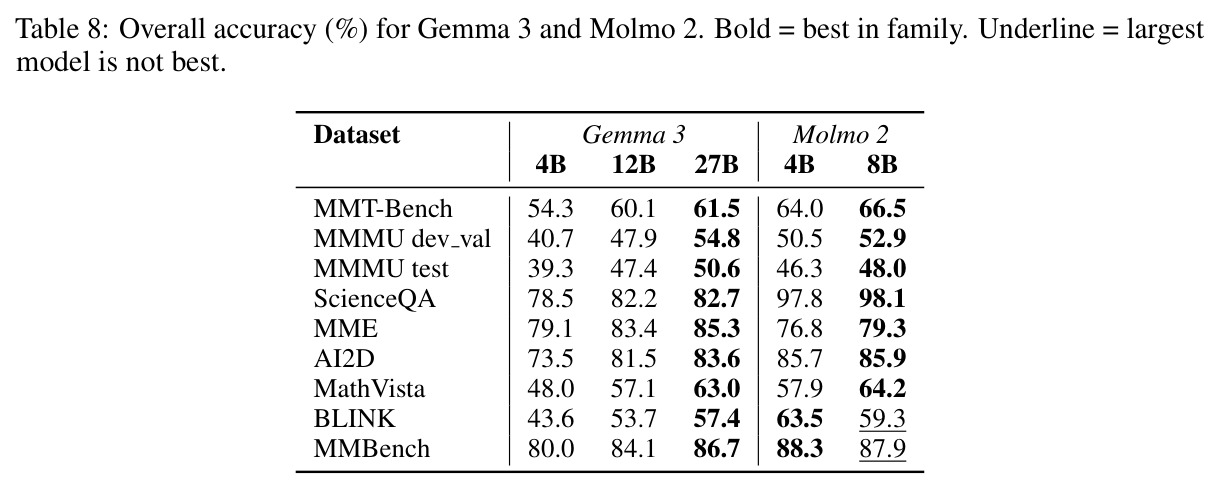
核心发现按层次展开。(1)普遍性:逆缩放在全部 4 个家族、全部 8 个基准上出现,共 375 个子任务-模型对案例(占 10,434 个合格比较的约 3.6%),涉及 115 个子任务-数据集对和 4,342 道"小模型对、大模型错"的题目;仅相邻档位比较(如 4B→8B)就有 197 个案例,说明这不只是顶端尺寸的边缘现象;87% 的家族-子任务组合呈非单调曲线而非持续退化。(2)跨家族复现:13 个子任务-数据集对在 ≥3 个家族复现——BLINK 占 5 个(Multi-view Reasoning 出现在全部 4 家族、22 案例;Jigsaw Max Net=36;Forensic Detection Max Net=30),另有 MMBench Coarse Perception、MMMU 的 Organic Chemistry/Investment/Thermodynamics、MMT-Bench 的 Autonomous Driving(Max Net=23)/Relation Reasoning/Emotion、MME Scene。(3)最强案例:Qwen 4B 在 BLINK Jigsaw 上 84.0% vs 30B-A3B 的 60.0%(+24.0pp,Net=36);InternVL 三个 dense 模型对 30B-A3B 的 Forensic Detection FlipNorm=0;Gemma 3 4B 在 ScienceQA Basic Economic Principles 上比 27B 高 39.4pp;12B 在 Particle motion and energy 上 95.1% vs 27B 的 51.2%(+43.9pp);Qwen 2B 在 MMMU test AI Content Detection 上 65.0% vs 235B-A22B 的 45.0%。Top 10 案例差距 7.2–39.4pp。(4)领域分布:多图空间推理(BLINK)、视觉感知(MME)、大学级 STEM(MMMU)受影响最重;归一化后 BLINK 逆缩放率最高(14.4%),而图表理解 AI2D 仅 9 案例、最抗逆缩放。(5)非单调的极端例子:InternVL 在 MMMU Mechanics of Materials 上从 1B 的 27.6% 波动到 241B-A28B 的 27.6%(38B 为峰值 62.1%),首尾一样差。(6)CoT 只部分挽救:对全部 375 案例双模型重跑后中位 Net 从 +8 降到 0,96 案例(25.6%)保持 Net≥5,101 个反号;大模型只找回其失分题的 43.5%(3,640/8,361),且小模型在 251 个案例中准确率反而下降;顽固性按基准分化——MME 48.6%、BLINK 42.1% 存活,MMMU test 仅 7.6%。(7)错误真实性:人工保守估计至少 84% 的翻转是真实模型错误,视觉推理基准(BLINK、ScienceQA)上人与 LLM 一致认为几乎全部为真错。
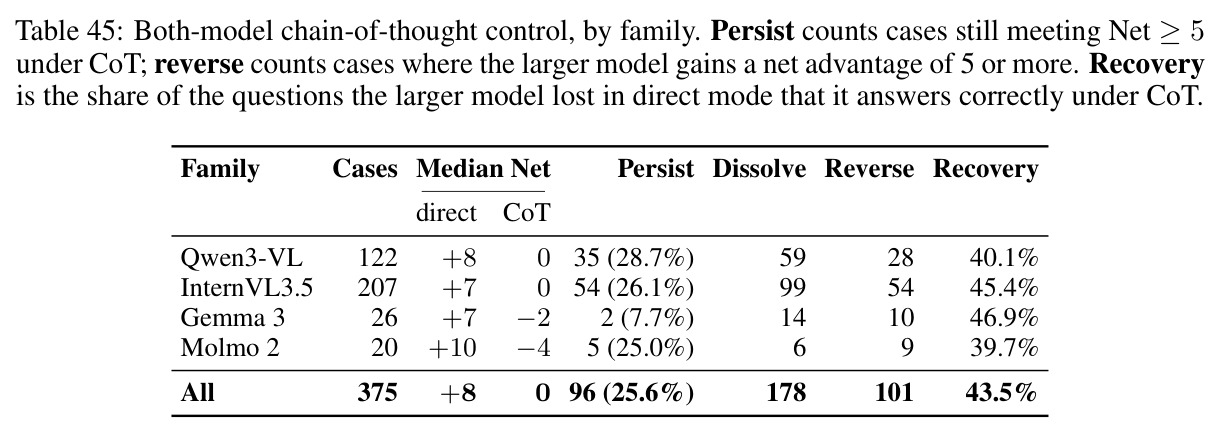
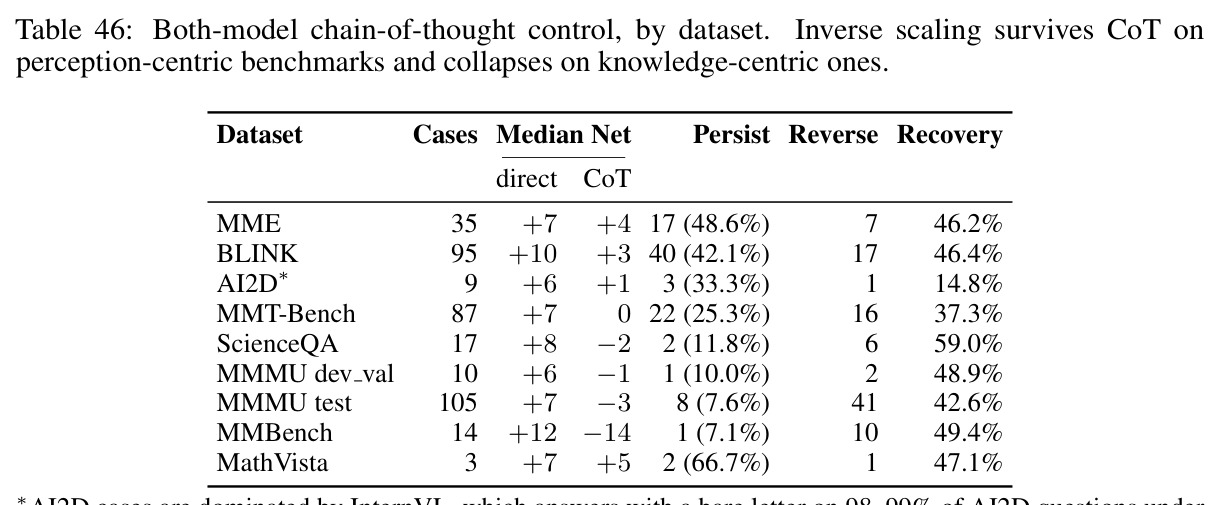
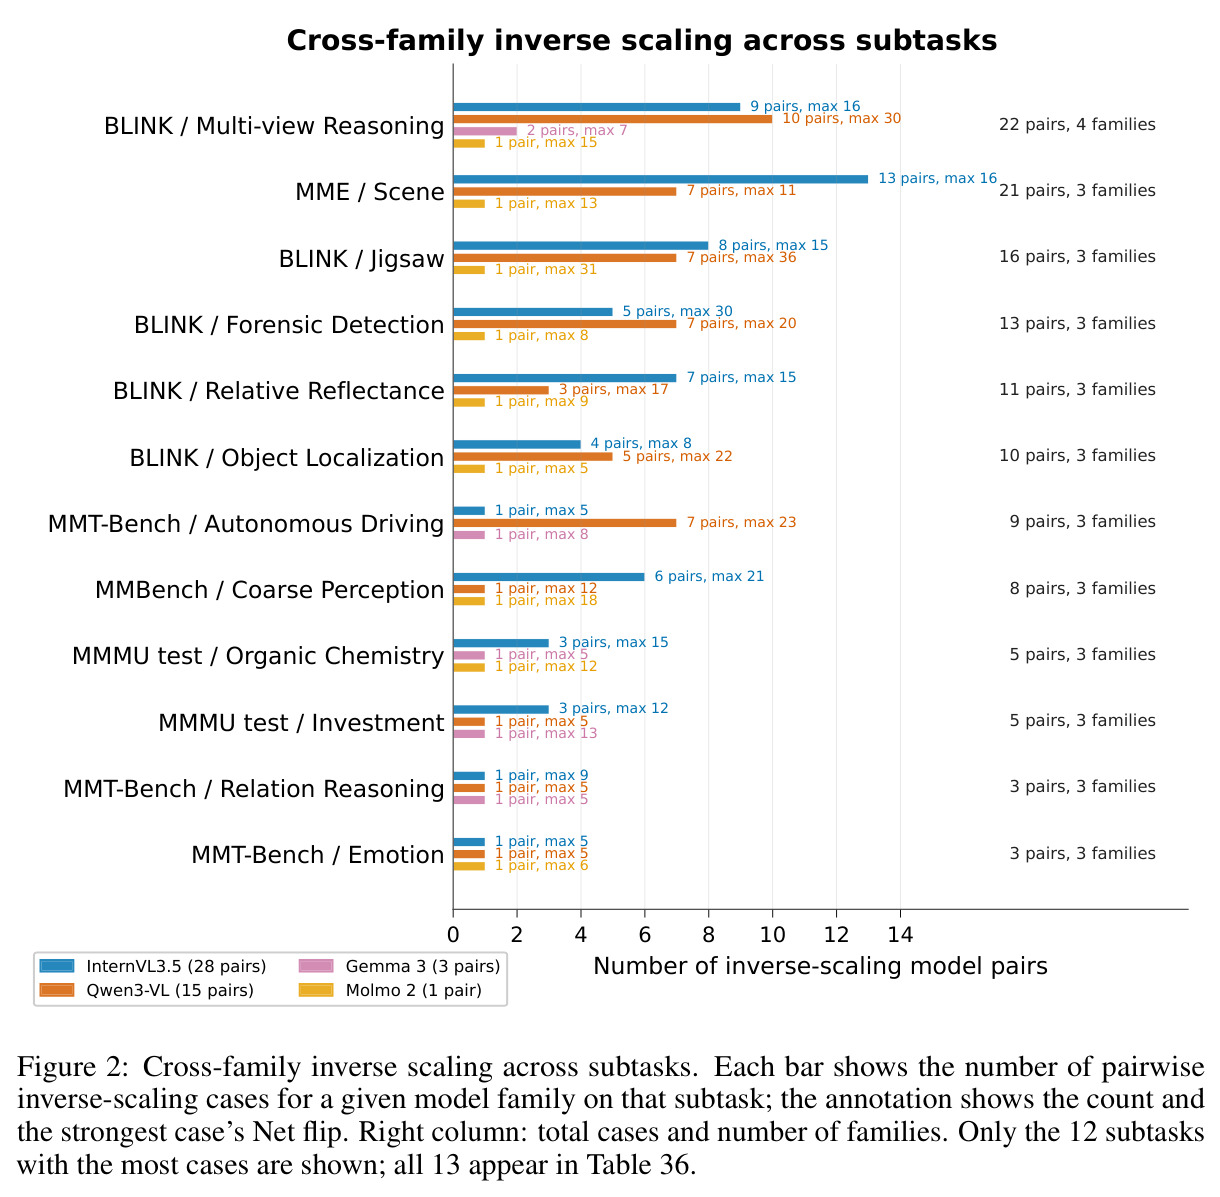
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BLINK Jigsaw(拼图补全) | 准确率 | Qwen3-VL 4B:84.0% | Qwen3-VL 30B-A3B(MoE):60.0% | +24.0pp(Net=36,全文最强案例) |
| BLINK Forensic Detection | 准确率 | InternVL3.5 2B:领先 22.7pp(FlipInv=30, FlipNorm=0) | InternVL3.5 30B-A3B(MoE) | +22.7pp,且大模型一道分歧题都没答对 |
| ScienceQA Basic Economic Principles | 准确率 | Gemma 3 4B:领先 39.4pp(Net=28) | Gemma 3 27B | +39.4pp(Top 10 中最大差距) |
| ScienceQA Particle motion and energy | 准确率 | Gemma 3 12B:95.1% | Gemma 3 27B:51.2% | +43.9pp(Net=18) |
| BLINK(聚合层面) | 准确率 | Molmo 2 4B:63.5% | Molmo 2 8B:59.3% | +4.2pp,聚合层面即出现逆缩放 |
| MMMU test AI Content Detection | 准确率 | Qwen3-VL 2B:65.0% | Qwen3-VL 235B-A22B:45.0% | +20pp,最小模型全家族最佳 |
| BLINK 子任务整体(跨家族汇总) | 逆缩放案例占比 | 95/658 合格比较 = 14.4%(各基准最高) | AI2D:9/611 ≈ 1.5%(最抗逆缩放) | 感知型基准受影响最重,图表理解最免疫 |
| 全部子任务(dense-only 复核) | 逆缩放案例数 | 193 例(8 个子任务跨 ≥3 家族复现) | 全量分析:375 例(13 个跨家族子任务) | 排除 MoE 后现象依然过半保留,非 MoE 伪影 |
局限与改进
作者明确承认的局限有六条:只测开放权重模型(闭源模型参数量与配置不可验证,缩放分析无法核实);翻转分析对所有题等权、不区分难度;跨家族复现只是观察性证据,不建立因果机制;同一家族名下的模型可能在视觉编码器、训练数据、对齐流程、激活参数上不同(附录 K 证实:Qwen3-VL 2B/4B 用 SigLIP2-Large 而更大档用 SigLIP2-SO-400M,InternVL3.5 到 14B/30B-A3B 用 InternViT-300M 而 38B/241B-A28B 用 InternViT-6B),因此结果描述的是发布变体间的子任务回归而非参数量的因果效应;更大的 checkpoint 可能见过更多基准数据,无法排除规模相关的污染;结果依赖选项顺序——最强 BLINK 案例在重排序下存活,但题目改写(paraphrase)未测试。我补充几点观察:其一,Net≥5 的绝对阈值在 n=20 时对应 25pp 差距、在 n=1,109 时只对应 0.45pp,所以各基准的"案例数"不可直接横向比较,作者也承认只做描述性解读;其二,375 案例中仅 35.5% 有未校正 p<0.05,大量案例是弱信号,跨家族复现虽是强证据但只有 13 个子任务通过;其三,评测只覆盖 zero-shot 直接提示,未测 few-shot、工具调用或厂商实际部署常用的提示策略;其四,四个家族都是 2025–2026 年的开放模型,结论向闭源前沿模型的外推完全未验证。
独立分析的弱点
独立分析出的弱点:(1)家族内比较的控制变量是不完全的——同家族不同档位常换语言底座、视觉编码器和数据配方,观察到的"逆缩放"可能反映的是工程决策(如为省算力换小编码器)而非规模规律本身。改进方向即作者自己也呼吁的:用单一配方训练多尺寸 VLM 的受控研究,或至少做编码器同层的分层分析(附录 K 已做:72.3% 案例同层,排除后 13 个跨家族子任务剩 10 个)。(2)机制解释缺位:四个假说(局部能力回归、干扰物敏感、MoE 路由、数据配比)都只是"与观察相容",没有任何干预实验(激活探针、注意力分析、训练数据溯源)支撑。改进方向:沿 Bae 等 2025 的干扰物范式对这 4,342 道真实失败题做受控复现,检验干扰物假说能否解释它们。(3)子任务标签粒度跨基准极不统一(MMMU test 177 个 vs MME 14 个),"BLINK 14.4% vs MMMU 2.3%"这类归一化比较受粒度影响。改进方向:跳出基准自带标签,按统一的能力本体(如"多图对应"“深度估计")重新标注题目。(4)实用价值未量化:24pp 的差距出现在 150 道题上,但真实部署流量中有多少落在这些子任务上、换小模型能省多少成本,文中未讨论。(5)错误分类虽有人工校验子样本(127 题),全量 1,300 题的分类仍出自 GPT-5.4 单一评委,且 GPT 与人工的"真实错误"判定阈值差异明显(97.4% vs 84.3%)。
未来方向
作者提出或暗示的方向:(1)受控训练研究——用一套完全公开的训练配方训练多个尺寸的 VLM,把参数量与编码器、数据、对齐等混杂分离,使逆缩放分析可复现、可归因;(2)鲁棒性补课——测试题目改写(paraphrase)而不仅是选项重排序;(3)机制层面解释逆缩放为何在多图空间推理和 STEM 子任务上集中发生。基于本文成果可自然延伸的方向:(1)把翻转分析工程化为持续回归监控:新 checkpoint 发布时自动对上一代做子任务级 diff,把本文的离线研究变成发布流水线的回归测试;(2)二维失败地图——结合 Gema 等 2025 的测试时算力逆缩放,画"参数量 × 思考长度"平面上的失败区域,回答 CoT 救不了的那 25.6% 案例加算力能否救;(3)数据配比假说的直接检验:追溯大模型多见的数据中哪些分布(如单图配文)挤占了多图空间关系的预训练覆盖,做配比干预实验;(4)针对 BLINK 类感知任务的架构或训练干预(更高分辨率视觉 token、多图对齐预训练目标),验证局部能力回归可否被修复;(5)把"任务感知选型"落地为路由系统:感知型查询走小模型、知识型查询走大模型,用本文数据估算成本-质量帕累托前沿。
复现评估
复现条件非常好。所有 19 个模型均开放权重,附录 A 给出确切的 HuggingFace 标识符、所用算力与 API 配置;分析代码开源于 github.com/saxenarohit/vlm_inverse_scaling;评测协议遵循开源的 VLMEvalKit;每个基准的完整提示词在附录 G 复现,案例筛选阈值($n\ge 20$、$\mathrm{Net}\ge 5$)与 CoT 对照设定在正文 4.1 和附录 L 明确说明;基准全部公开(MMMU test 需注册下载)。算力门槛是主要成本:总评测量 558,334 次模型-题目评测加 CoT 对照的 92,694 次,最大模型为 235B-A22B 的 MoE(激活 22B),由 Edinburgh International Data Facility (EIDF) 支持——拥有 8×A100/H100 级别资源的实验室可以完整复现,单卡用户则只能复现 Gemma 3(4B–27B)和 Molmo 2(4B/8B)等小模型部分及对应案例。外部依赖是 GPT-5.4 作为答案裁决(0.4% 回答)与错误标注器、Claude Opus 4.6 复核,需要 API 访问但费用不高。总体评估:中等难度——推理算力是大头,分析部分(翻转统计、McNemar、阈值扫描)都是确定性计算,代码与阈值齐全,结果表(附录 B/C 全部 375 案例)足以逐条核对。
论文图表