任务组合下的脆弱性:语言模型的隐式思考预算 On the Fragility of Tasks under Composition: Implicit Budgeting in Language Models
组合任务触发隐式思考预算缩水,长推理任务率先失效,按脆弱性分批可省43%token
前置知识
思考 token / 思考预算(thinking budget)
推理模型(如 Qwen3 Thinking、DeepSeek-R1、Claude 扩展思考)在给出最终答案前先生成一段思维链,这段中间过程消耗的 token 数就是思考预算。投入的思考量直接影响解题成功率:外部提前截断思维链会显著降低准确率。
本文的全部论证都建立在「每任务思考 token 数 $T_i(k)$」这一可测量上,读懂它才能理解幂律缩水与脆弱性的含义。
幂律缩放(power law)
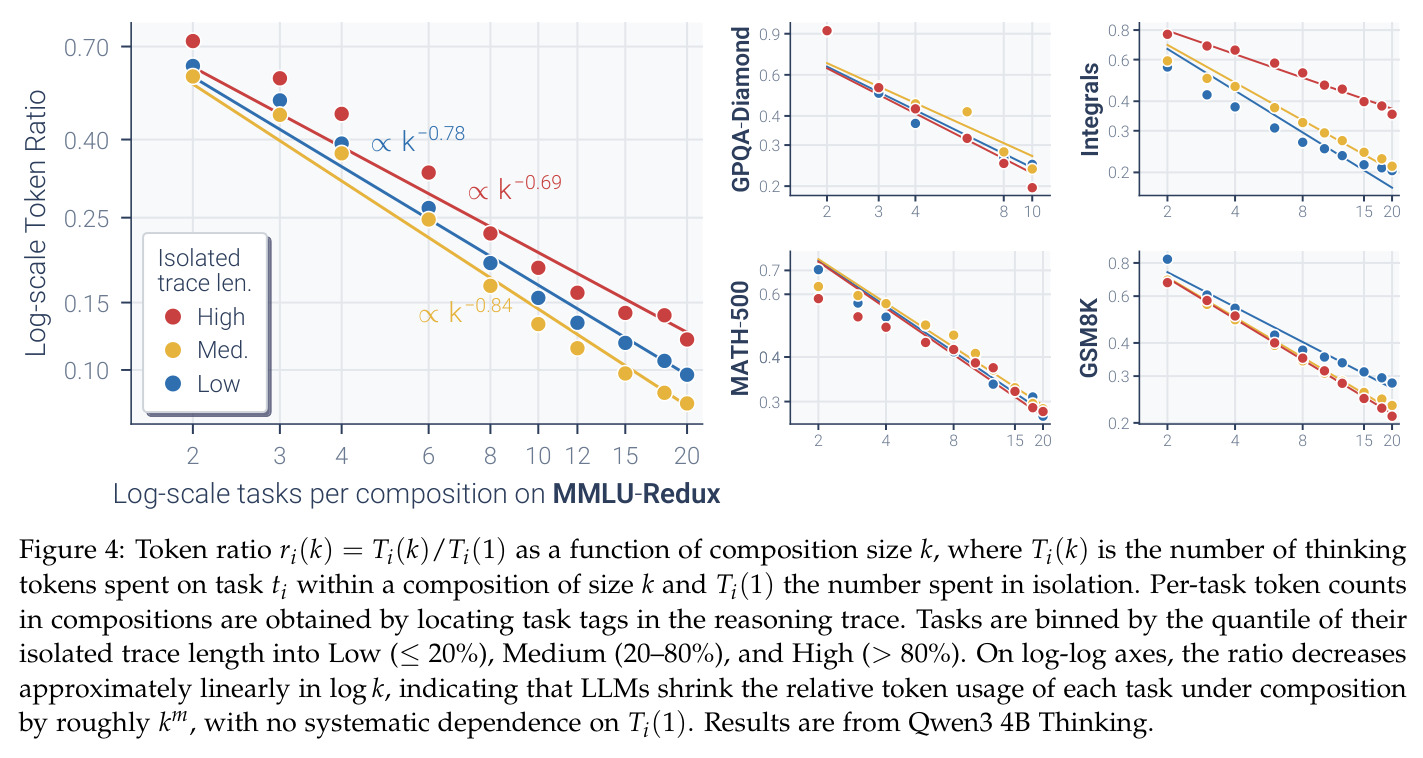
形如 $y \approx x^m$ 的关系,在双对数坐标下表现为一条斜率为 $m$ 的直线。本文发现每任务思考 token 比率 $r_i(k) = T_i(k)/T_i(1)$ 近似等于 $k^m$($k$ 为组合内任务数),即组合规模每扩大一倍,每任务推理量按固定比例打折。
幂律是本文的定量核心:拟合出斜率 $m$(中位 $-0.54$)才能预测任意组合规模下的 token 缩减,进而设计分批策略。
独立错误累积
若每个子任务以概率 $p$ 独立失败,则 $k$ 个任务的组合失败率约为 $1-(1-p)^k$。这是过去解释「多任务一起问就掉分」的主流假说,预测的退化完全由单独任务的错误率决定。
本文实验显示实际退化远超累积假说的预测,理解这一基线假说才能体会「隐式预算错配」解释的革命性。
后训练三阶段 SFT / DPO / RLVR
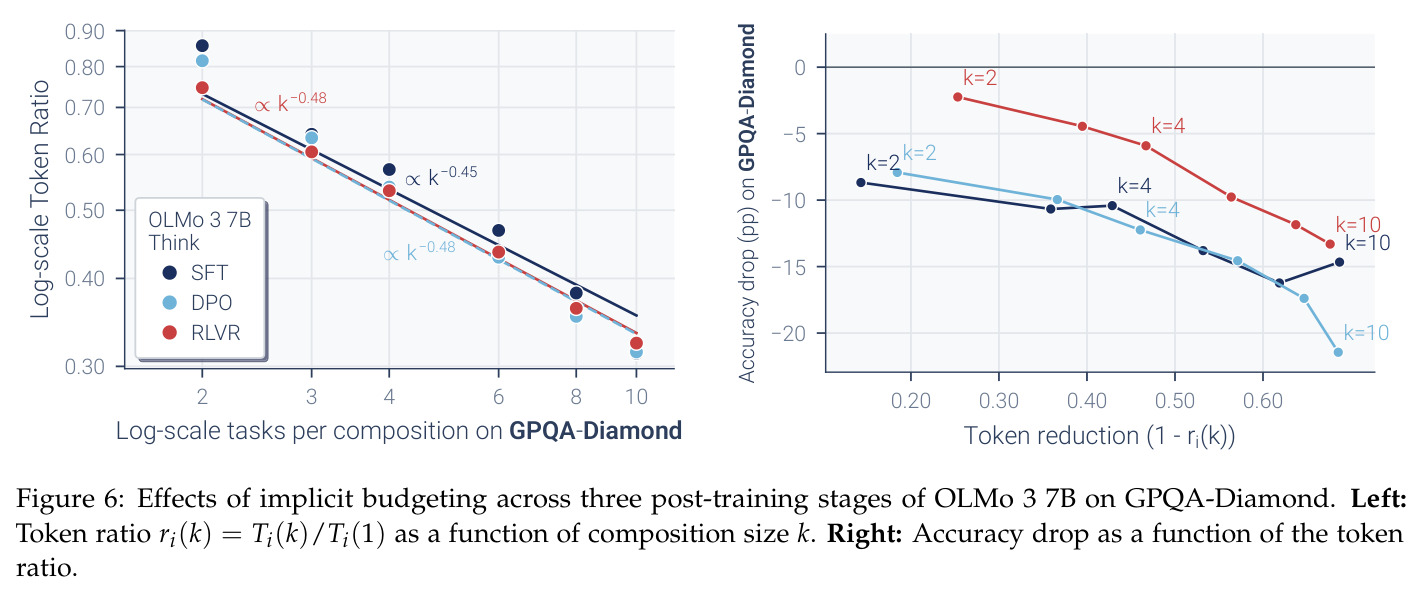
SFT(监督微调)用示范数据教模型格式与行为;DPO 用偏好对比对优化回答质量;RLVR(可验证奖励的强化学习)用可自动判分的奖励(如数学答案对错)直接优化推理。OLMo 3 公开了这三个连续阶段的检查点。
论文第 5 节用 OLMo 3 的三个阶段拆解后训练对组合退化的影响,结论是 RLVR 缓解后果但不消除机制本身。
拉格朗日松弛
把带约束的优化问题(最大化省 token,同时期望精度损失不超过 $B$)转成无约束形式:目标函数加一个乘子 $\lambda$ 乘以约束项,扫描不同 $\lambda$ 等价于在精度—成本曲线上取不同的权衡点。
fragility-aware batching 的组合大小分配 $k_i(\lambda)$ 就是用它求解的,$\lambda^*$ 由保留集网格搜索加嵌套 5 折交叉验证确定。
研究动机
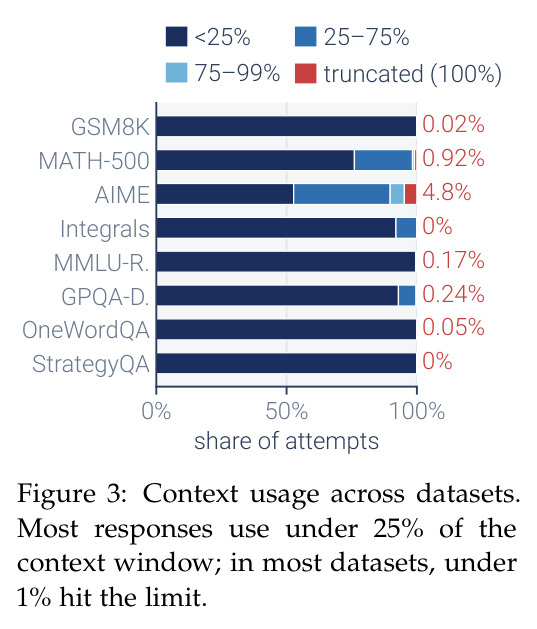
主流基准(GPQA-Diamond、GSM8K、MATH-500、MMLU-Redux 等)几乎都是一次只考一个任务,而真实使用中用户经常在同一个提示里塞进多个问题、多道题或一串指令。已有工作把多任务提示下的精度下降归因于「独立错误累积」:每个任务有非零失败率,放在一起自然更容易失败;另有解释认为模型在组合题上模仿训练中的解题模式、或无法组合各自已知的事实。但作者指出这些只解释了一半——组合同时改变了任务结构和 token 需求,此前并不清楚成员任务本身的能力是否退化。对照实验显示退化远超累积预测:在 GPQA-Diamond 上,把模型单独三次全对的任务原样拼成 10 个一组的提示后,连 Claude Opus 5 都掉了约 7 个百分点,R1 蒸馏的 Qwen 7B 在 $k=6$ 时掉 25.5pp;而绝大多数回答远未触顶上下文窗口(多数数据集截断率低于 0.3%),说明这不是上下文截断问题。
本文的目标是作者要回答一个干净的问题:一个能可靠单独解决某任务的模型,把同一批任务原样拼接进单个提示后还能不能解?为此建立受控设定:先筛选出每模型「自信解出」的任务集 $D_M$(单独 3/3 全对),再用固定模板把 $k\in\{3,6,10,20\}$ 个任务拼进一个提示,用 5 次独立采样估计每个成员任务的准确率变化 $\Delta_i(k)=\mathrm{acc}_i(k)-\mathrm{acc}_i(1)$,从而把「组合带来的退化」与「任务本身解不出」分离开。更进一步,作者想找出退化的机制:解释为什么退化集中在部分任务、刻画每任务思考 token 随组合规模 $k$ 的缩放规律,并把规律转化成「按脆弱性分批」的推理省 token 策略,在开源模型和 Claude Opus 5 这样的专有前沿模型上都验证有效。
与已有工作不同的是,与「错误累积」「匹配训练中的解题模式(Dziri 等)」「无法组合已知事实(Press 等)」等既有解释不同,本文提出组合退化源于模型对隐式思考预算的错配:模型按比例给每个任务分配推理量,组合时统一乘以 $k^m$ 的缩减因子,而不是各任务独立地随机出错。独特切入有三点。一是测量手段:用提示内标签(Q01、Q02…)把一条混合思维链切分归属到各任务,首次测得「组合内每个成员任务」的思考 token 数。二是定量刻画:发现缩减近似幂律 $r_i(k)\approx k^m$(中位斜率 $m=-0.54$,中位 $R^2=0.91$),且缩减比例与任务单独时的推理长度无关,说明是全局统一折扣而非按需分配。三是性质分析:证明脆弱性是模型内稳定(跨组合规模相关 0.81)、跨模型不稳定(相关 0.24)的属性,因而可测量、可预测、可被纯黑盒的分批干预所利用。
核心方法
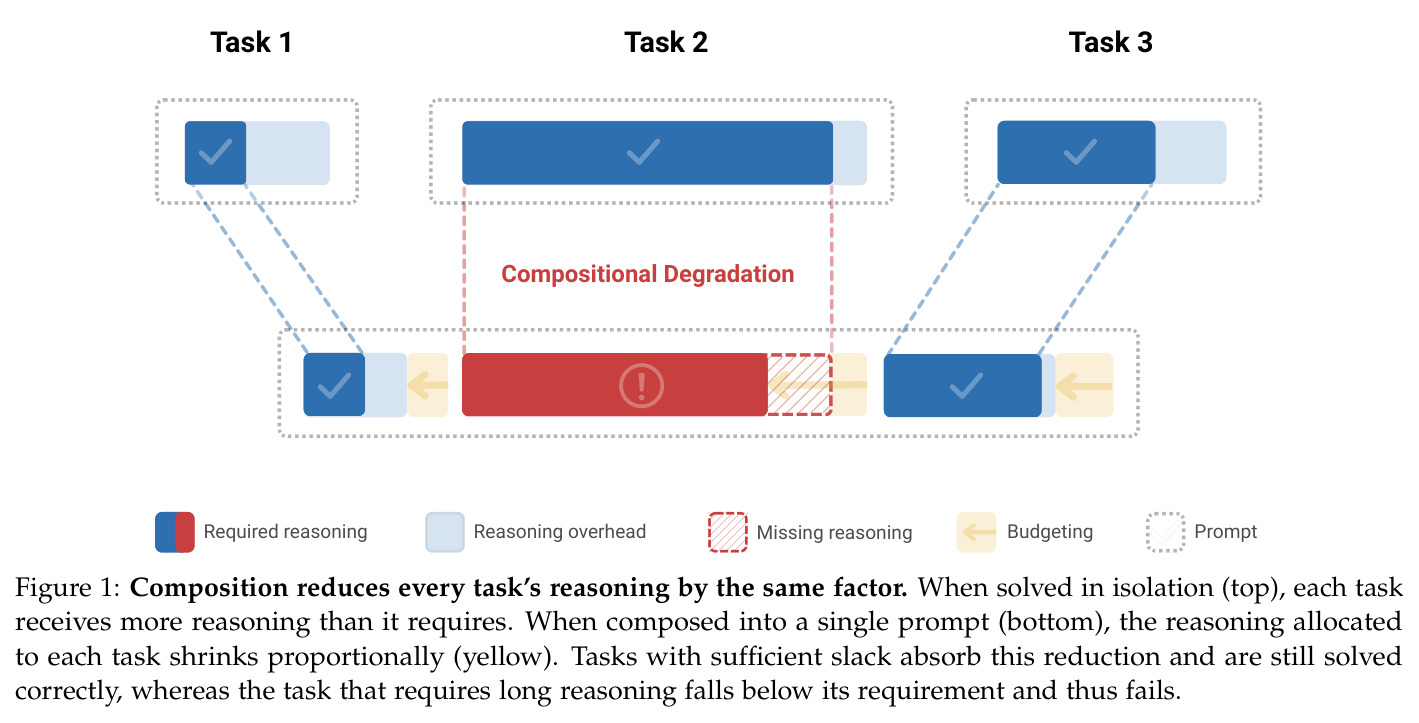
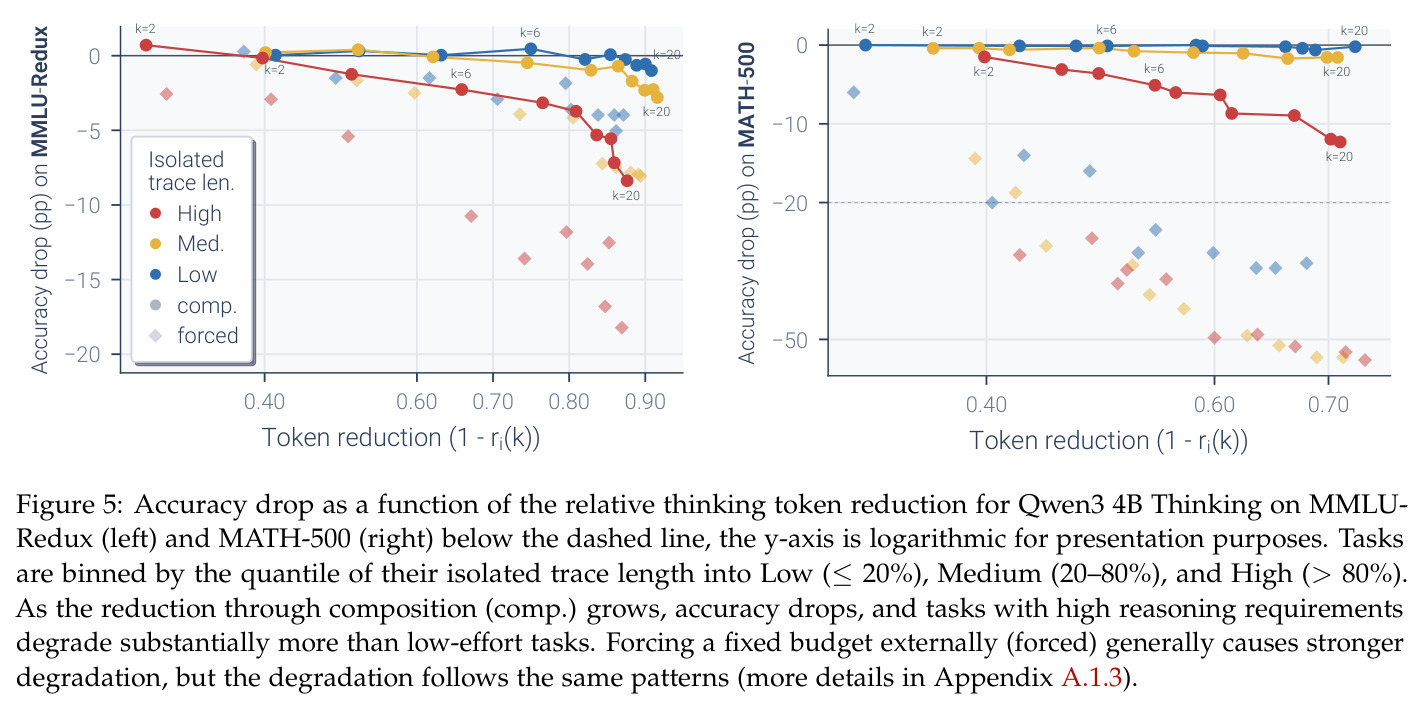
直觉上,推理模型像在心里维护一个「总思考预算」,一个提示里任务越多,分给每个任务的份额就越小。技术上分三步。第一步是测量:给每个任务加唯一标签(Q01、Q02…),模型推理时这些标签会出现在思维链里,据此把单条轨迹切成段,数出每个任务在组合规模 $k$ 下花掉的思考 token $T_i(k)$,除以单独求解的 $T_i(1)$ 得到比率 $r_i(k)=T_i(k)/T_i(1)$。第二步是刻画:在双对数坐标上过原点拟合,得到幂律 $r_i(k)\approx k^m$,各模型×数据集的中位斜率 $m=-0.54$(范围 $[-0.88,-0.04]$)、中位 $R^2=0.91$。第三步是利用:按测得的脆弱性给任务分配组合大小——解拉格朗日松弛 $k_i(\lambda)=\arg\max_{k\in K}\mathbb{E}[\Delta_i(k)]+\lambda(1-\mathrm{cost}_k)$,把期望精度损失控制在预算 $B=0.5\%$ 内,实测平均省 43% token 而精度不掉;再用 Qwen3 Embedding 8B 固定嵌入加每模型一个线性探针预测未见任务的脆弱性,平均省 31.0% token、精度损失不超过 0.5pp。
核心创新是把组合退化从「能力问题」重述为「预算分配问题」。关键证据是:所有任务的思考 token 几乎按同一比例缩减($r_i(k)\approx k^m$),且缩减幅度与任务单独时的推理长度无关——单独需要长推理的任务并不会少缩一点。也就是说,模型保留了任务间的相对分配(单独要长推理的任务在组合内仍相对更长),但对所有任务施加统一的比例折扣。短推理轨迹含有冗余、缩完仍高于需求;长推理轨迹本就贴近最低需求、缩完跌破阈值,于是退化集中在「长推理任务」,作者称之为脆弱任务。与已有方法的本质区别在于:过去用错误率或能力缺失解释多任务失败,本文用思考 token 的系统性错配来解释,并证明该机制在每模型内稳定(同模型跨 $k$ 的脆弱集合相关 0.81±0.04)、可测量、可干预——不需要微调或访问内部状态,纯靠重新组织提示分组就能操作隐式预算。
方法步骤详情
完整流程:1) 任务筛选:每模型单独跑 3 次,只保留 3/3 全对的任务构成 $D_M$,确保能力在场。2) 构造组合:用每数据集固定模板把 $k\in\{3,6,10,20\}$ 个任务拼成一个提示(类别均匀采样),每题前加唯一标签 Q01…,开源模型温度 0.6、上下文不少于 131072,每组 5 次采样,把单条回答拆成 $k$ 个答案逐题判分。3) token 归因:在推理轨迹中定位标签,数出每任务的 $T_i(k)$,除以单独的 $T_i(1)$ 得 $r_i(k)$。4) 幂律拟合:对 $\log r_i(k)\approx m\log k$ 过原点拟合,得每模型×数据集的斜率 $m$。5) 脆弱性分析:按单独轨迹长度分位分箱(Low≤20%、Med、High>80%),画精度损失随 token 缩减的变化,用衰减校正后的 Pearson 相关比较不同条件下的脆弱集合。6) 分批优化:保留集上网格搜索 $\lambda^*$(嵌套 5 折交叉验证),$K=\{1,3,6,10,20\}$、预算 $B=0.5\%$,再贪心把任务并进尽量少的组合。7) 脆弱性预测器:Qwen3 Embedding 8B 固定嵌入加每模型一个线性探针,标签来自每任务在 4 个规模各 10 次的组合内评估,5 折 cross-fitting 输出未见任务的预测。8) 后训练分析:在 OLMo 3 7B 的 SFT、DPO、RLVR 三阶段重复上述测量。
技术新颖性
技术新颖性体现在四个层面。测量层面:用提示内标签把一条混合思维链按任务切分归因,这是以前的多任务评测没做过的,把「机制」从猜测变成可测量的对象。刻画层面:给出幂律 $r_i(k)\approx k^m$ 的定量规律(中位 $m=-0.54$、$R^2=0.91$),并证明缩比例与任务难度无关,从「组合会省 token」这一已知现象推进到「每任务均匀折扣」的机制刻画。分析层面:用衰减校正相关证明脆弱性是模型内稳定属性(同模型跨 $k$ 相关 0.81)而跨模型不稳定(0.24),回答了「脆弱是谁的属性」这一被忽视的问题——同一配方训练的 Qwen3 8B/14B 之间也只有 0.56。应用层面:fragility-aware batching 完全黑盒、无需训练或内部状态,直接重组提示即可操作隐式预算,因此能直接作用于无法访问内部的 Claude Opus 5(GPQA-Diamond 省 24.3% token、仅损 0.4pp),这是与需要白盒访问的方法(如强制截断思维链)的关键差别。
实验结果
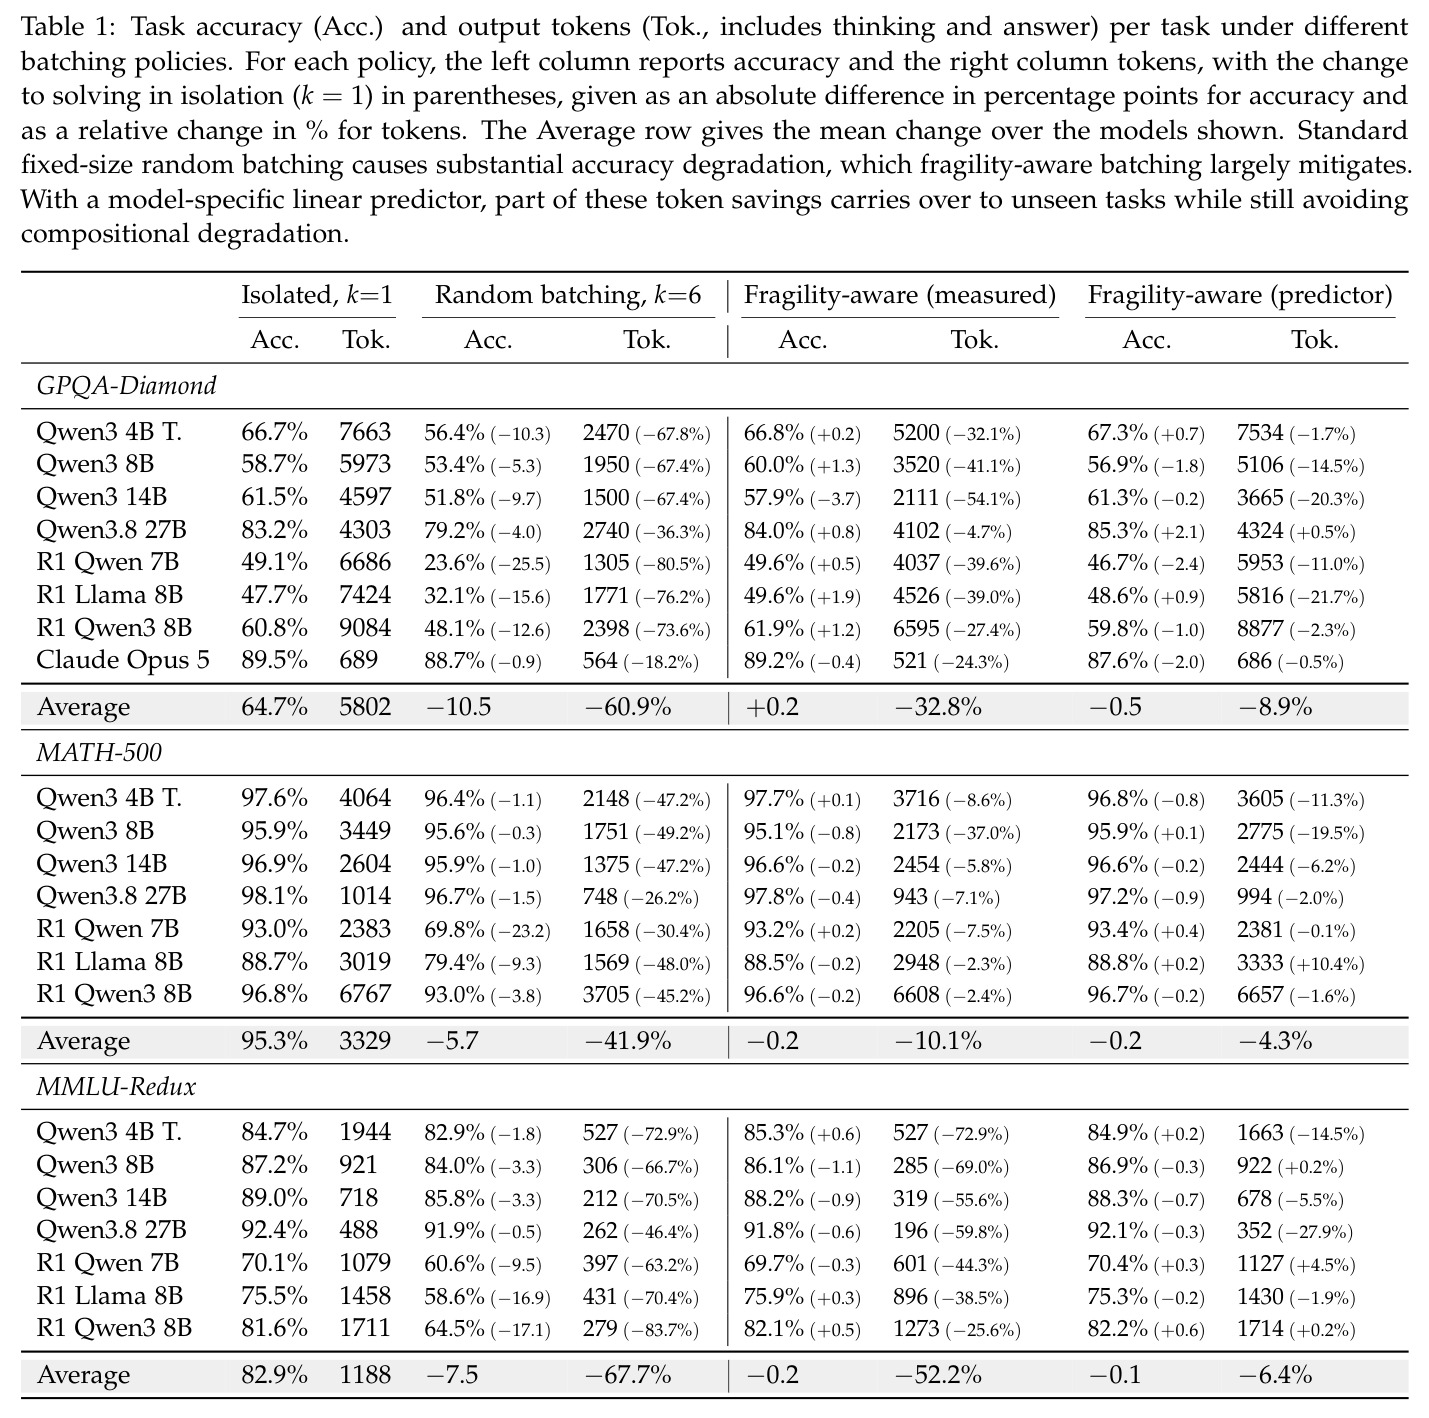
1) 组合退化普遍存在:把单独 3/3 全对的任务拼成 10 个一组后,GPQA-Diamond 上所有模型都掉分——R1 蒸馏模型最重(R1 Qwen 7B 在 $k=6$ 掉 25.5pp),Qwen3 系列次之,Claude Opus 5 在 $k=10$ 掉约 7pp;需长推理的数据集(GPQA、GSM8K、MATH-500、MMLU-Redux、AIME、Integrals)全部退化,几乎不需推理的 OneWordQA 和 StrategyQA 不退化。上下文截断率除 AIME 4.8%、MATH-500 0.92% 外均低于 0.3%,排除截断解释。2) 隐式预算幂律缩水:除一个例外,几乎所有任务的思考 token 随 $k$ 单调下降,拟合 $r_i(k)\approx k^m$ 中位 $m=-0.54$、中位 $R^2=0.91$。3) 脆弱归因:按单独轨迹长度分箱,High 组退化远大于 Low 组;外部强制固定预算的退化模式相同但更剧烈。4) 稳定性:同模型跨组合大小相关 0.81±0.04,跨模型仅 0.24±0.03(同配方 Qwen3 8B/14B 间 0.56±0.09)。5) 分批收益:随机 $k=6$ 在 GPQA 平均 −10.5pp、省 60.9% token;脆弱感知分批 +0.2pp、省 32.8%;预测器版 −0.5pp、省 8.9%。全数据集平均:测量版省 43% token 且精度 +0.6pp,预测器版省 31.0%、损失≤0.5pp;OneWordQA/StrategyQA 都省 68–74%。6) 前沿模型迁移:Claude Opus 5 GPQA 隔离 89.5%、689 token/题,脆弱感知分批 −0.4pp、省 24.3%。7) 后训练:OLMo 3 7B 三阶段 token 缩减几乎相同,但 RLVR 精度损失显著更小(SFT 与 DPO 脆弱集合相关 1.03±0.35,RLVR 对 SFT 仅 0.69±0.23、对 DPO 0.89±0.26),说明 RLVR 缓解后果而非机制本身。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GPQA-Diamond(8 个模型平均) | 准确率变化 / 每任务输出 token 变化(相对单独求解) | 脆弱感知分批(测量版):+0.2pp / −32.8% | 随机分批 $k=6$:−10.5pp / −60.9% | 避免约 10.7pp 的准确率损失,同时保留约一半的 token 节省 |
| Claude Opus 5 on GPQA-Diamond | 准确率 / 每任务输出 token | 脆弱感知分批(测量版):89.2%(−0.4pp)、521 token(−24.3%) | 单独求解:89.5%、689 token | 对前沿专有模型省 24.3% 生成 token 且精度几乎不变 |
| 全部数据集平均(除 AIME,7 模型) | 平均 token 节省 / 精度变化 | 测量版 43% / +0.6pp;预测器版 31.0% / 损失≤0.5pp | 单独求解 $k=1$(精度基线) | 零训练、黑盒条件下的大幅推理成本削减 |
| MMLU-Redux(7 模型平均) | 准确率变化 / token 变化 | 测量版分批:−0.2pp / −52.2% | 随机分批 $k=6$:−7.5pp / −67.7% | 精度持平的前提下接近随机分批的节省幅度 |
| OneWordQA 与 StrategyQA | 输出 token 节省 | 脆弱感知分批 68–74% | 单独求解 | 与随机分批持平,验证轻推理任务可大胆合批 |
| OLMo 3 7B 三阶段(SFT/DPO/RLVR) | 同等 token 缩减下的精度损失 / 脆弱集合相关 | 三阶段幂律缩减几乎相同;RLVR 精度损失最小,RLVR 与 SFT 脆弱集合相关 0.69±0.23 | SFT 与 DPO 相互相关 1.03±0.35(退化几乎同一批任务) | 证明 RLVR 缓解退化后果,但不改变预算错配机制 |
局限与改进
作者承认的局限:缩减的驱动因素尚不清楚——为什么模型会对所有任务统一折扣思考预算仍是黑盒;实验限于同数据集、相互独立任务的组合,混合领域和有依赖关系的组合未测;推理长度的细粒度分析只对开源模型做了,专有模型只能观察结果端。我的补充观察:其一,标签归因依赖模型在思维链中复述 Q01/Q02 标签,若模型跳跃推理或合并多个任务的思考,$T_i(k)$ 的归属会有偏差,论文未报告标签命中率这一可靠性指标;其二,测量脆弱性的代价很高——训练预测器需要每任务在 4 个组合规模各跑 10 次,且脆弱性跨模型相关只有 0.24,换一个模型就要整套重测;其三,线性预测器在描述长而复杂的任务上失效,在 Claude Opus 5 的 GPQA 上甚至 −2.0pp 且几乎不省 token;其四,判分方式要求把单条回答拆成 $k$ 个答案,格式遵从失败可能被误记为任务失败,从而污染脆弱性估计;其五,准确率用 5 次采样估计,处在脆弱边界附近的任务估计噪声不小。
独立分析的弱点
独立来看有几处可改进。1) 脆弱性测量成本高且不跨模型迁移:跨模型相关仅 0.24 意味着每个新模型都要重新做 3/3 筛选加多规模多试次评估,工业落地困难。改进方向:直接用「单独求解的平均轨迹长度」这一免费特征粗筛(论文已显示长轨迹约等于脆弱),或只测一个中间规模(如 $k=6$)后用幂律外推。2) 预测器太弱:只用冻结嵌入加线性层,在 Opus GPQA 上 −2.0pp 且几乎不省 token。改进:引入轨迹长度、题目类型、历史失败率等结构化特征,或用小模型做代理评估。3) 机制归因不完整:无法排除注意力稀释、位置偏差等混淆因素,附录提到弱位置偏差但正文未深究。改进:在组合中插入不影响输出的占位任务改变有效 $k$,检验缩减是否真随任务数而非上下文长度变化。4) 组合设定单一:同类型独立任务拼接与真实 agent 工作流、多轮对话有距离,与 context rot 的联系只是推测。改进:构造混合领域、带依赖的组合验证幂律是否仍成立。5) 评估协议风险:拆分 $k$ 个答案依赖格式遵从,R1 系模型格式错误较多时会低估真实精度、高估脆弱性,应报告格式失败率并单独统计。
未来方向
作者提出的方向:把预算管理显式纳入 RL 训练,在组合任务上训练让模型学会为每个成员任务分配推理量;把隐式预算研究扩展到无关上下文、对话历史、嵌套大任务等更丰富的场景;在 agent 生产环境中保持上下文精简,并把高推理强度的步骤交给从全新上下文启动的子 agent,避免错配在长链路中传播。基于本文成果可以进一步延伸:把 $r_i(k)\approx k^m$ 的幂律做成服务端的请求合批调度器,以预测脆弱性和精度预算 $B$ 为约束动态拼 prompt,类似推理服务的 batching 但以精度为第一约束;在 RLVR 奖励中加入组合内 token 分配的显式项,检验能否同时保精度和控预算,从根上修复错配;研究脆弱性为何跨模型不稳定——是否与预训练/后训练数据中各任务的出现分布有关;把脆弱性度量推广到工具调用 agent 的多步推理链,为「哪一步值得开子 agent」提供量化依据。
复现评估
复现条件较好。代码与项目页公开(github.com/chenpanli/fragility,chenpanli.github.io/fragility)。8 个数据集中 6 个是公开基准(GPQA-Diamond、GSM8K、MATH-500、MMLU-Redux、StrategyQA、AIME),2 个自制且容易重建:1000 道随机系数不定积分(符号验证答案)和单步事实问答 OneWordQA。开源模型从 4B 到 27B(Qwen3 4B Thinking/8B/14B、Qwen3.8 27B、三个 R1 蒸馏模型、OLMo 3 7B),权重全部公开,单张 A100 级显卡即可复现主要实验(温度 0.6、上下文 131072)。机制分析本身只需线性回归,难度低。真正的瓶颈有两处:Claude Opus 5 部分需要 API 预算(每任务 689 输出 token,多规模多试次叠加);预测器训练需要每任务 4 个组合规模×10 次的组合内评估,长推理数据集(GPQA 每任务约 6000–9000 token)消耗可观。总体属中等难度:工程量集中在批量推理与轨迹切分脚本,方法本身没有训练门槛。
论文图表
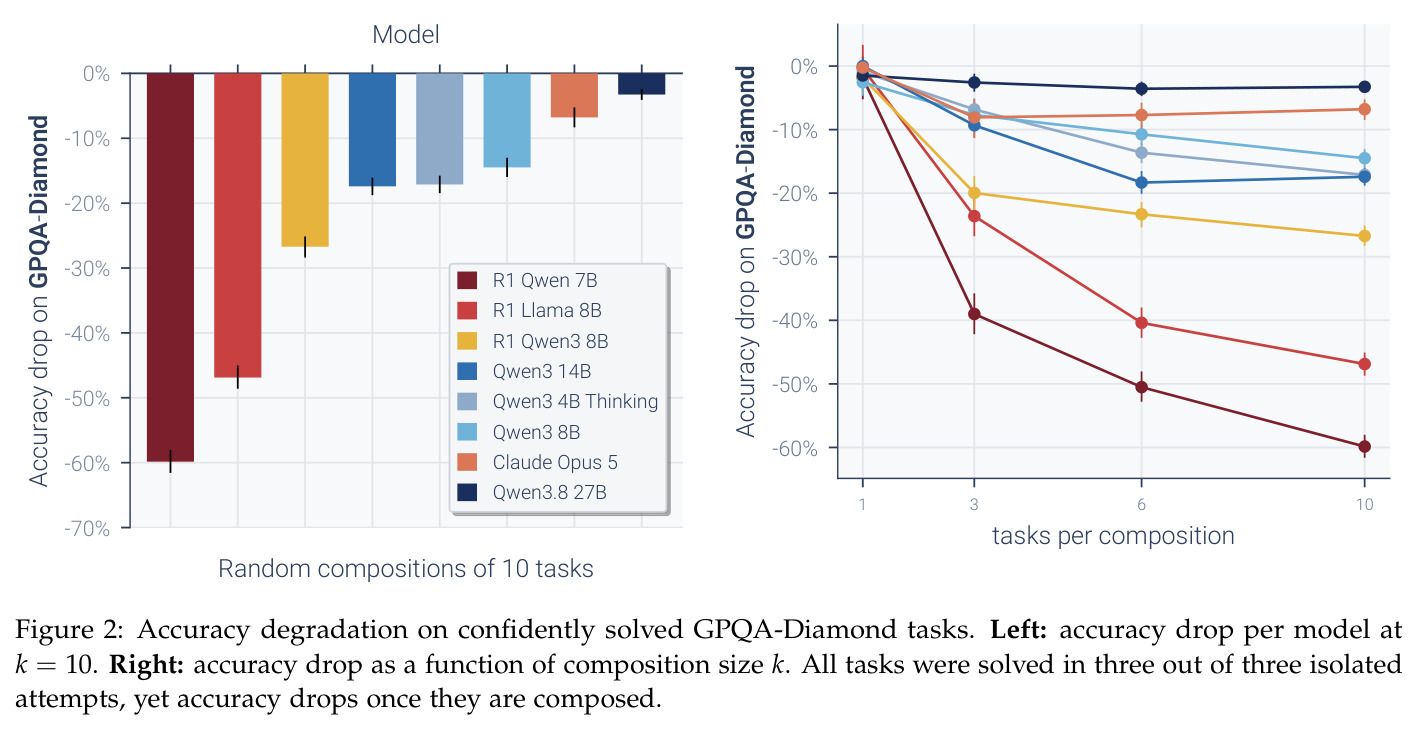
左图:$k=10$ 时各模型在 GPQA-Diamond 上每任务的准确率下降,R1 蒸馏模型掉得最多,Qwen3 系列次之,Claude Opus 5 掉约 7pp。右图:准确率下降随组合规模 $k$(1/3/6/10)增大而加深。
这是现象的建立实验:所有任务单独 3/3 全对,拼接后仍大面积失败,且退化超出错误累积预测。它是后续一切机制分析的出发点。