OpenVLHarness:基于多模态记忆的真实世界视觉智能体工具使用框架 OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory
能力层+持久多模态记忆双机制,让MLLM在22个基准上平均提升9.7–12.6分
前置知识
多模态大语言模型(MLLM)
以语言模型为核心、能同时接收图像、文档、网页等多模态输入并输出文本的模型,如 Qwen3-VL、GPT-6。它将图像编码为视觉 token,与文本 token 一起送入 Transformer 进行联合推理,从而实现'看着图说话'。其能力边界决定了哪些任务必须借助外部工具获取额外证据。
本文的 orchestrator(调度核心)就是一个 MLLM,全部实验都是围绕'给 MLLM 挂载工具框架'展开的,只有先理解 MLLM 单独能做到什么、做不到什么,才能理解 harness 带来的增益从何而来。
推理时扩展(inference-time scaling)
不更新模型权重,仅增加推理阶段的计算量来换取精度,典型做法是让模型生成更多思考 token,如 GPT-6 的 low/medium/high/xhigh/max 推理力度档位。其收益通常边际递减:计算量翻倍不等于准确率线性提升。
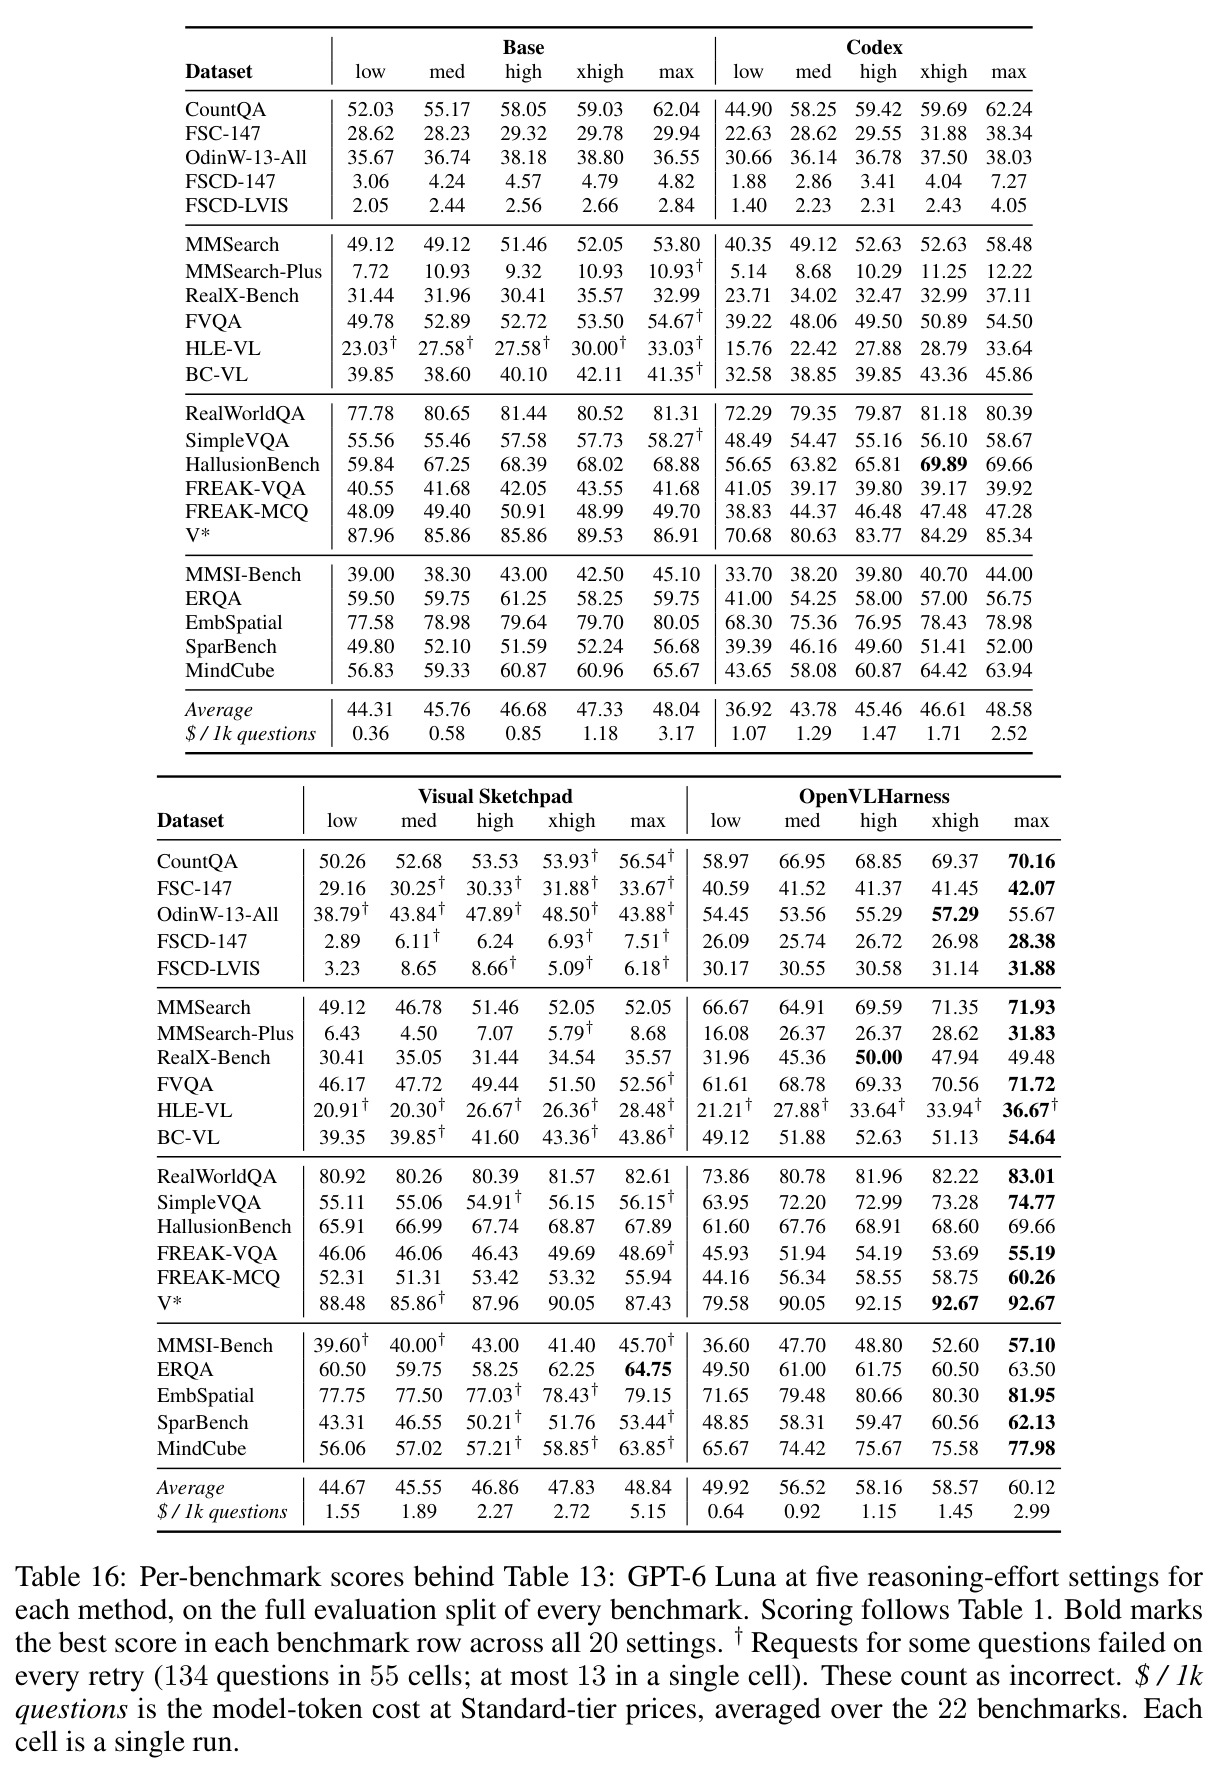
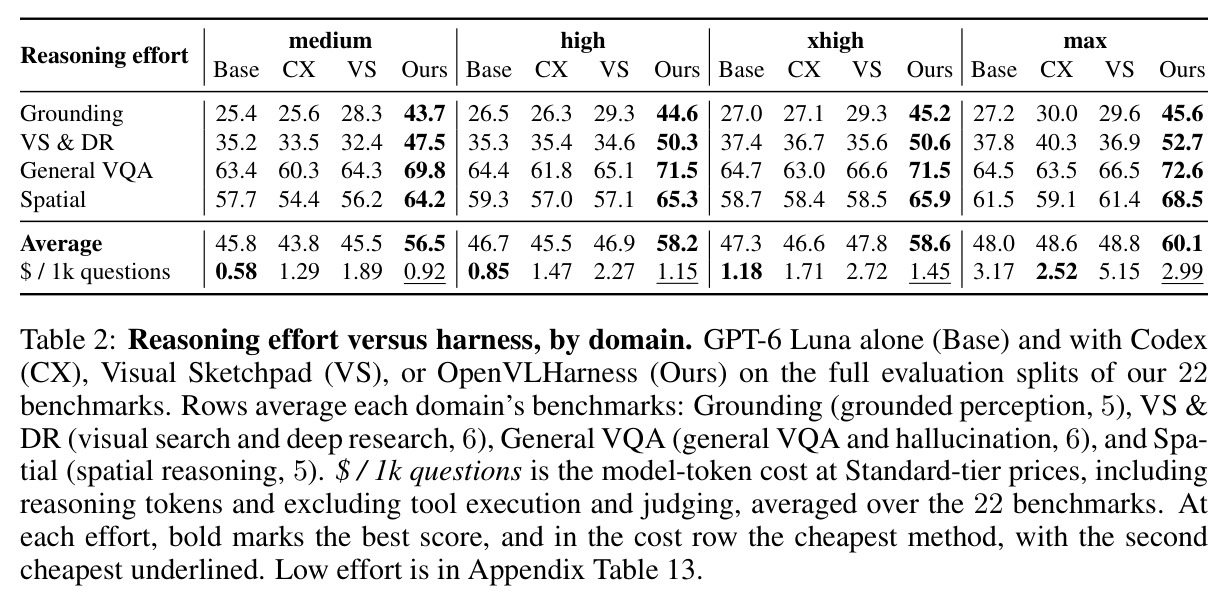
论文的出发点正是一组对照实验:基础模型推理预算从 xhigh 提到 max 档,模型 token 开销乘以 $2.7$ 倍,22 基准平均分却只提高 $0.7$ 分。这个'多想不如多看证据'的观察是整篇论文的立论基础。
开放词汇定位与 RLE 分割掩码
Visual Grounding 根据文本查询在图像中定位目标,输出边界框和分割掩码;RLE(游程编码)是压缩存储掩码的紧凑格式,数值上精确但人类和模型都无法直接读懂。要被 MLLM '看见',必须渲染成标注叠加图;要被程序精确计算,又必须保留原始数组。
这正是论文'证据渲染'设计要解决的核心矛盾:工具输出的原始载荷机器可读但模型不可读。理解 RLE 掩码的双重属性,才能理解为什么作者要同时做'可视化渲染'和'工件保留'。
智能体工具调用与 harness
harness 指包裹模型的外层框架,负责工具接口、消息循环与状态管理。模型以 ReAct 风格运行:每轮输出一次工具调用,框架执行后把观察结果(observation)回填上下文,循环往复直到给出最终答案。工具调用通常走模型原生的 function calling 通道。
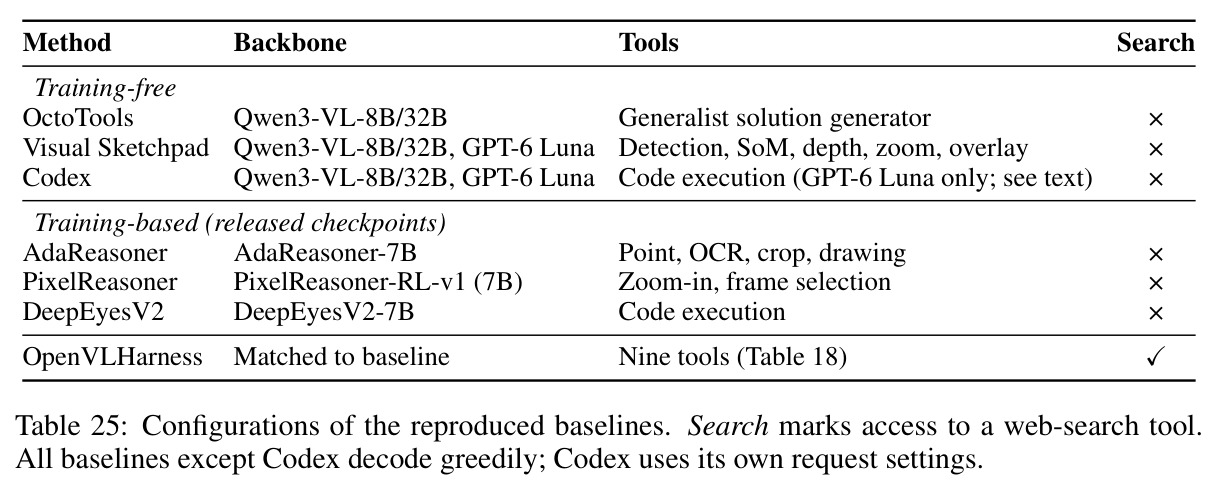
OpenVLHarness 本身就是一个 harness。分清'模型能力'与'框架能力'的边界,才能读懂论文的实验设计:同一骨干分别接 Base、Codex、Visual Sketchpad、OpenVLHarness 四种框架对比,隔离出框架本身的贡献。
深度估计与相机位姿
深度估计为图像每个像素预测距离值,得到稠密深度图;相机位姿由内参矩阵 $K$ 和外参 $[R|t]$ 描述,刻画相机在场景中的位置与朝向。多张图的位姿统一后可建立共享三维坐标系,进而在代码中计算物体间的真实三维距离。
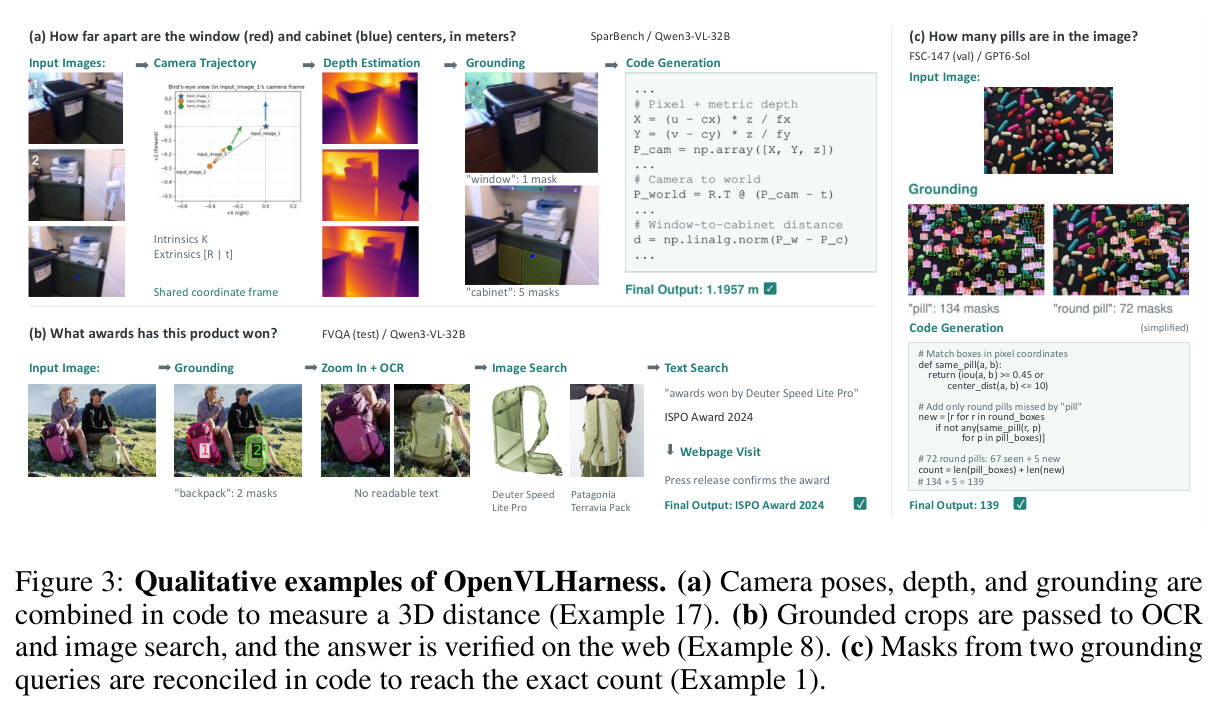
论文的招牌示例(计算窗户与柜子中心距离 1.1957 米)正是把相机位姿、深度数组与 grounding 掩码三类工件在记忆中组合后,由 Python 编码智能体算出的,是理解'记忆接地计算'的最佳入口。
研究动机
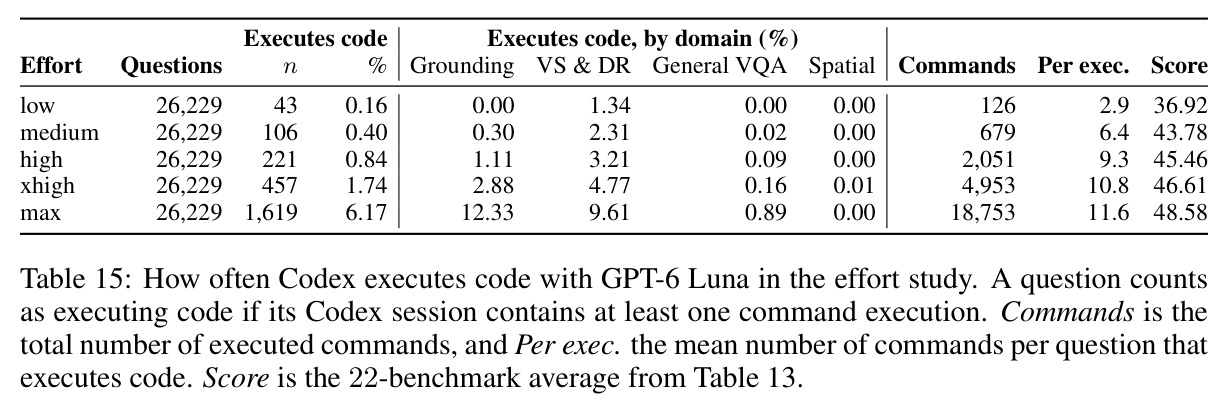
多模态大模型在视觉推理上进步很快,但许多真实任务需要的证据无法靠模型'内省'得到:在密集场景中定位大量微小物体、检索长尾实体的外部知识、或根据中间测量值计算数量,这些都需要通过感知、搜索和计算获取额外证据。作者在 22 个基准上做了受控实验:把基础模型的推理力度从 xhigh 提到 max 档,模型 token 开销乘以 $2.7$ 倍,平均分却只提高 $0.7$ 分,说明单纯'多想'已严重边际递减。已有视觉工具方案各有短板:训练类框架(AdaReasoner、PixelReasoner、DeepEyesV2)需要微调骨干模型;免训练框架(Visual Sketchpad、OctoTools)依赖手工设计的工具接口;通用编码智能体 Codex 给 GPT-6 Luna 使用反而把 22 基准均分从 45.8 拉低到 43.8。更深层的技术障碍有二:其一,异构后端调用约定不一,分割掩码、深度图、网页原文等输出格式模型难以解读;其二,后续步骤仍需访问底层工件——渲染好的深度图便于'看',但精确测量必须拿到数值数组,而把数组直接塞进上下文既耗 token 又不可解读。
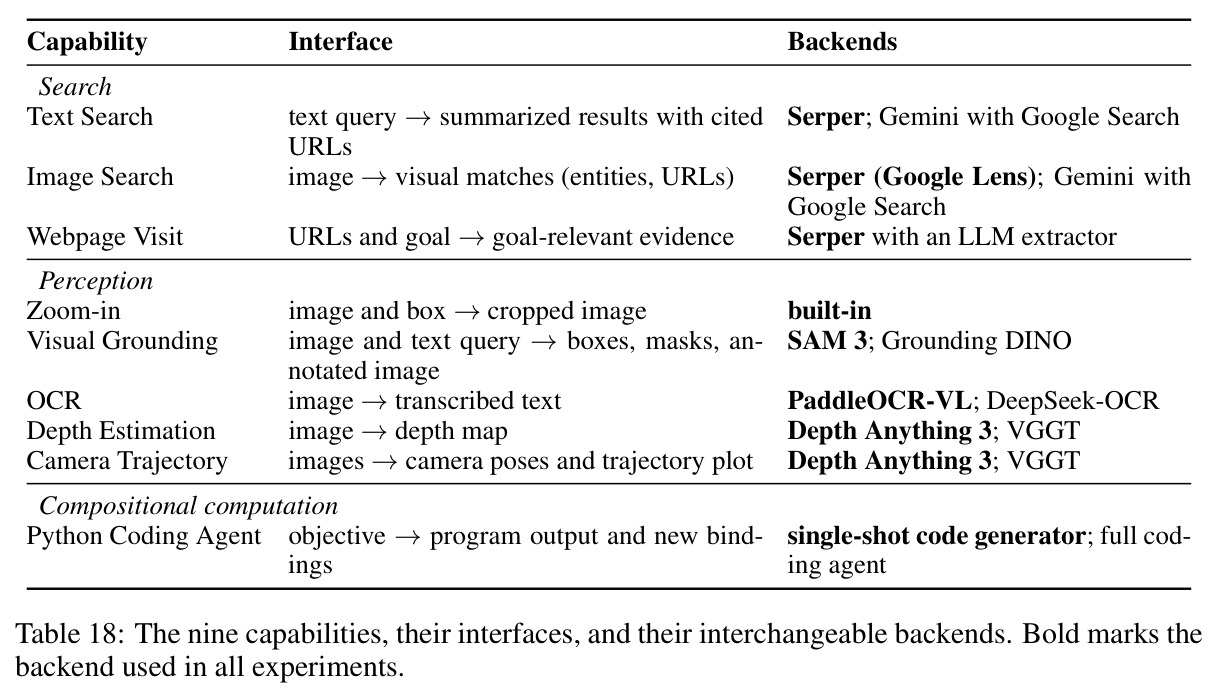
本文的目标是本文的目标是构建一个免训练、模型无关的通用视觉智能体框架 OpenVLHarness,让任意 MLLM 骨干都能一致地调用感知、搜索、计算三类异构工具,并以可解读、可复用的方式利用工具产物完成多步推理。具体拆成四点:其一,定义任务级工具接口,使 SAM 3 与 Grounding DINO、PaddleOCR-VL 与 DeepSeek-OCR 等后端可以互换而不改变上层调用方式;其二,把每个工具的原始输出渲染成模型可读的观察,即可视化附件+简短自然语言描述+紧凑结构化信息的组合;其三,建立持久多模态记忆,把图像、结构化数据、网页引用注册为可寻址工件,供后续轮次通过句柄复用;其四,用 Python 编码智能体对存储的数据执行计算,把多个工具的输出组合成完整推理链。最终在 22 个基准、8 个开源与专有骨干上系统验证效果,并与免训练基线、训练类基线以及推理预算扩展做正面对比,同时提供把 harness 适配到自定义领域的免训练优化工作流。
与已有工作不同的是,本文的独特切入点是把'证据的可用性'和'证据的可复用性'拆成两个正交机制分别设计。以往工具框架要么关注工具集本身(有什么工具),要么关注调用策略(何时调用),很少系统回答'工具输出的二进制产物如何跨轮次被再次使用'这个问题。作者的做法是:能力层用'任务级接口+证据渲染'解决'模型看得懂',持久多模态记忆用'句柄与载荷分离的工件注册表'解决'模型用得上'——orchestrator 只看到紧凑句柄和描述符,重型载荷(图像字节、数值数组)留在框架侧按引用解析。另一个差异是框架自身的可进化性:用 Kimi K3 批判失败轨迹,自动诊断该改提示词还是该造新工具,再由 harness search 与 tool generation 两条免训练工作流落地,使 harness 能跟随模型与任务演进。此外,作者首次在 22 个基准、26229 题规模上把'加工具'与'加推理预算'放进同一成本坐标系比较,得出二者互补而非替代的结论,回答了'更多推理能否取代框架'这一悬而未决的问题。
核心方法
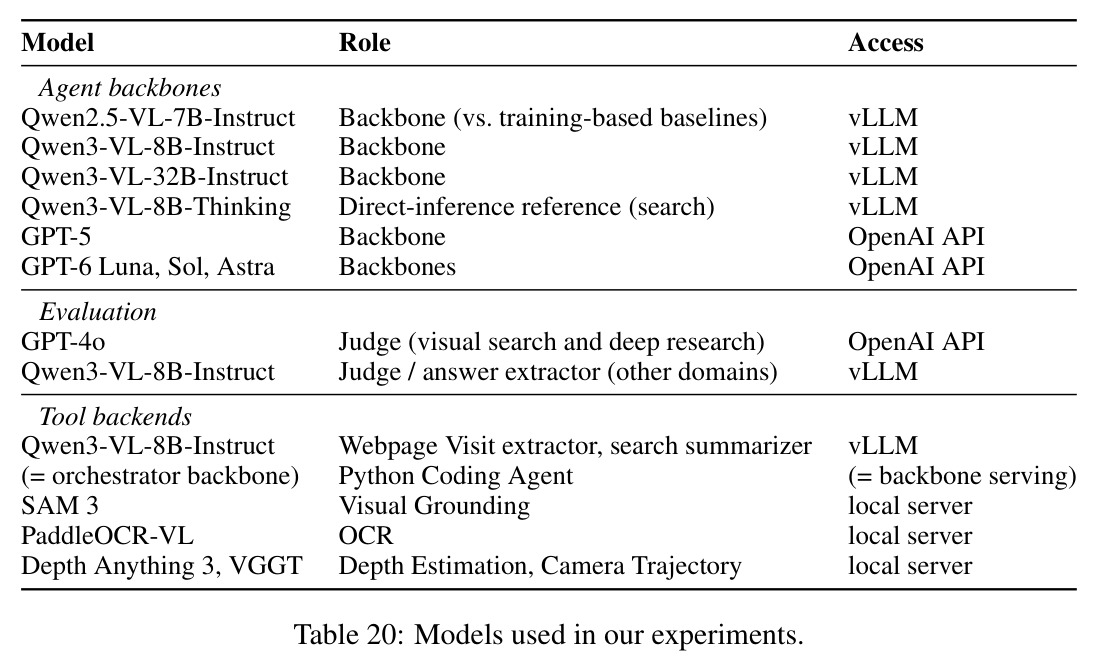
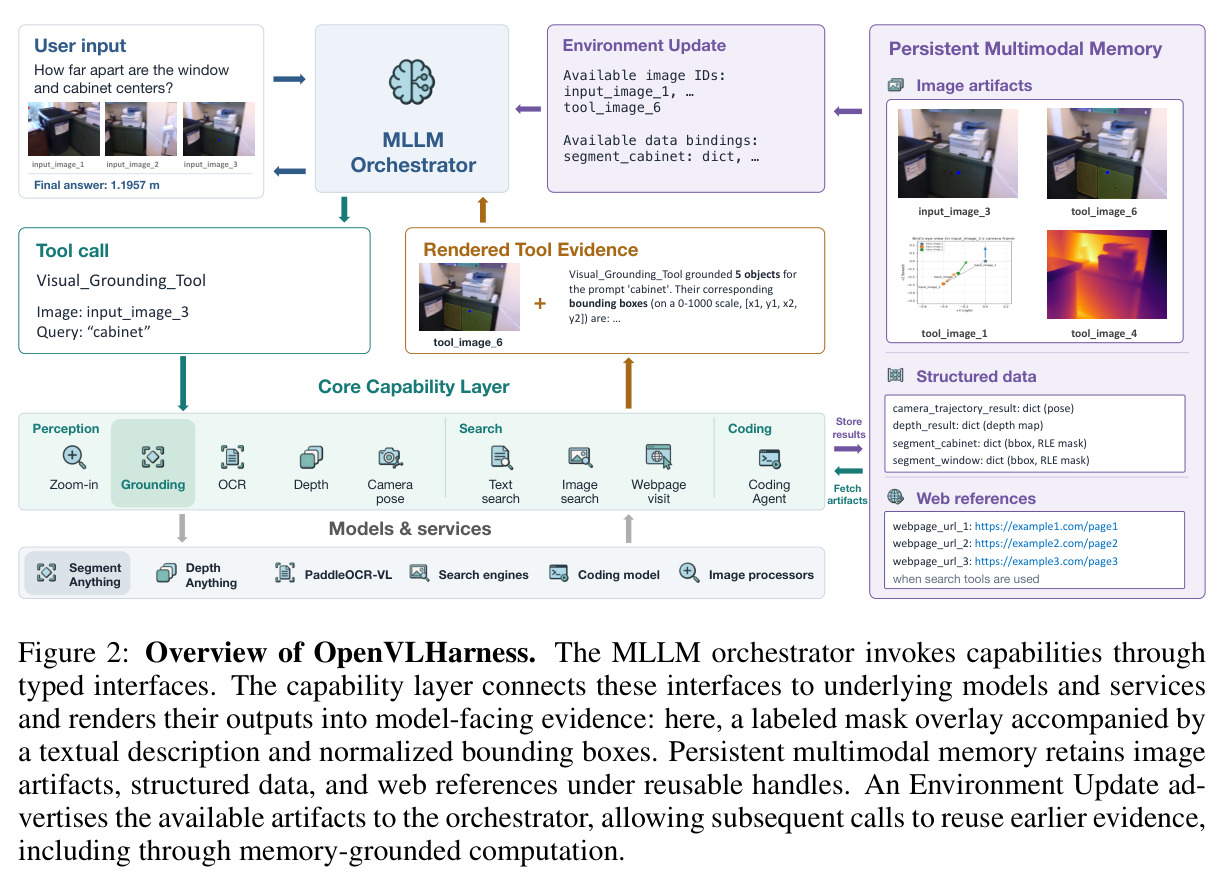
整体思路的直觉是:把 MLLM 当作'会思考的调度员',给它配一间'设备齐全的实验室'(能力层)和一个'随手可取的物料架'(持久多模态记忆)。技术路线上,OpenVLHarness 以 ReAct 风格循环运行:orchestrator(即骨干 MLLM)每轮至多发起一次原生工具调用;能力层把调用路由到具体后端并渲染观察;记忆模块登记产物并发出 Environment Update 消息广播当前可用句柄;Python Coding Agent 接收自然语言计算目标,用同一骨干生成代码并在存储数据上执行。基础实例化包含九个能力:感知五项(Zoom-in、Visual Grounding、OCR、深度估计、相机轨迹),信息获取三项(文本搜索、图片反搜、网页访问),外加编码智能体。感知后端包括 SAM 3/Grounding DINO、PaddleOCR-VL/DeepSeek-OCR、Depth Anything 3/VGGT,搜索走 Serper API 并由 Qwen3-VL-8B 做摘要与重排。每题最多 15 次工具迭代,上下文上限 168K token。
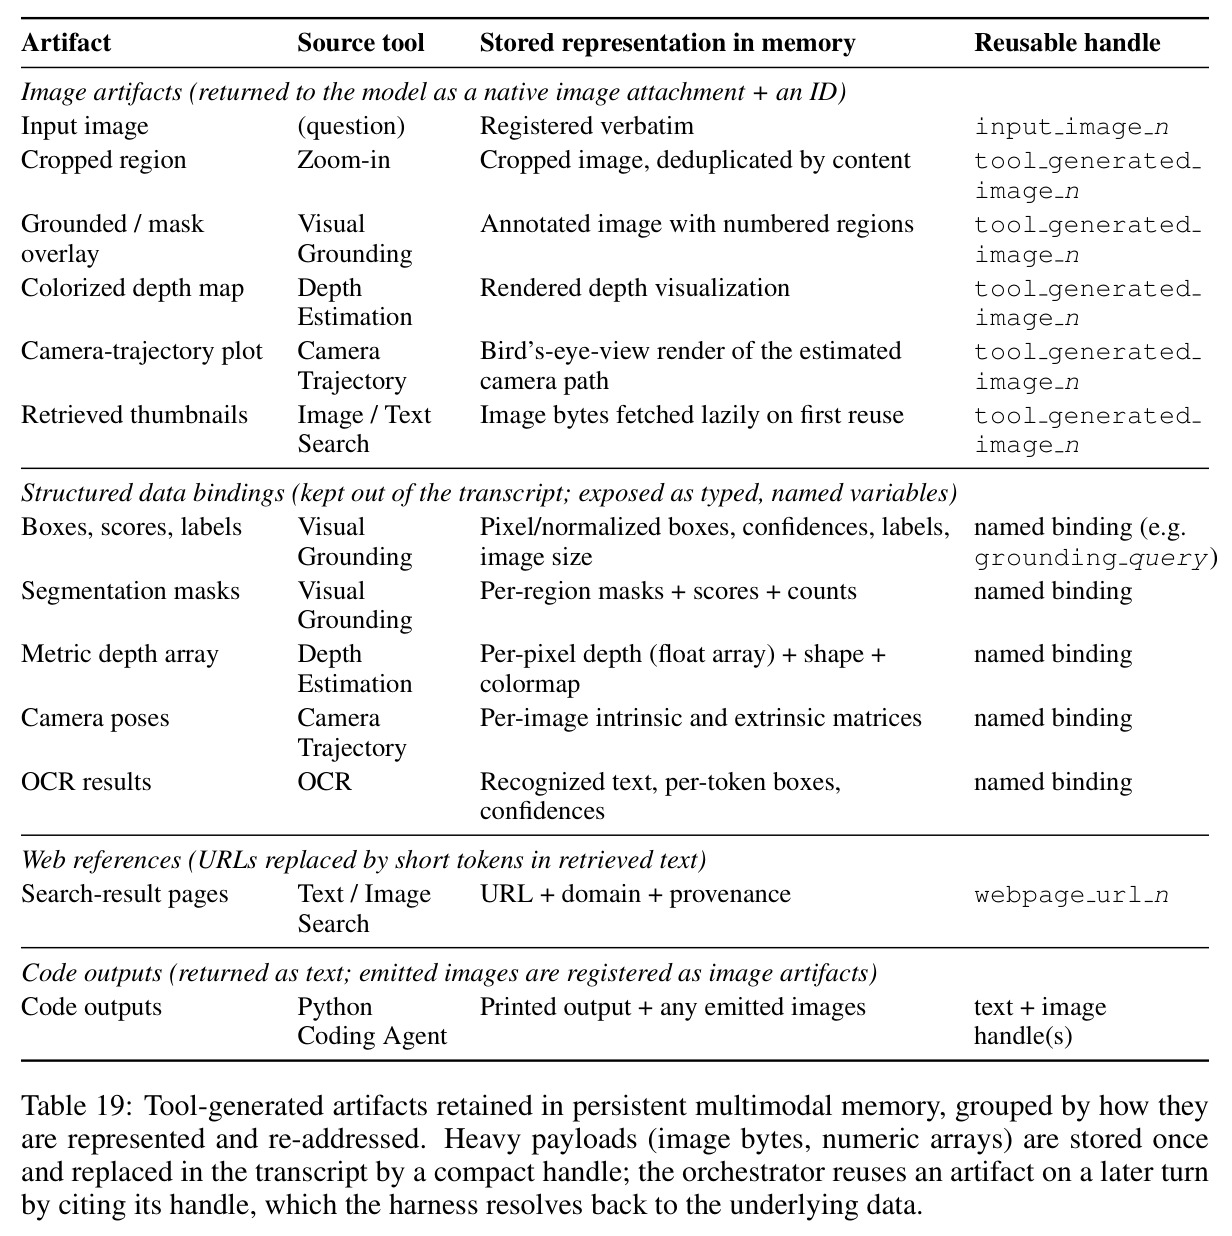
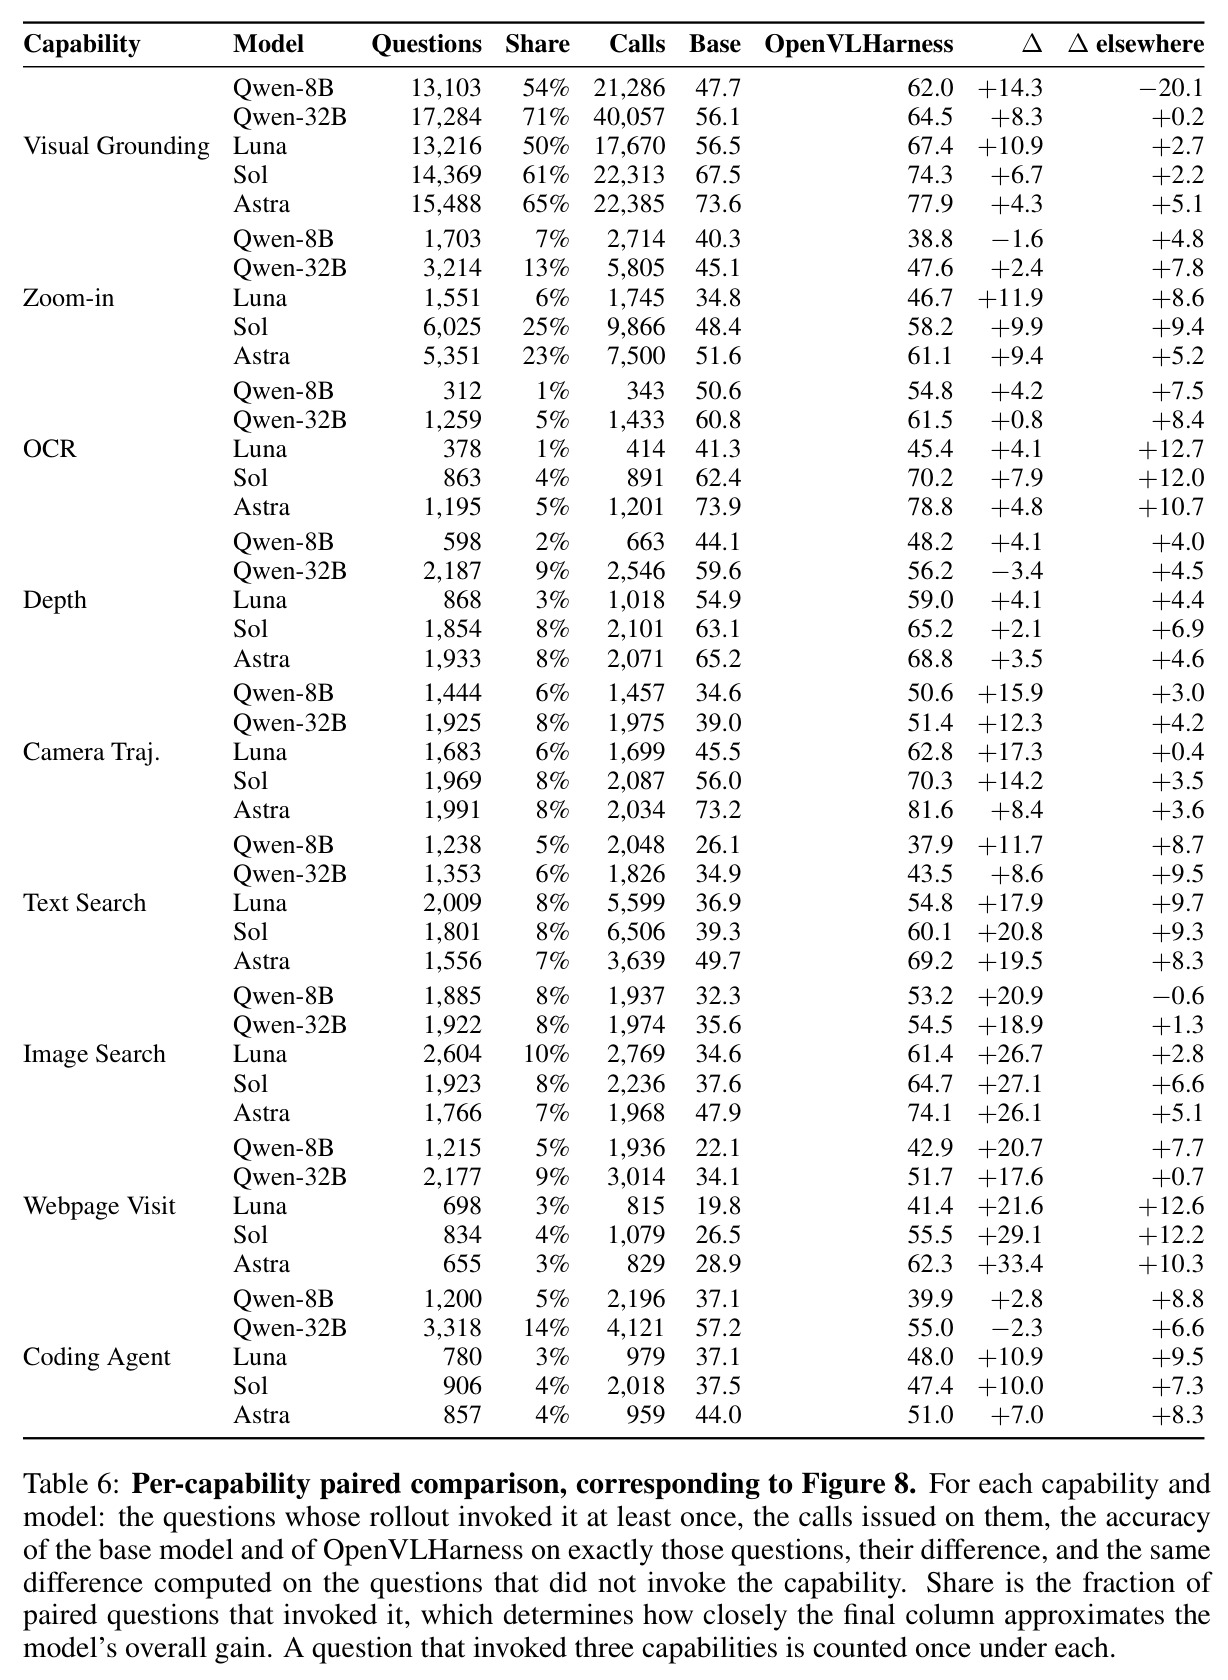
核心创新是'能力层+持久多模态记忆'的双机制架构,与已有工作的本质区别有三点。第一,证据渲染:不是简单把工具返回值塞进上下文,而是每个能力自带输出处理器,把 RLE 掩码、深度数组等渲染成'标注叠加图+简短描述+归一化坐标(0–1000 尺度)'的组合观察,模型既看得懂内容又拿得到精确数字的引用。第二,工件句柄化:记忆注册表把图像(input_image_3、tool_image_6)、结构化绑定(segment_cabinet: dict 含 bbox 与 RLE mask)、网页引用(webpage_url_1)分类登记,载荷与句柄分离,Environment Update 只广播命名空间而不重复内容,后续调用凭句柄即可取用原始数据。第三,记忆接地计算:orchestrator 用自然语言描述计算目标,编码智能体在以数据绑定为具名变量的环境里执行代码,例如把 grounding 掩码与深度数组结合算出每个区域的平均深度。与 ReWOO、CodeAct 等文本符号引用方案不同,这里维护的是跨图像、结构化数据、网页证据的统一类型化工件注册表。
方法步骤详情
流程可拆为六步。步骤一(输入注册):用户问题连同图像进入系统,图像登记为 input_image_N 句柄。步骤二(推理决策):orchestrator 阅读系统提示、工具 schema 与 Environment Update,每轮恰好调用一个工具或给出 Final Answer。步骤三(执行与渲染):能力层把调用路由到后端(如 Visual Grounding 默认 SAM 3),返回编号标注的掩码叠加图、检测数量与归一化边界框描述,原始掩码和坐标同时交给记忆。步骤四(登记与广播):工具生成的图像按内容去重后注册为 tool_generated_image_N,结构化输出成为带类型描述符的数据绑定,网页存为 webpage_url_N;随后发出 Environment Update 列出全部可用句柄。步骤五(复用与计算):后续工具凭句柄取得输入,harness 解析回真实载荷;需要计算时,orchestrator 把目标(如'计算每个检测区域的平均深度')连同绑定描述符交给 Python Coding Agent,程序以绑定为变量执行,结果再登记复用。步骤六(作答):证据充分时输出最终答案。
技术新颖性
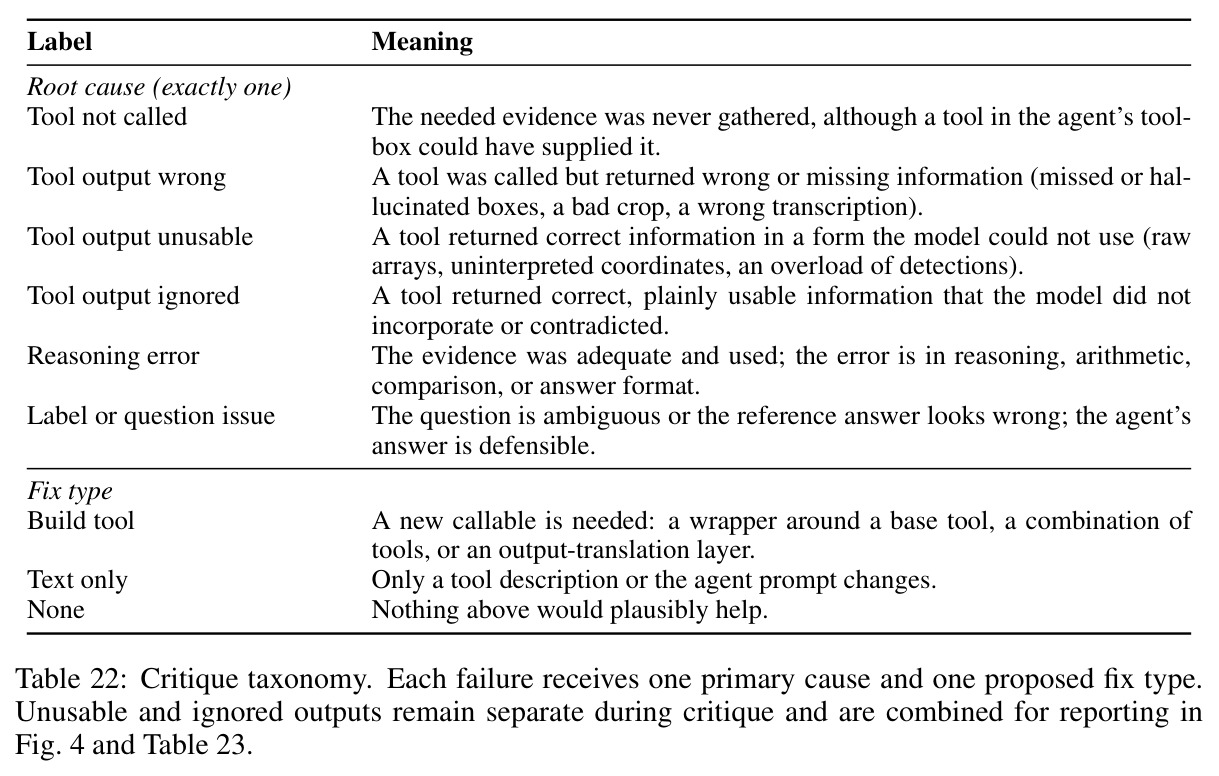
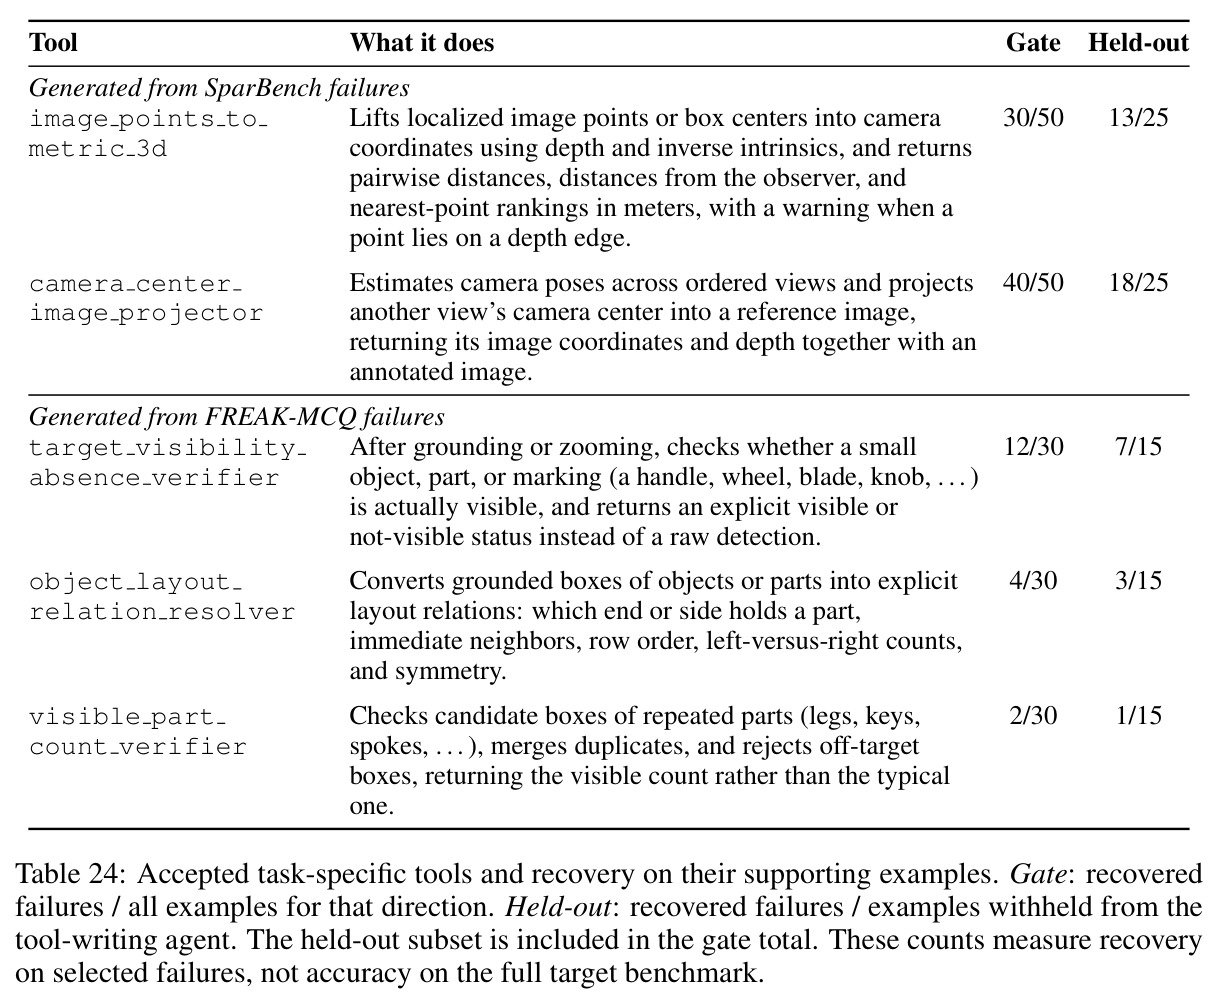
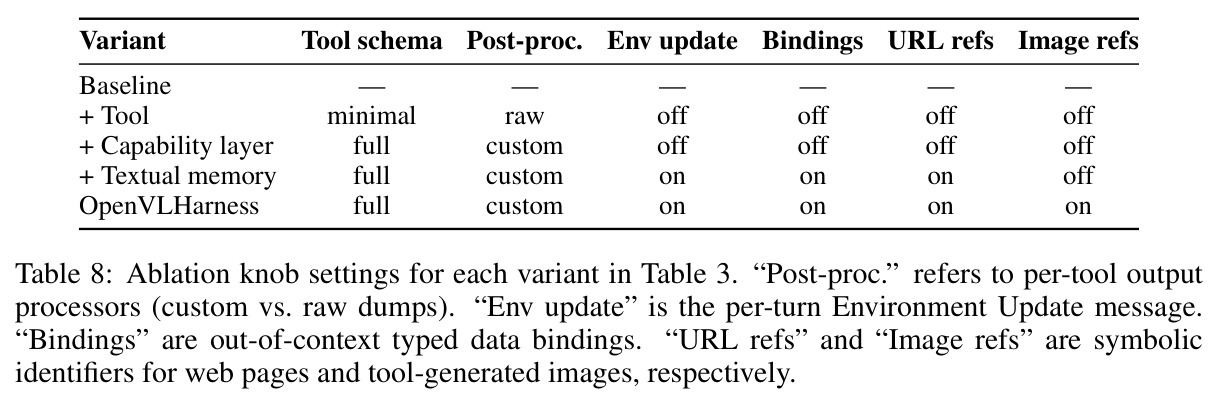
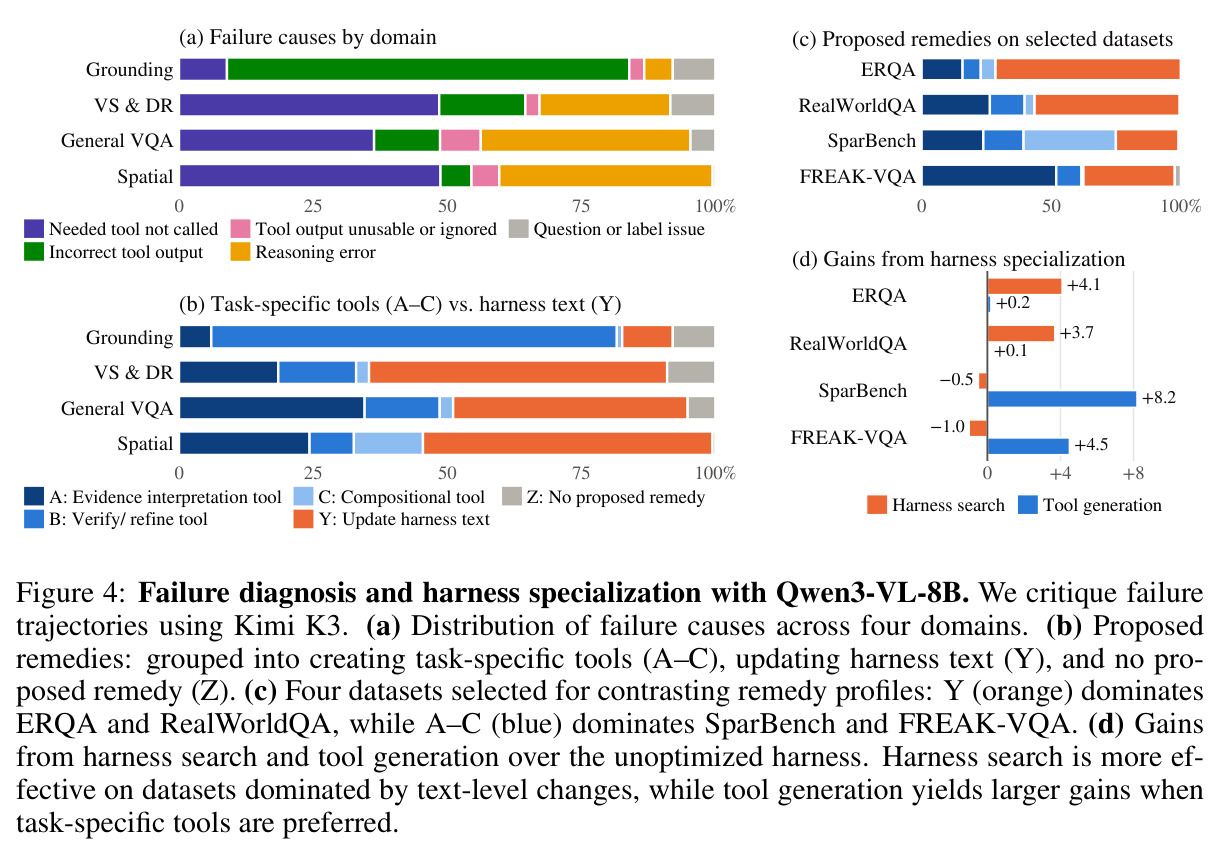
技术新颖性体现在四个层面。接口层:任务级接口与后端解耦是常见工程思想,但与证据渲染绑定成'调用约定+观察格式'一体化设计是新的——换后端不动提示词词汇,模型无感知,后端可按精度、成本、延迟灵活调整。记忆层:此前多模态工具框架要么不保存工具图像、要么只存文字描述;本文消融显示仅加文本记忆(图像转最多 160 token 描述)只涨 $+0.7$ 分(8B),补上可复用图像句柄后立刻再涨 $+3.1$ 分(32B 为 $+4.5$),直接证明'图像可寻址性'是被前人忽略的关键变量。系统层:Python Coding Agent 与记忆绑定组合使任意两个能力的输出都能在代码里组合,比 Visual Sketchpad 的固定画板和 OctoTools 的手工流水线表达力更强。方法层:用 Kimi K3 批判 9,893 条失败轨迹(与人工标注一致率 92%),按'失败原因×修复通道'自动分流到 harness search 或 tool generation,让框架本身成为可优化对象且全程不更新权重。
实验结果
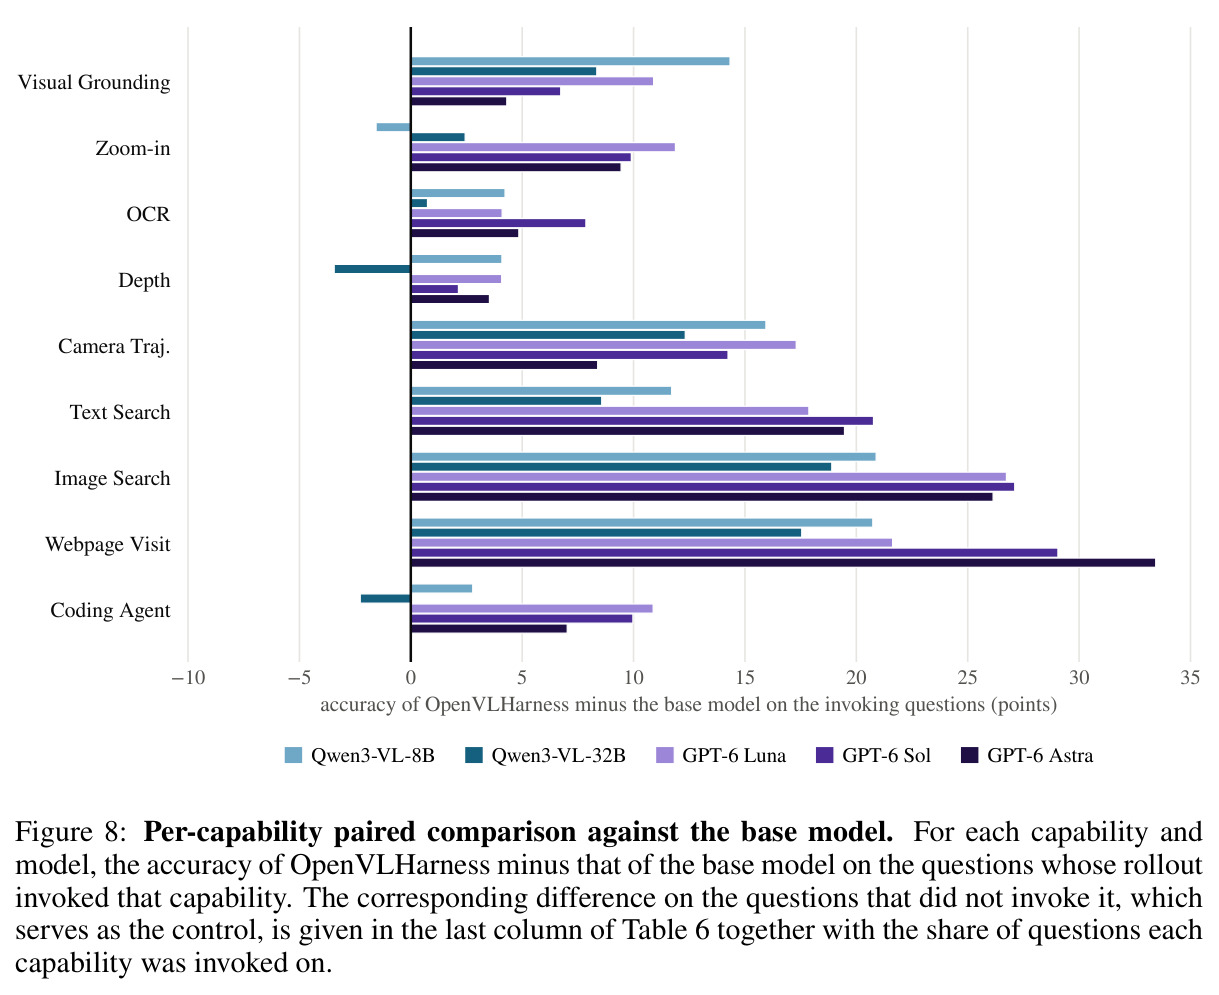
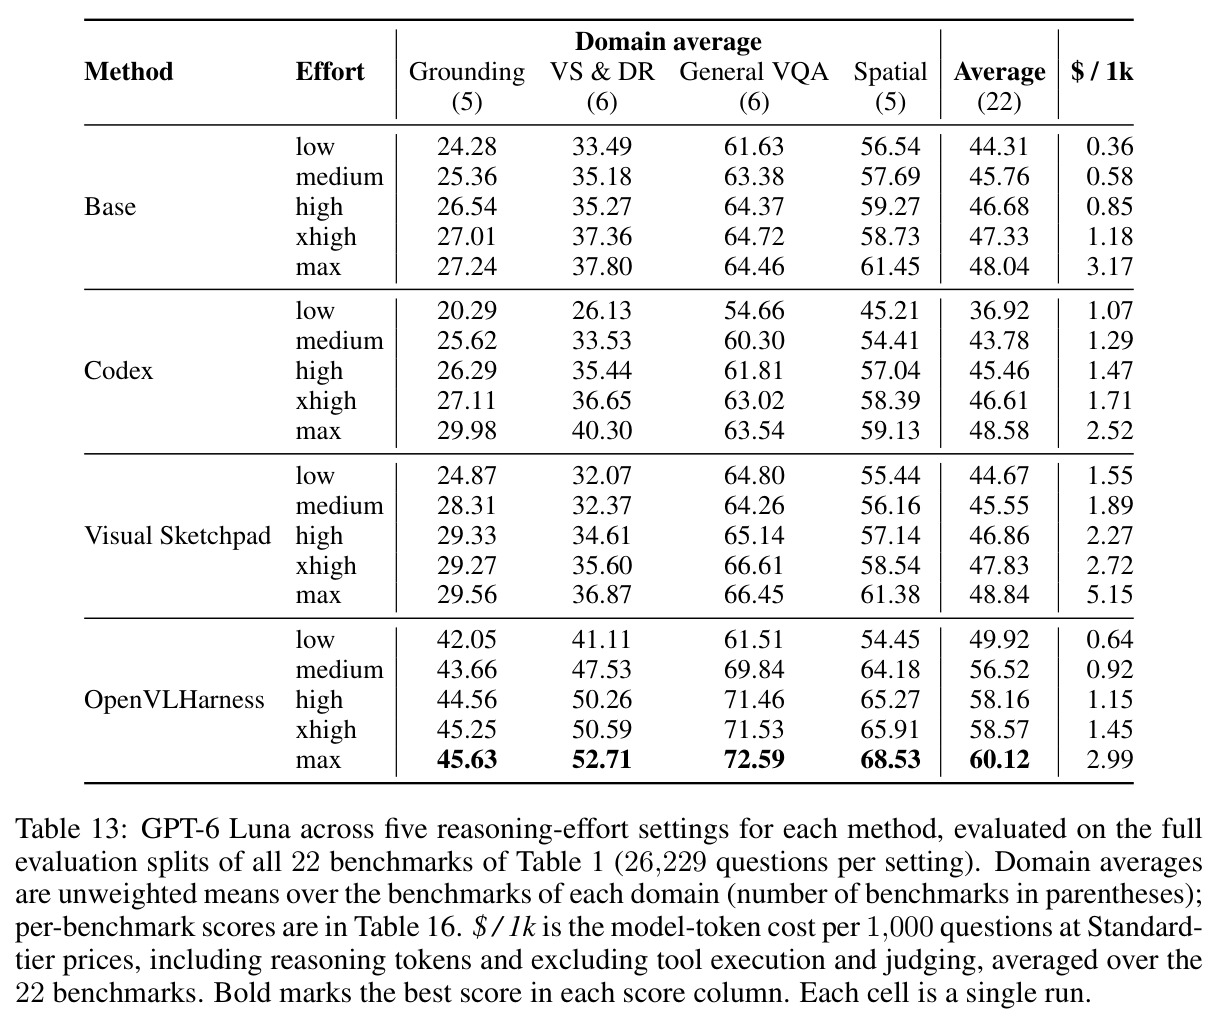
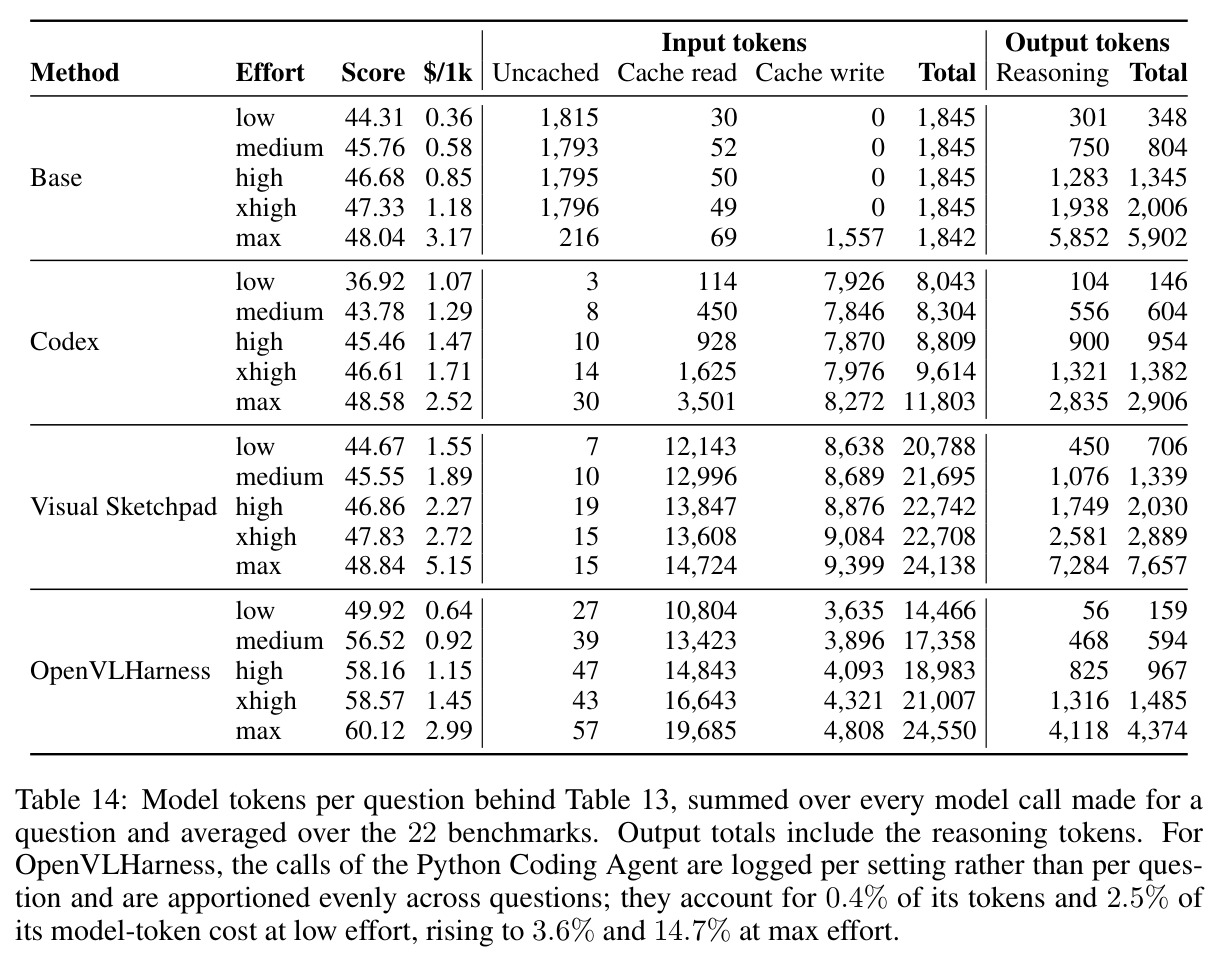
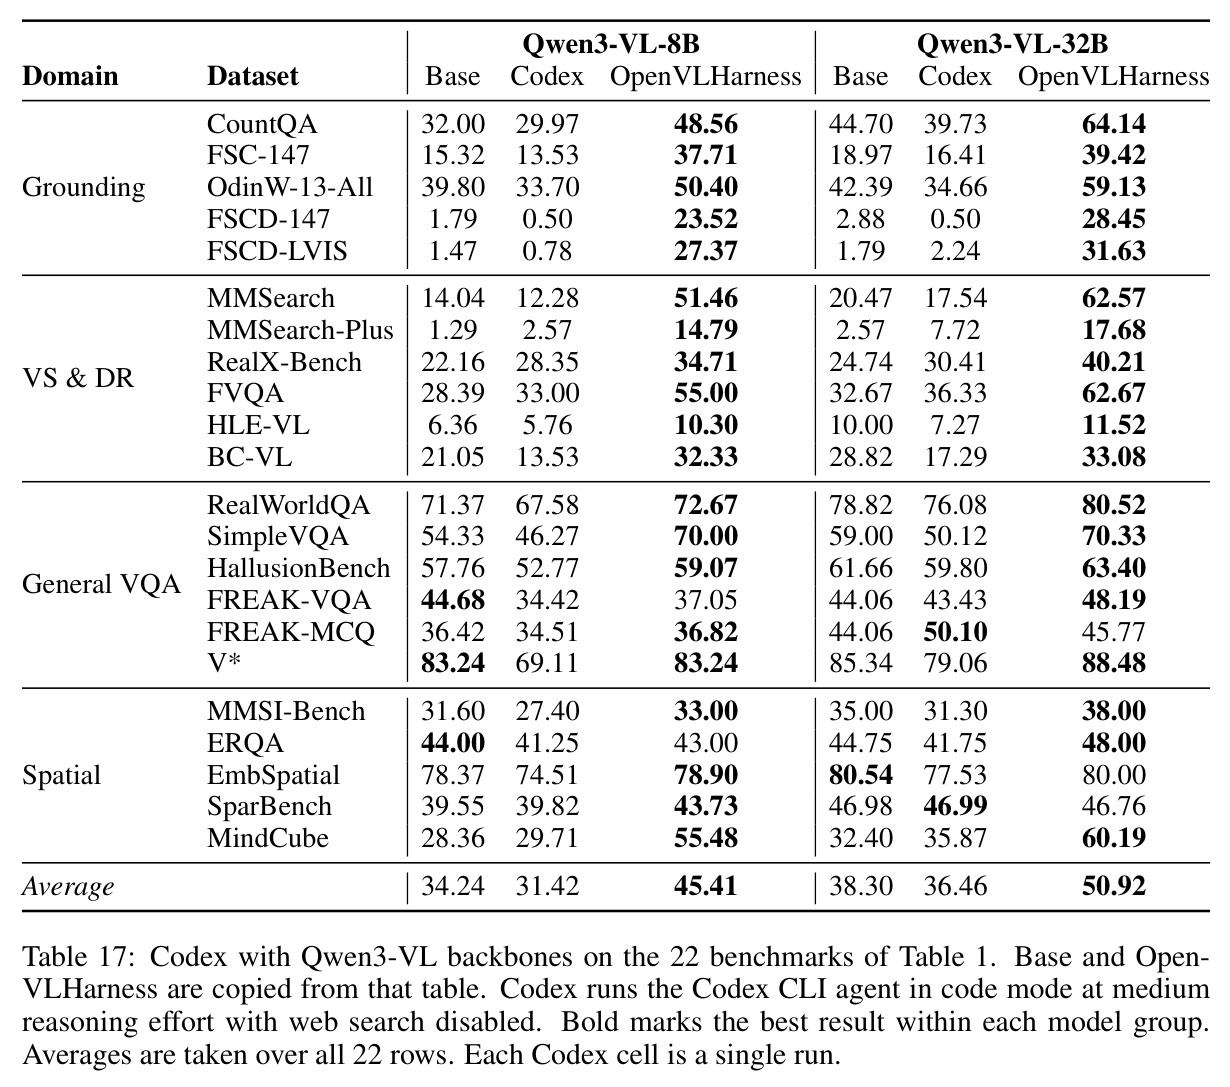
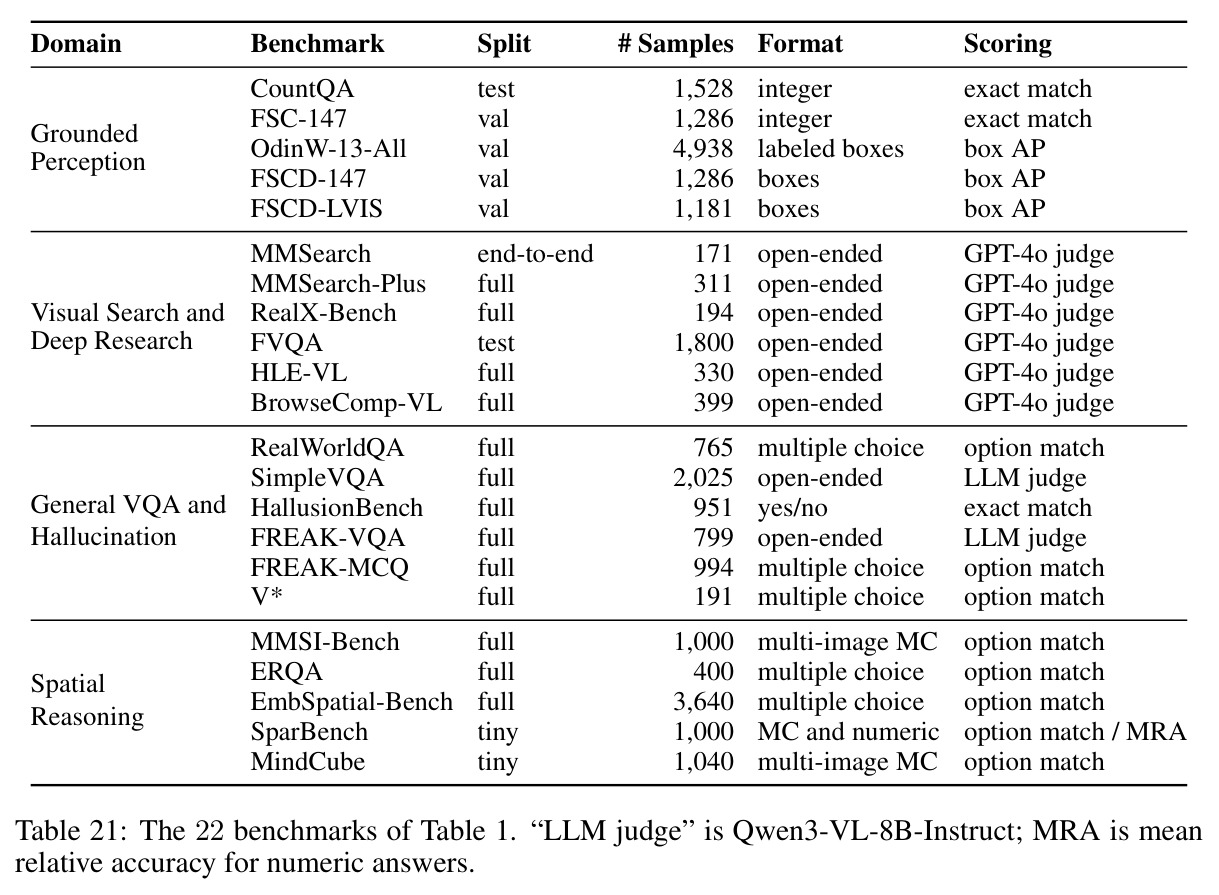
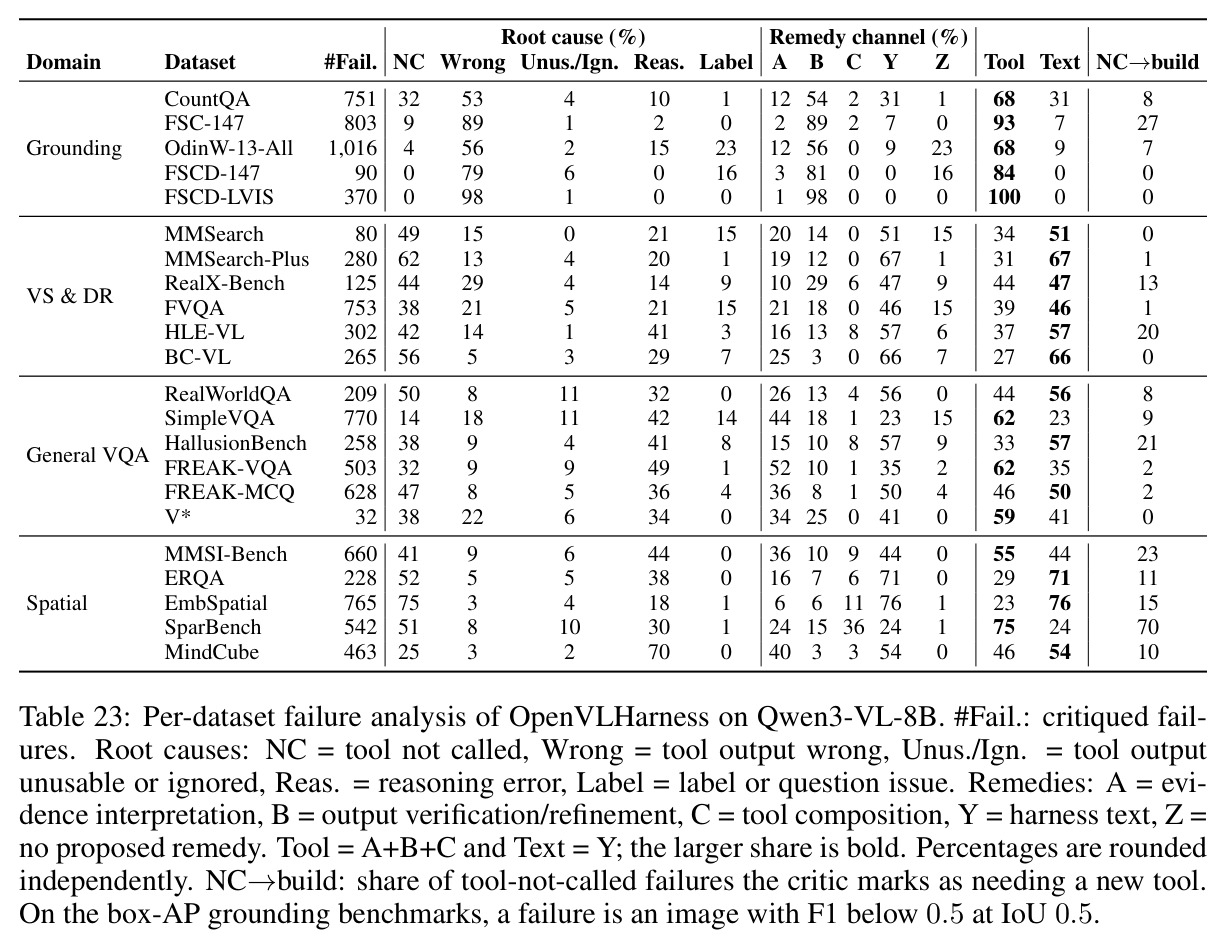
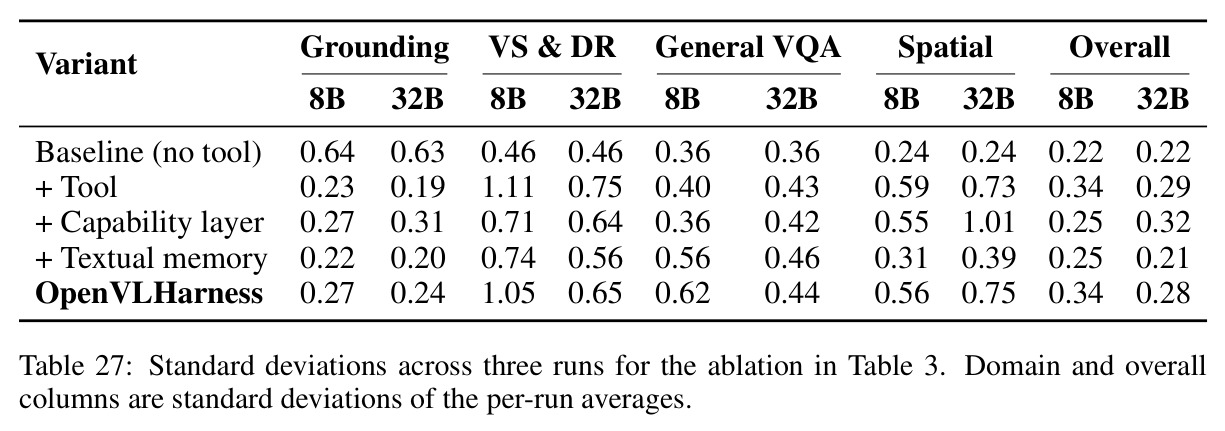
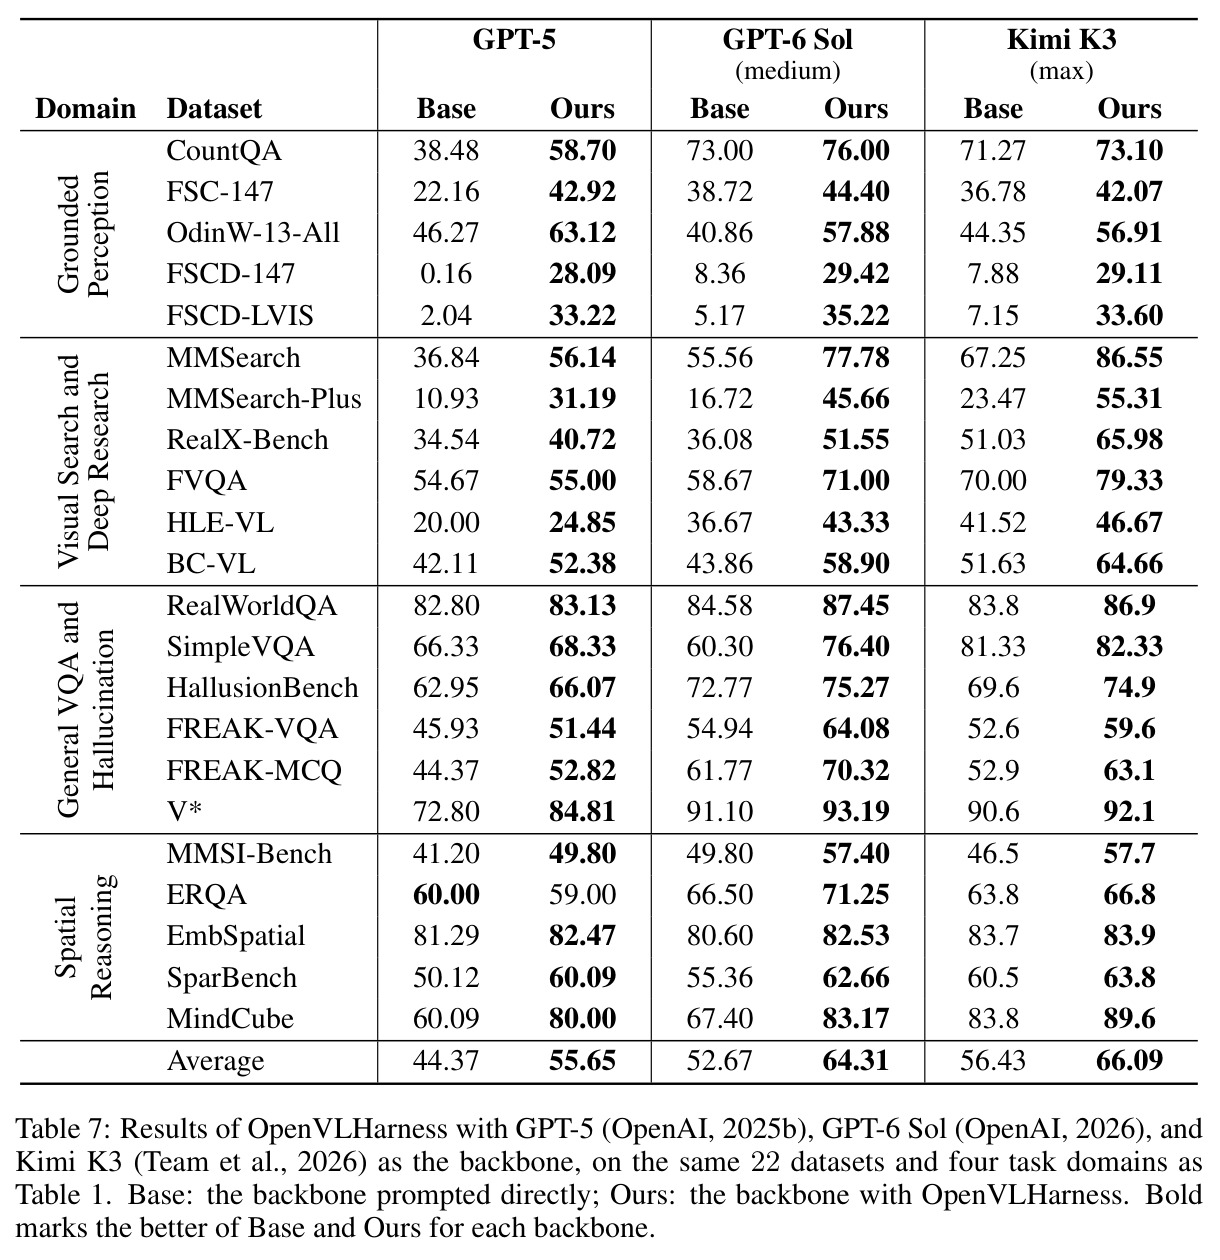
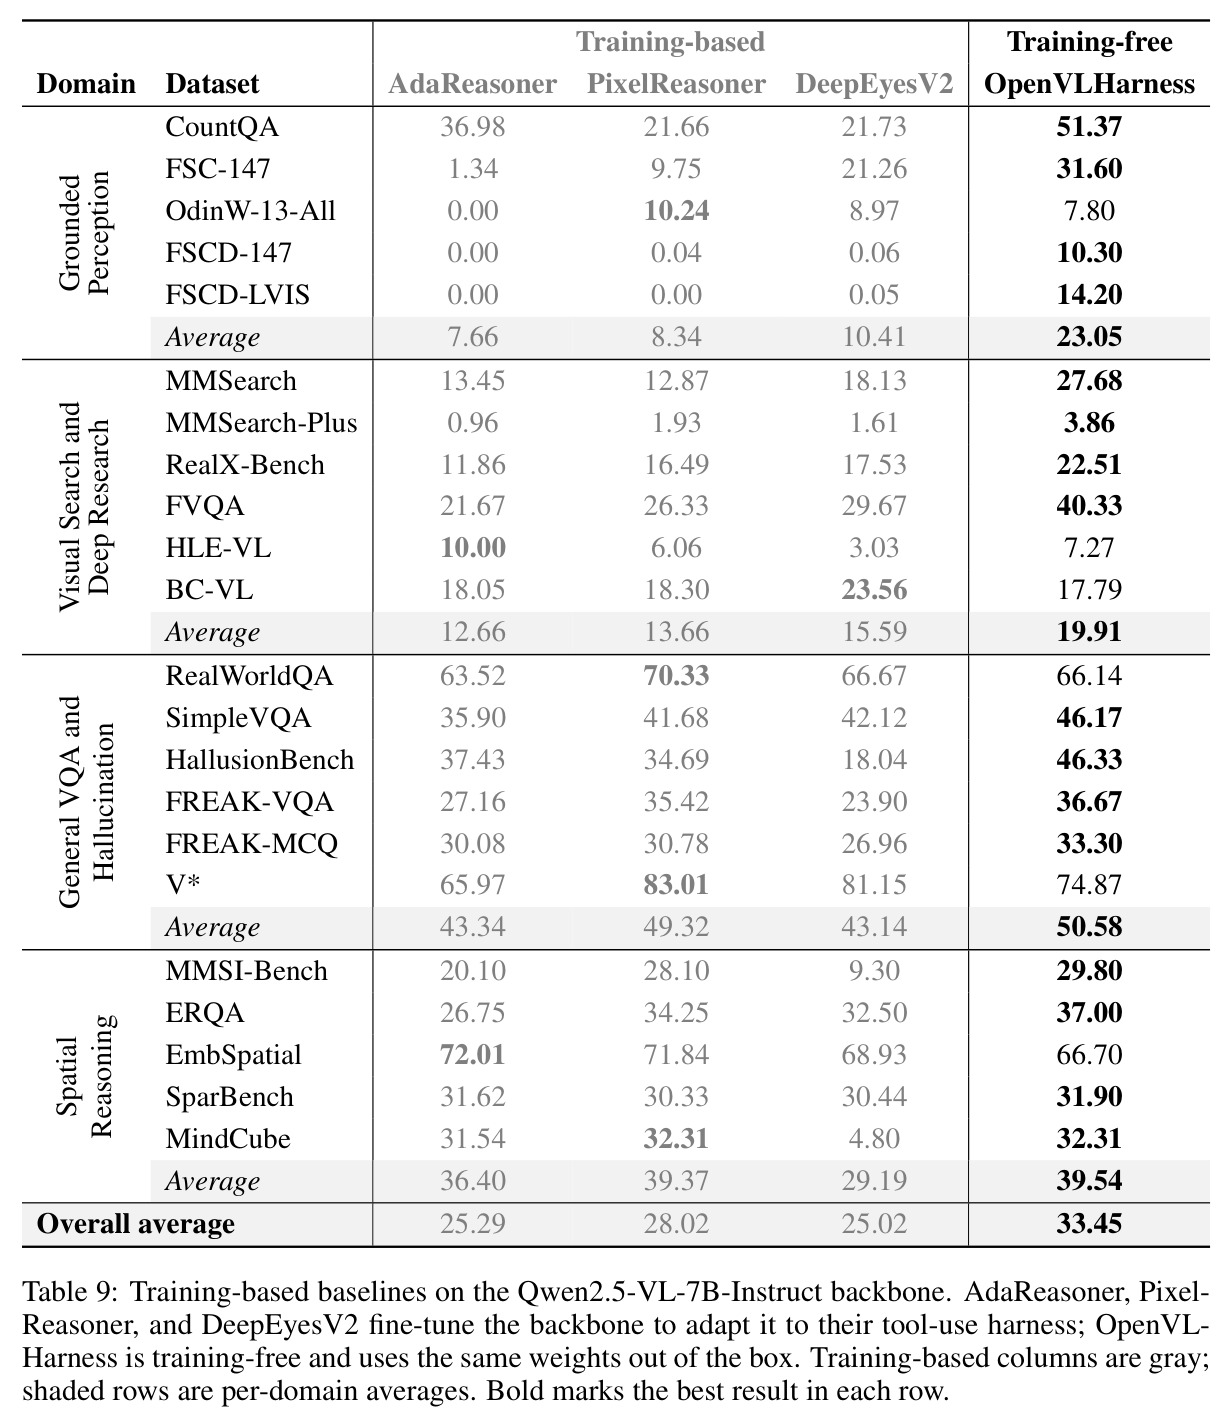
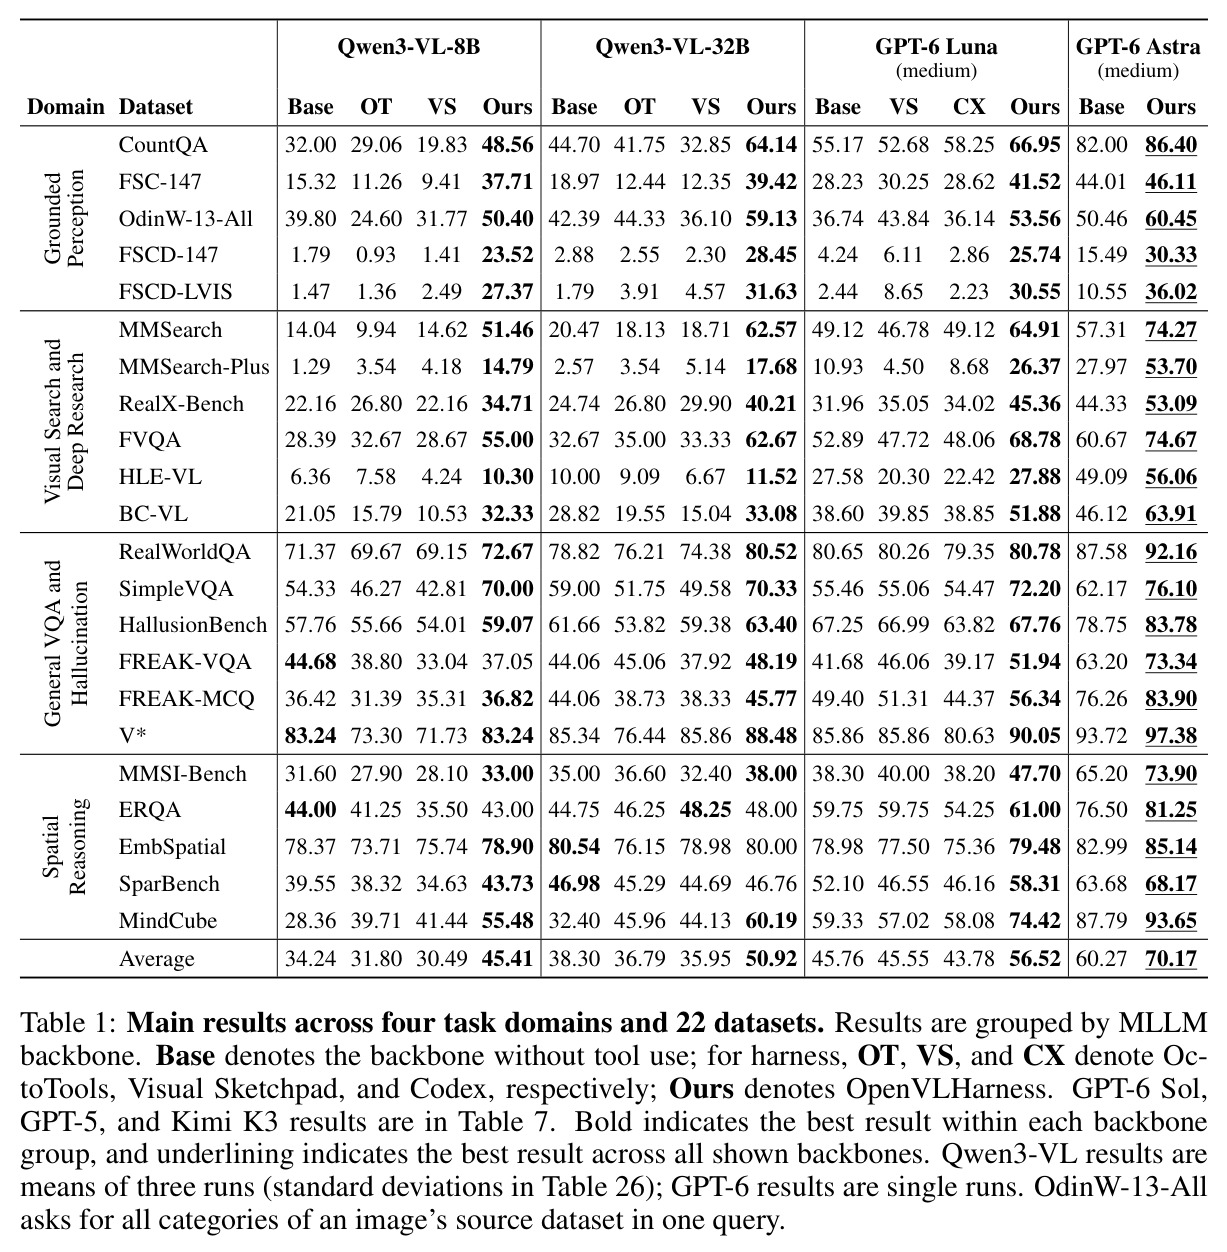
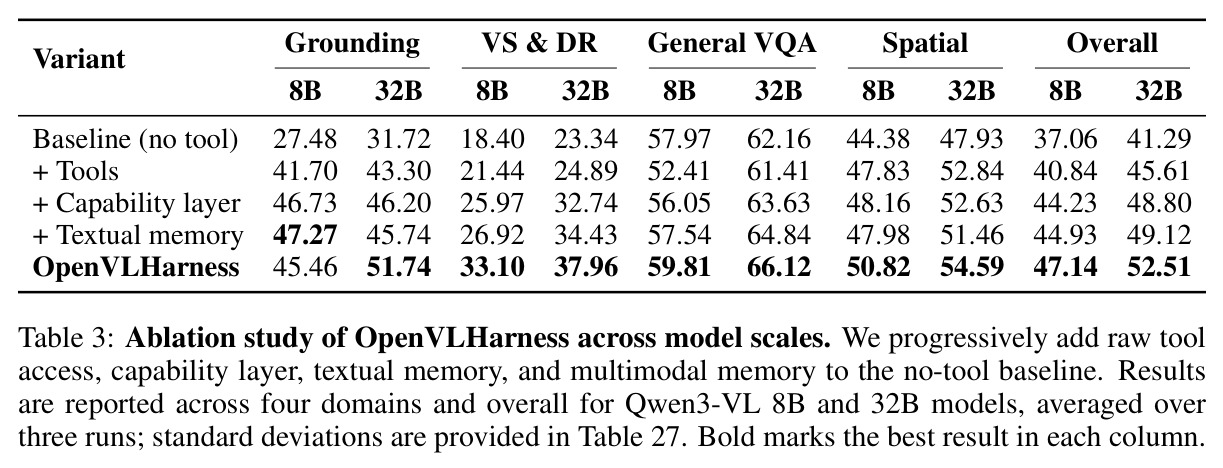
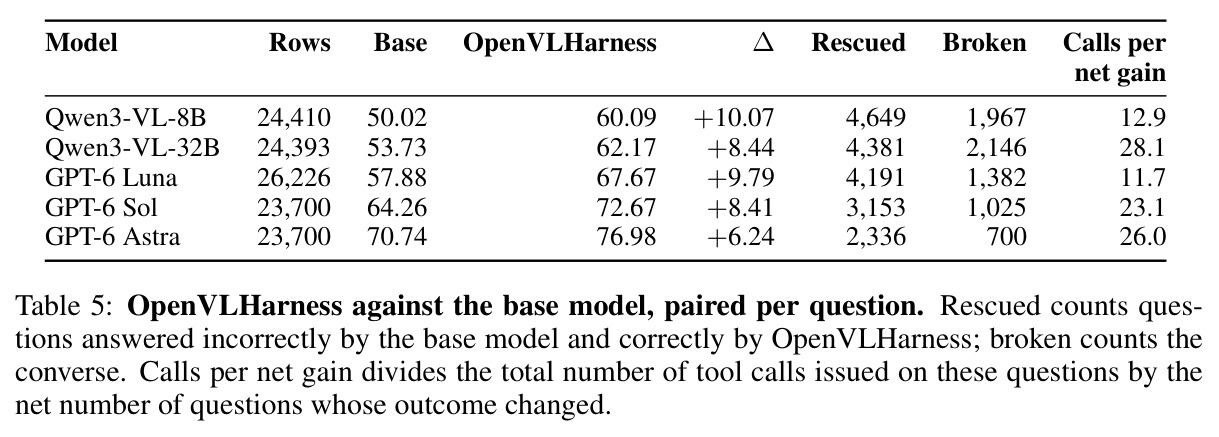
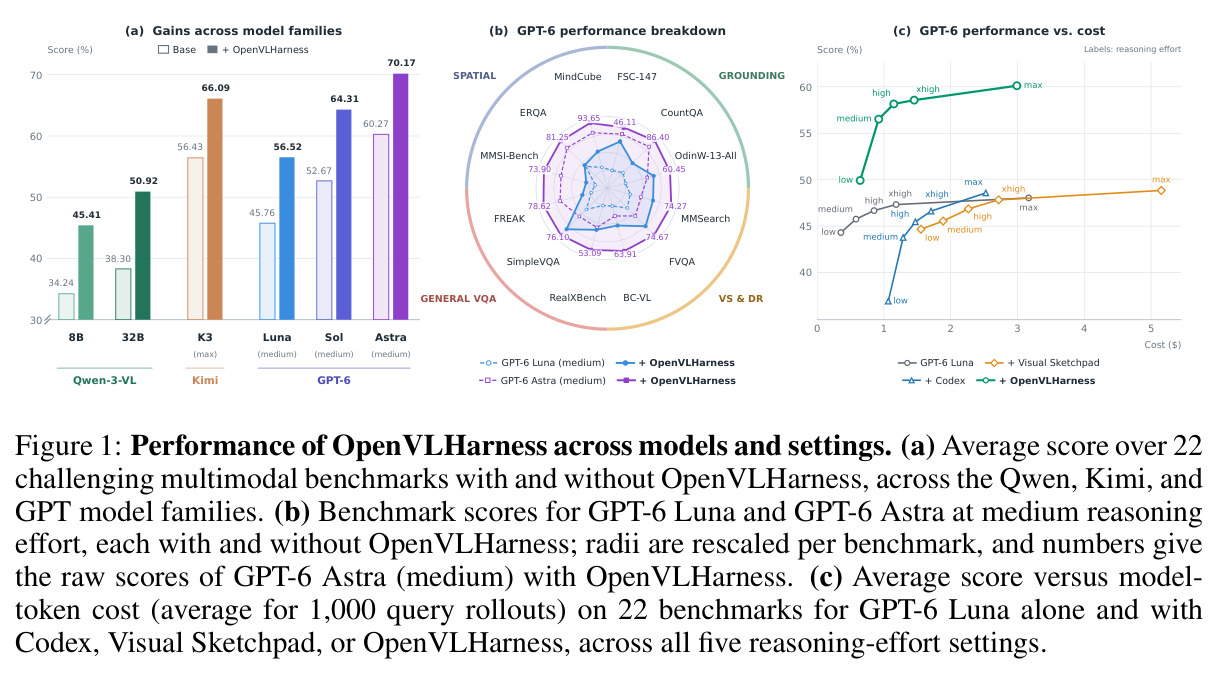
核心发现按实验逐一分析。(1)主实验(Table 1):22 基准、8 骨干,相对无工具基线平均提升 9.7–12.6 分——Qwen3-VL-8B 34.24→45.41($+11.2$)、32B 38.30→50.92($+12.6$)、GPT-5 44.4→55.7、Kimi K3 56.4→66.1、GPT-6 Astra 60.27→70.17($+9.9$,22 项全升)。8B 上超最强免训练基线 OctoTools(31.8)13.6 分;Qwen2.5-VL-7B 上得 33.45,超过需微调的 DeepEyesV2(25.02)。(2)推理预算对照(Table 2):GPT-6 Luna 每档 26,229 题,Base 从 low 到 max 仅 44.3→48.0,Visual Sketchpad 到 48.8,Codex 到 48.6;OpenVLHarness medium 档即 56.5,花费不超过对手 max 档成本的 37%,max 档在 Grounding/VS&DR 领先 15.6/12.4 分。(3)消融(Table 3):8B 从 37.06→40.84(裸工具 $+3.8$)→44.23(能力层 $+3.4$)→44.93(文本记忆 $+0.7$)→47.14(多模态记忆 $+3.1$)。(4)失败分析:9,893 条失败轨迹中 Grounding 域 75% 归因工具输出错误,VS&DR 49% 是漏调工具。(5)专项优化:harness search 在 ERQA/RealWorldQA 提升 $+4.1$/$+3.7$,tool generation 在 SparBench/FREAK-VQA 提升 $+8.2$/$+4.5$。逐题配对显示每净纠错一题花费 11.7–28.1 次调用。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 22 基准平均(Qwen3-VL-8B) | 平均得分(3 次运行均值) | 45.41 | Base 34.24;最强免训练基线 OctoTools 31.80 | 较 Base +11.2 分,较 OctoTools +13.6 分 |
| 22 基准平均(Qwen3-VL-32B) | 平均得分 | 50.92 | Base 38.30;OctoTools 36.79 | 较 Base +12.6 分 |
| 22 基准平均(GPT-6 Astra, medium) | 平均得分 | 70.17 | Base 60.27 | +9.9 分,22 项基准全部提升 |
| 22 基准平均(Kimi K3, max) | 平均得分 | 66.09 | Base 56.43 | +9.7 分 |
| GPT-6 Luna 跨推理力度对比 | 平均得分 / 模型 token 成本(每千题) | medium 档 56.5($0.92) | Base max 档 48.0($3.17);Codex max 48.6($2.52);Visual Sketchpad max 48.8($5.15) | 领先 7.7–8.5 分,成本仅其最多 37% |
| Qwen2.5-VL-7B 对比训练类基线 | 22 基准平均得分 | 33.45(免训练) | AdaReasoner 25.29;PixelReasoner 28.02;DeepEyesV2 25.02(均需微调) | 最高领先 8.43 分且不更新权重 |
| 组件消融(32B 完整 vs 无工具) | 22 基准平均得分 | 52.51 | 无工具 41.29;裸工具 45.61;文本记忆 49.12 | 合计 +11.2 分,其中多模态记忆贡献 +4.5 |
局限与改进
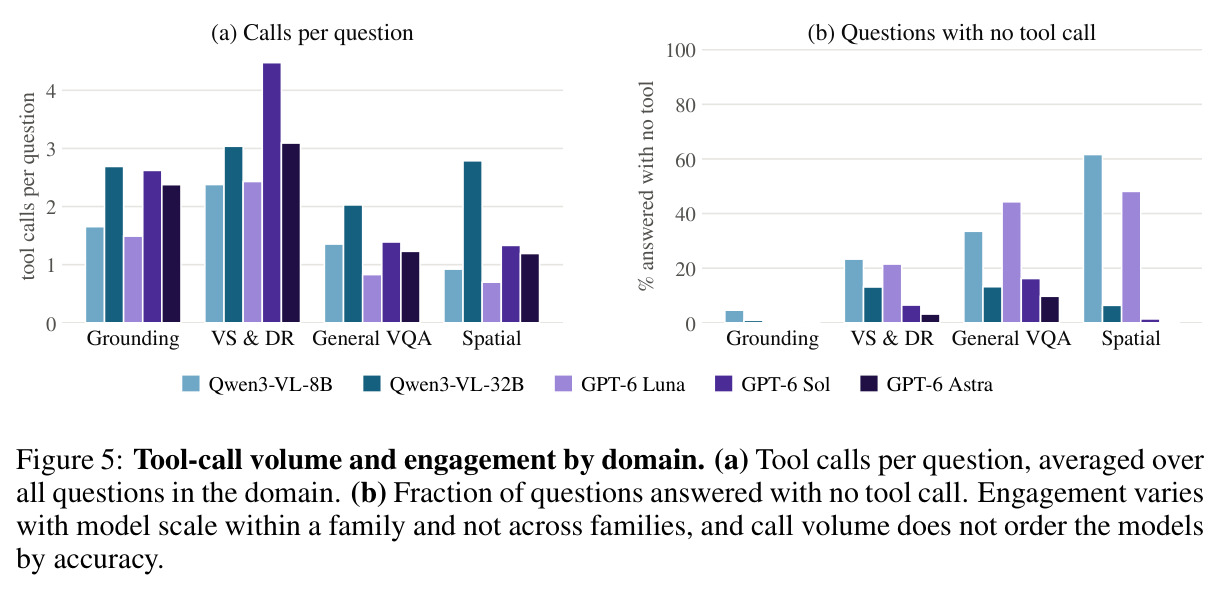
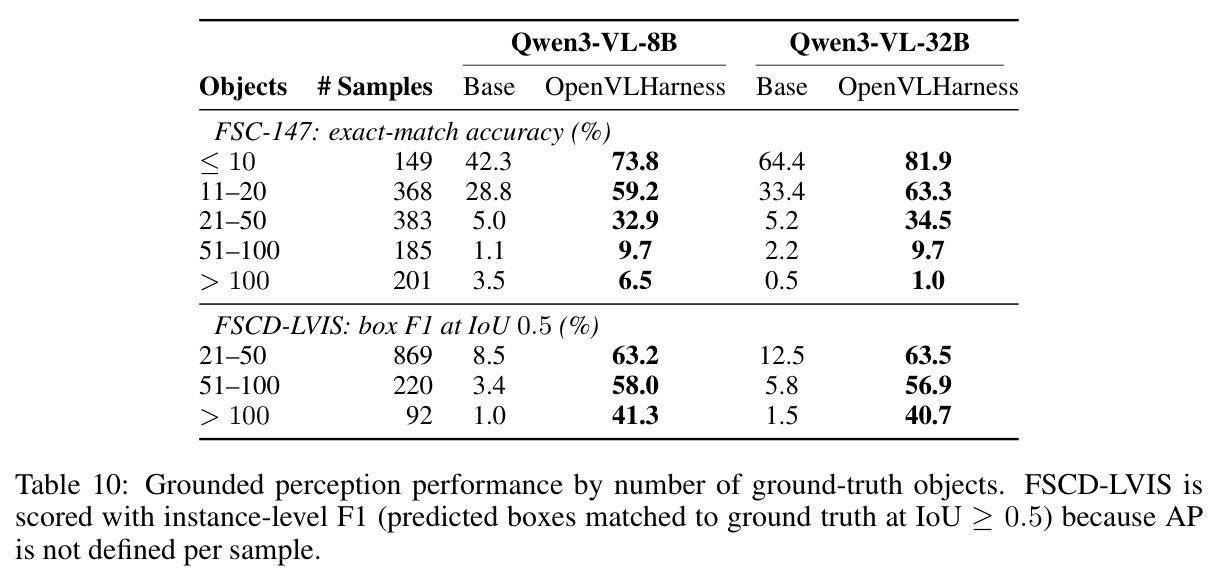
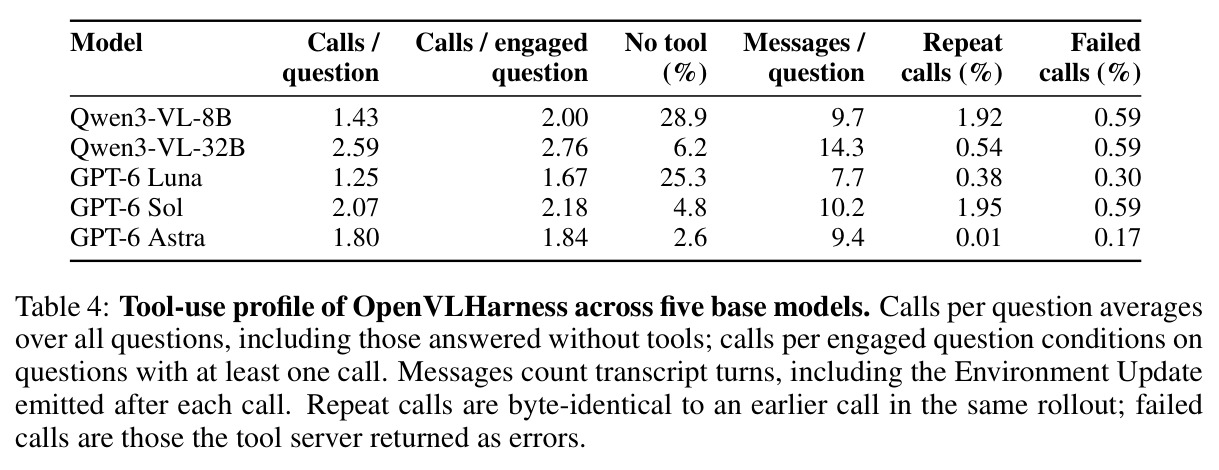
作者承认的局限:一是收益分布不均——通用 VQA 与幻觉、空间推理域的增益更依赖骨干能力,Luna 在 RealWorldQA、HallusionBench、EmbSpatial 上提升不足 1 分;Qwen3-VL-8B 在部分基准上增益不一致,8B 有 28.9% 的问题根本未调用工具,说明小模型使用工具的熟练度有限。二是密集感知仍是硬骨头:超过 25 个物体的图像中漏检与实例合并主导了 Grounding 域 75% 的失败。三是成本核算不含工具执行与 LLM 判卷费用,专有模型结果为单次运行。我自己的观察:其一,LLM 判卷器与搜索摘要器都用 Qwen3-VL-8B,与部分被评骨干同源,可能引入评测偏差;其二,搜索依赖 Serper 单一商业 API,可复现性受第三方制约;其三,逐题配对显示仍有 700–2,146 题'被工具做坏',未调工具时 8B 还损失 1.8 分,提示工具接口有上下文税;其四,每题 8–14 轮对话的延迟未报告,实际部署体验存疑。
独立分析的弱点
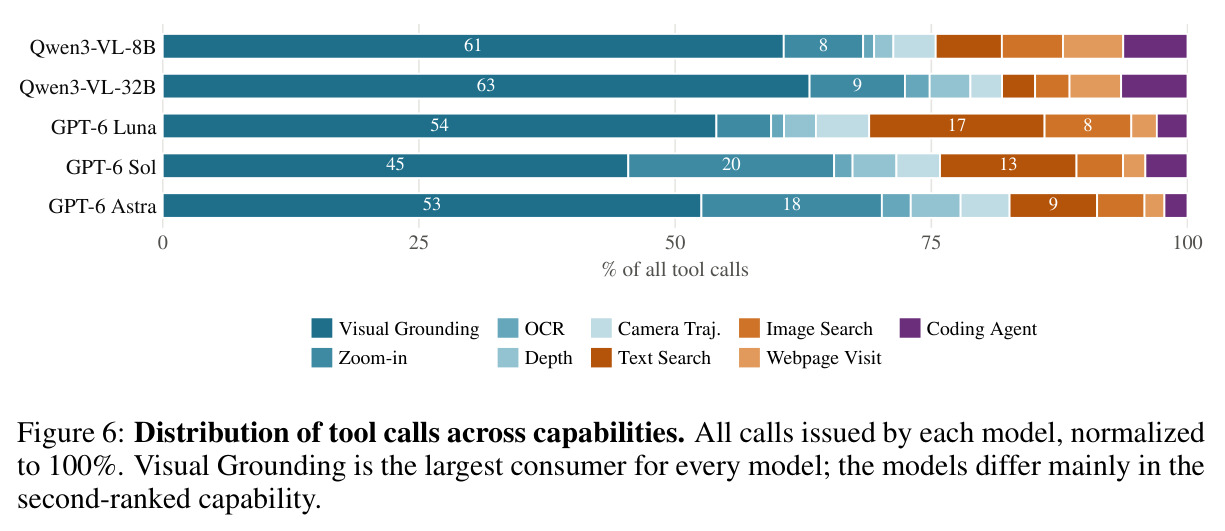
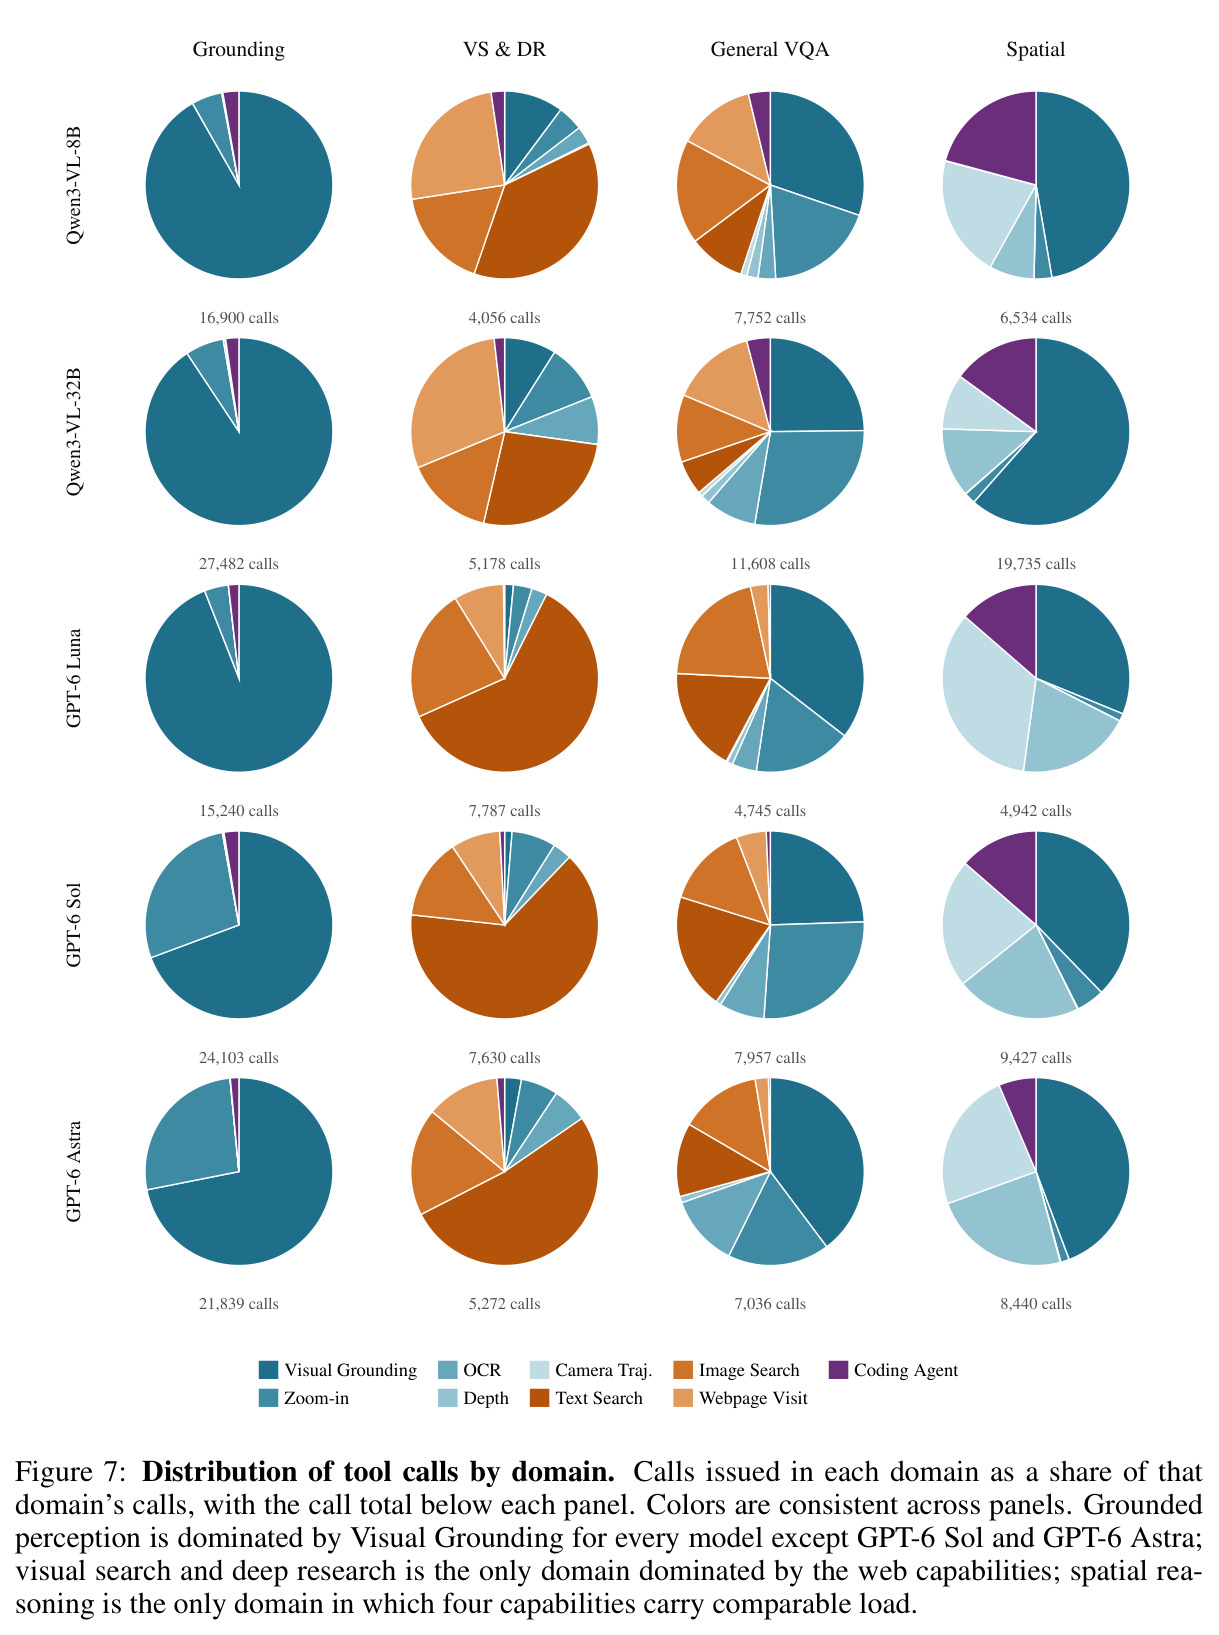
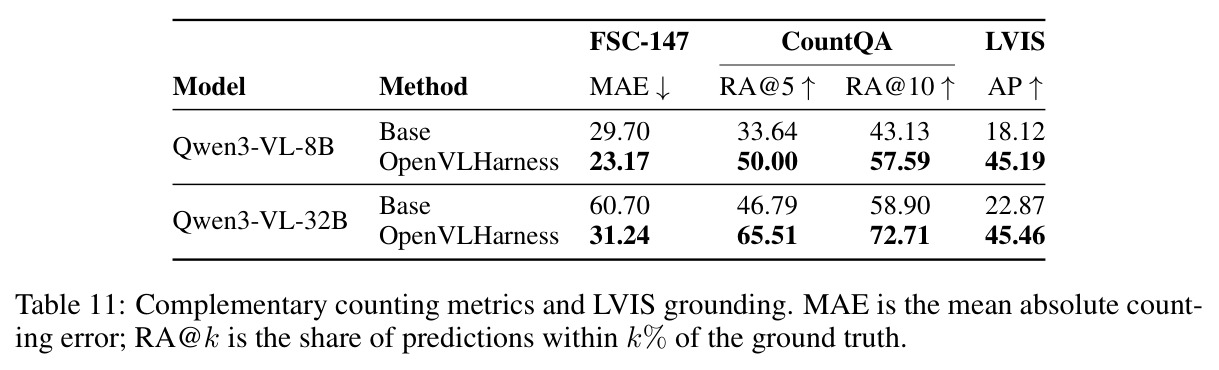
独立分析的弱点及改进方向:(1)小模型不会主动用工具——Qwen3-VL-8B 有 28.9% 的问题零调用,携带工具接口本身还带来 $-1.8$ 分的空载税;改进方向是为小模型蒸馏工具调用策略,或按问题类型注入领域相关的调用先验,降低'何时该调工具'的决策难度。(2)感知后端是准确率天花板——Grounding 域 75% 失败源于检测/分割错误,框架再好也救不了 SAM 3 在数百物体场景的漏检;改进方向是接入高密度计数专家(如 CountGD)、分块迭代检测或专用密集场景模型,并在证据渲染层提示模型对高密度区域做多次局部查询。(3)工具收益不对称——Depth Estimation、OCR、编码智能体在多数模型上不优于对照组,调用占比也低;改进方向是按域自适应启用工具子集,缩小选择空间、降低提示长度。(4)记忆机制按查询隔离,跨问题无法积累知识;改进方向是引入可检索的长期多模态记忆与重要性剪枝。(5)专项优化依赖失败轨迹与多轮重复评测,小数据域可能噪声过大;改进方向是结合少量人工标注校准批判器,或用更强的批判模型降低 8% 的标签噪声。
未来方向
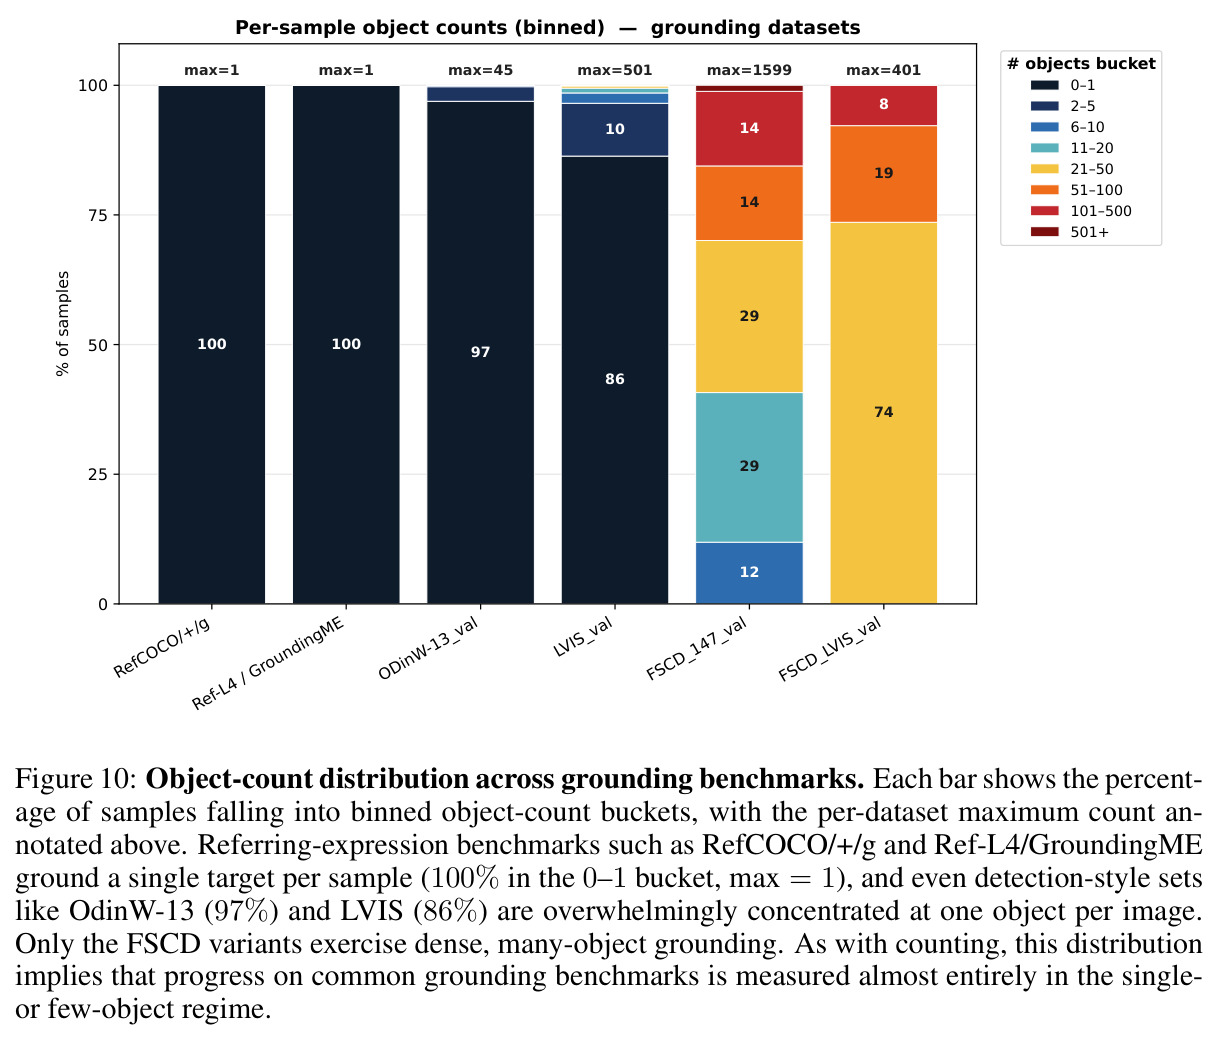
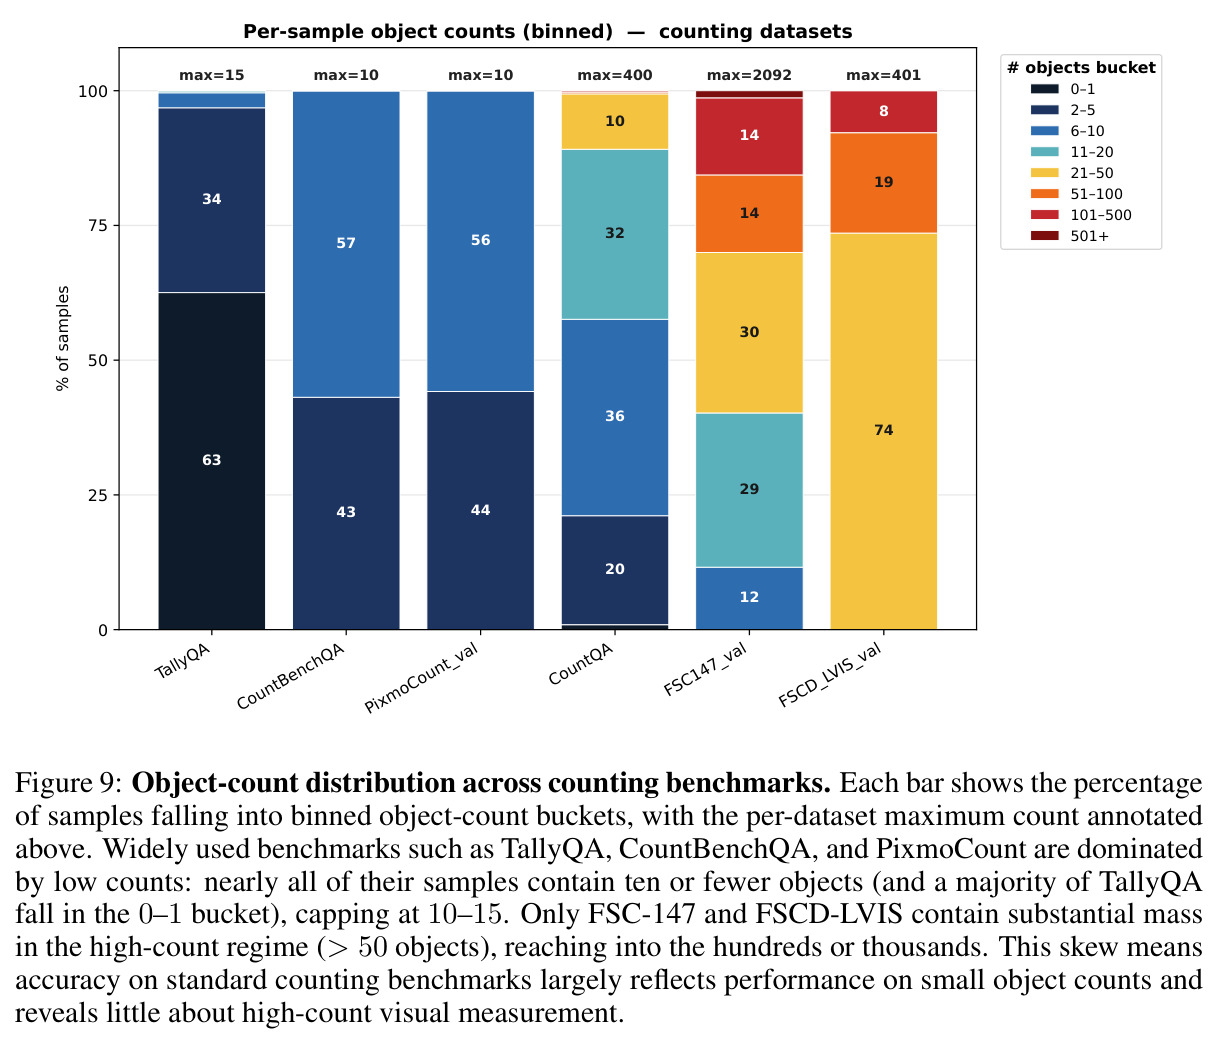
作者提出的方向:将 harness search 与 tool generation 推广到更多自定义领域,让工具库随任务自动生长;把 harness、工具、评测协议和优化工作流开源作为社区基础设施。基于成果可延伸的方向:(1)在 harness 之上做强化学习——免训练已有 9.7–12.6 分增益,用可验证奖励微调 orchestrator 的工具路由策略可能进一步放大;(2)跨查询持久记忆:把单查询工件注册表扩展为可检索的长期多模态知识库,支持'上次查过这个产品'类连续任务;(3)后端自动路由:按精度/成本/延迟动态选择 SAM 3 与 Grounding DINO 这类互换后端,接口层天然支持但论文未实现;(4)并行工具调用与异步执行,压缩 8–14 轮串行对话的延迟;(5)把'推理预算×工具'互补性研究推广到纯文本智能体,检验能力层+记忆范式能否迁移到代码、网页场景;(6)构建更高密度的计数与定位基准——Figure 9/10 显示主流基准绝大多数样本不超过 10 个物体,而 FSCD-LVIS 最高达 1599 个,高密度区间的测量能力远未被充分评测。
复现评估
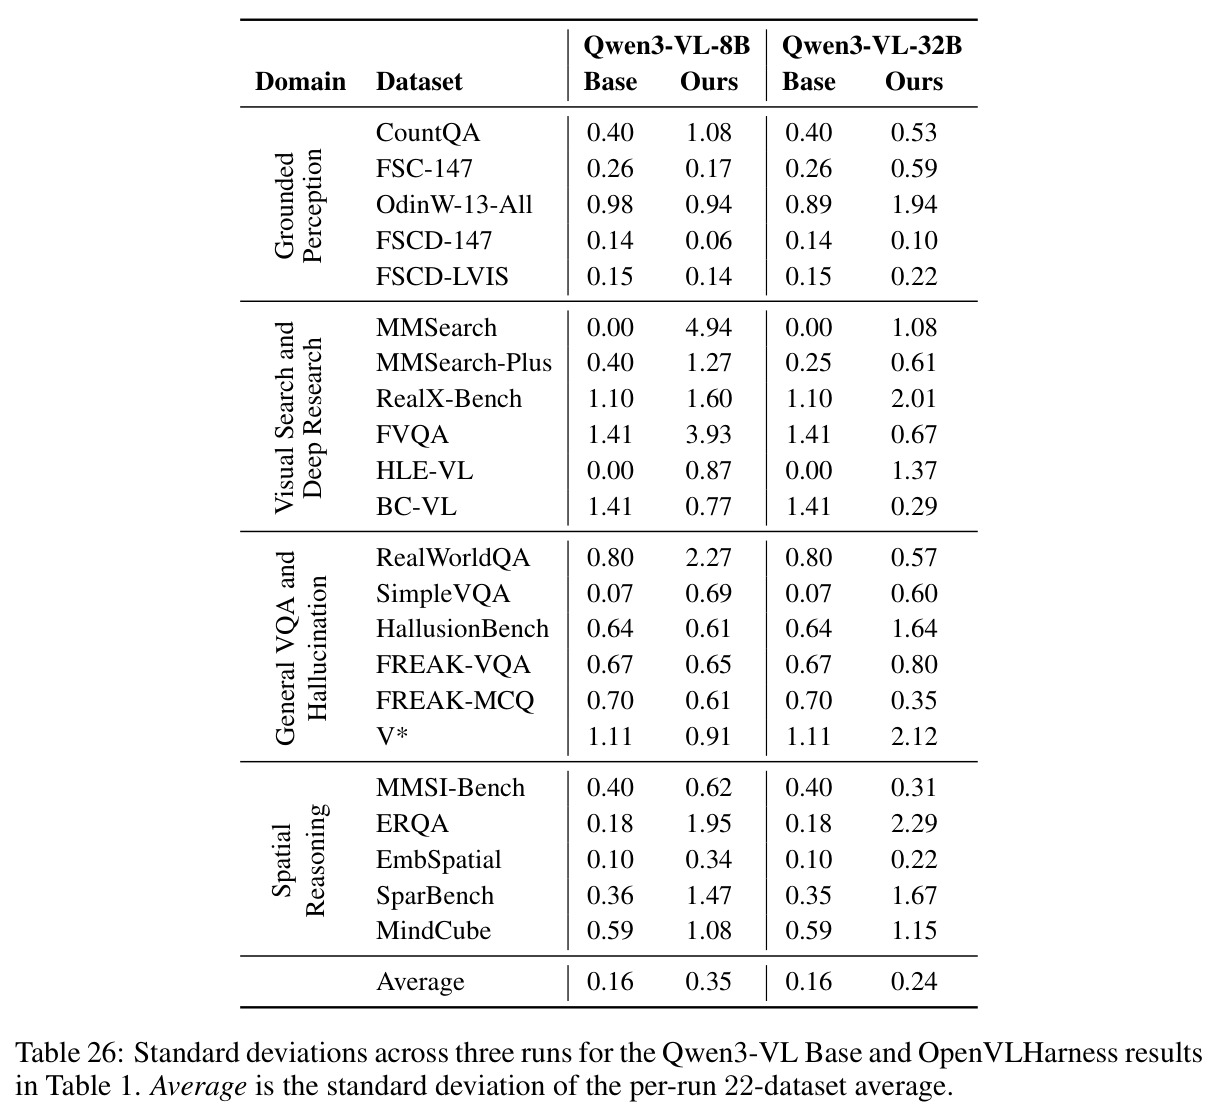
复现条件相当友好。代码开源(github.com/uclanlp/OpenVLHarness),项目页 openvlharness.github.io,发布内容包括 harness、九个工具、22 基准评测协议和两条优化工作流。开源侧:Qwen2.5-VL-7B、Qwen3-VL-8B/32B 经 vLLM 部署,感知后端 SAM 3、Grounding DINO、PaddleOCR-VL、DeepSeek-OCR、Depth Anything 3、VGGT 均为公开模型本地服务,需较大显存 GPU。专有侧:GPT-5、GPT-6 系列与 Kimi K3 需 API 付费,专有模型结果为单次运行;搜索默认走 Serper API(付费)。22 个评测数据集均为公开数据,Qwen3-VL 结果为三种子平均且附标准差。整体难度中等:无需训练,算法门槛低,但工程集成量不小(工具服务器、消息循环、记忆注册表都要复刻);复现单模型单基准结论较可靠,完全复现 8 骨干×22 基准主表需可观 API 预算。
论文图表