SpecKCast:面向扩散模型加速的谱域卡尔曼预测 SpecKCast: Spectral Kalman Forecasting for Diffusion Acceleration
在DCT频域用逐系数Kalman滤波预测跳步输出,配合不确定性调度实现最高6×免训练加速
前置知识
扩散模型与流匹配
扩散模型通过逐步去噪把高斯噪声变成数据;流匹配是其现代变体,学习一个速度场 $v=\epsilon-x_0$,沿近似直线路径 $x_t=(1-t)x_0+t\epsilon$ 把噪声输运到数据。采样用欧拉更新 $x_{j+1}=x_j+(\sigma_{j+1}-\sigma_j)Y_j$ 迭代执行,每一步都要完整跑一次大模型前向。推理代价用 NFE(去噪器被真正评估的次数)衡量,含 CFG 的模型每步消耗两次前向。
SpecKCast 加速的对象正是这个逐步采样循环:它预测被跳过步骤的速度输出 $Y_j$,让采样器少跑完整 transformer 前向,因此必须先理解采样更新式和 NFE 的含义。
特征缓存与预测式加速
相邻去噪步的模型输出高度相似,缓存类方法(DeepCache、FORA、TeaCache)把先前步的特征或输出直接复用到后续步来跳过计算;代价是跳步间距变大后相似性衰减、误差累积,只能做到约 3× 加速。预测式方法(TaylorSeer 用有限差分泰勒展开、Spectrum 用切比雪夫级数拟合全部历史)进一步外推目标步的取值,从而支持更大的跳步间隔。
SpecKCast 属于预测式加速这一族,理解缓存与预测的区别及各自的失效模式,才能看懂它在“预测什么、沿哪条时间轴预测”两个层面的针对性创新。
2D DCT 与径向频带分解
二维离散余弦变换是一种正交变换,把图像/特征映射到空间频率系数上;正交归一化保证白噪声变换后仍是白噪声、能量可无损还原。把频率平面按归一化半径 $r(a,b)$ 划分为 $L$ 个互不重叠的环形(径向)频带,就可以把系数按低频/中频/高频分组建模与统计。
SpecKCast 对每步 transformer 输出逐通道做 2D DCT,再按 7 个径向频带分组跟踪,是全文“频域解耦预测”设计的核心载体。
Kalman 滤波
经典递归状态估计器:维护状态 $h_j=(m_j,\nu_j)$(信号值与变化率)及其协方差 $P_j$,每步先按转移矩阵预测 $\hat h_j=A_j\hat h_{j-1}$、$\bar P_j=A_jP_{j-1}A_j^\top+Q_j$,有观测时再按增益 $K_j$ 修正。无观测时协方差持续增长,定量刻画“预测越来越不可信”;全程在线、常数内存,可并行跟踪海量信号。
SpecKCast 给每个 DCT 系数配一个微型 Kalman 滤波器:预测均值作为跳步输出,协方差膨胀作为“何时必须真正计算”的调度信号,这是整个方法的数学骨架。
噪声调度与对数信噪比 log-SNR
噪声调度定义每个去噪步的噪声水平 $\sigma_j$;在流匹配插值 $x_j=(1-\sigma_j)x_0+\sigma_j\epsilon$ 下,$\lambda_j=2\log\frac{1-\sigma_j}{\sigma_j}$ 即该步的 log-SNR,衡量还剩多少信号。由于真实管线常对调度做 shift(且与分辨率相关),等间隔的步号并不对应等量的去噪进度,用步号 $j$ 当时间轴会让轨迹难以外推。
SpecKCast 不用步号而用 log-SNR 派生的逐频带非线性时间坐标,这是它区别于既有预测方法的关键之一,也解释了等步长为何会放大外推误差。
无分类器引导(CFG)
CFG 每步把 transformer 跑两次(有提示词与负提示词),按 $Y=u+w(c-u)$ 组合两个输出以提升文本一致性,因此含 CFG 模型的每个去噪步消耗两次前向。Qwen-Image 等模型还会对引导结果做逐 token 的范数重缩放等非线性修正。
论文评测的四个模型多数使用 CFG;SpecKCast 选择在引导合成之后预测最终速度,这决定了方法的放置位置、NFE 统计方式以及与“分分支预测”方案的理论等价条件。
研究动机
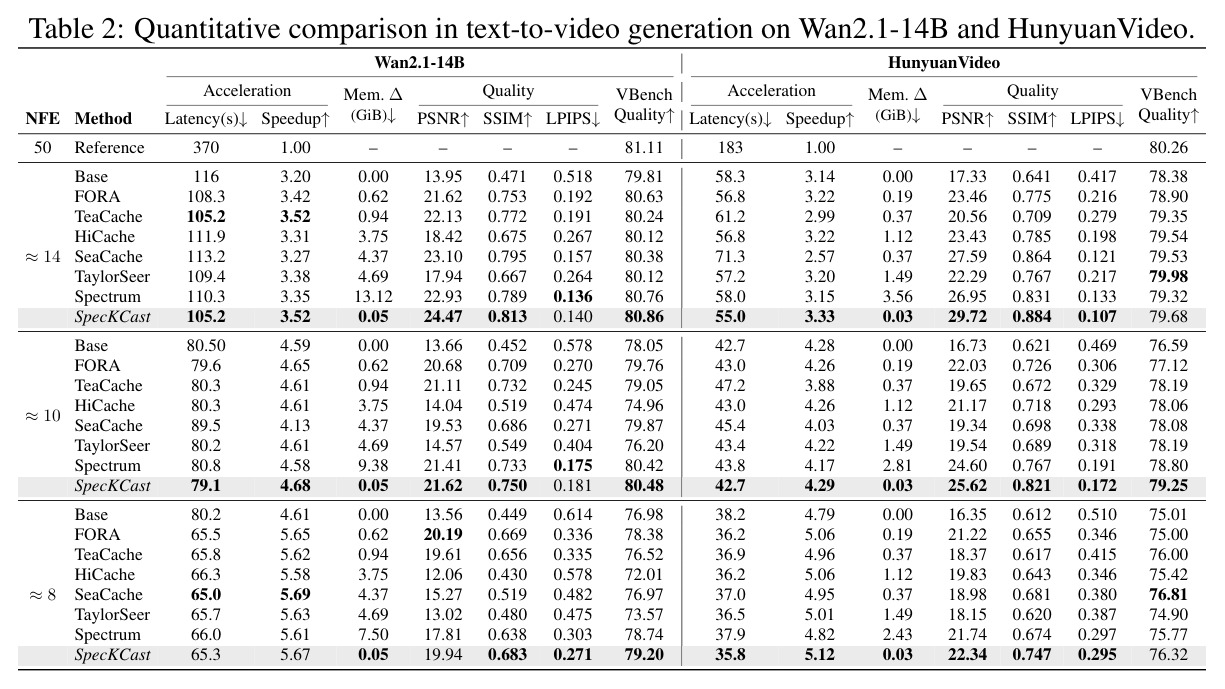
扩散 Transformer(DiT)的推理代价极高:FLUX.1-dev 生成一张 1024×1024 图像需要 50 步、H100 上延迟 11.68 秒,Wan2.1-14B 生成一段视频要 370 秒,难以进入实时应用。免训练的特征缓存方法(FORA、TeaCache、SeaCache 等)利用相邻步输出的相似性跳过计算,但相似性随跳步间距增大而衰减,误差在采样过程中累积,长跳步下画质骤降,实际只能做到约 3× 加速。新出现的预测式方法(TaylorSeer、Spectrum)改用外推,能支持更大间距,但它们把输出当作一个整体、用同一条外推规则和同一个时间轴处理所有分量:而低频成分在去噪前几步就剧烈变化然后稳定,高频成分前段几乎不动、第 40 步之后才快速演化,统一预测器必然顾此失彼;再加上等步号间隔对应的去噪进度并不相等,跳步一长预测误差被显著放大——Spectrum 在 Qwen-Image 8 NFE 下 LPIPS 恶化到 0.527,远高于其 14 NFE 时的 0.135。
本文的目标是本文目标是设计一个免训练、几乎零开销的 DiT 推理加速方法:把 50 步采样压缩到 8–14 NFE(对应约 3.4×–6× 加速)的同时,让生成结果尽可能复现 50 步全量计算在同提示词、同种子下的参考输出,而不是“换一张还过得去的图”。具体量化目标包括:在高加速档把最强基线的保真度再推高 1–2 dB PSNR、把 LPIPS 显著压低;把额外显存开销控制在 0.05 GiB 以内(对比 TaylorSeer/HiCache/Spectrum 高达 0.73–18.97 GiB 的额外显存);额外延迟不超过约 0.1 秒;并且完全不改模型权重、不蒸馏、不做任何训练。
与已有工作不同的是,作者的独特切入点是质疑预测式方法的两个“隐含均匀性假设”。其一,预测对象不该是整体特征:论文图 2 用 PCA 轨迹展示 FLUX.1-dev 一次生成中 50 个速度预测的主成分路径,发现低频带 B0 第一步就剧烈移动、中频带 B3 在更宽区间演化、高频带 B6 在第 40 步后才最活跃——各频带在不同阶段“轮流值班”,单一预测器必然顾此失彼(附录 G 进一步用 12 条提示词的联合分析验证了该模式跨提示、跨模型成立)。其二,时间轴不该是步号或原始 timestep:每个 scheduler 的去噪进度非均匀,等步长不代表等变化量。据此 SpecKCast 提出“频域解耦预测 + 调度器对齐的非线性时间轴 + 带不确定性的在线滤波”三合一设计,并让不确定性直接驱动计算调度。
核心方法
直觉上,去噪过程中模型输出的低频结构(构图、主体)早早定型,而高频细节(纹理、边缘)要到收尾阶段才涌现,所以不该用同一个外推器、同一条时间轴对付所有频率成分。技术上,SpecKCast 在推理时对每个 transformer 输出 $Y_j\in\mathbb{R}^{C\times H\times W}$ 逐通道做正交 2D DCT 得到 $Z_j$,把频率平面按归一化半径切成 $L=7$ 个径向频带;每个系数配一个两维状态的 Kalman 滤波器,同时跟踪值 $m_{i,j}$ 与时间导数 $\nu_{i,j}$,同频带共享时间坐标、过程噪声与协方差(仅 $L$ 个 2×2 矩阵);时间坐标由噪声调度派生的 log-SNR $\lambda_j=2\log\frac{1-\sigma_j}{\sigma_j}$ 经逐带 sigmoid 弯折并重标定到 $[-1,1]$。计算步上用观测修正滤波器,跳步上用预测值经逆 DCT 回空间域直接喂给采样器;另有一个“风险副车”协方差递归估计预测误差何时超过阈值 $\epsilon$,据此触发真正的模型计算。整个流程额外显存约 5 MiB(FLUX.1),各变体延迟差在 0.1 秒以内。
核心创新是“预测什么”与“沿什么预测”的双重重参数化,再配上原则性的不确定性调度。与 TaylorSeer(对整体输出做有限差分泰勒外推)、Spectrum(对全部历史拟合切比雪夫级数)的本质区别有三点。第一,预测单位从整个输出或通道降为单个 DCT 系数,天然表达“低频早稳定、高频晚活跃”的异质动态(图 2 的 PCA 证据)。第二,时间轴从步号 $j$ 或原始 timestep 换成逐频带弯折的 log-SNR 坐标 $s^\ell(j)=\mathrm{rescale}_{[-1,1]}\,\mathrm{sigmoid}\big((\lambda_j+\log p^\ell)/T_w\big)$,其中 $\lambda_j+\log p^\ell$ 恰是频带自身 SNR 的对数(附录 B.1),sigmoid 在“该带信号从噪声中浮现”处导数最大,于是时间增量自动在带活跃期大、沉寂期小,一个简单动力学模型无需逐步逻辑就能自适应各带行为。第三,Kalman 协方差的膨胀给出可度量的预测不确定性,用第一性原理的量替代启发式的“该不该算”决策。
方法步骤详情
方法分五步。第一步标定:用 12 条提示词跑未加速模型,由末段 25 步输出估计各频带功率 $p^\ell$,并对阈值 $\epsilon$ 二分搜索对齐 NFE 预算。第二步准备:按管线实际(可能带 shift 的)噪声调度重建 $\sigma_j$,为每个频带算好时间坐标 $s^\ell(j)$,开销仅为标量运算。第三步初始化:状态取 $m_{i,0}=Z_{i,0}$、$\nu_{i,0}=0$,前 3 步与末步强制真实计算。第四步推进:每个去噪步先用带内共享的转移 $A_{\ell,j}$(值积分导数、导数按 $\rho_{\ell,j}=e^{-\Delta/\tau}$ 阻尼,$\tau=0.1$)与积分维纳噪声 $Q_{\ell,j}$ 预测;计算步用观测 DCT 系数按 Kalman 增益修正并在线更新 $\tilde\kappa_\ell$;跳步取预测均值经 IDCT 得 $\hat Y_j$ 送采样器。第五步调度:风险副车前滚协方差预测风险 $R(j)$,首个 $R>\epsilon$ 的步触发计算,连续跳步上限 10。CFG 模型在引导合成后预测最终速度即可。
技术新颖性
技术新颖性在于把三个经典组件以正交方式组合出新的能力:DCT 频带分解把“扩散输出各频率异时演化”的经验观察(图 2 与附录 G 的 12 提示词联合 PCA)变成可操作的预测单元;逐带时间弯折不是启发式缩放,而是有明确物理解读的重参数化——sigmoid 的自变量 $\lambda_j+\log p^\ell$ 就是该频带自己的 log-SNR,零交叉点即“信号压过噪声”的时刻,时间增量因此自动对齐该带的活跃窗口;积分维纳过程噪声 $Q_{\ell,j}$ 与阻尼转移 $A_{\ell,j}$ 的搭配保证跳步越长不确定性越大、趋势贡献有界($\Delta/(1-\rho^\ell)\to\tau^\ell$,附录 C),从数学上防止长时间外推的过冲。相比 HiCache 的缩放 Hermite 多项式或 SeaCache 的谱滤波缓存决策,SpecKCast 是唯一把频带、时间轴、不确定性三者统一进一个在线估计框架的方法;协方差按频带共享(仅 $L=7$ 个 2×2 矩阵加副车),使数十万系数的并行跟踪几乎零成本。
实验结果
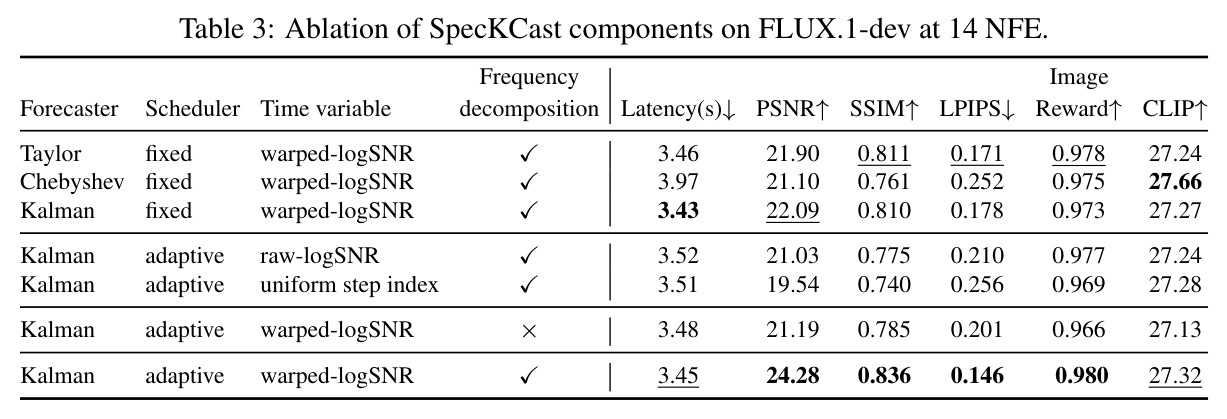
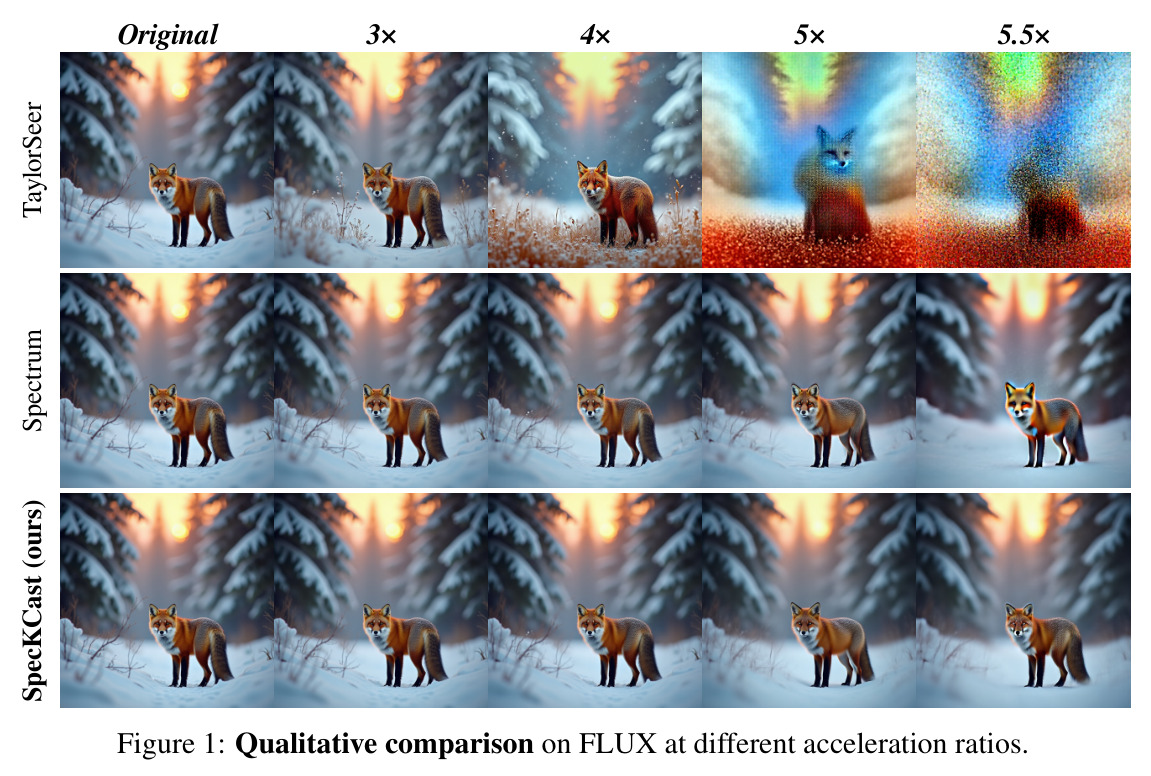
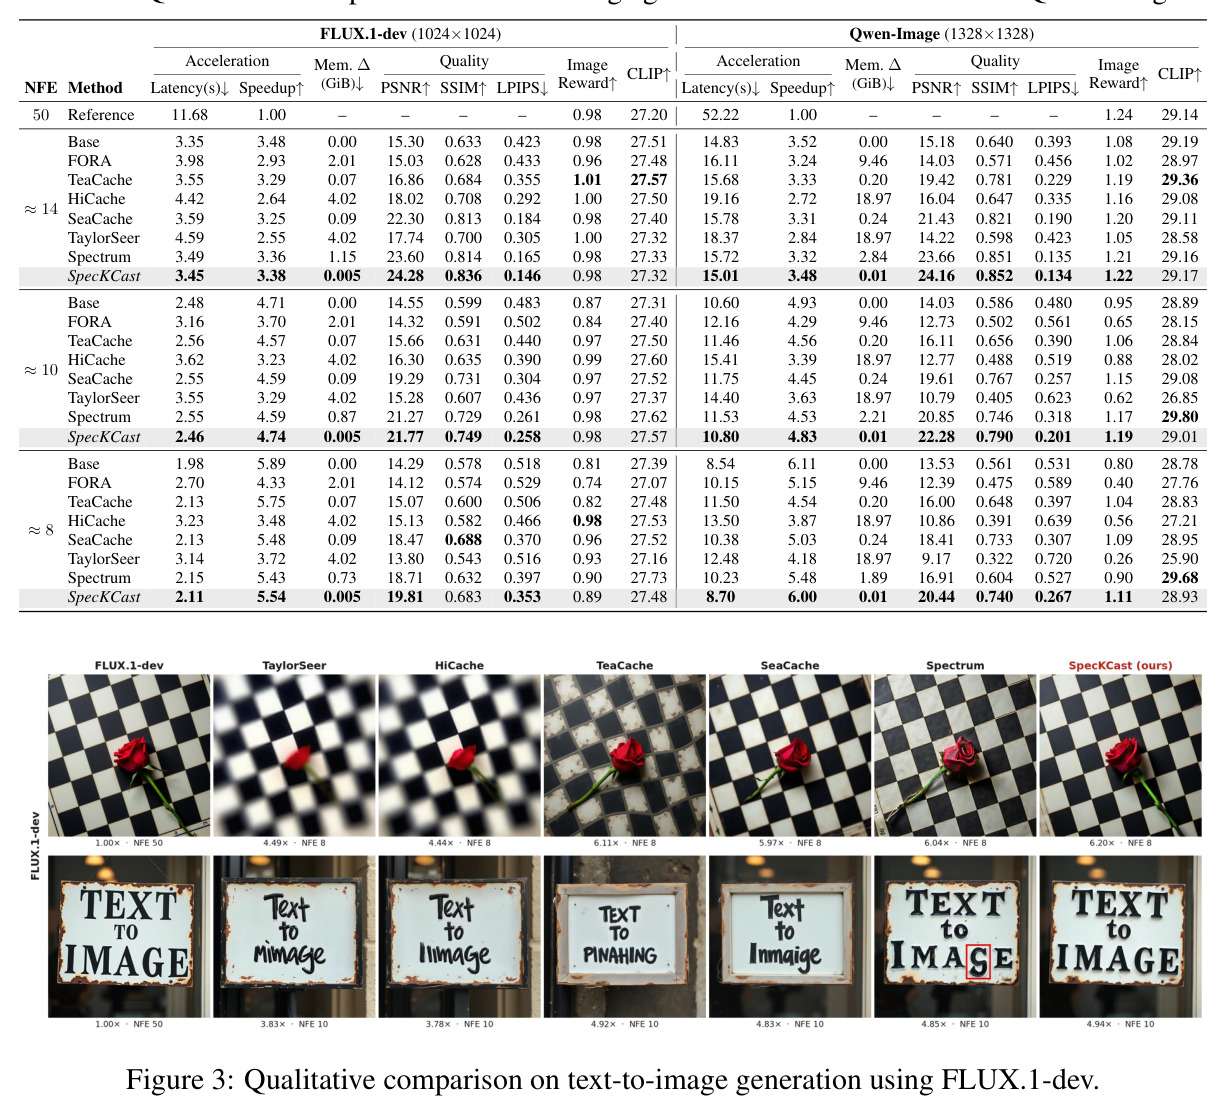
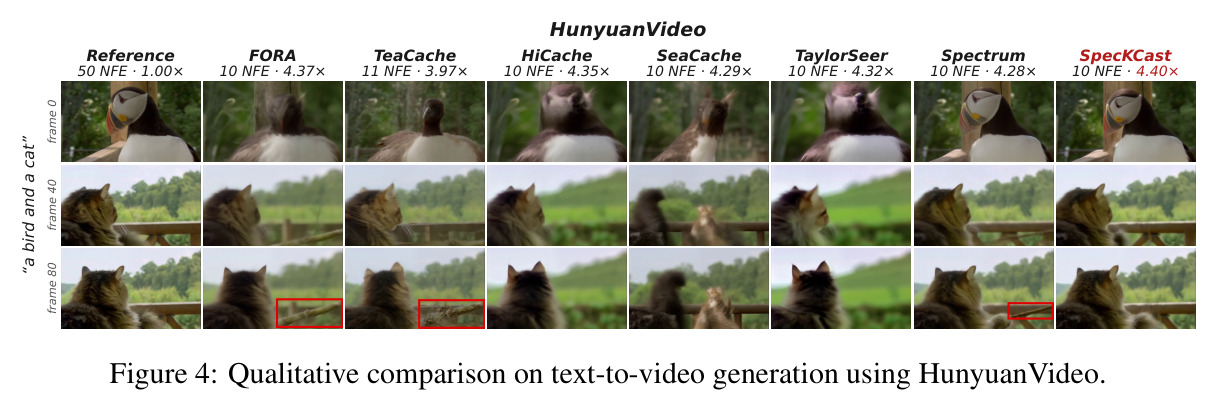
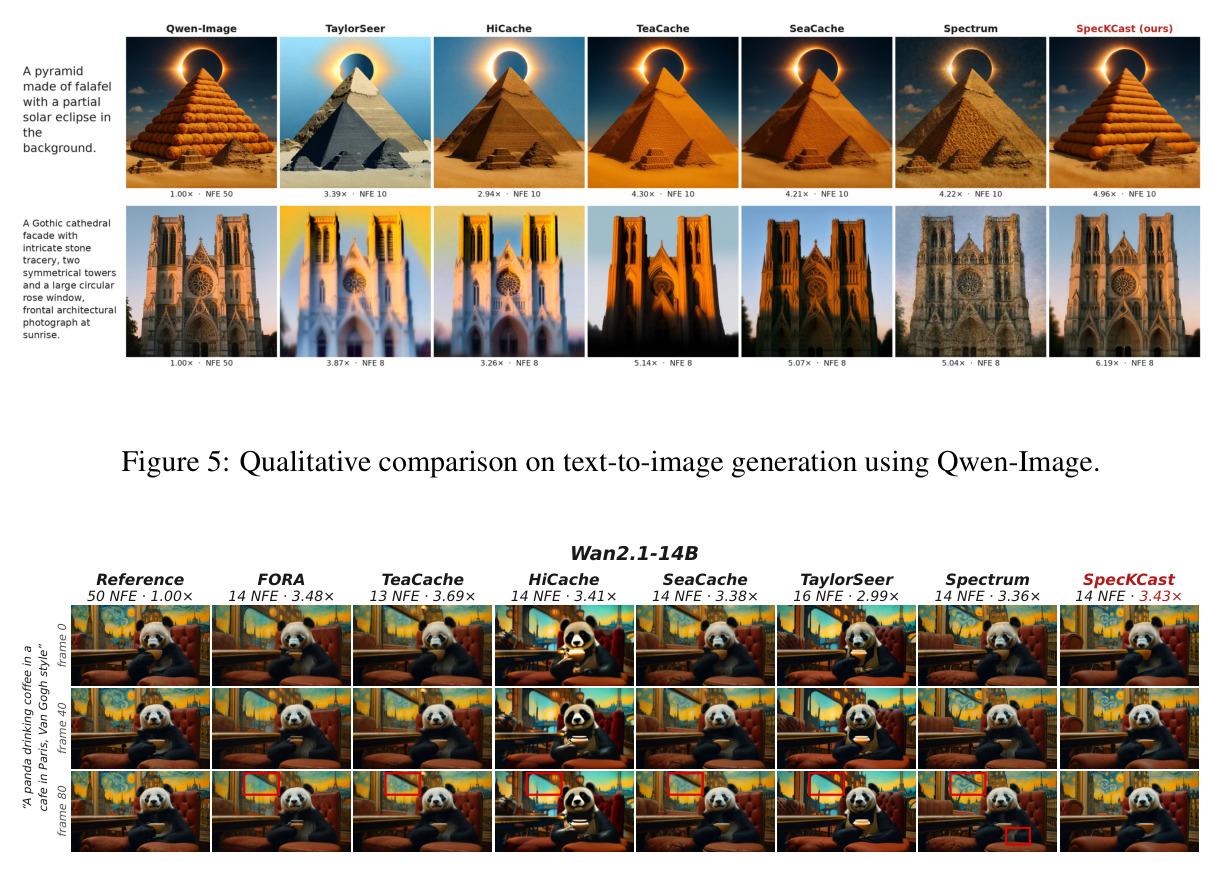
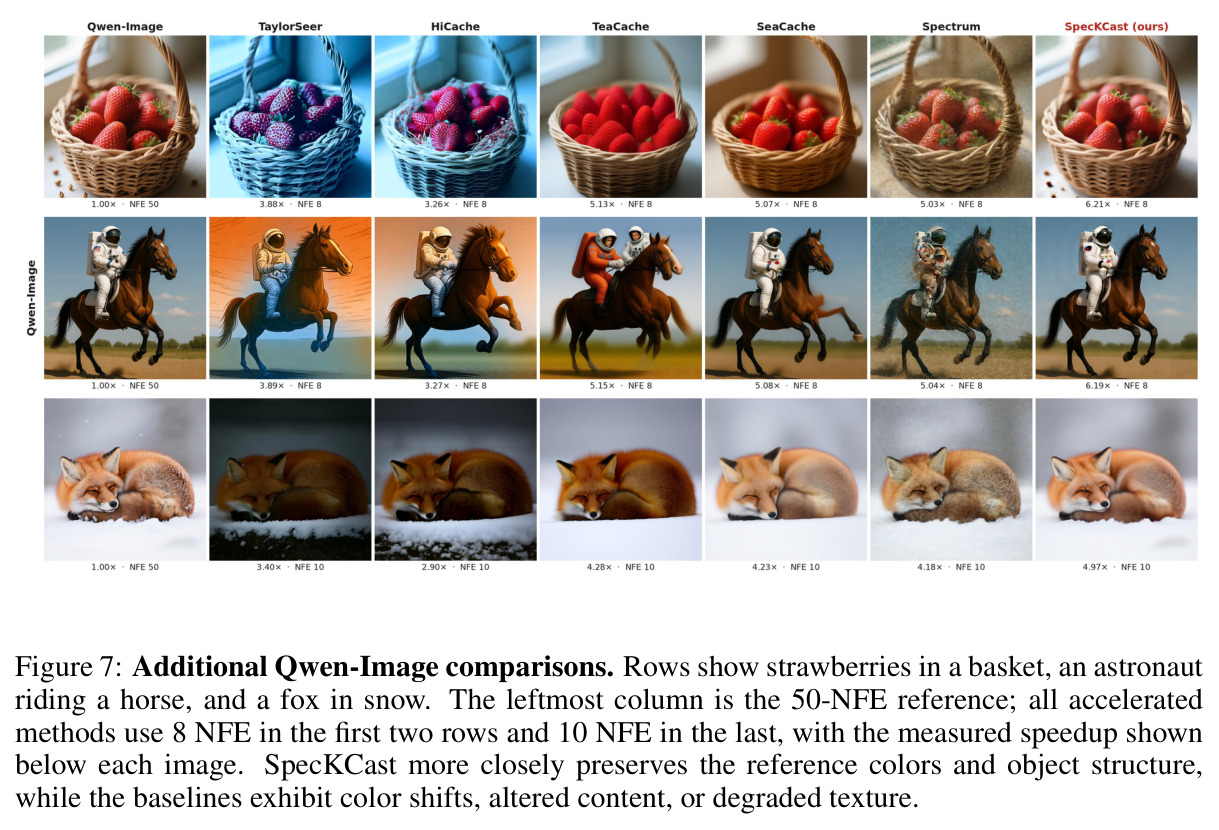
表 1 文生图:FLUX.1-dev 8 NFE 档 5.54×、PSNR 19.81,超 Spectrum 1.1 dB;14 NFE 档 24.28 dB 接近无损。Qwen-Image 差距更大:8 NFE 档 6.00× 下 PSNR 20.44,Spectrum 崩到 16.91 dB/LPIPS 0.527(本文 0.267);各设置 PSNR/LPIPS 均最优,显存增量 0.01 GiB 内(基线达 18.97 GiB)。表 2 文生视频:HunyuanVideo 14 NFE 档 PSNR 29.72,超 SeaCache 2.1 dB 且更快(3.33× vs 2.57×);Wan2.1-14B 各预算 VBench 最优(80.86 对参考 81.11),8 NFE 档基线跌至 12–13 dB 时仍达 19.94 dB。表 3 消融:频带分解 +3.1 dB,弯折时间轴比 log-SNR/步号 +3.3/+4.7 dB,自适应调度 +2.2 dB。定性上(图 3–6),基线常见文字拼错与主体替换,本文最贴近参考。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Qwen-Image 文生图(8 NFE,1328×1328) | PSNR(对同种子 50 步参考) | 20.44 dB,6.00× 加速,LPIPS 0.267 | Spectrum 16.91 dB,5.48× 加速,LPIPS 0.527 | +2.0 dB PSNR,LPIPS 减半,加速比更高 |
| FLUX.1-dev 文生图(8 NFE,1024×1024) | PSNR(对同种子 50 步参考) | 19.81 dB,5.54× 加速 | Spectrum 18.71 dB,5.43× 加速 | +1.1 dB PSNR |
| HunyuanVideo 文生视频(14 NFE) | PSNR(对 50 步参考) | 29.72 dB,3.33× 加速,VBench 79.68 | SeaCache 27.59 dB,2.57× 加速,VBench 79.53 | +2.1 dB PSNR 且延迟从 71.3 秒降到 55.0 秒 |
| Wan2.1-14B 文生视频(14 NFE) | VBench Quality | 80.86(参考 81.11),额外显存 0.05 GiB | Spectrum 80.76,额外显存 13.12 GiB | 质量更高且显存开销减少约 260 倍 |
| FLUX.1-dev 消融(14 NFE) | PSNR | 24.28 dB(完整方法) | 去掉频带分解 21.19 dB;步号时间轴 19.54 dB;固定调度 22.09 dB | 频带分解 +3.1 dB、逐带时间弯折 +4.7 dB、自适应调度 +2.2 dB |
局限与改进
作者在结论中承认 SpecKCast 只利用去噪步之间的时间冗余,每个真正计算的步仍要处理完整 token 网格,空间冗余完全保留,因此加速还有上限之外的空间。方法层面还有几点值得注意:其一,离线标定虽轻量(12 条提示词、每模型一次),但频带功率 $p^\ell$、阈值 $\epsilon$、感知权重 $\gamma_{\ell,w}$ 都依赖校准集,跨模型或跨分辨率需要重标定;作者自己也证明用热身步在线估计 $p^\ell$ 会失真,因为热身阶段输入接近纯噪声、各带功率几乎相同。其二,评测以“复现 50 步参考”的 PSNR/SSIM/LPIPS 为主,而“贴近参考”与“独立生成质量”并不完全等价:高加速档 ImageReward 只从 0.98 降到 0.89(FLUX),VBench 差距也在零点几分量级,PSNR 上的 1–2 dB 优势对只关心画面好看的用户意义有限。其三,连续跳步上限 10、前 3 步与末步必算等保护机制偏经验性,$\epsilon$ 在每个 NFE 预算下都要重新二分搜索。其四,视频场景只在每帧的空间频谱上分解,没有利用时间维度上的频率结构。
独立分析的弱点
独立分析有四个弱点。第一,评测范式的局限:所有定量优势都建立在“同种子复现参考输出”的假设上,若用户只关心独立质量(ImageReward、VBench),SpecKCast 与基线差距缩小到零点几分,标题性的 1–2 dB PSNR 优势对这类场景说服力有限;改进方向是补充人工评估或无参考指标的大规模评测,并区分“保真型”与“质量型”两种应用需求。第二,标定负担与泛化性:$p^\ell$ 用 12 条提示词的末 25 步估计,隐含自然图像能量谱分布稳定的假设,对频谱异常的内容(纯色 logo、医学影像、极端分辨率、非自然风格)可能失准;改进方向是设计采样中段在线估计频带功率的稳健方案,或对 $p^\ell$ 的失配做在线纠偏。第三,风险副车的感知权重 $\gamma_{\ell,w}$ 通过向输出注入带限噪声再测 LPIPS 变化来标定,流程依赖 LPIPS 网络且与最终画质的关系是间接的;改进方向是把调度目标直接对齐下游任务指标,或让权重随提示词类型自适应。第四,与空间加速正交但未融合:每个计算步仍是全 token 网格前向,token 冗余没有利用,实际部署需要与 token 剪枝、稀疏注意力叠加,两者的交互效应(例如频域预测误差是否放大空间稀疏的敏感性)完全未研究。
未来方向
作者明确提出把时间冗余与空间冗余联合利用是下一个方向,例如与 token 剪枝或稀疏注意力叠加,或与作者前作 SeGA 的分辨率外推结合。顺着本文成果还有几条自然延伸:第一,把 Kalman 框架升到时空 DCT,对视频统一建模帧内空间频率与帧间时间频率的演化差异,弥补只在每帧空间频谱处理的缺口;第二,目前的转移模型是带阻尼的一阶动力学(值+导数),可以为每个频带学习或校准更高阶的动力学核,进一步压低 8 NFE 以下极高档位的误差(FLUX 8 NFE 时 PSNR 已不足 20 dB);第三,把不确定性调度推广为预算分配问题——附录 E 已指出 CFG 无条件分支的误差被 $w-1$ 放大,给两个分支分配不同计算预算的非对称变体值得实验;第四,标定自动化:用少量无标注数据自动搜索 $(p^\ell, \epsilon, \gamma_{\ell,w})$ 或跨模型共享标定,做成真正的 plug-and-play 组件;第五,检验“频带异时演化”假设在一致性模型蒸馏、轨迹式编辑等其他迭代推理场景中的普适性。
复现评估
复现友好度较高。方法完全免训练,核心是 DCT、Kalman 递归和阈值调度,计算开销可忽略(FLUX.1 额外显存约 5 MiB,各变体延迟差在 0.1 秒内);实验基于公开模型与基线官方实现,硬件为单张 NVIDIA H100,评测协议清晰(DrawBench、VBench、同种子参考比 PSNR/SSIM/LPIPS)。附录 B–E 给出关键细节:频带边界 $[0,1/64,1/32,1/16,1/8,1/4,1/2,1]$,超参 $\tau=0.1$、$T_w=2.0$、$\beta=0.6$、$L=7$,标定集 12 提示词×末 25 步,副车记忆因子 $\rho_{sc}=0.9$、跳步上限 10、前 3 步与末步必算,以及 CFG 放置与 Qwen 范数重缩放公式。需小心的坑:噪声调度要在采样前按管线实际 shift 重建、$\sigma$ 端点需 clamp 避免 log 无穷、$\epsilon$ 按目标 NFE 二分搜索。论文未给出开源仓库链接,若不开源,从附录细节复现约需一至两周;验证小模型一张 24GB 显卡即可,完整复现视频实验需 H100 级硬件。
论文图表
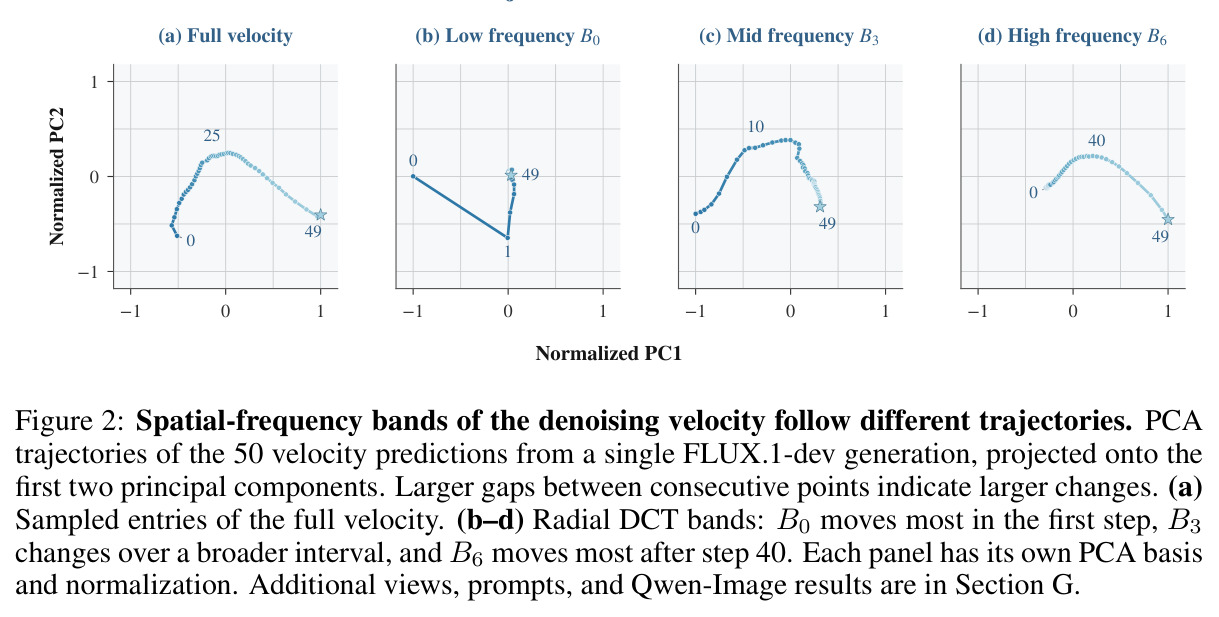
对 FLUX.1-dev 单次生成的 50 个速度预测做 PCA 并投影到前两个主成分,分别展示完整速度、低频带 B0、中频带 B3、高频带 B6 的轨迹:B0 在第 1 步大幅移动后即稳定,B3 在更宽的区间内演化,B6 在第 40 步之后才最活跃;点间距越大代表变化越大。
这是全文动机的实证基石:直接证明各空间频带在不同去噪阶段轮流活跃,从而论证“为什么必须频域解耦、为什么每带需要自己的时间轴”。
两个文生图模型在 ≈14/≈10/≈8 NFE 三档预算下的完整定量结果:延迟、加速比、显存增量、PSNR/SSIM/LPIPS(对同种子参考)与 ImageReward/CLIP 分数,覆盖 Base、FORA、TeaCache、HiCache、SeaCache、TaylorSeer、Spectrum 和 SpecKCast。SpecKCast 在几乎所有设置下速度最快、保真度最高、显存开销最小(0.005–0.01 GiB)。
论文的核心证据表:所有关于“加速-保真权衡优于现有方法”的结论都来自这张表,也是与后续工作比较的基准。