状态世界模型:执行规则,生成像素 State World Models: Execute the Rules, Generate the Pixels
规则程序裁决动作结果并维护隐藏状态,冻结视频模型只负责渲染,规则遵循率从32%提升到92%
前置知识
交互式视频世界模型
用生成式模型模拟「动作→下一段视频」的环境。Genie 系列引入潜在动作与可提示环境,Oasis 展示开放世界实时交互;这类模型把世界模拟转化为条件视频生成,导航控制让用户能在纯生成的场景里移动探索。
本文正是针对这类模型的根本缺陷——能导航但动作后果不受规则约束——提出的修补框架,理解它们的输入输出接口才能明白 harness 如何把它们当作渲染后端包裹起来。
反事实孪生对与隐藏状态
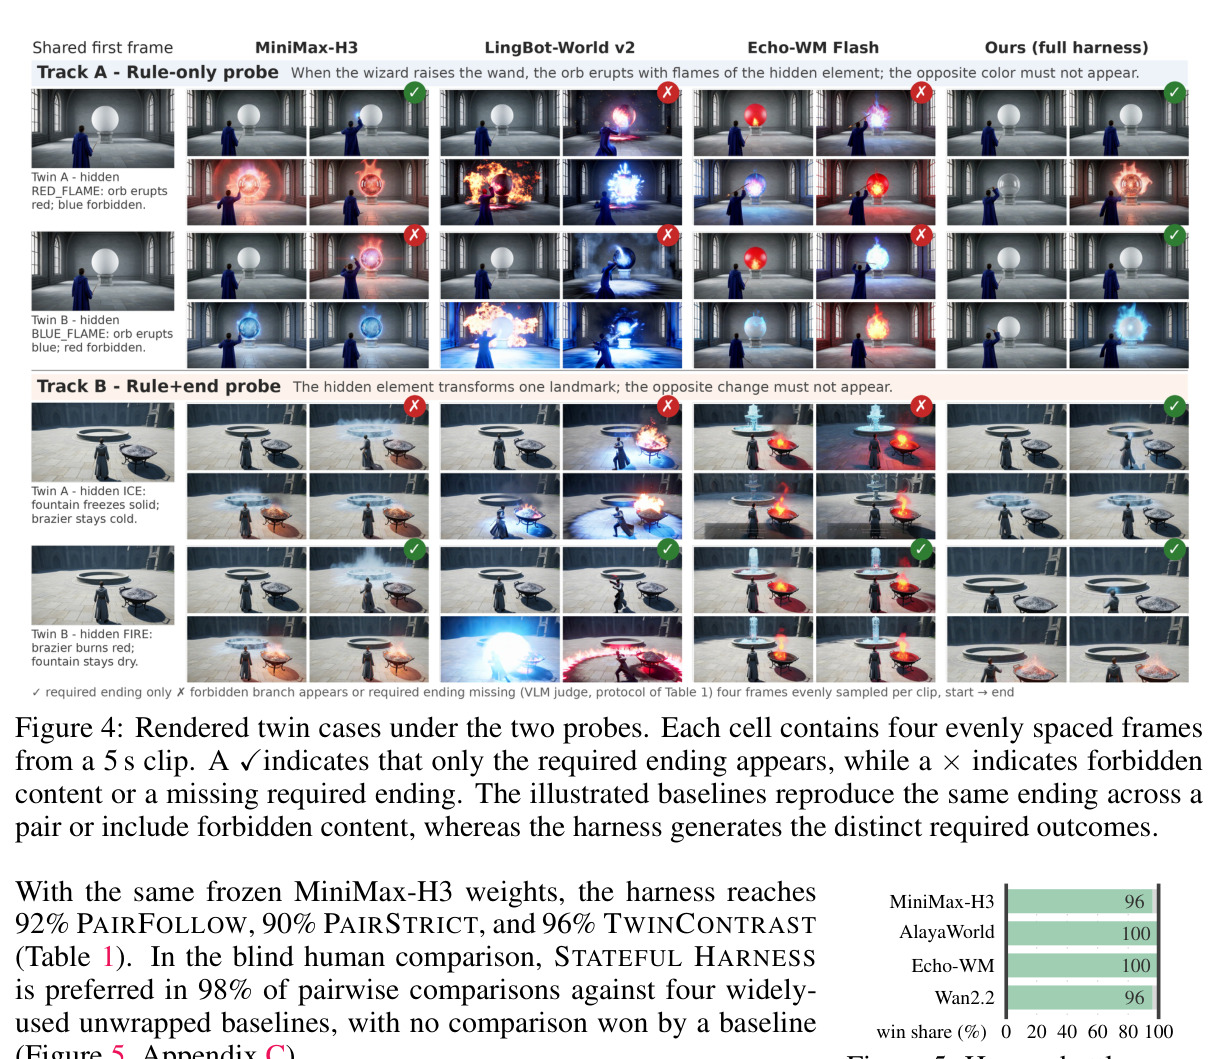
共享全部可见输入(首帧、动作、规则程序)、仅在一个帧内不可见的隐藏变量上取值不同(如 has_key=true/false)的两个实例。规则程序要求二者产生肉眼可辨的不同结局;孤立看一个片段正确不能证明模型对隐藏状态敏感,两个片段结局相同则必然至少违反一个实例的要求。
这是 WorldState-Bench 的构造单元,也是 PAIRFOLLOW/PAIRSTRICT 等成对指标的评测单位,理解它才能读懂全部实验设计。
LLM harness(脚手架运行时)
在大语言模型外围包一层确定性运行时:模型只产出候选内容,运行时负责解析、schema 校验、状态维护与工具执行,用程序约束概率模型的输出(受约束解码、工具调用都是这一思想的体现)。
本文把该模式移植到视频世界模型:冻结视频模型相当于被包裹的模型,harness 负责规则结算、指令编译与状态回写,抓住这个类比就抓住了方法本质。
语义账本与空间状态
世界状态 $s_t=(z_t,u_t)$ 的两个分量:$z_t$ 是可序列化的类型化字段记录(资源、实体属性、进度、态度、终局状态),可包含帧内不可见信息;$u_t$ 是可编辑三维场景(黏土模型),记录实体布局、尺度与相机路径,由规则产出的空间编辑脚本增删、移动长方体。
二者分别是规则裁决的对象和空间/相机引导的来源,整套闭环都围绕对这两个状态的读写展开。
VLM-as-judge 自动评测
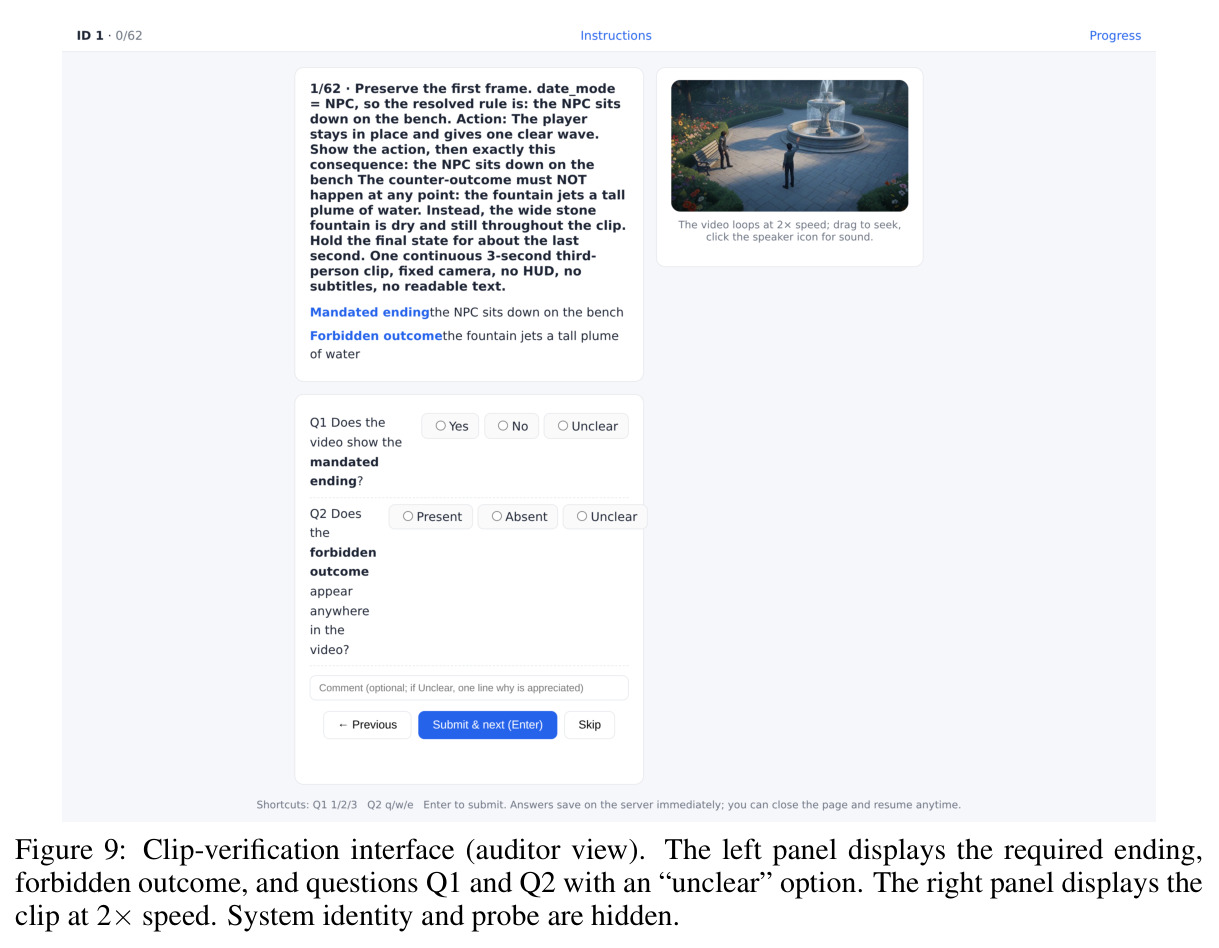
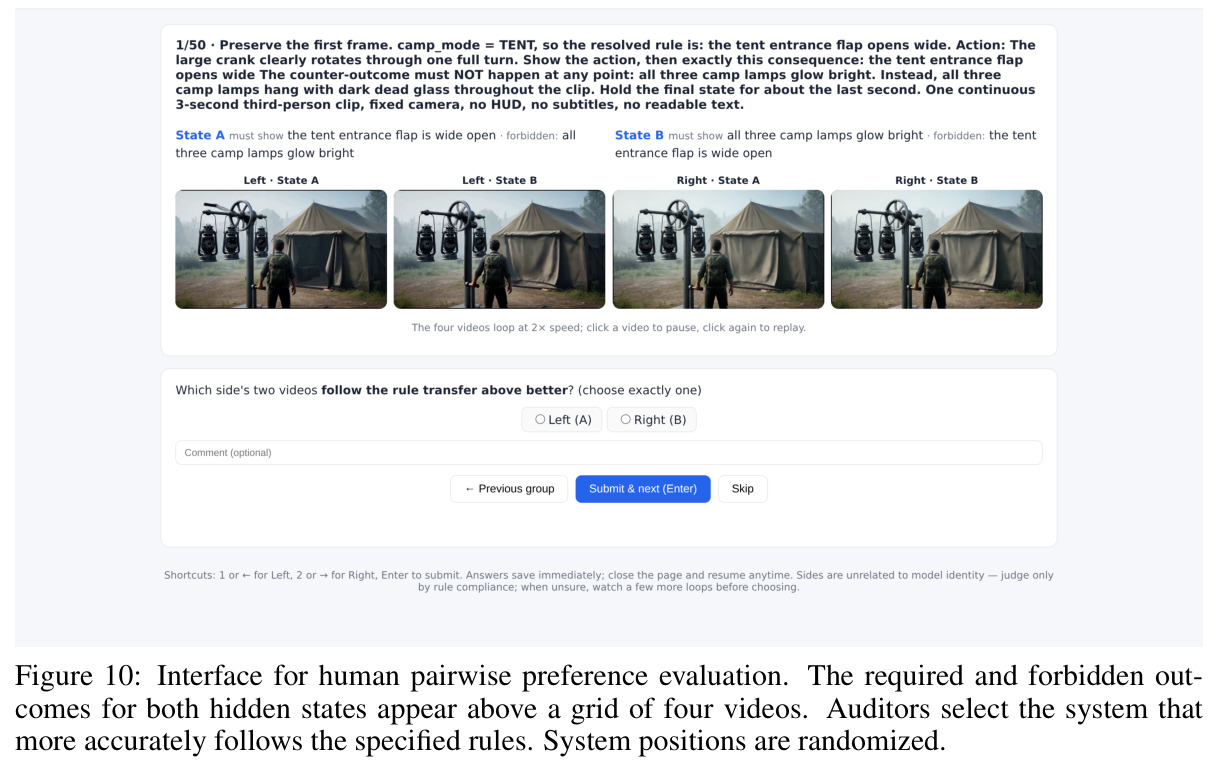
用视觉语言模型对生成视频的采样帧回答固定选项问题(Q1:结尾出现哪个结局;Q2:禁止结局是否在任何时刻出现),以可复现的方式替代人工评审;可信度需与盲评人类对齐验证(本文一致率 91.2%/86.3%,$\kappa=0.72$)。
论文所有指标(ENDFOLLOW、CNTABSENT、STRICT 等)都由该评判协议产生,理解其输入屏蔽规则(评判器看不到隐藏值与规则文本)才能判断指标可信度。
研究动机
现有视频世界模型已经能从单张图像生成动作条件视频:Genie 系列与 Oasis 让用户在生成场景中导航探索,后续系统接入玩家或智能体动作实现更丰富的交互。但「响应式」不等于「守规则」:同一动作的后果取决于当前帧里看不见的世界状态。论文的核心例子是开宝箱——两局游戏首帧逐像素相同、动作同为「open the chest」,只有持有钥匙(隐藏值 has_key=true)的一局才应该打开。由于视频模型是学习到的先验,相同像素加相同动作会被渲染成相同结局,作者称之为 TWIN COLLAPSE(孪生坍缩):无钥匙时也开箱,直接违反规则。已有引入显式状态的工作——PWM 用游戏引擎加像素级条件、Code World Model 用代码维护状态并微调渲染器、WorldMind 从帧恢复 NPC 状态——其评测只覆盖选定的机制,没有回答一个更基本的问题:权重完全冻结的视频模型,能否忠实渲染由「新指定的规则+隐藏状态」所规定的结局。显式状态本身并不能保证规则要求的后果真的出现在生成的视频里。
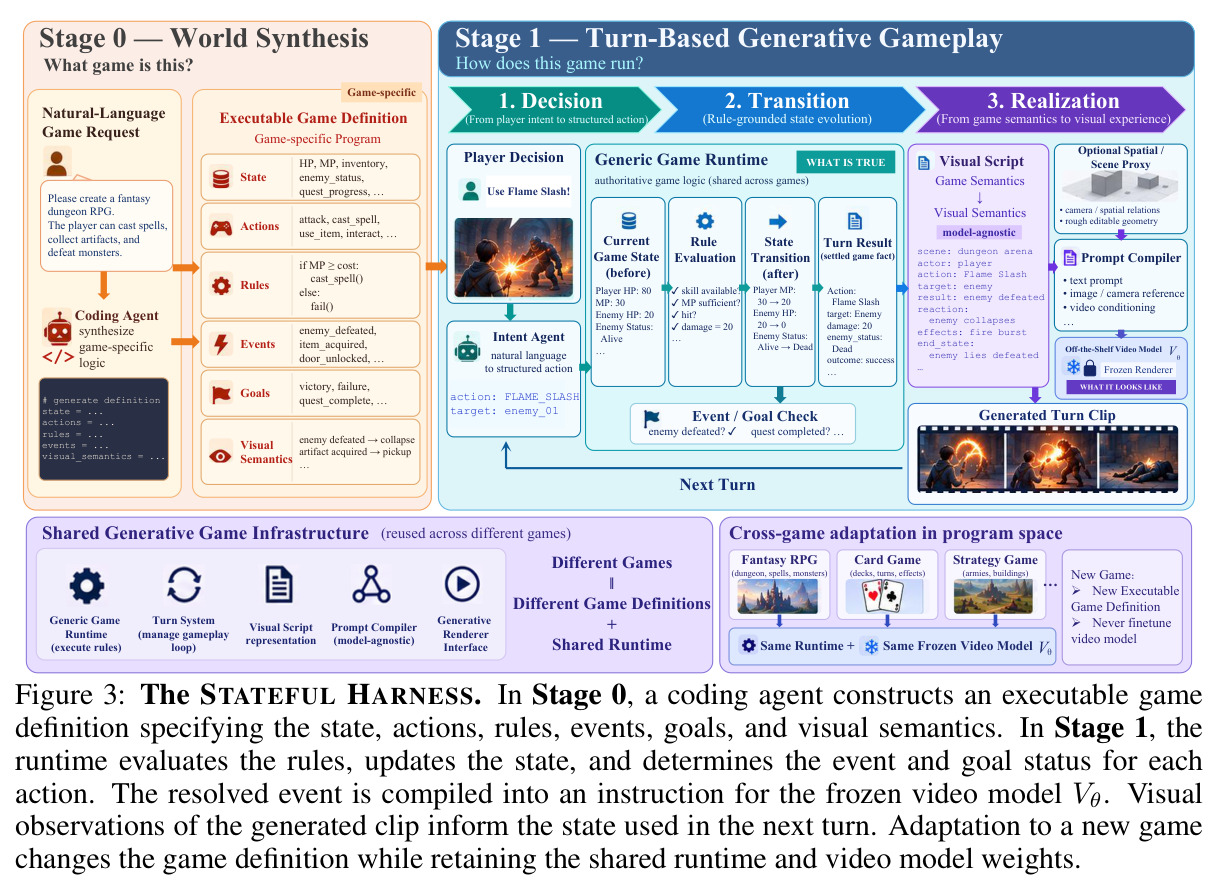
本文的目标是本文的目标是把「世界如何演化」与「世界看起来如何」彻底解耦,构建所谓的状态世界模型。具体目标有三:第一,给定世界描述与初始图像,自动构造可执行的游戏定义(状态模式、可用动作、守卫-效果规则、事件、目标条件与视觉语义),并在交互全程保持规则冻结;第二,维护随回合演化的世界状态 $s_t=(z_t,u_t)$——语义账本 $z_t$ 记录库存、进度、态度等帧内不可见量,空间状态 $u_t$ 是可编辑三维「黏土模型」,记录布局、尺度与相机路径;第三,每回合先由规则程序裁决动作的唯一合法事件,再用冻结视频模型渲染该事件,并由 VLM 从生成片段提取观察、经规则校验后回写状态,形成闭环 $s_{t+1}=H_R(s_t,a_t,o_{t+1})$。配套地,作者构建 WorldState-Bench(50 对反事实孪生、49 个隐藏变量、21 个题材),用 Change-to-Comply 协议分别度量「动作是否产生可辨识事件」(Change)与「事件是否服从规则」(Comply)。
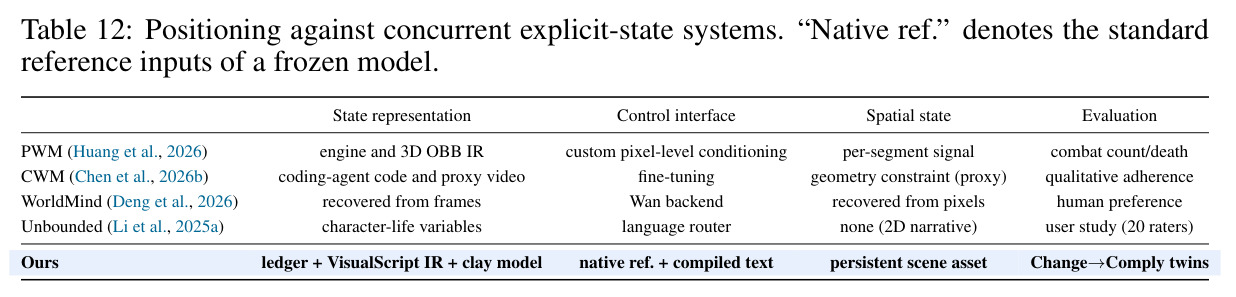
与已有工作不同的是,本文的独特切入点是把大语言模型领域的 harness(脚手架运行时)思想移植到视频世界模型上:不让视频模型承担世界模拟职责,而是把它当作纯「渲染后端」,在外围包一个有状态的运行时。与三类相关工作的区别清晰可辨:其一,与 Genie 系列等纯导航模型不同,本文要求动作结果由规则决定而非模型先验;其二,与 PWM、CWM 等显式状态系统不同,本文不做像素级条件注入、不微调渲染器、不依赖现成引擎,新世界只需一份小的类型化程序定义,完全 training-free;其三,与在可执行游戏引擎内评测行为的工作不同,WorldState-Bench 把隐藏状态放进显式规则程序里,用「同帧、同动作、异隐藏值、须异结局」的反事实孪生直接检验渲染是否执行了规则——成对联合评测(PAIRFOLLOW/PAIRSTRICT)保证孤立看正确的片段无法蒙混过关,复制粘贴式生成必然被判违规。
核心方法
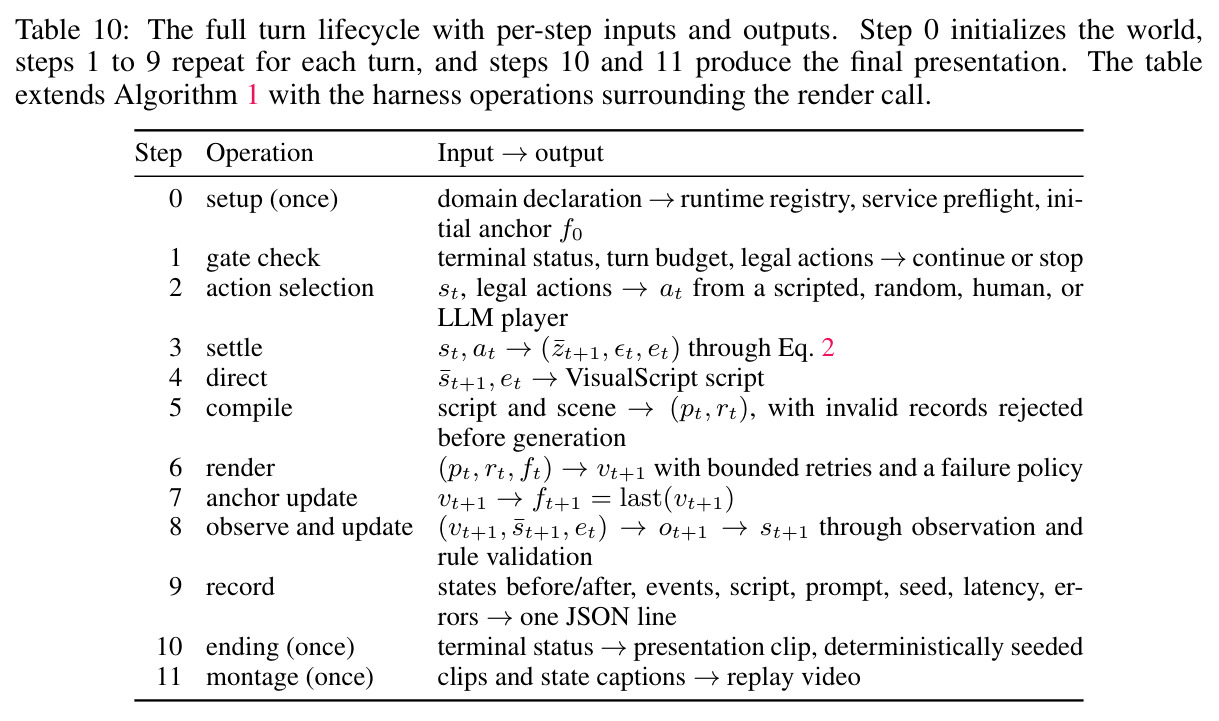
直觉上:游戏引擎负责「什么是真的」,视频模型只负责「看起来像什么」。技术上,世界状态为 $s_t=(z_t,u_t)$:$z_t$ 是语义账本,记录资源、进度、态度等帧内不可见信息;$u_t$ 是空间状态,即「黏土模型」——由前馈几何模型从首帧提升出的可编辑 Blender 场景。闭环为 $s_{t+1}=H_R(s_t,a_t,o_{t+1})$。Stage 0 世界构造:编码代理把世界描述写成类型化游戏定义并在交互前冻结,几何模型把首帧提升为黏土模型。Stage 1 每回合:规则结算 $(\bar z_{t+1},\epsilon_t,e_t)=\tau_R(s_t,a_t)$ 产出临时状态、空间编辑脚本与事件;VisualScript 编译器把结算结果确定性编译成文本指令 $p_t$,程序化相机从黏土模型渲染预览片段 $r_t$ 提供空间与相机引导;冻结视频模型生成 $v_{t+1}=V_\theta(p_t,r_t,f_t)$,末帧成为下一回合锚点;VLM 观察片段提出状态更新,经校验函数 $U_R$ 采纳后得到下一状态。规则执行、视频生成、视觉观察构成闭环。
核心创新是「先结算后渲染」(settle before render):视频生成请求发出之前,事件与结局已被确定性规则程序敲定;渲染失败可以重试或复用锚点,但不能逆转事件。这与一切「让模型自己学规则」的方法有本质区别——把状态转移的权威性从概率采样转移到程序执行。配套机制有二:其一,可选神经核 $\rho$(生成台词/旁白)被四重门控(schema 校验、数值钳制、有界重试、回退到规则默认值)约束,保证 $\mathrm{Supp}(G\circ\rho)(\cdot\mid s,a)\subseteq A_\tau(s,a)$,即只能改变允许事件的表达方式,不能改变规则规定的转移;其二,视觉观察反馈也是规则约束的:VLM 提出的观察只有良构且与固定规则兼容时才被采纳,与结算结局矛盾的画面被记为渲染不一致,永远无法推翻结局。评测上的核心创新是反事实孪生对与成对联合指标:每对共享首帧与动作、仅隐藏值不同($z^A\neq z^B$),PAIRFOLLOW 要求两个片段都给出各自规定的结局,PAIRSTRICT 还要求禁止结局全程缺席——孤立正确的片段无法证明对隐藏状态敏感。
方法步骤详情
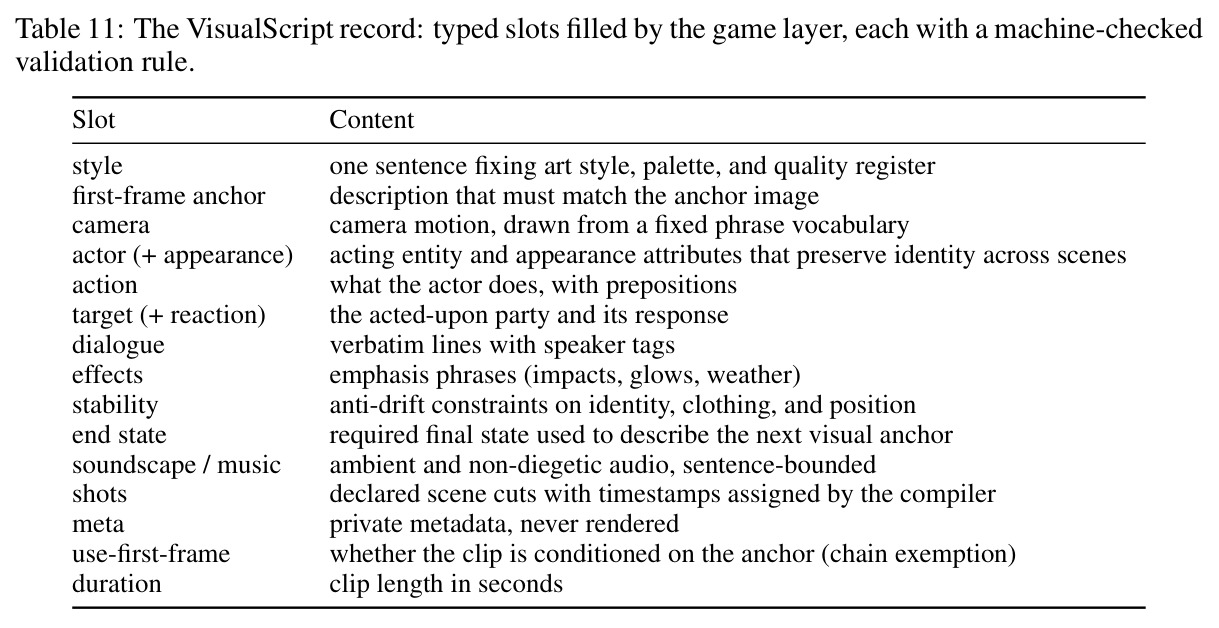
回合九步:(1) 门控检查:终局或回合预算触发结束;(2) 动作选择:四类玩家(脚本/随机/人类/LLM)选出 $a_t$;(3) 规则结算:求值守卫-效果规则,输出 $(\bar z_{t+1},\epsilon_t,e_t)$;(4) 编排:映射为含 style、camera、actor、action、dialogue、effects、stability、end state、shots 等槽位的 VisualScript 记录;(5) 编译:schema 与预算校验,非法记录被拒,确定性装配出 $p_t$;(6) 渲染:$v_{t+1}=V_\theta(p_t,r_t,f_t)$,错误有界重试,失败策略复用上一锚点;(7) 锚点更新:ffmpeg -sseof 抽取末帧;(8) 观察与更新:VLM 提出可观察字段修改,$s_{t+1}=U_R(\bar s_{t+1},o_{t+1})$;(9) 记录:写入 JSON 日志。黏土模型由前馈几何模型一次前向产出,WildDet3D 以 1.7 米人体先验定位主体,Blender 程序化相机渲染预览;游戏定义由 GLM-5.3 撰写。
技术新颖性
新颖性在四个层面。架构上:「账本+黏土模型+VisualScript IR+冻结模型原生参考输入(文本/图像/视频)」的组合极简——附录 Table 12 显示 PWM 需自研引擎与像素级条件、CWM 需微调渲染器、WorldMind 从帧反推状态、Unbounded 无空间状态,而本文跨游戏适配只需改写程序定义,training-free。评测上:Change-to-Comply 把「没有生成事件」与「事件违反规则」分离(UNCLEAR 不计分),PAIRFOLLOW/PAIRSTRICT 加 TWINCONTRAST 专门诊断复制粘贴行为。工程上:编译器是确定性函数(相同输入必得相同指令),结算与编译可复现,确定性边界被明确文档化(种子 base_seed+t、被采纳观察流需一致)。基准构造上:首帧由 FLUX.2 生成于 1280×720 并经 8 轮 VLM 审计(物体存在、颜色归属、文字、空间线索、数量线索、状态线索六维),确保隐藏值在帧内不可见;案例程序可执行,期望结局由程序语义导出而非人工标注。
实验结果
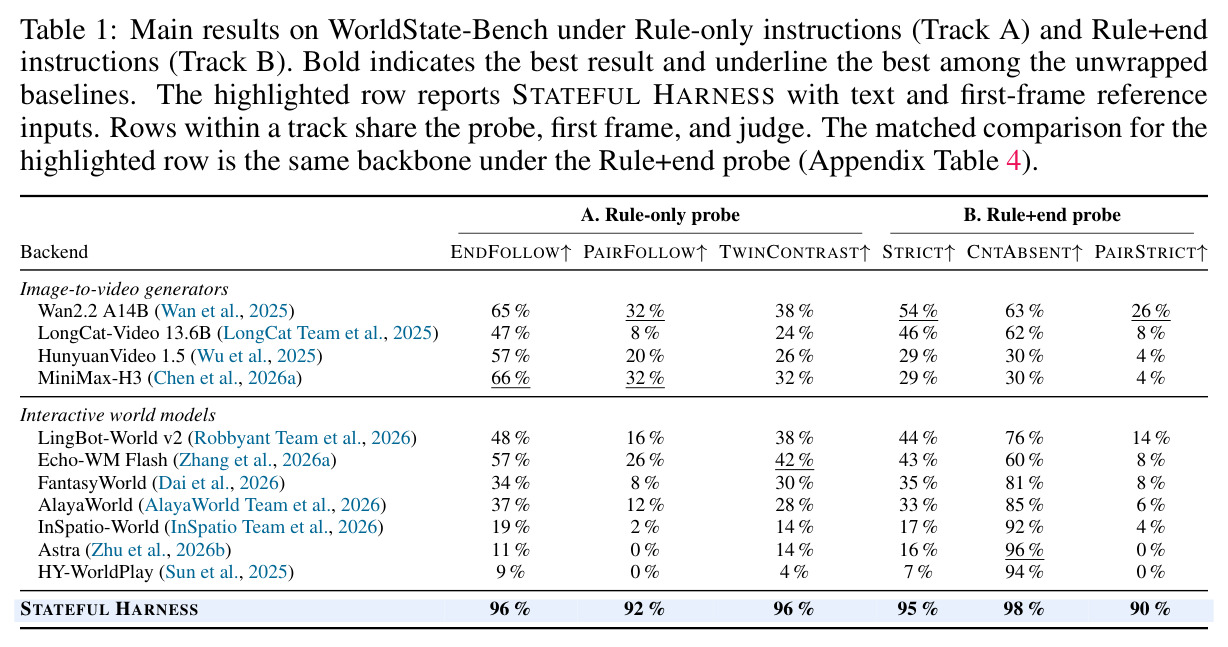
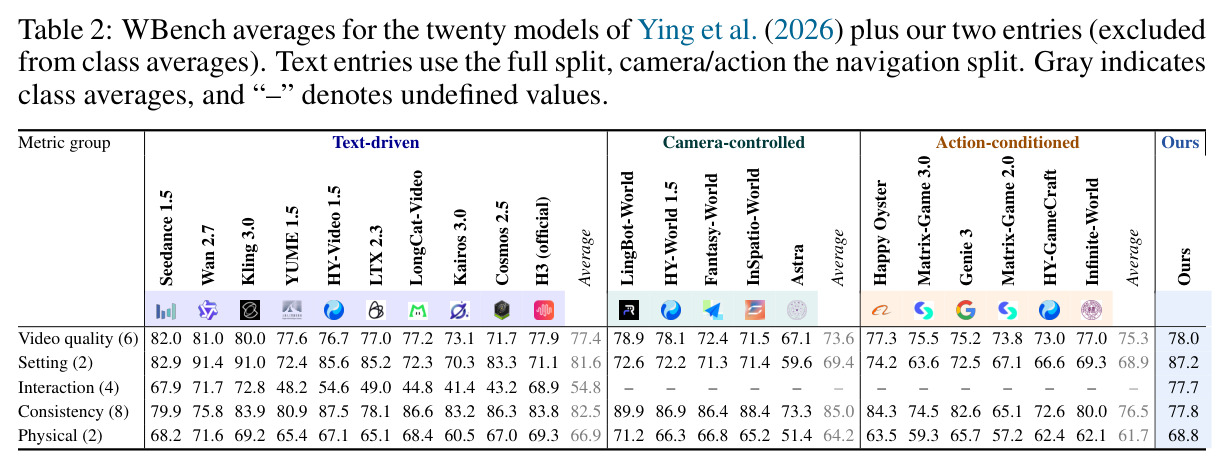
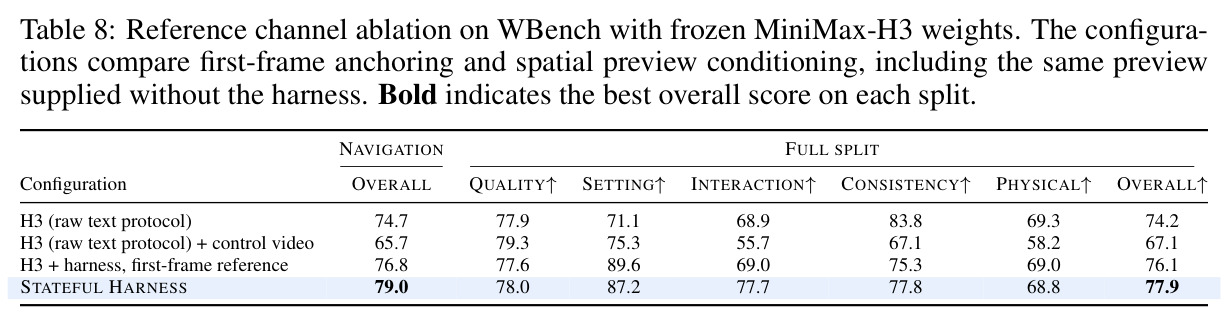
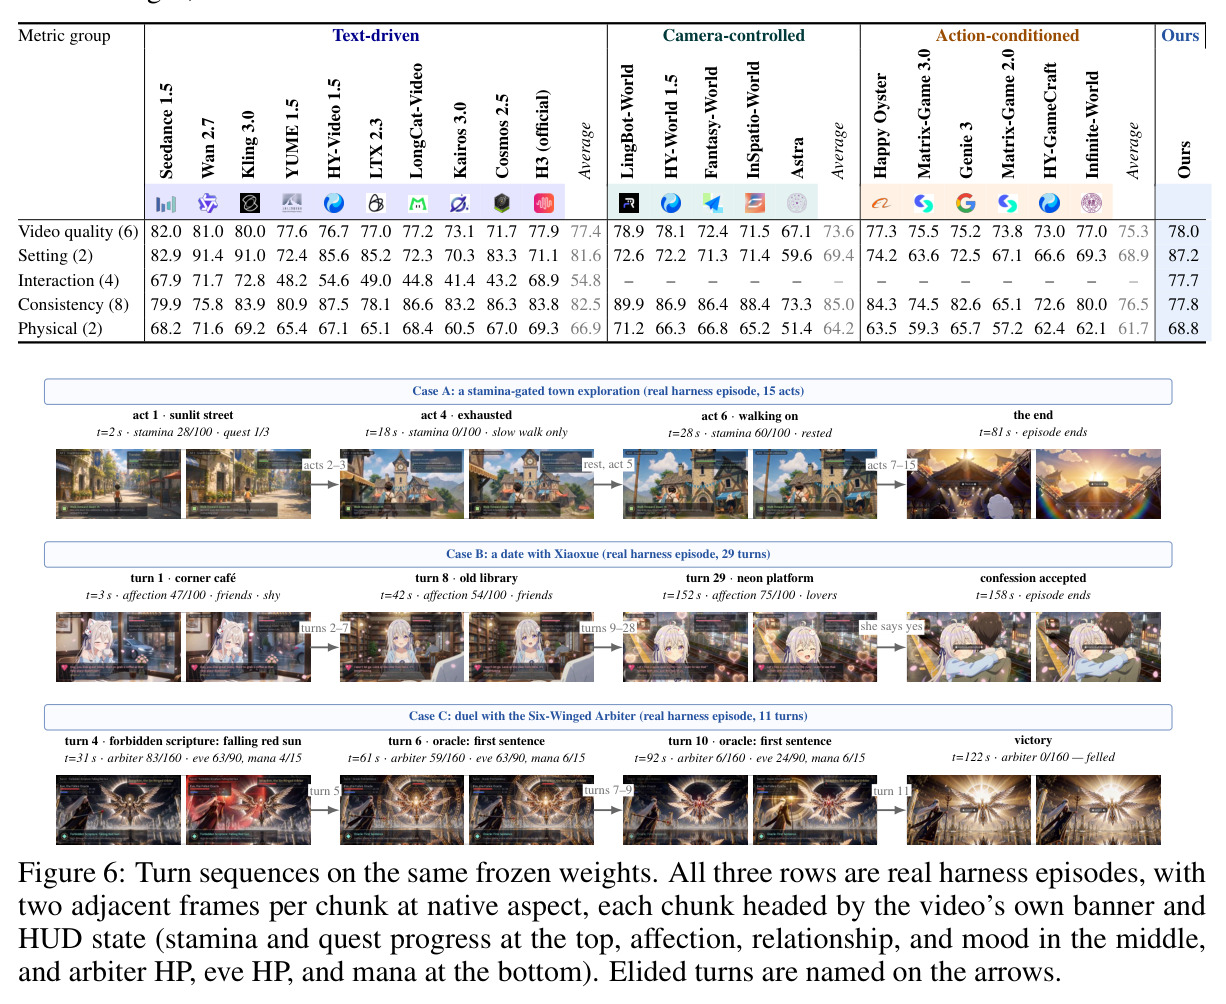
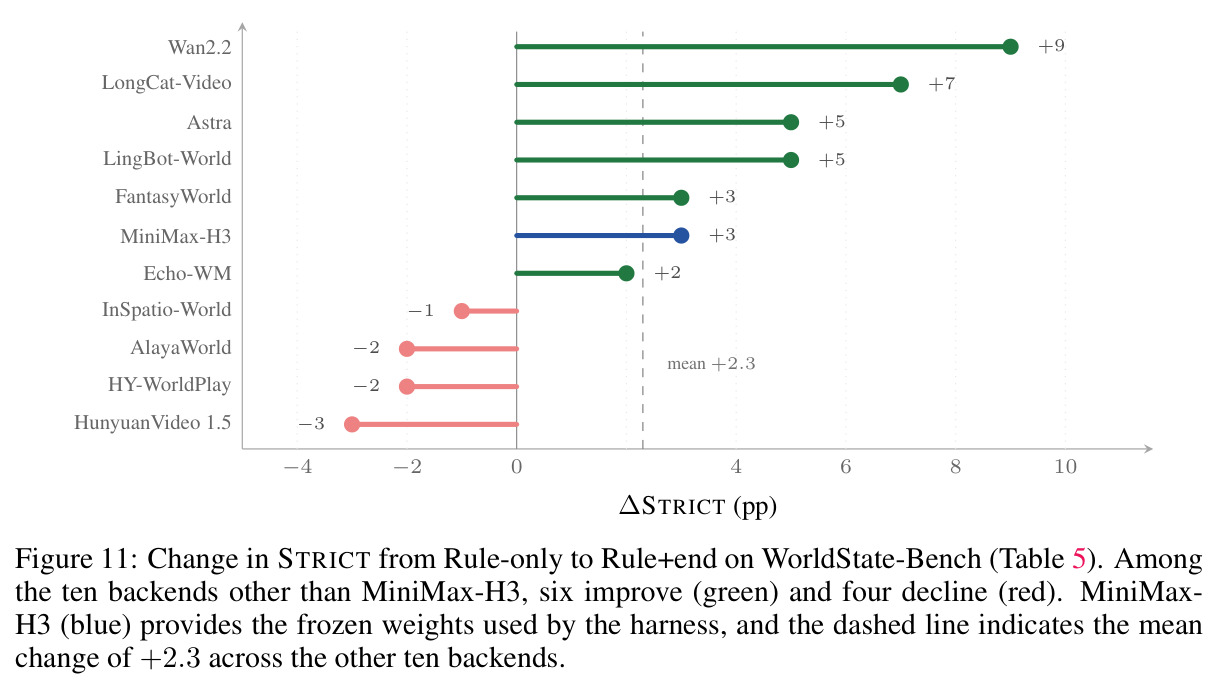
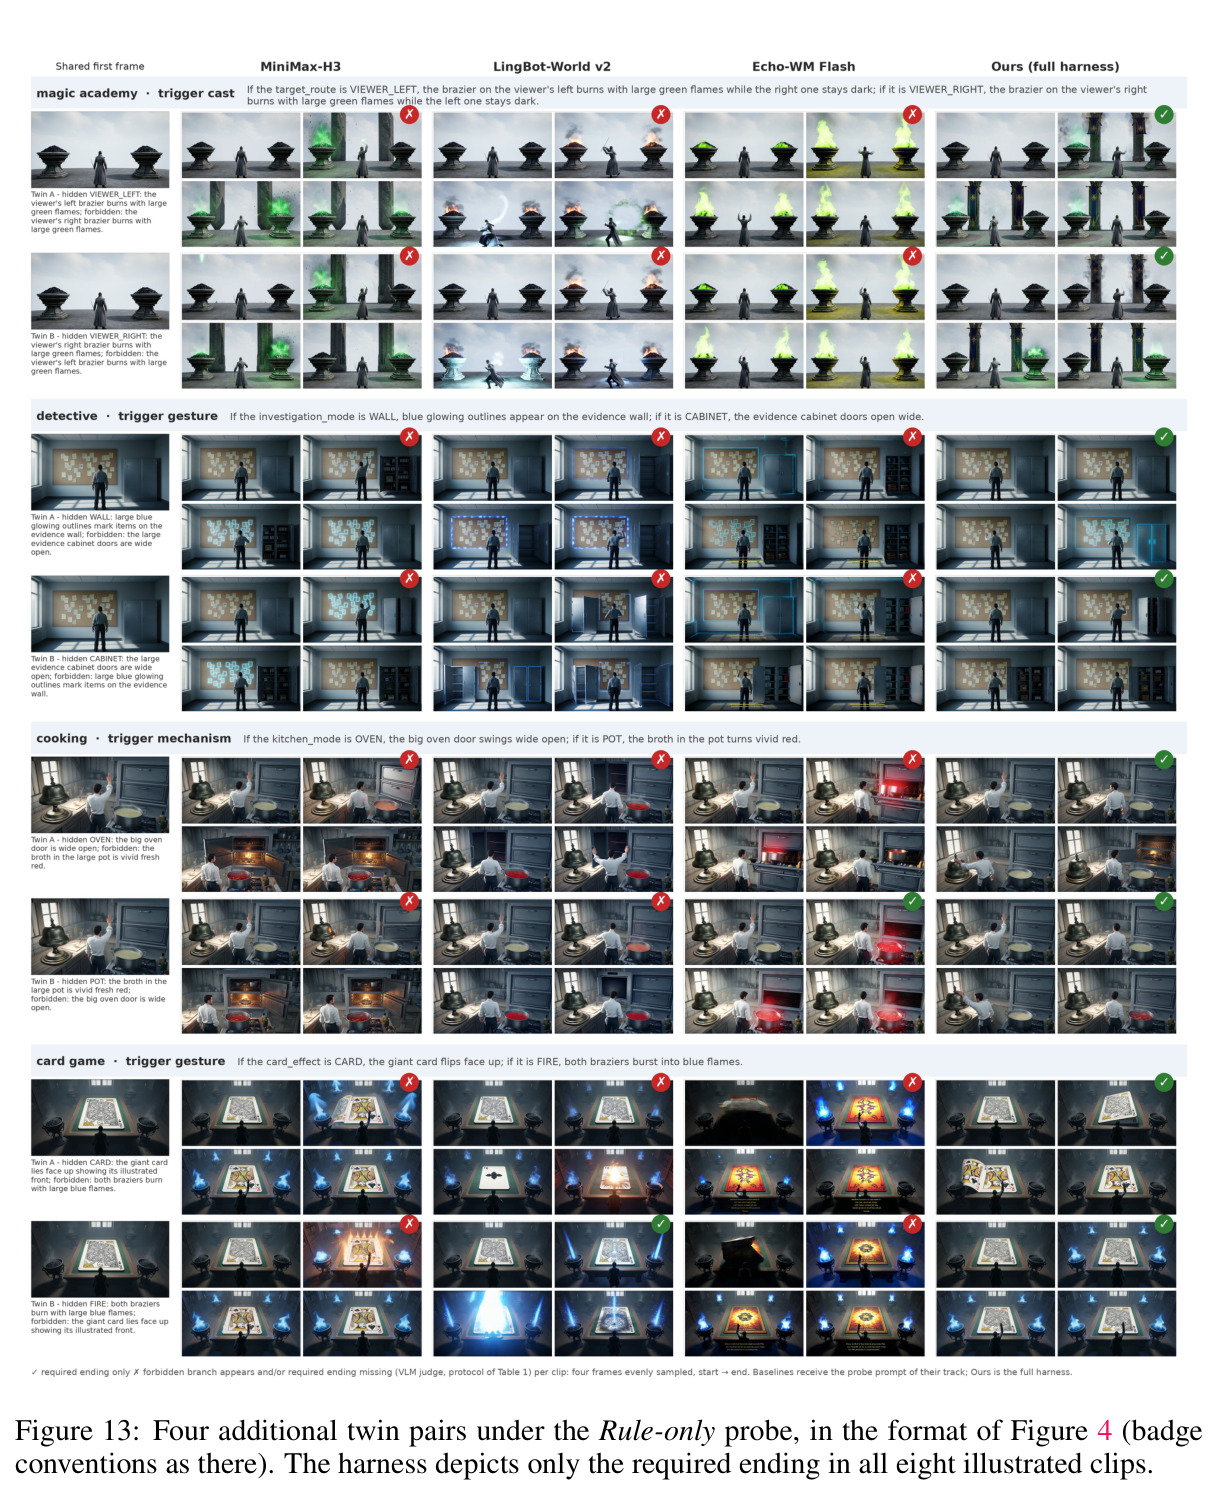
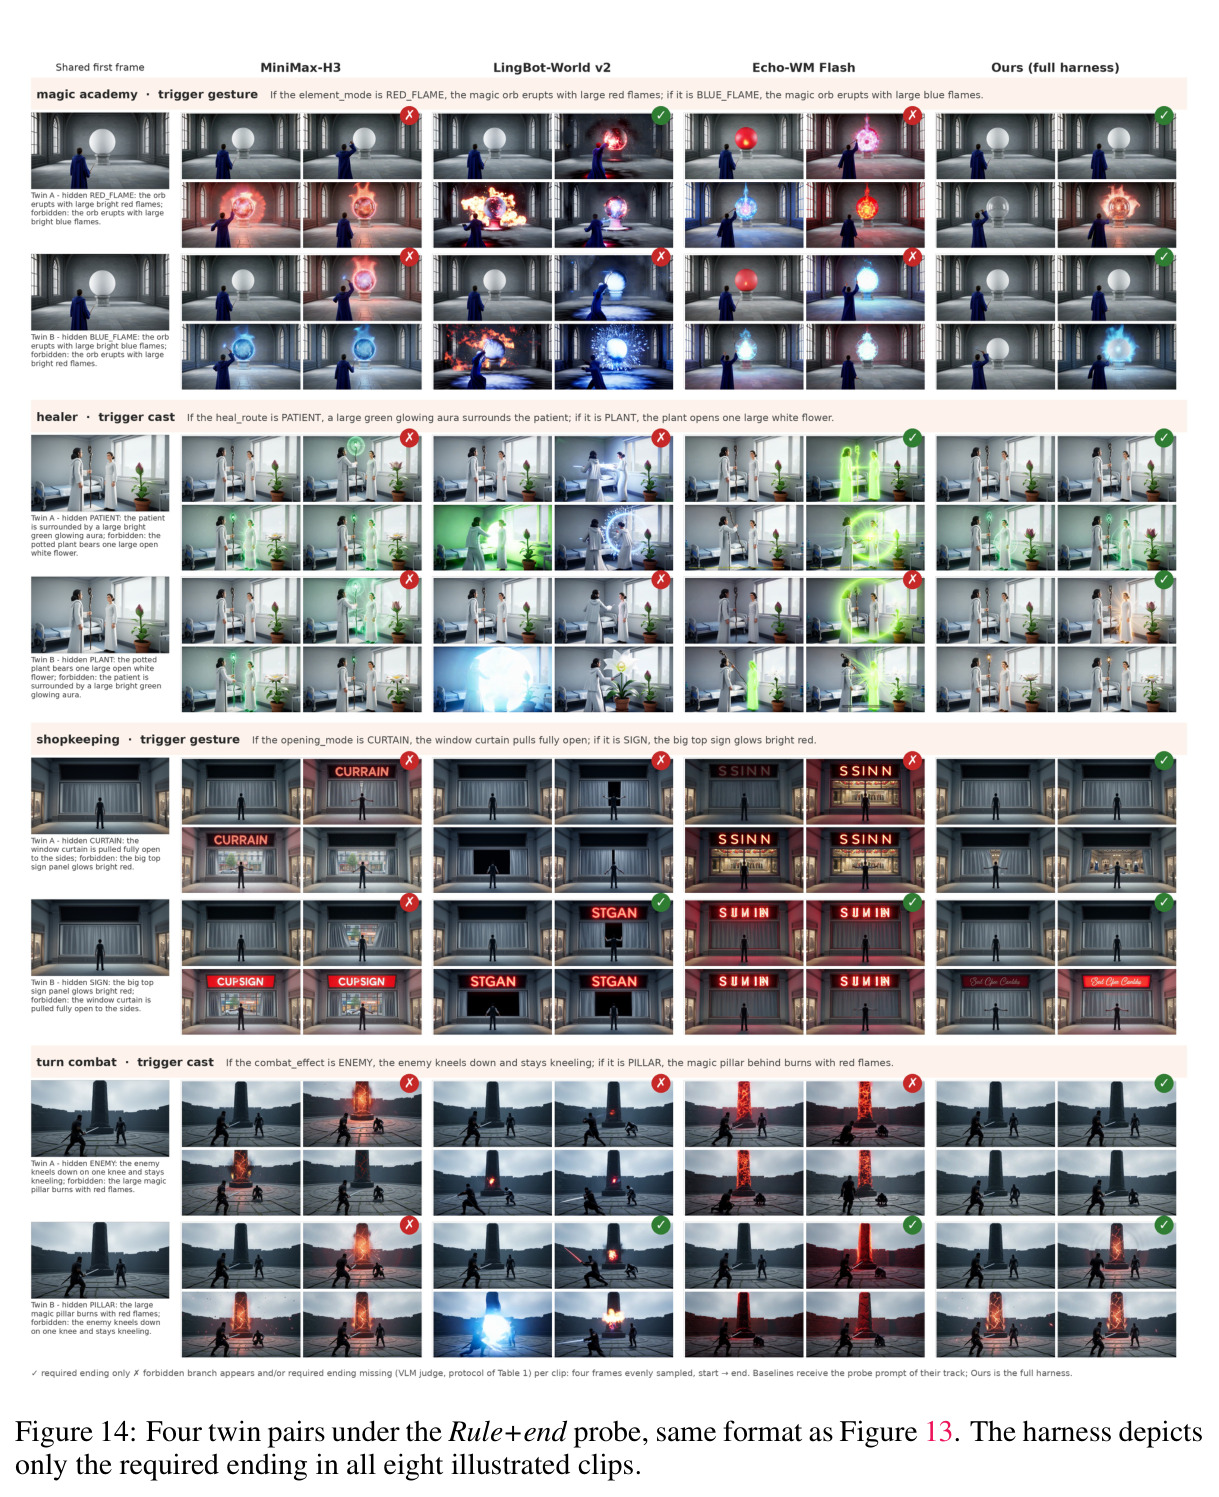
主实验覆盖 WorldState-Bench 50 对反事实孪生。Rule-only 下 11 个裸后端最好仅 32% PAIRFOLLOW;Astra 等三个交互模型 ENDFOLLOW 不足 20% 而 UNCLEAR 达 65-84%,即禁止内容缺席常因事件根本未生成。Rule+end 把 MiniMax-H3 的 PAIRFOLLOW 提到 64%,PAIRSTRICT 仅 4%(十后端平均 ΔSTRICT 仅 +2.3)。同一冻结权重上,harness 达 96% ENDFOLLOW、92% PAIRFOLLOW、96% TWINCONTRAST、90% PAIRSTRICT、98% CNTABSENT、2% UNCLEAR,较裸基线提升 30-86 分。归因:结局规范 +32 分、执行状态+编译参考 +28 分(McNemar $p<0.003$)。人类盲测胜率 98%;最难的 zone 触发类 PAIRSTRICT 83.3%。WBench 上场景遵循 71.1→87.2、交互 77.7 最高。三个真实片段(15/29/11 回合)证明同一冻结权重跨题材维持状态一致。
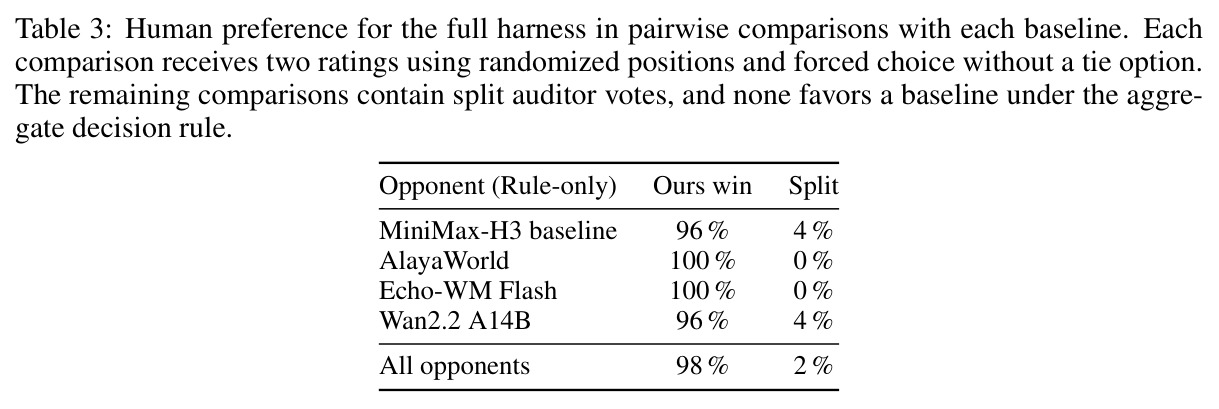
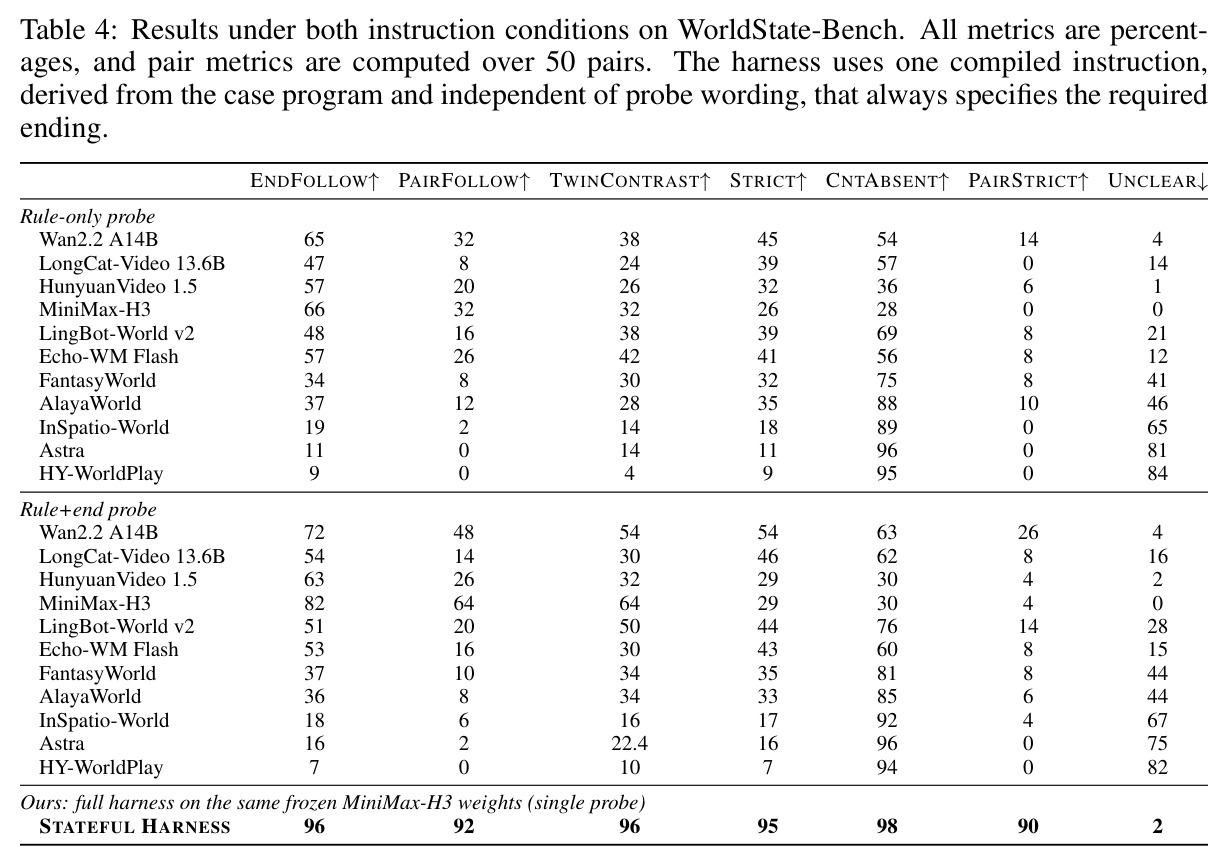
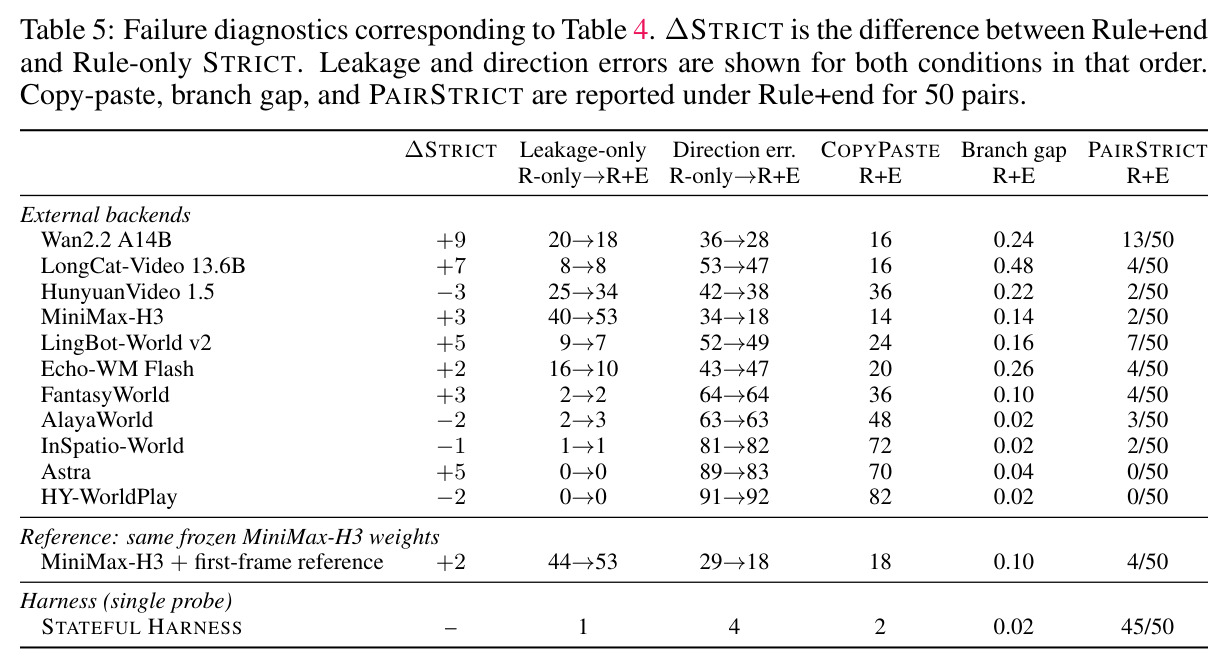
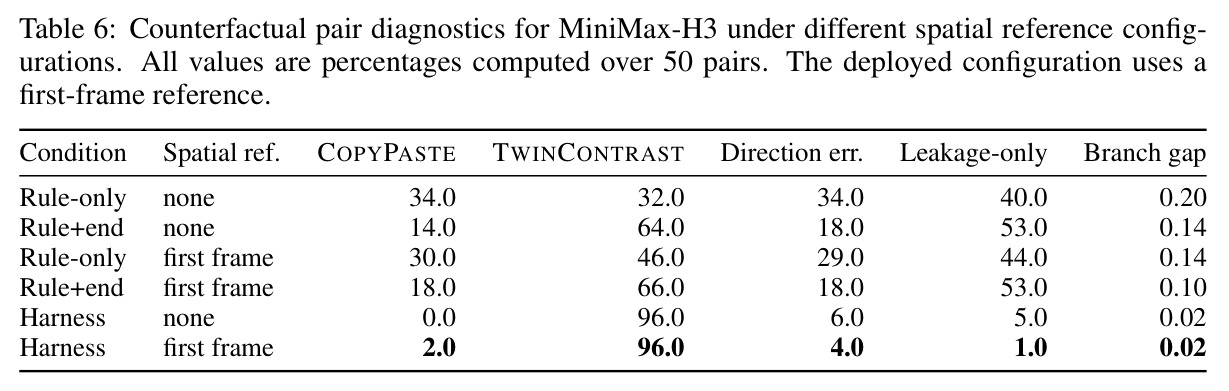
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 反事实孪生成对规则遵循(WorldState-Bench) | PAIRFOLLOW | 92% | MiniMax-H3 裸后端(Rule-only)32% | +60 个百分点 |
| 反事实孪生严格合规(要求禁止结局全程缺席) | PAIRSTRICT | 90% | 同骨干 MiniMax-H3(Rule+end)4%;裸后端最好 Wan2.2 26% | +86 个百分点(同骨干)/ +64 个百分点(最好裸后端) |
| 单片段规定结局命中率 | ENDFOLLOW | 96% | MiniMax-H3(Rule-only)66% | +30 个百分点 |
| 孪生结局可区分性 | TWINCONTRAST | 96% | MiniMax-H3(Rule-only)32% | +64 个百分点 |
| 外部多轮交互评测(WBench) | Interaction 平均分 | 77.7(对比中最高) | 文本驱动类均值 54.8;同骨干原始文本协议 68.9 | 较类均值 +22.9,较同骨干原始协议 +8.8 |
| 外部场景遵循评测(WBench Setting) | Setting 平均分 | 87.2 | 同骨干原始文本协议 71.1 | +16.1 |
局限与改进
作者承认的局限:黏土模型只是基于长方体的粗糙空间表示,实例恢复误差会传播到预览;文本指令并不总能让渲染器避免复现「黏土外观」;关节姿态与精细外观完全交给视频模型决定;空间流水线是离线的。我的补充观察:其一,基准只有 50 对、49 个隐藏变量、21 个题材且全部由作者构造,PAIRSTRICT 90% 意味着仍有 5 对失败,而最接近真实空间推理的 zone 触发类仅 83.3%(5/6 对);其二,自动评判依赖单一 VLM(Qwen3.8-27B-VL),虽有人工审计(Q1 一致率 91.2%、$\kappa=0.72$、Spearman $\rho=0.94$),但审计只覆盖 102 个片段;其三,所有探针都是单动作、约 5 秒的短片段,最长演示也只有 29 回合/158 秒,长时程状态漂移、多实体并发状态与玩家长线目标尚未检验;其四,harness 每回合引入多次 LLM/VLM 调用(结算、提议、观察),论文未报告延迟与成本,对实时交互不可行;其五,失败策略「复用上一锚点并记为已玩」可能掩盖渲染失败对状态链的影响。
独立分析的弱点
弱点一:空间表示太粗。长方体黏土模型无法表达关节、材质与细粒度几何,拾取、堆叠等物体交互超出其表达能力;改进方向是引入可编辑的实例化网格或高斯场景表示,并用可微渲染校验预览与真实帧的对齐。弱点二:规则语言表达力有限。当前守卫只读当前状态的类型化字段,没有时序条件(如「连续三回合未进食」)与量化(如「所有敌人」);可引入线性时序逻辑或 Datalog 风格规则编译器,并对规则程序做性质验证。弱点三:视觉观察环节是软肋。VLM 读帧提出的更新可能包含幻觉,虽会被规则否决,但「可观察字段」与「规则不可见字段」的边界全靠人工设计;可让规则程序显式声明每个字段的可见性条件,由编译器自动生成观察提示词。弱点四:单后端绑定。所有头条数字都在 MiniMax-H3 上取得且指令方言遵循该模型官方指南,换后端需重调适配器;应发展后端无关的中间表示与提示词方言自动搜索。弱点五:回合延迟与算力成本未量化,8×A800 的评测配置对普通实验室不友好;蒸馏小型渲染器或缓存预览是可行的降本方向。
未来方向
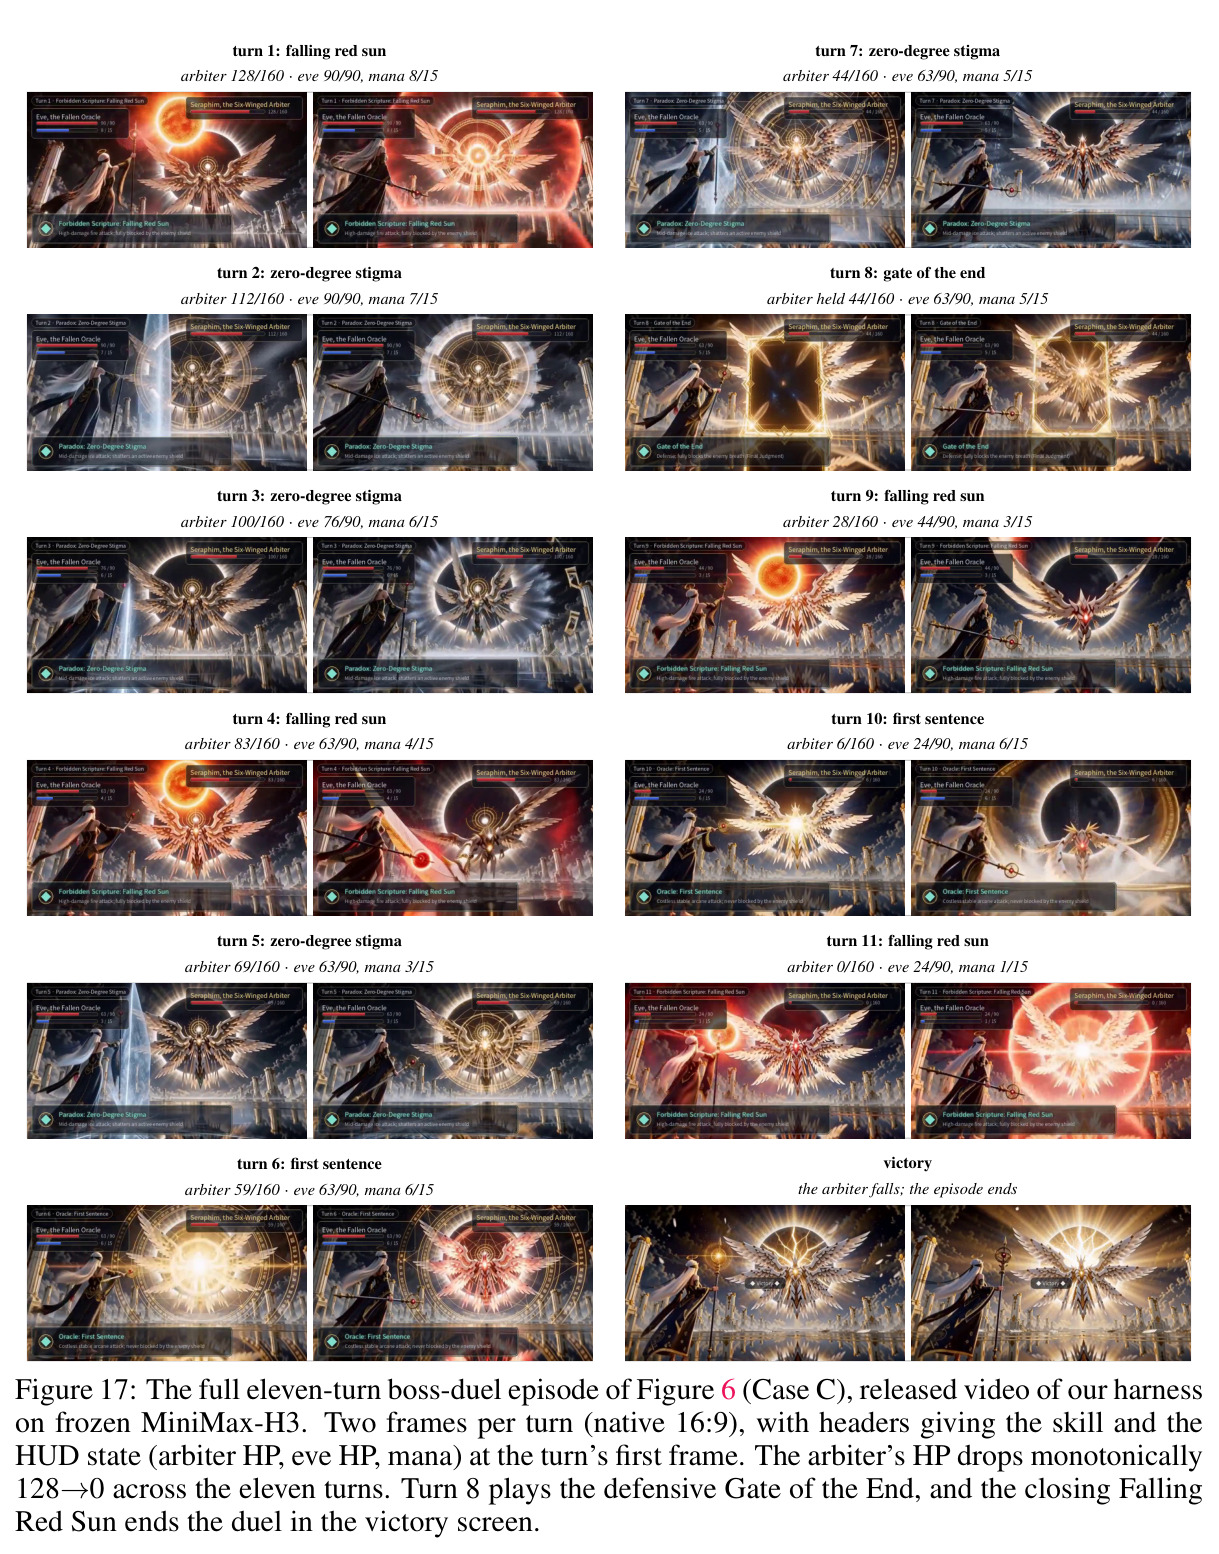
作者明确提出:更丰富的规则语言(时序与量化条件)、跟踪更多实体与关系的状态、把编译指令迁移到更多视频后端、把闭环扩展到更长片段、多智能体交互、以及目标与规则随时间演化的开放环境。基于本文成果还可延伸:其一,把反事实孪生协议推广为世界模型评测的标准件,覆盖空间记忆(与 shell-game 式内部状态测试对接)、经济系统与社会性规则;其二,研究「规则与渲染的仲裁」——当渲染反复偏离结算结局时,自动微调轻量适配器或重写指令,而非让权重永远冻结;其三,让规则程序本身可被玩家或 LLM 在线修改,同时给出修改的安全性验证;其四,把 RL 智能体放进 harness 内训练——状态完全可序列化、奖励可由规则程序自动判定,是天然的 gym 环境;其五,探索多智能体一致性与并发动作解析(两名玩家同时开同一宝箱),这在回合制框架中是自然的下一步。
复现评估
复现友好度较高。作者承诺发布全部 50 个案例程序、首帧提示词与图像、审计记录、VisualScript 语法与编译器、后端适配器与生成设置、采样片段、固定选项评判提示词与逐片段判定(项目主页/GitHub/HuggingFace/ModelScope 链接已在文中给出);期望结局由案例程序语义导出、编译器确定性,因此每个数字都能从程序追溯到判定。确定性边界被清晰文档化:结算与编译是确定的,神经核/视频后端/观察者有随机性,完整复现片段需种子 base_seed+t 与相同的被采纳观察流。算力方面:评测用单节点 8×A800 80GB,harness 逻辑只跑在 CPU 上;MiniMax-H3 经官方文本/图像/视频参考接口调用,无任何权重修改。难点在于:需同时获得 11 个后端的可用推理服务(部分可能是闭源 API)、VGGT 类几何模型、依赖 SAM3 的 WildDet3D 与 Blender 流水线、以及 Qwen3.8-27B-VL 评判服务;工程整合量大,但训练量为零,理论上有一张能跑 MiniMax-H3 的卡即可复现核心数字。
论文图表
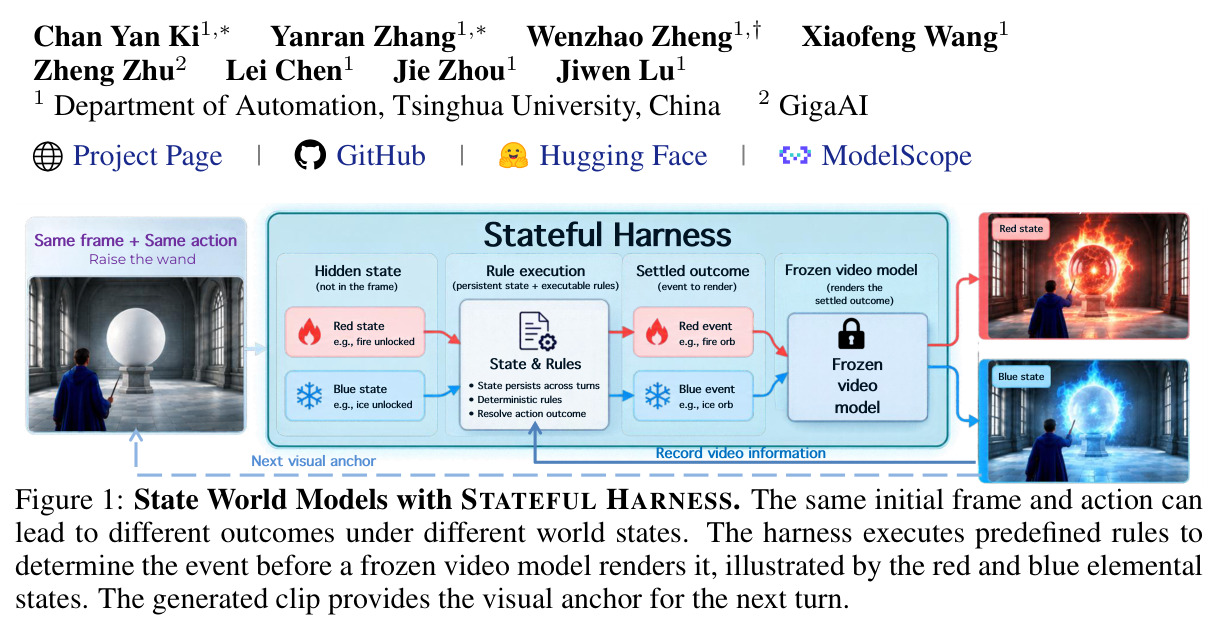
题图概念图:同一首帧与同一动作「举起魔杖」,在红/蓝两种隐藏元素状态下,经有状态 harness 执行预定义规则得到不同结算事件(红:火球解锁;蓝:冰球解锁),冻结视频模型只负责把结算事件渲染成片段,片段末帧成为下一回合的视觉锚点,且该状态跨回合持续。
一张图说清论文核心命题「执行规则、生成像素」:结局由隐藏状态和规则决定,而非由渲染模型决定。
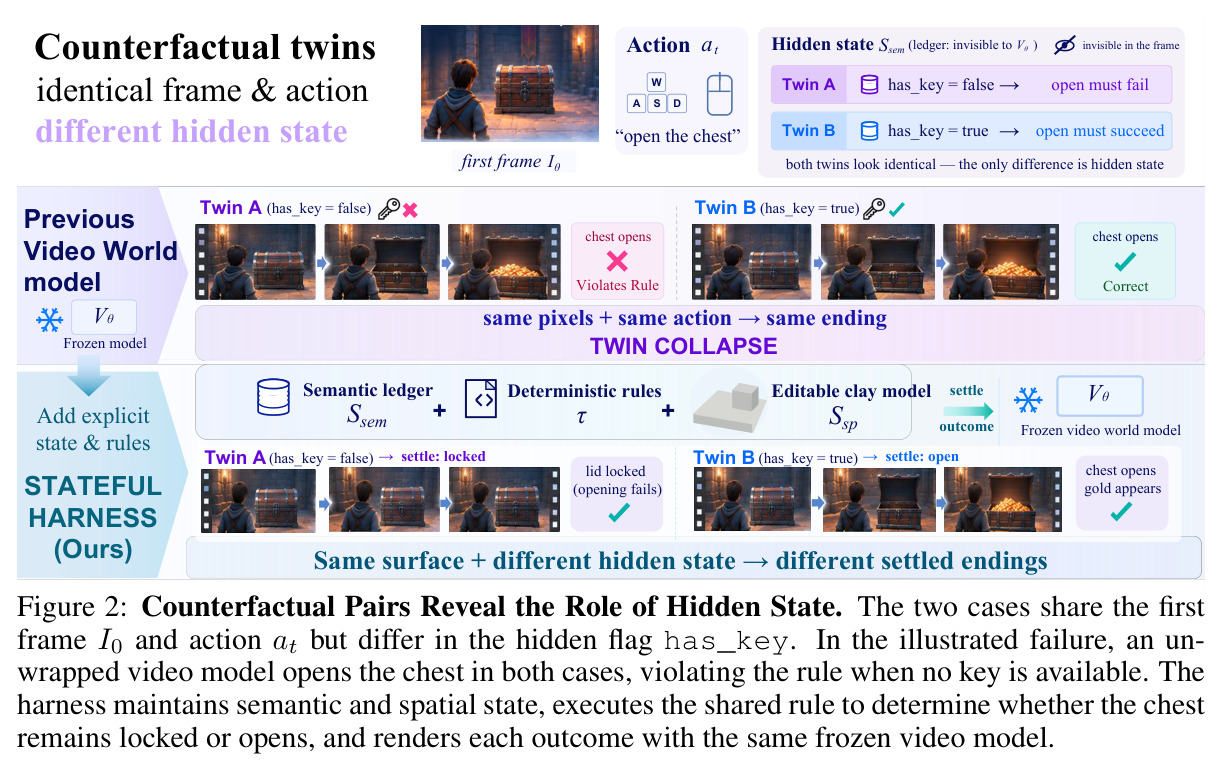
上半部分展示反事实孪生:同帧同动作「开宝箱」,仅 has_key 隐藏值不同(false 时开启必须失败,true 时必须成功)。下半部分展示失败模式与解法:裸视频世界模型在两个案例上同样渲染开箱(TWIN COLLAPSE,违反规则);而 STATEFUL HARNESS 用语义账本+确定性规则+可编辑黏土模型结算后,由同一冻结模型渲染出「锁死」与「开箱出金」两种正确结局。
直观呈现论文要解决的核心失败模式(孪生坍缩)与「显式状态+规则结算」的对应解法,是理解全文的入口。
与 Figure 7 同版式的第二个完整样例(sign 对,twin A,opening_mode=CURTAIN):CURTAIN 分支要求帘幕完全拉开并禁止上方招牌发红光,SIGN 分支则要求招牌发红光;高亮标出追加的 Rule+end 结局句与编译指令中规定的结局。
第二个完整提示样例,覆盖另一隐藏变量族,帮助读者确认案例构造的对称性与审计流程。
散点图:横轴 TWINCONTRAST(孪生结局可区分性),纵轴 PAIRSTRICT。11 个裸后端散布在左下方,最好基线 Wan2.2 也只有 PAIRSTRICT 26%;harness 以星标独占右上角(96, 90),说明「区分两个结局」与「严格合规」是两个维度且 harness 双高。
一图总结核心主张:显式结局指令不足以带来严格合规,只有规则结算+渲染参考才能同时最大化两个指标。
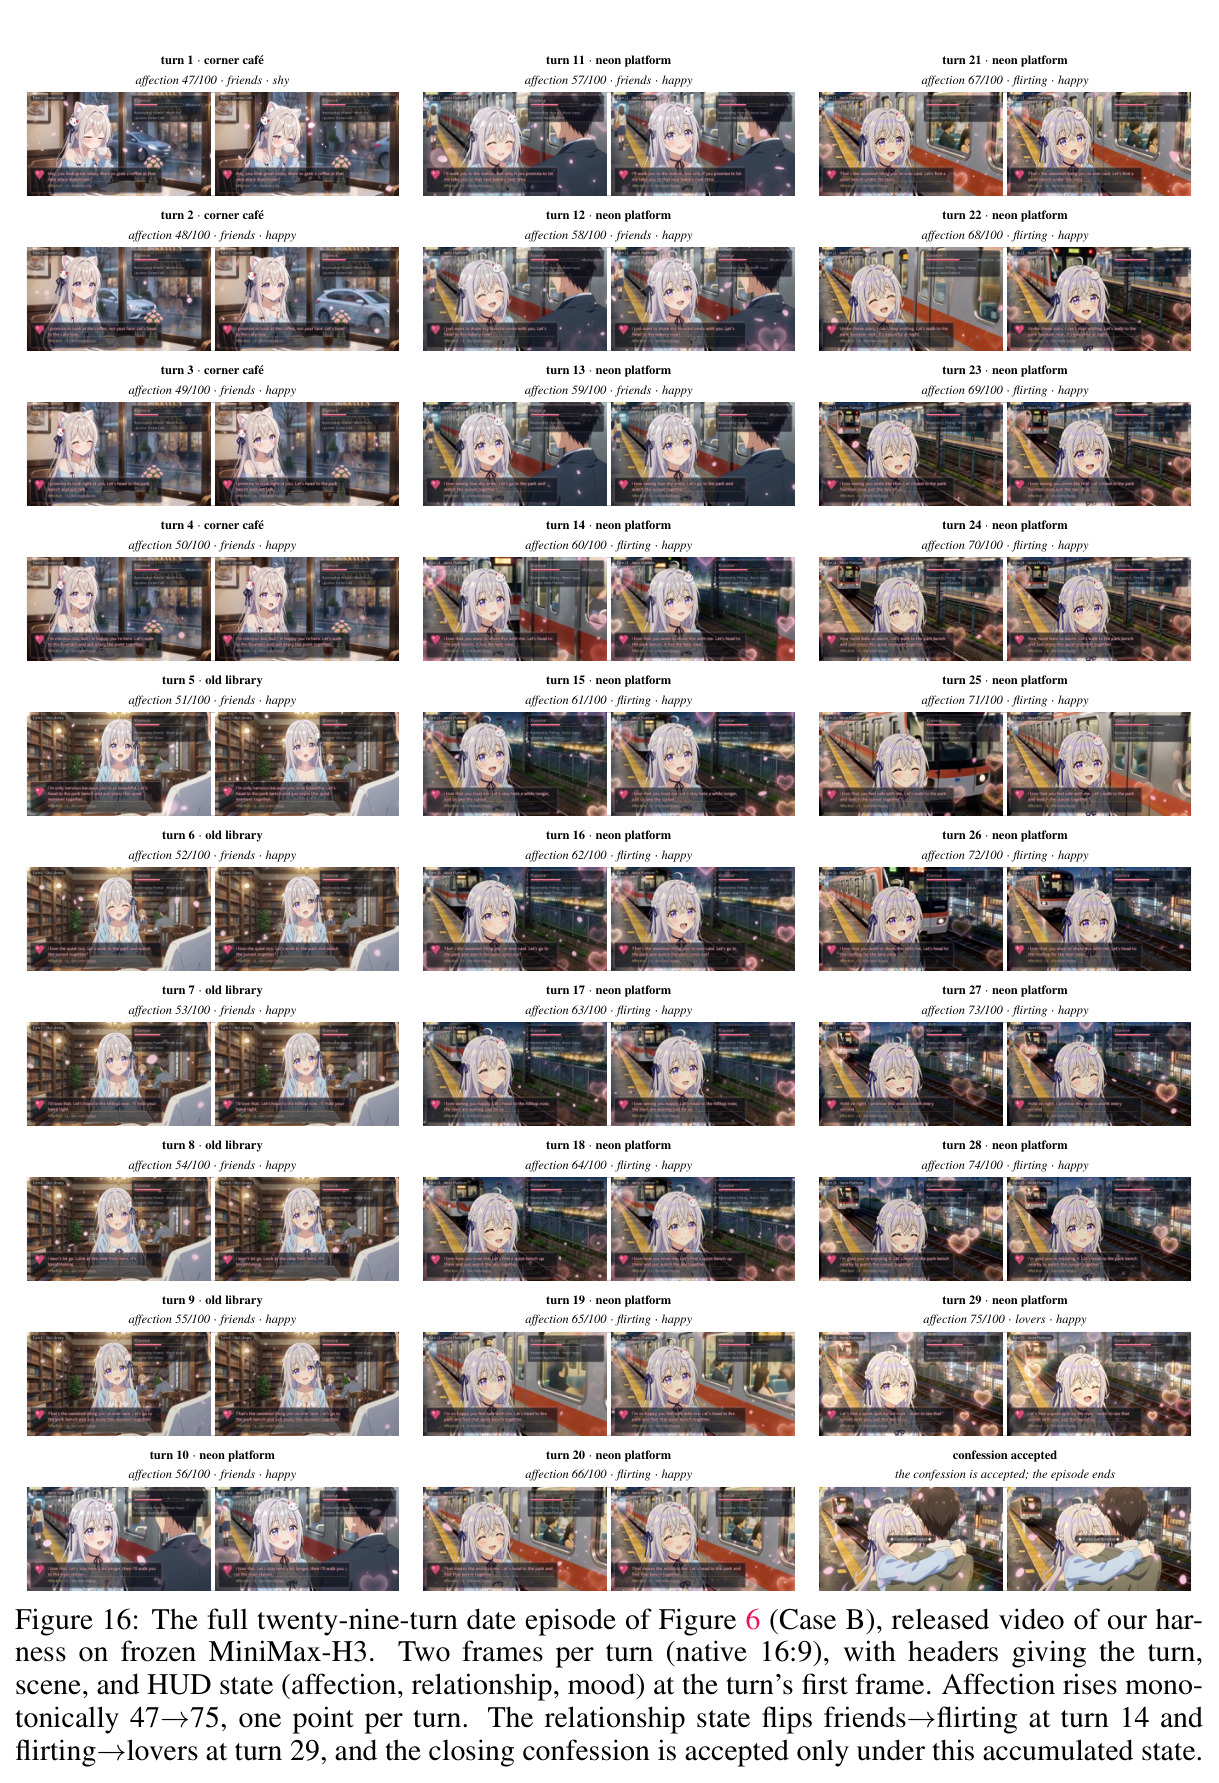
15 幕全展开(每幕 2 帧 + HUD 读数):体力沿路程从 28 一路降到 0,状态行切到「Exhausted—slow walk only」,休息恢复到 60,第二轮消耗-恢复后抵达后台门;任务计数只前进(1/3→2/3→3/3),场景从阳光街道经石板广场到昏暗后台走廊。附录 Figure 16/17 以同样格式展开 29 回合约会(好感 47→75 单调上升、关系两次翻转)与 11 回合决斗(arbiter HP 128→0、第 8 回合开防御技)。
逐回合完整记录长片段的状态一致性,是验证闭环在多回合中不丢状态、不逆转状态的最终证据。