PROWBench:视频模型对程序规定世界的渲染忠实度基准 ROWBench: Do Video Models Render What the Program Specifies?
用引擎记录的可回放世界状态与时间戳事件,检验视频模型是否忠实渲染程序规定世界
前置知识
可编程世界模型(Programmable World Model)
把世界模拟拆成两层的新范式:状态演化与交互规则交给可执行程序或编码代理(Code World Model)显式维护,视频生成器只负责根据结构化世界状态渲染画面。与从视觉历史隐式推断状态的视频世界模型(如 Genie、GameNGen、Matrix-Game)相对,它把“世界当前是什么样”变成可查询、可重放的数据,而不是藏在生成模型的隐变量里。
本文的全部动机建立在“程序执行正确不等于视觉渲染忠实”这个缺口上:只有理解了状态与渲染分离的架构,才能明白为什么要单独评测渲染环节对程序规定的服从程度。
条件式视频生成与代理表示(Proxy Representation)
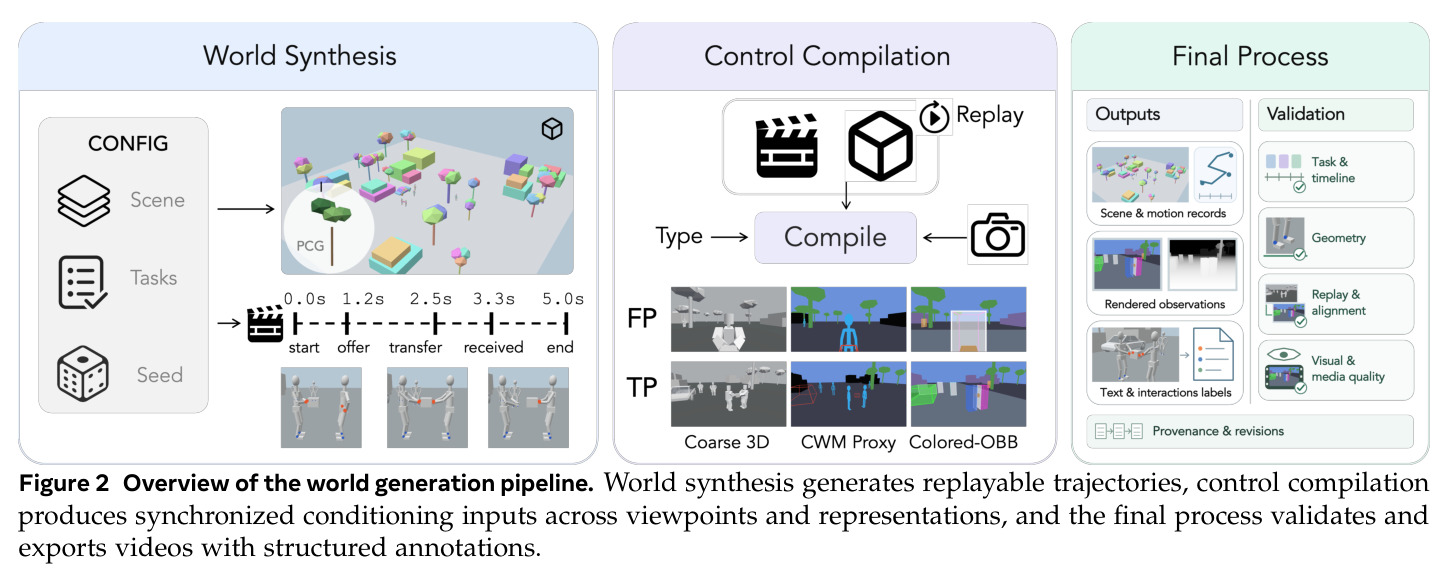
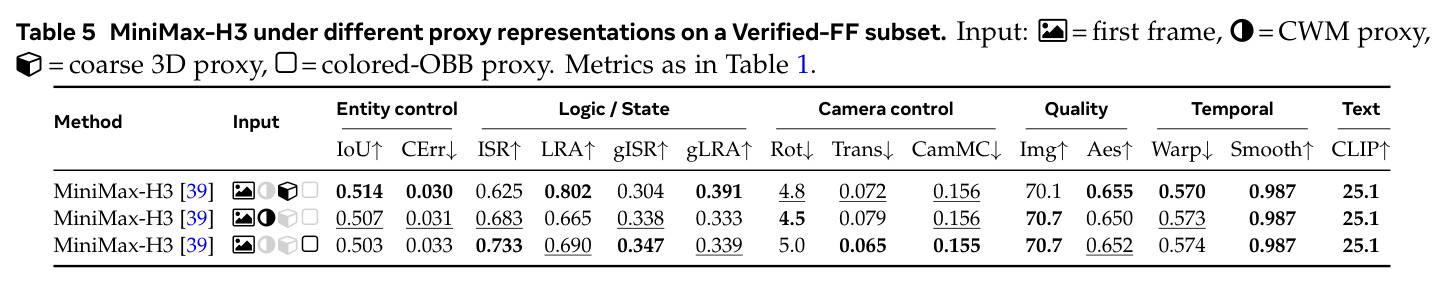
指用深度图、语义分割、姿态轨迹、有向包围盒(OBB)等结构化信号控制视频生成。本文的引擎把同一条世界状态记录渲染成三种代理:粗 3D(中性材质保轮廓与关节)、CWM 语义代理(语义色环境加简化人形)、彩色 OBB(每实体唯一身份色、白色面标正面)。代理视频既是生成模型的控制输入,也隐含了相机运动。
代理是本文评测的载体:生成模型拿代理视频当条件,评测时再检查输出是否遵循代理所编码的实体轨迹与事件时序;三种成对代理还支撑了表示消融实验。
VLM 裁判式评测(VLM-as-Judge)
用视觉语言模型(本文用 Qwen3.6-27B)替代人工判卷:把采样帧、事件描述与期望终态一起喂给裁判,由它判断“规定动作是否出现在对应时间窗内”。本文 ISR 给裁判事件窗口内 8 帧(含全帧与引擎定位裁剪),LRA 给 12 帧,要求动作与终态同时确认才算事件成功。
ISR 与 LRA 两个核心指标完全由 VLM 裁判驱动,是检验“逻辑是否被渲染出来”的关键工具;同时裁判未与人工标注校准也是论文明示的主要局限。
BBox IoU 与匈牙利匹配
IoU(交并比)衡量预测框与参考框的空间重合度,取值 0 到 1;匈牙利匹配则在预测实体集合与引擎实体集合之间按标签兼容性和 IoU 找全局最优一一对应。本文用 SAM 3 按语义标签从生成视频里定位实体,与引擎投影框做标签兼容匈牙利匹配,漏检记零分,逐实体平均得到片段级 BBox IoU。
实体控制(BBox IoU、中心误差)是本文最基础的客观指标,gISR/gLRA 也以它加权;不理解这套定位-匹配流程就看不懂主结果表。
研究动机
现有视频评测基准覆盖了视觉质量(VBench、EvalCrafter)、可控性与世界动态(WorldScore)、指令遵循与物理合理性(WorldModelBench、WorldSimBench)、交互与长时程一致性(MIND、WorldArena、WBench、Omni-WorldBench 等),但没有一个检验生成视频对细粒度、程序规定世界事件的忠实度。可编程世界模型与代码世界模型把状态演化交给可执行程序、把画面交给视频生成器,然而程序执行正确并不保证视觉实现忠实:一段视频可以看起来完全合理,却违反了规则或漏掉了规定的交互。由于缺少可回放的实体状态和带时间戳的事件记录,已有方法只能评判视频“看起来像不像”,无法对照“程序实际执行了什么”。论文开篇的例子极具说服力:一个明显没有完成规定交互的坏 case 拿到更高的 CLIP 分(24.51 对好 case 的 22.29),说明感知类指标对逻辑违背完全失明。
本文的目标是本文要回答一个明确的评测问题:视频模型能否忠实渲染一个可编程世界所规定的场景结构、规则与交互?为此作者构建 PROWBench:170 个程序化构造的动态场景 episode 和 600 段同步代理视频,覆盖第一/第三人称视角,部分 episode 提供同步多视角观察。数据引擎把实体状态与带时间戳的事件(包括相机视野外的事件)记录成可回放的世界记录,再从同一份记录渲染出粗 3D、语义代理(CWM proxy)与彩色有向包围盒(Colored-OBB)三种表示,以及自动生成的文本提示。评测端除了实体控制和长时程记忆,还提出两个 VLM 指标:逻辑-渲染对齐(LRA)检验生成视频是否按引擎规定的时间线逐段呈现动作,交互成功率(ISR)以引擎日志为真值检验注册事件是否在对应时刻被视觉实现。整个数据引擎设计为可扩展框架,支持新场景、新动作、新表示的增量添加。
与已有工作不同的是,本文的独特切入是评测的“真值来源”。已有基准把生成流水线当黑盒整体评测,误差混入了动作理解、状态预测、记忆、动力学等各个环节;PROWBench 用引擎帧级记录直接给渲染环节判卷——所有方法消费同一份记录导出的控制信号,方法间差异才真正反映渲染对规定状态的服从程度。Table A.1 的逐项对照显示,此前没有一个基准同时具备多实体状态与事件记录、无需重跑控制器即可重放的记录、同步多视角观察、以及从同一状态派生的成对代理表示;而成对表示与同步视角正是在固定世界演化下隔离“表示选择”和“视角选择”影响的必要条件。把“引擎日志当真值、代理成对可控对比”作为评测原则,在视频世界模型领域是首次。
核心方法
直觉上,这是给视频模型安排一场“对着标准答案判卷”的考试:引擎执行程序时逐帧记录一切,阅卷时对照记录逐条检查画面。技术上分三段。其一是世界合成:配置驱动地过程化生成地形、建筑、道路、室内与交互物,专用控制器编排各类行为——例如搬运任务被拆成接近、抓取、抬起、运输、放下五个阶段并同步更新手部目标与物体归属——外部代理可查询实体、提交动作并按固定 tick 推进世界,每次执行产出结构化 episode 记录。其二是控制编译:从记录导出第三人称任务相机与第一人称头部相机轨迹,渲染适配器按 $I_v^r = R^r(G, S_i, C_v^i)$ 从共享几何 $G$、状态 $S_i$ 与相机参数 $C_v^i$ 生成三种代理表示的条件视频,同时用确定性脚本把记录转换成带时间轴的文本提示。其三是评测:模型生成视频后,用 SAM 3 加标签兼容匈牙利匹配对齐引擎投影框计算 BBox IoU,用 Qwen3.6-27B 裁判判定 ISR 与 LRA,另测相机误差、感知质量与长时程记忆。
核心创新是把评测锚定在可回放的引擎世界记录上:生成视频不是与另一段视频比感知相似度,而是与程序执行的“可观测后果”逐条对账。ISR 定义为 $\mathrm{ISR}_s=\frac{1}{|E_s|}\sum_{e\in E_s}\mathbf{1}[\text{有效响应, action=yes, end state=yes}]$,即每个注册事件的动作与期望终态都被裁判确认才算成功;LRA 定义为时间线各段规定动作在其时间窗内被可见实现的比例;再把两者分别乘以逐样本 BBox IoU 得到 $\mathrm{gISR}_s=\mathrm{ISR}_s\cdot\mathrm{IoU}_s$ 与 gLRA,把“事件实现了”和“实体摆对了”联合考核。Figure 1 显示 CLIP 给坏 case 打 24.51、好 case 只有 22.29,而 ISR 正确给出 0/3 对 3/3。错配时间线实验中各方法 LRA 从 0.46–0.85 骤降到 0.07–0.20,证明这些指标响应的是“规定内容”本身而非视频的通用质量——这正是与所有感知类指标的本质区别。
方法步骤详情
第一步世界合成:输入环境、实体布局、参与者、任务控制器、随机种子与时长等配置,过程化生成场景并给每个实体持久 ID、语义类别与组件层级;交互、活动运动(动物、飞行、游泳)与驾驶三类控制器在执行中报告动作阶段、参与实体与关系变化。第二步控制编译:从记录导出含内参与外参的相机轨迹,第三人称走任务轨迹、第一人称由头部位姿推导;渲染适配器 $R^r$ 把共享状态渲染成粗 3D(中性材质,保轮廓与关节)、CWM 代理(语义色环境加蓝色简化人形)与彩色 OBB(每实体唯一身份色,白色面标记正面)三种条件视频。第三步首帧构建:Verified-FF 用 MiniMax-H3 从彩色 OBB 加场景描述生成候选首帧,SAM 3 校验人数与布局(人/动物框 IoU 不低于 0.30),Qwen3.6-27B 检查风格、代理残留与朝向,不合格则换种子重生成。第四步文本提示:除外观块外全部由确定性脚本生成,含控制块、按十六进制颜色绑定的主体定义与覆盖 0–5 秒的连续时间线。第五步四类验证(任务/时间线、几何、回放对齐、视觉质量)并保留溯源。
技术新颖性
与 Table A.1 逐项对照可以看清新颖性:VBench 只有文本提示,WorldScore 有目标相机路径但无事件参考,MIND 有 actor/camera 位姿却无结构化交互记录,WBench 有逐回合事件检查但不可回放、无成对代理;只有 PROWBench 同时具备多实体状态与带时间戳引擎事件、可回放记录、子集同步多视角、以及从同一状态派生的多种代理表示。方法论上,它把“整条生成流水线的好坏”收窄为“给定规定状态后的渲染忠实度”,使方法比较第一次在固定世界演化下进行。指标设计上,gISR/gLRA 首次把事件实现与空间摆放联合计分;ISR 与 LRA 故意分离“事件是否达成终态”与“时间线是否照演”,二者在场景内与 BBox IoU 的 Spearman 相关仅 0.05–0.06,证明它们测量的是几何与感知指标看不到的行为维度。可扩展框架把场景构建、行为控制、状态记录与渲染解耦,新增相机策略或渲染适配器无需重跑行为控制器。
实验结果
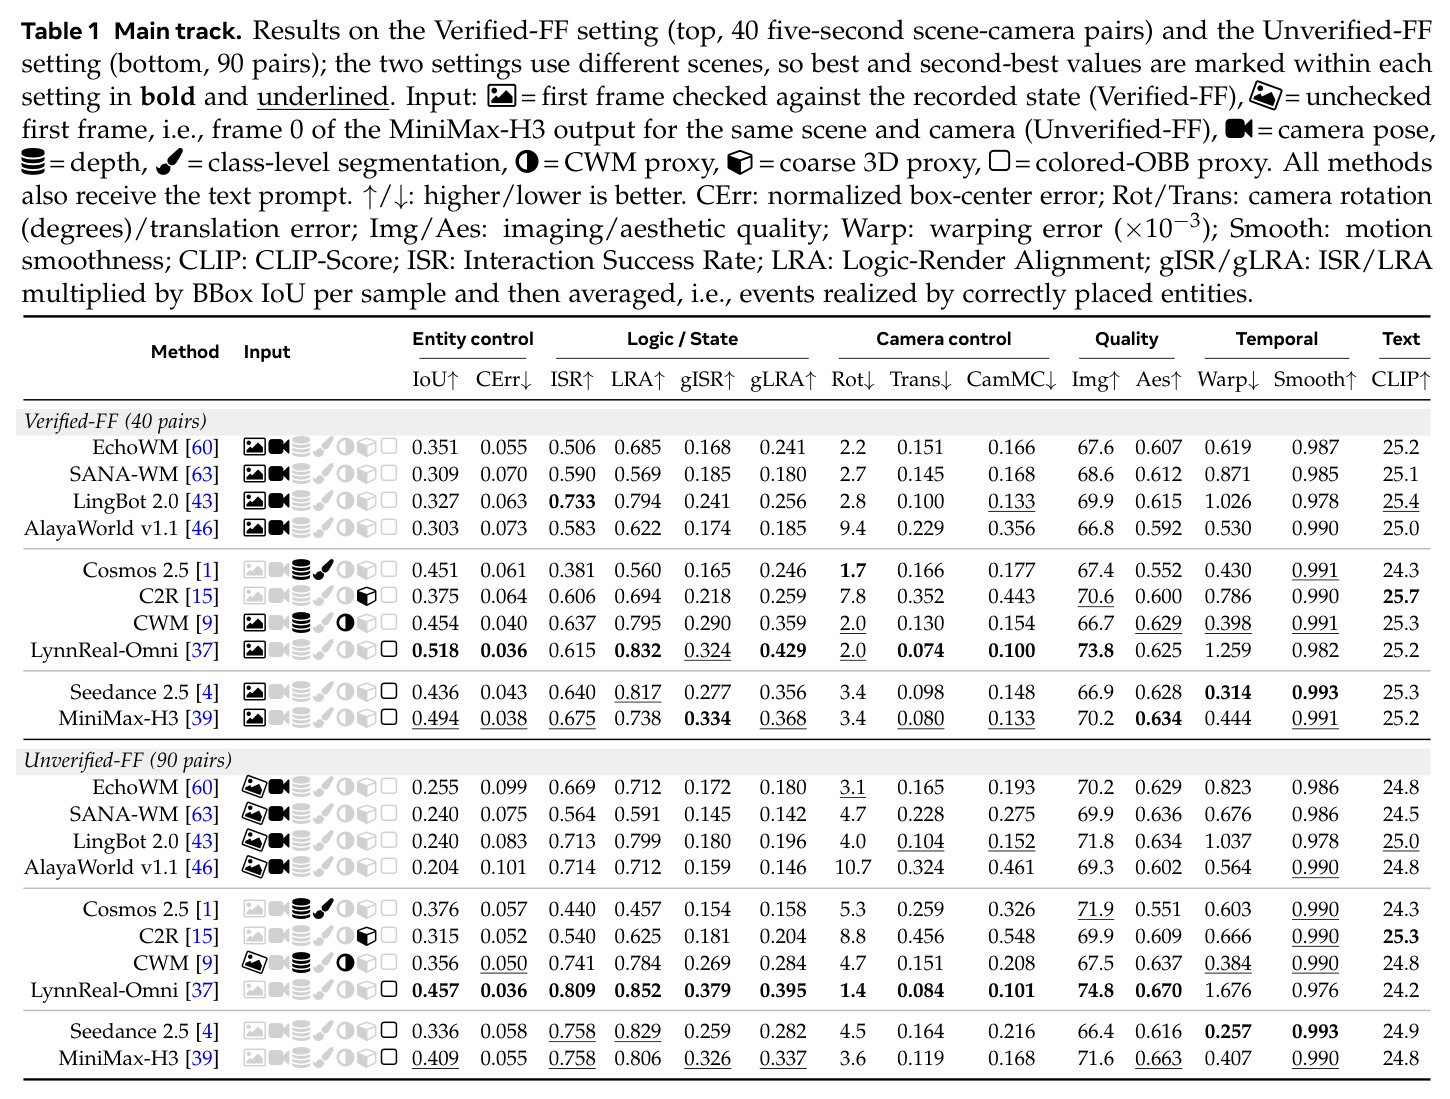
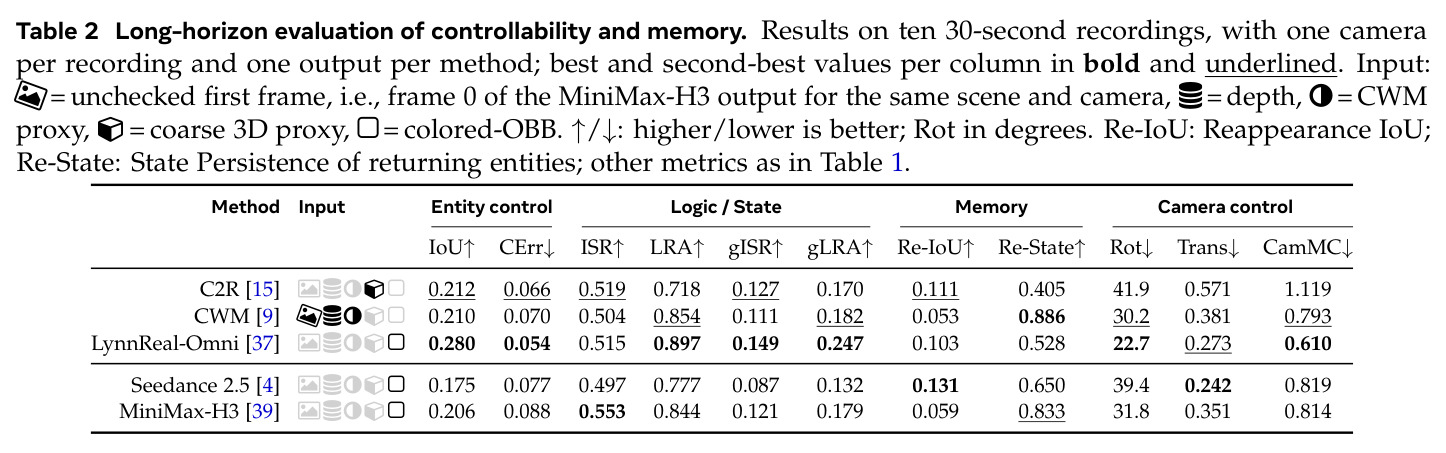
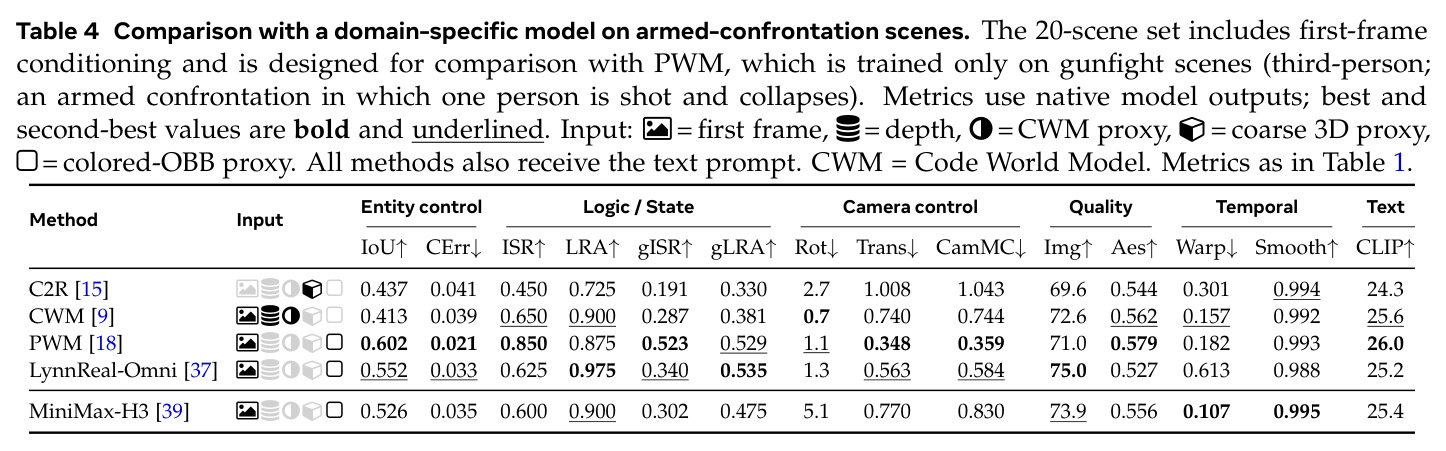
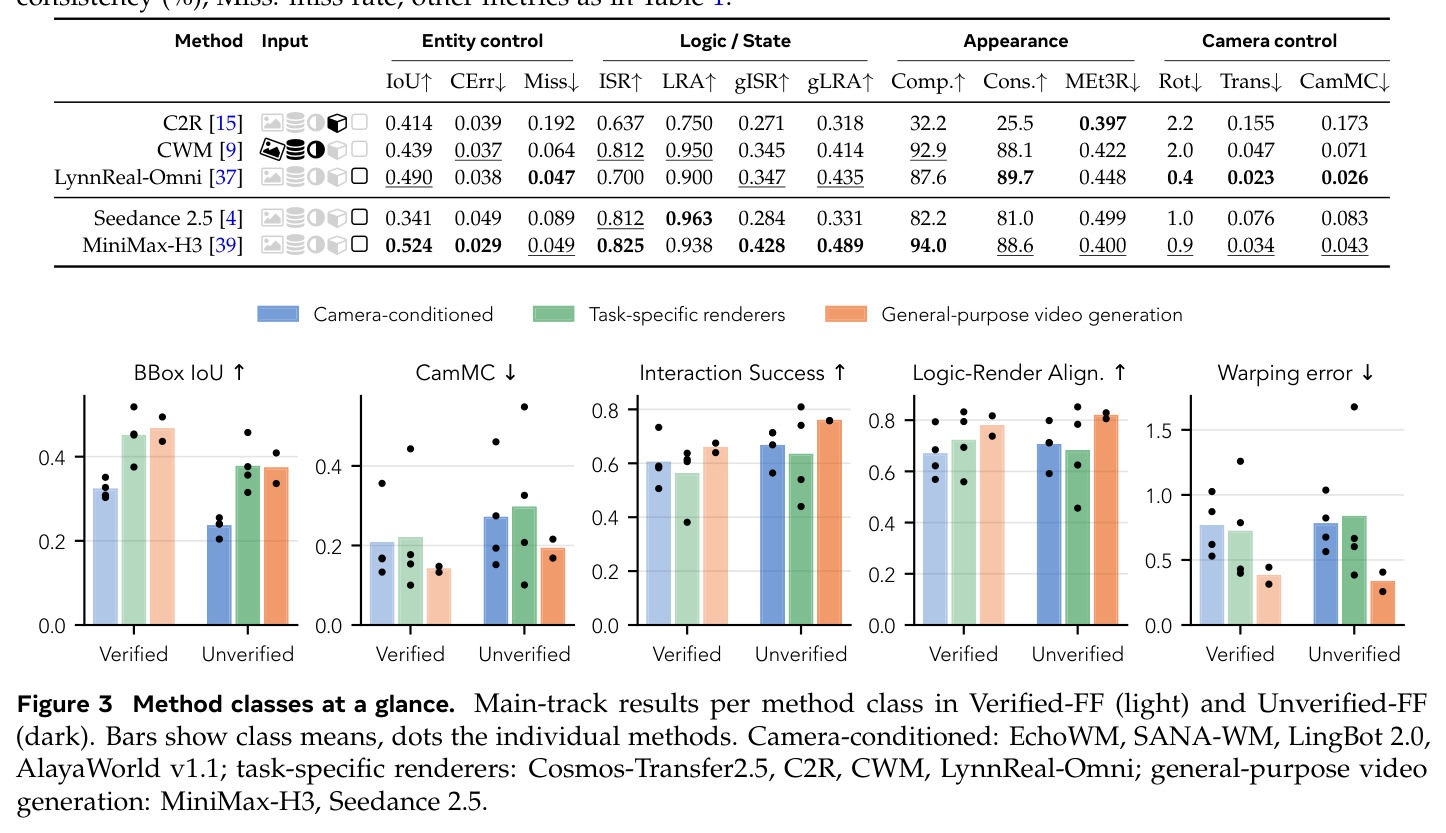
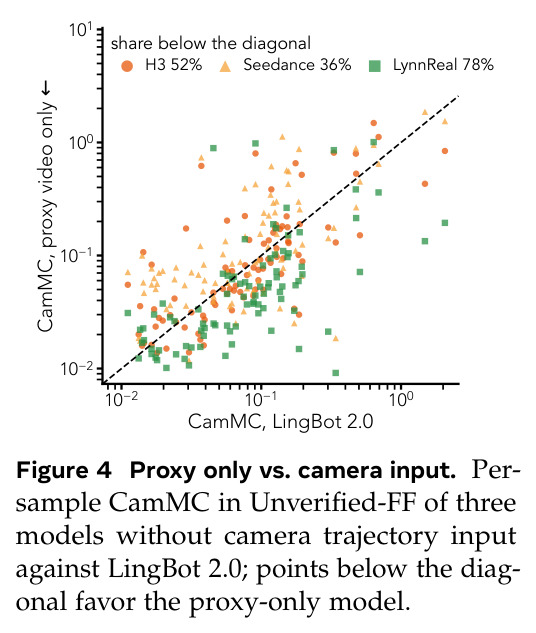
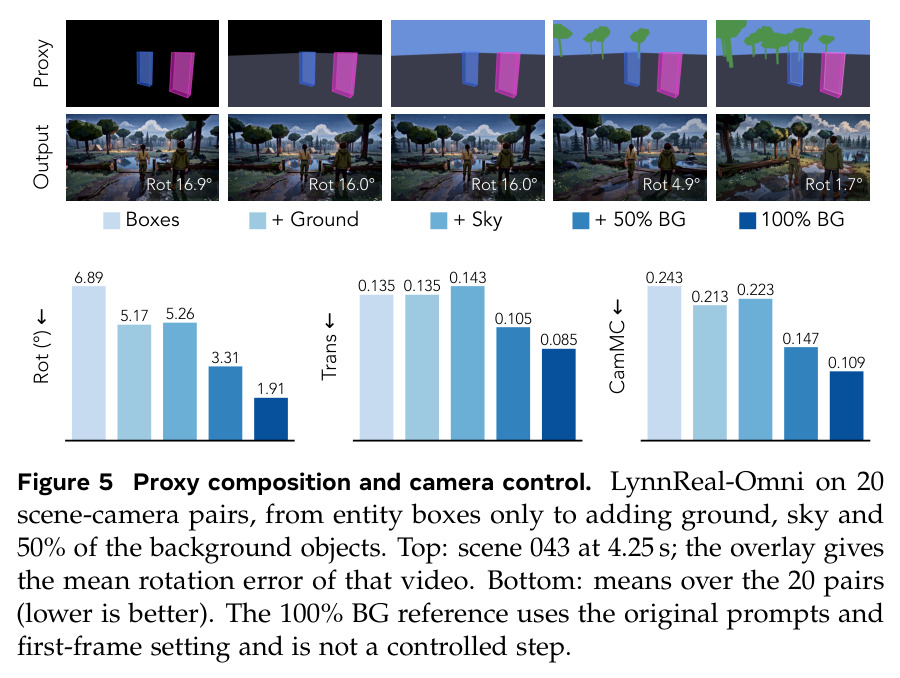
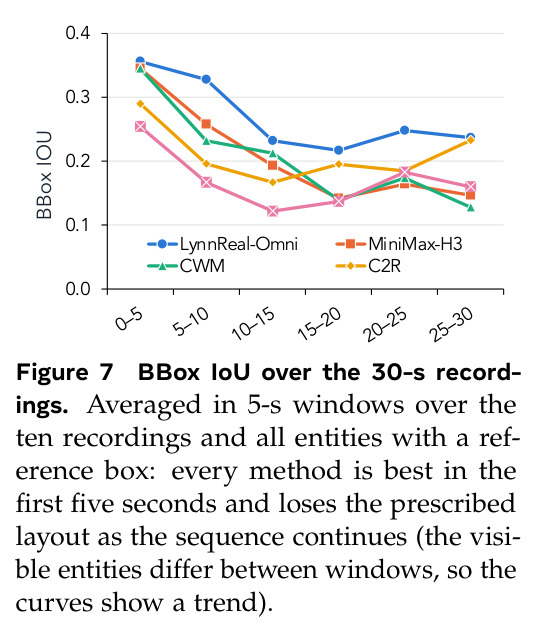
主赛道(5 秒片段)上代理控制明显强于相机控制:Verified-FF 中 LynnReal-Omni 的 BBox IoU 达 0.518、MiniMax-H3 0.494、CWM 0.454,只给相机轨迹的四个世界模型仅 0.303–0.351;类均值上任务特定渲染器 0.450、通用模型 0.465 对相机条件类 0.322,配对比较在 38/40 与 87/89 个场景占优(中位 +0.14,$p<10^{-8}$)。行为指标:LingBot 2.0 以 ISR 0.733 居 Verified-FF 首位但 IoU 仅 0.327,Cosmos-Transfer2.5 两设定 ISR/LRA 均垫底(0.381/0.560);LRA 最高为 LynnReal-Omni 0.832 与 Seedance 0.817;gISR 最高 MiniMax-H3 0.334,gLRA 最高 LynnReal-Omni 0.429,加权后排序改变。相机方面,代理已隐含相机:无相机输入的通用模型与显式相机条件模型打平($p=1.0$),MiniMax-H3 在 52% 样本上误差低于 LingBot 2.0,LynnReal-Omni 达 78%;代理加 50% 背景使旋转误差 6.89°→3.31°、CamMC 0.243→0.147。通用模型短片段质量最好(warp error 类均值 0.38/0.33 对渲染器 0.72/0.83),但枪战 20 场景上域内 PWM 达 ISR 0.850、IoU 0.602,明显超 MiniMax-H3 的 0.600/0.526,且通用模型出现代理泄漏。长时程是重灾区:30 秒录制 IoU 只剩 0.175–0.280,重现 IoU 仅 0.053–0.131,前 5 秒最好(0.25–0.36)、10 秒后跌至 0.12–0.25,回场行人 IoU 依次为 CWM 0.34、LynnReal 0.30、Seedance 0.17、MiniMax-H3 0.01。多视角设定中,有身份色或首帧的方法外观合规 82–94%、跨视角一致 81–90%,灰粗 3D 且无首帧的 C2R 仅 32.2%/25.5%;62 个多人场景人工审计中 MiniMax-H3 换装 12 例。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 实体轨迹跟随(Verified-FF,40 个 5 秒片段) | BBox IoU | LynnReal-Omni 0.518(代理条件类均值 0.450–0.465) | 相机条件世界模型最佳 EchoWM 0.351(类均值 0.322) | +0.167(类均值 +0.13–0.14;配对符号检验 38/40 场景占优,p<10^-8) |
| 交互成功率(Verified-FF) | ISR(动作与终态均需判为出现) | LingBot 2.0 0.733 | 同为代理条件的 Cosmos-Transfer2.5 仅 0.381;EchoWM 0.506 | 约为最差代理模型的 1.9 倍,但 gISR 加权后退居第五(0.241) |
| 时间线遵循(两种主赛道设定) | LRA(逻辑-渲染对齐) | LynnReal-Omni 0.832 / 0.852(Verified/Unverified) | Cosmos-Transfer2.5 0.560 / 0.457 | +0.27 至 +0.40;错配时间线时各方法 LRA 降至 0.07–0.20,证明指标对规定内容敏感 |
| 相机轨迹跟随(不注入相机参数) | CamMC / 旋转误差 | 通用模型(仅代理视频)与显式相机条件模型统计打平(p=1.0);MiniMax-H3 在 52% 样本、LynnReal-Omni 在 78% 样本上误差低于 LingBot 2.0 | LingBot 2.0(显式接收相机轨迹,Unverified-FF 中 CamMC 最低的相机条件模型) | 无显著差异——代理视频本身已编码相机运动,是重要发现而非指标领先 |
| 长时程记忆(10 条 30 秒录制) | BBox IoU / 重现 IoU(Reappearance IoU) | 最佳 IoU 0.280(LynnReal-Omni);重现 IoU 全体仅 0.053–0.131 | 同批方法在 5 秒设定为 0.32–0.52 | 为负向退化:42/50 个方法-录制结果低于 0.3,离场实体回归后布局几乎全部丢失 |
| 多视角身份一致性(10 场景 × 4 独立生成视图) | 外观合规率 / 跨视角一致率 | MiniMax-H3 94.0% / 88.6%(有身份色输入的方法达 82–94% / 81–90%) | C2R(灰色粗 3D 代理、无首帧)仅 32.2% / 25.5% | +61.8 与 +63.1 个百分点;MEt3R 几何一致性则与身份一致无必然联系 |
| 域内专用事件(20 个枪战场景:规定时刻一人中枪倒地) | ISR / BBox IoU | PWM(仅在枪战场景训练)0.850 / 0.602 | MiniMax-H3(免训练通用模型)0.600 / 0.526 | ISR +0.25,说明空间对齐不保证可靠执行规定事件,域专用训练仍有明确价值 |
局限与改进
作者承认的局限:ISR、LRA 与外观指标依赖的 Qwen3.6-27B 裁判尚未与人工标注校准;相机指标继承位姿估计器(ViPE)误差,即便在引擎渲染上也有 1.1–5.4°;Unverified-FF 集合用 MiniMax-H3 输出筛选、所有方法首帧也由其生成,可能偏袒它;挑战集每项只有 10 个录制/场景;State Persistence 每方法仅 17–21 个事件且来自未校准裁判,只能看趋势;各方法长视频窗口衔接协议不同,测的是端到端保持而非隔离的内部记忆。我的补充观察:单场景事件数少使 ISR/LRA 方差偏大;gISR/gLRA 把行为分与 IoU 直接相乘,量纲语义有争议;11 个被评模型多为闭源商业或机构内部模型,结果难以独立归因;引擎事件记录的是编排执行而非经验证的物理因果(作者在 scope notes 中亦承认);单一引擎、七类场景对“游戏引擎”这一目标仍偏窄。
独立分析的弱点
第一,代理表示的信息缺口:彩色 OBB 只规定位置、尺度与朝向,不含外观,导致身份-外观绑错(62 例审计中 MiniMax-H3 换装 12 例)与面向渲染不稳(马背场景中 Seedance 把背对镜头的马渲染成面对镜头);改进方向是给代理加入轻量外观码或朝向嵌入。第二,代理泄漏:通用模型输出中残留线框、彩色盒子或人形轮廓(Figure 6),域内训练的 PWM 几乎没有;可在训练中加入泄漏负样本或解码端过滤。第三,长时程崩溃:10 秒后规定布局逐渐遗忘,离场实体几乎回不到规定位置(重现 IoU 0.05–0.13);需要跨窗口状态注入或分层世界记忆。第四,裁判可靠性:未校准的 VLM 裁判可能有系统偏差,应建人工标注校准集并报告裁判间一致性。第五,统计功效不足:170 个 episode、挑战集各 10 条,Table 5 等消融在 10 对样本上无显著性。第六,对闭源商业模型的依赖削弱可复现性与公平性。
未来方向
作者明确指出的方向:设计“便宜渲染但编码身份、朝向与关节”的更优代理表示,并称其为忠实渲染的直接杠杆——Table 5 已给出固定生成器下比较候选代理的协议;在强视频基座之上做面向事件保真、长时程记忆与身份绑定的定向训练(T6 的结论:通用基座加定向能力优于从头域训练);把多视角从独立生成走向联合一致生成。基于本文成果可自然延伸:把校准后的 ISR/LRA 用作可微奖励或强化学习信号,训练事件感知的渲染器;用可回放记录构造记忆检索型评测,把“实体离场-回归”变成世界模型记忆的天然探针;把数据引擎适配到 Unreal/Unity 等商用引擎以扩大场景域与物理复杂度;为事件记录增加碰撞、命中等物理因果验证,使“引擎真值”从编排执行升级为物理真值;以及研究多玩家在线场景中跨视角身份的显式约束解码或事后身份对齐。
复现评估
开源情况:代码与项目页公开(github.com/AlayaLab/PROWBench),数据引擎可扩展、episode 记录可回放、文本提示由确定性脚本生成,基准数据(170 个 episode、600 段代理视频、经校验的首帧与提示、时间戳事件标签)应可再生成,且框架明确支持新增场景与表示。但要完整复现论文排行并不容易:11 个被评模型中 MiniMax-H3、Seedance 2.5、LynnReal-Omni 等是商业 API,Cosmos-Transfer2.5、CWM、PWM 等为特定机构的模型,需要访问权限与 API 预算;评测管线依赖 SAM 3(实体分割)、Qwen3.6-27B(裁判)、ViPE(相机位姿恢复)等模型,各有可观算力需求;自建新场景还需要引擎级工程能力。总体评估:复现数据集与指标管线难度中等(工程量大但路径清晰、均有公开组件),完整复现全部 11 个方法的对比难度高,最可行的复现路径是用公开的引擎记录与指标代码对自己可访问的一两个模型做诊断性评测(如 Table 5 式的代理表示消融)。
论文图表
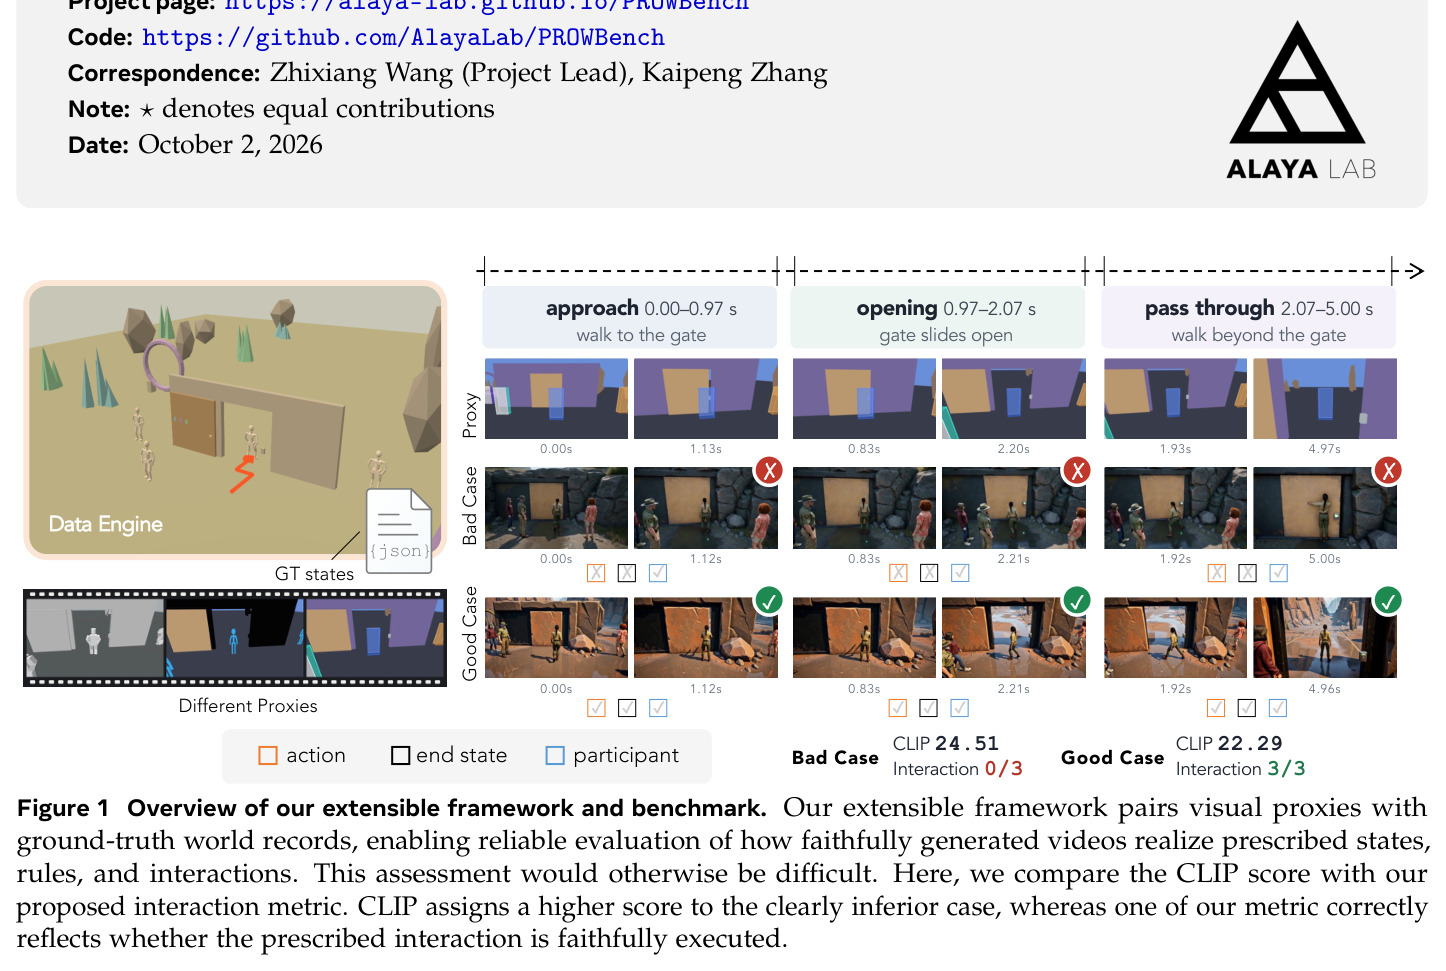
总览图:数据引擎从世界记录渲染带真值状态的代理输入,用“走向大门-门滑开-穿过大门”三阶段示例对比坏 case(三个阶段均未实现)与好 case(全部实现);右侧显示 CLIP 给坏 case 打 24.51 分反而高于好 case 的 22.29,而本文交互指标正确给出 0/3 对 3/3。
一图讲清整个基准的动机与方法:感知指标会奖励“看起来对”的视频,必须对照引擎记录逐事件判卷——这是理解全文的入口。
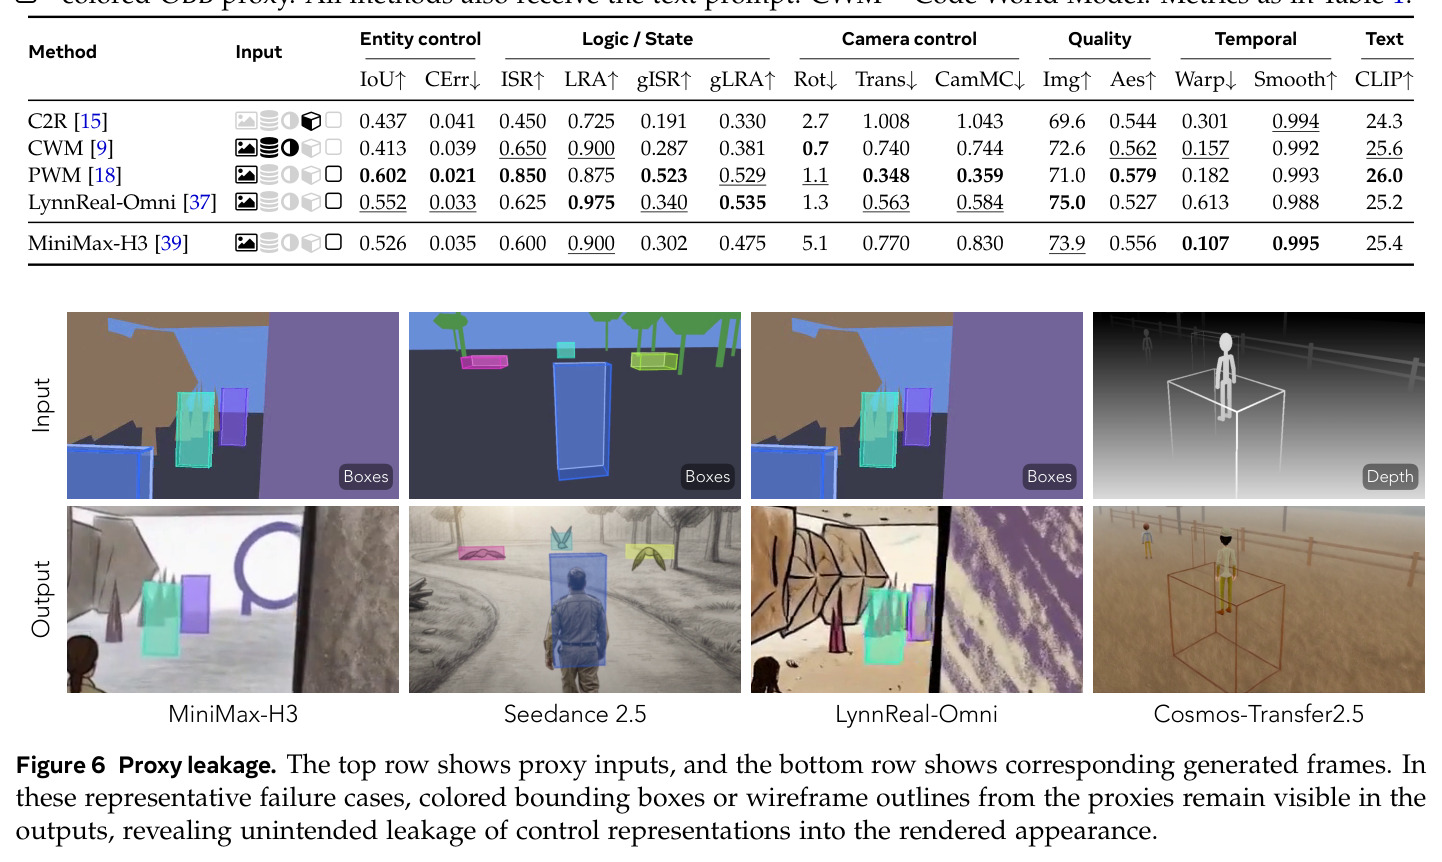
四个失败案例:上排是彩色包围盒或深度等代理输入,下排是各模型生成帧,可见 MiniMax-H3、Seedance 2.5、LynnReal-Omni、Cosmos-Transfer2.5 的输出中残留彩色盒子、线框或人形轮廓。
展示“输出过度忠于输入几何”这一典型失败模式,说明代理设计不仅关乎控制,还会泄漏进外观。
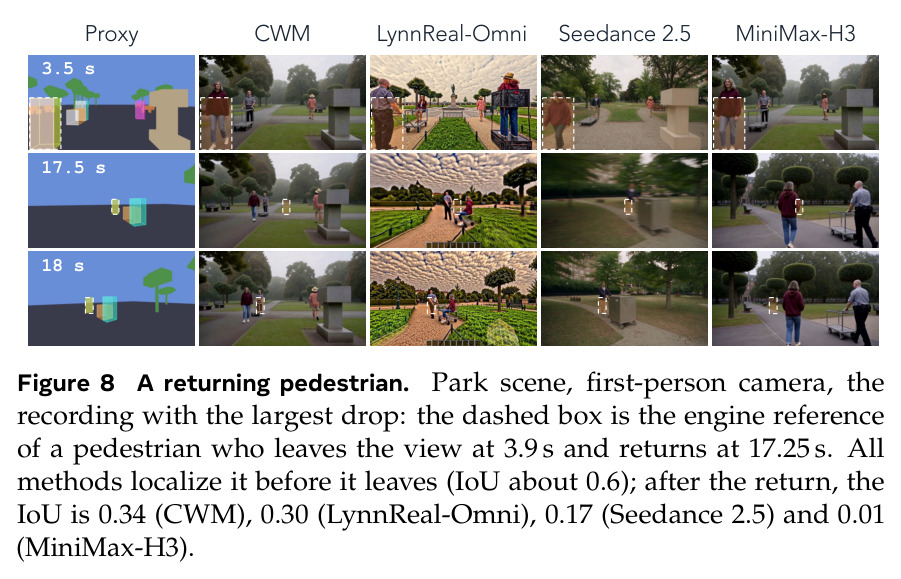
公园场景第一人称相机中一名行人 3.9 秒离场、17.25 秒回归:所有方法离场前定位良好(IoU 约 0.6),回归后 IoU 仅 0.34(CWM)、0.30(LynnReal-Omni)、0.17(Seedance 2.5)、0.01(MiniMax-H3)。
离场-回归是最苛刻的记忆探针:局部窗口内的跟随能力完全不能外推到长程缺席后的位置恢复。
10 个四人场景、每场景 4 个独立生成的同步跟随视角(每方法 40 段):外观合规 82.2–94.0%、跨视角一致 81.0–89.7%(有身份色/首帧的方法)对 C2R 的 32.2%/25.5%;MEt3R 几何一致性反而是 C2R 最好(0.397)。
揭示“几何一致不等于身份一致”这一多视角评测的关键洞见,支撑 T6 的多视角身份开放问题。
把 PROWBench 与 VBench、WorldScore、WorldModelBench、MIND、WorldArena、Omni-WorldBench、MemoBench、WorldMark、WBench、PlayWorld、TriWorldBench 逐一对照行为规范、状态/轨迹参考、任务/事件参考、可回放性、同步多视角与成对代理六个维度:只有 PROWBench 在回放与代理两列打勾。
用协议级对照精确划定本文与全部先前基准的差异,是理解“研究缺口”论证的最直接证据。
全部 170 个 case 的图库:每格显示 MiniMax-H3 输出在片段中点的画面,内嵌同瞬间的彩色 OBB 代理输入,按五个集合(Verified-FF 40、Unverified-FF 90、长时程 10、多视角 10、枪战 20)分组,FPP 标记第一人称。
让读者一眼看清数据规模、场景多样性与代理输入的实际形态,评估基准覆盖面的第一手材料。
多样性总览:第一/第三/多视角的示例帧,九类交互(搬运、交接、推车、推物、动物相遇、载具、闸门、游泳等)、七类场景域(城市、室内、自然、水上、空中、竞速、奇幻)与 0–30 秒长时程条带。
直观呈现基准在视角、交互类型、场景域与时长四个轴上的覆盖设计。
数据构成统计:人-人交互占 44.7%、人-动物 23.5% 等;写实风格 63.5%;城市 37.6%、室内 22.4%、自然 18.2% 等;相机路径长度中位 6.11 米、86.5% 第三人称、13.5% 第一人称。
给出评测集的精确分布,便于判断结论对哪些场景类型的外推有效性。
同一条城市街道跟随镜头下五方法对比:虚线为对向车(青)与前车(橙)的引擎参考框,代理条件模型把两车保持在框内(IoU 0.62–0.86),只给相机轨迹的 EchoWM 前车后退、对向车未完成会让(0.27 和 0.29)。
T1 的定性配对证据,把类均值差距落到具体实体轨迹上。
闸门场景逐事件判定:六个方法在接近、开门、穿过三个事件上的帧序列(白色虚框为引擎参考框)与 ISR/LRA/IoU 汇总;LingBot 2.0 演完全部三个动作(LRA 1.00)但漏掉第一事件的终态(ISR 0.67),EchoWM 两者均为 0。
最清晰地演示 ISR 与 LRA 两个新指标如何逐帧判定、以及二者为何必须同时存在。