SpatialScout:评估视觉语言模型智能体主动探索与物体级三维建图能力的基准 SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?
要求VLM智能体主动探索80个室内场景并构建物体级3D地图,最强模型平均IoU仅41.71%
前置知识
VLM 智能体与工具调用循环
视觉语言模型(VLM)是能同时处理图像与文本的大模型;VLM 智能体指模型处于一个反复调用的循环中:每次输出工具调用(如移动相机、拍照、提交坐标),环境执行后把结果(新图像、诊断信息)回传给模型,直到任务完成或预算耗尽。SpatialScout 中每回合限 100 次模型调用、100 张图像采集。
SpatialScout 的被评估对象正是这种智能体,理解“模型调用—工具执行—观测反馈”的回合结构是理解任务协议、预算设计与结果分析的前提。
相机内参、外参与坐标系变换
内参矩阵 $K$ 描述焦距与主点,把相机坐标系中的射线映射到像素平面;外参(位置 $o$ 与旋转 $R$)描述相机在参考坐标系中的位姿。本文任务坐标系固定于初始相机:$+x$ 为初始光轴前向、$+y$ 初始左、$+z$ 初始上,所有提交的三维坐标必须表达在该坐标系中。
目标中心的定义(论文式 1)、三角化工具的输入输出、坐标合法性校验全部建立在这套几何语言之上,不懂内外参就无法理解任务和评分。
多视图三角化(Triangulation)
同一物理点在两幅以上已知位姿的图像中各标记一个像素,每条像素反投影为三维空间中的一条视线;三角化求解与所有视线距离平方和最小的点:$\hat{p}=\arg\min_p \sum_k \Vert A_k(p-o_k)\Vert_2^2$,其中 $A_k = I - d_k d_k^\top$。残差与射线夹角可用来诊断对应点标记的质量。
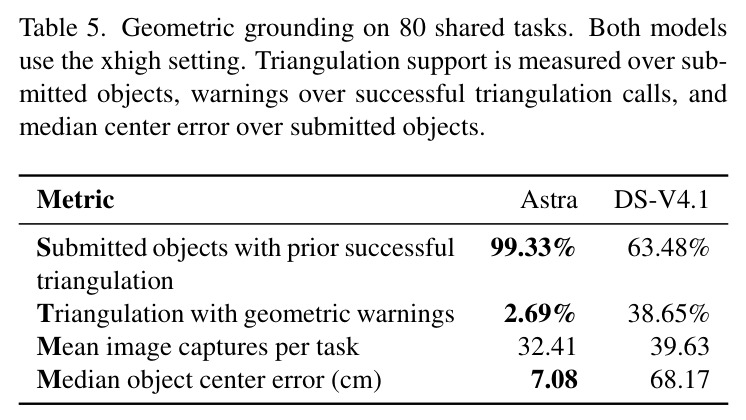
三角化是基准提供给智能体的核心几何辅助工具,模型的定位精度和论文中的失败归因分析(如 Table 5 的 Astra 与 DeepSeek 对比)都围绕它展开。
3D IoU 与物体尺度敏感性
交并比(IoU)衡量两个包围盒的重叠程度。本文做法特殊:把候选目标的参考 AABB 包围盒平移到预测中心后再计算 IoU,因此分数只反映预测中心相对物体尺度的偏移。要达到 IoU>0.9,位移必须小于 $\ell/19$(约轴长的 5.26%),对最短边 1 cm 的小物体相当于约 0.526 mm 的容差。
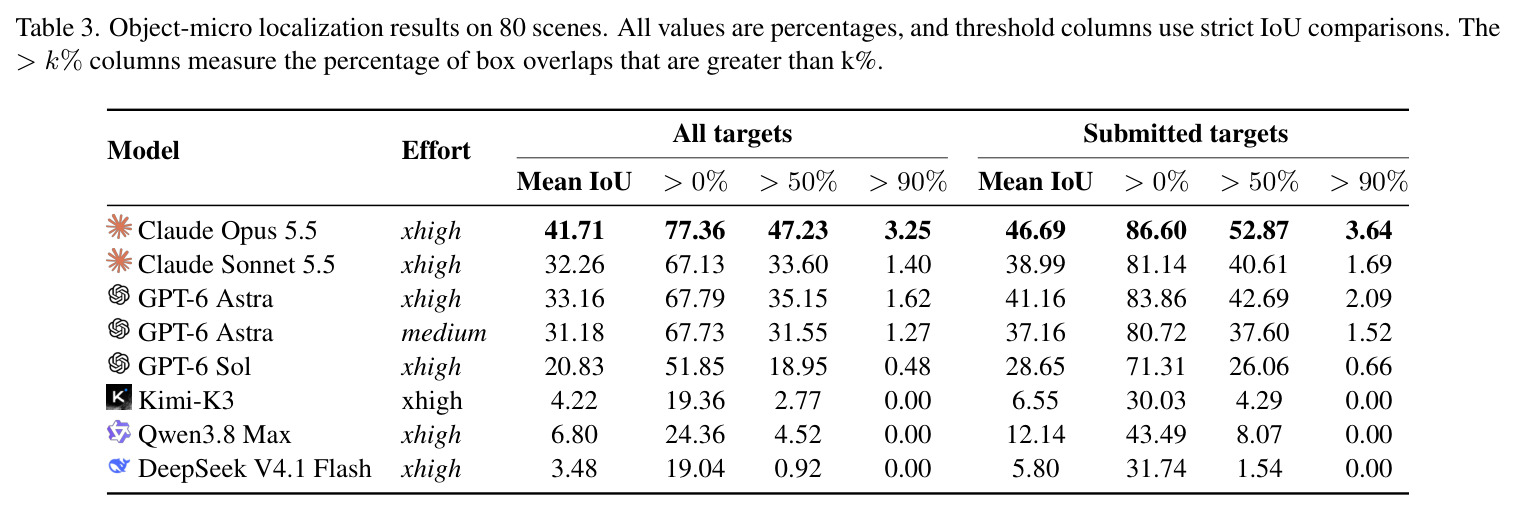
主结果表(Table 3)的全部指标(Mean IoU、>0%、>50%、>90%)都基于这个 object-scale IoU,它是读懂实验结论的关键。
主动感知与下一最优视角(NBV)
主动感知指智能体自主决定“在哪里看、何时看、看多少”,以最大化信息获取效率;下一最优视角规划是三维重建中的经典问题,SCONE、ActiveSplat、FisherRF 等系统用表面覆盖增益或信息增益来选视角,但它们是专门化规划器。
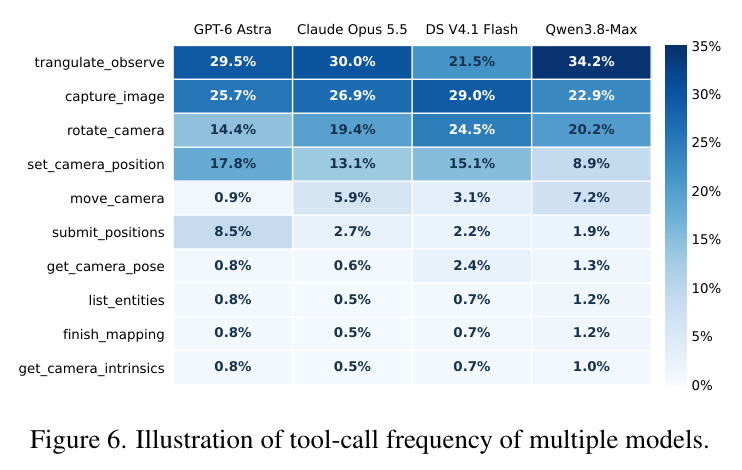
SpatialScout 把这类视角规划交给通用 VLM 完成,这是它与被动问答基准的本质区别,也是论文 Figure 5 工具调用行为分析的背景。
研究动机
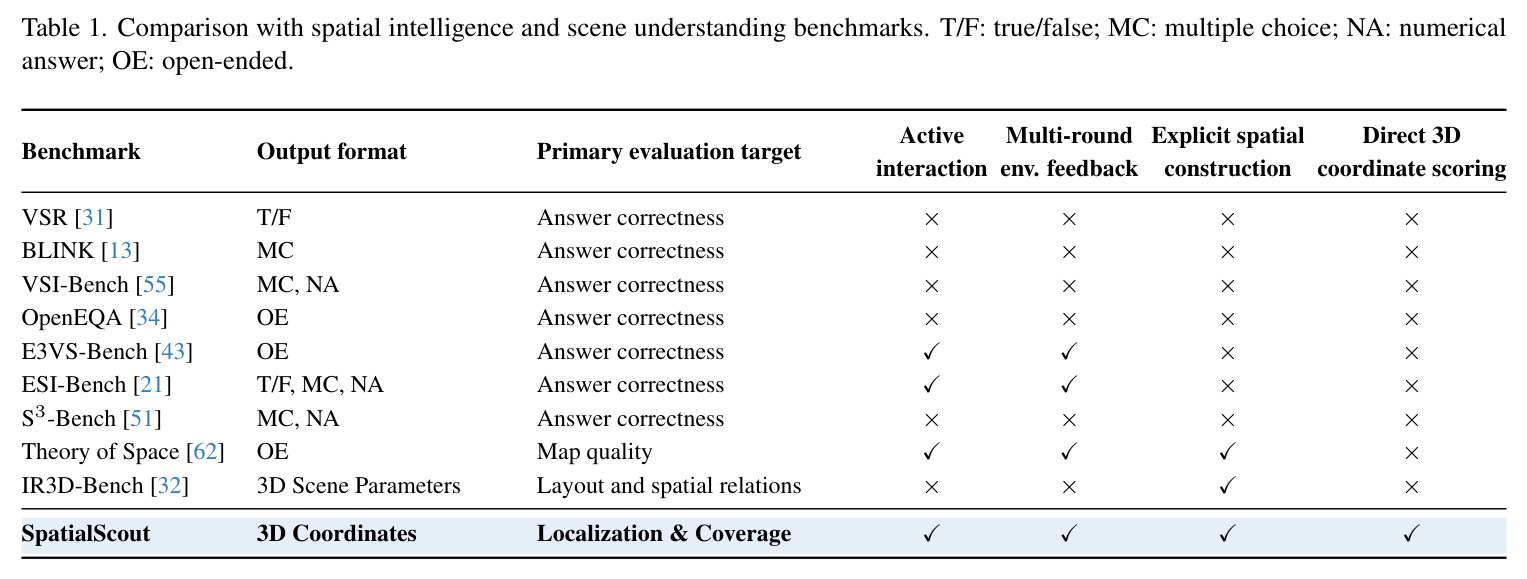
现有空间智能评估几乎全部采用图像/视频问答范式:VSR、BLINK、VSI-Bench、OpenEQA 等基准让模型回答计数、方向、距离或空间关系题,以答案正确性计分。这种范式存在两个结构性缺陷。第一,答案正确性对空间理解只有弱约束:有限选项允许模型通过猜测或排除法答对,答案分布中的语言先验也可能让模型借助非空间线索得分,视觉证据的作用被稀释。第二,它与真实需求脱节:具身智能体必须自主决定观察什么、何时观察,把跨视角证据融合为一致的 3D 表征,再用它指导后续行动,而单轮问答无法考察这条多步闭环。后续工作虽在逼近——E3VS-Bench 与 ESI-Bench 引入了主动交互,S3-Bench 结合流式记忆,Theory of Space 研究离散认知地图的构建——但它们的最终产物仍是答案或离散地图,没有一个要求模型在连续度量坐标系中输出精确的三维物体中心。于是“模型能答对空间选择题”与“模型能建出可用的度量地图”之间的差距一直无法被量化,前沿模型在 QA 榜单上的高分掩盖了这一鸿沟。
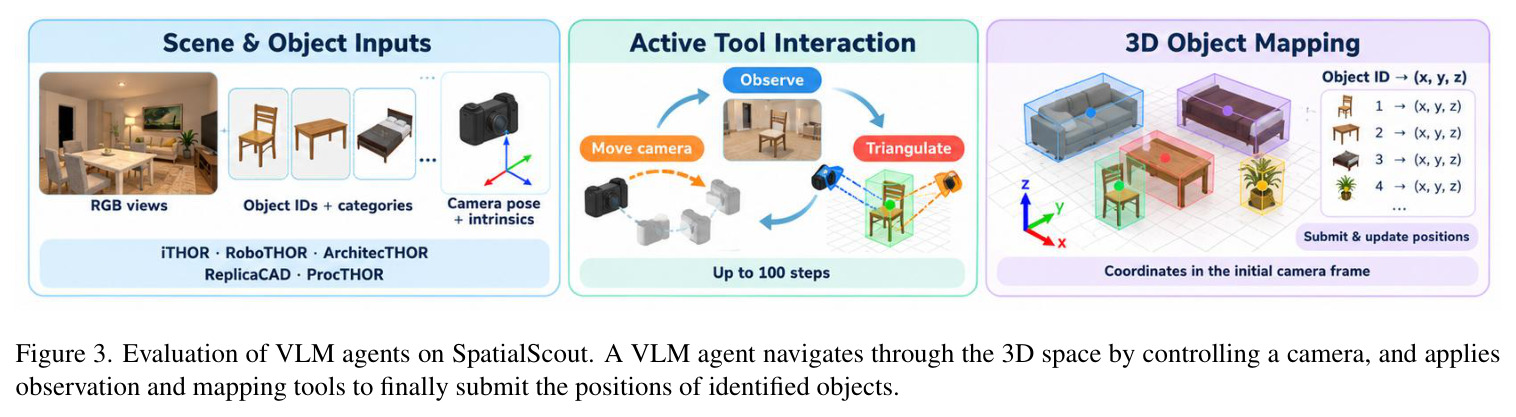
本文的目标是本文的具体目标是构建 SpatialScout:一个把“主动交互下的物体级三维建图”作为直接评估对象的基准。任务设定为:给定目标物体清单(实例 ID、类别、等价组)、相机内外参与一张初始 RGB 观测,VLM 智能体需在 100 次模型调用、100 张图像采集的预算内,自主控制虚拟相机探索 80 个室内场景之一,跨视角关联物体,估计每个目标渲染几何包围盒中心的三维坐标,并提交到以初始相机为原点的共享任务坐标系。评估不再看答案对错,而是联合度量定位精度与目标覆盖率:等价组内最小距离一对一匹配后的中心误差(米)、覆盖率,以及物体尺度敏感的 3D IoU(阈值 0/0.5/0.9,缺失目标计零分)。基准还记录每次提交的地图快照,支持离线回放空间表征随探索推进的演化。作者希望借此量化前沿模型“从局部观测构建完整精确度量地图”的能力缺口,为主动感知、跨视图推理与持久空间记忆研究提供统一测试床。
与已有工作不同的是,本文的独特切入是把三种此前分散的能力耦合进单个闭环任务,并让中间产物可被几何评分。其一,显式空间构建:模型必须输出一组三维坐标而非选项,使空间表征质量能被 IoU 与中心误差定量评估。其二,闭环主动探索:当前的空间估计决定下一步观察什么,所选视角又塑造之后可用的证据,形成“感知—表征—决策”的反馈回路,这超出短思维链问答的考察范围。其三,长时程端到端:单回合内需持续协调观察规划、物体识别、跨视图关联、几何估计与地图修订,以最终地图质量计分。与最接近的工作相比:ESI-Bench、E3VS-Bench 仍以答案正确性为目标;Theory of Space 构建的是离散认知地图;IR3D-Bench 考察给定图像的逆图形学重建,不需要自主获取新证据;而 SCONE、ActiveSplat 等主动重建系统是专门规划器而非通用智能体。SpatialScout 填补了“通用 VLM 智能体在共享工具与显式预算下主动构建度量地图”的空白,并通过统一接口与多口径指标支持对失败模式的归因。
核心方法
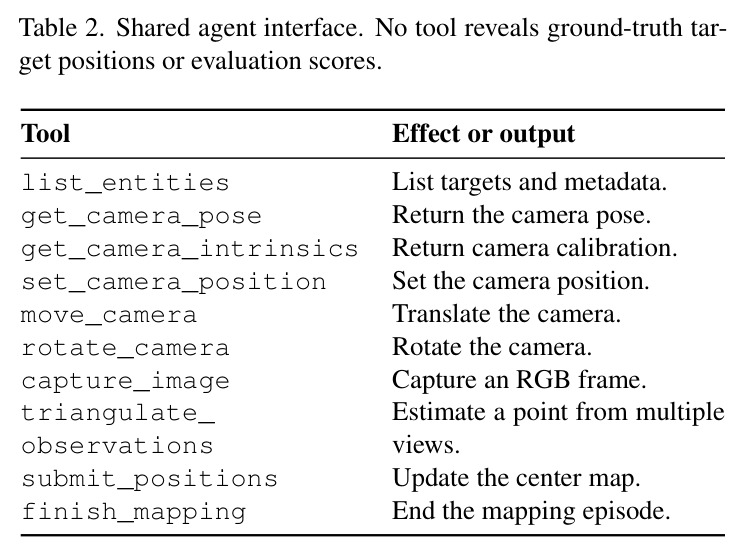
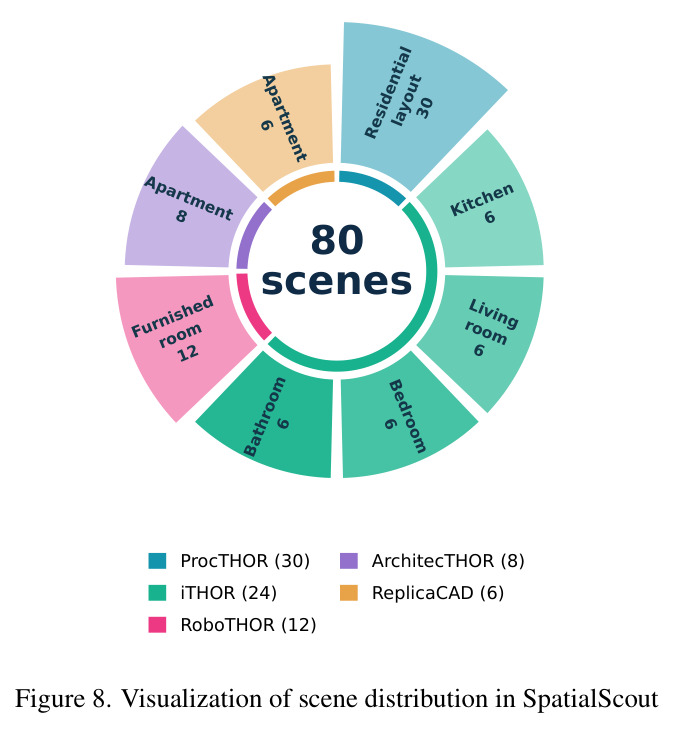
从直觉上看,SpatialScout 把“派一个机器人拿着相机进陌生房间清点家具,并绘制每件家具三维中心的地图”抽象成纯视觉—几何任务,交给 VLM 智能体完成。技术路线分三部分。场景构建:基于 SAPIEN 与 ManiSkill3 渲染 80 个室内场景(ProcTHOR 30、iTHOR 24、RoboTHOR 12、ArchitecTHOR 8、ReplicaCAD 6),共 3,140 个目标,每景 30–40 个,区域半径 1.95–9.23 m,约四成目标(1,489 个)属于同场景多实例等价组;目标中心定义为渲染几何紧致世界轴对齐包围盒(AABB)中点。交互接口:10 个共享工具覆盖实体清单、位姿/内参查询、相机控制、显式拍照、多视图三角化、批量提交与结束制图(Table 2);图像以 512×512 渲染、最长边 384 像素 JPEG 下发。评估协议:每回合 $B=100$ 次模型调用、$V=100$ 张图像(含初始图),调用 finish_mapping 或预算耗尽时冻结地图打分。七个前沿模型在相同 80 景上各跑一回合。
核心设计是把“物体级度量地图”设为唯一评估产物,并让评分在几何上严格且可归因。评分比较每个等价组内预测位置与参考中心的多重集:先做组内最小总欧氏距离的一对一匹配,得到中心误差与覆盖率;再对每个匹配对,把候选目标的参考包围盒平移到预测中心计算 3D IoU,参考边下限 $\epsilon=0.01$ m。这一“平移框”打分使 IoU 只取决于预测中心相对物体尺度的偏差:要达到 IoU>0.9,位移必须小于 $\ell/19\approx 5.26\%$ 轴长,对 1 cm 最短边物体约为 0.526 mm——这与问答正确性或布局级评分有本质区别。第二,“所有目标”口径下缺失计零分,并辅以可配置的遗漏惩罚 $\mathcal{L}_{scene}=\frac{\sum_{i=1}^{M} e_i+\lambda(N-M)}{N}$(默认 $\lambda=5$ m),空地图损失恰为 $\lambda$,迫使模型不能只提交有把握的子集。第三,回合制允许反复提交修订,每次成功提交都保存完整地图快照,可离线回放误差与覆盖率随调用数、图像数的演化,把“构建”与“修订”两个环节都纳入考核。
方法步骤详情
流程如下。输入:初始 RGB、实体清单 $E=\{(i,c_i,g_i)\}$、相机内外参、以初始相机为原点的任务坐标系与半径 $r=\max_i\Vert p_i\Vert_2$;参考中心为 $p_i=R_0^\top\left(\frac{b_i^-+b_i^+}{2}-o_0\right)$。第一步,list_entities 与标定工具获取元信息。第二步,探索采图:move_camera 平移、rotate_camera 旋转、set_camera_position 传送,capture_image 采 384 像素 JPEG。第三步,几何估计:对同一物理特征在至少两帧上标记原始网格像素,调 triangulate_observations 求解 $\hat{p}_{tri}=\arg\min_p\sum_k\Vert A_k(p-o_k)\Vert_2^2$;工具做几何校验并可能返回警告。第四步,submit_positions 批量提交/修订,校验通过后替换该 ID 估计并返回当前地图。最后 finish_mapping 冻结。提示要求看过两个视图后即开始提交并持续修订。
技术新颖性
技术新颖性有四点。其一,评估产物从“答案”变为连续坐标多重集,等价组机制化解重复实例的 ID 歧义——组内 ID 可互换,评分对提交顺序鲁棒,字典序平局处理保证可复现。其二,object-scale IoU(参考框平移到预测中心)把定位质量标准化为相对物体尺度的量,自动加重小物体放偏的惩罚,补全了米制中心误差。其三,遗漏惩罚 $\lambda$ 可配置且与主指标解耦:主表指标独立于 $\lambda$,作者用地图回放在 $\lambda\in\{1,2,5,10\}$ m 下重打分,分开“报告权衡”与“预测变化”。其四,过程诊断设施:每次提交保存快照支持离线回放;三角化输出残差与射线夹角诊断,为失败归因提供抓手——据此发现 GPT-6 Astra 99.33% 提交有成功三角化支撑而 DeepSeek 仅 63.48%。相比主动问答基准与 SCONE、AREA3D 等专用重建系统,它首次在共享工具与显式预算下比较通用 VLM 的度量建图能力,并用无 RGB 基线校准难度:全零策略场景宏损失 3.113 m,随机球策略 4.701 m。
实验结果
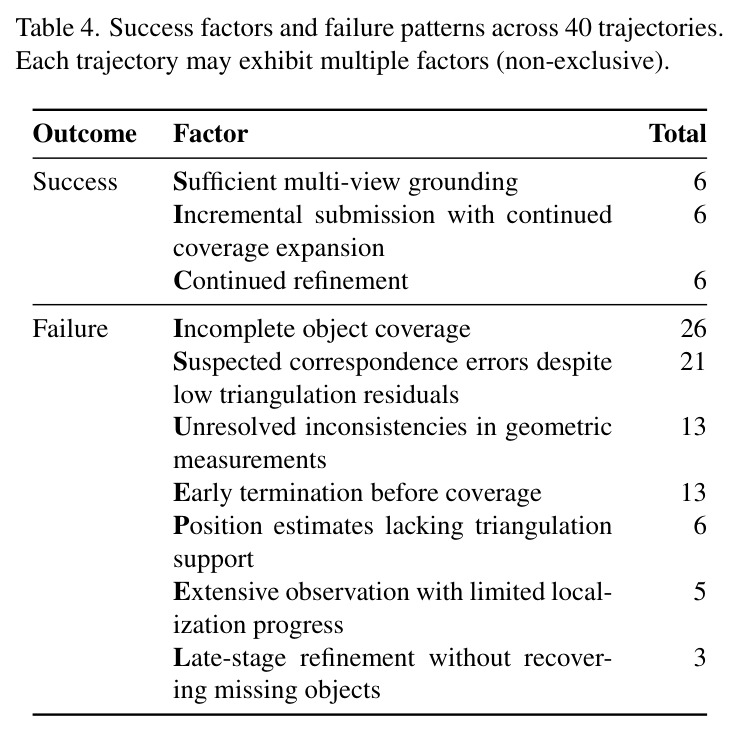
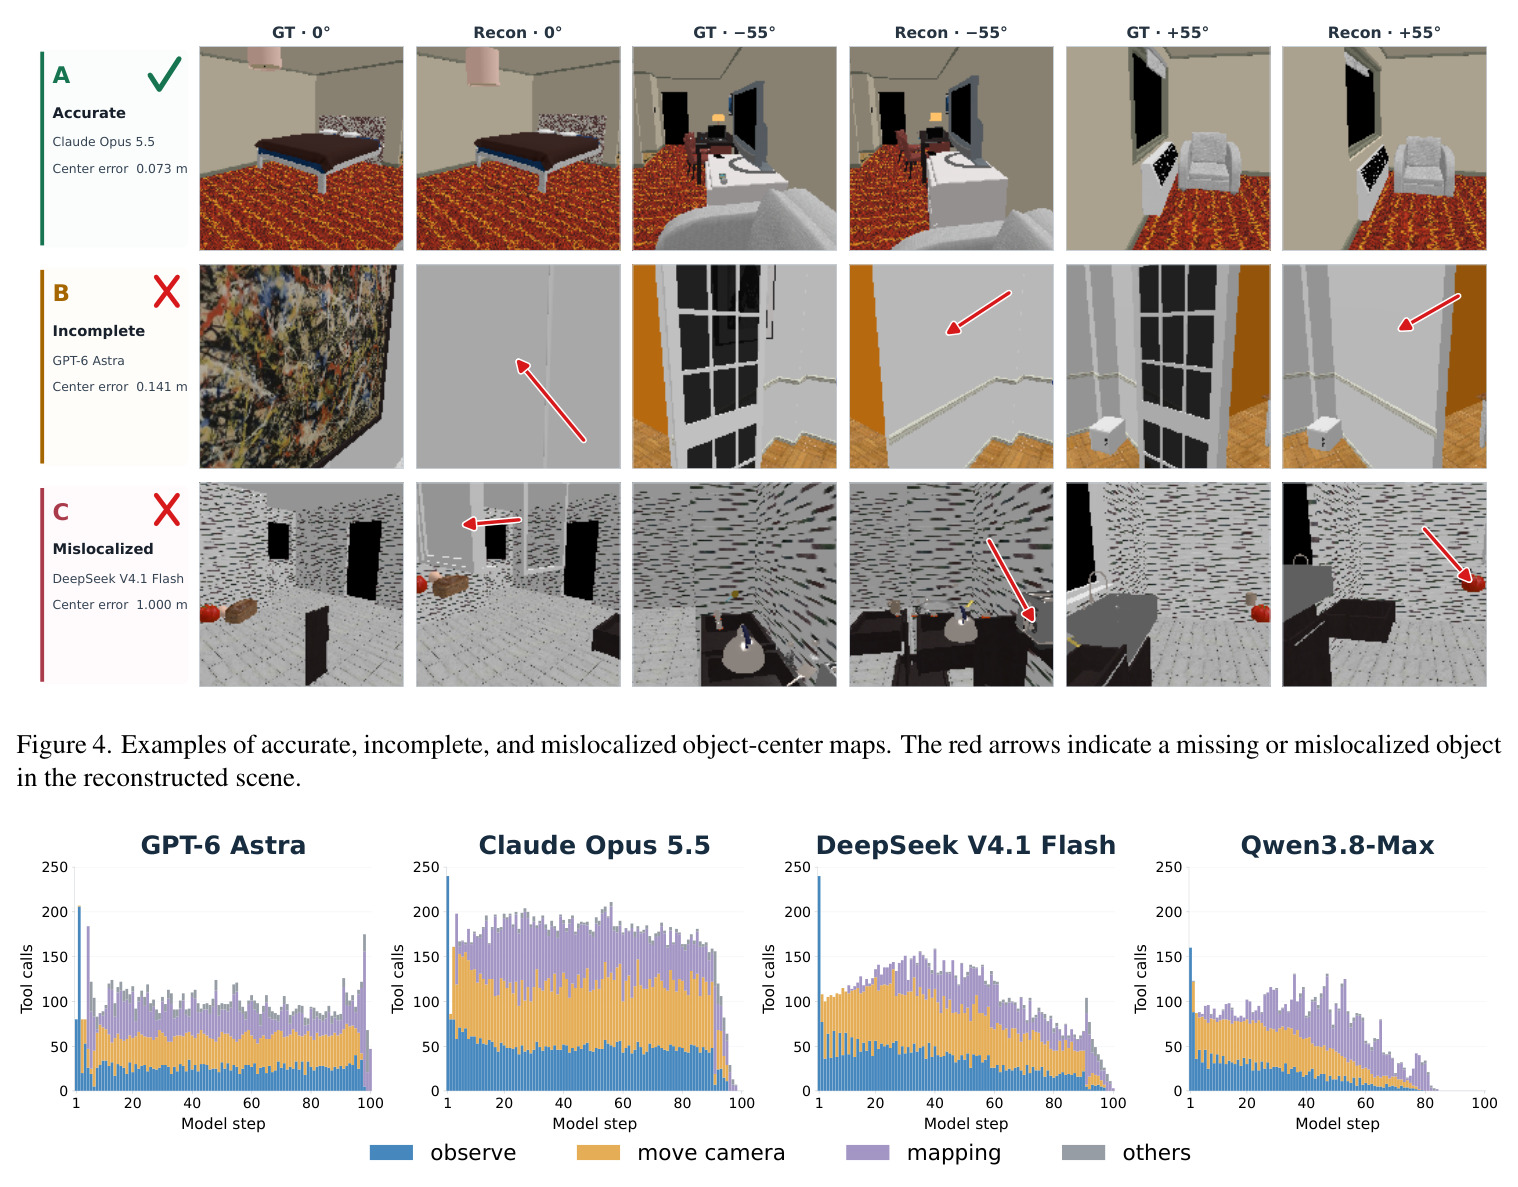
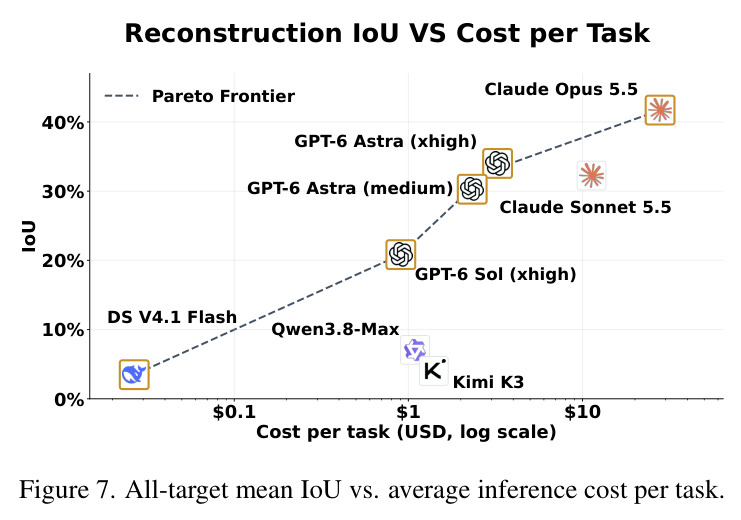
核心发现:模型能恢复粗略布局,但覆盖与精度不足。主实验(Table 3):Claude Opus 5.5 全目标平均 IoU 41.71%,47.23% 目标超过 IoU 0.5,3.25% 超过 0.9,已提交口径 46.69%。GPT-6 Astra 为 33.16%;开源模型:Qwen3.8-Max 6.80%、Kimi-K3 4.22%、DeepSeek-V4.1-Flash 3.48%。Figure 4 三例:Opus 5.5 全提交 35 目标、误差 0.073 m;GPT-6 Astra 只提交 80 目标中的 65 个;DeepSeek 全提交但误差 1.000 m。Table 4 的 40 条轨迹仅 6 条达标(覆盖率 ≥90%、误差 ≤0.2 m),主因覆盖不全(26 例)与对应错误(21 例)。Table 5 对照:Astra 与 DeepSeek 调用量相近,但前者 99.33% 提交有成功三角化支撑、中位误差 7.08 cm,后者为 63.48%、68.17 cm。Opus 5.5 最贵,28.85 美元/任务(Figure 7)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 物体级 3D 建图(80 场景、3,140 个全部目标) | 全目标平均 IoU | Claude Opus 5.5:41.71% | GPT-6 Astra:33.16%(次优);开源最高 Qwen3.8-Max:6.80% | 领先次优 +8.55 个百分点,约为开源最高的 6.1 倍 |
| 中等精度定位(全部目标) | IoU>0.5 召回率 | Claude Opus 5.5:47.23% | GPT-6 Astra:35.15% | +12.08 个百分点 |
| 高精度定位(全部目标) | IoU>0.9 召回率 | Claude Opus 5.5:3.25% | GPT-6 Astra:1.62% | +1.63 个百分点,但绝对值极低,说明精细定位普遍失败 |
| 跨视图三角化质量(已提交目标) | 中位中心误差 | GPT-6 Astra:7.08 cm | DeepSeek-V4.1-Flash:68.17 cm | 误差降低约 9.6 倍(几何警告率 2.69% 对 38.65%) |
| 无 RGB 基线校准(场景宏全场景损失) | L_scene(米,λ=5 m) | origin 全零策略:3.113 m | 均匀球随机策略:4.701 m | 随机提交比全零更差,说明不加视觉证据的盲目提交有害 |
| 精度—成本权衡 | 全目标平均 IoU / 每任务推理成本 | Claude Opus 5.5:41.71% @ 28.85 USD/任务 | GPT-6 Astra:33.16% @ 明显更低成本 | Opus 精度最高但成本最高;开源模型(Qwen、Kimi)更贵且更差,仅 DeepSeek 比 GPT-6 Sol 便宜 |
局限与改进
作者在附录 C 承认:基准依赖物理仿真引擎生成的数据,可能无法完全捕捉真实世界的复杂性与多样性,并承诺一个月内发布真实场景数据集。我的补充观察:第一,目标定义为渲染几何 AABB 中点,对细长或亚厘米级物体过苛——IoU>0.9 在 1 cm 最短边上等价于约 0.526 mm 容差,而图像下采样到 384 像素 JPEG 后单个像素对应的物距远超此值,部分目标在感知上近乎不可达,可能混淆“感知极限”与“推理能力”;第二,预算固定为 100 次调用与 100 张图像,未系统刻画预算—性能曲线,也未研究自适应停止策略;第三,主表为每模型单次运行,未报告方差或置信区间,41.71% 对 33.16% 差距虽大,但 xhigh 与 medium 间约 2 个百分点的小差异稳健性存疑;第四,约 6.7%(210/3,140)目标因最短边小于 1 cm 需正则化(边下限 0.01 m),评分引入近似;第五,三角化工具要求精确标记原始网格像素,接口可能系统性偏好精细指代能力强的模型;第六,场景均为静态、光照均匀的室内环境,无动态物体与真实材质。
独立分析的弱点
独立分析的弱点及改进方向。第一,仿真到现实鸿沟:SAPIEN/THOR 系场景光照均匀、材质干净、摆放规整,真实家庭中的镜面、玻璃、杂乱堆积会显著降低跨视图关联成功率,应尽快纳入真实扫描与实拍数据并报告域间落差。第二,小物体评分不可达:6.7% 目标最短边小于 1 cm,IoU>0.9 需毫米级定位,超出 384 像素 JPEG 的信息极限,应对小物体改用相对误差分级或按尺度分桶报告,避免其稀释总分。第三,接口偏好性:triangulate_observations 要求手动标记像素,测量的部分是“像素级指代能力”而非纯空间推理,可提供基于分割或跟踪的自动对应点作为对照接口,分离两种能力。第四,成功判据(覆盖率 ≥90% 且误差 ≤0.2 m)只用于小样本案例分析,主指标阈值 0/0.5/0.9 粒度较粗,可补充覆盖—精度连续曲线。第五,缺乏人类基线:同一接口下人类能达到什么水平无从知晓,任务难度标定不完整。第六,每模型单回合、无温度或种子方差报告,40 条轨迹只覆盖 4 个模型 10 个任务,行为学结论的外推性有限,应扩大轨迹样本并报告多次运行统计。
未来方向
作者明确提出的方向:一个月内发布真实世界场景数据集,并欢迎各类合作。基于该基准的成果还可延伸:其一,把 SpatialScout 的可验证几何奖励用于强化学习训练 VLM 的主动感知——每次提交的 IoU 与覆盖率就是天然奖励,有望像 SWE-bench 之于代码智能体那样推动空间智能体的后训练;其二,引入 DUSt3R、VGGT 等前馈几何模型作为智能体可调用的工具,研究“通用 VLM + 专用几何工具”组合的性能上限,并结合三角化诊断信息设计更可靠的工作流;其三,自适应停止与预算分配:借鉴 Explore until Confident 的思路,研究何时停止探索、何时精化已有估计,逼近 Figure 7 的帕累托前沿;其四,把地图从物体中心扩展到朝向、尺寸、语义关系与开放词汇场景图,对接 ConceptGraphs、ConceptFusion 一系工作;其五,跨回合持久空间记忆:多房间、多会话的增量建图与地图修订,考察 3D-Mem 式记忆机制在通用 VLM 上的可行性;其六,与具身操作闭环:将建图输出直接用于抓取、导航等下游任务评估,验证度量地图质量对下游成功率的预测力。
复现评估
复现条件较好,但全量复现主表有成本门槛。开源情况:代码在 GitHub 公开(JesseZZZZZ/SpatialScout),协议附录极其详尽——场景准备固定 seed 0、512×512 渲染、CPU 仿真与渲染、JPEG quality 82,用 SHA-256 指纹缓存并校验源配置、代码与资产树;每次尝试记录模型标识、推理配置、完整提示与工具模式;评分完全确定性(字典序排序消除平局歧义),附录 B 给出全部公式(三角化正规方程、IoU 解析式、遗漏惩罚)。数据:80 个场景经 ManiSkill3/SAPIEN 自动渲染,无需人工标注。算力:仿真渲染 CPU 即可,无 GPU 训练需求。成本:复现打分、地图回放与无 RGB 基线几乎零成本;但复现主表需调用 7 个前沿商业 API,仅 Claude Opus 5.5 单任务 28.85 美元、80 景约 2,300 美元,全部模型粗估上万美元及相应 API 权限。总体难度中等:本地工程复现与二次开发(换模型、改预算)门槛低,完整复现主表需要可观 API 预算。
论文图表
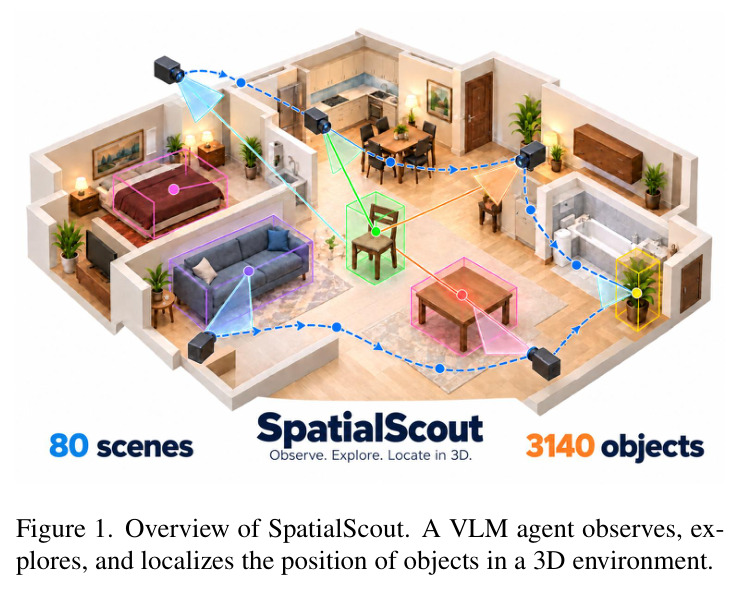
总览示意图:VLM 智能体在三维室内环境中通过控制相机进行观察与探索,跨视角定位目标物体,并逐步构建物体级 3D 中心地图。
一图看懂整个基准在做什么:输入是场景与清单,输出是 3D 坐标地图,中间是主动探索闭环。
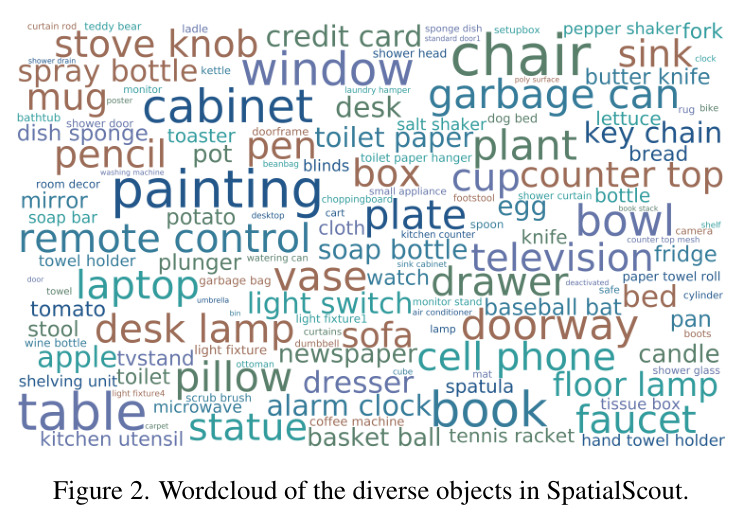
目标物体类别的词云图,直观展示 3,140 个目标覆盖椅、桌、植物、柜、门、窗等多样室内类别。
展示物体类别的多样性,说明任务涉及的识别与关联难度。
80 个场景的来源与房间类型分布:ProcTHOR 30、iTHOR 24、RoboTHOR 12、ArchitecTHOR 8、ReplicaCAD 6;房间类型涵盖客厅、厨房、卧室、浴室及公寓/住宅布局。
说明场景多样性与来源构成,支撑基准覆盖度的论证。
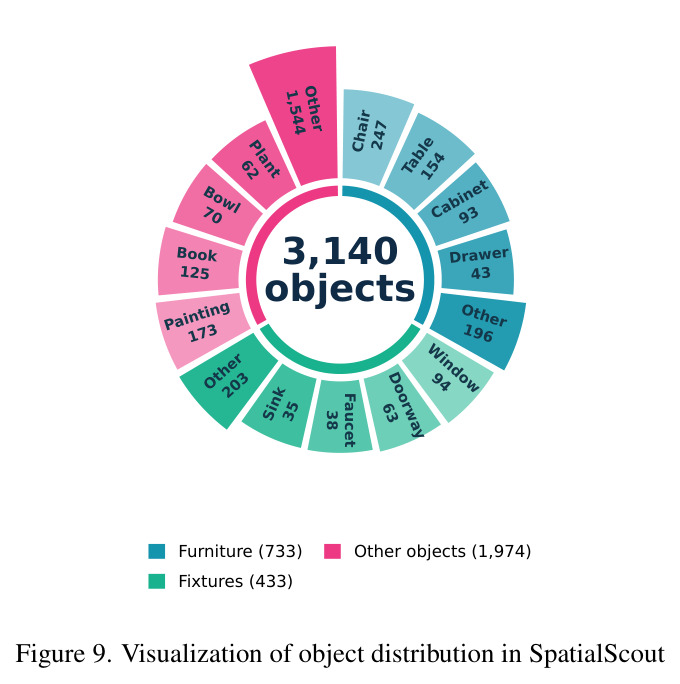
3,140 个目标物体的类别分布统计:家具 733、其他物体 1,974、固定装置 433 等,最大类别为椅(247)、桌(154)、柜(93)等。
展示物体类别与数量构成,说明等价组(重复实例)带来的关联挑战。
默认评估(B=V=100)下提供给建图智能体的完整任务提示词:包括坐标系定义、AABB 中心约定、像素网格换算规则、等价组说明、提交与结束流程、预算说明等。
保证评测透明与可复现,也说明模型收到的确切指令边界(如禁止为遮挡物体编造位置)。
提供给智能体的 10 个工具的完整参数模式与行为说明:get_camera_pose、get_camera_intrinsics、set_camera_position、move_camera、rotate_camera、capture_image、list_entities、triangulate_observations、submit_positions、finish_mapping。
定义了智能体可用的全部动作空间,是理解工具调用行为分析(Figure 5/6)的基础。