DeOverlay:视频叠加文字去除的基准与源锚定流模型 DeOverlay: A Benchmark and Source-Anchored Flow for Video Overlay Removal
从源隐变量出发的流匹配模型,把视频文字去除变成迭代修正,并发布1631段配对基准。
前置知识
流匹配与修正流
一类生成建模框架:不预测噪声,而是学习速度场 $v_\theta$,把样本沿路径从一端输运到另一端。修正流(rectified flow)用直线路径连接两端,目标速度是端点之差,推理时 Euler 步进求解。本文把「源视频隐变量」与「干净视频隐变量」设为路径两端,目标速度 $v^* = a - z_c$。
DeOverlay 的训练目标(式 1–2)与推理更新(式 6)完全建立在流匹配框架上,不懂这套语言就读不懂方法章节。
隐空间扩散与 VAE
VAE 把像素视频压缩到低维隐空间 $z\in\mathbb{R}^{C\times T_\ell\times H_\ell\times W_\ell}$,生成模型在隐空间上操作以大幅节省算力,最后由解码器 $D$ 还原为像素。本文的源初始化、流路径构造与加性条件全部发生在隐空间。
论文中 $z_s$、$z_c$、$E(\cdot)$、$D(\cdot)$ 等符号,以及掩码插值到隐网格的处理,都以这一设置为前提。
视频扩散 Transformer(DiT)
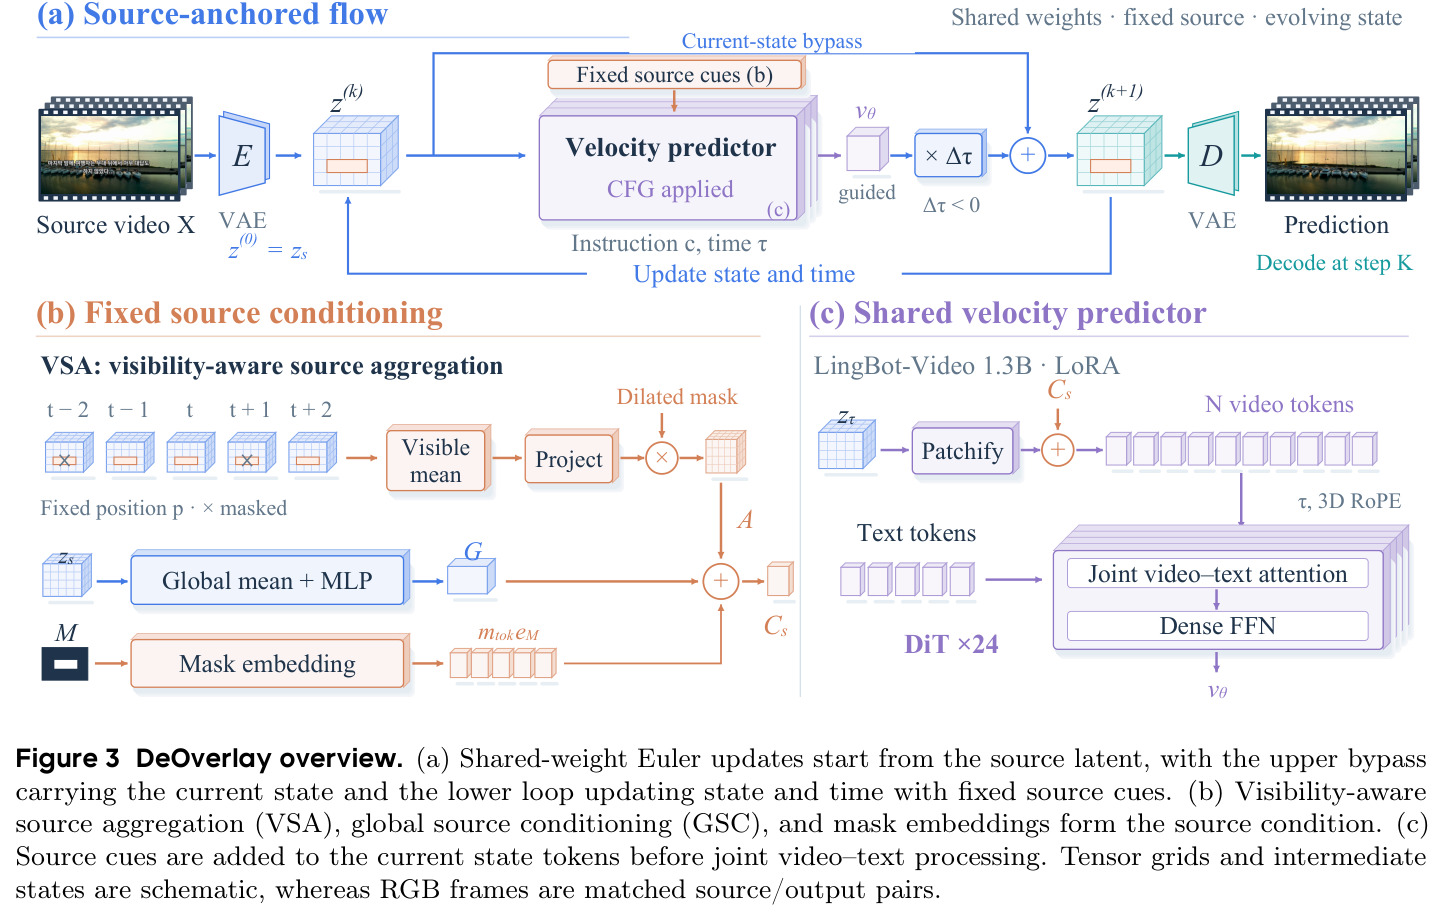
把视频按 patch 化成 token 序列,用 Transformer 配 3D RoPE 做时空与文本的联合注意力,是当前视频生成/编辑的主流骨干。本文采用 LingBot-Video 1.3B 稠密模型(24 层 DiT),每步约处理 13,346 个视频 token。
理解「N 个视频 token」「序列拼接翻倍到 2N」「加性条件不增加序列长度」等效率论证的基础。
LoRA 低秩适配
冻结预训练权重,只训练附加的低秩增量矩阵,用极少参数完成领域适配。本文用 rank-256 的 LoRA 适配 1.3B 骨干,同时直接训练 patch embedding 与源引导模块,并冻结 VAE 与文本编码器。
决定了训练开销与复现所需算力,也是理解「共享权重 + LoRA」实验设置的关键。
无分类器引导(CFG)
训练时以一定概率丢弃条件,推理时用 $v = v_{uncond} + g\,(v_{cond}-v_{uncond})$ 外推增强条件影响。本文取 $g=2$,每步需两次网络评估,$K=6$ 步共 12 次前向。
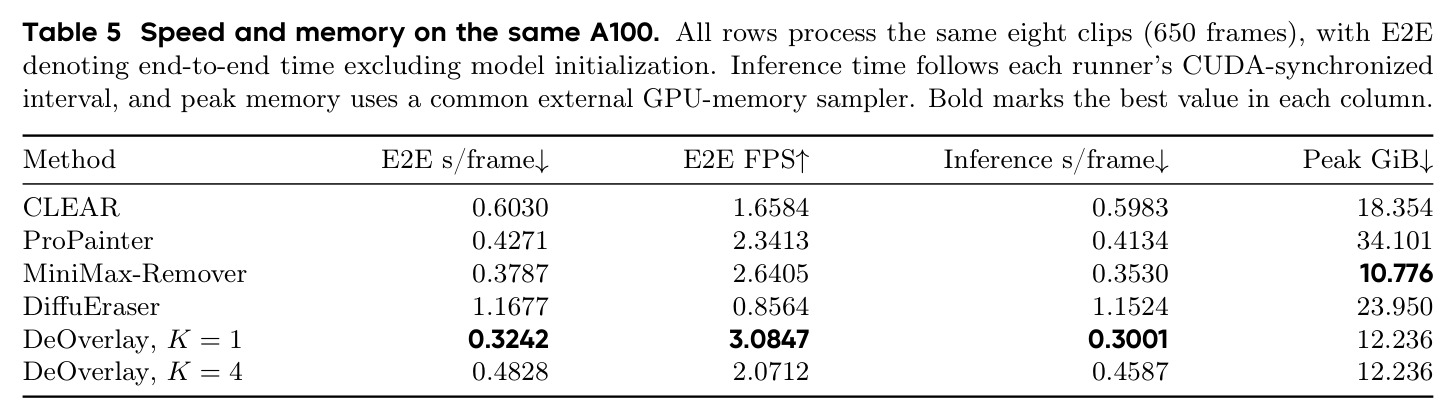
直接决定推理成本核算(Table 4/5 的时延与 FPS),也是「每步计算翻倍」这一弱点的来源。
感知质量指标 LPIPS/DISTS/VFID
LPIPS 与 DISTS 用深度网络特征比较图像感知差异,比 PSNR 更贴近人眼判断;VFID 是视频版 FID,在特征分布层面衡量生成视频与真实目标的距离。数值均越低越好,本文在掩码区域上计算这些指标。
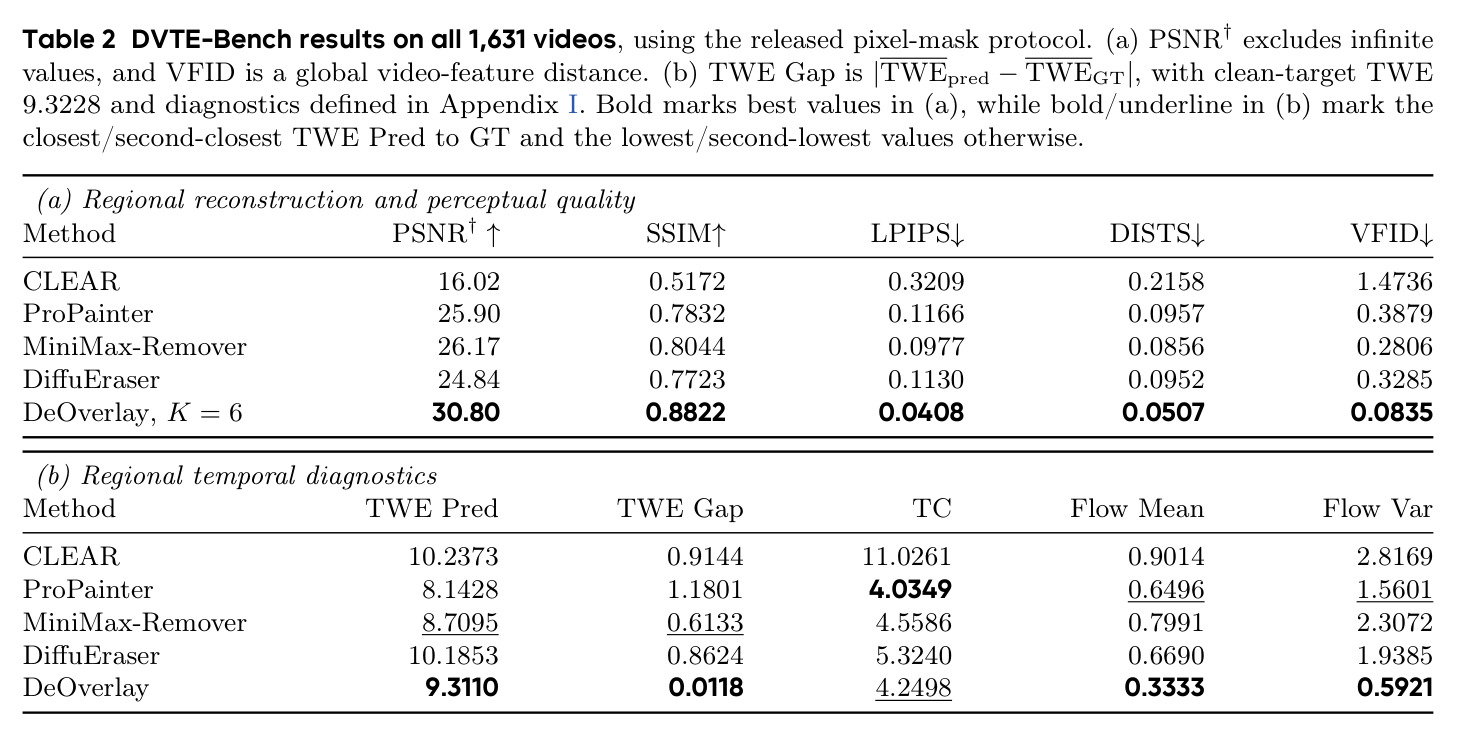
Table 2 的核心结论(LPIPS 降 58.3%、VFID 降 70.3%)全部建立在对这些指标的正确解读上。
研究动机
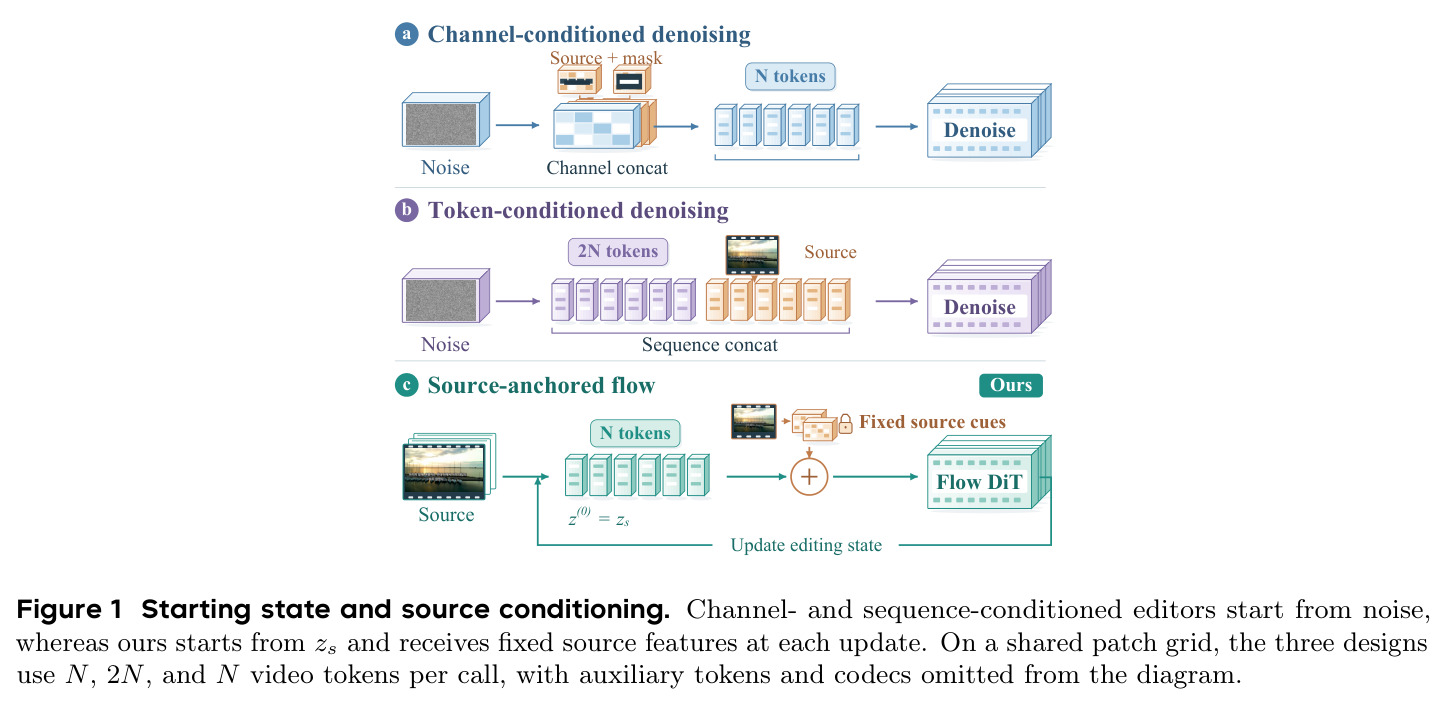
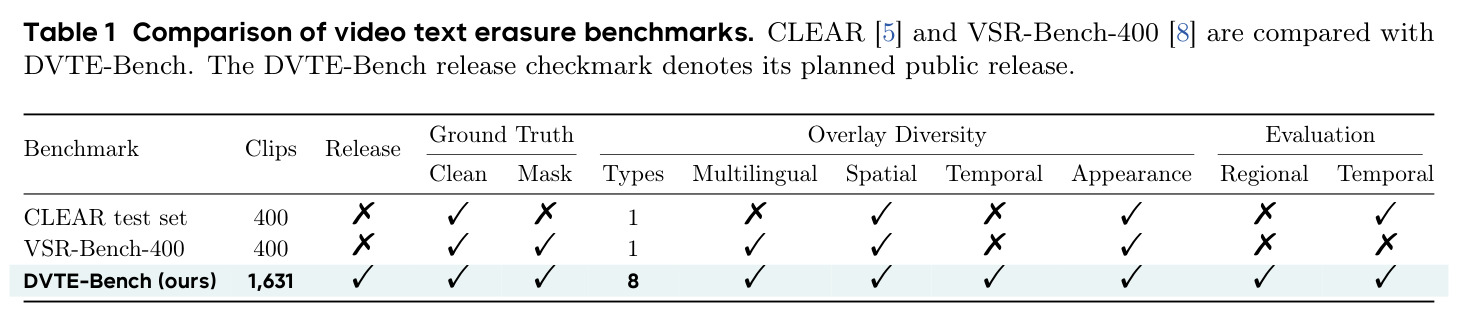
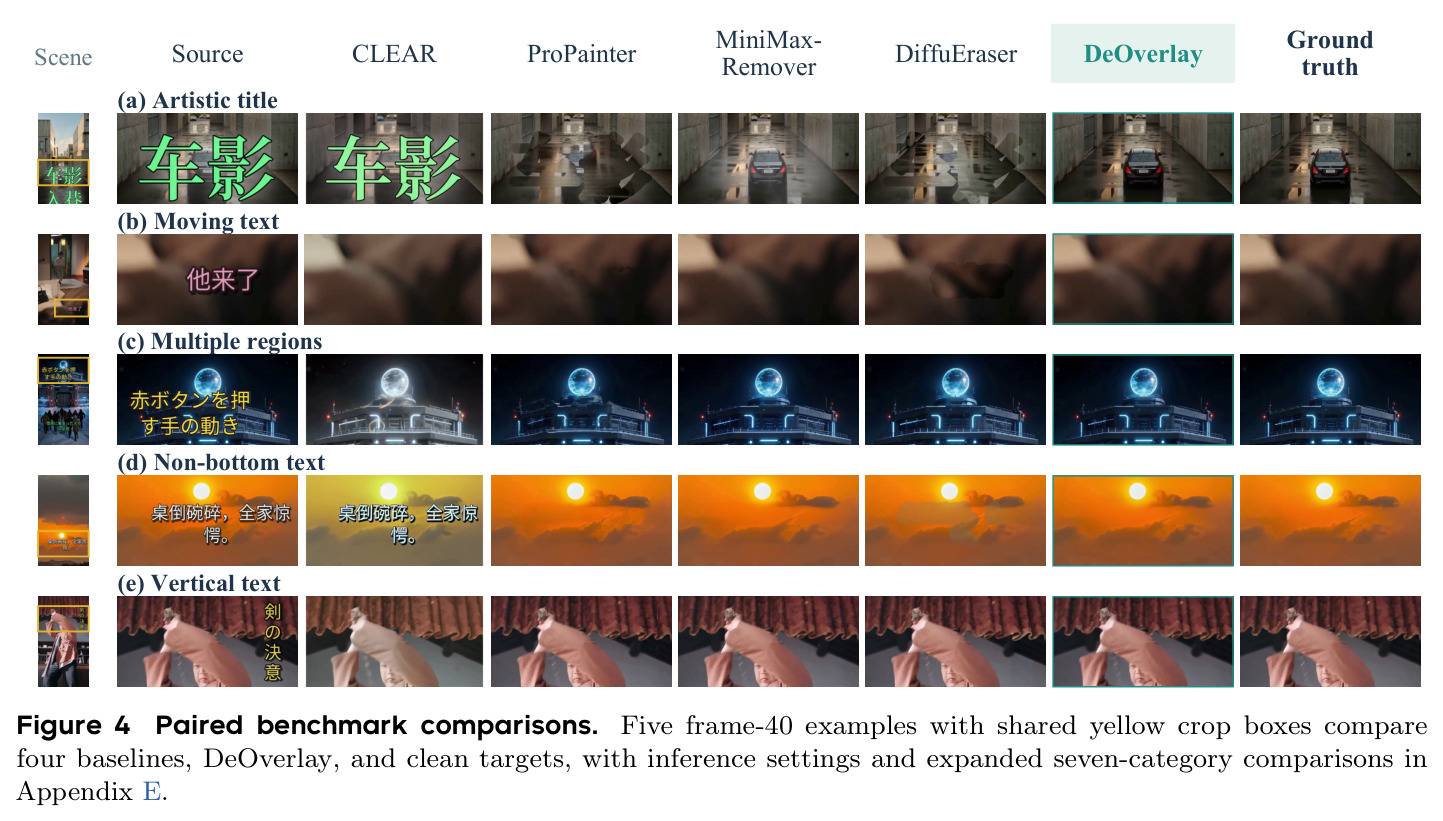
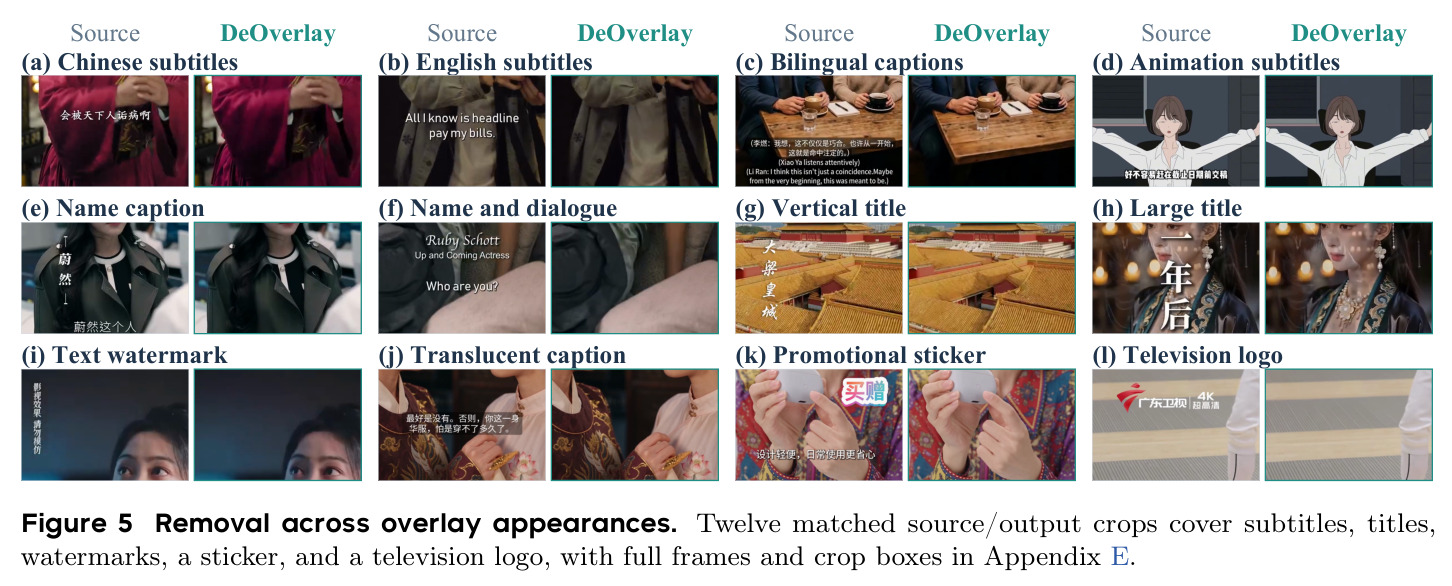
视频叠加去除要抹掉字幕、标题、水印和 logo 并还原被遮挡的场景,同时保持周边画面不变。现有方法分两类:以 ProPainter 为代表的传播式修补靠跨帧复制内容与特征,但当被遮挡区域在整个片段中始终没有露面时,只能退化为学习先验,容易产生模糊结构;以 CLEAR、SEDiT、MiniMax-Remover 为代表的生成式方法从纯噪声初始化编辑状态,源视频只通过通道拼接或序列拼接进入条件,配对比较显示这类输出存在残留文字与边界扭曲(Figure 4),且序列拼接会把 token 数量翻倍。评测侧同样欠缺:CLEAR 测试集与 VSR-Bench-400 各只有 400 段、单一字幕类型,没有像素级掩码和 OCR 筛选过的干净目标,无法跨叠加类型做统一的区域化评估。
本文的目标是本文同时解决「评不了」和「去不净」两个问题。评测侧,构建 DVTE-Bench:1,631 段配对视频、136,090 帧、91.1 分钟,覆盖八种文字叠加类型(标准字幕、艺术标题、移动文字、竖排文字、非底部排版、多区域、持续水印、语音对齐字幕),每段都有 OCR 逐帧筛查的干净目标与帧对齐像素掩码,并规定统一的区域重建、感知质量与时序诊断协议。方法侧,提出 DeOverlay:不从噪声而是从源视频隐变量 $z_s$ 出发,训练共享速度网络学习「源到干净」的修正流,并在每次更新中注入固定的局部与全局源线索,使模型既利用邻近帧可见的观测,又能在完全遮挡处依靠视频先验合理补全,最终在全部五项重建与感知指标上超过四个基线。
与已有工作不同的是,切入角度是把编辑的「起点」和「引导」同时换掉:起点从无信息的噪声换成承载全部观测的源隐变量,引导从一次性拼接换成每次更新都重新注入的固定源线索。与 PCFlow 在图像上比较观测初始化与噪声初始化、IR-Flow 学习图像退化-清晰传输不同,本文把配对流扩展到视频,并加入区域加权与固定源引导;借鉴 DiffST 的局部/全局分解,但改为固定坐标下的可见性归一化聚合。条件方式上坚持加性注入而非序列拼接,保持单一 $N$-token 视频序列——同一权重下若加入第二条源 token 流,token 从 13,346 涨到 26,594,中位耗时 2.485×、峰值显存 1.995×,凸显这一设计取舍的价值。
核心方法
直觉上,与其让模型从纯噪声重新想象整幅画面再贴回去,不如让它站在「已经看到一切」的源视频上,只学习「如何从有叠加修到无叠加」的增量。技术上:先用视频 VAE 把源视频编码为隐变量 $z_s$ 作为初始编辑状态;训练时为每个源-干净对构造路径 $a = z_s + \sigma\epsilon$($\sigma=0.05$)、$z_\tau = (1-\tau)z_c + \tau a$,干净端在 $\tau=0$、源端在 $\tau=1$,目标速度 $v^* = \partial z_\tau/\partial\tau = a - z_c$,用共享速度网络 $v_\theta$ 在路径各处拟合修正场。条件侧按 $h_\tau = P(z_\tau) + A(z_s,M_{model}) + G(z_s) + m_{tok}e_M$ 把局部源线索、全局摘要与掩码嵌入加性并入状态。推理从 $z^{(0)}=z_s$ 出发做 $K$ 步 Euler 下降,CFG 尺度 $g=2$,最后解码并做 12 像素无缝贴回。
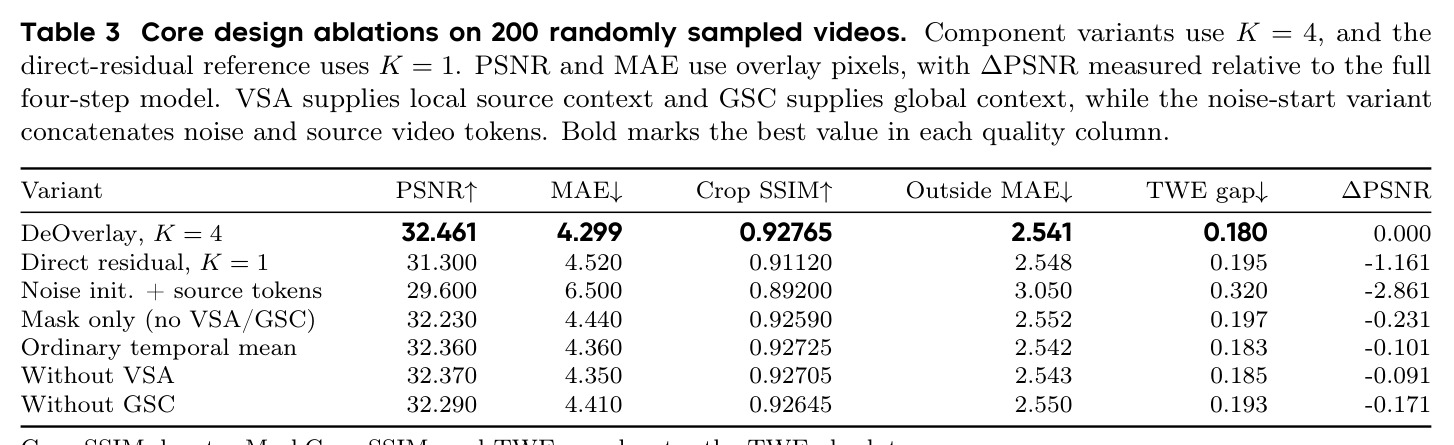
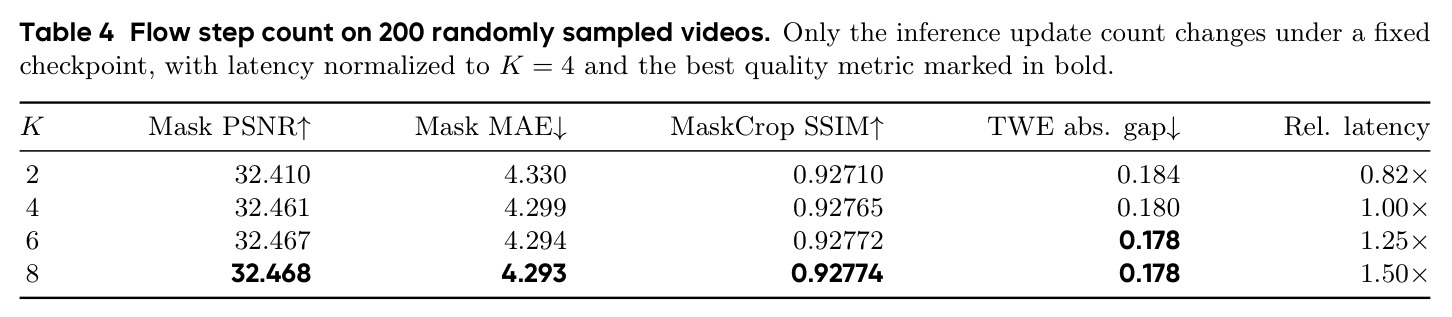
核心创新有三。其一是源锚定流:训练路径两端分别是源与干净目标,推理从源出发,权重固定而状态与时间演化,一个 checkpoint 就能支持任意推理步数($K=2$ 到 $8$ 的 PSNR 仅从 32.410 变到 32.468 dB),且四步流比单独训练的一步直接残差参考高 1.161 dB,说明「从当前状态和时间重新预测速度的迭代修正」优于一步回归。其二是可见性归一化时间聚合 VSA:在时间窗 $N(t)=\{t-2,\dots,t+2\}$ 内排除被掩码位置、按可见观测数归一化后再平均,避免普通时间平均把叠加特征混进场景信息。其三是加性条件:VSA 局部线索、GSC 全局摘要与掩码嵌入全部以加法并入 patch 化状态,保持单一视频 token 序列,对比实验表明第二条源 token 流会让中位耗时增加 2.485 倍。
方法步骤详情
第一步,编码与路径构造:输入叠加视频 $X$、干净目标 $Y$ 与掩码 $M$,VAE 编码得 $z_s=E(X)$、$z_c=E(Y)$,采样 $a=z_s+0.05\epsilon$ 并按 $z_\tau=(1-\tau)z_c+\tau a$ 取中间状态。第二步,训练:LingBot-Video 1.3B 骨干加 rank-256 LoRA,冻结 VAE 与文本编码器;VSA 在窗口内计算可见性归一化均值(分母按可见观测数归一,$\delta=10^{-4}$),GSC 把源时空均值过两层 MLP;区域加权损失中遮挡像素权重 $1+\lambda=6$、外部为 1;20% 概率缺失掩码训练。训练用 35 万对样本(含 5 万风格化与 5 万镜像文字),取 40K checkpoint。第三步,推理:$z^{(0)}=z_s$,按线性-二次下降调度执行 $z^{(k+1)}=z^{(k)}+\Delta\tau_k b\,v_\theta$,CFG 尺度 $g=2$。第四步,输出 $\hat{Y}=D(z^{(K)})$,分块推理并做 12 像素无缝贴回。
技术新颖性
与已有方法的本质区别在三个维度。起点语义:ProPainter 依赖跨帧传播,CLEAR、SEDiT 与 MiniMax-Remover 从噪声起步,编辑状态不含任何观测;DeOverlay 的 $z^{(0)}=z_s$ 从第一步就保留已见结构,消融显示换成噪声初始化加源 token 拼接要损失 2.861 dB。引导持续性:SEDiT 只在序列层面拼一次源 token,本文在每次共享权重更新中重新注入固定的 VSA/GSC 线索,适配状态不断演化的去叠过程。条件效率:加性注入不增加 token 数,而拼接方案在同权重、同样四次前向下中位耗时 2.485×、增量峰值显存 1.995×。此外,训练目标把 $\tau$ 的语义反转(0 为干净、1 为源),配合区域加权与缺失掩码训练,同时兼顾去叠质量与无掩码泛化。
实验结果
在 DVTE-Bench 全部 1,631 段上,DeOverlay($K=6$)五项指标全部第一:Mask PSNR 30.80 dB、SSIM 0.8822,感知指标 LPIPS/DISTS/VFID 降至 0.0408/0.0507/0.0835;相对最强基线 MiniMax-Remover,后三者分别下降 58.3%、40.8%、70.3%,而 CLEAR 仅 16.02 dB,非字幕迁移吃力。时序上 TWE Pred 9.3110 最接近干净目标 9.3228,TWE Gap 0.0118 远小于基线 0.6133。分类型看,艺术字 PSNR 最低(26.24 dB),竖排文字 LPIPS 最高(0.0975)。消融中:噪声初始化+源 token -2.861 dB,一步直接残差 -1.161 dB,仅掩码 -0.231 dB,去 GSC -0.171 dB,去 VSA -0.091 dB。步数 $K=2$→$8$ 仅从 32.410 升到 32.468 dB。效率上 $K=1$ 达 3.0847 FPS(最快基线的 1.17 倍),峰值显存 12.236 GiB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频文字去除·区域重建(1,631 段全量) | Mask PSNR (dB) ↑ | 30.80 | MiniMax-Remover 26.17 | +4.63 dB |
| 视频文字去除·区域重建(1,631 段全量) | Mask SSIM ↑ | 0.8822 | MiniMax-Remover 0.8044 | +9.7% |
| 视频文字去除·感知质量(1,631 段全量) | Mask LPIPS ↓ | 0.0408 | MiniMax-Remover 0.0977 | -58.3% |
| 视频文字去除·感知质量(1,631 段全量) | Mask VFID ↓ | 0.0835 | MiniMax-Remover 0.2806 | -70.3% |
| 时序一致性诊断(掩码区域 TWE) | TWE Gap ↓ | 0.0118 | MiniMax-Remover 0.6133 | -98.1% |
| 端到端推理速度(单张 A100,8 段 650 帧串行) | E2E FPS ↑ | 3.0847(K=1) | MiniMax-Remover 2.6405 | 1.17× |
局限与改进
作者承认的局限:DVTE-Bench 只覆盖合成文字叠加,图形 logo、贴纸与自然场景文字的保护留待更广泛的配对评测;当相邻帧都没有露出被遮挡内容时,重建完全依赖视频先验;应用示例中仍有残留图形与局部纹理伪影。我的补充观察:其一,基线对照不完整,SEDiT 因无可执行模型只做概念性比较,最接近的「序列拼接源条件」方案缺少实测数据;其二,基准由文本计划或语音转写渲染而成,与真实拍摄叠加(压缩伪影、运动模糊、半透明混合)存在域差距;其三,推理使用 GT 框级掩码输入,实际使用需要用户手绘或另行检测;其四,TWE/TC 等时序指标只是辅助诊断,作者也承认时序平滑不等于内容正确,幻觉内容可能同时在感知与时序指标上表现良好;其五,CFG 使每步要两次网络评估,六步共十二次前向,部署成本仍高于一步模型。
独立分析的弱点
第一,全遮挡区域的幻觉风险:当某区域整段视频从未露出,DeOverlay 会生成「看起来合理」的内容,LPIPS/DISTS 无法区分正确重建与漂亮幻觉,可能误导下游使用。改进方向:为输出附加逐像素不确定性图,或用 OCR/分割模型对重建区域做语义一致性校验。第二,掩码依赖:VSA 的可见性归一化与掩码嵌入都以输入掩码准确为前提,掩码偏大会浪费可观测信息、偏小则残留叠加,而实际用户的粗掩码很常见。改进方向:联合训练掩码细化模块或引入软掩码容错。第三,CFG 翻倍计算:$g=2$ 意味着每步两次网络评估,$K=6$ 共 12 次。改进方向:CFG 蒸馏或引导蒸馏,把推理压到单次评估。第四,类别级与组件消融只在 200 段子集上进行,统计功效有限,艺术字、竖排文字等边界情况需要更大样本验证。第五,12 像素固定融合带在快速运动或大位移叠加下可能出现接缝伪影。
未来方向
作者明确提出的方向:把图形 logo、贴纸以及自然场景文字保护纳入配对评测,扩展 DVTE-Bench 的覆盖面。基于本文成果还可延伸:把源锚定流推广到更广的视频恢复任务,如去雾、去模糊与时空超分(DiffST 的启发本就来自这一脉);对真实叠加数据做域适应或半监督训练,缩小合成渲染与真实字幕/水印的差距;一步蒸馏以逼近 $K=1$ 的 3.08 FPS 并进一步部署到端侧实时场景;步数自适应调度,让简单场景用 1–2 步、复杂场景用更多步;引入指令驱动的交互式编辑,把「去除」推广为「替换」或「改写」;建立语义正确性评测,用识别模型检验重建内容与真实场景的一致性,弥补纯感知指标的盲区。
复现评估
复现前景总体乐观但有保留。利好是评测侧:作者承诺开源完整基准、评测代码与测试输出,DVTE-Bench 提供 1,631 段视频、136,090 帧、帧对齐 NPZ 掩码档案和统一的 Farneback 时序协议,附录 C/I 详细规定区域计算与聚合规则,照此复现表格数字难度低。保留在训练侧:论文未明确承诺开源模型权重与 35 万训练对的构造代码;骨干 LingBot-Video 1.3B 加 rank-256 LoRA,训练需要多卡 A100 级算力与较大的数据工程。推理侧门槛不高:单张 A100、峰值显存 12.236 GiB 即可运行,且 $K=1$ 与 $K=4$ 模式灵活可调。总体而言,复现评测容易、复现模型训练中等偏难,适合先把 DVTE-Bench 当作独立评测资源使用。
论文图表
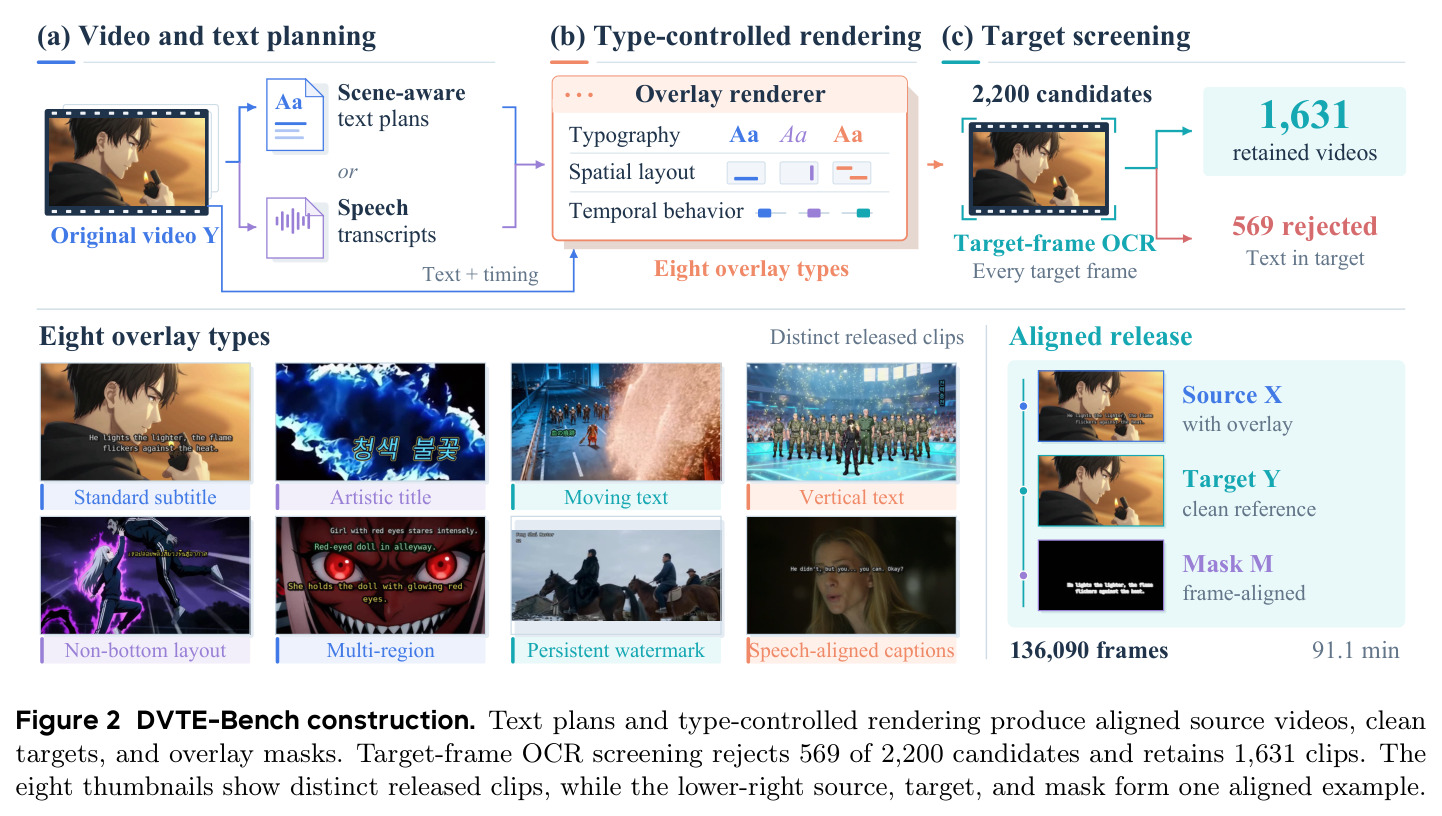
展示基准的三阶段流水线(视频与文本规划、类型受控渲染、目标筛查),以及八类叠加示例和源/目标/掩码对齐样例,共 136,090 帧、91.1 分钟。
理解基准的数据来源、OCR 质量控制(74.1% 保留率)与八类设计动机的入口,评测结论的可信度建立在这条流水线上。