MFVSR:面向视频字幕去除的多风格细粒度基准 MFVSR: A Multi-Style and Fine-Grained Benchmark for Video Subtitle Removal
3,000对可控渲染字幕视频、16种语言的基准,解耦诊断修复、保持与时间保真
前置知识
视频字幕去除(VSR)
从烧录字幕(字幕已渲染进画面像素、无法通过字幕轨关闭)的视频中定位字幕、重建被遮挡的背景内容,同时保持画面其余部分不变与跨帧时间一致性。它与视频修复(video inpainting)、视频目标移除同属'移除+补全'任务,但独特之处在于要求字幕区域精确还原真实场景、未受影响区域尽量不动、且输出在时间上稳定。
本文整个基准——配对数据、掩码定义、评估视图——都是围绕这一任务的四重挑战(定位、重建、保持、时间稳定)设计的,不理解任务特殊性就看不懂评估协议为何这样拆。
盲去除与掩码引导去除
盲(blind)方法只看带字幕的视频,需要同时推断'在哪里改'和'怎么改';掩码引导(mask-guided)方法额外获得由字幕BBox派生的矩形掩码作为空间先验,只需负责内容补全。两者可用的信息量不同,属于不同的信息条件,直接混在一个排行榜里比较会混淆定位能力与修复能力。
MFVSR 的核心协议就是把这两种设定分开排名;理解信息不对称,才能读懂为何盲方法 CLEAR 与五个引导方法分属不同结果块、从不直接比大小。
全参考质量指标(PSNR/SSIM/LPIPS/DISTS)
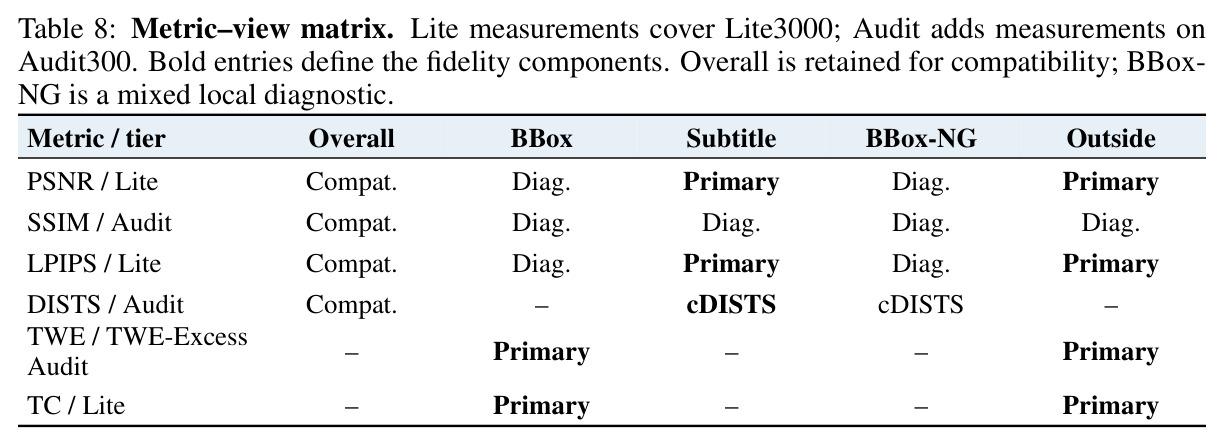
PSNR 衡量像素级均方误差(dB,越高越好);SSIM 衡量局部结构相似性;LPIPS 用深度网络特征度量感知距离;DISTS 分离结构与纹理的感知相似度。MFVSR 只改变这些指标的统计区域(聚合支持)而不改定义,并把 DISTS 的区域化用法明确定义为条件化 DISTS(cDISTS)——只在目标图上替换被评区域后再计算,属于受控输入干预。
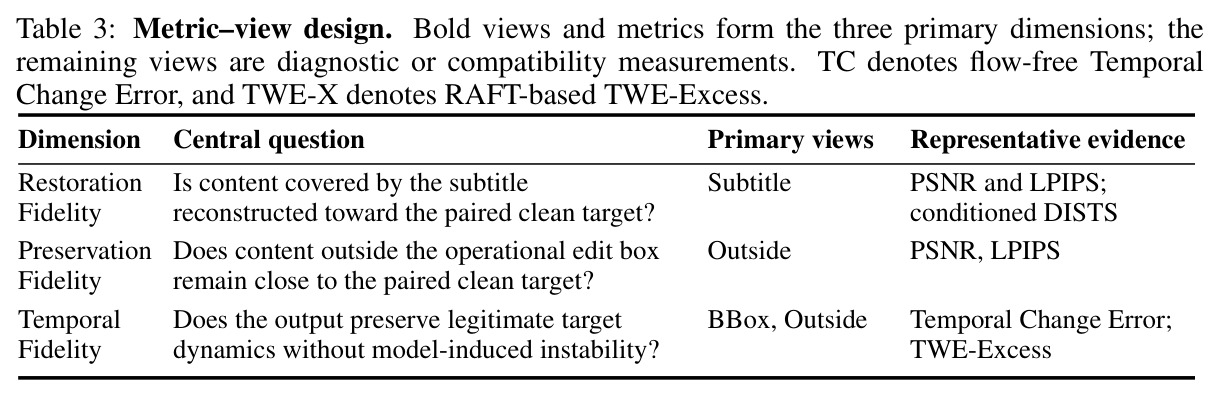
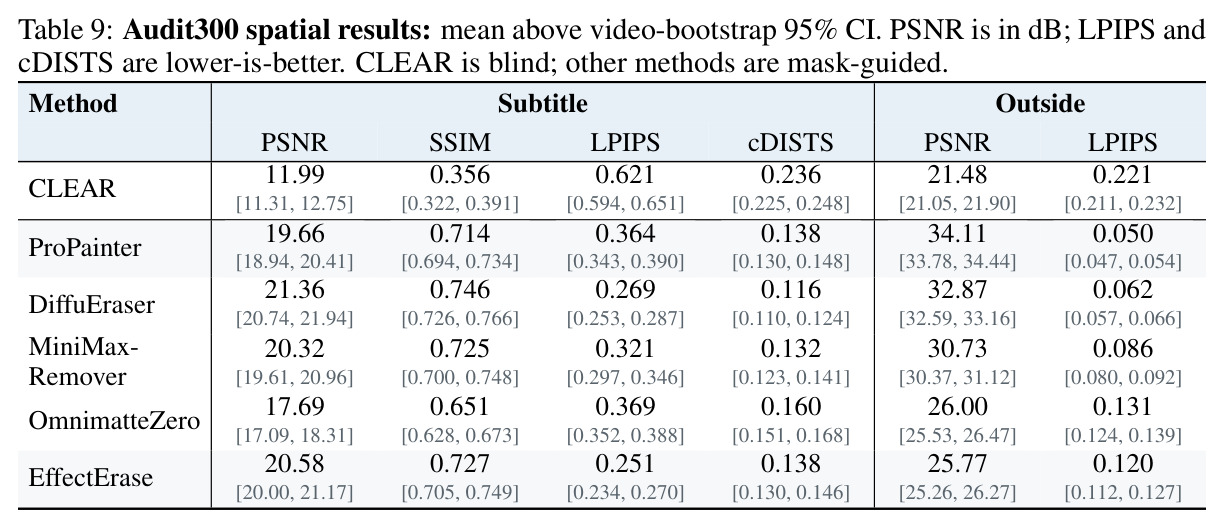
修复(Restoration)与保持(Preservation)两个维度的主证据分别是 Subtitle 视图和 Outside 视图上的 PSNR/LPIPS,读懂这些指标是理解主结果表 Table 4 的前提。
光流与时间一致性误差(TWE / TWE-Excess / TC)
用 RAFT 在干净目标上估计相邻帧光流,TWE(temporal warping error)将前一帧经光流扭曲到当前帧后计算残差,衡量运动补偿后的不一致。TWE-Excess = TWE_pred − TWE_gt,扣除目标自身的合法运动后近似隔离模型引入的抖动;TC 是免光流的补充诊断,惩罚模型对目标真实帧间变化的抑制。两者互补、结论可以相反。
时间保真(Temporal Fidelity)的全部证据来自这两个指标,而它们在 10 个方法对中有 6 对排序不一致,这一发现本身就是论文的核心结论之一。
字形掩码、BBox 与五视图分解
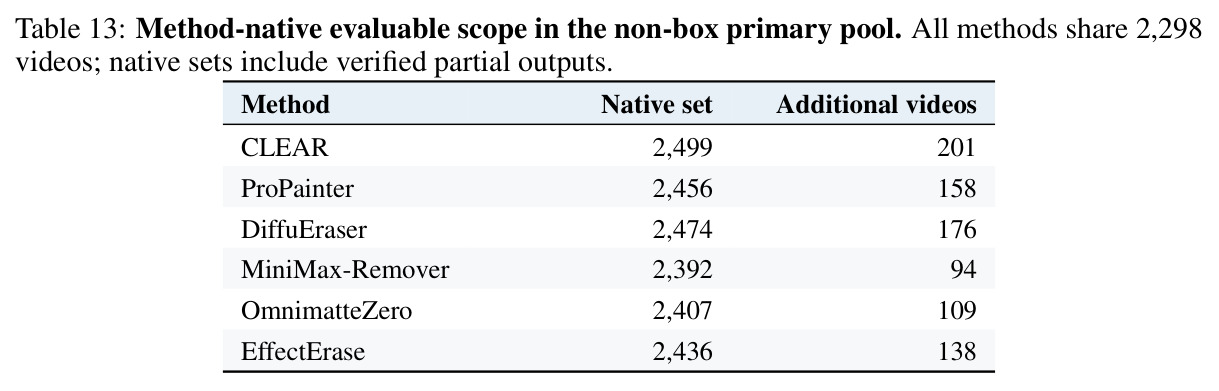
字形掩码 $G_t$ 是字幕文字的像素级轮廓,仅用于评估;BBox $B_t$ 是包含字幕的矩形框,派生出掩码引导模型的输入。由二者定义三个互斥且穷尽的原子区域:Subtitle $=G_t$、BBox-NG $=B_t \wedge \neg G_t$(框内非字形,含阴影描边等效果)、Outside $=\neg B_t$,再加聚合视图,构成 Overall/BBox/Subtitle/BBox-NG/Outside 五个评估视图。
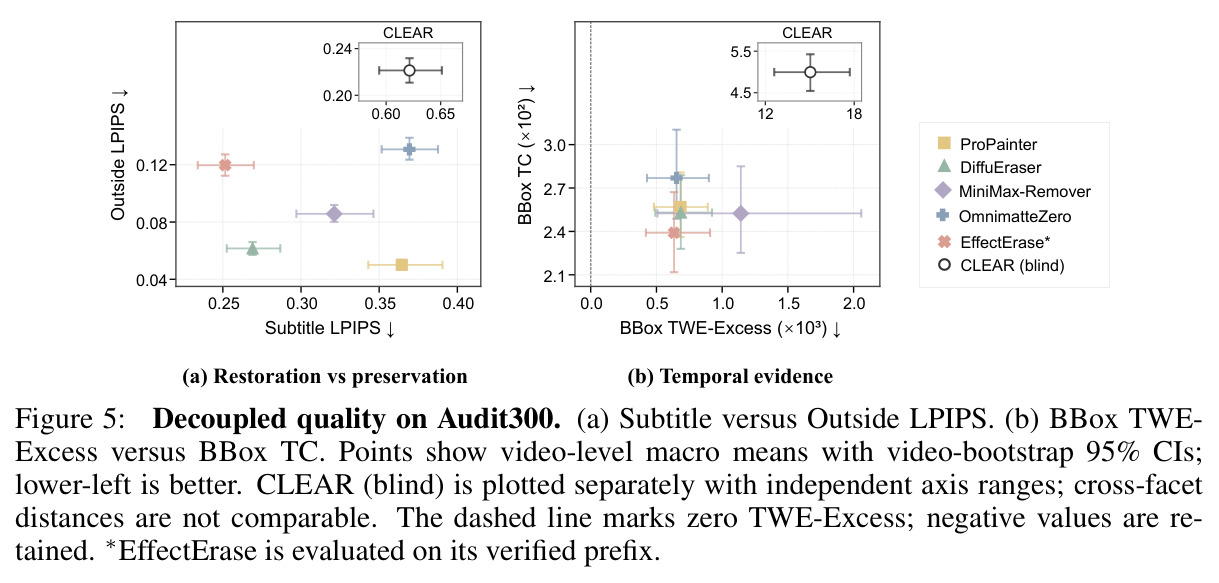
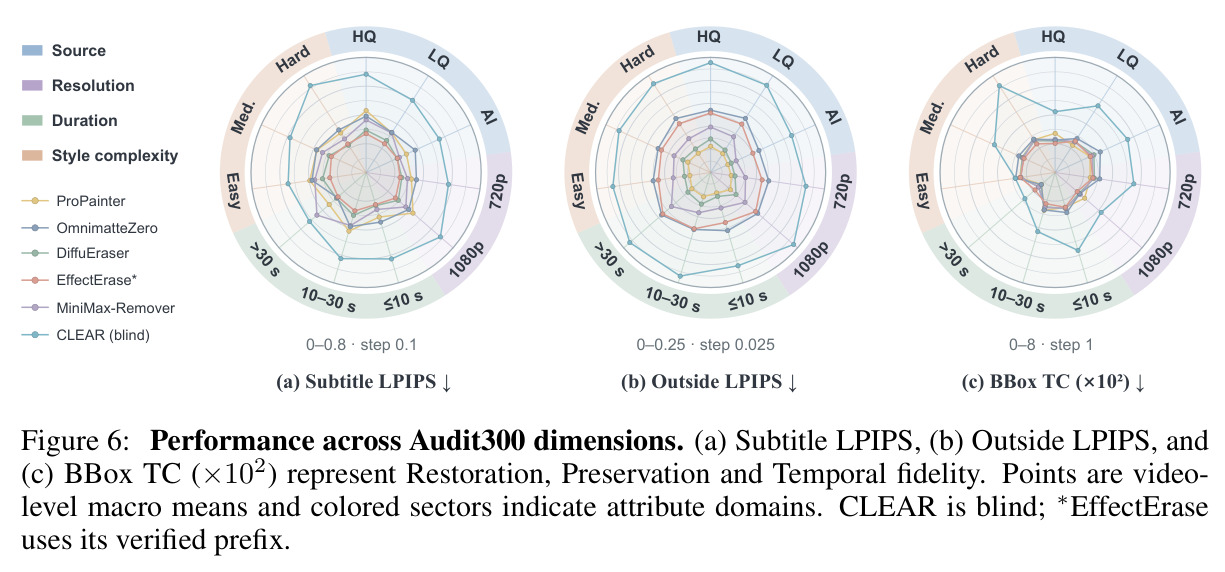
五视图是把全帧分数拆成'修复/保持/时间'三种能力坐标的数学基础,也是 Figure 5、Figure 6 等所有结果图表的坐标轴来源。
研究动机
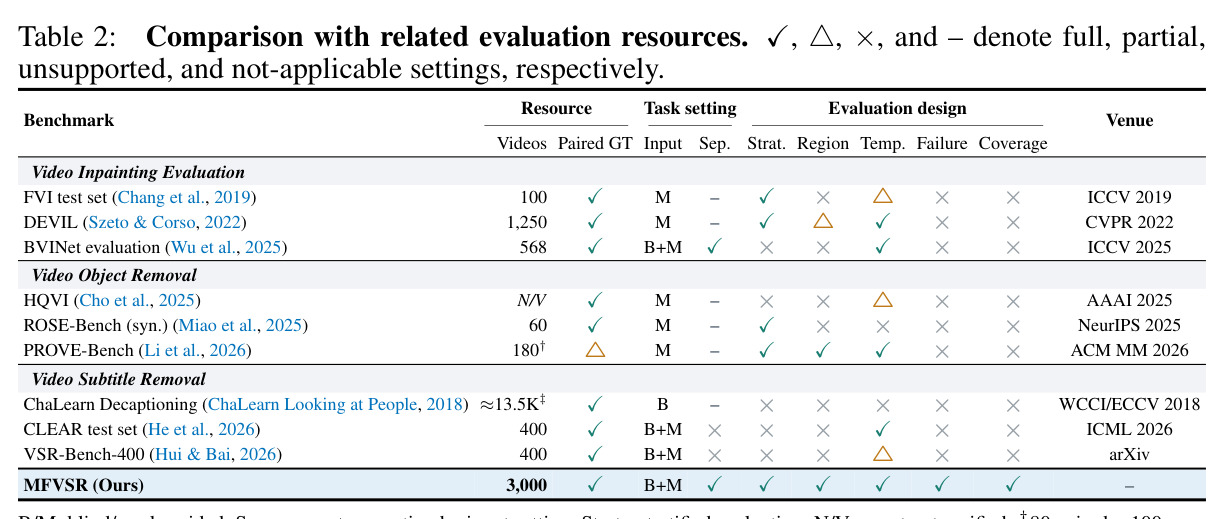
现有视频字幕去除评估存在三大结构性缺陷。其一是基准碎片化:ChaLearn 2018 数据集仅提供 128×128 的超低分辨率短片段,而近年的 SEDiT 与 CLEAR 各自构建了仅约 400 条视频的论文专用测试集,来源、分辨率和真实内容分布覆盖都很窄,导致跨方法、可复现的系统性比较几乎不可能。其二是字幕变化缺乏结构:现有测试集虽含多样字幕外观,却未按空间布局、时间行为、视觉风格、语言模式等独立因子组织,当方法在某测试集上表现更差时,无法判断究竟是动态轨迹、双语排版还是霓虹特效所致,也无法做分层归因。其三是通用视频修复评估协议不适配字幕任务:把 DAVIS、YouTube-VOS 加合成掩码的评估直接挪用,既不围绕多语言字幕的排版、动画与阅读方向设计,也不处理盲定位与掩码修复之间的信息不对称;同时常规全帧 PSNR/LPIPS 会掩盖四类字幕特有的失效——字幕区重建误差、区域外的意外修改、时间抖动以及输出不完整。例如一个方法可能字幕区重建很差,却因'没怎么动其他区域'而获得不错的全帧分数,排名被严重误导。
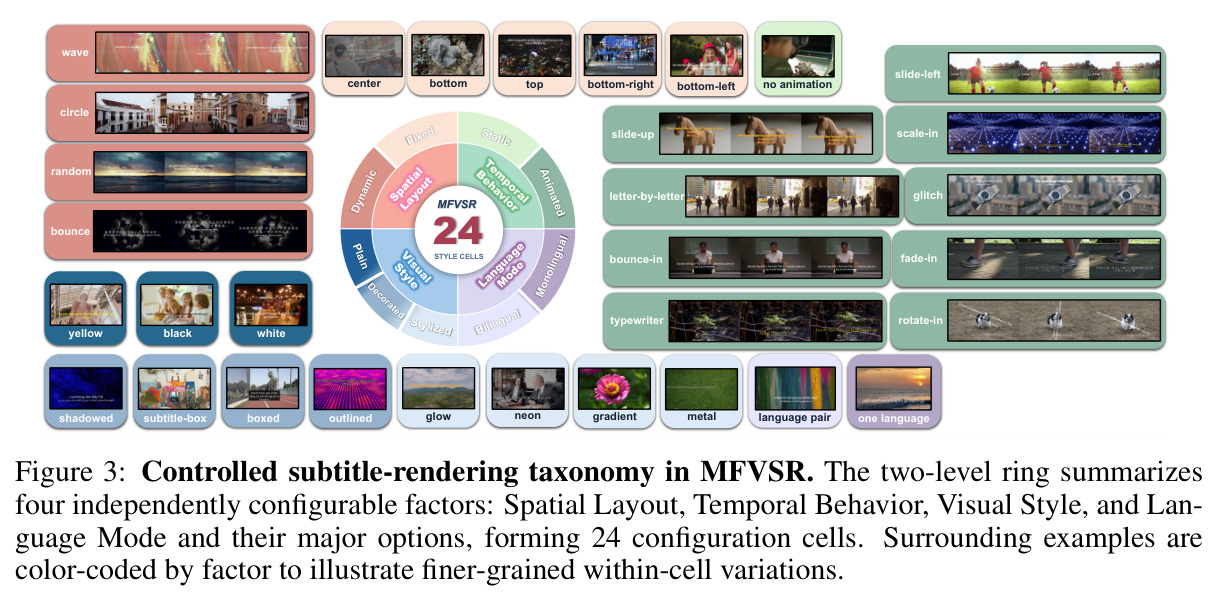
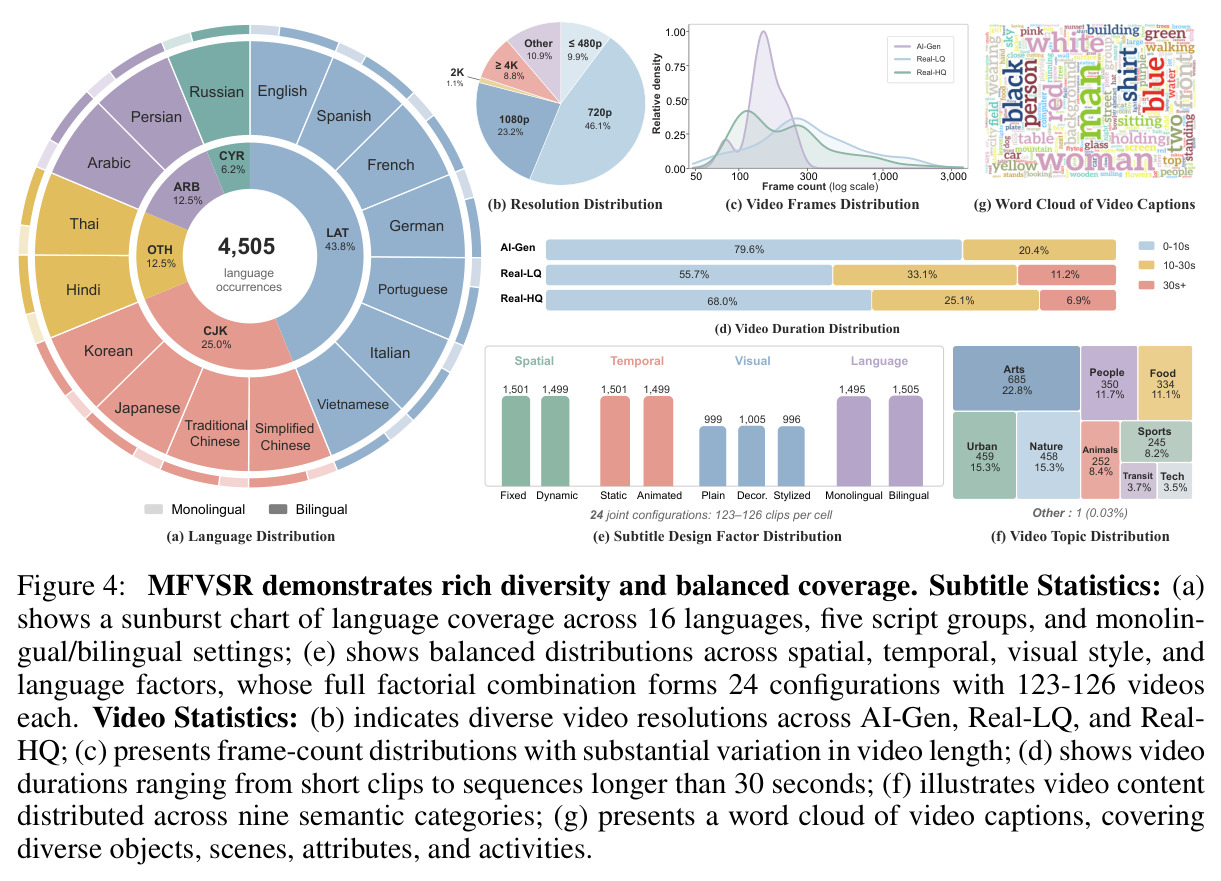
本文的目标是本文目标是构建 MFVSR——一个大规模、多风格、细粒度且可靠性感知的视频字幕去除基准,把评估从'单一总分'升级为'能力画像'。具体包括三点:第一,数据上提供 3,000 条分辨率多样的配对视频,在 Real-HQ(≥1080p)、Real-LQ(512p–1080p)与 AI 生成三个来源层各 1,000 条均衡分布,配对资产包含干净目标、像素级字形掩码、逐帧 BBox、BBox 派生的模型输入掩码与渲染元数据;另附 953 条来自 B 站、抖音、小红书、快手、YouTube 的野外真实带字幕视频以扩展真实世界覆盖,但明确将其排除在配对定量评估之外。第二,受控多样性:把字幕渲染分解为空间布局、时间行为、视觉风格、语言模式四个可独立配置的因子,全因子组合产生 24 个配置单元,每单元 123–126 条视频,覆盖 16 种语言。第三,评估协议:分离盲与掩码引导两种信息条件,用五个空间视图和修复保真、保持保真、时间保真三个维度分别度量,同时显式报告条件质量、时空覆盖率、部分输出与整体失败率。
与已有工作不同的是,本文的独特切入角度在于把'评估设计'本身当作研究对象,并贯彻几个此前 VSR 评估缺失的原则。首先,它不预设任何语言或渲染因子天然更难,而是用受控渲染引擎把字幕多样性变成可复现的实验变量,使性能差异可被归因。其次,它明确提出盲去除与掩码引导是不同信息条件下的不同任务:盲方法要同时解决'在哪改'与'怎么改',混合排名会混淆定位与修复,因此 MFVSR 用相同的目标与指标但分块报告。第三,它主张条件质量必须与输出支撑一起解读——一个只在 43.1% 时间覆盖率前缀上成立的漂亮分数,与 100% 交付下的分数不可比,因此把完整/部分/失败三态交付统计作为基准的一等公民而非脚注。第四,它采用预注册的统计纪律:Audit300 的选择只依赖数据集元数据、SR-Q 标量的晋升规则事先注册,人工研究不支持时诚实降级而非事后拟合。作者的核心论断是:当前领域缺的不是数据量,而是'高分辨率配对监督 + 受控字幕多样性 + 真实世界覆盖 + 信息条件化空间解耦评估'的统一,这一定位使 MFVSR 区别于单纯扩充数据的增量工作。
核心方法
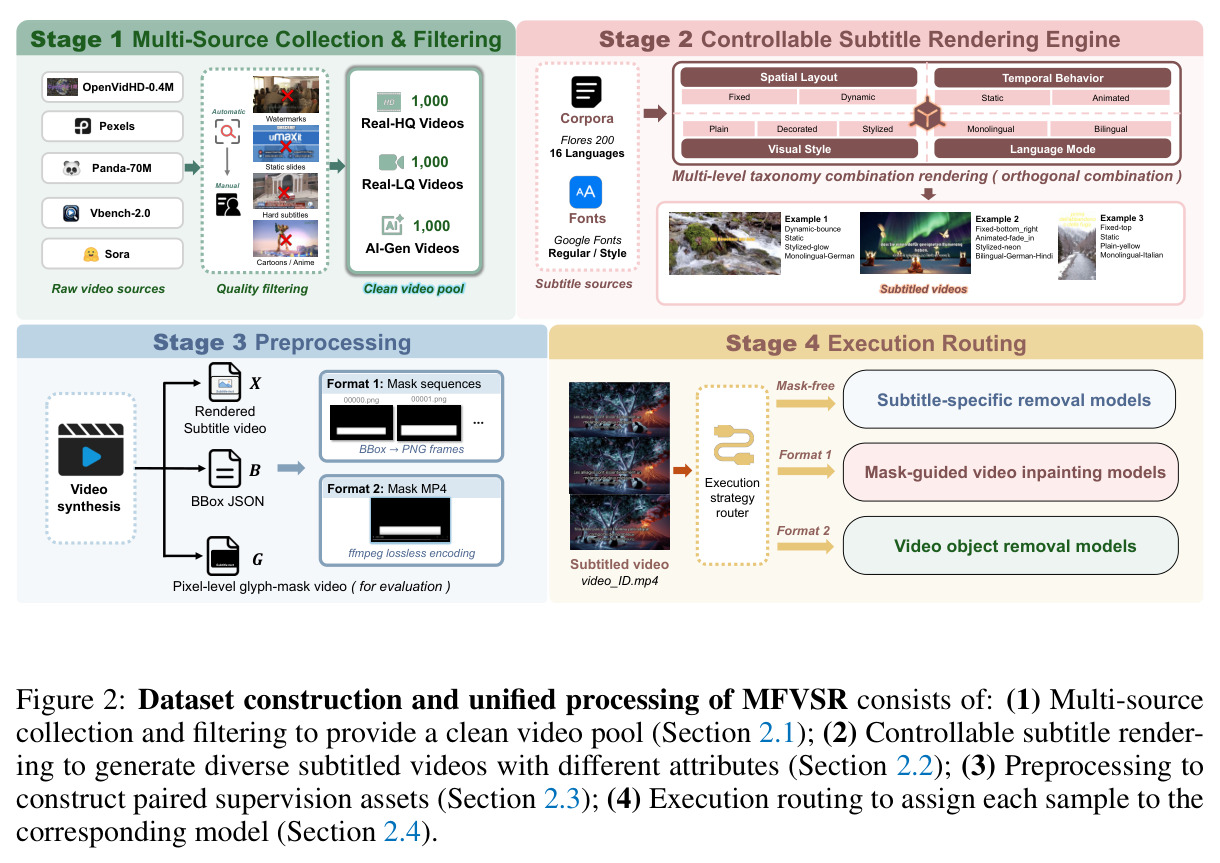
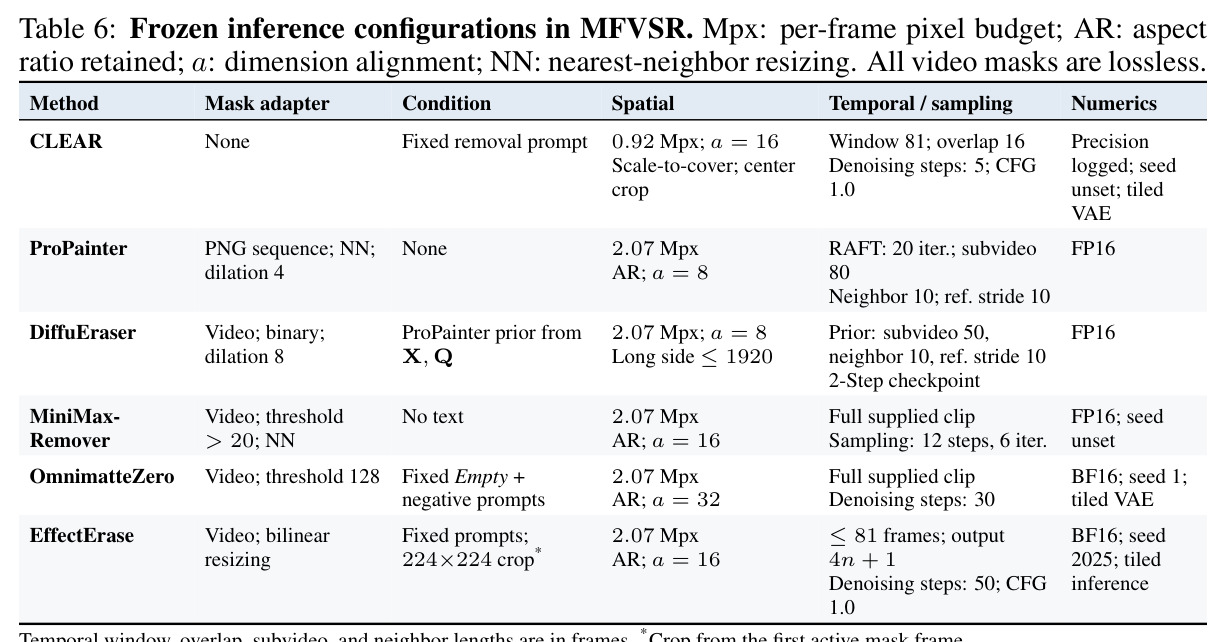
核心直觉是:字幕是渲染在场景之上的合成层,因此可以在干净视频上重新'受控地'渲染字幕,天然获得完美的配对监督(干净目标)与全部中间标注(字形掩码、BBox、渲染参数);再把每帧拆成互斥的空间区域分别打分,就能把笼统的全帧分数分解成可解释的能力维度。技术路线分四个阶段(Figure 2)。阶段一,多源收集与过滤:从 OpenVidHD 与 Pexels 取 Real-HQ(≥1080p)、Panda-70M 与 Pexels 取 Real-LQ(512p–1080p)、VBench-2.0 与 Rapidata Sora 取 AI 生成视频各 1,000 条;自动筛查做抽帧、解码校验、分辨率与清晰度过滤并用 OCR 标记烧录文字与水印,人工复核剔除含字幕、显著水印、静态幻灯片、卡通动漫的视频。阶段二,可控字幕渲染:文本取自 FLORES-200(16 种语言),字体取自 Google Fonts,按四因子分类组合渲染。阶段三,预处理与配对资产生成:每个干净基视频合成三路逐帧对齐输出——带字幕视频 $X$、像素级字形掩码视频 $G$、逐帧 BBox JSON $B$,干净基视频保留为真值 $Y$,并从 BBox 生成逐帧 PNG 掩码序列与无损掩码 MP4 两种等价输入格式。阶段四,执行路由:每个模型按其发布接口做确定性预处理,盲方法只接收 $X$,掩码引导方法接收 $X$ 加规范 BBox 掩码,字形掩码永不作为模型输入。
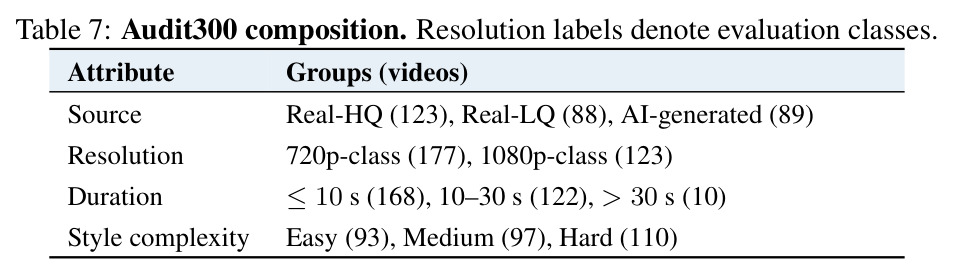
核心创新是把 VSR 评估从全帧相似度比较改造为'信息条件化、空间解耦'的能力诊断体系。每个样本被形式化为五元组 $I=(X,Y,G,B,A_{render})$,其中 $A_{render}$ 编码语言模式、风格、布局、动画等渲染属性,使任何结果都能下钻到具体字幕条件。空间上,评估定义三个互斥且穷尽的原子支撑:$\mathcal{R}^{Sub}_t=G_t$(字形核心)、$\mathcal{R}^{BBox\text{-}NG}_t=B_t\wedge\neg G_t$(框内非字形效果)、$\mathcal{R}^{Out}_t=\neg B_t$(框外背景),加上聚合视图构成 Overall/BBox/Subtitle/BBox-NG/Outside 五视图,使'字幕区修得好不好'与'框外有没有被改坏'成为两个独立坐标。时间上,用只在干净目标上估计光流的 TWE-Excess $=\mathrm{TWE}^{pred}-\mathrm{TWE}^{gt}$ 剔除目标自身运动、隔离模型引入的不稳定,并用免光流的 TC 惩罚对合法目标变化的抑制,形成双证据。可靠性上,缺失帧不复制不填充、无法验证时空对应的指标保留缺失而非记零,完整/部分/失败三态分开统计。与已有工作的本质区别:CLEAR/SEDiT 的 400 条私有测试集只给单一总分,DEVIL 等修复基准不围绕多语言字幕结构设计,而 MFVSR 把信息边界、空间分解、时间双证据、交付覆盖与预注册人工验证统一进一个协议。
方法步骤详情
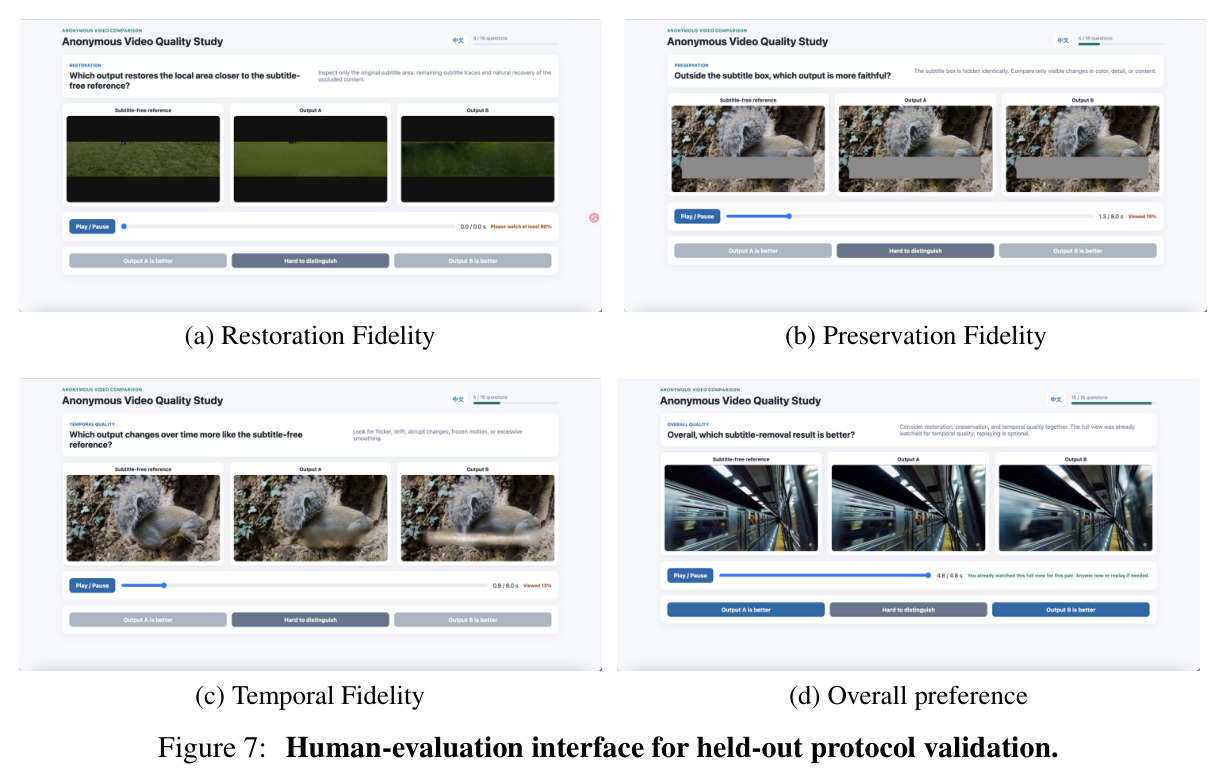
完整流程分六步。第一步数据构建:多源采集后经自动筛查(抽帧验解码、分辨率与清晰度阈值、OCR 标记烧录文字/URL/水印)与人工核验,产出 3,000 条干净基视频与 953 条野外辅助视频;逐条验证解码、分辨率与帧对齐,任何字形像素落在 BBox 并集外即拒收,掩码与预测帧率须与目标一致(误差 ≤0.01 fps)。第二步受控渲染:按四因子配置渲染——空间布局(Fixed 有 5 个锚点;Dynamic 有 4 条轨迹)、时间行为(Static;Animated 含 fade-in、typewriter、glitch 等 9 个子类型)、视觉风格(Plain 纯色 / Decorated 阴影描边底框 / Stylized 发光渐变霓虹金属)、语言模式(单语/双语两行),共 $2\times2\times3\times2=24$ 个配置单元,输出 $I=(X,Y,G,B,A_{render})$。第三步接口适配:从 BBox JSON 确定性生成各模型所需掩码(ProPainter 用 PNG 序列+膨胀 4;DiffuEraser 二值视频掩码+膨胀 8;MiniMax 阈值 >20;OmnimatteZero 阈值 128;EffectErase 双线性缩放+224×224 裁剪),全部冻结成配置表。第四步推理执行:盲设置仅 CLEAR 输入 $X$;保留各方法原生分辨率上限、精度、分块与采样,原始输出不可变。第五步评估:Lite3000 每视频抽 ≤48 帧(32 个字幕活跃帧 + 16 个全时间线帧)与 32 个相邻帧对,计算 PSNR/LPIPS/TC;Audit300(固定 300 条)加测 SSIM、条件化 DISTS 与 TWE-Excess;逐视图计算并给出视频级宏平均与自举 95% 置信区间。第六步交付与人工验证:在全部 3,000 条上统计完整/部分/失败,另在 100 条 held-out 视频上对 15 个方法对做四任务盲评。
技术新颖性
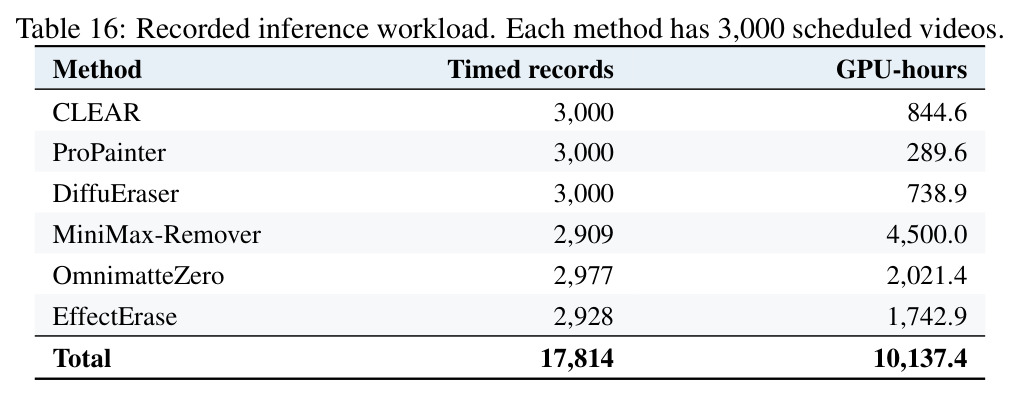
技术新颖性体现在五个层面。数据层:这是首个大规模多风格 VSR 基准,比此前最大的专用测试集(CLEAR/SEDiT 各 400 条)大 7.5 倍,首次覆盖 16 种语言与五个文字系统(含从右至左的阿拉伯语、波斯语),并以 953 条野外视频补足真实分布,同时诚实将其排除在定量评估之外。协议层:'信息条件化'评估在 VSR 领域是新的——同一配对目标与指标下按信息边界分块排名,直接回应盲方法与引导方法能否同榜的争议。指标层:条件化 DISTS 是受控输入干预——$\tilde{Y}_t(\mathcal{R})=\mathcal{R}\odot\hat{Y}_t+(1-\mathcal{R})\odot Y_t$,只在目标图上替换被评区域再计算 DISTS,避免把图像级指标误用于稀疏区域;区域 PSNR/LPIPS 只改聚合支持不改定义,与既有文献兼容。统计层:Audit300 的选择是只依赖元数据的固定种子优化问题(平衡来源、分辨率、时长、风格复杂度及 Source×Complexity、Resolution×Duration 交互),指标值、方法身份、排名与人工判断都不参与选择,杜绝选择偏差;SR-Q 采用冻结的 P5/P95 锚点归一化并预注册晋升规则。透明层:论文公开报告负面结果(SR-Q 未通过人类验证、时间维度与人类判断对齐弱),并以 10,137.4 GPU 小时的完整推理日志支撑交付统计,这种评估工程化程度在基准论文中罕见。
实验结果
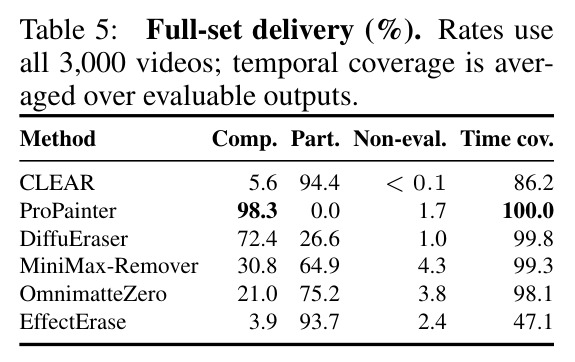
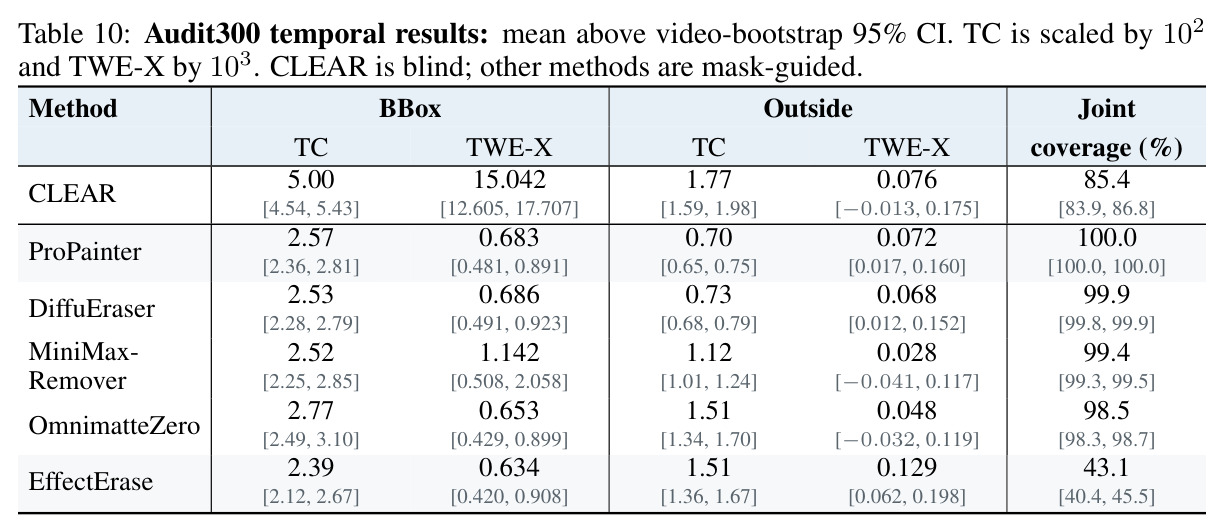
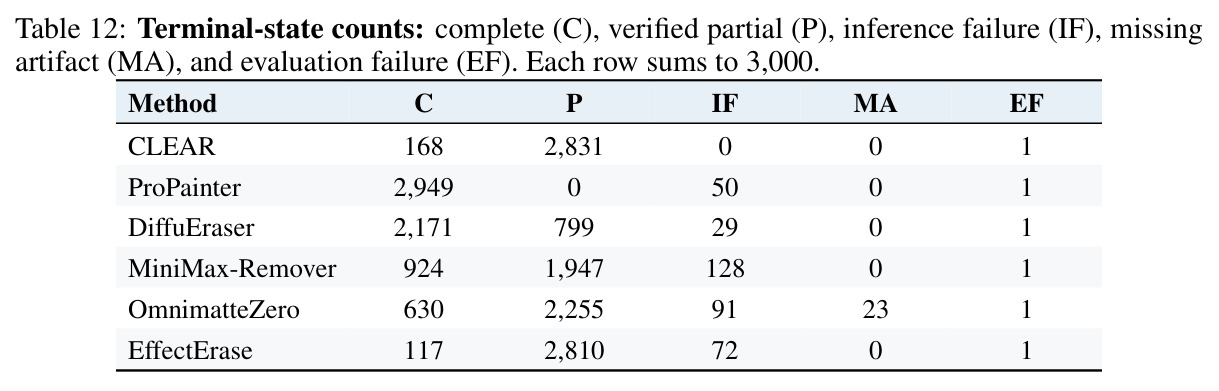
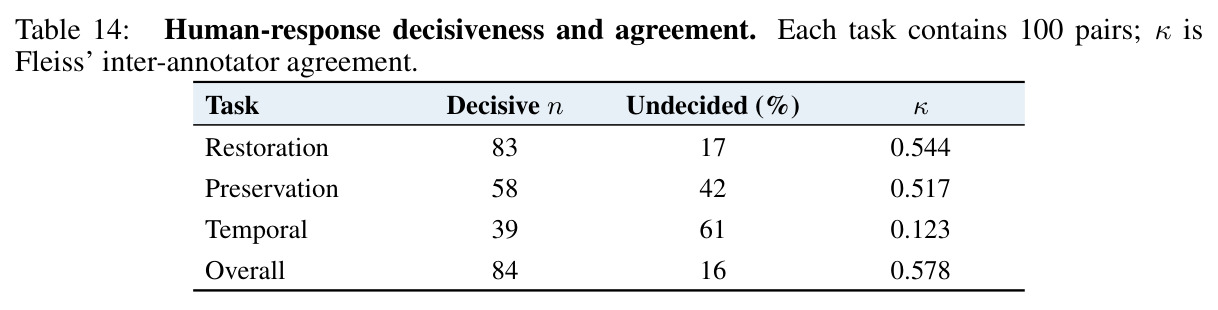
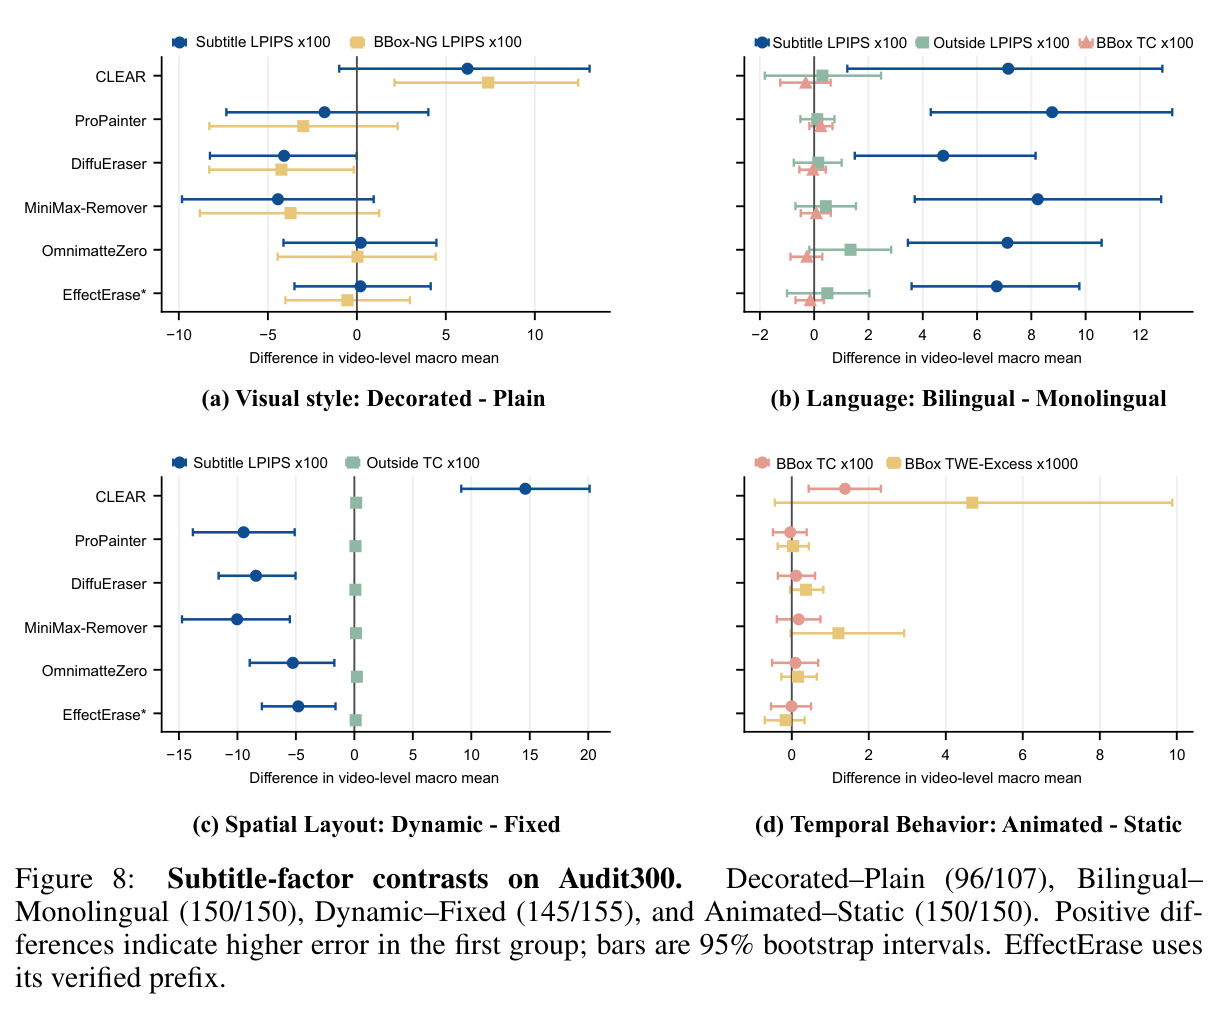
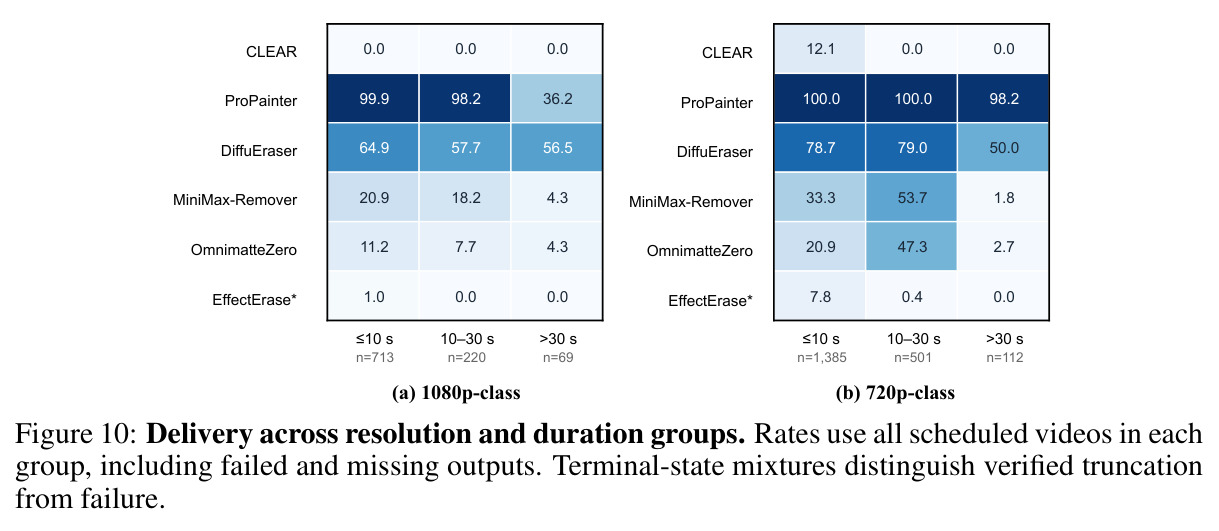
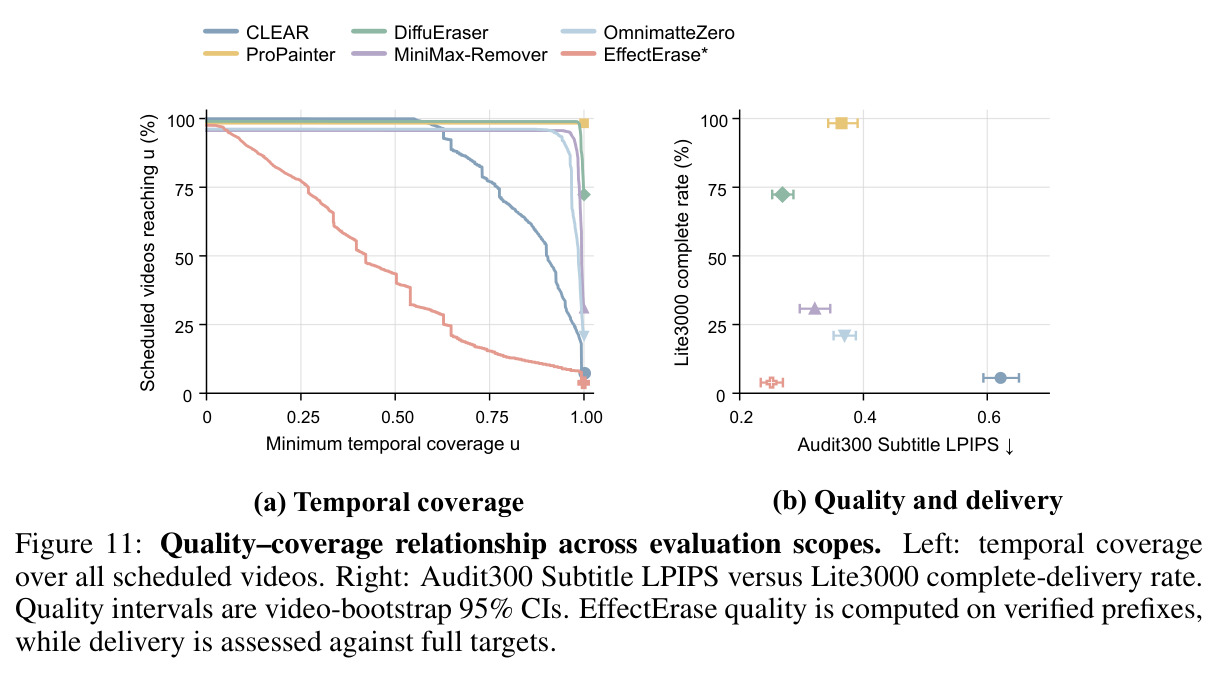
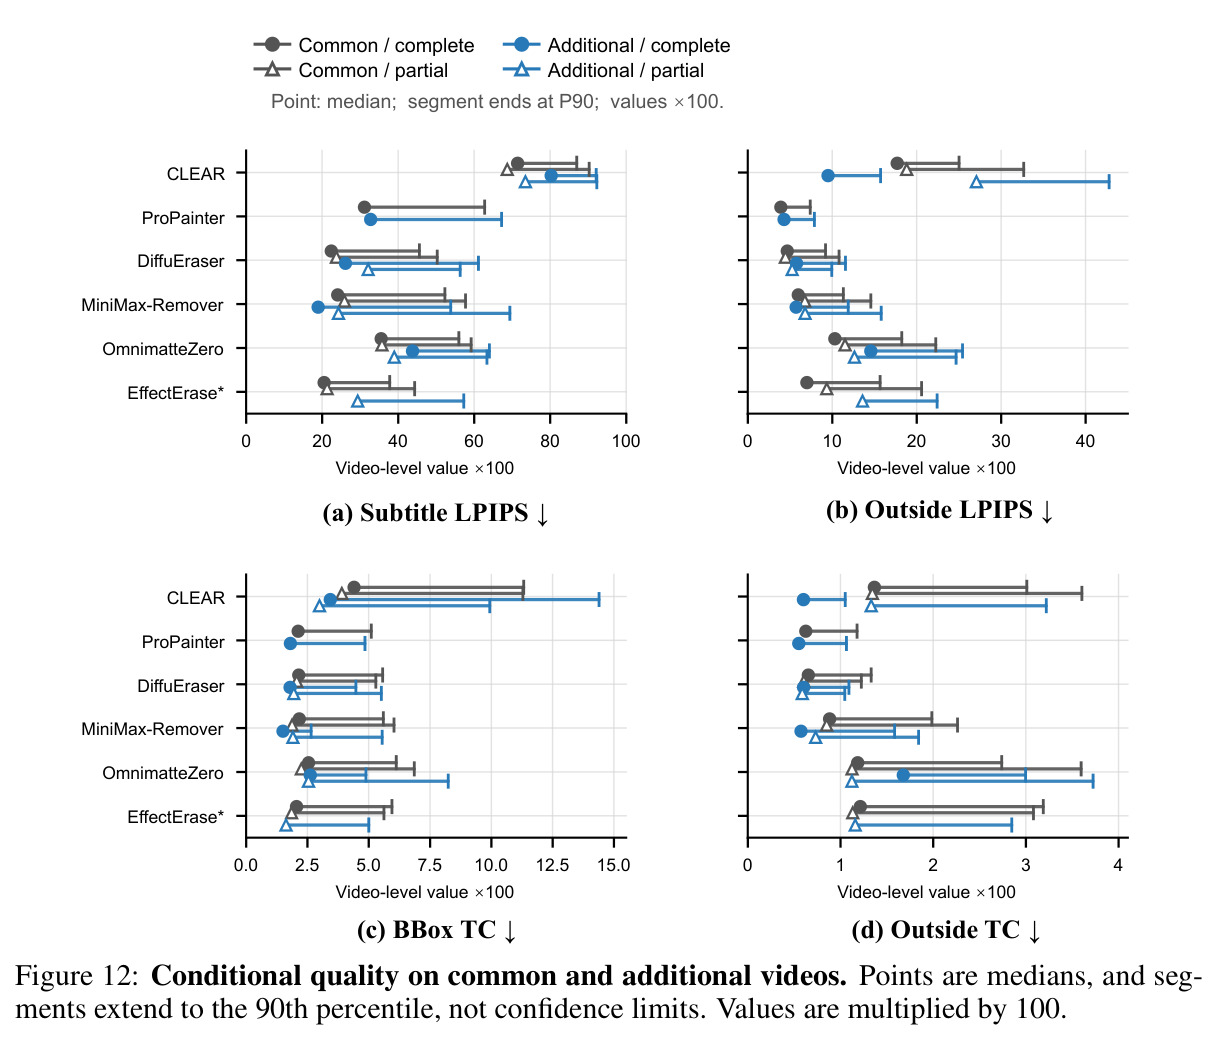
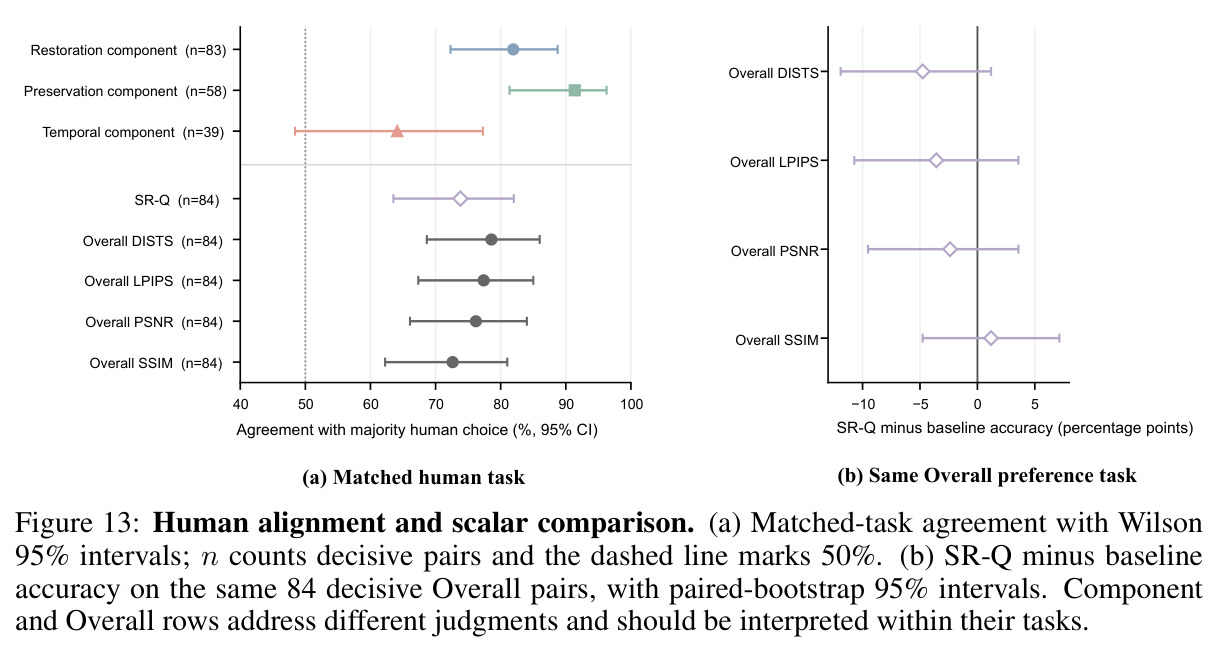
Audit300 主结果揭示了被全帧指标掩盖的能力权衡。修复维度:DiffuEraser 字幕区最佳(Subtitle PSNR 21.36 dB、LPIPS 0.269、cDISTS 0.116、SSIM 0.746),盲方法 CLEAR 仅 11.99 dB、LPIPS 0.621。保持维度:ProPainter 框外最佳(Outside PSNR 34.11 dB、LPIPS 0.050),几乎不动背景。时间维度:ProPainter 与 DiffuEraser 的 BBox TWE-Excess 相当(0.683 / 0.686 ×10⁻³),MiniMax-Remover 的 Outside TWE-X 最低(0.028×10⁻³),而 CLEAR 高达 15.042×10⁻³。发现一:能力互不可换——Subtitle 与 Outside LPIPS 在 10 个引导方法对中 5 对排序反转(Kendall τ=0.00),BBox TWE-X 与 TC 6 对反转(τ=−0.20);而 Overall LPIPS 与 Outside LPIPS 高度一致(τ=0.80、仅 1 对反转)、与 Subtitle LPIPS 仅 τ=0.20,证明全帧分数本质上在测'有没有改坏别处'而非'字幕区修得如何'。发现二:难度效应分化——Real-HQ 上全部 6 个方法的 Subtitle/Outside LPIPS 均劣于 AI 视频,但其中 5 个方法 BBox TC 反而更低,即视觉上更难修复不代表时间更不稳定;Hard 风格让引导方法的 Subtitle LPIPS 下降却推高 Outside LPIPS,CLEAR 则双双恶化;双语字幕对全部方法显著更难(Bilingual−Monolingual 组 150/150,区间不含零);动态布局对盲方法更难、对引导方法反而更容易。发现三:交付率天差地别——ProPainter 完整率 98.3%,EffectErase 仅 3.9%(其最低 Subtitle LPIPS 0.251 只在 43.1% 联合覆盖的验证前缀上成立),CLEAR 94.4% 为部分输出。发现四:人类对齐不对称——空间维度可靠(Preservation 组件准确率 91.4%;Restoration 组件 81.9%,Subtitle LPIPS 达 88.0%),时间维度 61% 的对未决、κ=0.123、组件准确率仅 64.1%;预注册的 SR-Q(73.8%)不敌 Overall DISTS(78.6%),Holm 校正后 McNemar p=1.0,未获晋升。
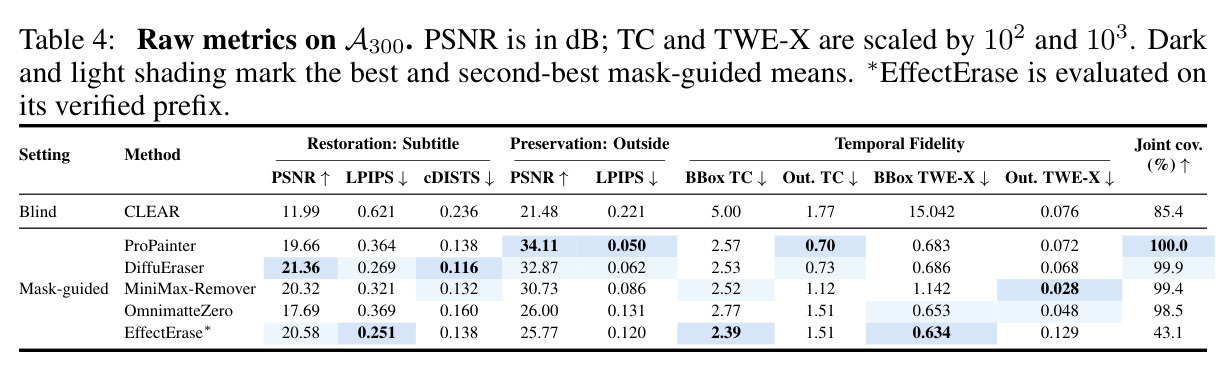
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 字幕区修复(Restoration Fidelity) | Subtitle PSNR (dB) ↑ | DiffuEraser 21.36 | CLEAR(盲)11.99;最佳引导基线 ProPainter 19.66 | 较盲方法 +9.37 dB,较最佳引导基线 +1.70 dB |
| 字幕区感知质量 | Subtitle LPIPS ↓ | EffectErase* 0.251(验证前缀) | CLEAR 0.621;完整输出最佳 DiffuEraser 0.269 | 较盲方法降低 0.370 |
| 字幕区结构纹理相似度 | cDISTS ↓ | DiffuEraser 0.116 | CLEAR 0.236 | 降低 0.120 |
| 区域外保持(Preservation Fidelity) | Outside PSNR (dB) ↑ | ProPainter 34.11 | OmnimatteZero 26.00;CLEAR 21.48 | 较最弱引导方法 +8.11 dB |
| 区域外感知保持 | Outside LPIPS ↓ | ProPainter 0.050 | CLEAR 0.221;EffectErase* 0.120 | 较盲方法降低 0.171 |
| 时间一致性(Temporal Fidelity) | BBox TWE-Excess (×10⁻³) ↓ | OmnimatteZero 0.653 | CLEAR 15.042;MiniMax-Remover 1.142 | 较盲方法降低约 23 倍 |
| 时间变化保真 | BBox TC (×10⁻²) ↓ | EffectErase* 2.39 | CLEAR 5.00;OmnimatteZero 2.77 | 较盲方法降低 52% |
| 全量交付可靠性(3,000 条全集) | 完整输出率 (%) ↑ | ProPainter 98.3% | EffectErase 3.9%;CLEAR 5.6% | 相差约 25 倍 |
| 全量交付可靠性 | 联合时空覆盖率 (%) ↑ | ProPainter 100.0 | EffectErase 43.1;CLEAR 85.4 | +14.6 至 +56.9 个百分点 |
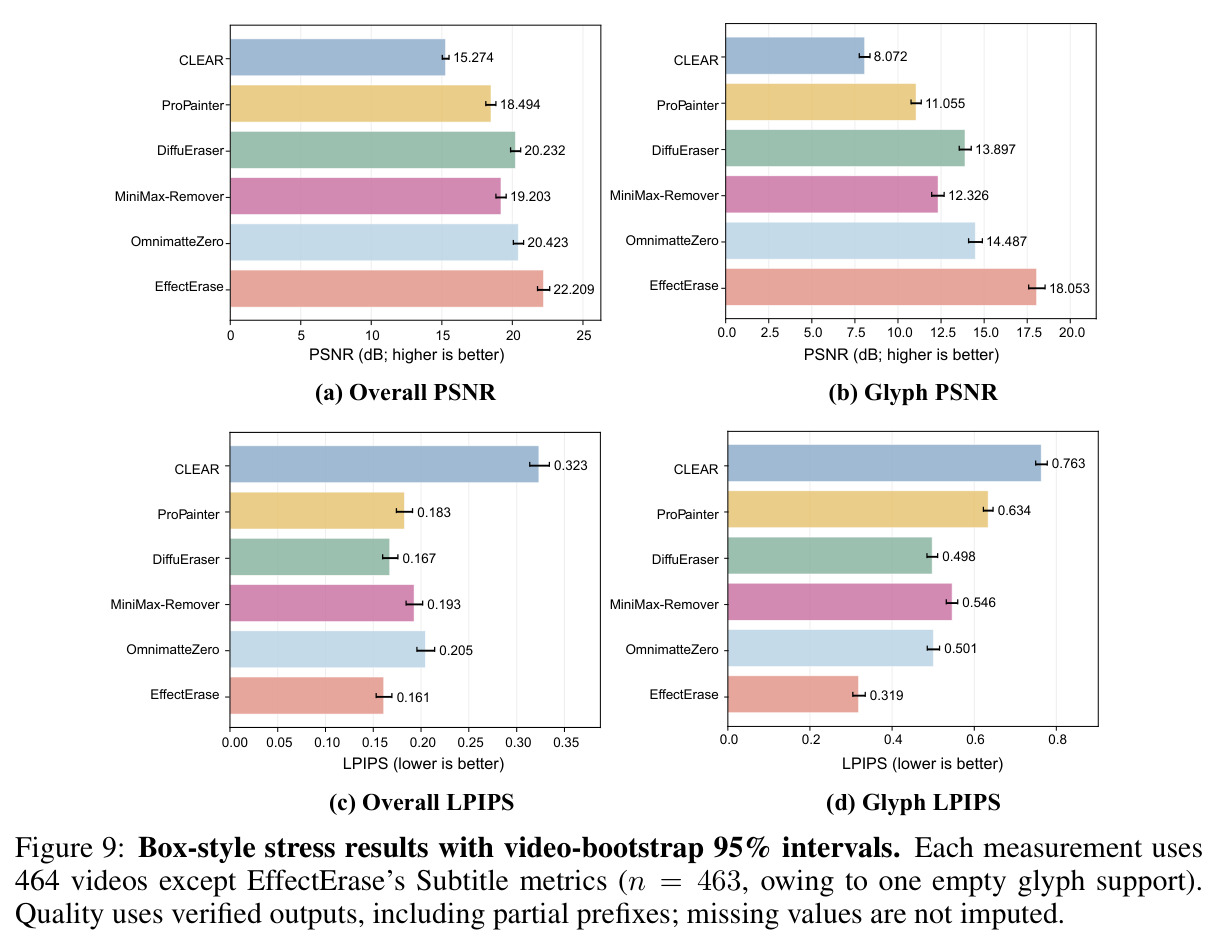
| 带底框样式压力集(464 条)字形核心修复 | Glyph PSNR (dB) ↑ | EffectErase 18.05 | CLEAR 8.07;ProPainter 11.06 | 较盲方法 +9.98 dB |
局限与改进
作者明确承认的局限包括:源与分辨率在 Audit300 中完全耦合(Real-HQ 全部为 1080p 类,Real-LQ 与 AI 生成全部为 720p 类),来源效应与分辨率效应无法分离,相关对比只能解读为联合层属性;字幕因子分组使用不同基视频,因子对比只是统计关联而非因果效应,面积、行数等中介变量只能逐因子单独评估;>30 秒的长视频切片仅 10 条 Real-LQ 视频,长时结论脆弱;时间维度的感知有效性未确立——人工研究中 61% 的对未决、标注者间 κ 仅 0.123,Temporal 指标与人类偏好的对齐区间很宽;BBox-NG 视图混合了附近背景与字幕效果,只能作局部诊断;带底框样式需要单独的 464 条压力集且 Outside 视图在该场景失效;953 条野外视频没有干净目标、未做隐私筛查,只能做覆盖分析;计时边界在各方法间不一致,10,137.4 GPU 小时不能作为效率比较。我自己的观察补充:盲设置只有 CLEAR 一个代表,'盲 vs 引导'的结论实际建立在单样本上,更强的盲方法 SEDiT 缺席可能改变格局;受控渲染的双语组合与霓虹金属风格可能偏离真实字幕分布,而能校准真实分布的野外集又缺少标注闭环;AI 生成视频缺乏真实传感器噪声与压缩伪影,'AI 视频更易修复'的外推存疑;TWE-Excess 为负不保证更好、TC 又会惩罚合理变化,两个时间指标解释成本高;基准完全未度量生成内容的'合理性/真实感',而这恰是生成式修复方法的核心诉求。
独立分析的弱点
独立分析的弱点及改进方向:(1)盲方法覆盖单薄——只有 CLEAR 一个盲方法,而盲去除无需标注、应用价值最高;建议纳入 SEDiT 等新方法,并增加字幕定位子任务(定位 IoU/命中率),把'找得到'与'修得好'拆开诊断,这也更符合其信息条件化的初衷。(2)条件质量与交付错位使榜单难以直接使用——EffectErase 条件指标最好却只覆盖 43.1%,ProPainter 覆盖 100% 但条件指标非最优;建议定义覆盖率加权的综合分数,或报告时强制标注最小覆盖门槛,并给出质量–覆盖帕累托前沿。(3)时间评估的感知效度不足——61% 未决率说明现有播放式对比对时间伪影不敏感或伪影本身难察觉;可设计闪烁检测、帧插值一致性等更灵敏的探测任务,或训练面向时间伪影的代理指标。(4)来源与分辨率混杂——可对 Real-HQ 做受控下采样构造同源不同分辨率对照组,实现真正的分辨率消融。(5)BBox 标注假设字幕效果都在框内——box 风格下 Outside 失效;建议渲染时同时输出包含阴影/发光/底框的'效果支撑掩码',使 Outside 视图恒有定义。(6)因子对比非因果——可在同一基视频上渲染多因子变体做被试内配对比较,把关联升级为效应估计。(7)算力门槛高——完整复现约一万 GPU 小时;建议发布预计算指标表与 Audit300 单卡快速评估脚本,降低社区跟进成本。
未来方向
作者提出的后续方向:在遵守上游许可的前提下发布渲染器、评估代码、冻结标识符、模型配置、分析表与逐样本溯源记录;野外集只再分发获许可资产并提供来源信息与重建说明;继续时间维度的感知验证(论文明确将其留作开放问题)。基于其成果可以自然延伸的研究有:(1)训练专用盲多语言字幕去除模型——3,000 条配对、16 语言、24 配置单元的监督信号可直接用于课程学习,把字幕因子难度作为训练调度信号;(2)把'叠加层移除'协议推广到台标、水印、贴纸移除等任务族,复用受控渲染 + 空间解耦 + 交付统计框架;(3)时间保真的感知校准——收集大规模时间伪影人类标注训练代理指标,解决 61% 未决与 κ=0.123 的测量失效;(4)质量–覆盖联合排行榜与帕累托前沿分析,把部分输出正式纳入排名理论;(5)利用 AI 生成层研究生成式修复模型的分布外失败模式及生成数据作基准层的适用边界;(6)渲染引擎反哺上游任务——合成带标注数据可训练字幕检测/OCR;(7)SR-Q 的失败本身是研究素材:组件与人类对齐但标量不对齐,说明线性/几何平均不是正确的聚合方式,值得研究面向人类偏好的指标融合理论。
复现评估
复现条件总体友好。开源方面:代码在 GitHub(hxyiiii/MFVSR),数据在 HuggingFace(siiian/MFVSR),论文承诺发布渲染器、评估代码、冻结标识符、模型配置、分析表与逐样本溯源记录;野外集因许可限制只发布可再分发部分并提供来源信息与重建说明。数据全部来自公开资源(OpenVidHD、Panda-70M、Pexels、VBench-2.0、Rapidata Sora、FLORES-200、Google Fonts),六个基线的推理配置(分辨率预算、掩码适配器、去噪步数、种子等)在 Table 6 完整冻结;评估采样(Lite3000 每视频 ≤48 帧 + 32 相邻对;Audit300 用只依赖元数据的固定种子优化器选出,组成:Real-HQ 123 / Real-LQ 88 / AI 89)与聚合方式(视频级宏平均 + 固定种子自举 95% CI)均有精确规定;指标细节如区域 PSNR 的平方误差池化、条件化 DISTS 公式与 16 像素上下文边距、TWE-Excess/TC 的数学定义、0.01 fps 帧率校验等足以复算。算力是主要门槛:六个基线全集推理共 10,137.4 GPU 小时(约 422.4 GPU 天),其中 MiniMax-Remover 占 4,500 小时、ProPainter 仅 289.6 小时;但复现评估协议本身只需少量方法与 Audit300 的 300 条视频(每视频最多 48 帧),中等规模单机数天可完成。人工研究(16 名标注者、944 个有效判断)复现成本较高但非必需。综合评级:协议复现容易、数据重建中等、全套基线复现需大算力,在基准论文中属可复现性上游水平。
论文图表
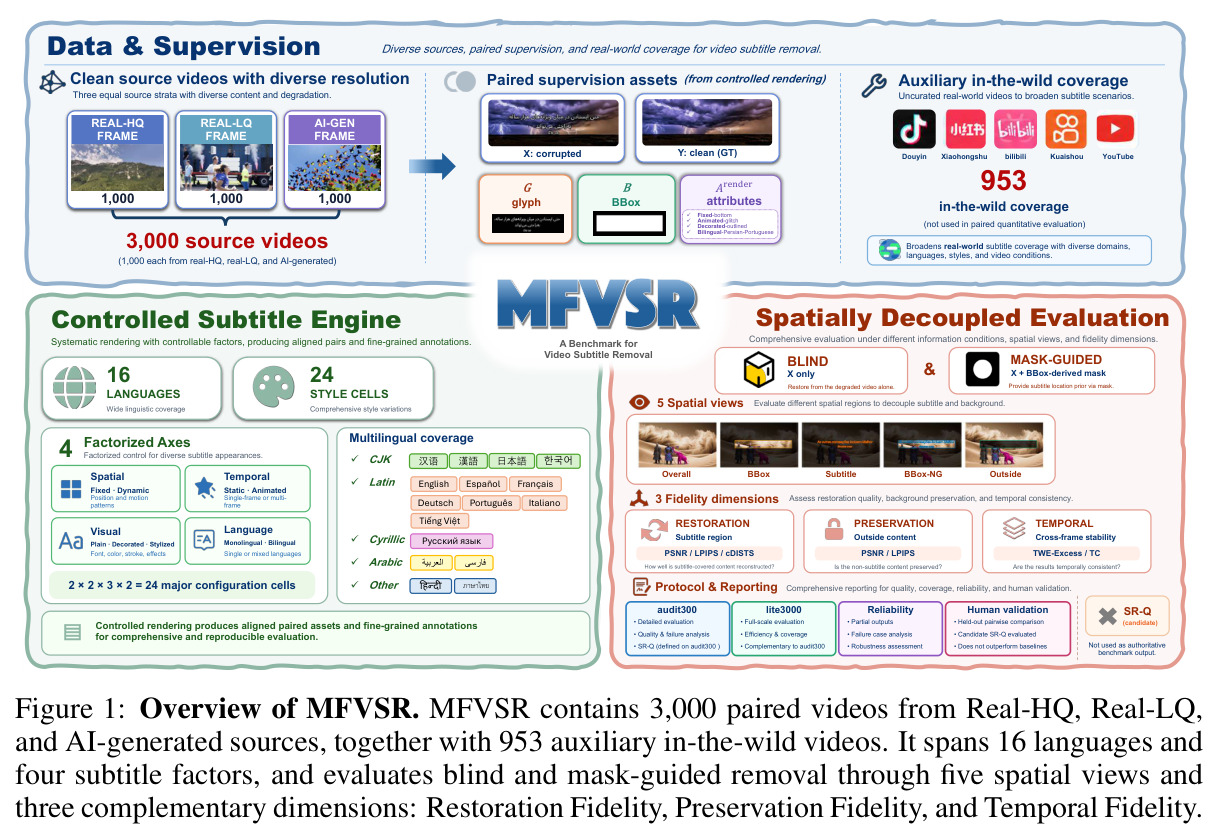
一页式总览图,上半部分展示数据体系:三个来源层各 1,000 条带字幕视频与干净真值 Y 配对,附字形/BBox 标注,及 953 条来自抖音、小红书、B站、快手、YouTube 的野外覆盖集;下半部分展示评估体系:16 语言 × 24 风格单元的受控渲染、盲与掩码引导两种输入条件、五个空间视图与三个保真维度,以及审计、可靠性统计与人工验证流程。
这张图浓缩了整个基准的设计哲学——数据(配对+野外)、受控多样性、信息条件化空间解耦评估三件事如何拼成一个系统。看懂它就掌握了论文的骨架,是阅读其他所有图表的地图。
表格列出六个方法的类别、掩码格式、骨干与时间机制:ProPainter(修复类,PNG 序列掩码,光流+稀疏 ViT,流引导传播);DiffuEraser(修复类,MP4 掩码,SD1.5+BrushNet,带先验的运动模块);MiniMax-Remover、OmnimatteZero、EffectErase(目标移除类,MP4 掩码,Wan/LTX DiT);CLEAR(字幕专用,无掩码盲输入,Wan DiT 时空注意力)。
它界定了实验的公平性边界:每个方法拿什么输入、走哪条路由一目了然,理解'盲与引导分块报告'以及 mask 适配器差异为何必须被冻结配置,都要以这张表为参照。
四行统计:Subtitle LPIPS vs Outside LPIPS 反转 5/10 对、Kendall τ=0.00;BBox TWE-Excess vs BBox TC 反转 6/10、τ=−0.20;Overall LPIPS vs Subtitle LPIPS 反转 4/10、τ=0.20;Overall LPIPS vs Outside LPIPS 仅 1/10 反转、τ=0.80。去除 EffectErase 后反转依然存在(2/6 与 6/6)。
它把'指标分歧'量化成可引用的统计量:τ=0.80 揭示全帧分数几乎就是区域外保持分数、与修复质量近乎无关,是论文最具冲击力的一句话结论的数据来源。
按人类任务分块:修复任务(n=83)中 Subtitle LPIPS 准确率 88.0% [79.2, 93.3] 最高,组件 81.9%;保持任务(n=58)组件与 Outside LPIPS 均为 91.4%;时间任务(n=39)组件仅 64.1% [48.4, 77.3]、Outside TC 74.4%;整体任务(n=84)中 SR-Q 73.8% 低于 Overall DISTS 78.6% 与 Overall LPIPS 77.4%。
它是对整个评估协议的外部校验:证明空间维度的区域视图捕捉了人类可感知的差异,同时否定了 SR-Q 标量的优势——一正一负两个结论共同支撑'保留三维原始画像为主证据'的最终设计决定。