截断与否?截断反向传播下循环Transformer的缩放研究 Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation
统一缩放律表明循环Transformer全BPTT最优,两次完整循环以27%更少参数媲美非循环模型
前置知识
循环Transformer(looped transformer)
一种深度参数共享架构:模型由 prelude(含输入嵌入)、共享循环块、coda(含输出头)三段组成,循环块 $R$ 与注入矩阵 $W_{inj}$ 只有一份参数,但在一次前向中被重复执行 $T$ 次。每步更新为 $s_t=\mathrm{RMSNorm}(R(W_{inj}[s_0;s_{t-1}]))$,即把初始状态 $s_0$ 注入每一步(input injection)再通过共享块。这样计算的深度随 $T$ 增长,可训练参数却不变,代表工作有 Universal Transformer、ALBERT 和 Huginn 的 prelude–recurrent–coda 架构。
本文的研究对象就是这种架构:缩放律里只有循环块参数 $N_{rec}$ 会被循环"放大",prelude/coda 参数 $N_{once}$ 只算一次,这一结构划分直接决定了有效参数 $N_{eff}$ 的构造方式。
截断BPTT(truncated backpropagation through time)
循环模型训练时梯度需沿 $T$ 个循环反向传播(BPTT),开销大。截断 BPTT 设置为 $(T,B)$:前向跑满 $T$ 个循环,但只对最后 $B$ 个循环回传梯度,在第 $T-B$ 步的状态 $s_{T-B}$ 上施加 stop gradient,前面的循环仅前向执行、不存激活。$B=T$ 即全 BPTT,$B<T$ 为截断,$(1,1)$ 就是普通 Transformer。一次反向循环的 FLOPs 约是前向的两倍,所以截断省算力,但梯度有偏。
论文标题"截断与否"问的正是这个选择:截断的算力节省与梯度偏差之间的权衡,是全文缩放律要定量刻画的核心变量 $B$。
神经缩放律与计算最优训练
缩放律用幂律刻画验证损失与参数量 $N$、训练token数 $D$ 的关系,如 Chinchilla 的 $L=E+A N^{-\alpha}+H D^{-\beta}$;本文采用 Videau 等的耦合形式 $L=E+[A(N/N_0)^{-\alpha}+H(D/D_0)^{-\beta}]^{\kappa}$。在固定算力 $C\approx 6ND$ 下最小化损失可得计算最优的 $N,D$ 配比(IsoFLOP 分析),这是现代大模型"该训多大、训多久"的标准决策工具。
本文把循环数引入这套框架:用有效参数替换 $N$,再从驻点条件解析导出循环数、token、模型大小随算力的最优增长指数,是典型的缩放律建模工作。
有效参数与计算等价参数
论文分析循环设置 $(T,B)$ 时使用两个"等效的非循环模型大小":按损失等价的有效参数 $N_{eff}=N_{once}+g(T,B)\cdot N_{rec}$(它达到相当于多大的非循环模型的损失),以及按FLOP等价的计算参数 $N_{comp}=N_{once}+\frac{T+2B}{3}N_{rec}$(它花费相当于多大的非循环模型的算力,反向按2倍前向计)。二者之比 $\chi=N_{comp}/N_{eff}$ 表示"每一份有效参数付出的算力"。
整篇论文的决策逻辑都建立在这对概念上:固定 $T$ 时该不该截断,归结为枚举整数 $B$ 最小化 $\chi$;理解了 $N_{eff}$ 与 $N_{comp}$ 的分离,才能看懂全部结论。
研究动机
循环Transformer通过重复使用同一组共享层(如Huginn的prelude–recurrent–coda架构)在不增加可训练参数的前提下提升计算深度,参数与显存效率出色。但训练它需要沿循环深度做时间反向传播(BPTT),代价高昂;为省算力,近年的循环语言模型普遍采用截断BPTT——只对最后 $B$ 个循环回传梯度,前面 $T-B$ 个循环仅前向执行。截断节省反向计算和激活显存,却引入有偏梯度,可能削弱循环带来的收益(Schwethelm等2026年已观察到这种现象)。于是出现一个关键的资源分配问题:固定训练算力下,算力应如何在 $T$、$B$、模型大小 $N$ 和训练token数 $D$ 之间划分?现有缩放研究都没把 $T$ 和 $B$ 当独立变量联合建模:Schwethelm等对"全BPTT"和"截断一半"分别各拟一条缩放律,无法回答"该不该截断";Parcae在小模型上变动过 $B$,但在缩放实验中固定 $B=\lceil T/2\rceil$,把联合优化留作未来工作。
本文的目标是本文要回答一个明确问题:"模型大小、训练token数、前向与反向循环数如何共同决定损失?在固定训练算力预算下到底该不该截断反向传播?"为此作者训练了近600个模型(共592次运行),缩放套件覆盖58M–919M非嵌入参数的五个尺寸、每参数1.1–1291个token(三个数量级)、最多16个前向循环共15种 $(T,B)$ 设置,独立变动前向和反向循环数。在此基础上拟合一统一缩放律,希望它做到三件事:(1)用"有效参数量"统一刻画循环收益与截断折扣;(2)解释截断在什么条件下划算、什么条件下不划算,并解释已有文献表面矛盾的结论;(3)分别给出模型大小固定(受显存约束)和模型大小自由两种情形下的计算最优分配规则,并给出可落地的参数高效训练配方。
与已有工作不同的是,本文的独特切入是把反向循环数 $B$ 作为独立变量写进缩放律,并用一个有界饱和的循环增益函数同时统一"循环收益"与"截断折扣"。此前对循环语言模型的缩放律要么对每种架构单独拟合曲线(SMELT、Lee等),要么只建模单一循环数 $T$ 而把 $B$ 固定或绑定于 $T$:Schwethelm等用无界幂律增益 $T^{\phi}$,Parcae用线性增益,Ouro用加性损失项。本文则把耦合的规模–数据缩放律(Videau等)与有界循环增益(Chen等的饱和观察)结合,提出 $g(T,B)=\exp[c\,(1-T^{-p}B^{-q})]$,同时满足归一化 $g(1,1)=1$、单调性、零反向极限 $g(T,0)=0$ 和饱和上界 $e^c$ 四条建模要求。正是这一形式让"固定 $T$ 时截断有利"与"联合优化时全BPTT最优"这两组看似矛盾的实验现象在同一律下自洽地被解释。
核心方法
直觉上,循环Transformer里只有循环块 $R$ 和注入矩阵 $W_{inj}$ 被每个循环重复执行,循环只会"放大"这部分参数的价值,因此作者把非嵌入参数拆成只跑一次的 $N_{once}$(prelude与coda)和每循环复用的 $N_{rec}$,用有效参数量替换损失律中的 $N$:$L=E+[A(N_{eff}/N_0)^{-\alpha}+H(D/D_0)^{-\beta}]^{\kappa}$,其中 $N_{eff}=N_{once}+g(T,B)\cdot N_{rec}$,循环系数 $g(T,B)=\exp[c\,(1-T^{-p}B^{-q})]$ 随 $T$、$B$ 增大单调升向有限上界 $e^c$,截断则打折扣 $g(T,B)/g(T,T)\le 1$。实验遵循Schwethelm等的prelude–recurrent–coda架构与训练配方:在100B token的FineWeb-Edu语料上训练五个尺寸(60M/120M/240M/480M/1B,非嵌入参数57.8M–918.7M,宽度768–2176,prelude/循环/coda层数从2/4/2到4/8/4),矩阵参数用MuonH、嵌入/输出/归一化用AdamW,报告去重held-out分片上的验证交叉熵(nats/token)。全网格592次运行、347个配置,$T\in\{1,2,4,8,16\}$,230个配置用于拟合、117个留作独立检验。
核心创新有三点。第一,用"一对尺寸"刻画任意循环设置 $(T,B)$:同一模型对应两个等效的非循环尺寸——按损失等价的有效尺寸 $N_{eff}$(它值多少参数)和按FLOP等价的计算尺寸 $N_{comp}=N_{once}+\frac{T+2B}{3}N_{rec}$(它花多少算力,前向每参数每token算2 FLOPs、反向算4),二者之比 $\chi=N_{comp}/N_{eff}$ 就是"每有效参数付出的算力",于是固定 $T$ 的截断决策化成与总算力无关的整数优化:选 $B$ 最小化 $\chi(T,B)$(Lemma D.1)。第二,凸优化论证:固定循环算力 $S=T+2B$ 时最大化 $g$ 等价于最小化 $T^{-p}B^{-q}$,这是标准凸问题,当 $q>2p$ 时唯一解为 $T=B=S/3$,即全BPTT(Lemma D.2);拟合值 $q\approx1.022$ 远大于 $2p\approx0.474$。第三,有界饱和增益 $g(T,T)=\exp[c(1-T^{-(p+q)})]$ 趋于 $e^c\approx3.04$,取代先前工作的无界幂律,使"截断在固定 $T$ 时有利"与"联合优化时全BPTT最优"在同一律下自洽。
方法步骤详情
流程分五步。(1)建实验网格:五个尺寸的 $N_{rec}/N$ 相近(0.505–0.564),每个尺寸在15种 $(T,B)$ 设置与多个token预算下训练,缩放套件347个配置跨1.1–1291 token/参数,共592次运行,同配置多次运行取平均验证损失。(2)联合拟合:对九个参数 $E,A,H,\alpha,\beta,\kappa,c,p,q$ 最小化平方误差,配置等权,参考尺度固定 $N_0=2.4\times10^8$、$D_0=2^{30}$,从64个随机初值出发取最优,全部收敛;结果 $E=0.299$、$A=6.487$、$H=7.633$、$\alpha=0.306$、$\beta=0.393$、$\kappa=0.325$、$c=1.112$、$p=0.237$、$q=1.022$。(3)留一验证:分别留出一个配置、一个模型尺寸、一个token预算、一个循环设置重新拟合再预测被留出的测量,RMSE为 $6.4$–$8.7\times10^{-3}$ nats,$R^2=0.9992$。(4)解释性检验:用PCHIP插值从非循环运行反推经验有效尺寸与经验循环系数,与仅含 $c,p,q$ 的 $g$ 预测面对比,吻合良好。(5)决策与分配:固定 $T$ 时枚举整数 $B$ 最小化 $\chi$;$T$ 自由时做凸优化;再从驻点条件解析导出固定尺寸与自由尺寸的算力分配幂律,并用专门实验验证。
技术新颖性
与已有工作的本质区别有四。(a)统一性:Schwethelm等需要为每种BPTT配方各拟一条律,结构上无法回答"该不该截断";本文的律把 $T,B$ 当变量,一个框架内同时预言"固定 $T$ 时截断有利"与"$T$ 可选时全BPTT最优"两种结论,并用分别拟合的律和等算力实验交叉验证。(b)增益形式:循环增益取有界指数饱和而非幂律(Schwethelm)、线性(Parcae)或加性(Ouro);作者用对held-out前向循环数的预测精度证明有界形式更符合数据。(c)决策还原:把截断决策还原为只依赖 $\chi(T,B)$、与总算力无关的整数优化问题,并给出严格引理(D.1、D.2),说明结论 $q>2p\Rightarrow$ 全BPTT的解析依据。(d)分配规则的来源:$T^*\propto C^{0.24}$、$D^*\propto C^{0.76}$ 等指数是从拟合律的渐近驻点条件推导出来的,而非对经验最优点的二次拟合,把Parcae只在固定尺寸、固定截断规则下的分析推广到联合选择 $T,B$。
实验结果
六组发现均有数字支撑。(1)律拟合极好:230配置拟合集 $R^2=0.9992$,RMSE $6.14\times10^{-3}$ nats/token;留出模型尺寸或token预算的LOO误差仅7.48和 $6.42\times10^{-3}$,留出循环设置最难($8.67\times10^{-3}$)。(2)循环增加有效参数、截断打折:$N_{eff}/N$ 从 $(1,1)$ 的1.00升至 $(2,2)$ 的1.46、$(4,4)$ 的1.76、$(8,8)$ 的1.91,系数趋向上界 $e^c\approx3.04$;且 $q\approx1.02>p\approx0.24$,同起点下 $B$ 翻倍比 $T$ 翻倍更值钱。(3)固定 $T$ 时截断有利:$T=8$ 时律选 $B^*=2$,$\chi(8,2)=1.580$ 远小于 $\chi(8,8)=2.376$,预测等损失省34%算力($N^*$、$D^*$ 各增1.51、1.20倍);单独拟合的律证实 $T=4$ 省5–11%、$T=8$ 省33–35%。(4)$T$ 自由时全BPTT最优:等算力实验($D=16D_0\approx172$亿token)中 $(4,4)$ 在60M–1B所有尺寸上均低于 $(8,2)$,$\Delta L$ 从 $2.78\times10^{-3}$ 降至 $0.87\times10^{-3}$ nats;等损失下省8–14%算力。(5)固定尺寸最优分配 $T^*\propto C^{0.24}$、$D^*\propto C^{0.76}$:算力×10对应循环×约1.7、token×约5.8,五个尺寸一致。(6)尺寸自由时不循环最优、两次完整循环最佳:$(2,2)$ 与计算最优非循环模型差距≤0.008 nats却少27–32%参数;$2.1\times10^{19}$ FLOPs处多训8%后,$(2,2)$(344M)损失2.36反超非循环(471M)的2.37。
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 缩放律对验证损失的预测(含留一验证) | RMSE(nats/token,×10⁻³) | 拟合集内 6.14;留出一个配置 6.40;留出一个模型尺寸 7.48;留出一个token预算 6.42;留出一个循环设置 8.67 | 此前工作为各架构/各配方分别拟合,无统一 $T,B$ 联合律可比 | 单条统一律覆盖15种循环设置与5个尺寸,$R^2=0.9992$,对未见过的尺寸和预算误差仅约0.006–0.007 nats |
| 固定前向循环数 $T=8$ 时截断与全BPTT的等损失计算 | 等损失所需训练计算节省 | 律预测 $B^*=2$ 时节省34%($\chi(8,2)=1.580$ vs $\chi(8,8)=2.376$);对 $T=8$ 单独拟合的律证实33–35% | 全BPTT $B=T=8$ | 截断在 $T$ 被规定时确有优势,且节省随 $T$ 增大($T=4$ 时为5–11%) |
| 等算力匹配实验:$(4,4)$ vs 截断 $(8,2)$($D=16D_0$≈172亿token) | 验证损失差 $\Delta L$(nats/token,×10⁻³) | $(4,4)$ 全BPTT在所有尺寸更低:60M 2.78、120M 1.47、240M 1.36、480M 1.07、1B 0.87 | $(8,2)$ 截断BPTT(同为 $T+2B=12$ 循环算力) | 等损失下 $(4,4)$ 少用8–14%计算,验证 $T$ 可选时全BPTT最优 |
| 参数效率:$(2,2)$ 两次完整循环 vs 计算最优非循环模型 | 验证损失(nats/token)与非嵌入参数量 | 等算力下差距≤0.008 nats;$2.1\times10^{19}$ FLOPs处344M参数、+8%算力后损失2.36 | 非循环模型471M参数、损失2.37 | 少27–32%非嵌入参数达到近乎相同损失;多花8%计算即反超0.007 nats |
局限与改进
作者明确承认四点局限:只研究稠密(dense)模型,未涉及循环MoE架构(而循环MoE常采用两次循环),截断与算力分配结论能否迁移未知;只测量验证损失,未验证观察到的收益能否转化为下游任务表现或推理能力;实验止步于 $T\le16$(Schwethelm等到8循环、Parcae平均12循环),增益上界 $e^c$ 与更深循环处的切换点均属外推,而更深循环还会加剧残差爆炸与loss spike等不稳定问题;每个尺寸的prelude/coda与循环块参数比例固定,未探索不同比例下的循环收益与最优循环数。我的补充观察:FLOP计数采用leading-order近似(每参数每token前向2、反向4,忽略注意力项、输出投影与优化器更新),长上下文或大词表场景下 $\chi$ 的排序可能改变;§6.3的关键差距只有0.007–0.008 nats、每模型仅3个种子,已接近种子间噪声量级;所有系数在单一语料FineWeb-Edu(教育网页)上拟合,对代码、数学等分布的普适性存疑;饱和假设基于信息存储论证,属经验建模而非理论必然。
独立分析的弱点
弱点一:计算模型粗糙。$C\simeq 6D\cdot N_{comp}$ 忽略注意力的序列长度项、输出投影与优化器更新,在实验的短上下文小模型上尚可,但注意力占比随上下文上升,$\frac{T+2B}{3}$ 的等价关系会失真,可能动摇 $B^*=2$ 与全BPTT结论;改进方向是把注意力与优化器FLOPs显式纳入重新拟合并重解分配。弱点二:结论完全依赖拟合值 $q\approx1.022>2p\approx0.474$,论文未报告 $c,p,q$ 的置信区间,也没有数据重采样下的稳健性检验;若 $q$ 逼近 $2p$,"全BPTT最优"将失去解析依据,建议bootstrap给出参数区间。弱点三:只看验证损失——循环模型常被宣传对推理/思维链有优势,仅凭损失选 $T,B$ 可能与下游能力错位。弱点四:所有结论绑定单一架构选择(RMSNorm、输入注入、ReLU² FFN、固定 $N_{rec}/N$),残差/超连接、MoE路由等改良结构下 $g$ 的形状可能不同。弱点五:整数循环数的台阶效应使固定尺寸分配律只是渐近结果,小算力区间偏差可能不小,实践应结合逐点IsoFLOP扫描。
未来方向
作者提出的方向:把统一律扩展到循环MoE模型;验证损失的收益能否转化为下游任务与推理能力;突破 $T=16$ 并发展稳定训练配方以应对残差爆炸与loss spike;变化prelude/coda与循环块的参数占比,研究参数分配对循环收益的影响。基于成果可延伸的方向:把截断BPTT与不动点梯度/截断Neumann级数的既有理论联系做定量刻画,从理论上解释为何 $q\gg p$(反向深度远比前向深度重要);训练–推理协同设计——循环次数可变的自适应深度与早退机制下,最优训练深度与推理预算可能不同,律可以给出先验;在代码、数学等不同数据分布上重拟合 $c,p,q$,检验饱和上界 $e^c$ 的普适性;把"两次完整循环"的参数效率结论放大到7B级实用规模,并结合蒸馏、深度共享微调等手段落地;以及把该律用作实际预训练的循环配置决策工具(类似Chinchilla在非循环模型中的角色)。
复现评估
复现条件总体较好:代码开源于 https://github.com/xjxyys/Truncate-or-Not,数据为公开的FineWeb-Edu(100B token),prelude–recurrent–coda架构细节(输入注入 $W_{inj}$ 初始化为 $[I\ 0]$、RMSNorm、stop gradient位置)与训练超参(MuonH用于矩阵、AdamW用于嵌入/输出/归一化,学习率与batch规则)在附录B.3有完整描述,五个模型配置(宽度、层数、$N_{rec}/N$)在表2给出。但完整复现缩放套件需592次训练、最大919M非嵌入参数、单次运行算力最高约 $10^{20}$ FLOPs量级,估计要数十万GPU小时,普通实验室难以承受。务实的做法是部分复现:在中尺寸(如240M)上做几组等算力匹配对比($(4,4)$ vs $(8,2)$,或 $(2,2)$ vs 非循环),以及在1–2个尺寸上重拟合九参数看量级是否一致,即可低成本检验核心主张。难度评估:部分复现中等,全量复现困难。
论文图表
四联概览图。(a) $(T,B)=(4,2)$ 的一次训练步:前4个循环中最后2个有梯度。(b) 在 $8D_0$ token处循环增加有效参数而截断对其打折(第4节,线为律、点为运行)。(c) 固定120M尺寸下全BPTT的最优循环数随算力增长。(d) $(2,2)$(344M参数)以多8%计算、少27%参数取得优于非循环 $(1,1)$(471M,$2.1\times10^{19}$ FLOPs)的损失(2.36 vs 2.37 nats)。
一图预览全文三个核心结论(循环增益与截断折扣、固定尺寸下最优循环数随算力增长、两次完整循环的参数效率),是理解论文故事线最快入口。
把各循环设置 $(T,B)$ 放在律找到的计算最优点上:横轴为达到同样损失相对不循环模型所需的训练算力倍数(×1–×4),纵轴为节省的非嵌入参数比例(0–50%)。实心点为全BPTT,虚线是律对 $T=2$ 到16的全BPTT预测:所有截断设置都落在曲线下方,全BPTT构成前沿;$(2,2)$ 以约8%额外计算节省约50%参数,最接近不循环模型。
直观展示"不循环最优但 $(2,2)$ 最划算"这一主要实践结论,并可视化全BPTT优于一切截断设置的前沿关系。
架构图。(a) 一次训练步:prelude产出 $s_0$,循环块共享权重迭代 $T=4$ 次,对 $s_{T-B}=s_2$ 施加stop gradient(前2个循环仅前向),coda读 $s_T$ 出预测。(b) 单个循环:$W_{inj}[s_0;s_{t-1}]$ 注入初始状态,接循环块与RMSNorm。(c) 各部分FLOPs计账:总计算为 $6N_{once}+(2T+4B)N_{rec}$。
看懂 $(T,B)$ 语义、stop gradient位置和 $\frac{T+2B}{3}$ 计算等价参数推导的基础,是方法部分的架构依据。
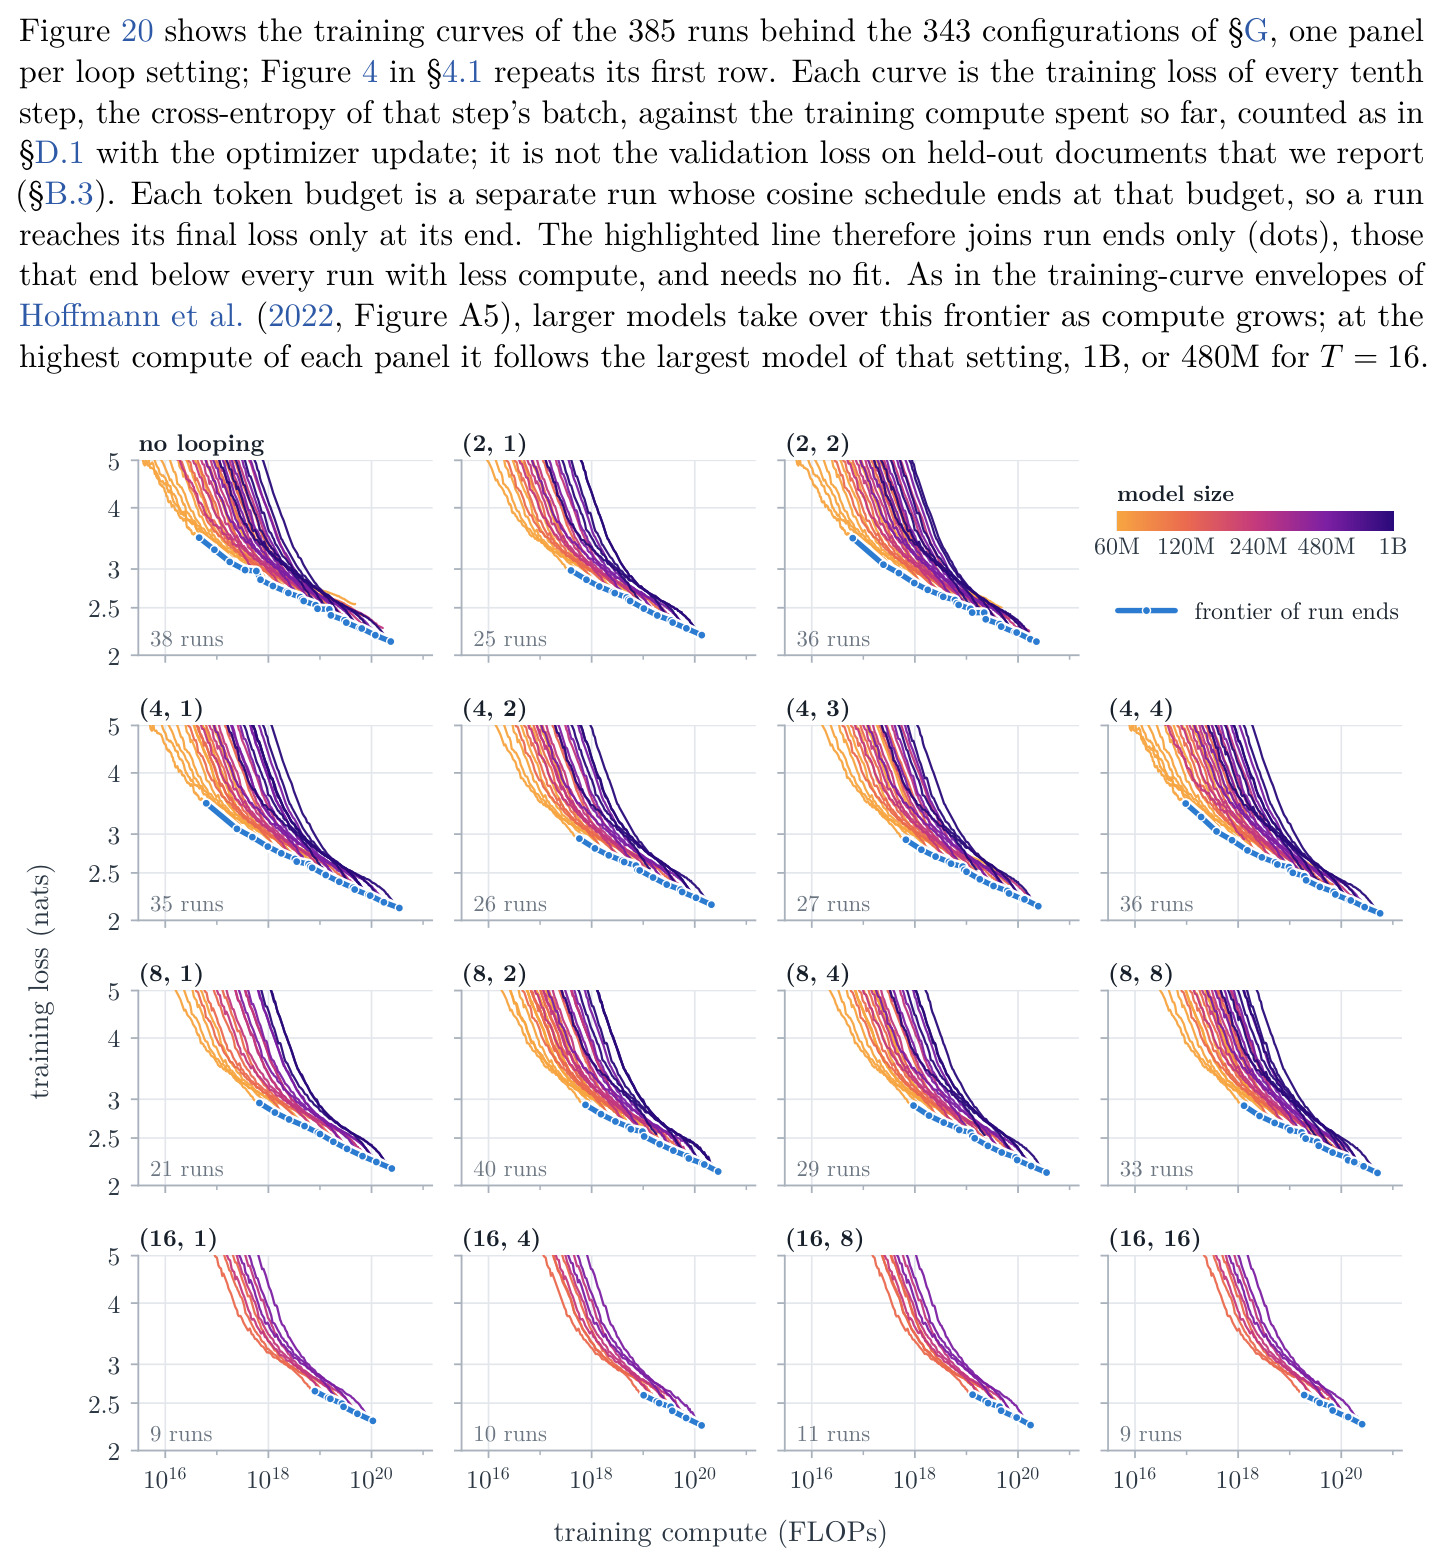
三种设置(不循环38次、$(2,1)$ 25次、$(2,2)$ 36次运行)的训练损失随训练FLOPs的曲线,按模型尺寸着色,高亮线与点为"运行终点前沿"(低于所有更小算力运行的运行)。随算力增大,更大模型接管前沿,与Hoffmann等2022的模式一致。
展示原始实验数据质量与缩放套件全貌,说明拟合所用的运行分布和"前沿"概念如何定义。
150个配置上损失匹配的经验循环系数 $\tilde g$ 对训练比例 $r=B/T$ 的中位数与范围,及各 $T$ 下 $\log_2\tilde g$ 对 $\log_2 r$ 的最小二乘拟合线:$T=2$ 时斜率0.823、$T=4$ 时0.446、$T=8$ 时0.173。截断相同比例循环的代价随 $T$ 增大而减小,说明 $g$ 必须把 $T$ 和 $B$ 耦合起来。
为循环系数 $g(T,B)$ 的函数形式提供直接经验动机,解释为什么不能只用单一比值 $B/T$ 建模截断。
全数据拟合的循环系数曲面 $g(T,B)$(面与菱形)与163个 $T\le8$ 配置的经验循环系数(圆点与灰色IQR条)对比,竖线段连接同设置的经验中位数与拟合值。仅 $c,p,q$ 三个参数的曲面即可捕捉运行对 $T$、$B$ 的依赖。
验证 $g(T,B)=\exp[c(1-T^{-p}B^{-q})]$ 这一关键建模选择的正确性,是缩放律可信度的核心证据。
全BPTT四种设置(不循环、$(2,2)$、$(4,4)$、$(8,8)$)在五个模型尺寸上验证损失对训练token($D/D_0$,$D_0=2^{30}$)的曲线;实心点为拟合集运行,空心点为留出运行,线为全数据拟合律。更多循环在每个尺寸与预算下都降低损失,且一条律追踪所有曲线。
缩放律与测量最直接的对照图,同时展示留出配置(空心点)也被律准确预测,是律有效性的主证据。
固定240M尺寸与 $2D_0$ 预算。(a) $B=T$ 时增益随 $T$ 饱和,而先前工作的幂律增益(虚线)无界增长;(b) 固定 $T$ 时训练更多循环(增大 $B$)持续降低损失;(c) 固定 $B$ 时增加前向循环 $T$ 帮助甚微。结论:训练更多循环比跑更多循环更有效。
分离 $T$ 与 $B$ 的贡献,直观呈现 $q>p$(反向比前向重要)这一驱动全文结论的不对称性。
三个视角解读循环设置的"价值"。(a) 全BPTT的 $g(T,T)$ 逼近拟合上界(虚线为外推);(b) $g(T,B)$ 随训练比例 $B/T$ 变化;(c) 各设置的总有效尺寸 $N_{eff}/N$(按 $B$ 分组):$(1,1)$ 1.00、$(2,1)$ 1.09、$(4,1)$ 1.19、$(8,1)$ 1.27、$(2,2)$ 1.46、$(4,2)$ 1.53、$(8,2)$ 1.60、$(4,4)$ 1.76、$(8,4)$ 1.80、$(8,8)$ 1.91。有效尺寸主要由 $B$ 决定,同 $B$ 组内增加 $T$ 几乎无收益。
用"有效参数"语言把每个循环设置的价值量化成单一数字,是理解第4节解释框架和后续算力分配的关键图。
对 $B^*=2$ 与 $B=T$ 分别拟合律的等损失等值线与计算最优前沿:$T=4$ 时 $B^*=2$ 等损失省5–11%计算,$T=8$ 时省33–35%(阴影为差距)。截断省下的计算部分投入更大模型。两设置的计算最优点均落在各自运行范围内。
用与统一律无关的独立拟合交叉验证"固定 $T$ 时截断有利"的预测,排除统一律拟合伪影的可能。
$(T,B)=(4,4)$ 与 $(8,2)$(两者 $T+2B=12$,计算相同)的等损失等值线:实线 $(4,4)$ 在每个损失水平都位于虚线 $(8,2)$ 左侧,即等损失少用8–14%计算。粗线为各自的计算最优前沿,渐隐段落在运行范围之外。
等循环算力下的直接对照,是"一旦 $T$ 可选,全BPTT击败截断"结论的独立拟合证据,与Figure 10互补。
上排固定240M尺寸:(a) 五档算力下损失对循环数的IsoFLOP曲线及最优点(星标);(b)(c) 最优循环数与最优token数随算力增长,趋近指数 $(6.4)$。下排尺寸自由:(d) $(1,1)$ 与 $(2,2)$ 的损失对模型尺寸曲线及最优点;(e)(f) 最优参数与token的标度,$(2,2)$ 在更小模型处逼近 $(1,1)$。
集中展示第6节两组算力分配结论(固定尺寸与自由尺寸)的实验依据,是理解 $C^{0.24}/C^{0.76}$ 指数来源的图。
四个尺寸上各循环设置的损失减去同算力不循环模型的损失(后者把算力花在更多token上):随算力增长最优设置从 $T^*=1$(不循环)切换到 $T^*=2$ 再到 $T^*=4$,粗线为最优设置轨迹(渐隐为外推)。切换之间新增算力花在token上,切换时用token换循环。
验证"固定尺寸下最优循环数随算力缓慢增长"的运行级证据,把抽象指数 $T^*\propto C^{0.24}$ 落到可读的切换行为。
拟合的 $g(T,T)$(实线,整数 $T$ 处有标记)与 $T$ 份不共享副本(虚线)对比:$T\ge2$ 时 $g(T,T)<T$,即不共享副本始终更值钱;差距在 $T=2$ 最小,此时两次循环接近两份副本的有效尺寸。
解释为什么"不循环最优"却"$(2,2)$ 接近最优":两次共享循环几乎白拿两份副本的有效尺寸,是第6.2节论证的核心。
在 $2.1\times10^{19}$ FLOPs处对比计算最优 $(2,2)$ 与不循环模型(同Figure 1d):$(2,2)$ 用344M非嵌入参数(少27%)、多8%训练计算,损失2.36优于不循环模型的2.37(471M参数)。
论文最终实践建议(两次完整循环的参数高效训练)的实验落地,包含标题结论引用的具体数字。
相关缩放律对比表:按架构(dense/MoE)、缩放轴($N$、$D$、$T$、$B$)、循环增益形式(幂律 $T^{\phi}$、线性 $T$、有界指数、加性、逐架构拟合)、BPTT配方(全、$T$、$\lceil T/2\rceil$)与适用情形(固定深度、固定 $N$、自由 $N$ 等)列出Schwethelm、Parcae、Chen、SMELT、Lee、Ouro与本文。只有本文同时建模独立的 $T$ 与 $B$ 且增益有界、覆盖 $1\le B\le T$。
一眼看清本文在循环缩放律文献中的定位与差异化:$B$ 作为独立变量是此前所有工作都没有的。
五个模型尺寸的配置:60M(宽度768,层2/4/2,$N=57.8$M,$N_{rec}/N=0.510$)、120M(1024,2/5/2,115.4M,0.564)、240M(1280,3/6/3,239.2M,0.507)、480M(1664,3/7/4,470.8M,0.506)、1B(2176,4/8/4,918.7M,0.505)。
复现实验网格的必要信息;$N_{rec}/N$ 比例相近这一事实是律中把该比例当常数处理的前提。
律的拟合与预测误差(单位 $10^{-3}$ nats/token,基于230个配置):拟合集内RMSE 6.14、MAE 4.91;留出一个配置(230次重拟合)RMSE 6.40;留出一个模型尺寸(7次)7.48;留出一个token预算(11次)6.42;留出一个循环设置(15次)8.67;$R^2=0.9992$。
量化律的拟合质量与各类外推难度,说明"未见尺寸/预算易预测、未见循环设置难预测"的误差结构。
九个拟合参数:不可约损失 $E=0.29865$,尺寸系数 $A=6.48695$,数据系数 $H=7.63343$,尺寸指数 $\alpha=0.30568$,token指数 $\beta=0.39281$,耦合指数 $\kappa=0.32510$;循环系数参数 $c=1.11198$、$p=0.23677$、$q=1.02181$。参考尺度固定 $N_0=2.4\times10^8$、$D_0=2^{30}$。
律的全部数值内容:后续所有结论($q>2p\Rightarrow$ 全BPTT、$e^c$ 上界、$C^{0.24}/C^{0.76}$ 指数)都由这九个数推出。
$T$ 被规定时对整数 $B$ 最小化 $\chi(T,B)$ 的结果:$T=1,2$ 选全BPTT($\chi=1.000$、1.031);$T=4$ 选 $B^*=2$($\chi$ 1.204 vs 全BPTT的1.430,$N^*=1.27$、$D^*=1.08$);$T=8$ 选 $B^*=2$(1.580 vs 2.376,$N^*=1.51$、$D^*=1.20$);$T=16$ 选 $B^*=2$(2.343 vs 4.339)。截断节省随 $T$ 增大。
给出"固定 $T$ 时截断有利"结论的完整数值依据,并解释截断省下的算力如何转化为更大模型与更多token。
$D=16D_0$(172亿token)下等算力匹配实验:每行 $(8,2)$ 与 $(4,4)$ 的模型尺寸、token、训练计算(含优化器更新)完全相同。损失 $\Delta L=L_{8,2}-L_{4,4}$(nats/token,$10^{-3}$):60M 2.78、120M 1.47、240M 1.36、480M 1.07、1B 0.87,$(4,4)$ 全部更低且优势随尺寸增大而减小。
直接测量而非律预测的"全BPTT优于截断"证据,是第5.2节核心主张的实验支撑。
三个训练预算下,$(2,2)$ 模型与不循环模型各按该预算的损失最优尺寸与token数训练(每模型3个种子)的对比:每个预算下循环模型损失差距不超过0.008 nats,同时少27–32%非嵌入参数;差距随预算增大而缩小,在 $2.1\times10^{19}$ FLOPs处已小于种子间标准误;$(2,2)$ 多训8% token后损失低0.007 nats。
支撑"两次完整循环以少27–32%参数逼近计算最优非循环模型"这一标题级结论的完整数字。