StopLoss:教会智能体预测失败并提前止损 StopLoss: Teaching Agents to Predict Failure and Stop Early
用最终验证结局训练7B小模型监控代码智能体,提前中止注定失败的运行以省钱
前置知识
SWE-bench Verified / Pro
真实软件工程智能体基准:给定真实 GitHub 仓库的 issue,智能体在容器中多轮编辑代码、执行命令,最后提交补丁,由基准自带的隐藏测试判定 PASS/FAIL。Verified 是人工筛选过的 500 题子集,Pro 是更长更难的扩展版,本文用其 Python 子集(ansible、openlibrary、qutebrowser 三仓库)。
本文的训练数据来源、执行器评估和「最终结局」标签全部建立在这类基准的验证机制上,不理解验证流程就无法理解结局监督从何而来。
LoRA(低秩适配)
参数高效微调方法:冻结预训练权重,只在注意力 q/k/v/o 投影旁挂低秩矩阵 $\Delta W = BA$(秩 $r \ll d$)参与训练,可训练参数量降低几个数量级,使单卡微调 7B-8B 模型成为可能。
StopLoss 用 rank-16、scale-32 的 LoRA 在三个 7B-8B 骨干上训练监控器,这是它能以极低成本训练和部署的关键。
tier AUC(分档 AUC)
AUC 衡量失败窗口的得分是否系统性高于成功窗口(0.5 为随机,1 为完美排序)。tier AUC 先把检查点窗口按已花费执行成本分成四档,在同时含两种结局的档内分别计算失败 AUC 再取平均,排除「失败窗口天然更贵」带来的虚高。
这是论文的主排序指标(如训练后 0.622 对未训练 0.491),不理解分档逻辑会误读监控器的真实判别力。
logit 读出与 softmax 打分
不做自回归生成,而是把监控判断当作三选一分类(CONTINUE/DELIVER/ABORT),取候选答案首 token 的 logit $z_c$ 做 softmax:$s_t(k) = \exp z_{\text{ABORT}} / \sum_c \exp z_c$,一次前向传播即得失败概率,无需生成任何文字。
这是单次检查只要 $0.000237、比大模型裁判便宜 9-326 倍的直接原因,是「早停能回本」论证的技术前提。
误杀率与阈值校准
误杀(false kill)指把最终会成功的运行提前中止。校准时对每条成功运行取轨迹级最大分 $z_t = \max_k s_t(k)$ 排序,按目标误杀率 $\rho$(名义 5%)选阈值 $\tau = z_{(\lfloor \rho n \rfloor + 1)} + 10^{-9}$,冻结后线上分数越线即停。
早停的经济收益由误杀率与省下执行成本的权衡决定,全文分析框架是不等式 $CPS < CPS_0 \iff g > m + r$,其中 $r$ 即误杀率。
CPS(每保留解成本)
cost per retained solve:把中止后省下的执行费 $C_t(K_t(\tau))$、访问过的监控费 $M_t(\tau)$、被误杀损失的成功解全部记账,$CPS = \frac{\sum_t (C_t(K_t(\tau)) + M_t(\tau))}{\sum_t y_t \mathbf{1}[K_t(\tau) = \infty]}$,即每保住一个成功解的平均总花费。
这是论文的核心评价指标,理解它才能读懂「裁判 AUC 更高却更亏钱」这类反直觉结论。
研究动机
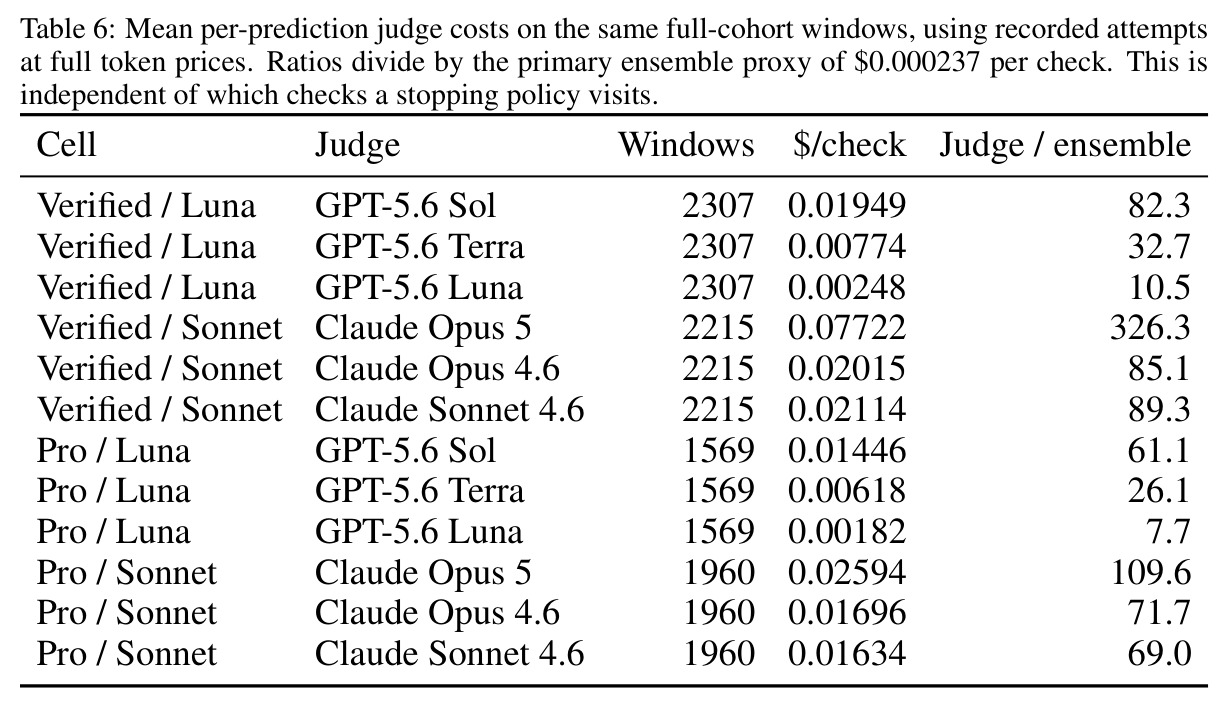
编码智能体经常在注定无法通过最终验证的任务上持续编辑、测试、调用工具,等验证结果出来时成本已经花掉。论文在 SWE-bench Pro Python 子集上实测:GPT-5.6 Luna 跑 213 个任务有 69 个失败,这些执行成本全部沉没。现有两类监控方案各有硬伤:其一是预算型方法(步数/花费上限,如 BAGEN),只回答「能否在预算内完成」,会把需要更久但最终能成功的运行误杀;其二是用前沿大模型当裁判读轨迹判进度,但每次判断本身就是昂贵的 API 调用(实测 $0.0018-$0.0772 一次),反复评估的监控账单可能超过省下的执行成本——GPT-5.6 Sol 在 Verified/Luna 上仅监控就花 $33.20,比 425 个任务全部跑完的 $28.44 执行费还高,使每保留解成本暴涨 116.8%。
本文的目标是本文目标是训练一个小而便宜的外部监控器 StopLoss:它从已完成的轨迹及其验证结局中学会识别失败,在运行的早期检查点(工具步 5, 8, 11, ...)只读步数和最近 3 个动作-观察对,单次前向传播即输出失败概率,单次检查成本 $0.000237,比任何被测裁判低 1-2 个数量级;再用只在成功轨迹上标定并冻结的阈值把分数转成中止决策,完全不改动执行器。最终验收标准是经济学意义上的:监控费加误杀损失必须小于省下的执行成本,即每保留解成本(CPS)低于不监控的全量执行,且在 GPT 与 Claude 两类执行器、Verified 与 Pro 两个基准、三个 7B-8B 骨干上都要成立。
与已有工作不同的是,本文的独特切入是「结局即免费标注」:验证器只能在运行结束后给出 PASS/FAIL,但回溯看,这个最终结局可以监督标注运行中每一个更早的局部窗口,于是不用任何人工标注、不需要中间补丁-测试信号、不需要执行器隐藏状态,就能低成本批量生产监督数据。因为标签是「这条已观测执行继续走完的结局」,一个最终通过验证的昂贵运行仍被视为成功,监控器学的是识别失败而非执行预算,避免了预算型方法误杀慢而成功的运行。同时它只读可观测文本,经 LoRA 微调的 7B-8B 小模型一次前向即可打分,既能监控 GPT、Claude 这类闭源执行器,又把监控成本压到裁判的 1/9 到 1/326。
核心方法
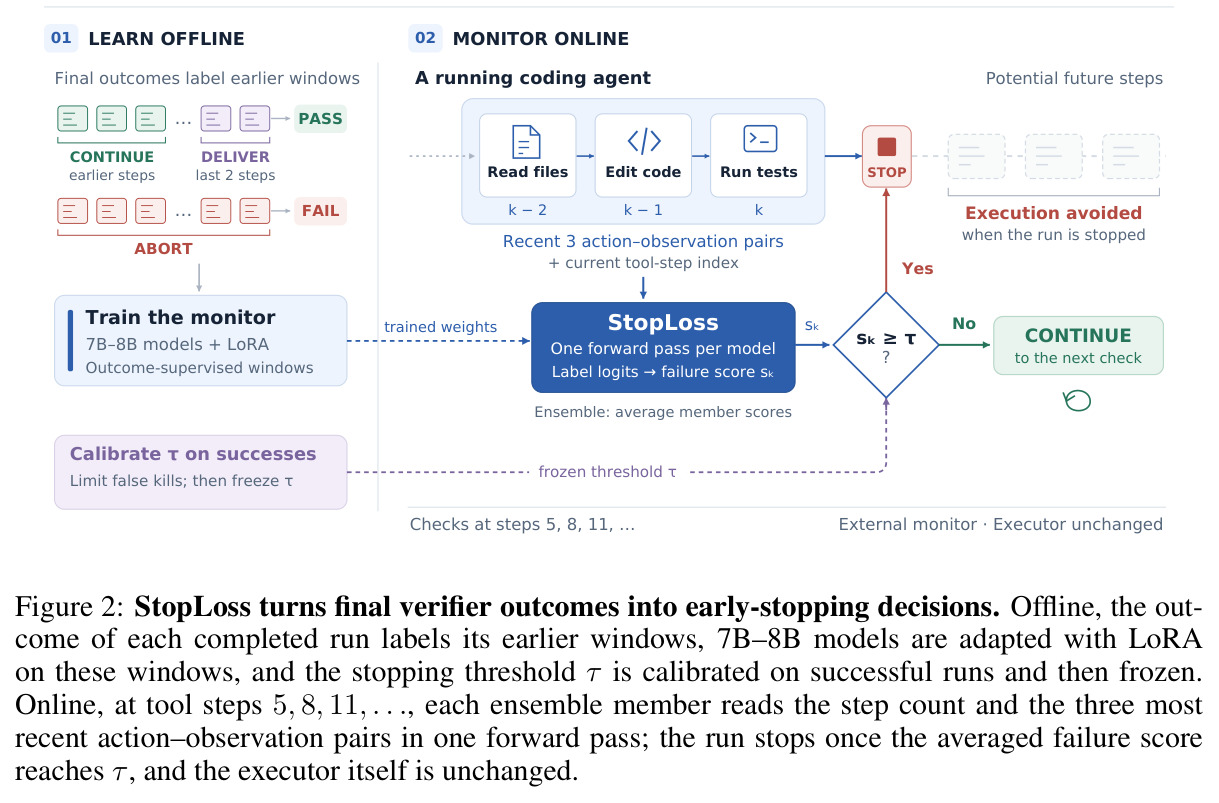
直觉上,失败的运行在中途就会露出征兆,而这些征兆蕴含在最近几步的动作-观察文本里;既然最终结局已知,就能反过来教小模型认识这些征兆。方法分离线、在线两段。离线:对任务 $t$ 的完成轨迹与结局 $y_t \in \{0,1\}$,在检查点 $k \in \{5, 8, 11, \ldots\}$ 取步数和最近 3 个动作-观察对构成窗口 $w_{t,k}$(1600 token 上限);失败运行的所有窗口标 ABORT,成功运行的最后两步($k \ge n_t - 1$)标 DELIVER,更早的窗口标 CONTINUE;用 LoRA 微调 Qwen2.5-7B-Instruct、Qwen3-8B、Qwen2.5-Coder-7B-Instruct 三个 7B-8B 骨干。在线:检查时对每个集成成员做一次前向,从 logits 直接读失败分 $s_t(k) = \exp z_{\text{ABORT}} / \sum_c \exp z_c$,集成取平均;阈值 $\tau$ 在成功校准运行上按名义 5% 误杀率标定后冻结,$s_t(k) \ge \tau$ 即中止。
核心创新是三个设计的组合。第一,弱监督来源极简:只需已完成轨迹加验证器布尔结局,这是任何跑过基准的团队都现成就有的数据,不需要人工过程标注、不需要可执行测试的中间反馈、不需要执行器内部状态,因此能监控闭源模型。第二,读出方式极端便宜:不做生成式判断、不写推理链,而是把打分当分类,从 ABORT/CONTINUE/DELIVER 候选首 token 的 softmax 直接读概率,一次前向完成,实测 $0.000237 一次,是裁判的 1/9 到 1/326。第三,风险可控的决策:阈值只在成功轨迹上用轨迹级最大分 $z_t = \max_k s_t(k)$ 的分布标定,直接控制最危险的轨迹级误杀事件(一次越线即中止整条运行),把预测问题转化为误杀率 $\rho = 5\%$ 约束下的停止策略。这与「让大模型读轨迹、写推理、给概率」的裁判路线有本质区别。
方法步骤详情
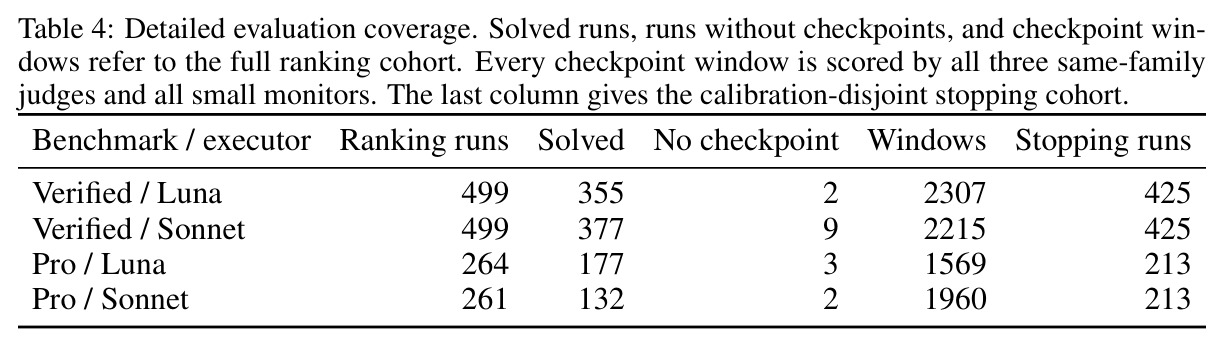
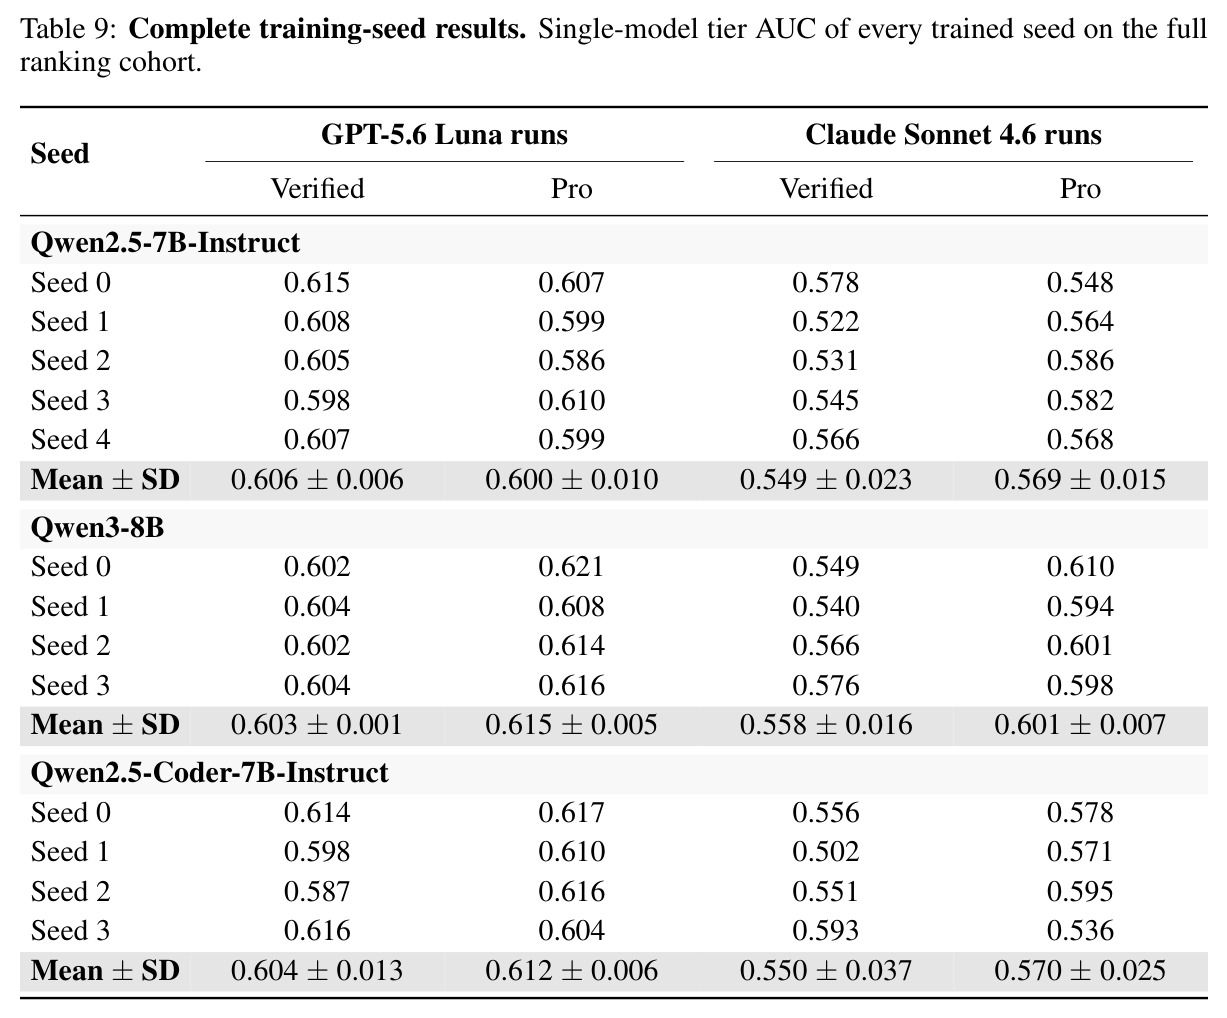
完整流程五步。1)数据构建:SWE-rebench 共 5,086 任务/63,173 窗口,219 个任务留作模型选择,拟合集 4,867 任务/61,315 窗口。2)训练:LoRA rank-16 微调骨干,AdamW 学习率 $10^{-4}$,损失只算答案 token,按验证集失败 AUC 选 checkpoint,每骨干训 5/4/4 个种子组成集成。3)阈值校准:GPT 侧用 90 条校准成功运行,Claude 侧 76 条;对每条成功运行取 $z_t = \max_k s_t(k)$ 排序,取 $\tau = z_{(\lfloor \rho n \rfloor + 1)} + 10^{-9}$ 控制名义误杀率 5%。4)在线停止:在工具步 5, 8, 11, ... 检查,集成平均分达到 $\tau$ 即中止。5)评估回放:按 $CPS = \frac{\sum_t (C_t(K_t(\tau)) + M_t(\tau))}{\sum_t y_t \mathbf{1}[K_t(\tau) = \infty]}$ 计算每保留解成本,监控费与误杀损失都入账。
技术新颖性
与最接近工作的区别:Ruan 等的探针方法需要访问执行器隐藏状态,无法用于闭源 API;AgentStop 依赖 token 对数概率等执行信号,同样需要 executor 内部信息;PrefixGuard 从可观测轨迹学监控器,但不以最终验证结局做大规模弱监督;FailFast-RestartSmart 需要中间补丁-测试监督且主打停止加重启;BAGEN 估计预算内可行性,本质仍是预算判断,可能砍掉能成功但慢的运行;SWE-Router 关心换模型路由而非是否继续当前运行。StopLoss 把三件事统一到最低成本形态:结局监督(数据最便宜)、logit 读出(推理最便宜)、成功轨迹校准(误杀可控),并首次以每保留解成本为核心指标,把监控费和误杀损失都计入地系统对比六种裁判策略,给出判别式 $g > m + r$(省下的执行比例必须超过监控占比加误杀率)。
实验结果
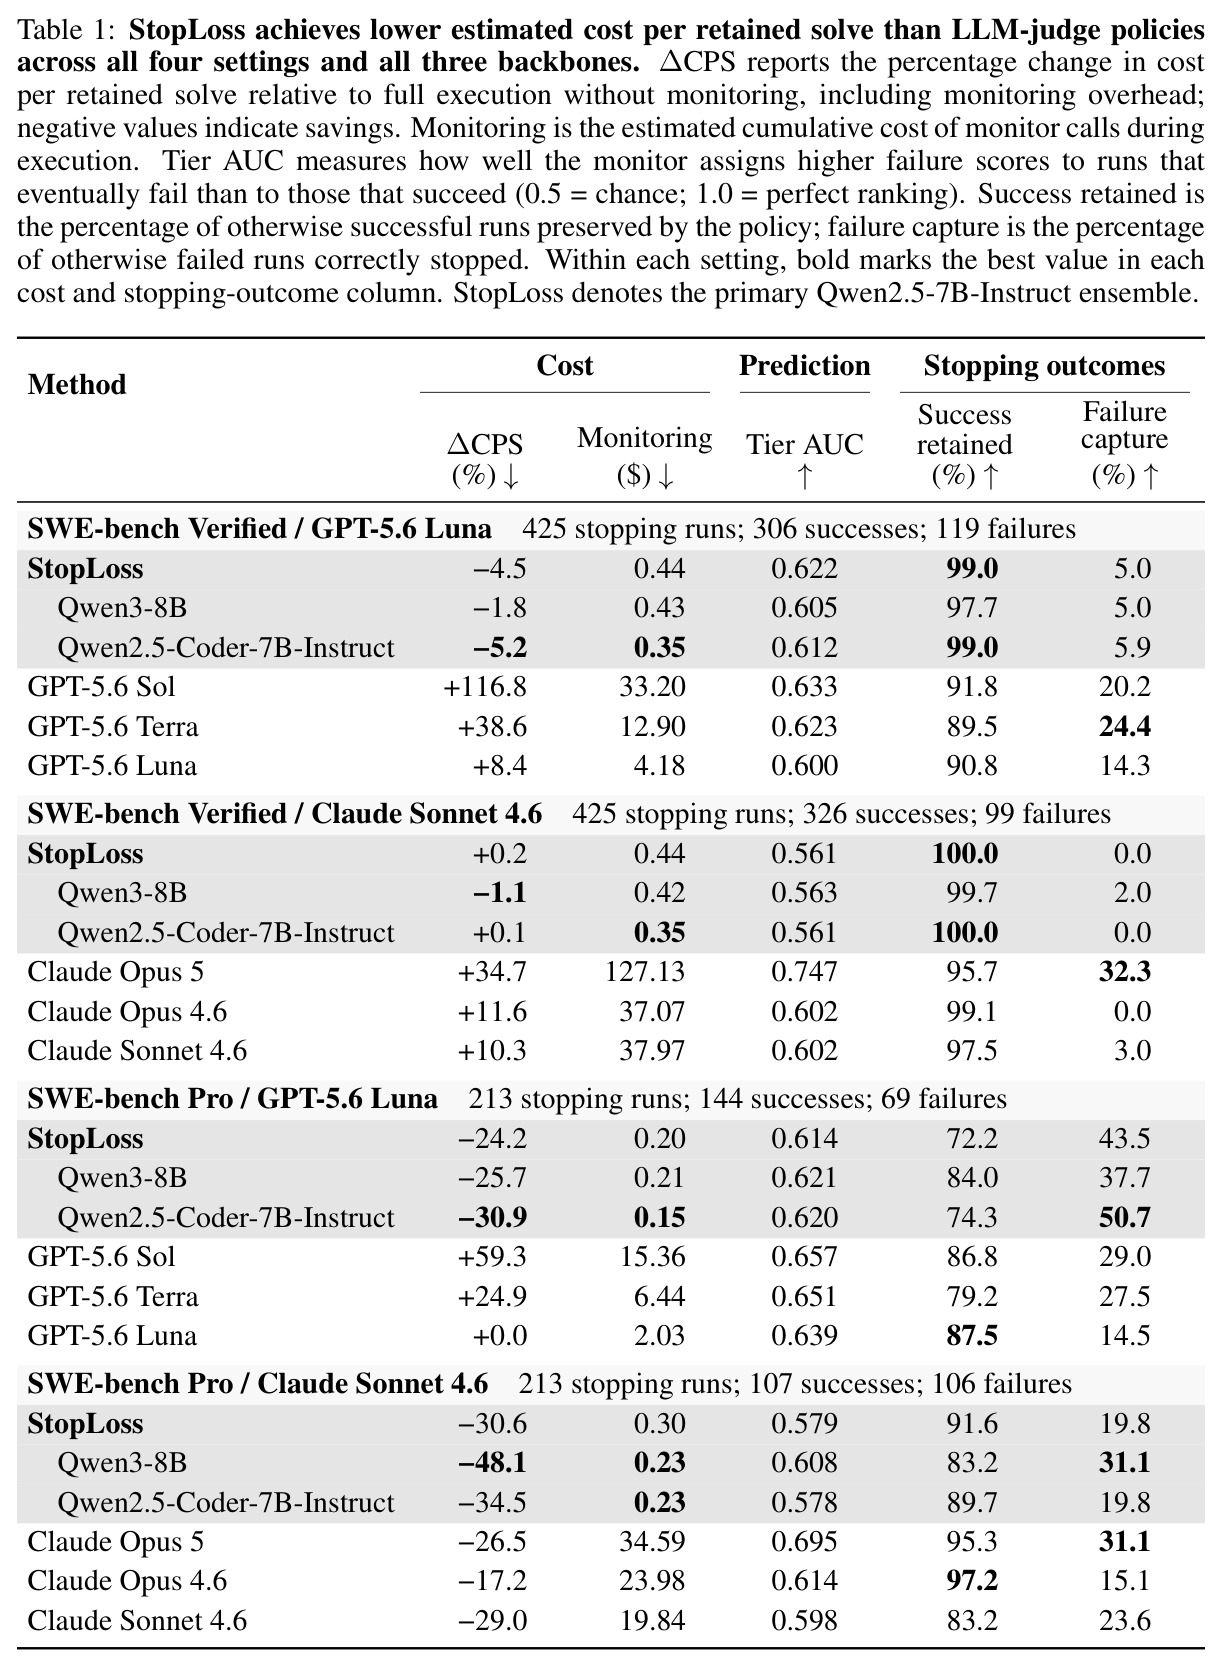
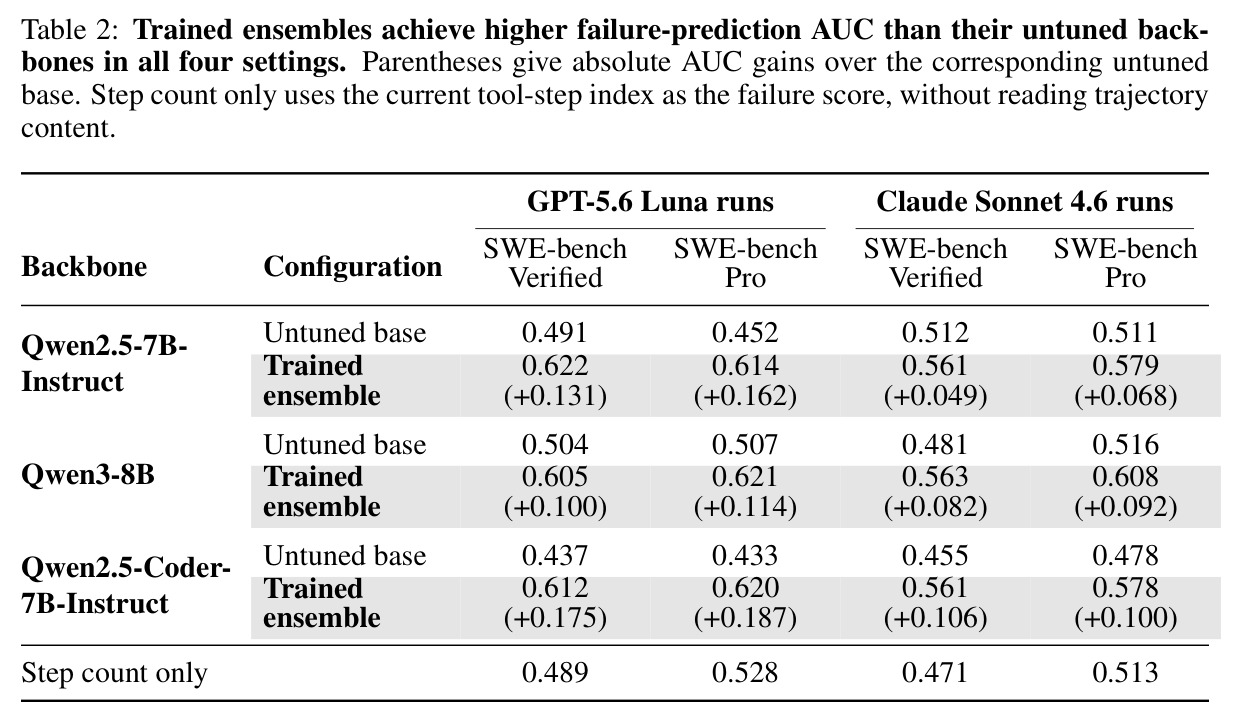
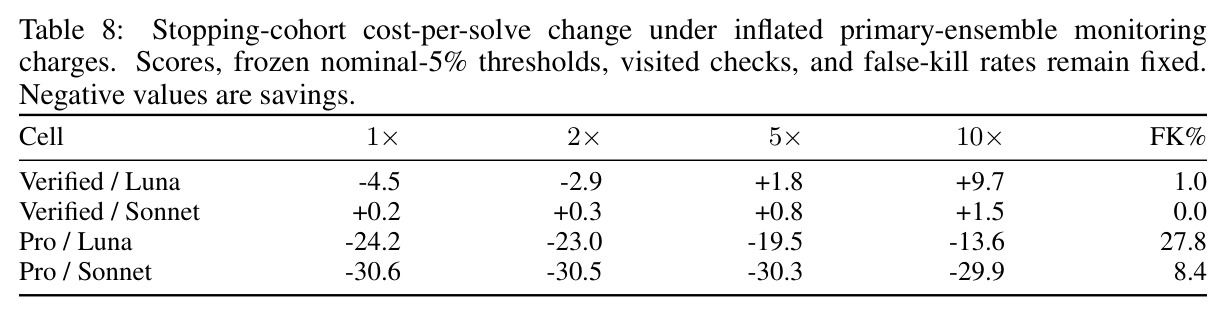
StopLoss 在四个执行器-基准设置上成本均低于全部六种裁判。Verified/Luna 停止队列:$\Delta CPS = -4.5\%$,保留 99.0% 成功,监控仅 $0.44,而 GPT-5.6 Sol 监控 $33.20、$\Delta CPS = +116.8\%$。Pro/Luna:$-24.2\%$(保留 72.2%,误杀 27.8%),Coder 骨干 $-30.9\%$;Pro/Sonnet:$-30.6\%$(保留 91.6%),Qwen3-8B 骨干 $-48.1\%$。训练把单模型 tier AUC 从 0.491 提到 0.606、0.452 提到 0.600,集成再增约 0.015;第一次检查(步 5)ordinary AUC 已达 0.642/0.645,未调优基线仅 0.494/0.450。裁判对照揭示「排名准不等于省钱」:Claude Opus 5 在 Verified/Sonnet AUC 最高(0.747),却因监控费 $127.13 使 $\Delta CPS = +34.7\%$。8 个正确停止触发时中位还剩 64.5% 执行成本。
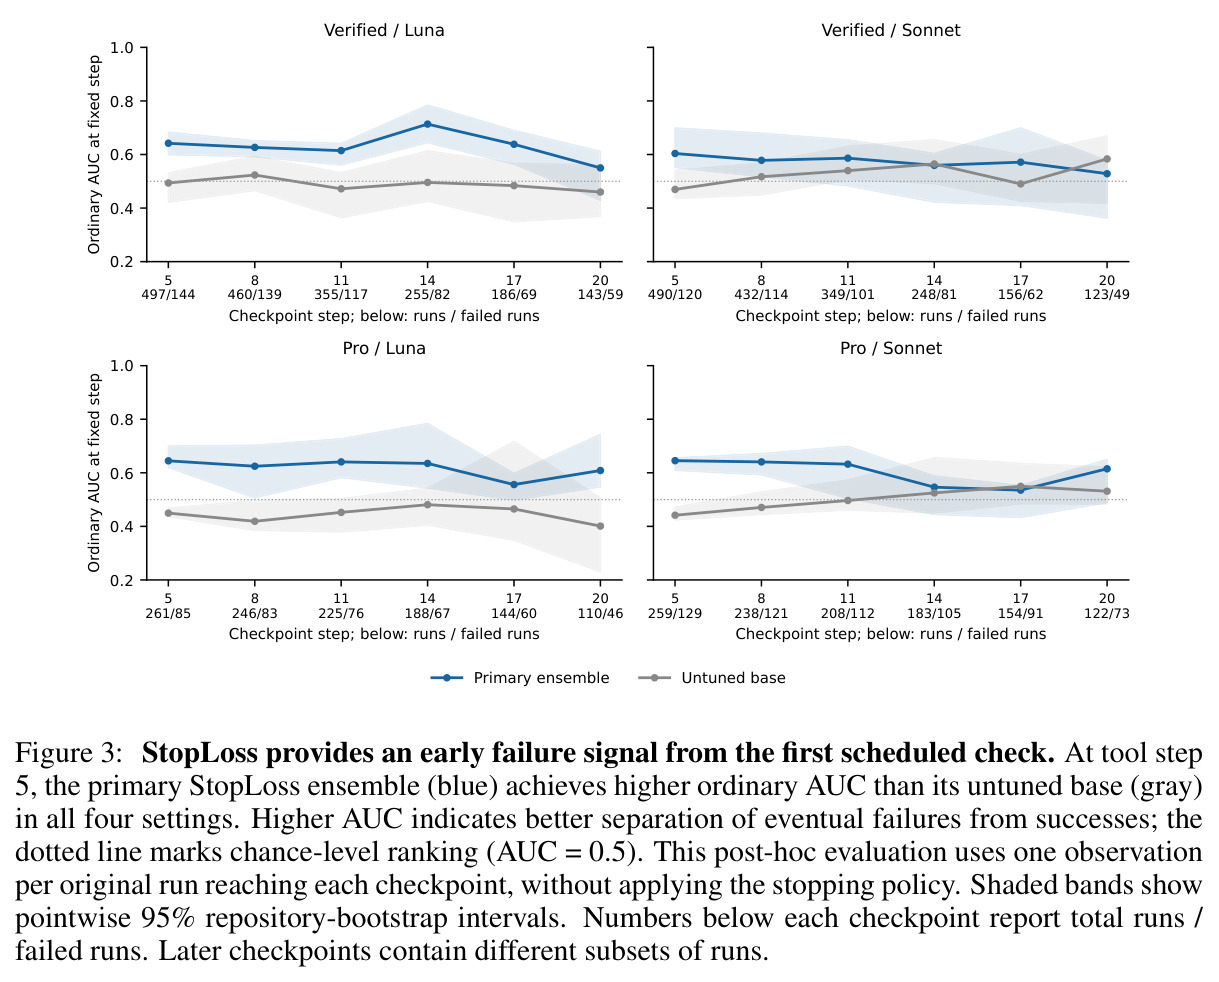
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench Verified + GPT-5.6 Luna(425 停止队列,306 成功/119 失败) | 每保留解成本变化 ΔCPS(含监控费)与成功率保留 | StopLoss(Qwen2.5-7B 集成):-4.5%,保留 99.0% 成功,tier AUC 0.622,监控费 $0.44 | 不监控全量执行 0%;最佳裁判 GPT-5.6 Luna +8.4%;GPT-5.6 Sol +116.8% | 相对全量执行省 4.5%,比最省的裁判策略低约 12-56% |
| SWE-bench Pro + GPT-5.6 Luna(213 停止队列,144 成功/69 失败) | ΔCPS 与失败捕获率 | StopLoss:-24.2%(保留 72.2%,捕获 43.5%);Qwen2.5-Coder 骨干 -30.9%、捕获 50.7% | GPT-5.6 Sol +59.3%、Terra +24.9%、Luna +0.0% | 监控费 $0.15-$0.21 对裁判 $2.03-$15.36(低 14-104 倍),失败捕获 50.7% 对裁判最高 29.0% |
| SWE-bench Pro + Claude Sonnet 4.6(213 停止队列,107 成功/106 失败) | ΔCPS 与成功率保留 | StopLoss:-30.6%(保留 91.6%);Qwen3-8B 骨干 -48.1%(保留 83.2%,捕获 31.1%) | Claude Opus 5 -26.5%(AUC 0.695)、Opus 4.6 -17.2%、Sonnet 4.6 -29.0% | Qwen3-8B 比最佳裁判多省约 19 个百分点,且监控费仅 $0.23 对 $19.84-$34.59 |
| SWE-bench Verified + Claude Sonnet 4.6(425 停止队列,326 成功/99 失败) | ΔCPS(跨执行器迁移检验) | StopLoss:+0.2%(基本持平,保留 100%,捕获 0%);Qwen3-8B -1.1% | Claude Opus 5 +34.7%(AUC 0.747 全场最高但监控费 $127.13) | 在迁移受限的设置下不亏钱,避免了裁判式的大额亏损 |
局限与改进
作者承认的局限:训练数据全部来自 GPT 系执行器轨迹,跨执行器迁移打折——同为工具步 8,Verified 上 Luna 的 ordinary AUC 0.627、Sonnet 上只有 0.578;评估仅限 Python;SWE-bench Pro 只覆盖 3 个仓库(ansible、openlibrary、qutebrowser),仓库聚类仅 3 个使 bootstrap 区间不可信;GPT 阈值校准复用了模型选择任务,不是独立认证集。我自己的观察:第一,Pro/Luna 误杀率 27.8%(只保留 72.2% 成功),对生产环境不可接受,归因于 Pro 成功运行更长(中位 16 步对 Verified 13 步)、检查点更多更易越线,暴露冻结阈值对轨迹长度分布脆弱;第二,Verified 上失败捕获率仅 5.0%,收益高度集中在少数长而贵的失败运行(前三大节省占 65.8%);第三,成本核算按冻结价目表和 GPU 时摊销代理(batch-1 计时),非真实在线服务延迟;第四,弱标签假设失败运行无可挽回,忽略了换条路径可能成功,而 ABORT 是永久放弃。
独立分析的弱点
独立分析四个弱点及改进方向。1)误杀-捕获权衡在长轨迹基准上失衡:Pro/Luna 为捕获 43.5% 失败牺牲 27.8% 成功,若基准通过率高、单任务便宜,止损反而亏钱;改进方向是引入结合剩余预算与分数置信度的联合决策,或对临界分数用一次便宜裁判复核构成级联过滤。2)跨执行器泛化弱:模型只见过 GPT 风格轨迹(错误信息格式、工具调用习惯、推理长度),在 Claude 轨迹上 tier AUC 系统性低 0.04-0.05;改进方向是混合多执行器训练、对轨迹文本做归一化增广,或用少量目标执行器轨迹做轻量继续训练。3)停止即永久放弃过于激进:被停的运行没有重启或降级续跑的机会,而 FailFast-RestartSmart 已证明带历史编辑的重启能挽回部分失败;改进方向是把 ABORT 扩展为止损加换策略重启,或接入 SWE-Router 式模型路由。4)检查点网格固定(5, 8, 11, ...)与运行长度、成本结构无关:Verified 有 2-9 个运行根本没有检查点,长成功运行却暴露在更多误杀机会下;改进方向是按预期剩余成本自适应调度检查频率。
未来方向
作者提出的方向:扩展到其他编程语言和基准(需要相应轨迹与结局标签)、改进跨执行器泛化与阈值迁移。基于成果可延伸的方向:1)止损加重启/路由组合——把 ABORT 从终局改为触发更便宜模型的续跑或带历史编辑的重启,可能同时降低误杀损失与总成本;2)把监控分数反哺执行器训练:失败分高的轨迹段可作为执行器微调的负样本或 RL 的过程奖励信号,替代昂贵的 PRM 逐步验证;3)迁移到非代码智能体——web 操作、深度研究等任务的结局同样可自动判定,方法几乎原样适用;4)在线阈值自适应——用运行中的结局反馈滚动更新 $\tau$,缓解分布漂移下 Pro/Luna 27.8% 误杀的问题;5)与预算估计(BAGEN)结合,输出失败概率乘剩余成本的期望损失,做更理性的中止与升级决策。
复现评估
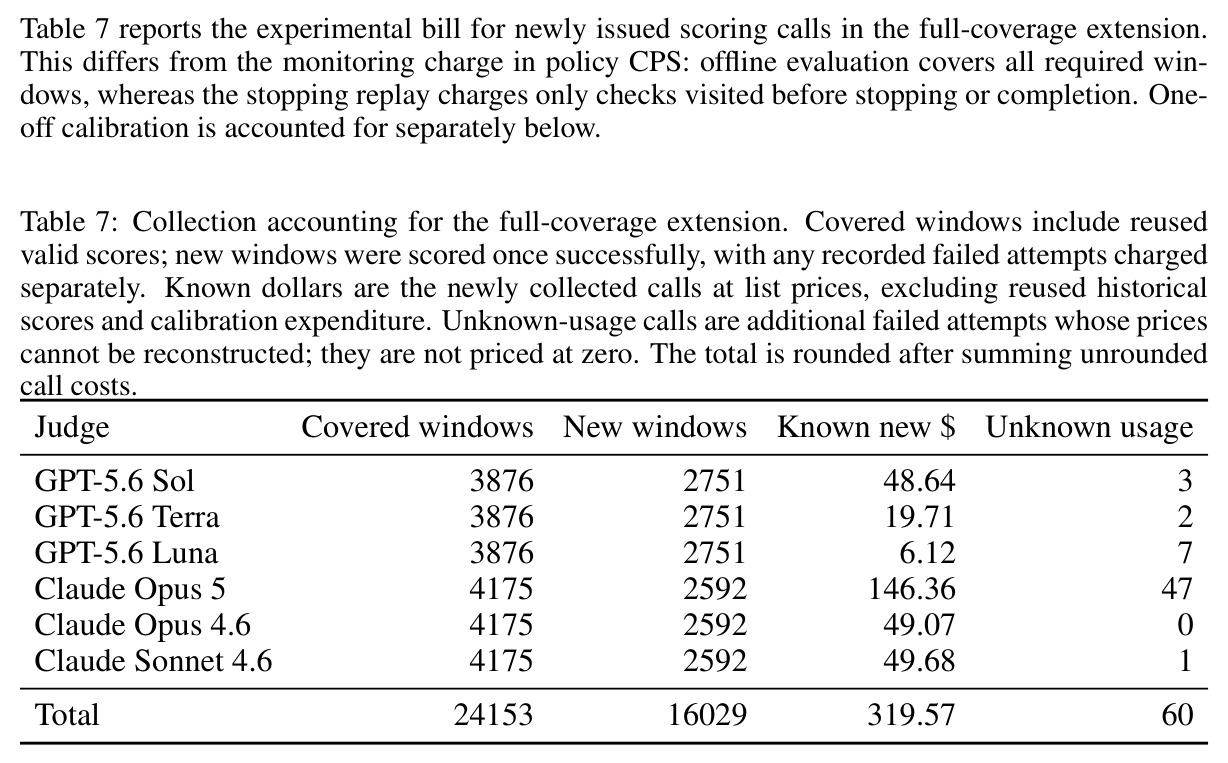
复现条件较好。代码开源在 GitHub(TIGER-AI-Lab/StopLoss),训练数据 SWE-rebench 公开,轨迹采集用 Harbor 0.17.0 的 Terminus-2 2.0.0 脚手架,论文完整记录了配置(100 agent turns、7,200 秒超时)与全部提示模板。训练门槛低:LoRA rank-16 微调 7B-8B,1 epoch、61,315 窗口,单卡或双卡(RTX A6000 级)即可;推理极便宜,$0.80/GPU 时,五成员集成每检查 $0.000237。主要门槛在评估端:需要调用商业 API 生成执行轨迹(Verified/Luna 425 任务执行费 $28.44,Claude 侧更贵),完整六裁判对照的扩展评分花费 $319.57(Opus 5 一家 $146.36),个人难以全套复现;但复现核心贡献——训练监控器并在自己已有的轨迹上校准回放——成本极低。总体难度中等偏上,需要处理轨迹解析、窗口构建和回放记账的工程细节,附录 A-C 给出了足够细节。
论文图表
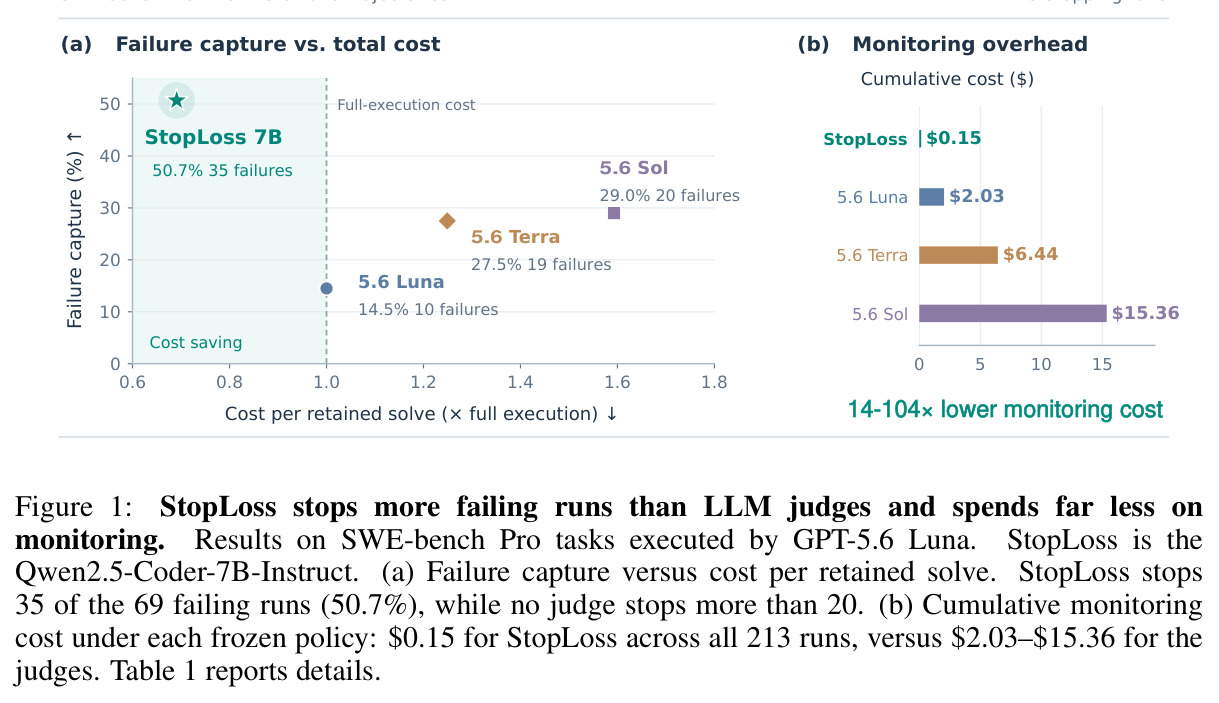
在 SWE-bench Pro(GPT-5.6 Luna 执行器,213 个停止队列任务)上的两张图。(a) 失败捕获率对每保留解成本:StopLoss(Qwen2.5-Coder-7B)停在左上优势区,中止 69 个失败运行中的 35 个(50.7%),没有任何裁判超过 20 个;全执行成本线标出 5.6 Sol 的 14.5%、Luna 的 29.0%、Terra 的 35% 捕获点。(b) 各冻结策略的累计监控成本:StopLoss 全部 213 次运行只花 $0.15,裁判为 Luna $2.03、Terra $6.44、Sol $15.36,低 14-104 倍。
一张图讲清全文卖点:更便宜的监控器同时实现了更高的失败捕获和更低的每保留解成本,把「便宜且判别力够用」这个核心主张可视化。
列出执行器与裁判的生成/评估配置:GPT-5.6 Luna 执行器(100 turns、7200 秒超时、$9 花费阀);Claude Sonnet 4.6 执行器(thinking 开启、8000 token 预算、$26 阀);GPT 系裁判用高推理档,Claude 系裁判用自适应 thinking 高 effort。还说明了同一模型兼任执行器与裁判时配置的区分。
评估公平性的关键:所有方法读相同的窗口内容,只差最后提问与聊天格式,此表记录了这些固定配置,保证对比可复现。
冻结的价目表(每百万 token 美元):gpt-5.6-sol 输入 4.00/输出 20.00;gpt-5.6-terra 2.00/12.00;gpt-5.6-luna 0.20/1.20;claude-opus-5 与 opus-4-6 均 5.00/25.00;claude-sonnet-4-6 3.00/15.00。缓存输入按全价计,输出含推理 token。
所有成本结论(ΔCPS、监控费)都依赖这套标准化定价,读成本表前必须知道计价假设。