世界模型可解释性:从解码表征到理解潜在世界 World Model Interpretability: From Decoding Representations to Understanding Latent Worlds
提出四阶段蓝图,推动JEPA可解释性从解码表征走向理解、验证与干预潜在世界
前置知识
JEPA(联合嵌入预测架构)
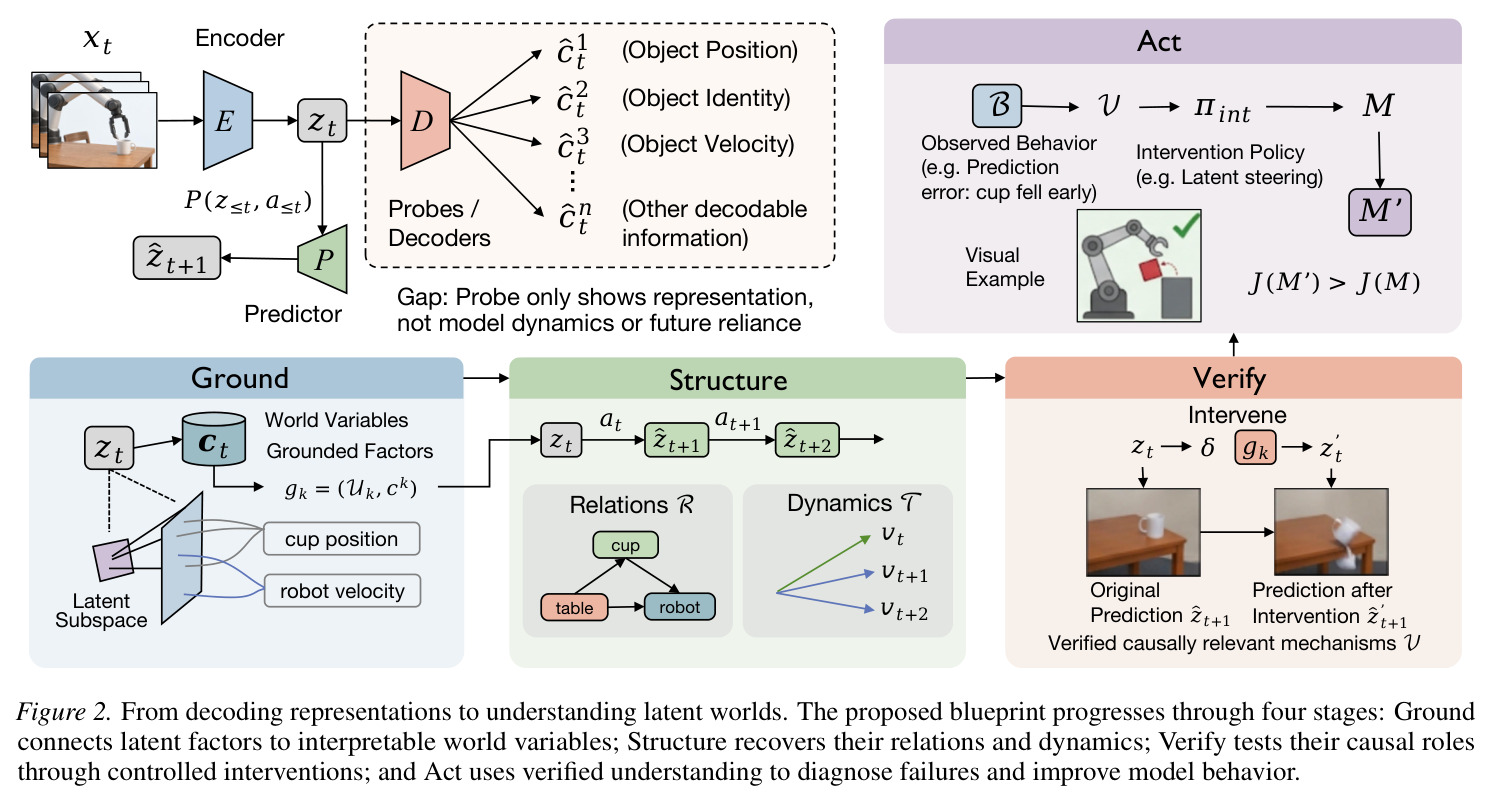
Joint-Embedding Predictive Architecture,LeCun 等提出的一类自监督架构:编码器 $E$ 把观测 $x_t$ 映射为潜在状态 $z_t = E(x_t)$,预测器 $P$ 在表征空间中预测未来状态,而不是在像素空间重建观测。这样模型只需关注世界中可预测的抽象方面。代表工作包括 I-JEPA、MC-JEPA、V-JEPA、V-JEPA 2 等,目前已扩展到机器人、3D 理解、医疗影像、基因组等领域。
本文讨论的对象正是 JEPA 作为潜在世界模型时的可解释性问题,必须先理解其预测发生在抽象表征空间、没有像素级输出接口。
世界模型与潜在世界
能对环境状态与演化进行内部建模、支撑预测与规划的模型,如 Ha & Schmidhuber 的 World Models 和 2025 年登 Nature 的 Dreamer 式模型。本文的"潜在世界"指通过 $M=(E,P)$ 的预测过程实现的内部变量、关系与动力学的整体,解释对象因此不只是单个表征 $z_t$,还有这个随时间演化的预测系统本身。
理解"潜在世界"这一核心概念,才能明白作者为什么主张解释对象要从静态表征转向整个预测系统。
线性探针与解码范式
冻结模型表征,在其上训练线性分类/回归器(解码器 $D$),检验某个语义变量(物体位置、速度、动作等)能否被恢复:$\hat{c}_t = D(z_t)$。能解码说明信息可访问,是表征可解释性最常用的证据形式,作者称之为解码范式。V-JEPA 2 与 AIM 的内部分析即属此类,方法学综述见 Belinkov 2022。
本文的核心论点"可解码不等于理解"正是针对解码范式的局限提出的,理解探针的作用边界是读懂全文的前提。
稀疏自编码器(SAE)与概念探针
SAE 是无监督方法,把神经网络激活分解为大量稀疏、通常更单义的方向或特征,ICLR 2024 的工作表明 SAE 能在大语言模型中发现高度可解释的特征。概念探针(如 TCAV)则检验某概念方向对预测的显著度。在本文框架中,SAE、概念探针、聚类、表征相似性等方法都被归入 Ground 阶段,用于建立潜空间子空间 $U_k$ 与世界变量 $c_k$ 的对应。
这些方法是作者设想中实现 Ground 的主要工具,也是后续结构与因果分析的起点。
因果干预与激活引导
通过受控修改内部表征并观察输出变化来建立因果关系的技术,包括激活修补、激活引导(steering)等,在 LLM 机制可解释性中已广泛应用。本文把 Verify 阶段形式化为 $z'_t = \mathrm{Intervene}(z_t, g_k, \delta)$,比较干预前后预测 $\hat{z}_{t+1}$ 与 $\hat{z}'_{t+1}$ 的差异;Act 阶段则用干预策略 $\pi_{int}$ 把被验证的机制转化为模型改进。
干预是从"相关"走向"因果"的关键一步,作者认为这正是当前 JEPA 可解释性最缺失的环节。
研究动机
JEPA 类潜在世界模型正在从视觉表征学习快速扩展为支撑预测、规划与控制的通用世界模型:V-JEPA 2(2025)已能在动作条件下预测未来潜状态并用于机器人控制,相关架构还进入了具身控制、3D 场景理解(3D-JEPA)、医疗分析(白内障手术、超声、心电)与科学发现(基因组 JEPA-DNA、对撞机物理 HEP-JEPA、6G 通信)等。问题在于,这些潜在空间成为模型的内部状态后天然缺乏人类可解释的接口:与生成式世界模型不同,JEPA 在抽象表征空间里预测,没有可直接观察的输出。当预测失败时(例如机器人推桌边的杯子,模型预测杯子留在桌上而实际掉落),很难判断失败源于状态表征错误、动力学学错、交互建模缺失,还是多步 rollout 的误差累积;更根本的是,仅凭预测性能无法区分模型是学到了真实世界结构,还是依赖训练分布内的捷径(如背景纹理、相机运动)。而现有可解释性工作几乎只回答"表征里能解码出什么",无法回答信息如何组织、如何参与预测。
本文的目标是本文的目标是确立"潜在世界可解释性"(latent-world interpretability)这一研究方向,把解释对象从"表征编码了什么"转向"潜在变量如何交互、如何演化、如何因果地驱动预测"。具体产出是一个四阶段研究蓝图:Ground 把潜在因子对应到外部世界变量,Structure 恢复这些因子的关系与动力学,Verify 用受控干预检验其因果角色,Act 用被验证的理解诊断失败并改进模型。作者以此框架系统梳理现有 JEPA 可解释性工作,定位空白(现有证据集中在 Ground 阶段),并提出建设可控测试床、研究潜在世界的涌现与跨模型差异、连接解释与模型行为设计、扩展到真实场景这四大优先事项,为该新兴议程给出可操作的路线图。
与已有工作不同的是,作者抓住了一个被普遍忽视的概念区分:可解码性与世界模型理解是两回事。从 $z_t$ 解码出速度,只说明速度信息可访问,既不能说明它与位置、接触等变量如何组织关联,也不能说明预测器计算 $\hat{z}_{t+1}$ 时真的使用了速度信息——同样的预测可能由相关视觉线索或捷径驱动(作者引用 Dedieu et al. 2024 的认知地图工作说明这一点)。同时,尽管通用 XAI 工具箱极其丰富(归因、反事实、概念方法、电路分析、激活修补、引导等),却很少有人把学到的世界模型本身当作解释对象:TDB、OOCDM、Causal-JEPA 是把显式世界结构当作建模机制,另一批工作(Othello 世界模型假设、迷宫求解 Transformer)则是用世界模型作为透镜研究 LLM,两者的解释对象都不是世界模型。直接针对学习到的潜在世界的系统性解释因此几乎空白,这正是本文的切入点。
核心方法
这是一篇 Perspective(观点)论文,核心产出是形式化框架而非新算法。直觉上可以把 JEPA 想成黑箱剧场:解码范式只是偷看后台有哪些演员(表征里有什么信息),而要看懂整台戏,需要知道演员如何互动(Structure)、某位演员缺席剧情会怎么变(Verify)、如何据此改剧本(Act)。技术上,作者先把 JEPA 世界模型形式化为 $M=(E,P)$:编码器给出 $z_t = E(x_t)$,预测器在潜空间给出未来状态;外部世界用可解释变量 $c_t = (c^1_t, \dots, c^K_t)$ 描述,涵盖物体身份、位置、速度、几何、接触、事件等。在此之上定义四阶段流水线:$(Z, C) \xrightarrow{\mathrm{Ground}} G \xrightarrow{\mathrm{Structure}} W \xrightarrow{\mathrm{Verify}} V \xrightarrow{\mathrm{Act}} M'$,并用 5 条 Takeaway 和 Table 1 的证据映射支撑立场,使框架的适用边界清晰。
全文最重要的观点是 Takeaway 1:可解码性不是理解(decodability is not understanding)。能从潜状态恢复某个世界变量,只说明信息可访问,却不说明它如何被组织、如何随学习到的动力学演化、预测器是否因果地依赖它。作者据此把"表征可访问性"与"世界模型理解"严格区分:前者回答 what is recoverable,后者回答信息如何组织、如何在动力学中演化、动作如何影响演化。由此展开的四阶段蓝图中,Ground 仍是探针、SAE、概念方法的老地盘,但只是起点;Structure 要求恢复关系 $R$ 与动力学 $T$;Verify 要求用干预区分"参与预测的因子"与"仅与运动相关的因子"——例如把被锚定为速度的潜因子改变而固定其他因子,预测的运动应系统性改变;Act 则要求理解能反过来诊断失败、改进模型(如潜空间引导)。这把可解释性从"信息提取"重新定义为"对预测系统内部机制的理解",是与所有现有表征级解释工作的本质区别。
方法步骤详情
四阶段形式化如下。第一步 Ground:给定潜状态序列 $Z$ 与世界变量序列 $C$,学习 $G \leftarrow \mathrm{Ground}(Z, C)$,其中 $g_k = (U_k, c_k)$ 把潜子空间 $U_k \subseteq Z$ 对应到世界变量 $c_k$;线性/概念探针(TCAV)、聚类、SAE、表征相似性都是实例方法。第二步 Structure:恢复 $(R, T) = \mathrm{Structure}(G, Z, A)$,$R$ 刻画因子间耦合(位置、速度、接触等),$T$ 刻画演化及动作的影响,构成内部世界假设 $W = (G, R, T)$。第三步 Verify:对 $g_k$ 做受控干预 $z'_t = \mathrm{Intervene}(z_t, g_k, \delta)$,比较干预前后的预测 $\hat{z}_{t+1}$ 与 $\hat{z}'_{t+1}$;对被锚定为速度的因子,改变它而固定其他因子应系统性改变预测的运动,由此得到被因果支持的机制集 $V = \mathrm{Verify}(M, W, I)$。第四步 Act:给定观测行为 $B$(预测误差、分布外失败、规划失败等),执行 $M' \leftarrow \mathrm{Act}(M, V, B)$,通过干预策略 $\pi_{int}$ 做潜空间引导、激活编辑或微调,要求 $J(M') > J(M)$。
技术新颖性
新颖性体现在三点。其一,解释对象的迁移:从单个表征或特征转向"变量—关系—动力学"构成的潜在世界整体,这要求把既有 XAI 工具(归因 2017、反事实 2017、TCAV 2018、电路分析 2020、激活修补 2022、SAE 2024、激活引导 2023)重新组织为针对预测系统的分析流水线,而不是孤立使用。其二,明确引入因果层级:Ground 只建立对应关系,Verify 用干预 $z'_t = \mathrm{Intervene}(z_t, g_k, \delta)$ 检验因果参与,作者还坦承干预有效性(因子纠缠、潜状态合理性)是开放难题,这种自我限定比多数立场论文更严谨。其三,强调潜在世界的领域依赖性:机器人操控关注物体/接触/运动,3D 定位关注物体位置与空间关系,手术视频关注器械、解剖结构与手术阶段,基因组关注序列与调控元件——不存在普适的可解释特征集合,Ground 必须由领域本体驱动,这为框架落地提供了务实约束。
实验结果
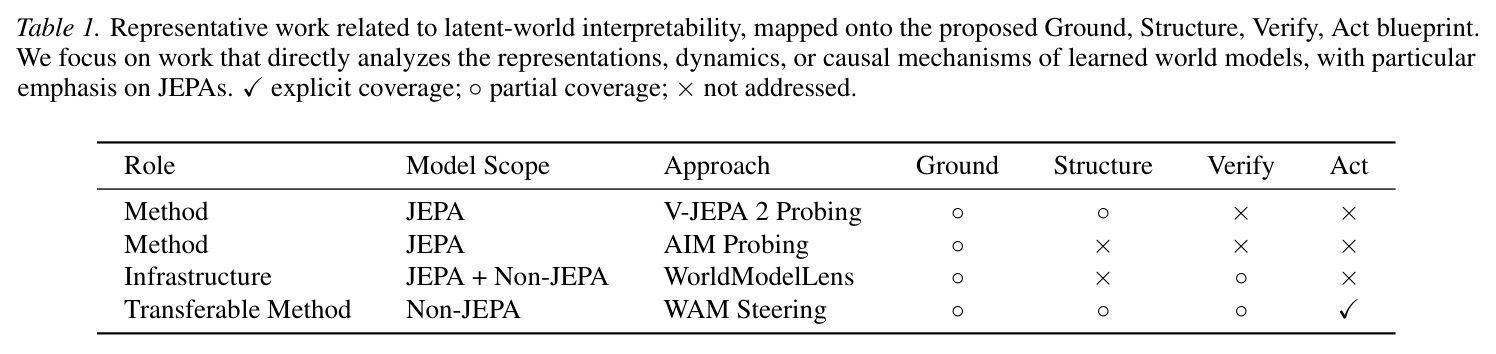
作为观点论文,其"结果"是对领域的系统盘点。第一,证据映射(Table 1):4 项直接相关工作中,V-JEPA 2 探针(2025)显示冻结表征包含外观、运动与动作信息,但 Ground 只算部分覆盖(◦)、Verify 与 Act 完全空白(×);AIM 探针仅有 Ground ◦;WorldModelLens(2026)提供跨架构的探针、归因、稀疏分析、激活修补与干预回放,做到 Verify ◦;WAM 引导(2026)虽是非 JEPA 的世界动作模型,却是唯一在 Act 打勾(✓)的工作。这支撑 Takeaway 3:JEPA 中的直接证据几乎全部集中在 Ground 阶段。第二,跨领域分析(Figure 3):以机器人操控(V-JEPA 2-AC + DROID 杯子抓放)、3D 定位(3D-JEPA + ScanRefer 系数据集)、医疗(Cataract-101 手术阶段识别)、科学发现(JEPA-DNA + GUE 启动子预测)为例,展示不同领域需要完全不同的世界变量本体。第三,四项应用价值:失败定位(杯子坠落错误可分解为状态表征、动力学、交互、rollout 四种失败模式)、区分真实世界结构与捷径、解释泛化边界、面向决策的前置可信度评估(Takeaway 4:相似性能可能隐藏截然不同的内部世界)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| JEPA 表征内容解码(Ground 阶段证据) | 蓝图覆盖度(✓ 显式 / ◦ 部分 / × 未涉及) | V-JEPA 2 探针:Ground ◦、Structure ◦ | AIM 探针:Ground ◦、Structure × | 在运动与动作信息上增加了部分结构证据,但 Verify 与 Act 仍为 × |
| 跨架构世界模型分析(Verify 阶段证据) | 蓝图覆盖度 | WorldModelLens(基础设施):Ground ◦、Verify ◦ | V-JEPA 2 / AIM 探针:Verify × | 首次提供探针+归因+稀疏分析+激活修补+干预回放的统一基础设施 |
| 用解释改进模型行为(Act 阶段证据) | 蓝图覆盖度 | WAM 引导(非 JEPA,2026):Act ✓ | 所有 JEPA 系工作:Act × | 证明 Act 阶段可行,但 JEPA 内部尚无任何工作,正是本文呼吁填补的空白 |
局限与改进
作者承认的局限有:其一,潜空间干预未必有效——一个潜变量可能同时纠缠多个属性,改动速度相关因子可能连带改变其他性质,修改后的潜状态也可能不再对应任何合理的世界状态,使预测变化无法归因于目标因子,这是 Verify 阶段的核心难题;其二,人类定义的本体未必是模型内部的正确分解,JEPA 的表征可能是分布式、非线性、关系性或任务依赖的,有些预测因子没有简单的人类对应物(作者引用 Chawla et al. 2026),模型偏离人类概念的方式本身可能揭示其独特的世界表征方式;其三,可解释性并非构建可靠世界模型的必要条件,行为评估、不确定性估计、鲁棒性训练和分布外测试可以不打开黑箱,本文立场是互补而非替代(Takeaway 5)。我的补充观察是:全文没有任何实验验证蓝图可行性,Ground 到 Act 的完整闭环在 JEPA 上尚无先例,且 Ground 通常需要带世界变量标注的数据(机器人轨迹、手术视频标注),获取成本高昂,论文对此没有给出低成本替代方案。
独立分析的弱点
独立分析几点弱点。第一,零实证支撑:论文没有在任何真实 JEPA 上走通哪怕一次 Ground→Structure→Verify→Act 的完整流程,蓝图停留在概念层面,改进方向是先在具有解析真值的受控物理环境(物体属性、动力学均已知的模拟器)做最小试点,验证每一步的可操作性。第二,Ground 依赖人工本体:需要预先定义 $c_k$ 并标注序列 $C$,在机器人和医疗场景标注昂贵且可能遗漏模型真正使用的变量,改进方向是利用仿真器自动生成变量真值,或先无监督发现潜在因子、再反向匹配人类概念,把单向的"人定义—模型验证"变为双向发现。第三,Verify 的关键难题(干预保真性与因子解耦)被指出但未给方案,可借鉴因果表征学习中的解耦约束与能量模型式的潜状态合理性检验,构造"只改目标因子、保持其余信息、状态仍合理"的干预算子。第四,"理解"本身缺乏度量:论文未提出任何可横向比较的评估指标,不同研究的结果将无法比较,改进方向是把解释稳定性、结构一致性、因果声明在受控变化下的保持性形式化为基准协议。
未来方向
作者在第 7 节提出四个优先方向:构建有已知物体、变量与动力学的可控测试床和评估准则,使潜在世界解释可以对照世界真值检验;研究潜在世界如何随架构、训练目标、数据、模型规模与训练阶段涌现,并比较跨模型的结构差异(引用 Richens et al. 2025 关于通用智能体需要世界模型的理论结果);把解释与预测、泛化、失败模式和下游规划/控制的行为差异绑定,使可解释性反哺架构与目标函数设计;把方法扩展到自然视频、长时程预测和复杂环境中的具身智能体,并建设共享基础设施与可复现协议。基于成果可延伸的方向包括:用因果发现算法自动恢复 $R$ 与 $T$ 而非依赖人工分析;在 V-JEPA 2-AC + DROID 上复现 WAM 式引导,补上 JEPA 的 Act 首例;以及把该蓝图反过来用于检验"LLM 是否内部实现了世界模型"这一相邻问题,两条线可共享工具链与评估协议。
复现评估
作为观点论文,没有需要复现的实验本身,跟进成本极低:作者维护了相关文献列表(GitHub 仓库 Jize-W/Awesome-World-Model-Interpretability,见论文脚注 1)。如果想实践该蓝图,关键依赖大都已经开放:V-JEPA 2 有公开代码与权重(arXiv:2506.09985),DROID 大规模机器人操控数据集公开,Cataract-101 包含 101 台白内障手术视频,GUE 基因组基准公开;训练探针和 SAE 属于分析型工作,单张消费级 GPU 即可完成,WorldModelLens 与 WAM 引导的代码开放状态需查原文确认。真正的门槛不在算力而在方法:Structure 阶段缺乏成熟工具,Verify 阶段的干预构造是公认未解难题,且论文未提供任何参考实现。总体属于中等偏难的方法论复现——适合当作研究议程去跟进,而不是拿来即用的 pipeline。
论文图表
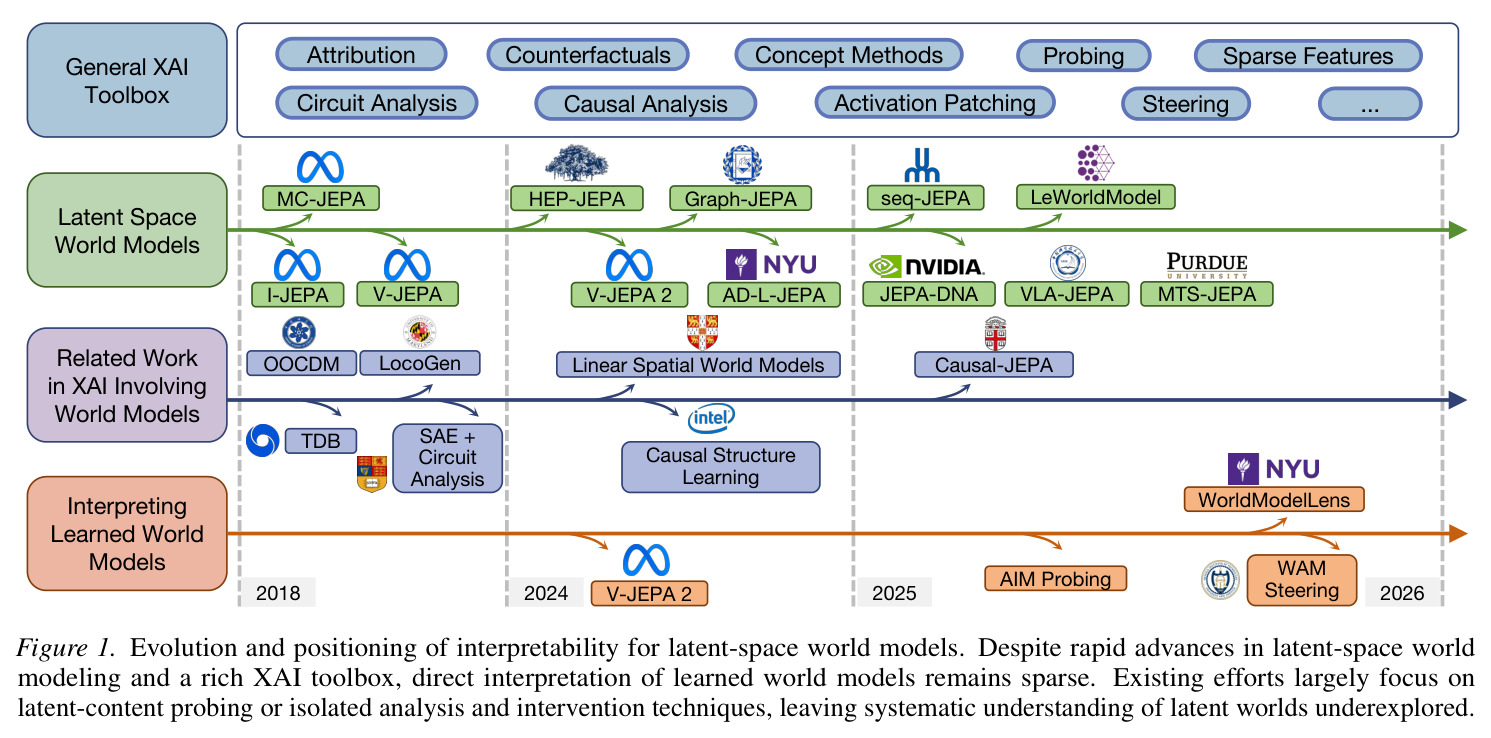
2018–2026 时间线图,分三层:最上层是通用 XAI 工具箱的演进(归因、反事实、概念方法、探针、稀疏特征、电路分析、因果分析、激活修补、引导);中间层是潜在空间世界模型家族(MC-JEPA、I-JEPA、V-JEPA、V-JEPA 2、Graph-JEPA、seq-JEPA、HEP-JEPA、JEPA-DNA、VLA-JEPA、MTS-JEPA 等);最下层是涉及世界模型的少量 XAI 工作(TDB、OOCDM、线性空间世界模型、Causal-JEPA、SAE 分析、WAM、WorldModelLens、AIM),显示工具箱与世界模型两条线并行繁荣,但直接解释世界模型的工作非常稀少。
一图看清"工具丰富但应用缺位"的领域格局,是论文研究空白论证的视觉总纲,帮助读者快速定位本文在时间与问题空间中的位置。
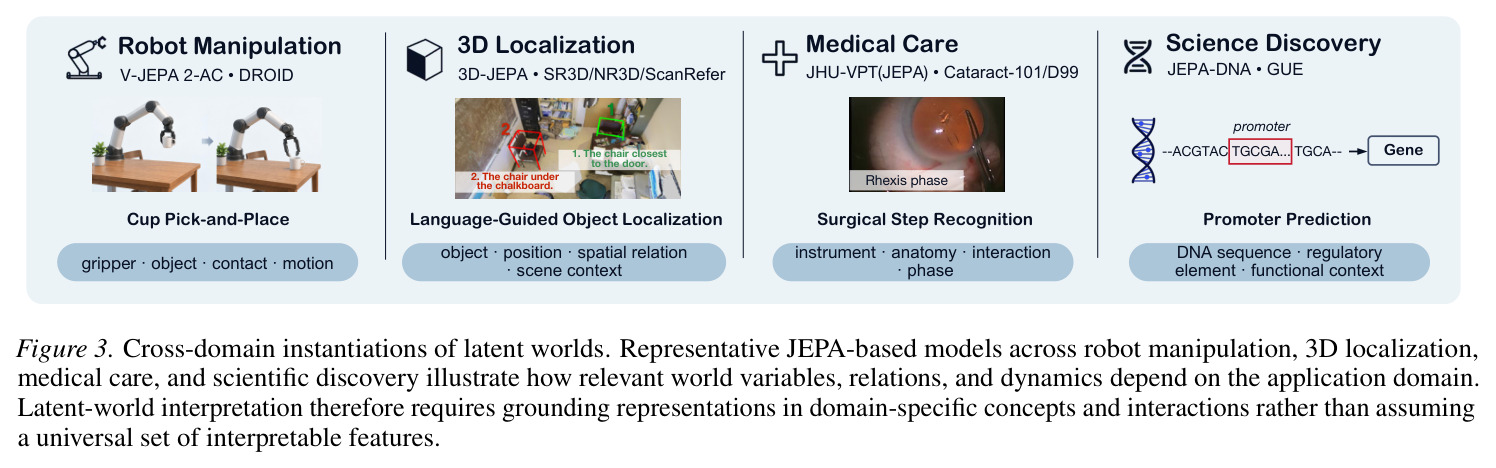
四栏领域对比图:机器人操控(V-JEPA 2-AC + DROID,杯子抓放任务,变量含抓爪、物体、接触、运动)、3D 定位(3D-JEPA + SR3D/NR3D/ScanRefer,语言引导的物体定位,变量含物体、位置、空间关系、场景上下文)、医疗(JHU-VPT + Cataract-101/D99,手术阶段识别,变量含器械、解剖结构、手术阶段、功能上下文)、科学发现(JEPA-DNA + GUE,启动子预测,变量含 DNA 序列、调控元件)。
证明潜在世界的本体是领域依赖的:机器人、3D、医疗、基因组的可解释变量完全不同,Ground 阶段不能假设普适特征集,这直接影响框架在各领域的落地方式。