深度融合记忆:面向大语言模型的块级参数化记忆 Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
块级共享监督+门控深度融合的参数化记忆,免检索推理且构建成本降2048倍
前置知识
参数化记忆
把外部语料知识离线'蒸馏'进模型参数的一类方法:训练时用检索结果构造监督信号(如邻居的下一词分布或连续向量),推理时不再查询数据库,直接由模型内部模块生成记忆。代表工作有 MLP Memory、Memory Decoder。与 RAG 的区别是推理零检索开销,代价是训练前的数据构建和训练本身开销大。
DFM 本身就是一种参数化记忆架构,理解它的定位才能明白它与 RAG、CPT 之间的取舍关系。
kNN-LM 与浅层融合
kNN-LM 在每个 token 位置检索相似上下文,用邻居的下一词分布与模型自身输出分布在 softmax 概率层做插值。这种只发生在输出概率层的融合被称为浅层融合:记忆无法影响中间隐状态,后续解码层没有机会进一步加工这些信息。MLP Memory、Memory Decoder 都沿用这种输出插值范式。
DFM 的'深度融合'正是针对输出插值这一范式提出的,对比才能理解其核心创新点。
灾难性遗忘
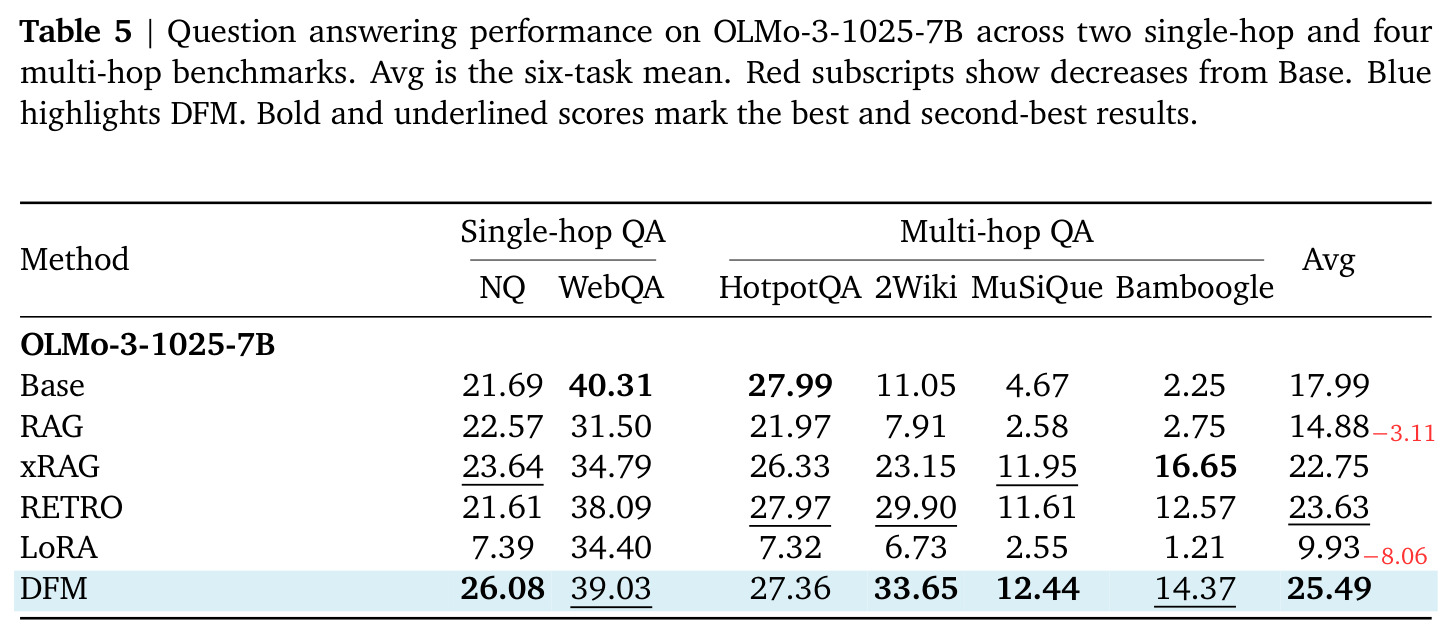
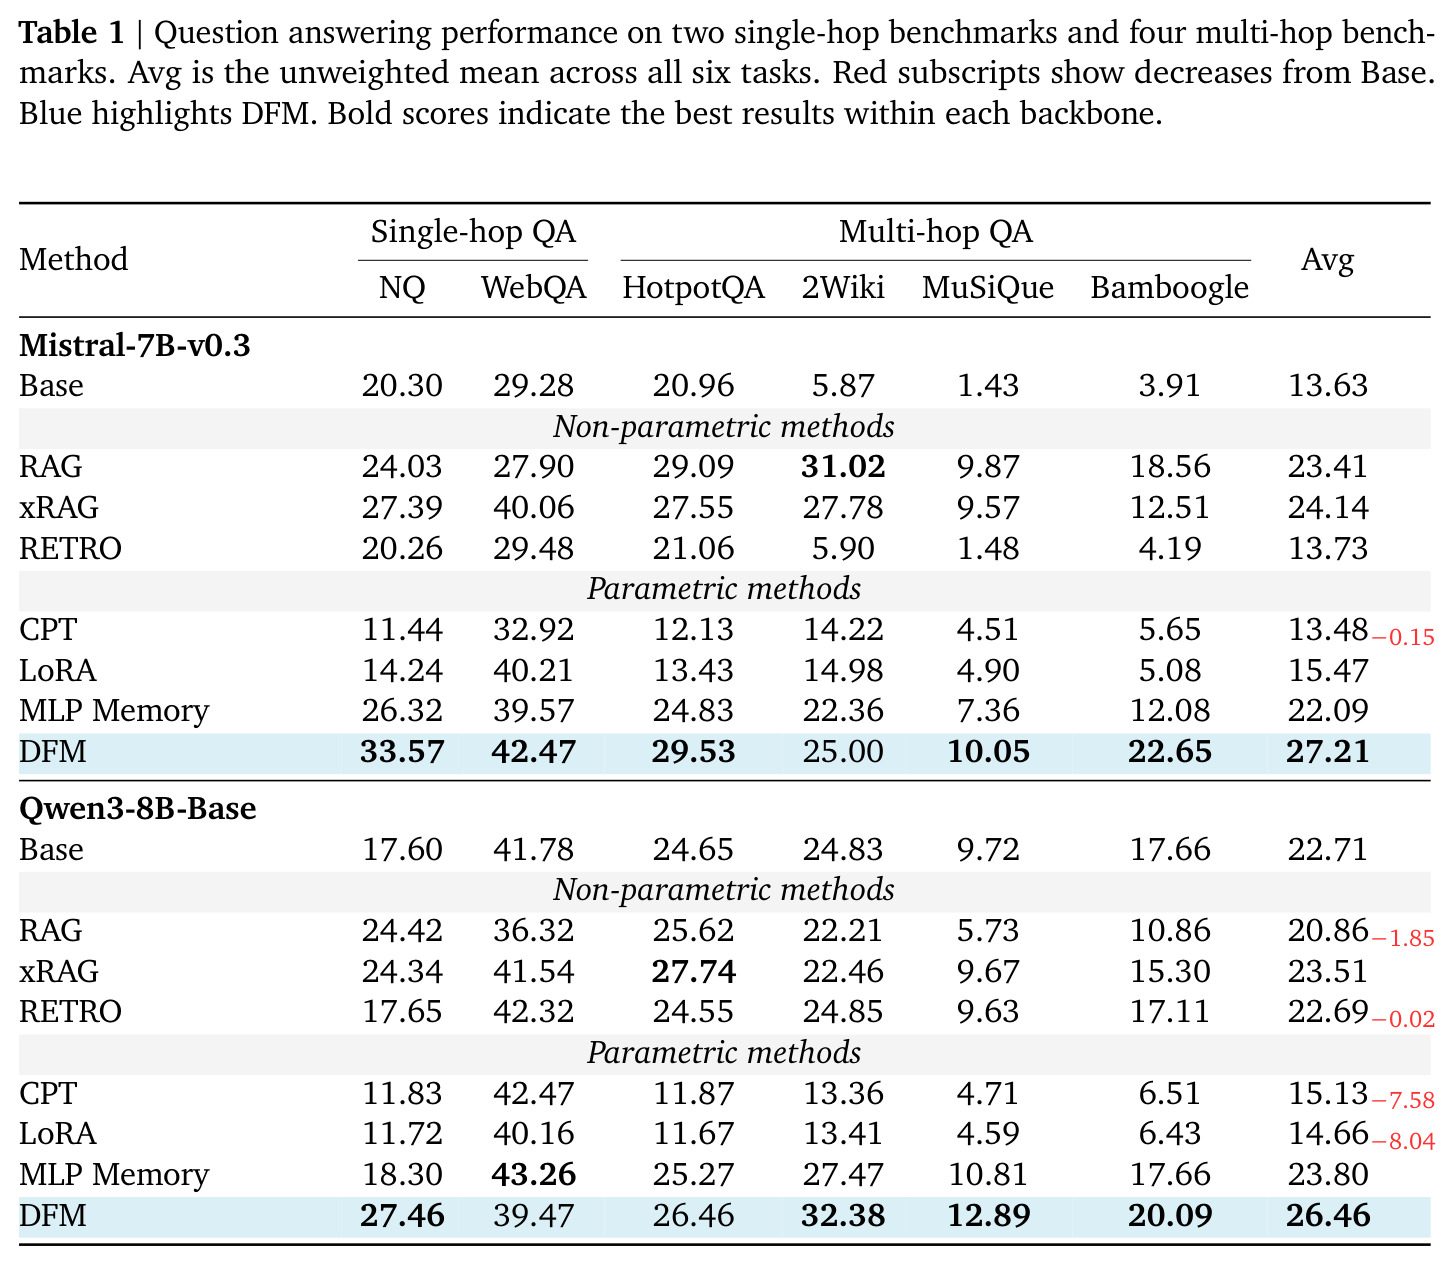
在补充语料上继续预训练或微调(CPT/LoRA)时,模型参数被新任务梯度覆盖,原有通用能力显著退化的现象。本文实验中 Qwen3-8B 做 CPT 后六任务 QA 平均从 22.71 掉到 15.13(−7.58 分),LoRA 更是掉 8.04 分,直观展示了这一风险。
这是 DFM 选择冻结骨干、只训练外挂记忆模块的直接动机。
门控交叉注意力
交叉注意力让当前 token 的 query 去查询一组外部 key-value(这里是 K 个记忆向量);门控则在每个注意力头上乘一个由当前 token 状态经 $g_t=\sigma(W_g z_t + b_g)$ 得到的 0–1 标量,控制该头记忆信息的注入强度,实现逐 token、逐头的软选择。
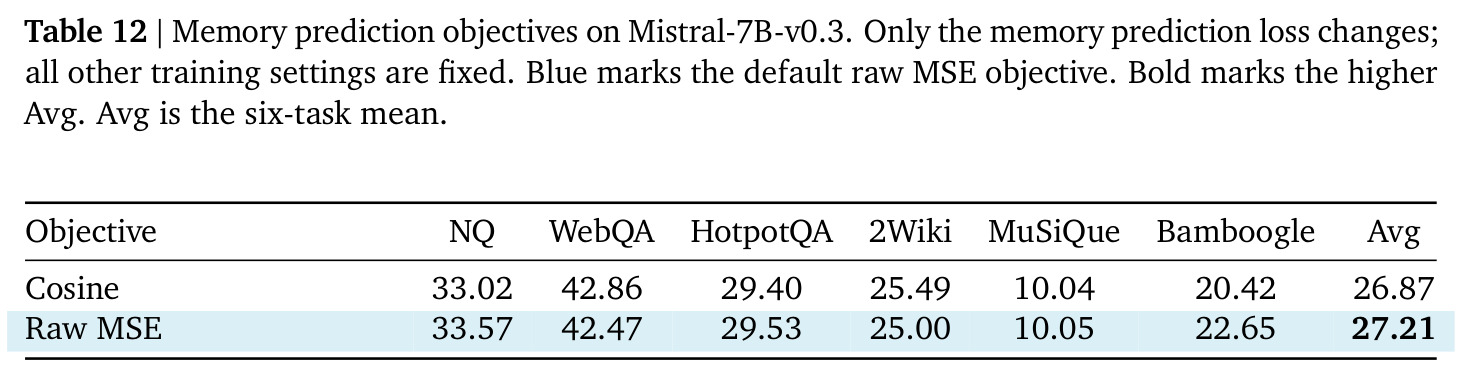
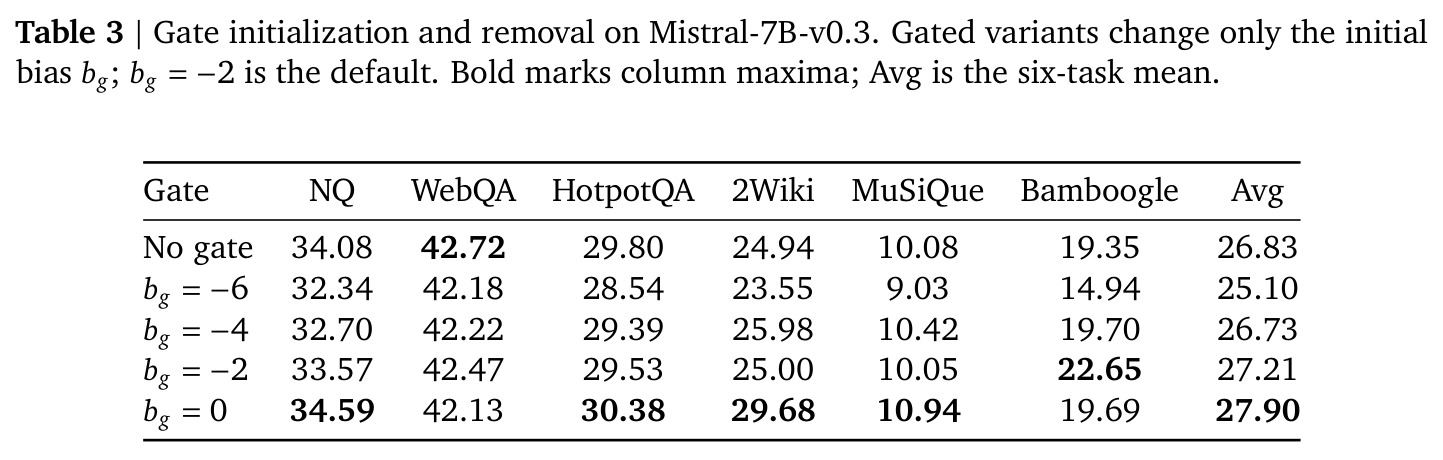
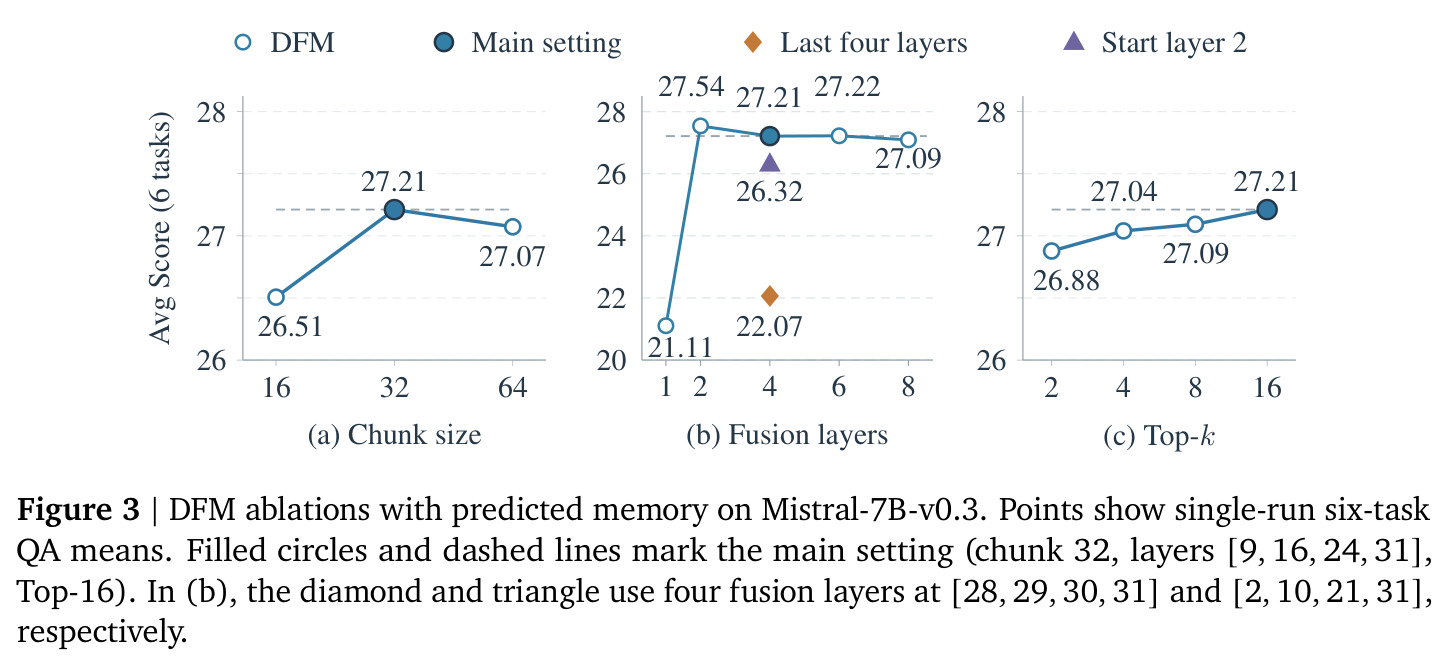
门控交叉注意力是 DFM 把记忆注入隐状态的核心机制,消融显示去掉门控会从 27.21 掉到 26.83。
块级检索(RETRO 范式)
不以单个 token 而以固定长度文本块(chunk)为检索单元:用前一块的编码向量去语料库中检索 top-K 相似块。RETRO 首先在解码器内部用交叉注意力融合这些检索块。块级操作把检索次数从 token 数降到块数,天然适合批量构建监督数据。
DFM 把 RETRO 的块级检索搬到了离线监督构造环节,是 32×/2048× 效率提升的来源。
研究动机
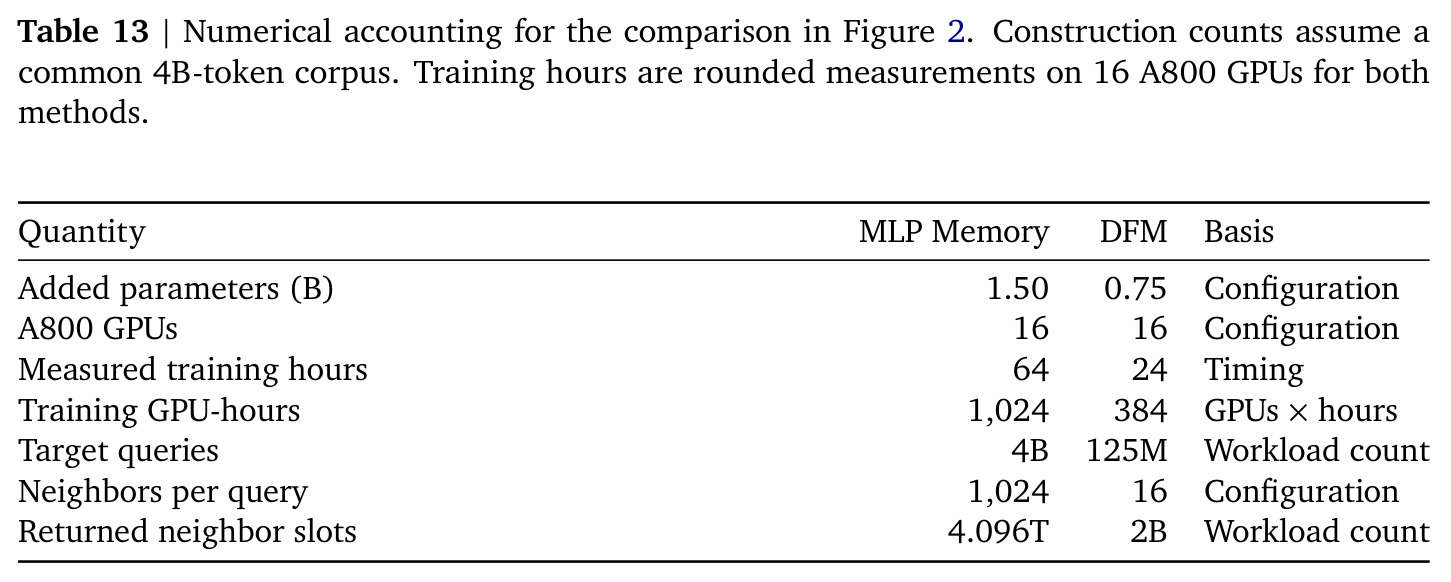
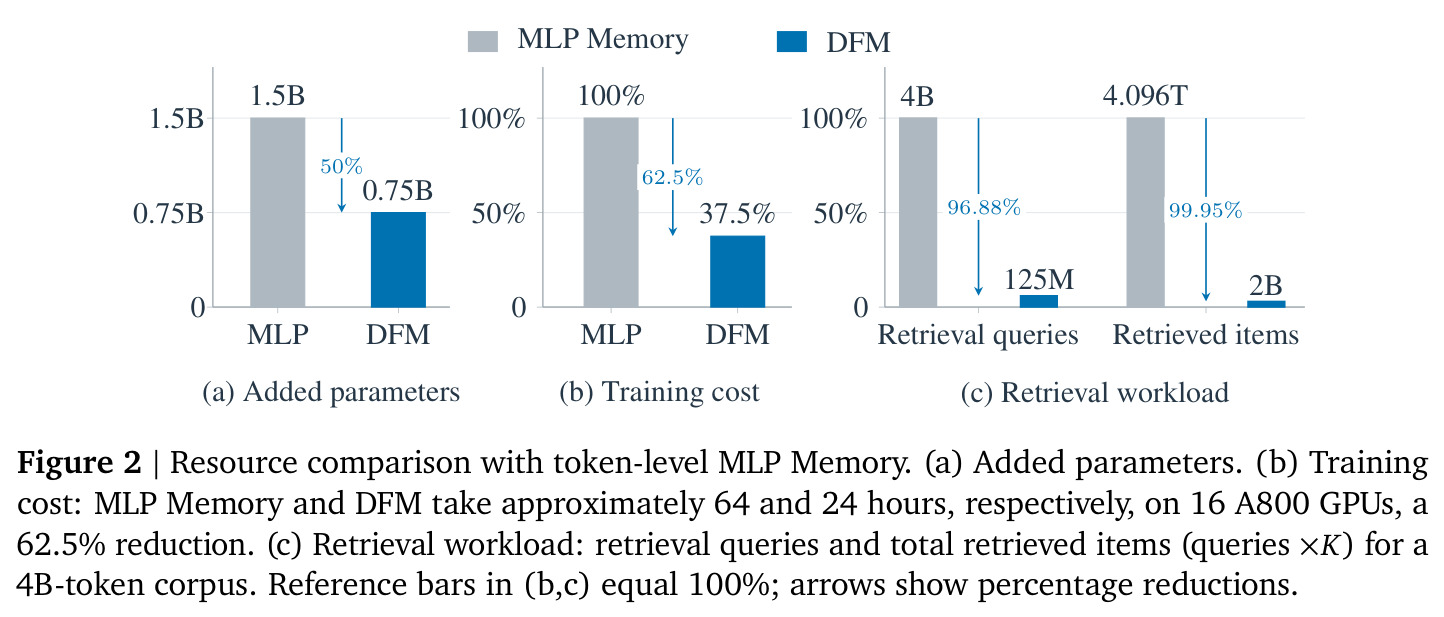
给 LLM 注入外部语料知识存在'不可能三角':推理开销、能力保持、知识获取成本三者难以兼得。继续预训练(CPT)和 LoRA 推理自足,但会灾难性遗忘——本文实验中 Mistral-7B 做 CPT 后六任务 QA 均值反而从 13.63 降到 13.48,Qwen3-8B 上 CPT/LoRA 分别暴跌 7.58/8.04 分;RAG 类方法知识可更新但要在线检索,datastore 搜索和证据处理带来显著推理延迟;MLP Memory、Memory Decoder 这类参数化记忆避免了在线检索,但它们以 token 为粒度构造训练目标:对约 40 亿 token 的语料,每个 token 位置都要检索一次,共需 40 亿次检索查询,按 Top-1024 计高达 4.096 万亿条检索条目,训练也要 64 小时(16 张 A800)。此外这些方法只在输出概率层做插值,属于浅层融合,记忆无法被中间解码层进一步加工。
本文的目标是本文目标是设计一种兼具高效与深度的参数化记忆架构 DFM:其一,把监督数据的构建成本压到可用水平——用块级共享目标替代 token 级目标,将检索查询数减少 32 倍、检索条目数减少 2048 倍;其二,让学到的记忆不只是修正输出分布,而是通过门控交叉注意力注入中间隐状态,使后续解码层能把记忆与不断演化的上下文结合加工;其三,全程冻结骨干网络并端到端联合训练记忆预测器与融合模块,推理时完全不需要检索。量化目标上,DFM 要在六个知识密集型 QA 任务上以两位数相对幅度超越最强基线(最终在 Mistral-7B-v0.3 上超 12.71%、Qwen3-8B-Base 上超 11.19%),并在代码、数学、法律等域适应任务上稳定超过基线模型。
与已有工作不同的是,已有参数化记忆工作普遍默认'监督必须逐 token 构造',因为语言建模目标本身是逐 token 的;本文抓住一个被忽视的事实:相邻 token 共享几乎相同的上文,对每个 token 位置独立检索是对同一上下文的重复查询。DFM 由此把监督粒度从 token 提升到 chunk,让同一 chunk 内所有 token 的预测共享同一份目标记忆,再由逐 token 的门控注意力自行决定各自'读取'记忆的哪一部分——监督是共享的,使用是个性化的。另一个切入点是融合深度:kNN-LM 一系只在输出概率层插值,而 RETRO 已证明中间层的交叉注意力融合有效但依赖在线检索;DFM 把两者结合,先离线学习预测记忆、再在解码器内部深度融合,兼得 RETRO 的融合深度与参数化记忆的免检索推理。
核心方法
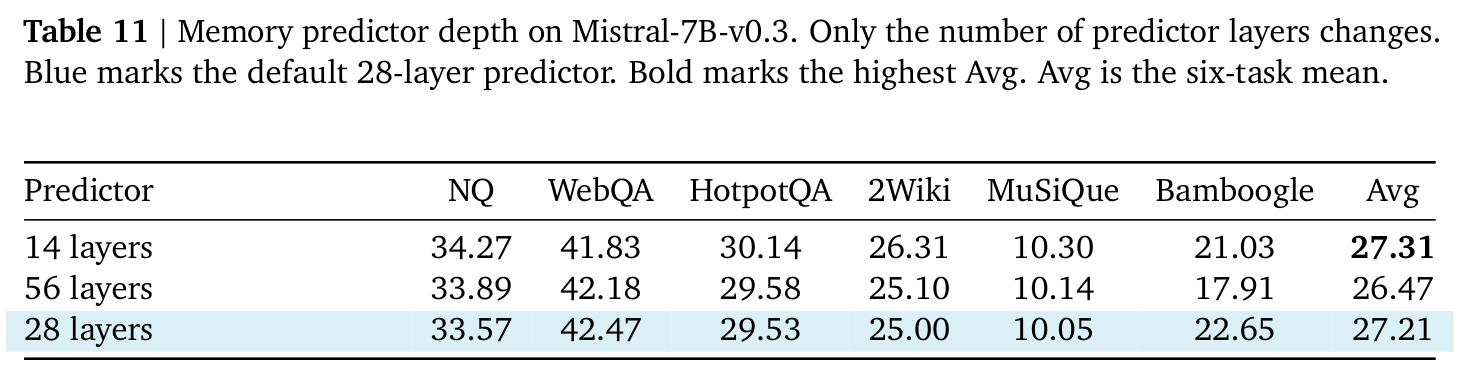
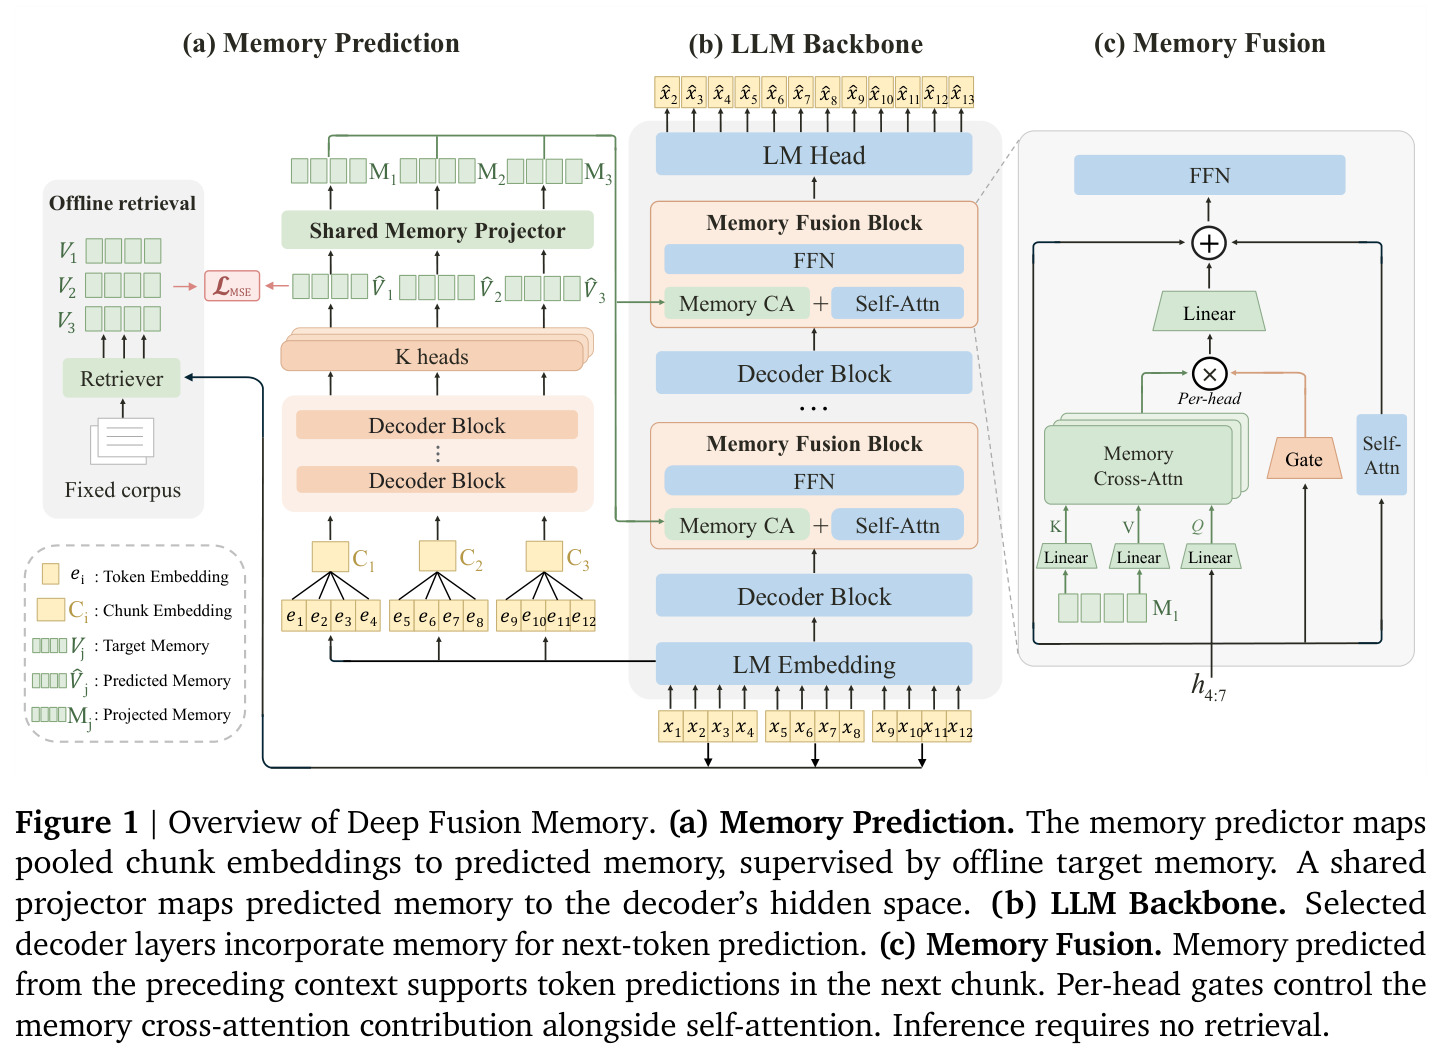
直觉上,DFM 像一位随行图书管理员:模型每读完一个 32-token 的段落,管理员就根据这段内容从知识库里挑出 16 张最相关的'索引卡'(连续向量),递给模型用于预测下一段——同一段里的每个词拿到的是同一叠卡片,但每个词通过各自的注意力'翻阅'其中对自己有用的部分。技术上,DFM 由两个外挂模块加冻结骨干组成:(1) 因果块级记忆预测器——将前一块 token 嵌入平均池化得到块向量 $C_j$,用一个小型因果 Transformer 加 K 个线性输出头预测 $\hat{V}_j \in \mathbb{R}^{K \times d_m}$;(2) 插入第 9/16/24/31 层的记忆融合块——以投影后的记忆 $M_j$ 为 key/value 做门控交叉注意力。训练用 $\mathcal{L} = \mathcal{L}_{LM} + \beta \mathcal{L}_{MSE}$($\beta=1$)端到端完成,在约 40 亿 token 的 2018 年英文维基上单轮训练仅需 24 小时(16 张 A800),而 MLP Memory 需要 64 小时。
核心创新有三点。第一是块级共享监督:为一个 chunk 只构造一份目标记忆(前一块检索到的 top-16 相似块嵌入按检索排名堆叠成 $V_j$),它同时监督该 chunk 内全部 32 个 token 的预测,使 40 亿 token 语料的检索查询从 40 亿次降到 1.25 亿次(32×),检索条目从 4.096 万亿降到 20 亿(2048×)。这与已有方法'逐 token 构造目标'的本质区别在于:监督信息的粒度不必等于预测的粒度,个性化的记忆使用可以建立在共享的监督之上。第二是深度融合:预测记忆不与输出概率插值,而是作为交叉注意力的 key/value 进入中间隐状态的残差流 $\hat{h}_t = h_t + \mathrm{SelfAttn}(z_{\le t}) + u_t$,让更上层的解码器把记忆当作普通上下文继续加工。第三是端到端训练:语言建模损失的梯度经融合模块回传到预测器,目标记忆仅通过 MSE 监督,预测器于是学会生成'既像检索结果、又对下一词预测有用'的记忆。
方法步骤详情
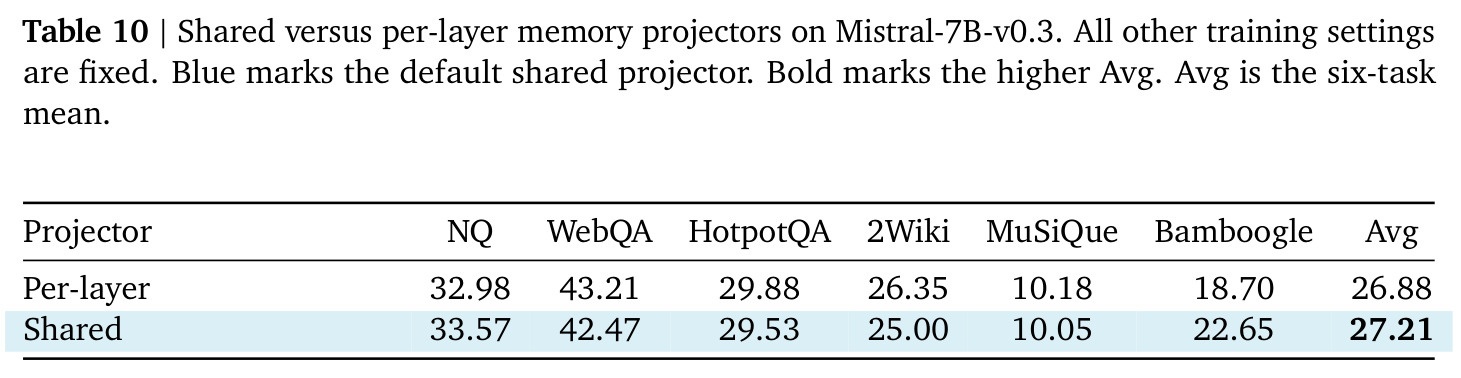
流程分五步。(1) 离线构造目标:把序列切成不重叠的 32-token 块 $X_0,\dots,X_{J-1}$;对每个 $j\ge 1$,用 Qwen3-Embedding-0.6B 编码前一块 $X_{j-1}$,检索 top-16 相似块,其冻结编码按排名堆叠为 $V_j \in \mathbb{R}^{16 \times d_m}$,首块不参与监督。(2) 预测记忆:骨干 token 嵌入按前一块平均池化得 $C_j$,因果 Transformer 预测器以 $C_{\le j}$ 为输入、K 个线性头输出 $\hat{V}_j$。(3) 投影:共享投影器(LayerNorm + 两层 GELU 线性层)把 $\hat{V}_j$ 映到隐空间得 $M_j \in \mathbb{R}^{K \times d}$,跨融合层复用。(4) 融合:在 [9,16,24,31] 层,以 $z_t=\mathrm{Norm}(h_t)$ 为 query、$M_j$ 为 key/value 做 H 头交叉注意力(每头在 K 个 slot 上 softmax),逐头门控 $g_t=\sigma(W_g z_t+b_g)$ 缩放后过输出投影得 $u_t$,与自注意力并行进入同一残差;对齐规则 $j=\lfloor (t+1)/C \rfloor$。(5) 训练与推理:联合优化全部新增模块,损失 $\mathcal{L}=\mathcal{L}_{LM}+\beta\mathcal{L}_{MSE}$($\beta=1$);推理时块查询来自输入嵌入,生成期间记忆固定,零检索。
技术新颖性
与 MLP Memory / Memory Decoder 相比,DFM 的差异是全方位的:监督粒度从 token 级变为 chunk 级(构建成本降 2048 倍)、融合位置从输出概率插值变为中间隐状态、训练范式从'先蒸馏分布再插值'的两阶段变为端到端联合训练、新增参数从 1.5B 降到 0.75B(省 50%)。与 RETRO 相比,RETRO 推理时必须在线检索并对真实检索文本做交叉注意力,DFM 的交叉注意力面向的是预测器生成的连续记忆,推理零检索、零 datastore。与 xRAG 相比,xRAG 仍需检索并把文档嵌入压成单个 token 放进上下文,DFM 干脆不检索。与 CPT/LoRA 相比,DFM 冻结骨干从而规避遗忘(CPT 在 Qwen3-8B 上掉 7.58 分)。逐 token、逐头的 sigmoid 门控也是对 RETRO 标准交叉注意力的改进。
实验结果
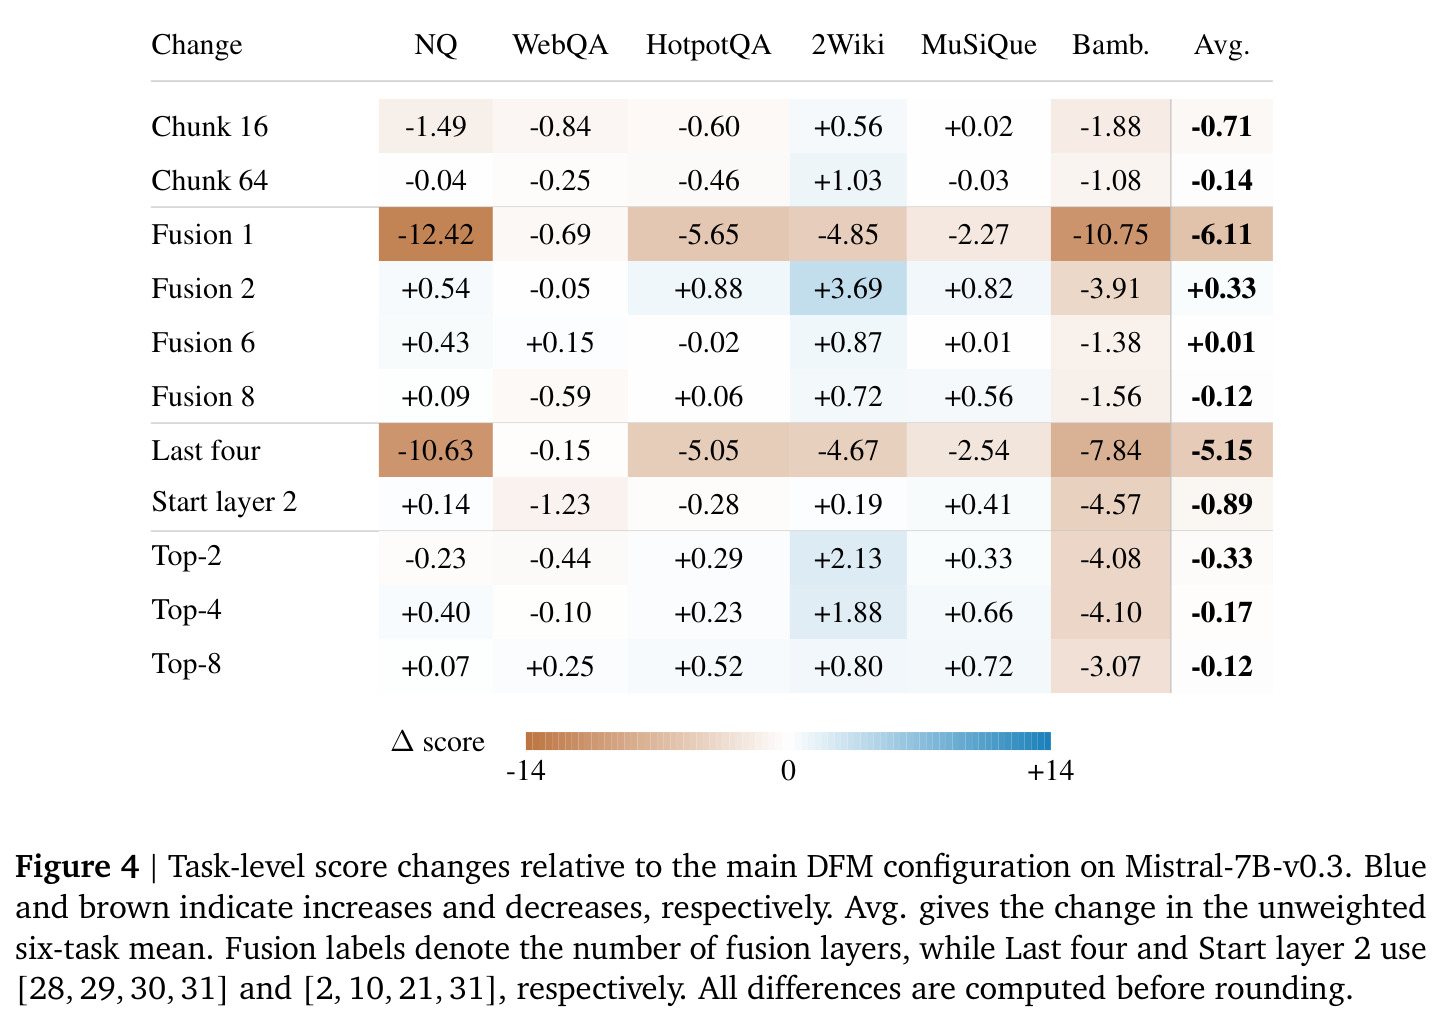
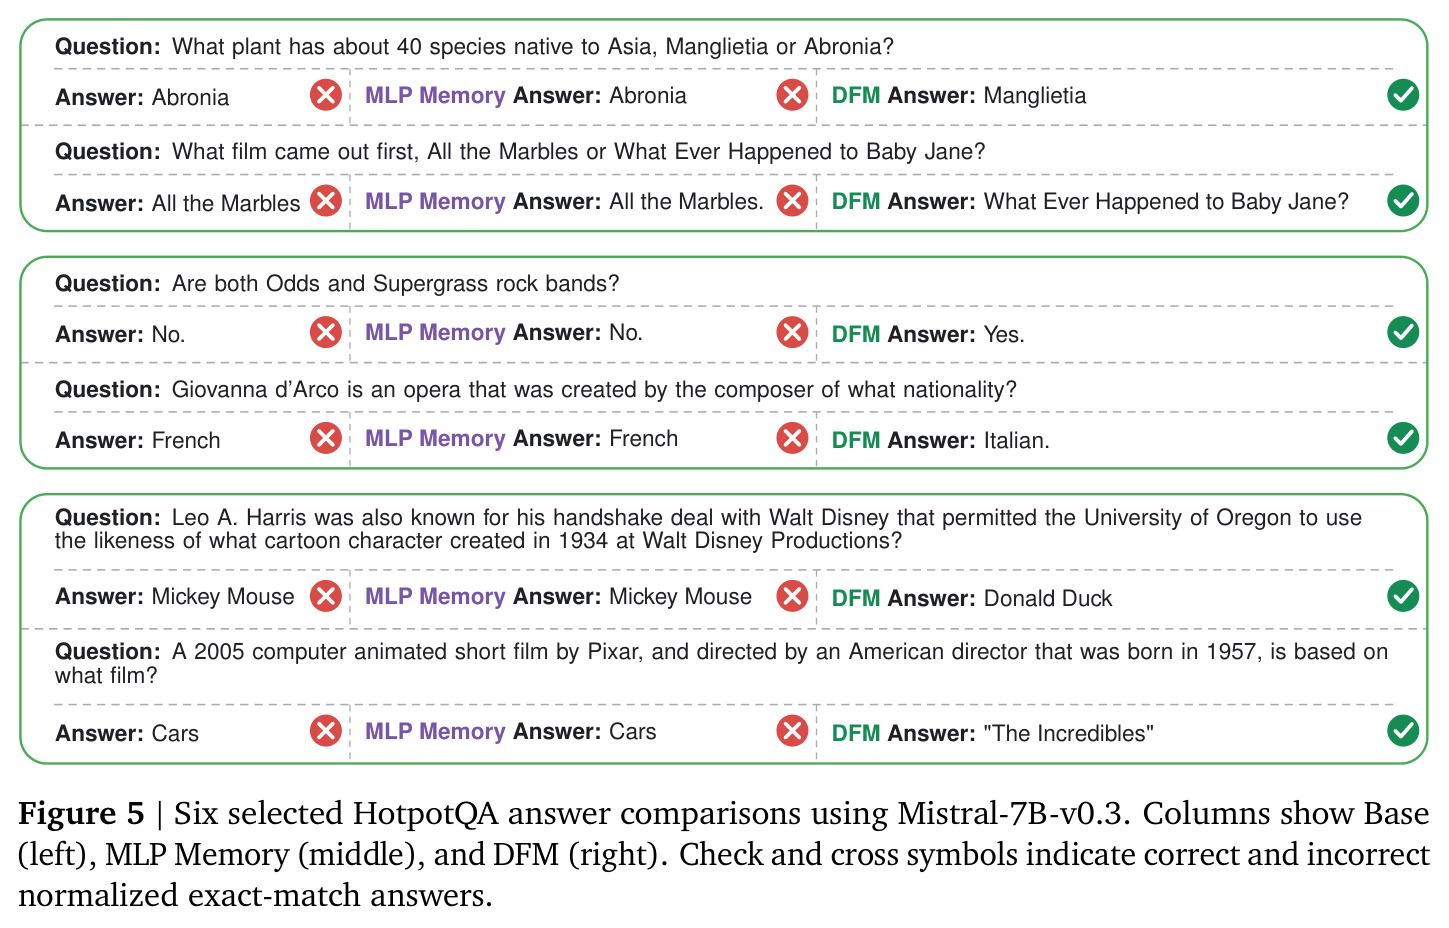
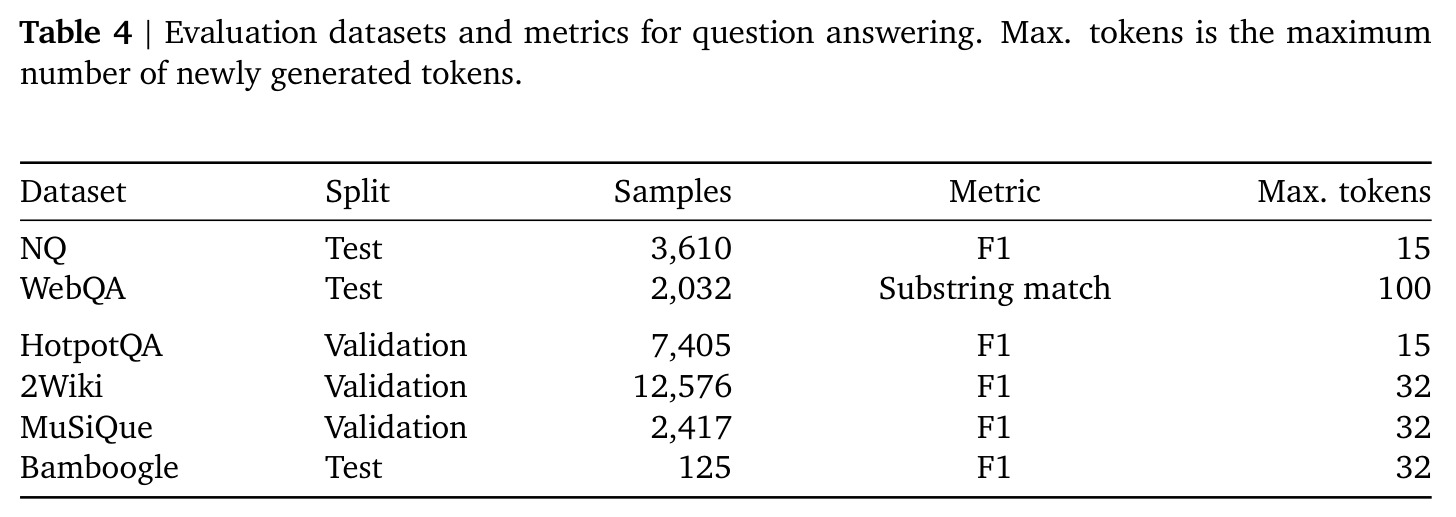
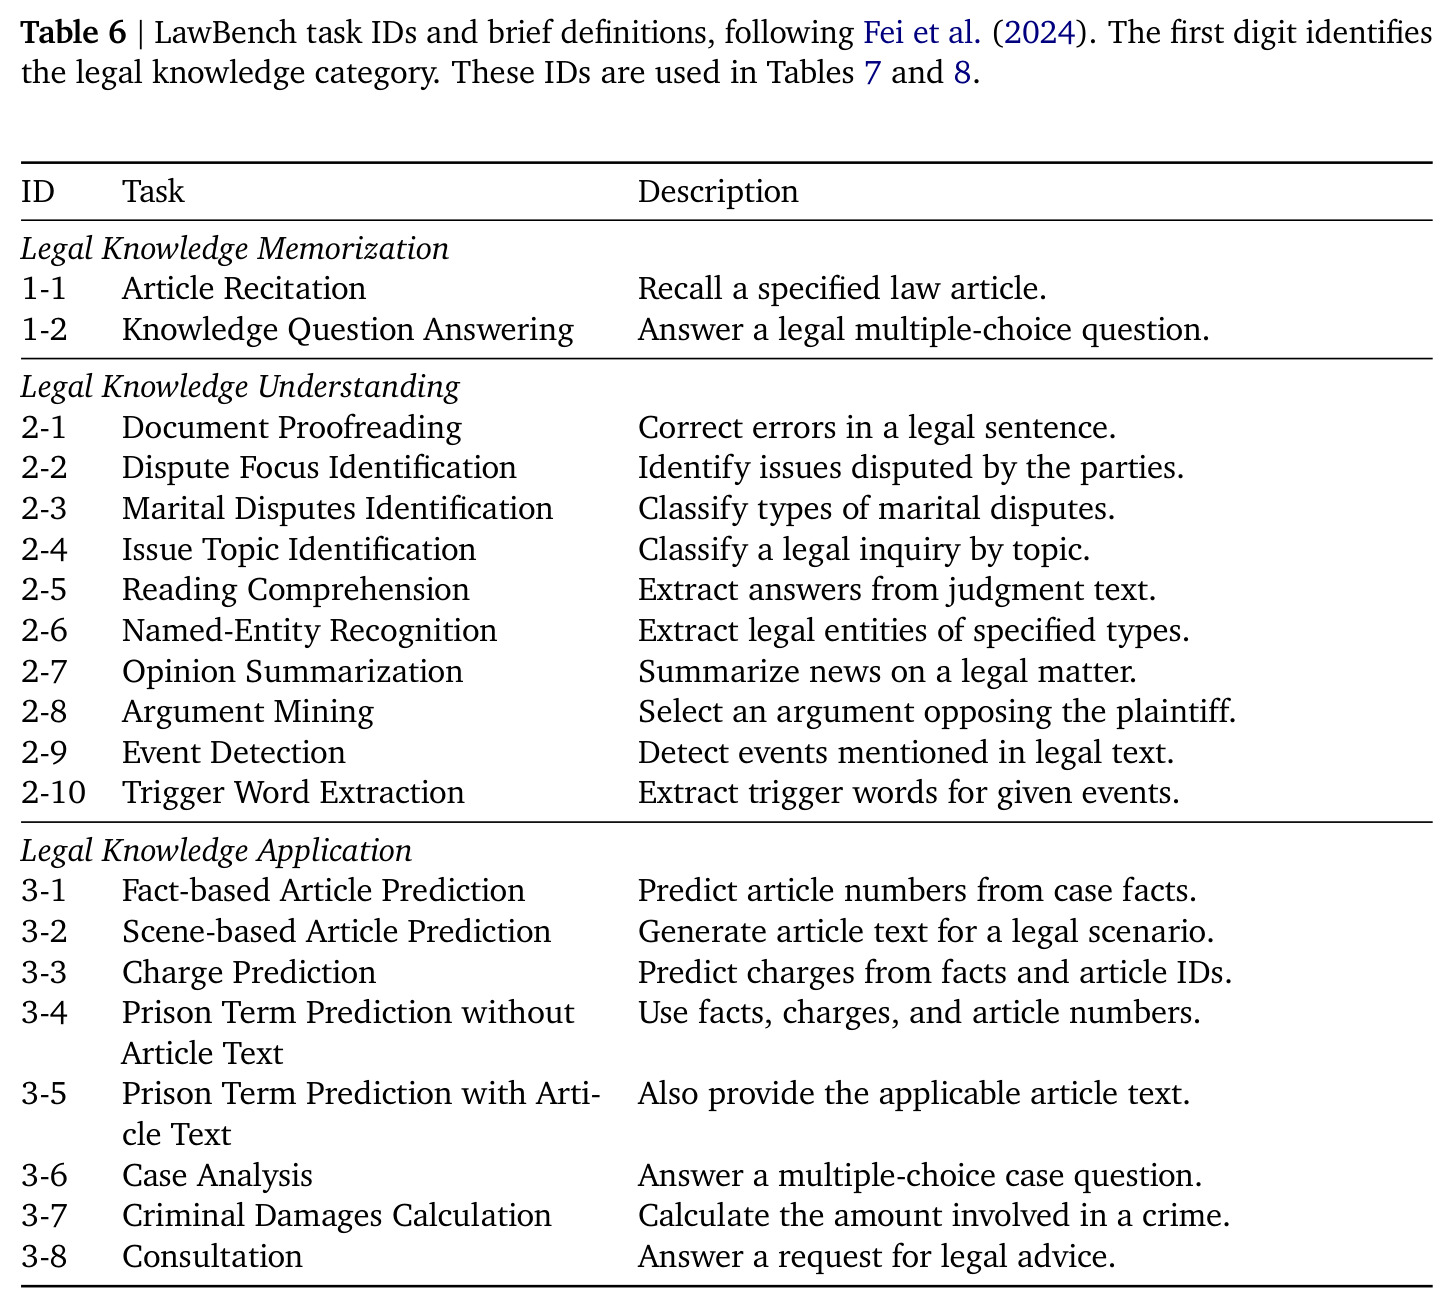
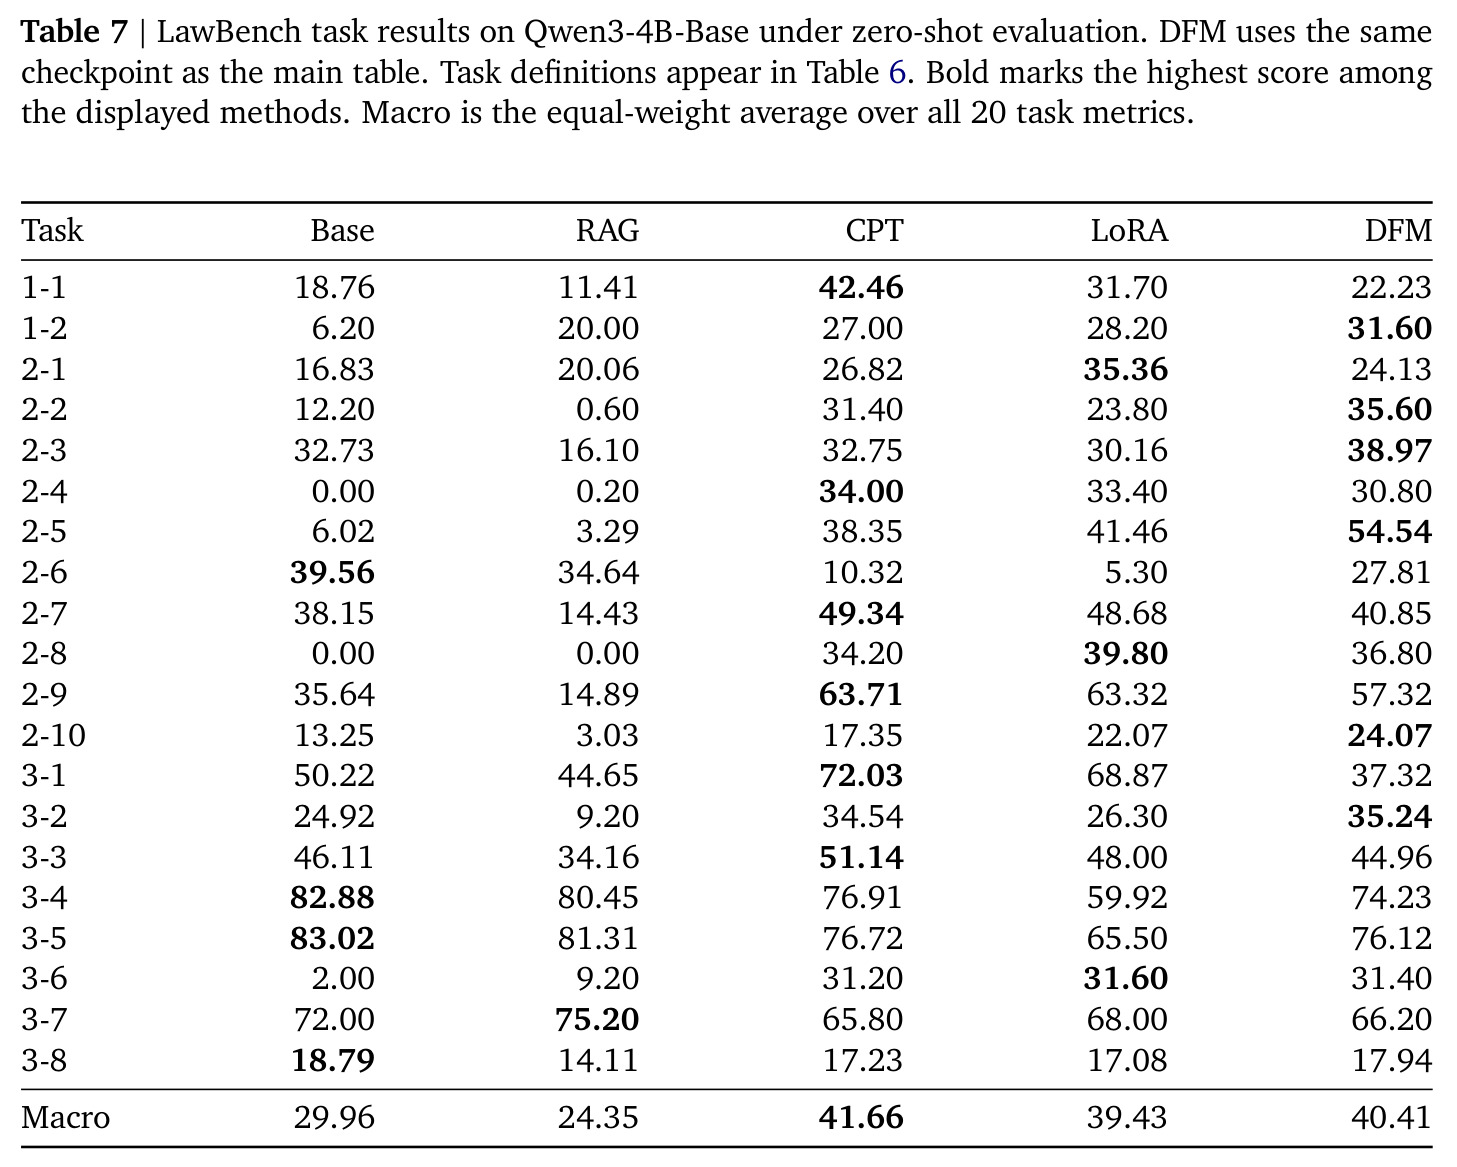
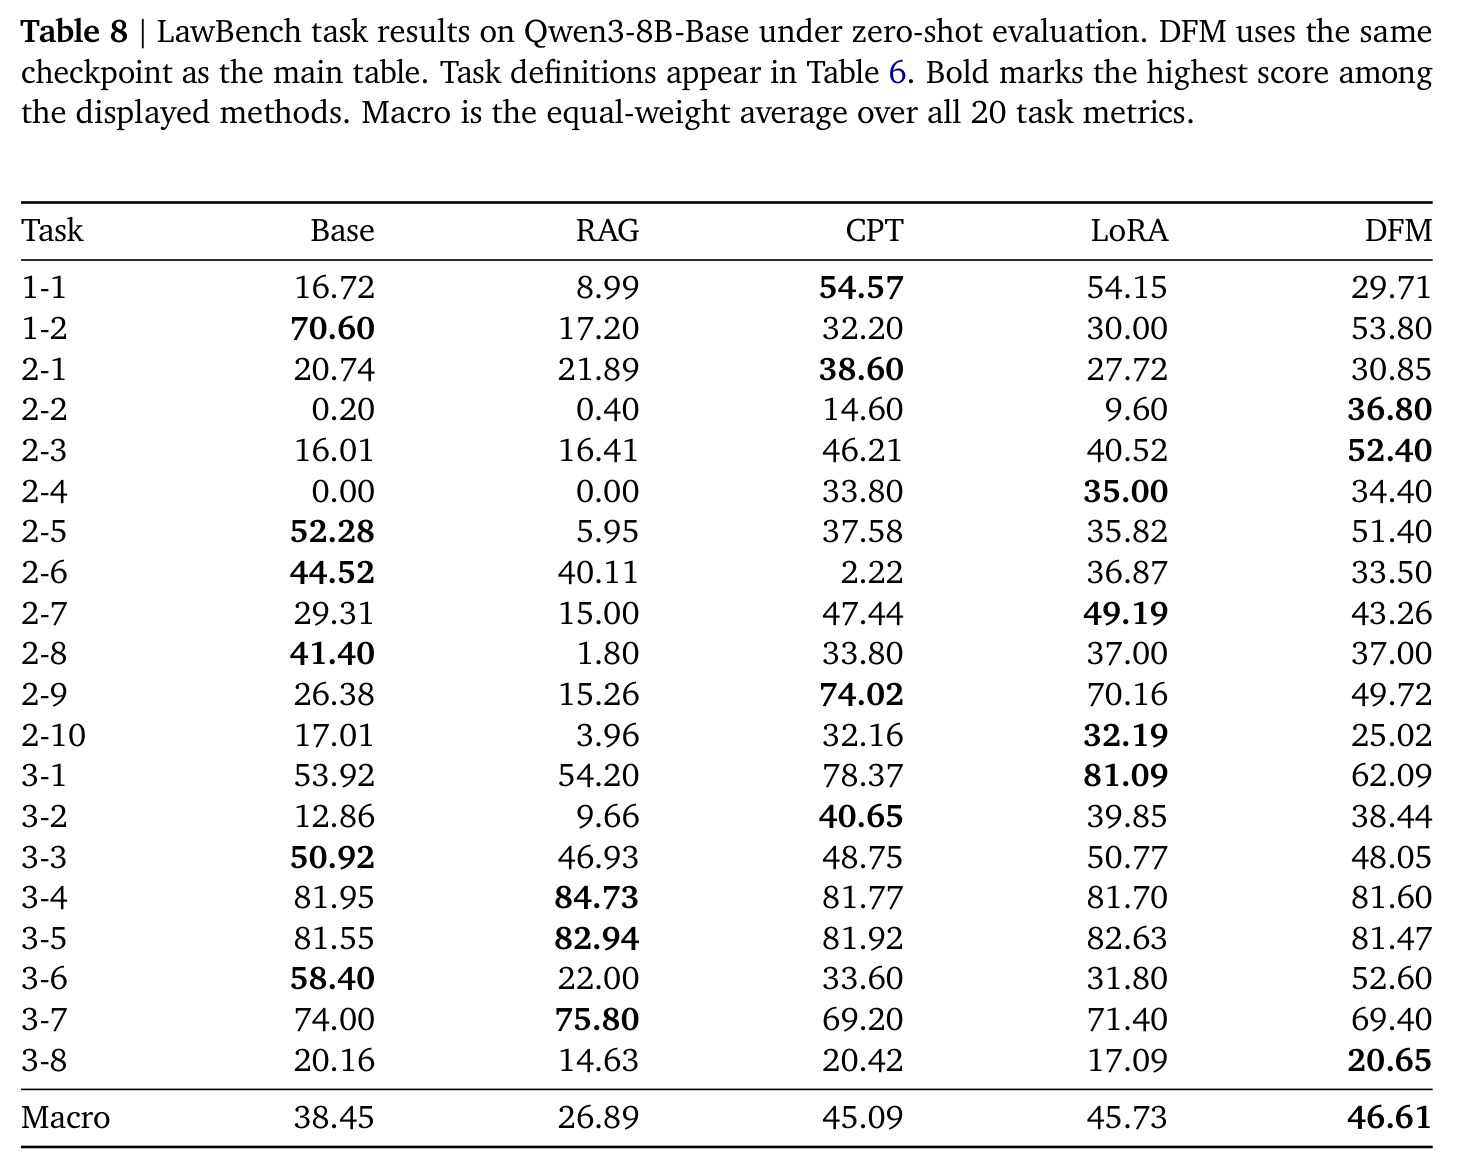
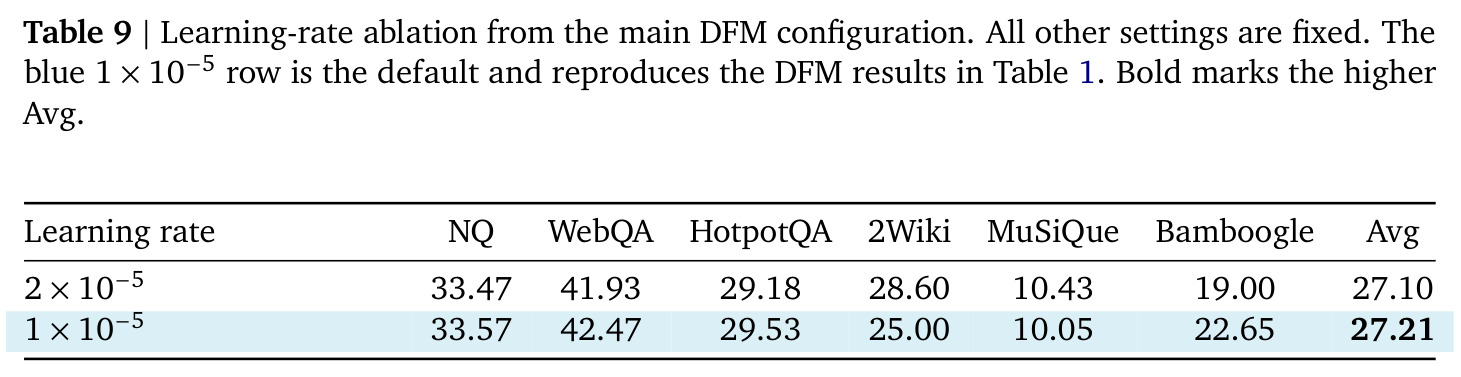
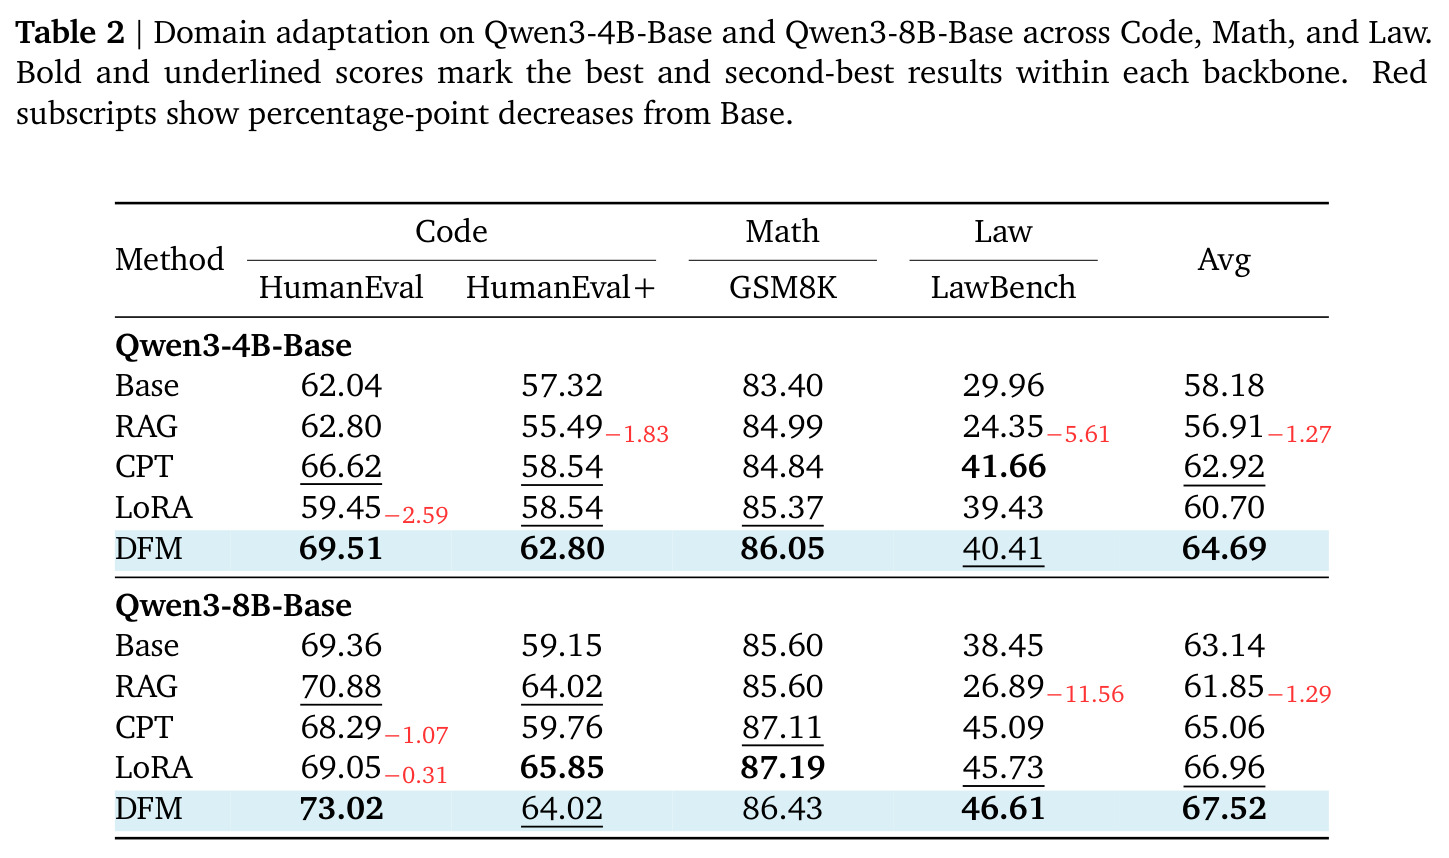
问答(Table 1):Mistral-7B-v0.3 上 DFM 六任务均值 27.21,最强基线 xRAG 为 24.14(相对提升 12.71%,绝对 +3.07),较 Base 的 13.63 提升 13.59 分且六任务全部超越 Base;NQ 33.57(超最强基线 6.18 分)、WebQA 42.47,多跳 Bamboogle 从 3.91 飙到 22.65,2Wiki 从 5.87 升至 25.00(但 RAG 的 31.02 仍更强)。Qwen3-8B-Base 上均值 26.46 超 MLP Memory 的 23.80(+11.19%),2Wiki/MuSiQue/Bamboogle 全场最佳,NQ 从 17.60 升至 27.46,唯 WebQA 降至 39.47(MLP Memory 达 43.26)。域适应(Table 2):Qwen3-4B/8B-Base 四基准均值 64.69/67.52(超 Base 6.51/4.38 分);LawBench 提升最显著,8B 从 38.45 到 46.61、领先 RAG(26.89)19.72 分;HumanEval 上 8B 拿全场最高 73.02,但 HumanEval+ 与 GSM8K 不敌 LoRA 的 65.85/87.19。效率(Figure 2):新增参数 0.75B(MLP Memory 为 1.5B),训练 24 小时对 64 小时(省 62.5%),目标构建查询 125M 对 4B(−96.88%)、条目 2B 对 4.096T(−99.95%)。消融(Figure 3/Table 3):chunk=32 最优;融合层只放最后四层仅 22.07,中后层分布的 [9,16,24,31] 达 27.21;Top-2 与 Top-16 仅差 0.33 分;门控 $b_g=0$ 可到 27.90,去掉门控降为 26.83。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六任务知识密集型 QA 平均(Mistral-7B-v0.3) | 六任务平均分 | 27.21 | 最强基线 xRAG 24.14(Base 为 13.63) | 相对提升 12.71%,绝对 +3.07 分 |
| 六任务知识密集型 QA 平均(Qwen3-8B-Base) | 六任务平均分 | 26.46 | 最强基线 MLP Memory 23.80(Base 为 22.71) | 相对提升 11.19%,绝对 +2.66 分 |
| NQ 单跳问答(Mistral) | 评测分数 | 33.57 | xRAG 27.39 / Base 20.30 | 超最强基线 6.18 分,超 Base 13.27 分 |
| Bamboogle 多跳问答(Mistral) | 评测分数 | 22.65 | Base 3.91 / RAG 18.56 | 较 Base 提升 18.74 分,超 RAG 4.09 分 |
| 域适应平均(Qwen3-4B-Base,Code/Math/Law 四基准) | 四基准平均分 | 64.69 | Base 58.18 / CPT 62.92 | +6.51 分,超 CPT 1.77 分 |
| LawBench 法律域(Qwen3-8B-Base) | 评测分数 | 46.61 | RAG 26.89 / Base 38.45 | 超 RAG 19.72 分,超 Base 8.16 分 |
| 训练目标构建(40 亿 token 语料) | 检索查询数 / 检索条目数 | 125M / 2B(Top-16) | token 级 MLP Memory:4B / 4.096T(Top-1024) | 查询 −96.88%,条目 −99.95% |
| 训练开销(16 张 A800,同一语料) | 训练时长 | 约 24 小时 | MLP Memory 约 64 小时 | 减少 62.5% |
局限与改进
作者承认的局限:跨骨干表现不一致——Qwen3 上 WebQA 从 41.78 降到 39.47 且输给 MLP Memory 的 43.26,说明冻结骨干下的记忆适配也并非对所有任务都有益;部分基准上显式检索仍占优(Mistral 2Wiki 上 RAG 31.02 对 DFM 25.00,Qwen3 HotpotQA 上 xRAG 27.74 对 26.46);门控偏置默认值 $b_g=-2$ 并非最优,$b_g=0$ 可再提至 27.90,作者自述选 −2 只是'保守默认'。我观察到的局限:其一,QA 绝对分数普遍偏低(均值 27 左右),说明参数化记忆注入的知识量仍有限,离'替代检索'还有距离;其二,QA 评测时记忆由 prompt 一次性计算并在整个生成期间固定,长答案或需求动态知识的场景可能失效,论文未测试生成中途更新记忆;其三,新增 0.75B 参数约为 Mistral-7B 的 10%,且预测器本身是一个额外因果 Transformer,推理时延与显存代价未单独报告;其四,未评估知识时效性(语料截至 2018 年)与幻觉率,也未在更大语料或多语种上验证。
独立分析的弱点
独立分析四个弱点。(1) 记忆静态性:QA 场景记忆在生成期间固定,多跳推理中问题焦点会漂移,固定的 16 个 slot 可能覆盖不了后续跳所需证据;改进方向是让预测器随生成进度滑窗重算,或引入分层记忆(篇章级+句级)按需刷新。(2) 覆盖假设脆弱:块级监督的质量完全取决于语料是否覆盖查询主题,域外问题上预测记忆可能是噪声而非知识;改进方向是给门控加'拒答'能力(如训练出输出近零记忆的空闲 slot),或与轻量在线检索做置信度触发的混合回退。(3) 骨干嵌入的语义瓶颈:块查询用冻结骨干的输入层 token 嵌入平均池化得到,输入嵌入偏词法、语义能力弱,可能限制预测器对长程主题的理解;改进方向是用骨干中间层隐状态或单独的检索编码器在线编码块查询。(4) 超参敏感且默认次优:$b_g=0$ 比默认 $b_g=-2$ 高 0.69 分,融合层起点、chunk 大小的最优值都可能随骨干/语料漂移;改进方向是用小规模代理任务自动搜索初始化与配置,并报告敏感性曲线。
未来方向
作者方向:代码即将开源;域适应实验(代码/数学/法律平均 +4.38~6.51 分)暗示可沿 Memory Decoder at Scale 的路线把块级监督扩展到大规模通用与领域记忆预训练。可延伸方向:其一,动态记忆——把固定的 prompt 记忆改为随生成滚动更新,服务多轮对话与 agent 场景;其二,记忆组合——为多个语料各训练一个预测器,推理时按主题路由或线性组合记忆,实现'插拔式'知识库;其三,时效更新——语料更新时只需重算目标记忆并微调预测器,探索低成本的知识刷新与遗忘控制;其四,结构压缩——Top-2 仅比 Top-16 低 0.33 分提示记忆高度冗余,可研究 slot 剪枝、低秩化或把预测器蒸馏进骨干已有层;其五,与 RAG 混合——DFM 提供零开销默认知识,检索仅在门控置信度低时触发,构成自适应混合系统。
复现评估
复现难度中等偏高。开源情况:论文注明'代码将很快发布'(v1 尚未提供),这是最大的不确定性。数据与模型全部公开:训练语料为 2018 年 12 月英文维基(约 40 亿 token),检索编码器用 Qwen3-Embedding-0.6B,评测集 NQ/WebQA/HotpotQA/2WikiMultiHopQA/MuSiQue/Bamboogle/HumanEval(+)/GSM8K/LawBench 均可公开获取。算力需求:QA 训练用 16 张 A800 80GB 跑约 24 小时(2048-token 序列、全局 batch 128、单轮 epoch,AdamW 学习率 1e-5),域适应为每个域单独训练、每次优化器更新 262,144 token;新增可训练参数 0.75B,单机 8 卡 A100 应该也可行(预计两天左右)。主要复现风险在未完全展开的工程细节:datastore 构建、检索排名顺序与目标堆叠的对齐、门控初始化、逐域训练配置(附录 A 有部分说明);建议等官方代码发布后复现,先在小语料上验证 32×/2048× 的构建效率数字。
论文图表