迈向大语言模型的参数内记忆增强 Towards In-Parameter Memory Augmentation for Large Language Models
以参数位置与获取时机两轴,系统梳理大模型参数内记忆增强方法
前置知识
上下文学习
ICL 指推理时不改参数,把示例、检索文档等以显式文本 token 拼进上下文窗口,让冻结的大模型据此完成检索增强生成等任务。它可解释、易修改,但计算和延迟随 token 数增长,长上下文会耗尽有限窗口,且对同一段知识每次请求都要重复编码。
本文全篇都在论证为何要从 ICL 范式迁移到参数内记忆范式,理解 ICL 的成本结构才能读懂论文的动机与边界划分。
LoRA 与参数高效微调(PEFT)
PEFT 冻结骨干权重、只训练少量新增参数。LoRA 在权重旁注入低秩矩阵,推理时按 $W \mapsto W + BA$ 组合。本文把可插拔 PEFT 视为通过三重准入测试的 IPM 范式,Doc2LoRA、Temp-LoRA、LatentSkill 等方法正是把 LoRA 适配器当作记忆对象。
论文分类体系中大量方法的记忆对象就是适配器,不懂 LoRA 的组合规则就无法理解增强算子 $\mathcal{C}$ 的含义。
KV 缓存
自回归解码时缓存每个 token 的键值向量以免重复计算。本文的关键边界判据是:未经修改的 KV 缓存只是预填充的副产品,不满足独立获取算子,不算参数内记忆;而由独立编码器产出的编码 KV 库(如 KBLaM、AtlasKV、SR-KI)则留在范围内。
论文用 KV 缓存这一反例来精确定义什么才算 IPM,Table 1 的边界讨论直接依赖这个概念。
FFN 即键值记忆
Geva 等与 Meng 等的归因研究表明,Transformer 的 FFN 层行为类似键值存储,特定神经元和层与事实联想相关联,知识编辑工作正是据此定位并改写事实。这解释了为什么许多 IPM 方法选择把记忆写入 FFN 侧参数。
参数放置维度中 FFN 类的存在依据就来自这批实证研究,是理解放置轴设计逻辑的前提。
测试时训练(TTT)
TTT 指在推理阶段继续用梯度更新等方式学习:把隐藏状态当作一个在测试时训练的模型,或对上下文做测试时梯度下降压缩成前缀记忆 token(如 GradMem),或训练注意力耦合的神经记忆(如 Titans、TTT Layers)。这是在线获取一类的代表性技术路线。
在线获取类的注意力侧方法几乎都由 TTT 思想驱动,是理解 online 分类与有状态获取算子的核心。
快速权重与线性注意力
线性注意力和 fast-weight 变体把联想压缩进固定大小的状态矩阵,按 delta 规则 $φ_t = \mathcal{A}(φ_{t-1}, z_t)$ 这类循环写规则逐步更新,如 δ-mem 维护紧凑在线联想状态、MesaNet 在注意力侧状态中做局部最优 TTT。它们是注意力侧在线 IPM 的主要记忆对象。
论文的有状态获取算子形式化正是从这类递归写规则抽象而来,属于方法部分的形式化基础。
研究动机
当前部署的 LLM 与智能体普遍依赖上下文学习(ICL)把预训练之后的知识——领域事实、用户偏好、文档、交互经验——以显式文本 token 的形式塞进上下文窗口,RAG 是最典型的形态。这类方法可解释、可审查、易修订,但代价随检索 token 数增长:注意力的预填充计算是上下文长度的平方级(论文引用 McDermott et al., 2026),每次请求都要对同一段知识重复做一遍离散化编码;稀疏注意力与 KV 缓存压缩只是缓解而非消除这一扩展瓶颈,长上下文最终仍会耗尽有限窗口。对于需要跨查询复用的记忆,这种每问一次、编码一次的模式既浪费算力又推高推理延迟,而当记忆需要在部署过程中不断吸收新证据时,纯文本承载方式更是无能为力。
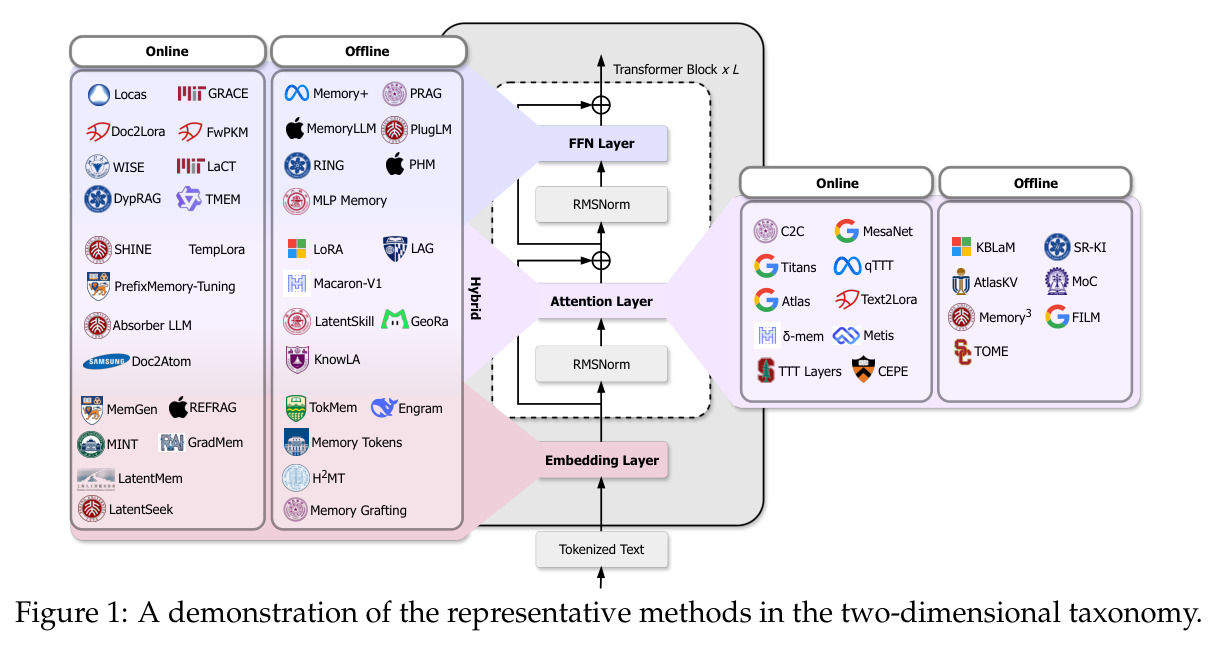
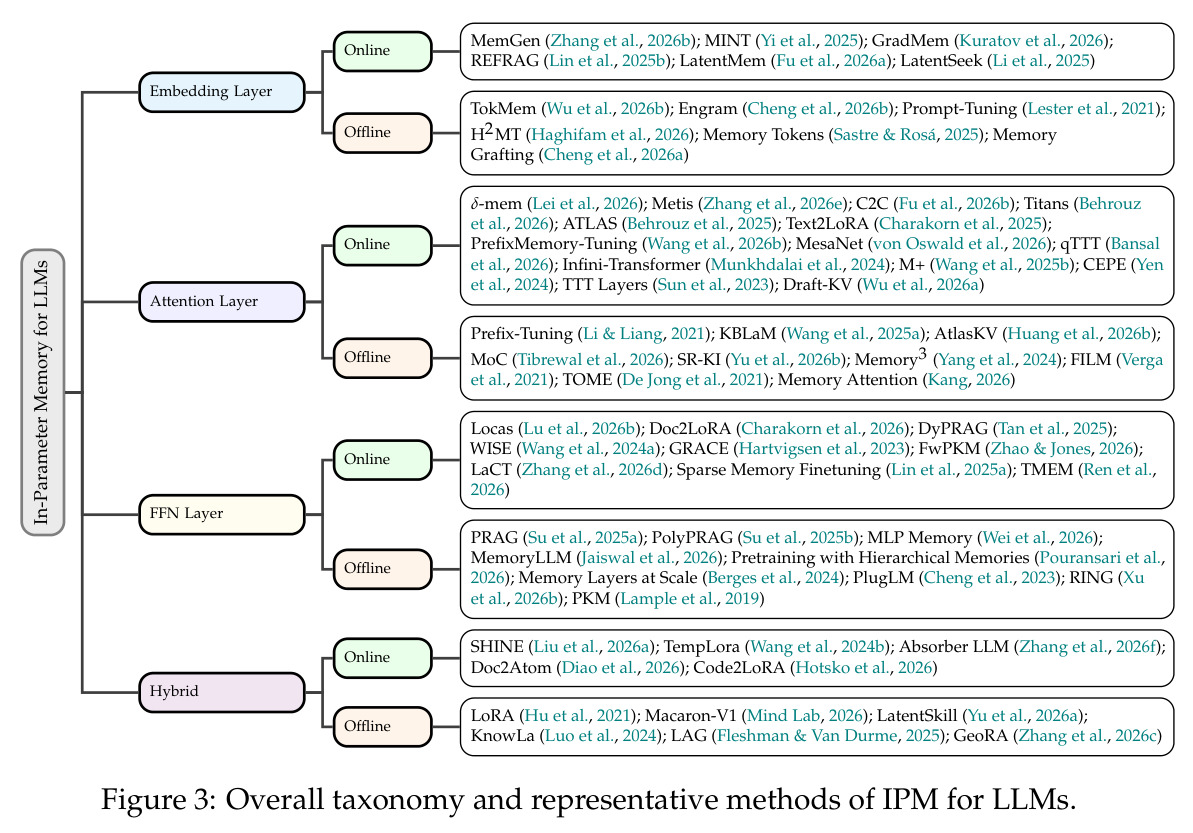
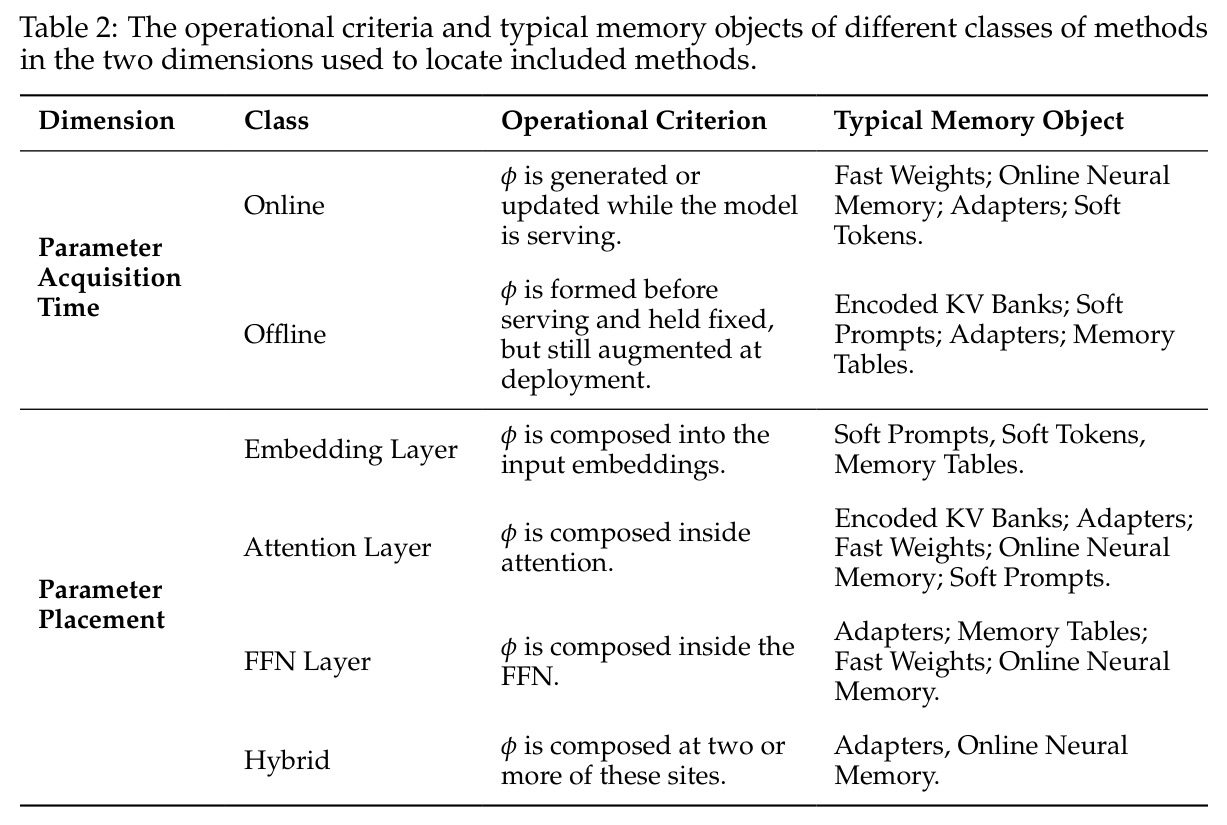
本文的目标是本文的目标是为参数内记忆这一新兴范式提供首个聚焦部署视角的系统综述,具体包含四件事:其一,沿两个正交维度建立可操作的分类体系——参数放置(记忆对象注入 Embedding、Attention、FFN 哪一层,两处以上为 Hybrid)与参数获取时机(记忆对象在部署前 offline 形成还是服务中 online 形成);其二,用一个记忆对象 $φ$、一个获取算子 $\mathcal{A}$、一个增强算子 $\mathcal{C}$ 的算子化形式给出统一定义和明确边界;其三,按任务目的、物化方式、持久性、写入与读取成本比较 8 个类别、约 60 余个代表方法的性质差异;其四,指出干扰与遗忘、安全感知获取、与 ICL 协同设计、模型原生递归自我改进这 4 个开放方向。
与已有工作不同的是,与邻近综述相比,本文的切入角度更严格也更聚焦。已有架构中心综述(Zhoubian et al., 2026)把记忆范围放得很宽,连 KV 缓存、SSM、MoE 这类隐式计算耦合记忆都纳入。本文只研究满足三个条件的部署时增强:一个参数形态的、由独立获取算子产出的记忆对象在推理时被组合进前向传播,并明确把未修改的 token 衍生 KV 缓存排除在外——它们是预填充的副产品而非独立算子的产物;而 KBLaM、AtlasKV 等编码 KV 库留在边界内,因为小编码器本身就是独立的 $\mathcal{A}$。同时,不同于把 PEFT 单独成篇的综述,本文用统一的三重测试把可插拔 PEFT 吸收为 IPM 子集,并用 $\mathcal{A}$ 与 $\mathcal{C}$ 的分离澄清了放置指的是增强位置而非获取位置这一常见混淆。
核心方法
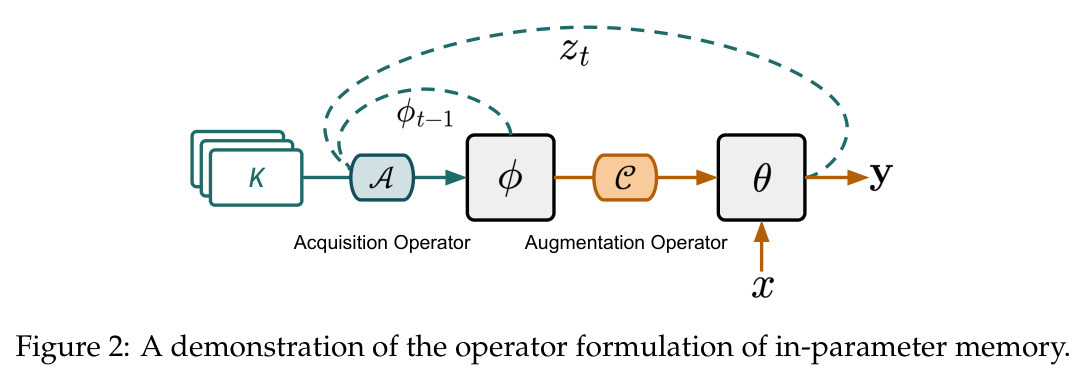
直觉上,与其每次查询都把知识当文本塞进上下文,不如把可复用的知识压缩成参数形态的记忆对象,在推理时组合进前向传播——这就是从 ICL 转向参数内记忆的动机。形式化地,设骨干参数为 $θ$,记忆对象为 $φ$,任何 IPM 方法由两个算子刻画:获取算子 $\mathcal{A}$ 产出 $φ$,增强算子 $\mathcal{C}$ 把 $φ$ 组合进前向。部署模型的生成过程为 $$φ_t = \mathcal{A}(φ_{t-1}, z_t), \qquad y_t \sim p_{\mathcal{C}}(θ, φ_t)(y_t \mid x_{\le t}),$$ 一次性获取时 $φ_0 = \mathcal{A}(\mathcal{K})$。$\mathcal{A}$ 有两种形式:一次性获取把静态外部知识 $\mathcal{K}$ 映射为 $φ$,涵盖梯度优化连续向量、单遍超网络、知识编码器;有状态获取按 $φ_t = \mathcal{A}(φ_{t-1}, z_t)$ 用部署中观察到的证据改写当前对象,涵盖 delta 规则、惊讶驱动更新等循环写规则,触发频率可按 token、按段落或按需。据此沿放置与时机两个正交轴构成 4×2 共 8 类分类体系。
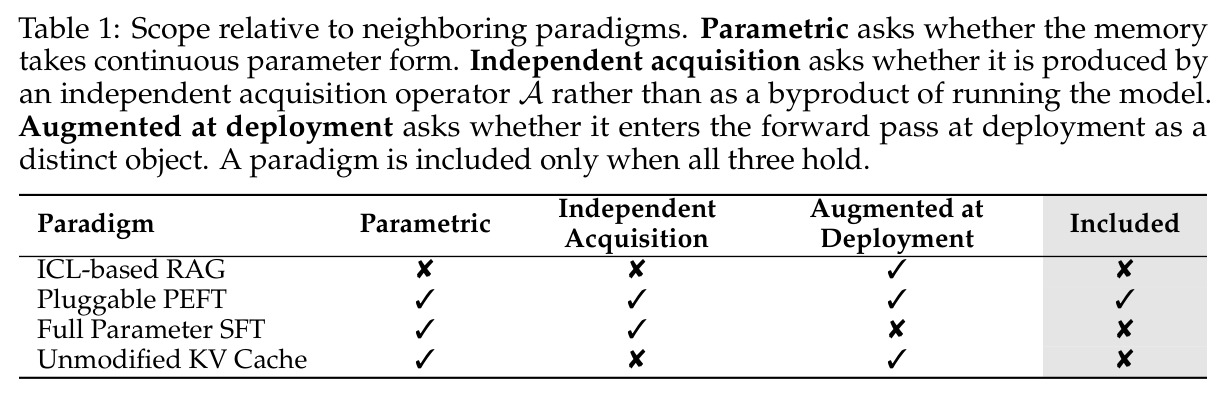
核心创新是三重准入测试与两轴分类的组合。准入判据(Table 1)要求记忆同时满足三点:参数形态(连续参数而非文本 token)、独立获取(由独立算子 $\mathcal{A}$ 产生而非运行模型的副产品)、部署时增强(作为独立对象进入前向传播),三条全过才纳入。于是可插拔 PEFT 三条全满足而入选;全参数 SFT 因更新在服务前已合并进 $θ$、不留独立对象给 $\mathcal{C}$ 而出局;未修改 KV 缓存因不满足独立获取而出局;连续学习因知识增强发生在离线训练阶段而只把近期 LLM 迁移工作作为 offline 类收入。分类时强调两个易错点:放置指 $\mathcal{C}$ 的作用位置而非 $\mathcal{A}$ 的位置(如超网络部署时现场生成 LoRA,按插入位置归类);获取时机指被部署的 $φ$ 何时形成,而非产生它的算子何时被训练——超网络离线训练,但它为具体上下文现生成的 LoRA 属于 online。
方法步骤详情
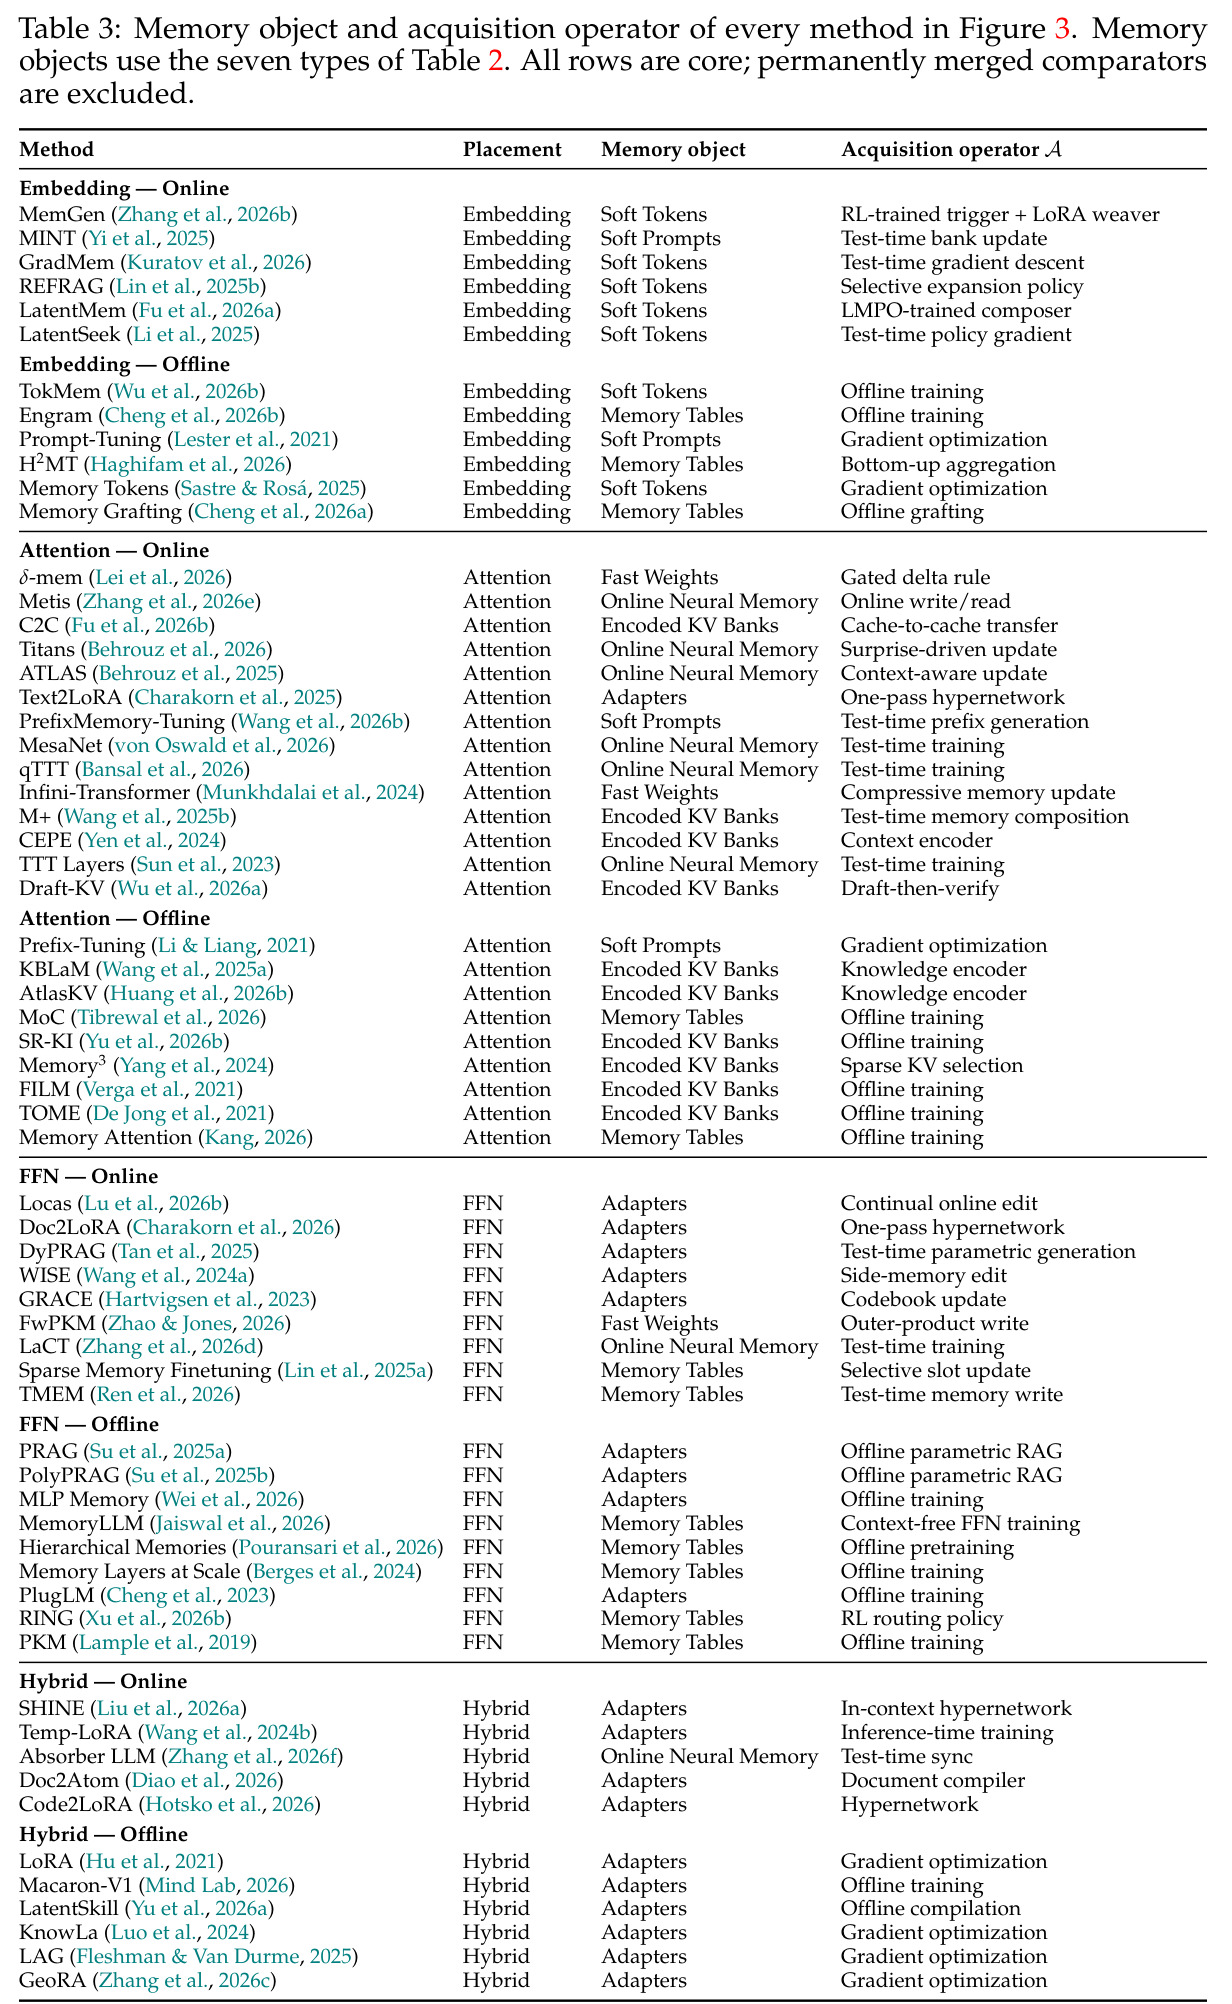
分类体系的完整展开(Figure 3,共约 60 余个方法)如下。Embedding 层 online:MemGen 用 weaver 把当前隐状态合成为前置的潜在记忆 token;GradMem 以测试时梯度把上下文压成少量前缀记忆 token;MINT 维护可检索更新的软提示库;REFRAG 注入压缩的 chunk 嵌入、按需展开;LatentMem 为多智能体蒸馏角色感知的潜在记忆 token。Embedding 层 offline:prompt-tuning 部署前优化连续软提示;TokMem 离线训练专用 token 承载程序性知识;H2MT 组织层级记忆树并自顶向下路由查询;MemoryTokens 学习可逆句子表示;Engram 做 N-gram 条件查表;Memory Grafting 用冻结 N-gram 表做最长匹配与门控注入。Attention 层 online:Titans、Atlas、TTT Layers、MesaNet、qTTT 做测试时训练的神经记忆;δ-mem 用 delta 规则维持联想状态校正注意力;Infini-Transformer 把过去段压缩成固定矩阵;CEPE 用小编码器加交叉注意力读长上下文;M+ 在测试时组合查询条件记忆库;C2C 学习缓存融合器把他模型 KV 投影进来;PrefixMemory-Tuning 把前缀移到外部查询条件模块。Attention 层 offline:prefix-tuning 逐层学连续 KV;KBLaM、AtlasKV、SR-KI 学交叉注意力投影头把冻结编码器的句子表示投进语义空间;Memory3 把知识库转成稀疏注意力 KV 记忆按检索注入;MoC 挂载章节级记忆模块。FFN 层 online:Doc2LoRA 一遍前向把文档映射为 MLP down-projection 上的 LoRA;DyPRAG 测试时从检索文档生成参数化适配器;WISE、Locas 提供侧记忆或局部支持的持续更新;GRACE 用码本键值适配器按激活邻近性套用;FwPKM 引入快速权重乘积键记忆;LaCT 在 FFN 侧做 TTT。FFN 层 offline:PRAG、PolyPRAG 从文档合成 QA 离线训练 FFN 侧 LoRA;MLP Memory 预训练 MLP 模仿 kNN 检索器;RING 向记忆专家混合体注入语料并用强化学习学路由策略;MemoryLLM 只在无上下文 token 嵌入上训练 FFN 使整层塌缩为可预计算的查找表;稀疏记忆微调用掩码梯度把新事实写进记忆层最活跃槽位。Hybrid online:Temp-LoRA 推理中训练多点位临时 LoRA;SHINE 用 in-context 超网络一遍前向产出逐层适配器;AbsorberLLM 跨点位同步因果状态做测试时训练;Doc2Atom 编译出跨模块的可组合语义类型记忆原子。Hybrid offline:标准 LoRA 同时适配注意力与 FFN;Macaron-V1 每轮路由到专家 LoRA;KnowLA 经小适配器注入知识图谱实体嵌入;LatentSkill 把文本技能离线编译为 LoRA。
技术新颖性
本文的技术新颖性主要体现在四点。第一,算子化的形式语言:把所有方法统一表述为获取算子 $\mathcal{A}$ 与增强算子 $\mathcal{C}$ 的组合,并明确放置是 $\mathcal{C}$ 的位置而非 $\mathcal{A}$ 的位置,这解决了很多方法描述中的位置歧义(超网络类方法最容易混淆)。第二,以部署生命周期定义获取时机:online/offline 的划分标准是被部署对象的形成时刻而非算子训练时刻,配合一次性获取 $\u03c6 = \mathcal{A}(\mathcal{K})$ 与有状态获取 $\u03c6_t = \mathcal{A}(φ_{t-1}, z_t)$ 两种形式,使分类可机械执行。第三,边界判据显式化:用参数形态、独立获取、部署时增强三条测试对 ICL-based RAG、可插拔 PEFT、全参数 SFT、未修改 KV 缓存四个邻近范式逐一裁决,特别是论证了未修改 KV 缓存与编码 KV 库的本质区别在于是否存在独立的编码算子。第四,把与 ICL、连续学习的分界也纳入讨论:连续学习与 IPM 的分界线被定义为 $φ$ 是否仍在部署时被增强。
实验结果
作为综述,本文的核心产出是性质比较而非实验指标。沿获取时机轴,论文得出:online 方法几乎都是每请求或每 token 触发、作用域短暂或会话级——生成的适配器与软提示支付中等成本的一次性写入换取新对象,循环式快速权重与在线神经记忆支付低成本的每 token 写入以维持长上下文可变状态;offline 方法几乎都是部署前完成、持久有效——支付一次性高成本写入把知识冻结进软提示、KV 库或记忆表,此后读取成本很低。沿放置轴的权衡为:embedding 侧组合最便宜(走输入流、骨干冻结),但影响间接,被其上所有层中介;attention 侧内容可寻址,query-key 读取既支持大库联想查找也支持循环更新状态,代价是与头结构和注意力预算耦合;FFN 侧直接写进事实联想所在层、可覆写特定行为,但读取是逐位置的(每个 token 独立查询记忆,条目间没有基于内容的选择),对共享权重的顺序写入会互相干扰;Hybrid 最具表达力,但行为无法归因到单一组件,更新需跨异质对象协调。同类记忆对象因时机不同而表现迥异:适配器在线生成便宜、离线训练昂贵;编码 KV 库在 CEPE 和 M+ 是每请求组合、在 KBLaM 和 AtlasKV 是预计算。Table 3 与 Table 4 用任务目的、物化方式、持久性、写读成本的定性带宽对每个代表方法列表比较,因为源论文极少报告可比的 FLOPs 或墙钟时间。论文同时强调:需要精确引用、溯源、定向删除或人工修订的任务,ICL 与 ICL-based RAG 仍然更可取。
局限与改进
作者在 Section 8 明确承认三点局限:其一,只考虑文本模态下的 IPM,而视觉、音频、视频领域同样有大量 IPM 工作未覆盖;其二,未包含内建到新 LLM 架构的 IPM 设计,如 Mixture of Latent Experts(MLE)、Multi-head Latent Attention(MLA)、Manifold-Constrained Hyper-Connections(mHC);其三,比较不做数值测量,写成本、读成本与保持性都是从机制推断的定性带宽,因为源论文几乎不共享基准或可比测量。我自己的观察是:三重测试中的独立获取判据存在连续过渡地带(如检索后缓存与编码器生成 KV 之间),边界裁决带主观性;分类体系本身没有经过任何实证验证(例如按此分类预测方法成败的能力);覆盖范围受限于写作时点,而该领域方法迭代极快,Figure 1 与 Figure 3 中的方法清单很快需要更新。
独立分析的弱点
第一,干扰与遗忘只停留在方向层面:论文承认顺序编辑和 delta 规则写入会覆写早期联想、被编辑权重的范数会随更新序列增长并破坏通用能力方向,但既没有给出量化干扰的统一协议,也没有比较各类门控的实证数据,建议后续建立 IPM 专用的干扰/遗忘基准。第二,安全分析偏概念:一次来自不可信上下文的写入会被当作可信知识检索、行为卸载会留痕迹这两点没有配套的攻击实验或防御评估,建议补充参数记忆投毒与溯源审计的实证研究。第三,定性带宽无法指导工程选型:Table 3、Table 4 的低成本/中成本/高成本分档缺少 FLOPs 与墙钟数字支撑,读者无法据此判断在具体硬件上该选 CEPE 式每请求组合还是 AtlasKV 式预计算,建议推动社区形成统一评测协议。第四,与 ICL 协同设计的方向最缺乏可操作细节:$φ$ 与上下文如何分工、$\mathcal{A}$ 的划分决策如何训练都未给出算法草图。第五,部分方法(Figure 3 中约 60 余个)只获得一句话描述,读者难以据此判断方法间细微差异,需要回到原文。
未来方向
作者明确提出 4 个开放方向。干扰与遗忘:子空间投影、范数约束、擦写门控只能减缓塌缩,它们仍保留不断增长的过去键记录或只门控当前键,长流上的冲突检测与固定容量分配仍未解决。安全感知获取:需要更新预算、溯源条件写门与隐私感知合并,使参数化写入可审计、可撤销。与 ICL 协同设计:让 $\mathcal{A}$ 决定什么信息留在上下文、什么压缩进 $φ$,$\mathcal{C}$ 在一次前向中同时读取两者,兼顾效率与细粒度访问。模型原生递归自我改进(RSI):现有递归自我改进都活在智能体外壳里(提示、技能、知识库、工具在模型外修订),模型原生版本应让 $\mathcal{A}$ 把有用的部署经验写进 $φ$ 本身,从而缩小离线训练与在线推理的差距。我补充三条延伸:把综述扩展到视觉、音频、视频多模态 IPM;研究 MLA、MLE、mHC 等新架构原生的记忆位点如何纳入放置分类;以及为定性带宽建立数值化的写读成本与保持性测量基准,使分类体系可被实验检验。
复现评估
这是一篇综述,复现的对象是方法集合与分类体系而非实验结果。论文在首页给出 GitHub Repository 链接,Figure 3 列出了经过审核的完整方法集合(4 个放置类别 × online/offline 共约 60 余个方法),Table 3、Table 4 对每个代表方法给出放置位置、记忆对象、获取算子与性质带宽,具备良好的索引价值。复现分类本身成本极低:无需算力与数据,主要工作是按三重测试核对方法边界。但若要复现其中具体方法则参差不齐:prompt-tuning、LoRA、PRAG、Memory3 等主流工作开源成熟,而 SHINE、Doc2Atom、AbsorberLLM 等 2026 年新工作的代码与算力情况需逐篇确认。总体难度低,适合作为进入该领域的路线图使用;验证综述结论(如 FFN 侧顺序写入互相干扰)则需要自行设计实验。
论文图表
按任务目的、物化方式、持久性、记忆写入与读取成本等性质对每个代表方法给出定性带宽比较。由此归纳出论文的模式:online 行几乎都是每请求或每 token、短暂或会话级作用域;offline 行几乎都是部署前一次性高成本写入、之后低成本读取;同一对象类型因时机不同而行为迥异,如适配器在线生成便宜、离线训练昂贵,编码 KV 库在 CEPE/M+ 为每请求组合、在 KBLaM/AtlasKV 为预计算。
这是综述的核心结论载体:所有关于权衡的定性结论都出自此表,是工程选型和后续研究的直接依据。