HybridResearcher:打通结构化与非结构化数据边界的深度研究智能体 HybridResearcher: Bridging the Structured-Unstructured Boundary for Deep Research Agents
用单源种子合成跨源桥接数据,把混合推理能力教给4B小模型,超越397B旗舰
前置知识
深度研究智能体 (Deep Research Agent)
LLM 智能体通过工具调用(搜索 API、网页访问、SQL 执行)与环境进行多轮交互,在长程任务中自主搜集、交叉验证并综合证据以回答问题。典型循环是『推理→调用工具→观察结果→再推理』,直到提交最终答案或耗尽轮次预算。这类智能体的能力来自后训练:SFT 模仿教师轨迹,RL 用答案对错作奖励优化策略。
本文训练的对象正是这种智能体,其数据构建、轨迹生成、RL 与评估全部建立在工具调用循环之上,不理解智能体范式就无法理解论文的实验设计。
Text-to-SQL 与执行准确率
将自然语言问题转换为可在关系数据库上执行的 SQL 查询的任务。现代做法不是一次性翻译,而是智能体先探索 schema、执行查询、再根据执行结果改写查询。评测标准是执行准确率:提交的查询在数据库上执行后,其结果表与金标准查询的结果在语义上等价即算正确。
本文一半的训练种子来自 text-to-SQL 任务,SQL 腿是跨源任务的结构化一侧;Spider 2.0-lite 是检验 SQL 能力是否被混合训练破坏的留出基准。
SFT 与 RL 两阶段后训练
SFT(监督微调)在教师模型生成的成功轨迹上做下一词预测,直接模仿专家行为;RL 采用 GRPO 类目标(本文叠加 CISPO):对同一提示采样一组 rollout,用组内标准差归一化的优势加权更新策略,奖励是二值的答案对错。SFT 教基本机制,RL 精化行为并提升一致性。
本文是标准的『先 SFT 后 RL』配方,主表按 base/SFT/RL 三行报告,行为分析章节的全部结论都依赖理解两个阶段各自的分工。
捷径学习与参数化记忆
模型绕过工具调用,直接用预训练时记住的事实回答问题;即使检索到的证据与参数记忆冲突,模型也倾向相信记忆(Xie et al., 2024)。本文实测发现:在通过标准正确性过滤的教师混合轨迹中,79.5% 从未执行实质性 SQL——模型在『假装跨源』。在错误轨迹上训练只会放大这种伪能力。
捷径是本文数据构建要解决的头号敌人,所有确定性验证门(membership gate、mask test、伪词实体)都是为了在构造层面堵死捷径,这是全文方法论的核心动机。
桥接实体与跨源相互依赖
连接结构化与非结构化两个源的证据锚点:一个源的计算结果(如 SQL 输出表中的某个单元格)作为在另一个源中检索的输入,或反过来。『真互依赖』意味着任一源单独都不足以答题,两个子任务的简单拼盘不算。本文按桥的方向把任务分为 SQL2S(SQL 结果去找网页)与 S2SQL(网页答案进 SQL)。
全部数据构造围绕『强制桥接』展开,SQL2S/S2SQL 这两个方向贯穿数据合成、RL 数据配比(1:1)与评测(硬子集按三类任务均分),是读懂方法与结果的关键词汇。
pass@k 与 avg@k
对每道题独立采样 k 次:pass@k 是至少一次答对的题目比例,衡量能力上限;avg@k 是平均单次正确率,衡量稳定性与置信度。两者差距大说明模型『会做但不可靠』。本文所有主表同时报告 pass@8 与 avg@8,评测时用 LLM judge 五票多数判定答案对错。
本文的核心结论之一是『RL 主要提升 avg@8 而 pass@8 提升有限』,失败分析中 82% 错误提交自我承认猜测——这些发现只有理解两个指标的差异才能正确解读。
难负例 (Hard Negatives)
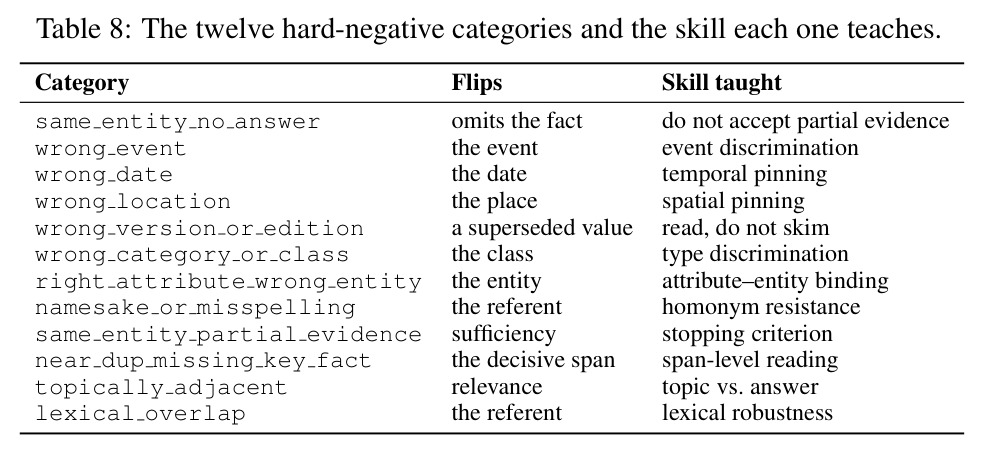
与金文档高度相似、但恰好翻转一个关键约束的干扰文档,用来训练模型逐条核对约束而非做浅层词汇匹配。本文为每条合成事实配最多 10 个难负例,共 12 个类型(错日期、错地点、同音错拼、部分证据、主题相邻等),每个类型对应一种要训练的判别技能。
难负例是防捷径与防『早锁定』(过早承诺第一个看似合理的候选)的核心组件,理解它才能理解合成语料为什么能逼出严谨的多文档交叉验证行为。
研究动机
现有 LLM 智能体在单一同质数据源上已很强:数据库侧,text-to-SQL 智能体能探索 schema 并按执行结果改写查询;网页侧,搜索智能体能完成 BrowseComp 这类长程难题。但真实问题几乎不尊重这个边界——企业审计要交叉内部交易数据库与公开 SEC 文件,供应链风险评估要合并库存 SQL 与全球新闻。HybridDeepResearch 基准量化了这一鸿沟:连 GPT-5、Claude-Sonnet-4.6 在证据必须跨源时也表现挣扎,而训练侧完全空白。作者用受控实验证明单源数据无法组成混合能力:在 120 题硬子集上,Qwen3.5-4B 基座 pass@8 为 30.83%,仅用 SQL 轨迹、搜索轨迹或两者并集微调后分别只有 31.67%、15.83% 和 29.17%,无一改善甚至倒退——单源轨迹从不把一个工具的输出用作另一个工具的输入。更糟的是朴素混合合成有致命捷径:在通过标准过滤的教师轨迹中,79.5% 从未执行实质性 SQL,模型直接凭参数化记忆答题;在错误轨迹上训练只会让模型学会『假装跨源』,堆更多未精选数据只会加剧。
本文的目标是本文目标是填补『训练鸿沟』:给出第一个把跨源深度研究能力直接教给小模型的完整训练配方,覆盖数据构建、SFT 与 RL 全流程,训练出 HYBRIDRESEARCHER-4B。目标拆成四个可检验要求。第一,数据必须保证真正的跨源相互依赖——任一源单独都不足以答题,而非两个子任务的拼盘;所有实例须通过确定性构造门验证,确认桥接实体是两源间唯一必经之路。第二,从机制上杜绝捷径:桥接实体不能出现在问题文本中(逼模型执行 SQL),跨源事实用全球唯一注册的伪词实体(堵死参数化记忆)。第三,性能目标:在 HybridDeepResearch 硬子集 pass@8 上相对基座(30.83%)提升约 30 点,并超越 397B 旗舰 Qwen3.5-397B-A17B(52.50%)。第四,不以牺牲单源能力为代价——在留出的 Spider 2.0-lite 与 BrowseComp/BrowseComp-Plus 上不得灾难性遗忘,最好协同提升。全程在可复现的离线环境(21M 文档冻结语料+本地检索器+SQLite)中进行,使轨迹生成、RL 与评估环境一致且不受网页漂移影响。
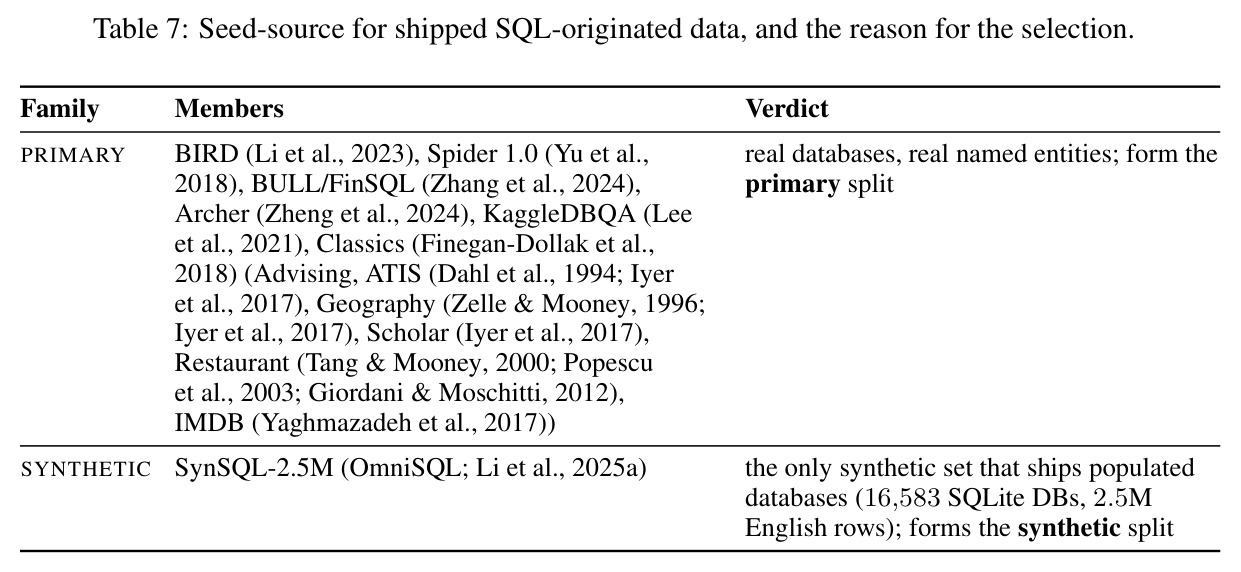
与已有工作不同的是,本文的独特切入角度是:混合训练数据不必从零编造,而应从『难度已被验证』的单源种子向外延伸。每个实例都始于一个现成的 text-to-SQL 任务或硬搜索问题,围绕种子自身输出中的桥接实体合成缺失的另一源,使种子的难度被继承而非重新建立——SQL 难度来自原 gold 查询,搜索难度来自原种子问题。这与现有工作的定位截然不同:HybridQA、FinQA 等经典混合问答只在给定或一步检索的表格+文本上推理,模型既不执行查询也不决定下一步查哪个源;DSL-R1 把结构化过滤与向量搜索合并成一种查询语言,证据始终不出一个封闭集合,智能体从不需要把一个源的结果带进另一个源;Wu et al. (2026a) 合成的只是『SQL+单篇维基查找』的简单两跳问题并用提示引导的 RL 训练。而本文面向『难 SQL 执行+长程网络搜索』的多跳组合,并明确指出先前工作只造基准、不造训练配方。方法论上,本文把『防捷径』从概率性过滤升级为确定性构造门:membership gate、执行检查、mask test 等性质可以在数据进门之前被机械地验证,从数学上证明『两源缺一不可』,这与依赖 LLM 判断质量的常见做法有本质区别。
核心方法
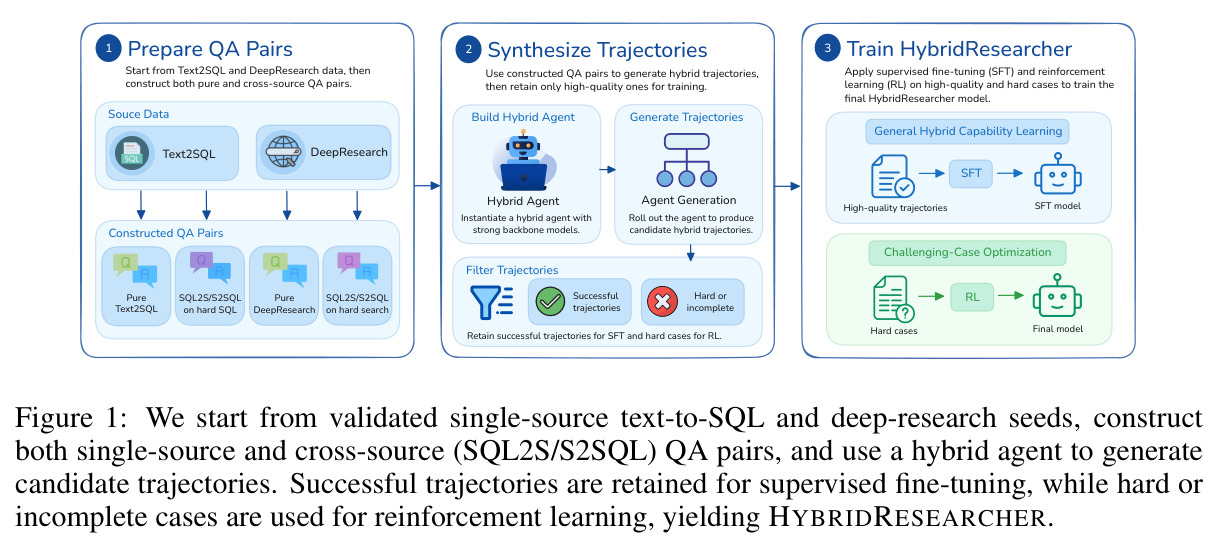
整体直觉:跨源推理 = 两个单源技能 + 一座显式『桥』,桥必须用数据直接教,堆单源数据教不出来(单源微调实验全部失败)。路线三阶段。第一阶段数据合成:SQL-originated 以 text-to-SQL 任务为种子,产出 SQL2S(SQL 输出单元是桥,答案上网找)与 S2SQL(WHERE 字面量是锚,须先上网解码才能写对 SQL);search-originated 反向,以硬搜索问题为种子,围绕种子实体合成带真实结构化难度的 SQLite 数据库;所有实例须过确定性验证门,保证桥是两源间唯一必经之路。第二阶段轨迹生成:用 Qwen3.5-397B-A17B-FP8 或 DeepSeek-V4-Flash 作教师,在自建 harness 中于 21M 文档本地语料+SQLite 环境 roll out;成功轨迹留作 SFT,仍未解决的 21K 难例经三阶段过滤成 0.7K RL 数据。第三阶段训练:先 SFT,再用 CISPO(GRPO 目标)做 RL,配合 hard-gating(退化行为零奖励)与五票多数 judge(抑制奖励噪声),得到 HYBRIDRESEARCHER-4B。
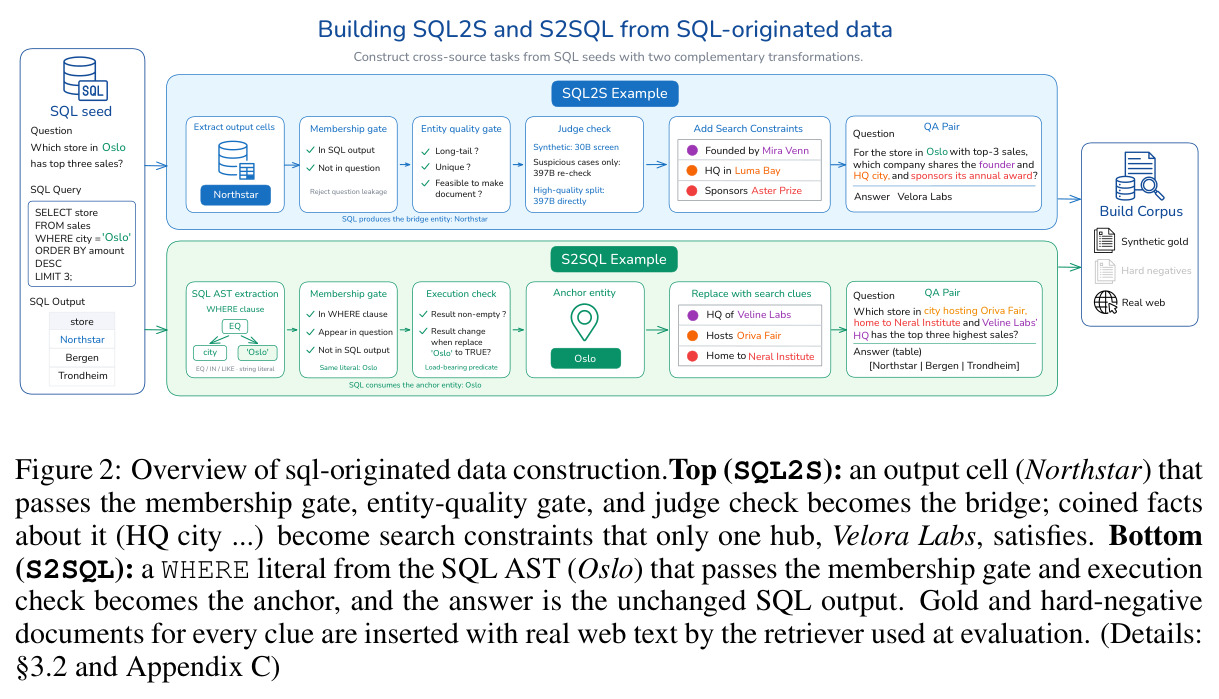
核心创新可概括为『种子继承 + 确定性反捷径门』,与已有方法的本质区别:别人造更难的混合问题,本文造结构上『必须跨源』的问题。第一,桥接实体从种子自己的执行输出里选(如 SQL 输出表的 Northstar 单元格),membership gate 确定性保证它出现在输出但不在问题文本中,从构造层面强制『必须执行 SQL 才能发现它』。第二,针对参数化记忆绕过工具边界的风险,跨源事实一律用可发音伪词实体凭空发明(全局唯一注册表防撞名),模型记忆里根本不存在这些事实;对真实著名实体(如 Google Photos)则做反捷径加工,给参数先验设计『显著性反转』诱饵——把最权威文档给与先验冲突的错误答案。第三,交集枢纽设计:金枢纽满足全部 $c$ 条件,每个近似干扰枢纽恰好满足 $c-1$ 条,且每个条件都是某个干扰所缺的那条,迫使逐条交叉验证而非早锁定。第四,S2SQL 的执行检查把谓词换成永真式后要求行集改变,数学上验证锚是『承重的』。作者还证明单源并集训练能恢复并行任务但严重损伤方向性任务,说明『桥』是可分离、可显式教授的能力——这是对混合能力为何无法自发涌现的机理解释。
方法步骤详情
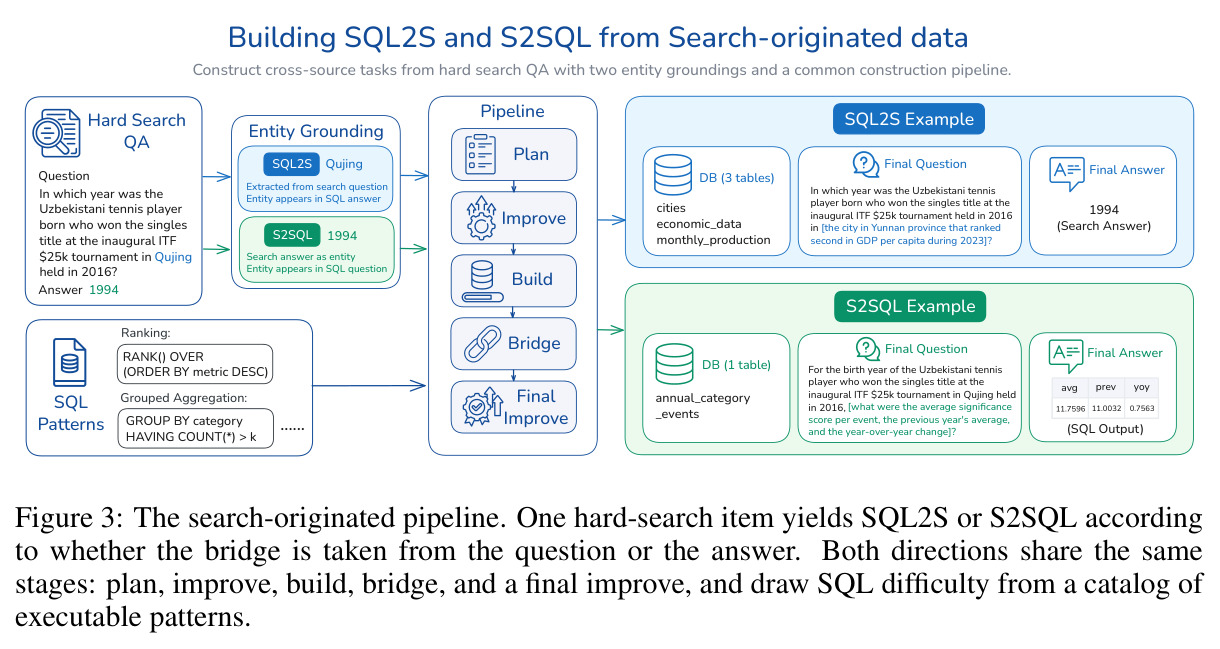
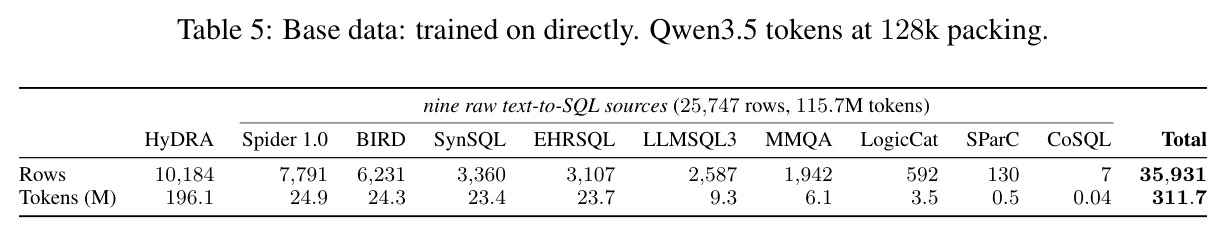
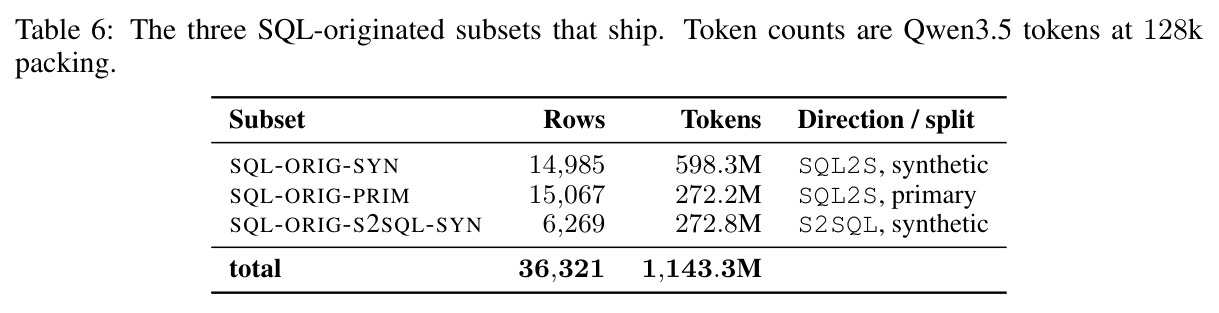
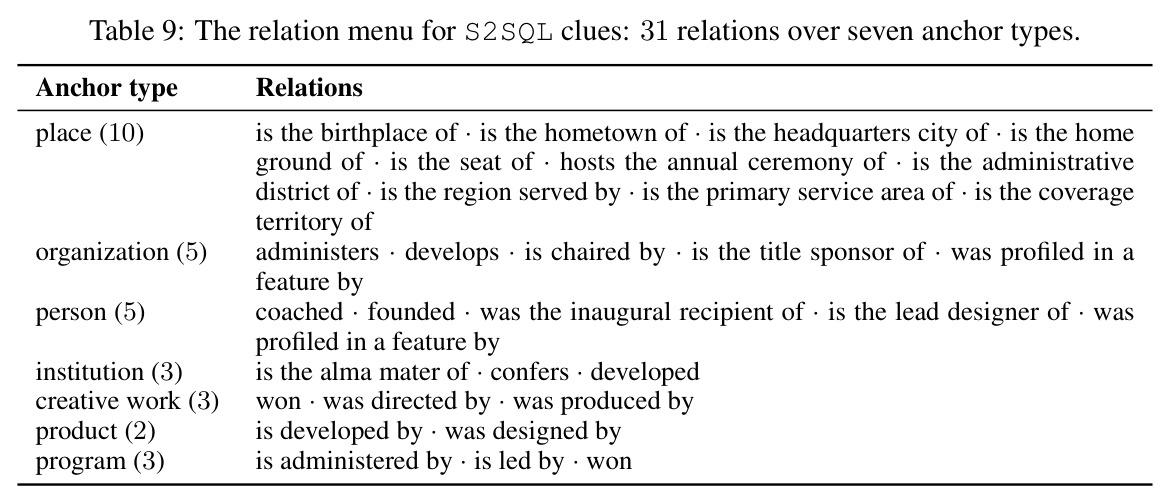
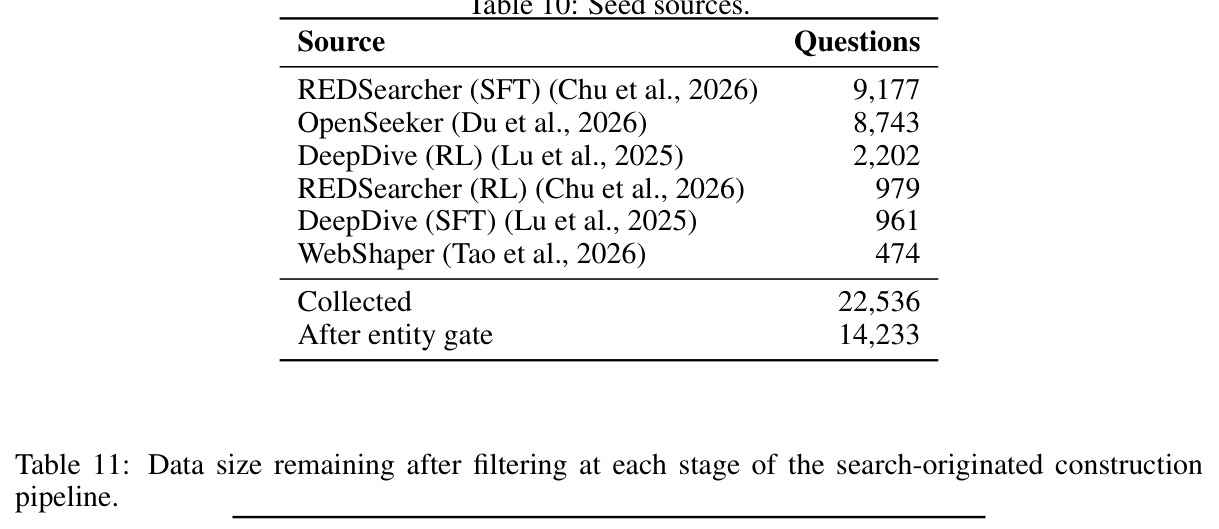
构建与训练两条线。SQL-originated 四步:(i) 桥选择——执行 gold SQL,从输出表选一个不在问题里的单元做桥,membership gate 保证必须执行 SQL 才能发现它;(ii) 第一跳——围绕桥用伪词发明 $c$ 条事实,每条配金文档和最多 10 个难负例;(iii) 第二跳——金枢纽满足全部 $c$ 条件,近似干扰恰好缺一条;(iv) 6 个确定性门加 5 个模型门验证。S2SQL 从语法树选 WHERE 字面量为锚,执行检查要求谓词换永真式后行集改变,经 31 种关系展开线索并隐藏锚。search-originated 从 6 个公开问题集收集 22,536 种子,过滤后留 14,233,经 Plan→Improve→Build→Bridge→Final Improve;SQL2S 桥取问题实体,S2SQL 桥取搜索答案。训练侧:SFT 混合 35,931 行直接数据与教师轨迹;RL 从 21K 未解任务过滤到 0.7K,CISPO 训练。
技术新颖性
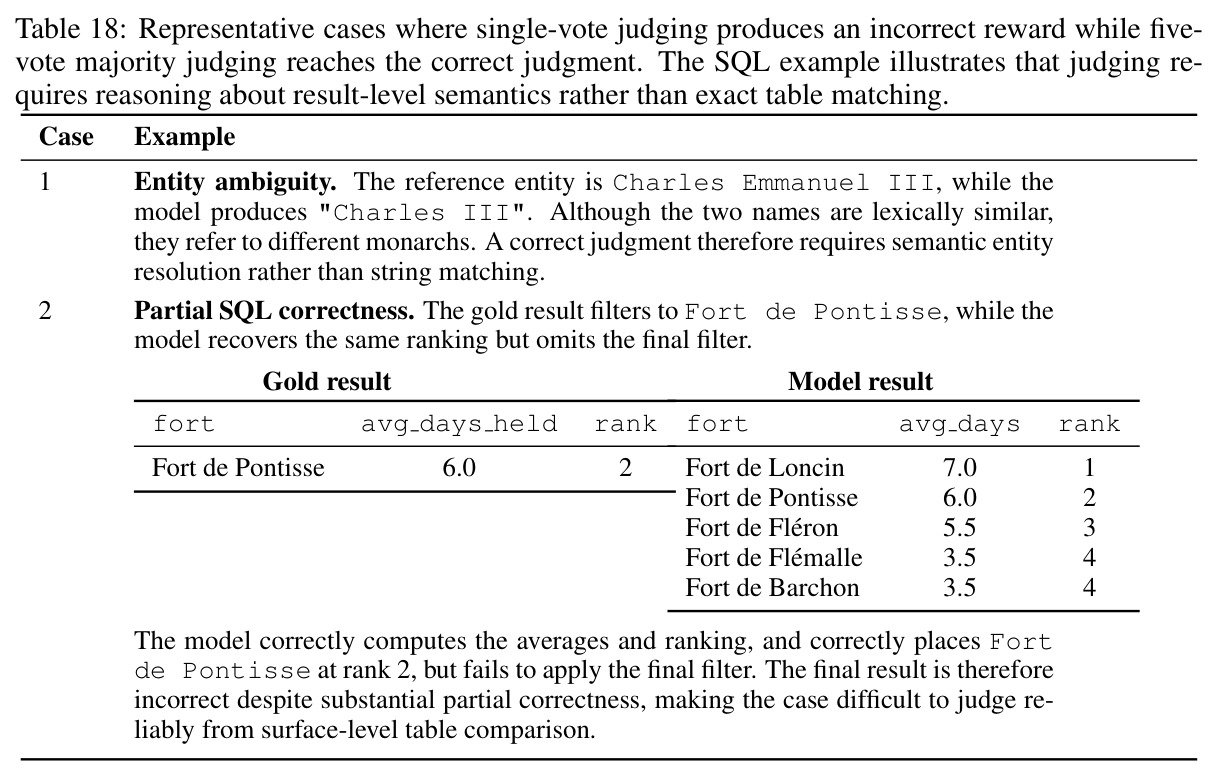
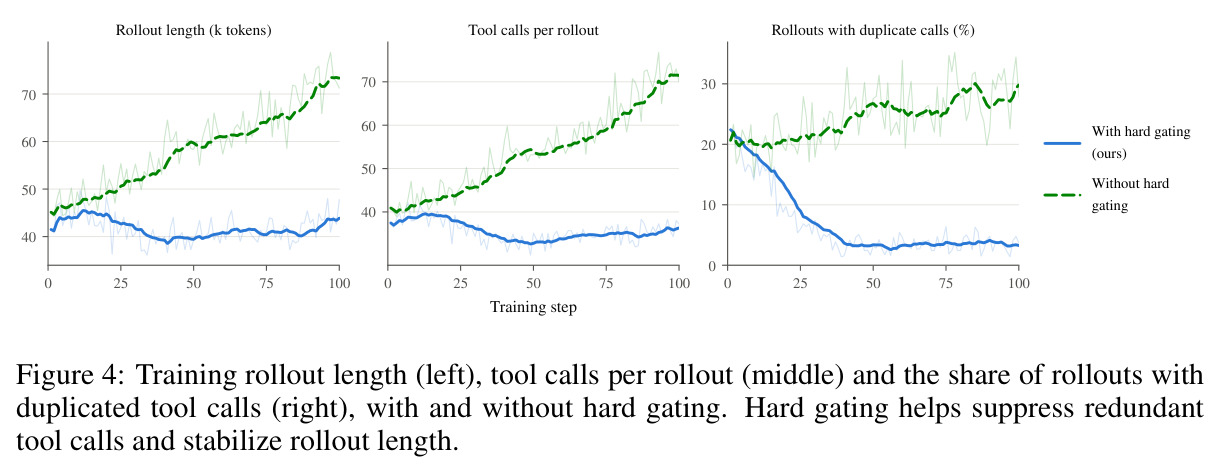
新颖性五层面。第一,定位:第一个针对结构化-非结构化边界的完整训练框架(数据+算法+模型),此前只有评测基准。第二,数据工程:『种子继承』用已验证难度的单源任务做地基,难度可控;SQL 难度由 gold 查询结构签名(表数、CTE 深度、窗口函数类、聚合类)保证覆盖 2,518 个组。第三,反捷径是确定性而非概率性的:membership gate、执行检查、mask test 都可机械验证,直接回应 79.5% 教师轨迹走捷径的实证发现,与依赖 LLM 打分的做法本质不同。第四,RL 工程可量化:hard-gating 在 rollout 层消灭退化行为,阻止轨迹长度与重复调用的正反馈失控(重复调用 49%→11%);五票 judge 平滑单 judge 8.2% 的共识分歧(S2SQL 12.2%、SQL2S 1.2%),avg@8 25.2%→27.2%;0.7K 精选胜 21K 未滤(27.2% vs 21.0%),证明数据质量压倒规模。第五,『教桥不遗忘』:混合训练反提升单源成绩,桥接与组件技能协同而非竞争。局限:仅在 SQL-Web 一种组合上验证,其他异构组合只是蓝图。
实验结果
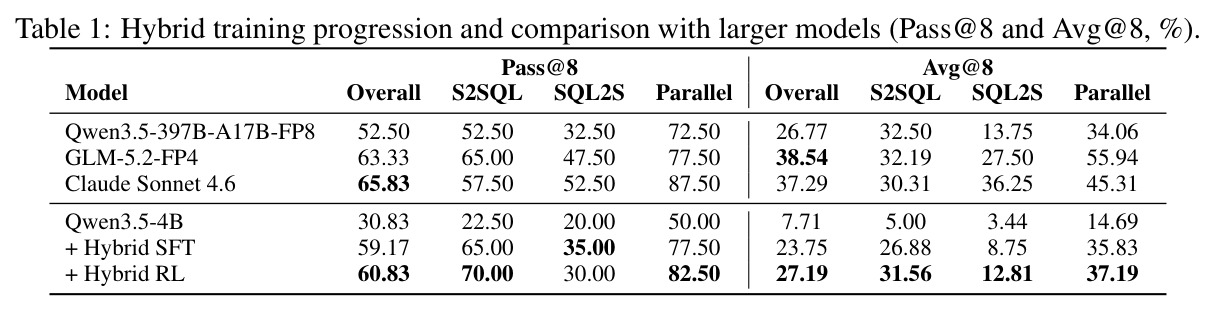
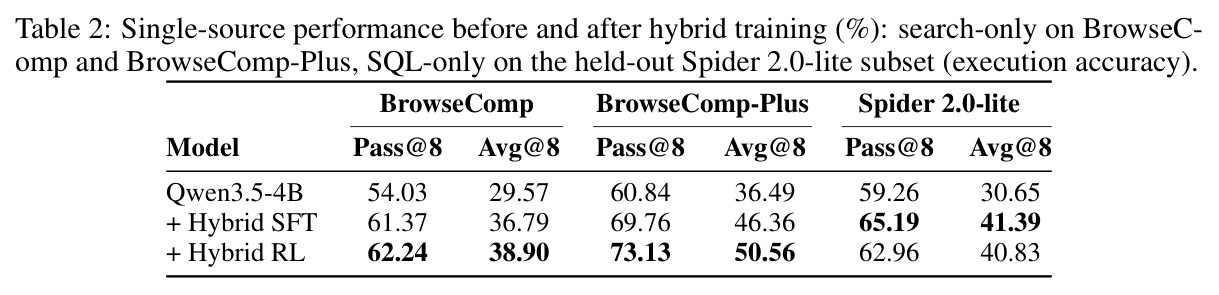
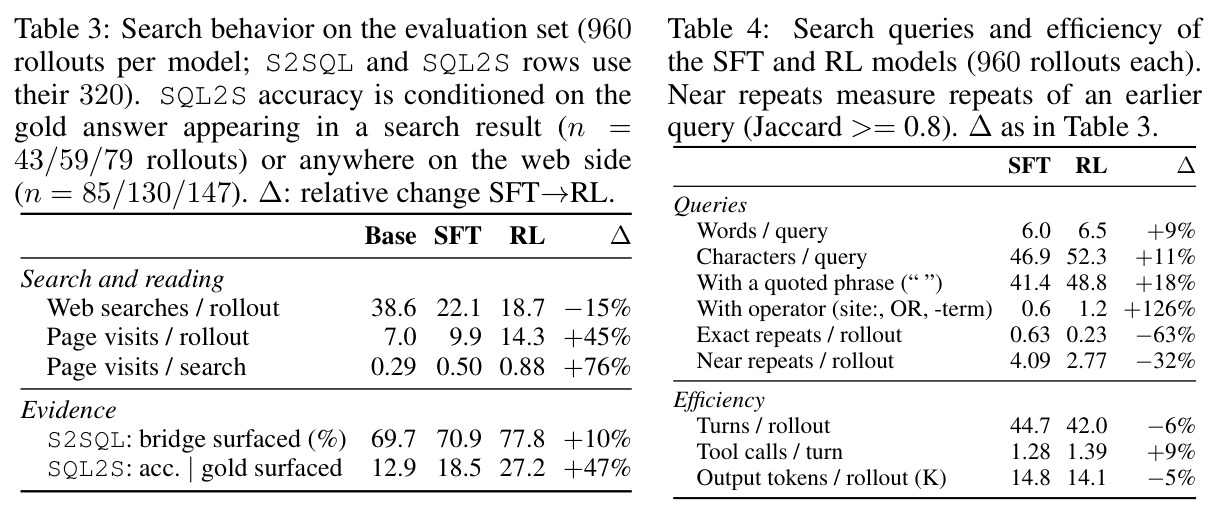
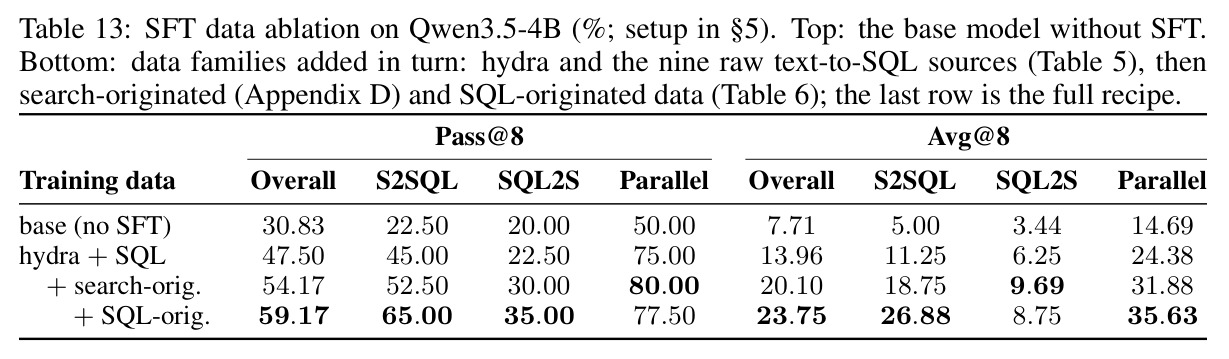
主结果(Table 1):HybridDeepResearch 120 题硬子集上,基座 Qwen3.5-4B pass@8 仅 30.83%,SFT 升至 59.17%,RL 至 60.83%,合计 +30.0 点;超越 397B 旗舰 8.3 点,逼近 Claude Sonnet 4.6。RL 主要提升 avg@8(23.75→27.19),即稳定性与置信度。单源保留(Table 2):BrowseComp pass@8 54.03→62.24,BrowseComp-Plus 60.84→73.13,Spider 2.0-lite 59.26→65.19,不遗忘反而协同增益。SFT 消融(Table 13):数据逐族加入,pass@8 从 47.50→59.17。行为分析:基座每 rollout 38.6 次搜索却只看 0.29 页,SFT 转为先读再搜,RL 后重复查询 -63%。数据质量:0.7K 精选 avg@8 27.2% 胜 21K 未滤 21.0%;五票 judge 使 avg@8 25.2→27.2;移除 hard-gating 后降至 25.6。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HybridDeepResearch 硬子集(120题,S2SQL/SQL2S/Parallel 各40) | Pass@8 | 60.83(SFT 59.17) | Qwen3.5-4B 基座 30.83 | +30.0 点 |
| HybridDeepResearch 硬子集 | Pass@8 | 60.83 | Qwen3.5-397B-A17B-FP8 52.50 | +8.3 点(以 4B 胜 397B) |
| HybridDeepResearch 硬子集 | Avg@8 | 27.19(基座 7.71,SFT 23.75) | Qwen3.5-4B 基座 7.71 | +19.48 点 |
| BrowseComp(实时web搜索,1266题) | Pass@8 | 62.24(RL)/61.37(SFT) | Qwen3.5-4B 基座 54.03 | +8.21 点 |
| BrowseComp-Plus(固定10万文档语料,830题) | Pass@8 | 73.13(RL)/69.76(SFT) | Qwen3.5-4B 基座 60.84 | +12.29 点 |
| Spider 2.0-lite(SQL-only,135个本地SQLite实例) | Pass@8(执行准确率) | 65.19(SFT)/62.96(RL) | Qwen3.5-4B 基座 59.26 | +5.93 点(SFT) |
| HybridDeepResearch 硬子集(对标前沿) | Pass@8 | 60.83 | Claude Sonnet 4.6 65.83 / GLM-5.2-FP4 63.33 | 4B 模型差距缩至 5.0 与 2.5 点 |
局限与改进
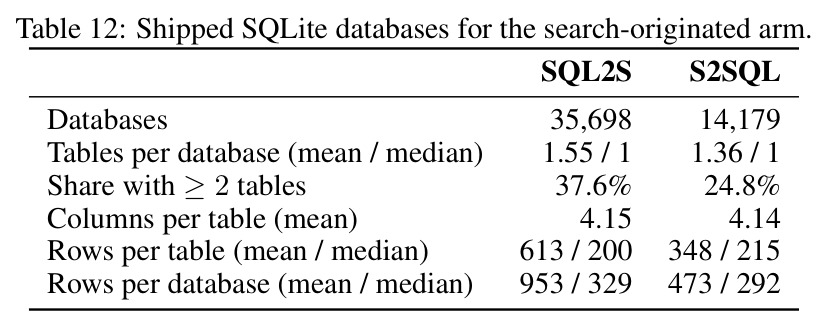
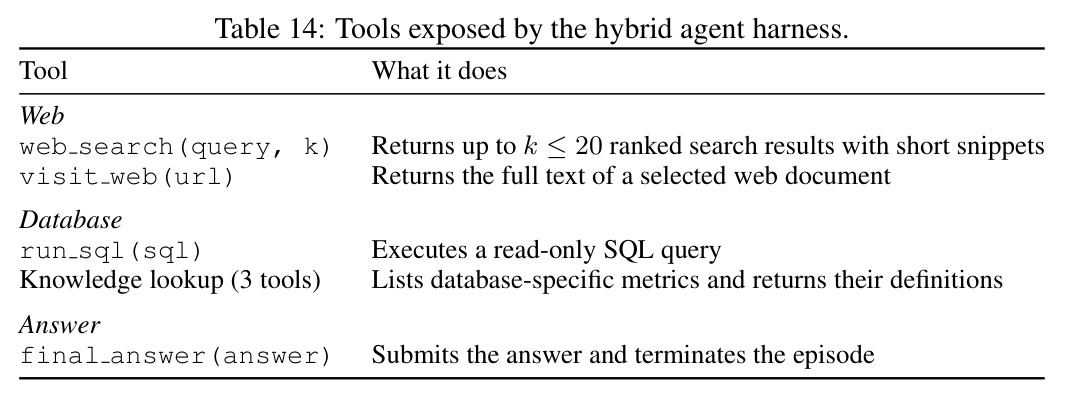
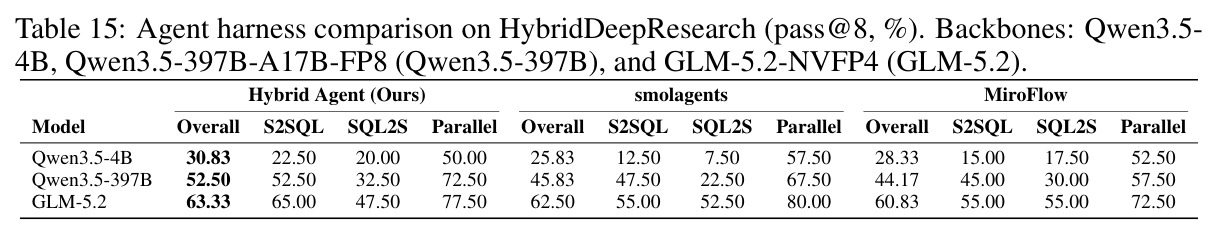
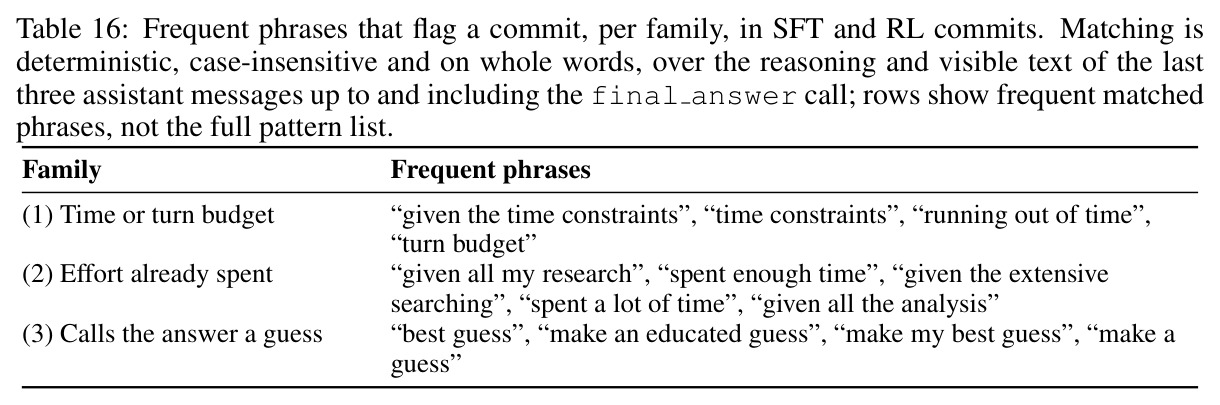
作者承认:一,检索瓶颈——S2SQL 22.2% 的 rollout 桥接实体未出现于任何搜索结果;SQL2S 最大失败类是『金答案从未出现』(SFT 52.2%、RL 52.8%)。二,过早提交——RL 82.0% 的错误提交(正确仅 48.7%)引用时间/努力/猜测,flagged 提交同问题内低 24.3 点,28.6% 的 SFT 训练轨迹已含此类表述。三,35/120 题三模型都解不出。我的补充:一,评估与训练环境耦合——除 BrowseComp 走实时 web 外,HybridDeepResearch 用的就是训练同款本地语料,有主场优势;二,合成数据全是伪词实体,与真实企业场景分布差距未量化,S2SQL 合成只用合成库;三,search-originated 数据库很小(平均每库 473 行),离企业级数库尚远;四,avg@8(27.19%)与 pass@8(60.83%)的差距说明单次可靠性仍低;五,judge 是 LLM,系统性偏差难排除;六,自家 harness 优于开源框架,『4B 超 397B』的幅度可能含 harness 贡献。
独立分析的弱点
第一,域迁移未验证:训练数据充斥伪词实体,『逐条核对约束』策略在真实实体(参数先验丰富、证据冲突真实)上是否迁移,只在 BrowseComp 间接检验;改进:保留种子 SQL,用真实企业文档替代伪词语料做消融。第二,SQL 复杂度天花板低:search-originated 数据库平均每表 613/348 行、单表为主,规模与真实数仓差几个数量级;改进:用 BIRD/Spider 级大库加真实脏数据重建。第三,教师依赖重:轨迹生成依赖 397B 或 DeepSeek-V4-Flash,每条预算 3600 秒、300 turns、128k tokens,小团队难复制;改进:自举或流程级蒸馏。第四,RL 数据仅 0.7K,靠三道过滤从 21K 淘洗,成本高且可能误删长尾;改进:在线课程学习,按 reward contrast 动态调度。第五,早停只诊断未解决:flag 触发验证步骤仅是提议;改进:训练证据充分性判断头或引入 PRM,显式建模『何时停止搜索』。第六,S2SQL 评估不成熟:judge 对 SQL 表语义等价的单票分歧率 12.2%,需更稳健的表等价判定器。
未来方向
作者提出的方向:一,把『种子+桥』配方推广到其他异构源组合——内部文档、代码仓库、领域数据库,只要满足『有已验证难度的单源任务做种子+存在可跨界桥接实体』即可,论文将其定位为可复制的结构性蓝图;二,解决过早提交:让提交依赖证据而非时间预算,例如由 flag 短语触发验证步骤。基于本文成果可延伸:第一,组合泛化——从两源扩展到三源以上链式桥接(SQL→web→内部文档),研究桥的传递性与误差放大;第二,真实环境 RL——本文 RL 在冻结本地语料上进行,搬到实时 web 并处理网页漂移与时效性是自然下一步;第三,不确定性校准——『82% 错误提交自我承认不确定』是干净训练信号,可构造置信度感知的 RL 奖励,惩罚证据不足时的提交;第四,评估方法论——构造训练语料完全隔离的混合基准,消除主场效应;第五,过程监督——桥的承重性验证目前靠构造期确定性门,若用 PRM 在推理期验证每步桥接的证据链,有望收窄 pass@8 与 avg@8 的差距(60.83 对 27.19);第六,效率——当前每 rollout 中位数 41-44 turns、约 14K 输出 tokens,用更少交互达到同精度对部署成本关键。
复现评估
难度中高。有利:基座、教师、重排器(Qwen3.5-4B、397B-A17B-FP8、Qwen3-Reranker-0.6B)均公开;RL 栈完整公开——PRIME-RL、GRPO+CISPO、学习率 $1\times10^{-6}$、每步 32 提示×组 5、单 8-GPU 节点;评估协议详尽(judge prompt 全文、Spider 2.0-lite 比较函数逐行移植);附录 C/D 有完整 worked examples 与统计。不利:一,正文未给代码/数据仓库链接(从 AI 使用声明看子集已『shipped』,可获取性需自行确认);二,本地语料需自建——21M 文档、2026 年 6 月维基 dump+FineWeb 快照,加混合检索与重排,工程量不小;三,教师轨迹生成贵:每条 3600 秒、最多 300 turns、128k tokens,数万条需大量推理算力;评估需 8×H200 或 8×B200,BrowseComp 需搜索 API key。综合:管道描述详细到可照抄,最大不确定性在语料构建与教师轨迹算力;拿到作者数据则复现训练现实,从零复现全管道预计需数百 GPU 天。
论文图表
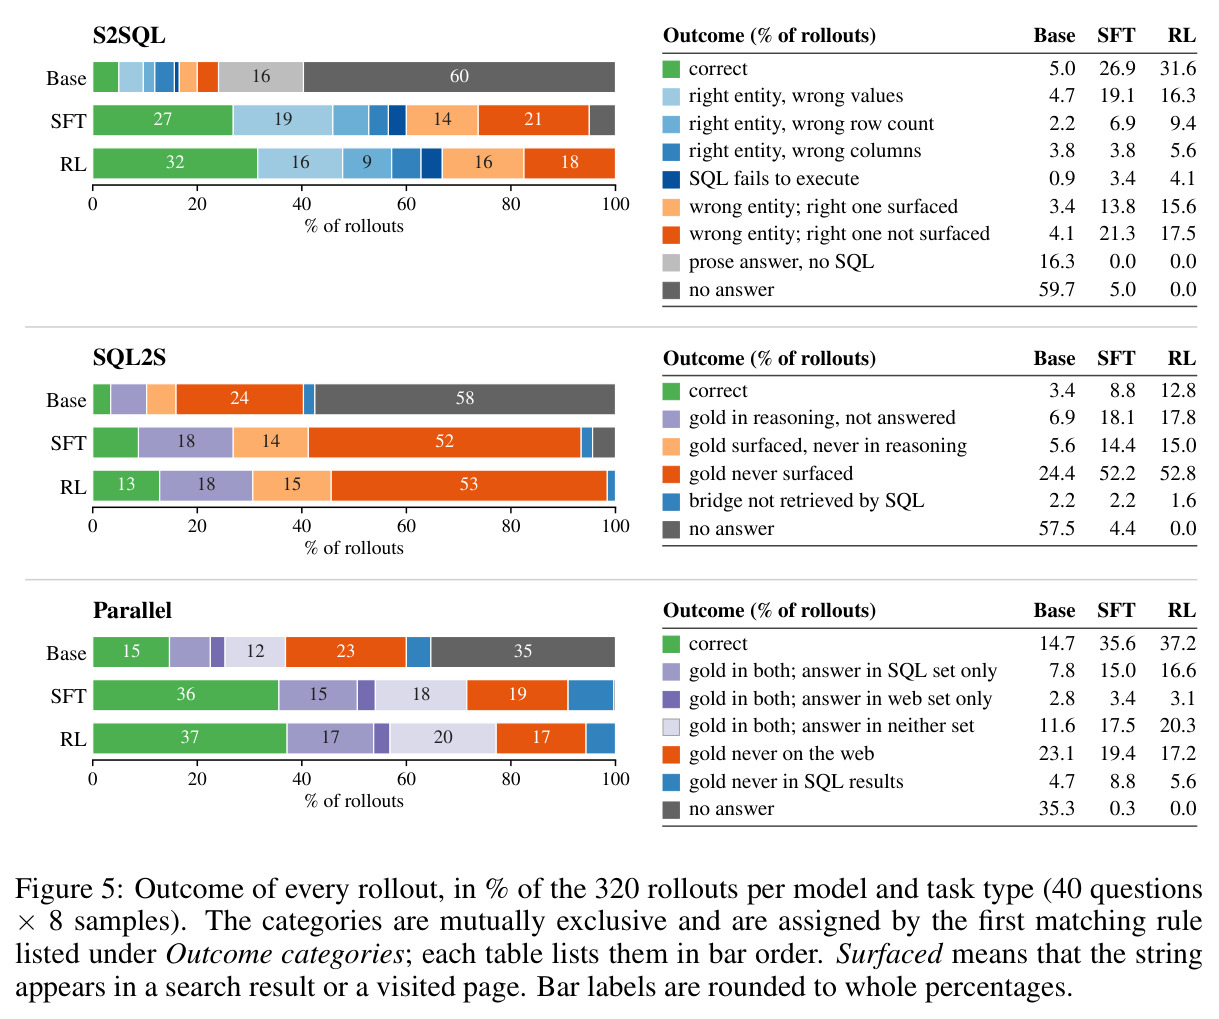
对 base/SFT/RL 三个模型共 2,880 次 rollout 的互斥结果归类条形图:正确率、金答案是否出现(surface)于搜索结果、是否进入推理、是否提交等。可见训练把『无答案』(基座 S2SQL 59.7%)几乎清零,但『金答案从未出现』(SQL2S 超 50%)成为最大剩余失败类。
全文最细粒度的失败解剖,直接支撑『检索瓶颈与证据利用率』这两大剩余瓶颈的结论,也是失败分析章节的核心。
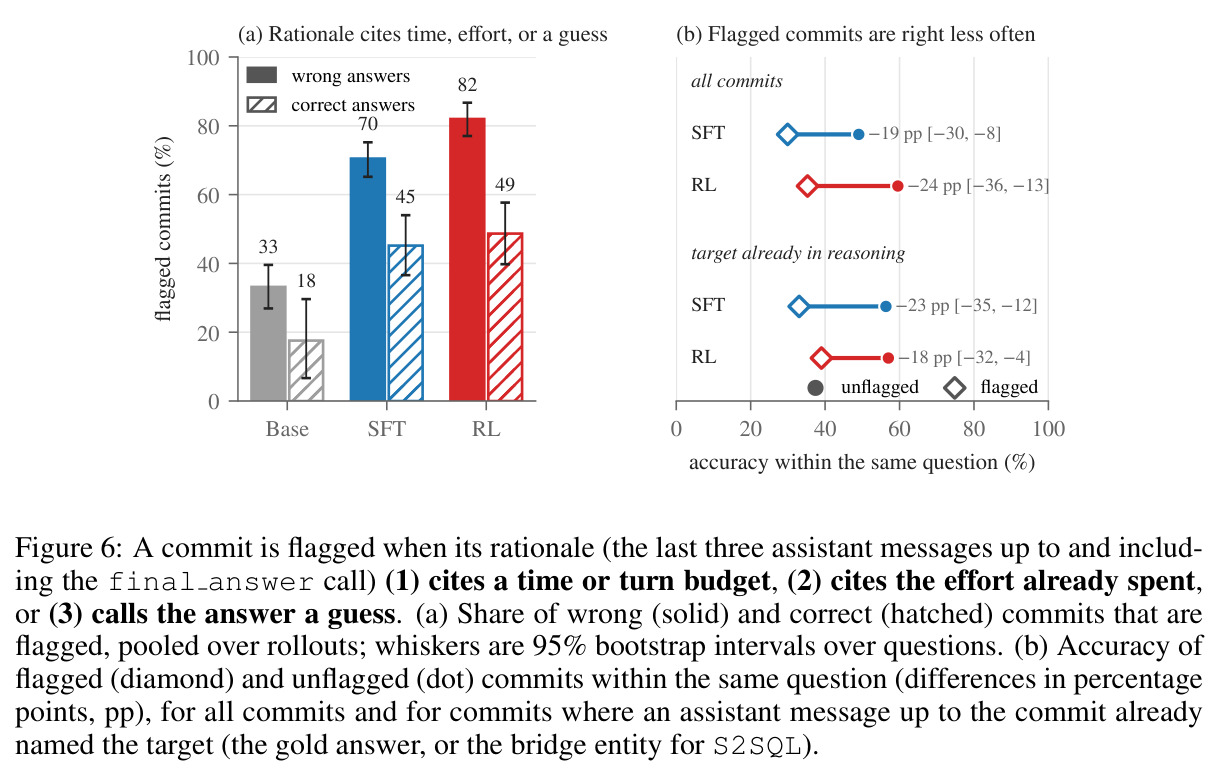
对『以时间/努力/猜测为由的提交』的定量分析:RL 错误提交中被 flag 的比例 82.0%,正确提交仅 48.7%;同一问题内 flagged 提交正确率比 unflagged 低 24.3 个百分点,控制证据与长度后仍低 10 个点。
揭示了『过早提交、自认猜测』这一被量化刻画的行为缺陷,直接对应作者提出的未来方向(让提交依赖证据),对改进智能体可靠性有普遍参考价值。
搜索行为对比:每 rollout 搜索次数 38.6→22.1→18.7(-15%),页访问 7.0→9.9→14.3(+45%),页访问/搜索 0.29→0.50→0.88(+76%);S2SQL 桥出现在证据中的比例 69.7%→70.9%→77.8%,SQL2S 在金答案已出现条件下的准确率 12.9%→18.5%→27.2%。
揭示训练如何改变工具使用行为——SFT 教会『先读再搜』,RL 精化证据利用,是理解性能提升机理的关键。
搜索起源的种子来源:REDSearcher (SFT) 9,177、OpenSeeker 8,743、DeepDive (RL) 2,202、REDSearcher (RL) 979、DeepDive (SFT) 961、WebShaper 474,合计收集 22,536,过实体门后剩 14,233。
给出搜索起源生产线全部种子的出处与过滤前的规模,是复现该数据族的第一步依据。
flag 分析的支撑数据:RL 提交中被 flag 占 72.9%(错误 82.0%、正确 48.7%);同问题内 flagged-vs-unflagged 准确率差 -24.3 点,控制证据与长度后 -10.0 点;中位轮次 RL 41/300,无一 rollout 触及『剩 10 轮』提醒;28.6% 的 SFT 混合训练轨迹已含 flag 短语。
完整披露统计细节与置信区间,证明『过早提交是训练数据与策略共同的毛病、且预算并不是停止原因』,对设计证据依赖的提交机制有直接指导意义。