好判断,坏建议:决策模型控制器推高智能体成本却不提升成功率 Good Judgment, Bad Advice: Decision-Model Controllers Raise Agent Cost Without Improving Success
决策模型控制器使智能体成本升19%而通过率不变,好排名坏校准
前置知识
Agent 脚手架
包裹在推理模型外层的控制逻辑:终端智能体每步调用一次模型,模型可执行 shell 命令或请求结束,脚手架决定何时停止、何时自查、何时换思路。成本几乎全部来自推理模型调用。本文固定一个极简循环(Sonnet 5.5 只有 bash/finish 两个工具,Harbor 在 Daytona 沙箱里执行命令、跑验证器),所有实验组共享这个循环。
论文的全部实验设计都建立在『冻结智能体循环、只换控制器』这个受控框架上,不理解脚手架就无法理解五个实验臂之间到底比的是什么。
类型化决策模型
为循环中固定决策点设计的小模型:输入状态和固定的选项集合,输出一个选项及其概率分布,价格远低于推理模型。本文用的 Jev 1.13 每百万输入 token 仅 $0.042,单次决策约 $0.00008、平均 0.52 秒。它走的是与级联/路由不同的省钱路线:推理模型固定不变,由廉价模型决定循环如何推进。
Jev 是论文的被试对象,所有核心结论(离线 AUROC 0.78、校准差、在线成本升 19%)都围绕这类模型的『判断』与『干预』展开。
AUROC 与校准误差(ECE)
AUROC 衡量概率的排序能力:随机抽一正一负两个样本,模型给正例更高分数的概率,0.5 等于瞎猜。ECE 衡量概率数值本身的可靠性:按预测概率分桶后比较平均置信度与真实频率。一个模型可以排序很好但整体概率严重偏低——Jev 正是如此,AUROC 0.78 却把 $P(\text{finish})$ 的均值压在 0.50。
论文的核心机制解释——『判断好、校准差、所以干预频繁且低价值』——完全由这两个指标刻画,不懂它们就看不懂第 4.3 节。
安慰剂对照
在相同的触发时刻以相同的频率进行干预,但选择从 Jev 自己开发期的选择频率中随机采样(Q-progress:continue 0.625 / investigate 0.125 / recover 0.25 / abandon 0;Q-finish:finish 0.652 / verify 0.348),按试验播种。若安慰剂与真控制器效果相同,说明起作用的是『干预』本身;若不同,才能归因于决策内容。
安慰剂臂是本文最重要的设计创新,正是它把『Jev 的选择有害』从『干预行为本身有害』中剥离出来,得到比单纯对比 native 强得多的结论。
Bootstrap 置信区间与几何均值比
本文按任务配对比较各臂:先对每任务多次尝试取平均,再以任务为单元重采样 10000 次构造百分位 95% 置信区间;成本效应定义为各任务『每次尝试美元成本比』的几何均值 $\text{ratio} = \exp\big(\frac{1}{T}\sum_t \ln (c_{t,\text{Jev}}/c_{t,\text{native}})\big)$,多重比较用 Holm 校正。
论文的确认性结论(成本比 1.19,95% CI 1.02–1.36)完全建立在这套统计流程上,理解它才能判断哪些结果稳健、哪些只是弱证据。
研究动机
终端智能体的成本几乎全部花在推理模型上,于是脚手架把『何时停止、何时自查、何时换路』这类小决策外包给更便宜的模型,希望又省钱又聪明。但现有评估几乎只测判断质量(置信度估计、判分准确性,如 Kadavath 2022、LLM-as-judge),从不端到端检验『判断能否转化为成本节省』。问题在终端任务里特别尖锐:智能体自己的 finish 请求 87% 都是对的,此时插一轮 verify 几乎纯属浪费;而真正无望的运行往往死在超时或预算上限(native 臂 17 次失败中 10 次如此),根本没有 finish 请求可供拦截,控制器也从没提议过放弃。直觉上『让小模型管小事』应该省钱,但没人做过对照实验验证,甚至可能适得其反。
本文的目标是作者要在严格受控的条件下回答一个明确的因果问题:向固定的 Claude Sonnet 5.5 终端智能体循环接入类型化决策模型 Jev 1.13(仅在确定性决策点咨询,每次决策约 $0.00008),能否在不降低通过率的前提下降低成本。为此设计预指定的安慰剂对照研究:在 Terminal-Bench 2.1 的 21 个 held-out 任务上,每任务 5 个臂(无控制器 native、确定性规则、Claude Haiku 5.5、Jev、安慰剂)× 3 次尝试共 315 次试验;确认性假设 C1 只检验成本比,通过率则以 −10 个百分点的降幅为预设安全边际。
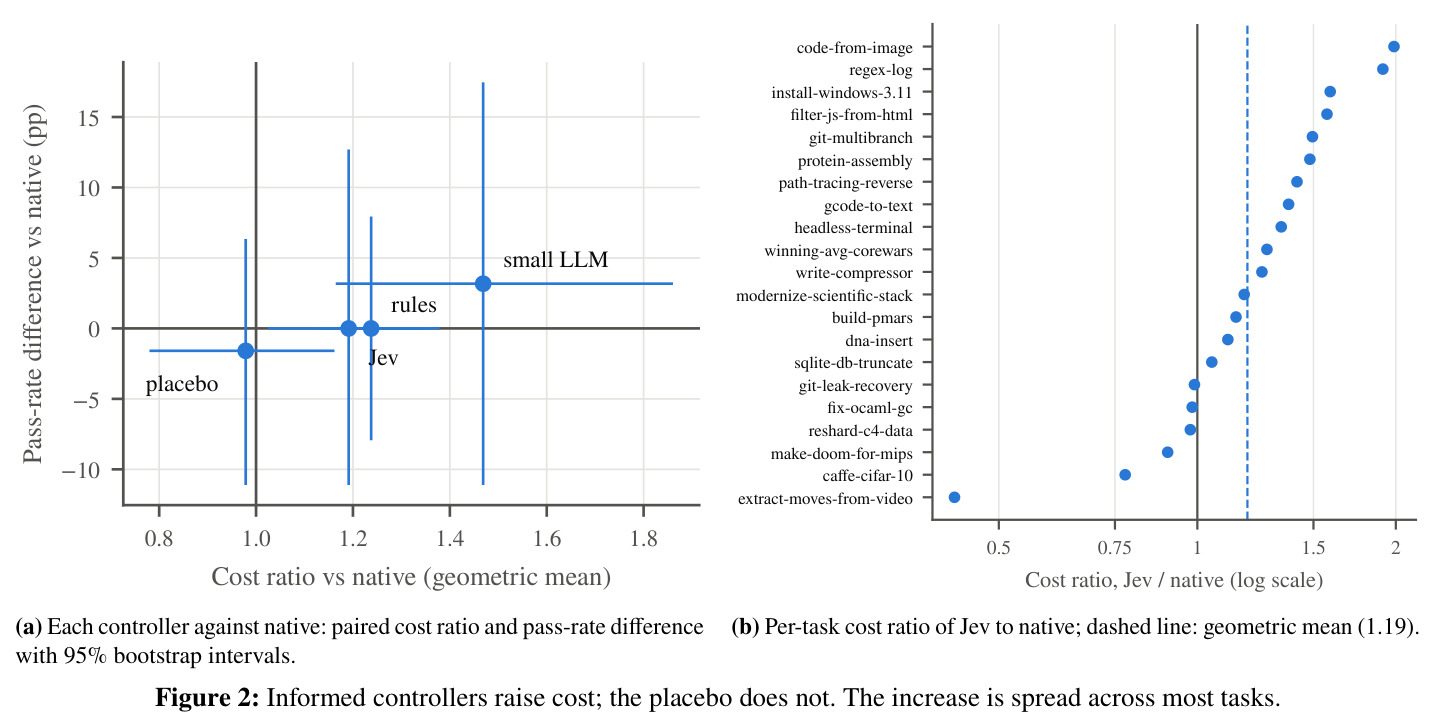
与已有工作不同的是,独特之处是三重基线设计加『只变一个变量』:确定性规则回答『到底需不需要模型』(rules ×1.24 vs native),小 LLM 回答『为什么不用便宜的通用 LLM』(Haiku ×1.47),安慰剂回答『起作用的是决策内容还是干预本身』(placebo ×0.98)——三个混淆因素被逐一分离。判断质量与干预效果也被显式解耦:离线把触发状态回放给各控制器打 AUROC/ECE,在线再测真实干预效果,两者的断裂正是本文的核心发现。此外把成本作为确认性主要终点、用任务配对 bootstrap 几何均值比做推断,这种严谨度在智能体评估里极为罕见。
核心方法
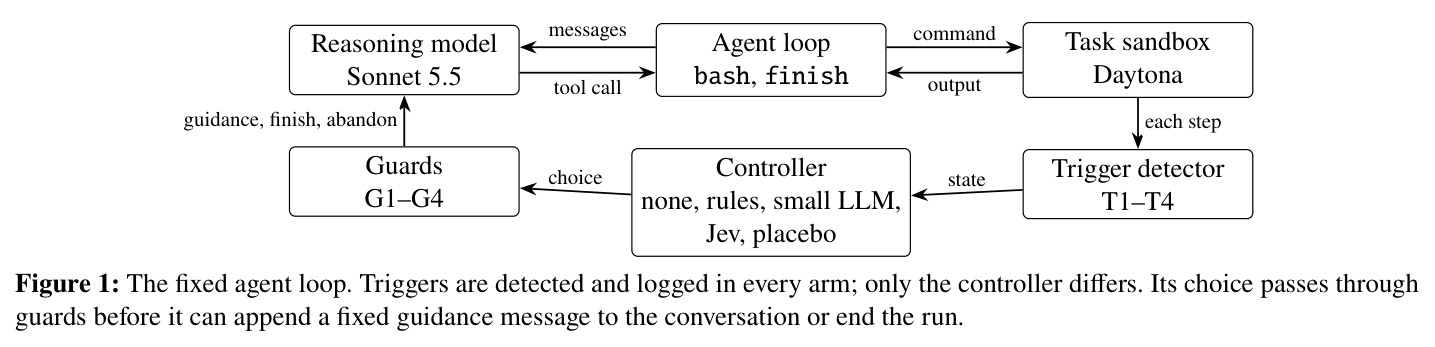
整体思路是构造一个所有臂共享的极简智能体循环(Figure 1):每步一次 Sonnet 5.5 调用(reasoning effort high、prompt caching,模型不接受温度参数),只能调 bash 或 finish,无工具调用的回复视为 finish 请求,命令经 Harbor 在 Daytona 沙箱的新 shell 里执行,输出截断前 4000 后 8000 字符,上下文从不压缩。所有臂(包括 native)都在相同规则下检测并记录 4 个确定性触发点:T1 连续失败(≥2 条连续失败命令)、T2 无进展(重复命令或重复输出)、T3 finish 请求、T4 每 10 步检查点;每步至多一个触发,同类触发 3 步内不重触。唯一的实验变量是触发时咨询哪个控制器,其选择经守卫过滤后才生效。
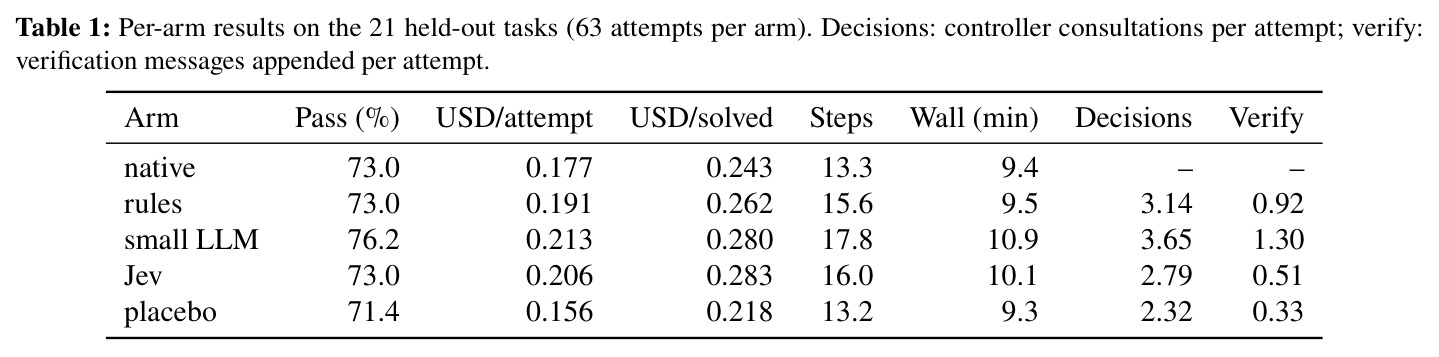
核心创新是安慰剂臂:它在相同时刻以相同频率干预,但选择是从 Jev 自己开发期的选择频率(Q-progress:continue 0.625/investigate 0.125/recover 0.25/abandon 0;Q-finish:finish 0.652/verify 0.348)按试验播种随机抽取的。这把『干预时机与频率』和『决策内容』两个混淆因素彻底分开——若安慰剂与 Jev 通过率相当但更便宜(实际 $0.156 vs $0.206/次),那么贵的部分只能归因于 Jev 的选择本身。次要创新是把判断与行动解耦:用 native 臂记录的触发状态离线回放给每个控制器、以试验结果为标签打分(AUROC/ECE/argmax 准确率),再对照在线行为,从而精确定位『信息丰富的判断为何没变成有用的干预』。
方法步骤详情
步骤如下。(1) 任务准备:Terminal-Bench 2.1 共 89 任务,剔除 2 个超时超 60 分钟和 1 个 Sonnet 5.5 首轮拒答的任务;30 个校准任务每任务用 native 跑两次按通过次数分层,切成 8 个开发任务与 21 个 held-out 任务(14 易 3 中 4 难),清单校验和锁定,校准尝试不进结果。(2) 定守卫:上限 60 步/$1.00;G1 强制步数/花费/token/时间硬限,G2 规定预算用过 40% 且有失败串才许 abandon,G3 规定两次 verify 后第三次 finish 才放行,G4 把超时或畸形答案回退为 continue/finish。(3) 控制器只看转录摘要(指令、触发、步数/花费占比、最近 5 条命令及输出尾部、失败与重复计数、上次编辑后是否跑过验证类命令、finish 摘要、自身历史选择),看不到测试或参考答案。(4) 评估:21 任务 × 5 臂 × 3 尝试 = 315 试验,臂序在任务-尝试块内随机,成本取供应商上报之和(不含沙箱算力)。(5) 统计:按任务配对,重采样 10000 次取 95% CI,C2–C4 用 Holm 校正。(6) 离线回放:native 臂的 53 个 Q-finish、72 个 Q-progress 状态回放给各控制器打分。
技术新颖性
技术新颖性不在模型而在实验方法论。第一,预指定的安慰剂对照设计在 LLM 智能体评估中罕见:随机干预充当活性对照,证明 Jev 的选择(而非干预行为)贡献了额外成本(安慰剂 $0.156/次 vs Jev $0.206/次,且安慰剂通过率 71.4% 与所有知情控制器统计上无差)。第二,成本作为确认性主要终点,用任务配对 bootstrap 几何均值比加 Holm 校正处理多重比较,远比常见的『报个通过率加粗略花费』严谨。第三,离线/在线双层评估把判断质量与干预价值分离,揭示出一个漂亮的悖论:AUROC 0.78 的好排名因概率均值 0.50(真实通过率 0.87)而在 argmax 策略下准确率只剩 0.55、反而低于无脑全 finish 的基率。第四,附带发现两条评测基建陷阱:朴素的『是否验证过』特征会漏掉自己跑测试自查的智能体;安全拒答返回空回复会被循环误判成 finish 请求。
实验结果
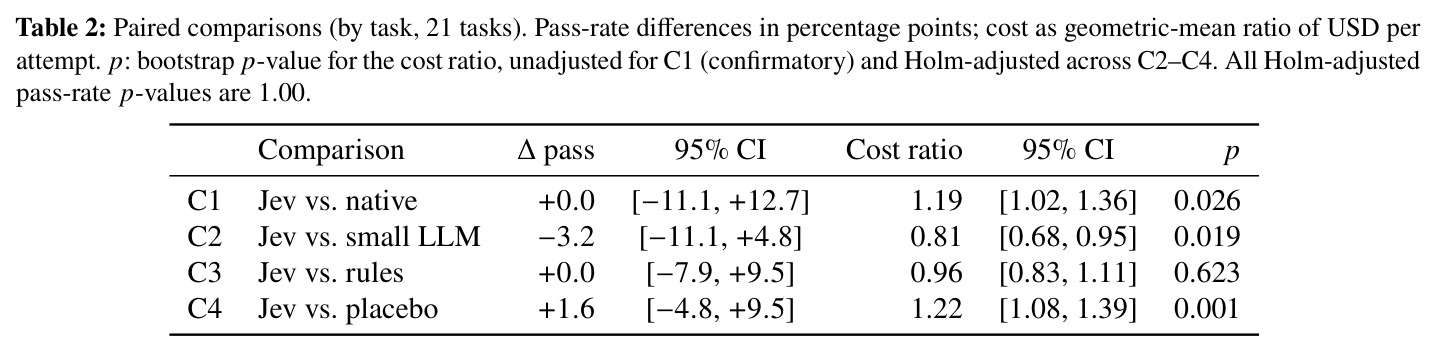
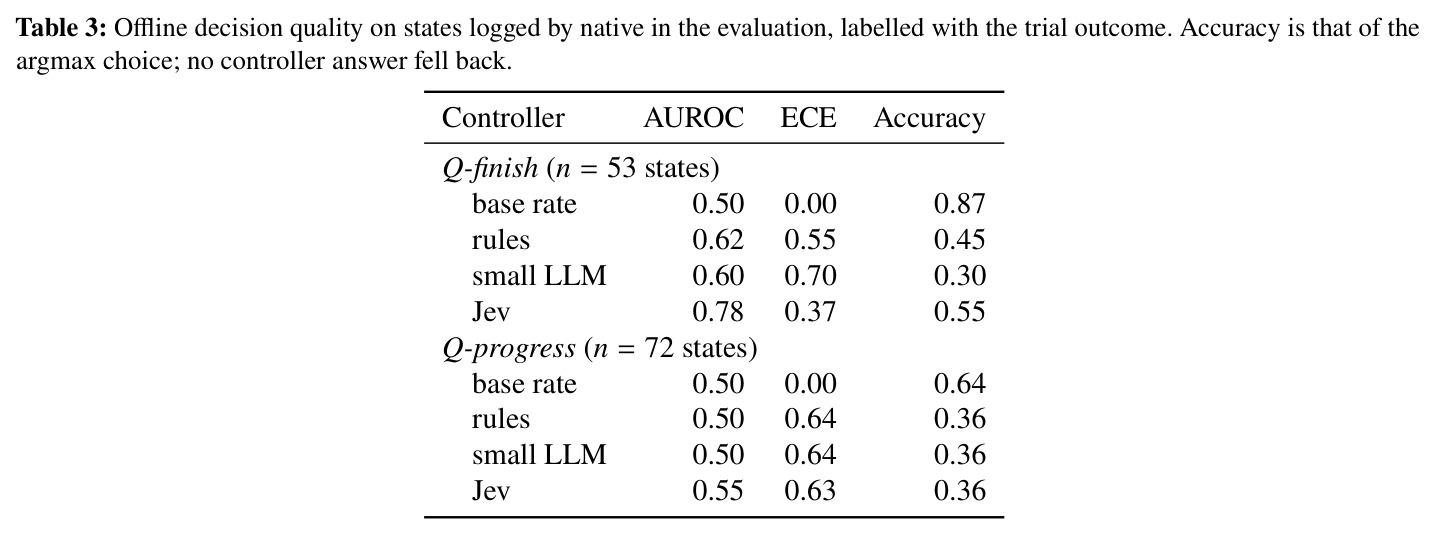
确认性结果 C1:Jev 使每次尝试成本上升 19%(几何均值比 1.19,95% CI 1.02–1.36,$p=0.026$),通过率完全相同(73.0% vs 73.0%),『省钱』假设被拒绝。次级比较:Jev 比小 LLM 控制器便宜 19%(0.81)、与规则打平(0.96)、比安慰剂贵 22%(1.22,$p=0.001$);相对 native,rules ×1.24、small LLM ×1.47、Jev ×1.19 都更贵,唯独安慰剂 ×0.98 不贵;通过率经 Holm 校正后 $p$ 全为 1.00。机制层面:native 的 finish 请求 87% 通过,Jev 却对 53 个 finish 请求中的 29 个选 verify——其 $P(\text{finish})$ 均值仅 0.50 而基率 0.87,离线 AUROC 0.78 优于 rules 0.62 和小 LLM 0.60,但 argmax 准确率 0.55 低于基率;$P\ge 0.5$ 的运行 96% 通过,低于 0.5 的也过 79%。Q-progress 上无控制器选过 abandon:315 次试验零放弃,make-doom-for-mips 的 15 次运行全死于超时或 $1 上限。成本分解:多花的 $0.029/次中 $0.011 在第一条 verify 后,其余来自更长轨迹(16.0 步 vs 13.3)。Jev 在 15/21 个任务更贵,留一法 1.16–1.25;调用开销可忽略(0.52 秒/决策,占总花费 0.11%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Jev vs 无控制器(确认性 C1,21 任务 × 3 尝试配对) | 每次尝试成本几何均值比 / 通过率差(pp) | 成本比 1.19(95% CI 1.02–1.36),$p=0.026$;通过率 73.0% vs 73.0%(+0.0pp) | native 臂:$0.177/次、通过率 73.0%、平均 13.3 步 | 负优化:成本 +19%,通过率零变化,省钱假设被拒绝 |
| Jev vs 小 LLM 控制器(C2,同为 Claude Haiku 5.5 回答相同问题) | 成本比 / 通过率差 | 0.81(0.68–0.95);−3.2pp(CI −11.1 至 +4.8,不显著) | small LLM 臂:$0.213/次、通过率 76.2%、verify 消息 1.30 次/次 | Jev 便宜 19% 且决策快约 3 倍(0.52s vs 1.46s),说明开销不是问题、策略才是 |
| Jev vs 确定性规则(C3) | 成本比 / 通过率差 | 0.96(0.83–1.11),$p=0.623$;+0.0pp | rules 臂:$0.191/次、通过率 73.0%、verify 0.92 次/次 | 统计打平:一个 $0.00008/次决策的专业模型没能胜过几行 if-else |
| Jev vs 安慰剂(C4) | 成本比 / 通过率差 | 1.22(1.08–1.39),$p=0.001$;+1.6pp(不显著) | placebo 臂:$0.156/次、通过率 71.4%、verify 仅 0.33 次/次 | Jev 贵 22%——直接证明额外成本来自 Jev 的决策内容而非干预行为本身 |
| 离线判断质量 Q-finish(53 个 native 触发状态回放,标签=通过) | AUROC / ECE / argmax 准确率 | Jev:0.78 / 0.37 / 0.55;$P(\text{finish})$ 均值 0.50 vs 基率 0.87 | rules:0.62 / 0.55 / 0.45;small LLM:0.60 / 0.70 / 0.30;无脑全 finish 基率准确率 0.87 | 排名最强、校准最差:argmax 准确率反而远低于不做任何判断的基率 |
| 离线判断质量 Q-progress(72 个状态回放,标签=失败,测 abandon 概率) | AUROC / argmax 准确率 | Jev:0.55 / 0.36;rules 与小 LLM:0.50 / 0.36 | 基率:AUROC 0.50、准确率 0.64 | 基本无信号:315 次在线试验中没有任何控制器真正选过 abandon |
局限与改进
作者承认:held-out 集仅 21 个任务且 14 个偏易、只有 3 个中等难度,通过率置信区间宽达 ±11–13pp,C1 的非劣性检验恰在设计的分辨率极限上,只能读作『未见大幅下降』而非证明非劣;只测了一个推理模型(Sonnet 5.5)、一个极简循环和一个决策模型(Jev 1.13),开源权重模型因 OpenRouter 各主机量化不一致而无法固定;模型不接受温度参数、主机不固定,只能靠多次尝试当重复样本;安慰剂分布来自仅 8 个 progress、23 个 finish 决策的开发样本且 abandon 概率为 0,测的是决策内容而非干预频率;离线标签用整场试验结果而非反事实结果。我补充:三段固定建议消息从不包含命令、路径或测试信息,干预的信息量被人为封顶,实际测的是『最低限度建议』而非控制器干预的上限;选项描述、消息措辞、守卫阈值(40% 步数预算、第三次 finish 放行)都可能大幅改变结论却没有敏感性分析;通过率端 76.2% 的小 LLM 臂反而最高,尽管不显著,样本更小时无法排除小 LLM 略有帮助的可能。
独立分析的弱点
独立分析四点。其一,统计功效不足且错配:14 个易任务几乎全过、4 个难任务几乎全败,真正能区分控制器的中等难度任务只有 3 个(pass-rate 区间 ±11–13pp),『通过率不变』是很弱的陈述——改进方向是按难度分层加大中等任务采样。其二,离线评估的反事实缺陷:verify 之后通过了,无法知道不 verify 是否也通过,于是把验证成本一律算作浪费——改进方向是用交叉臂配对(同任务同触发点在不同臂的实际不同决策)构造准反事实标签。其三,干预被设计得太弱:固定建议消息不含任何新信息,而 Huang et al. 2024 已表明无新信息的自查常无效;控制器唯一强动作 abandon 又被 G2 的 40% 预算门槛加上自身概率分布(安慰剂里为 0)压死——改进方向是让 verify 携带外部证据(如运行独立测试套件)并重新设计止损动作的触发条件。其四,概率→动作的策略是最粗糙的 argmax:Jev 明明有真实排序能力($P\ge 0.5$ 组 96% vs $P<0.5$ 组 79% 的通过率差),却因整体压低的校准被 argmax 放大成频繁低价值干预——改进方向是基率感知阈值或 conformal 校准。
未来方向
作者提出:用基率感知的阈值作用于校准后的概率,而不是 argmax;给控制器一个它真正会用的止损动作并在新任务上预注册重复实验;用开源权重模型复制。基于本文成果可延伸:(1) 在线校准——把 Jev 的 $P(\text{finish})$ 用 temperature scaling、isotonic regression 或 conformal prediction 拉回基率 0.87 附近,再测干预价值能否由负转正;(2) 让控制器决策『要不要引入新证据』而非『要不要再想想』,例如授权 verify 触发一次独立的测试运行或与任务规格的对照检查;(3) 把成本作为强化信号直接训练控制器策略,用本文的循环和守卫做环境;(4) 扩大控制器管辖的杠杆——上下文压缩时机、模型切换(简单步骤换便宜模型)、并行尝试的早期淘汰,这些都比『是否 verify』省钱空间大,而 make-doom-for-mips 这类 15/15 全灭任务正是止损动作的天然试验场;(5) 把本文的安慰剂协议推广为智能体干预研究的标准评估件:任何『给智能体加个监督者』的论文都应报告与随机干预的对比。
复现评估
复现条件较好。代码、配置与分析脚本公开(github.com/namanvats/decision-model-controllers);基准版本、Harbor 0.24.0、模型标识(typesafe/jev-1.13,快照 jev-1.13-20260917)、上限、触发与守卫参数及全部提示词都写进论文与附录;每条试验记录配置指纹、锁文件哈希与 Harbor 命令,任务集按内容摘要固定、held-out 清单有校验和、评估期内臂序随机化有记录。算力门槛极低:评估期模型花费 $59.46,全程 $72.29,单试验上限 $1.00,个人研究者即可承担。主要障碍有三:Jev 是 TypeSafe 的商业模型(经 OpenRouter 调用),离开它无法复现核心臂;Sonnet 5.5 不接受温度参数且主机不固定,完全复现只能做到统计意义上的复制;Daytona 沙箱与 Harbor 环境需要配置。总体难度中低:脚本齐全、花费便宜,但因结果对随机性敏感,需要按原设计跑满 315 试验才能重现置信区间。
论文图表