HABIT-Bench:评测智能体记忆从长程弱证据中归纳与应用用户习惯的能力 HABIT-Bench: Evaluating Habit Induction from Longitudinal Weak Evidence in Agent Memory
构造四域合成用户史与四选一探针,测出记忆系统归纳习惯仅约三成准确,且不优于简单检索
前置知识
LLM 智能体长期记忆
指智能体在多会话交互中把历史信息组织、存储并在后续决策中调用的机制。典型系统如 A-MEM、Mem0、MemOS、MemRL、LightMem、SeCom,以及多存储库的 Letta、MIRIX。流程一般形式化为三步:按时间逐会话写入 $M_u^t=\mathrm{Update}(M_u^{t-1},\,s_t)$,探针时刻检索 $R_p=\mathrm{Retrieve}(M_u^{t_p},\,x_p)$,再由模型作答。它与一次性把历史塞进上下文的简单做法(Full Memory)或 RAG 检索相对立。
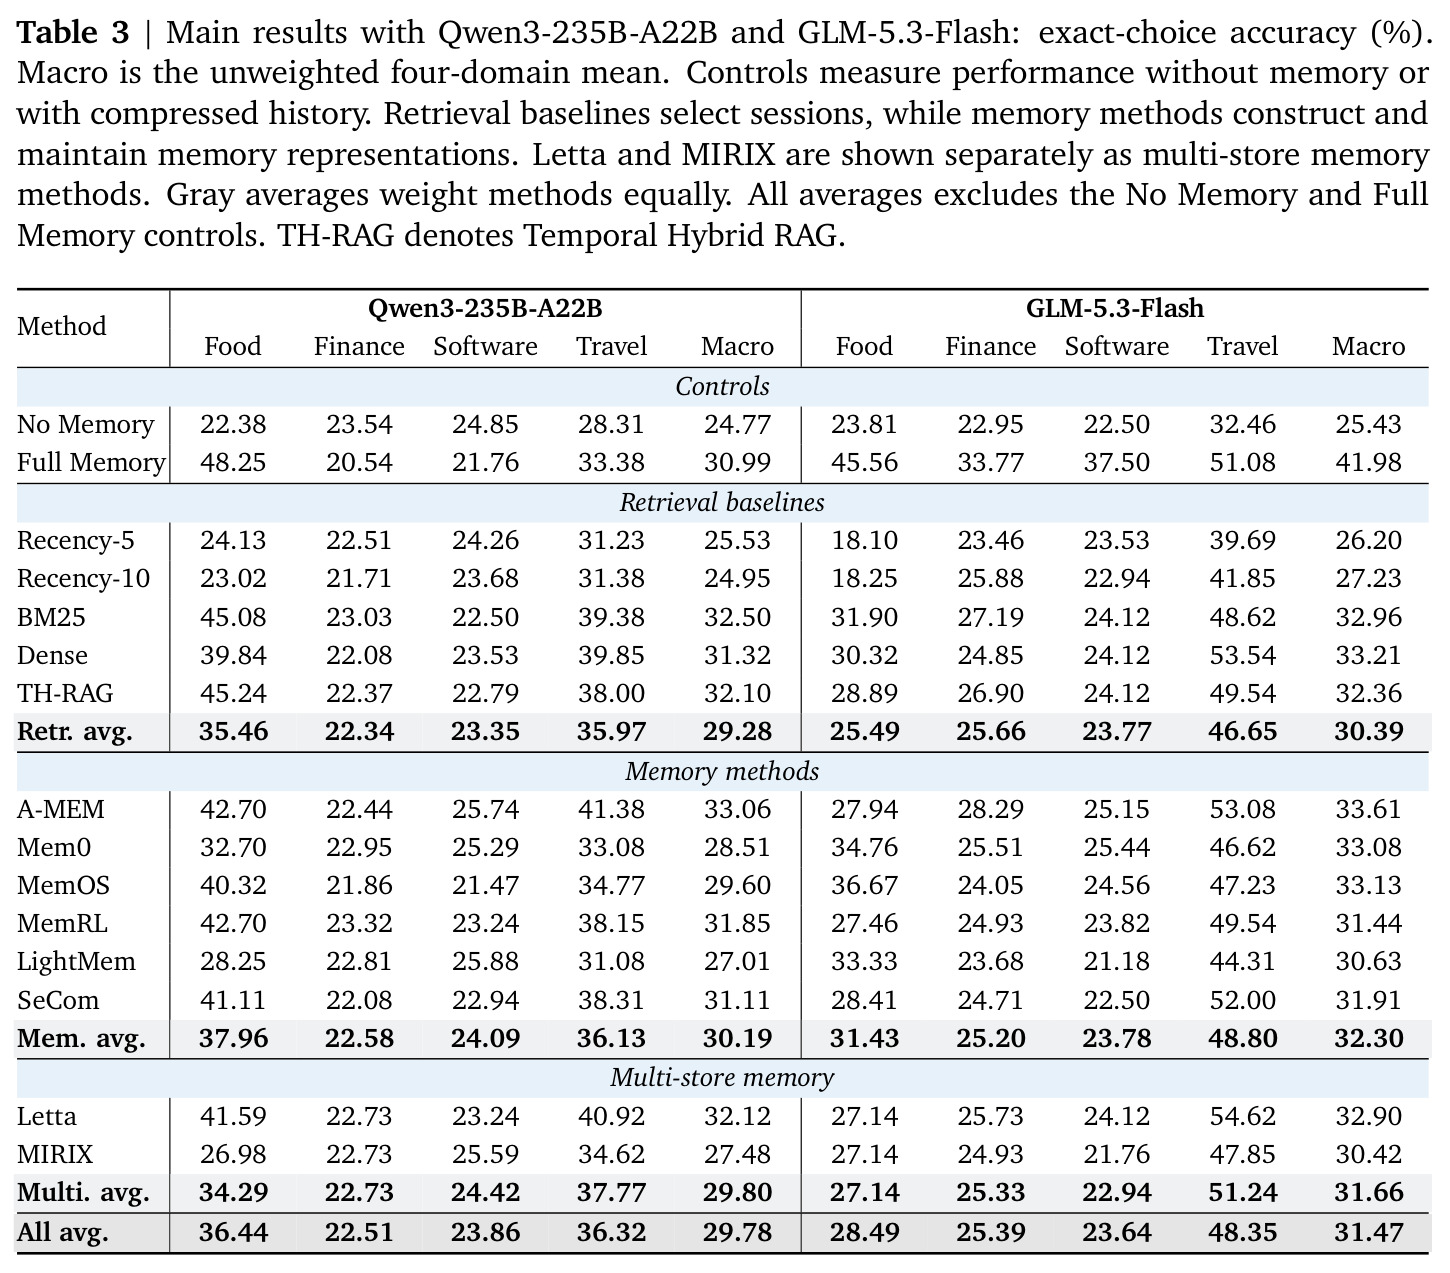
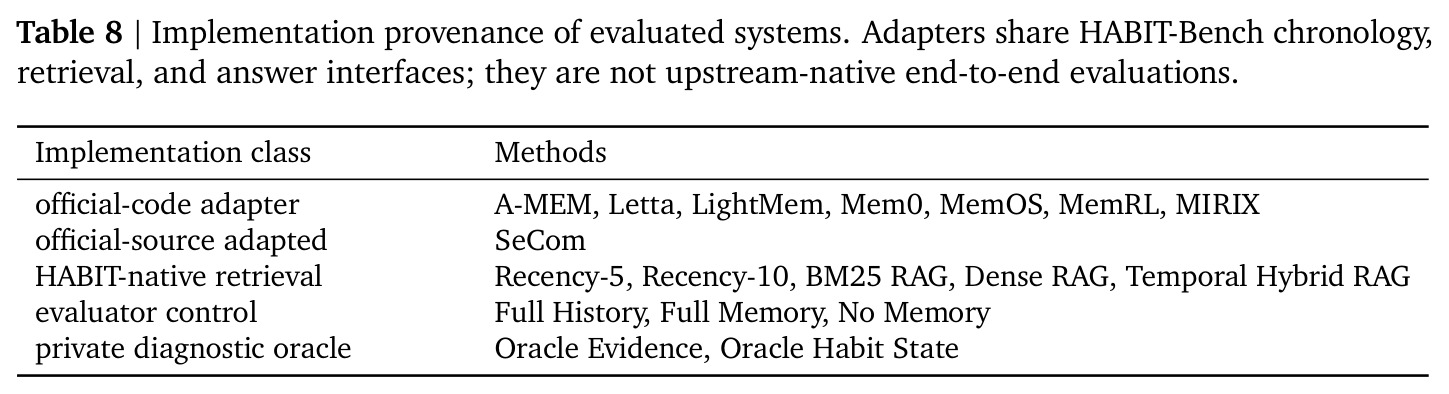
本文的被评测对象就是这八类记忆系统,必须理解它们与朴素检索基线的区别,才能读懂『复杂记忆管线并不稳定优于简单检索』这一核心结论。
习惯(行为默认)及其四要素
用户在长期交互中形成的稳定行为模式,例如『切蔬菜用斜薄片』『银行卡丢失先锁卡再核查』。论文将其形式化为带时间戳的状态 $z_{u,h}(\tau)$,包含四个维度:默认动作、适用范围(scope)、例外条件、时间有效性,以及用户是否真正认可(endorsement)。习惯不等于历史里每一条被记录的选择,而是『何时该照惯例做』的可推断规则。
这是基准要考察的目标能力,所有探针的错误选项都围绕这四要素设计:过期默认、越界外推、把未采纳建议当偏好,读懂它才能看懂任务构造。
弱证据(weak evidence)
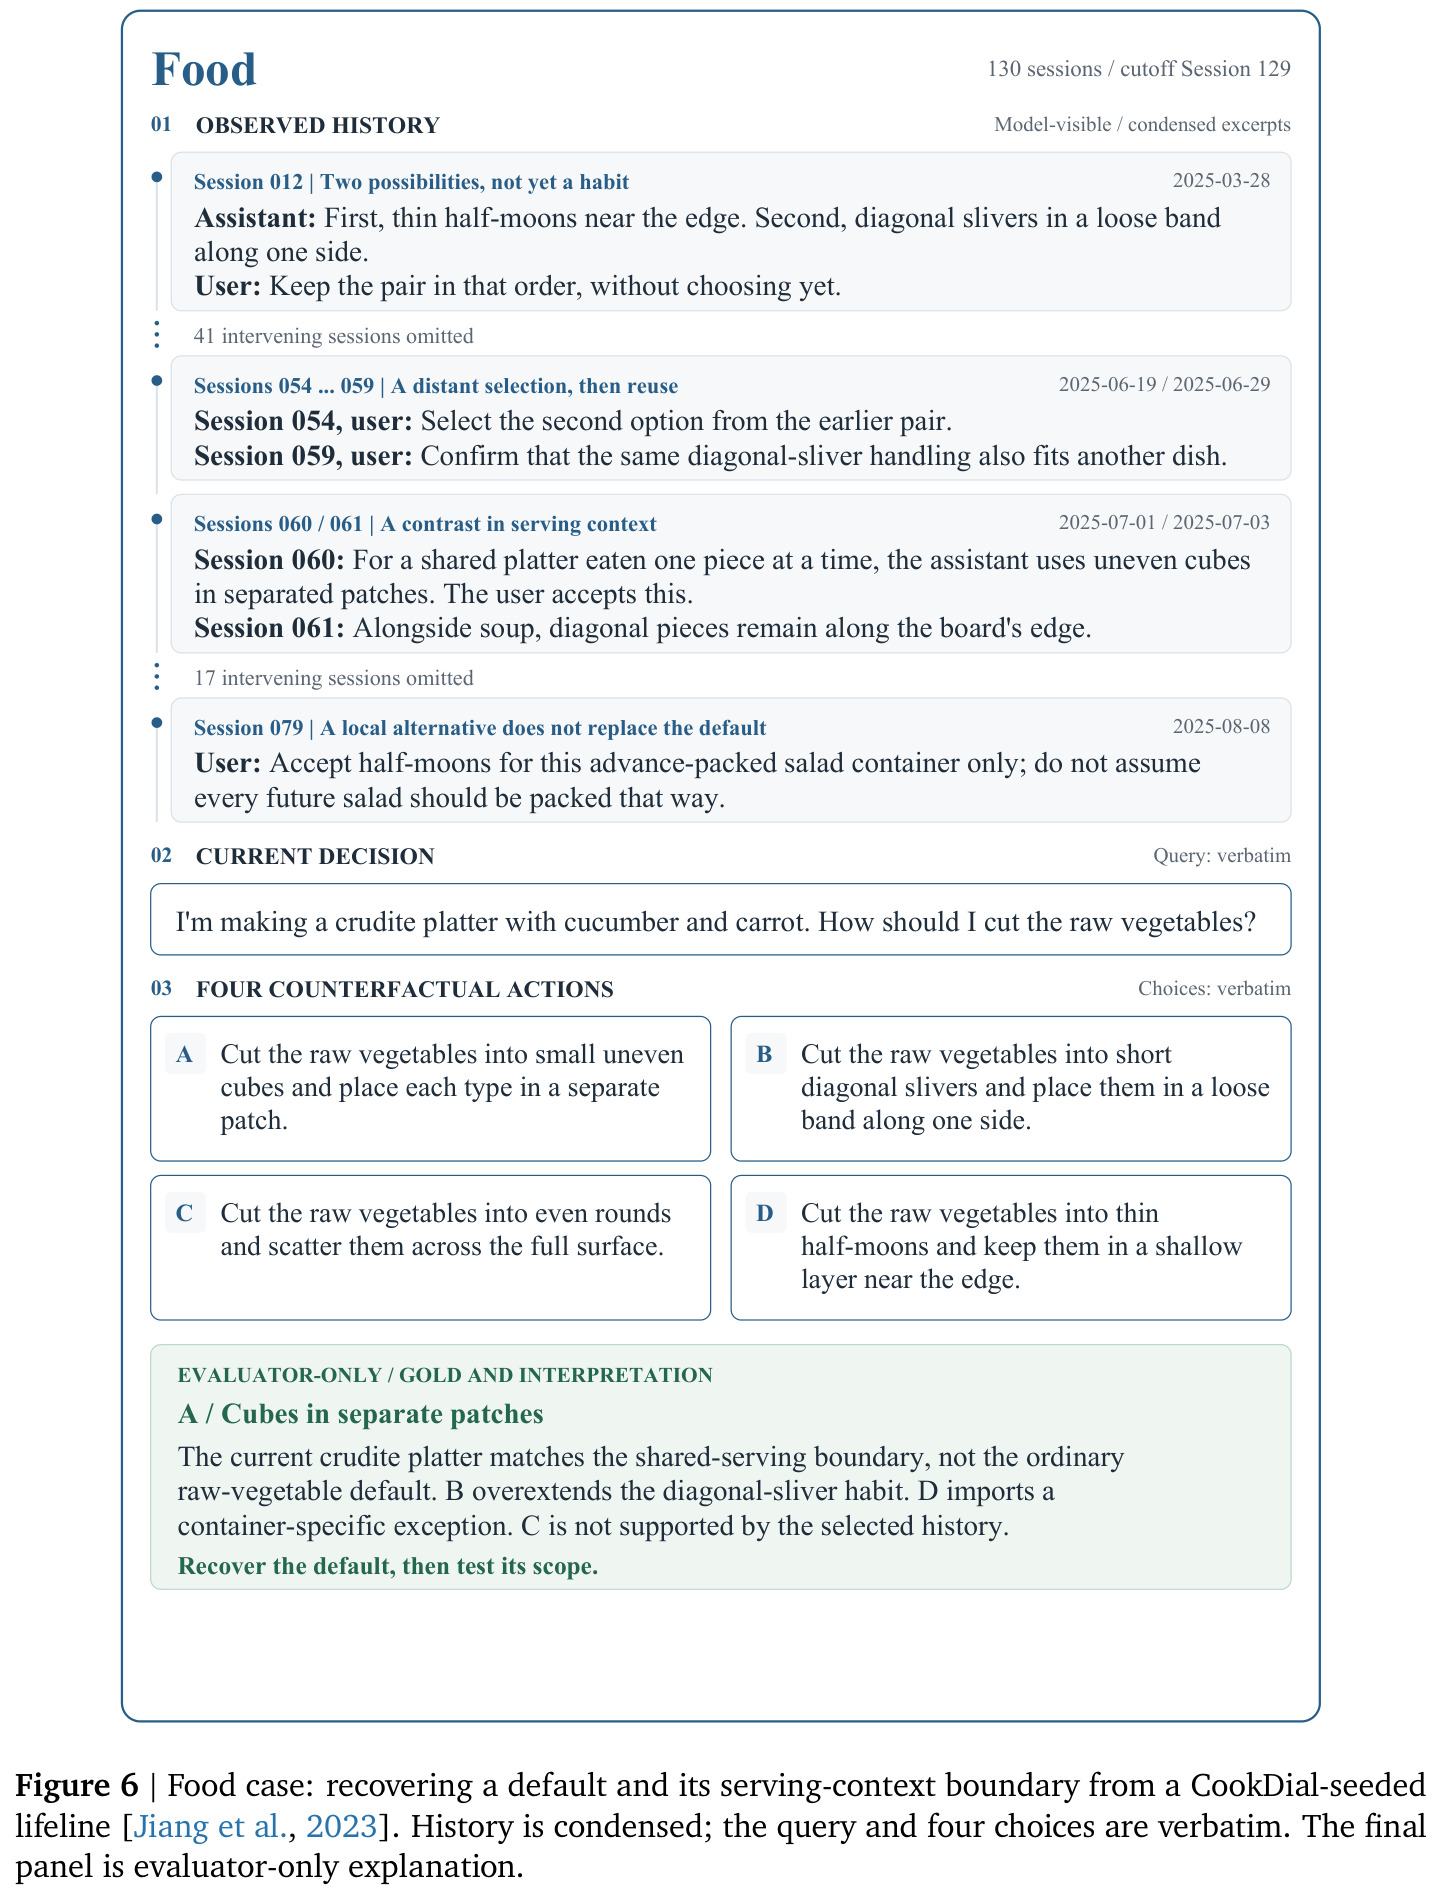
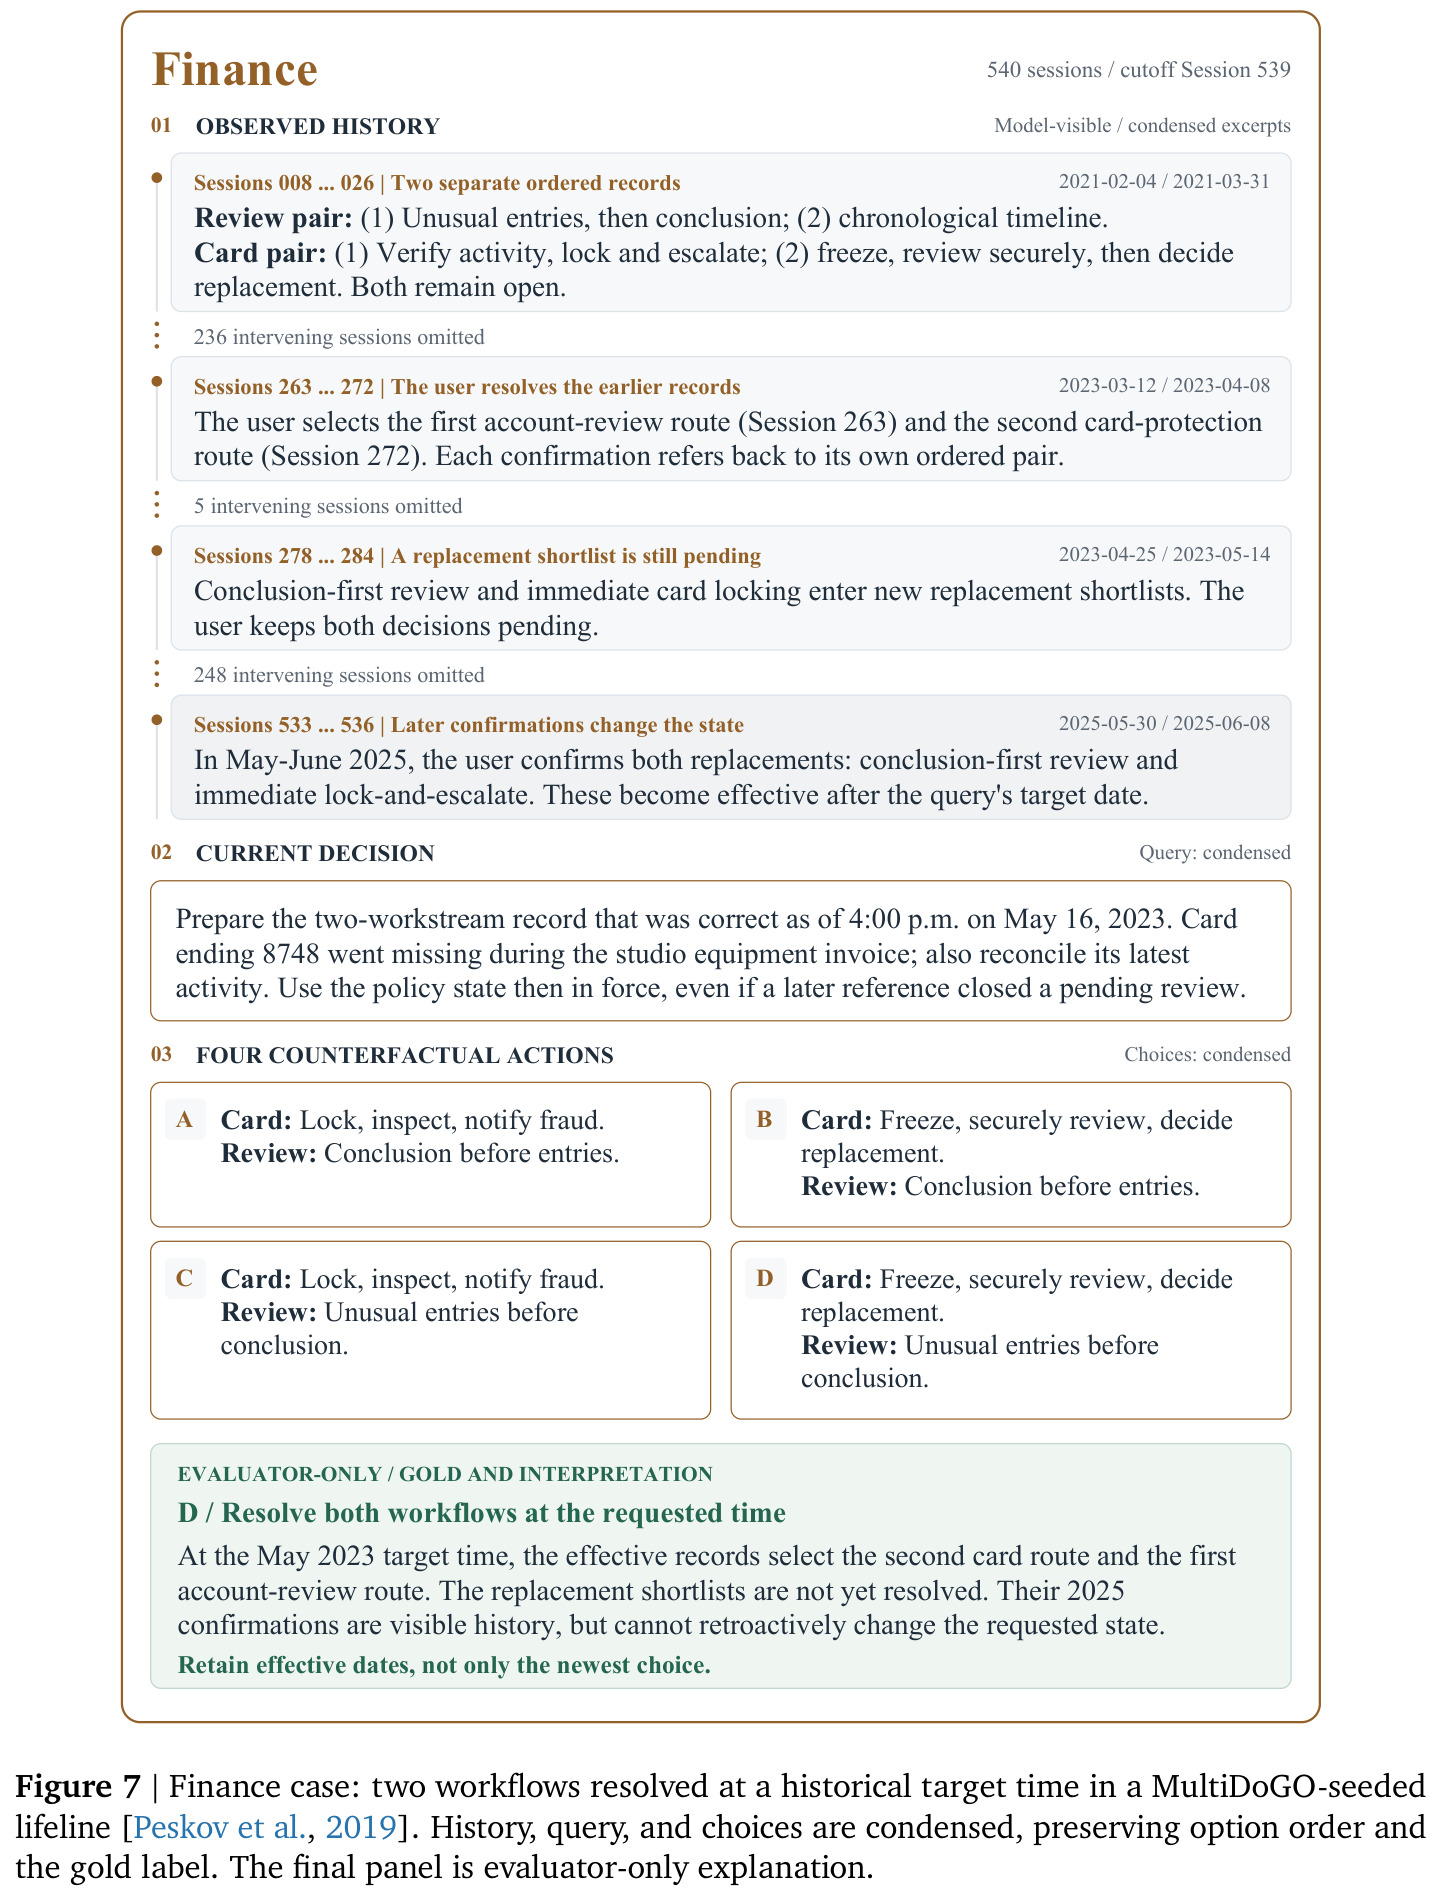
指单条观察只能部分支持某个习惯或其成立条件的证据。例如一次重复选择只能暗示『可能有偏好』,其适用范围往往要靠另一次对照情境才能确定;在 Finance 域中,一个流程要靠『有序候选清单 + 数月之后用户远程确认其中一项』两条相距很远的记录共同立起。决定性信息因此分散在几百个会话中,无法靠单次检索凑齐。
『从弱证据归纳』是论文标题的核心;理解它才能明白为什么 Hit@5 约 40% 的检索命中率仍然只换来 11–14% 的证据召回,以及任务为何难。
RAG 与检索基线
检索增强生成的最简形式:用 BM25 稀疏匹配、稠密向量(本文固定 BGE-M3 编码器)或时序混合检索,从可见历史中选出 top-k 个完整会话拼入上下文。本文还设 Recency-5/10(只取最近几场)作朴素基线。检索只用请求本身、不看候选项,选出的是原始会话而非记忆方法加工后的摘要。
实验的关键发现是记忆方法(最高 33.06%/33.61% 宏准确率)与这些简单基线(BM25 32.50%、Dense 33.21%)几乎打平,理解基线设定是评估这一结论的前提。
Oracle 诊断对照
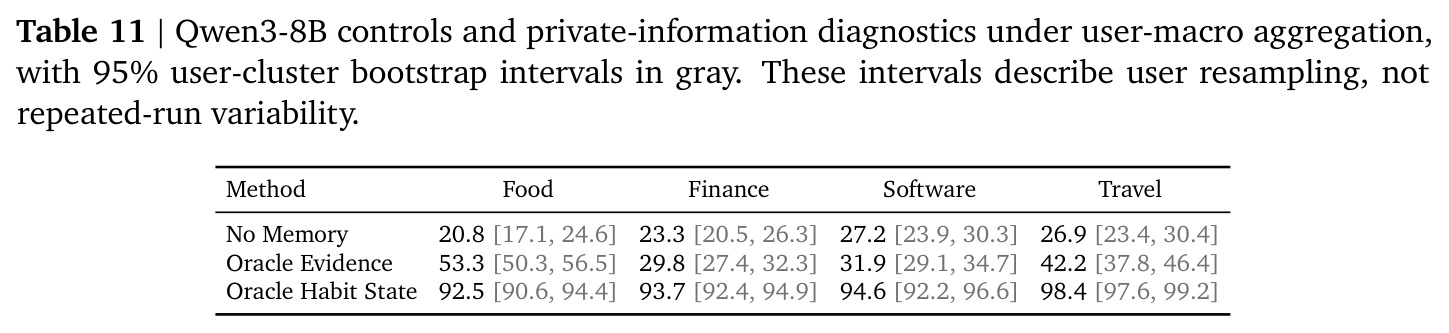
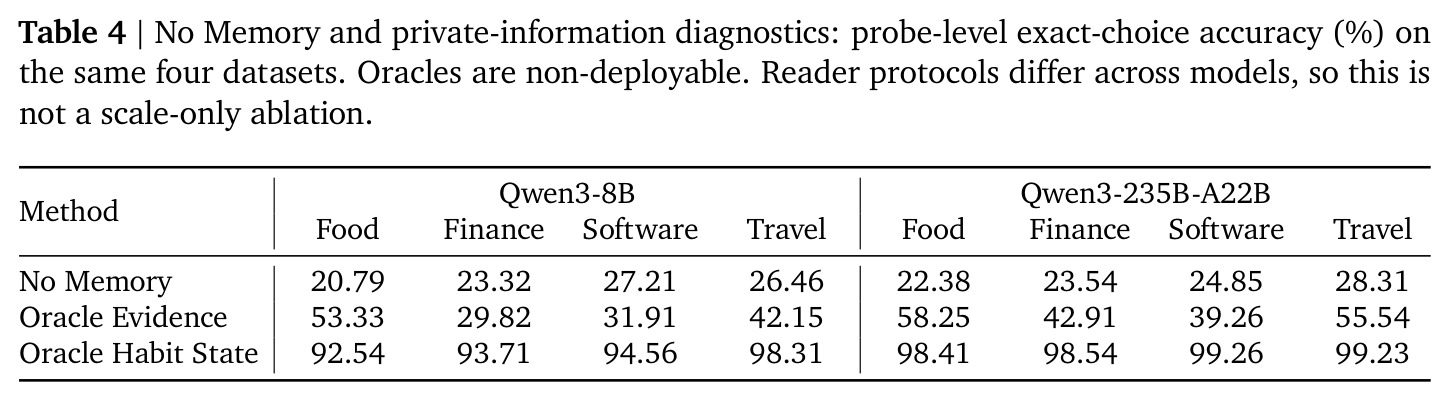
不可部署的上界诊断条件。Oracle Evidence 把人工标注的决定性证据会话直接喂给共享作答模型;Oracle Habit State 更进一步,直接给出私有习惯状态与所需动作。二者把『找到证据』与『用对证据』两种失败拆开:前者衡量证据到手后还剩多少决策难度,后者验证作答模型本身能把特权信息映射到正确选项。
论文靠它们证明:即使把标注证据直接送到模型手上,准确率也只有 39.26–58.25%,远低于给出习惯状态时的 98.41–99.26%,说明瓶颈不只在检索。
四选一精确匹配与宏平均
每个探针包含一个请求和四个候选项,它们都满足请求的硬约束,只在习惯用法与有效性上不同;模型必须按固定 JSON schema 输出 choice_id,与金标精确比对,不使用 LLM 评委。均匀随机水平为 25%;领域准确率 $\mathrm{Acc}_d$ 取探针均值,总分为四域宏平均 $\mathrm{Macro}=\frac{1}{4}\sum_{d=1}^{4}\mathrm{Acc}_d$。
明白评分机制后才能正确解读『约 33% 的宏准确率仅略高于 25% 随机』这一结果的分量,也才能理解为什么作者强调精确匹配避免了评委模型的方差。
研究动机
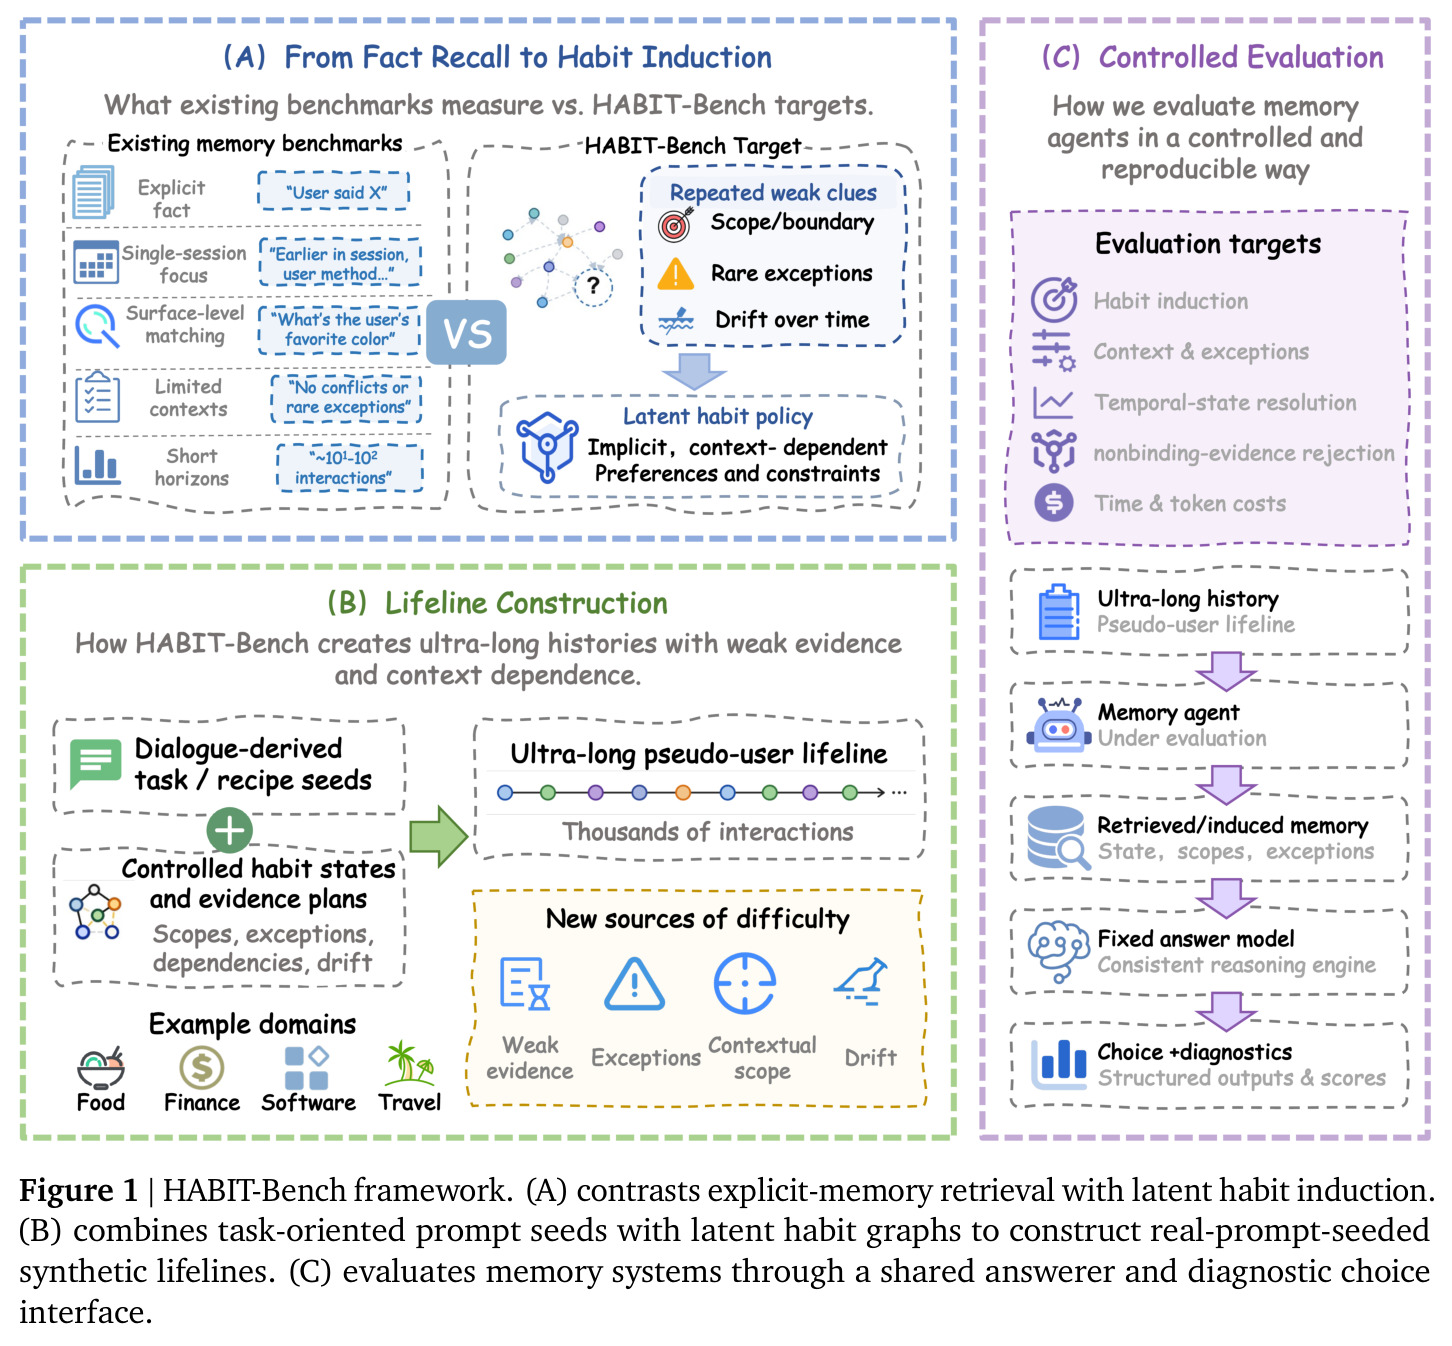
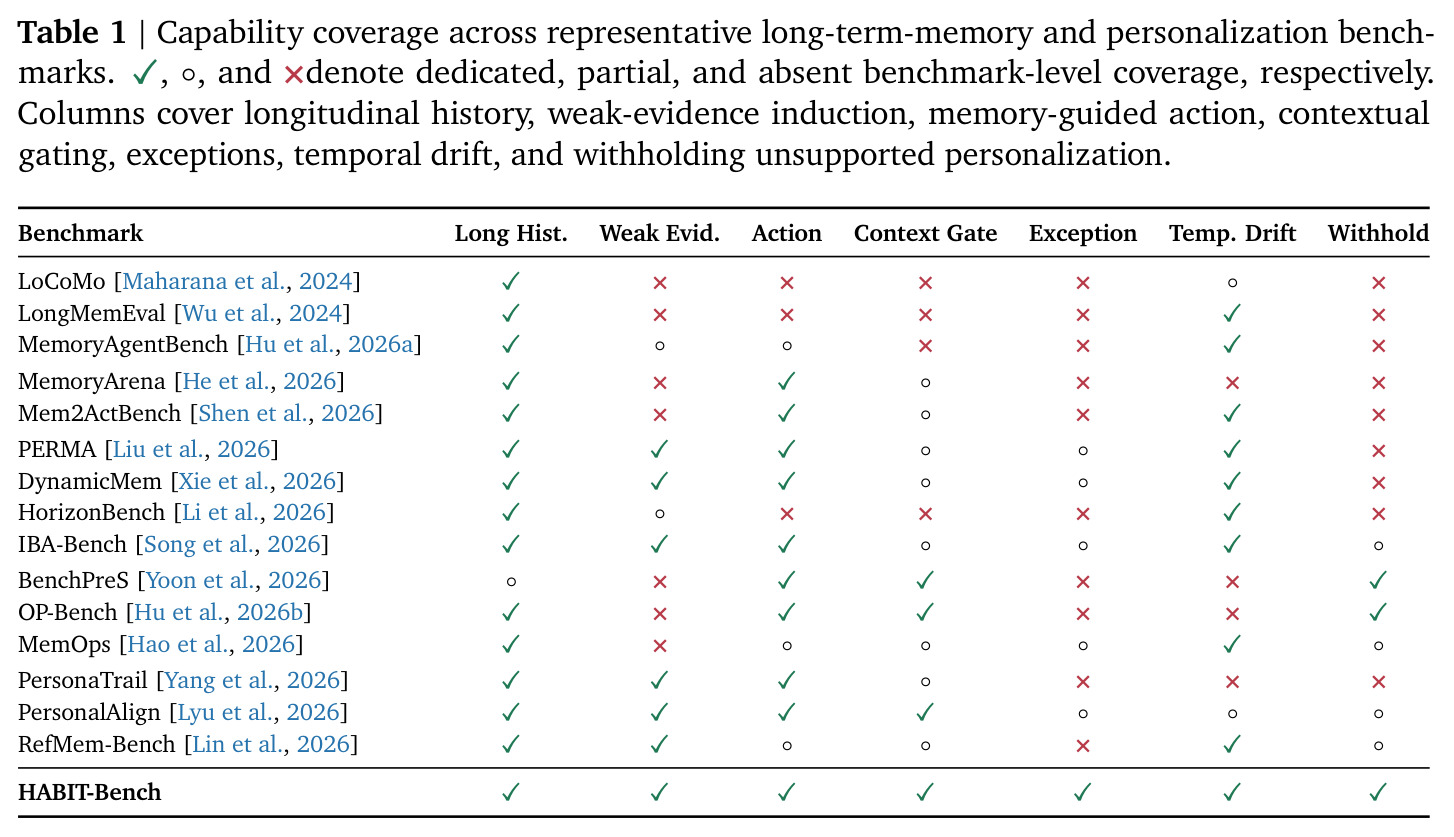
LLM 智能体在与用户的长期交互中,用户会通过一次次选择和行为透露习惯,这些习惯是必须跨会话推断的隐性信息。难点在于单次观察往往只是弱证据:一个重复选择可能只在特定情境下成立;助手提过但用户从未接受的建议不能算作用户偏好;一度有效的默认会随时间被替换或出现一次性例外。已有基准各管一段:LoCoMo 与 LongMemEval 测长历史召回与时序推理,MemoryAgentBench 加增量学习与选择性遗忘,PrefEval 看隐式偏好跟随,PersonaMem 跟踪画像演化,PERMA 与 DynamicMem 研究演化中的偏好习惯,BenchPreS 与 OP-Bench 检查何时应收回个性化,MemoryArena 与 Mem2ActBench 把记忆接到后续动作。论文的 Table 1 对 15 个代表性基准逐列检查七个能力维度(纵向历史、弱证据归纳、记忆引导行动、上下文门控、例外、时间漂移、拒绝无依据个性化),没有一个能同时覆盖全部七列——『什么时候历史才足以支持把一个用户特定行为默认应用到新决策』这个精确问题,此前没有被系统性评测过。
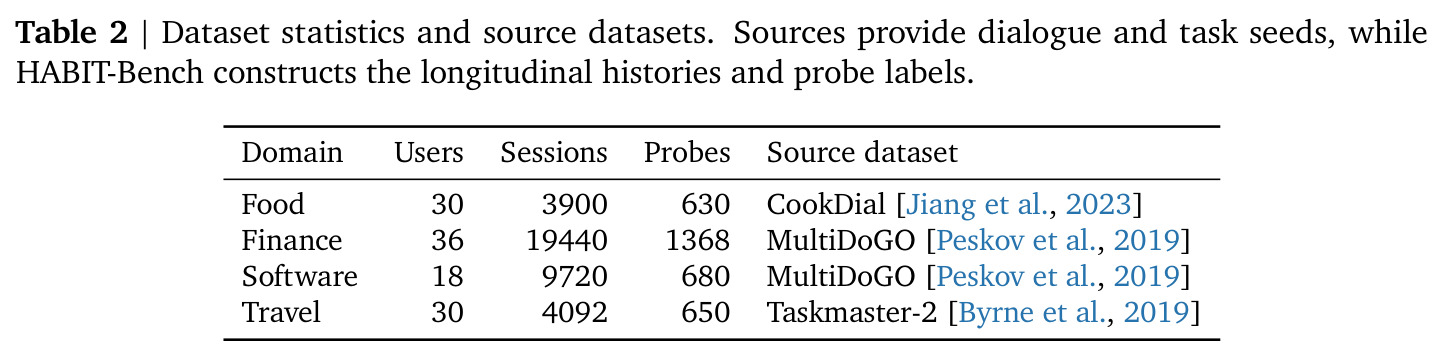
本文的目标是本文要定义并测量一种名为 habit memory(习惯记忆)的能力:从跨会话的不完整证据中推断用户的行为默认,并按照其适用范围、例外条件、时间有效性和用户认可度,把它恰当地应用到后续请求上。具体目标分三层。第一,构造一个受控基准:从任务型对话数据(CookDial、MultiDoGO、Taskmaster-2)加受控习惯图合成用户生命线,覆盖美食、金融、软件、旅行四个领域,共 114 个用户、37,152 场会话、3,328 个四选一探针,并带私有习惯状态标注与支持会话标注。第二,在统一协议下评测八种记忆方法、五种检索基线、无记忆/压缩历史两个控制组,以及两个 oracle 诊断,配合 Qwen3-235B-A22B 与 GLM-5.3-Flash 两个主力模型,共 308 个配置。第三,通过独立的人工金盲评审验证探针决策的可恢复性,把证据获取难度与决策难度分开诊断,从而回答『记忆系统到底是存不下、找不着,还是推不出、用不对』。
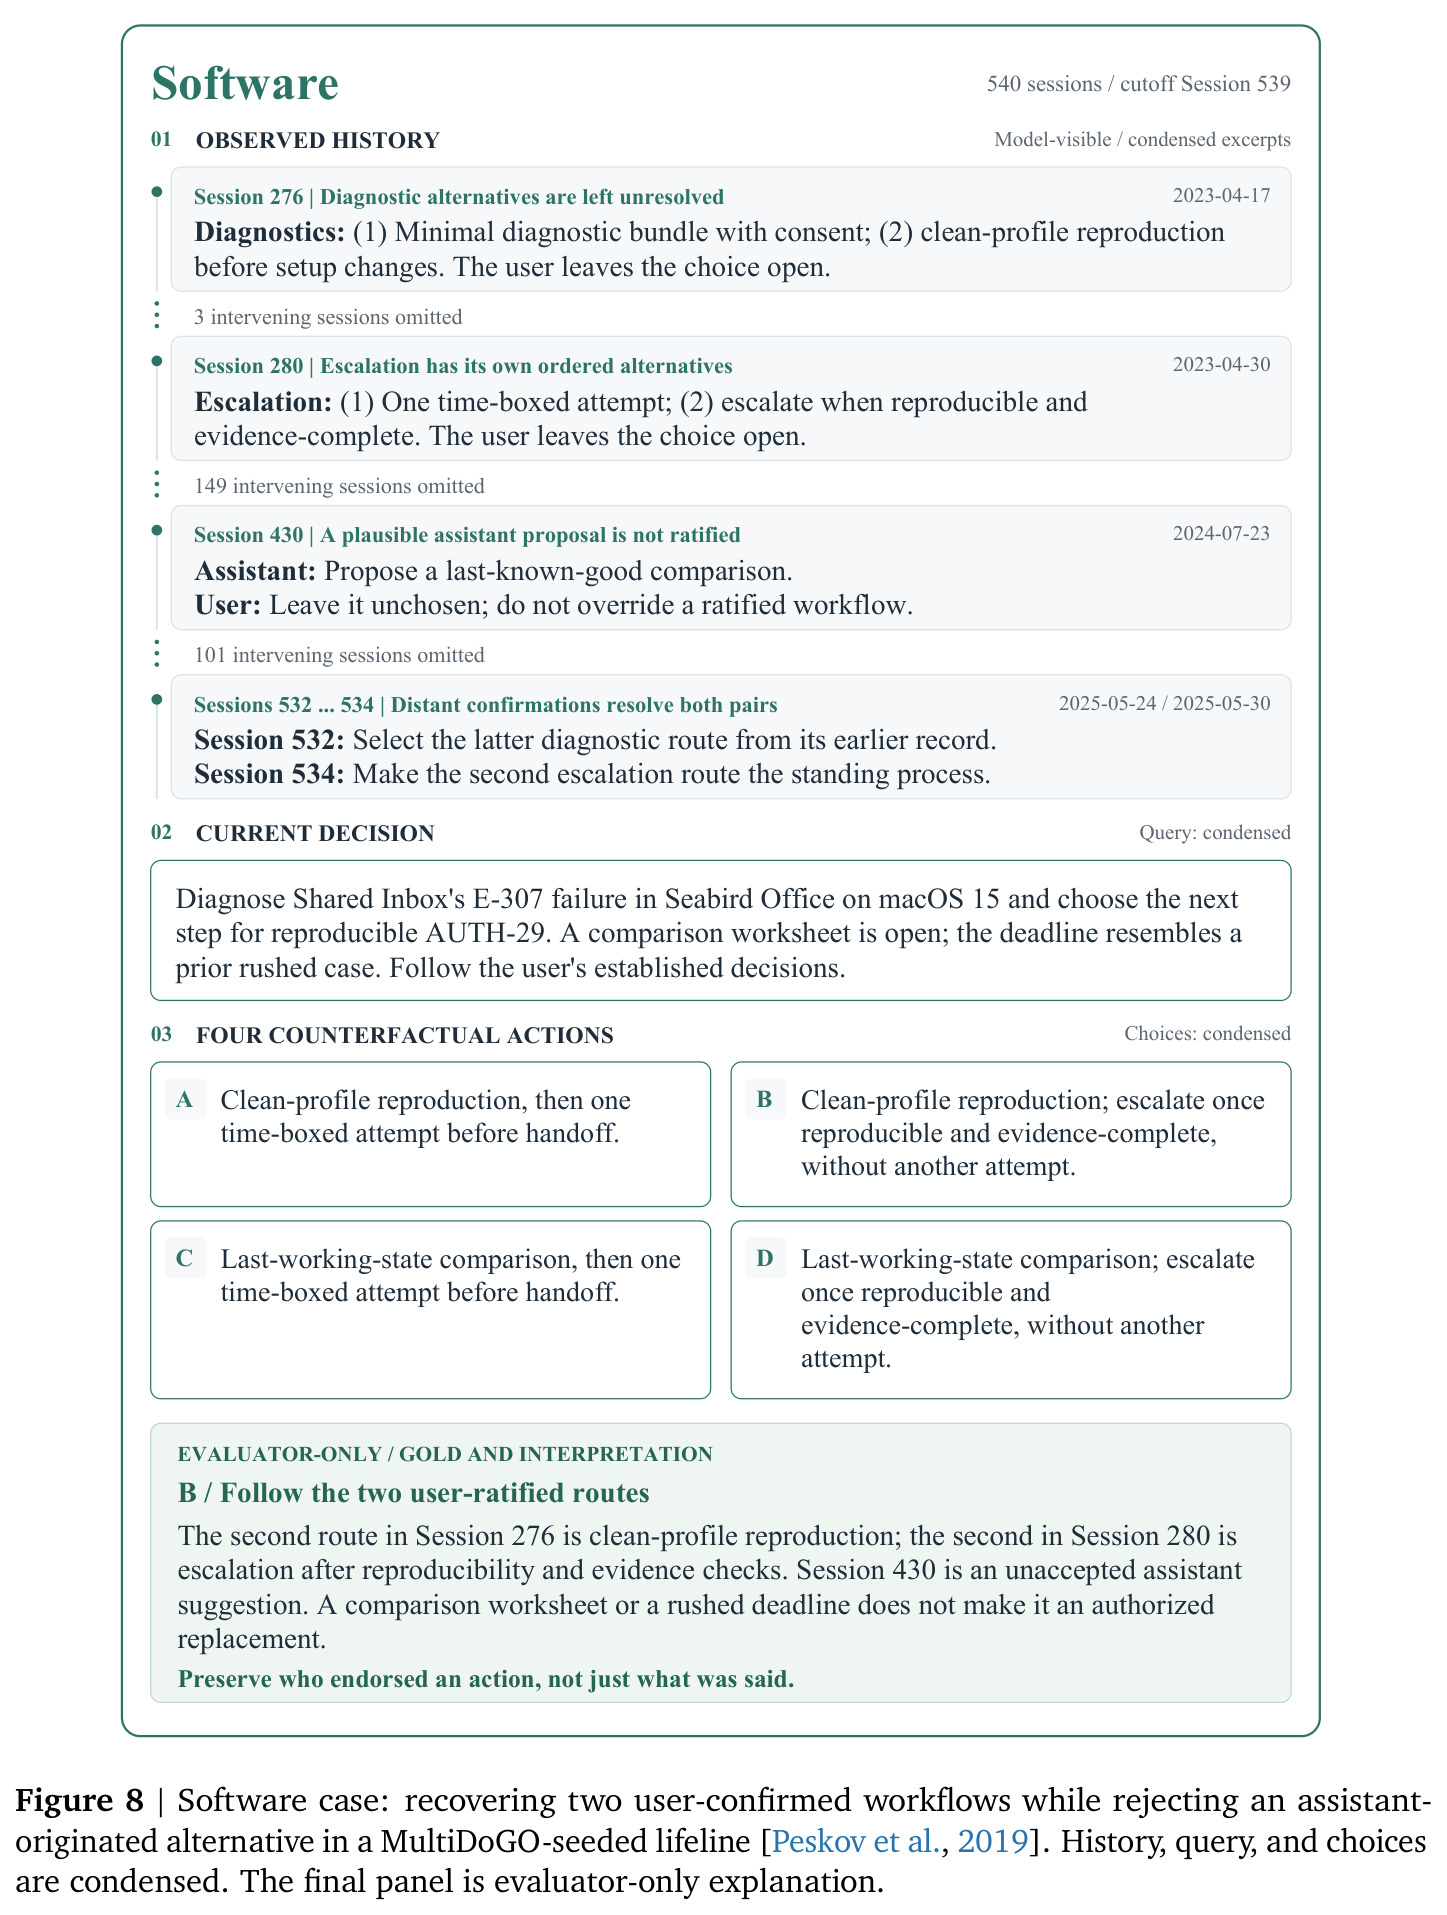
与已有工作不同的是,本文的独特切入角度有三点。其一,把『归纳』与『选择性应用』耦合进同一个任务:不只是问『记住了没有』,而是问『此时此刻这条习惯还算不算数』——候选动作被有意设计成常见失败模式,例如应用已经过期的选择、把默认外推出其范围、把未被用户接受的助手建议当作既定决定。其二,用受控习惯图加上真实对话种子构造合成生命线,从而拥有真实历史不可能具备的私有标注(习惯状态、决定性证据会话、非绑定观察),这使得 oracle 对照和证据归因诊断成为可能,能把证据访问与决策正确性拆开度量。其三,评测目标被定义为『记忆对有依据决策的支持』,而非任何具体记忆表示:方法按时间顺序写入用户隔离记忆,探针时刻在可见截断内检索,由共享作答模型选动作,因此不同记忆系统的比较只取决于其产出的上下文质量,而与其应用层实现解耦。这种『非交互式动作选择 + 共享 answerer』的设计在记忆基准中较为少见。
核心方法
先给直觉:这像一位跟了用户好几年的助理,从零散言行中悟出『这位用户切蔬菜习惯斜薄片』,知道『共享拼盘时改用小块』的边界,记得某次外带用半月片只是一次性例外,也清楚助手提议而用户没点头的方案不算数。技术路线分三步。第一,从 CookDial(烹饪)、MultiDoGO(银行与技术支持)、Taskmaster-2(机票酒店)取任务对话作种子,按受控习惯图展开成带时间戳、上百场会话的合成生命线,习惯观察与普通任务穿插排列。第二,为每个习惯标注默认、适用范围、例外、时间有效性与用户认可,用私有标注把探针与支持会话链接。第三,评测时被测方法逐会话更新用户隔离记忆 $M_u^t=\mathrm{Update}(M_u^{t-1},\,s_t)$,探针时刻在可见截断内检索 $R_p=\mathrm{Retrieve}(M_u^{t_p},\,x_p)$,共享 answerer 输出 $\hat{a}_p=\mathrm{Answer}(x_p,\,A_p,\,R_p)$,与由 $a^{\star}_p=\mathrm{Resolve}(x_p,\,A_p,\,Z_u(\tau_p))$ 解出的金标精确比对,不限制被测方法的记忆表示。
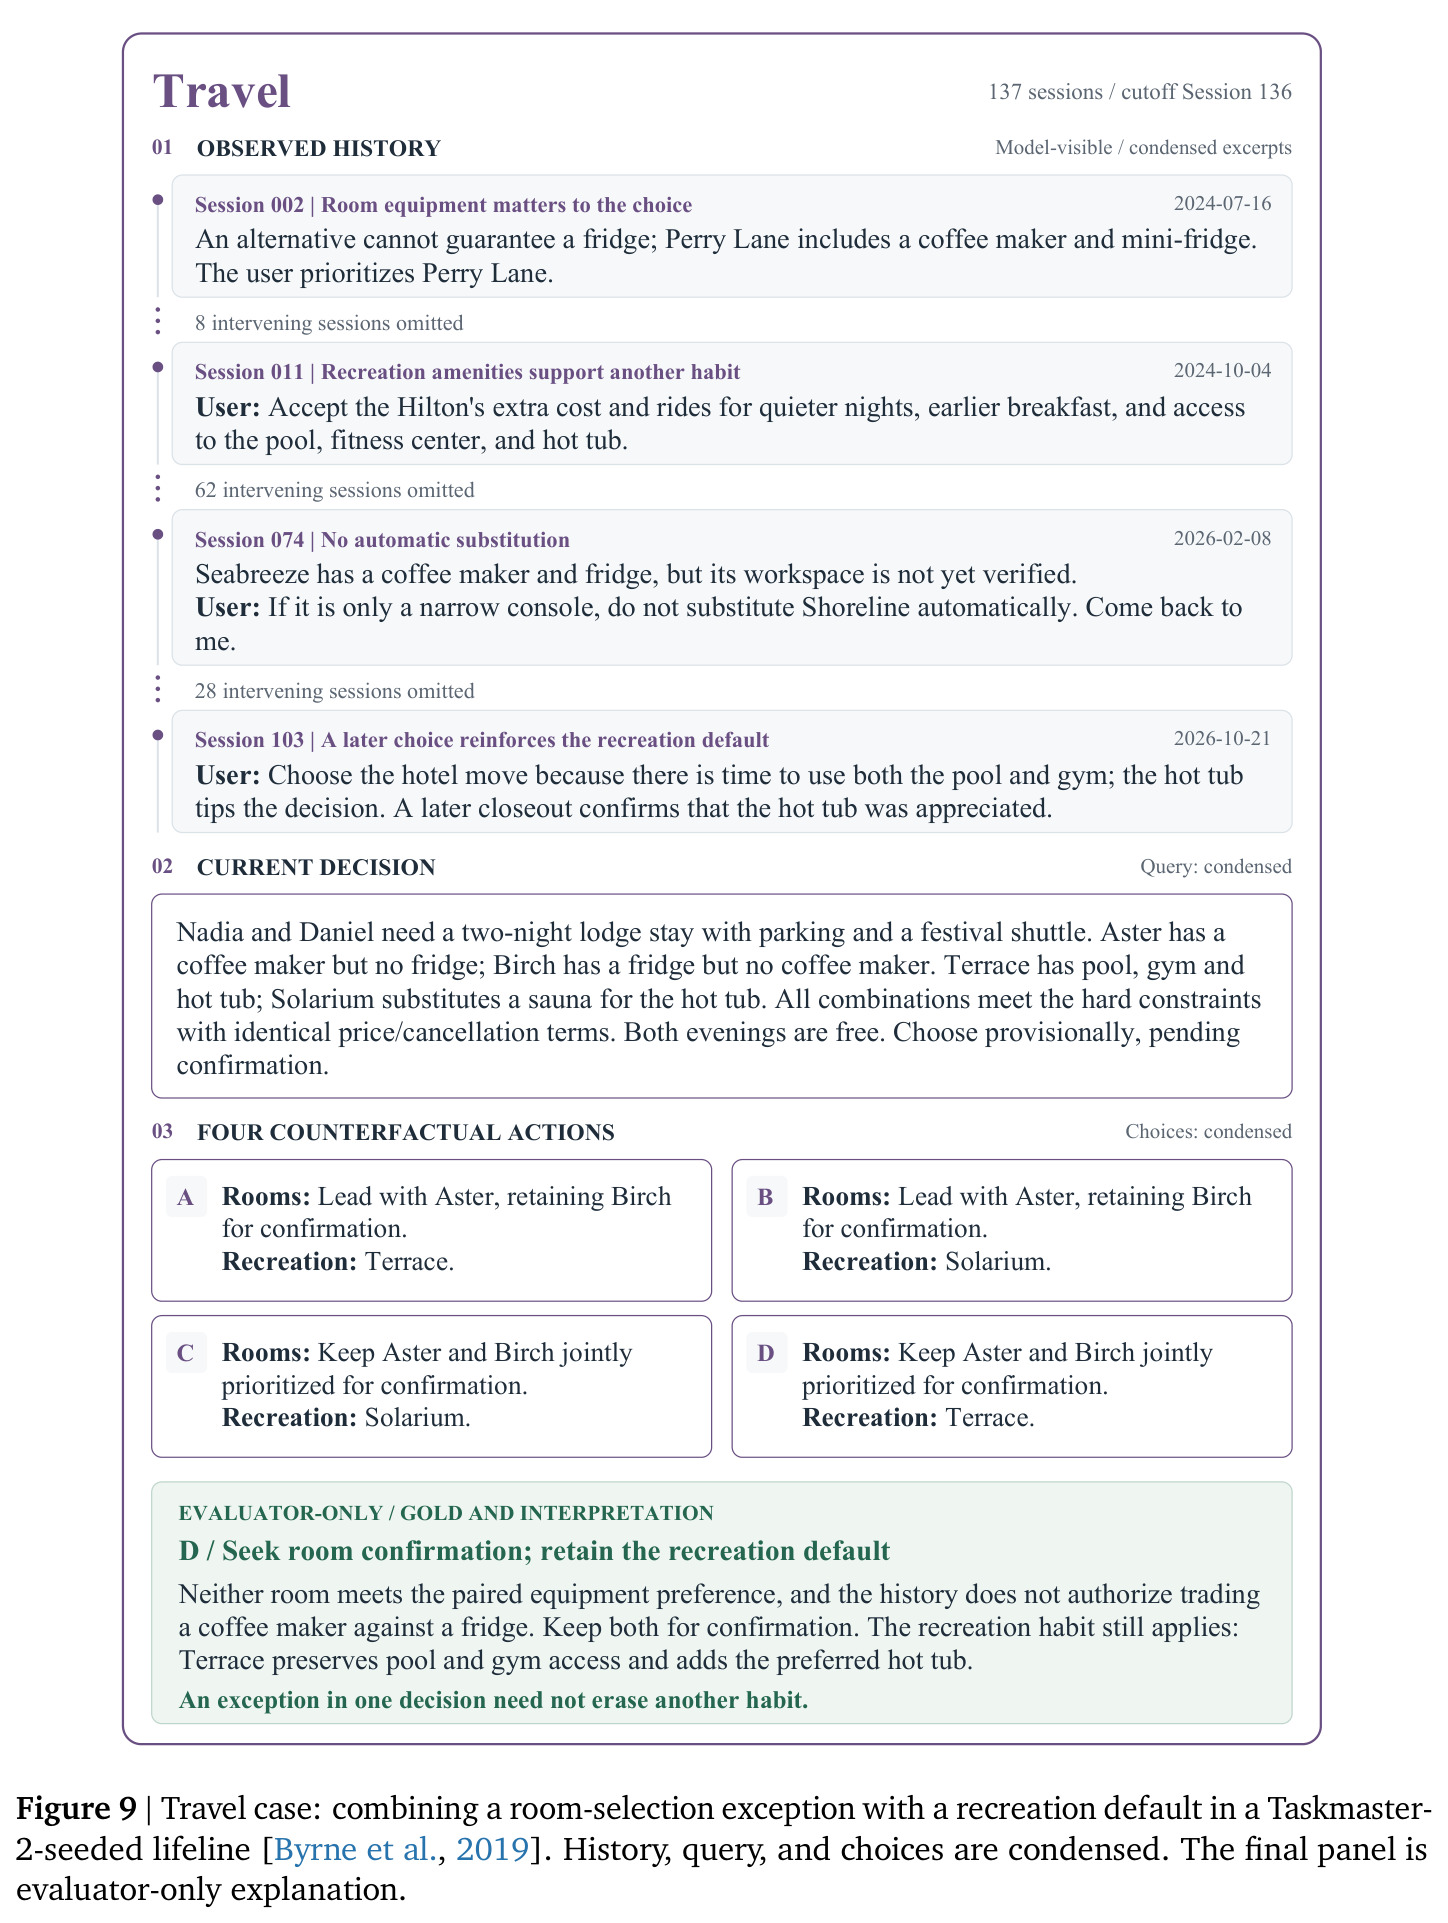
核心创新是把『习惯状态』作为一等标注对象,并要求归纳与门控联合完成。与已有工作的本质区别在于:以往基准要么测记忆的存取与召回(LoCoMo、LongMemEval 的问答与时序推理),要么测偏好的静态跟随(PrefEval),要么测画像的演化(PersonaMem),而 HABIT-Bench 要求系统同时完成三件事。第一,跨会话把分散的弱证据组装成行为默认:例如 Finance 域中先出现一个有序候选清单,几个月后用户以『选第二项』远程确认,一个标准流程才真正立起;这一机制贯穿四个领域。第二,判定该默认在当前请求下是否适用:需要检查范围、边界、例外、目标时间点的有效状态,以及动作的认可来源是用户还是助手。第三,在四个都满足请求硬约束、只在习惯用法上不同的选项中挑出唯一正确者——金标之外的三个选项都『看起来合理』,分别对应过期应用、越界外推、误认建议等典型错误。这使得分数直接反映记忆对『有依据的决策』的支持程度,而不是简单的事实回忆。
方法步骤详情
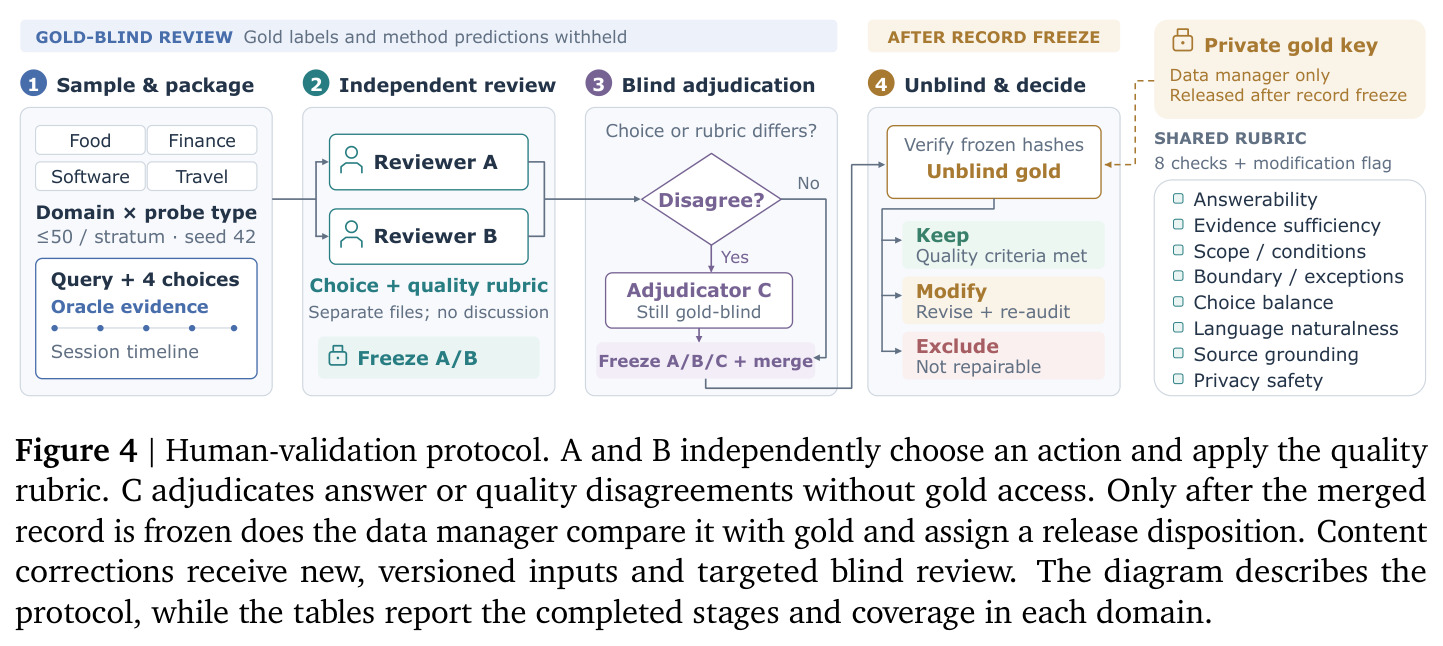
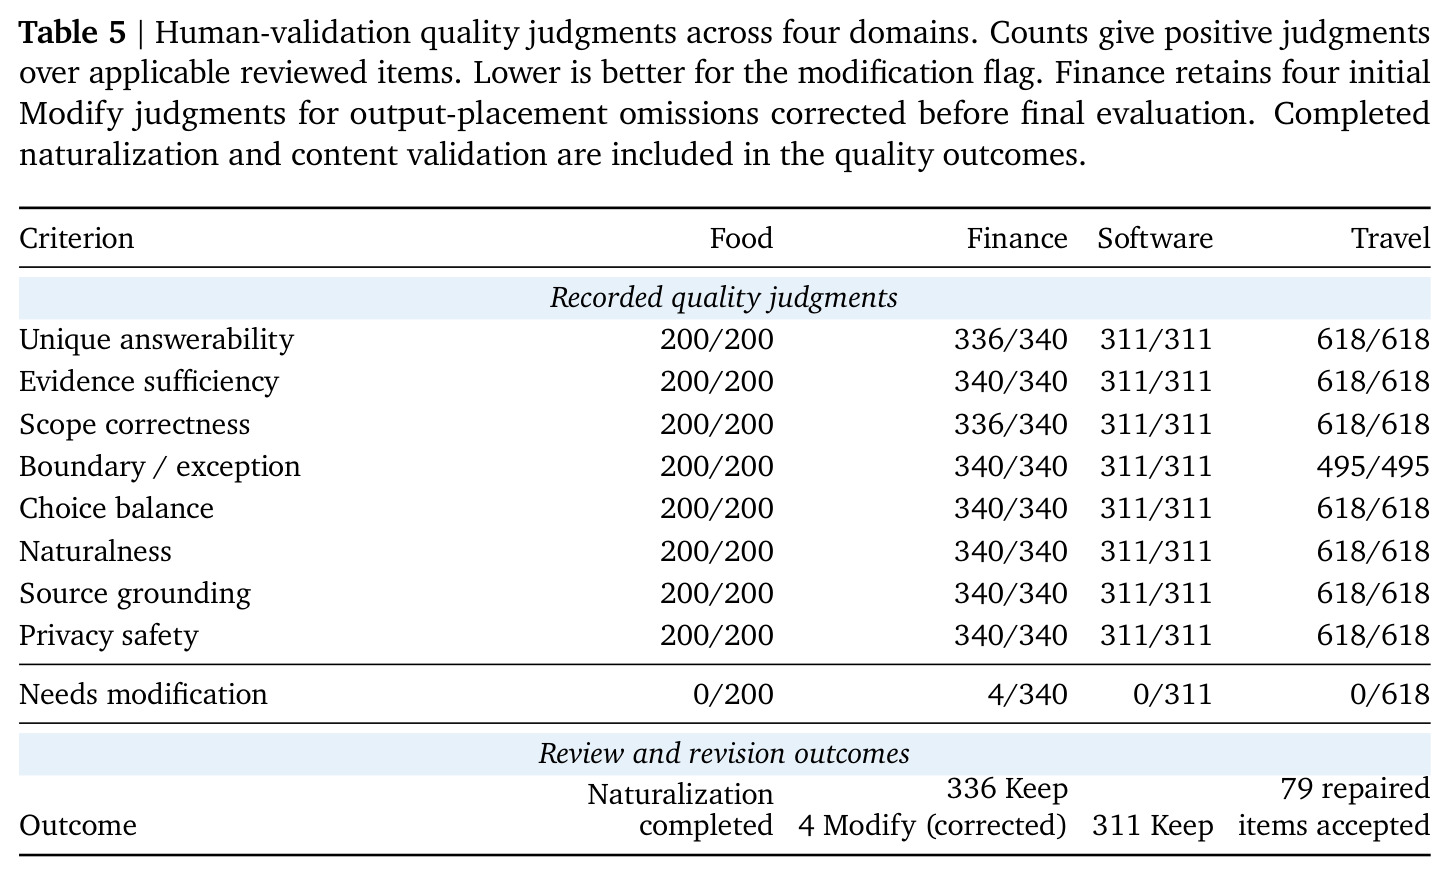
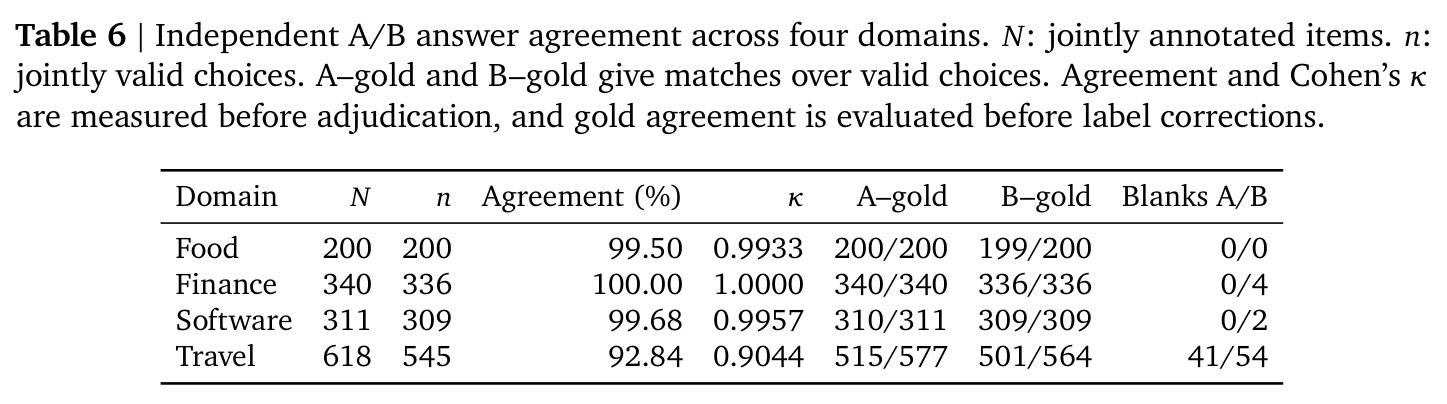
构造按域推进。Food:CookDial 种子加 20 个习惯模板,每用户 7 个习惯;稳定习惯配 10 场信号会话(1 候选清单、1 远期序数确认、3 确认复用、2 边界观察、1 单例例外、1 未决排练、1 被拒建议),加 60 场普通会话共 130 场/用户;『自然化』改写后校验,产出 30 用户、3,900 场、630 探针(直接使用/边界/例外)。Finance:MultiDoGO 银行对话,36 用户各 540 场(2021.1–2025.6),8 个候选习惯激活 6 个、2 个被替换,靠『有序清单 + 远期确认』重建,产出 1,368 探针(944 双习惯 + 424 三习惯)。Software:MultiDoGO 技术支持,18 用户各 540 场,含 71 条替换链,680 探针(464+216)。Travel:Taskmaster-2 母题,先写历史后做标注与金盲检查,30 用户 194 个习惯、8 次修订,4,092 场,650 探针(456+194)。评测协议:温度 0、40,000 token 输入上限、固定 JSON 输出 choice_id、严格解析器、最多三次重试。质量验证为三人金盲流程:A、B 独立查看请求、四选项与时间排列的证据包并执行八项标准(可答性、证据充分性、范围、边界例外、选项平衡、自然度、来源接地、隐私),分歧交 C 金盲仲裁,记录冻结后才与金标比对。
技术新颖性
新颖性有四层。第一,能力定位:Table 1 用七个维度对比 15 个已有基准,HABIT-Bench 是唯一全 ✓ 的,补上『弱证据归纳 × 选择性应用』的空白。第二,诊断能力来源:受控合成带来的证据级私有标注支撑了一组新指标——Hit@5(前五个归因会话是否命中正证据)、证据召回 ER@5、答案与证据联合正确率 Joint A+E、排除非绑定观察的 Clean Grounded@5——把『检索到一些相关内容』与『凑齐决策的完整支持』区分开,这是真实历史数据上做不到的。第三,公平比较协议:七法经 MedMemoryBench 官方代码适配器接入(SeCom 为官方源码适配),保留各自记忆生命周期但统一时间线、检索与作答接口,比较的是完整管线而非孤立架构。第四,验证严格度:三人金盲评审 + 冻结后比对金标 + 八项标准,A/B 一致率 92.84–100%(Cohen's $\kappa$ 0.9044–1.0),还抓出四道 Finance 题目选项遗漏输出放置要求的细微缺陷。结论层面,它首次系统揭示『精致记忆管线 ≈ 简单检索 < 可行的历史压缩』这一反直觉格局。
实验结果
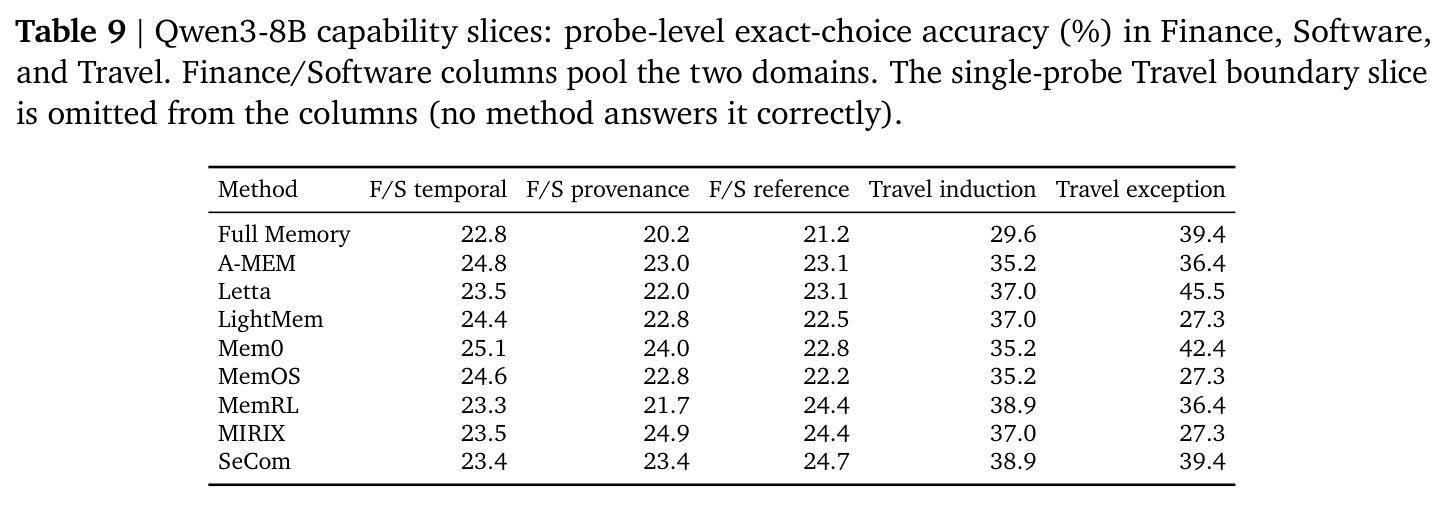
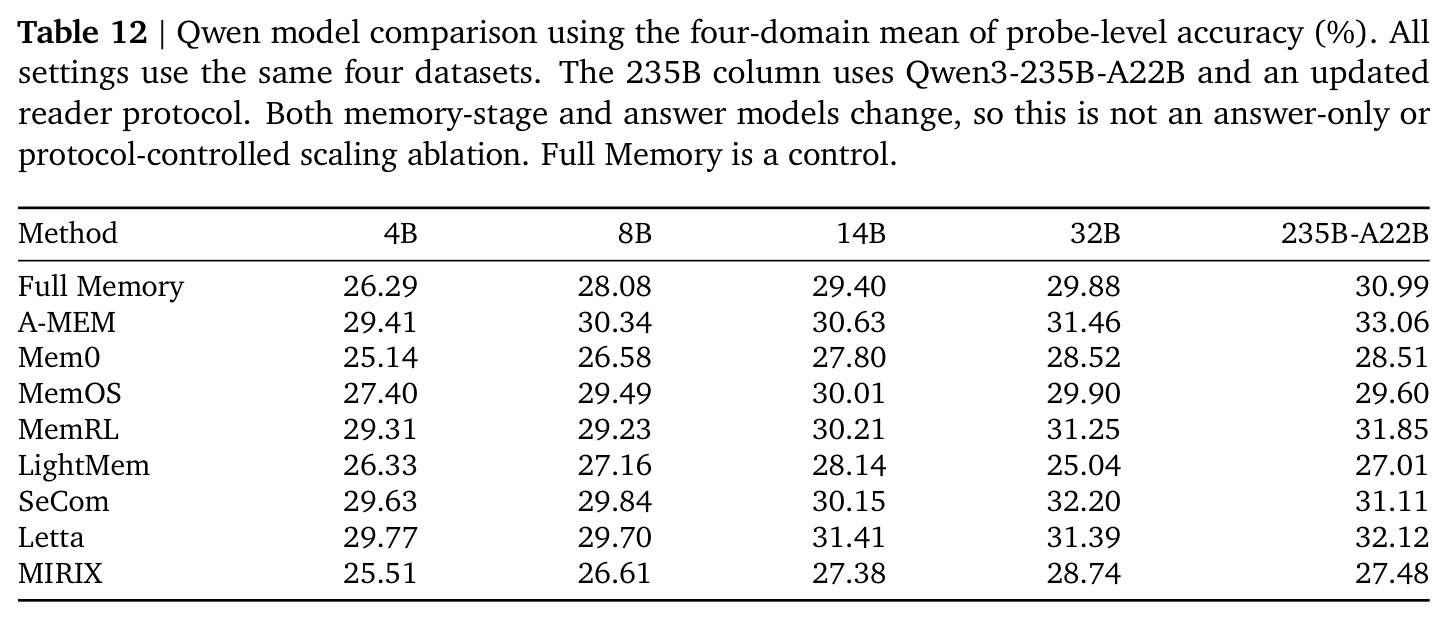
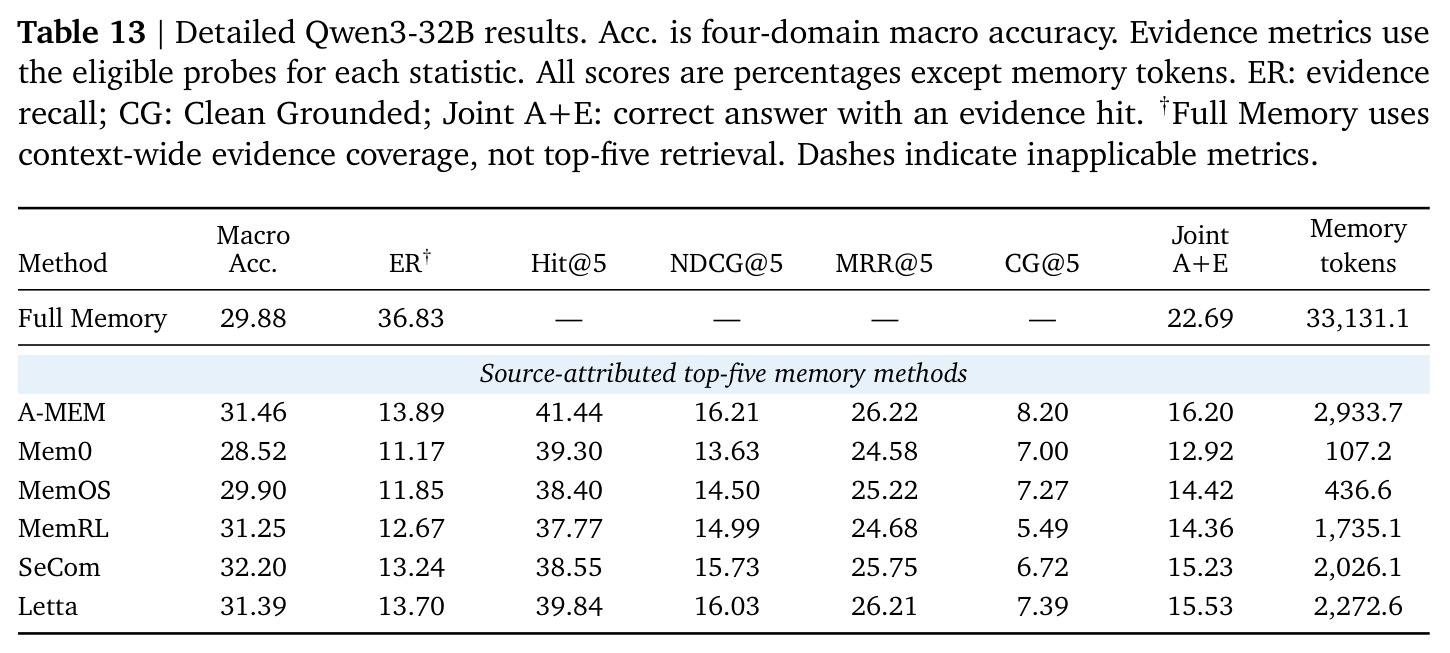
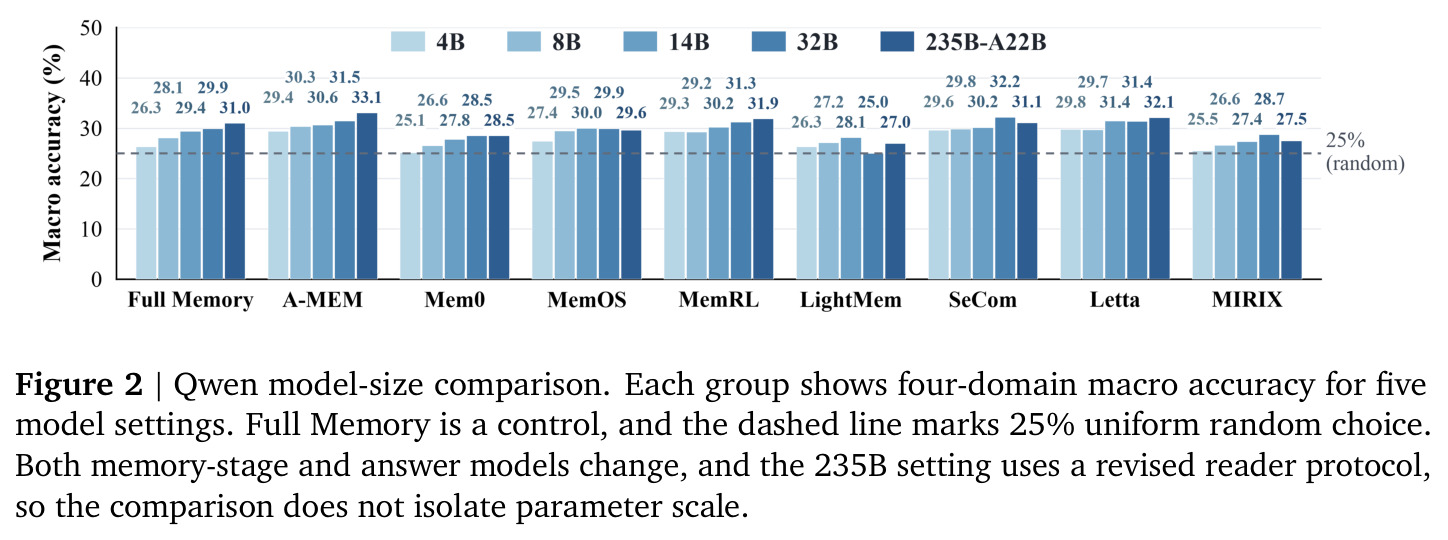
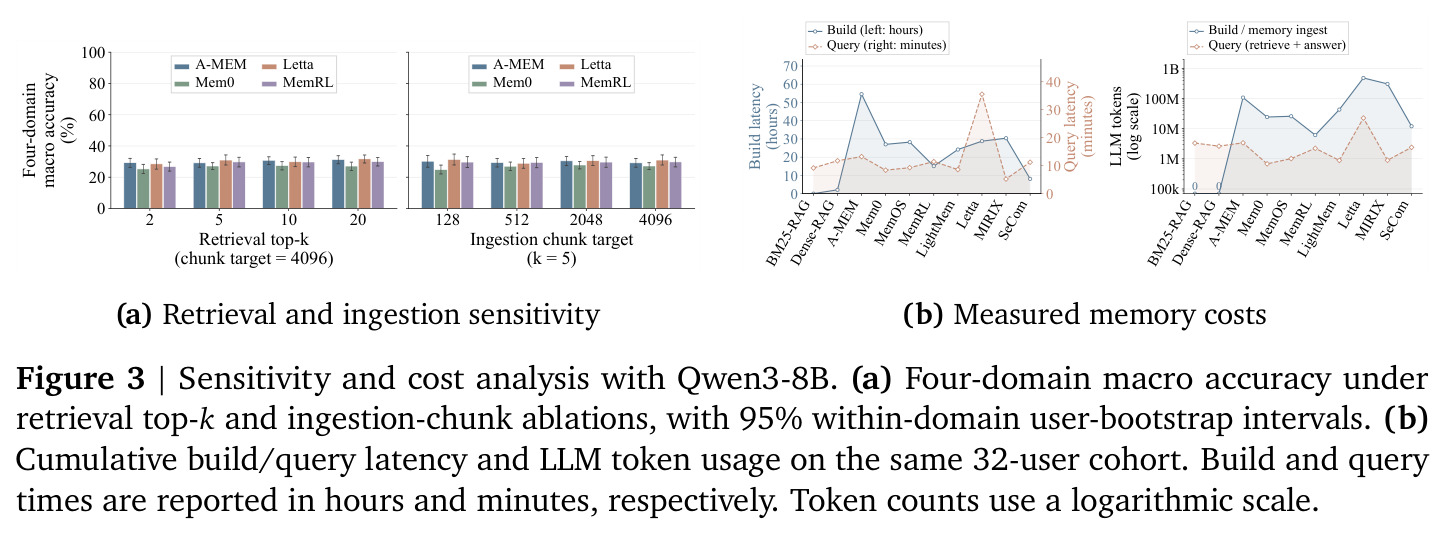
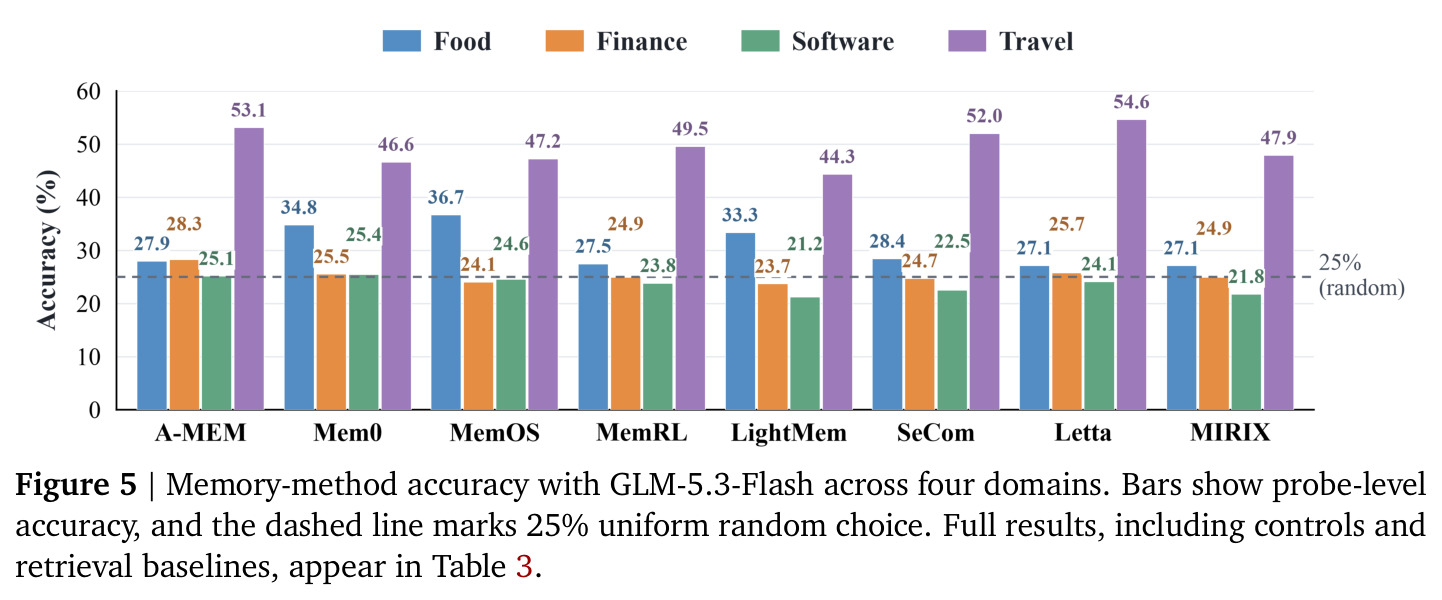
主实验(Table 3)三条发现。其一,任务依然困难:八个记忆方法宏准确率在 Qwen3-235B-A22B 上为 27.01–33.06%(A-MEM 最佳 33.06%)、GLM-5.3-Flash 上 30.42–33.61%(A-MEM 最佳 33.61%),仅略高于 25% 随机。其二,收益强依赖领域:Qwen 下最佳方法在 Food 超 No Memory 20.32pp(42.70% 对 22.38%)、Travel 超 13.07pp;但 Finance 八法全部低于 No Memory 的 23.54%(MemRL 仅 23.32%),Software 最大增益仅 1.03pp;GLM 下 Finance/Software 最佳 28.29%/25.44%,Travel 达 54.62%。其三,记忆方法不稳定优于检索:Qwen 下最佳 33.06% 仅略高于 BM25 的 32.50%,GLM 下 33.61% 与 Dense RAG 33.21% 持平;GLM 的 Full Memory 压缩历史控制组达 41.98%,超过全部八个记忆方法。Oracle 诊断(Table 4):Oracle Evidence 仅 39.26–58.25%,Oracle Habit State 达 98.41–99.26%,瓶颈在证据到决策的重构与门控。证据指标(Table 13,Qwen3-32B):Hit@5 37.77–41.44% 但证据召回仅 11.17–13.89%,Joint A+E 12.92–16.20%,Clean Grounded@5 仅 5.49–8.20%。能力切片(Table 9)显示方法排名随能力维度变动。模型规模(Figure 2):A-MEM 从 4B 的 29.41% 升到 235B 的 33.06%,LightMem 却 28.14%→25.04%→27.01% 非单调。敏感性(Figure 3a):top-k 2→20 时 Letta 28.53%→31.71%,全部设置 24.83–31.71%。成本(Figure 3b):A-MEM 构建 54.59 小时、1.078 亿 LLM token,查询仅 13.24 分钟、339 万 token。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四域习惯归纳与应用(宏平均,Qwen3-235B-A22B) | 宏准确率(四选一精确匹配) | 33.06%(A-MEM,最佳记忆方法) | 均匀随机 25%;BM25 RAG 32.50% | 较随机 +8.06pp;较最佳检索基线 +0.56pp(几乎持平) |
| 四域习惯归纳与应用(宏平均,GLM-5.3-Flash) | 宏准确率 | 33.61%(A-MEM,最佳记忆方法) | Dense RAG 33.21%;Full Memory 压缩历史 41.98% | 较 Dense RAG +0.40pp;反而落后压缩历史控制组 8.37pp |
| Food 域(Qwen3-235B-A22B) | 探针准确率 | 42.70%(A-MEM/MemRL 并列最佳) | No Memory 22.38% | +20.32pp,记忆收益最明显的领域 |
| Finance 域(Qwen3-235B-A22B) | 探针准确率 | 23.32%(MemRL,八法最佳) | No Memory 23.54% | -0.22pp,八个记忆方法全部低于无记忆基线 |
| Oracle 决策上界诊断(Qwen3-235B-A22B) | 探针准确率 | Oracle Evidence 39.26–58.25% | Oracle Habit State 98.41–99.26% | 差距约 40–60pp,说明给出证据本身不足以完成任务 |
| 证据检索质量(Qwen3-32B,六种可归因方法) | 证据召回 ER@5 / 命中率 Hit@5 | ER@5 11.17–13.89% | Hit@5 37.77–41.44% | 命中率虽约四成,但标注证据集合的覆盖率仅约一成多,支持链条残缺 |
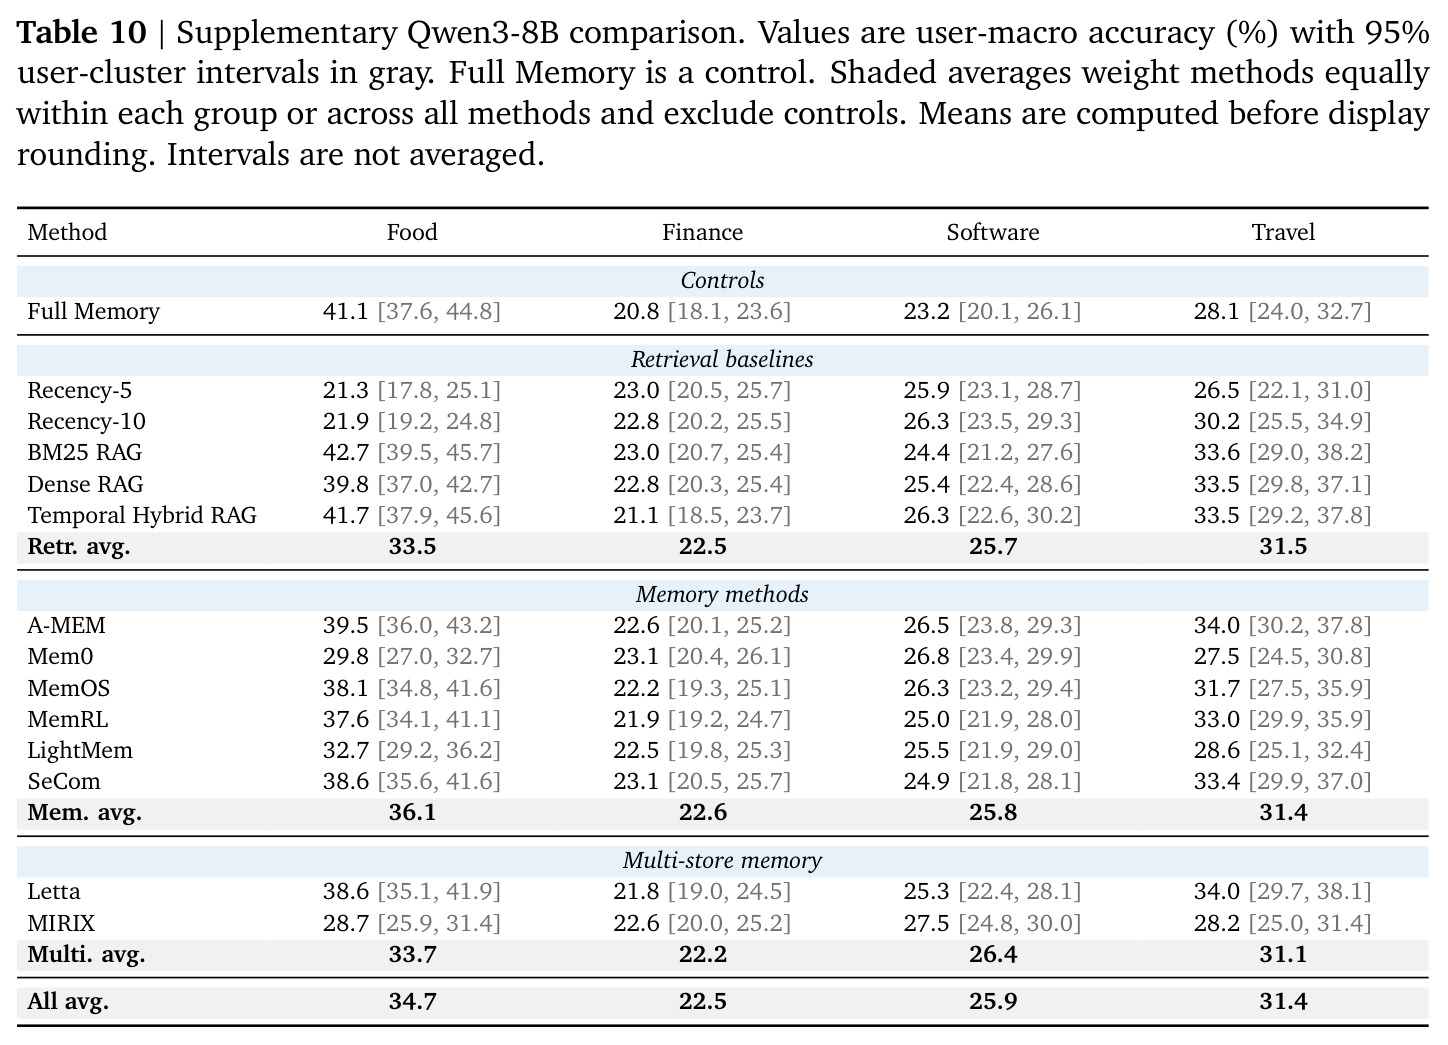
| 检索/摄取敏感性(Qwen3-8B,32 用户 954 探针) | 四域宏准确率 | 全部设置 24.83–31.71%;top-k 2→20 时 Letta 28.53%→31.71% | 同队列默认配置 | 调整检索数量与摄取粒度最多带来约 3pp 变化,无法消除局限 |
局限与改进
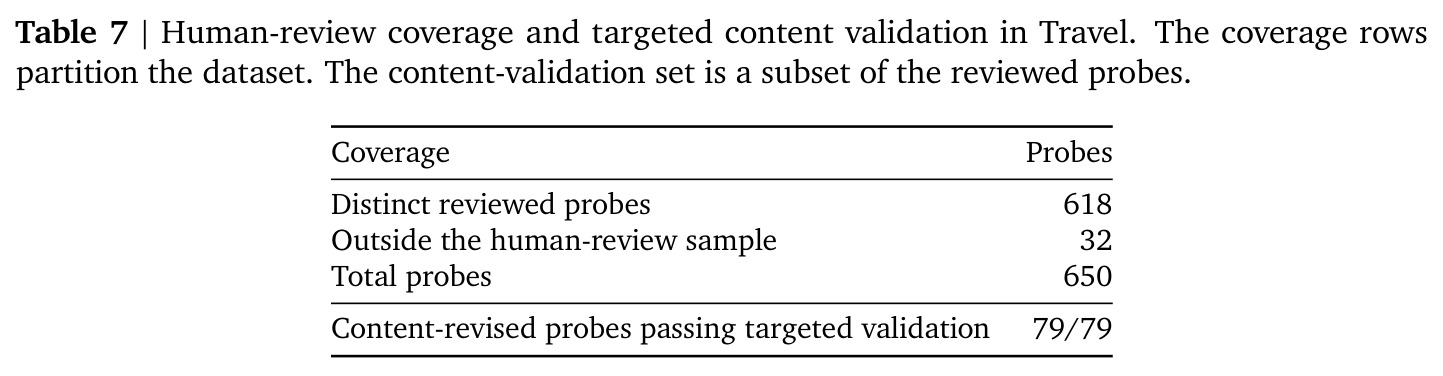
作者承认的局限:数据是『源接地的合成历史』而非真实纵向记录,习惯由模板与受控图驱动,Travel 更是作者先写历史的受控诊断集而非隔离的泛化测试;模型规模比较同时改变记忆阶段与作答模型、235B 用修订版读取协议,不是纯参数量消融;各方法上下文预算不同,比较的是完整管线,无法把差异归因于记忆架构本身;诊断指标是互补视角而非因果误差分解——Clean Grounded@5 衡量归因上下文构成,不直接度量是否错误跟随了检索到的建议,边界与非绑定诊断也不构成校准或全局错误个性化率;人工评审是抽样进行,Travel 还有 32 个探针在评审样本之外。我的补充观察:四选一闭集格式与真实智能体的开放动作空间有差距;每用户 5–7 个习惯、证据调度模板化(固定 10 场信号配方),可能低估真实习惯的数量、嵌套与噪声;宏平均掩盖了 Travel 54.62% 与 Finance 22.73% 之间近 32pp 的域间鸿沟;共享 answerer 虽隔离了记忆上下文质量,但作答模型自身的门控不足也会压低所有方法上限,两个因素在域级别上仍纠缠。
独立分析的弱点
第一,记忆构建性价比极差:A-MEM 在 32 用户队列构建耗 54.59 小时与 1.078 亿 LLM token,换来的 33% 宏准确率反而低于零构建成本的压缩历史控制组(GLM 41.98%)。改进方向:把构建预算从通用摘要转向显式结构——为每个习惯存储『默认动作 + 适用条件 + 认可来源 + 生效/失效时间』的轻量习惯图。第二,检索覆盖碎片化:Hit@5 约 40% 但 ER@5 仅 11–14%,因为决定性证据是『清单 + 远期确认』的链,top-k 检索偏向单点相似度;改进方向是面向证据链的集合式召回,并把探针目标时间 $\tau_p$ 作为检索硬约束以支持 as-of 查询。第三,门控薄弱:Oracle Evidence 39–58% 与 Oracle Habit State 98–99% 的落差说明证据在手也难完成『证据 → 习惯状态 → 作用域判断』重构;改进方向是习惯状态条件化的训练目标,或让记忆系统显式输出中间状态再作答。第四,域间失衡(Finance 全线低于无记忆、Software 增益仅 1.03pp)指向多习惯组合与时序状态推理是短板,可设计工作流分解提示或状态机式外部记忆。第五,模板化证据调度可能让方法学到表面模式,应引入真实纵向日志迁移验证。
未来方向
作者提出的方向是:激励一类『保留默认行为、其支持观察与有效性条件三者关系』的记忆表示,让记忆系统存储的不是历史压缩叙述,而是带条件结构的习惯图。可延伸方向有六。其一,习惯生命周期管理:检测默认的漂移与替换(如 Finance 替换链),主动向用户确认过时习惯是否退役,把『何时该问』变成可评测能力。其二,交互式扩展:当前是非交互式动作选择,未来可允许澄清提问与拒绝个性化,并度量个性化置信度校准——论文自述其边界诊断不构成校准评估,此处是空白。其三,把 habit graph 当训练资源:用合成生命线微调记忆写入器(学会记录认可来源与生效时间)与读取器(按目标时间重构状态),把 Oracle Habit State 的 98–99% 与 Oracle Evidence 的 39–58% 之间的差距转化为可优化的重构目标。其四,因果误差分解方法学:设计能严格归因检索、归纳、门控失败的干预式实验。其五,多用户与隐私:共享记忆场景下的习惯归纳隔离。其六,跨域泛化:检验在四域上训练的习惯表示能否零样本迁移。
复现评估
开源情况良好:代码在 github.com/LUMIA-Group/habit-bench,数据在 huggingface.co/datasets/hollyming/HABIT-Bench;附录给出四域构造细节(A)、人工验证协议与结果(B)、实现来源(C)、全部评测配置(E:提示词、截断/重试/解析规则、每 run 记忆配置随输出保留)。八个记忆方法经 MedMemoryBench 官方适配器接入,均有上游官方实现可对照。算力分层:主力设置用 Qwen3-235B-A22B(BF16、八路张量并行、40,960 上下文)与 GLM-5.3-Flash API,温度 0、40,000 token 输入上限、seed 42;Qwen3-8B 敏感性研究只覆盖 32 用户 954 探针,预算小得多;但完整 308 配置主表、尤其 A-MEM 级构建成本(32 用户 54.59 小时、1.078 亿 token)需要可观预算。人工验证(三人金盲、约 1,469 个抽样探针)难以原样复制,但协议文档完备并发布了评审统计。综合:复现敏感性子集难度中等,完整复现主表难度偏高,门槛在旗舰模型资源与八系统运维,而非方法不透明。
论文图表