DuoLM:基于语言模型的快速高效个性化推荐框架 DuoLM: Fast and Effective Personalized Recommendation with Language Models
编码器离线压缩物品为单向量、排序器在线个性化打分,共享前缀推理使吞吐达全文教师60倍。
前置知识
双塔模型与交叉编码器
双塔模型用两个独立编码器分别编码用户和物品,靠点积打分,物品向量可离线预计算、在线检索极快,但两侧文本在编码时互相不可见;交叉编码器则把用户历史与候选全文拼成一条输入送入同一个Transformer,候选token直接对历史做注意力,质量更高,但每个候选都要完整计算一遍,表示无法跨用户复用。
DuoLM的核心权衡就是「双塔的效率+交叉编码器的质量」:物品编码离线化以复用,个性化保留在在线排序器。理解两种架构的差异才能看懂它的设计动机。
KV缓存与共享前缀
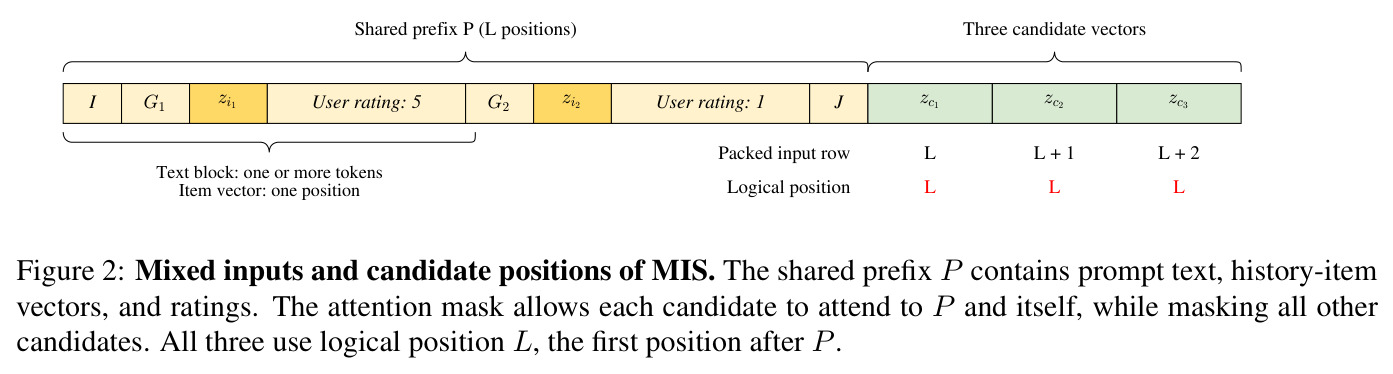
Transformer推理时把每个token的Key/Value投影缓存为KV cache,新位置只需与缓存做注意力。vLLM与SGLang的前缀缓存可让不同请求复用相同前缀的KV,避免重复预填充。MIS更进一步:同一请求内的K个候选共享同一份历史前缀KV,每个候选只额外计算自己的一个向量位置。
推荐请求的典型形态是「历史相同、候选众多」,请求内共享前缀KV是MIS取得4.81×–29.3×吞吐提升的计算基础,也是论文效率结论的关键。
知识蒸馏(KD)
用更强教师模型的输出分布监督小模型:对同一组候选,把教师和学生打分分别除以温度τ后做softmax得到概率分布,再用KL散度衡量差异,按Hinton经典做法乘$\tau^2$做梯度缩放。温度越高分布越软,能传递候选之间相对好坏的「暗知识」,而不只是硬标签。
DuoLM学生模型(编码器+接口+排序器)的监督一半来自冻结全文教师的候选组分布,训练目标$\mathcal{L}=(1-\beta)\ell_{CE}+\beta\tau^2 D_{KL}$以及温度/权重消融都建立在KD之上。
连续输入接口(软提示向量)
把一段文本压缩成一个连续向量,直接送入另一个LLM的嵌入层以替代其文本token序列,类似gist tokens、xRAG等工作。DuoLM对物品向量做RMS归一化,再按排序器原生词嵌入估计的参考尺度$\rho$和可学习增益$e^\gamma$校准,使$z_i$与原生token嵌入处于同一量级。
这是连接编码器A与排序器B的唯一桥梁;尺度校准失败会导致压缩表示淹没或放大在词嵌入海洋中,是复现与改进时最敏感的部件之一。
CUDA Graph捕获与回放
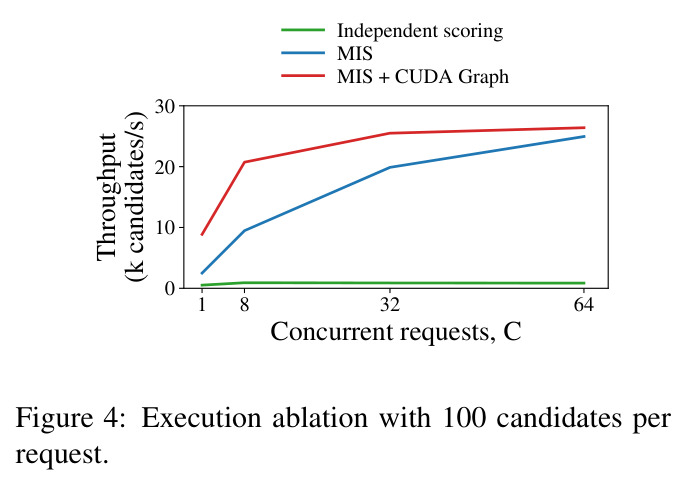
GPU每执行一个算子都需要CPU发起kernel launch,小算子密集的推理中主机调度开销可观。CUDA Graph把整段GPU操作及依赖捕获成静态图,之后一次调用即可按相同结构回放,消除逐kernel的CPU开销。DuoLM对MIS的分段预填充做图捕获,在线只更新输入数据与候选位置ID。
它是MIS之外的第二级加速:低并发时额外带来3.54×提升,说明端到端瓶颈不只在GPU计算,主机侧开销同样关键。
HR@10与NDCG@10
HR@10衡量真实目标是否出现在排序前10;NDCG@10按位置折减累加增益,排得越靠前分越高,能区分「第1名命中」与「第10名命中」。本文推荐评测用1个真实目标加99个随机未交互物品构成100候选集;评分预测报告NLL、MAE、RMSE与严格proper scoring规则RPS。
论文所有质量结论(如Books NDCG@10 0.5586 vs HLLM 0.5508)都用这些指标表述,且评估协议是随机负例,读懂协议才能正确解读绝对数值。
研究动机
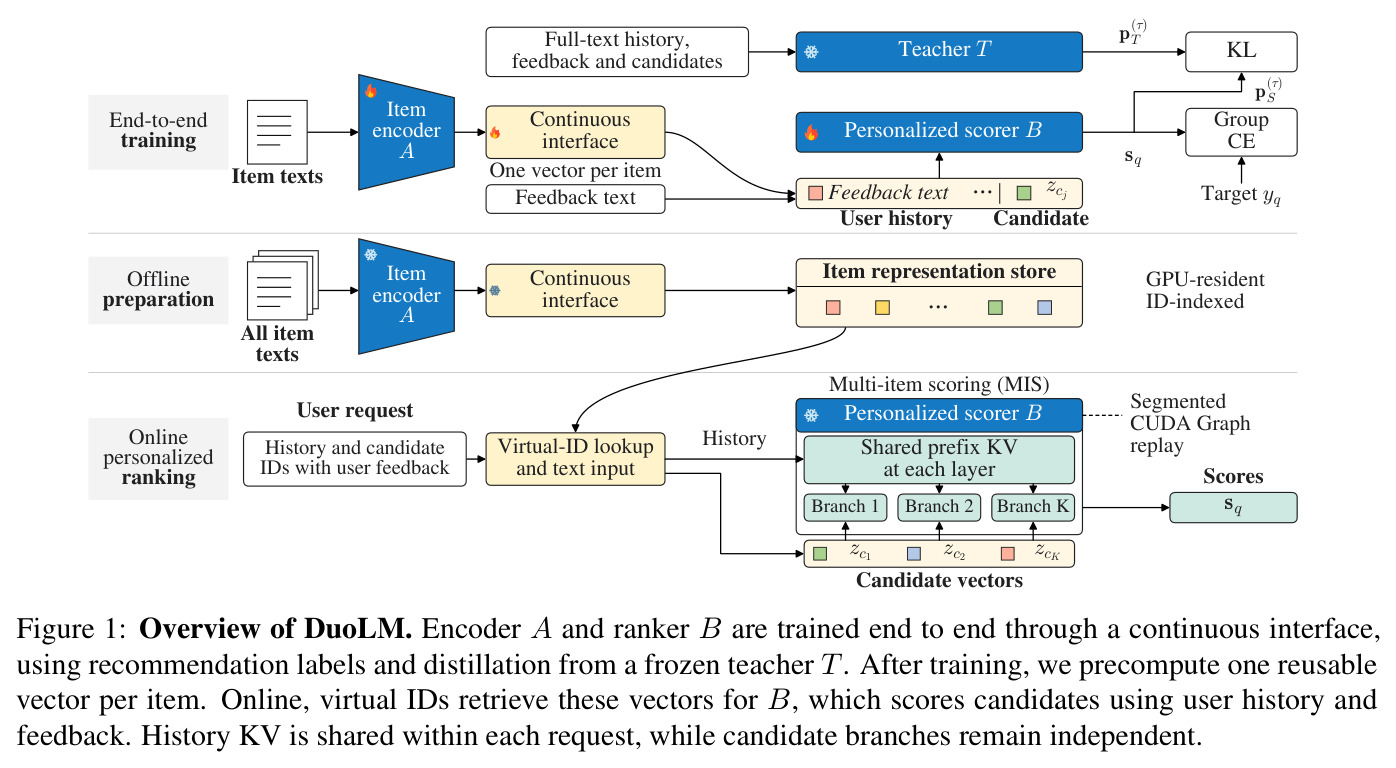
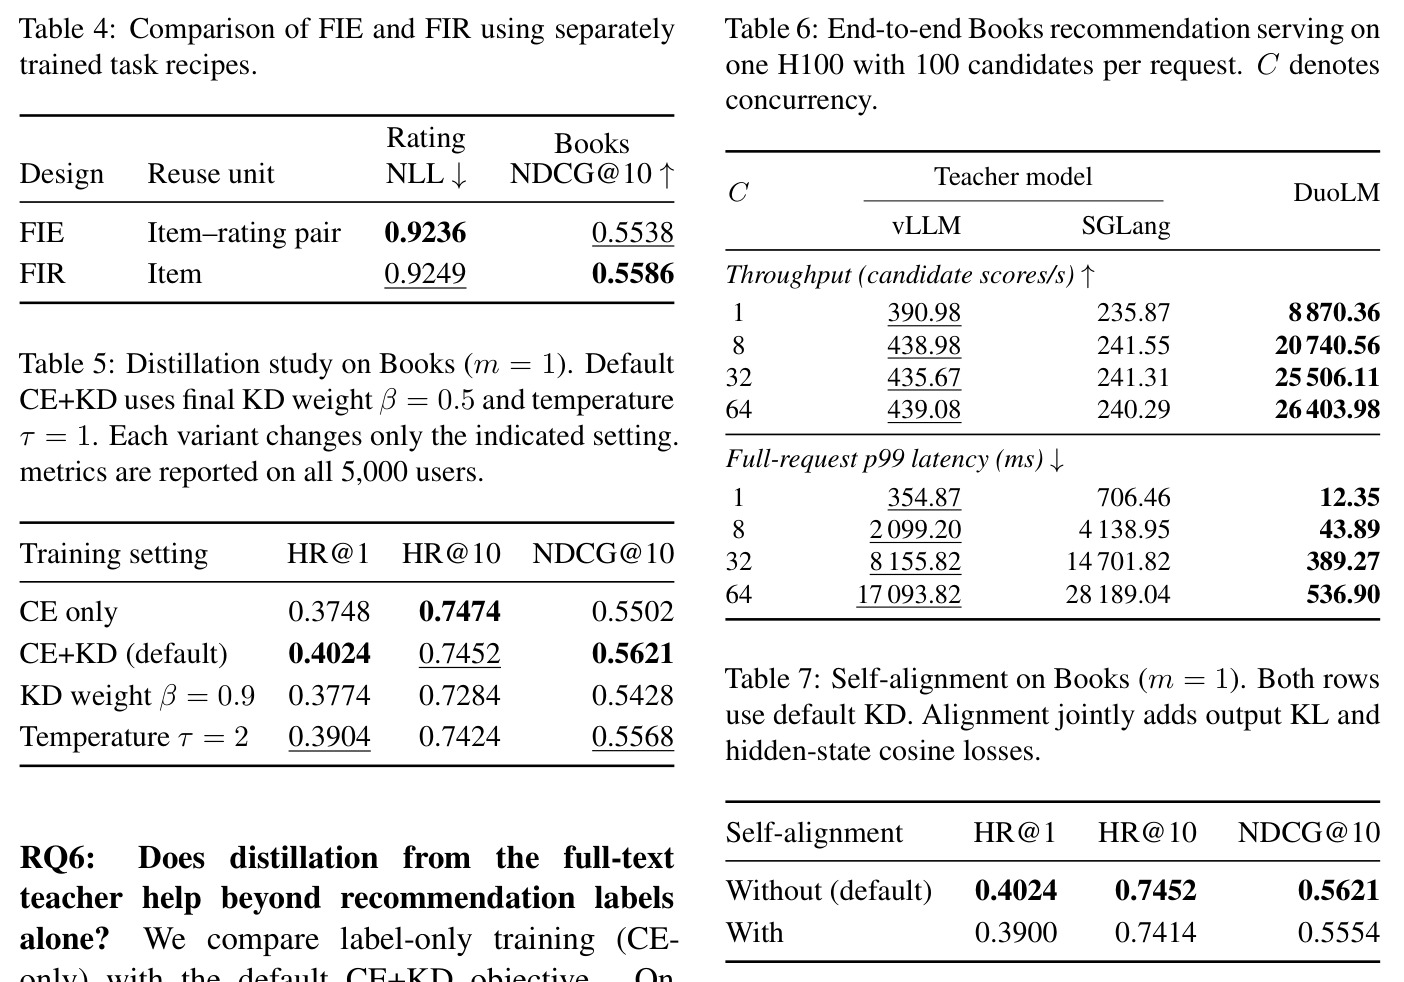
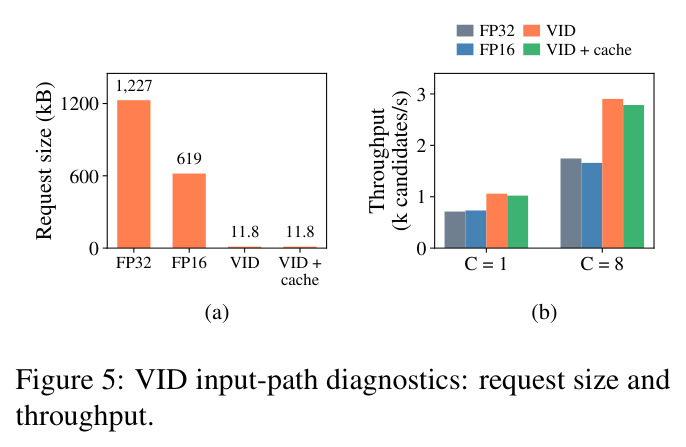
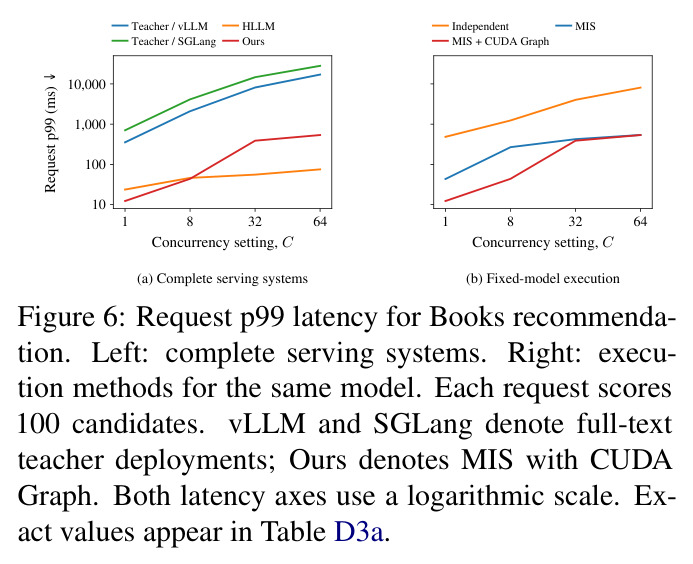
用语言模型做个性化推荐(把用户历史、反馈和候选物品全文拼给LLM打分)质量好,但在线服务代价高昂:一条请求要对几十甚至上百个候选打分,每个候选都重复编码完整全文输入,计算量随候选数线性膨胀。论文在单张H100上实测,全文教师模型即便经vLLM加自动前缀缓存加速,吞吐也只有约391–439个候选分/秒,C=64并发时p99延迟高达17,094毫秒,远不能满足在线流量。现有替代方案各有硬伤:传统ID双塔推荐快,但只依赖交互共现,无法利用文本语义与预训练世界知识,长尾和冷启动物品表示学不好(Hou 2022、Li 2023等指出);全文本交叉编码器质量高,但候选表示依赖用户上下文,无法离线预计算、跨用户复用;直接压缩物品文本(Chevalier 2023、Ge 2024等)又可能丢弃对特定用户重要的细节。此外还有第二个矛盾:模型侧计算减少并不自动转化为端到端加速——如果每个候选单独提交请求,服务层仍会重复构建与传输相同的历史输入、为每个候选单独调度,前缀缓存本身并不能消除这类框架级冗余。
本文的目标是本文目标是构建一个既保住全文本LLM个性化推荐质量、又能大规模在线低延迟服务的框架,具体拆成三件事。其一,模型侧:把物品文本离线压缩成单个可复用向量,在线只运行一个轻量「个性化排序器」,候选向量与逐条历史向量直接做注意力产生分数,完全不跑自回归解码。其二,训练侧:用推荐标签的交叉熵加上冻结全文本教师候选分布的KL蒸馏,端到端联合训练编码器、连续接口和排序器,使压缩表示尽量保真教师的组内偏好判断——量化目标是质量对齐教师(最终Books推荐NDCG@10甚至反超:0.5586 vs 0.5440)。其三,运行时侧:设计虚拟token ID、请求内多候选共享历史KV的MIS推理路径和CUDA Graph回放,把模型侧省下的计算真正转化为端到端吞吐,论文给出的量级目标是单张H100上达到每秒上万级候选打分(最终26,400候选分/秒)。
与已有工作不同的是,独特切入角度是「表示学习与推理服务的协同设计」,并明确与两条已有路线划清界限。与HLLM等分层LLM推荐相比:HLLM虽然也用两个LLM分别编码物品与用户,但候选排序靠用户表示与物品表示的余弦相似度,个性化被压进单一用户向量;DuoLM让每个候选向量直接对逐条历史物品向量及其评论文本做注意力,保留交叉编码器式的细粒度交互。与xRAG、PISCO、CLaRa等上下文压缩工作相比:那些方法把压缩向量用于RAG生成,DuoLM把它用于推荐排序并以教师蒸馏保证偏好保真,还给出了尺度校准的连续接口。与vLLM/SGLang等通用推理引擎相比:论文指出通用前缀缓存无法消除推荐服务特有的冗余(候选逐个提交、历史重复传输),于是自建MIS语义路径——树状注意力掩码加统一逻辑位置ID,在精确算术下严格保证打包打分与逐候选打分等价($s^{MIS}_{q,j}=s_{q,j}$),每层消除$(K_q-1)L_q(L_q+1)/2$个重复前缀query-key对。这是「为推荐负载定制运行时语义」而非「套用通用引擎」的差异化定位。
核心方法
直觉上,DuoLM把「读物品」和「读用户」拆开:物品内容与用户无关,可以离线一次性压缩;用户历史与反馈才需要在线个性化处理。技术路线是两个0.6B Qwen3骨干加一条连续输入接口。编码器A(Qwen3-Embedding-0.6B)读物品全文,取EOS位置最后一层隐状态作为表示$a_i\in\mathbb{R}^d$;接口对$a_i$做RMS归一化,再按排序器原生词嵌入估计的参考尺度$\rho$校准并乘可学习增益$e^\gamma$,得到$z_i$。排序器B(Qwen3-0.6B)的输入是指令文本、按序排列的历史条目(物品向量$z_{i_t}$加反馈原文)和候选向量$z_{c_j}$,用共享线性头$w$读候选最后隐状态得$s_{q,j}=w^\top h_{q,j}$,直接排序、无需解码。训练时由同规模但读全文的教师T在同一候选组上产生软分布,学生以$\ell=(1-\beta)\ell_{CE}+\beta\tau^2 D_{KL}(p_T^\tau\|p_S^\tau)$联合学习,梯度穿过接口回传到编码器,物品向量每次前向重算保持可微路径。
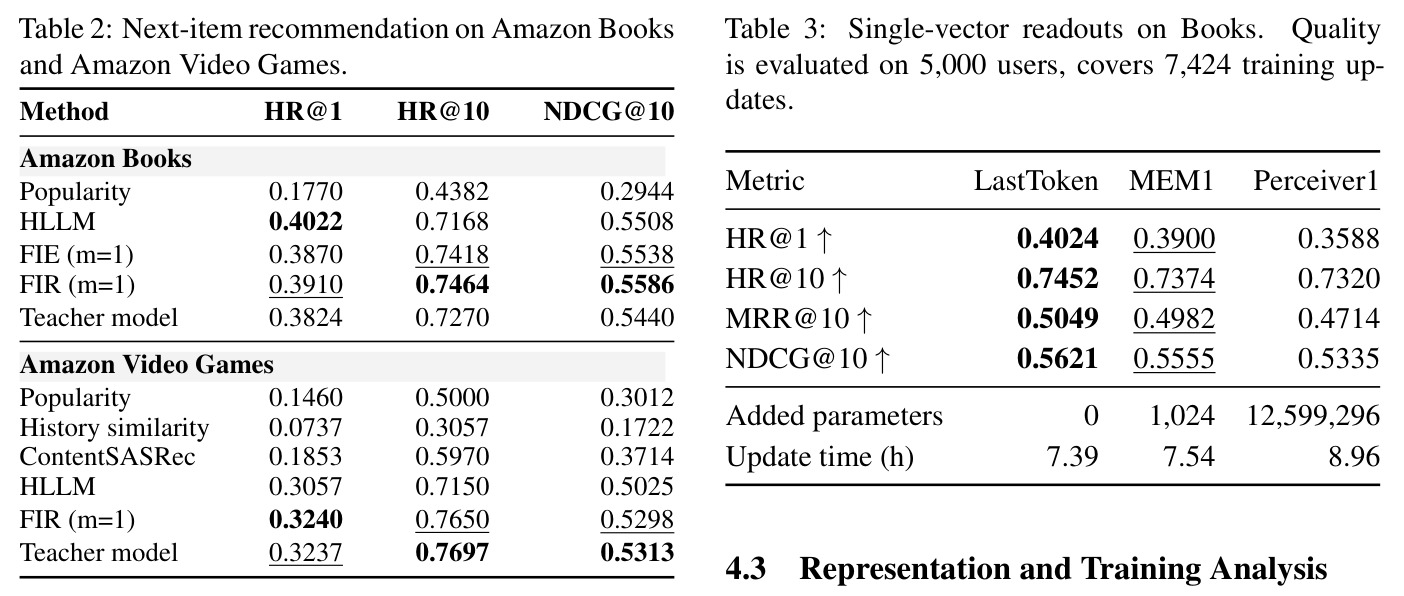
核心创新有三层。第一,「向量替文本」的表示复用:候选与历史共用同一套用户无关的物品向量,编码成本从在线挪到离线,候选表示不再依赖用户上下文——这是与全文本交叉编码器的本质区别;作者还证明最朴素的EOS末token读出反而优于MEM1、Perceiver等专用读出(NDCG@10分别为0.5621、0.5555、0.5335),简洁即有效。第二,教师蒸馏的偏好保真:不只学「哪个是真实目标」(CE),还学教师在候选组内的相对偏好分布(KD);消融显示CE+KD把HR@1从0.3748提到0.4024、NDCG@10从0.5502提到0.5621,说明蒸馏传递了标签之外的组内序信息。第三,MIS运行时语义:把K个候选打包进一条请求,历史前缀只预填充一次并跨候选分支共享KV;通过树状注意力掩码(每个候选只可见前缀和它自己)与统一逻辑位置ID(所有候选都占前缀后第$L_q$个逻辑位置),在精确算术下严格保证$s^{MIS}_{q,j}=s_{q,j}$。这把「压缩表示」与「共享计算」两条正交的省算力路径统一在一个框架里,且等价性有数学证明而非近似。
方法步骤详情
步骤一(教师训练):教师T模板与排序器相同但以物品全文替代向量,线性头读末token得$t_{q,j}$,仅用交叉熵识别真实目标;训练后冻结并缓存其原始分数。步骤二(学生端到端训练):可训练参数含$\theta_A,\gamma,\theta_B,w$及两骨干原生词嵌入,物品向量每次前向重算;损失$\ell_u(q)=(1-\beta_u)\ell_{CE}+\beta_u\ell_{KD}$,CE用温度1,KD用$\tau=1$与$\tau^2$缩放,$\beta_u$在前743步线性爬坡到0.5后固定。步骤三(离线导出):冻结学生后把接口后向量$z_i$以FP16写入GPU常驻表$D$,分配虚拟输入ID $V+\iota(i)$,嵌入查找按ID返回对应行。步骤四(MIS打分):请求只携带物品ID与反馈文本;运行时查表拼出共享前缀$P_q$并一次预填充缓存KV;候选排在后面,候选$j$只可见前缀和它自己,逻辑位置均为$L_q$;共享线性头按输入顺序返回K个分数。步骤五(CUDA Graph回放):对分段预填充与候选段捕获计算图,在线以新输入和新候选位置ID回放,消除主机调度开销。
技术新颖性
技术新颖性可从四点评估。(1)架构组合新:现有LLM推荐要么全文交互(TALLRec等),要么双塔相似度(HLLM);DuoLM首次把「每候选单向量+逐历史条目注意力+反馈文本内联在排序器」三要素合一,兼顾表示复用与细粒度个性化,消融证实优于HLLM(Books NDCG@10 0.5586 vs 0.5508,Video Games 0.5298 vs 0.5025)。(2)训练目标新:以冻结全文教师缓存的候选组分布做组内KL蒸馏,权重线性爬坡(0→0.5)与CE加权融合;不同于传统逐样本蒸馏,这里对齐的是组内排序偏好,并给出分数梯度解析式(标签残差+教师残差)。(3)运行时语义新:MIS不是纯工程技巧,而是有精确等价性证明(Eq.8–9)的语义定义,把可见性与逻辑位置解耦,基于SGLang和FlashInfer的prefill kernel实现,这类按负载定制注意力语义的思路在推荐服务中少见。(4)反直觉实证有价值:LastToken胜过专用读出结构;FP16减字节不必然更快;全文自对齐使训练时间增2.29×却降NDCG@10。
实验结果
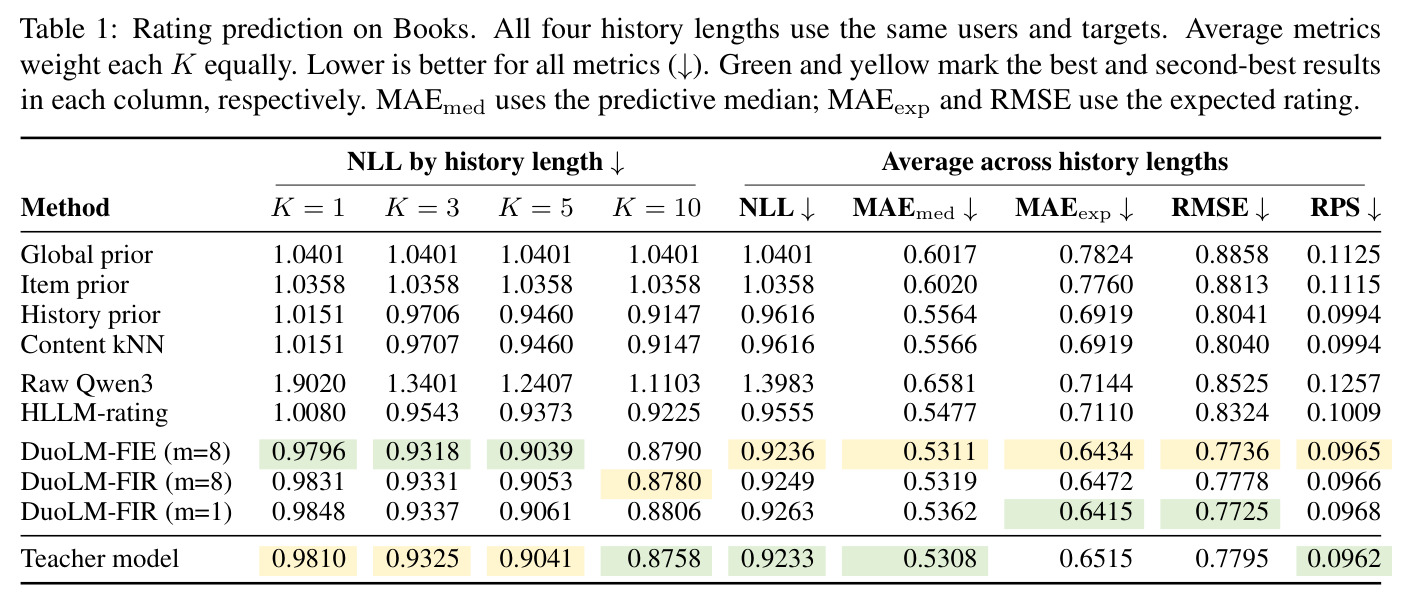
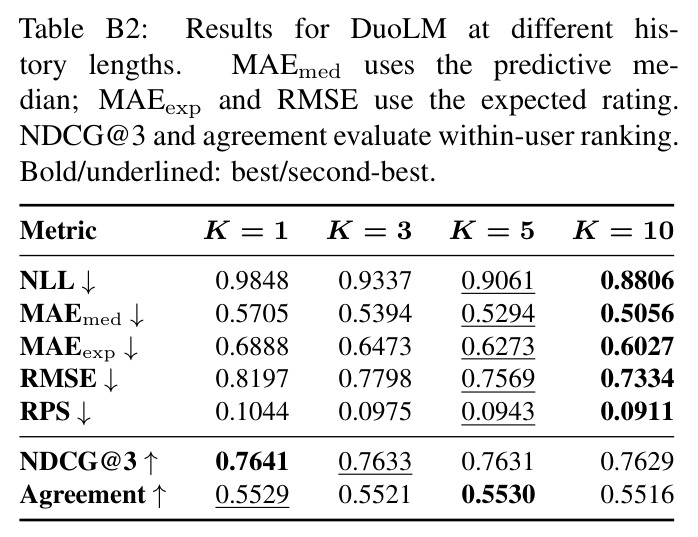
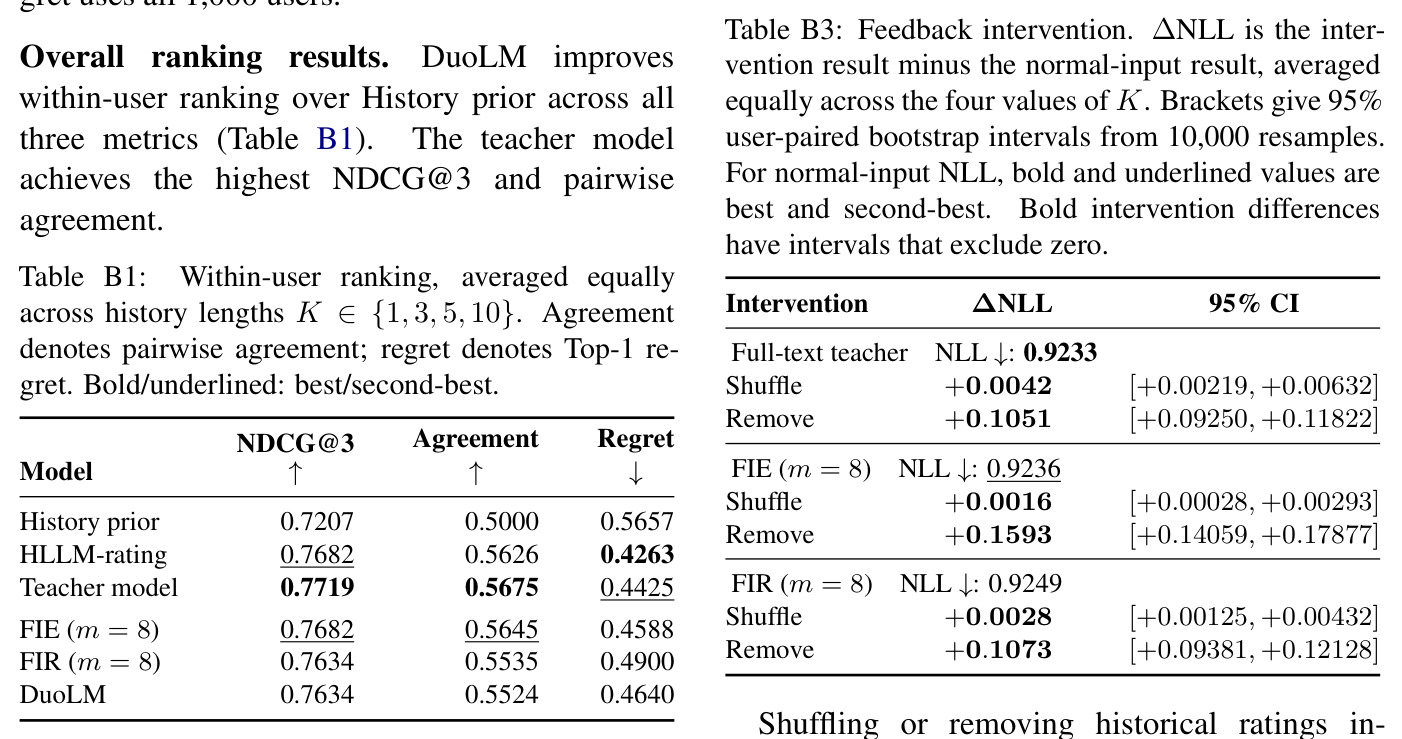
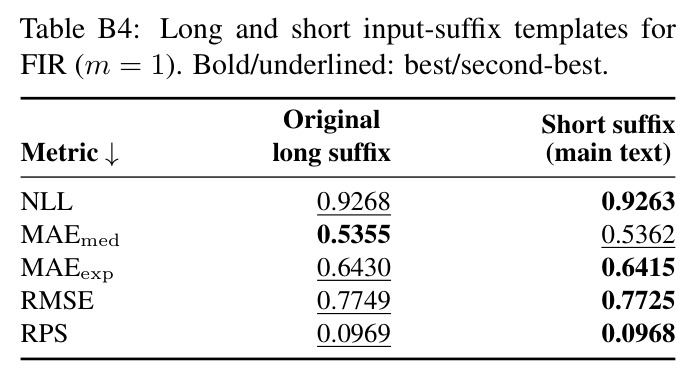
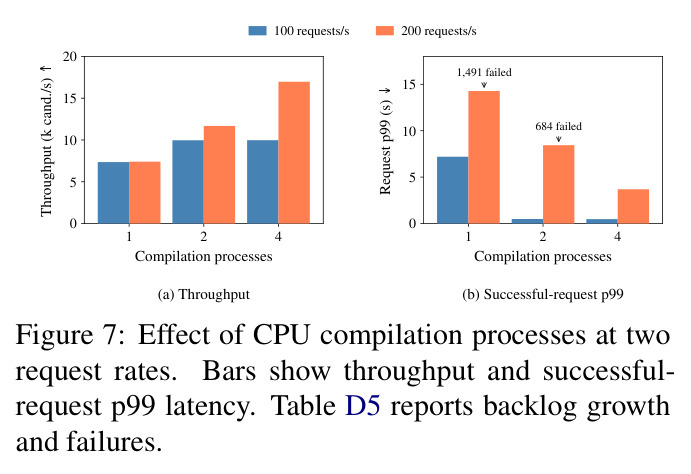
质量(RQ1):Books评分预测平均NLL为0.9263,与教师0.9233几乎持平,MAEexp与RMSE反超教师(0.6415/0.7725);Books推荐NDCG@10达0.5586,超教师的0.5440与HLLM 0.5508;Video Games NDCG@10为0.5298,与教师0.5313持平、高于HLLM的0.5025。历史越长质量越高(RQ2):NLL从0.9848(K=1)降至0.8806(K=10)。效率(RQ3):单H100、100候选/请求,吞吐从8,870(C=1)升至26,404(C=64)候选分/秒,为vLLM教师的22.7–60.1×、SGLang教师的37.6–109.9×;C=64时p99为536.9 ms vs 17,093.8 ms。归因:MIS提速4.81×–29.3×、CUDA Graph再提1.06–3.54×;虚拟ID使请求体积降99.0%、吞吐+66.5%。消融:LastToken读出最优;KD必要(CE-only仅0.5502),β=0.9、τ=2、自对齐均有害;200请求/秒下单进程CPU编译失败1,491次。
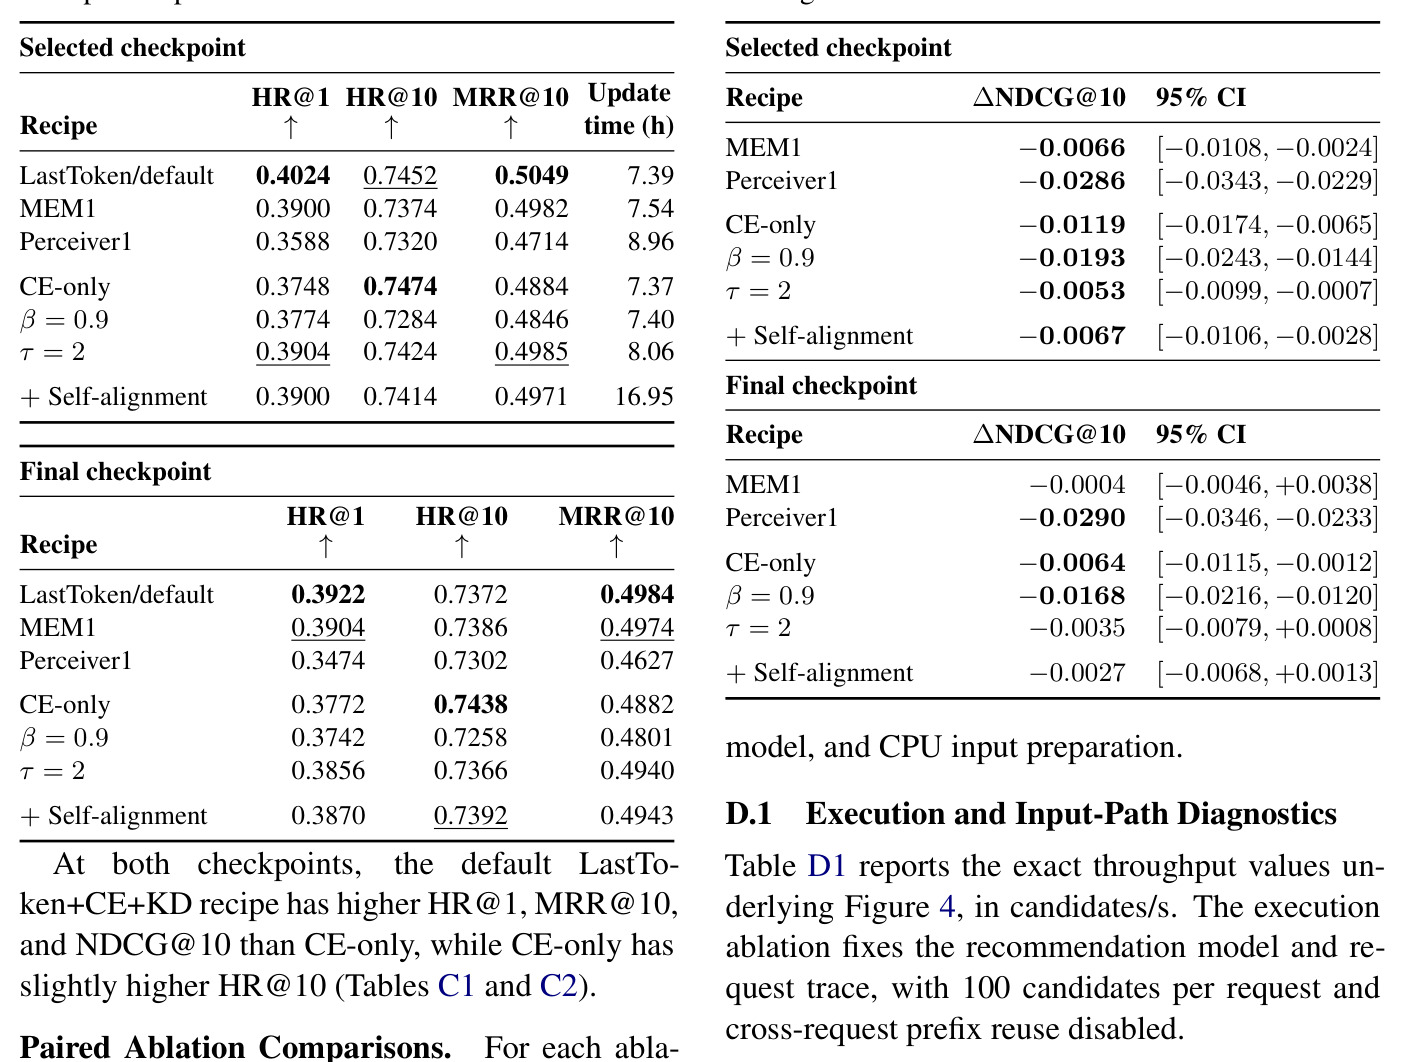
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Books 评分预测(K∈{1,3,5,10}平均) | NLL ↓ | 0.9263(DuoLM-FIR, m=1) | 0.9233(全文教师)/ 0.9555(HLLM-rating)/ 1.3983(Raw Qwen3) | 与教师基本持平(+0.3%);较HLLM-rating降低3.1% |
| Books 评分预测 | MAEexp / RMSE ↓ | 0.6415 / 0.7725 | 0.6515 / 0.7795(全文教师) | 均反超教师约1%–1.5%(教师仅在MAEmed与RPS上略优) |
| Amazon Books 下一物品推荐 | NDCG@10 ↑ | 0.5586(FIR, m=1) | 0.5440(教师)/ 0.5508(HLLM) | 较教师+1.4%,较HLLM+0.8%;HR@10 0.7464为最优 |
| Amazon Video Games 下一物品推荐 | NDCG@10 ↑ | 0.5298(FIR, m=1) | 0.5313(教师)/ 0.5025(HLLM) | 与教师持平(-0.3%),较HLLM+2.7% |
| Books 在线推荐服务吞吐(单H100,100候选/请求,C=64) | 候选分数/秒 ↑ | 26,404(MIS+CUDA Graph) | 439(教师@vLLM)/ 240(教师@SGLang) | 60.1× / 109.9×(全并发区间为22.7–60.1×与37.6–109.9×) |
| Books 在线推荐请求p99延迟(C=64) | 毫秒 ↓ | 536.9(MIS+CUDA Graph) | 17,093.8(教师@vLLM)/ 28,189.0(教师@SGLang) | 约31.8×(降低96.9%);C=1时p99仅12.35 ms |
| 固定模型的执行方式消融(100候选/请求) | 相对逐候选独立打分的吞吐提升 ↑ | MIS:4.81×(C=1)至29.3×(C=64);MIS+CUDA Graph:C=1达8,870/s(16.7×) | 独立打分:851.48/s(C=64) | MIS最高29.3×,CUDA Graph叠加1.06–3.54× |
| 评分服务对比(FIR m=8 vs 全文教师@SGLang,混合N∈{5,20,50,100}) | 请求吞吐(requests/s)↑ | 17.90(C=1)/ 51.30(C=8) | 7.60(C=1)/ 11.34(C=8) | 2.36×(C=1)/ 4.52×(C=8);N=100请求p50延迟从417.42降至92.03 ms |
局限与改进
作者明确承认的局限:评测仅覆盖Amazon Books与Video Games两个数据集、0.6B规模骨干,结论未必推广到其他领域、更大模型或用户偏好快速变化的场景;候选集由1个真实目标加99个随机未交互物品构成,随机负例远弱于真实检索系统的难负例,绝对指标可能被高估;每物品压缩为单向量可能丢弃对特定用户关键的细节;离线表示在物品内容或编码器变化时需全量重算;吞吐测量只含在线服务,未计训练与离线编码成本;且均在受控负载的单张H100上测得。我的补充观察:其一,端到端训练每步都要重算全部物品向量,成本随目录规模增长(Books目录49.5万物品),工业级目录下可扩展性存疑;其二,虚拟ID表常驻GPU(评分诊断中约2.17 GB FP16),超大目录需多级缓存方案,论文未讨论;其三,反馈文本仍以全文进入排序器,反馈很长会稀释请求内共享前缀的收益;其四,干预实验显示打乱历史评分仅使NLL上升0.0028(移除则+0.1073),说明模型对评论文本内容的利用可能远弱于对评分存在性的利用,个性化深度存疑;其五,教师分数缓存绑定特定历史-候选组合,换采样策略需重跑教师,复用性受限。
独立分析的弱点
弱点一:随机负例评估协议偏乐观。99个随机未交互物品大多与用户兴趣明显无关,模型靠内容与历史的粗相关性即可胜出;真实系统需从百万级候选先检索再精排,难负例下单向量的信息瓶颈会暴露。改进方向:接入真实检索管道(如用DuoLM向量做ANN召回)构造难负例重评。弱点二:单向量与个性化粒度的矛盾。物品向量用户无关,「同一物品对不同用户呈现不同侧面」无法表达;论文自己的干预实验(打乱评分仅+0.0028 NLL)暗示细粒度反馈信号利用有限。改进方向:探索每物品少量向量或用户条件化的低秩调制。弱点三:目录动态性。新物品入库或编码器更新需全量重编码与表刷新,新旧向量混用一致性未讨论。改进方向:增量编码加版本化向量表。弱点四:训练可扩展性。每步重算物品向量使FLOPs正比于目录规模乘请求数。改进方向:物品向量定期冻结、编码器低频交替更新。弱点五:仅验证0.6B规模,更大排序器能否消除与教师的剩余差距未知。改进方向:做1.7B/4B规模scaling实验。弱点六:优化后瓶颈转移到主机侧——200请求/秒、单进程编译时1,491次失败。改进方向:输入预编译缓存、请求合并提交。
未来方向
作者在限制中隐含的方向:更多数据集与领域、更大模型、真实检索候选、动态偏好场景的验证。基于其成果可延伸的研究:(1)检索-排序同表示闭环——用编码器向量做ANN召回、排序器精排,形成级联系统,并研究召回与排序蒸馏目标的一致性;(2)多向量与自适应压缩——按物品文本长度或热度分配1到$m$个向量,刻画信息瓶颈与质量的帕累托前沿;(3)会话内增量个性化——历史新条目到来时只追加向量与KV,研究增量更新与全量重算的质量差异;(4)反馈语义深化——当前FIR把反馈文本放排序器,可试验把评论全文压缩进历史向量,或引入反馈摘要;(5)运行时泛化——把MIS的树状掩码+逻辑位置抽象移植到vLLM等引擎,并探索跨请求的物品级KV复用(不同用户历史含同一物品时共享其分段KV);(6)蒸馏目标扩展——以列表级损失(ListNet等)或排序一致损失补充组内KL;(7)冷启动系统研究——新物品无交互时纯文本向量天然可用,可量化DuoLM相对ID模型在冷启动上的优势上限;(8)真实流量A/B——论文只有受控压测,尾部用户、突发流量与延迟SLO约束下的表现有待检验。
复现评估
复现条件中等偏上。有利因素:模型全部基于公开权重(Qwen3-Embedding-0.6B、Qwen3-0.6B/Base,28层);数据为公开的Amazon Reviews 2023,附录A.1给出固定用户哈希切分、K∈{1,3,5,10}嵌套历史、候选采样(训练每目标配7个负例:4随机+3内容检索;评测1目标+99随机)等完整协议;附录A.2描述各基线实现,附录C/E给出训练预算(有效batch 32、7,424步、β爬坡743步、参考尺度$\rho=0.0280669$)、蒸馏调度、分数梯度解析式和MIS注意力公式,数值细节完备。不利因素:论文未提供开源代码仓库链接;MIS依赖对SGLang/FlashInfer prefill kernel的修改(自定义掩码与位置ID),工程量不小且无现成API;教师分数缓存、虚拟ID表管理、CUDA Graph捕获均需自研。算力方面:单张H100 80GB即可完成全部实验,默认配方训练7.39小时,七组消融加压测约需数十GPU小时。总体判断:算法与实验部分可复现性高,运行时部分复现难度较高,熟悉SGLang的工程师预计需数周。
论文图表
四步流程图:(a)历史与文本构成前缀P;(b)每个候选读取P和自身;(c)排序器对P做一次预填充并缓存各层KV;(d)复用KV独立给每个候选打分,共享线性头输出$s_1,s_2,s_3$。图中区分了文本块(多个token)与物品向量(一个位置)。
直观解释了为什么MIS能省算力:历史只算一次,K个候选各只增加一个向量位置的计算,配合Figure 2即可完整理解请求内共享的计算结构。