论“舌尖现象”:首Token提示作为LLM回忆失败的行为探针 On the Tip of the Tongue: First-Token Cueing as a Behavioral Probe of Recall Failures in LLMs
给模型答案的首Token即可修复两成到一半闭卷错误——许多事实错误是回忆失败而非知识缺失
前置知识
舌尖现象(TOT)与首音提示范式
舌尖现象指说话者明知某词却暂时说不出,但能报告其语义和首音等部分形式(Brown & McNeill 1966)。传递缺失假说认为这是语义可达但语音形式通路连接弱。实验心理学发现,提供一个词的首音(onset cue)是解除TOT最有效的线索(Meyer & Bock 1992),符合编码特异性:线索与存储目标匹配程度越高越有效。
本文的方法论和命名都直接借自此范式:把『给首音能唤醒整词』改造成『给首Token能唤醒整个答案』,是理解全文动机的钥匙。
自回归解码与首Token承诺
自回归语言模型逐token生成,每个token以之前所有token为条件。因此第一个生成的token锁定了后续内容的走向:一旦开头选错,后续在错误前缀的强约束下继续。已有工作发现幻觉片段的首token携带最强错误信号(Snel & Oh 2025),答案承诺定位于首个解码步(Yeom et al. 2026)。
首token是本文唯一的干预点。理解『第一步选答案、后面只是补全』这个两阶段图景,才能理解为什么一个token的提示足以修复大量错误。
输出预填充(Prefilling)
在模型响应起点预先放入若干token再让其续写,即强制模型从给定前缀开始生成。形式化地,把提示 $x_q$ 与前缀 $t^\star_1$ 拼接为 $c_{\text{cue}} = x_q \oplus (t^\star_1)$,再贪心解码。预填充也是越狱攻击的常用手段(Qi et al. 2025:预填充几token的顺从回复即可绕过安全对齐)。
First-Token Cueing 在实现上就是一次预填充,但加入了gold信息;理解预填充机制及其『仅凭格式约束也可能改变输出』的混淆效应,是理解本文一系列控制实验(随机token、通用前缀)存在的原因。
不确定性度量:熵、AUROC与PRR
熵 $H$ 衡量下一步token分布的分散程度,是不确定性的代理。AUROC 衡量某个分数区分正确与错误答案的判别力(0.5为随机,1为完美)。PRR(Prediction Rejection Ratio)衡量按不确定性从低到高拒答时,准确率提升相对于理想oracle的比率(1为oracle,0为随机)。
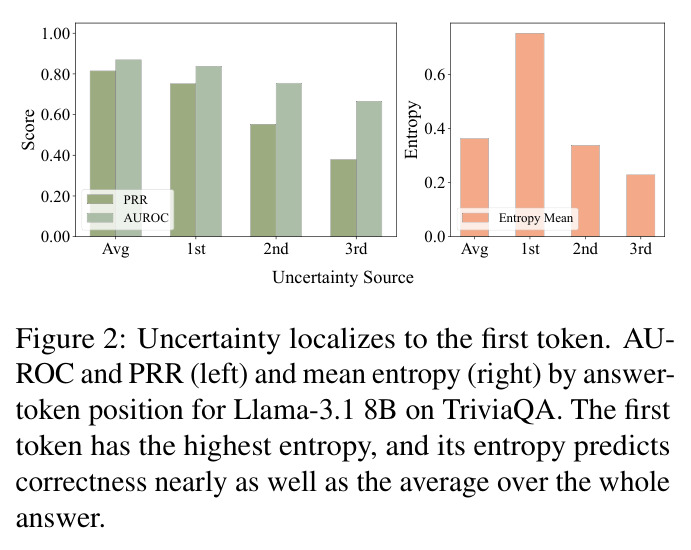
论文第3节用这三个指标证明『关于正确性的不确定性集中在首token』:首token熵单独预测答案对错几乎与整段答案平均熵一样好,这是『失败发生在第一步』的直接证据。
pass@k 与『编码但无法回忆』判据
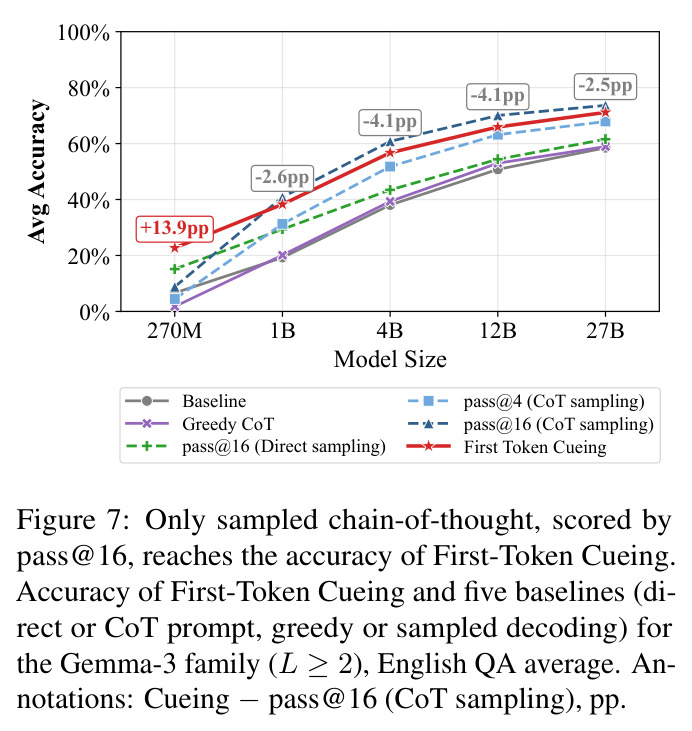
pass@k 是对每题采 $n$ 个样本时至少一个正确的概率(Chen et al. 2021 无偏估计)。Calderon et al. (2026) 用16样本思维链(thinking pass@16)能否解出来作为『知识已编码但未被直接回忆』的行为判据;本文借它作为独立于cue的第二个判据来交叉验证。
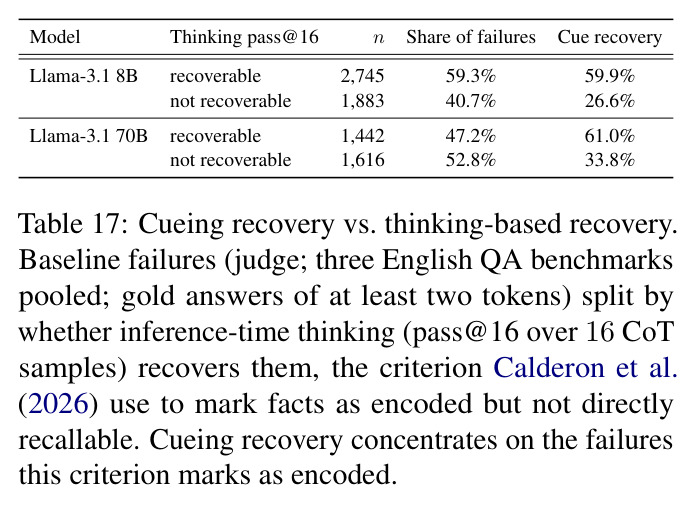
cue修复错误本身不能证明知识已编码(提示可能泄露答案)。pass@16 CoT提供了一个不用gold首token的独立判据,两者重叠(77%/62%)才构成『回忆失败』的完整论证。
编码特异性原则(Encoding Specificity)
Tulving & Thomson (1973) 提出的记忆检索原则:检索线索只有在与存储目标的编码方式匹配时才有效。不匹配的线索不仅无用,还可能把检索引向错误目标。这解释了为什么首音有效而任意提示无效。
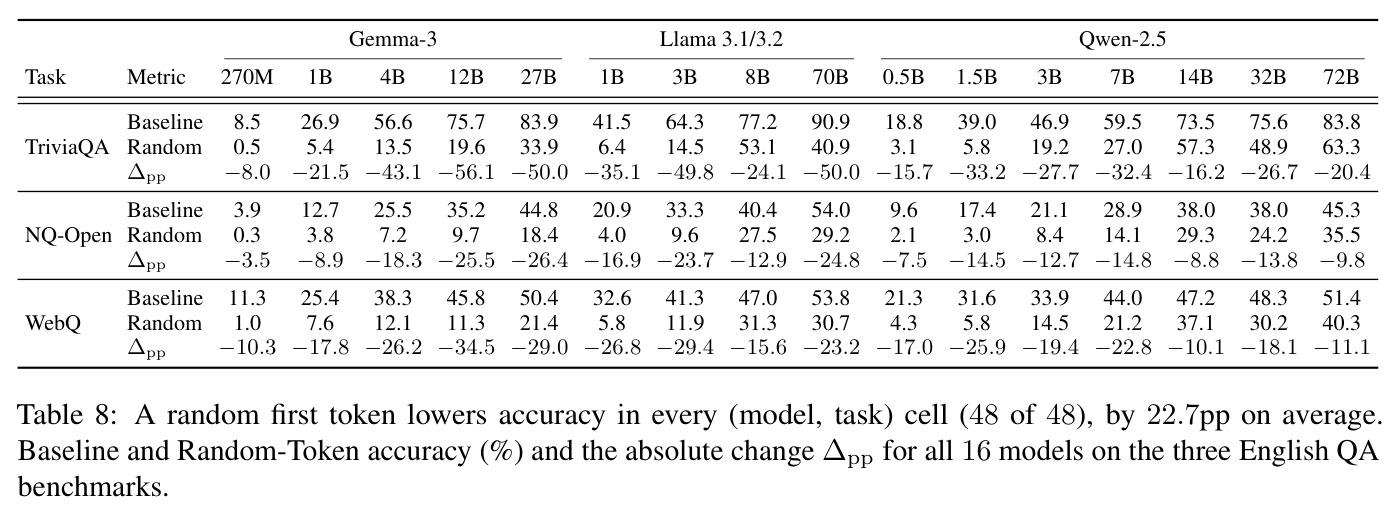
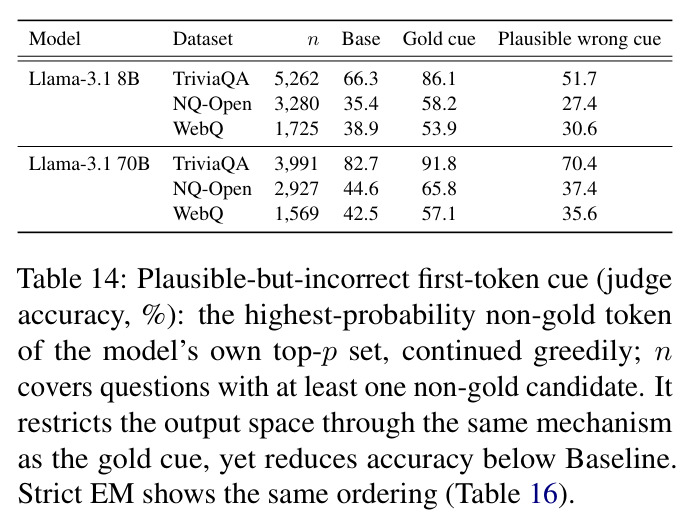
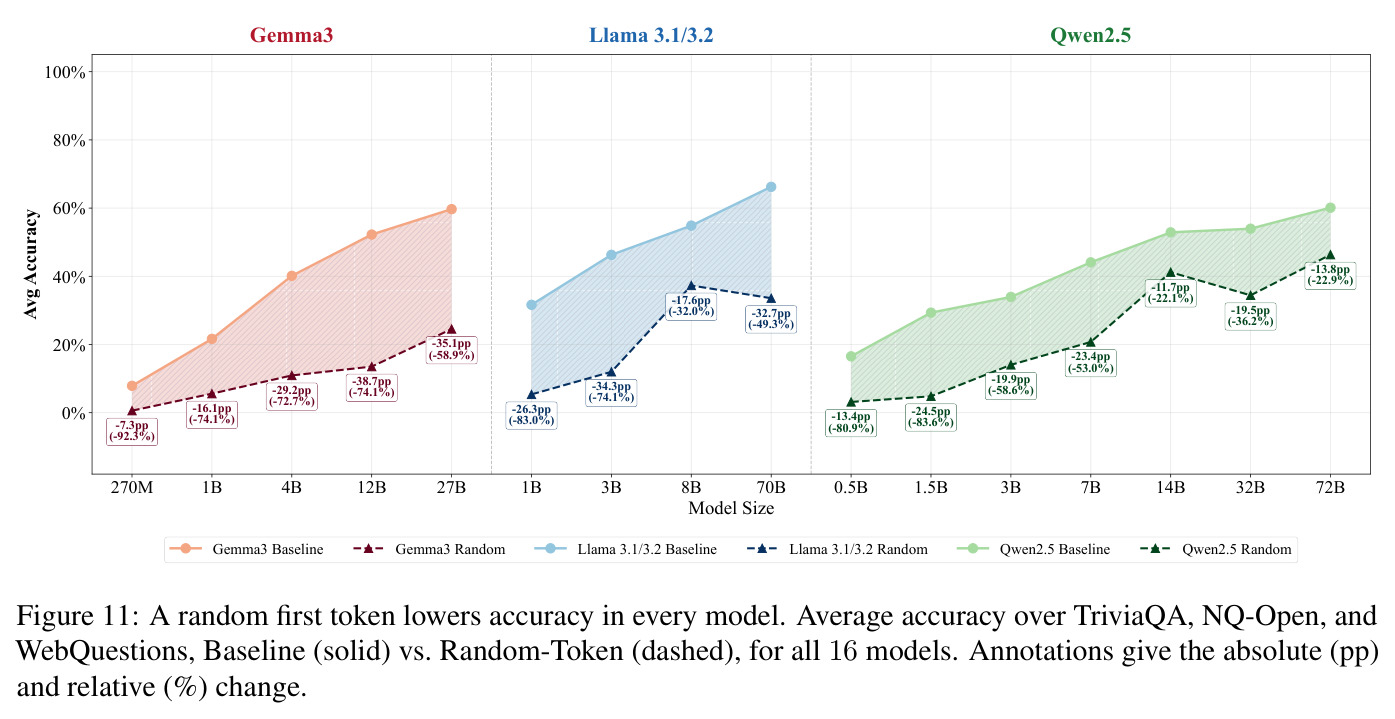
本文的两个关键对照——随机token使准确率平均下降22.7pp、似真但错误的token下降7–15pp、而gold首token上升约18pp——正是编码特异性在LLM中的行为学再现,是区分『提示内容』与『预填充形式』的核心逻辑。
研究动机
闭卷问答中LLM的事实性错误通常被当作『知识缺失』处理,标准补救是扩大参数量与预训练数据(Kaplan et al. 2020缩放律、Hoffmann et al. 2022),成本高昂且不回答『错误究竟发生在生成的哪一步』。但近年的探针研究发现模型常常『知道却不产生』:Burns et al. (2023)、Azaria & Mitchell (2023)、Orgad et al. (2025)能从内部状态读出正确答案;Gekhman et al. (2025)发现模型给正确答案的评分高于错误答案却生成不出来;Calderon et al. (2026)以『空货架还是丢了钥匙』为题指出前沿模型的瓶颈在回忆而非编码。另一方面,自回归生成对首token极其敏感:幻觉片段的首token携带最强错误信号(Snel & Oh 2025),答案承诺定位于首个解码步(Yeom et al. 2026)。然而这些工作只把首token当作错误的『信号』来读,从未有人做过大规模行为学检验回答两个问题:如果直接把正确首token喂给模型,能修复多少错误?失败是否真的发生在『选择如何开始回答』这一步?这个空白正是本文要填的。
本文的目标是本文的目标是定位并量化一类可恢复的事实错误,具体拆成三步。第一,验证关于答案正确性的不确定性是否集中在首个答案token上,即错误是否在『选择如何开头』时就已决定——用首token熵的AUROC/PRR与后续位置对比来检验。第二,提出First-Token Cueing行为学探针:只把gold答案的首个token预填充进模型响应,让模型自己贪心续写剩余部分,在16个开源模型(270M–72B)、3个英语QA基准(TriviaQA、NQ-Open、WebQuestions)和7语言MKQA上,量化这类『cue可修复错误』占baseline错误的比例,并考察其随规模、语言和分词器的变化。第三,用一系列控制实验区分两种解释:错误被修复是因为提示携带了答案信息(信息泄露),还是因为模型真的『认得』这个它自己产生不出的正确开头(识别=回忆失败的证据)——为此设计了随机token、似真错误token、通用前缀、首token oracle和crossed-cue配对等对照。
与已有工作不同的是,本文的独特切入是把人类记忆研究中『舌尖现象』(TOT)的实验范式移植到LLM行为学评估。TOT研究中的经典事实是:说话者说不出一个自己认识的词,却能报告其语义和首音;首音提示是解除TOT最有效的线索(Meyer & Bock 1992; James & Burke 2000),传递缺失假说将其解释为『语义可达但语音形式通路弱』。作者明确声明只取实验范式作类比、不主张人类与模型共享机制。与既有LLM工作的区别有三:其一,探针纯行为学,只需一次预填充,不依赖读内部状态的探针网络或激活干预,任何暴露接口的黑盒模型都能测;其二,干预点精确到首个解码步,而以往工作(Snel & Oh 2025; Yeom et al. 2026)只把首token当不确定性信号;其三,设计了crossed-cue控制——同一个token在一题中是正确cue、在配对题中是错误cue——把『识别正确开头』与『提示携带的答案信息』干净地分离,这是实验心理学对照设计的直接移植,在LLM评估文献中相当少见。
核心方法
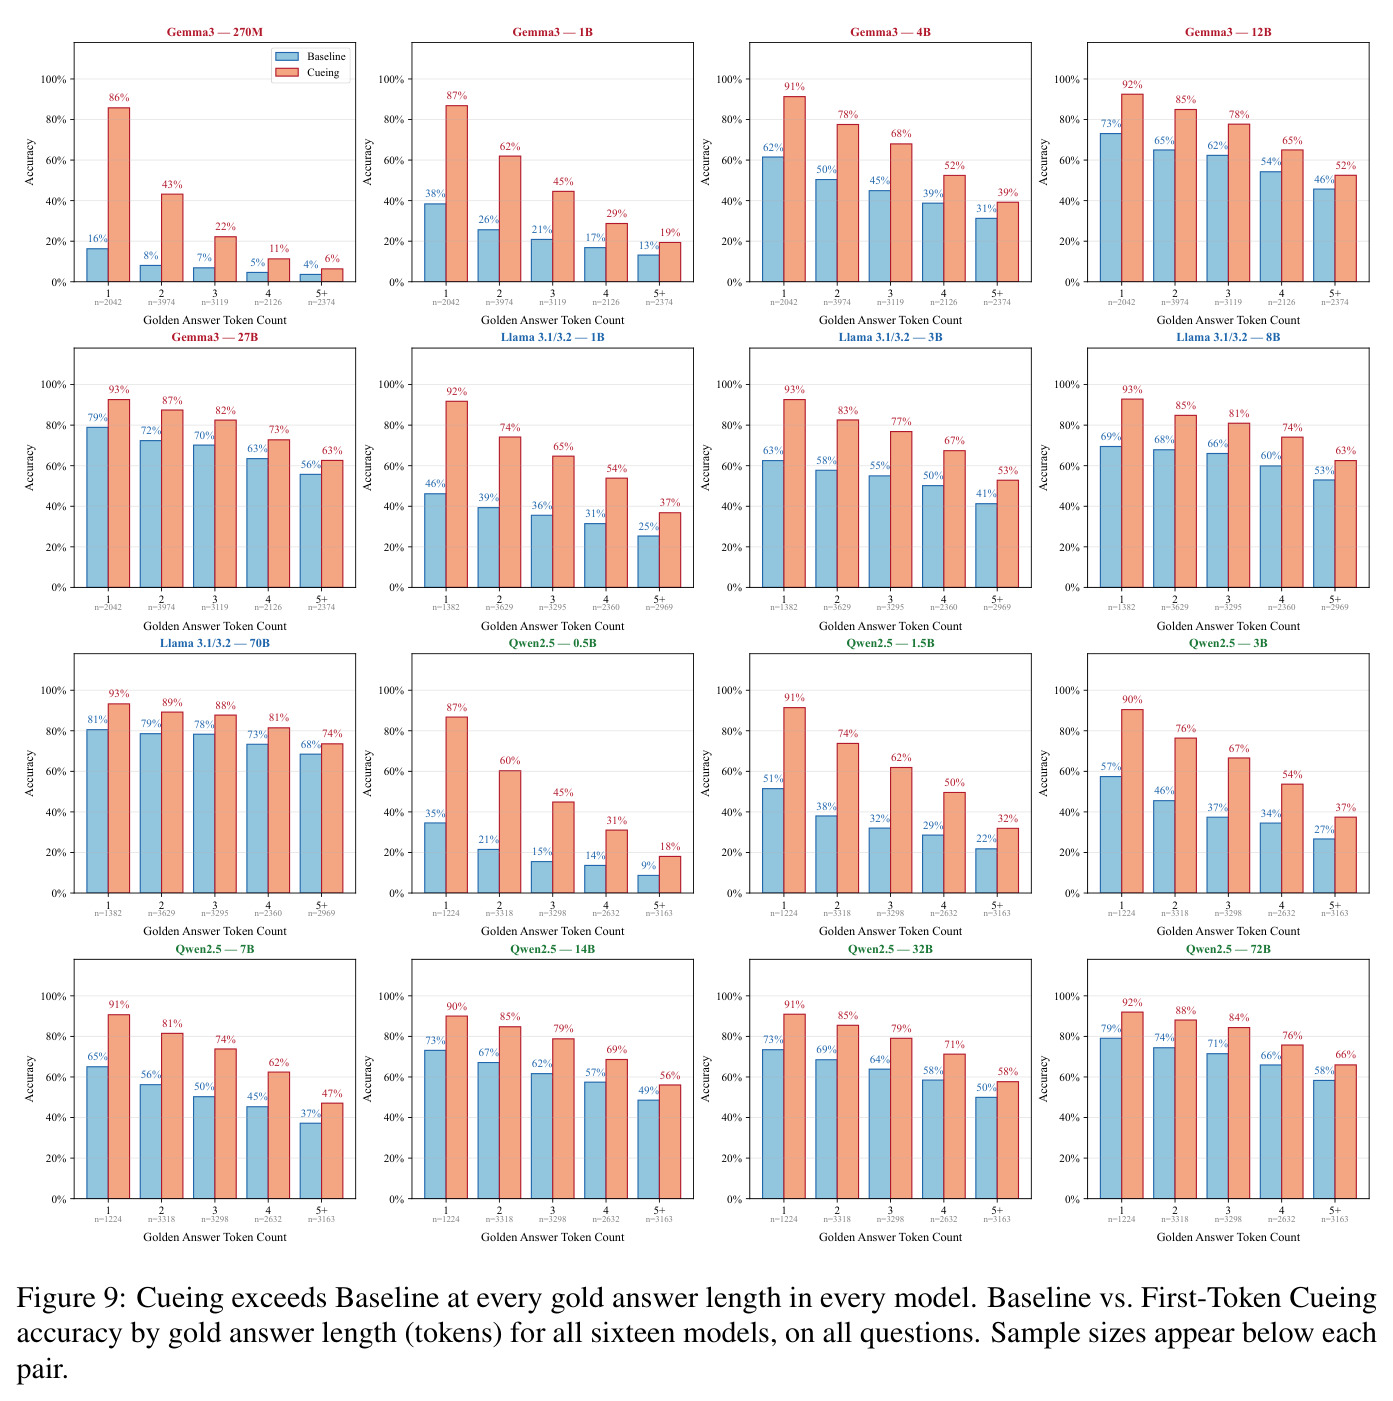
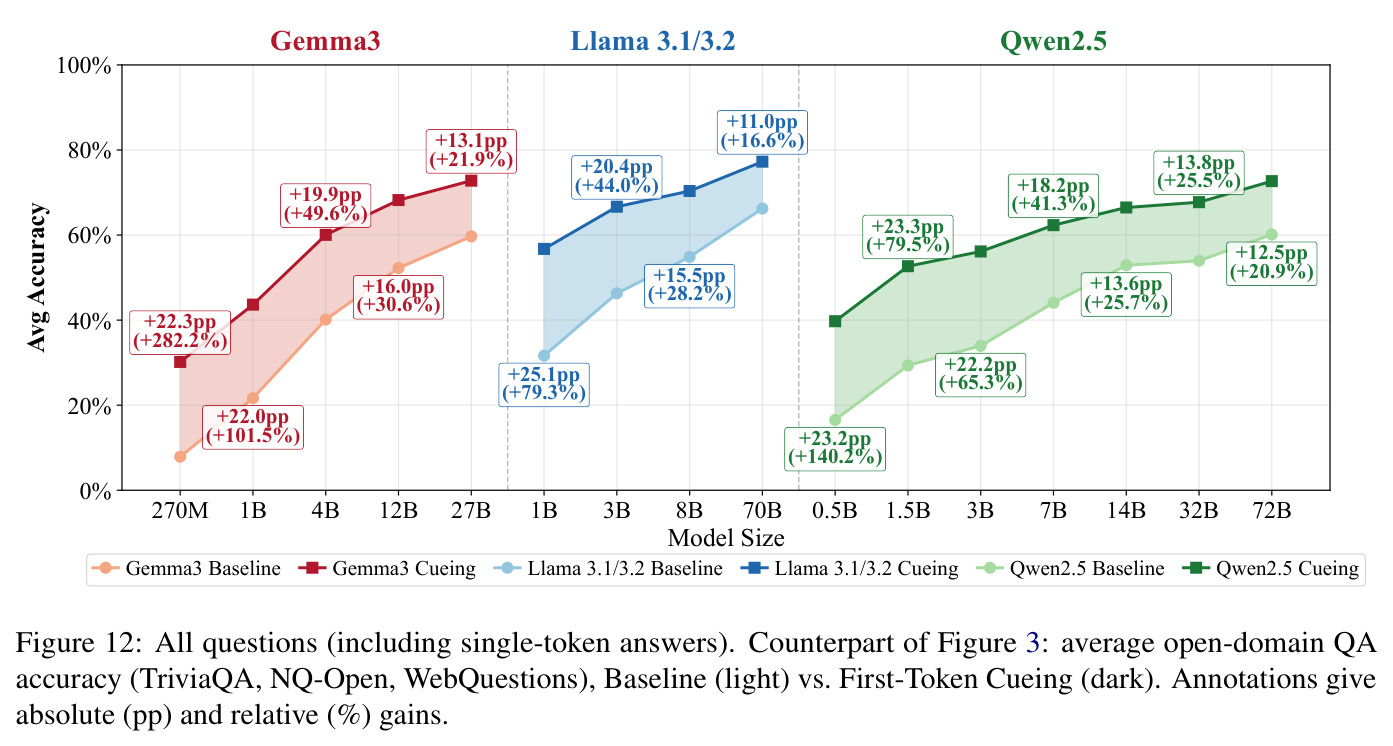
直觉先行:如果许多闭卷错误是『开不了头』而非『不知道答案』,一个极小的提示——答案的首个token——就应该修复大量错误。技术上,设问题 $q$ 的gold答案为 $y^\star$,分词为 $t^\star = \mathcal{T}(y^\star) = (t^\star_1, \dots, t^\star_L)$,chat模板 $\Phi$ 把系统提示与5-shot示例拼成提示 $x_q = \Phi(s, F, q)$。First-Token Cueing在响应起点追加gold首token并贪心续写:$$c_{\text{cue}} = x_q \oplus (t^\star_1), \qquad \tilde{y} = \mathrm{Greedy}(M_\theta, c_{\text{cue}})$$ 评测答案为 $\hat{a} = \mathrm{decode}((t^\star_1) \oplus \tilde{y})$;$k$-token版本预填充前 $k$ 个token。Baseline用相同提示与解码但无cue。评测覆盖Gemma 3(270M–27B)、Llama 3.1/3.2(1B–70B)、Qwen 2.5(0.5B–72B)共16个指令模型,vLLM单卡B200、贪心解码50 token,判分用gpt-oss-120b对照gold与别名。单token答案的cue即完整答案,故headline结果限定 $L \ge 2$(排除约十分之一英语题)。这是oracle诊断探针而非可部署方法。
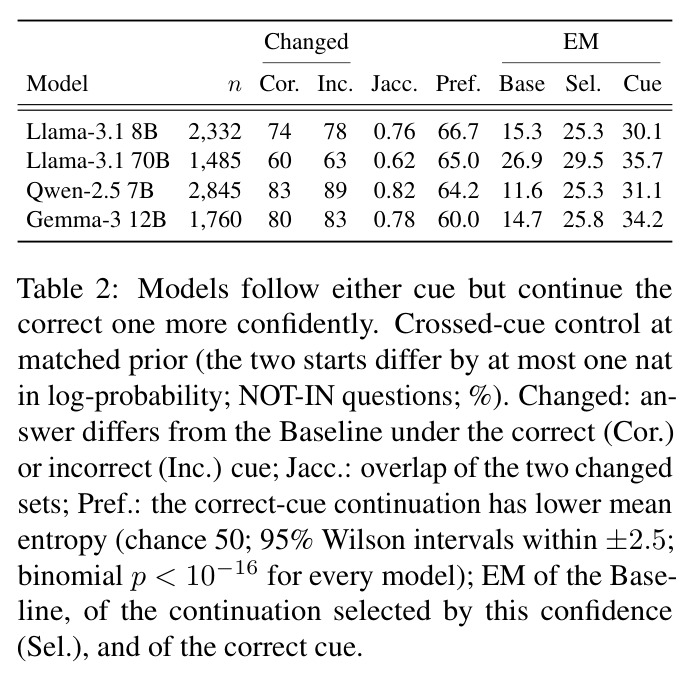
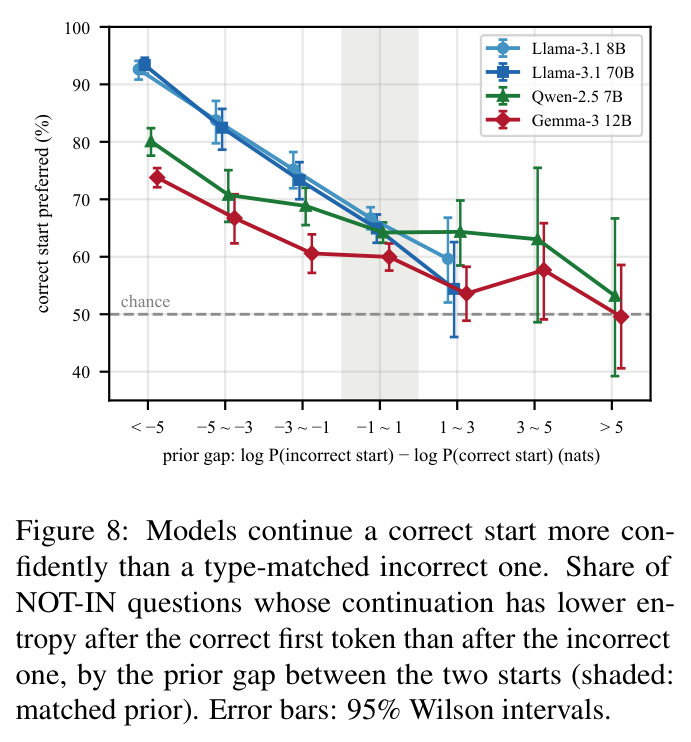
核心创新有三。第一,把首token从『信号』升级为『干预点』:Snel & Oh (2025)与Yeom et al. (2026)只读首token的错误信号,本文直接改动它,把相关性变成因果性的行为证据——错误确实可由第一步的修正消除。第二,cue取自模型自己对gold答案的分词($t^\star_1$ 是首个token而非首字符),保证输入符合模型预期;附录H显示强行用单字符预填充会破坏tokenization,Llama-3.1 8B反而掉13.0/7.1/7.8pp。第三,crossed-cue控制:把候选集不含正确开头的NOT-IN问题按答案类型配对、首token先验差限制在1 nat内(代价 $|\log p(t_j|q_i) - \log p(t_i|q_j)| + |\log p(t_i|q_j) - \log p(t_j|q_j)|$ 的贪心最小成本匹配),同一token在一题是正确cue、在配对题是错误cue,抵消token自身的一切效应;若模型只把cue当信息,它应同等自信地续写同类型同先验的错误开头,实验却显示它显著偏爱正确开头,从而把『识别』与『信息泄露』干净分开。
方法步骤详情
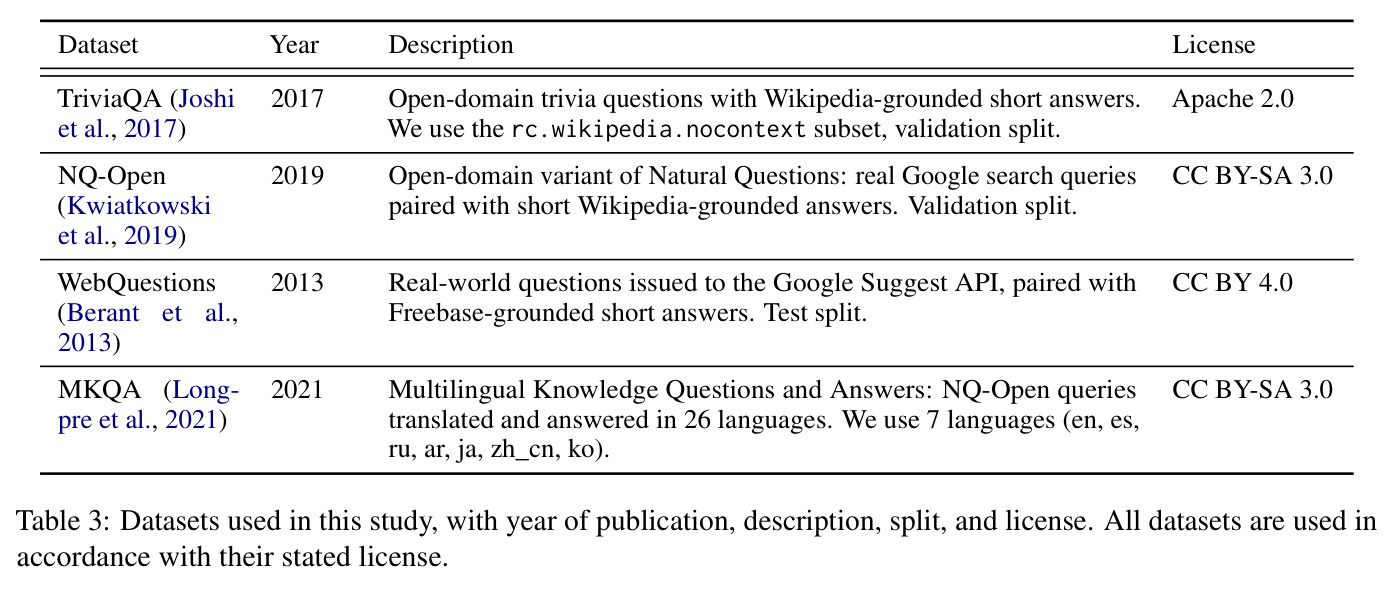
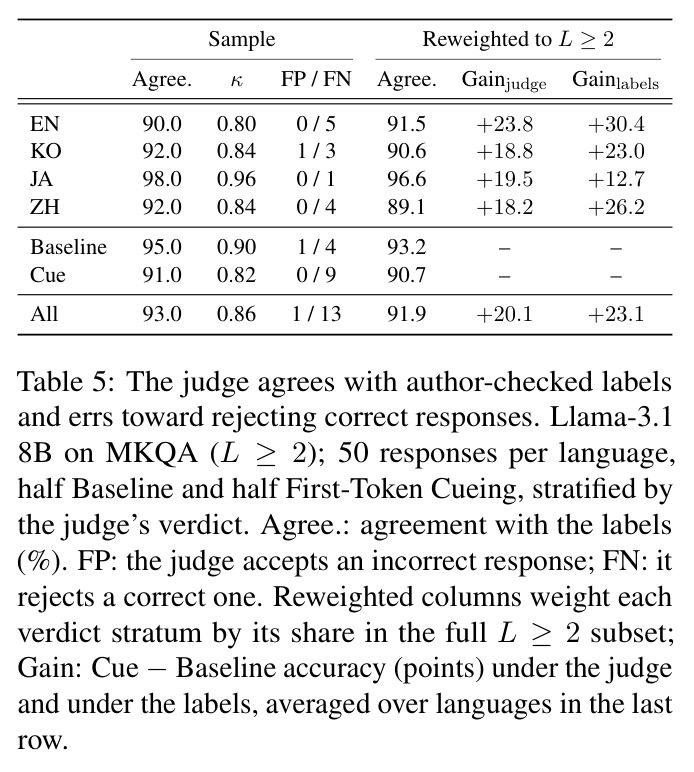
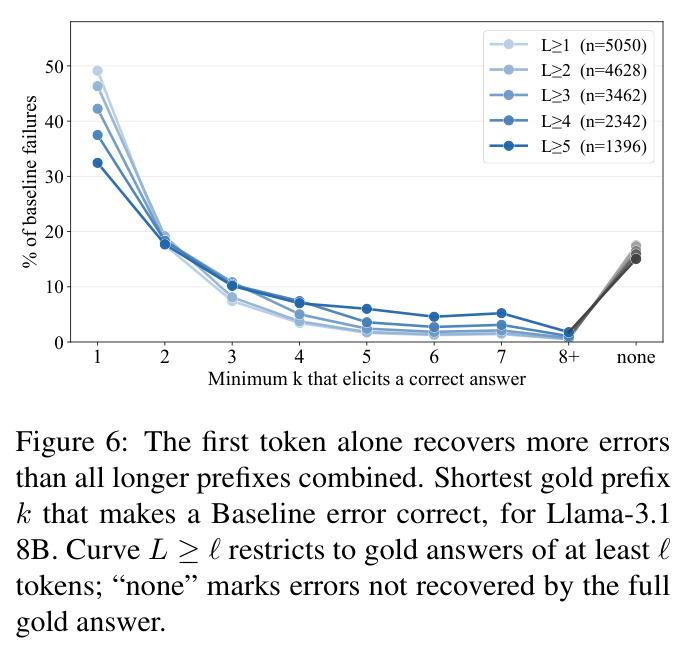
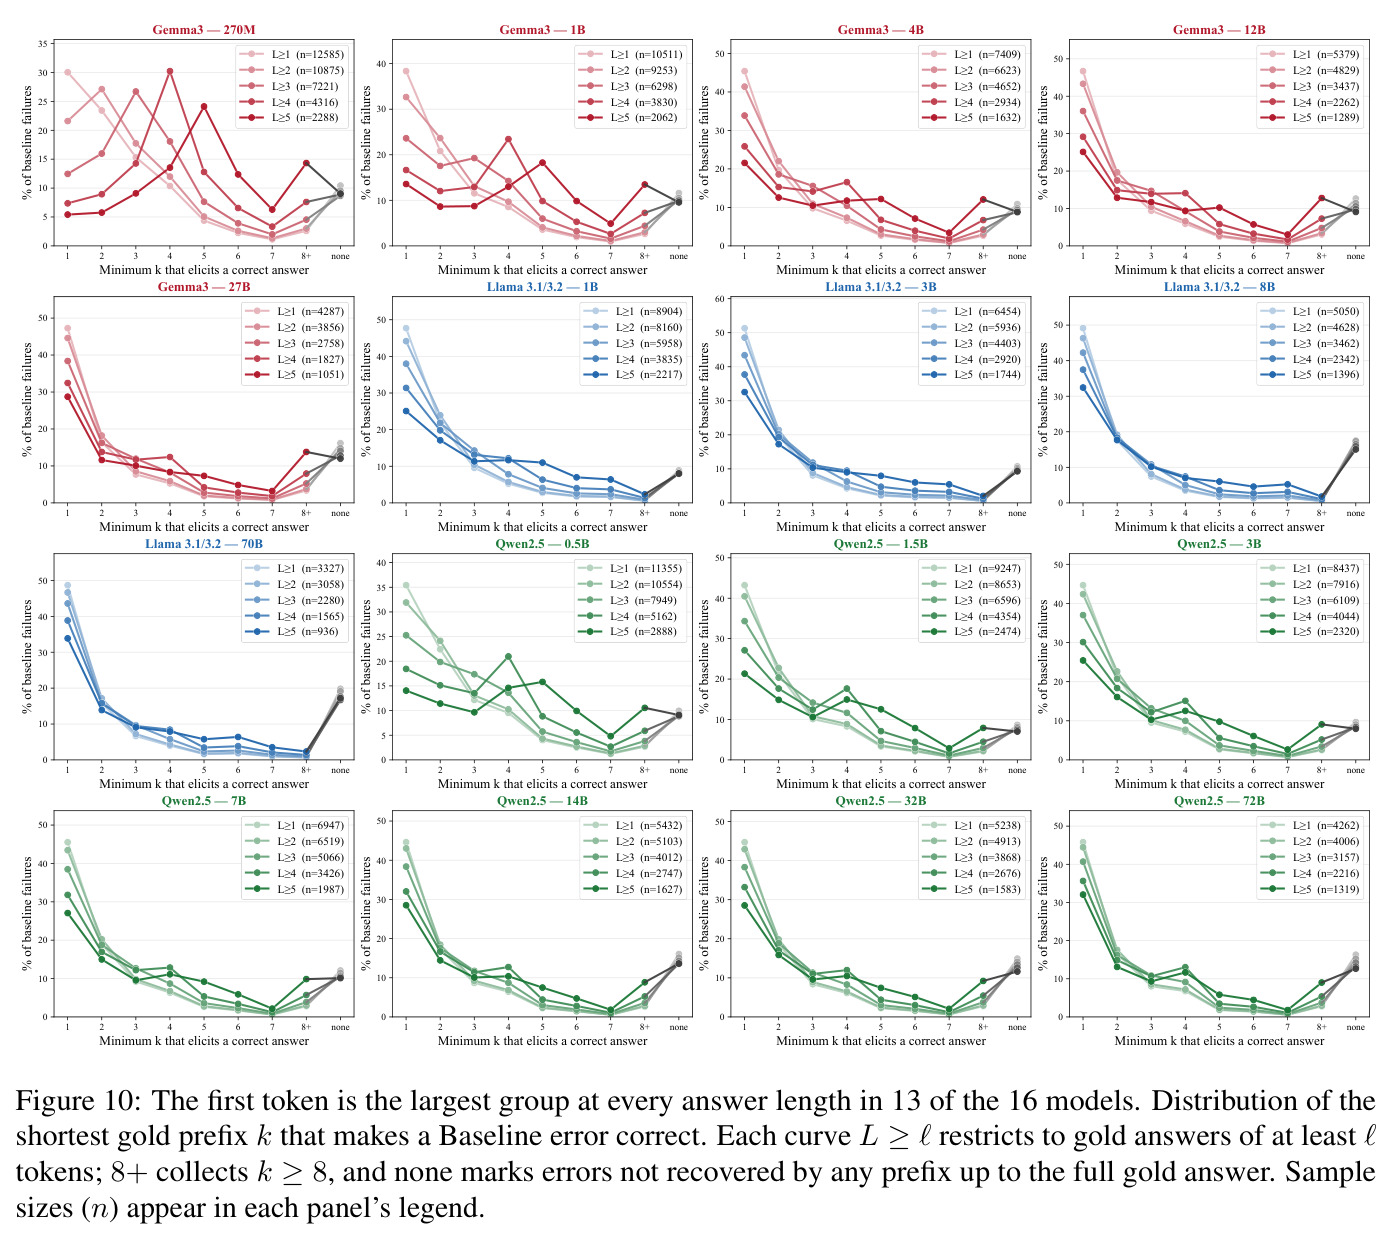
流程十步。(1)数据:TriviaQA(rc.wikipedia.nocontext验证集)、NQ-Open、WebQuestions与MKQA七语言,取gold答案与别名集。(2)构建直接回答提示 $x_q = \Phi(s, F, q)$(5-shot)。(3)Baseline:贪心50 token。(4)Cueing:预填充 $t^\star_1$ 后贪心续写,其余条件与Baseline完全相同。(5)判分:gpt-oss-120b对照gold与别名;作者人工复核200条MKQA响应,一致率93.0%($\kappa=0.86$)且偏保守,按人工标签重估增益从+20.1升至+23.1pp,说明主结果被低估。(6)控制实验:随机token(词表均匀采样)、似真错误token(top-p内概率最高的非gold token)、通用前缀(『Given the question, my answer is: 』)。(7)机制分析:逐位置计算next-token熵 $H$,用AUROC/PRR比较各位置判别力。(8)前缀分解:对每个Baseline错误找使其变正确的最短gold前缀 $k$。(9)oracle分析:在首位置top-$p$($p=0.95$)候选内逐个预填充,任一续写正确记oracle-correct;按候选集是否含gold首token前缀分IN/NOT-IN;另跑pass@16 CoT作独立判据。(10)crossed-cue:标注七类答案类型、同数据集同类型配对且先验差≤1 nat,记录两种cue下答案是否改变、正确性及续写负熵置信度,用Wilson区间与二项检验对照50%随机水平。
技术新颖性
新颖性有四。其一,测量范式:不同于读内部状态的probing(Burns et al. 2023)与激活干预(Li et al. 2023; Simhi et al. 2024),探针只依赖预填充,黑盒API模型可用,且要求模型自己续写剩余答案,比给完整答案打分(Gekhman et al. 2025)更严格。其二,干预粒度:把诊断精确到首个解码步,与对每步一视同仁的test-time scaling互补,直接指出计算应集中之处。其三,实验设计:crossed-cue配对加先验匹配是心理学对照在LLM评估中的少有移植,正面解决『cue泄露答案信息』这一最尖锐的替代解释;前缀歧义度分析(Table 13)显示收益峰值在中等信息量前缀(数据集中共享2–20个答案的超额+15.3/+10.3pp)而非唯一前缀(+8.4/+8.1pp),说明模型在用问题补全答案而非机械续写,更像回忆而非查找。其四,结论与人类TOT结构同构:feeling-of-knowing(认得却说不出)对应第6节识别实验,onset cueing对应First-Token Cueing,为一类错误提供统一的行为学命名与可操作判定流程。
实验结果
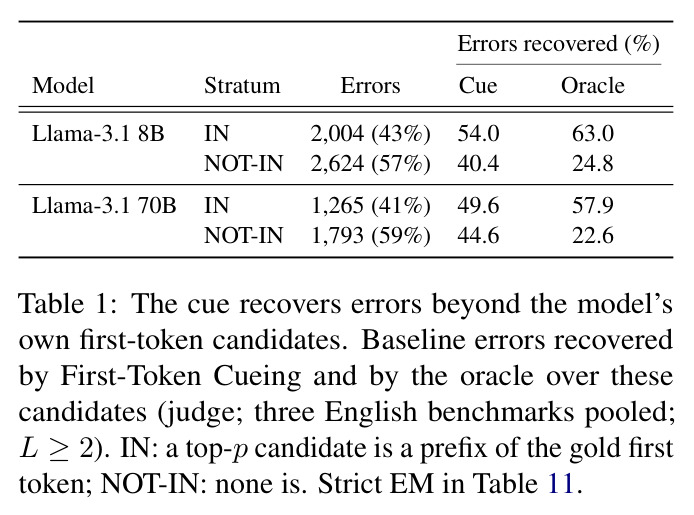
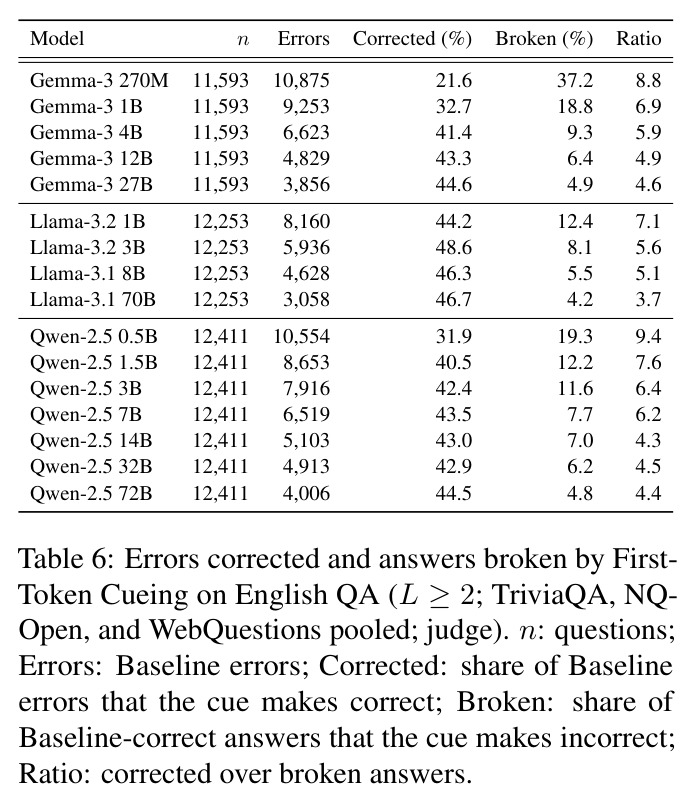
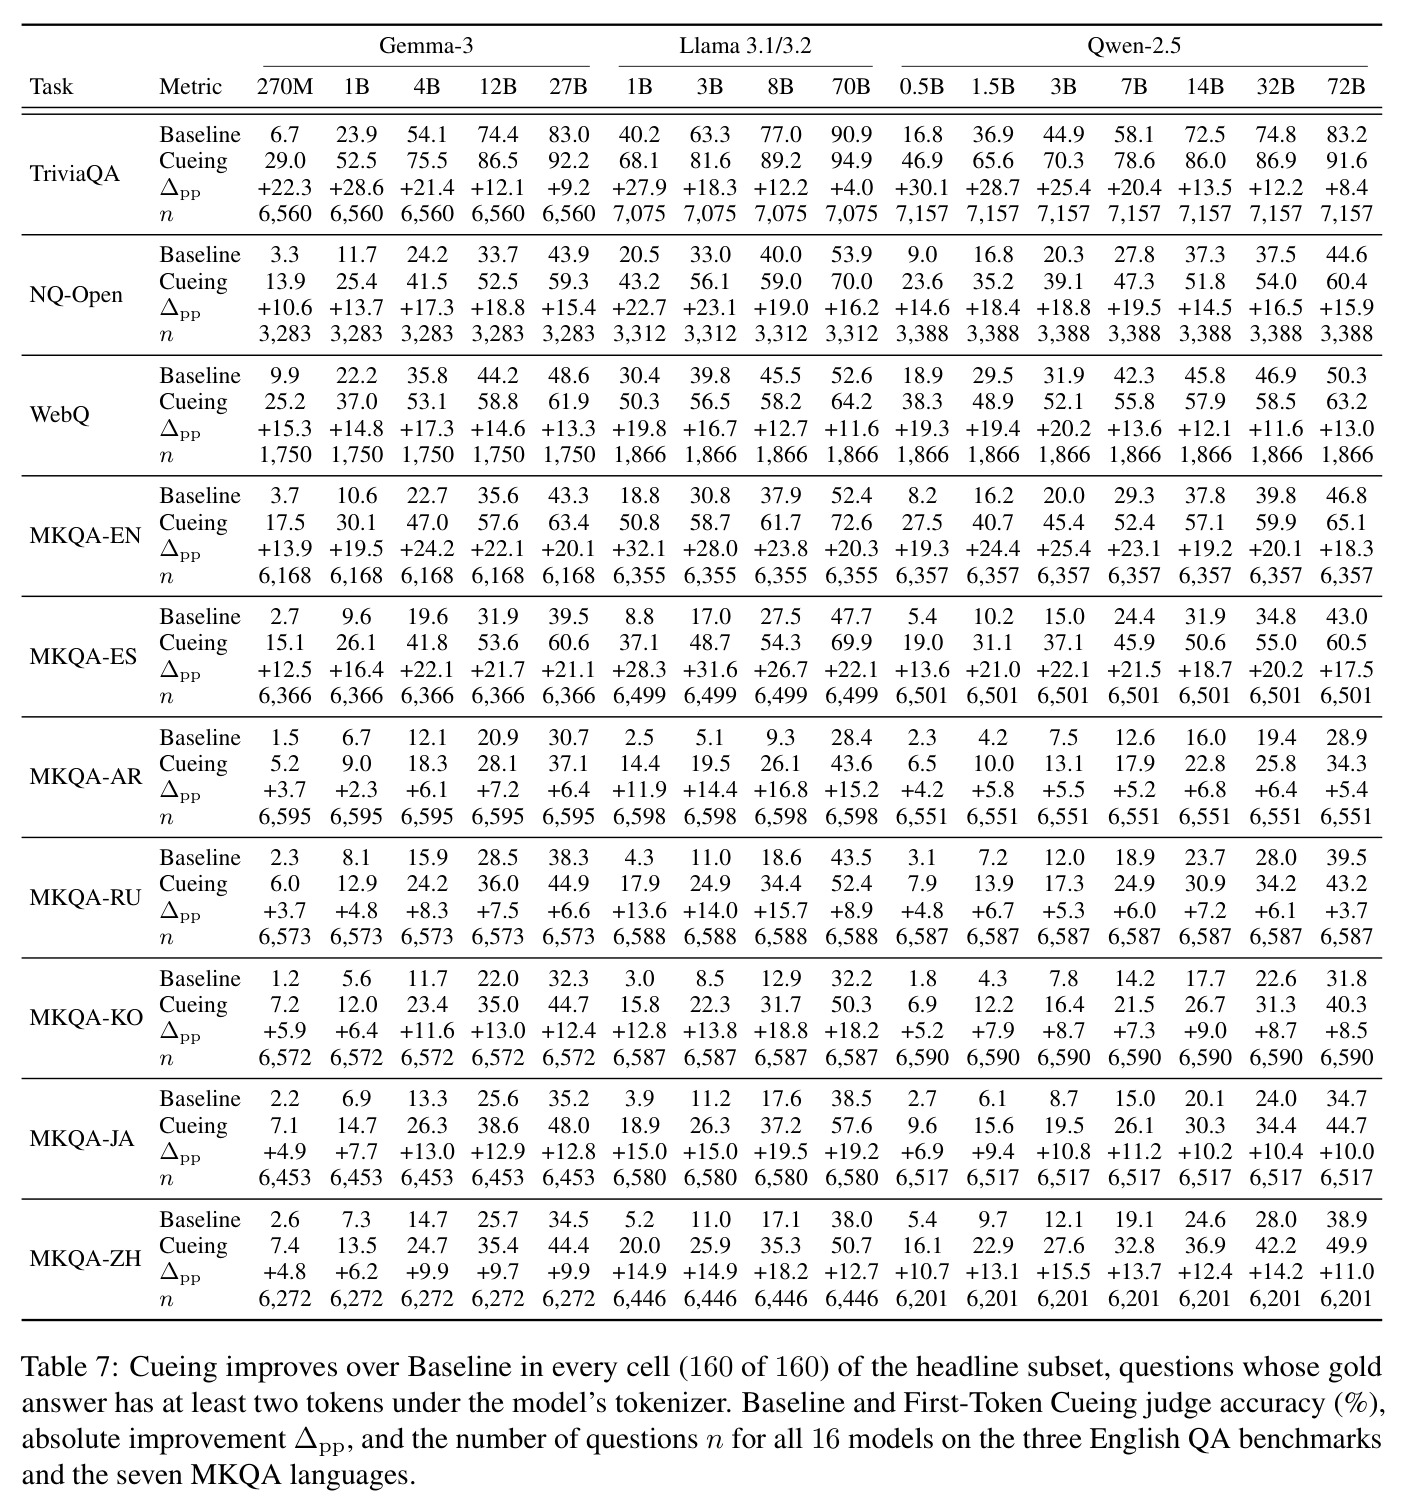
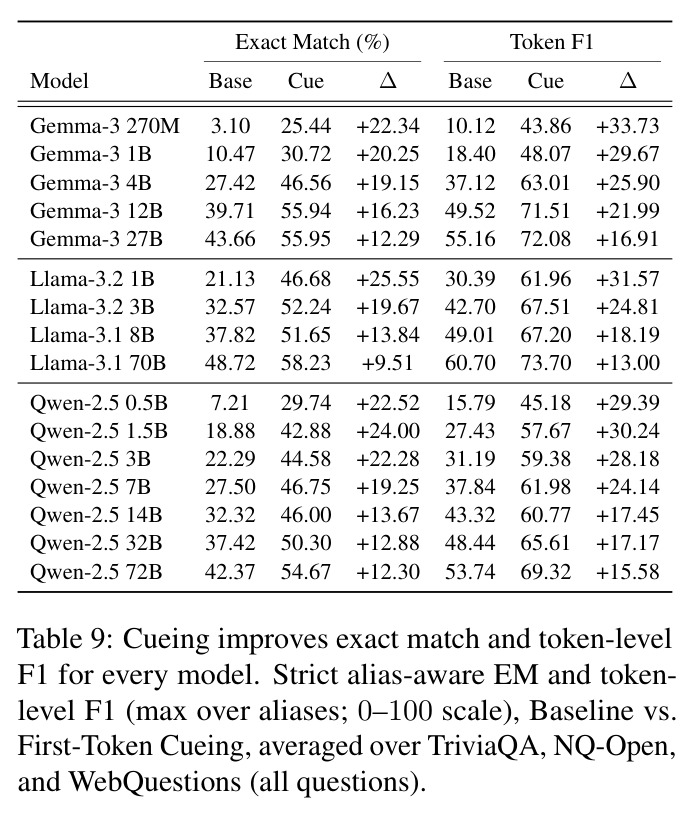
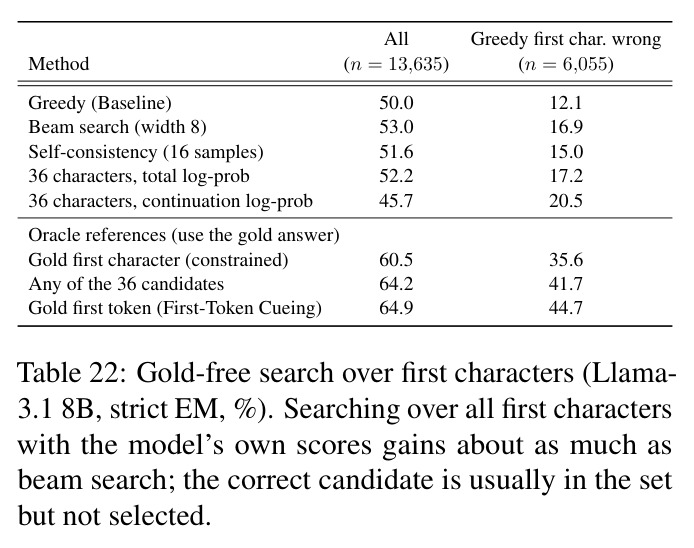
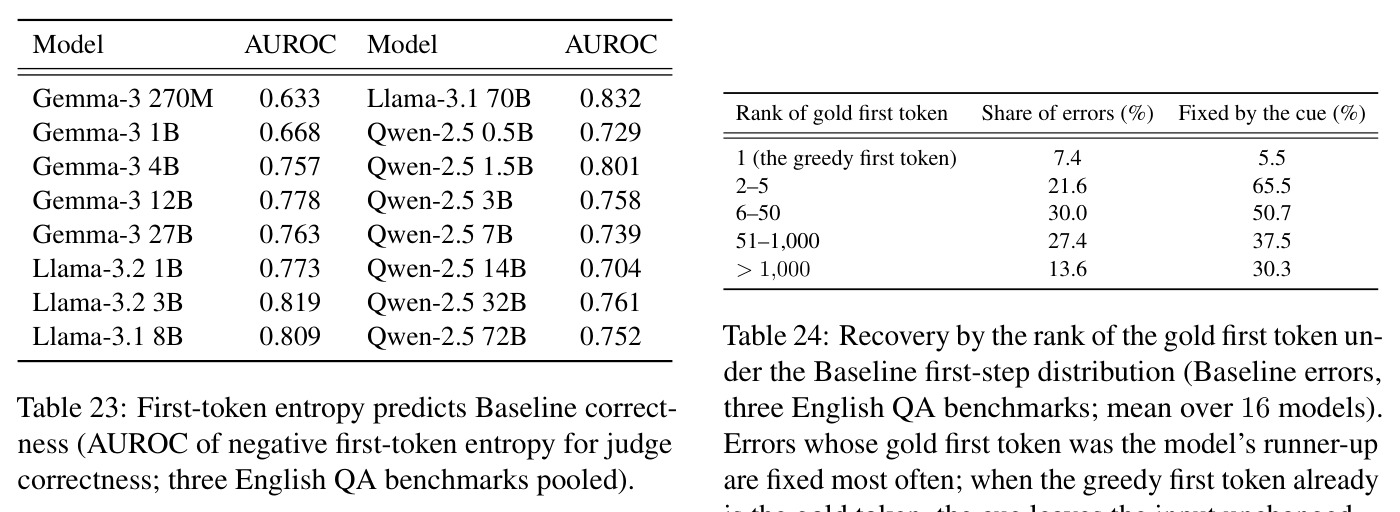
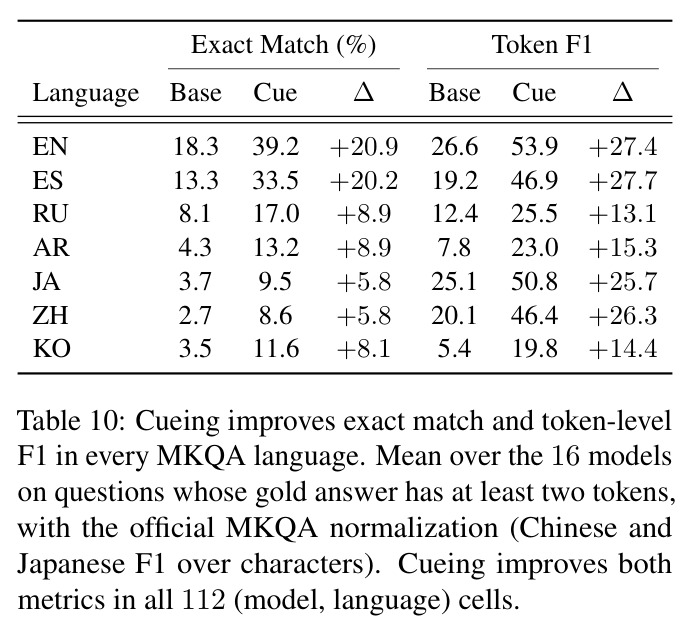
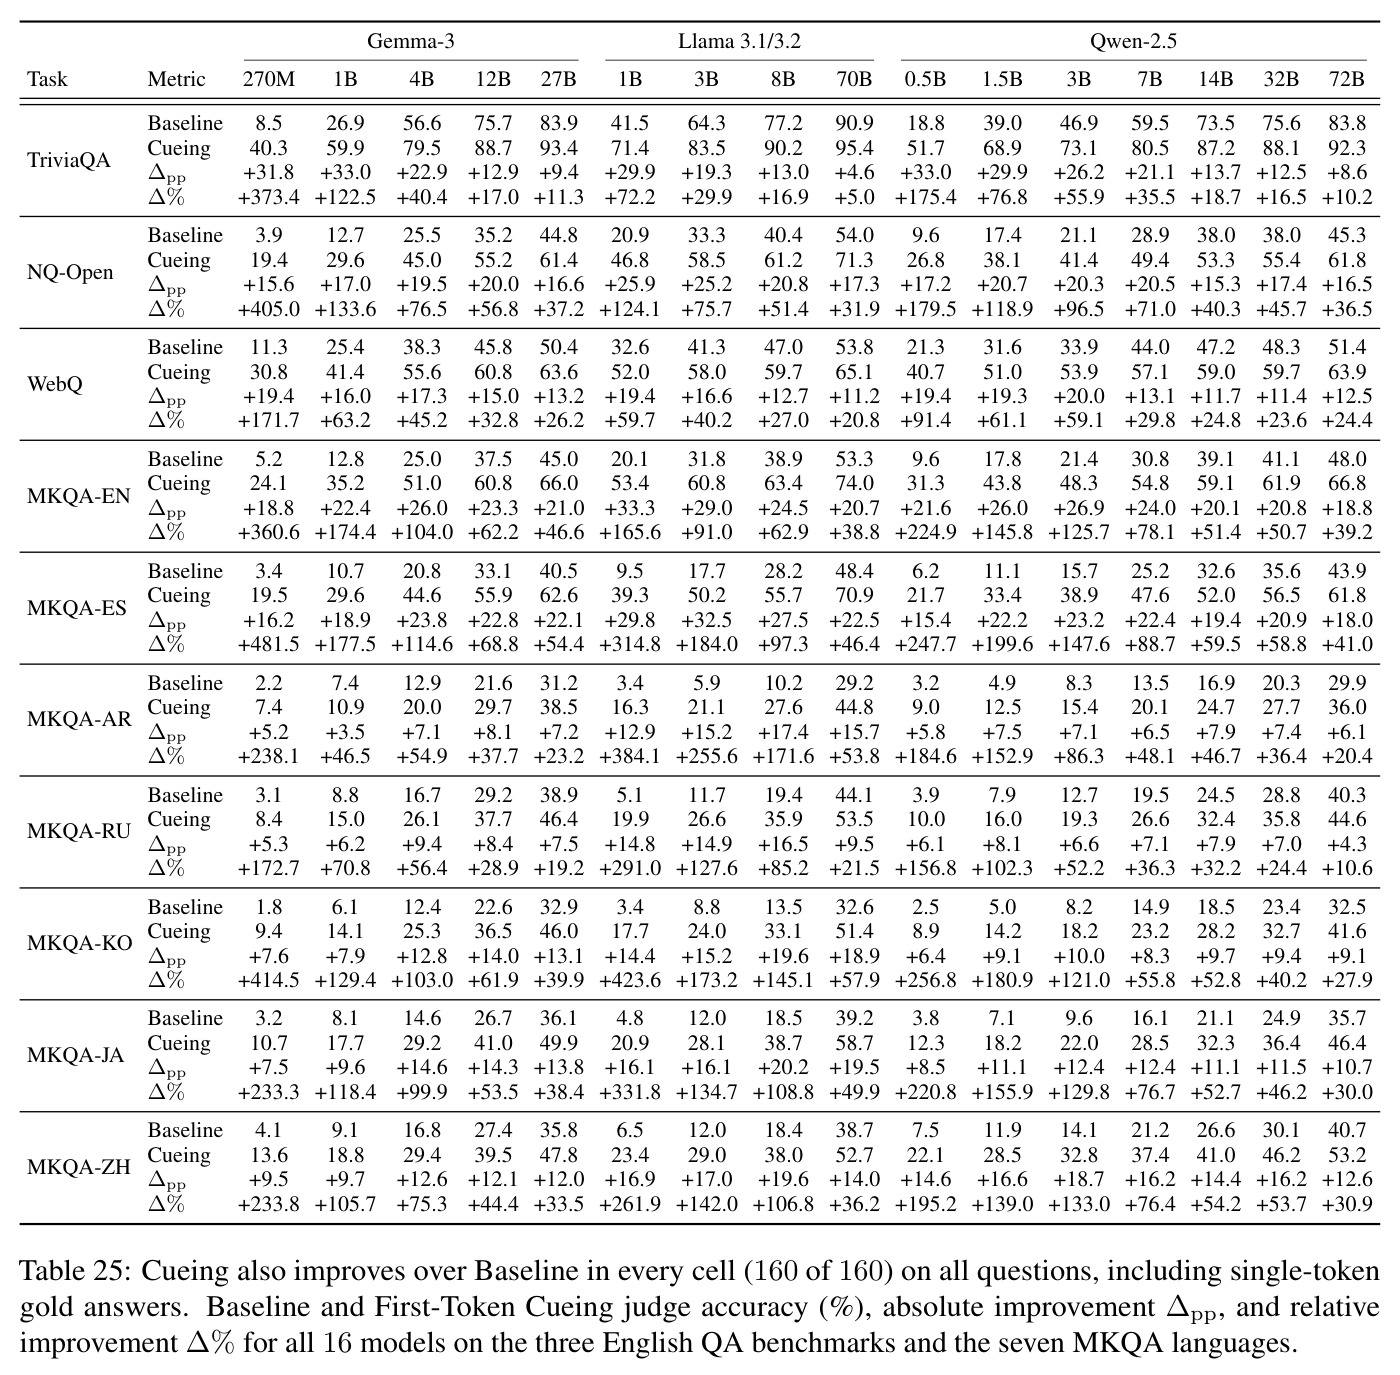
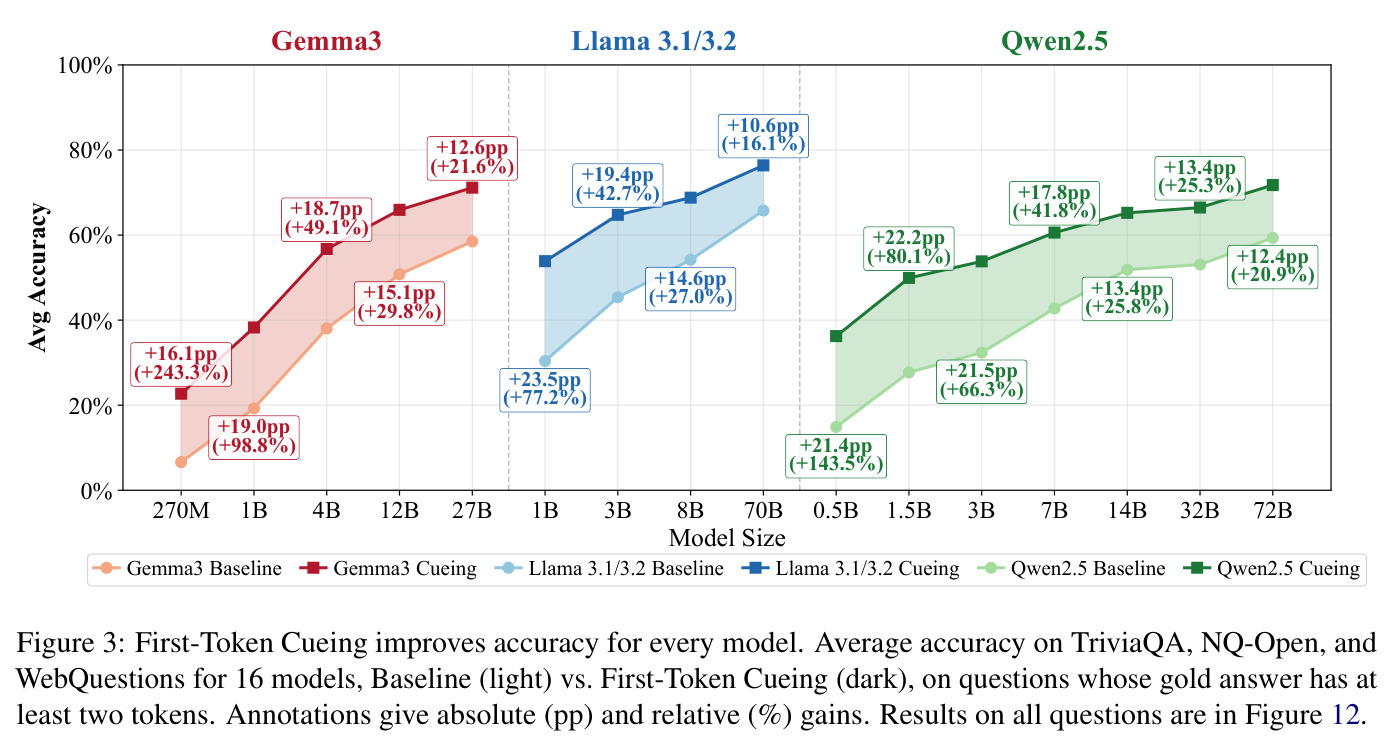
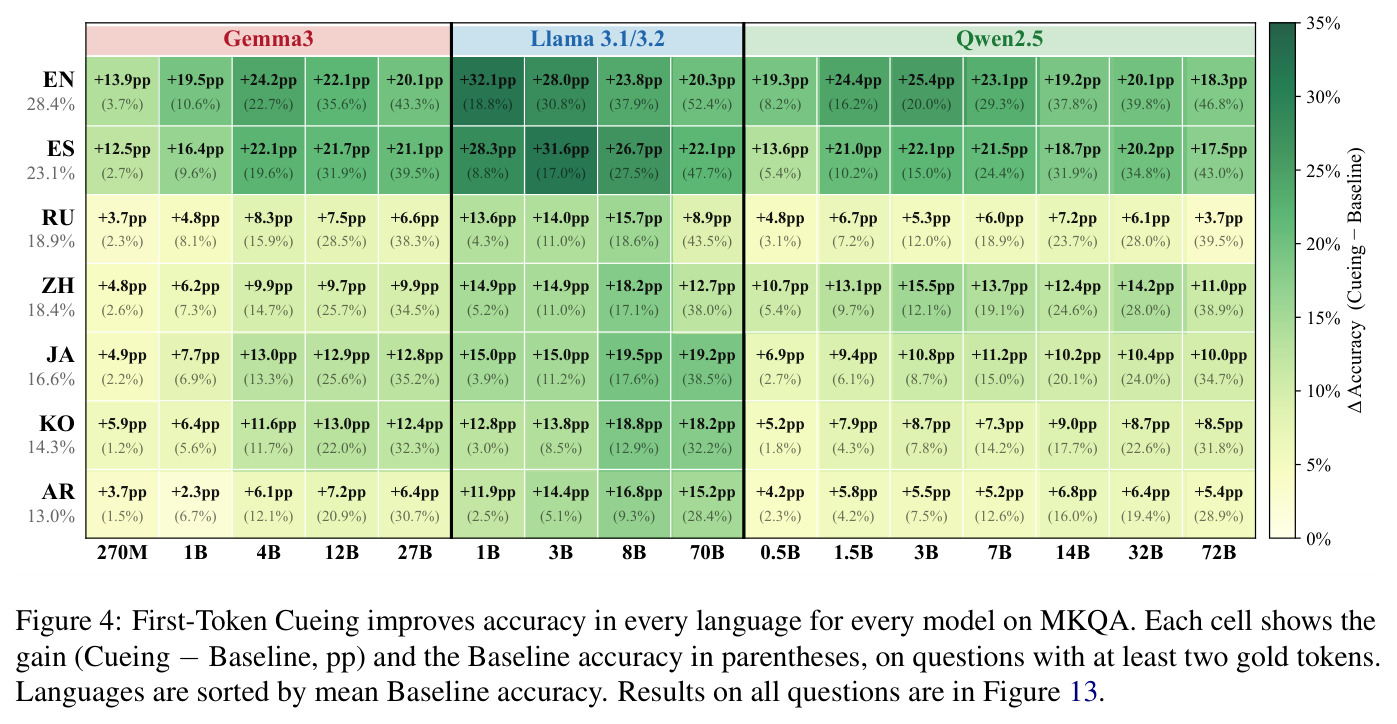
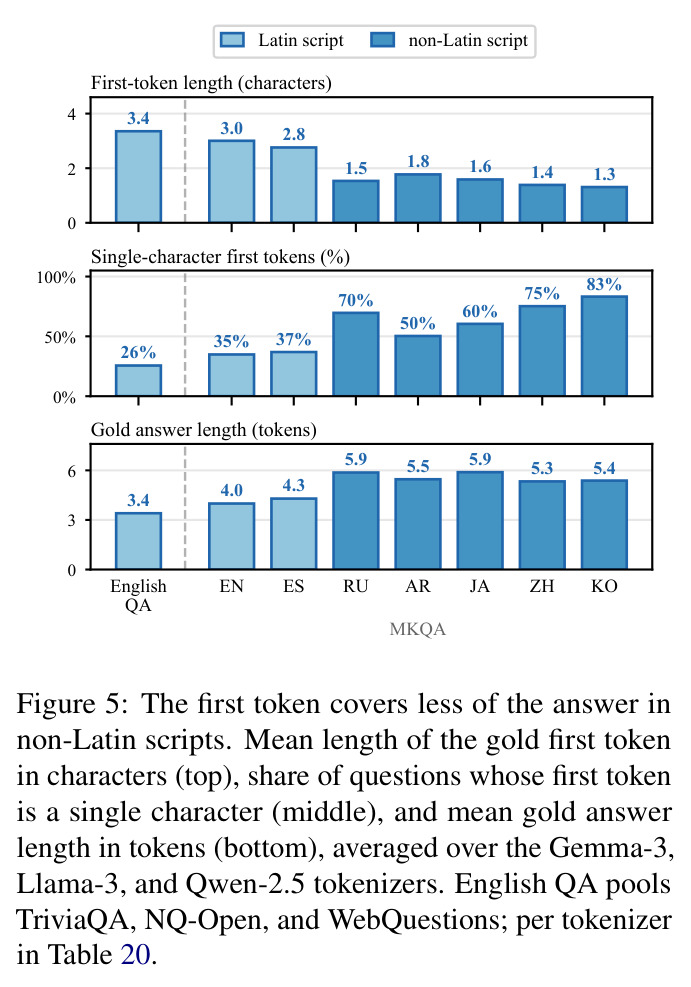
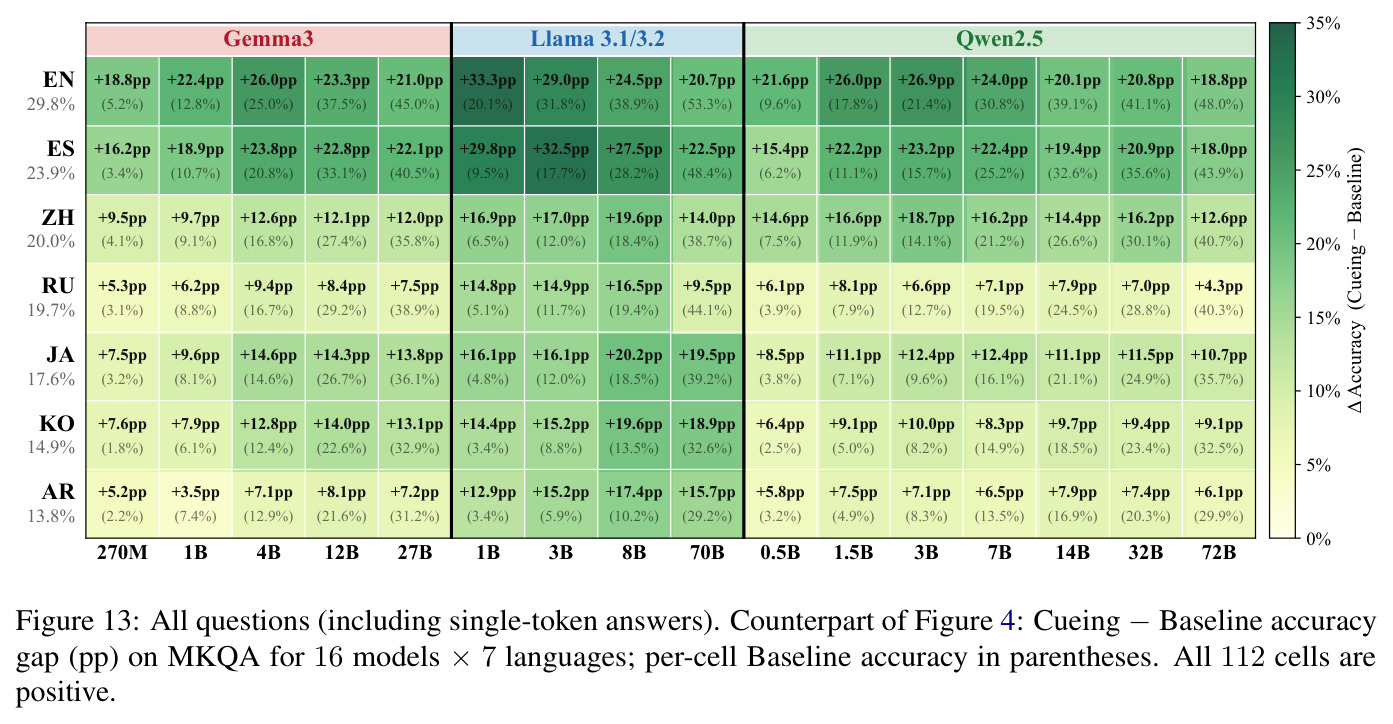
发现覆盖16模型、160个(模型,任务)格子。(1)不确定性集中于首token:首token熵对Baseline正确性的AUROC为0.633(Gemma-3 270M)至0.832(Llama-3.1 70B),几乎与整答案平均熵一样好,第2、3个token差得多;cue修复率随gold首token在Baseline分布中的排名递减——排名2–5的错误修复65.5%,排名>1000仅30.3%。(2)首token修复大量错误:英语QA($L\ge2$)上cue修复Baseline错误的21.6%(Gemma-3 270M)至48.6%(Llama-3.2 3B),≥3B模型均40–50%,同时仅破坏4.2–37.2%的原本正确答案,修复/破坏比3.7–9.4(McNemar $p<10^{-100}$);绝对增益小模型更大(TriviaQA:Gemma-3 270M 6.7→29.0%,Llama-3.1 8B 77.0→89.2%,70B 90.9→94.9%),但可修复比例不随规模下降,支持『回忆而非编码是瓶颈』。(3)多语言全部有效:MKQA 112个格子全正,EN/ES增益最大(Llama-3.1 8B EN +23.8pp),AR/RU最小,增益与首token字符长度正相关——非拉丁文字38–94%的首token是单字符。(4)修复超越信息泄露:IN错误上cue修复54.0%略低于oracle的63.0%;NOT-IN上cue修复40.4%远超oracle的24.8%,候选集仅单候选时仍超+5.3/+1.9pp;以thinking pass@16为独立判据,77%(8B)/62%(70B)的cue可修复错误同时是thinking-recoverable,cue对『已编码』失败修复约60%、对其余仅27–34%。(5)模型认得说不出的开头:crossed-cue中60.0–66.7%的题目正确cue续写更自信($p<10^{-16}$),但无gold的36字符搜索仅+2.1pp,尽管64.2%的题目候选集中存在正确答案。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 英语闭卷QA(TriviaQA/NQ-Open/WebQuestions,L≥2) | Baseline错误修复率 | 21.6%(Gemma-3 270M)至48.6%(Llama-3.2 3B);所有≥3B模型40–50% | 0%(无cue的Baseline) | 平均准确率+10.6至+30.1pp;修复/破坏比3.7–9.4(McNemar p<10^-100,160/160格子改进) |
| TriviaQA(Llama-3.1 8B,L≥2) | judge准确率 | 89.2% | 77.0% | +12.2pp(相对+15.8%) |
| MKQA七语言(16模型,L≥2) | judge准确率 | 112/112格子全部改进;EN增益+18.3~+32.1pp,AR +2.3~+16.8pp | 各格Baseline准确率0.8%–52.4% | 增益随首token字符长度单调上升(1字符+6.0~+21.2pp vs 4+字符+12.1~+31.5pp,Table 18) |
| 首token熵预测Baseline正确性 | AUROC | 0.633(Gemma-3 270M)至0.832(Llama-3.1 70B) | 0.5(随机) | 接近整答案平均熵的判别力;第2/3个token显著更差 |
| Crossed-cue置信度偏好(NOT-IN配对,先验差≤1 nat) | 正确cue续写更自信的题目比例 | 60.0%(Gemma-3 12B)至66.7%(Llama-3.1 8B) | 50%(随机水平) | 二项p<10^-16;等先验置信度优势(回归截距)+0.07~+0.38 nat |
| Random-Token控制(英语QA平均) | judge准确率变化 | First-Token Cueing约+18pp | 随机首token使准确率平均下降22.7pp(48/48格子全部下降,-7.3至-38.7pp) | 证明收益依赖cue内容与gold答案匹配,而非预填充本身 |
| 无gold首字符搜索(Llama-3.1 8B,严格EM) | 准确率 | 36字符搜索+总分选择52.2% | 贪心50.0%;beam search(宽8) 53.0% | 仅+2.1pp,尽管64.2%问题候选集中存在正确答案(oracle 64.2%)——识别与寻找的差距 |
局限与改进
作者承认的局限:研究限于短答案事实QA,gold答案及其首token才有明确定义,扩展到长文本生成(以每个事实断言的首token为探针)是下一步;First-Token Cueing依赖gold答案,是诊断而非可部署的解码方法,『回忆失败』是行为学推断而非内部状态证据;无gold时如何供给首token(如检索)留作未来工作。我的观察:其一,判分完全依赖单一judge(gpt-oss-120b),200条人工复核虽显示93.0%一致且偏保守(只会低估增益),但存在系统性误拒模式(年份形式『1776』、多实体列表、别名处理),MKQA翻译质量也未讨论;其二,『cue可修复≠回忆失败』的论证依赖多层间接证据(oracle超出、pass@16重叠、crossed-cue),首token处到底发生什么(知识检索失败还是表面形式竞争——Yeom et al. 2026提到概率质量分散于多种表面形式)缺乏机制层面解释;其三,三个家族均为稠密Transformer指令模型,未覆盖MoE与闭源前沿模型;其四,非拉丁语言的弱增益归因于tokenizer粒度,但与语言能力本身混杂;其五,crossed-cue在1-nat caliper下覆盖率仅16.2–40.5%,配对可能引入选择偏差,放宽caliper后原始偏好升至74.8–76.5%。
独立分析的弱点
独立分析的弱点:(1)探针依赖gold答案无法部署——改进方向:由检索器供给首token候选,或让模型对自身top-$k$首token分支后用外部证据选择;36字符实验表明纯模型内选择只拿到约三分之一的oracle收益,缺口正是外部证据的价值空间。(2)置信度选择彻底失败:正确开头的续写比其他候选更自信(82.7%)却通常打不过模型已承诺的错误开头(仅39.9%更低熵),说明内部置信度无法推翻首选——可设计首token对比损失等训练目标,或在首token高熵时触发重采样/回卷的推理机制。(3)跨语言失衡根源在tokenizer粒度:非拉丁文字38–94%的首token是单字符,一个token承载的信息太少——逐语言自适应cue粒度(字符级/音节级约束解码)或优化分词器可释放收益。(4)只系统测了贪心解码与50 token预算,采样温度与提示形式(CoT仅出现于pass@k对比)的影响未探索。(5)判分单judge且有系统性误拒(年份、多实体、别名),值得多judge或规则化修正。(6)结果对口径敏感:headline排除单token题(约十分之一英语题),全题口径(Table 25)增益更大,与其他工作比较时需注意口径一致性。
未来方向
作者明确提出的方向:(1)无gold的首token供给——如检索系统在首token层面提供证据,把诊断收益转化为推理时收益,『此类方法能否挽回同等收益』被列为开放问题;(2)扩展到长文本生成,以每个事实性声明的首token为探针单位,对接幻觉检测文献(幻觉片段首token信号最强,Snel & Oh 2025);(3)把推理时计算集中于首token——这些错误在第一步已被决定,而现有解码与test-time scaling对每步一视同仁。基于成果可延伸的方向:(4)训练侧干预——设计首token感知的微调目标,让参数化知识在首位置的排序更靠前;(5)自适应计算分配——首位置熵高时触发检索/重采样/验证,类似Glimprouter(Zeng et al. 2026)以单token glimpse路由推理的思路;(6)机制研究——用因果追踪或激活补丁定位首token承诺的内部回路,检验传递缺失假说在Transformer中是否有对应物;(7)安全维度——预填充对齐绕过(Qi et al. 2025)与cue现象共享机制,可研究对恶意cue的鲁棒性;(8)把crossed-cue配对推广为『模型是否认得自己说不出之物』的通用评测工具,用于翻译、指令跟随等任务的失败归因。
复现评估
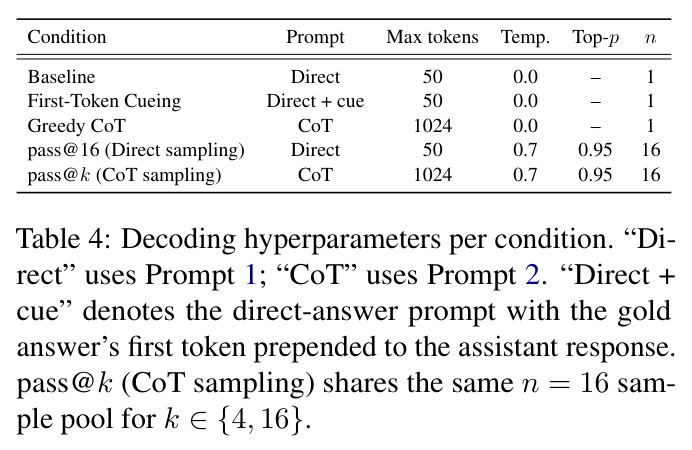
复现条件很好。模型全为公开权重:Gemma-3的-it变体(270M–27B)、Llama 3.1/3.2的-Instruct(1B–70B)、Qwen 2.5的-Instruct(0.5B–72B)共16个;数据集公开且license明确(TriviaQA Apache 2.0、NQ-Open与MKQA CC BY-SA 3.0、WebQuestions CC BY 4.0);判分模型gpt-oss-120b也开源,服务参数(vLLM eager模式、贪心、4096上下文、显存利用率0.80)完整给出。附录提供全部提示模板(Prompts 1–5)、六种条件的解码超参(Table 4:Baseline/Cueing贪心50 token;采样温度0.7、top-p 0.95、n=16;CoT预算1024)与判分解析规则,人工复核协议(每语言50条分层抽样)也很细。算力:单卡NVIDIA B200、bfloat16、4096上下文即可完成全部推理(72B约需140GB显存,无B200可用多卡或量化),另有judge推理开销。论文未提及代码开源,需自行实现预填充/判分/配对管线,其中crossed-cue的贪心最小成本匹配最繁琐,但论文给出代价公式、1-nat caliper与覆盖率数据(Table 21)足以对拍。综合:概念与实现都不复杂,主要成本在16模型×4基准×多条件的推理量与judge调用,复现难度中等偏低。
论文图表
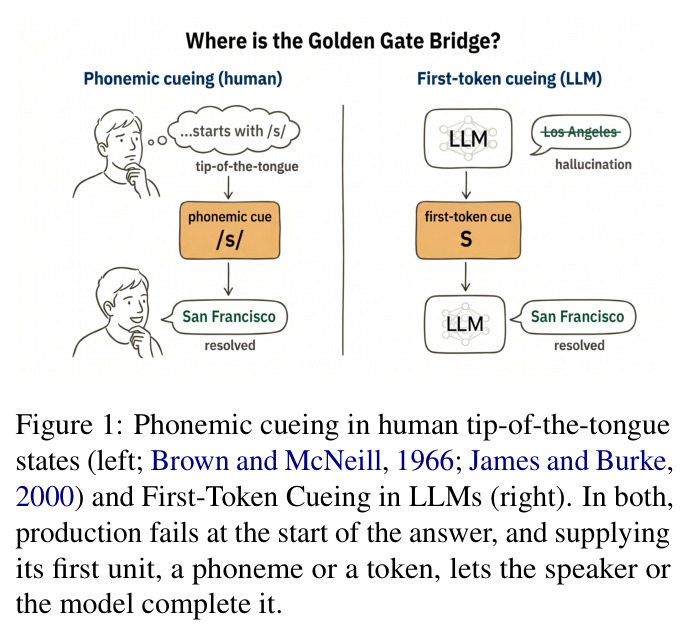
左右对照的示意图:左侧是人类的舌尖现象——说话者说不出目标词,给一个音素即可补全;右侧是LLM的First-Token Cueing——模型产生不出答案,预填充gold答案的首token后模型完成剩余部分。
一图讲清全文的核心类比与方法:产出都在答案开头失败,供给首个最小单元(音素/token)即可完成。作者声明这只是范式类比而非机制主张,图是这个立场的可视化。