MultiAgent-OPD:基于在线策略蒸馏的层级多智能体系统端到端训练 MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
任务Teacher对Searcher逐token蒸馏,Leader与Answerer用结果奖励联训。
前置知识
GRPO(组相对策略优化)
一种无需 critic 网络的 RL 算法:对同一问题采样一组 $G$ 条轨迹,用组内奖励的均值和标准差做归一化得到优势,即 $\hat{A}^{\text{GRPO}}_{r,i} = \frac{R_{r,i} - \mu_{x,r}}{\sigma_{x,r} + \epsilon}$,替代价值函数估计基线,再配合 PPO 裁剪目标更新。DeepSeek-R1 等推理模型训练广泛使用它。
本文所有基于结果奖励的角色(Leader、Answerer、Stage I 的 Searcher)都用 GRPO 计算优势,且在各角色内部单独归一化,读懂方法部分必须先理解这个公式。
在线策略蒸馏(On-Policy Distillation, OPD)
学生模型在自己的采样轨迹上,用冻结 Teacher 对相同前缀 $h_t$ 的概率分布作为目标,最小化反向 KL 散度 $\ell_t = D_{\text{KL}}(\pi_\theta(\cdot|h_t) \\| \pi_T(\cdot|h_t))$。其负梯度中教师与学生概率之比 $\log\frac{\pi_T(a_t|h_t)}{\pi_\theta(a_t|h_t)}$ 天然充当逐 token 优势,只惩罚学生'自信但偏离教师'的 token。
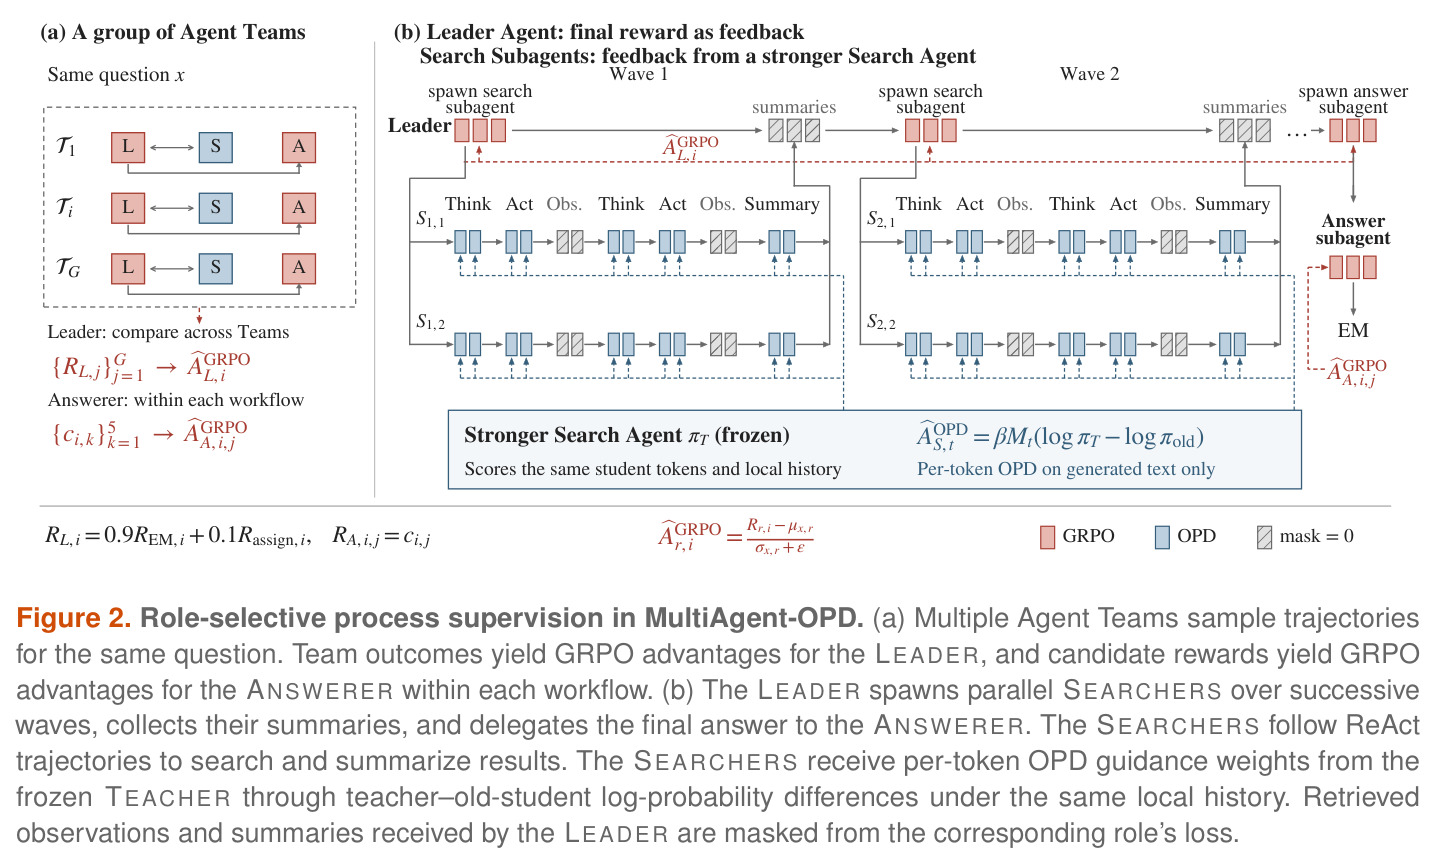
这是本文核心训练信号:Searcher 的每个 token 的优势 $\hat{A}^{\text{OPD}}_{S,t} = \beta M_t \log\frac{\pi_T(a_t|h_t)}{\pi_{old}(a_t|h_t)}$($\beta=0.01$)完全来自这个 log-ratio,而非最终答案对错。
层级多智能体系统(Leader–Subagent 架构)
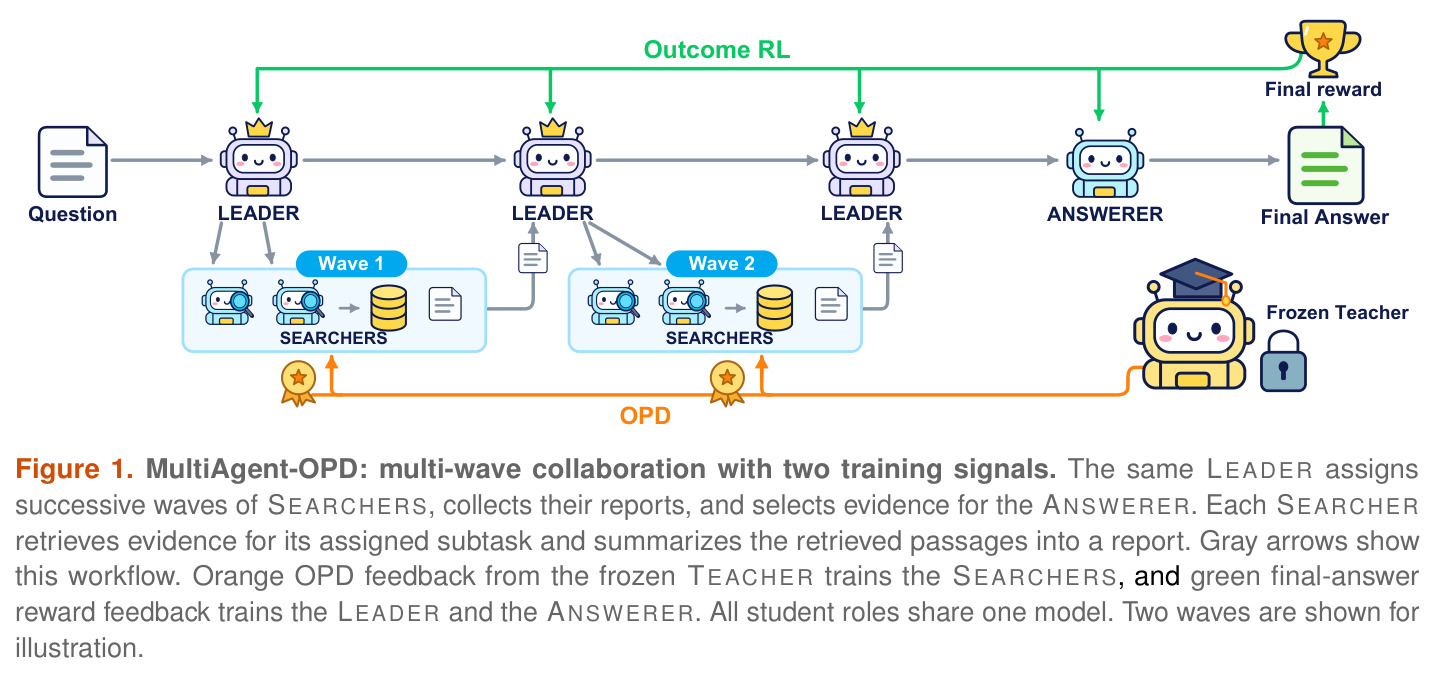
一个 Leader 负责把问题分解为子任务、分波(wave)派发给多个 Searcher 子代理,收集检索报告后筛选证据交给 Answerer 生成最终答案。所有角色可共享同一个模型参数,仅靠角色提示词切换行为,代表系统如 Kimi K2.5 的 PARL、Anthropic 的并行研究系统。
本文训练对象正是 Leader–Searcher–Answerer 三角色团队,且全部共享一个 $\pi_\theta$,任一角色的梯度更新都会影响其他角色的策略,这是信用分配困难的根源。
信用分配问题(Credit Assignment)
在多智能体 RL 中,最终答案只反映团队整体表现,无法判断哪个中间动作该受奖励:Searcher 精心检索的报告若被 Leader 忽略或 Answerer 用错,好的动作也拿不到正奖励。M-GRPO 类方法引入 LLM judge 给子任务打分,但 judge 本身有偏差和推理错误,且单一分数无法指导产生报告的搜索决策序列。
本文的全部动机就是解决层级系统中 Searcher 的信用分配:用任务训练的 Teacher 提供 token 级过程监督,替代不可靠的 LLM 评分和稀疏的结果奖励。
研究动机
用强化学习训练 LLM 层级多智能体系统时,结果奖励只能反映团队整体成败,对子代理的中间动作只有间接反馈。以 Leader–Searcher–Answerer 架构为例:Leader 分解任务并派发,Searcher 检索并写报告,Answerer 汇总作答,但最终答案的对错无法告诉某条搜索查询是好是坏——一份高质量报告可能因为其他角色没用好而拿不到正奖励。Kimi K2.5 的 PARL 只用冻结子代理优化 Leader,回避了联合训练;M-GRPO 用 LLM judge 给子任务执行打分以提供局部监督,但 judge 的可靠性取决于其自身评估能力,存在偏差与推理错误(Zheng et al., 2023),而且单个子任务分数也无法指导产生该报告的一系列搜索决策。本文诊断实验直接量化了这个问题:若让 Searcher 也用最终答案的 GRPO 优势训练,系统会彻底崩溃——7 个数据集 macro avg@4 跌到 17.78%,比不训练的 H-MAS base(28.60%)还低 10.82 个百分点,2 万条测试工作流中搜索动作数 recorded 为 0,尽管 99.51% 的轨迹仍产出子任务和报告。
本文的目标是本文的目标是让共享参数的 Leader–Searcher–Answerer 团队能够端到端联合训练,且每个角色获得与其在任务中位置匹配的学习信号:Leader 的协调决策用团队成败奖励对齐,Answerer 直接用候选答案的 exact-match 奖励评估,而 Searcher 这种中间证据获取者则需要一种可靠、token 级、随策略演化而更新的过程监督,替代依赖 LLM judge 的间接评分。同时要求训练完成后只需保留一个学生模型即可推理,Teacher 仅在训练期存在。最终在 7 个开放域问答数据集上,用相同的 Qwen3-4B-Instruct-2507 骨干和相同检索器,在 macro avg@4 和 macro pass@4 上同时超过级联系统、层级系统与五个 RL 搜索智能体基线。
与已有工作不同的是,已有 OPD 工作都停留在单智能体搜索场景:SD-Search 用结果条件化的自我蒸馏在查询位置加步级监督,OPDSearch+ 直接在实时搜索轨迹上蒸馏一个现成冻结教师再用 RL 精炼,两者都没有任务委派结构。本文的独特切入是把'用更简单工作流训练出的策略'当作层级系统子代理的 Teacher——Stage I 在无委派的 Searcher–Answerer 级联工作流中用答案对错训练出 Teacher,Stage II 让这个冻结 Teacher 在学生自身演化出的子任务历史上给 Searcher 的每个 token 打分。由于 Searcher 接口在两种工作流中一致(输入问题或子任务、输出报告),按问题训练的教师可以给委派子任务打分,且教师条件于学生的交互历史,监督会跟随团队策略演化而更新——这与 PARL 冻结子代理、M-GRPO 依赖 LLM judge 都本质不同。
核心方法
直觉上,每个角色离最终结果的'距离'不同,就该用不同的奖励:Leader 和 Answerer 离结果近,结果奖励够用;Searcher 产出的是中间证据,其价值取决于下游角色是否用好,稀疏结果奖励无法覆盖。MultiAgent-OPD 据此设计两阶段框架:Stage I 从指令模型 $\pi_0$ 出发,训练一个没有委派结构的 Searcher–Answerer 级联工作流,Searcher 领取问题、调检索器、写报告,Answerer 直接读报告作答,用答案正确性训练,并把该策略冻结为 Teacher $\pi_T$(同一策略在级联工作流下评测即为基线 C-MAS + RL,36.07% macro avg@4)。Stage II 重新从 $\pi_0$ 初始化层级学生,对每个问题采样 $G$ 条团队轨迹:Searcher 的 token 用教师–学生对数概率比 $\hat{A}^{\text{OPD}}_{S,t} = \beta M_t \log\frac{\pi_T(a_t|h_t)}{\pi_{old}(a_t|h_t)}$($\beta=0.01$)作为优势,Leader 用团队奖励、Answerer 用候选正确性做 GRPO,三者共享一个模型统一 PPO 更新。全程每题 Answerer 生成 5 个候选。
核心创新是把 Searcher 过程监督形式化为'来自任务训练教师的在线策略蒸馏'。与 M-GRPO 用 LLM judge 打一个整体分数不同,OPD 给出的是逐 token 信号:在学生采样的历史 $h_t$(角色提示词、子任务、已生成 token、检索到的段落)上评估冻结 Teacher 的概率,反向 KL 的负梯度给出 $-\nabla_\theta \ell_t = \mathbb{E}_{a_t \sim \pi_\theta}[\log\frac{\pi_T(a_t|h_t)}{\pi_\theta(a_t|h_t)} \nabla_\theta \log \pi_\theta(a_t|h_t)]$,log-ratio 天然就是优势——教师认为该 token 比当前采样策略更优时为正,推高其概率。关键性质有二:其一,每个 Searcher token 都有信号,包括最终答案错误、以及全组 $G$ 条轨迹结果相同的轨迹(此时 GRPO 优势恒为零);其二,Teacher 条件于学生生成的前缀,Leader 改变任务划分后监督自动跟随新子任务。蒸馏损失为 $\mathcal{L}_{\text{OPD}}(\theta) = \mathbb{E}_{\tau \sim \pi_\theta} \sum_t M_t \ell_t(\theta)$,掩码 $M_t$ 只覆盖 Searcher 生成的 token,排除检索段落与填充。
方法步骤详情
第一步,Stage I:从 $\pi_0$ 训练级联 Searcher–Answerer。Answerer 每个候选得 $R_{A,i,j} = c_{i,j}$(归一化 exact-match);Searcher 得 $R_{S,i} = 0.9 R_{\text{EM},i} + 0.1 \tilde{b}_{S,i}$,行为奖励搜一步出总结记 0.5、两步以上记 1、否则 0,无效动作格式记 -1;用 $\hat{A}^{\text{GRPO}}_{r,i} = \frac{R_{r,i}-\mu_{x,r}}{\sigma_{x,r}+\epsilon}$ 算优势并 PPO 更新(评测即 C-MAS + RL,36.07%),随后冻结为 Teacher $\pi_T$。第二步,Stage II 从 $\pi_0$ 重新初始化层级学生,每题采样 $G$ 条团队轨迹:Leader 分解问题、分波派发 Searcher(ReAct 式:写查询→读检索段落→再搜或写报告),最后筛选报告交 Answerer 产出 5 个候选。第三步,按角色赋优势(式 7):Searcher token 用 $\hat{A}^{\text{OPD}}_{S,t}$;Answerer 用候选组内归一化的 $\hat{A}^{\text{GRPO}}_{A,i,j}$;Leader 用团队级 $\hat{A}^{\text{GRPO}}_{L,i}$,其奖励 $R_{L,i} = 0.9 R_{\text{EM},i} + 0.1 R_{\text{assign},i}$,$R_{\text{assign},i}=\min(C_{\text{tool},i},6)/6$ 是有界搜索活跃度奖励。第四步,用带裁剪和熵 bonus 的 PPO 统一更新共享参数:Leader/Answerer 另加对 $\pi_T$ 系数 $10^{-3}$ 的 KL 惩罚,Searcher 不再加额外 KL。推理时只保留学生,一个模型扮演全部三角色。
技术新颖性
技术新颖性体现在三点。第一,训练信号的角色化设计:不是给所有角色同一奖励再加 judge,而是按'角色与最终目标的关系'分配信号——结果奖励给 Leader(团队成败)和 Answerer(候选正确性),token 级过程监督给 Searcher,这是一种原则性的信用分配方案。第二,'简单工作流策略作为层级 Teacher'的组合:Teacher 在无委派的 Searcher–Answerer 工作流中按问题训练,却能在学生的委派子任务历史上打分,这依赖两个工作流中 Searcher 接口的一致性,是与 SD-Search(自我蒸馏单智能体)和 OPDSearch+(现成教师蒸馏单智能体)的本质区别。第三,on-policy 特性保证监督不脱节:Teacher 每次都对学生当前策略采样的前缀评分,学生探索到新的子任务形态时监督自动适配,而 PARL(冻结子代理)和 M-GRPO(静态 judge)都不具备这种随策略演化的反馈。另外 Searcher 的 OPD 完全替代结果优势而非叠加,且不加额外 KL 惩罚,这是设计上的明确取舍。
实验结果
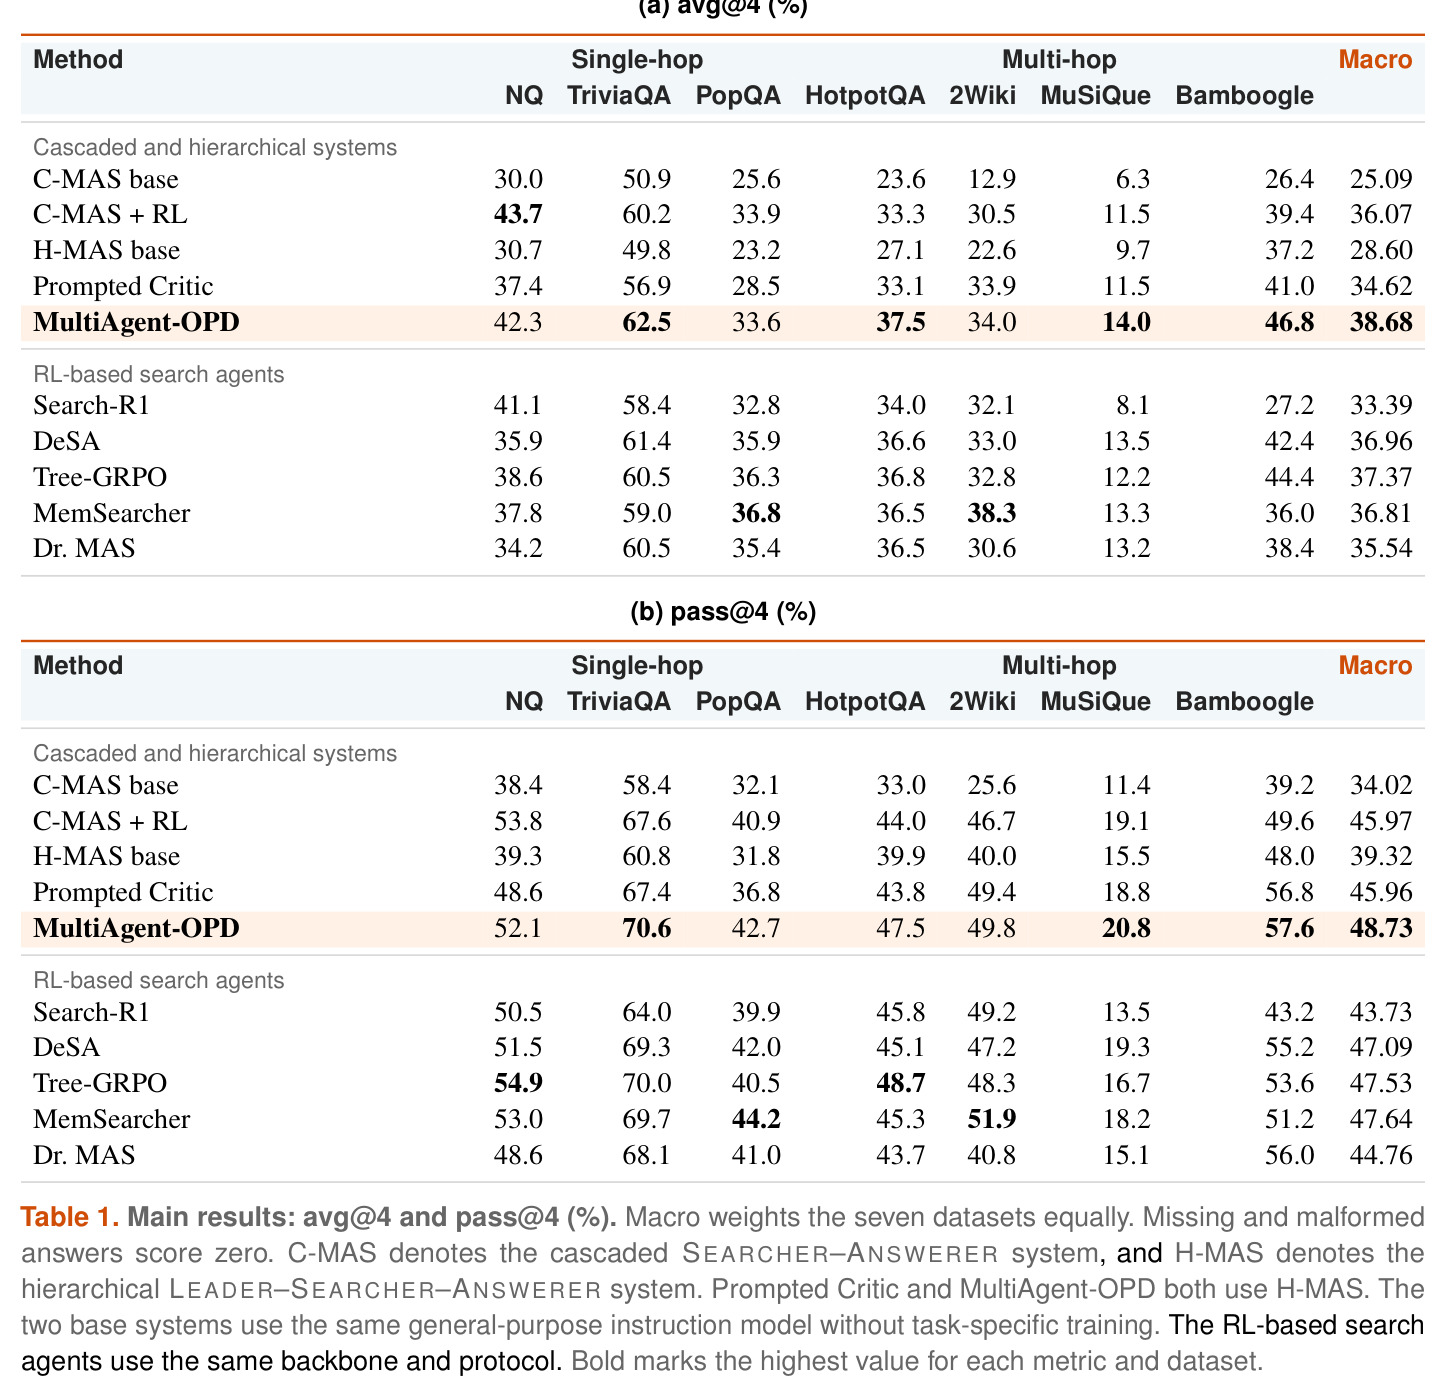
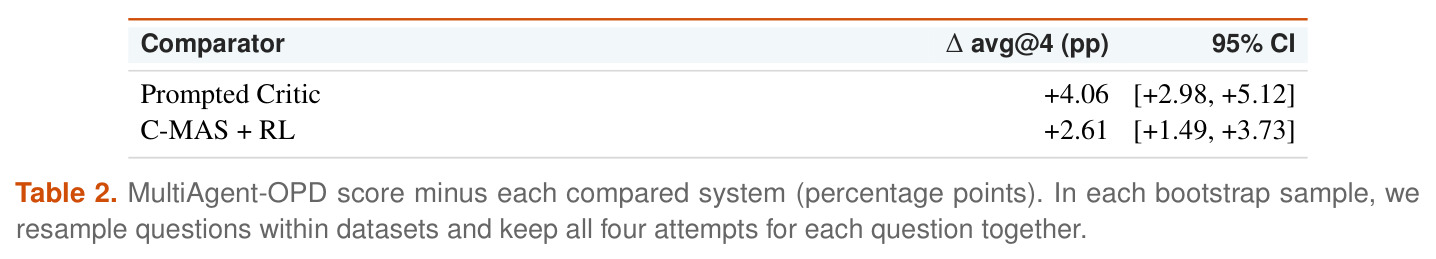
主实验在 NQ、TriviaQA、PopQA、HotpotQA、2Wiki、MuSiQue、Bamboogle 七个数据集固定 5000 题上评测,每系统每题跑 4 次,主指标为七数据集等权的 macro avg@4。MultiAgent-OPD 达 38.68% macro avg@4、48.73% macro pass@4,为全部系统最高:比 Prompted Critic(M-GRPO 式 judge 监督,34.62%)高 4.06pp(95% CI [+2.98, +5.12]),比级联的 C-MAS + RL(36.07%,即 Teacher 所评工作流)高 2.61pp(CI [+1.49, +3.73]),比最强单智能体基线 Tree-GRPO(37.37%)高 1.31pp;avg@4 上超过 Prompted Critic 全部 7 个数据集、超过 C-MAS + RL 5 个,对 C-MAS + RL 最大增益在 Bamboogle(+7.40pp)。无训练的层级 H-MAS base(28.60%)高于 C-MAS base(25.09%)3.51pp,说明层级结构本身有价值。诊断实验(表 3)三组对比关键:把 Searcher OPD 换成结果奖励 RL 直接崩溃到 17.78%,2 万条测试工作流 recorded 搜索动作数为 0,证明稀疏结果奖励无法维持层级系统中的检索行为;换成未训练的 base model 当 Teacher 掉到 29.50%,说明信号必须来自任务训练的策略;完全去掉 Searcher 直接监督为 29.82%,说明仅靠共享参数间接传播不够。4/4 全对率 29.27% 高于 C-MAS + RL 的 27.05% 和 Prompted Critic 的 23.24%,提升同时覆盖平均正确率与一致性。代价是算力:每工作流 5.39 次搜索、9172 输入 token,比 Prompted Critic(4.45 次、6786)多 21.4% 和 35.2%,但输出 token 从 885 降至 697。
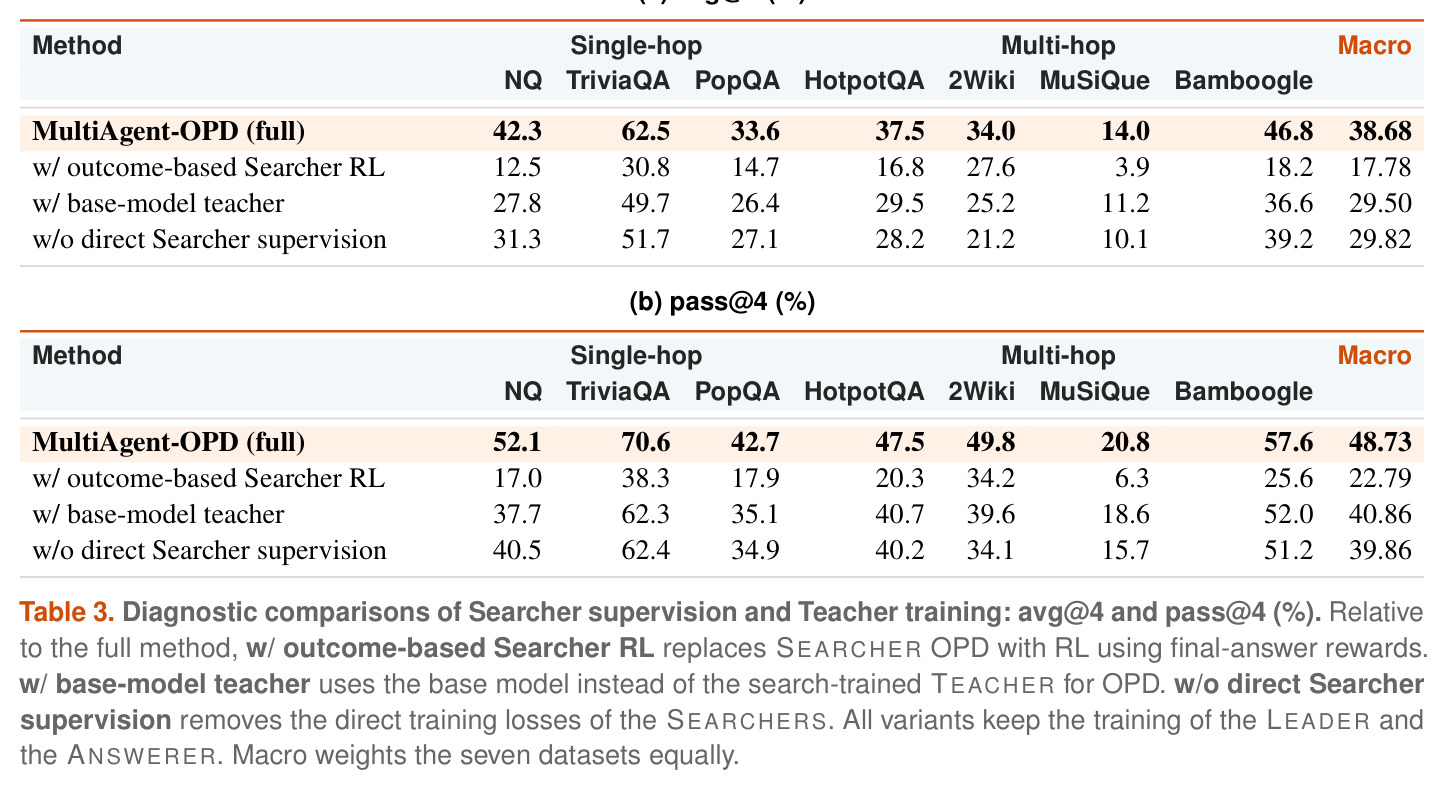
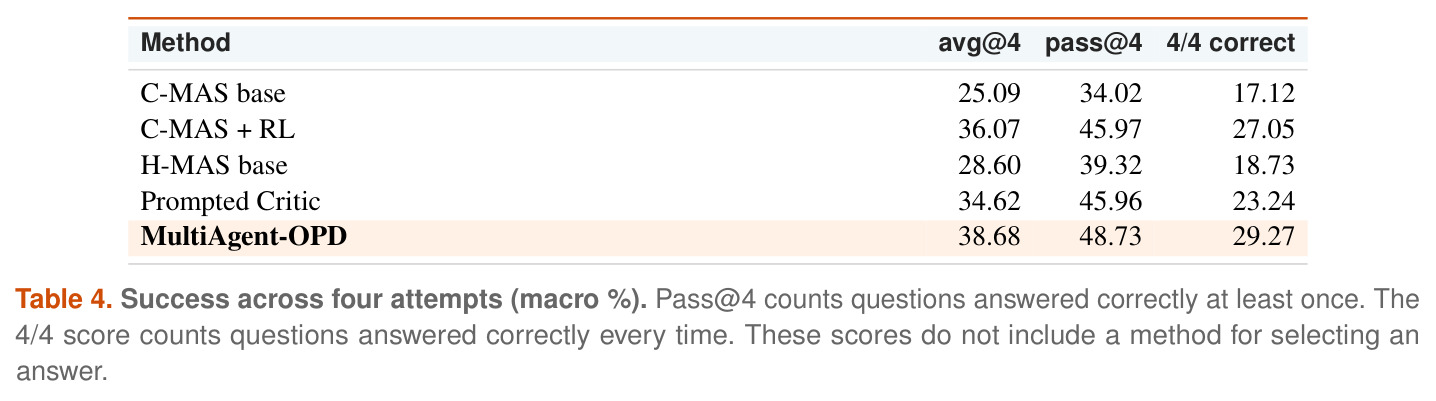
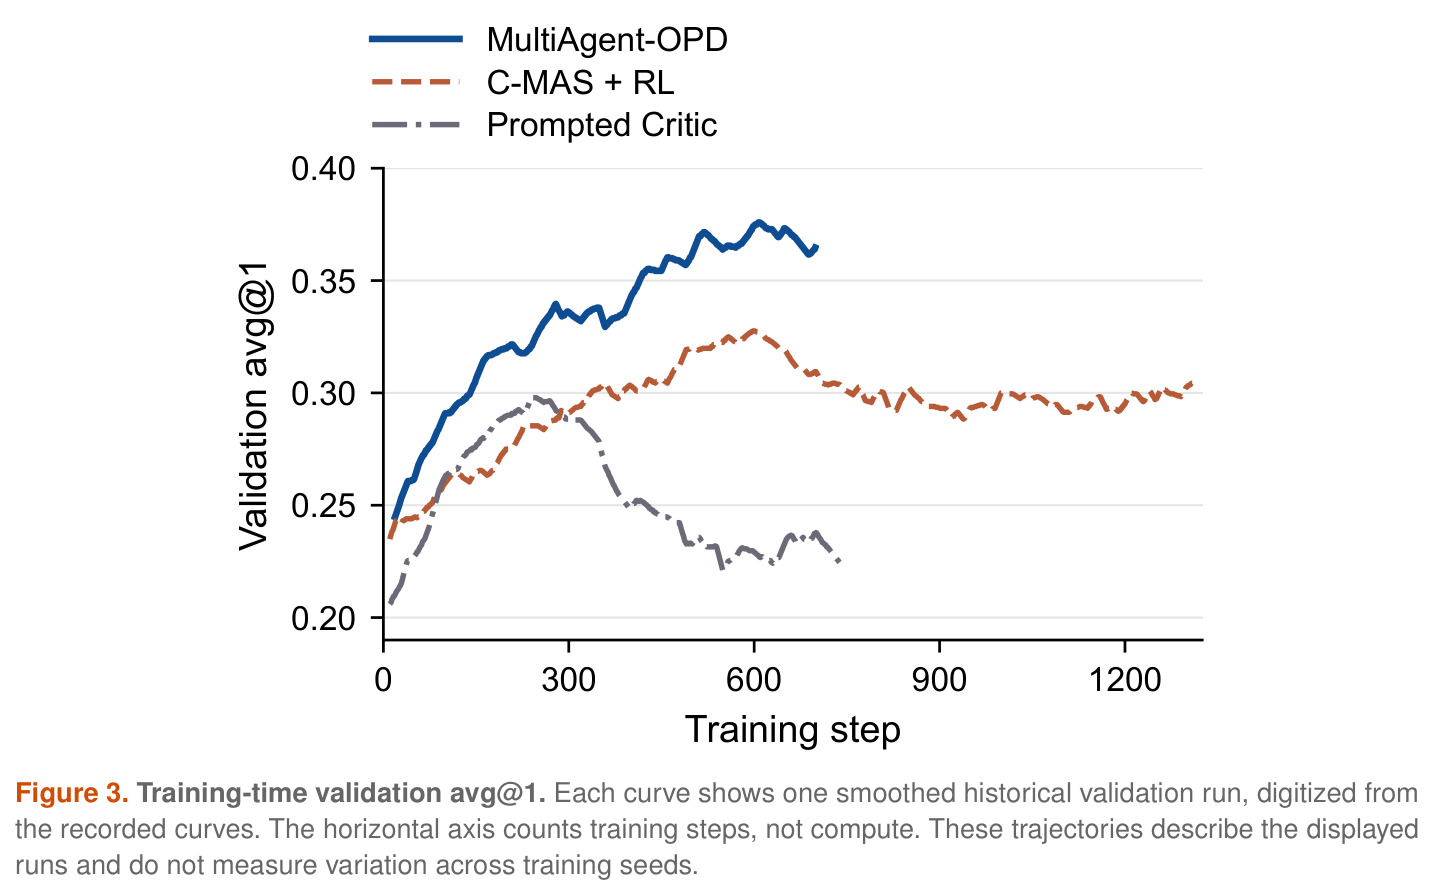
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放域问答(7 数据集宏平均,NQ/TriviaQA/PopQA/HotpotQA/2Wiki/MuSiQue/Bamboogle) | macro avg@4 (%) | 38.68 | Prompted Critic 34.62;C-MAS + RL 36.07;最强单智能体 Tree-GRPO 37.37 | +4.06pp vs Prompted Critic;+2.61pp vs C-MAS + RL;+1.31pp vs Tree-GRPO |
| 开放域问答(7 数据集宏平均) | macro pass@4 (%) | 48.73 | Prompted Critic 45.96;C-MAS + RL 45.97;Tree-GRPO 47.53 | +2.76pp vs Prompted Critic;+1.20pp vs Tree-GRPO |
| 答案一致性(4 次尝试全对) | 4/4 correct (%) | 29.27 | C-MAS + RL 27.05;Prompted Critic 23.24 | +2.22pp vs C-MAS + RL;+6.03pp vs Prompted Critic |
| 诊断:Searcher 用结果奖励 RL 替代 OPD | macro avg@4 (%) | 38.68 | 变体 17.78(且搜索动作归零,低于不训练的 H-MAS base 28.60) | 相对变体 +20.90pp,验证过程监督不可替代 |
| 诊断:Teacher 换成未训练 base model | macro avg@4 (%) | 38.68 | 变体 29.50 | +9.18pp,证明任务训练的 Teacher 是关键 |
局限与改进
作者明确承认的范围限制:全部系统都建在 Qwen3-4B-Instruct-2507 上、固定英语开放域 QA 集,4 次尝试和题目 bootstrap 区间只刻画单个 checkpoint 内的变化,没有多次独立训练的种子间方差;归一化 exact match 无法检测语义等价和预训练污染;各系统按自身工作流预算运行,没有在匹配的检索或 token 预算下对比——考虑到 MultiAgent-OPD 每工作流用 5.39 次搜索和 9172 输入 token(Prompted Critic 为 4.45 次、6786),公平性存疑。机制层面,OPD 只是教师条件化的局部过程监督,不是 token 对最终答案因果贡献的估计,Teacher 自身会犯错,按全问题训练的教师与委派子任务场景存在分布差异,共享角色参数使各角色更新互相耦合难以解耦归因,反向 KL 会压缩探索,且师生需要兼容的词表。我自己的观察:Stage I 和 Stage II 都从 $\pi_0$ 重新开始,Teacher 训练的额外算力未被计入对比;$\beta=0.01$、行为奖励系数等超参没有敏感性分析;Bamboogle 上 46.8% 的最佳值可能受益于层级结构 + 多波搜索的额度优势(12 步 vs 级联 5 步),而非纯方法增益。
独立分析的弱点
第一,训练成本核算不透明:需先完整训练 Stage I 得到 Teacher,再从头训练 Stage II,接近两倍单系统训练量,论文未报告 GPU 小时,也没有'把同样算力投给 C-MAS + RL 继续训练'的基线,38.68% 对 36.07% 的优势可能部分来自额外算力;改进方向是报告训练成本并加入算力匹配基线。第二,推理成本增加 35.2% 输入 token 却未做预算匹配对比,recorded token 含重复历史,无法换算为延迟或 API 成本;应在固定检索调用数或 token 预算下重跑主表。第三,反向 KL 蒸馏天然抑制探索,学生被拉向 Teacher 分布,论文承认但未度量策略熵或查询多样性变化,长训后 Searcher 可能陷入教师的查询模式;应监控熵曲线或混合前向 KL。第四,Teacher 按完整问题训练,对 Leader 生成的子任务文本只在接口层面兼容,对复杂多跳子任务(MuSiQue 上本文最低仅 14.0%)适配程度未知;可让 Teacher 在少量子任务数据上微调。第五,只在 4B 模型和英语 QA 上验证,OPD 依赖师生词表兼容,异构模型团队(不同底座)未探索。第六,训练曲线由记录曲线数字化且仅单次运行,4.06pp 的优势在种子方差下是否稳健需独立复现确认。
未来方向
作者方向上的自然延伸:其一,把 OPD Teacher 推广到更多子代理类型,例如给负责代码执行或工具调用的子代理训练对应的简单工作流 Teacher,形成'每类子代理一个过程教师'的通用层级训练配方;其二,研究 Teacher 与学生之间的词表/规模解耦——用更大的 Teacher(如 32B)蒸馏 4B 学生团队,论文受限于此处词表必须兼容;其三,将 $R_{\text{assign}}$ 这类有界活跃度奖励替换为可学习的搜索预算控制,解决搜索次数上升(5.39 次/工作流)带来的成本问题;其四,在匹配 token 预算下与单智能体方法系统对比,回答'层级结构何时值得'。基于本文成果可延伸的方向:把 OPD 的 log-ratio 优势与因果信用分配(如反事实评估)结合,得到既局部又接近因果贡献的信号;把该方法应用到多轮对话或长程 Agentic 任务(如 SWE-bench 类),其中子代理报告的下游利用更复杂;探索课程式 Teacher 更新——定期用 Stage II 训练出的学生重新训练 Teacher,形成教师–学生交替进化的循环;以及在中文和多语言 QA 上验证,因为检索语料质量变化会直接考验 Teacher 的过程监督鲁棒性。
复现评估
论文声明匿名 artifact 提供带评分的评测记录、聚合脚本、结果文件和评测协议,足以复现汇总统计量,但训练代码是否开源未明确,完整复现训练难度较高。资源估算:骨干 Qwen3-4B-Instruct-2507,两阶段训练(Stage I 级联 + Stage II 层级),每题采样 $G$ 条团队轨迹、Answerer 每请求 5 候选,rollout 含多波 Searcher 多轮检索(每查询 3 段落),token 开销大(每工作流 9172 输入 token),推测需多卡 A100 级集群数天。评测门槛低:七个数据集均为公开 QA 基准,固定 5000 题、归一化 exact match、avg@4/pass@4 协议清楚,附录给出归一化与 bootstrap 配对方法;检索器 3 段落/查询、级联 5 步/层级 12 步预算已写明。主要不确定性:检索器具体实现(Wikipedia 索引版本)未在正文给出,$\beta=0.01$、熵系数、学习率等训练超参需查附录或代码;训练曲线数字化无法精确对齐 step 数。总体:评测复现容易,训练复现中等偏难,建议先复现表 3 中搜索行为崩溃现象验证实现正确性。
论文图表
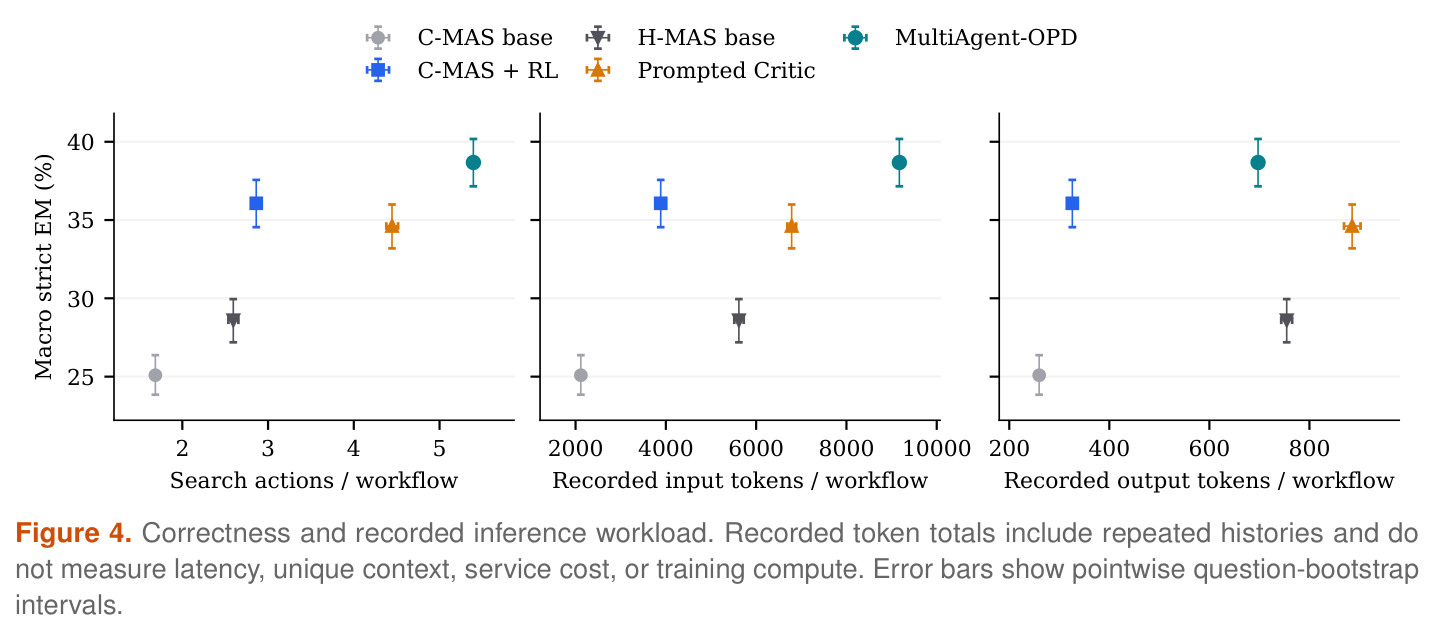
散点图展示 macro strict EM 与每工作流搜索动作数(约 2–5.4 次)、记录输入 token(3886–9172)、记录输出 token(697–885)的关系,含点式 bootstrap 误差棒;MultiAgent-OPD 搜索和输入 token 最多但正确率最高,C-MAS + RL 搜索最少。
诚实呈现了准确率提升的算力代价:比 Prompted Critic 多 21.4% 搜索、35.2% 输入 token,读者据此判断方法在成本约束下的实用价值,也引出'未做预算匹配对比'的局限性。