OPD 的强化学习视角:面向样本高效 LLM 推理的最小二乘策略蒸馏 An RL View of OPD: Least Square Policy Distillation for Sample-Efficient LLM Reasoning
将在线蒸馏重构为 KL 正则强化学习,用乐观最小二乘目标实现离策略复用与更高 Pass@k
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
一种大模型蒸馏范式:由学生模型自己生成回答,教师模型在学生产生的每个前缀上给出 token 级软标签,通过最小化学生与教师分布的反向 KL 散度来训练。由于监督落在学生实际会到达的状态上,比在教师生成文本上做 SFT 更贴合学生分布,代表实现为 Lu & Lab (2025)。
本文的研究对象就是 OPD,全文目标是重新解释并改进它的数据效率与探索能力。
反向 KL 与正向 KL
KL 散度不对称:正向 KL $\mathbb{E}_{y\sim\pi_E}[\log\frac{\pi_E}{\pi}]$ 以教师分布为期望,倾向 mass-covering;反向 KL $D_{KL}(\pi\|\pi_E)$ 以学生分布为期望,倾向 mode-seeking,学生会集中到教师的高概率模式上。OPD 在 token 级最小化的是反向 KL。
LSPD 的全部推导都从反向 KL 目标出发,Theorem 6.2 的遗憾也定义为对最优策略的反向 KL 累积。
KL 正则化 / 最大熵强化学习
把策略优化目标改为 $\arg\max_\pi \mathbb{E}_{y\sim\pi}[R(q,y)] - \eta^{-1}D_{KL}(\pi\|\pi_{ref})$;当参考策略取均匀分布时退化为最大熵 RL(如 Soft Actor-Critic)。该文献族提供闭式软策略更新 $\pi\propto\pi_{ref}\exp(\eta r)$,并支持离策略的价值型求解。
论文第一步就证明 OPD 恰是 $\eta=1$、奖励为教师对数似然比的 token 级 KL 正则 RL,这是整个方法框架的地基。
乐观面对不确定性(Optimism)与置信集合
奖励未知时不使用点估计,而是用历史数据构建统计上合理的置信集合 $C_k$(如最小二乘残差平方和不超过 $\beta^2$),按集合内最优奖励行动:$r^+=\sup_{r\in C_k}r$。这是 UCB 类算法的核心思想,可获得 $O(\log K)$ 级累积遗憾。
LSPD 名称中的最小二乘与理论保证都来源于此;实用目标中的熵正则正是乐观项经拉格朗日松弛后的产物。
离策略学习与经验回放
离策略指更新所用的数据可以由旧策略甚至其他策略生成;经验回放把历史轨迹存入缓冲区反复采样训练。价值型方法(Q-learning、fitted value iteration)天然支持,而 PPO/GRPO 这类策略梯度方法只能靠重要性比例与裁剪勉强偏离在线。
LSPD 的实用损失是回归型目标,梯度与数据来源策略无关,因此 LSPD-RB 能只用前 25% 的 rollout 批次追平 vanilla OPD 全程表现。
Pass@k 与 Avg@k 指标
评测推理模型的两类指标:对同一道题采样 k 个回答,Pass@k 是至少一个正确的比例,衡量解空间覆盖率;Avg@16 是 16 次采样的平均正确率,衡量单次生成质量。若蒸馏导致熵坍缩,Avg 可能不降但 Pass@k 会停滞。
论文用 Avg@16 与 Pass@16/32/64 区分平均准确和解覆盖两类收益,LSPD 的核心卖点正是后者随 k 增长的扩展性。
研究动机
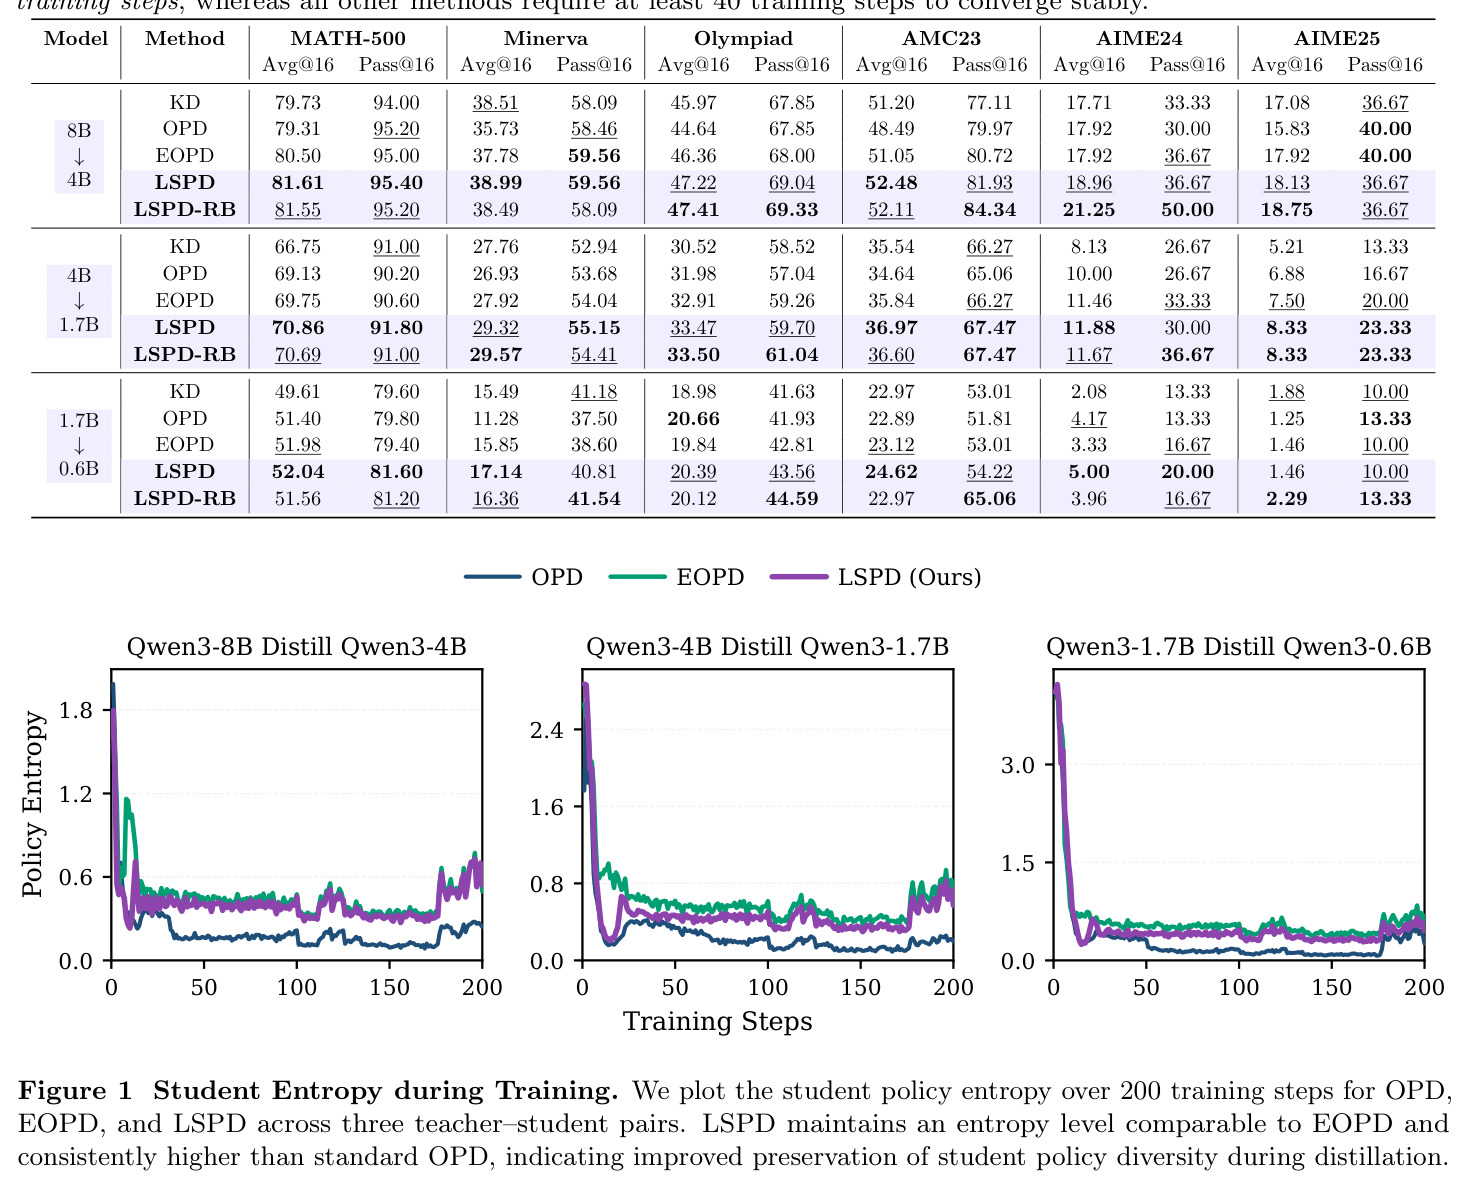
在线策略蒸馏(OPD)是当前大模型能力迁移的主流路线之一:学生自己生成轨迹,教师在学生遇到的每个前缀上提供 token 级监督,从而在学生分布覆盖的状态上给出指导。虽然近期工作已把 OPD 解释为一种强化学习并用 PPO、GRPO 等策略优化框架实现,但这些框架本质上仍是基于策略梯度的在线方法:训练全程要不断采样新 rollout,历史数据基本无法复用,探索也不充分。论文用具体数据说明这一痛点:在 Qwen3-4B 教师蒸馏 Qwen3-1.7B-Base 的设定下,OPD、EOPD 等基线需要 40 步以上训练才能稳定收敛,每步都伴随昂贵的 rollout 采样;同时标准 OPD 训练中学生会发生熵坍缩(Figure 1 显示其熵明显低于 0.5),多样性下降会直接损害 Pass@k 覆盖率。样本效率低、rollout 开销大、策略多样性流失,是现有 OPD 实现的三大问题。
本文的目标是本文的目标分两个层面。理论层面:建立 OPD 的反向 KL 目标与 KL 正则化策略优化之间的精确等价关系,把在线蒸馏严格纳入强化学习框架,而不是停留在启发式类比。方法层面:借助这一等价性,把基于价值的 KL 正则 RL 中成熟的乐观探索和历史数据复用机制引入蒸馏,提出最小二乘策略蒸馏 LSPD 及带经验回放的完全离策略变体 LSPD-RB,使同一批 rollout 能被多次更新、历史轨迹能被反复利用,在保持策略多样性的同时大幅降低 rollout 需求,理想化形态下还给出 $O(\log K)$ 量级的累积遗憾上界。实证层面:在六个数学推理基准(MATH-500、Minerva、Olympiad-Bench、AMC23、AIME24、AIME25)和三组 Qwen3 教师—学生配置上一致超越 KD、OPD、EOPD,并用 Pass@k 至 k=64 验证多样性收益。
与已有工作不同的是,已有工作的切入角度是把 OPD 塞进 PPO/GRPO 这类策略梯度框架,通过优势估计和裁剪目标优化反向 KL,这只借用了 RL 的外壳,没有吸收基于价值 RL 的算法红利。与之相对,KL 正则化强化学习(含最大熵 RL)在乐观奖励估计、最小二乘置信集合、经验回放和熵正则方面有一整套原则性算法与尖锐理论保证,却从未被系统性地用于蒸馏。与 DistiLLM 基于 skew KL 的自适应离策略复用这种启发式做法不同,本文从乐观主义原理出发推导目标:先用历史数据构建置信集合、取最有利的奖励做闭式更新,再经拉格朗日松弛自然得到学生—教师 log 概率二次匹配加熵正则的损失,使离策略性成为目标函数的内禀性质而非工程补丁。这个从策略梯度到乐观回归的视角转换,是本文区别于 OPD、EOPD、DistiLLM 系列工作的独特切入点。
核心方法
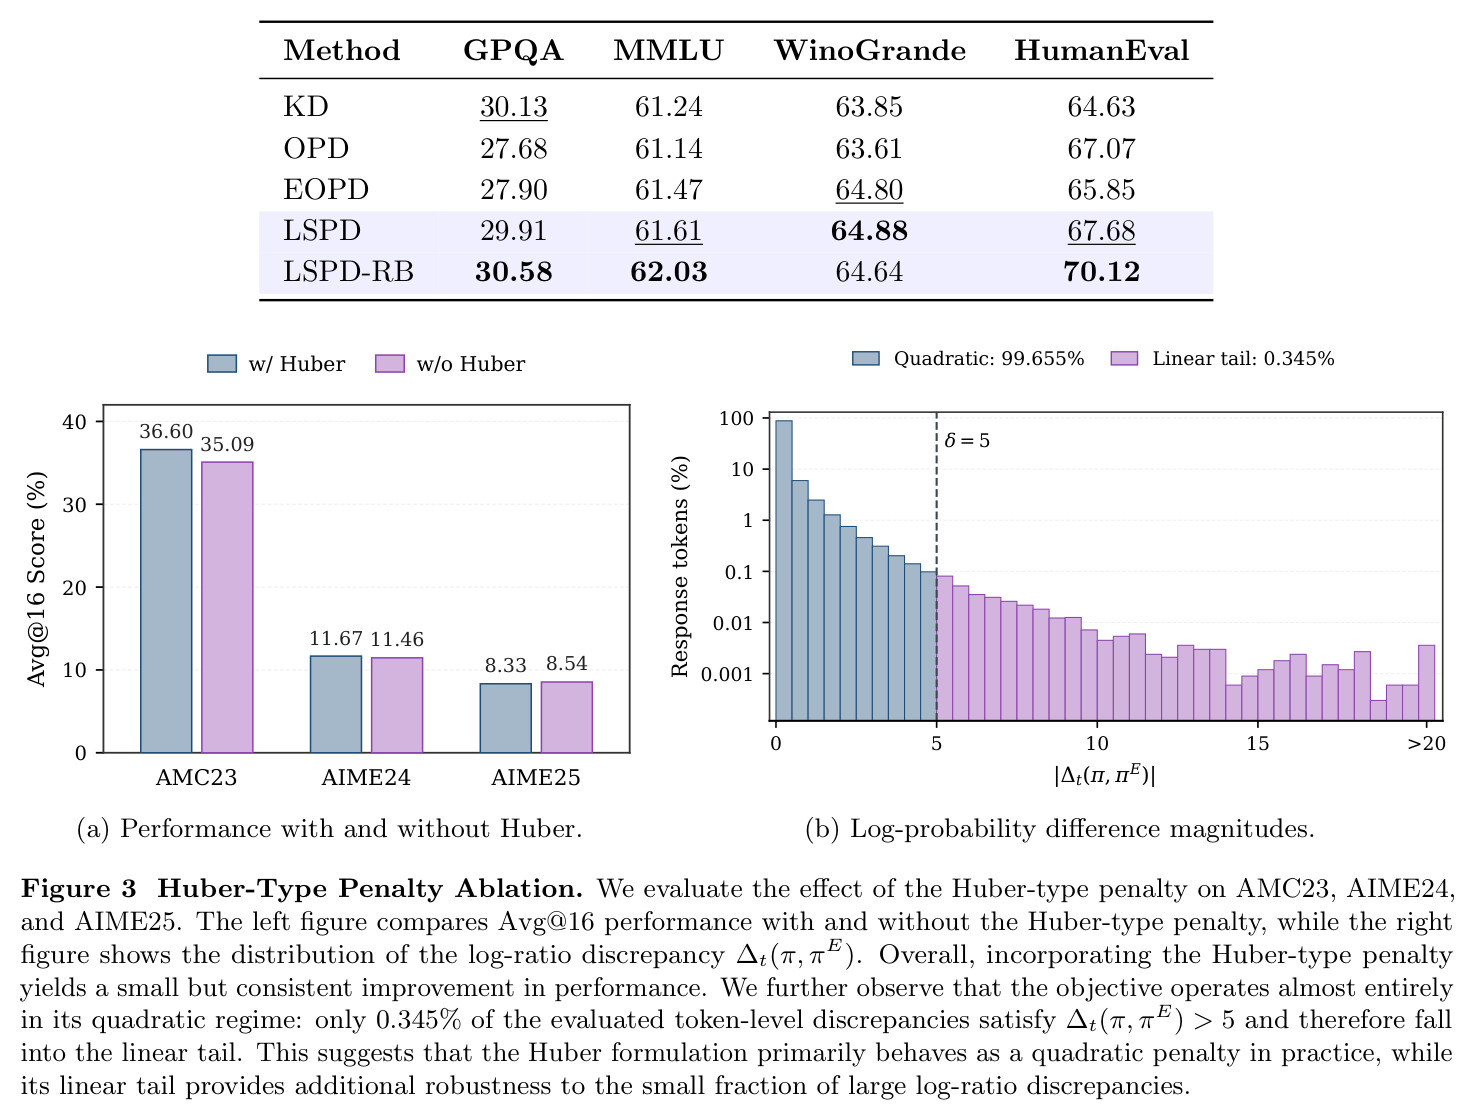
方法的直觉是:OPD 既然等价于带教师奖励的 token 级 KL 正则策略优化,就可用基于价值 RL 的估计奖励—乐观更新套路求解,而不必用策略梯度。技术路线分四步。第一步,把 OPD 的反向 KL 目标精确改写为 $\arg\max_\pi \mathbb{E}[\sum_{t=1}^{T} R(x_{<t},y_t)] - D_{KL}(\pi\|\pi_{ref})$,教师诱导奖励 $R(x_{<t},y_t)=\log\frac{\pi_E(y_t|x_{<t})}{\pi_{ref}(y_t|x_{<t})}$,$\eta=1$,这是恒等变形而非附加正则。第二步,用已积累的前缀—token 对做最小二乘奖励回归,构建置信半径 $\beta$ 的置信集合 $C_k$,逐点取上确界得乐观奖励 $r_k^+$,按 $\pi_{k+1}\propto\pi_{ref}\exp(\eta r_k^+)$ 闭式更新。第三步,对乐观项做拉格朗日松弛(乘子 $\mu$),化简为师生 log 概率的二次匹配,再加显式熵正则。第四步,工程上用 Huber 型稳健惩罚替换二次损失,得到支持同批多次更新与经验回放的实用目标。
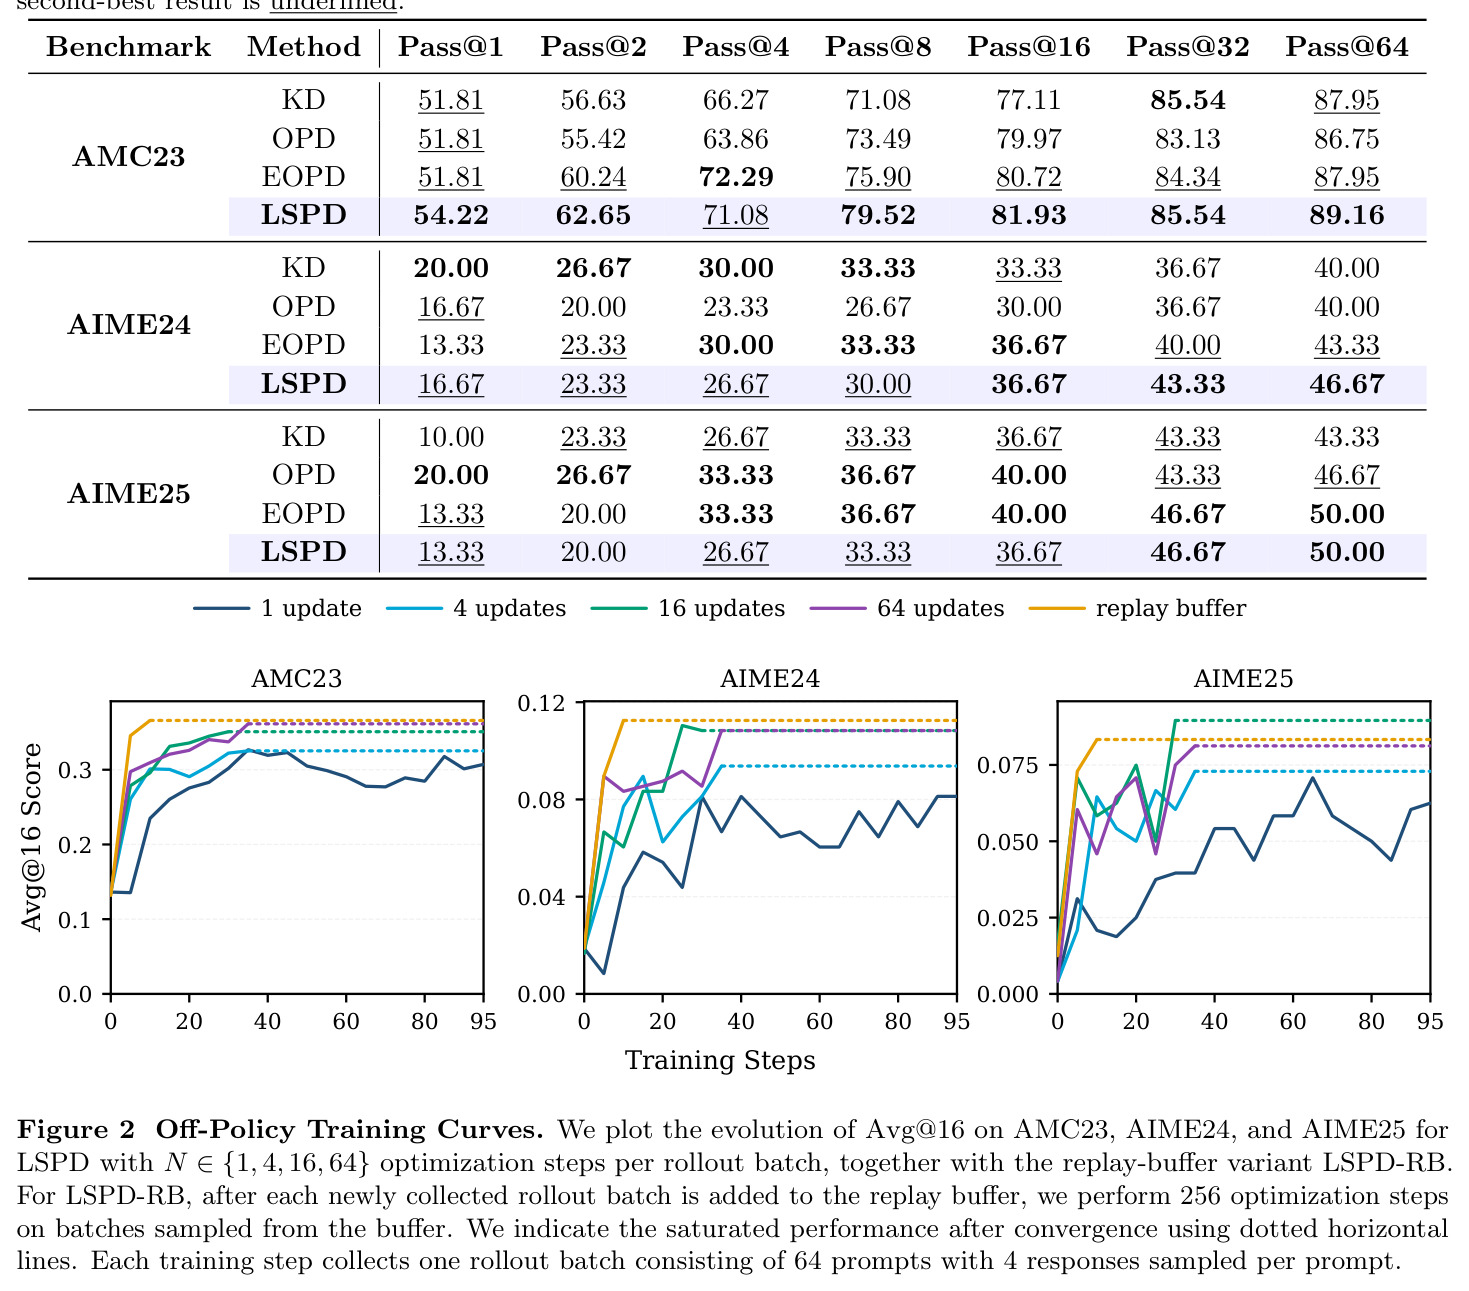
核心创新是把蒸馏从策略梯度加优势函数的范式换成乐观回归范式。与 PPO/GRPO 式 OPD 需要当前策略样本、依赖重要性采样和裁剪不同,LSPD 的实用目标 $J(\pi)=\mathbb{E}_{(q,y)\sim\mathcal{B}}\big[\frac{1}{T}\sum_{t=1}^{T}\psi(\log\pi(y_t|x_{<t})-\log\pi_E(y_t|x_{<t}))-\mu^{-1}H(\pi(\cdot|x_{<t}))\big]$ 是一个对数概率回归损失:梯度只要求能对学生和教师在存储样本上打分,与样本由哪个策略生成无关,因此天然支持离策略优化,无需任何裁剪技巧。乐观探索没有被丢弃,而是被拉格朗日松弛吸收成熵正则项——最大化置信集合中最有利奖励的效果,等价于在匹配教师的同时保持策略熵,这直接解释了实验中 LSPD 熵水平(约 0.5)高于标准 OPD 的现象。另一个本质区别是数据复用方式:目标对旧轨迹完全合法,LSPD 可对每批 rollout 做 $N$ 次更新,LSPD-RB 更把全部历史轨迹放进回放缓冲区,每个新批次入池后做 256 次回放更新。
方法步骤详情
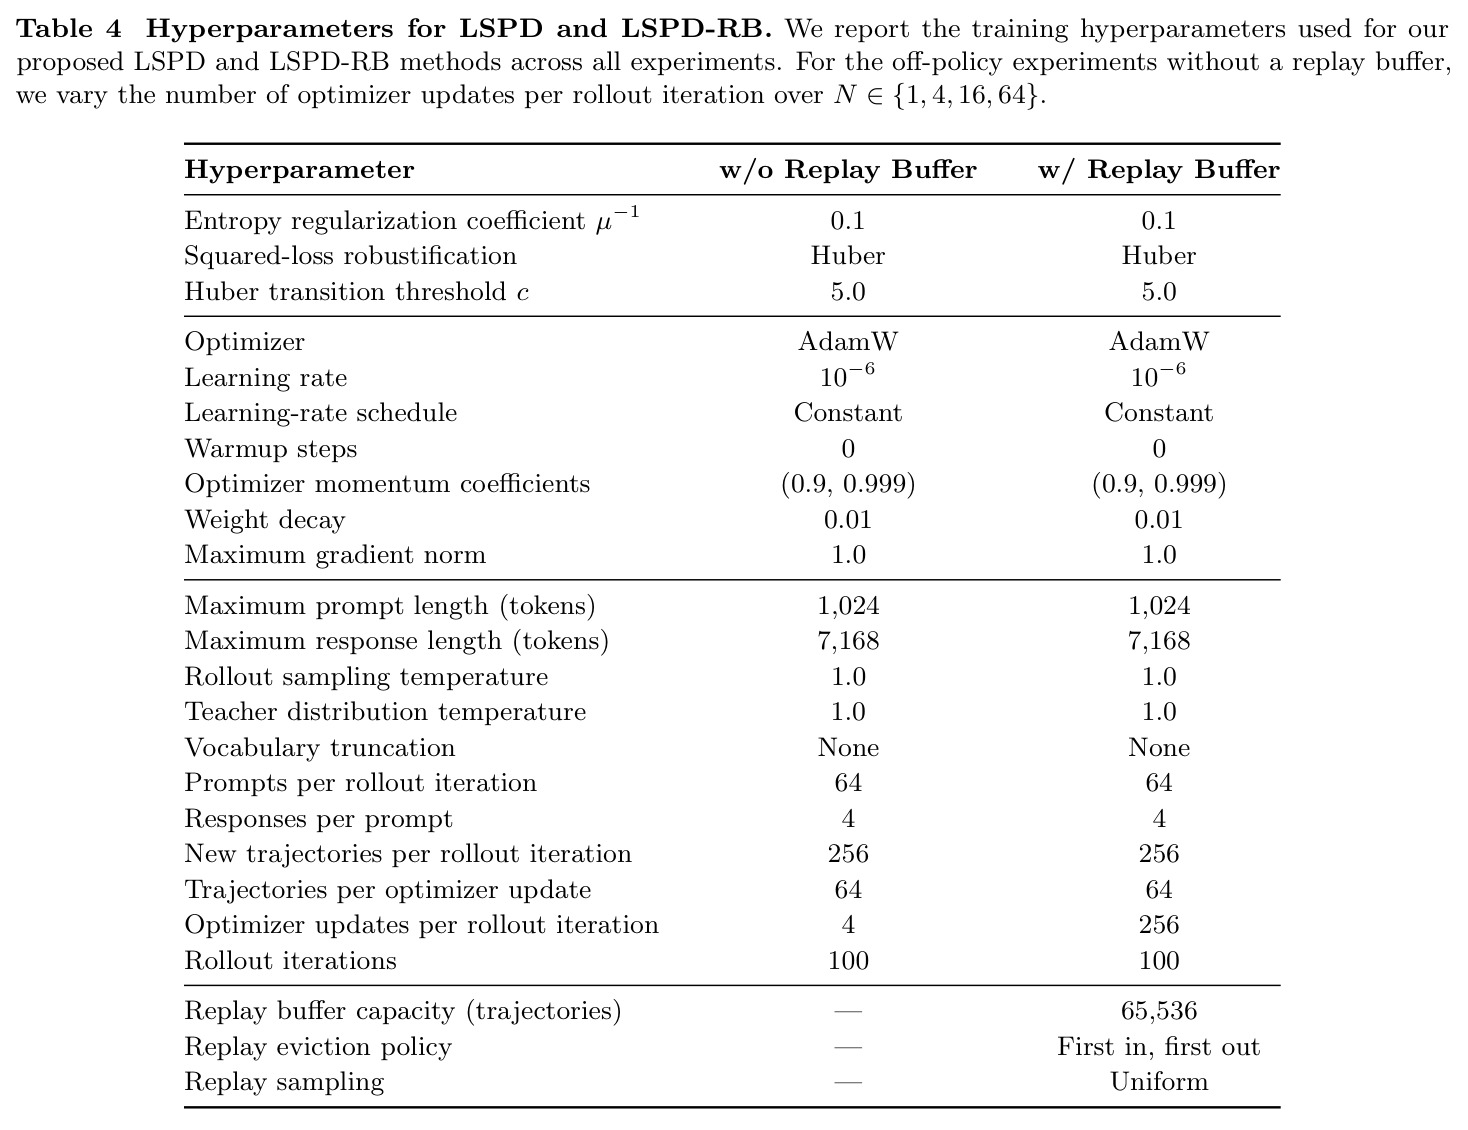
完整流程见 Algorithm 1。第一步 rollout 采集:每轮从 DAPO-Math-17K 采样 64 个 prompt,学生以 top-p=1.0、温度 1.0、最大长度 7168 token、每题 4 条回答生成响应,前缀—token 对加入缓冲区 $\mathcal{B}$。第二步策略更新:每批做 $N$ 次小批量更新($N\in\{1,4,16,64\}$),从 $\mathcal{B}$ 采样 minibatch,计算式 (4.6):存储前缀上师生 token log 概率之差的 Huber 稳健二次惩罚 $\psi(\cdot)$,减去学生下一 token 分布熵的 $\mu^{-1}$ 倍,反向传播更新学生。第三步缓冲区管理:LSPD 每轮末清空 $\mathcal{B}$(只用当前批,可多次更新),LSPD-RB 保留全部历史,每收一个新批次做 256 次回放更新。第四步:迭代 $K$ 轮后以 top-p=0.95、温度 0.7 评测。理论形态(Algorithm 2)在每次更新前做最小二乘回归、构造 $C_k$ 并取逐点乐观奖励闭式更新,实用目标即其可计算近似。
技术新颖性
新颖性体现在四个方面。其一,等价性证明:以往工作只把 OPD 看作 RL,本文给出精确改写,证明反向 KL 蒸馏就是奖励为教师对参考策略对数似然比、$\eta=1$ 的 token 级 KL 正则策略优化,且是恒等变形而非额外正则,与 RLHF 的 reward-KL 结构对接。其二,首次把乐观价值学习引入蒸馏:用最小二乘置信集合刻画统计上说得通的奖励并逐点取上确界,这是 UCB 式乐观探索在 token 级蒸馏中的移植,并带来 Theorem 6.2 的 $\text{Regret}(K)=O(d_E\log(N_R K))$ 尖锐遗憾率与 $\tilde{O}(\epsilon^{-1})$ 样本复杂度。其三,损失函数区别于近亲方法:IPO 对偏好对的 log 比值差做平方损失,本文直接匹配师生 log 概率;EOPD 靠熵门控的前向 KL 维持多样性,本文用显式熵正则;DistiLLM 的 skew KL 离策略复用是启发式的,本文的离策略性由目标结构保证。其四,Huber 稳健化加熵正则的实用组合兼顾训练稳定性与输出多样性。
实验结果
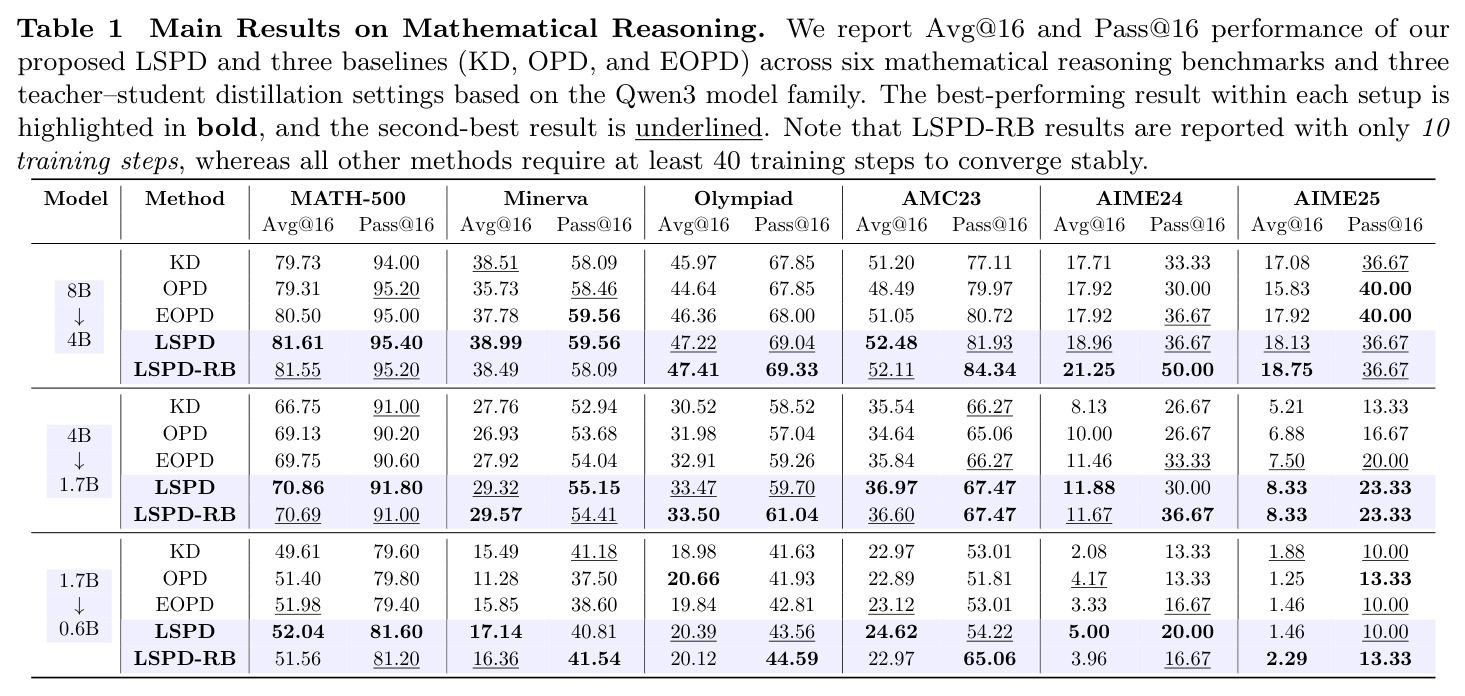
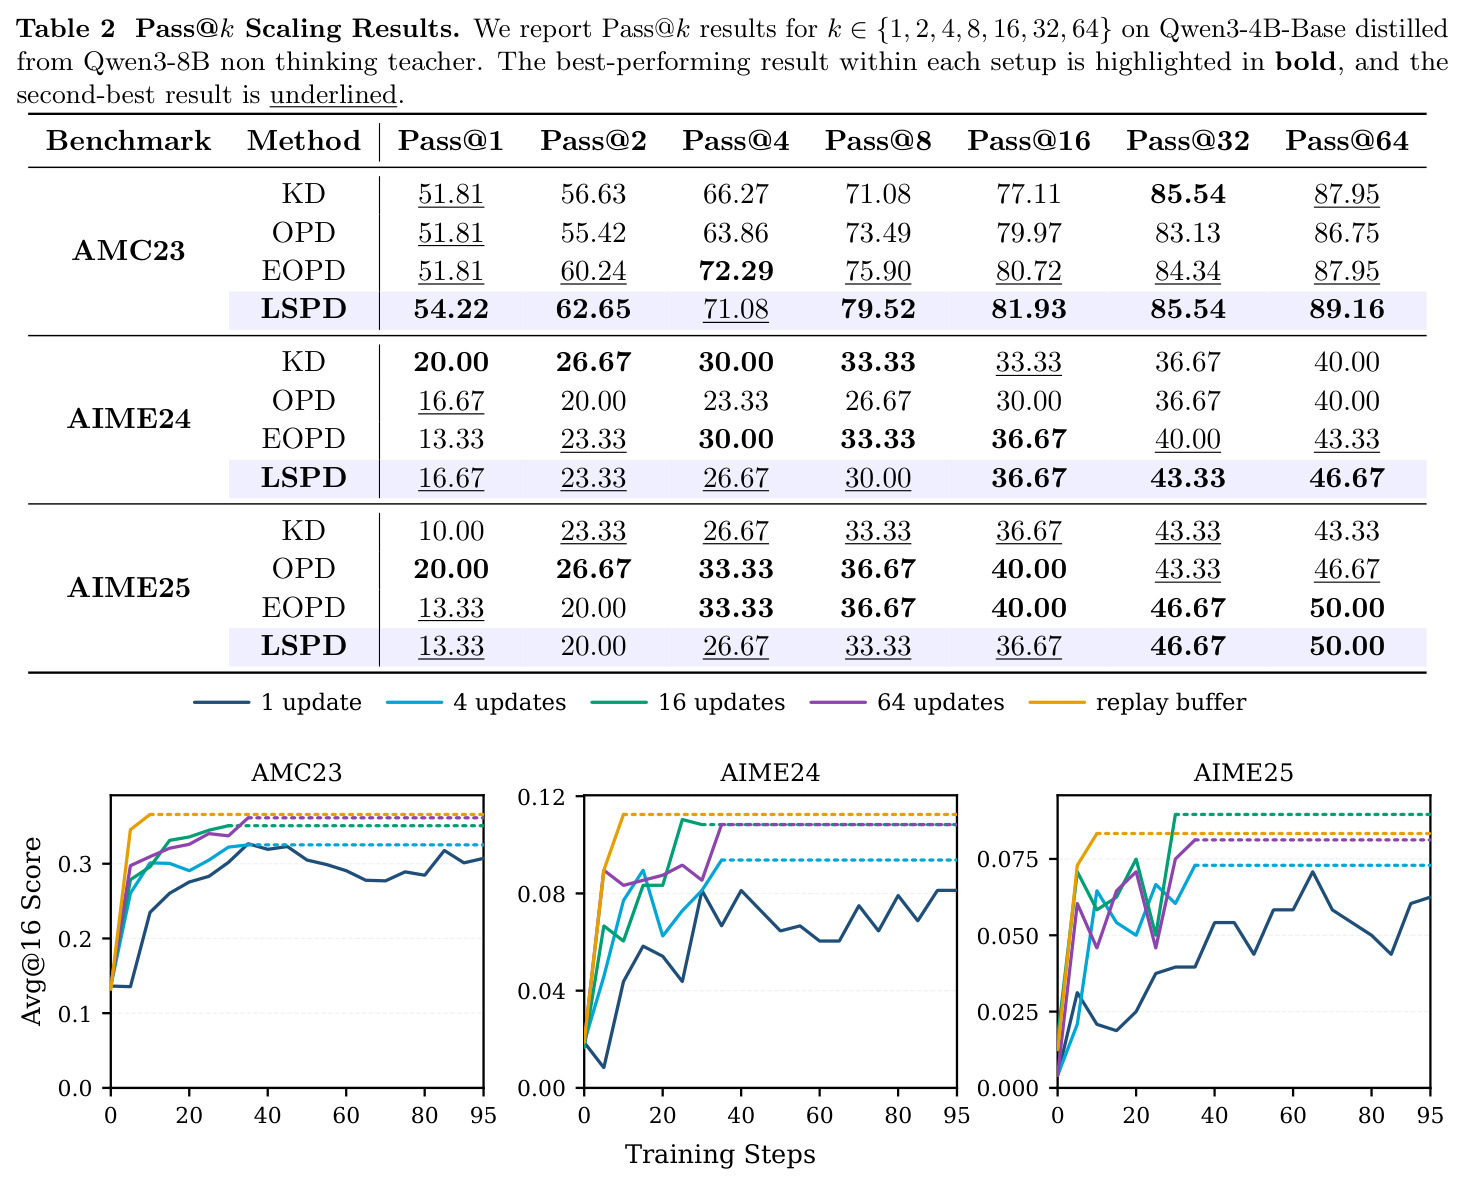
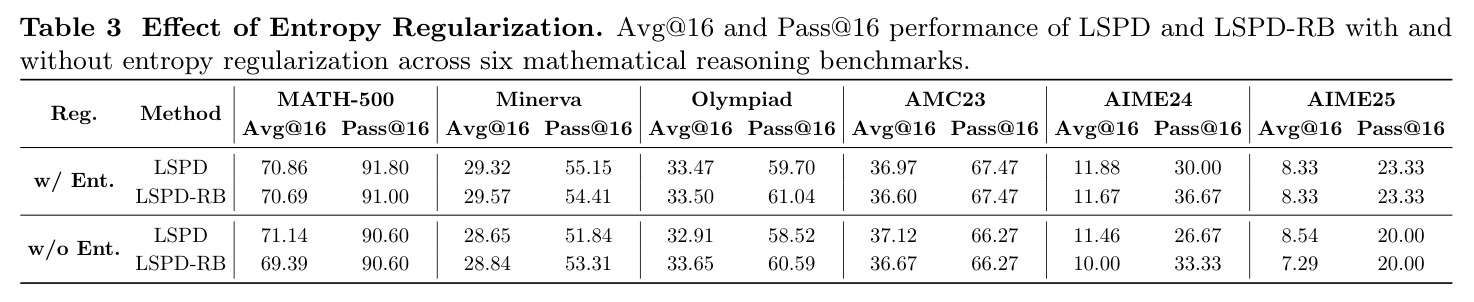
主实验(Table 1)覆盖 6 个基准乘 3 组师生配置(8B→4B、4B→1.7B、1.7B→0.6B)。18 个组合平均后,LSPD 达 Avg@16 31.60、Pass@16 53.30,比最强基线 EOPD 高 +0.91/+0.85,比 OPD 高 +1.99/+2.27;LSPD-RB 仅 10 步训练即达 31.51/54.86,超 EOPD +0.82/+2.42、OPD +1.89/+3.84,而基线需 40 步以上才收敛;两变体在 17/18 个设置上最优,36 个指标—设置组合全部进前二。Figure 1 显示 LSPD 全程维持学生熵约 0.5,与 EOPD 相当且高于 OPD。Pass@k 扩展(Table 2)中 LSPD 在三基准的 Pass@32/64 全部最优或并列最优(如 AIME24 43.33/46.67、AMC23 85.54/89.16),平均 58.51/61.94,领先 EOPD +1.51/+1.52。Figure 2 表明每批更新 $N\ge4$ 约 30 步饱和,$N=1$ 需 50 步以上,LSPD-RB 约 10 步即饱和,只用前 25% 的 rollout 批次追平 vanilla OPD。消融(Table 3)显示去掉熵正则后 Avg@16 平均仅降 0.46,Pass@16 平均降 1.95 且在全部 12 个对比中一致下降,说明熵正则主要保多样性。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(6 基准 × 3 组师生配置,18 个组合平均) | Avg@16 | LSPD 31.60 | EOPD 30.69(次优)、OPD 29.61、KD 28.85 | 较 EOPD +0.91,较 OPD +1.99 |
| 数学推理(6 基准 × 3 组师生配置,18 个组合平均) | Pass@16 | LSPD 53.30;LSPD-RB 54.86(仅 10 步训练) | EOPD 52.45、OPD 51.03 | LSPD 较 EOPD +0.85;LSPD-RB 较 EOPD +2.42、较 OPD +3.84 |
| AMC23(Qwen3-8B 教师 → Qwen3-4B 学生) | Pass@64 | LSPD 89.16 | EOPD 87.95、KD 87.95、OPD 86.75 | +1.21 |
| AIME24(Qwen3-8B → Qwen3-4B) | Pass@64 | LSPD 46.67 | EOPD 43.33、KD/OPD 40.00 | +3.34 |
| 训练样本效率(Qwen3-4B → Qwen3-1.7B,64 prompt/批 × 4 回答) | 达到饱和 Avg@16 所需训练步数 | LSPD-RB 约 10 步(每批回放 256 次更新) | 半在线 LSPD(N=1)需 50 步以上,OPD/EOPD 等 40 步以上 | rollout 需求降低约 75%,前 25% 批次追平 vanilla OPD |
| Pass@k 扩展(AMC23+AIME24+AIME25 平均,8B→4B) | Pass@32 / Pass@64 | LSPD 58.51 / 61.94 | EOPD 57.00 / 60.43 | +1.51 / +1.52 |
局限与改进
作者承认的局限主要在理论假设上:Theorem 6.2 依赖 Assumption 6.1,即最优策略与参考策略的对数比 $r^*=\log\frac{\pi^*(y_t|x_{<t})}{\pi_{ref}(y_t|x_{<t})}$ 必须落在有界奖励函数类内,实践中要求学生与教师有良好的分布覆盖,对能力差距悬殊的师生对未必成立;且理想化的乐观算法(Algorithm 2)与实用目标(Algorithm 1)之间存在差距,熵正则只是乐观项的替代品,$\beta$ 在实用算法中并未出现。我的观察是:评测全部集中在数学推理(训练用 DAPO-Math-17K),没有代码生成、通用问答或域外任务的主文证据(仅附录提及 OOD);实验限于 Qwen3 家族;最小规模 0.6B 学生上 LSPD-RB 不稳定,AIME24 的 Avg@16 仅 3.96,低于 LSPD 的 5.00;实际训练中教师需对缓冲区里每个历史 token 打分,教师推理开销随回放池线性增长;$\mu$、学习率等超参的敏感性只在附录讨论,正文未给出算力规模。
独立分析的弱点
第一,领域单一:所有训练和评测都在数学推理上,而乐观探索的收益在代码生成、多轮 agent 这类长序列稀疏奖励场景可能不同甚至失效,应扩展验证。第二,理论—实践鸿沟:实用损失把逐点乐观奖励换成熵红利,Huber 化进一步偏离最小二乘的统计解释,置信半径 $\beta$ 在 Algorithm 1 中完全缺席,理论保证是否覆盖实用算法存疑,改进方向是给出实用目标自身的遗憾分析或自适应调节熵系数。第三,成本结构:LSPD-RB 每个新批次要做 256 次回放更新,且所有历史样本都需要教师 log 概率,教师前向开销随缓冲区增长,可引入教师打分缓存、按新旧策略差距做重要性采样淘汰或优先回放。第四,小模型脆弱:0.6B 学生上 LSPD-RB 的 AIME24 Avg@16(3.96)明显低于 LSPD(5.00),AMC23 也从 24.62 降到 22.97,提示完全离策略回放可能放大小模型的过拟合,可按学生规模调整回放比例或加早停。第五,与可验证奖励(RLVR)结合完全未触及,OPD 只模仿教师分布,理论上限被教师封顶,缺少超越教师的任务信号通道。
未来方向
作者指出的方向包括:把遗憾分析推广到更一般的奖励函数类并弱化 Assumption 6.1 的覆盖假设(Theorem 6.2 目前依赖线性 $d$ 维奖励类和有界 log 比值);改进乐观项的实用替代形式。基于成果可延伸的方向:一是与 RLVR 结合,把教师对数似然比奖励与可验证任务奖励加权混合,兼得模仿的稳定性与超越教师的空间;二是自适应回放管理,按样本新旧策略差距加权或优先回放,进一步压低 rollout 需求(目前前 25% 批次已追平 OPD);三是迁移到代码、科学推理与多模态推理,检验 Pass@k 覆盖优势是否泛化到其他分布形态;四是与课程式蒸馏(论文引用的 Li et al. 2026a)及 thinking-mode 教师结合,研究长思维链下熵维持与信用分配;五是利用 LSPD 在大 k 下的覆盖优势,把它作为 test-time scaling 与 best-of-n 系统的高质量采样源,或反过来用 Pass@k 增益作为蒸馏目标函数的一部分。
复现评估
复现条件较好。代码开源在 https://github.com/UNCSciML/LSPD;模型全部为 Qwen3 开源权重(8B/4B/1.7B/0.6B 及对应 Base 版本,教师关闭 thinking 模式);训练数据 DAPO-Math-17K 与六个评测基准均公开可得。正文给出关键配置:训练 top-p=1.0、温度 1.0、rollout 最长 7168 token、每 prompt 4 条回答、每批 64 个 prompt;评测 top-p=0.95、温度 0.7;LSPD-RB 每批回放 256 次更新、仅训练 10 步。附录 A.1 提供 Huber 惩罚细节、A.3 提供 prompt 模板。未明确的是学习率、$\mu$、$\beta$ 等超参数值与具体 GPU 数量和训练时长,正文未报告算力规模,按学生 0.6B–4B、教师最大 8B 估计数十张高端 GPU 即可完成。总体复现难度中等:算法本体只是一个回归损失加熵正则,主要工程量在教师逐 token 打分的吞吐优化与 Pass@64 评估的采样成本。
论文图表