OfficeTown:面向智能体进化的生成式专业组织模拟框架 OfficeTown: Generative Organizations for Evolving Agent Intelligence
把职业组织建成持续运转的生成式模拟,让任务、上下文与评审从真实工作中自然涌现
前置知识
LLM 智能体(Agent)
以大语言模型为核心控制器、能循环执行「观察—思考—行动」的软件系统。智能体通过工具调用读写文件、执行终端命令、访问服务,每轮决策由模型根据当前上下文生成,直到完成任务或耗尽轮次/Token 预算。与单轮问答不同,智能体的成败取决于长程规划、工具使用与错误恢复能力。
OfficeTown 评测和训练的对象正是这类智能体:任务环境提供文件与终端,助手智能体在被授权的工作区内执行委派工作,不理解智能体的基本运行方式就无法理解论文的任务构造与评测协议。
主—助委托模式(Principal–Assistant)
一种双层智能体架构:由模型驱动的「专业者」担任委托人(principal),负责协调工作、把有边界的任务委派给助手(assistant)并评审其交付物;助手只在被授权的工作空间内执行。委派、执行、评审、接受被显式分离为不同动作,信息与操作权限随角色分层。
这是 OfficeTown 模拟的组织单元,也是论文 Harness 补充实验的核心设计;作者用实验证明该架构优于单智能体与 MetaGPT/CAMEL 等多智能体基线,是全文贡献的关键落点。
生成式智能体与组织模拟
由 Park 等人 Generative Agents 开创的思路:用 LLM 扮演带记忆、反思与规划的角色,在沙盒中持续产生社会性行为。组织模拟进一步引入汇报关系、会议、职责与权威边界,让角色间产生真实的工作协作;Agent Hospital 等工作则把机构模拟与专业能力积累结合。
OfficeTown 是该路线在职业工作场景的延伸,但新增了权限化状态与可执行交付物。了解这条学术脉络,才能看清它与 TheAgentCompany、生成式环境合成本质差异在哪里。
持久化与权限化状态(ACL 访问控制)
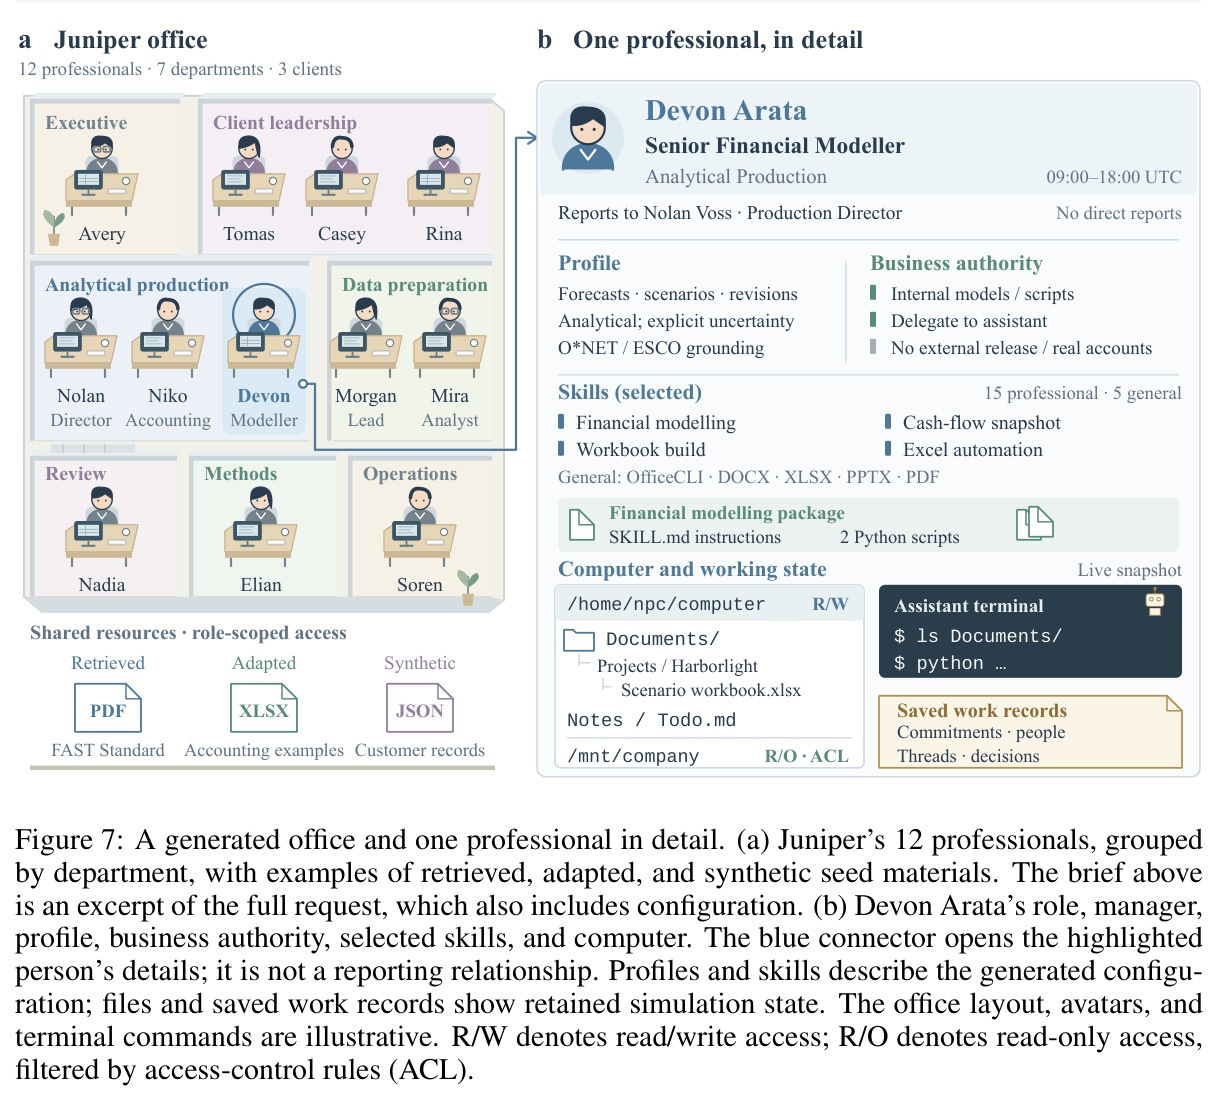
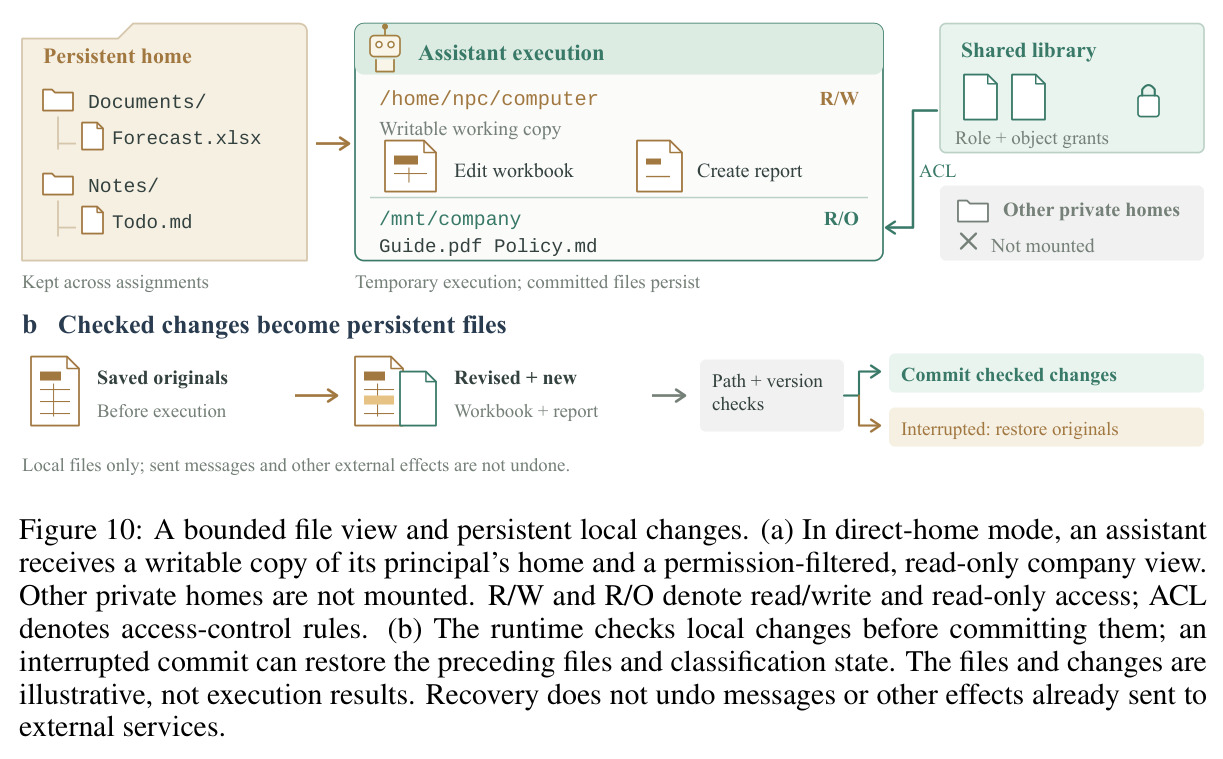
系统的文件、消息与决策跨任务保存,且每个成员只能看到权限允许的部分:角色权限、文件所有权、共享规则与保密等级共同决定信息视图;汇报关系不自动授予文件访问权。助手拿到的是委托人主目录的可写副本,加上按 ACL 过滤的只读共享挂载,他人私人工作区根本不挂载。
「持久但不可全局观测」是本文区别于普通基准的本质特征:任务语境、信息边界、修订类任务都由此产生,不理解 ACL 就无法理解「任务时刻快照」为何能既保留语境又不泄漏答案。
SFT 与在线策略蒸馏(OPD)
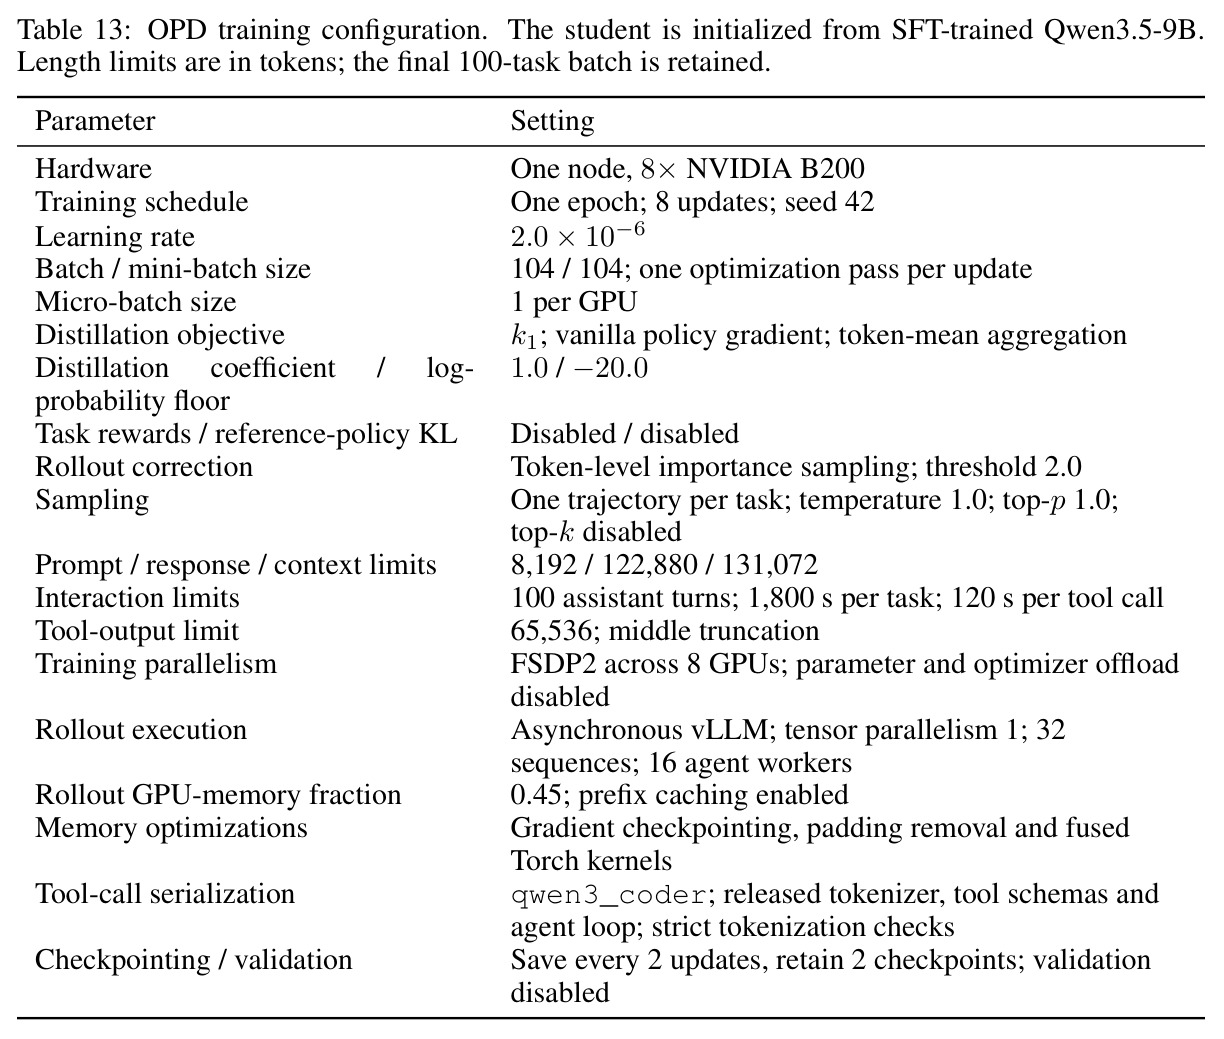
SFT(监督微调)用教师模型的完整轨迹(推理、工具调用、观察、回复)直接监督学生模型。OPD(Agarwal 等,2024)让学生先自己对任务采样动作 $a_t$,再用逐 token 对数概率差 $k_{1,t}=\log\pi_{\text{student}}(a_t|h_t)-\log\pi_{\text{teacher}}(a_t|h_t)$ 作为带停梯度的优势做策略梯度更新,让学生从自己的错误中向教师对齐。
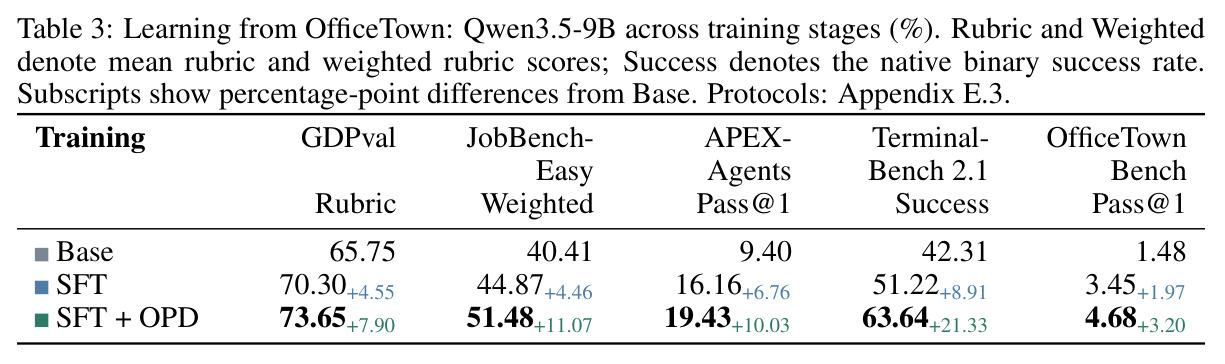
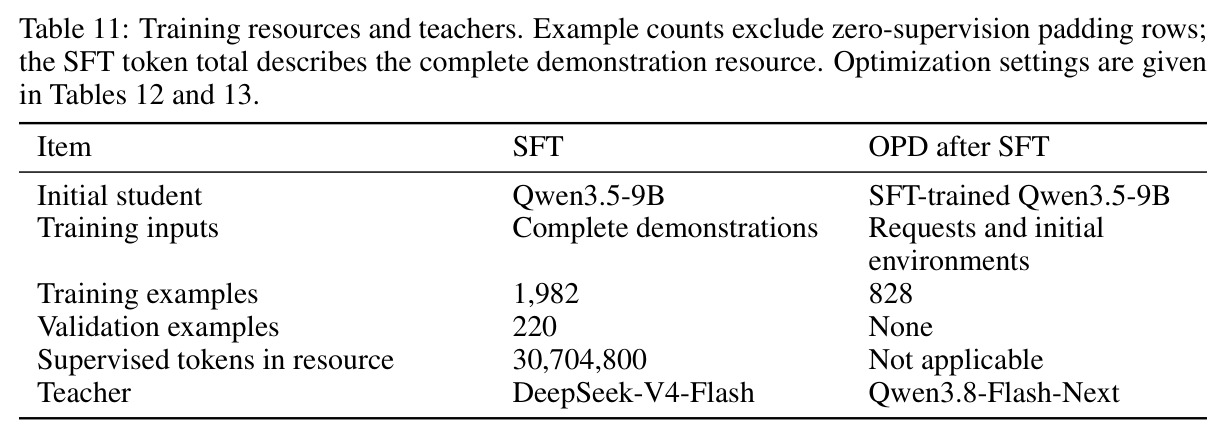
论文的训练实验正是两阶段:先在 2,202 条 DeepSeek-V4-Flash 轨迹上 SFT,再在 828 个 OfficeTown 环境中用 Qwen3.8-Flash-Next 做 OPD。两阶段的独立贡献需要分开理解,这是 Table 3 的阅读前提。
Pass@1 与加权评分(Weighted Score)
Pass@1 要求第一次尝试就满足任务所有必达评测标准才算通过,衡量「完整交付」;Weighted Score 按重要性加权统计每任务完成的评分权重占比再平均,衡量「部分完成程度」。本文权重按序统计中心权重取 $(\alpha_{P0},\alpha_{P1},\alpha_{P2},\alpha_{P3})=(25,13,7,3)$,即 $w_{ic}=\alpha_{p(c)}/|G_i(c)|$。
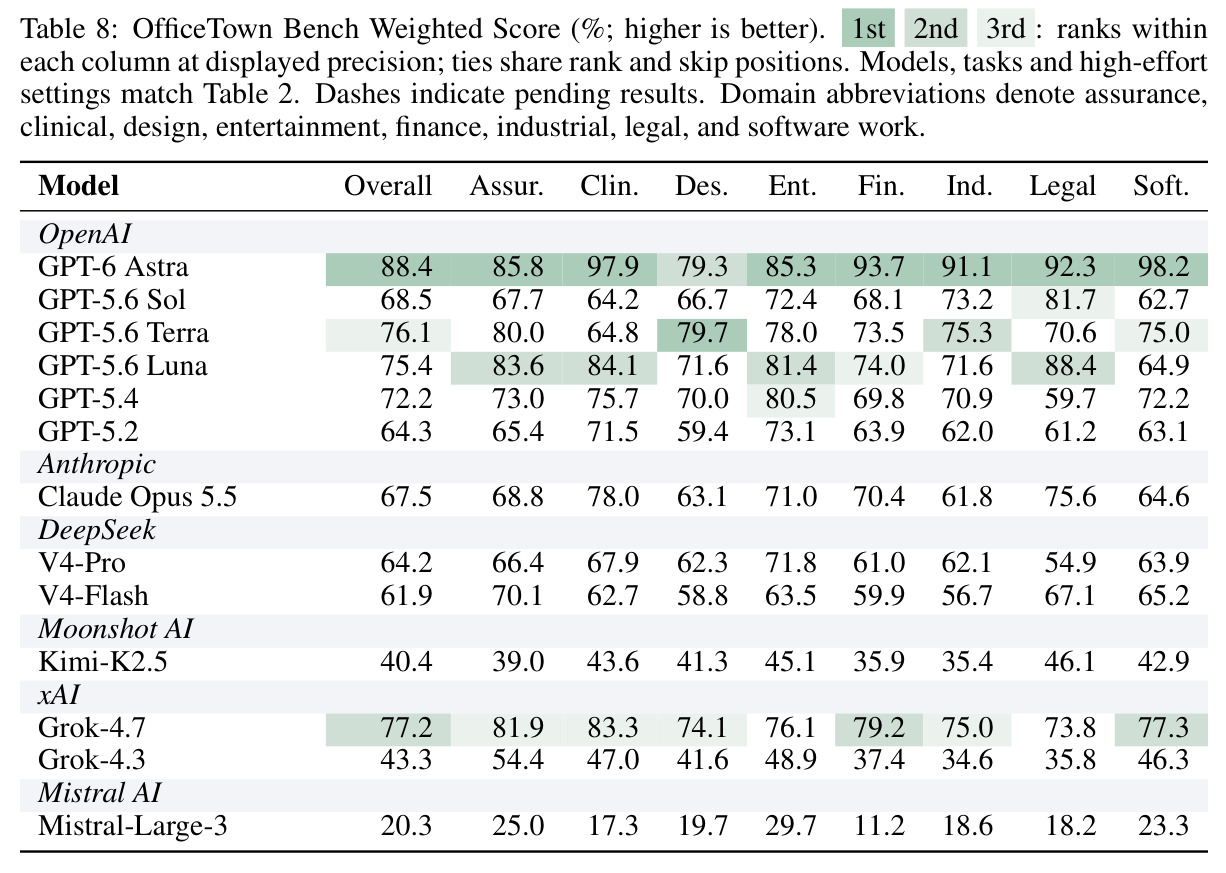
论文最重要的发现之一就是两个指标会给出相反的模型排序(Claude 通过率高于 GPT-5.6 Terra、加权分却更低),读懂这对指标才能理解「部分完成不等于专业交付」这一核心论点。
研究动机
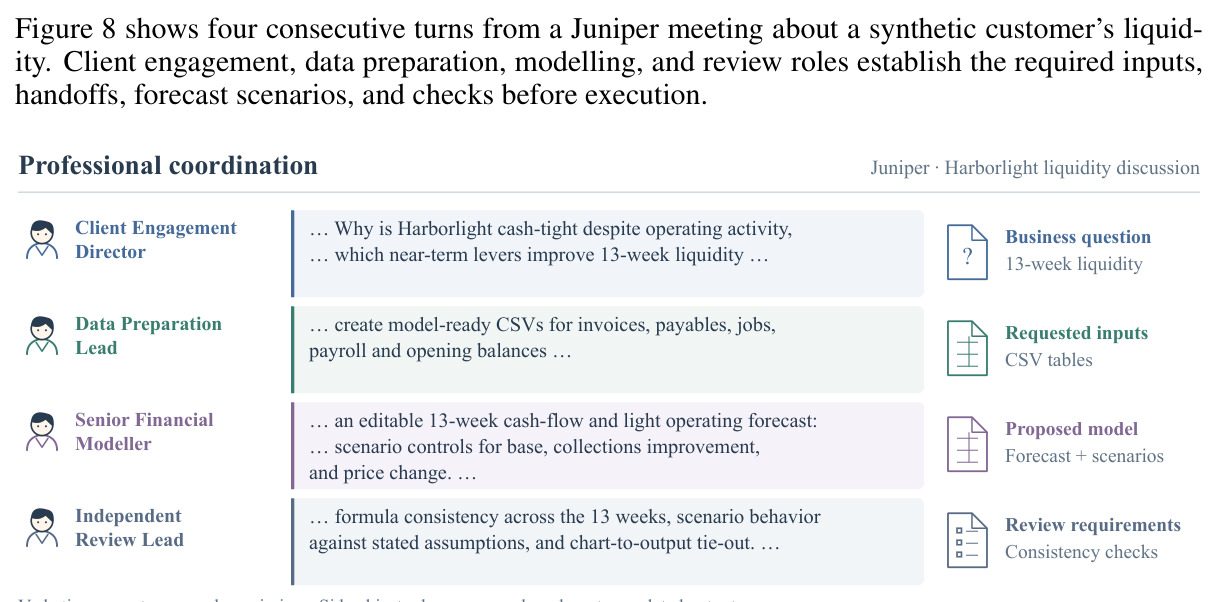
现有职业工作评测与环境合成方法(GDPval、ScaleEnv、EnvFactory、Agent-World 等)有一个共同前提:把任务当作孤立实例来生成与评测。但真实的职业工作几乎从不孤立发生——在组织中,新任务从正在进行的活动中涌现:交付物会被上级评审并要求修改,一个决策会催生后续请求,A 项目积累的材料会成为 B 任务的输入,而且每个成员能看到什么、能做什么由角色权限决定。以 OpenAI 的 GDPval 为例,它虽覆盖多个职业的真实交付物,但每个样本是静态的单点任务,没有评审反馈回路,没有信息权限边界,更没有跨任务的长程依赖。这带来三个具体问题:其一,评测无法考察智能体在「修订别人草稿」「只拿到权限内材料」这类真实约束下的表现;其二,训练数据合成管道缺少评审意见、未决事项这类高价值监督信号,任务之间彼此独立、语境稀薄;其三,任务质量依赖人工撰写或单次模型生成,难以规模化扩展。简言之,领域缺少一个能持续「生产」带语境、带反馈、带依赖的职业任务的系统。
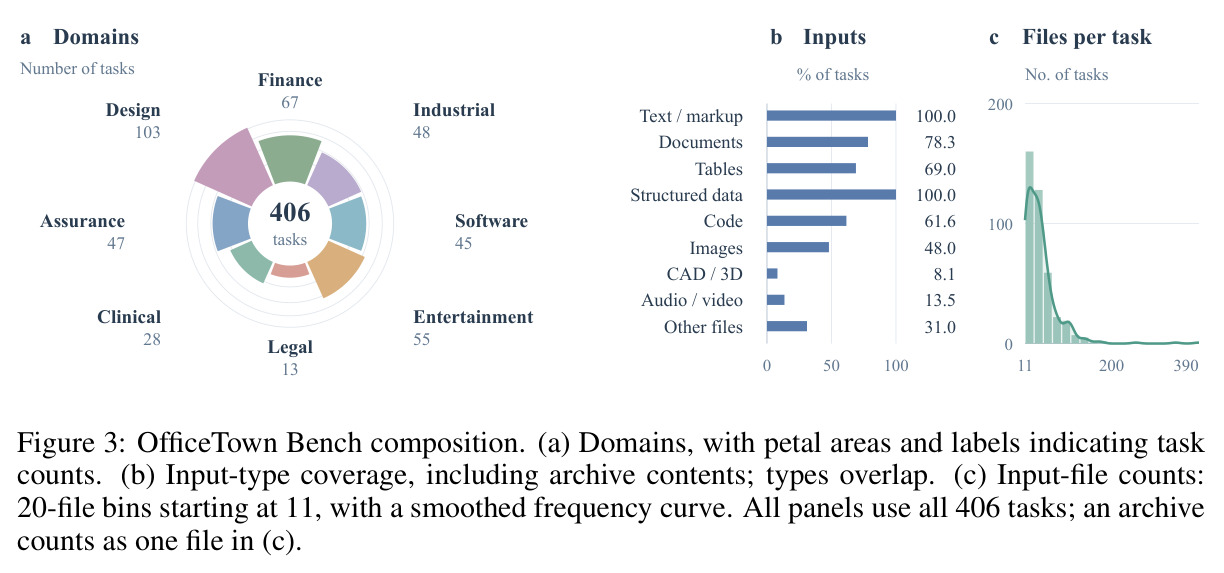
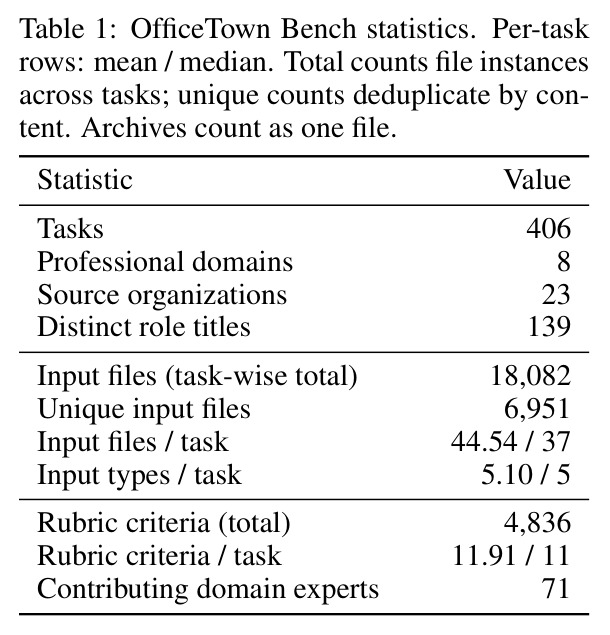
本文的目标是本文的目标是:不再直接生成孤立任务,而是建模那个持续生产职业工作的系统本身——职业组织。具体而言,要从一段自然语言的组织简介(一句话即可)出发,自动构造出具备角色、职责、资源与权威边界的持久组织,并模拟其中的持续工作:专业者通过消息、邮件、日历协调,把有边界的任务委派给助手智能体,评审其交付物并安排后续工作;文件、沟通与决策持续更新组织的持久状态,未决事项推动后续任务。在此之上,把精选的委派任务连同其「任务时刻」的语境打包成可执行资源,形成三样产物:(1) OfficeTown Bench——406 个任务、4,836 条评测标准、71 位领域专家参与打磨的基准;(2) 训练资源——2,202 条监督微调(SFT)轨迹与 828 个在线策略蒸馏(OPD)任务—环境对;(3) 一个主—助(principal–assistant)执行框架。最终用实验回答三个问题:这些任务能否难住前沿模型?在生成的数据上训练能否提升外部基准表现?主—助设计是否优于其他 harness?
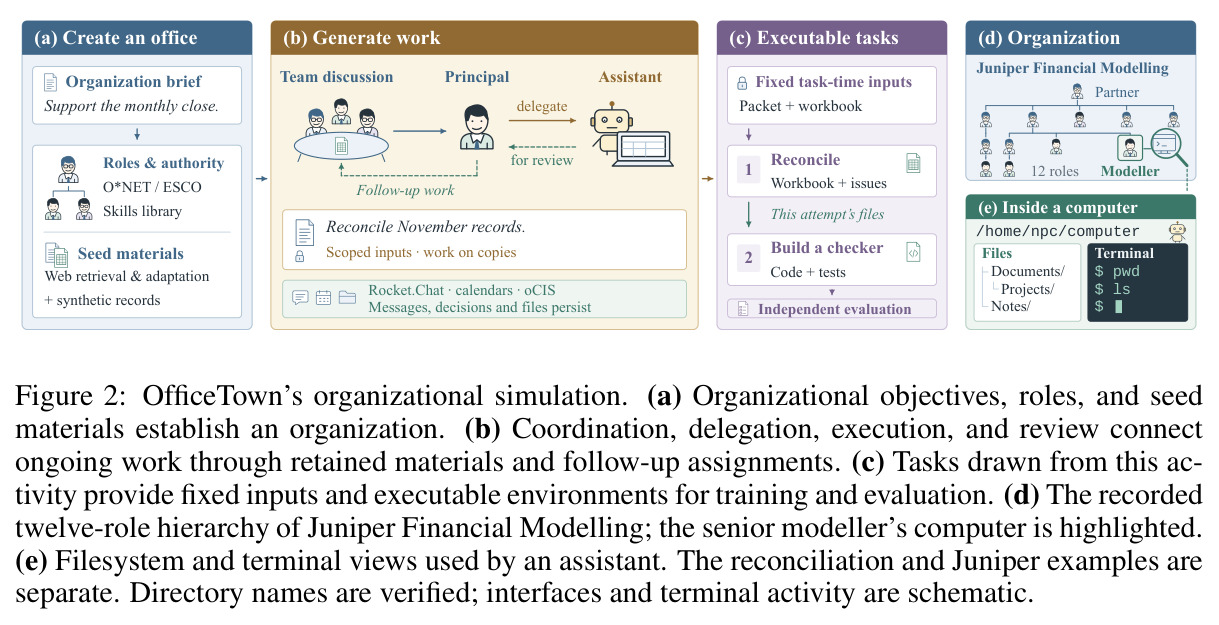
与已有工作不同的是,本文的独特切入点是「工作生成」而非「任务生成」。与最接近的 TheAgentCompany(模拟公司但任务靠人工整理)不同,OfficeTown 的任务是从组织模拟中自动涌现的,可规模化再生产;与环境合成工作(ScaleEnv、EnvFactory、Agent-World 等,从 API 或自然语言请求合成工具环境)不同,它建模的是组织层面的持续过程,任务天然带有评审反馈、未决事项与跨任务依赖;与 Generative Agents、Agent Hospital 等社会/机构模拟不同,它引入了权限过滤的信息视图与可执行的专业交付物,且模拟产物能直接变成可评测、可训练的资源。三个关键设计构成其差异化的生成内核:状态持久但不可全局观测(角色权限、所有权、共享规则决定每个成员的视野);保存、接受、共享是三种分离的动作(草稿不会被同事看到,接受须经专业者评审);任务以「任务时刻快照」固化,保留时间与权限边界、排除该任务后来的解法与评测者专属信息。这使生成的数据既携带真实组织语境,又不向被评测智能体泄漏答案。
核心方法
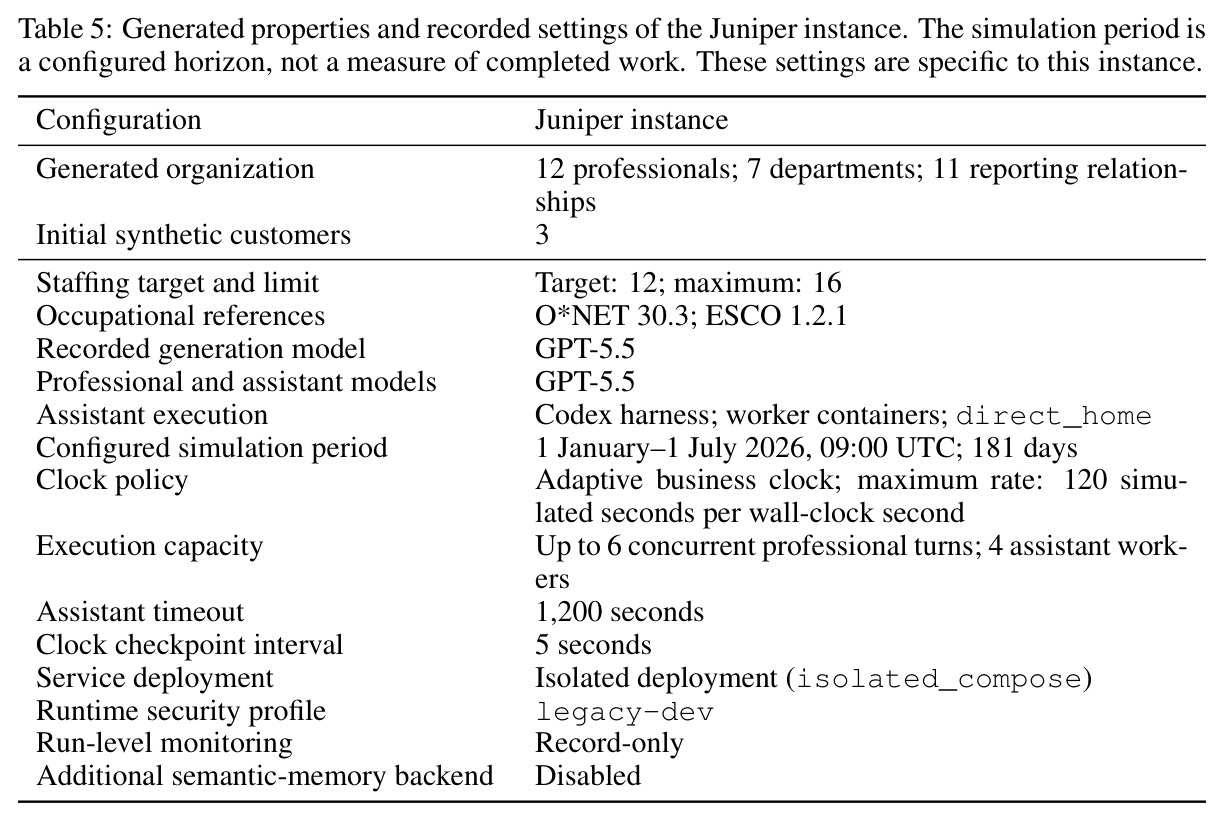
直觉上,作者把「出题」上移一层:与其让模型逐个编造任务,不如让一个持续运转的组织自己「长出」任务。技术上分四步。第一步组织构造:从组织简介展开出部门、角色(以 O*NET 与 ESCO 职业描述为根据)、汇报关系与合成客户,并装配「种子」材料——网络检索的专业文献(FAST 标准、ICAEW 财务建模准则)、改编材料与组织特有的合成记录(客户发票、期初余额)。示例组织 Juniper 有 12 名专业者、7 个部门、11 条汇报关系,服务 3 个合成客户。第二步异步模拟:共享日历上的请求、消息、会议与交付激活对应专业者,他们协调、委派、评审;办公服务由 Rocket.Chat(消息)、Mailpit(邮件)、Baïkal(日历)支撑,多个事项可并行推进。第三步状态演化:每次保存、评审、共享都更新持久且权限化的组织状态,未决问题保留待查。第四步任务固化:把委派任务与其任务时刻的文件、权限快照打包成可执行任务,供评测或训练。整个框架由前沿模型驱动(Juniper 用 GPT-5.5),模拟期可配置(Juniper 为 181 个模拟日,自适应时钟最多 120 模拟秒/真实秒)。
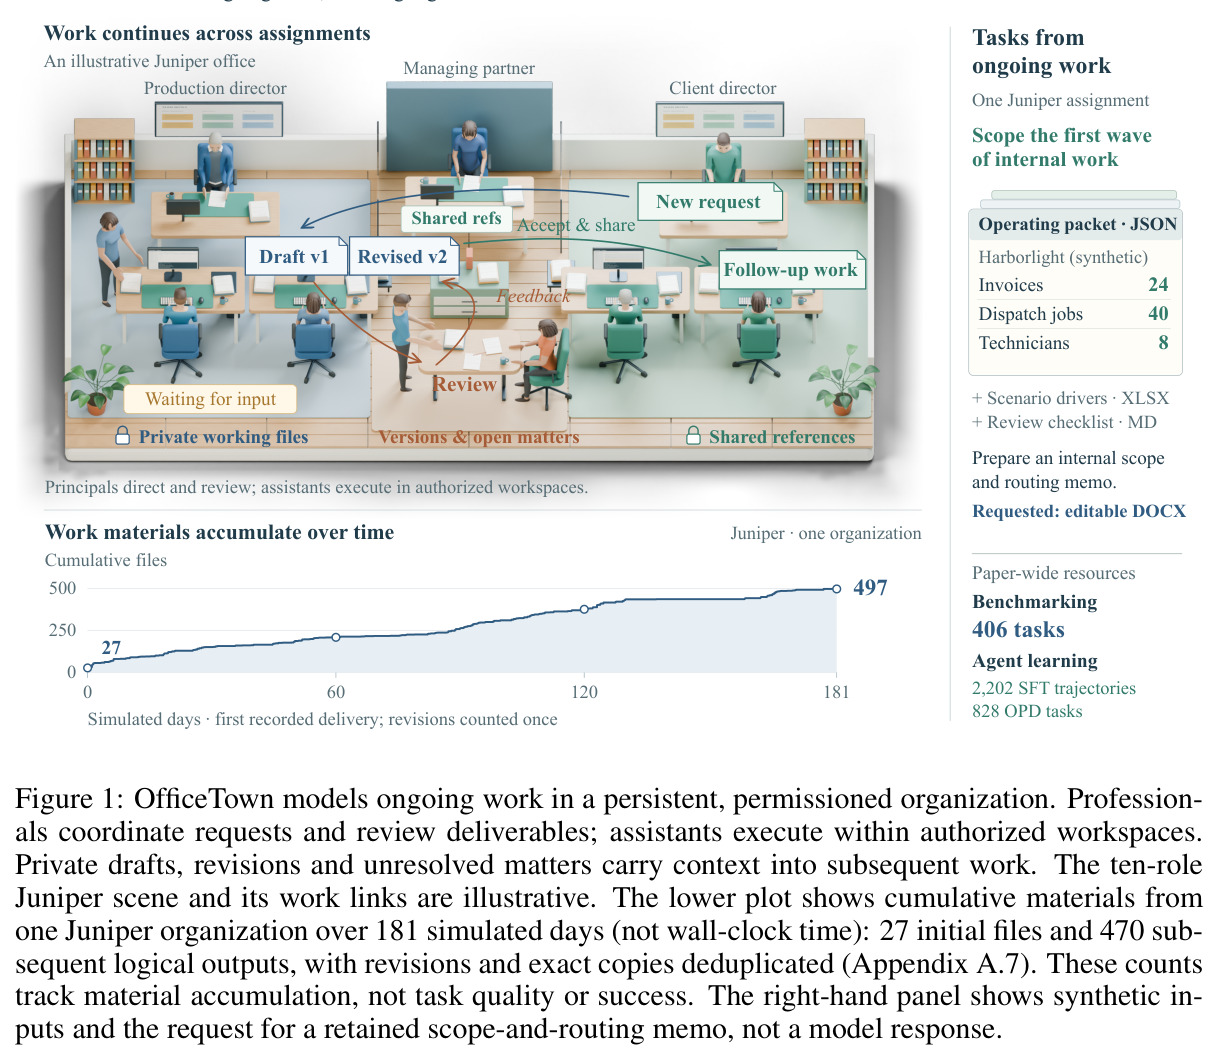
核心创新是把「持续、权限化、演化的组织状态」当作任务与训练数据的生成源,与已有方法的本质区别体现在三点。第一,任务从持续工作中涌现:后续任务的输入包含此前被接受的产物和未决问题,形成跨任务长程依赖,而不是每个任务都从零开始;Juniper 一个组织 181 天内材料从 27 个文件累积到 497 个,其中大量后续任务的输入正是早期工作的输出。第二,权限即语境:每个成员看到的是权限过滤后的视图,助手只拿到委托人授权范围内的可写工作文件与只读共享引用,他人的私人工作区根本不挂载,汇报关系不等于文件访问权——这让「信息边界」第一次成为可构造、可评测的任务属性。第三,工作流动作被真实建模:保存(保留草稿与待修订版本)、接受(专业者评审实际产物后确认)、共享(显式授权后发布)是分离的动作,发布前运行时检查接受记录、版本、密级与接收者权限。加上「任务时刻快照」机制(保留待修订的历史产物、排除该任务的历史解法),OfficeTown 生成的每个任务都自带真实工作的约束结构,而这是单点任务合成方法无法提供的。
方法步骤详情
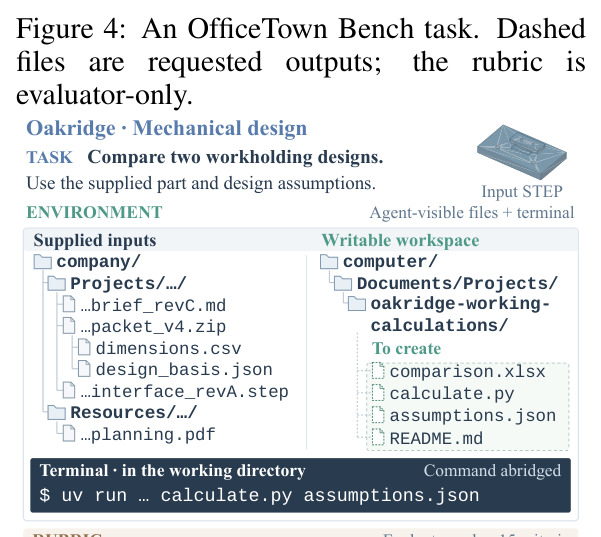
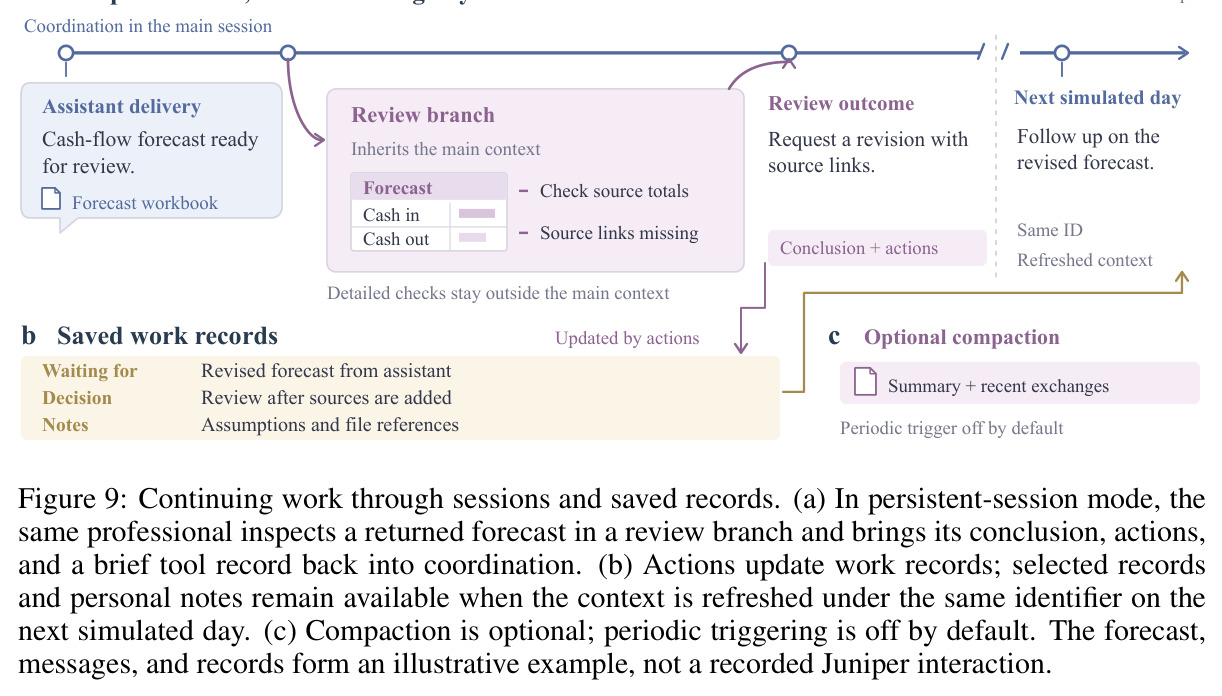
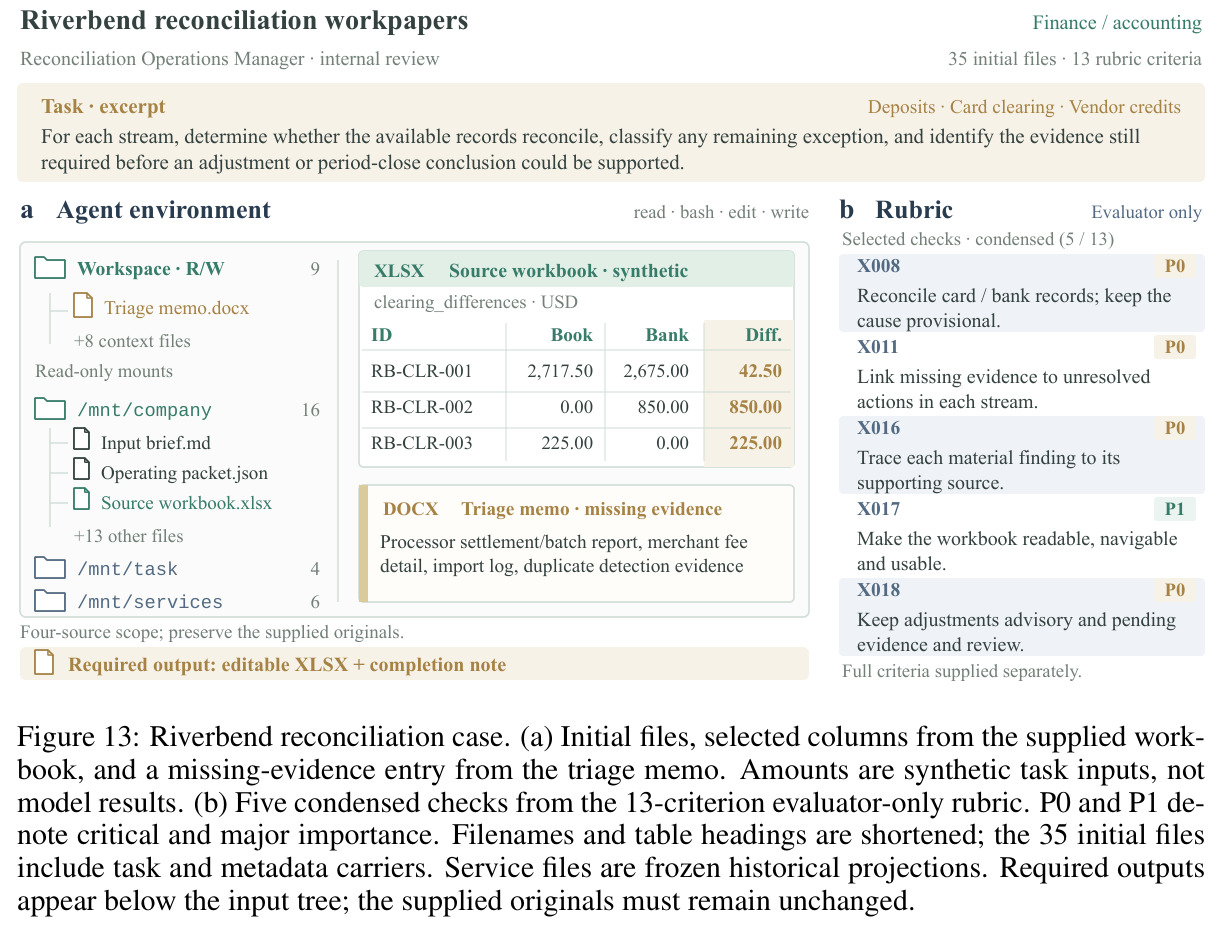
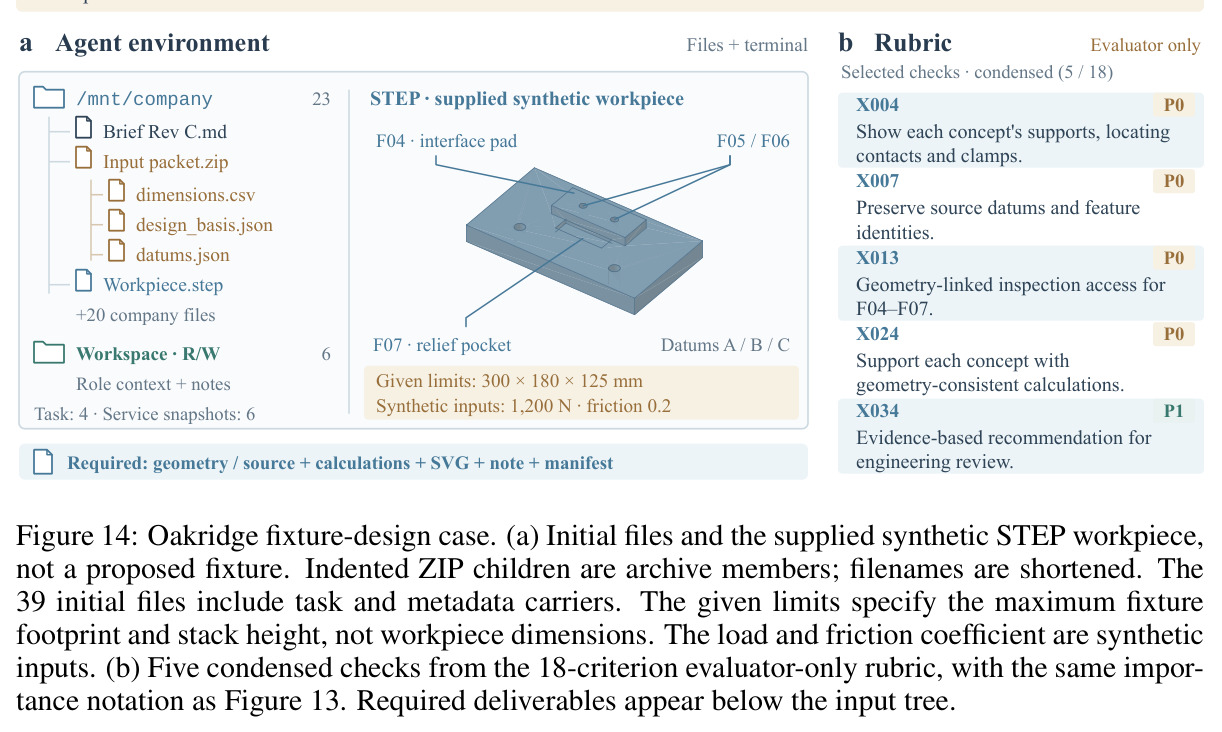
完整流程五步。(1) 组织构造:输入一句话简介,系统展开为部门、角色(挂接 O*NET/ESCO 档案与业务权威,如「可做内部模型、可委派、不得对外发布」)、汇报关系与合成客户,配技能包(15 职业+5 通用,含 SKILL.md 与脚本);种子材料(检索+改编+合成)经格式检查写入初始工作区,输出可运行组织包。(2) 协调与委派:对话达成为显式请求(结果、负责人、材料、截止时间);principal 指定目标、输入、约束与交付物,助手在授权工作区(/home/npc/computer 可写、/mnt/company 按 ACL 只读)执行,可向 principal 澄清。(3) 评审与后续:principal 检查实际产物而非完成报告,决定接受、修改或补充;接受结果经显式共享成为同事输入,未决问题保留。(4) 状态与记忆:承诺、讨论、未决决策独立于会话持久保存,每次激活默认注入 8 承诺/5 讨论/5 决策/10 同事记录;日切换时同 ID 重开会话,细查在分支会话完成、只带回结论。(5) 任务固化:打包任务时刻快照,在全新工作区初始化,智能体执行后产物对照 rubric 由可执行检查加内容判断评分。
技术新颖性
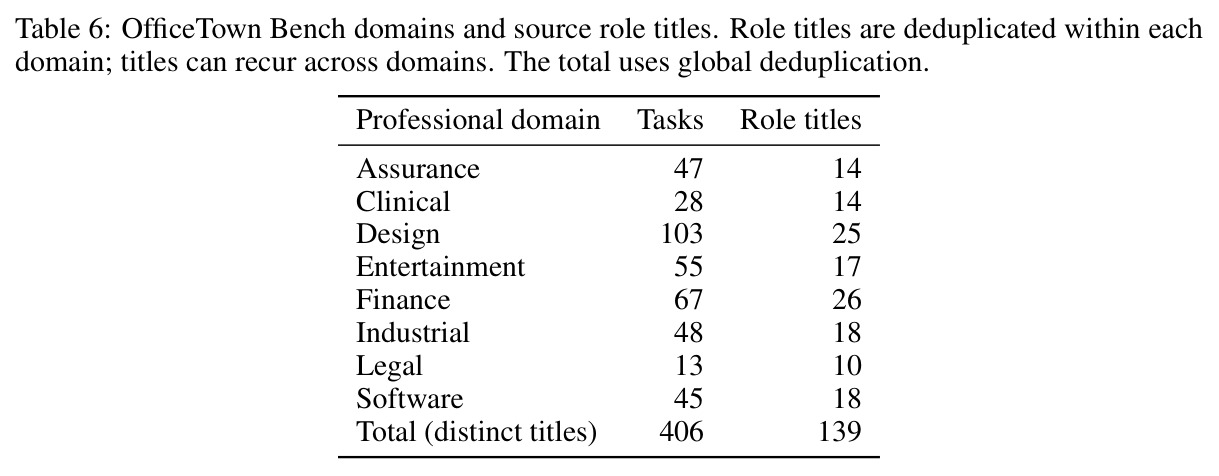
技术新颖性可从四层评价。基础设施层面,把企业级机制搬进智能体模拟:ACL 权限过滤视图、只读挂载沙箱、checked-update 提交边界与日志化恢复(中断可回滚文件与密级,已发邮件不可撤销)、自适应业务时钟——同类工作罕见。数据机制层面,「保存/接受/共享」三分离与任务时刻快照共同保证不泄漏:任务可含待修订的历史产物,但绝不含该任务的历史解法与评测者信息。评测层面,rubric 权重按序统计中心权重设计:$w_{ic}=\alpha_{p(c)}/|G_i(c)|$,$(\alpha_{P0},\alpha_{P1},\alpha_{P2},\alpha_{P3})=(25,13,7,3)$,删除标准不重分配权重;Pass@1 要求一次尝试满足所有必达标准,与衡量部分完成的加权分互补。训练层面,OPD 用对数比 $k_{1,t}=\log\pi_{\text{student}}(a_t|h_t)-\log\pi_{\text{teacher}}(a_t|h_t)$ 作停梯度优势、关闭任务奖励与 KL,是在线蒸馏的干净应用。质量投入上,71 位专家对 1,051 个候选任务、32,274 条候选标准给出 3,842 条修订建议,最终 394/406 任务绑定人工反馈,质控强度少见。
实验结果
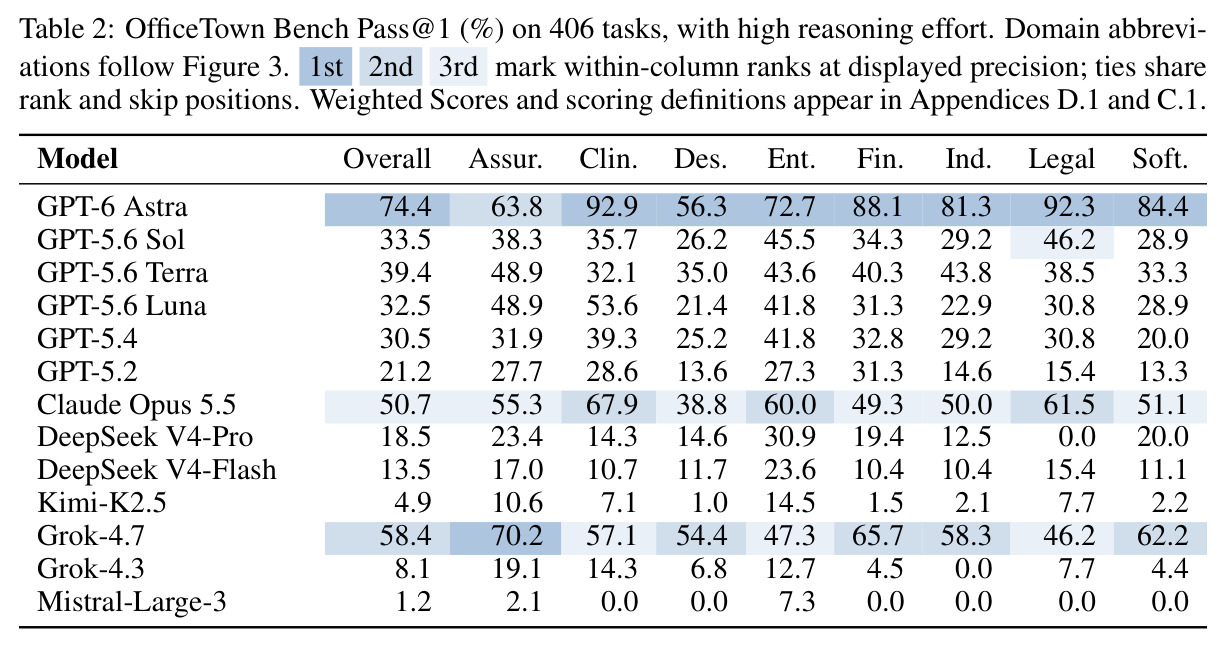
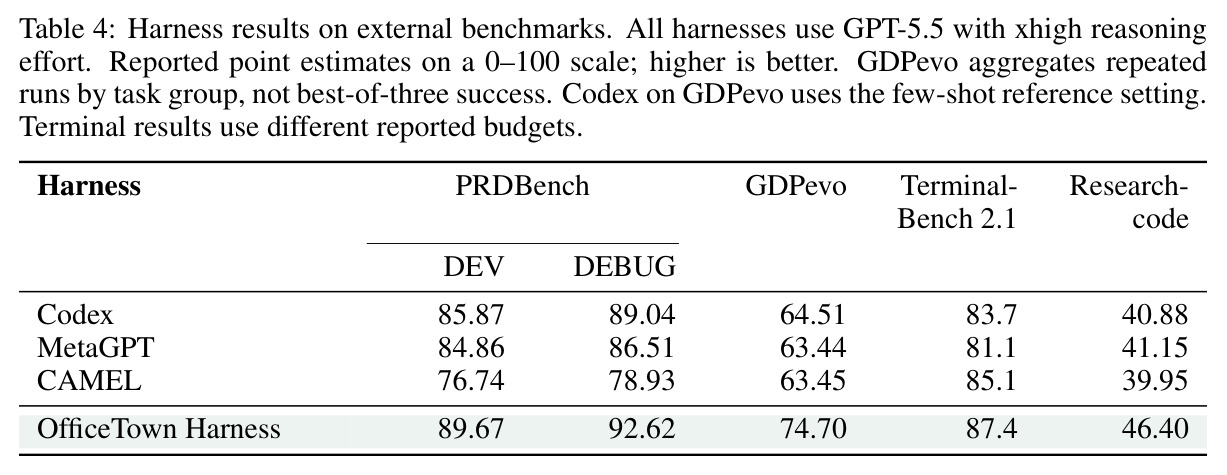
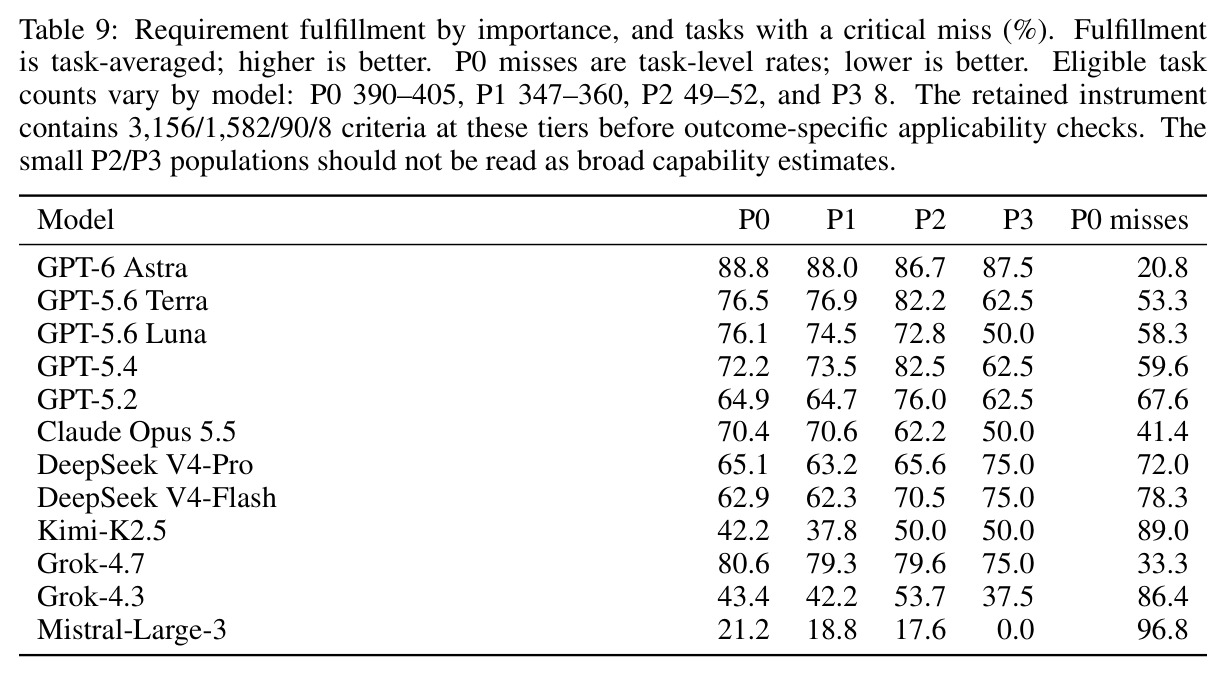
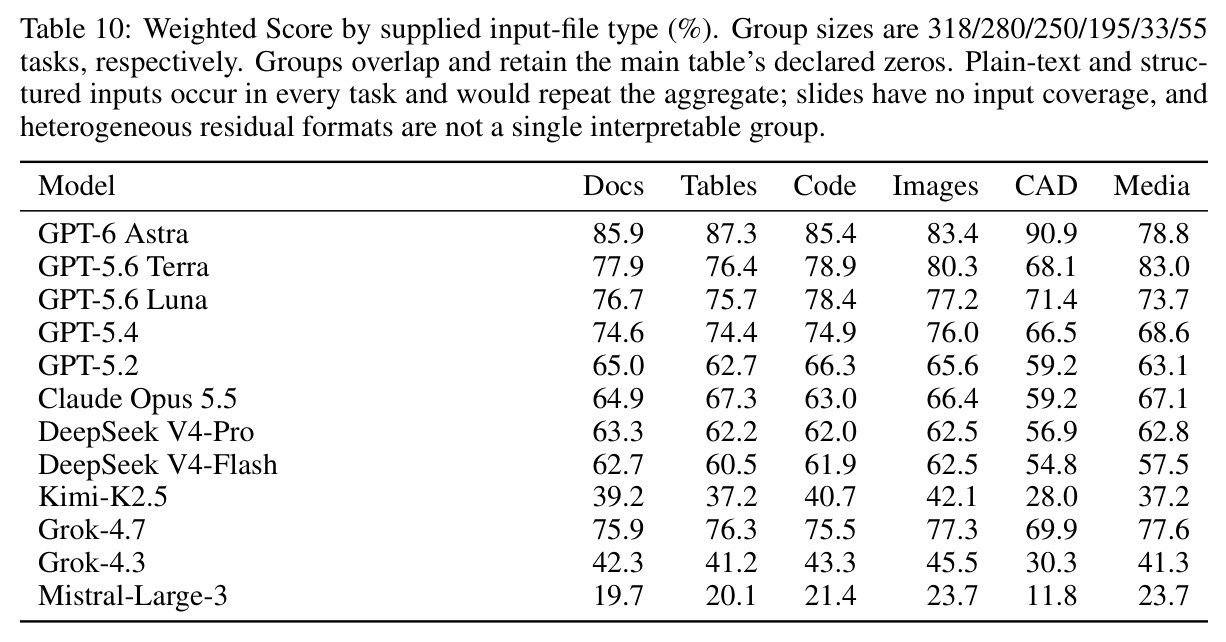
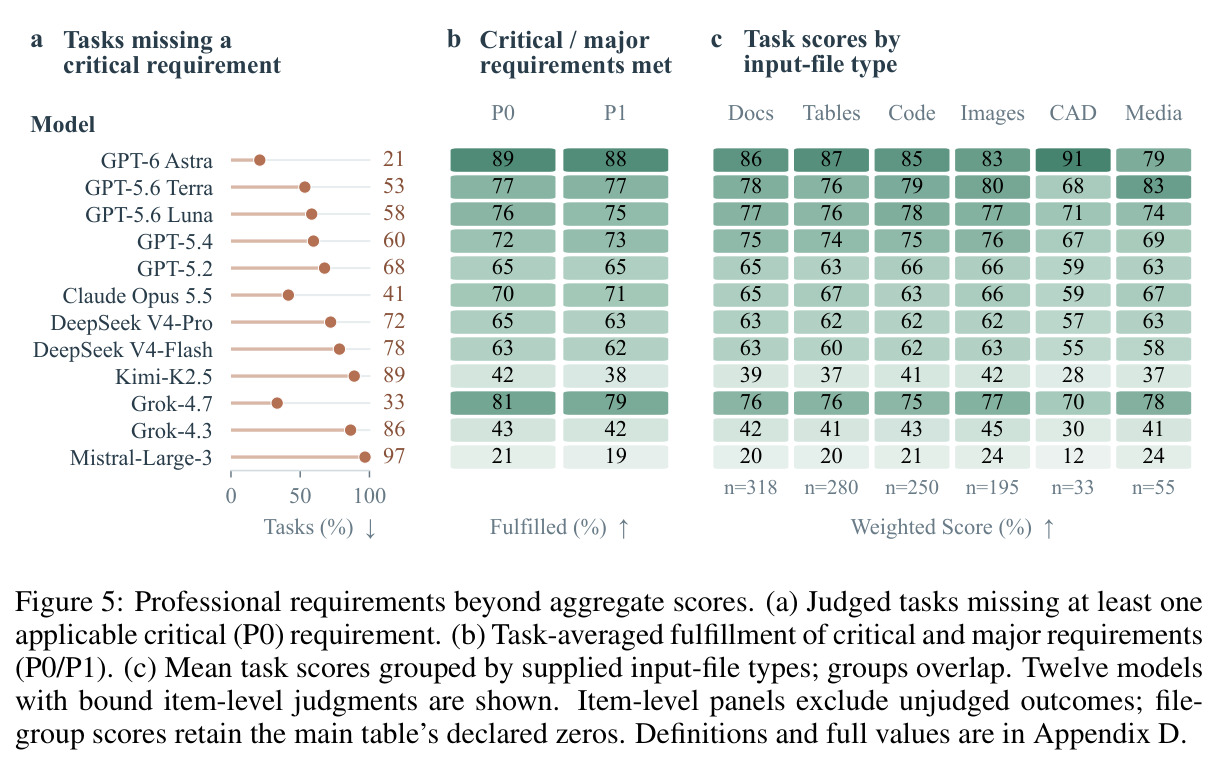
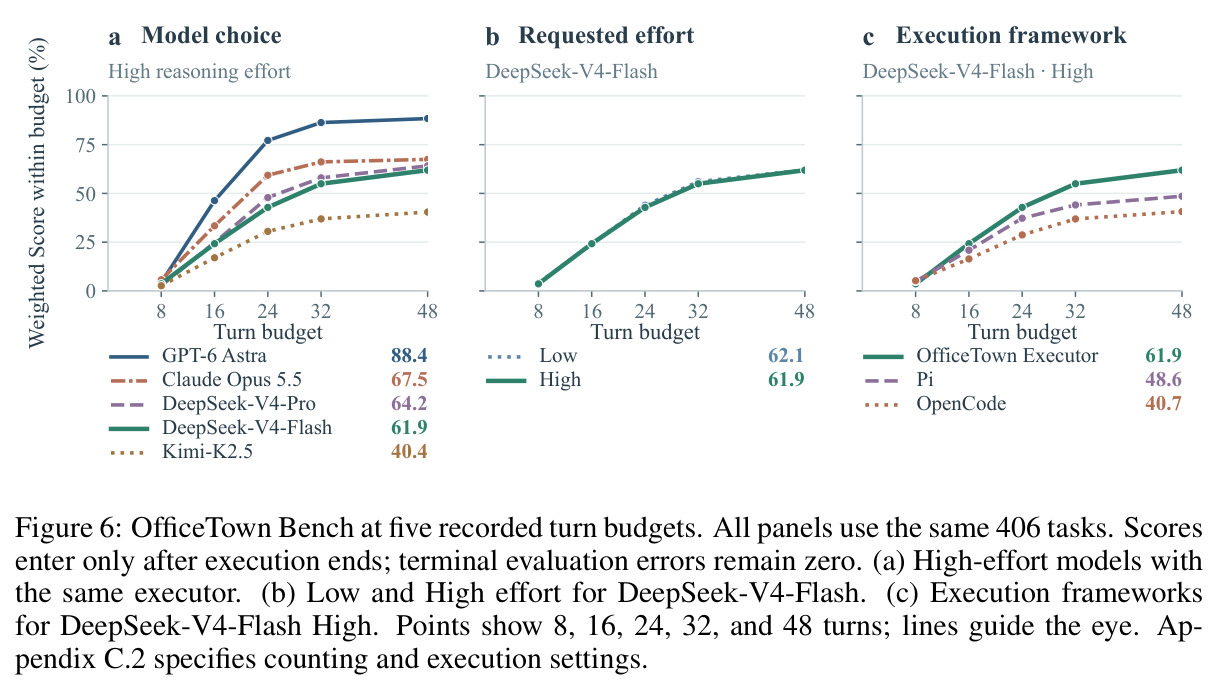
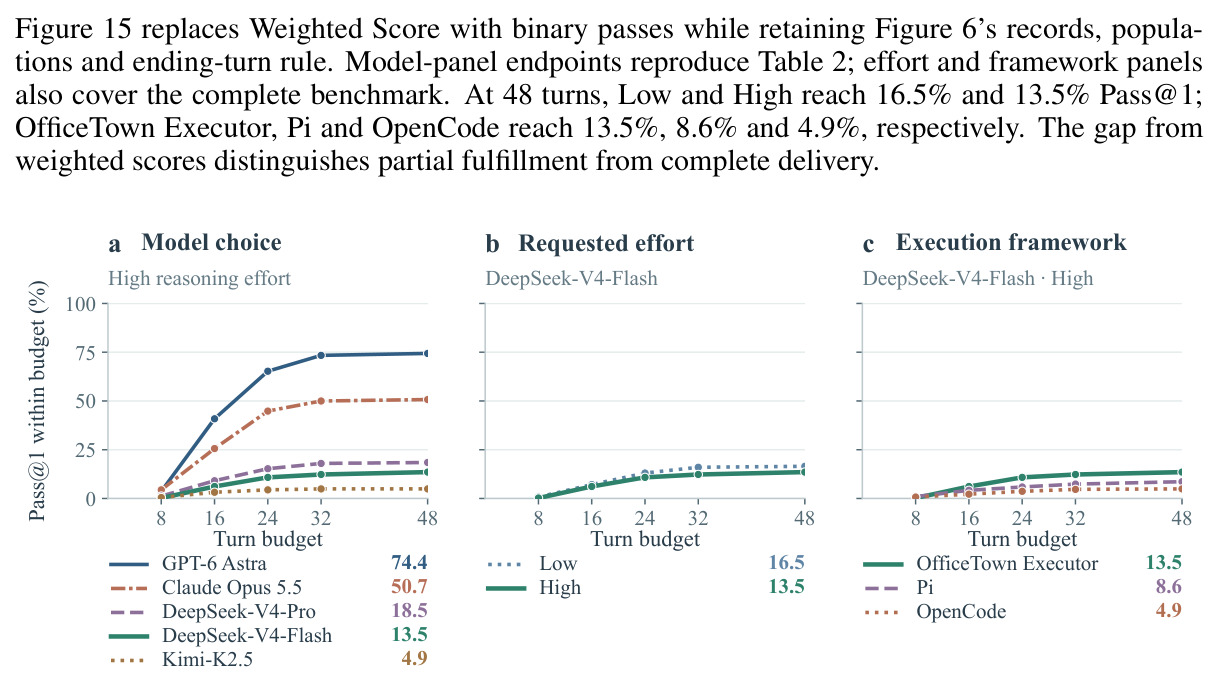
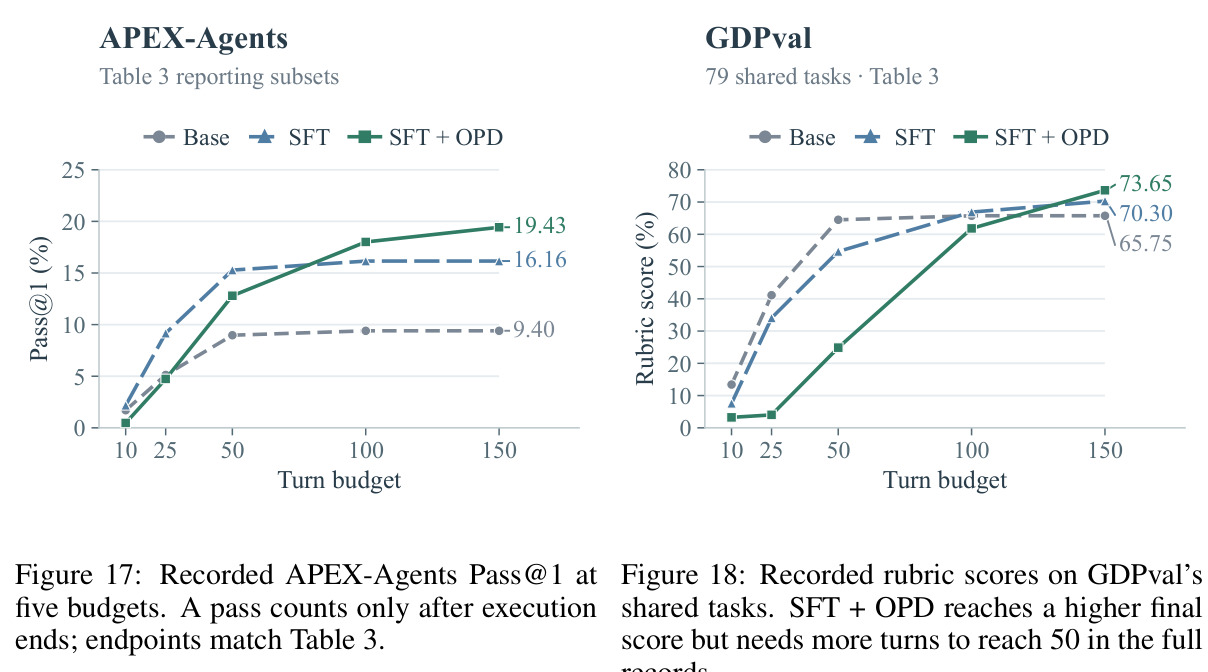
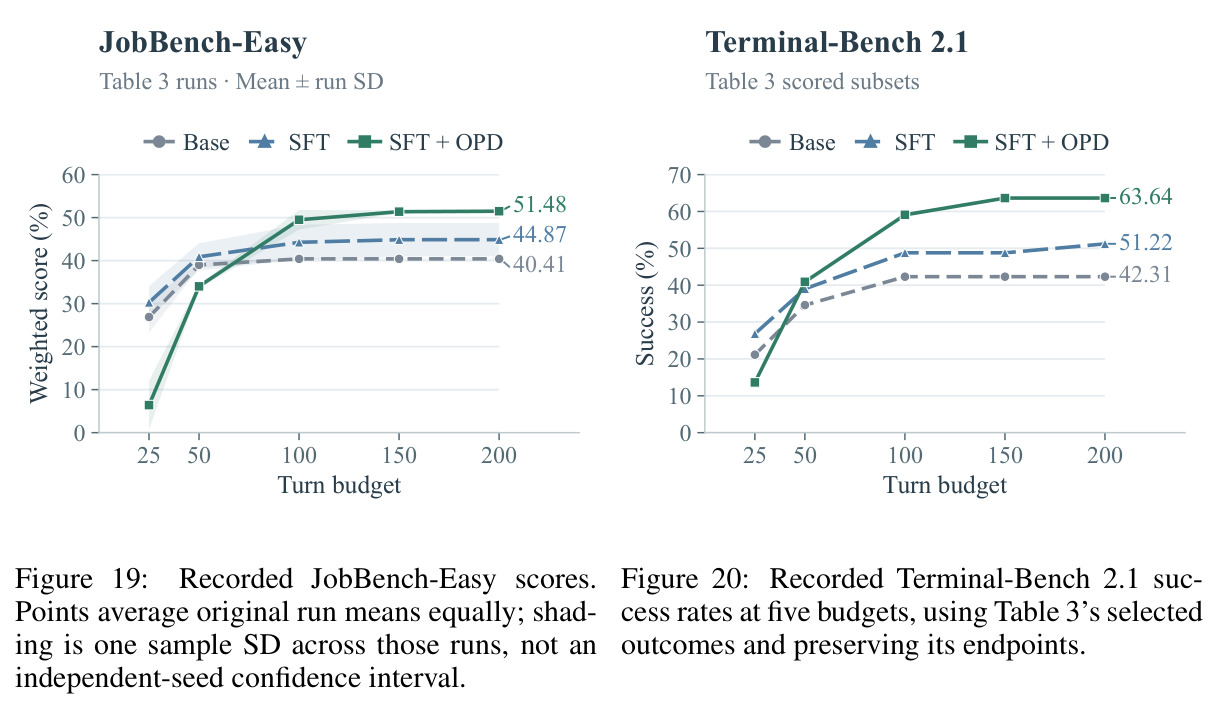
论文围绕五个问题做实验,逐一分析。(1) 基准排行(任务能否难住前沿模型):在 406 个任务、13 个前沿模型、高推理档的 Pass@1 评测中,GPT-6 Astra 以 74.4% 居首,Grok-4.7 58.4%、Claude Opus 5.5 50.7% 随后,GPT-5.6 Terra 仅 39.4%,DeepSeek-V4-Flash 13.5%、Mistral-Large-3 1.2%——即便最强模型也留下约四分之一任务无法完整交付。(2) 两种指标的分歧(部分完成是否等于专业交付):Claude 通过率高于 Terra(50.7% 对 39.4%)但加权分反而更低(67.5 对 76.1);Astra 平均达成 88.8% 的 P0 关键权重,仍有 20.8%(84/404 个适用任务)漏掉至少一条 P0,Terra 达 53.3%、Flash 78.3%,说明失败不限于可选细节。(3) 交互预算曲线(效率由什么决定):Astra 16 轮即达加权分 40(Claude 18 轮、Flash 24 轮);推理档位几乎不影响结果(Flash Low/High 为 62.1/61.9),执行框架差异才是主导:Executor 61.9、Pi 48.6、OpenCode 40.7;48 轮内 Pass@1 为 Low 16.5%、High 13.5%。(4) 训练迁移(生成数据有无学习价值):Qwen3.5-9B 经 SFT 再 OPD,GDPval 79 个共享任务从 65.75 升至 73.65(+7.90),JobBench-Easy 40.41→51.48(+11.07),APEX-Agents 9.40→19.43,Terminal-Bench 2.1 42.31→63.64,而 OfficeTown 自身仅从 1.48 升至 4.68——外部收益显著、域内仍极难。(5) Harness 对比(主—助设计是否普适):统一 GPT-5.5 xhigh 下 OfficeTown Harness 在五个外部基准全部领先,研究代码 46.40 对 MetaGPT 41.15 且少用 21.8% token。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OfficeTown Bench(406 任务,完整交付率) | Pass@1(%,高推理档) | GPT-6 Astra 74.4 | 次优 Grok-4.7 58.4;Claude Opus 5.5 50.7 | 领先次优 16.0 个百分点,但仍有约 25% 任务无法完整交付 |
| GDPval(79 个共享任务,排除搜索类) | Rubric 平均分 | 73.65(Qwen3.5-9B SFT+OPD) | Qwen3.5-9B Base 65.75 | +7.90 个百分点(SFT 单独贡献 +4.55) |
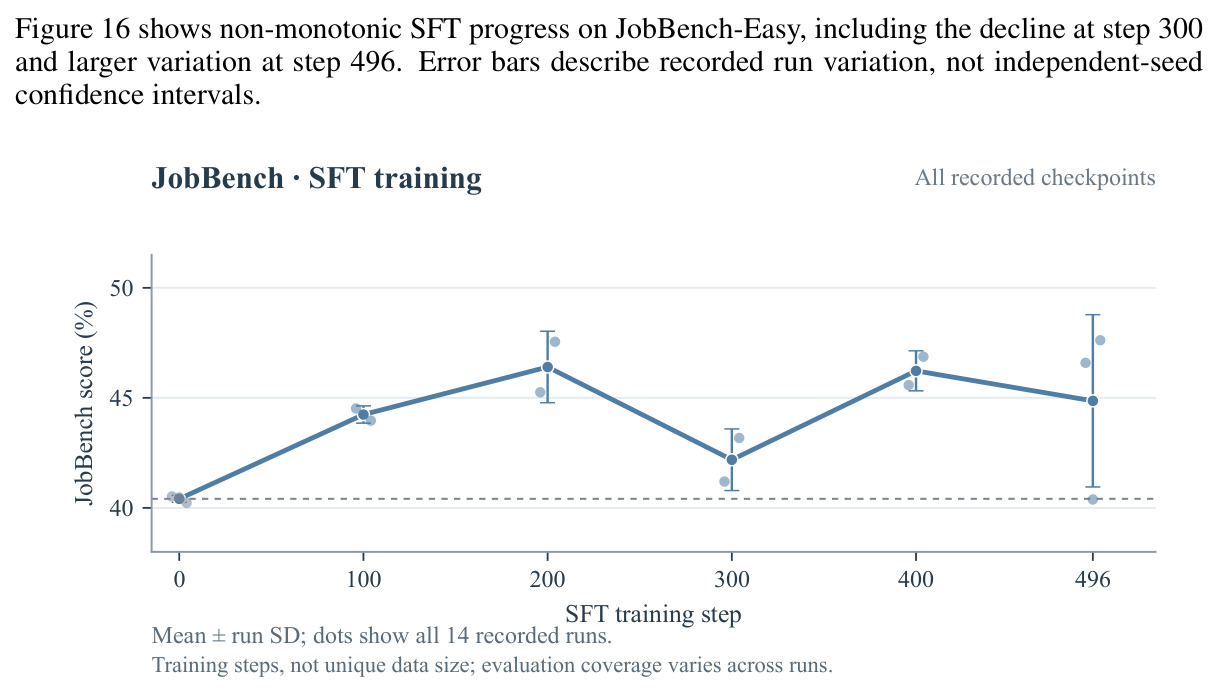
| JobBench-Easy(63 个环境) | 加权分(0–100) | 51.48(SFT+OPD) | Base 40.41 | +11.07 个百分点 |
| APEX-Agents | Pass@1(%) | 19.43(SFT+OPD) | Base 9.40 | +10.03 个百分点(翻倍) |
| Terminal-Bench 2.1(排除搜索类) | 原生二值成功率(%) | 63.64(SFT+OPD) | Base 42.31 | +21.33 个百分点(五项中提升最大) |
| ResearchCodeBench(研究代码,harness 对比) | 分数(0–100) | OfficeTown Harness 46.40 | MetaGPT 41.15 / Codex 40.88(同为 GPT-5.5 xhigh) | +5.25 分,token 比 MetaGPT 少 21.8%(为 Codex 的 3.49 倍) |
| GDPevo(业务规则,harness 对比) | 分数(0–100) | 74.70 | Codex 64.51 | +10.19 分(五列中领先幅度最大) |
| PRDBench DEV/DEBUG(harness 对比) | 分数(0–100) | 89.67 / 92.62 | Codex 85.87 / 89.04 | +3.80 / +3.58 分 |
| Terminal-Bench 2.1(harness 对比) | 分数(0–100) | 87.4 | CAMEL 85.1(同预算口径下最高基线) | +2.3 分(注意各 harness 预算口径不同) |
局限与改进
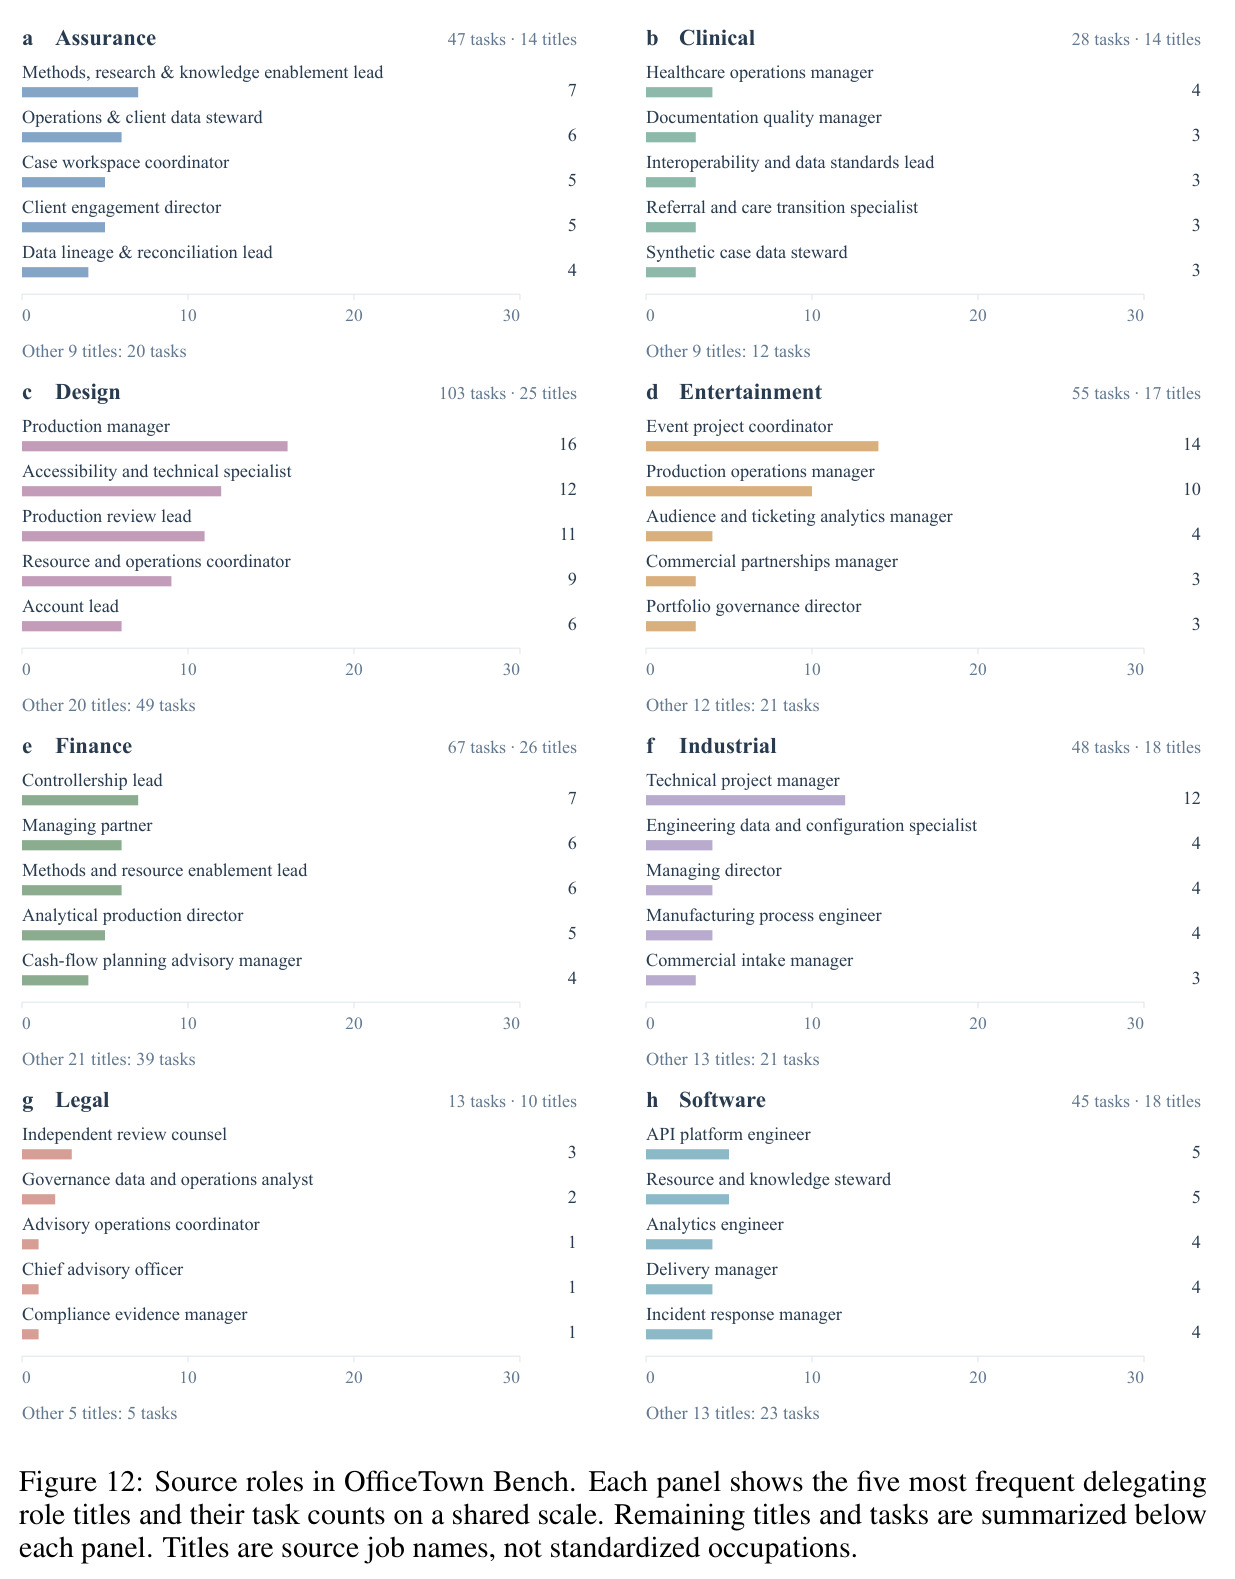
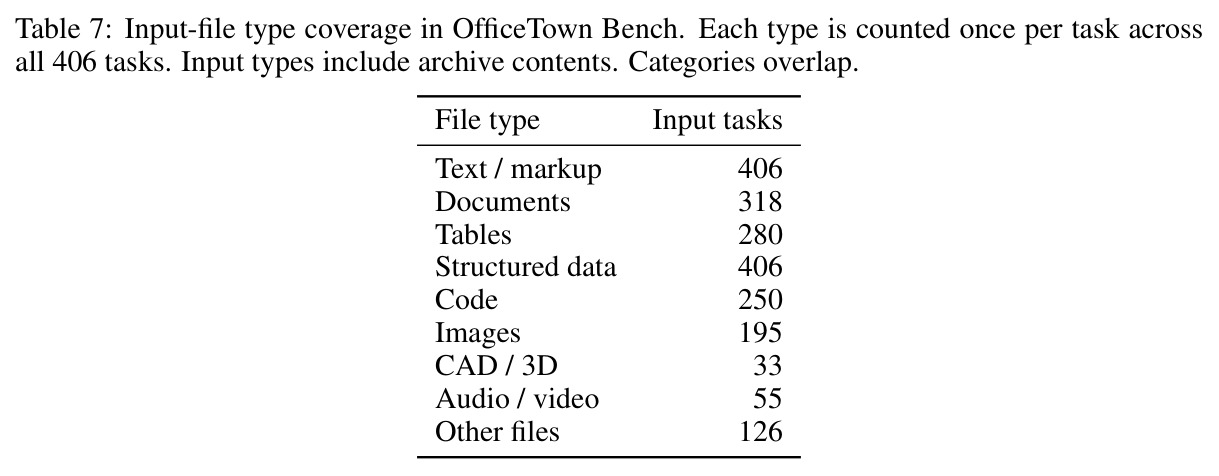
作者明确承认:模拟组织只是职业示例而非权威表征,O*NET/ESCO 与生成模型可能编码偏见;评测依赖 GPT-5.5 作模型裁判,且未验证自动裁判与人类评分的一致性;按输入文件类型分组只反映任务群体差异,不能隔离格式效应;材料积累统计只追踪数量不反映质量;406 个任务中 12 个未绑定人工反馈;专家评审针对任务与 rubric 而非智能体答案。我的观察补充:其一,数据链路全程依赖前沿模型——组织由 GPT-5.5 生成驱动、SFT 教师是 DeepSeek-V4-Flash、OPD 教师是 Qwen3.8-Flash-Next、裁判也是 GPT-5.5——教师上限与偏见会系统性传导到数据与学生模型;其二,OPD 关闭验证集,SFT 在 JobBench 上非单调(step 300 回落),稳定性依赖 checkpoint 挑选;其三,领域不均(Design 103 对 Legal 13),低资源领域结论需谨慎;其四,小模型 Pass@1 仅个位数(Base 1.48%),基准对中等模型可能过难;其五,组织模拟的生成成本可观且论文未报告账目。
独立分析的弱点
独立分析四个最值得改进的弱点。(1) 裁判单点依赖:所有任务级与条目级判断都出自 GPT-5.5,可能对同家族模型存在风格或格式偏好,且未报告与人类评分的一致率;改进方向是抽样 10–20% 任务做双人独立盲评并报告一致性系数,或引入异家族多裁判交叉验证。(2) 关键设计缺少消融:持久化状态、权限过滤、评审回路是三大卖点,但没有「无权限/无持久化/无评审」的对照版本来量化各机制对任务难度与训练收益的贡献;改进方向是发布消融配置,在同等任务量下比较训练收益与失败模式。(3) 蒸馏天花板:SFT 数据不按任务成败过滤、不做质量筛选,弱教师轨迹的冗长与错误会被原样继承;OPD 只跑 1 epoch、共 8 次更新且无验证集;改进方向是用 rubric 中的可执行检查预筛轨迹,并引入基于结果的强化学习突破教师上限。(4) 模拟成本与保真度未量化:会议、评审全由模型即兴生成,缺少与真实职场行为(评审往返次数、委派粒度、返工率)的统计对照;改进方向是用公开职业工作记录校准模拟节奏与失败分布。此外领域覆盖不均(Legal 仅 13 题、含 CAD 输入的任务仅 33 个)也限制对低资源职业与多模态任务的结论强度。
未来方向
作者在结论中提出的方向包括:扩展到更多职业领域与制度情境;引入更丰富的交互、更长时程的工作流与跨组织协作;系统研究持久历史、范围化访问与评审机制如何塑造任务生成与学习效果;提升模拟保真度与运行效率,并把模拟工作与真实职业实践对照验证。基于论文成果还可自然延伸出几条线:其一,把 OfficeTown 环境从蒸馏升级为强化学习——rubric 中的可执行检查天然可作为奖励信号,4,836 条标准提供了密集的结果监督,而当前实验只用到 SFT 与 OPD;其二,把权限感知的记忆与检索抽象成通用智能体组件,迁移到真实企业知识库场景,这与 CRMArena-Pro、EnterpriseBench 等企业评测反映的实际需求直接对接;其三,让多个组织互为客户/供应商,形成带外部服务状态的跨组织经济,检验智能体在组织边界上的谈判、合规与保密行为;其四,利用「任务时刻快照」机制构造课程式学习——按组织演化时间轴安排训练任务,从依赖浅的早期任务过渡到依赖深厚的后期任务;其五,把组织内评审(论文强调它是组织决策而非基准判断)与外部评测裁判解耦,研究评审驱动的自我修订能否成为一种测试时扩展手段。
复现评估
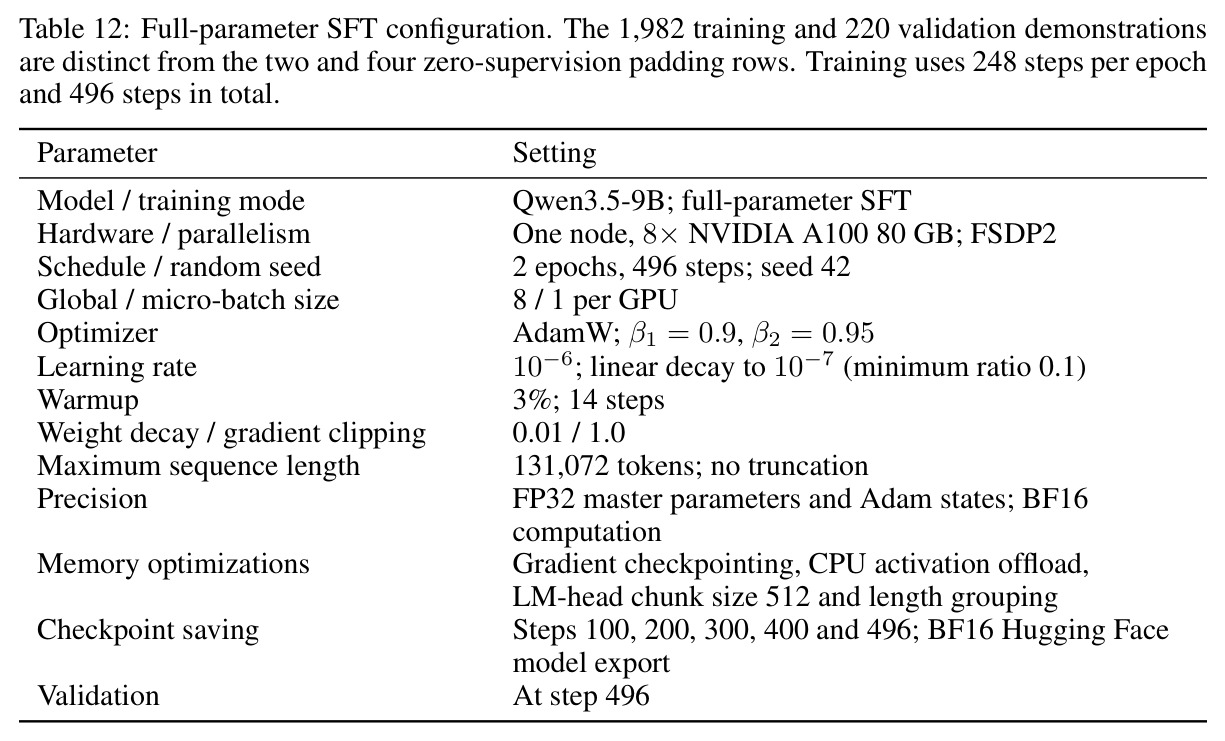
可复现性工程扎实:附录完整公开 Juniper 配置(Table 5:GPT-5.5 生成驱动、Codex harness 执行助手、181 天模拟期、6 并发专业者与 4 助手工人)、SFT 超参(Table 12:8×A100 80GB、FSDP2、2 epochs 共 496 步、学习率 $10^{-6}$ 线性衰减、序列上限 131,072 token、轨迹不截断)与 OPD 超参(Table 13:8×B200、共 8 次更新、学习率 $2\times10^{-6}$、蒸馏系数 1.0、任务奖励与 KL 关闭),承诺 release 与评分绑定随表格发布,主页 officeintelligence.github.io。训练仅需单机 8 卡,算力门槛不高。壁垒有三:组织生成与模拟依赖 GPT-5.5、DeepSeek-V4-Flash、Qwen3.8-Flash-Next 等闭源模型,从零重建需大量 API 调用;71 位专家评审(3,842 条修订建议)无法复制,绕开则质量打折;复现排行榜需对 13 个多为闭源的模型执行 406 任务并调用 GPT-5.5 裁判,成本可观。综合判断:若数据如期开源,复现训练部分属中等难度;完整重建数据管道属高难度。
论文图表
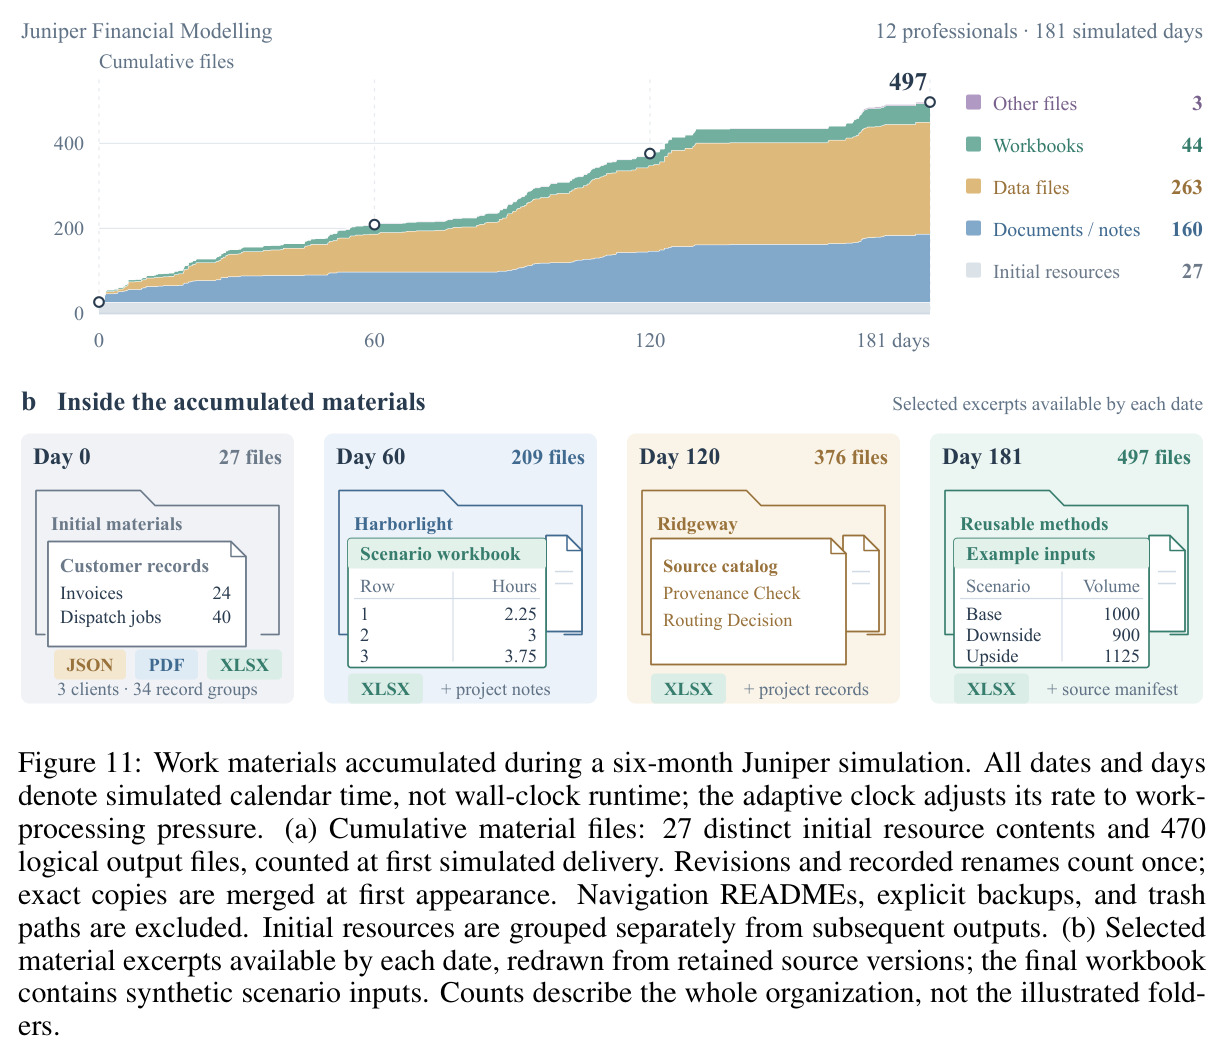
Juniper 组织 181 个模拟日的材料积累:(a) 累计文件从 27 个初始资源增至 209(60 天)、376(120 天)、497(181 天),其中数据文件 263、文档/笔记 160、工作簿 44、其他 3;(b) 各时间点可用材料示例:Harborlight 客户记录(24 张发票、40 个派工单、3 客户 34 组记录)、情景工作簿、Ridgeway 来源目录、带 base/downside/upside 情景输入的可复用方法组件。
用量化证据支撑全文核心前提——工作材料随时间积累、后续任务以前序产物为输入;修订与完全复制已去重,计数反映真实逻辑产出。
GDPval 79 个共享任务上三阶段的 rubric 分曲线,终点 65.75/70.30/73.65;正文特别指出 SFT+OPD 虽然最终分更高,但需要更多轮次才能达到 50 分,说明训练后模型倾向用更多交互换取更高完成度。
提示训练收益伴随轮次(成本)变化,是解读 Table 3 时容易被忽略的细节。
Terminal-Bench 2.1 上三阶段的成功率曲线,使用 Table 3 的选定结局并保持其终点(42.31/51.22/63.64),OPD 阶段提升最陡。
展示最大单项提升(+21.33)的预算维度细节,支持「OfficeTown 数据改善终端类任务」的结论。