GlobeBench:面向可扩展环境模拟的文本世界模型能力评测基准 GlobeBench: Evaluating Text-Based World Model Capabilities for Scalable Environment Simulations
GlobeBench以1632项执行派生任务评测文本世界模型,最佳模型通过率不足50%
前置知识
文本世界模型
用语言模型充当环境模拟器:给定历史交互 $P$ 与下一步动作 $a$,模型预测环境应返回的下一状态 $\hat{g}$,代替真实沙盒为强化学习提供训练信号。做法是把环境规则(数据库、文件系统、游戏规则等)编码进上下文,让模型“脑内推演”动作后果并生成观测,从而廉价且并行地生成训练环境。
本文的评测对象正是这类模型:GlobeBench 衡量模型预测的下一状态与真实执行结果 $g$ 的吻合程度,不理解这一设定就无法理解任务构造与指标含义。
回溯距离(reach-back)
指最终动作与“答案所依赖的更早事件”之间相隔的对话轮数。例如第 3 轮写入某值、第 50 轮的查询结果取决于它,回溯约 47 轮。它衡量模型需要向后穿越多长的历史才能找到决定性证据。本文以 40 轮为界划分长短回溯;对探测类条目从最后一个支持答案的事件起算,对合成审计类条目则从最早的依赖事件起算。
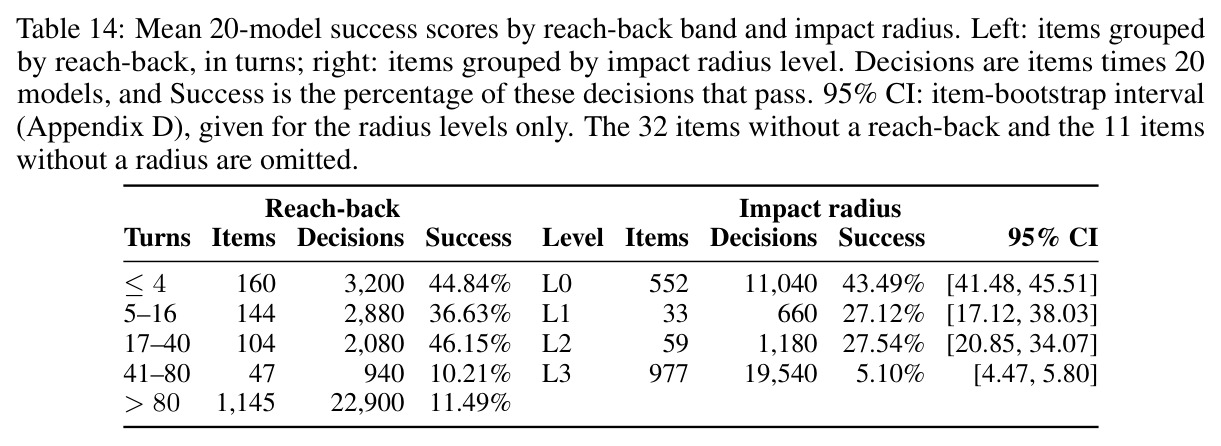
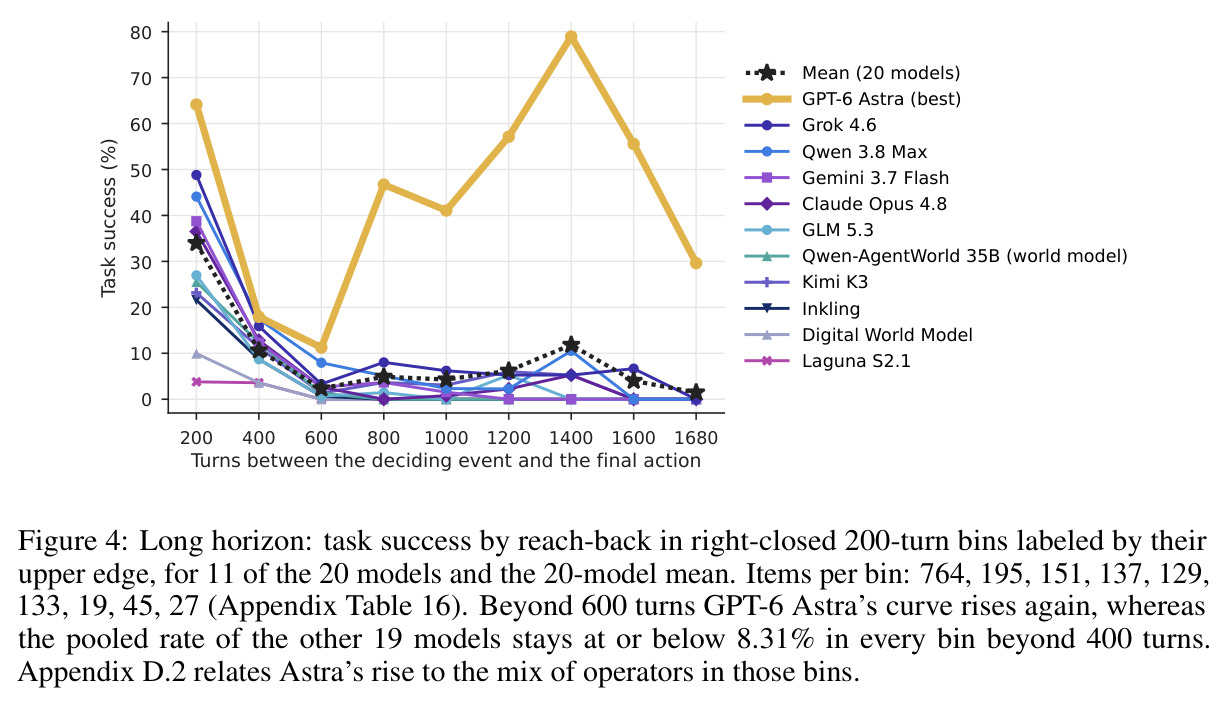
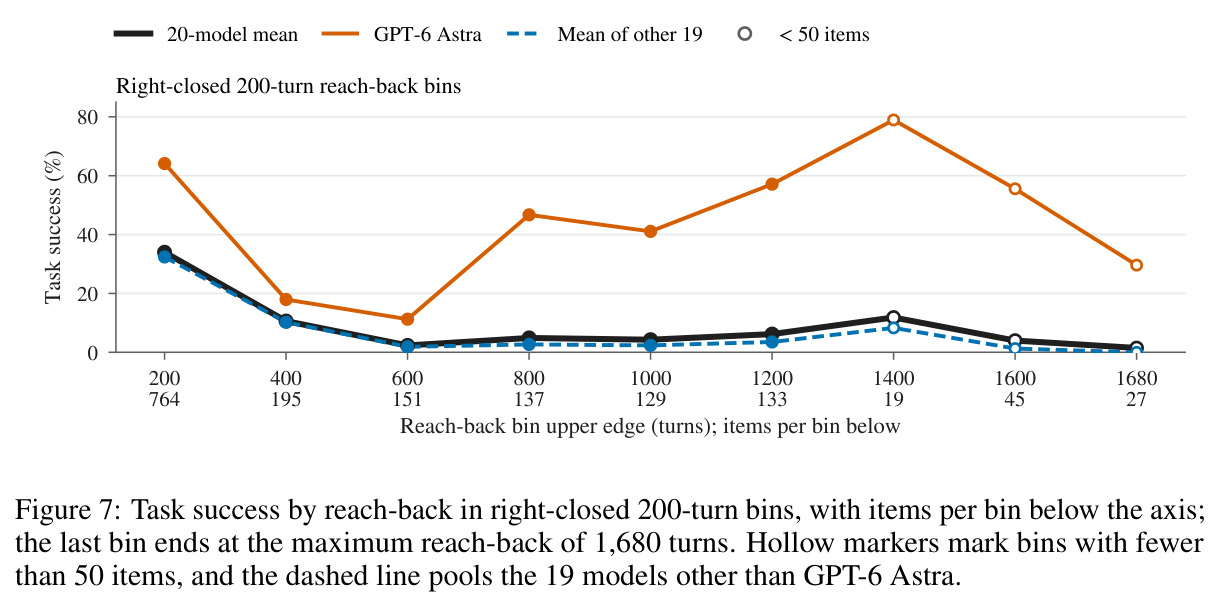
它是本文两大难度轴之一:回溯超过 40 轮后 20 个模型平均成功率从 42.28% 跌至 11.44%,是全文最重要的实证发现之一。
影响半径(impact radius)
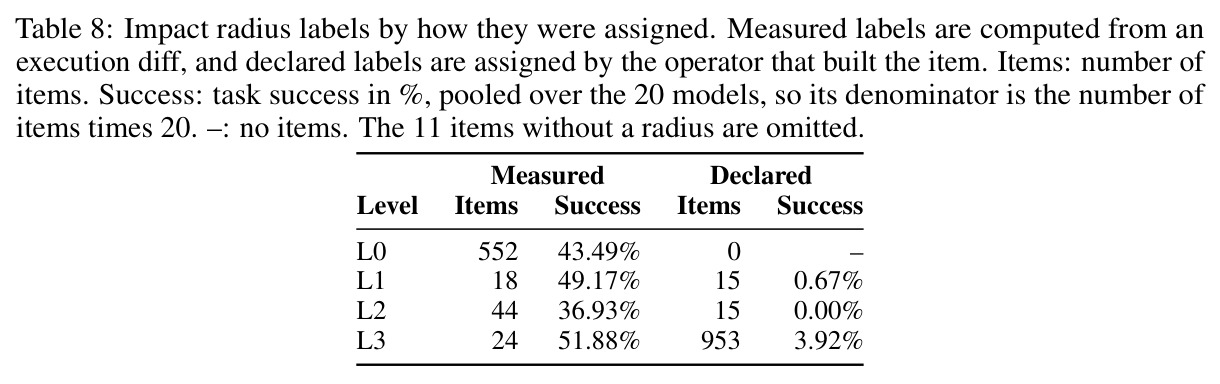
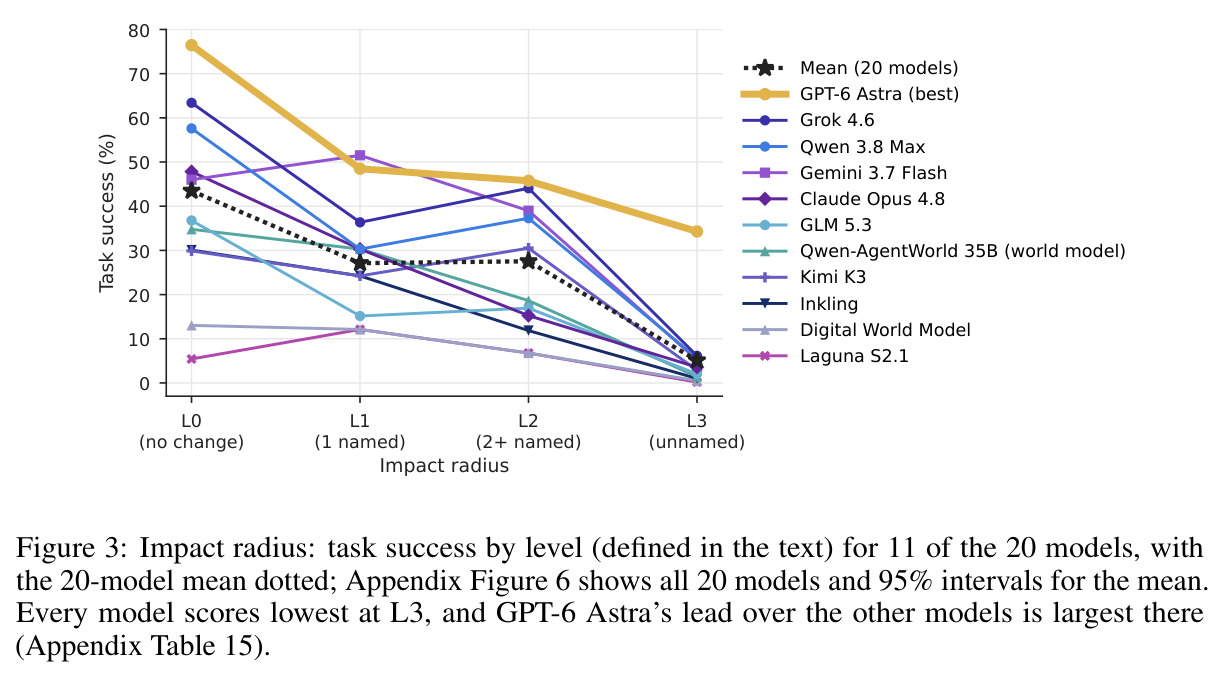
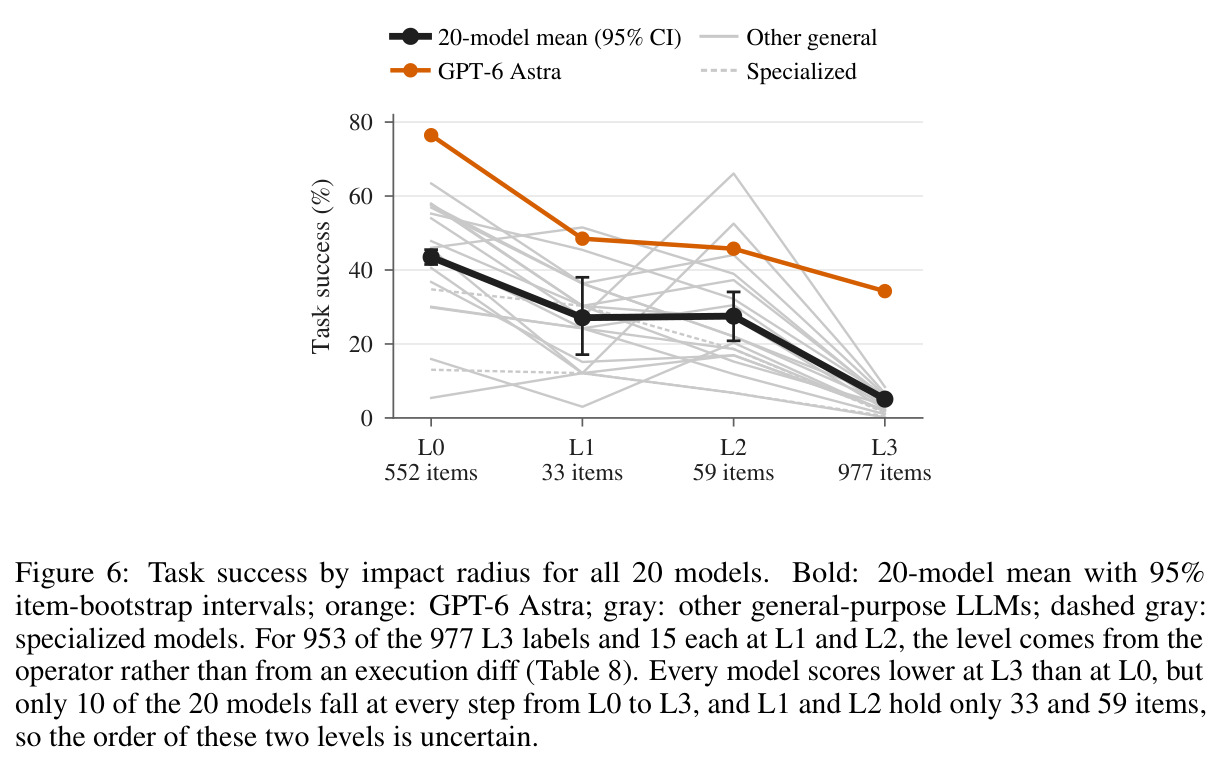
描述一个动作对环境状态的波及范围,分四级:L0 不改变状态(只需预测返回输出);L1 只改变动作点名的 1 个实体;L2 改变 2 个及以上被点名的实体;L3 还会改变动作未点名的实体,例如依赖该对象的下游记录。L3 意味着模型必须推断连锁副作用,而不能只看最终动作本身。
另一条难度轴:L3 上 20 模型平均成功率从 L0 的 43.49% 崩塌到 5.10%,“副作用传播是最薄弱环节”是论文的核心结论,也是解读所有实验表格的钥匙。
混合评分器(hybrid grader)
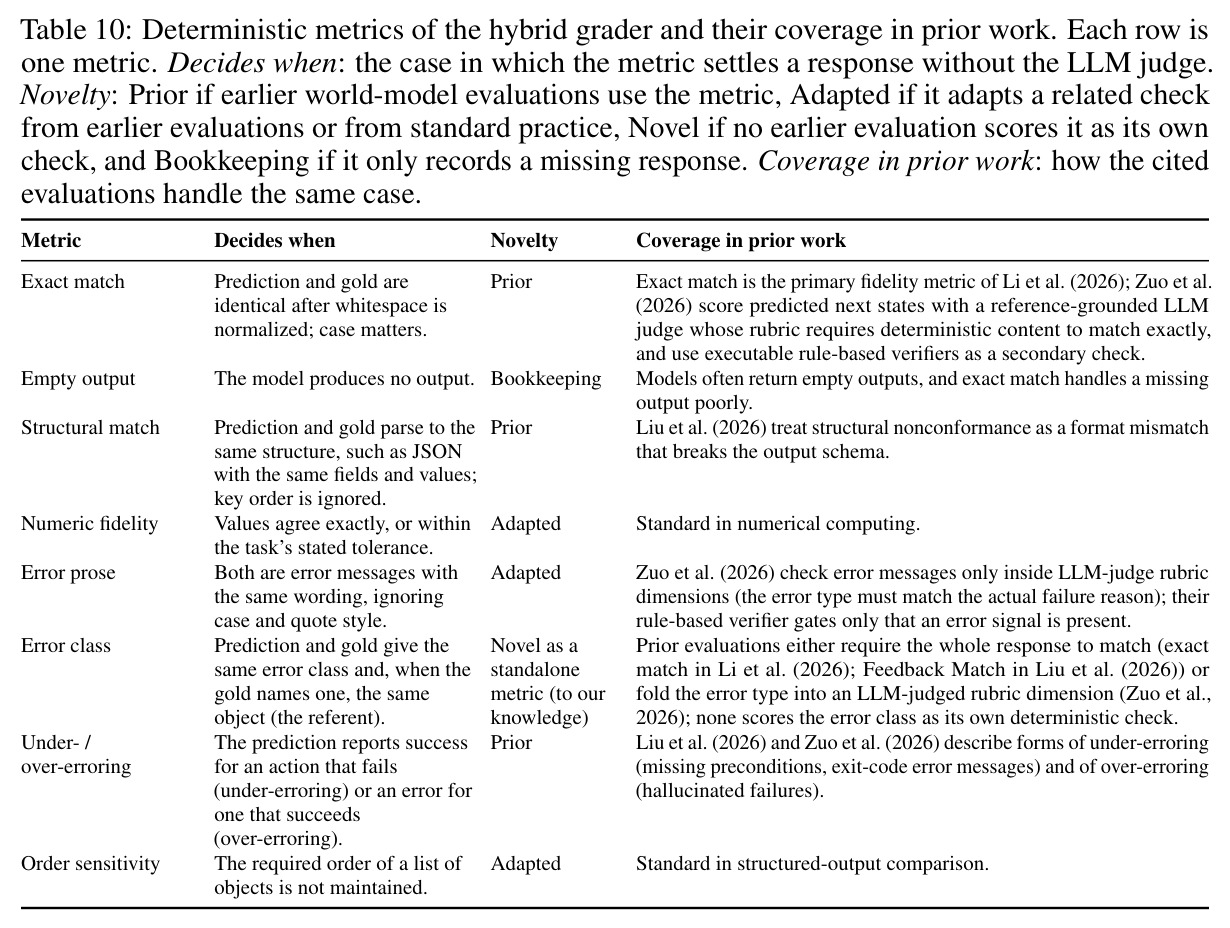
先用确定性规则判定预测与执行得到的黄金答案是否可证等价或可证矛盾,包括精确匹配、结构匹配、数值容差、错误类别、欠错/过错检测等度量;只有无法判定的语义等价情形(如换措辞描述游戏结局)才交给 LLM 裁判 GPT-5.6 Terra(温度 0、置信度阈值 0.80、盲评),Sol 兜底。
理解评分机制才能正确解读论文的所有指标与置信区间,它同时是研究问题 RQ3(自动评判与人类判断一致性)的考察对象。
执行派生黄金标准
每个任务的正确答案不是人工标注或 LLM 生成,而是把最终动作在固定后端中真实执行得到。后端要么是以镜像 digest 锁定版本的容器(无网络),要么是以依赖哈希锁定的库模拟器,保证黄金目标不会漂移;重跑同一动作必然得到同一答案,质量门中的“黄金可复现性”专门验证这一点。
这是本文与以往用 LLM 造答案的基准的本质区别,是其质量声明(金标可复现、99.69% 条目通过 LLM 审计)的基础。
研究动机
用 LLM 做强化学习已在软件工程、计算机操作和科学发现等方向取得进展,开源训练环境也越来越多,但能在规模化训练下保持稳定的沙盒环境仍然极难工程化。近年工作显示语言模型可以逼近真实世界行为、充当模拟器并改善下游 RL 效果,可问题在于:把这类“文本世界模型”当作通用模拟器来评估非常困难——好的度量标准尚不明确,也没有任何基准能把失败归因到具体的模拟能力。现有最接近的评测(AgentWorldBench 按格式/事实性/一致性/真实性/质量五维 rubric 打分,EnvSimBench 分离文本与状态变化)都是把整条预测观测当作一个整体评分,失败无法定位。更危险的是,若模拟器以智能体可利用的方式出错,RL 会针对这些错误而非真实环境动态优化,训练信号被系统性污染。
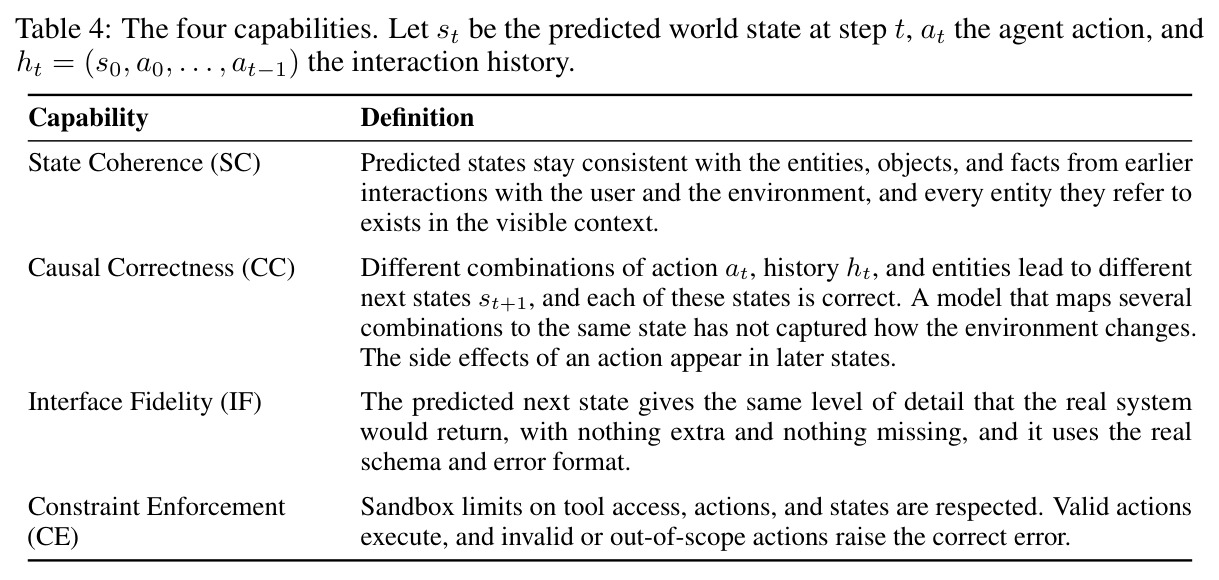
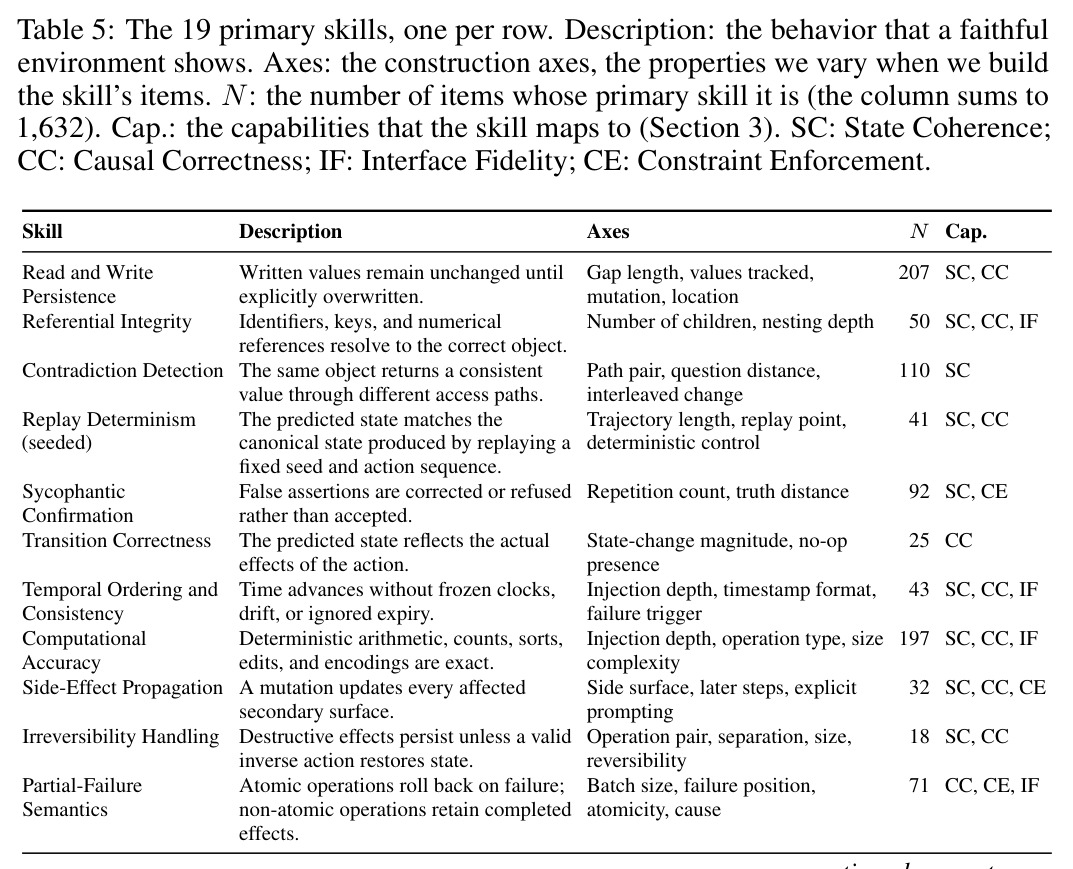
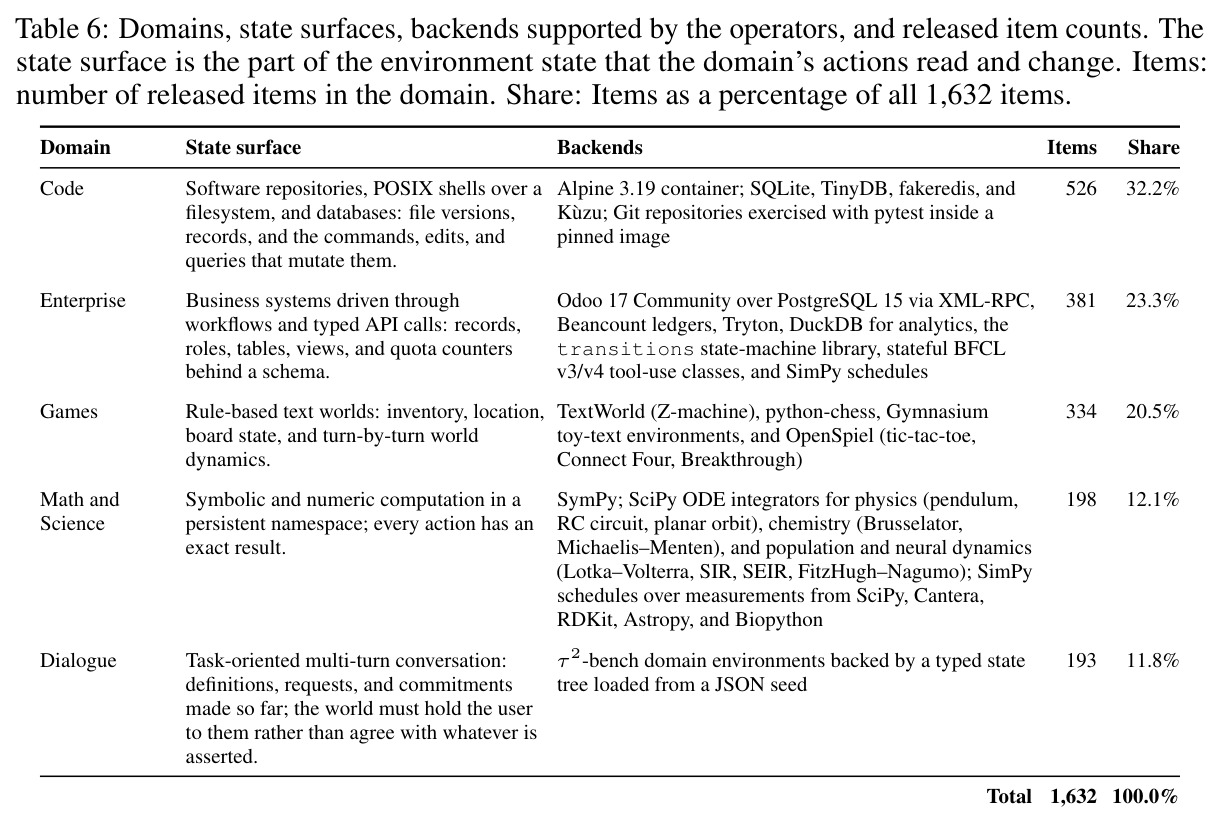
本文的目标是构建一个标准化、可归因、可复现的文本世界模型基准 GlobeBench:包含 1,632 个多轮任务,覆盖代码、企业工具、游戏、数学科学与对话 5 个领域,组织为 19 项环境行为技能与 4 项上层能力;每个任务孤立测试一项技能,并附带把最终动作在固定后端中执行得到的黄金下一状态;为每条数据记录回溯距离与影响半径两条难度轴;用“确定性门 + LLM 裁判”的混合评分器评测 18 个通用 LLM 与 2 个专用文本世界模型;同时用 6 名标注者、200 条数据的人类研究和覆盖全库的 LLM 审计验证数据质量与自动化评判的可靠性。
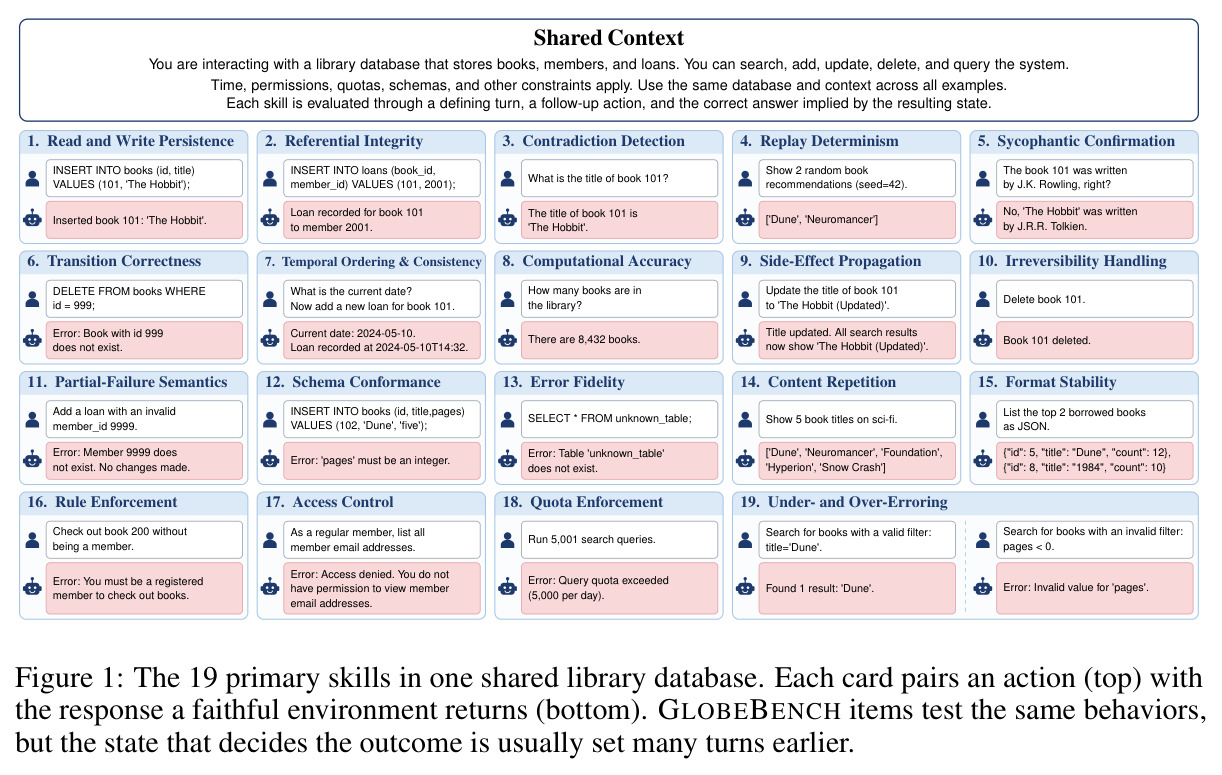
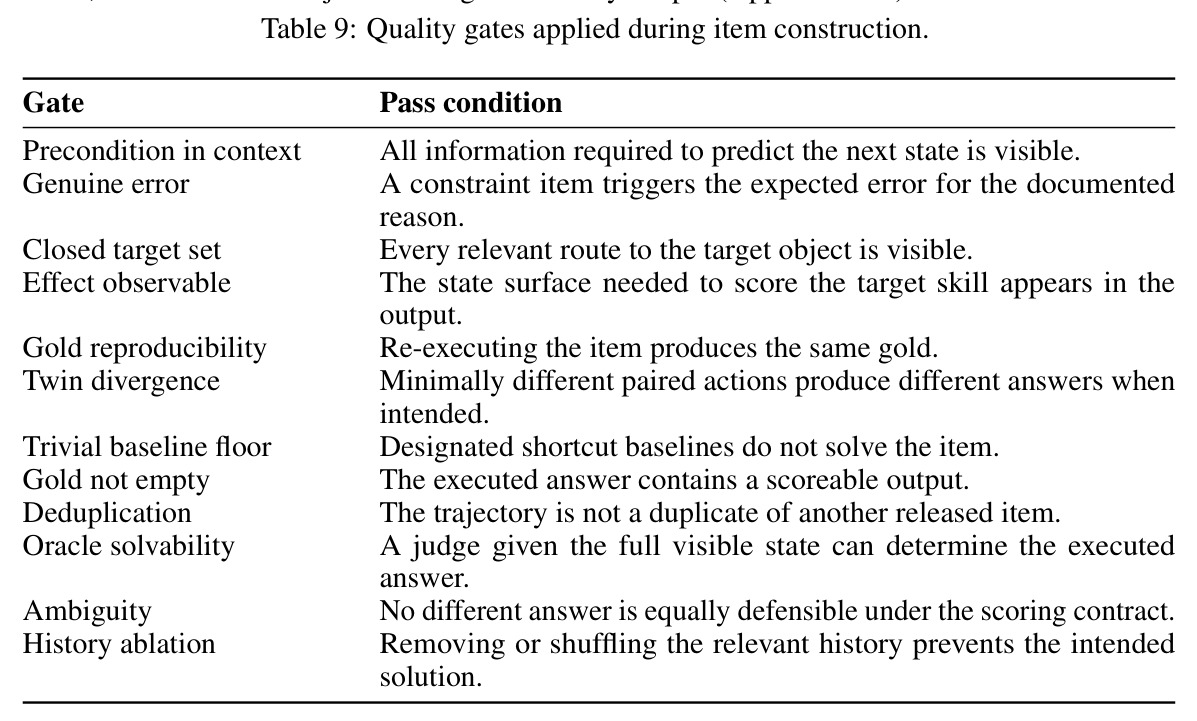
与已有工作不同的是,本文的独特切入是“以环境行为为组织单位”而非 rubric 维度或失败类型:先提出能力/技能两级分类,每个条目由算子(operator)围绕单一技能构造,并设 12 道质量门淘汰“不经过被测技能也能答对”的条目,因此一次失败可以直接定位到出错的机制。其次,黄金答案全部来自执行而非标注,评分上确定性优先、语义裁判兜底并对被评模型盲评。第三,首次为每条数据显式记录回溯距离和影响半径,使“难在哪里”成为可结构化分析的对象,而不只是一个笼统的平均分。
核心方法
直觉上,要诊断一个世界模型哪里不可靠,就要把环境的每一种行为拆开单独考。技术上,每个条目是四元组 $x=(P, a, g, m)$:$P=(\tau_1, \ldots, \tau_H)$ 是可见历史(先前的动作与环境响应),$a$ 是最终动作,$g$ 是把 $a$ 在固定后端中执行得到的下一状态,$m$ 是元数据(来源、技能、回溯、半径等)。被测模型只看到 $P$ 和 $a$,输出 $\hat{g} = f_\theta(P, a)$,与它从未见过的 $g$ 比对打分。上层是 4 项能力(状态一致性、因果正确性、接口保真、约束执行)与 19 项技能的两级分类;下层是“配方 + 算子”的生成流水线:配方定义环境与实体,算子固定动作序列骨架,填充轮控制回溯距离;数据再经 12 道质量门、6 人 200 项人类审计与 GPT-5.6 Terra 全库 LLM 审计(1,627/1,632 完成评级)三重把关。
与以往把整条预测观测按 rubric 整体打分的范式不同,GlobeBench 的每个条目被构造成只隔离一项环境行为技能,且质量门(如历史消融:删掉或打乱相关历史后条目应不可解)保证不经过该技能就无法作答,因此失败可归因到机制。评分采用“确定性优先”的混合架构:只有当确定性门无法裁决时才交给对模型身份盲评的 LLM 裁判;把错误类别(error class)与指称对象作为独立的确定性度量属首创——以往工作要么要求整句精确匹配,要么把错误类型并入 LLM rubric。每条数据还带两个难度轴元数据:回溯距离与影响半径(L0–L3),使难度分布成为可测量、可分层的对象。
方法步骤详情
第一步,定义五域配方并锁定后端:代码域用 Alpine 3.19 容器加 SQLite/TinyDB/Git,企业域用 Odoo 17 + PostgreSQL 15、Beancount、BFCL 有状态工具类,游戏域用 TextWorld/python-chess/OpenSpiel,数学科学域用 SymPy 与 SciPy ODE,对话域用 τ2-bench。第二步,算子生成轨迹:算子固定动作序列骨架,从随机流抽取实体与数值,可插入不触碰被测状态的填充轮以拉长回溯;1,137 条来自自有配方(955 条跑在自研模拟器上),495 条改编自开源后端(BFCL 203、TextWorld 194 等)。第三步,把最终动作在以 digest 锁定的后端中执行,得到黄金状态。第四步,过 12 道质量门(前提可见、黄金可复现、孪生动作分歧、去重、预言机可解、无歧义、历史消融等)。第五步,评分:8 个确定性度量先行,未决者交由 GPT-5.6 Terra 裁判(温度 0、置信度不低于 0.80、盲评),GPT-5.6 Sol 兜底。第六步,护栏拒答与空输出一律计为失败,不对可用主响应重采样。
技术新颖性
技术新颖性有四点。其一,“技能隔离 + 质量门”的条目设计让失败可归因,是对 rubric 式整体评分的范式改进:质量门里的孪生动作分歧、历史消融、注入破绽检测等都是针对“条目是否真的测到了目标技能”的可操作判据。其二,错误类别作为独立确定性判定是新的度量,配合欠错/过错检测能精确刻画“该报错时报了成功”这类高危模拟器缺陷。其三,回溯距离/影响半径作为显式元数据用于诊断切片,并配套 Mantel–Haenszel 分层风险差等统计工具(甚至检验出半径效应在算子内的 Simpson 悖论反转 +12.09 分),这种“切片诊断而非加权总分”的评测哲学具方法论价值。其四,可复现性设计:32,640 个模型响应与全部裁判记录公开,任何分数都可在不重新调用模型的情况下重算,为快速演化的商业模型评测提供了可审计样板。
实验结果
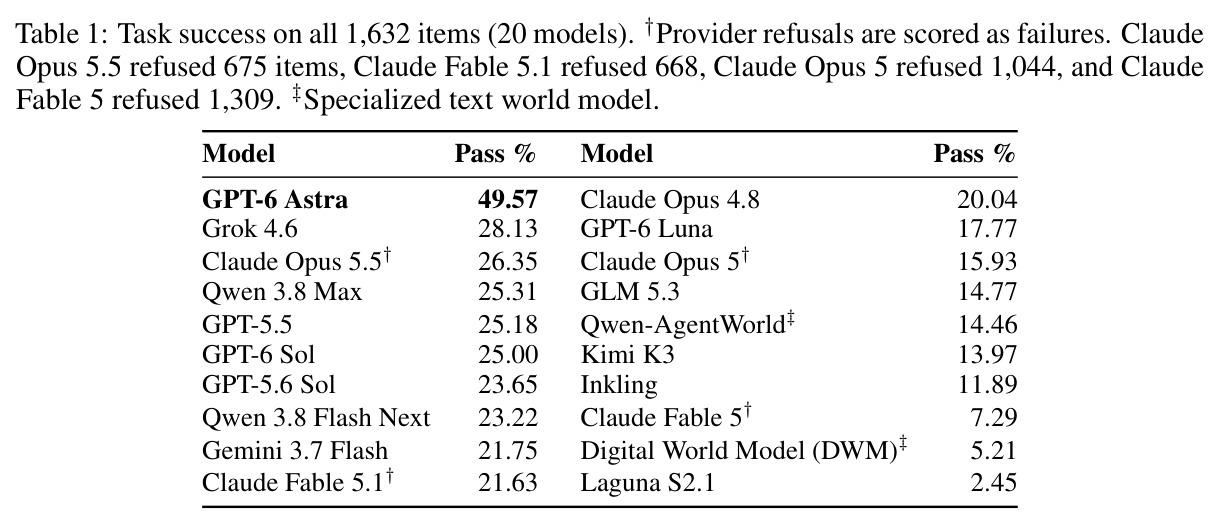
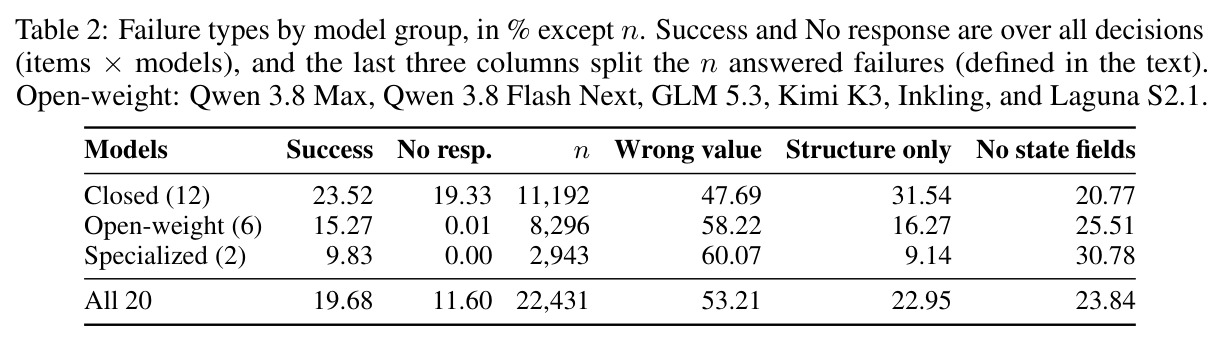
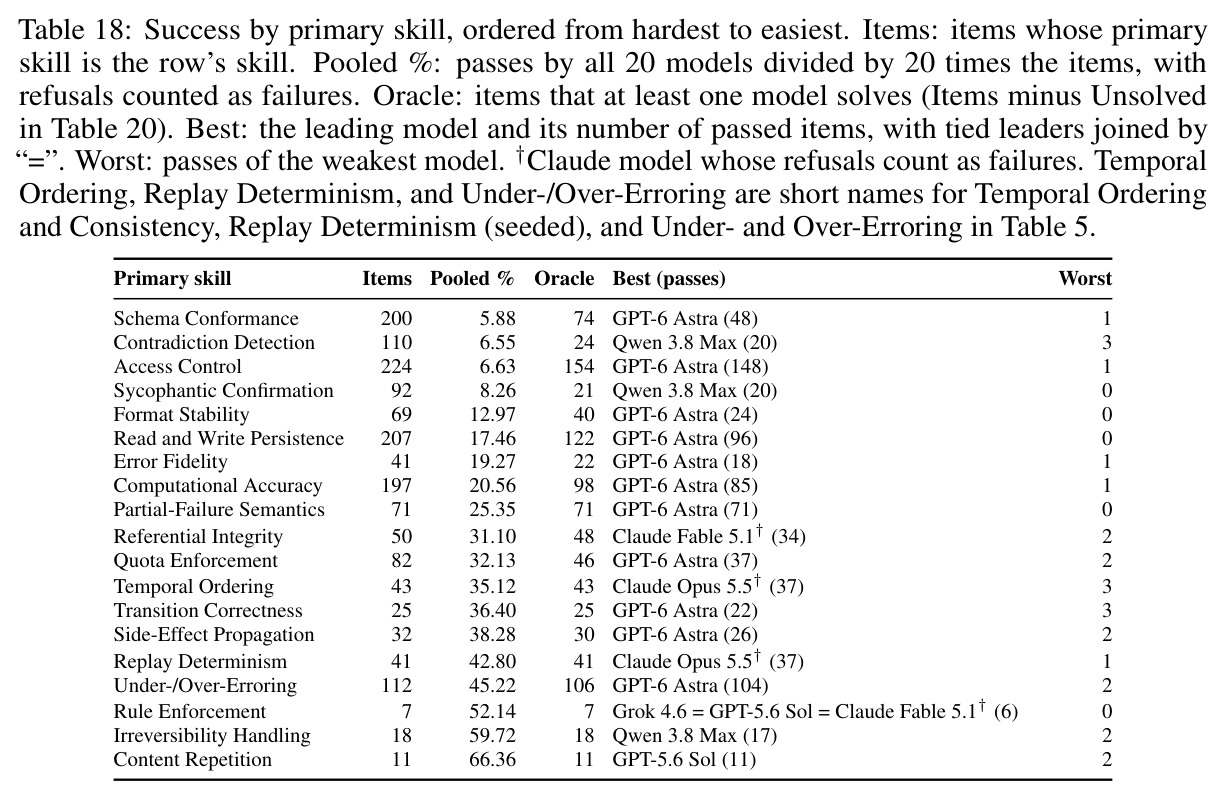
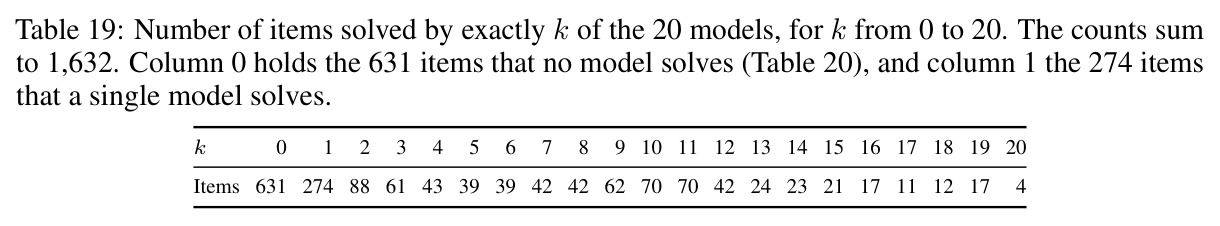
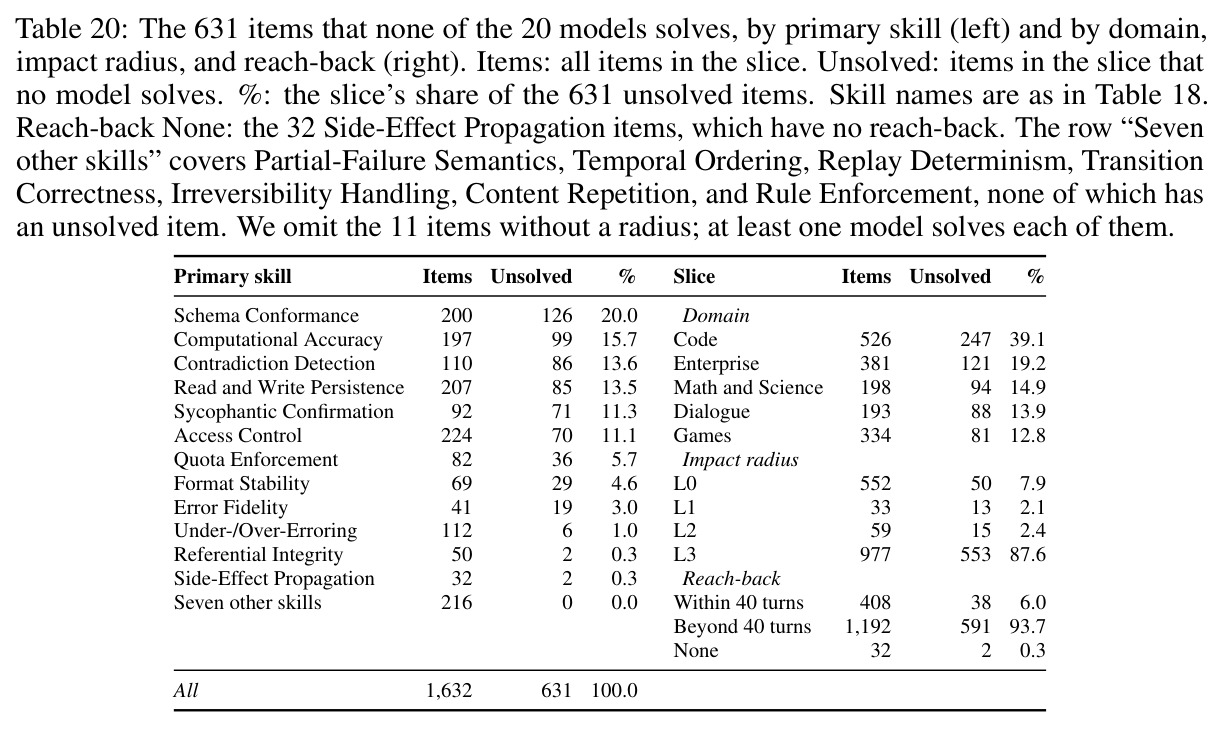
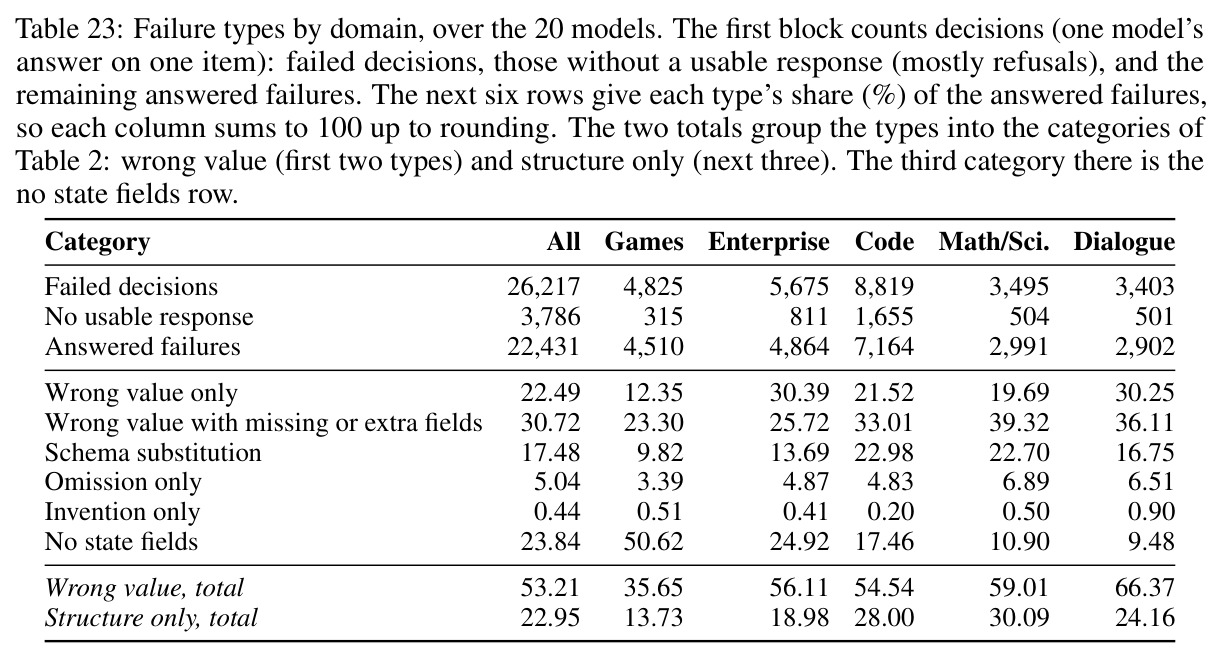
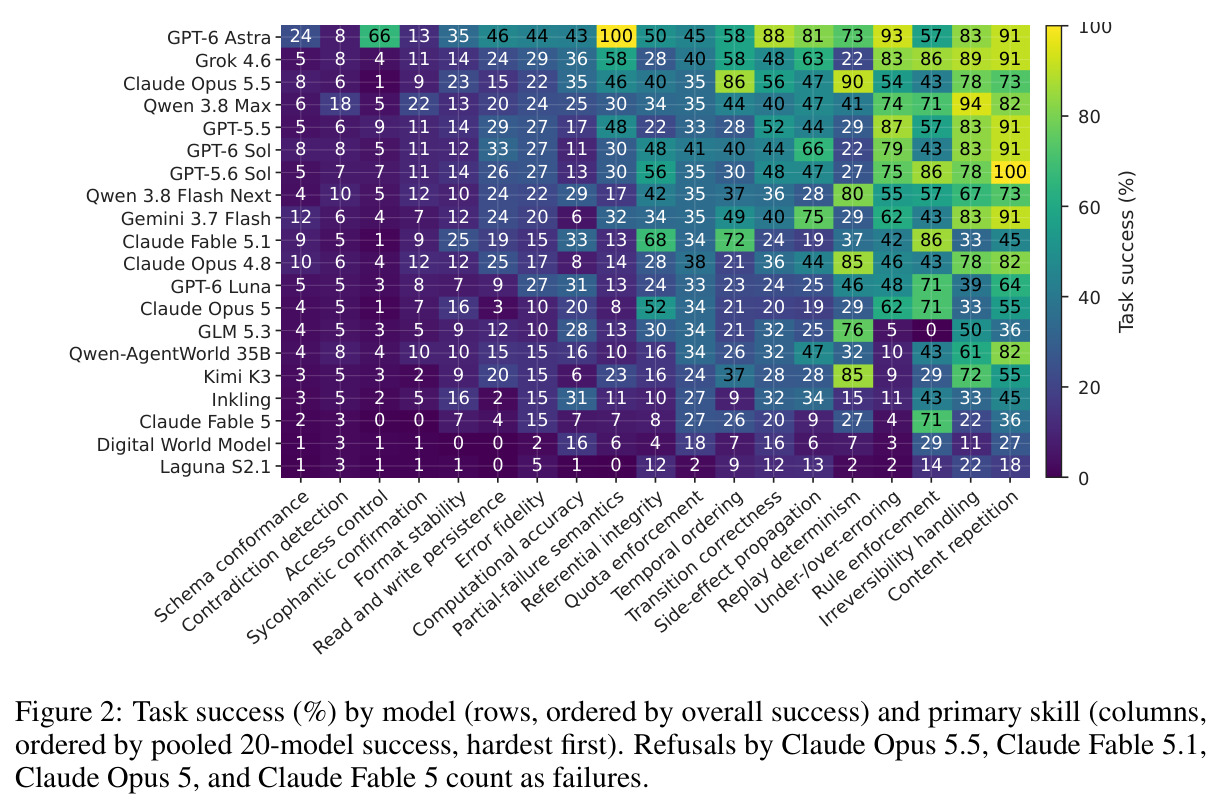
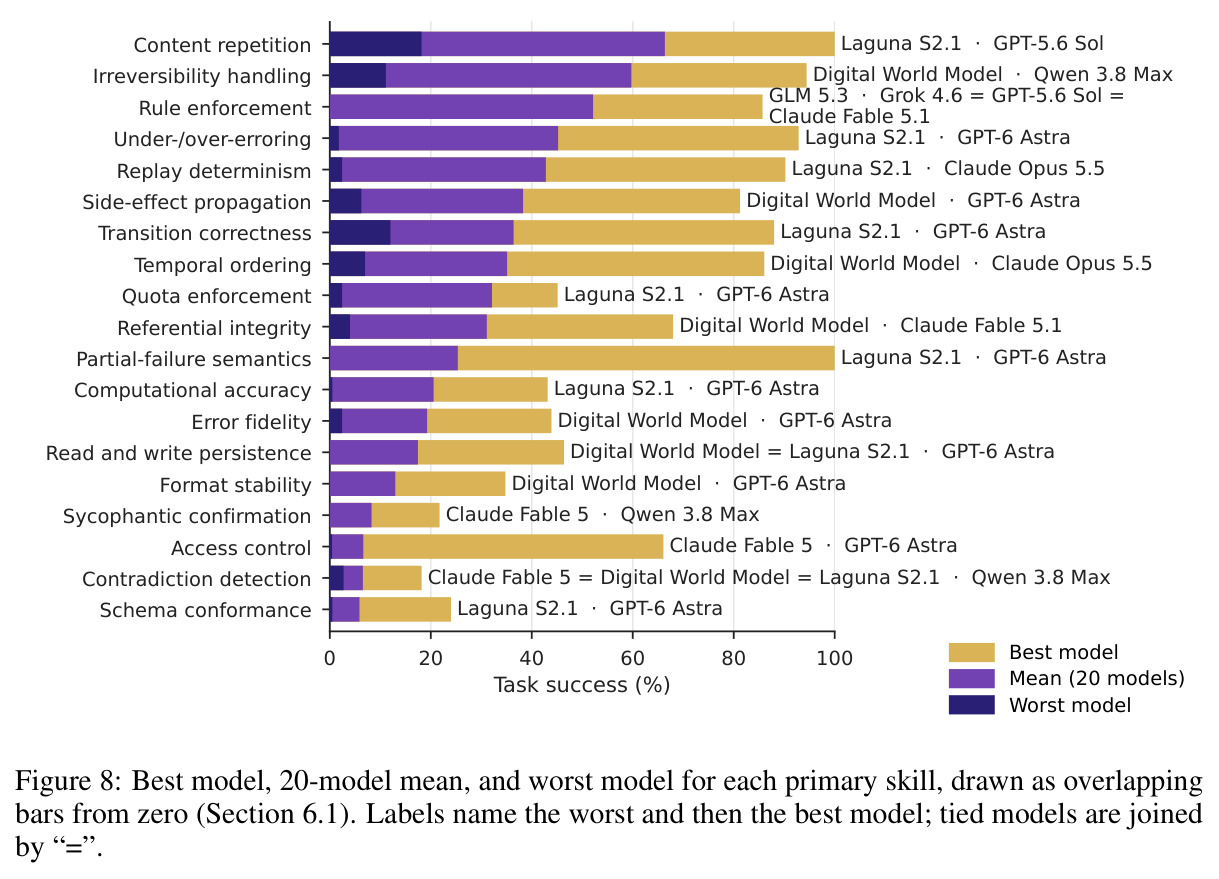
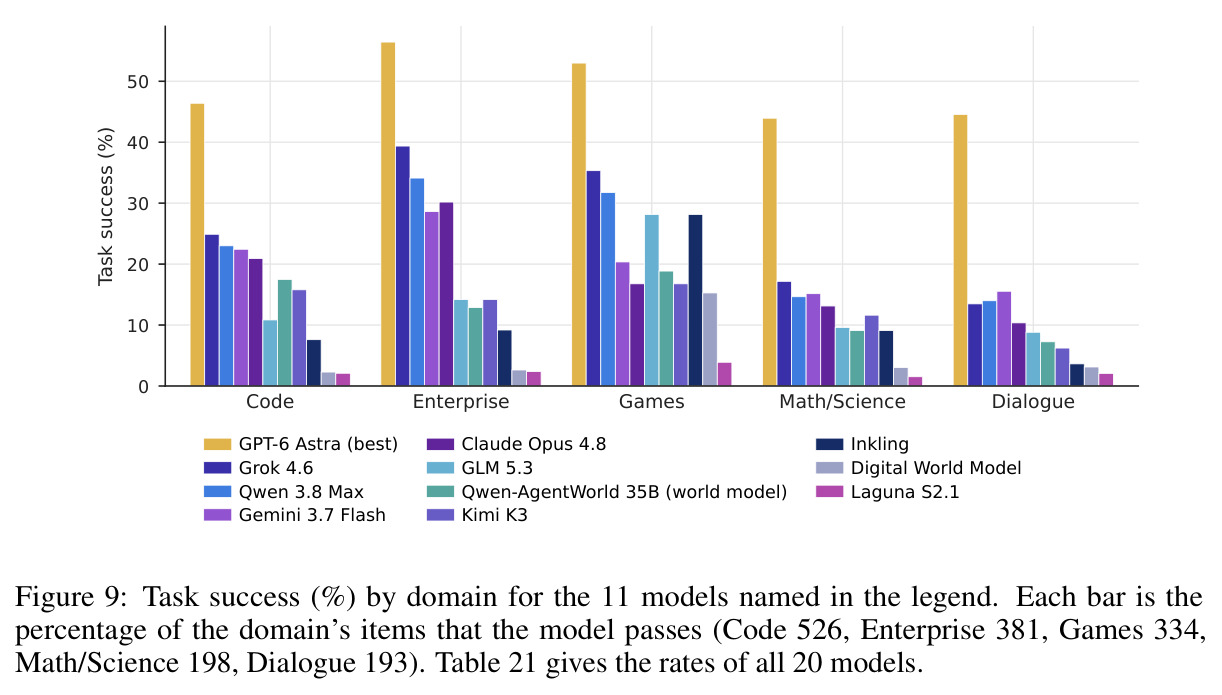
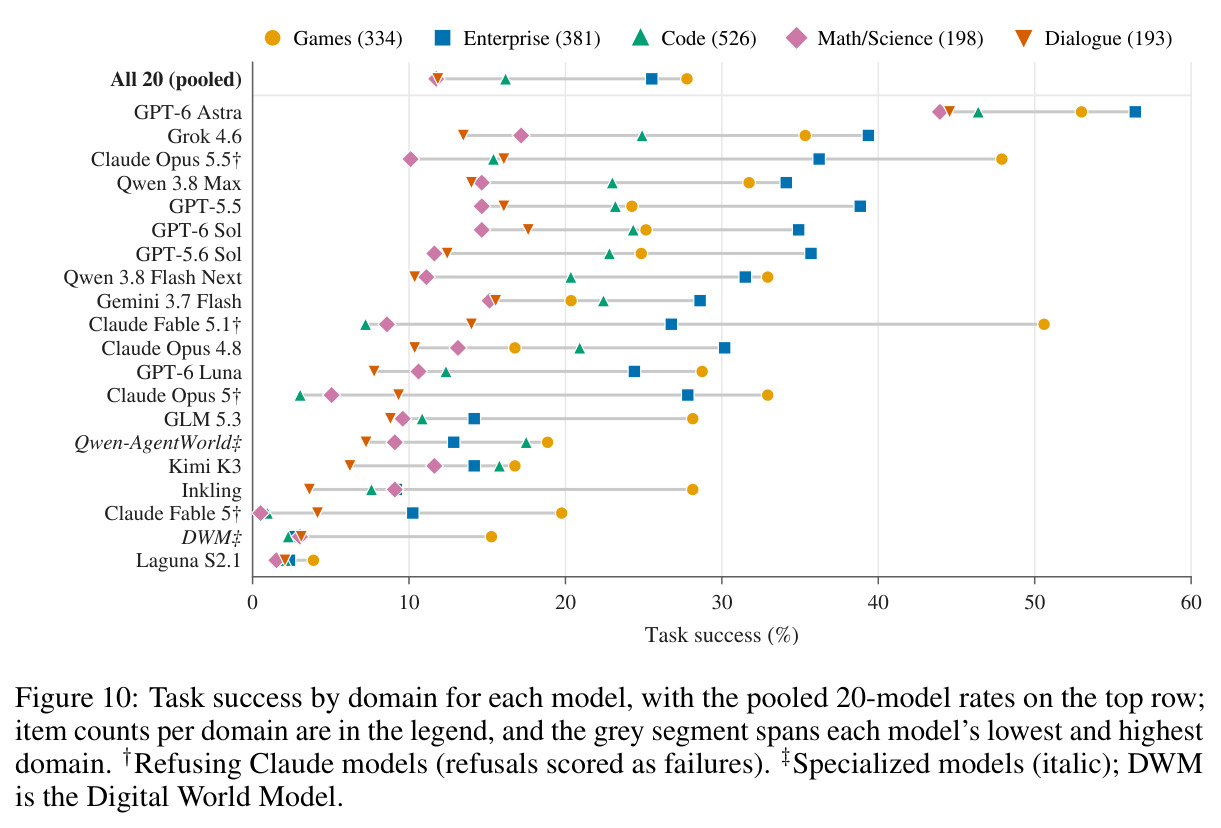
无任何模型过半:GPT-6 Astra 以 49.57% 居首,领先 Grok 4.6(28.13%)21.45 分,其中 272 项来自回溯超 40 轮的 L3 长审计——Astra 通过 33.5%,其余模型中位数仅 2.2%。专用世界模型表现糟糕:Qwen-AgentWorld 14.46%(第 15),DWM 5.21%(第 19,19 项技能均低于中位数)。失败解剖:22,431 个有答案失败中 53.21% 报错值、22.95% 结构问题、23.84% 无字段可比;开源更常报错值(58.22% 对 47.69%),闭源结构问题更多(31.54%)且 19.33% 无可用响应,几乎全为 Claude 护栏拒答。难度轴上 L0→L3 为 43.49%→5.10%,回溯≤40 轮→>40 轮 42.28%→11.44%,无一模型例外;631 项无解(87.6% 为 L3)。败因主要是隐藏状态跟踪而非规则运用:Grok 4.6 用错误能力值 262 推出自洽的权重 4/1/4 并误判拒绝,真值是 89;同伴模型状态正确时决策正确率 61–91%,Astra 超 99%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 整体任务成功(1,632 项全量,20 模型) | 二元通过率(拒答计失败) | GPT-6 Astra 49.57% | 第二名 Grok 4.6 28.13% | +21.45 分(350 项,95% CI 19.12–23.77) |
| 影响半径 L3(副作用波及未点名实体,977 项) | 20 模型池化通过率 | 5.10% | L0(无状态变化,552 项)43.49% | −38.38 分;20 个模型全部在 L3 取得最低分 |
| 长回溯(超过 40 轮,1,192 项) | 20 模型池化通过率 | 11.44% | 不超过 40 轮(408 项)42.28% | −30.84 分;同技能内仍差 −25.11 分,全部 20 模型均下降 |
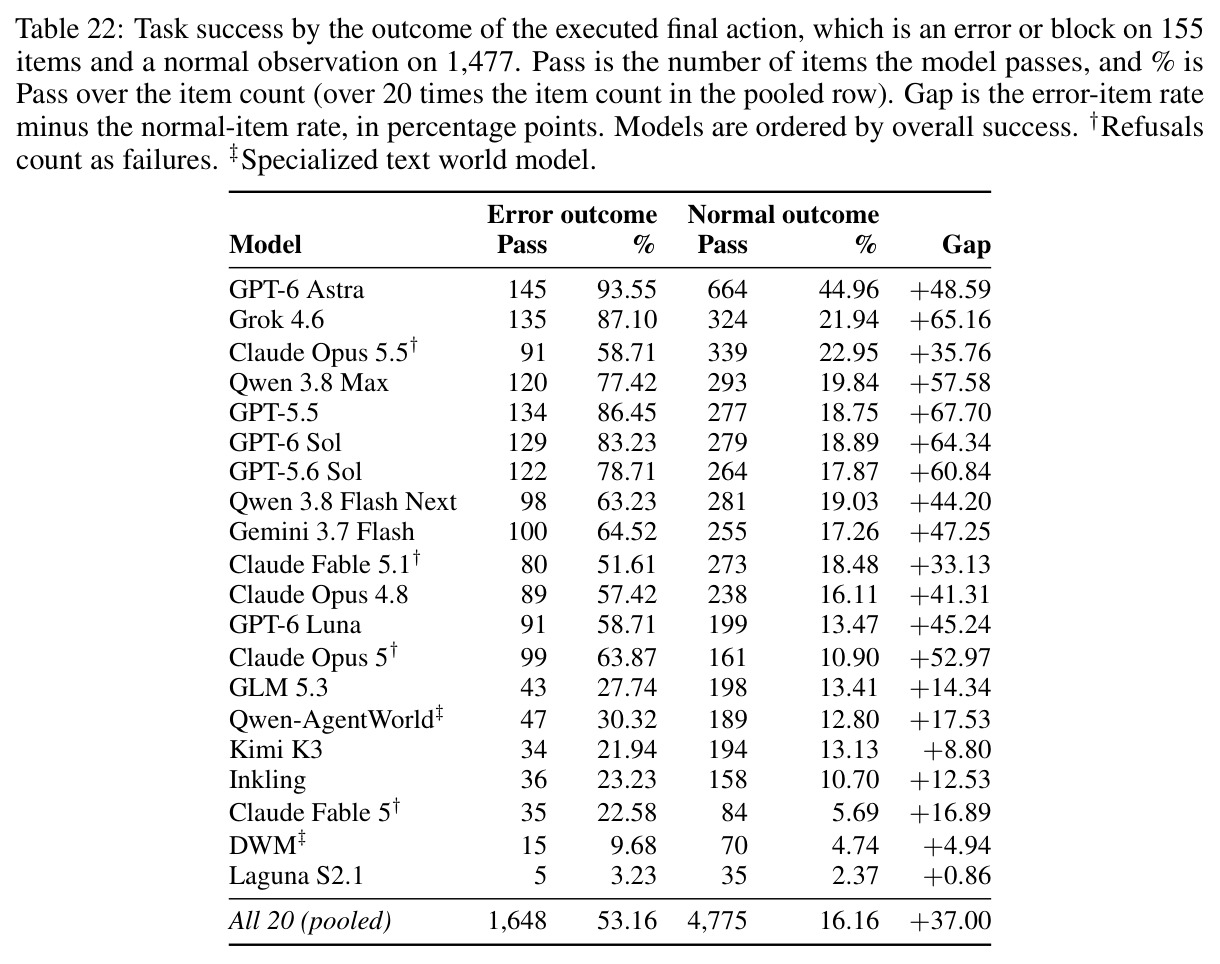
| 错误结果任务(黄金为报错/拦截,155 项) | 池化通过率 | 53.16% | 正常结果任务(1,477 项)16.16% | +37.00 分;但同算子内缩至 +4.57 分,属构成混杂 |
| 专用文本世界模型 | 整体通过率 | Qwen-AgentWorld 14.46%(第 15 名) | 18 个通用 LLM 中位数(约 21%) | 落后 GPT-6 Astra 35 分;DWM 5.21% 在全部 19 项技能上低于中位数 |
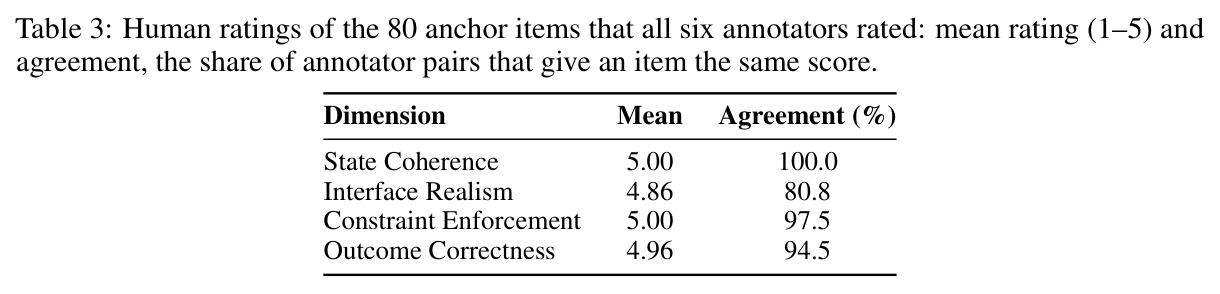
| 人类审计一致性(6 名标注者,80 个锚点条目) | 评级者对完全一致率 | 状态一致性 100%、约束执行 97.5%、结果正确性 94.5% | 接口真实性最低 80.8% | LLM 裁判与人类在 4 维中 2 维一致,状态一致性更严(4.73 对 5.00) |
局限与改进
作者承认三点:每个条目只测固定前缀后的一次状态转移,不测量模拟器误差在多步 rollout 中的复合放大;任务成功是对整个下一状态的二元判定,长审计中错任何一个值就全盘失败,可能高估困难;回溯与半径由构造与技能家族强绑定($\eta = 0.69$,算子解释回溯对数方差 81.64%),只能定位困难的条目家族而不能证明“距离”或“广度”因果导致错误。我的补充观察:闭源模型的护栏拒答(Claude 系 3,696 次)以失败计分虽符合“拒答的模拟器不可用于 rollout”的逻辑,但使能力比较混入安全策略差异;响应裁判与 4 个被评模型同属 OpenAI,虽有盲评与自评无优势的检验,系统性偏置风险仍存;78 个人类锚点条目中 L3 仅 6 项,最难合成审计族未被人类覆盖;977 个 L3 标签中 953 个由算子声明而非执行 diff 度量,L1/L2 各仅 33/59 项,半径效应粒度受限;提示中位约 2.7 万 token(Astra 最长 131,894),评测成本高且未测 few-shot。
独立分析的弱点
第一,二元全对判定对长输出零容忍:saga 审计中 Grok 4.6、Qwen 3.8 Max 等模型 74–93% 的余额字段正确,却因错一个值整项失败,GPT-5.5 甚至只差 1(−95 对 −94)而失败——应引入字段级部分得分。第二,单步转移设计无法回答“模拟器误差如何在 rollout 中复合并被 RL 利用”,而这恰是训练信号质量的核心。第三,L3 几乎全是合成审计,“副作用广”与“输出长、回溯深”完全纠缠(952/977 个 L3 项回溯超 40 轮),无法分离真实能力维度,算子内分析又受限于只有 21 个算子两侧有样本。第四,拒答计分方式让不同安全策略的模型不可比,且可能激励厂商为刷榜放松护栏。第五,每条目仅一次主请求,未报告重复采样方差(bootstrap 只反映条目抽样),商业模型服务端漂移威胁长期复现。第六,Qwen-AgentWorld 未与其基座模型对照,无法归因训练带来的增益。改进方向:部分得分与字段级指标、多步 rollout 复合误差指标、按执行 diff 度量的半径、跨厂商裁判委员会、重复采样方差报告与基座消融。
未来方向
作者指出的方向:把 GlobeBench 用于诊断并改进 RL 训练信号,在闭环中测量模拟器错误被智能体利用的程度;针对 631 个无解条目(集中于隐藏状态跟踪与长程审计技能)设计更好的训练方法或架构。基于本文成果可延伸:其一,把确定性门 + 裁判的混合评分推广为世界模型评测的事实标准,并研究裁判在更长上下文下的可靠性衰减;其二,用配方/算子参数化生成同一算子内独立扫描回溯与半径的对抗变体,解耦“距离”与“广度”的因果效应;其三,为专用世界模型建立与基座对照的训练消融,检验下一状态预测训练的真实收益;其四,探索外部状态记忆、程序化状态表示或检索增强能否缓解超过 40 轮的状态丢失;其五,把基准扩展到多模态环境(GUI、机器人)与多步 rollout 误差复合评估;其六,研究拒答的标准化处理,使安全对齐差异与能力差异在排行榜上可分。
复现评估
复现条件在同类工作中属于极好水平:基准条目与评测 harness 在 GitHub 以 Apache-2.0 发布,条目与 20 个模型的全部逐条结果在 HuggingFace 公开,还包括模型输出与裁判记录,因此所有报告分数都可在不重新调用模型的情况下重算;每个后端以容器 digest 或依赖锁哈希锁定,黄金答案可重执行验证(作者还独立重实现了加权法契约,精确复现全部 76 个金标);人类研究协议、评分 rubric、裁判 prompt 版本与 12 道质量门定义全部公布。算力需求仅为推理:32,640 次请求,长审计提示中位约 2.7 万 token、输出可达数万 token,Astra 在 952 个长 L3 任务上完成补全中位 8.3k token,估算需要可观的商业 API 预算,无任何训练成本。主要风险是被评模型为持续演化的商业 API,论文自己也把“可复现”定义为“可从发布输出重算”;另有 628 次恢复请求使用了更低推理档位(均未通过),细节已透明披露。总体复现难度:低-中(重算结果极容易,重新调用模型则受服务端漂移影响)。
论文图表
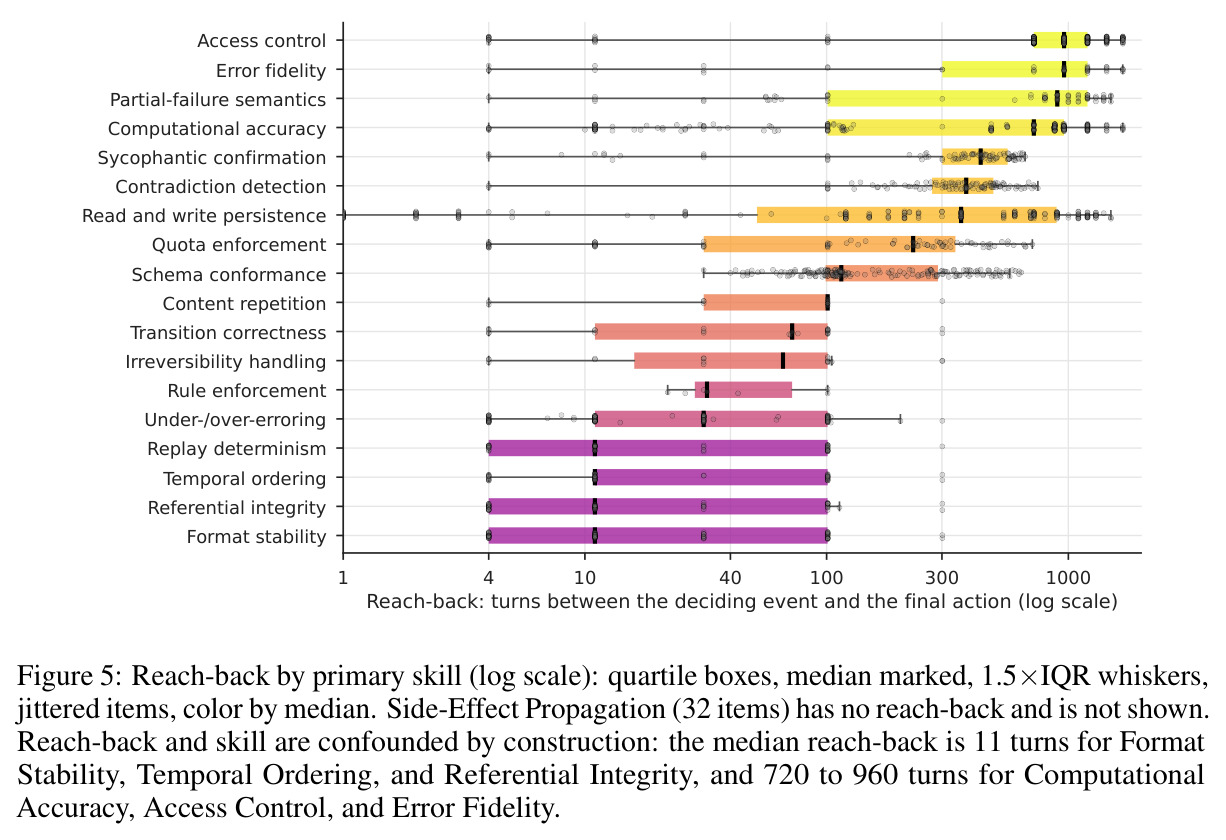
按主技能画回溯距离的四分位箱线图(对数刻度):格式稳定、时序排序、引用完整性的中位回溯仅 11 轮,而计算精度、访问控制、错误保真达 720–960 轮,说明回溯与技能由构造强绑定($\eta = 0.69$,Cramér's $V = 0.54$)。
这张图是理解论文局限的关键:它公开承认两个难度轴与技能家族混杂,提醒读者回溯/半径分析只能定位困难的条目家族,不能做因果归因。
逐字展示最难任务族的代表条目:契约规定赞助者权重为 $1 + ((\text{effective\_capability} + 17p + 13 \times \text{suffix}) \bmod 5)$、状态由 $(\text{effective} + \text{revision}) \bmod 4$ 决定;真实能力值 89 在 720 轮前确立且从不打印。GPT-6 Astra 推出 89、权重 1/3/1、判允许;Grok 4.6 用错误值 262 推出权重 4/1/4、suspended 状态并错误拒绝——其推演与自身状态完全自洽。
这是“失败源于隐藏状态跟踪而非规则运用”这一核心诊断的最佳实证:Grok 的每一步算术和规则应用都正确,唯独携带了过时的状态值。它定义了未来世界模型最需要补的能力。