OmniVerifier-C1:面向规则约束生成式世界建模的分解式分级验证器 OmniVerifier-C1: Decomposed Graded Verifier for Rule-Governed Generative World Modeling
提出分解式分级视觉验证器与成对验证范式,为生成式RL提供更可靠的奖励信号
前置知识
生成式视觉验证器(Generative Verifier / Generative Reward Model)
一类多模态模型:输入文本指令与生成图像,先产出显式推理过程(rationale),再判断图像是否满足指令。区别于只输出标量分数的传统奖励模型,它兼具可解释性,可用作评估工具、推理时的最佳样本选择器以及强化学习中的奖励来源。OmniVerifier 系列工作还配套了 ViVerBench 等评测基准。
本文的研究对象就是这类验证器,三项创新(分解打分、解耦 RL、成对验证)全部围绕'如何让验证器给出更可靠、更有信息量的反馈信号'展开,不理解这一角色定位就无法理解全文动机。
组相对强化学习(GRPO/DAPO)
一类无需价值网络的 RL 算法:对同一 prompt 采样一组候选输出,用组内奖励的相对差异(advantage)作为梯度权重进行策略更新。因此奖励的区分度直接决定学习信号强弱——若多个质量不同的样本拿到相同奖励,组内优势为零,策略无法从这批样本中学到任何东西。
论文的理论出发点正是:二值奖励把'错 3 个子条件'与'全错'的样本压成同一 0 分,削弱组相对 RL 的组内区分信号;理解 GRPO/DAPO 的奖励-优势机制,才能读懂第 3.1 节的排序准确性分析和 Table 1 的对比实验。
奖励黑客(Reward Hacking)与捷径学习
当监督信号稀疏、只看最终结果时,模型可能学到表浅统计模式来'猜中'期望标签,而不真正理解物体—属性—空间约束之间的组合语义,在分布外数据上迅速失效。二值 True/False 监督是典型的稀疏结果信号,特别容易诱发此类行为。
论文反复论证二值验证器易被钻空子,而'分解成子问题再逐项判断'的结构化推理是其给出的缓解手段;Table 1 中分级验证器在分布外基准上的优势正是这一论点的实证支撑。
点对验证(Pointwise)vs 成对验证(Pairwise)
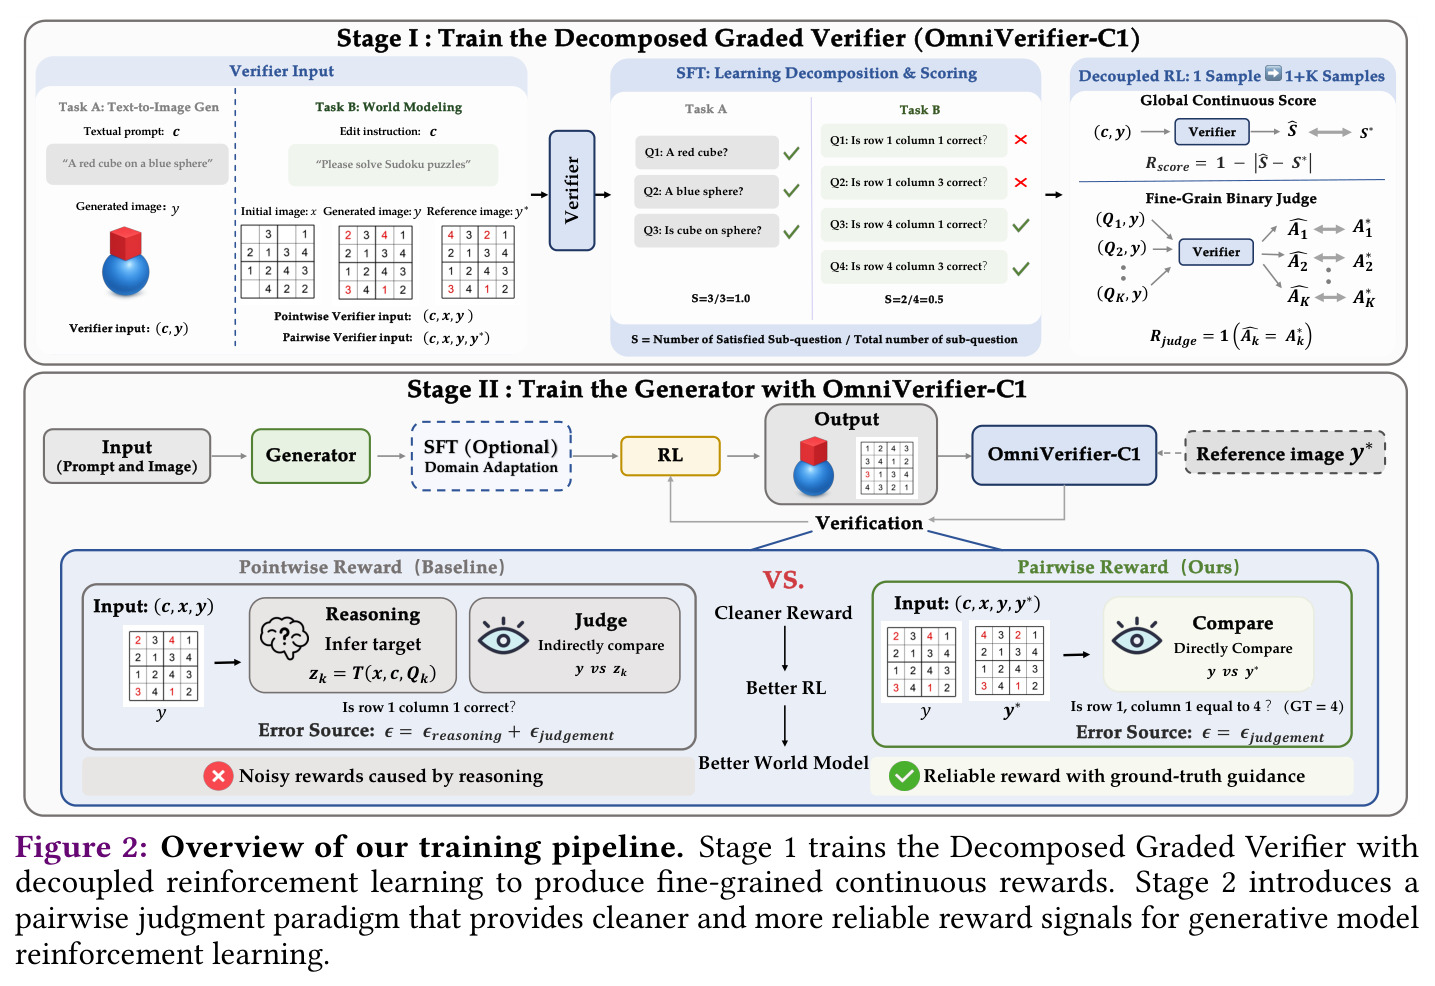
点对验证输入初始状态 $x$、规则 $c$、生成图 $y$,验证器需先在内部推断每个子问题的目标状态 $z_k = T(q_k, x, c)$ 再判断;成对验证额外输入真值图 $y^*$,直接对照 $y$ 与 $y^*$ 逐项比较。前者误差为 $\epsilon_{point} = \epsilon_{reasoning} + \epsilon_{judge}$,后者只剩 $\epsilon_{pair} = \epsilon_{judge}$。
这是论文在规则约束世界建模中的核心设计与最大亮点:理解'误差分解'才能明白为什么引入真值图能把验证从'开卷推理题'简化成'对照改错题',从而在 Maze/Sudoku 上带来大幅提升。
扩散模型 RL 后训练与 DiffusionNFT
对文生图/图像编辑扩散模型(如 SD3.5、FLUX、Qwen-Image-Edit)用外部奖励信号直接更新去噪骨干(DiT)参数的后训练范式。DiffusionNFT 是本文采用的具体算法,将奖励与去噪轨迹绑定进行策略优化,全程冻结文本编码器、只更新 DiT。
论文 Stage 2 用 DiffusionNFT 训练三个生成骨干各 200 步,验证器作为奖励模型接入该流程;'文本编码器冻结下 DiT 涌现推理能力'这一反直觉发现也依赖于对该训练范式的理解。
ViVerBench / GenEval / RISEBench / UniREditBench
ViVerBench 考察概念存在、物体关系、世界动态、图像标注、状态值评估、STEM 共 16 个子项的多模态批判能力;GenEval 考察单物体、双物体、计数、颜色、位置、属性绑定 6 类组合文生图能力;RISEBench 与 UniREditBench 分别考察图像编辑中的时间/因果/空间/逻辑推理与真实/游戏类编辑能力。
论文全部主结果(Table 1–4)都在这些基准上报告,知道每个基准考什么、指标是什么,才能正确解读'0.654→0.684''0.66→0.77'这些数字的含义与含金量。
研究动机
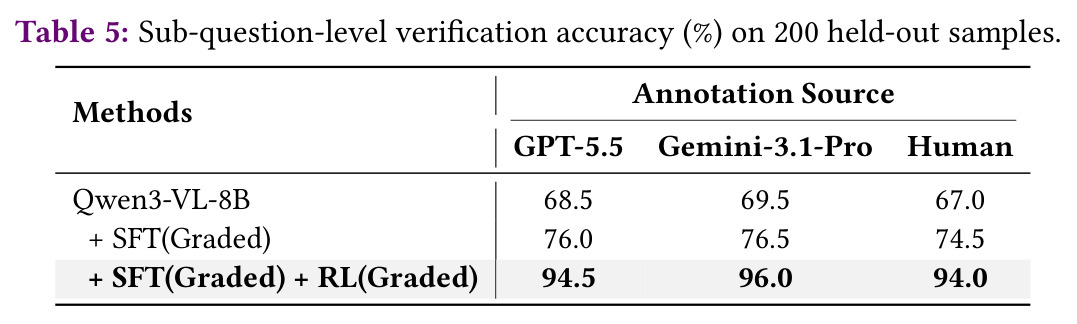
多模态生成模型在视觉保真度上已进步显著,但判断'生成图是否忠实遵循复杂指令与世界知识'仍是瓶颈。现有视觉验证器(OmniVerifier、各类 GenRM 等)几乎都采用二值判断范式,只输出 True/False。这在推理时扩展中够用,但作为 RL 奖励有两大硬伤:其一,反馈过粗——把'满足了 3/5 个子条件'与'全部错误'的样本压成同一个 0 分,抹掉部分正确性,削弱组相对强化学习(GRPO/DAPO)赖以工作的组内区分信号;其二,稀疏二值监督诱导捷径学习与奖励黑客——验证器可以靠表浅视觉模式猜中标签,而不真正推理物体、属性、空间约束间的组合关系。在规则约束的世界模拟任务(迷宫、数独等)中问题更严重:点对验证器还必须先在内部推断'目标状态长什么样',这一步的推理误差会进一步污染奖励。
本文的目标是本文要做两件事。第一,构建分解式分级验证器 OmniVerifier-C1:自动把复杂 prompt 或环境规则拆解为 K 个细粒度子问题,逐项判断后以满足比例 $S = z(x)/K$ 输出连续分数,并用'解耦 RL'策略同时优化子问题级 0/1 判断与全局打分对齐,让验证器具备细粒度、可泛化(含分布外)的批判能力。第二,在规则约束生成式世界建模中——初始状态加规则唯一确定目标状态、真值图可得——提出成对验证范式,把 reason-then-judge 简化为直接参照比较,为生成器的 RL 提供更干净准确的奖励。整体目标是把生成式模型从'图像好看'推进到'结构化世界推理智能体'。
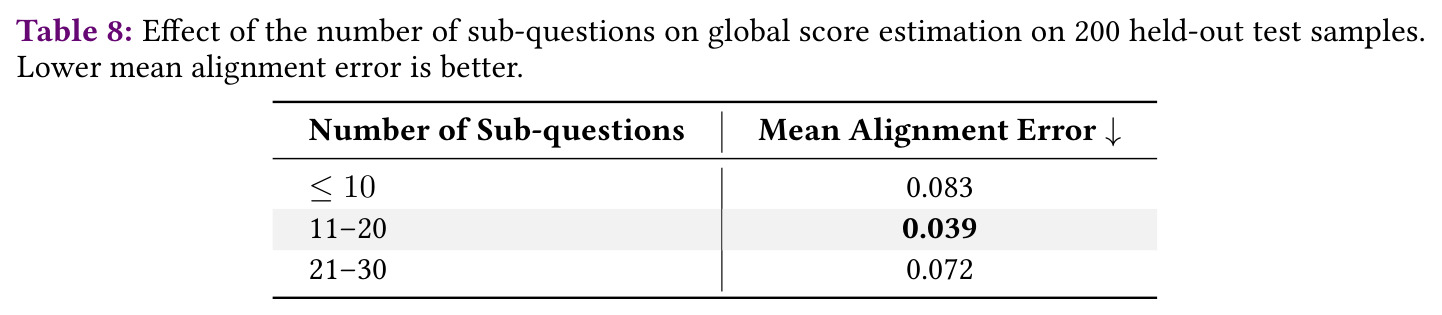
与已有工作不同的是,已有生成式验证器(OmniVerifier、OmniVerifier-M1、DeepSeekMath-V2)虽有显式推理链、规则化监督和元验证,但最终判断仍是二值,给不出稠密、优化友好的奖励;UnifiedReward 等连续奖励模型不做结构化分解,打分缺乏可解释依据。本文的独特切入有三点:一是为'分解+比例计分'补上理论——证明连续奖励的排序准确性恒为 1,而二值奖励只有 $\frac{2q_K(1-q_K)}{1-\sum_{k=0}^{K} q_k^2} \le 1$,只要存在两个真实质量不同的不完美样本就严格小于 1;二是解耦 RL 把 1 个训练样本扩增为 1+K 个,用精确的局部 0/1 反馈托底全局打分学习;三是首次明确区分 pointwise/pairwise 两种验证协议并给出误差分解,指出'真值图可得性'是生成模型升级为世界建模智能体的关键使能条件。
核心方法
直觉上,判断'红色立方体是否在蓝色球体上'比判断整幅图'对不对'容易且可验证得多,把若干简单判断的满足比例聚合起来,就得到保留部分正确性的连续分数。技术路线分两阶段。Stage 1 训练验证器:先 SFT 学习从 Seed1.8 蒸馏的子问题分解范式,再用 DAPO 做解耦 RL——每个 (prompt $c$, 图像 $y$) 对变成 K+1 个 RL 样本,K 个做子问题二值判断(奖励 $R_{judge}=\mathbf{1}[\hat{A}_k=A_k^*]$),1 个做全局打分(奖励 $R_{score}=1-|\hat{S}-S^*|$),在 Qwen3-VL-8B 上以 16 块 A800-80G 训练 80 步。Stage 2 把验证器接成生成式奖励模型,用 DiffusionNFT 以 200 步 RL 训练 SD3.5-medium 与 FLUX.1-dev(文生图),并在六类游戏任务上训练 Qwen-Image-Edit-2509(世界建模),其中对比了 pointwise 与 pairwise 两种奖励协议。
核心创新一是'分级奖励取代二值奖励':设 prompt 可无损分解为 K 个子问题,样本满足其中 $z(x)\in\{0,1,\dots,K\}$ 个,连续奖励 $r_c(x)=z(x)/K$ 对 $z(x)$ 严格单调,排序准确性 $\mathrm{Acc}_{rank}=1$;而二值奖励 $r_d(x)=\mathbf{1}[z(x)=K]$ 只在'一个全对、另一个不全对'时给出正确排序,$\mathrm{Acc}_{rank}(r_d)=\frac{2q_K(1-q_K)}{1-\sum_{k=0}^{K}q_k^2}$,只要存在两个质量不同的不完美样本就严格小于 1。创新二是解耦 RL:1 个样本拆成 1+K 个,子问题级 0/1 精确反馈培养细粒度验证能力,为可靠的全局连续打分打底,并缓解连续监督噪声。创新三是成对验证:显式输入真值图 $y^*$,把误差从 $\epsilon_{point}=\epsilon_{reasoning}+\epsilon_{judge}$ 降为 $\epsilon_{pair}=\epsilon_{judge}$,在规则约束场景下奖励显著更干净。
方法步骤详情
第一步,构建验证器训练数据:从 ShareGPT-4o-Image 采集不同复杂度的 prompt,用 FLUX.1-dev、Qwen-Image、Z-Image 采样生成图像保证视觉多样性;先 SFT 学习 Seed1.8 蒸馏的分解范式;随后过滤——剔除预测与真值完全一致的样本,用 GPT-5 Bo10 过滤准确率低于 60% 的样本,并把全对样本比例控制在 30%。第二步,解耦 RL(DAPO,Qwen3-VL-8B,80 步,16×A800-80G):每个样本扩增为 1+K 个,K 个子问题判断样本奖励为 $R_{judge}=\mathbf{1}[\hat{A}_k=A_k^*]$,1 个全局打分样本奖励为 $R_{score}=1-|\hat{S}-S^*|$,两类样本混批、各用各的奖励联合优化。第三步,生成器 RL(DiffusionNFT,200 步,16×A800-80G):文生图直接用分解打分作点对奖励;世界建模则在六类游戏任务上先 SFT 学执行先验,再分别用 pointwise 奖励(输入 $(x,c,y)$,需自行推断目标 $z_k=T(q_k,x,c)$)与 pairwise 奖励(输入 $(x,c,y,y^*)$,直接比较)训练,全程只更新 DiT 参数。
技术新颖性
相对已有工作的本质区别:(1) OmniVerifier/OmniVerifier-M1、DeepSeekMath-V2 等生成式验证器都以二值判决收尾,本文首次把'分解推理'与'连续计分'耦合,让推理过程本身成为可优化的监督结构;(2) 解耦 RL 的 1→1+K 样本扩增是新的数据利用方式——同一张图既提供全局回归信号又提供 K 个精确局部分类信号,解决了连续分数监督噪声大的老问题;(3) 理论上首次用排序准确性刻画奖励粒度对组相对 RL 的影响,而不是停留在经验对比;(4) pairwise 验证把世界建模中的验证从'开卷推理题'变成'对照改错题',明确指出真值图可得性是从生成模型迈向世界模型的关键前提;(5) 附带发现:文本编码器全程冻结、只训 DiT 也涌现出结构化推理能力,挑战了'推理智能主要存在于文本编码器'的惯例认知。
实验结果
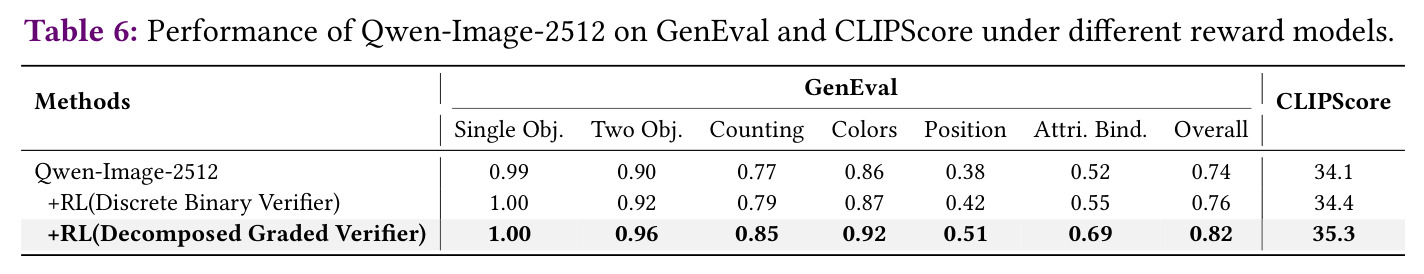
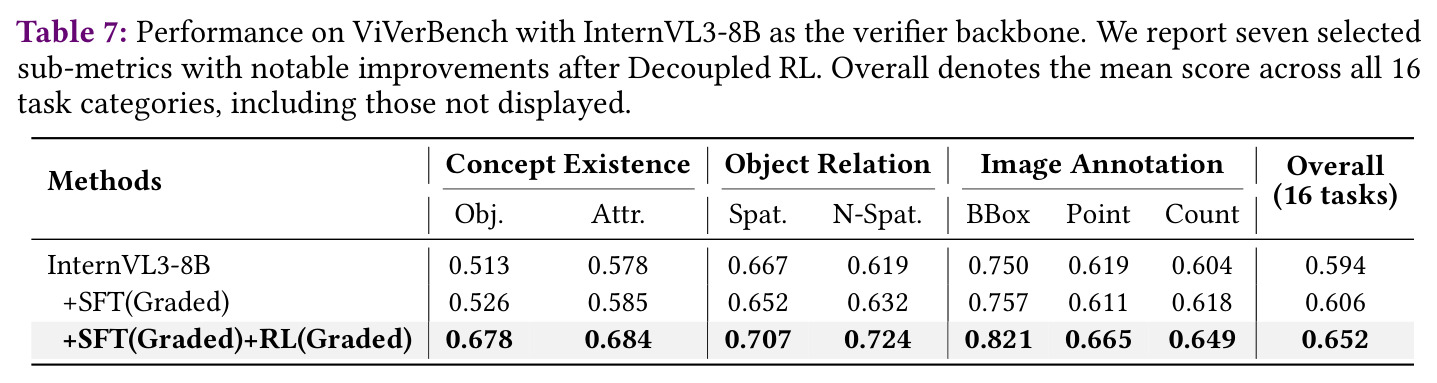
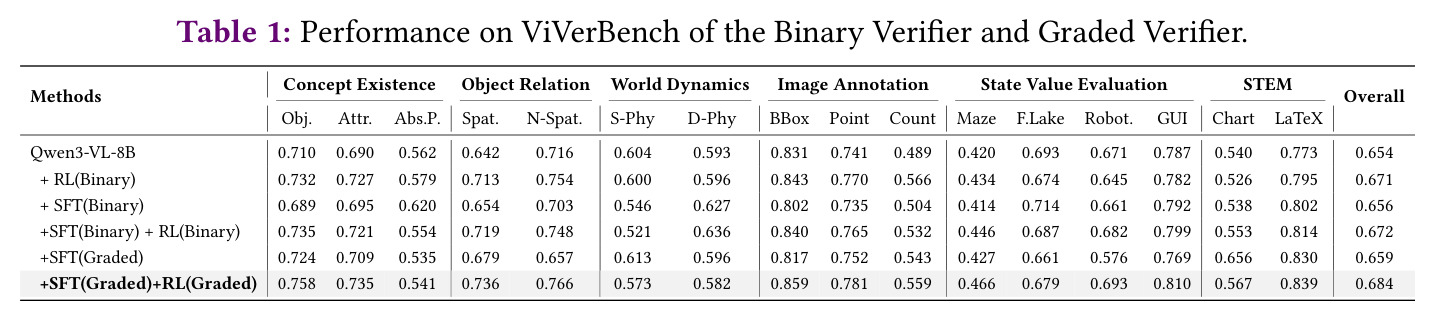
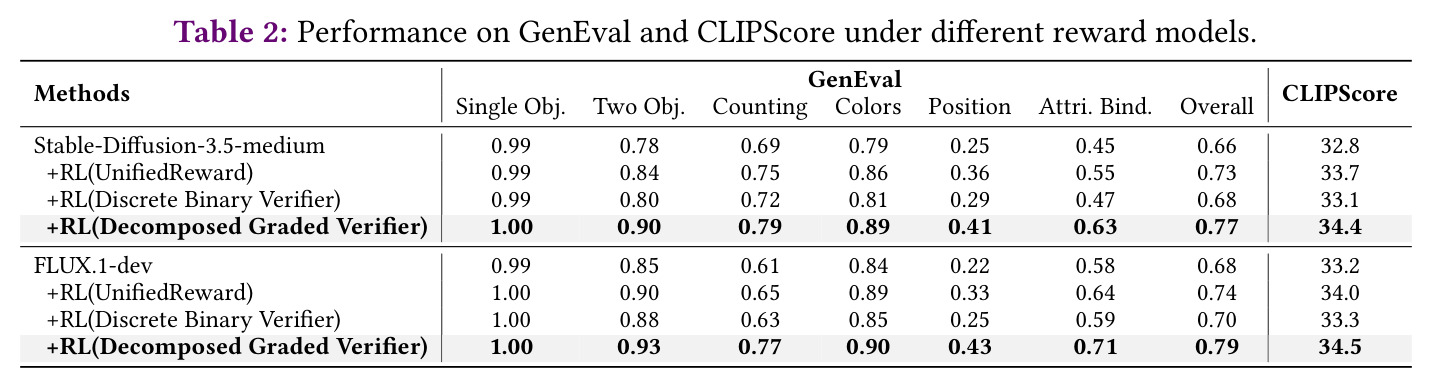
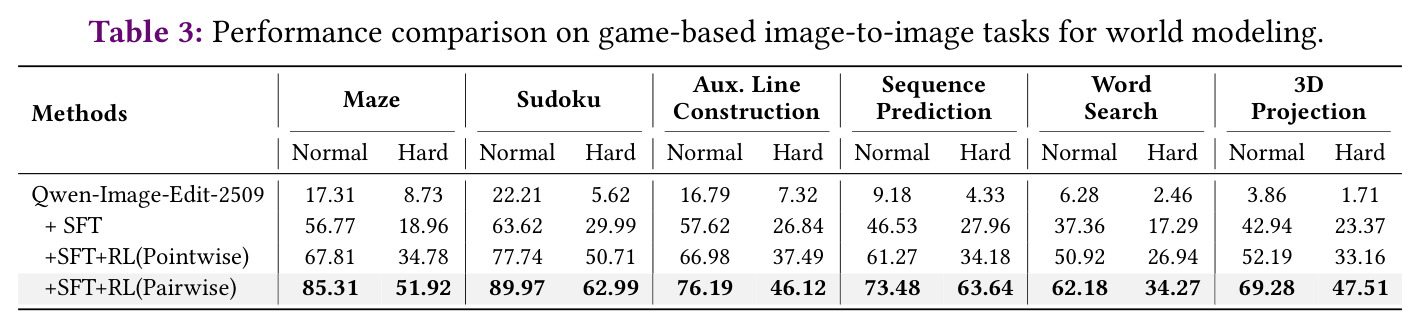
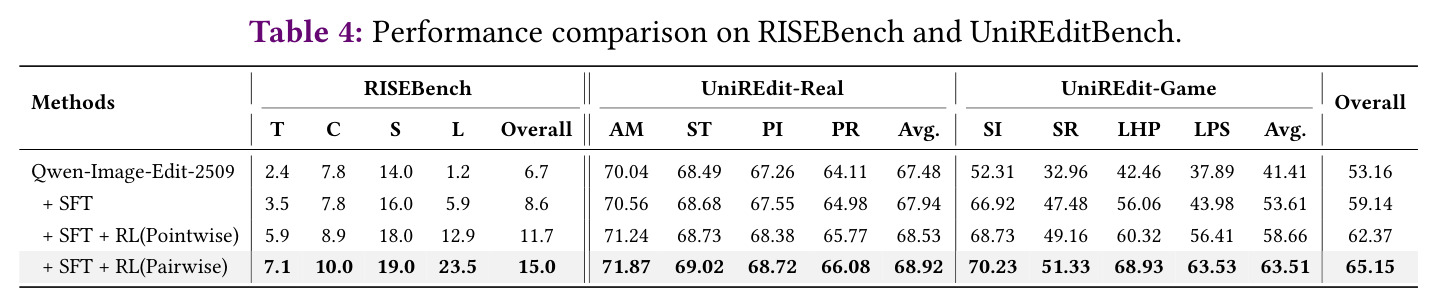
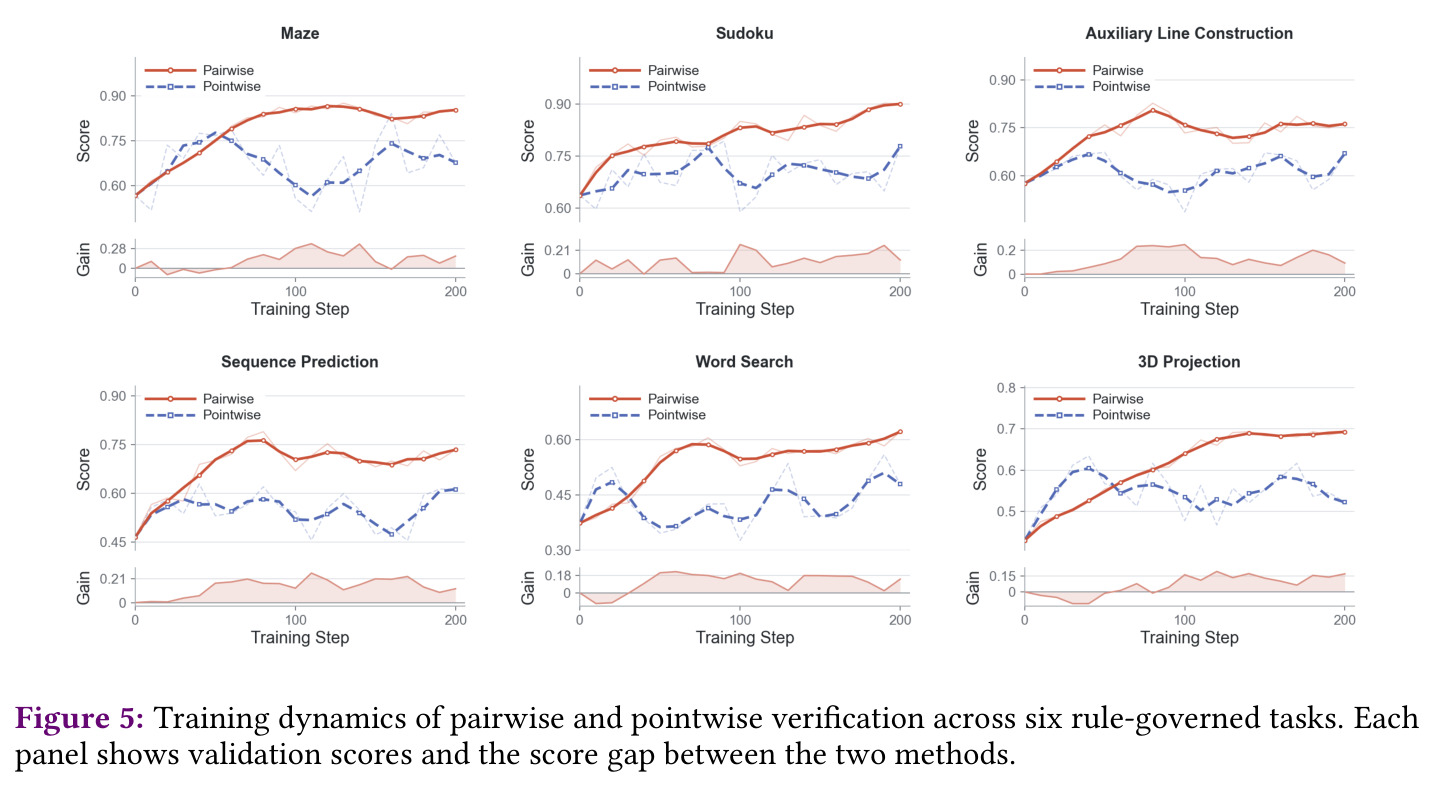
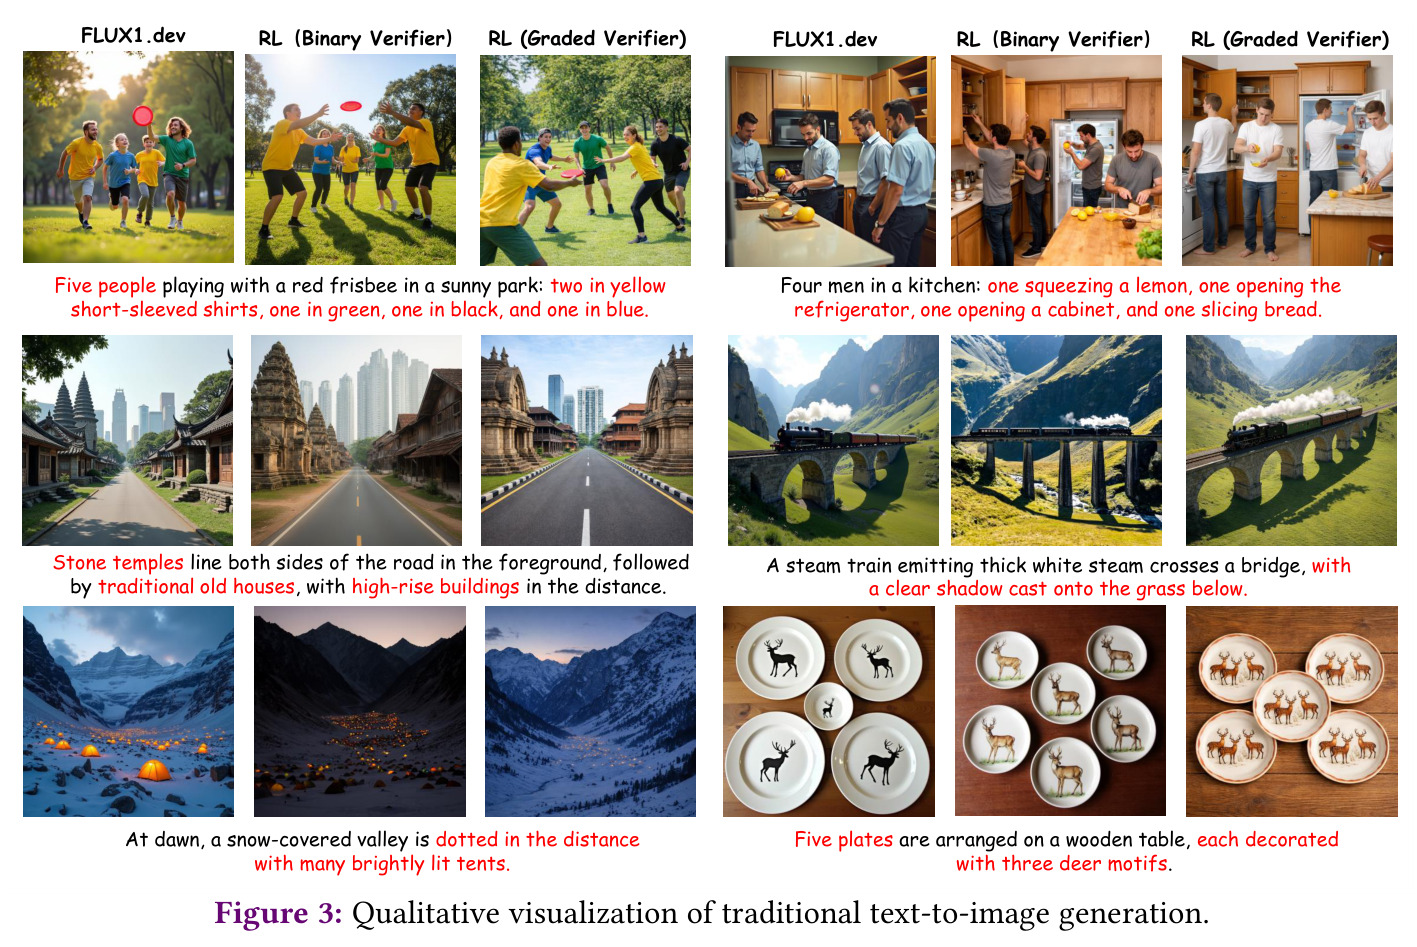
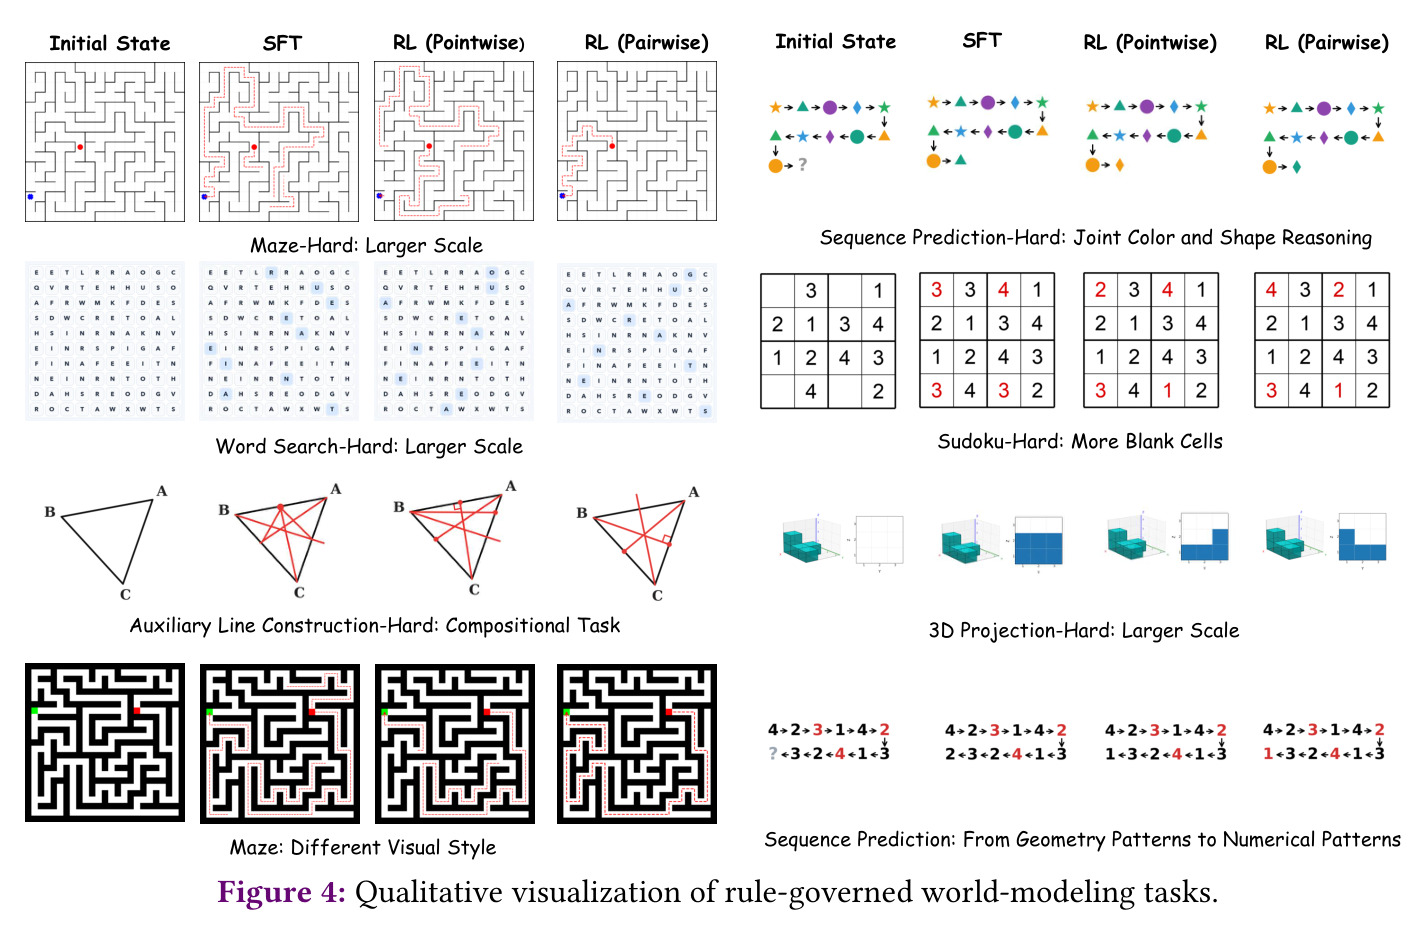
验证器能力(Table 1,ViVerBench):Qwen3-VL-8B 基线 Overall 0.654;RL(Binary) 0.671,SFT(Binary)+RL(Binary) 0.672;而 SFT(Graded)+RL(Graded) 达 0.684,在物体属性(0.735 vs 0.721)、空间关系(0.736)、BBox(0.859)、Maze(0.466)等多数子项领先——二值验证器无论是否加 SFT 都更差,说明关键在监督信号本身而非训练管线。文生图 RL(Table 2):SD3.5-medium 的 GenEval 总分从 0.66 提到 0.77(属性绑定 0.45→0.63、位置 0.25→0.41),超过 UnifiedReward 的 0.73 与二值的 0.68,CLIPScore 32.8→34.4;FLUX.1-dev 从 0.68 到 0.79(计数 0.61→0.77、属性绑定 0.58→0.71),CLIPScore 33.2→34.5。世界建模(Table 3):SFT+RL(Pairwise) 在 Maze 85.31/51.92(Normal/Hard,基线仅 17.31/8.73)、Sudoku 89.97/62.99(基线 22.21/5.62)、辅助线 76.19/46.12、序列预测 73.48/63.64、单词搜索 62.18/34.27、3D 投影 69.28/47.51,全面超过 pointwise(如 Maze-Hard 34.78 vs 51.92)。Table 4:RISEBench Overall 从 6.7 → 15.0(pointwise 仅 11.7),UniREdit 总分 53.16 → 65.15(pointwise 62.37)。未参与训练的 Hard 集与视觉风格迁移 OOD 评估显示 pairwise 模型泛化更强,且 Fig.1 显示其训练曲线更平稳、pointwise 则波动明显。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 验证器多模态批判能力(ViVerBench) | Overall 准确率 | 0.684(SFT+RL 分级验证器) | 0.671(RL 二值验证器)/ 0.654(Qwen3-VL-8B 原始) | 较二值 +1.3 pts,较基线 +3.0 pts |
| 文生图组合对齐(GenEval,SD3.5-medium) | Overall 分数 | 0.77 | 0.66(基线);0.73(UnifiedReward);0.68(二值验证器) | +11 pts;超 UnifiedReward 4 pts |
| 文生图组合对齐(GenEval,FLUX.1-dev) | Overall 分数 | 0.79 | 0.68(基线);0.74(UnifiedReward) | +11 pts;超 UnifiedReward 5 pts |
| 语义对齐(SD3.5 / FLUX.1-dev) | CLIPScore | 34.4 / 34.5 | 32.8 / 33.2 | +1.6 / +1.3 |
| 世界建模:迷宫 Maze(Normal / Hard) | 任务成功率(%) | 85.31 / 51.92(SFT+RL Pairwise) | 17.31 / 8.73(基线);34.78(Hard 下 RL Pointwise) | 较基线 +68 / +43.2 pts;较 pointwise +17.1 pts(Hard) |
| 世界建模:数独 Sudoku(Normal / Hard) | 任务成功率(%) | 89.97 / 62.99 | 22.21 / 5.62(基线);50.71(Hard 下 Pointwise) | 较基线 +67.8 / +57.4 pts;较 pointwise +12.3 pts(Hard) |
| 图像编辑世界推理(RISEBench) | Overall(T/C/S/L 平均) | 15.0(SFT+RL Pairwise) | 6.7(基线);11.7(RL Pointwise) | 较基线 +8.3 pts;较 pointwise +3.3 pts |
| 图像编辑(UniREditBench 总分) | Overall | 65.15(SFT+RL Pairwise) | 53.16(基线);62.37(RL Pointwise) | 较基线 +12.0 pts;较 pointwise +2.8 pts |
局限与改进
作者承认的局限:分级验证器必须先 SFT 才能学会分解范式(二值验证器可直接 RL),训练管线更复杂;数据过滤依赖 GPT-5(Bo10)、评测依赖 Gemini3.1-Pro 作为裁判,评估本身可能引入偏差;成对验证依赖唯一真值图,只适用于规则约束、目标状态确定的场景,传统开放式文生图无法使用。我自己的观察:连续分数是 K 个子问题的等权平均,忽略子问题难度与重要性差异('颜色正确'与'整行数独正确'权重相同);分解质量依赖蒸馏自 Seed1.8 的范式,K 的粒度没有自动调控机制;游戏任务均为 4×4 数独、小型迷宫等合成环境,向真实照片级世界模拟的可扩展性未知;验证器在大规模迷宫、3D 投影等需要精细空间核对的子项上绝对分数仍偏低(ViVerBench 上 Maze 0.466、Counting 仅 0.559);另外,连续奖励虽然更平滑,但生成器可能学会'专刷简单子问题、放弃难子问题'来抬高分数,论文未系统研究分级奖励下的 reward hacking 形态。
独立分析的弱点
第一,等权计分:$S=z(x)/K$ 假设所有子问题同等重要,改进方向是学习子问题权重(按规则依赖结构或难度自适应加权),或对关键子问题设置一票否决式的字典序奖励。第二,pairwise 强依赖真值图:真实世界的图像编辑与具身任务没有唯一真值,可延伸为'成对偏好比较'(判断哪个候选状态更符合规则)或用程序化检查器、状态符号表示替代真值图。第三,评估同源风险:GPT-5/Gemini 裁判可能天然偏好分解式输出,使 Table 4 的结论对裁判选择敏感,建议补充人工标注子集或多裁判交叉校验。第四,感知瓶颈:验证器在 Counting(0.559)、Maze(0.466)等细粒度空间任务上仍弱,可引入符号空间标注(延续 OmniVerifier-M1 的 bbox/点线思路)或更高分辨率输入辅助判断。第五,Hard 任务绝对性能仍有限(Word Search-Hard 34.27、Aux-Hard 46.12),可探索推理时扩展——用验证器做 best-of-N 选择或迭代编辑修正,与 RL 训练互补,把验证器同时用于训练与部署两个阶段。
未来方向
作者提出的方向:把分解式成对验证推广到视频世界模型与长时序状态序列(多步 rollout 的规则一致性核查);在更复杂的规则系统(更大规模数独、组合优化、物理仿真)中检验可扩展性;研究生成器与验证器协同进化时的博弈动力学与奖励 hacking 防御。基于本文成果可延伸:将等权比例分数升级为加权/层级化分解分数,并与过程奖励模型结合做逐步监督;把成对验证的误差分解理论推广到带噪声真值的场景,给出 $\epsilon_{pair}=\epsilon_{judge}+\epsilon_{GT}$ 条件下的排序保证与适用边界;深入剖析 DiT 涌现规则推理能力的机理(论文已证明文本编码器冻结下也能内化结构化推理),反哺世界模型架构设计;把验证器接入推理时搜索(best-of-N、beam search、self-refine),在无 RL 预算时也能提升世界建模准确率;探索从游戏规则自动合成子问题分解的自动化管线,摆脱对闭源教师模型(Seed1.8/GPT-5)的依赖。
复现评估
论文给出 GitHub 仓库(github.com/Cominclip/OmniVerifier),实验设置描述较完整:验证器基于 Qwen3-VL-8B,SFT 蒸馏自 Seed1.8,解耦 RL 用 DAPO 训 80 步;生成器 RL 用 DiffusionNFT 训 200 步,两阶段均为 16×A800-80G。主要门槛有三:(1) 数据依赖闭源模型——分解范式蒸馏自 Seed1.8、数据过滤用 GPT-5 Bo10、评测用 Gemini3.1-Pro,若仓库不发布处理后的数据,完整复现难度大;(2) 算力门槛高,两阶段合计约 280 步×16 卡 A800,中小团队可先只复现验证器 SFT+小规模 RL;(3) 六类游戏任务(迷宫、4×4 数独、辅助线、序列预测、单词搜索、3D 投影及 Hard 版)构造规则描述清晰、可程序化生成,但 Hard 评估集是否开源会影响公平对比。总体难度中高;若代码与数据齐全,两项核心结论(graded>binary、pairwise>pointwise)可在 8 卡级环境用较小模型定性复现。
论文图表