WorldReward:面向相机条件化世界模型的奖励建模 WorldReward: Reward Modeling for Camera-Conditioned World Models
用VLM分块推理统一评估世界模型的动作执行与视觉质量,并可作RL后训练奖励
前置知识
相机条件化世界模型
根据源图像、文本描述和显式相机/动作轨迹生成交互式视频的生成模型。用户每输入一个动作指令(如前进、左转),模型生成对应的场景变化视频,要求生成的画面既忠实执行指令的方向与时序,又保持几何、外观和时间动态连贯。代表工作包括 HY-WorldPlay、Matrix-Game、LingBot-World、Yume 等实时流式自回归系统。
本文的全部动机是为这类模型构建奖励:只有理解'动作指令→预期视觉变化'这一契约,才能明白为什么动作一致性和视觉质量必须被联合评估。
奖励模型与成对偏好
奖励模型学习预测人类对生成结果的偏好,是 RLHF/RL 后训练的核心信号源。成对偏好设定下,模型不输出绝对分数,而是对同一条件下两个候选 $A,B$ 判断谁更好,输出属于 $\{A,B,Tie\}$ 的三向判决,再通过胜率或标量化转换为可用于策略梯度优化的奖励值。
WorldReward 是成对偏好奖励模型,其训练目标(SFT 模仿偏好标注)和 RL 应用(式6-7 的胜率转换)都建立在这个范式上,理解它才能看懂方法与实验协议。
VLM-as-Judge
用视觉语言大模型代替人工评审:把候选输出和评审标准组织成多模态提示,让 VLM 输出判决和评估推理。优点是能给出可解释的推理链、支持多维度评估;缺点是上下文长度有限、对长输入容易'走马观花',稀疏采样会漏掉短促事件,稠密采样则成本爆炸且噪声大。
WorldReward 属于该范式但做了改造:直接整段判断长视频会稀释局部动作证据,这正是本文 chunk 化设计要解决的核心痛点。
几何奖励(轨迹恢复类)
用 DepthAnything3、WorldMirror 等 3D 基础模型从生成视频帧中恢复相机位姿轨迹,再与指令轨迹比对得到动作遵从度。这类奖励可验证、不易被 hack,但只度量几何执行,完全无法评价画面的时间稳定性、动态合理性与伪影,也不能区分'轨迹对但画面烂'的情形。
几何奖励是本文最重要的对照组:WorldCompass 用'几何奖励+HPSv3'两套异构系统做 RL,本文实验证明单一 VLM 奖励可以同时取代两者并取得更好效果。
DiffusionNFT 与流匹配 RL 后训练
对流匹配/扩散生成模型做 RL 的免监督微调协议:按 clip 级 rollout 采样一组候选,用奖励算出每个候选的最优性概率 $p_i$,再以负感知流匹配损失(式11)拉近优候选、推远差候选。配合 Pref-GRPO 的成对胜率奖励(组内两两比较取归一化胜率),避免了绝对分数标定困难。
第 3.6 节把 WorldReward 接入该框架对 HY-WorldPlay 1.5 做后训练,式(5)-(11) 的 rollout、胜率、优势标准化和损失全部依赖这套背景。
研究动机
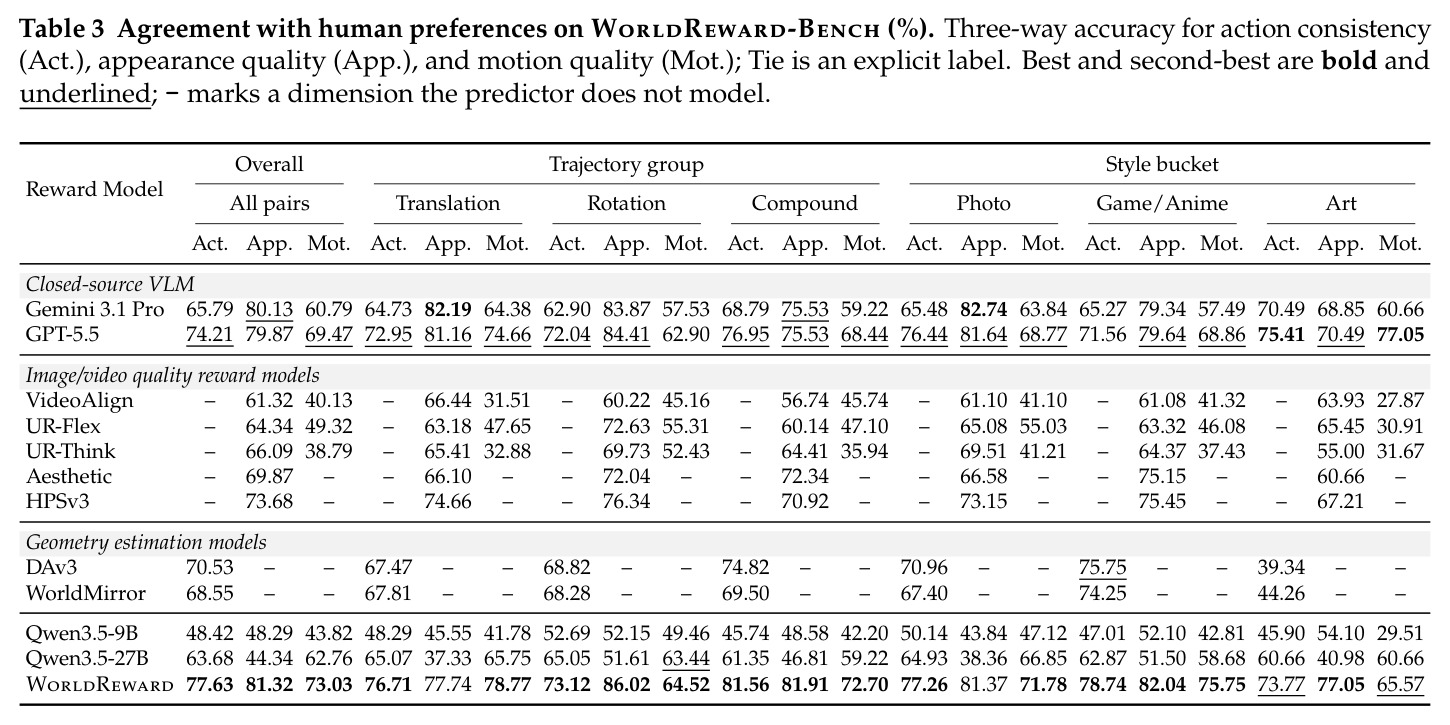
相机条件化世界模型(HY-WorldPlay、Matrix-Game 等)根据指令实时生成交互式视频,结果只有在'忠实执行指令'且'几何、外观、时间动态连贯'时才有用。现有奖励把两件事割裂:几何类奖励用 DepthAnything3、WorldMirror 等从生成帧恢复相机轨迹与指令比对,能度量执行却无法评判画面质量(闪烁、伪影、外观漂移);图像类奖励如 HPSv3 独立打分采样帧,察觉不到动作未被执行。WorldCompass 把两者拼接用于 RL,但仍是异构解耦系统。直接让 VLM 评审完整长视频加动作序列又面临三重困难:上下文过长、稀疏采样漏掉几帧内显现的局部动作证据、整体印象稀释局部失败且难归因。论文用数据量化了严重性:Qwen3.5-9B 基座直接评审在动作/外观/运动的三向一致率仅 48.42%/48.29%/43.82%,近随机;GPT-5.5 也只有 74.21%/79.87%/69.47%,距人类仍有差距。
本文的目标是本文的目标是构建一个统一的、VLM 驱动的成对偏好奖励模型 WorldReward:输入相同条件(源图 $x_0$、caption $d$、动作轨迹 $a_{1:N}$)下由世界模型生成的两个候选视频 $V_A,V_B$,输出维度分离的动作一致性与视觉质量偏好(式1),具体拆解为四个子目标。其一,设计一种能定位局部动作证据的输入组织方式,让短促的动作转变在紧凑上下文中可被验证,同时保持时间连贯性的全局视野。其二,建立一条大规模推理增强的偏好数据生产管线,使标注质量超越直接蒸馏的教师模型——最终在 WorldReward-Bench 三个维度上同时超过专有 VLM 评审(GPT-5.5、Gemini 3.1 Pro)、学习型视觉偏好模型(HPSv3、VideoAlign、UnifiedReward 系列)和几何估计器(DAv3、WorldMirror)。其三,发布一个带人工标注、按动作/外观/运动三维度独立打标的基准。其四,验证该奖励能作为有效 RL 信号,在对 HY-WorldPlay 1.5 的后训练中同时提升动作执行与视觉质量。
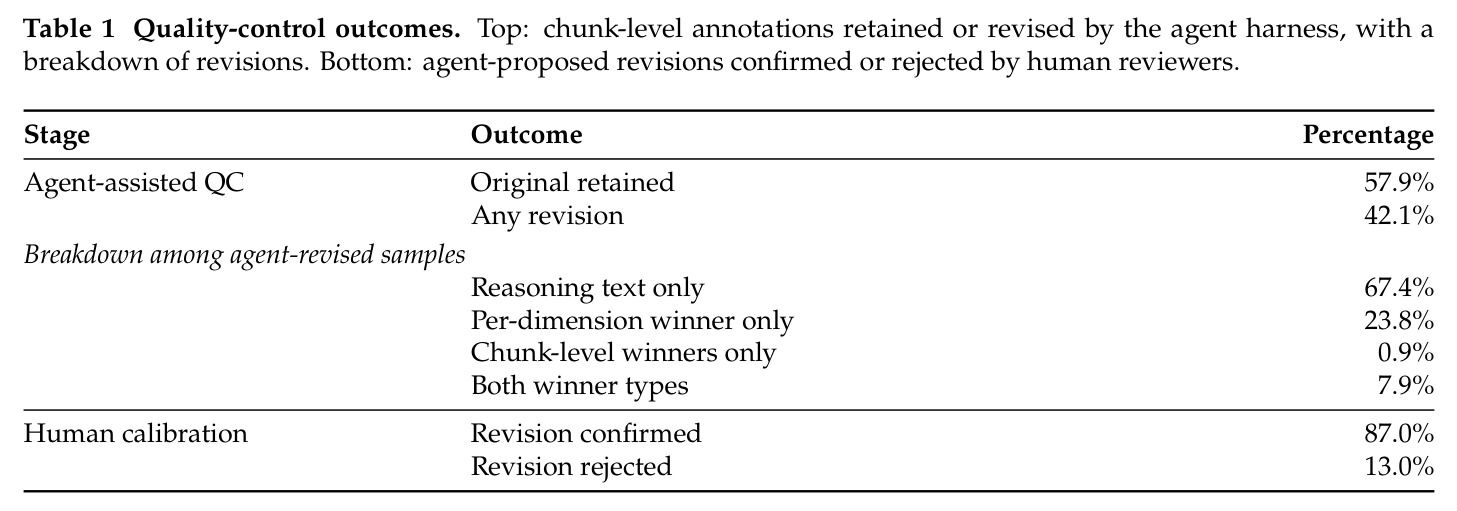
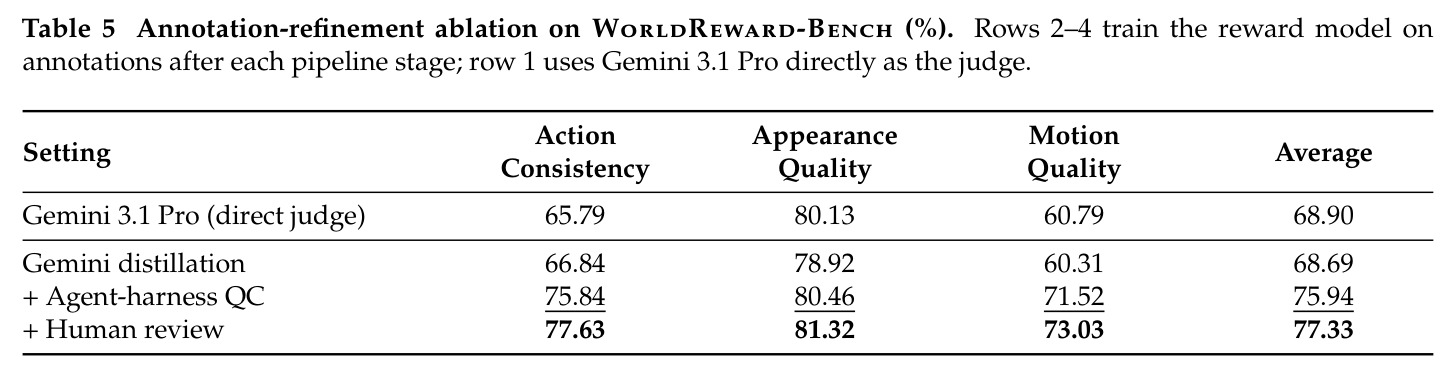
与已有工作不同的是,本文的独特切入是'局部到全局'的动作对齐分块推理。与几何奖励不同,动作偏好与质量偏好从同一套动作对齐视觉证据、由同一模型推理得出,天然共享解释空间(回应'同一视觉变化在不同指令下含义不同'的耦合难题);与整段 VLM 评审不同,它强制模型先在 4 动作一组的 chunk 内定位证据再下结论,投票聚合(式3)防止个别强/弱片段主导视频级判决;与逐帧评分不同,帧网格和动作面板保留了时间演化的视野。第二个独特发现是数据工程层面的:作者证明'蒸馏后精炼'而非蒸馏本身是超越教师的关键——Gemini 3.1 Pro 直接当裁判平均 68.90%,蒸馏后 68.69% 基本持平,而 GPT-5.5 agent 多轮工具审计把学生推到 75.94%,人工校准再至 77.33%,最终学生在三维度全面反超两位闭源教师。这一'agent 审计 + 定向人工复核'的标注质量控制范式本身即是贡献。
核心方法
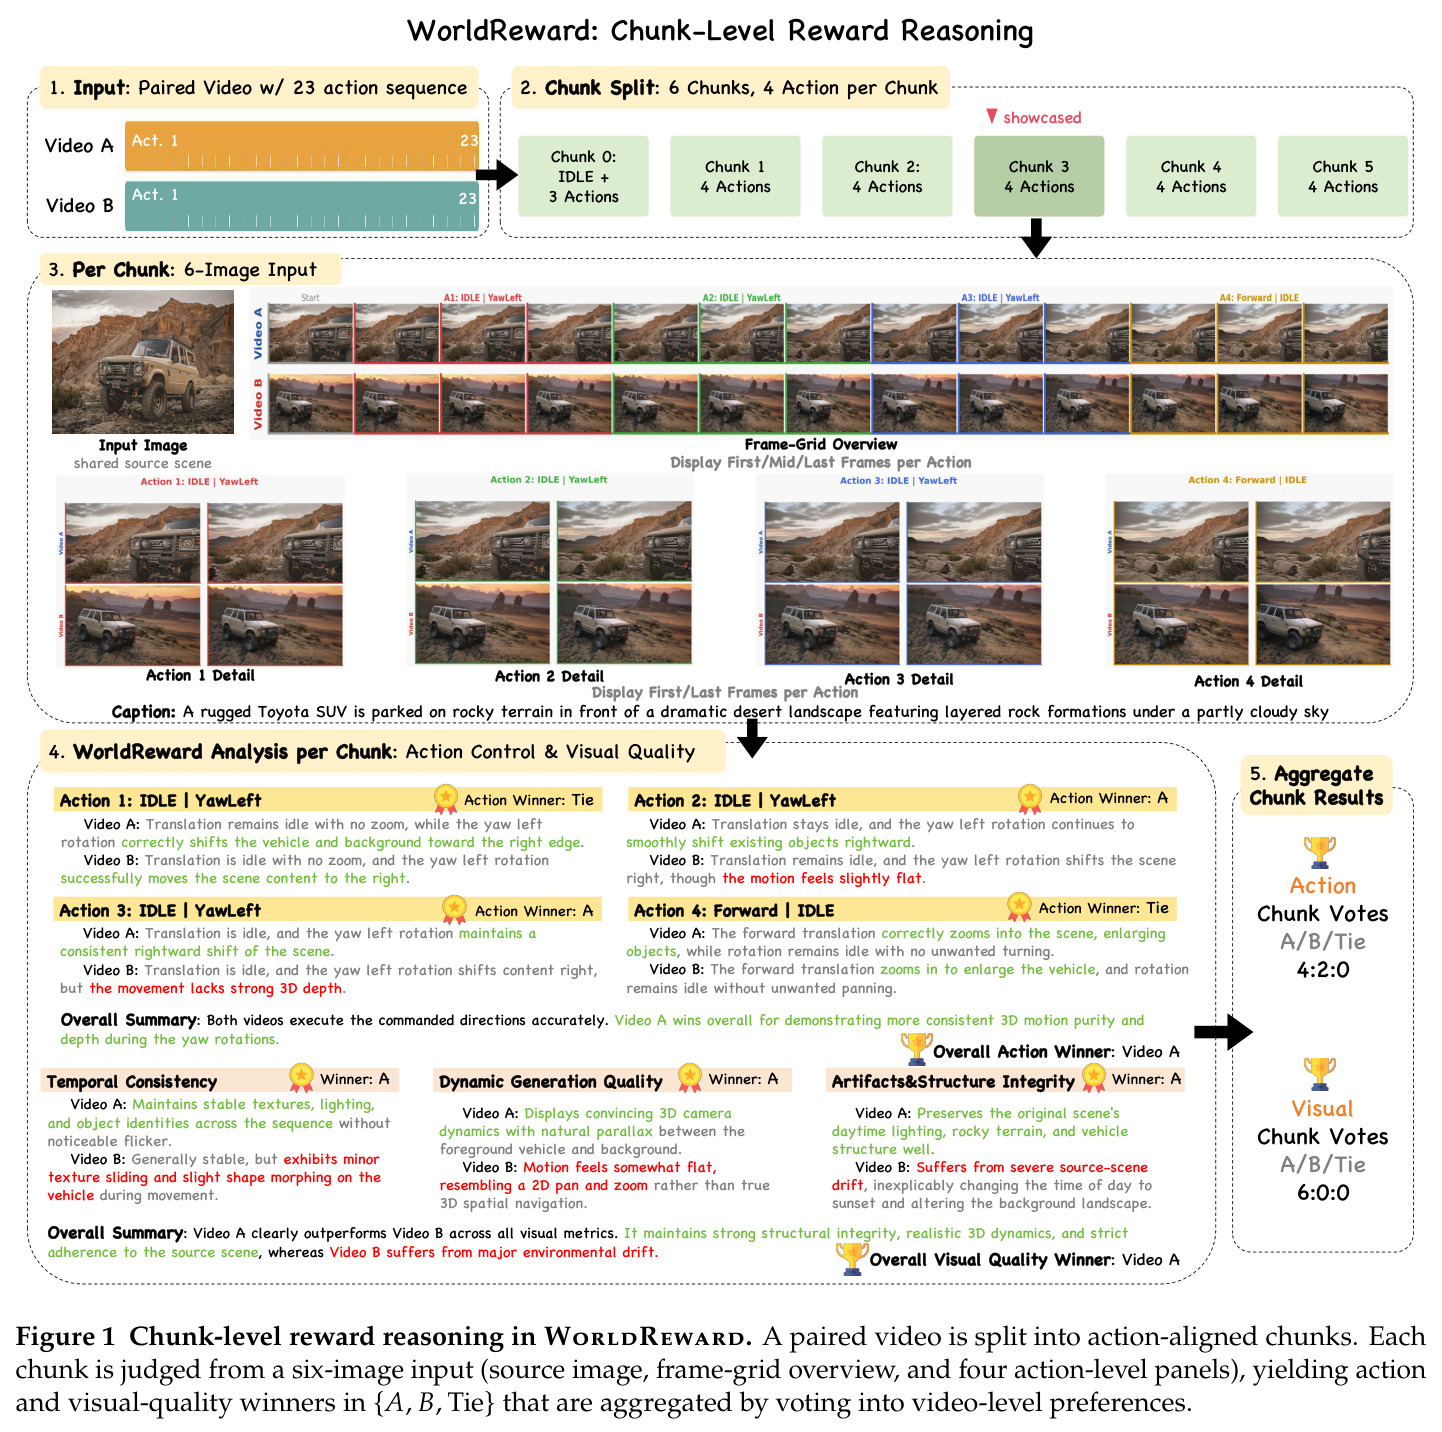
直觉出发点:相机动作留下方向特定的视觉证据——前进时内容逐渐放大,上仰时既有内容下移、新内容从顶部进入,这类证据最适合在'每动作前后几帧'的紧凑对比中验证,在长视频中会被稀释。技术路线分四层。第一层输入构造:轨迹前插入 idle 槽关联源帧,12 个动作槽划为固定 4 槽的 $K$ 个 chunk(式2),每 chunk 组装 6 图输入:源图 $x_0$、帧网格总览(每动作首/中/尾帧)、4 个动作级面板(首尾帧 A/B 对比)加 caption。第二层分块推理:先逐动作比较两视频局部转变是否符合指令方向,再从时间一致性、动态生成质量、伪影与结构完整性三方面评质量,输出动作与质量两个 $\{A,B,Tie\}$ 判决及推理文本。第三层投票聚合:按式(3)统计得票,多数胜出、平票为 Tie,得视频级 $R^{act}$ 与 $R^{vis}$。第四层训练与应用:Qwen3.5-9B 基座做 SFT(式4);RL 中按 Pref-GRPO 胜率(式6-7)转为归一化奖励,经 DiffusionNFT(式8-11)优化世界模型。
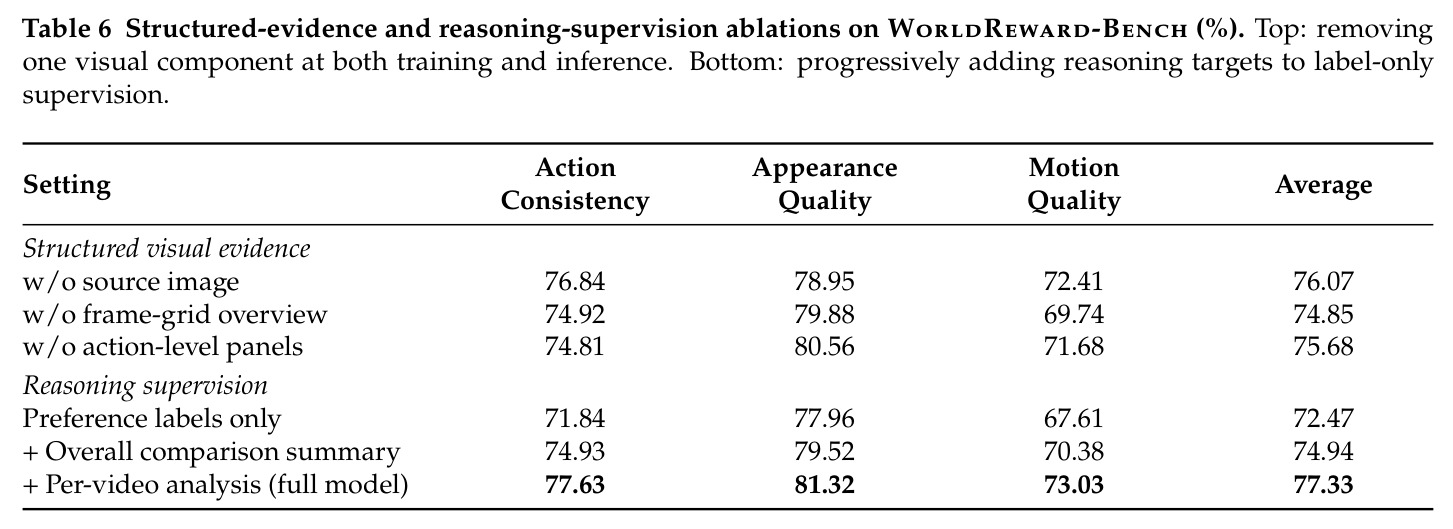
核心创新有四点,每点都与已有方法存在本质区别。其一,单一模型共享推理空间:动作一致性与视觉质量偏好由同一个 VLM 对同一套动作对齐证据推理产生,取代'3D 几何模型 + 图像评分器'的异构组合(WorldCompass 方案),使'同一视觉变化在不同指令下是好是坏'的耦合判断在共享解释中完成。其二,chunk 化的局部证据定位:把长视频对拆成 4 动作/块的紧凑单元,短促的局部动作转变(几帧内完成)得以被定位、验证并归因到具体动作段,直接回应整段 VLM 评审中'局部失败被全局印象稀释'的痛点。其三,6 图结构化证据各司其职——源图锚定场景身份以检测源场景漂移,帧网格展示 chunk 时间演化以判断动态强度,动作面板直接关联指令与局部首尾帧转变;消融显示去掉任一组件都降低与人类的一致率(去帧网格平均 -2.48 点最大)。其四,分层推理监督:先逐动作对比、再三维度分析、后总体总结的监督结构比纯偏好标签高 4.86 个百分点,说明'教会模型看什么'与'教它怎么比较'缺一不可。
方法步骤详情
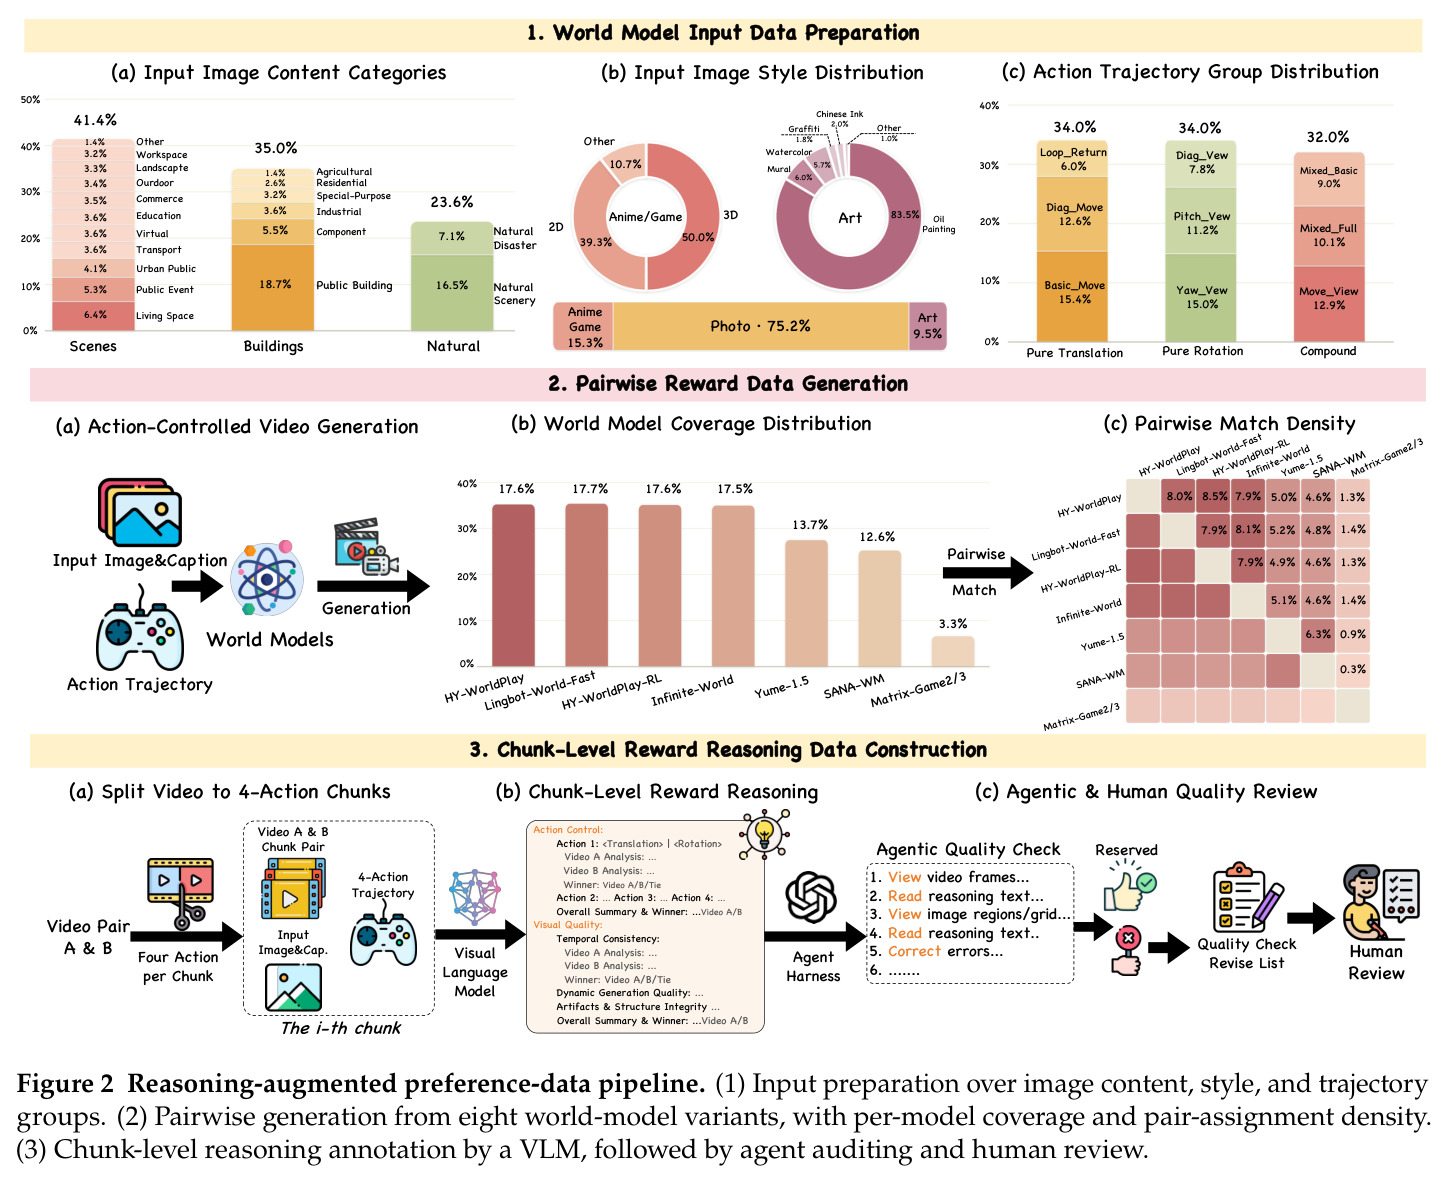
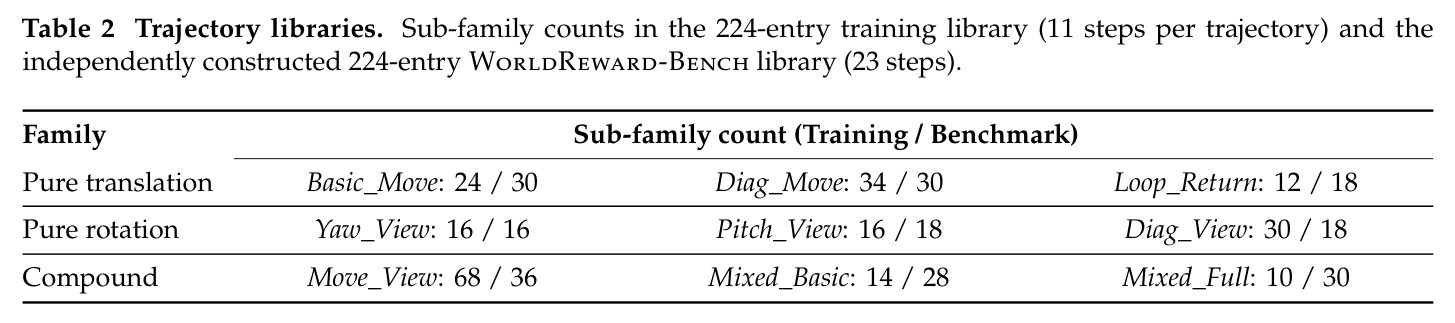
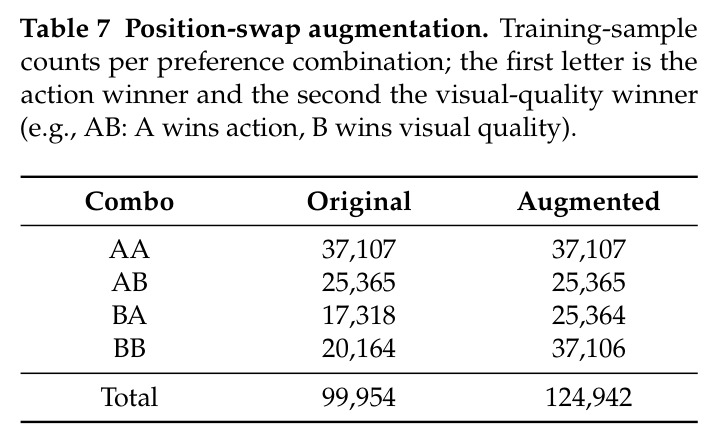
流程四步。一、数据生成:WorldPlay 图文对配 224 条 11 步轨迹(平移/旋转/复合三大类九个子类),用 HY-WorldPlay、LingBot-World-Fast、Yume-1.5、SANA-WM、Matrix-Game2/3 等 8 个变体在同条件下生成 50,000 对 15fps 视频;加 idle 槽后 12 槽分 3 chunk,采至约 10 万并交换增广至 124,942。二、标注质控:Gemini 3.1 Pro 蒸馏 chunk 级结构化推理与偏好;GPT-5.5 agent 按 Algorithm 1 多轮调用图像工具审计,自适应查看面板并可回看,必要时输出定位到 chunk×维度的 diff;被改样本交人工校准,87.0% 被确认。三、训练:Qwen3.5-9B 初始化,SFT 3 epochs,batch 128,学习率 $8\times10^{-6}$。四、RL:每组 $G$ 个候选两两配对送入 WorldReward,按式(6)(7)转胜率 $R^m_i$,组内标准化,按式(9)融合成最优性概率 $p_i$,用负感知流匹配损失(式11)更新。
技术新颖性
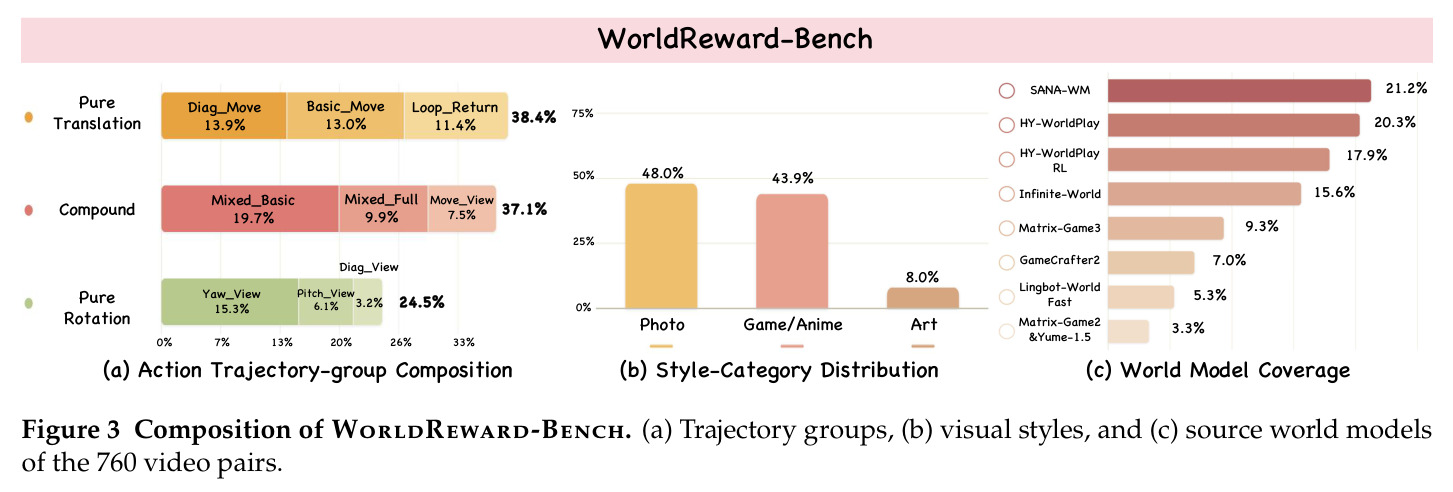
新颖性有四层面。问题定义上,这是首个为相机条件化世界模型统一动作一致性与视觉质量的 VLM 成对奖励模型:ReWorld、Reward-as-an-Agent 面向具身任务生成,WorldCompass 依赖几何加图像两套异构系统,VideoAlign/UnifiedReward 不通条件化指令。范式上,'chunk 级证据定位+投票聚合'区别于整段 VLM 评审和逐帧评分,显式建模'指令动作→局部视觉转变'的因果对应,三向判决加多数决保证局部失败可归因、局部优势不越权。数据工程上,agent-harness QC 是对单轮 API 评审的实质改进:审计 agent 自适应决定查看顺序、可回看证据、输出可追溯 diff,使标注质量从蒸馏的 68.69% 跃至 75.94%(+7.25 点),让学生反超 GPT-5.5 直接当裁判的 74.21/79.87/69.47,证明精炼是优势主因。评测上,WorldReward-Bench 以 760 对人工标注、三维度独立打标、Tie 为显式标签的三向准确率协议,填补该领域无专用基准的空白。
实验结果
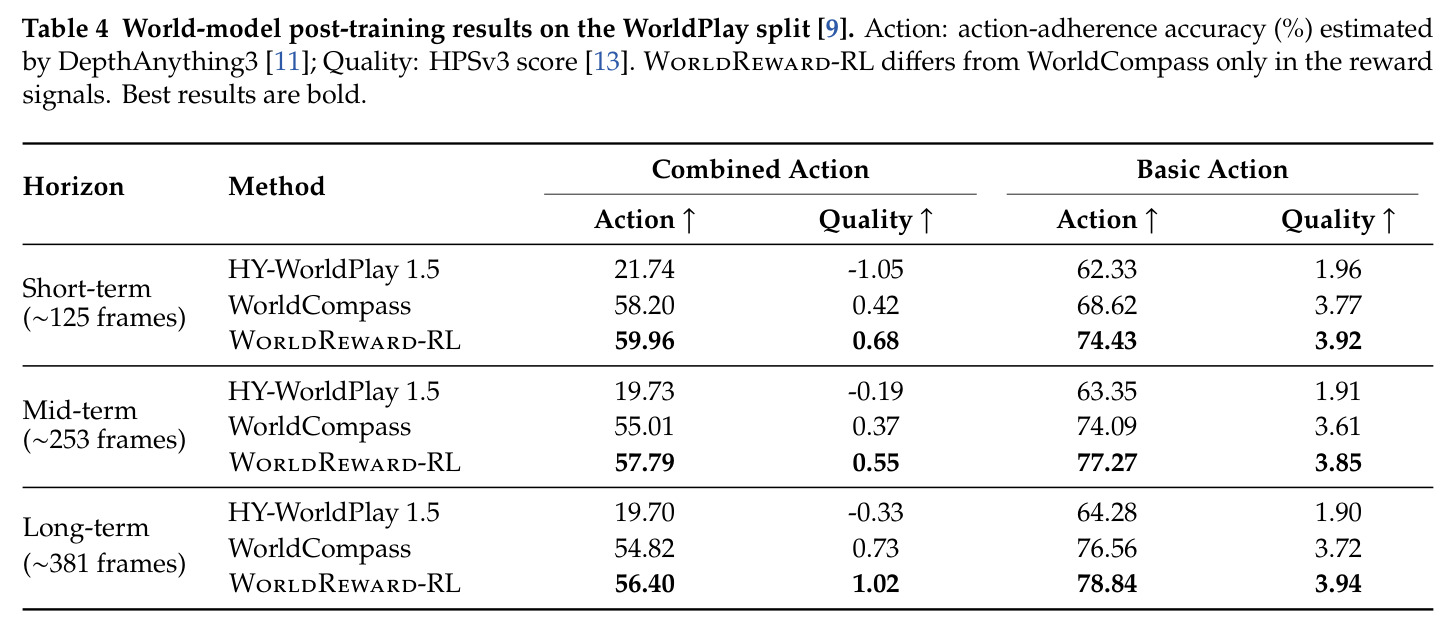
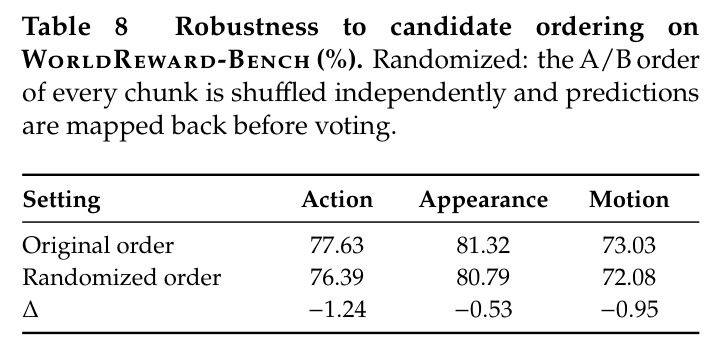
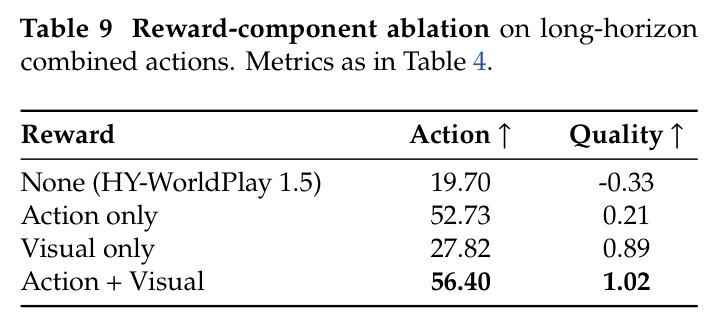
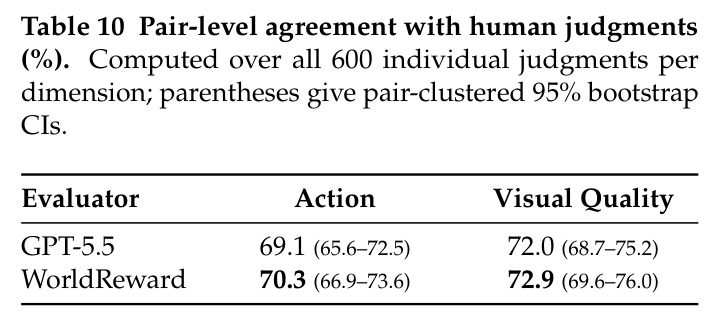
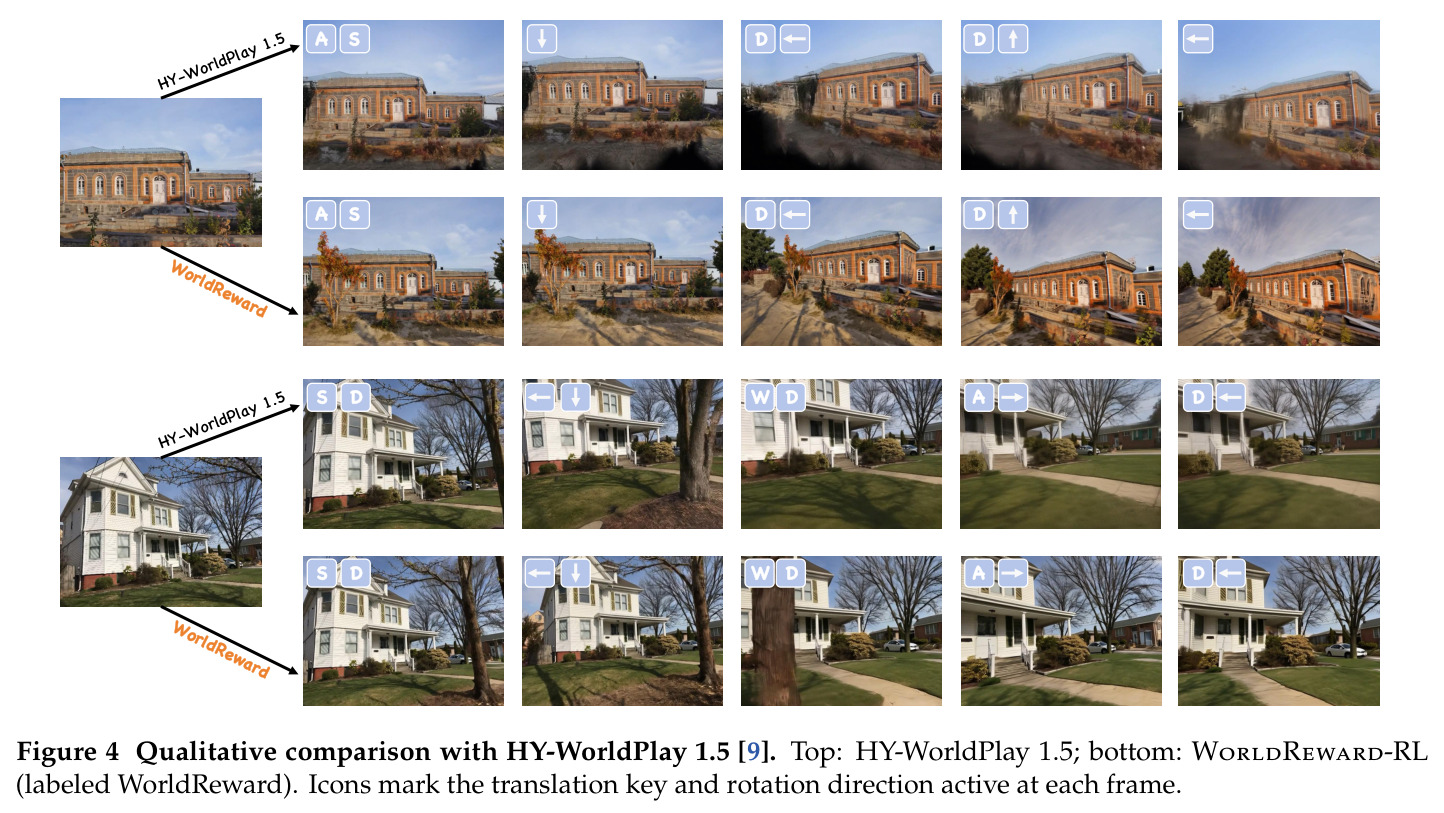
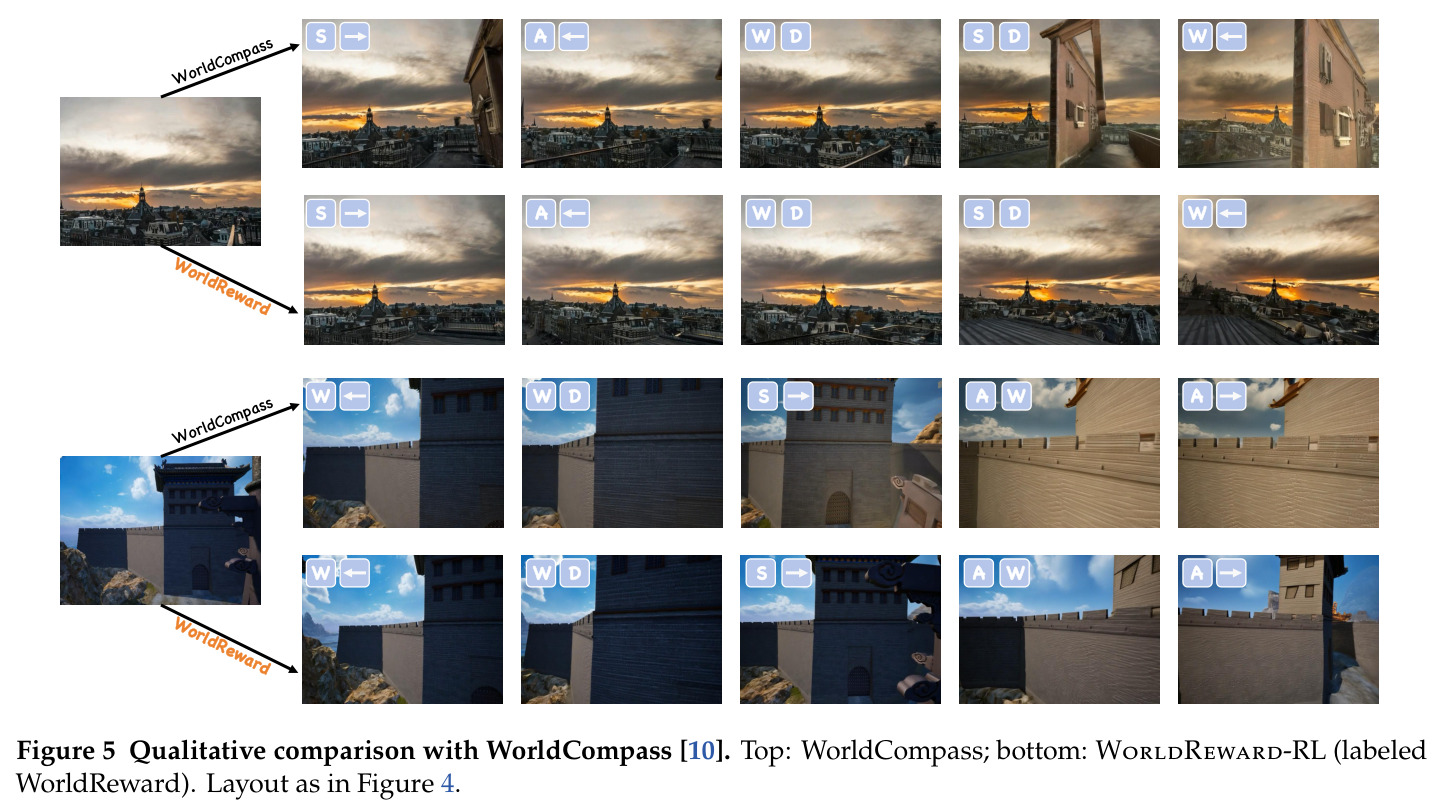
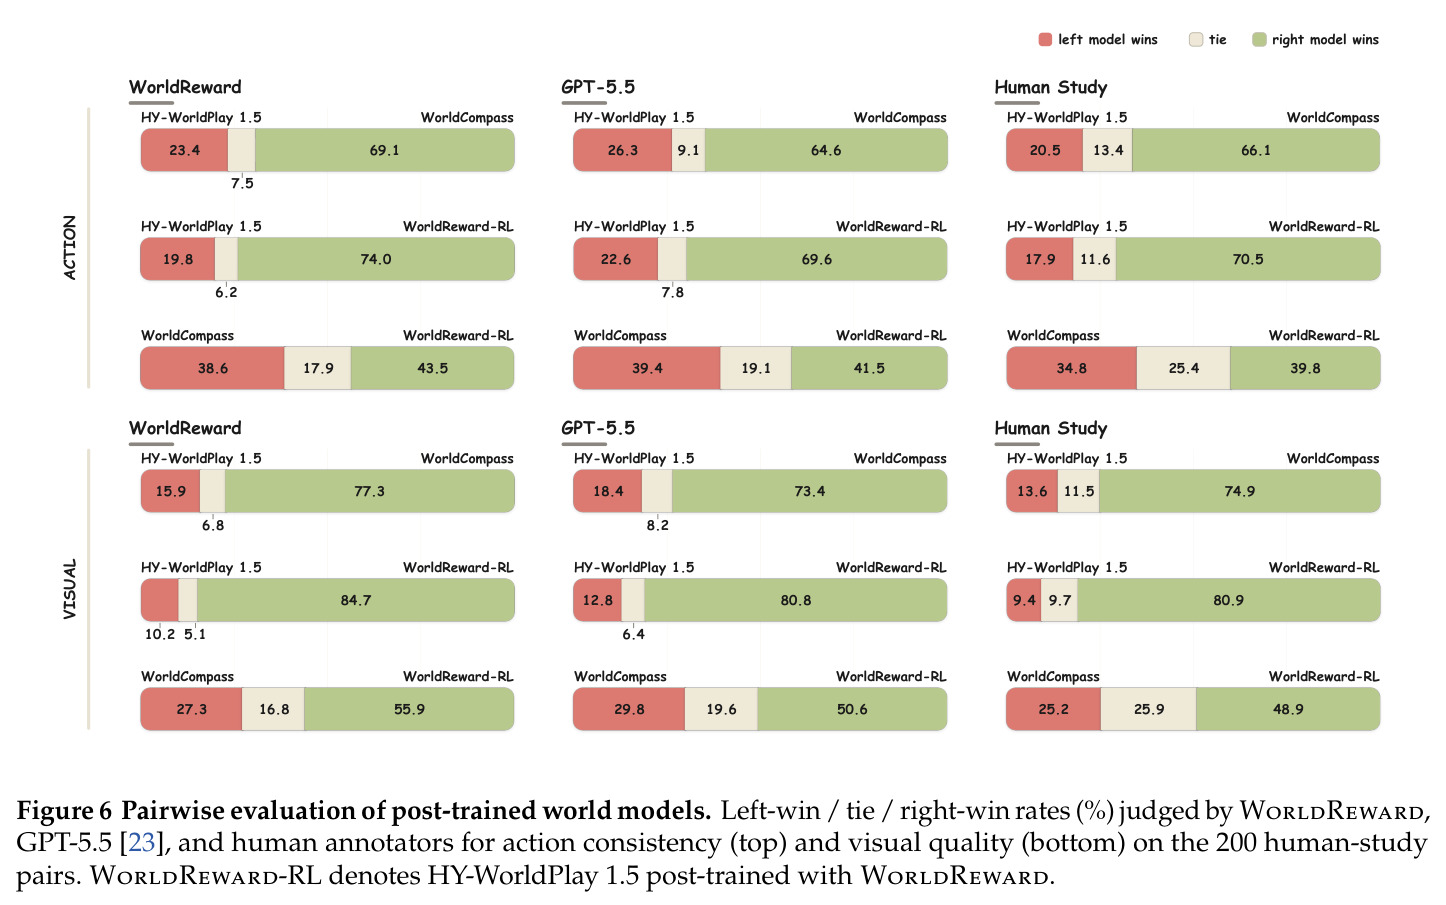
核心发现。(1) 基准(表3):三向一致率 77.63/81.32/73.03(动作/外观/运动)全面第一,超 GPT-5.5(74.21/79.87/69.47)3.42/1.45/3.56 点;几何基线 DAv3 动作 70.53、HPSv3 外观 73.68;基座 Qwen3.5-9B 近随机(44-48),27B 外观跌至 44.34,规模替代不了任务设计。(2) 泛化:复合轨迹动作 81.56、旋转组外观 86.02 最高,game/anime 全领先。(3) RL 后训练(表4):只换奖励,组合动作从 WorldCompass 的 58.20/55.01/54.82 提至 59.96/57.79/56.40,基础动作最高 78.84,HPSv3 全升;基座组合动作仅约 20。(4) 消融:agent QC 贡献最大(68.69→75.94),人工再 +1.39;纯标签仅 72.47。(5) 奖励分量(表9):action-only 52.73、组合 56.40,互补。(6) 人对照:pair 级一致率动作 70.3%、视觉 72.9% 与 GPT-5.5 相当。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 动作一致性偏好判断(WorldReward-Bench,760对) | 三向偏好准确率(%, Tie为显式标签) | 77.63 | GPT-5.5 74.21 / Gemini 3.1 Pro 65.79 / DAv3 70.53 | +3.42 (vs GPT-5.5) |
| 外观质量偏好判断 | 三向偏好准确率(%) | 81.32 | GPT-5.5 79.87 / HPSv3 73.68 | +1.45 (vs GPT-5.5) |
| 运动质量偏好判断 | 三向偏好准确率(%) | 73.03 | GPT-5.5 69.47 / Gemini 3.1 Pro 60.79 | +3.56 (vs GPT-5.5) |
| RL后训练·长期(~381帧)组合动作(WorldPlay split) | 动作遵从准确率(%, DAv3轨迹估计) | 56.40 (WorldReward-RL) | WorldCompass 54.82 / HY-WorldPlay 1.5 19.70 | +1.58 (vs WorldCompass), +36.70 (vs 基座) |
| RL后训练·长期基础动作 | 动作遵从准确率(%) | 78.84 | WorldCompass 76.56 / 基座 64.28 | +2.28 (vs WorldCompass) |
| RL后训练·长期组合动作视觉质量 | HPSv3 分数 | 1.02 | WorldCompass 0.73 / 基座 -0.33 | +0.29 (vs WorldCompass) |
局限与改进
作者承认或暗示的局限:其一,RL 验证只在 HY-WorldPlay 1.5 与 WorldPlay split 上做,尽管训练数据覆盖 8 个世界模型,'作为奖励有用'的外部效度依赖单一模型与协议;其二,三向一致率仍在 73-81% 区间,约四分之一判断与人不一致,旋转组运动 64.52、art 风格运动 65.57 短板明显;其三,标注依赖 Gemini 3.1 Pro 与 GPT-5.5 两个闭源模型,成本与可复现性受限;其四,轨迹库为人工策划的 224+224 条,未涉及真实交互的连续输入、碰撞与物体操控;其五,论文未系统研究长程 RL 中 VLM 奖励被 reward hacking 利用的风险。我的补充观察:评估循环有部分自我印证——DAv3 既是 WorldCompass 几何奖励的来源又是动作指标,WorldReward-RL 的动作增益以 DAv3 度量,好在人类盲评与 GPT-5.5 交叉验证缓解了担忧;此外评测时程最长约 381 帧(15fps),相对长时程世界模拟仍属短程;chunk 固定 4 动作的划分也是启发式,未讨论对不同节奏内容的适应性。
独立分析的弱点
独立分析的弱点及改进方向:(1) chunk 固定 4 动作且投票无权重(式3),含快速复合动作的 chunk 与平稳 chunk 等权,错误无法归因到具体动作或帧——可引入动作级信用分配或置信度加权聚合。(2) 数据管线重度依赖两个闭源教师,其系统性偏差(如风格偏好、Tie 倾向)可能进入 12.5 万样本——可用开源教师交叉验证或双教师一致性过滤。(3) 外观/运动到三准则的映射规则(时间一致性+结构→外观、动态质量→运动)为人工设定,与人类直觉边界未必一致——可让人类直接对三准则打标来学习映射。(4) RL 实验仅报告 4,000 条件、固定 $\lambda$ 的单次训练,未展示动作/视觉权衡系数与组大小 $G$ 的敏感性,也无长训练曲线观察奖励过优化。(5) 只覆盖相机控制族,对键盘语义动作、物体操控无证据组织方案,扩展需为每类控制重定义'方向特定视觉证据'。(6) 人类盲评规模有限(200 对、600 判决/维),置信区间宽约 6-7 点,vs WorldCompass 动作 39.8 vs 34.8 的差异显著性处于边缘。这些属工程与协议层面的可修复问题,不动摇核心结论。
未来方向
作者方向隐含在结论中:推广到更多世界模型与更长时程。基于成果可延伸:(1) 可微或权重化的 chunk 聚合——把式(3)硬投票换成软聚合,实现轨迹级到动作级的稠密信用分配,服务稀疏奖励长时程 RL;(2) 奖励鲁棒性与反 hacking——用基准式人工标注循环做持续校准,检测长 RL 中策略'讨好评审'的利用模式;(3) agentic reward——把训练期 agent 审计迁移到推理期,让奖励模型在低置信 chunk 上自适应回看高分辨率证据或多轮复核;(4) 控制类型扩展——为键盘语义动作、物体物理交互定义类比的动作-视觉证据面板,验证 chunk 范式的可迁移性;(5) 与几何信号互补——WorldReward 已超 DAv3,但几何奖励可验证、难 hack,可作正则项与 VLM 奖励融合并研究最优配比;(6) 数据范式模板化——'蒸馏→agent 审计→定向人工校准'三段式管线可推广到 3D 生成、图像编辑等偏好数据稀缺领域,并研究各阶段成本-收益曲线。
复现评估
复现评估:(1) 开源——有项目主页(codegoat24.github.io/WorldReward),正文未明确承诺代码权重开源;基座 Qwen3.5-9B 为开源权重,SFT 易实现;RL 依赖 DiffusionNFT 与 HY-WorldPlay 1.5/WorldCompass 框架,权重可得性需确认。(2) 数据——训练 5 万对与基准 760 对需调用 8 个世界模型变体自行生成,多款模型及 Gemini、GPT-5.5 教师均闭源或受限,完整复刻管线成本高;但 224+224 条轨迹库及九子类分类学在表2 完整可重建。(3) 算力——9B 模型 SFT 3 epochs 单节点多卡 A100/H100 可承受;RL 涉及 4,000 条件×组采样的世界模型训练加逐对 VLM 评审,需相当规模 GPU 集群。(4) 难度——若开源权重数据,复现表3评测较容易;复现 RL 需同时掌握世界模型推理与 VLM 批量评审,难度中上;从零复刻数据管线最难,瓶颈在闭源依赖而非算法;式(1)-(11)与 Algorithm 1 描述完整,无隐藏细节。
论文图表