LEASH:面向计算机使用智能体的不确定性感知弱到强升级与监督 LEASH: Uncertainty-Aware Weak-to-Strong Escalation and Oversight for Computer-Use Agents
用弱模型隐状态不确定性同时驱动升级决策与强模型监督,免训练。
前置知识
计算机使用智能体 (Computer-Use Agent, CUA)
将自然语言指令和屏幕截图等视觉观察翻译成可执行 GUI 操作(点击、键入、滚动)的智能体。任务常是长视界的:执行数百步、平均可超过一小时,例如在 LibreOffice 中安装扩展。执行循环为「观察屏幕→生成动作→执行→更新历史」。
本文的应用场景与实验载体就是 CUA,所有实验在 OSWorld 上进行。理解 CUA 的执行模型(逐步观察-动作循环、终态判定成败)是理解步级不确定性监控与升级时机设计的前提。
弱到强升级 (Weak-to-Strong Escalation, W2SE)
一种推理时资源分配范式:廉价的弱模型(小型开源权重模型)默认执行任务,当检测到失败风险时把控制权连同上下文移交给强模型(前沿闭源模型),由强模型完成剩余步骤直至任务结束。它与训练时的弱到强泛化(弱监督教强模型)不同,本质是推理时的顺序资源分配问题。
本文把 W2SE 形式化为预算约束的序贯停止问题:$\max_\pi \mathbb{E}_{x\sim\mathcal{D}}[S_\pi(x)]\ s.t.\ \Pr[t_\pi^{esc}(x)<T]\le p_{esc}$,这一优化目标贯穿全文,包括阈值校准和理论分析。
Mahalanobis 距离与共享协方差高斯判别 (池化 LDA)
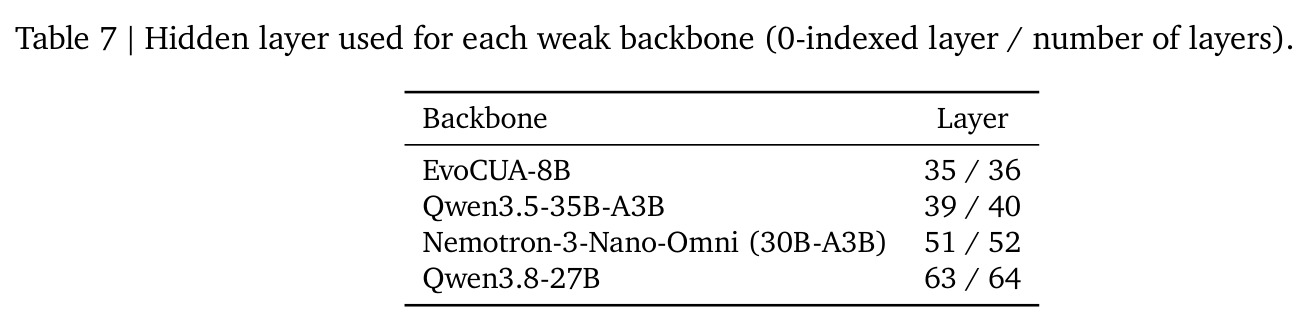
考虑类别协方差的距离度量 $d^2(h)=(h-\mu_y)^\top\Sigma^{-1}(h-\mu_y)$。当各类共享协方差时等价于线性判别分析(LDA),判别分数与类后验对数几率成线性关系。本文对特征级标准化后的隐状态拟合正则协方差 $\Sigma_{c,\lambda}=\hat{\Sigma}_c+\lambda_c I$,只需均值与一次 SVD,无梯度训练。
不确定度分数 $u_c(h)=d^2_{c,\text{Pass}}(h)-d^2_{c,\text{Fail}}(h)$ 完全建立在这个度量上,且命题 1 的最优性证明依赖 LDA 恒等式(分数正比于失败对数几率)。不懂 Mahalanobis 距离就读不懂方法核心与理论。
AUROC(ROC 曲线下面积)
衡量二分类评分器判别力的指标:随机取一个正例和一个负例时正例得分更高的概率。0.5 等于随机猜测,1.0 为完美区分。在不确定性估计中,它衡量「失败样本的不确定度是否系统性高于成功样本」。
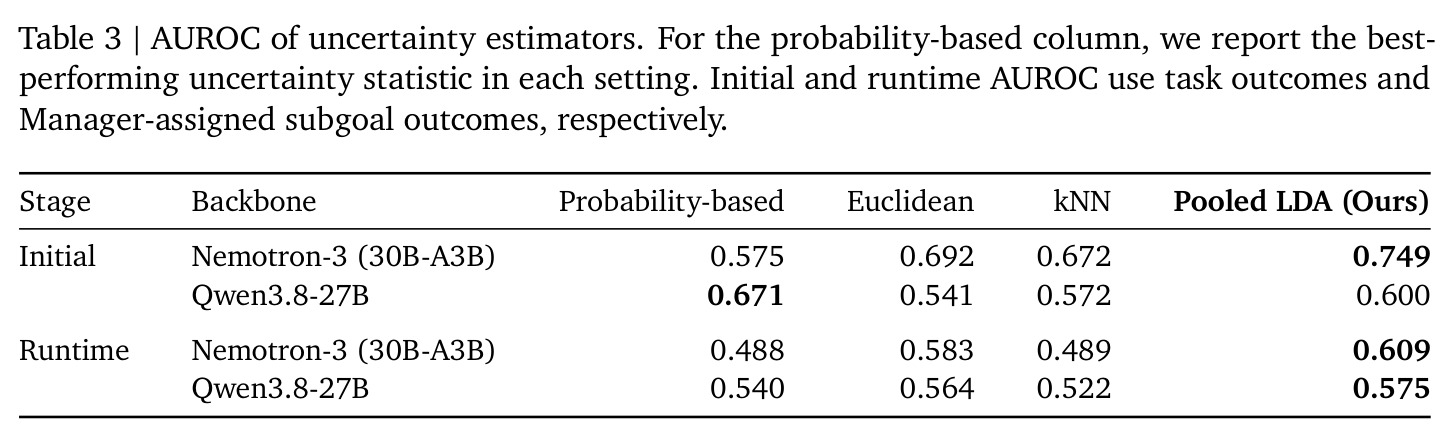
论文用任务分组交叉验证 AUROC 来选择正则系数 $\lambda_c$,表 3 用 AUROC 对比概率基线、欧氏距离、kNN 与池化 LDA 的不确定性质量,是评估信号好坏的核心指标。
OSWorld 基准
面向真实操作系统的计算机使用评测:智能体在真实 Ubuntu 环境和办公软件(LibreOffice、浏览器、邮件客户端等)中执行任务,以最终屏幕状态自动判定任务成败,任务多为长视界的多步自动化操作。
全部主实验在该基准上报告,表 1 的成功率与每任务成本数字(如 73.66%、$0.4117)都需在「任务级终态判定、数百步执行」的背景下解读,才能理解成本优化的实际意义。
研究动机
计算机使用智能体要执行动辄数百步、平均超过一小时的长视界任务,若每一步都运行 Claude Opus 5 这样的前沿闭源模型,推理成本会非常高(全时 Opus 每任务 $0.5094);而单独用小型开源模型又难以胜任(EvoCUA-8B 在 OSWorld 上仅 42.37% 成功率),形成精度与成本的两难。弱到强升级(W2SE)让弱模型默认执行、必要时才交棒给强模型,但「何时升级」是核心难题:已有方案要么再养一个监控智能体逐步校验(每步额外推理开销大),要么在标注轨迹上训练监控模块(引入数据标注与训练阶段);免训练的不确定性方法又依赖外部知识库、另一个参考模型或每步多次采样,在真实长视界任务中不可行。此外升级并非一劳永逸:强模型接手后仍可能陷入重复动作循环或迷失,但闭源 API 不暴露内部状态,口头自信度在长视界演化上下文中又不可靠,交接后缺乏有效的监督手段。
本文的目标是本文的目标是把弱到强升级形式化为预算约束下的序贯停止问题:在升级率预算 $\Pr[t_\pi^{esc}(x)<T]\le p_{esc}$ 的限制下最大化任务成功率 $\mathbb{E}_{x\sim\mathcal{D}}[S_\pi(x)]$,并同时回答两个被忽视的问题——(1) 弱模型何时该把控制权交给强模型(任务开始前的初始路由 + 执行中的步级升级);(2) 交棒之后谁来继续监督无法窥视内部的黑盒强模型。作者希望找到一个足够便宜、能在每一步都计算的不确定性信号,用同一信号驱动任务级路由、步级升级和交接后监督三层机制,且完全免训练、不增加额外前向传播、不引入辅助监控网络,最终以低于全时强模型的成本逼近甚至超越其成功率。
与已有工作不同的是,本文的独特切入是把弱模型自身的隐状态当作免费的不确定性燃料:利用「LLM 在生成任何 token 之前,其表示中已内化任务成败可能性」这一经验事实,在少量留出任务上记录弱模型在查询 prompt 最后一个 token 和每步动作 token 位置的最终层隐藏态 $h_0, h_t$,配上任务级/子目标级成败标签构建参考库;测试时用带正则共享协方差的 Mahalanobis 距离衡量当前隐状态「离过去失败比离过去成功近多少」。与相对 Mahalanobis 距离(Ren et al.)减去类无关背景项不同,本文减去对侧结果距离,得到失败倾向的锐利差分信号。更进一步,同一信号在交接后被复用:弱模型转为影子观察者,以自己的动作格式读强模型轨迹继续打分,实现白盒看黑盒的持续监督——一个信号管升级与监督两件事。
核心方法
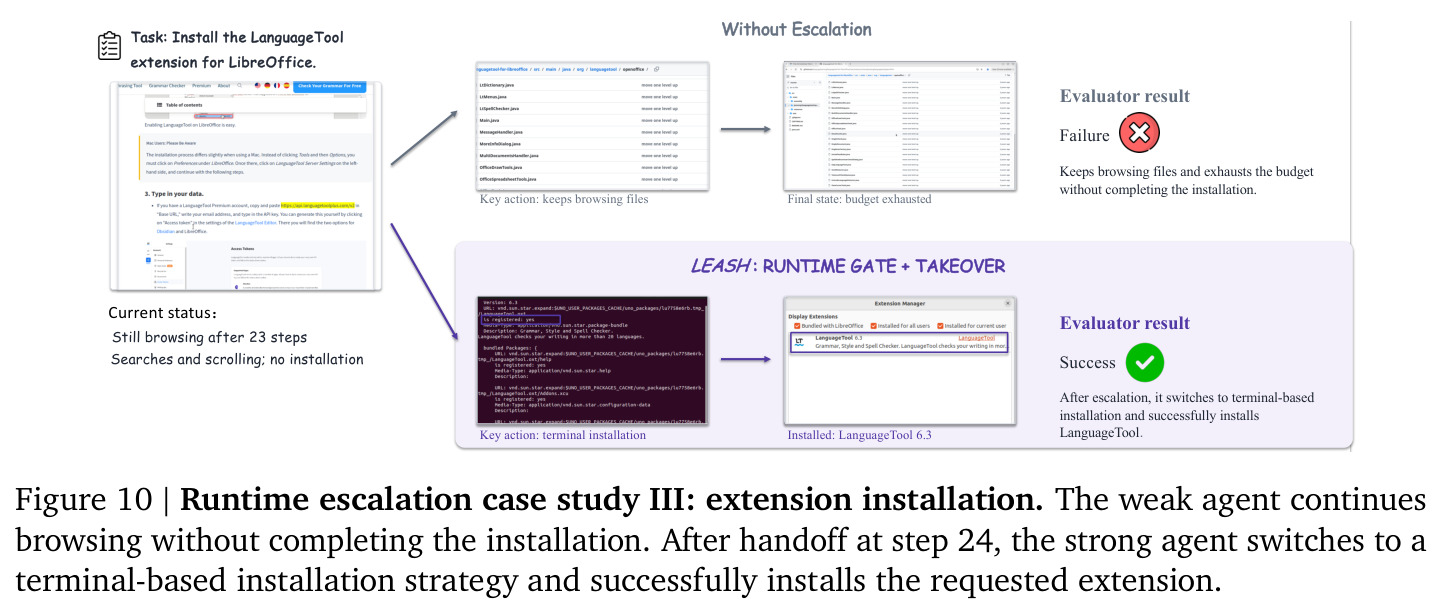
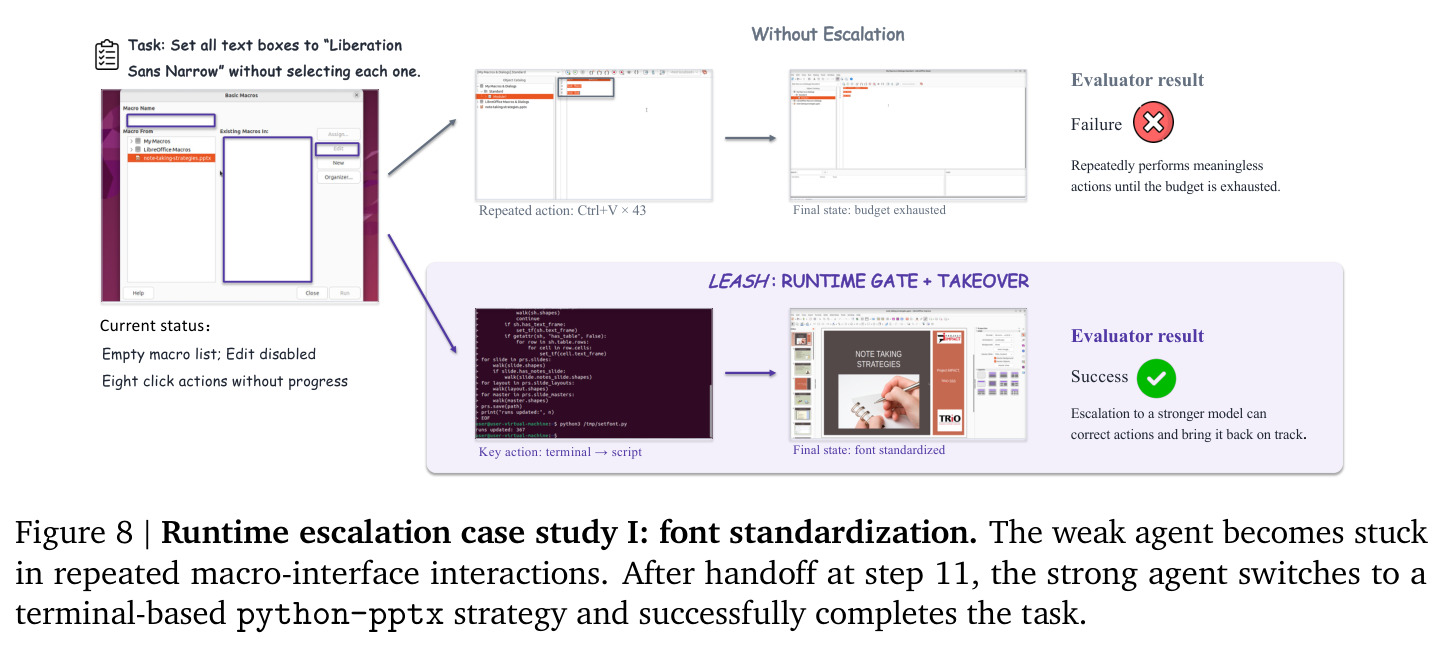
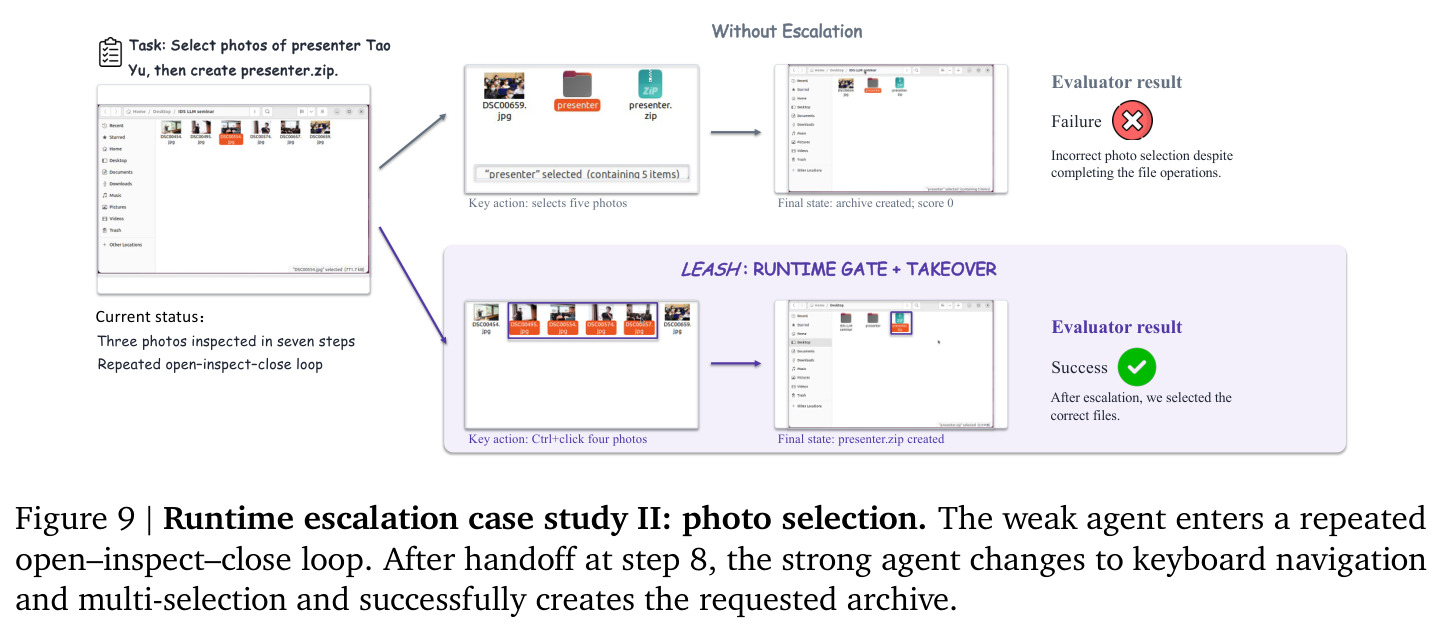
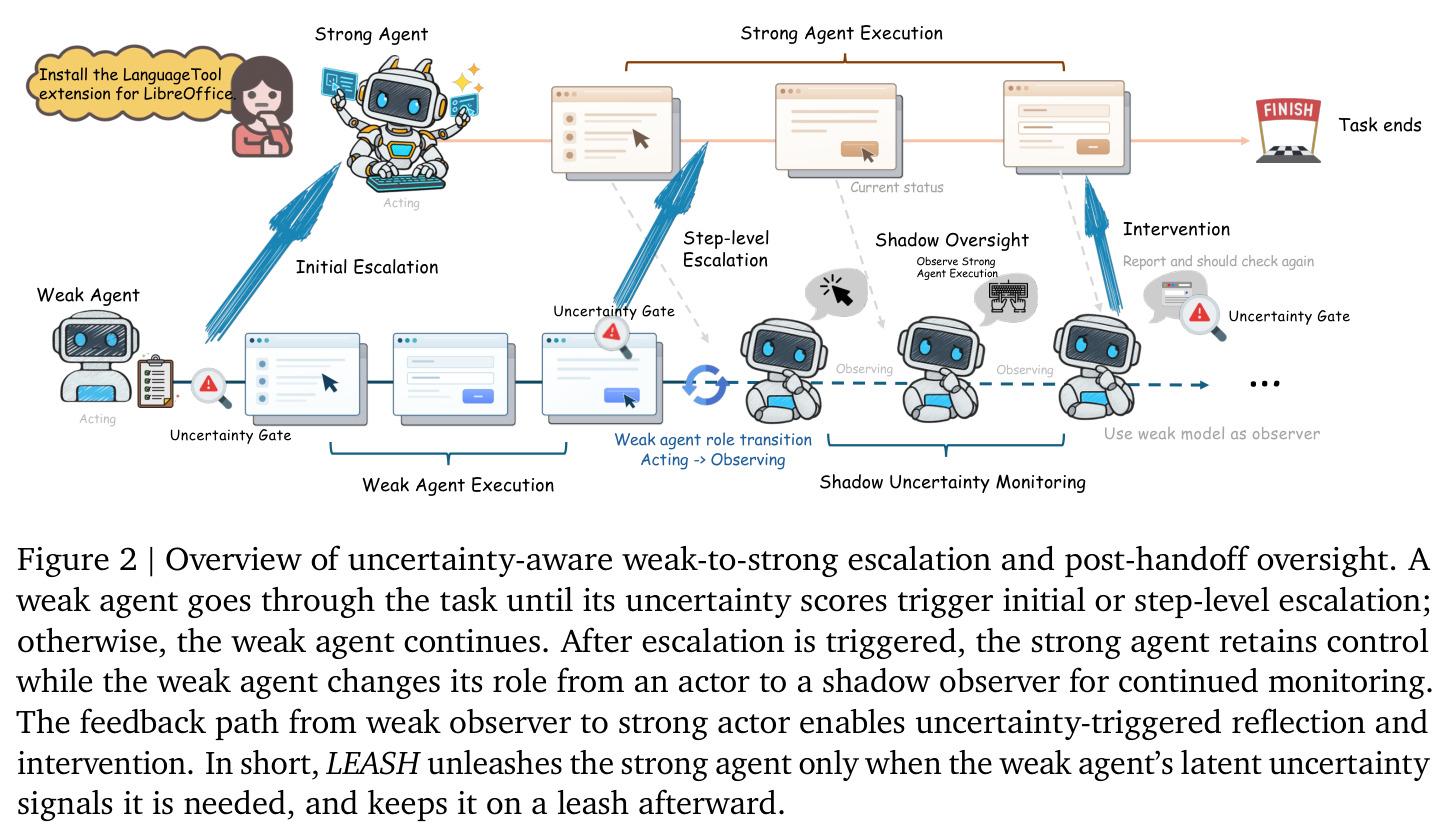
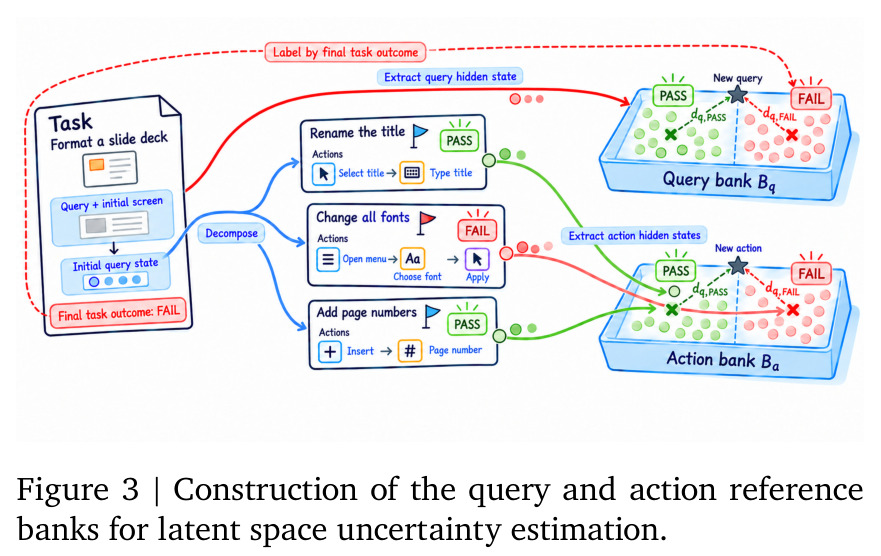
LEASH 分三层,直觉是:弱模型的隐状态已经「预感」到任务会不会失败,直接读出来即可,无需训练监控器。技术上先构建参考库:在少量留出任务上运行弱智能体,抽取查询表示 $h_0\in\mathbb{R}^d$(任务 prompt 最后一个 token)和每步动作表示 $h_t$(该步生成动作的最后一个 token),分别用任务结果和 Manager 智能体判定的子目标结果标注,得到查询库 $B_q=\{(h_{i,0},y_i)\}$ 与动作库 $B_a$。推断时初始门 $g_0=\mathbb{1}[u_q(h_0)>\tau_q]$ 在任务开始前把超出能力的任务直接路由给强模型;运行时门 $g_t=\mathbb{1}[u_a(h_t)>\tau_a]$ 在执行中一旦触发立即交棒,强模型拿到指令、当前截图和弱模型的近期步骤后接管到底。交棒后弱模型从行动者转为影子观察者,每 $k=3$ 步把强模型动作并入自己的历史并生成候选动作以抽取影子表示,$g^{sh}=\mathbb{1}[u^{sh}>\tau^{sh}]$ 触发对强模型的高推理力度反思干预。
核心创新有两点。第一是不确定性估计的「参考距离差分」设计:对参考库按特征级标准化 $z_c(h)=(h-\bar{h}_c)/s_c$,拟合共享协方差高斯判别模型 $\Sigma_{c,\lambda}=\hat{\Sigma}_c+\lambda_c I$,用 $u_c(h)=d^2_{c,\text{Pass}}(h)-d^2_{c,\text{Fail}}(h)$ 打分,值越大表示越接近失败参考。整个估计器复用动作生成时已经产生的激活值,零额外前向、零训练,只需均值与 SVD。理论命题 1 证明在共享协方差高斯假设下该分数(加常数后)正比于失败对数几率(经典 LDA 恒等式),Neyman-Pearson 交换论证表明固定升级率下没有其他基于 $z$ 的规则能抓住更多弱模型失败;当升级增益 $\Delta(z)=q_s(z)-q_w(z)$ 关于分数非降且 $q_s$ 为常数时还最大化成功率。第二是同一信号的双重复用:升级之后弱模型转为影子观察者监督黑盒强模型,弥补「升级不等于成功」的盲区。
方法步骤详情
流程分五步。(1) 离线建库:在留出任务上运行弱智能体采集轨迹,抽取 $h_0$ 与各步 $h_t$;Manager 智能体(Opus 5)把任务分解为带截图可验证标准的子目标并标注各段成败(通过为 Pass、需修订为 Fail、否则继承任务终态),存入 $B_q$ 与 $B_a$。(2) 拟合估计器:对每通道特征级标准化,按结果计算质心 $\mu_{c,y}$ 与池化正则协方差,一次 SVD 即可;$\lambda_c$ 用任务分组交叉验证 AUROC 逐骨干逐通道选取。(3) 阈值校准:$\tau_q=Q_{1-p_q}\{u_q(h_{i,0})\}$,$\tau_a=Q_{1-p_a}\{U_i\}$,其中 $U_i=\max_{1\le t\le T_i}u_a(h_{i,t})$,$p_a=(p_{esc}-p_q)/(1-p_q)$ 保证总升级率约等于预算;所有分数取折外值,最后在全库重拟合。(4) 在线执行:初始门路由→弱模型执行并逐步打分→运行时门触发即交棒,强模型接管至任务结束。(5) 影子监督:每 3 步查询一次,$u^{sh}$ 超参考库逐步分数 90 分位时丢弃强模型待执行动作并令其以更高推理力度反思重选;每任务最多 6 次干预,两次改变动作后停止。
技术新颖性
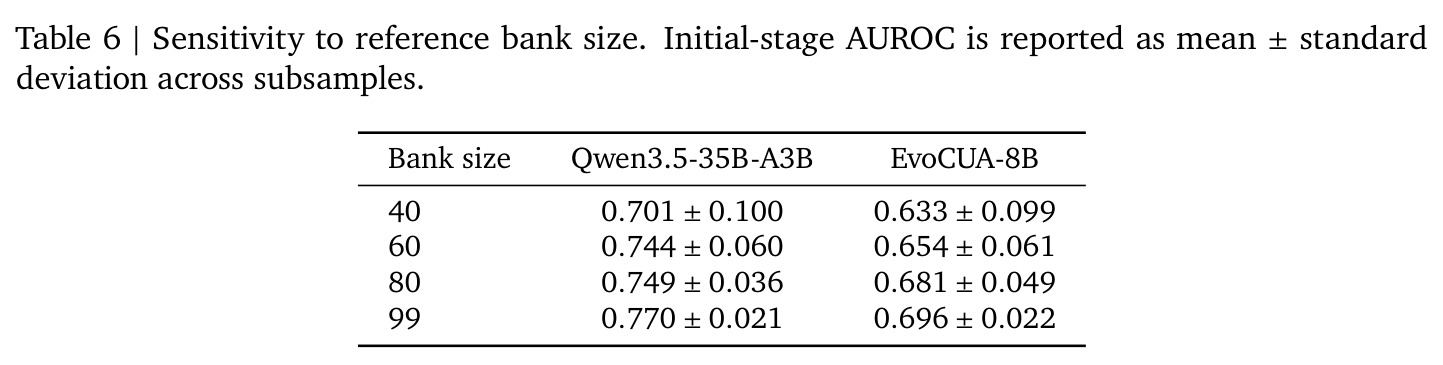
技术新颖性有四点。第一,视角转换:把 W2SE 从「监控问题」重构为预算约束的序贯停止问题,用弱模型失败风险作为升级期望收益的代理,并给出固定升级率下初始门的最优性证明(最大化 $\Pr(\text{escalated}\mid Y=\text{Fail})$),这在升级文献中是新的理论支撑。第二,估计器完全免训练且零额外前向:激活值在正常动作生成时已经产生,参考库还能随经验积累迭代更新(库从 40 扩到 99 时初始 AUROC 从 0.701 升到 0.770),天然适配递归自改进系统。第三,与相对 Mahalanobis 距离减去类无关背景项不同,本文减去对侧结果距离获得锐利的失败差分信号,为步级智能体监控量身定制。第四,影子观察者机制解决「白盒看黑盒」的不对称问题:弱模型以自己的动作格式复述强模型轨迹再抽隐状态,让闭源强模型也能被持续监控,不确定时回滚其动作并触发反思。
实验结果
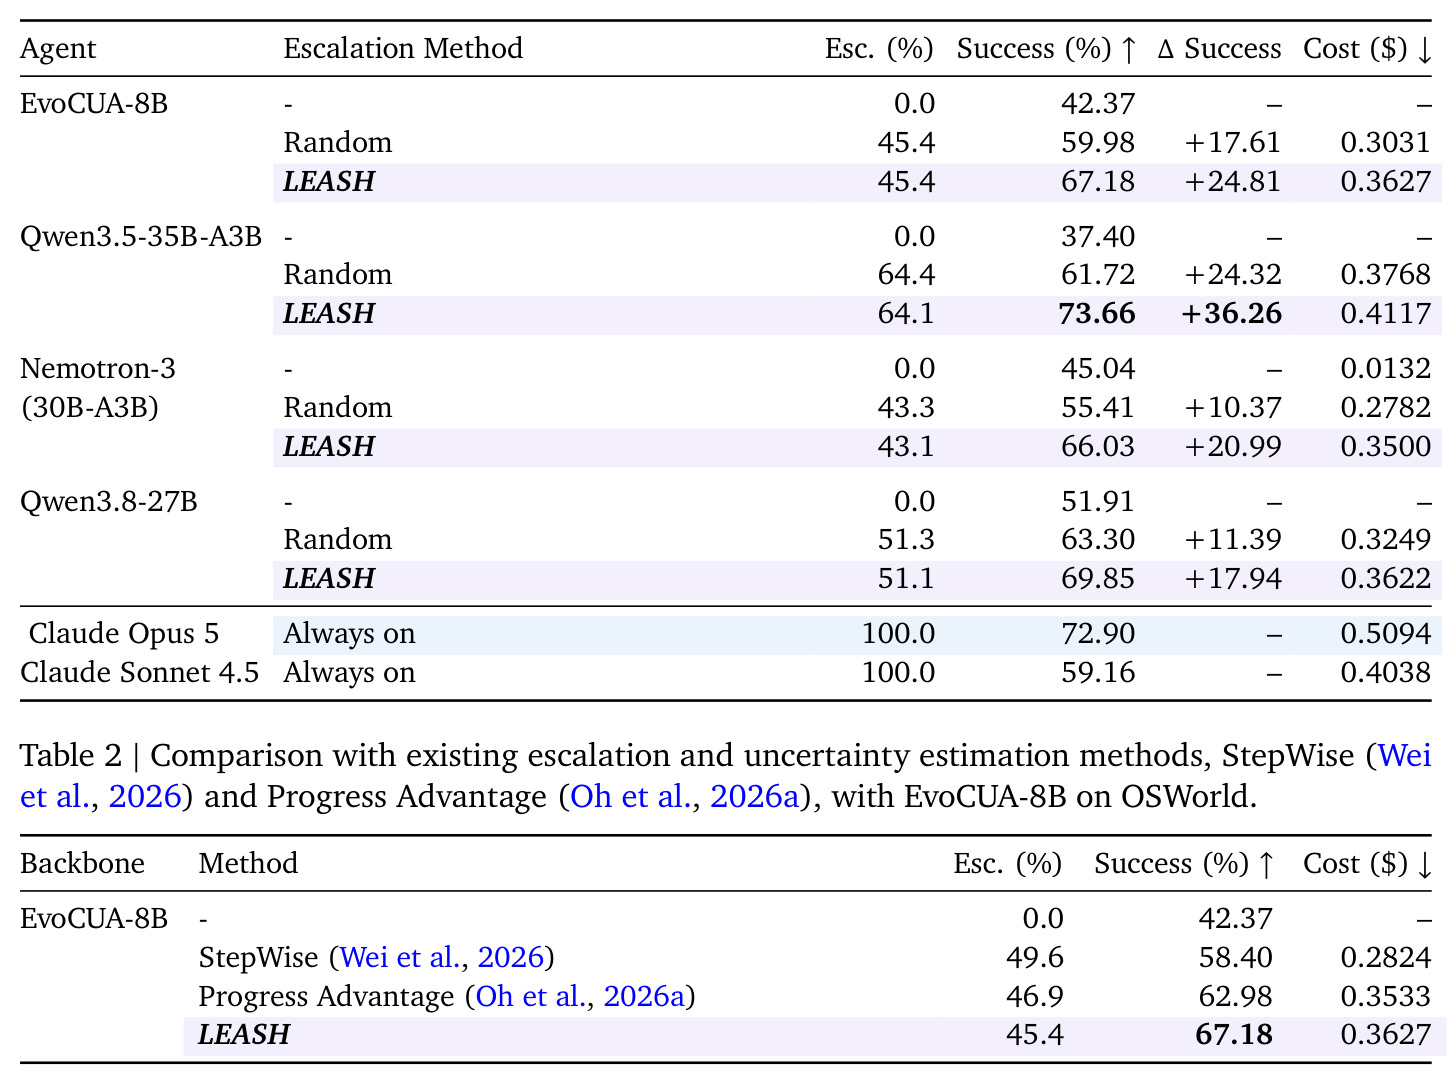
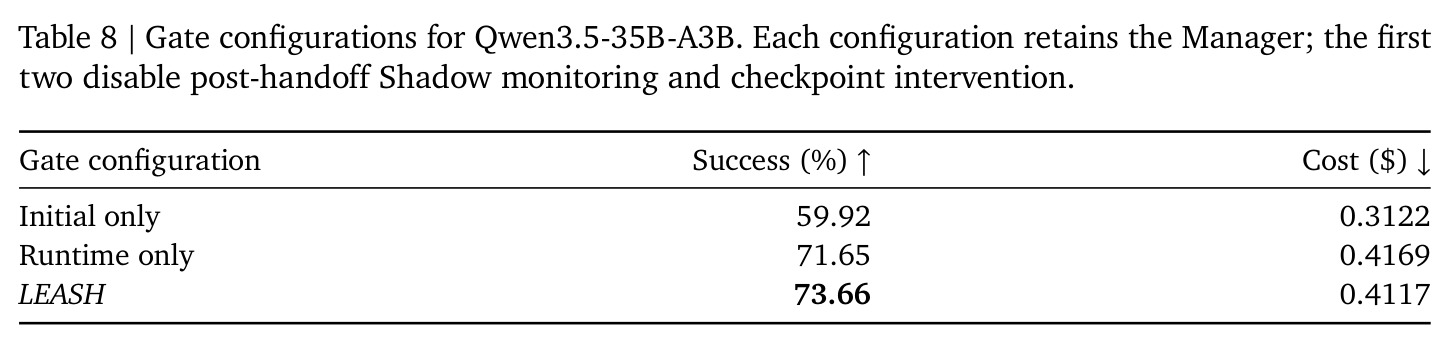
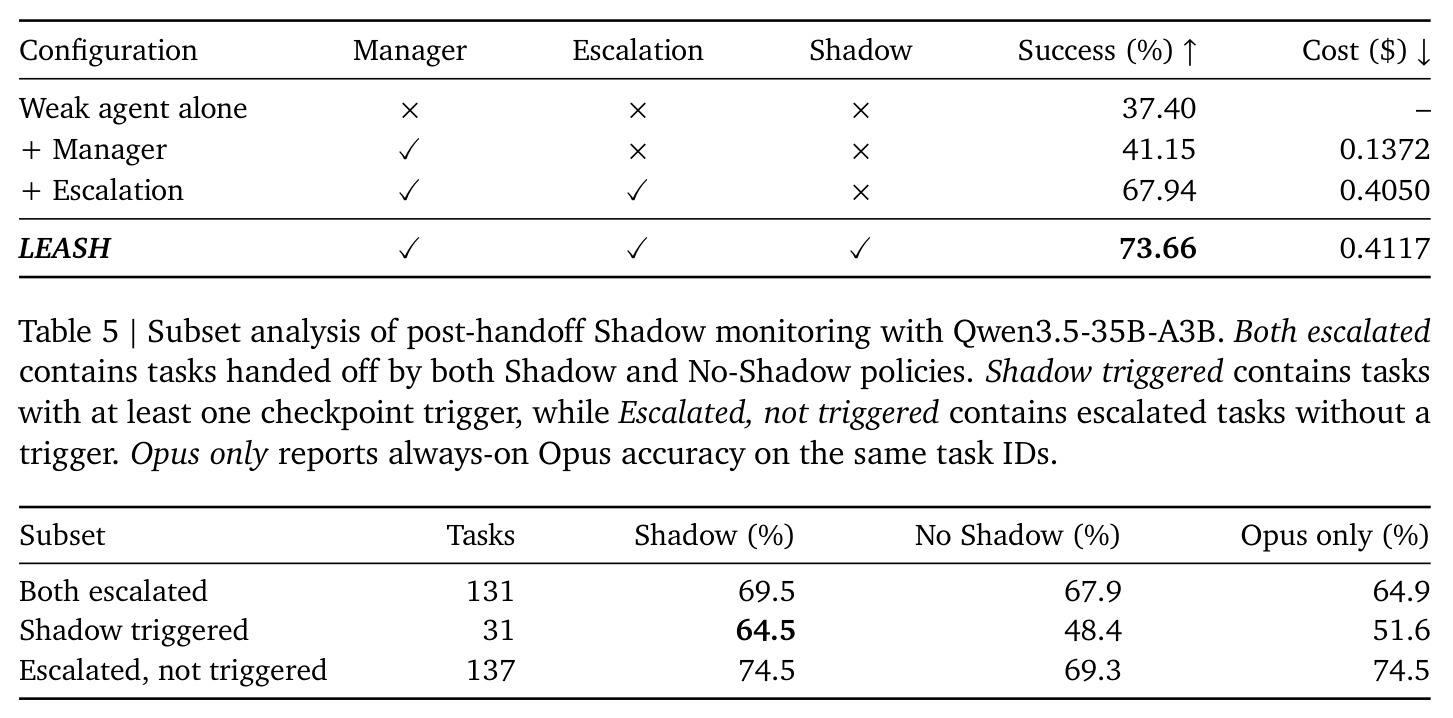
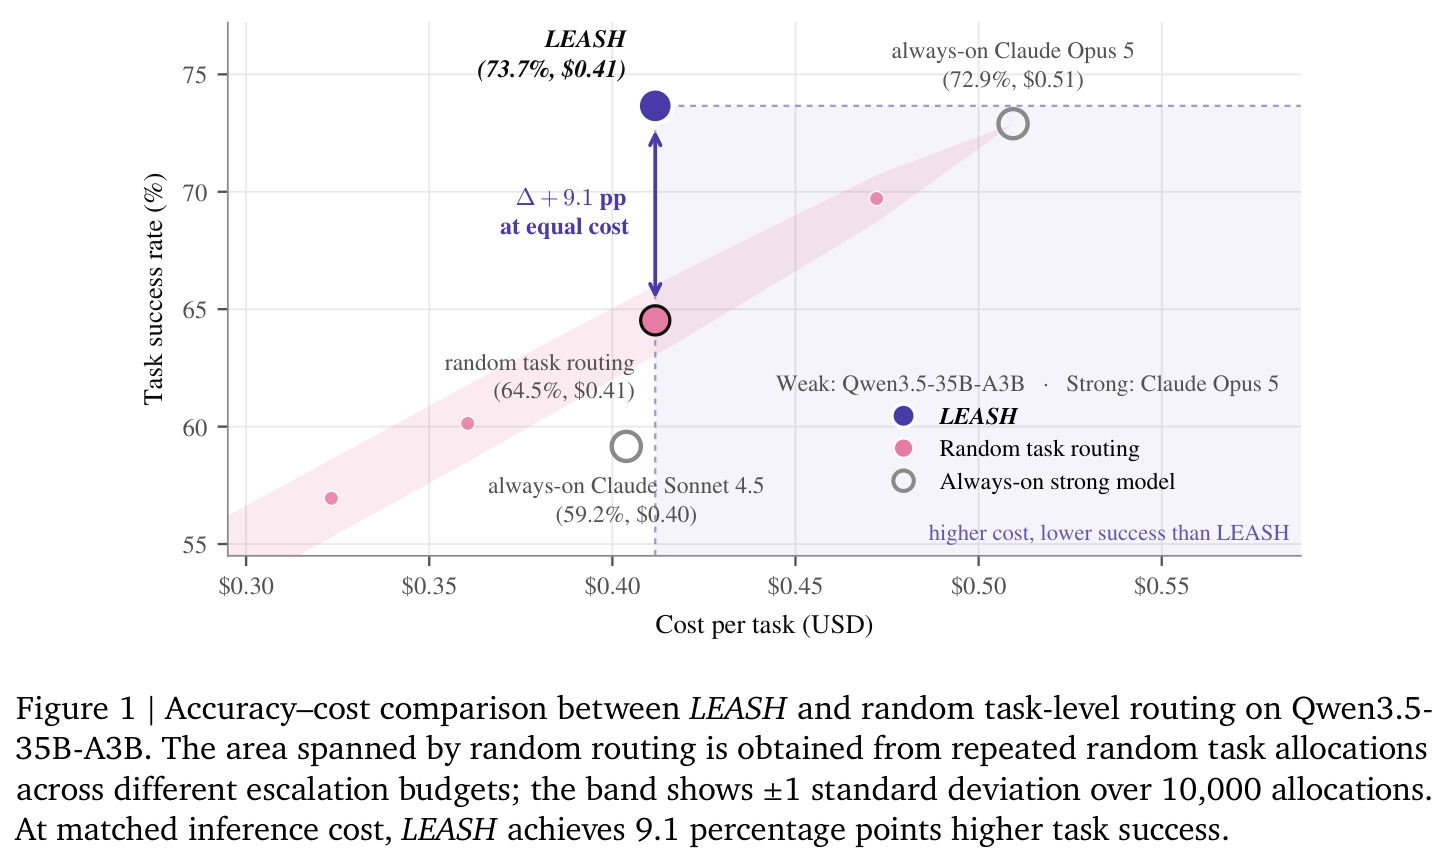
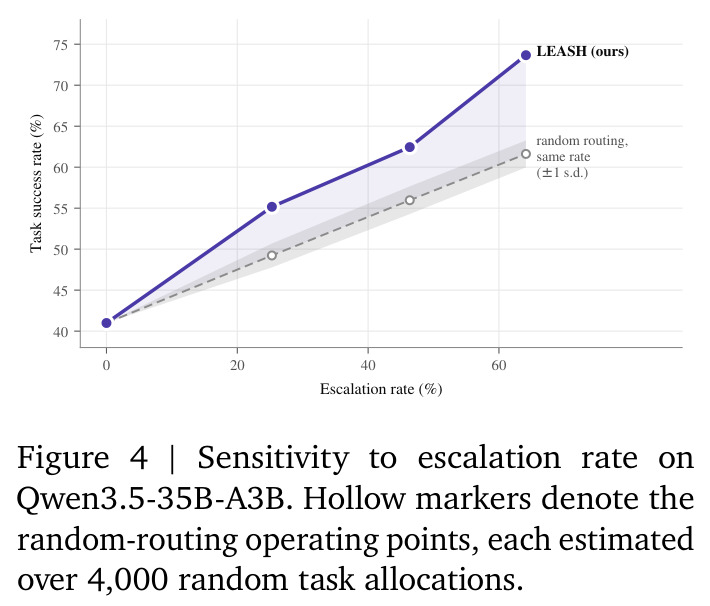
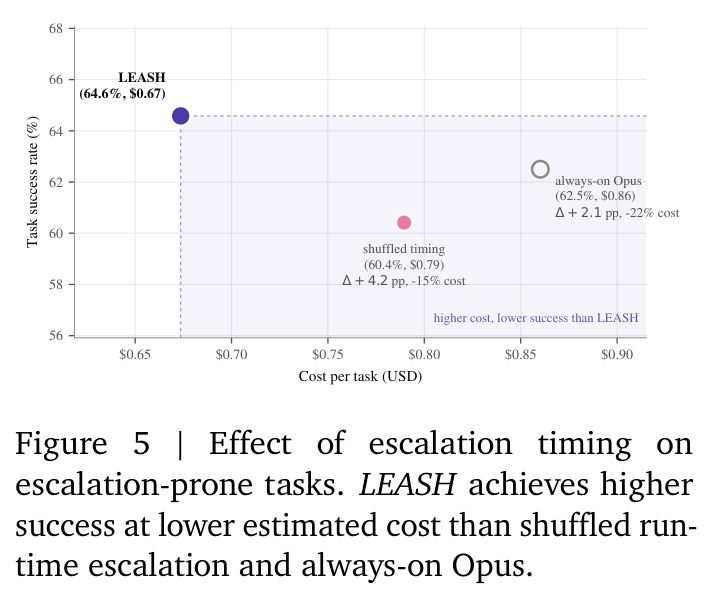
OSWorld 主结果(表 1):四种弱骨干一致受益,匹配升级率下比随机升级高 6.55–11.94 个百分点。Qwen3.5-35B-A3B 从 37.40% 升至 73.66%(升级 64.1% 任务,$0.4117/任务),以低 19.2% 的成本追平全时 Opus 5(72.90%,$0.5094);EvoCUA-8B 42.37%→67.18%;Nemotron-3 45.04%→66.03%;Qwen3.8-27B 51.91%→69.85%。LEASH 恢复 75–102% 的升级差距(随机仅 37–69%),成本为全时 Opus 的 69–81%。表 2:LEASH(67.18%)优于 StepWise(58.40%)与 Progress Advantage(62.98%)。表 3:池化 LDA 运行时两骨干均最佳(0.609/0.575),初始阶段 Nemotron 上最佳(0.749),但 Qwen3.8-27B 初始被概率基线 0.671 反超。表 4 消融:+Manager 41.15%($0.1372)→+升级 67.94%($0.4050)→+影子 73.66%($0.4117),影子仅增 $0.0067 却带来 +5.72pp。表 5:影子触发集中于难任务(全时 Opus 仅 51.6% 成功),影子使其从 48.4% 提到 64.5%。表 6:参考库 40→99 时初始 AUROC 从 0.701→0.770。图 5:升级时机本身有价值——LEASH 64.6%/$0.67 vs 打乱时机 60.4%/$0.79(+4.2pp、省 15%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld 计算机使用任务(Qwen3.5-35B-A3B 骨干) | 任务成功率 / 每任务成本 | 73.66%,$0.4117(升级 64.1% 任务) | 全时 Claude Opus 5:72.90%,$0.5094;随机升级:61.72%,$0.3768 | 以低 19.2% 成本追平全时 Opus;比同成本随机路由高约 9.1 个百分点 |
| OSWorld(EvoCUA-8B 骨干) | 任务成功率 | 67.18%(升级 45.4%,$0.3627) | 独立弱模型 42.37%;StepWise 58.40%;Progress Advantage 62.98% | 比独立弱模型 +24.81pp,比同升级率随机(59.98%)高 7.2pp |
| OSWorld(Nemotron-3 30B-A3B 骨干) | 任务成功率 | 66.03%(升级 43.1%,$0.3500) | 独立弱模型 45.04%;随机升级 55.41% | +20.99pp,比随机高 10.62pp |
| OSWorld(Qwen3.8-27B 骨干) | 任务成功率 | 69.85%(升级 51.1%,$0.3622) | 独立弱模型 51.91%;随机升级 63.30% | +17.94pp,比随机高 6.55pp |
| 不确定性估计质量(运行时步级) | AUROC | 池化 LDA:Nemotron 0.609、Qwen3.8-27B 0.575(两阶段最佳) | 概率基线 0.488/0.540;欧氏距离 0.583/0.564;kNN 0.489/0.522 | 运行时一致最佳,但绝对值仍属中等 |
局限与改进
作者承认三点局限:评估仅限 OSWorld 计算机使用场景,向其他领域的泛化未验证;不确定度估计的是弱模型失败风险而非升级期望收益,命题 1 依赖升级增益关于分数非降的条件,当强弱模型在同一任务上同样挣扎时会失效;影子监控存在分布移(观察者读的是强模型轨迹而非自己的执行轨迹),且干预效果未被因果隔离评估。我的补充观察:运行时 AUROC 仅 0.575–0.609,信号判别力中等,阈值校准依赖留出集的代表性;Manager 用 Opus 5 做子目标分解与标注,本身引入强模型依赖与成本($0.1372),与「弱模型自主执行」的叙事有张力;升级率高达 43–64%,意味着多数任务最终仍交给强模型;$k=3$ 的观察频率、最多 6 次干预、两次后停止等超参未做消融。
独立分析的弱点
独立分析几个弱点。(1) 初始门只读 prompt 最后一个 token 的隐状态 $h_0$,信息量可能不足以预测数百步执行中的具体失败模式——表 3 显示 Qwen3.8-27B 初始 AUROC 仅 0.600 且被概率基线 0.671 反超,改进方向是融合首屏截图的多 token 池化表示或查询与首步动作的联合表示。(2) 参考库依赖成败标签:任务级靠基准真值、子目标级靠 Manager 判定,真实部署中没有 ground truth 时标签噪声会污染质心与协方差估计,可用软标签或置信度加权缓解。(3) 升级不可逆:强模型接管后弱模型永不再执行,若强模型中途循环只能靠至多 6 次影子干预,缺少「降级回弱模型」或求助人工的通道。(4) 影子观察假设「弱模型觉得难的任务强模型平均也难」,这只是平均意义成立,运行时门的正式最优停止理论缺失(作者也承认留作未来工作)。(5) 成本核算基于固定参考价的 token 计量,未计入影子监控与 Manager 调用带来的延迟,实际产品化时体验成本可能高于账面成本。
未来方向
作者提出的方向:把运行时门纳入正式的最优停止理论分析(当前命题 1 只覆盖初始门);对影子干预效果做因果隔离评估(如随机化触发对照实验);验证 W2SE 范式在 OSWorld 之外领域(代码、机器人等)的泛化。基于成果可延伸的方向:利用参考库可增量更新的特性构建递归自改进闭环——每次执行结果回灌参考库持续精化估计器(表 6 已显示库 40→99 时 AUROC 0.701→0.770);把同一隐空间不确定度信号扩展到多智能体编队中的动态任务分派与级联;用更强的表征探针(线性探针微调、对比学习)替代纯距离度量,突破 0.6 左右的运行时 AUROC 瓶颈;研究「强降弱」的双向升级机制形成完整的控制回路;以及在强模型也开源(白盒)的场景下验证弱强共享参考库的可能性。
复现评估
复现评估:论文来自 Simular 与威斯康星大学麦迪逊分校,正文未明确给出开源代码链接。基准 OSWorld 公开可得;弱骨干均为开源权重(EvoCUA-8B、Qwen3.5-35B-A3B、Nemotron-3-Nano-Omni 30B-A3B、Qwen3.8-27B),但强模型与 Manager 依赖 Claude Opus 5 闭源 API,需要可观的 API 预算(每任务约 $0.3–0.5,四骨干全套评估成本不低)。方法本身免训练:隐状态抽取、Mahalanobis 拟合与分位阈值校准合计数百行代码,无需 GPU 训练,但需要能 hook 隐状态的推理框架(如 transformers 的 output_hidden_states 或 vLLM 的相应接口)。主要复现难点在于:留出参考集的规模与标注协议(Manager 子目标分解与判定的 prompt 在附录 C)、StepWise 与 Progress Advantage 基线的复现细节、成本核算口径(附录 B.1)。总体难度中等,工程量主要在智能体执行框架的搭建。
论文图表