Kolab:长时程工作流中人机协作能力的基准测试 Kolab: Benchmarking Human-Agent Collaboration in Long-Horizon Workflows
用115小时真实职业录屏测出:前沿模型预测不了专家会采纳、修改还是拒绝AI的贡献。
前置知识
人机协作(Human-Agent Collaboration)
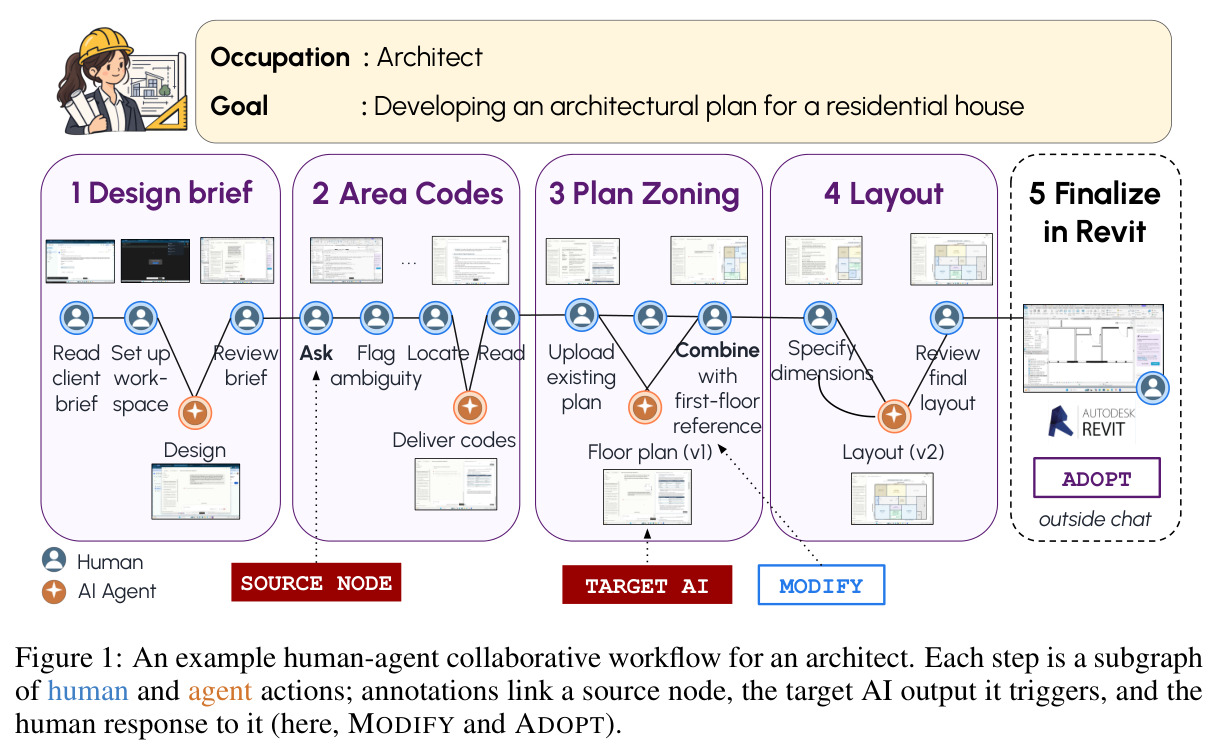
指人类与AI智能体在共同任务中交替行动、相互适应的过程。与『全自动一次完成任务』不同,协作强调智能体的产出会被人类采纳、修改或拒绝,且人类的反应经常发生在聊天窗口之外(例如建筑师把AI生成的平面图拿到Revit软件里执行修改)。本文的核心问题是:智能体能否理解自己在协作者工作流中的位置。
论文的立论就是『自动化能力强不等于协作能力强』,基准的两个任务(预测采纳行为、还原协作评分)全部定义在协作语境上,不了解这一概念就无法理解任务设计。
长时程工作流(Long-Horizon Workflow)
指需要多个相互依赖步骤、总工作量超过一小时才能完成的任务过程。例如建筑师设计住宅方案要经过解读委托书、查区划规范、空间分区、布置平面、在Revit中成图等五个步骤,前序决策塑造后续工作,错误会在步骤间传播。这与单轮指令即可完成的短任务形成鲜明对比。
KOLAB采集的正是这类工作流的完整录屏(要求至少1小时、至少5步),所有基准实验的上下文长度设置(单步、前三步、全工作流)都建立在其步骤结构之上。
多模态大语言模型(MLLM)
能同时处理文本、图像、视频等多种输入的大模型。本文评测的模型需要观看屏幕录制视频(识别任务片段平均14.0分钟、最长73.0分钟),并可选结合工作流图与聊天记录来推断人类行为,这对长视频理解、跨界面事件因果推理都提出很高要求。
基准以视频为主输入,因为人类处置AI产出的关键动作发生在AI界面之外的各类软件里,只有屏幕录像能看到;模型必须从像素级屏幕活动中读出协作语义。
时序工作流图(Temporal Workflow Graph)
论文把每个工作流形式化为有向图 $G=(V,E,a,w,\tau)$:节点 $v\in V$ 是一个人类或AI动作,带执行者标签 $a:V\to\{H,A\}$、步骤标签 $w:V\to\{1,\dots,K\}$ 和时间区间 $\tau(v)=[t_s(v),t_e(v)]$;有向边 $(u,v)$ 表示动作 $v$ 紧随 $u$ 发生。时间戳重叠产生分支,重复动作产生环。
它是数据组织的基本单元、七种输入模态之一,也是分支率 $W=Br/|E|$、AI保留率等协作分析指标的计算基础,读懂图定义才能理解标注与实验。
宏平均F1与逐类F1
F1是精确率与召回率的调和平均 $\mathrm{F1}=2PR/(P+R)$;宏平均(macro-F1)对ADOPT、MODIFY、REJECT三类各自的F1取算术平均,不按类别样本数加权。KOLAB中REJECT仅占15.0%,微平均会被多数类主导,宏平均能直接暴露模型在少数类上的失败。
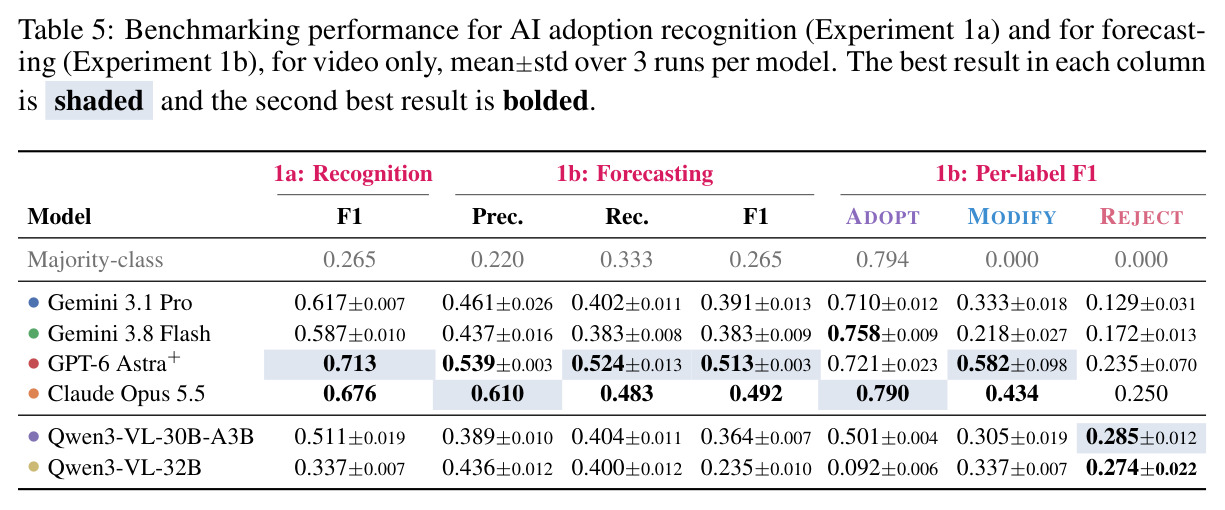
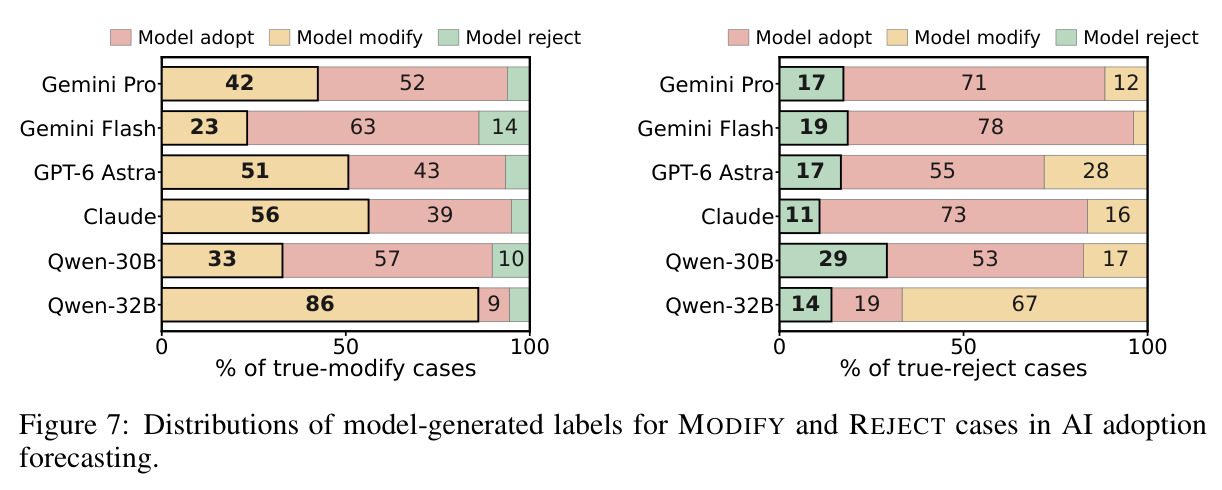
采纳识别与预测任务(1a/1b/1c/1d)的主要指标就是宏F1,而逐类F1用于诊断『偏 adop 标签』的系统偏置,是解读Table 5和Figure 7的关键。
Spearman等级相关与MAE
Spearman相关系数 $\rho\in[-1,1]$ 衡量两组排序的一致性,这里用于检验模型预测的评分能否复现专家评分的相对高低;MAE(平均绝对误差)度量预测分值与真实分值的平均偏差;within-1准确率指预测与真值相差不超过1分的比例。三者合用可区分『绝对值准』与『排序准』。
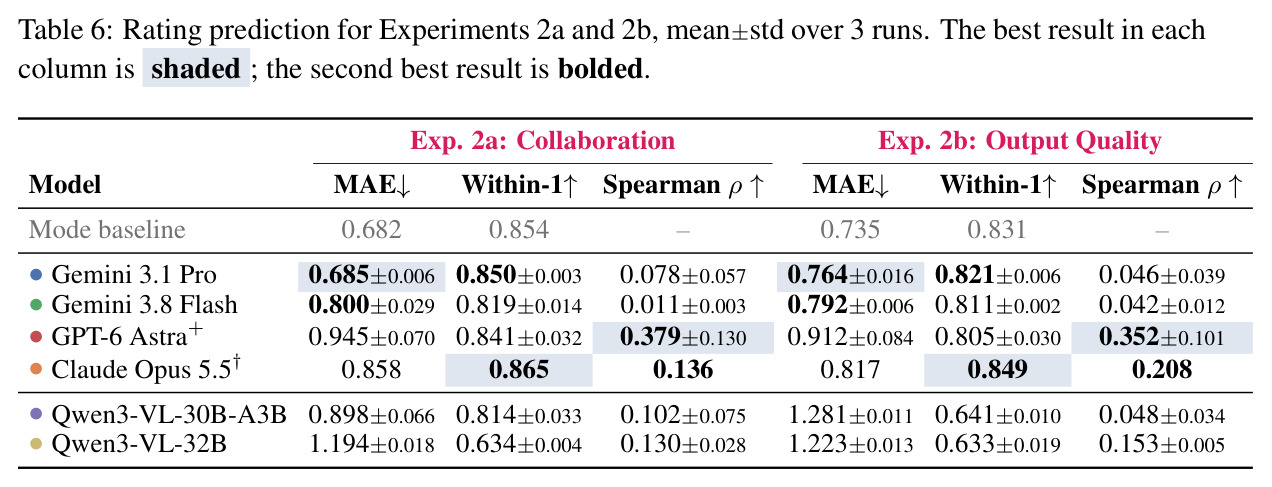
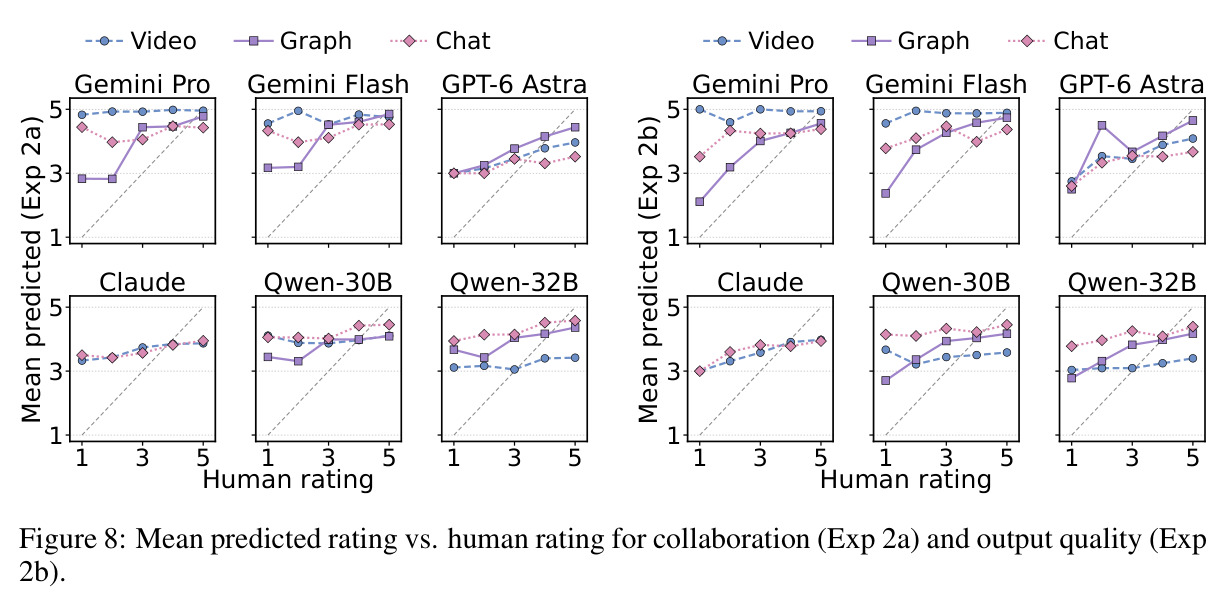
协作满意度(2a)与输出质量(2b)预测任务用MAE、within-1和Spearman ρ共同评估:模型MAE可能很低只因迎合高分偏斜分布,只有ρ能揭示它是否真正区分好坏协作。
研究动机
现有智能体基准几乎都在测『给定单条指令、单次尝试自动完成任务』的能力,论文列举了Agents' Last Exam(55个领域)、GDPVal(44个领域)、TheAgentCompany、Terminal-Bench等代表性工作,指出榜单高分并不代表真实工作中好用。原因在于真实职业问题求解不是一锤子买卖:人的目标会演化、早期决策塑造后续步骤、错误需要在传播前被干预。专业人士会在智能体与领域软件之间来回切换——例如建筑师让Claude出平面布局,然后自己到Revit里执行和修改,这个采纳过程发生在AI根本观察不到的聊天窗口之外。同时,现有人机协作数据严重缺乏真实支撑:有的不公开,有的用研究者预设任务,有的局限于单一领域(如软件工程的CollabSkill、法学领域的LawFlow、学术写作的ScholaWrite);与本文最接近的Hayati et al. (2026)也只用了聊天日志,无法看到人如何在聊天之外处置AI产出。长时程人机协作的基准化因此长期空缺。
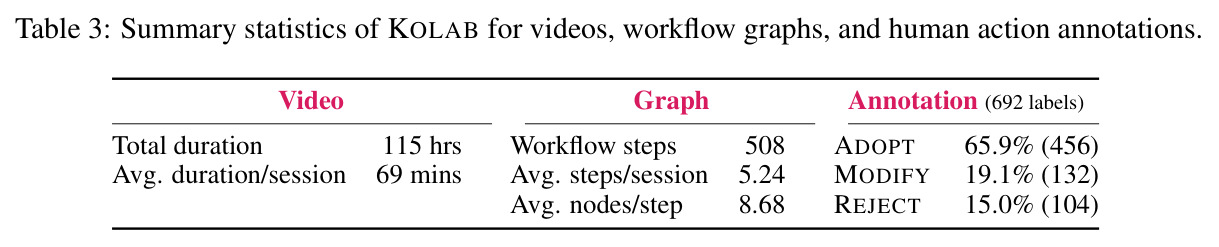
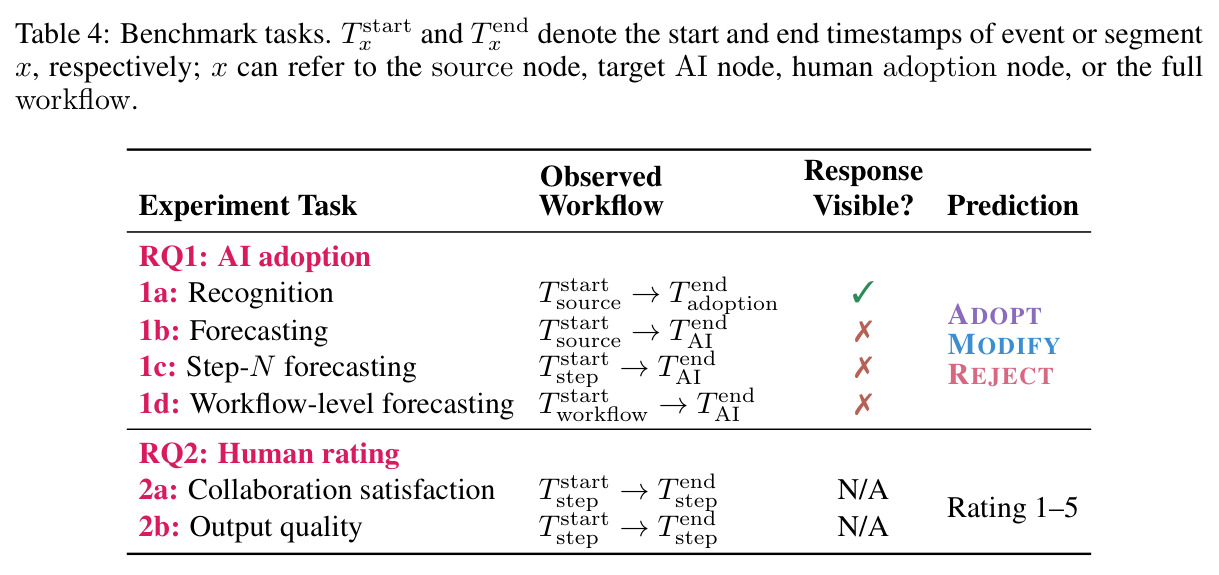
本文的目标是本文要构建KOLAB:一个公开的、多模态、跨领域的数据集与基准,完整记录50位来自40种职业的专业人士解决自己真实工作问题时与智能体协作的全过程。目标分三层。数据层:发布115小时屏幕录像、工作流文档、含工具调用的聊天记录、每步输入输出文件、逐步骤的协作满意度与输出质量人类评分(1–5分)、带时间戳和采纳标签的工作流图、会后问卷共七个组件。分析层:用协作突发性、工作流拓扑分支率、AI保留率三个新指标刻画协作何时发生、如何发生、AI产出被保留多少。基准层:把自动化基准从未测过的两种能力形式化为可计算任务——(1) 预测专家将采纳(ADOPT)、修改(MODIFY)还是拒绝(REJECT)智能体的贡献,含识别(1a)与三种长度的预测(1b/1c/1d);(2) 仅凭工作流还原专家对协作满意度与输出质量的评分(2a/2b),并系统评测前沿模型的能力边界与失败模式。
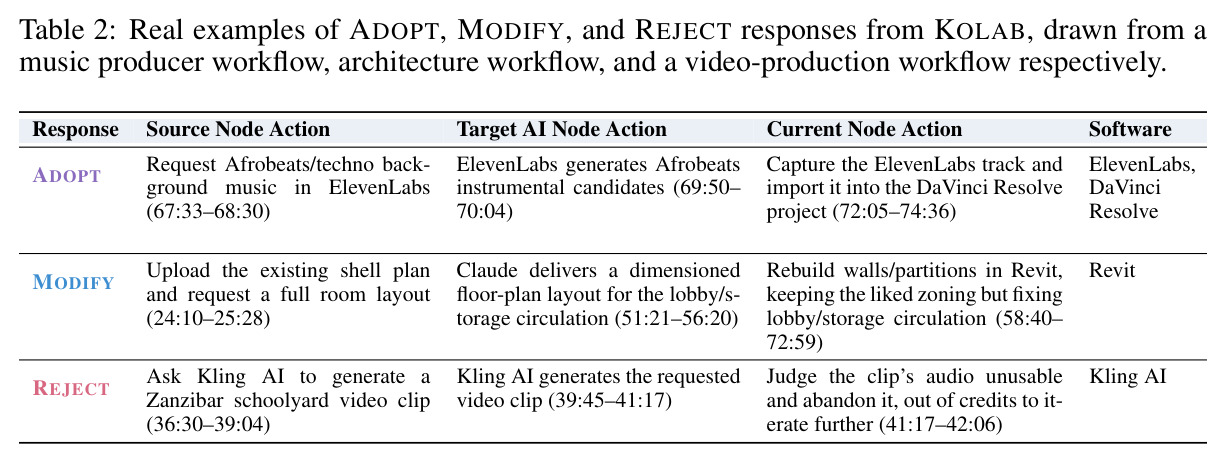
与已有工作不同的是,独特切入点是『把协作放进完整屏幕工作流里研究』。与已有工作的本质区别有三。其一,任务来自参与者自己的真实工作而非研究者预设,且须同时满足四条硬标准:真实来源、需要领域专业知识、长时程(规划至少1小时、至少5个相互依赖步骤)、有具体交付物——这保证了录屏是实质性职业活动而非泛化的电脑操作。其二,数据形态是屏幕录像+人工共同校对的时间工作流图+逐步骤人类评分的组合,能捕捉ADOPT/MODIFY/REJECT发生在AI界面之外的关键事实(Table 2给出音乐制作人、建筑师、视频创作者的真实例子),这是只看聊天日志的方法原理上做不到的。其三,把『协作理解』操作化为两个可预测目标:贡献的命运(投递时预测其被采纳/修改/拒绝)与协作本身的质量(从工作流还原专家评分),并显式控制上下文长度(单步→前三步→整个工作流),首次量化回答『给模型更长上下文是否真的提升协作理解』——结论是否定的,这直接挑战了长上下文越大越好模型越懂协作者的流行直觉。
核心方法
直觉上,一个能与人协作的智能体需要知道两件事:我交出去的东西对方会怎么处理(采纳、修改还是拒绝),以及这次协作到底做得好不好。KOLAB的技术路线分三步。第一步数据采集:50位专业人士每人参加两次约1小时的录屏会话,解决自选的真实工作问题,统一通过Claude(大多数用Sonnet 5.5,少数用Opus 5)作为默认智能体,也允许按需使用ChatGPT、Gemini、Grok等其他AI;会话前先提交工作流文档(目标、背景、步骤名与动作、软件),会话后填写涵盖7个维度的协作满意度量表、输出质量评分(1–5分)及逐步骤评分细则。第二步结构化表示:把每个步骤表示为时间工作流图 $G=(V,E,a,w,\tau)$,节点是人类或AI动作,图由研究团队与专业人士共同校对;两名标注者再对每处『人对AI产出的处置』标注响应三元组 $U(n)=\{(p_i,c_i,\ell_i)\}$,其中 $p_i$ 是触发生成的源节点、$c_i$ 是目标AI节点、$\ell_i\in\{\text{ADOPT},\text{MODIFY},\text{REJECT}\}$,共得692个带标签实例。第三步基准评测:从录屏截取多长度视频片段,配合图、聊天共七种模态组合,喂给6个前沿模型执行RQ1/RQ2六项实验,以多数类和众数评分为基线。
核心创新是把『协作质量』变成无需专家实时反馈即可度量的信号,具体包含两个关键想法。其一,贡献命运标注(adoption labels):不问『AI能不能完成任务』,而问『AI产出进入工作流之后发生了什么』——被原样纳入(ADOPT,占65.9%)、改造后使用(MODIFY,占19.1%)、审查后丢弃(REJECT,占15.0%),且响应可以发生在聊天窗口之外的任何软件里(如DaVinci Resolve、Revit),这迫使模型必须理解屏幕级别的因果链而非对话文本。其二,时间上下文的系统控制:通过对比『识别』(人类反应可见,1a)与『预测』(反应不可见、在投递时刻判断,1b),再逐步增加历史上下文(1c:前1/2/3步;1d:整个工作流),首次实证量化了上下文长度对协作理解的真实贡献,发现几乎为零。与Workflow-GYM把人类轨迹仅当作自主智能体的模仿示范、DeskCraft只在单一领域看AI产出、TheAgentCompany完全无人类参与不同,KOLAB把真实专业人士放进评估回路,用692个实例测『智能体能否读懂自己的协作者』。
方法步骤详情
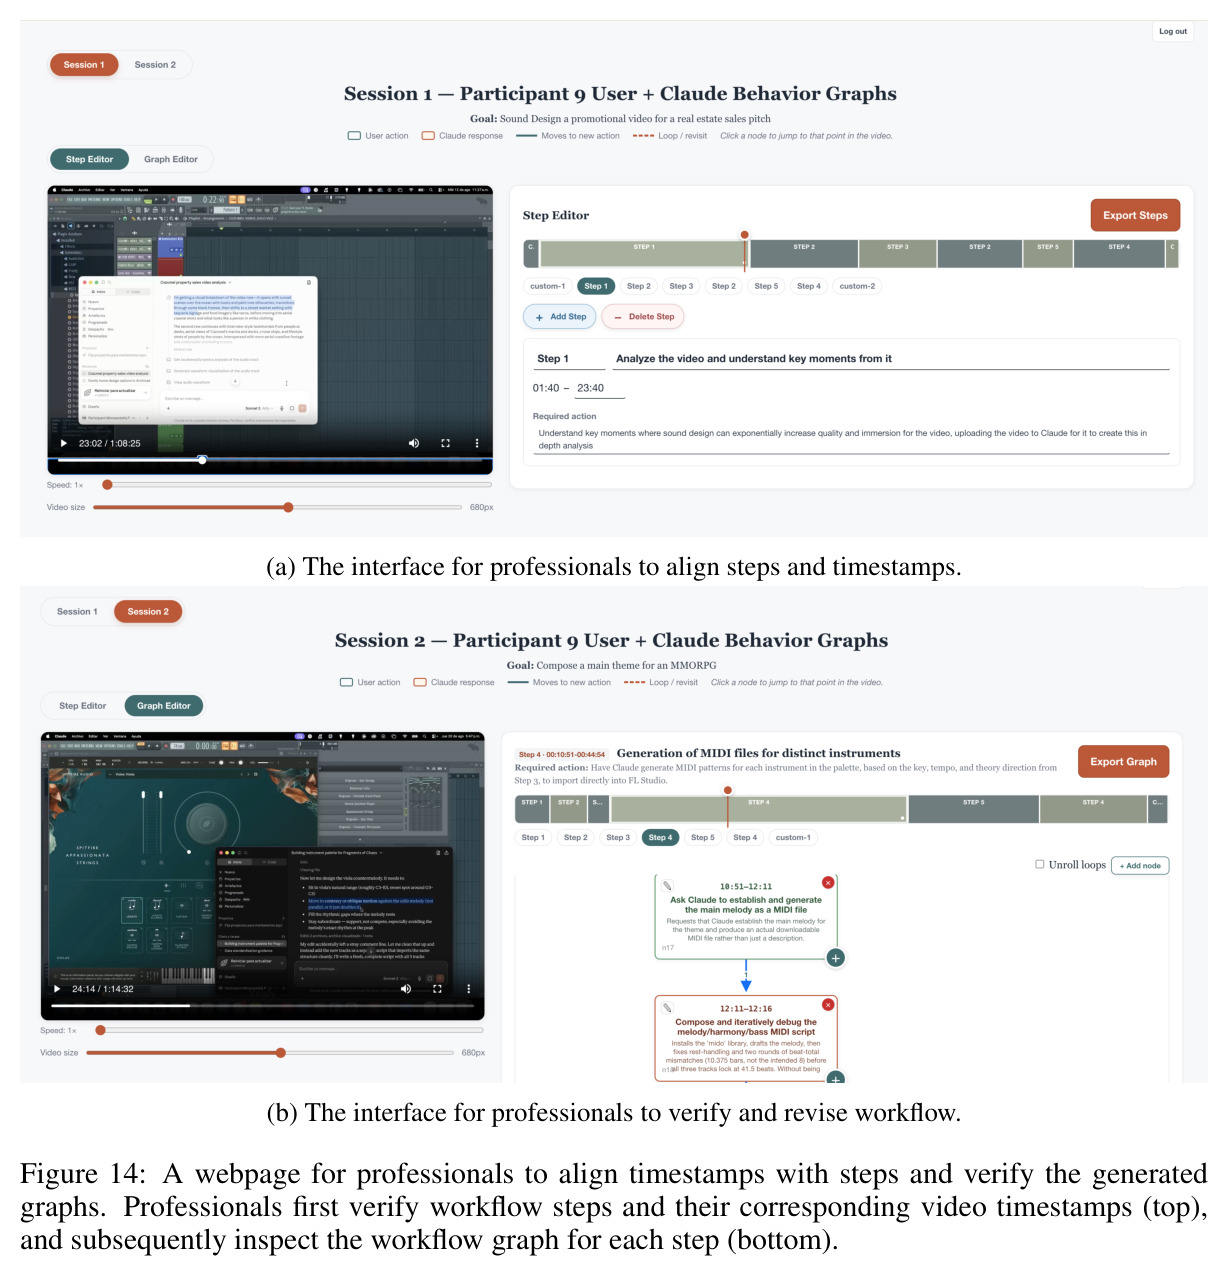
数据与评测流水线可概括为五步。(1) 招募与规划:经口碑、Prolific、Upwork招募50位专业人士(每人报酬100美元加超额奖金),会话前提交工作流文档并通过四条标准审核(真实、领域特定、≥1小时≥5步、有交付物)。(2) 录制会话:两次约1小时屏幕录制,Session 1要求与智能体至少交互5次,Session 2要求每个步骤都交互(两个会话可以是不同问题,也可延续前一任务);参与者被鼓励出声思考,语音转写用于辅助后续标注;默认使用Claude(Sonnet 5.5)。(3) 图构建与对齐:从视频抽取动作与时间戳,与参与者撰写的工作流步骤对齐,形成带执行者标签 $a$、步骤标签 $w$、时间区间 $\tau$ 的有向图,研究团队与参与者共同校对。(4) 标注与发布:两名标注者对每处AI产出的处置打ADOPT/MODIFY/REJECT标签,覆盖100个工作流、508个步骤、90+软件,共692个实例;七组件数据全部公开。(5) 基准执行:按Table 4截取片段——识别片段均长14.0分钟、预测片段8.8分钟、含前三步上下文37.9分钟、全工作流58.6分钟(Table 10),RQ2用每步全视频(350/373个片段);比较视频V/图G/聊天C及其并集共7种模态组合下6个模型(Gemini 3.1 Pro、Gemini 3.8 Flash、GPT-6 Astra、Claude Opus 5.5、Qwen3-VL-30B-A3B、Qwen3-VL-32B)的表现,每模型跑3次报均值与标准差。
技术新颖性
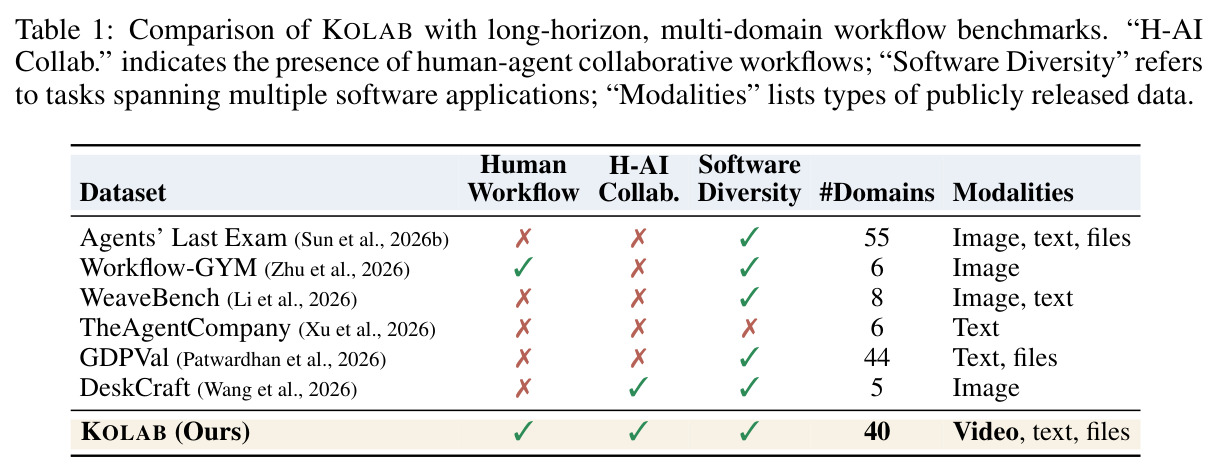
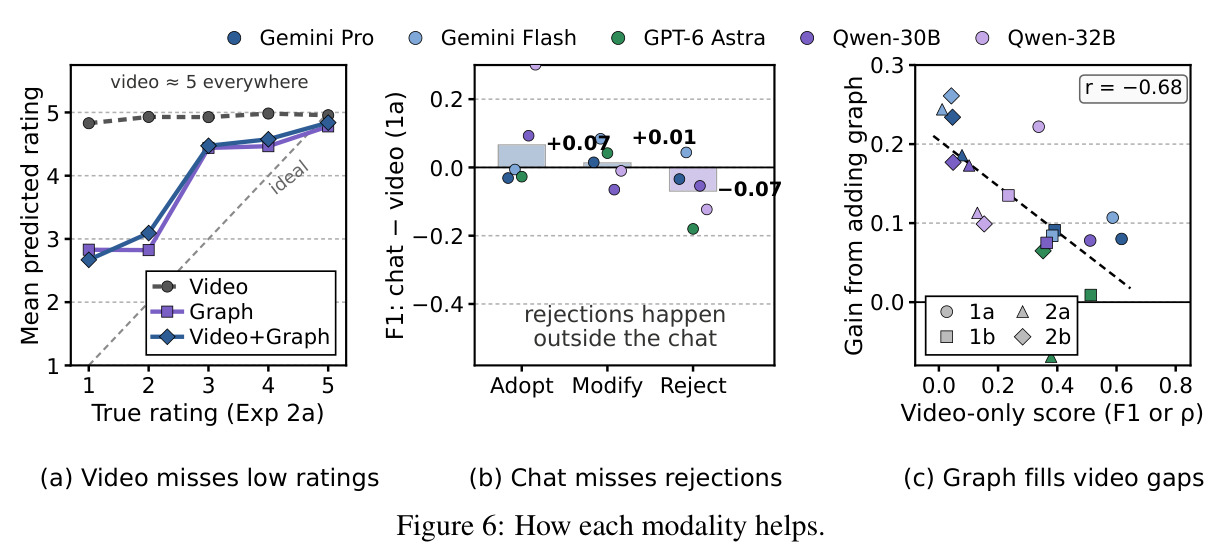
技术新颖性体现在四个层面。(1) 数据新颖:首个以屏幕录像完整记录跨40种职业、人机协作长时程工作流的公开数据集(115小时、100个工作流、508步、90+软件),Table 1显示同时具备『人类工作流轨迹+人机协作+软件多样性+多领域+视频模态』的只有KOLAB。(2) 形式化新颖:用带时间戳的动作图加响应三元组 $U(n)=\{(p_i,c_i,\ell_i)\}$ 把『协作』变成可标注、可预测的对象,并借用复杂系统突发性度量 $B=(\sigma_\tau-\mu_\tau)/(\sigma_\tau+\mu_\tau)\in[-1,1]$、图分支率 $W=Br/|E|$ 和AI保留率 $R_A=N_{\text{ADOPT}}/N_{\text{总}}$、$R_M=N_{\text{MODIFY}}/N_{\text{总}}$ 来刻画协作节奏与产出留存。(3) 任务新颖:『投递时预测贡献命运』是一种反事实式任务——在人类尚未反应前判断其未来行为,且预测器可反哺智能体的主动行为(预期被拒时先澄清、高风险时上报);『从工作流还原专家评分』则对应过程级奖励模型与部署态自动监控两个落地场景。(4) 诊断新颖:不止报分数,还系统揭示模型特有的标签先验(如Qwen-32B用视频时87.3%预测MODIFY而真实率仅19.1%、Gemini 3.1 Pro把71%的真实REJECT判为ADOPT)和评分坍缩现象(Gemini Pro对真实1分和5分分别预测4.83和4.95),把『模型是否真的在看工作流』变成可检验的实证问题。
实验结果
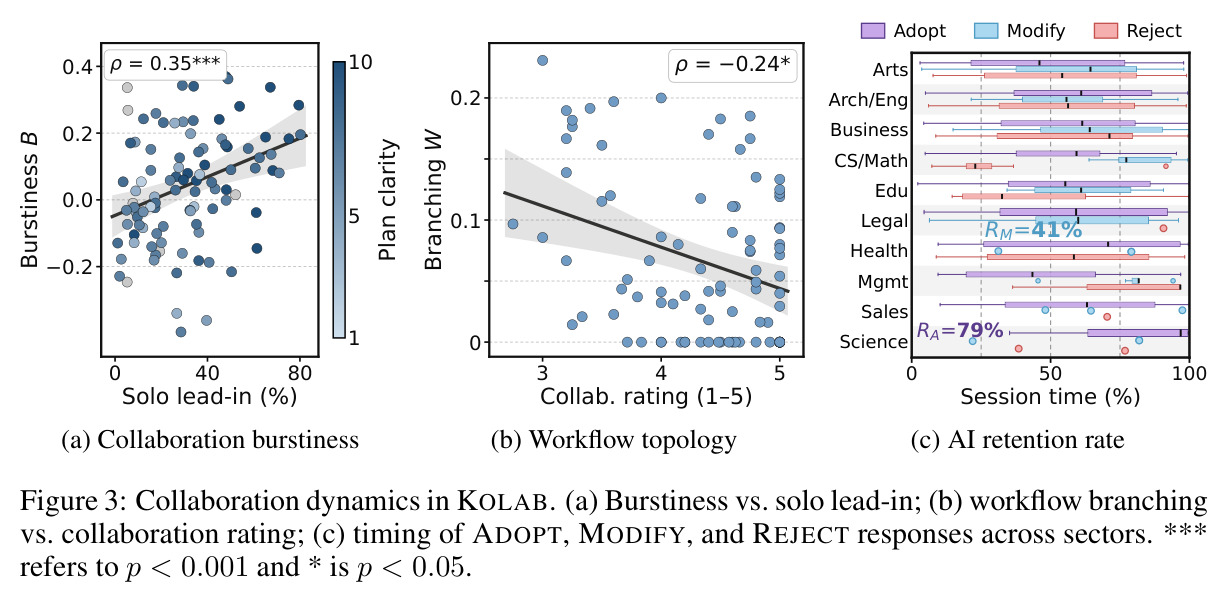
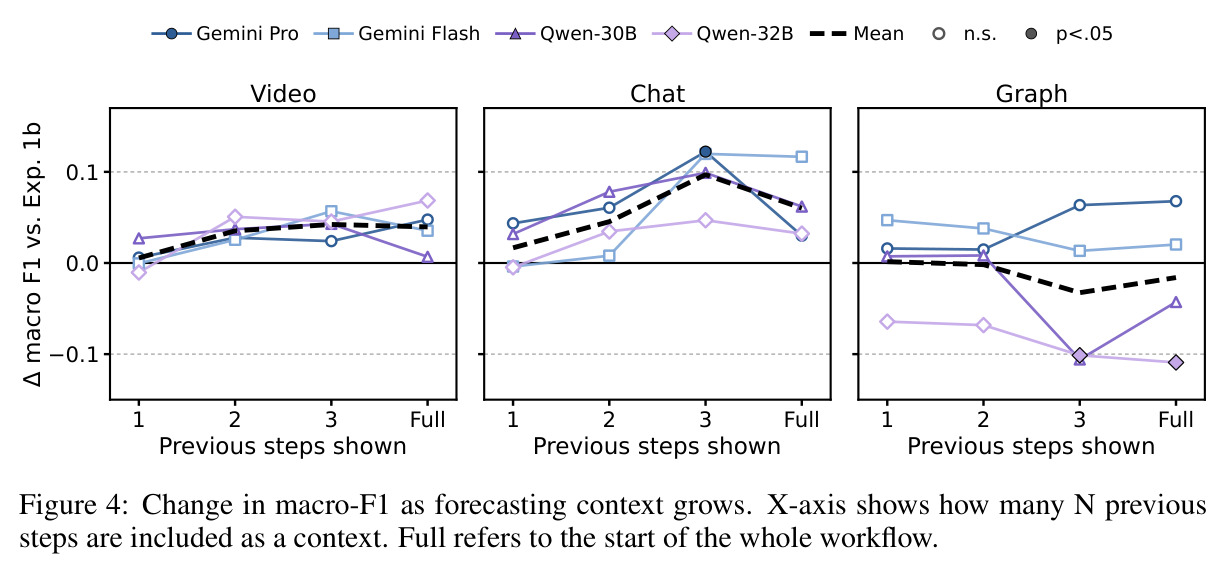
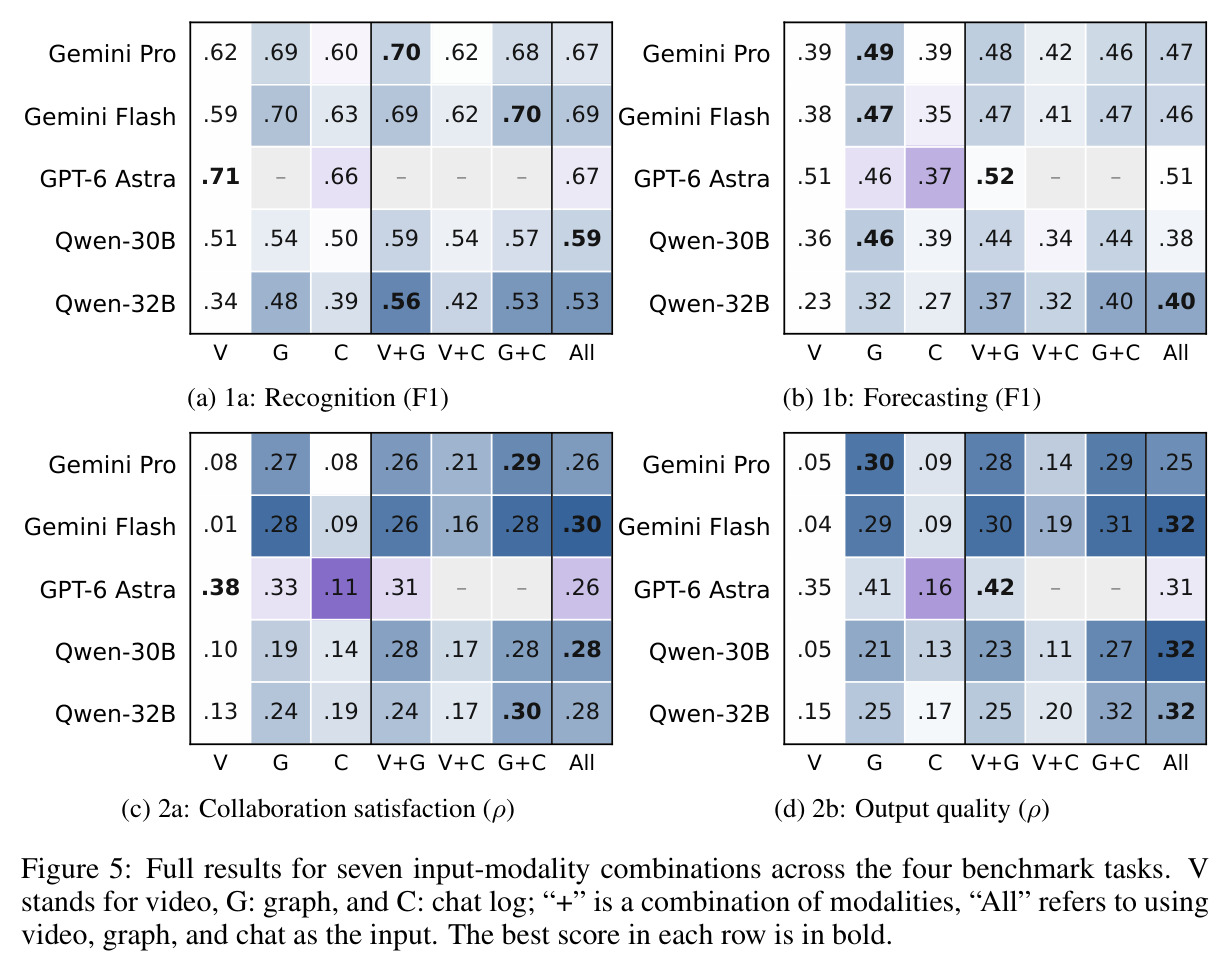
按实验逐一说明核心发现。(1) 采纳识别(1a,视频输入):GPT-6 Astra宏F1最高0.713,Claude Opus 5.5为0.676(作者假设其优势来自默认智能体正是Claude、它最熟悉自己界面内的交互),Gemini 3.1 Pro 0.617、Flash 0.587,开源Qwen-30B 0.511、Qwen-32B仅0.337,多数类基线0.265。(2) 采纳预测(1b):全体大幅下滑——最好的GPT-6仅0.513、Claude 0.492、Gemini 3.1 Pro只有0.391;Gemini对REJECT类F1低至0.129,把52%的真实MODIFY和71%的真实REJECT都判成ADOPT,甚至比开源Qwen-30B(REJECT F1 0.285)更差。(3) 上下文实验(1c/1d,114实例):更长上下文没有稳定收益,多数视频与图设置宏F1变化小于0.07且视频设置均不显著;聊天记录受益最大(Gemini Pro加三步历史+0.12 F1,p<0.01)但给全工作流后增益消失;Qwen-32B加全图反而从0.43跌至0.32(p<0.01)。(4) 评分还原(2a/2b):众数基线MAE为0.682/0.735,最好的Gemini Pro为0.685/0.764,没有一个模型超过基线;排序相关性最好的GPT-6也只有 $\rho=0.379$(2a)与0.352(2b),多个模型接近0。(5) 模态分析:无任何模态全面占优;图模态对开源模型帮助最大(Qwen-32B预测F1从0.23升至0.37),聊天输入损害REJECT识别(相对视频-0.07),因为聊天看不到界面外发生的事。(6) 协作动态:突发性与独立先导时长正相关($\rho=0.35$, p<0.001),分支率与满意度负相关($\rho=-0.24$, p<0.05),法律行业修改率41%约为其他行业(最高22%)的两倍。总结论:前沿模型(无论agentic与否)倾向依赖自身预测先验而非工作流证据做判断,无法区分高质量与低质量协作。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 1a 采纳识别(人类反应可见,视频输入) | 宏F1 | GPT-6 Astra 0.713(Claude Opus 5.5 0.676,Gemini 3.1 Pro 0.617) | 多数类基线(全预测ADOPT)0.265 | +0.448,但绝对水平仍低 |
| 1b 采纳预测(投递时刻,反应不可见,视频输入) | 宏F1 | GPT-6 Astra 0.513;Claude 0.492;Gemini 3.1 Pro 0.391 | 多数类基线 0.265 | +0.248(相对识别设置下跌约0.12–0.23) |
| 1b REJECT类预测(视频输入) | 逐类F1 | GPT-6 0.235;Gemini 3.1 Pro 0.129 | 开源Qwen3-VL-30B 0.285 | 前沿闭源模型反而落后于开源模型 |
| 2a 协作满意度还原 | MAE(越低越好) | Gemini 3.1 Pro 0.685 | 众数基线(恒预测5分)0.682 | 劣于基线0.003,无一模型超越 |
| 2b 输出质量还原 | MAE(越低越好) | Gemini 3.1 Pro 0.764 | 众数基线 0.735 | 劣于基线0.029 |
| 2a/2b 评分排序一致性 | Spearman ρ | GPT-6:2a 0.379 / 2b 0.352(视频输入) | Gemini 3.8 Flash:2a 0.011 / 2b 0.042 | 最好模型也只能解释不到15%的排序方差,多数模型接近零相关 |
| 1b 预测(视频+图模态) | 宏F1 | GPT-6 0.52;Qwen-32B 0.37 | Qwen-32B纯视频0.23 | 图模态对开源小模型提升+0.14,是唯一稳定有效的增益来源 |
局限与改进
作者承认的局限包括:GPT-6因成本限制只在279个实例(1a)/349个实例(1b)上评测,而非全部692个实例,跨模型可比性受损(附录Table 15/16在公共子集上补充);第4节的协作动态分析是描述性的,不做跨职业总体推断;标注依赖两名标注者并与参与者共同校对,主观性不可避免;人类评分高度偏斜(54.9%的满意度为5分、仅15.3%为3分及以下),使还原任务天然困难且基线很强。我自己观察到的问题:其一,两段会话由实验协议塑形(Session 1至少交互5次、Session 2每步交互),采集到的协作模式可能偏离自然工作状态;其二,统一用Claude作默认智能体给Claude模型带来『主场优势』,模型间比较混淆了界面熟悉度与协作理解力;其三,REJECT仅104例(15.0%),少数类样本过薄导致逐类F1方差大;其四,692个实例训练太小、评测类别失衡,且长视频token成本高(1d全工作流片段均长58.6分钟)限制大规模复现;其五,1–5单值评分信息量有限,无法区分『勉强能用』与『恰到好处』的协作。
独立分析的弱点
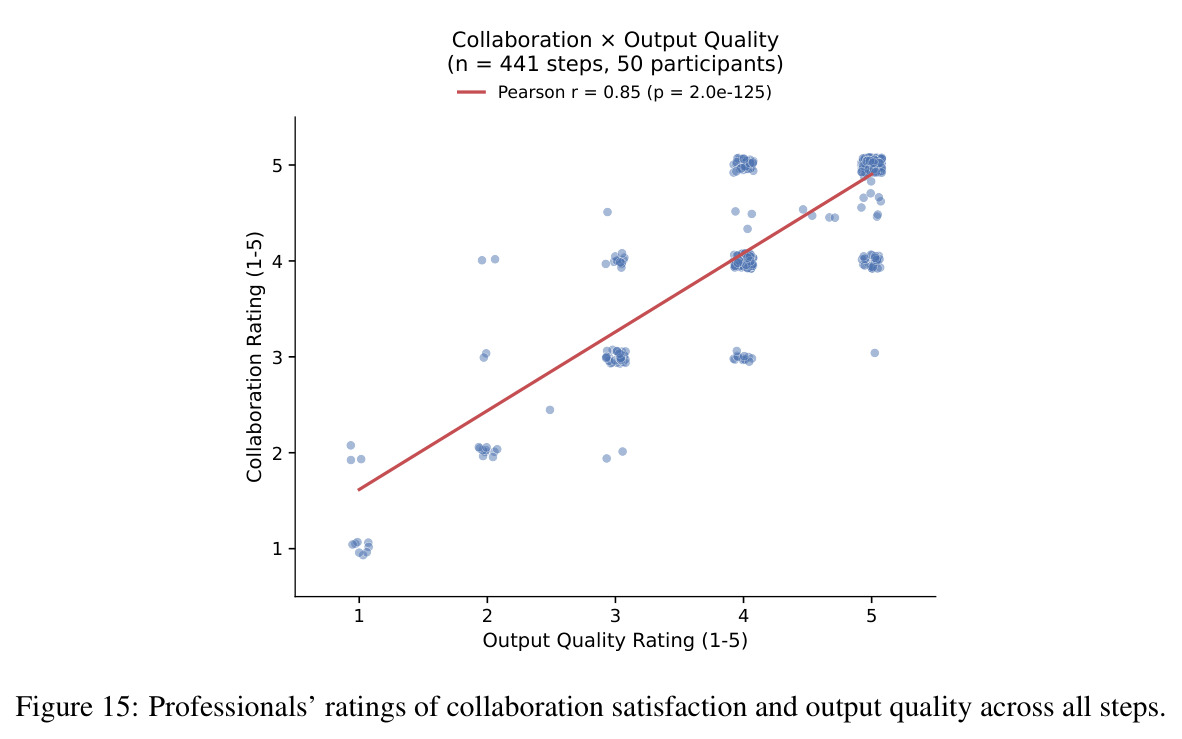
弱点一:标签语义粗糙。ADOPT/MODIFY/REJECT三分法无法表达『部分采纳』『只作参考降级使用』等常见情形,而法律行业41%的修改率提示MODIFY内部异质性极高。改进方向:引入连续采纳度(0–1分数)或用编辑距离等自动度量修改幅度,为预测任务提供更细的监督信号。弱点二:模型评测停留在零样本提示,没有微调、检索增强或显式时间定位推理,负结果可能低估可达上限。改进方向:在KOLAB训练划分上微调小型视频模型,或采用『先生成工作流摘要再预测』的两阶段方法检验是否有效。弱点三:缺乏证据定位实验。预测失败究竟是模型没看到关键视频证据、还是看到却不使用?论文只用偏置分布间接推断。改进方向:要求模型给出支持预测的时间戳区间,人工验证其证据定位质量,区分感知失败与推理失败。弱点四:单值总评分掩盖多维体验——会后问卷实际包含7个子维度(理解任务、响应恰当性、降低负担、主动建议、输出可信、交互流畅、可引导性),压成1–5分丢失信息。改进方向:直接预测子维度并检验可分离性,找出模型具体在哪些协作维度上失明。弱点五:样本以英语环境专业人士为主,跨语言、跨文化工作风格的泛化性未知,可增加多地区采集对照。
未来方向
作者明确提出两个方向:构建训练数据集,或开发沙盒环境让模型先与模拟用户练习协作再部署。沿此延伸,最自然的落地是把1b预测器用作过程级奖励信号训练协作策略:当模型预期REJECT概率高时主动提出澄清问题、标记预期被修改的部分、或在风险会向后续步骤传播时上报人类;把2b还原器作为无参考答案的专业任务的自动评估器和部署态摩擦监测器。基于本文成果还可延伸:(1) 多智能体多人协作——数据中专业人士本就同时使用Claude、ChatGPT、Gemini、Grok,协作理解需要推广到『理解人类与多个AI的编排』;(2) 把采纳率/修改率作为自动化基准的新指标,替代单一任务成功率,衡量智能体对工作流的真实贡献;(3) 系统刻画上下文收益的边界条件——论文发现聊天记录在多步历史下受益(+0.12 F1)而全工作流无益甚至有害,值得研究什么粒度、什么长度的上下文对协作理解真正有用;(4) 训练能从屏幕活动定位协作摩擦点的诊断模型,服务Figure 11揭示的现象:与智能体协作的录屏时长与参与者自估的无AI解题时长几乎无关($\rho=0.10$, p=0.37, n=92),说明『用了AI』不等于『省了时间』,需要工具帮专业人士识别AI何时在拖慢自己。
复现评估
复现条件较好。代码与数据已在项目主页 https://minnesotanlp.github.io/kolab/ 公开,包含七个组件:全部会话屏幕录像、专业人士撰写的工作流文档、含工具调用的人机聊天记录、每步输入输出文件、协作体验与输出质量评分及逐步骤评分细则(rubric)、带时间戳与采纳标签的工作流图、会后问卷。数据已去除 personally identifiable information 并通过机构IRB审查。附录提供采集协议(A.2)、图的形式化定义与构建流程(A.3)、标注界面与流程(A.4,Figure 14)、全部模型提示词与设置,主要指标均报告3次运行的均值±标准差,并给出公共子集的公平对比(Table 15/16)。评测端复现门槛低:开源的Qwen3-VL-30B/32B可在多卡单机运行,闭源模型调用API即可,主要成本是长视频token消耗(识别片段均长14.0分钟、全工作流片段58.6分钟,GPT-6正是因此只跑了279/349实例的子集)。数据采集端则几乎不可复制:需要招募50位真实专业人士、积累115小时高质量录屏、并与参与者共同校对工作流图,人力与信任成本极高;后续研究者更现实的做法是在公开数据上做基准扩展、诊断实验或训练,而非重建数据集。
论文图表
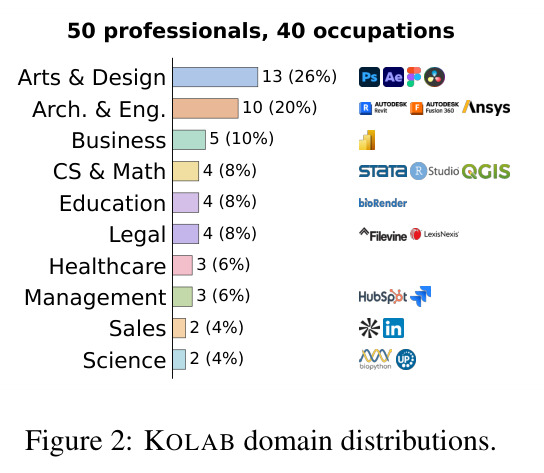
饼图展示50位专业人士、40种职业的领域分布:艺术与设计13人(26%)、建筑与工程10人(20%)、商业5人(10%)、计算机与数学4人(8%)、教育4人(8%)、法律4人(8%)、医疗3人(6%)、管理3人(6%)、销售2人(4%)、科学2人(4%)。
直观呈现数据集的跨领域广度,说明结论不是某个单一行业的特例;同时法律占比虽小却贡献了独特的41%修改率发现,为第3节的行业差异分析埋下伏笔。
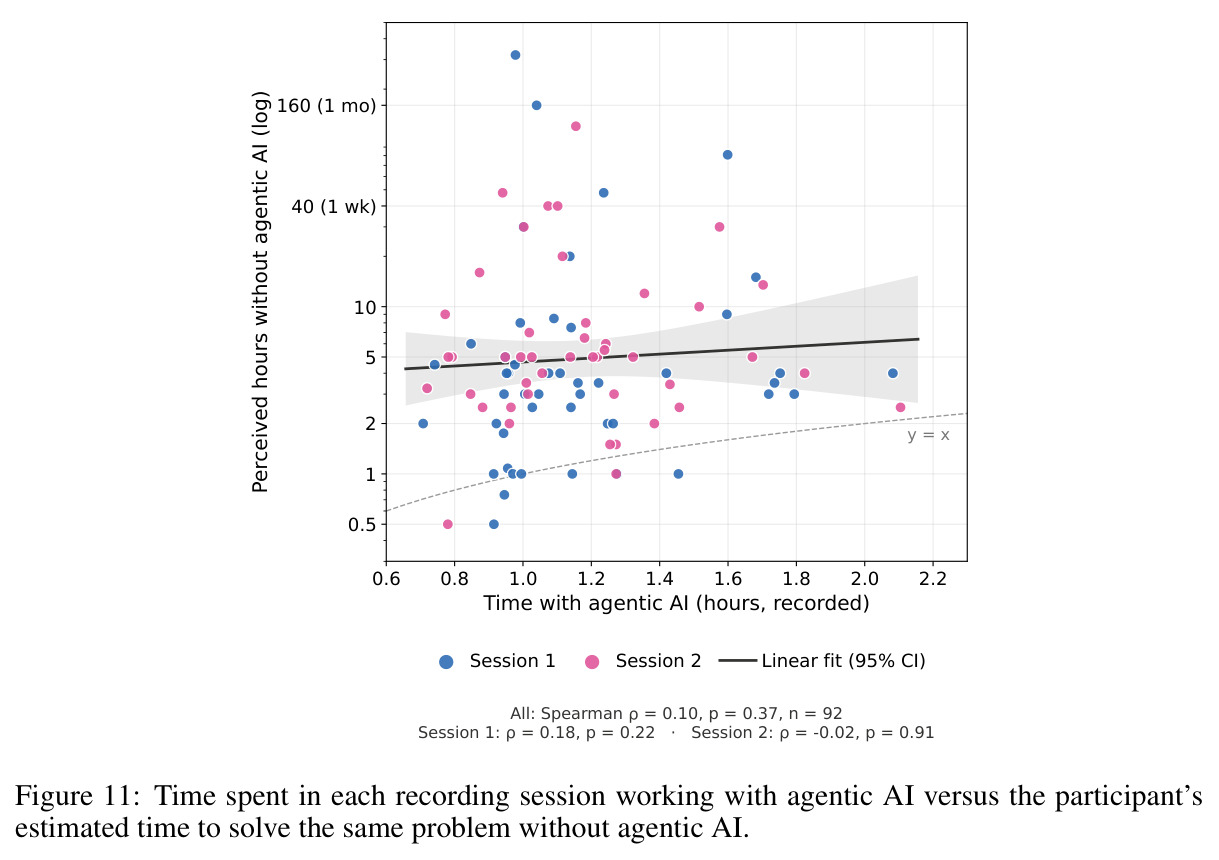
附录图:92个会话中,与智能体协作的实际录屏时长(0.5–160小时,对数轴)对参与者自估的无AI完成时长(2小时至1个月)作散点并拟合,整体Spearman ρ=0.10(p=0.37),两个会话分别为0.18和−0.02,均无显著相关。
用数据质疑『用AI必然省时』:录屏时长与自估工作量基本无关,说明协作收益高度依赖使用方式,为研究协作质量(而非使用量)提供了动机层面的实证支撑。