Athanor:面向自主后训练研究的智能体原生系统 Athanor: An Agent-Native System for Autonomous Post-Training Research
四个前沿智能体104小时自主把Qwen3-4B基座后训练到官方指令模型水平
前置知识
监督微调(SFT)
在指令-回答对上用负对数似然损失 $\mathcal{L}=-\sum_i \log p(y_i|x_i)$ 继续训练基座模型,让它学会按指令格式输出答案,是后训练的第一阶段。本文中每个智能体用约30–60万行公开推理轨迹的混合数据对Qwen3-4B-Base做一轮SFT,把六任务均值从16.1拉到49.7。
智能体配方的第一环,也是理解后续RL、合并为何有效的起点。
GRPO与可验证奖励强化学习(RLVR)
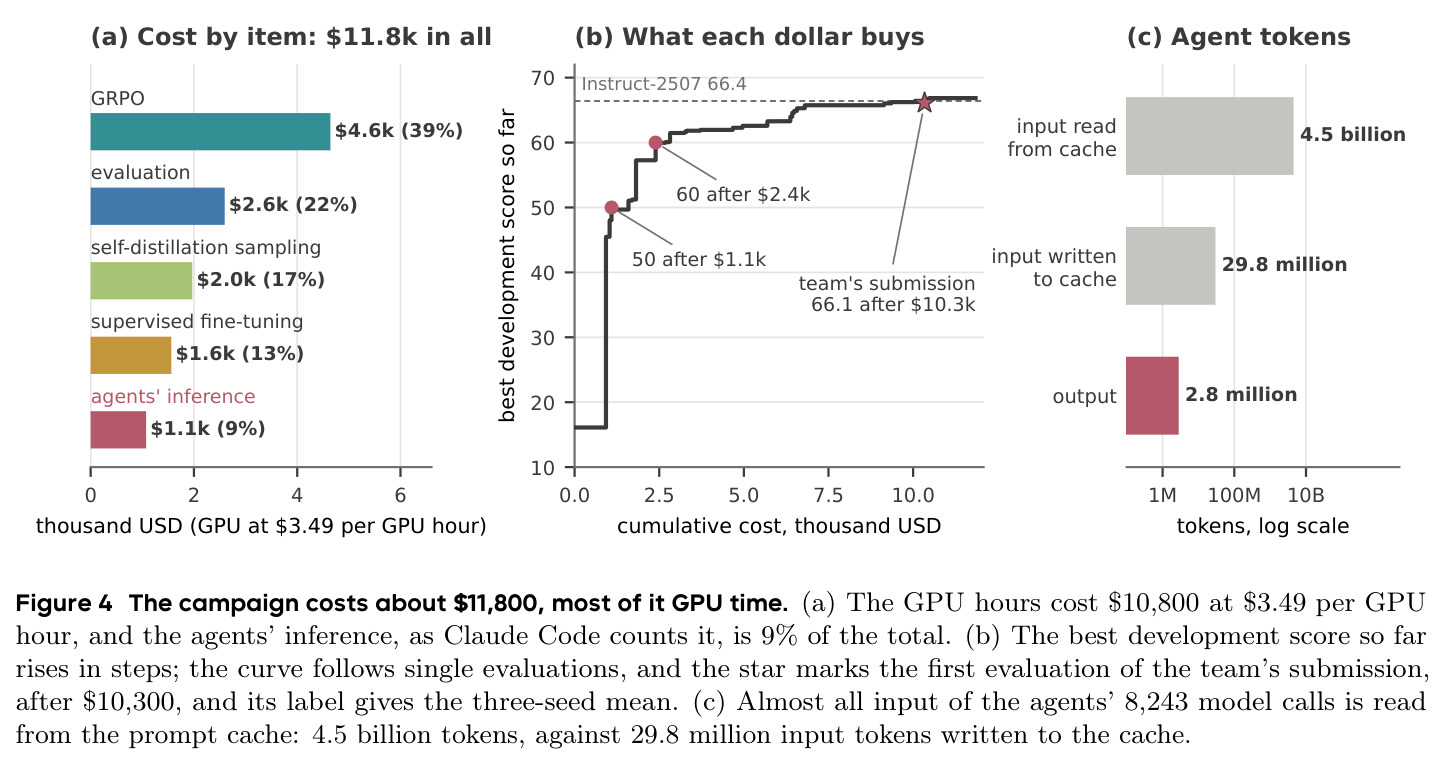
GRPO(Group Relative Policy Optimization)对每个问题采样一组回答,用组内相对优势替代价值网络基线;答案由规则或程序判分(可验证奖励),正确者获得正优势。本文一次GRPO作业约1.6小时,占全部GPU时间的40%,是成本最大的一项。
全文最关键的方法创新(1/4贪心rollout)就是智能体对GRPO rollout采样策略的修改。
权重合并与任务向量外推
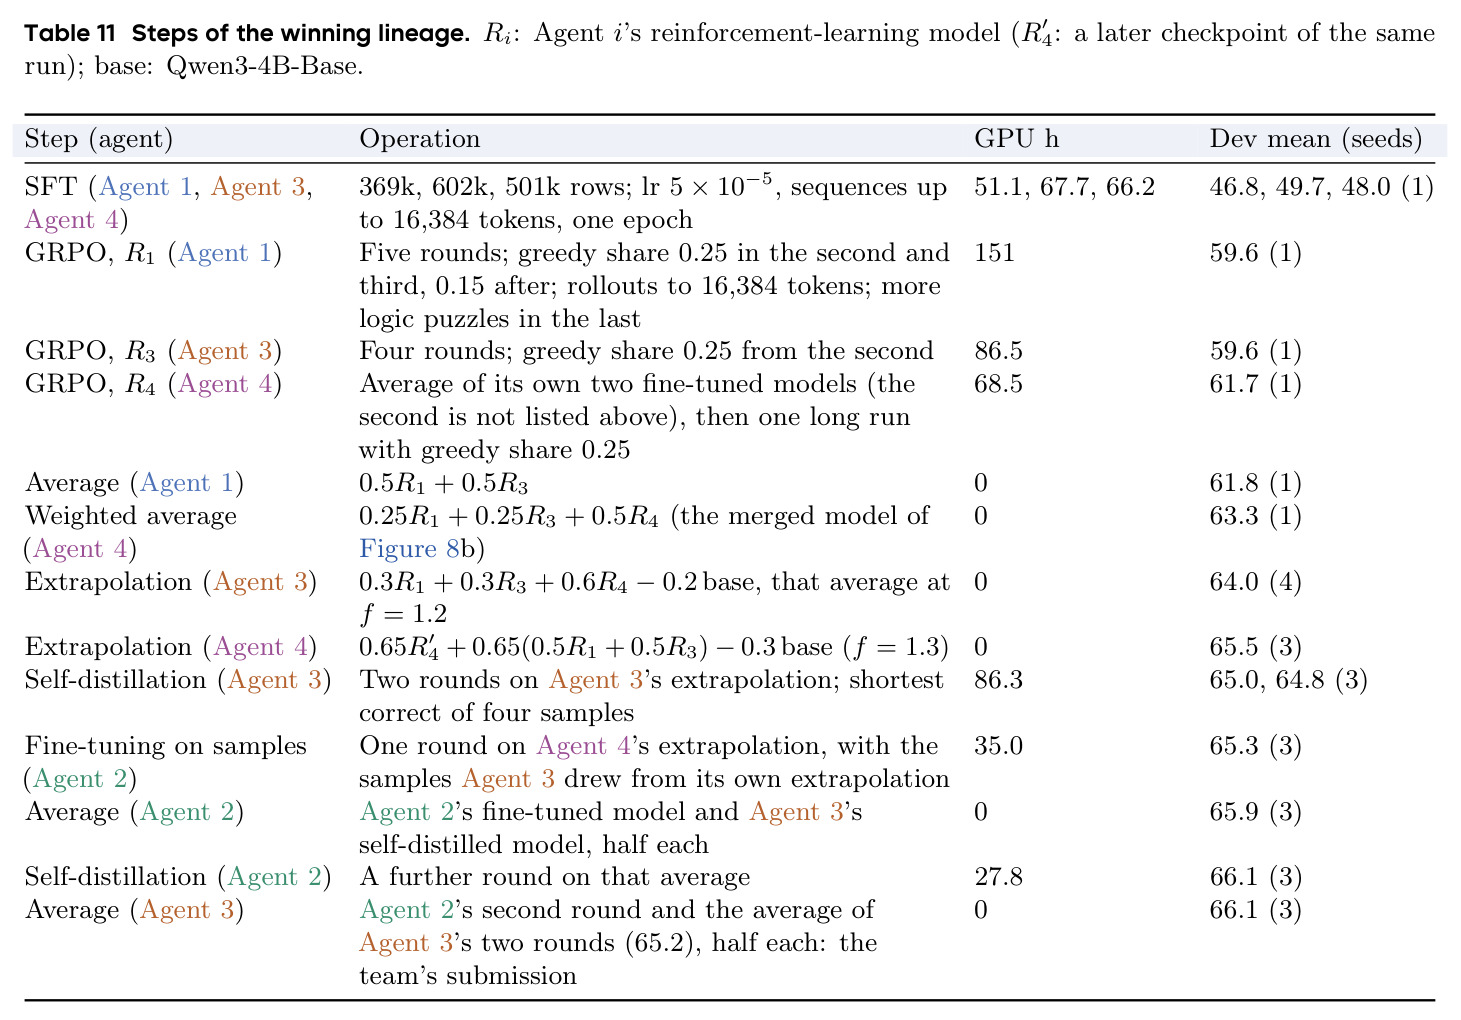
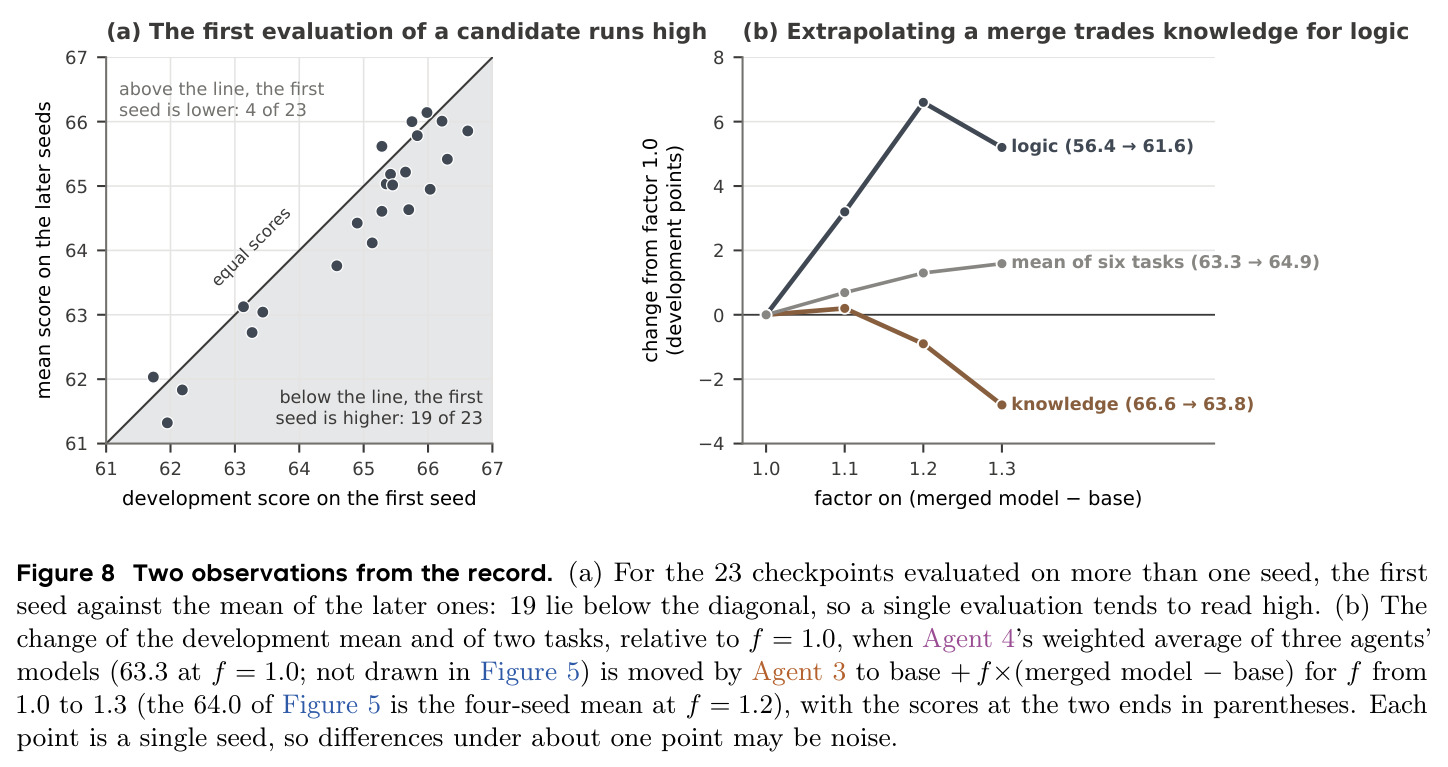
把多个模型的权重做加权平均(基于mergekit),或对模型相对基座的差(任务向量)$\Delta\theta=\theta_{\text{merged}}-\theta_{\text{base}}$ 按系数 $f$ 缩放后加回基座:$\theta=\theta_{\text{base}}+f\cdot\Delta\theta$。本文 $f=1.2\sim1.3$ 的外推用知识换逻辑能力。
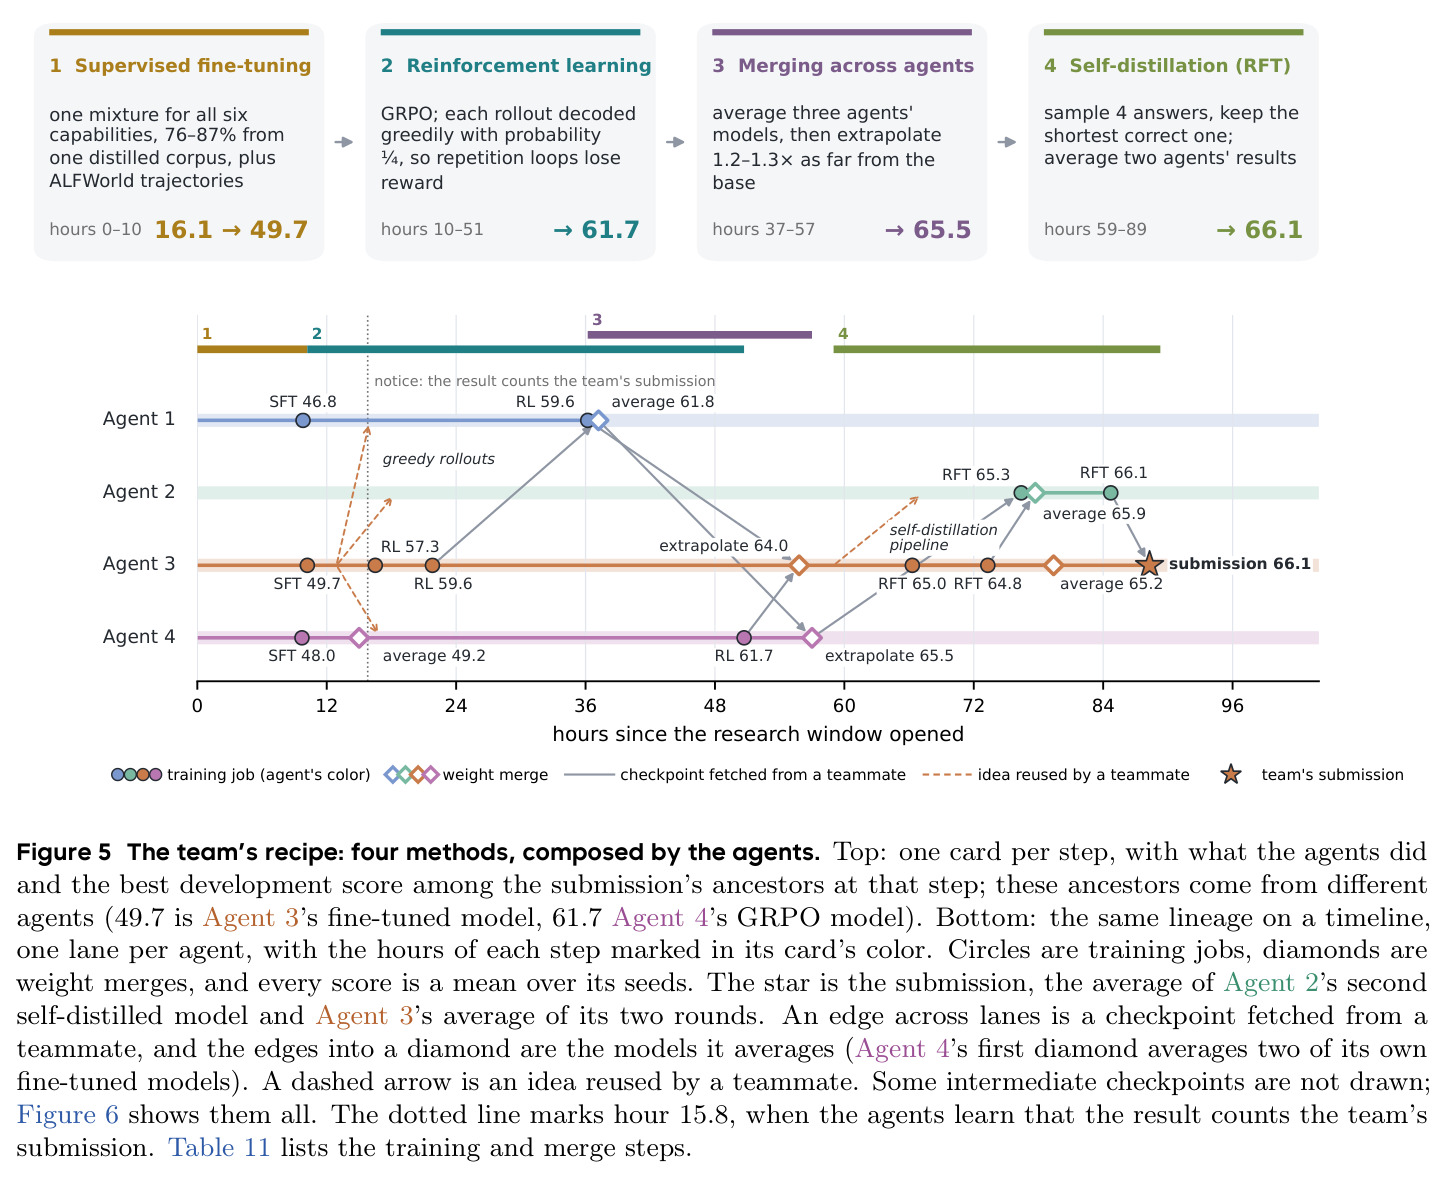
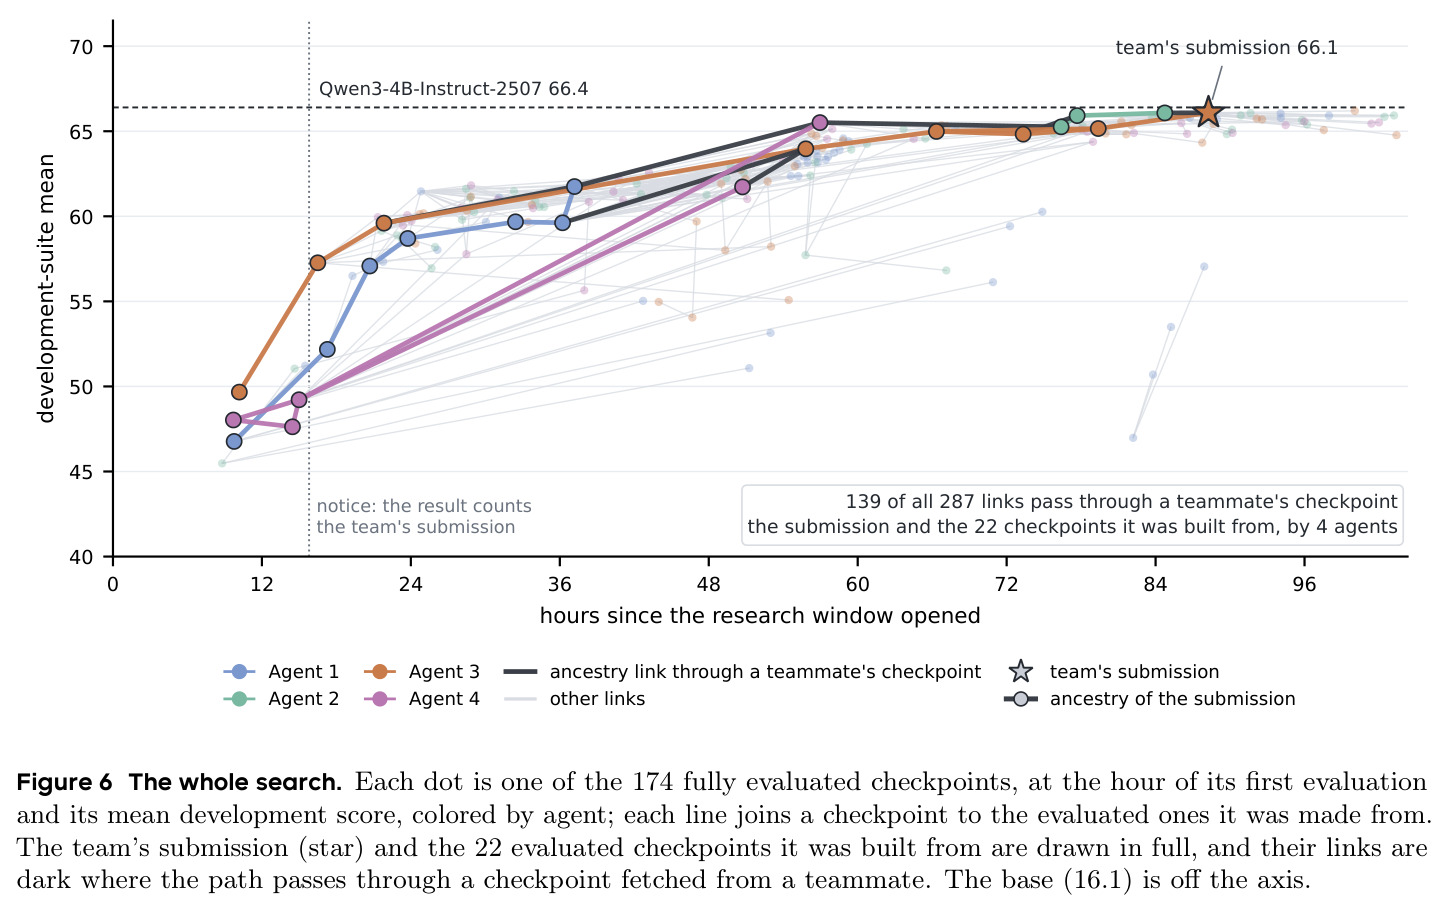
跨队友合并权重是战役后半程涨分的主力手段(61.7→65.5→66.1)。
拒绝采样微调(RFT)与自蒸馏
用当前模型对每个训练问题采样多个回答(本文采4个),按规则奖励保留正确者(保留最短正确答案),再用这些数据微调模型自身,相当于把模型自己最好的输出蒸馏回去,是无需教师模型的自我提升手段。
配方最后一环:两个智能体各自运行RFT后平均,得到66.1的最终提交模型。
留出评测与数据去污染
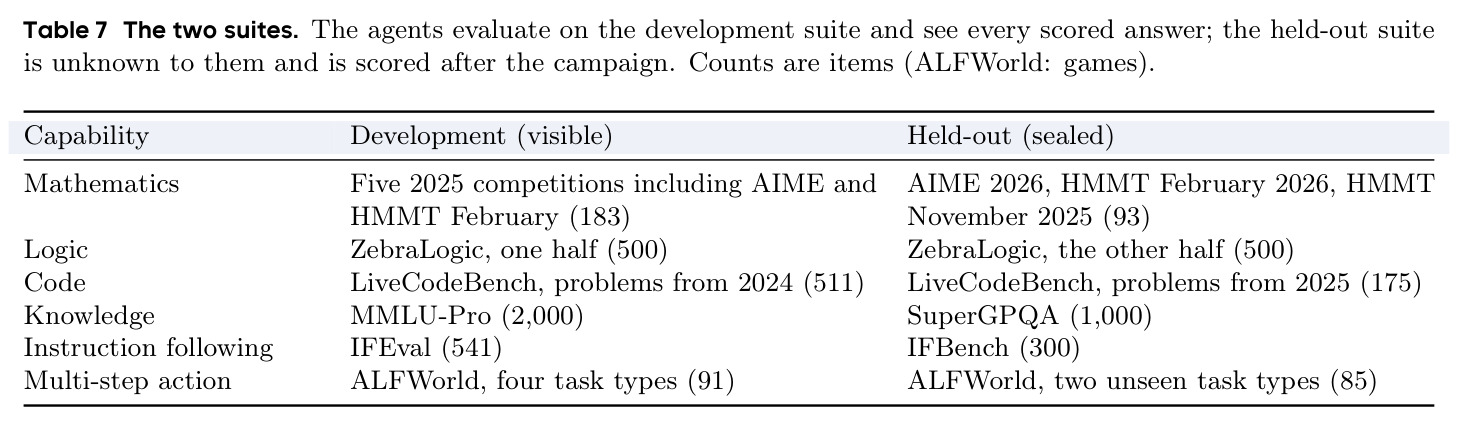
留出套件与开发集每任务一一配对(数学、逻辑、代码、知识、指令遵循、多步动作),但题目来自不同来源或更晚时间窗,智能体全程不可见、战后才评分;去污染指所有引入的公开数据先与评测集做重叠清洗,防止背题。
这是判断智能体是真会做研究还是过拟合评测的关键实验设计。
递归自我改进(RSI)
AI系统利用自身能力构建更强后继系统的循环,被认为是通往超人类智能的候选路线之一。本文是该理念的受控实验:前沿智能体通过修改模型权重来提升模型能力,其产出随算力增长的关系被称为autoresearch scaling。
全文动机所在:检验今天的前沿智能体是否已具备自主做后训练研究的能力。
研究动机
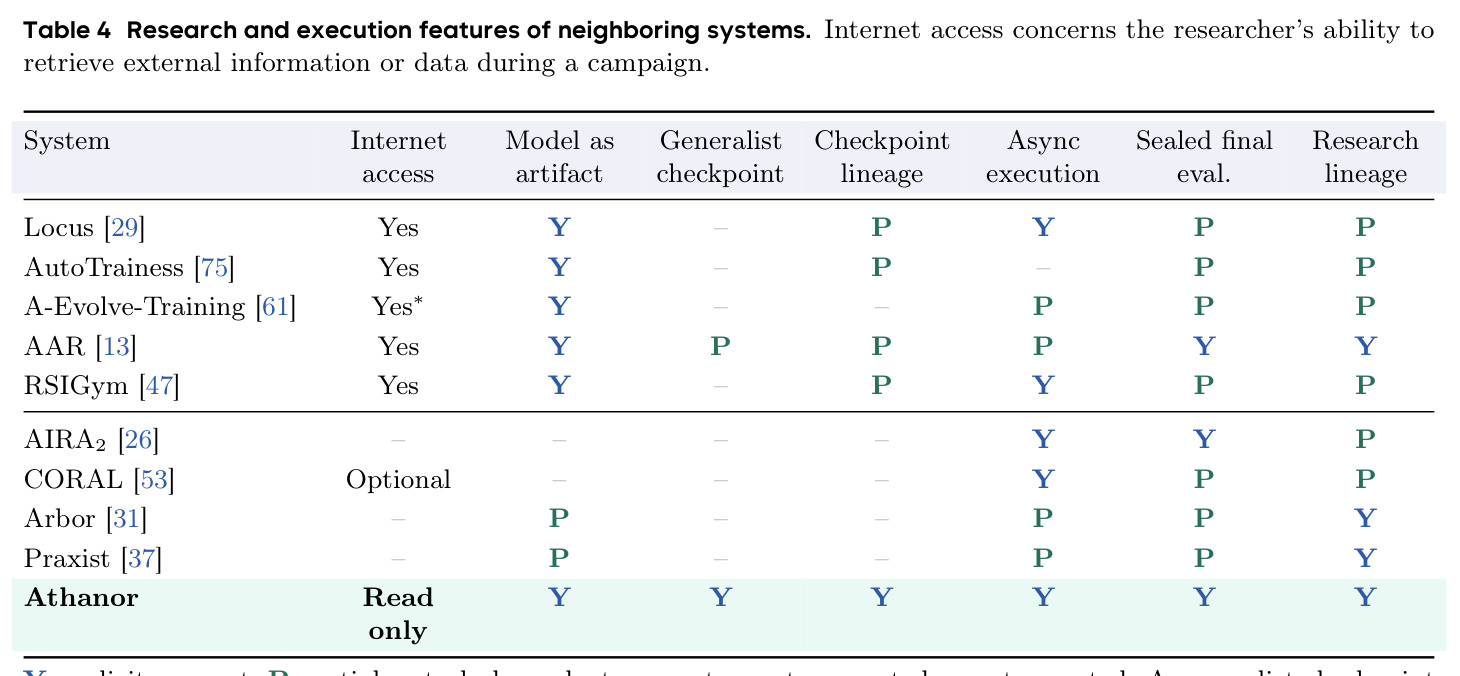
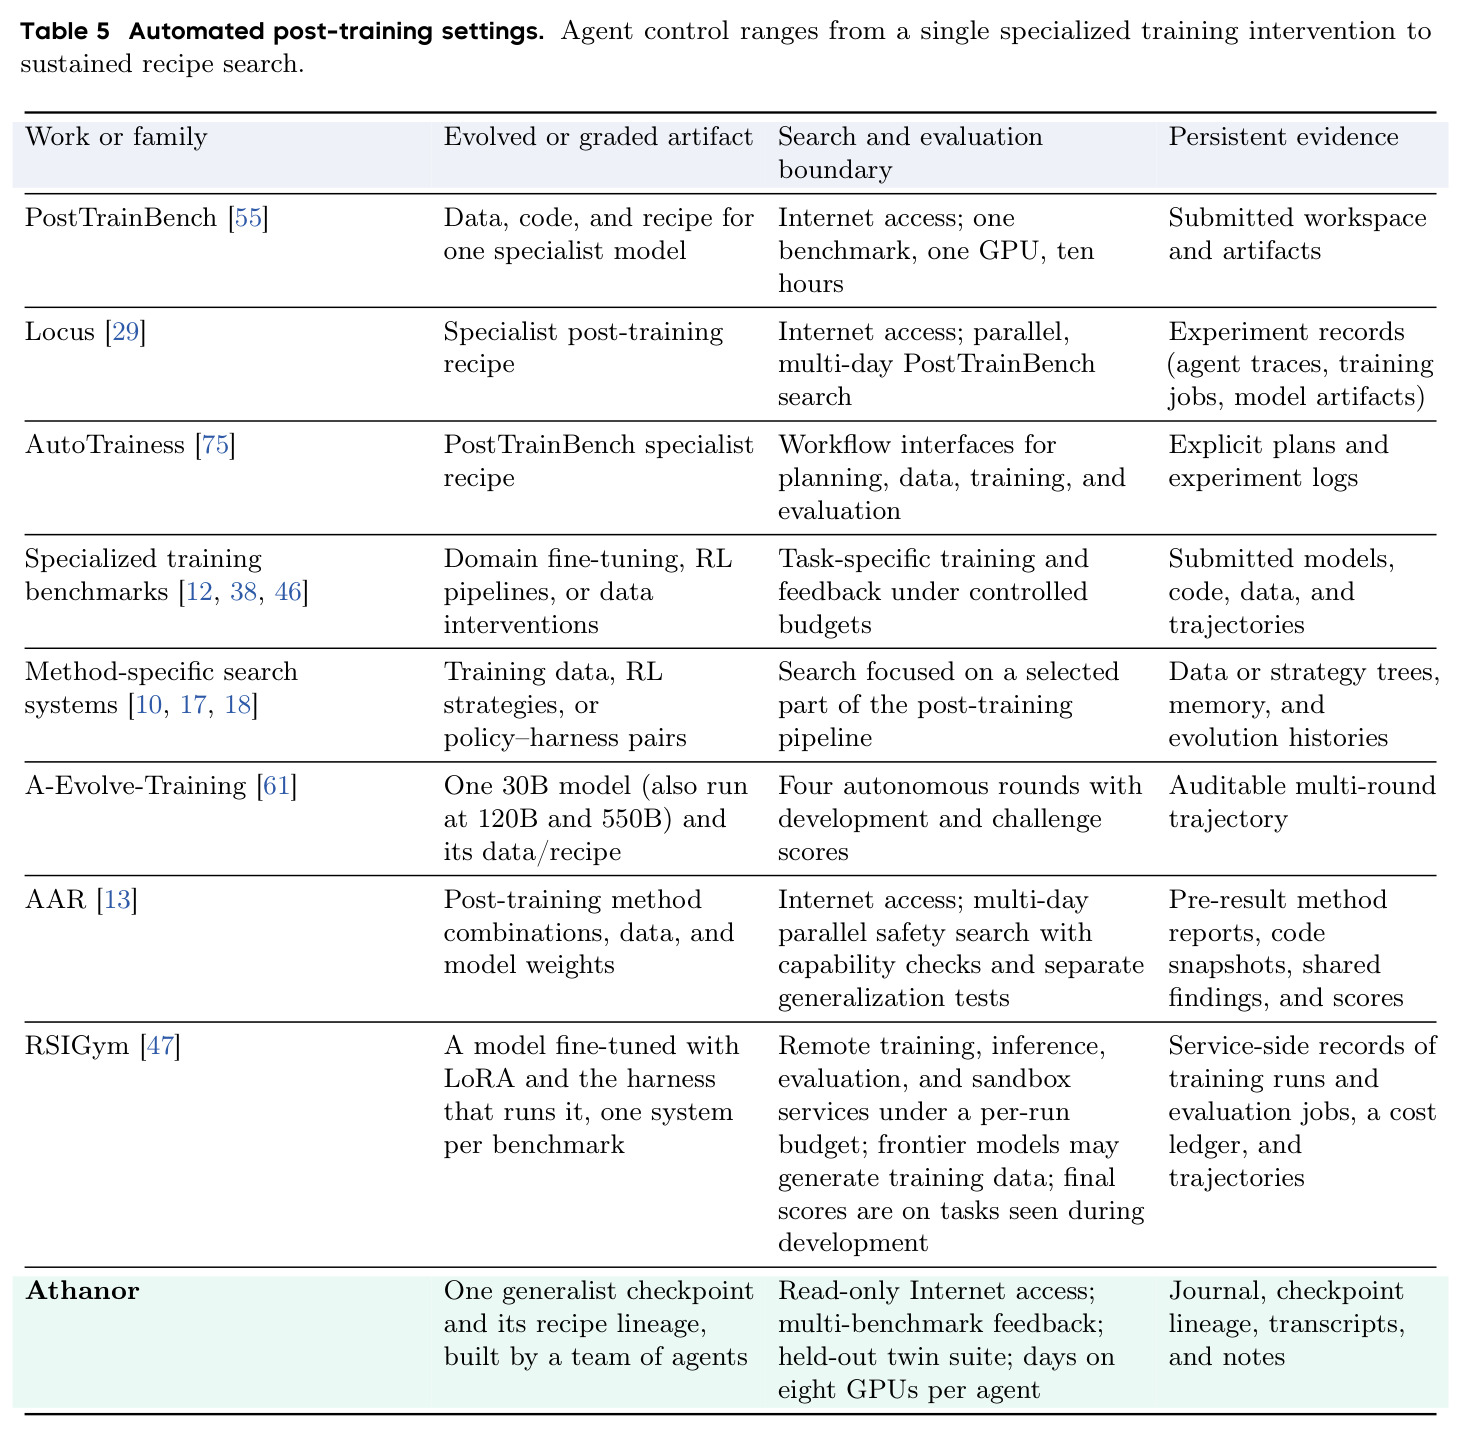
现有工作只研究了这个问题的窄版本:PostTrainBench让智能体在单张GPU上用十小时为一个基准训练一个专用小模型,Locus把它扩展为并行多日搜索,但二者都是每个基准训一个专才模型;RSI-Master、RSIGym等系统则允许调用外部教师模型API,或把训练与评估藏在远端服务后面,且普遍没有对智能体密封的留出评测。另一边,人类的后训练报告(如Tülu 3)通常只公布最终配方,不记录完整的研究轨迹,社区看不到哪些尝试失败了。而后训练搜索本身昂贵且难保诚实:一个假设往往要经过数小时易失败的GPU执行才能被评估,多天的搜索还必须防数据污染、防评测泄露,这些成本使智能体难以直接开展这类研究。
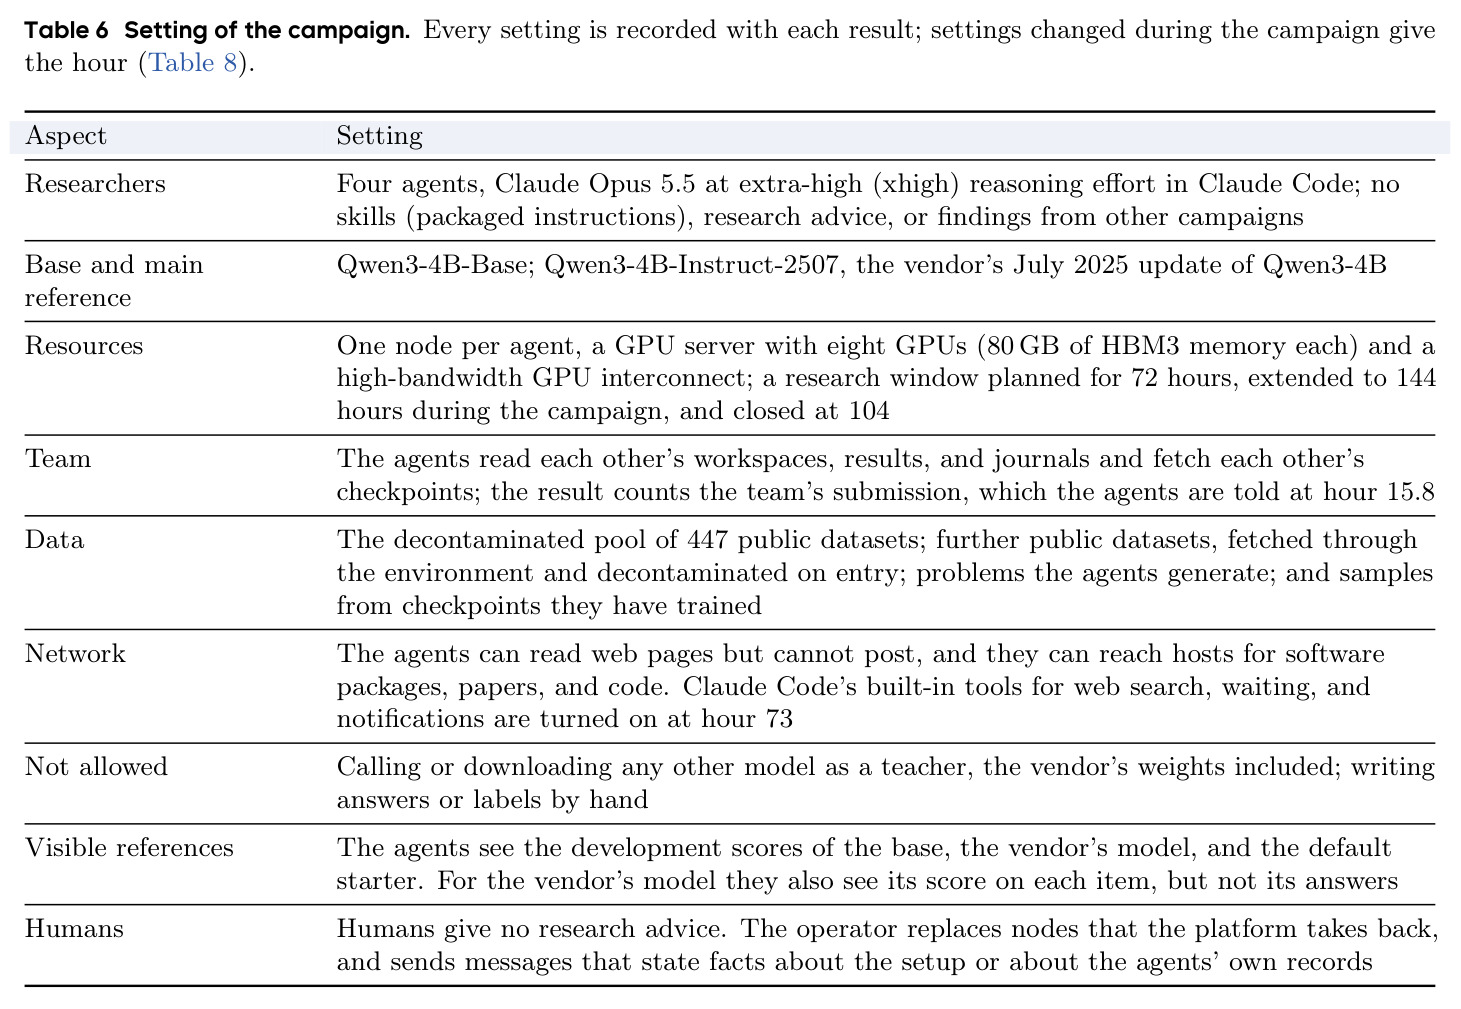
本文的目标是本文提出并研究AutoPostTrain:一队前沿智能体从原始基座模型Qwen3-4B-Base出发,只用公开数据,不调用任何教师模型,也不接受人类研究建议,要产出一个通才检查点,同时在数学、逻辑、代码、知识、指令遵循、多步动作六项能力上提升,并在智能体全程不可见的留出孪生套件上接受最终检验。为此作者构建了开源系统Athanor,组织了一场104小时、四个Claude Opus 5.5智能体(每人一个8×80GB GPU节点)的完整战役,把500个作业、255次全量评估、每个检查点的谱系与全部会话转录记录下来,作为首个可审计的自主后训练研究案例。
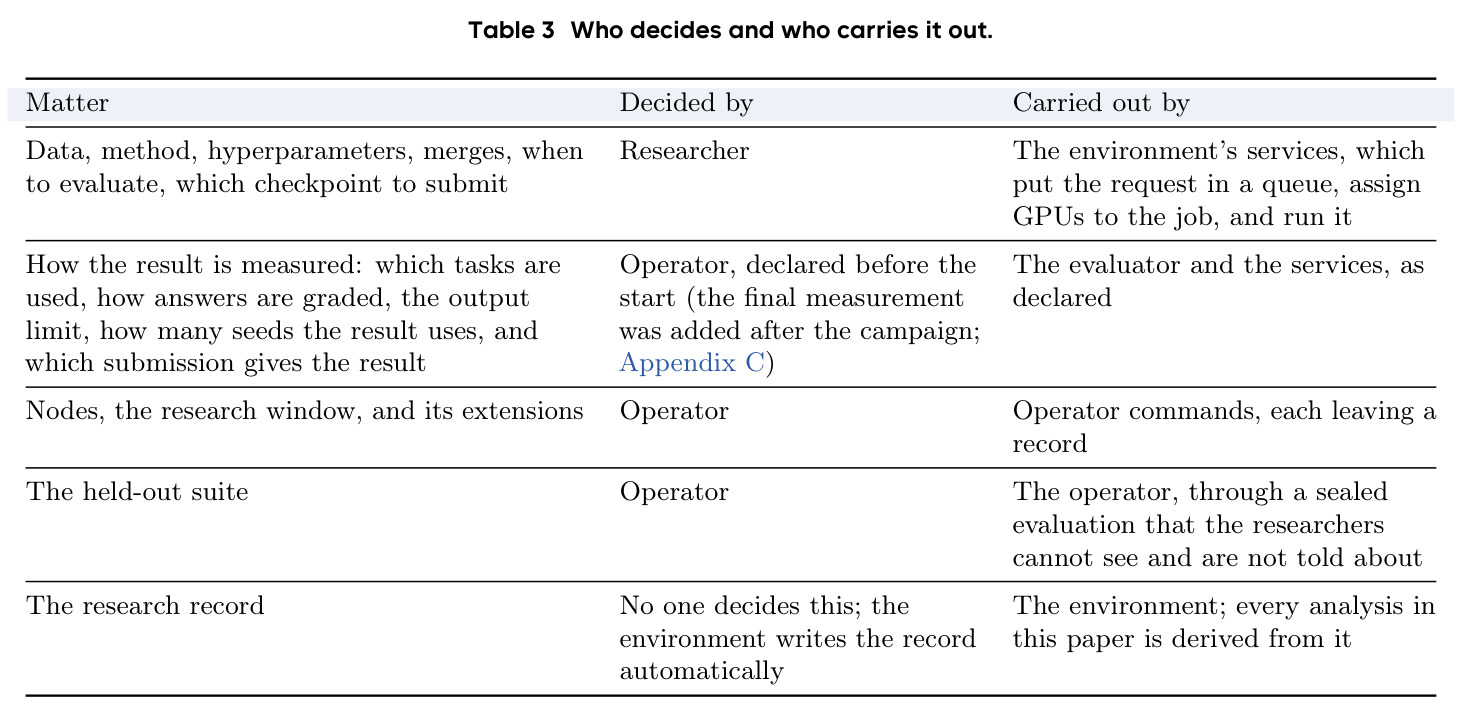
与已有工作不同的是,作者的独特切入点是一个设计论点:随着智能体智力提升,自主研究的瓶颈从“生成貌似合理的点子”转向“执行与验证点子的摩擦”——没有托管的执行环境,智能体会花数小时调试训练基础设施,并为每个实验重建同样的机器。因此Athanor不给智能体设计研究流程:遵循bitter lesson,早期版本中按配方填表、逐实验审批、中央调度器等脚手架反而更束缚强模型(其他团队也报告过类似现象)。它把后训练研究做成可编程的原子操作(athanor job/eval/data/artifact),由智能体用自己的shell和代码工具自由组合,同时用冻结评估器、密封留出集和持久研究记录保证长程搜索又快又诚实——这比既有智能体系统在每个环节上都选了更难的设定。
核心方法
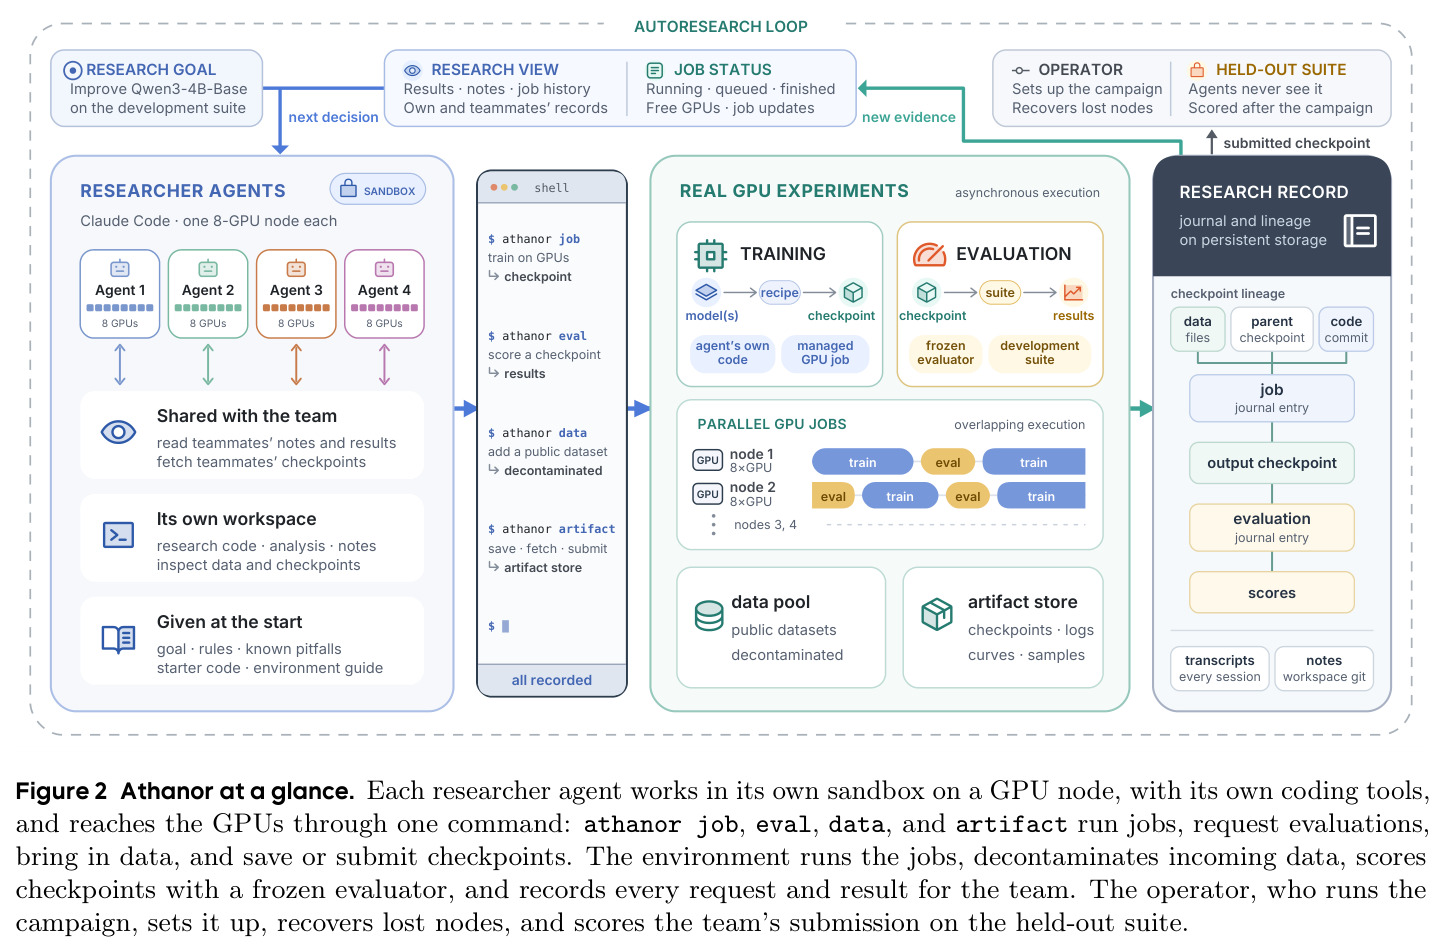
直觉上,Athanor把“决定做什么研究”与“把实验跑起来”彻底分开:智能体只负责看数据、写训练程序、决定下一个实验;环境负责排队、执行、评估、宕机恢复和记账。技术上,AutoPostTrain被形式化为配方空间上的随机黑盒爬山:第 $t$ 步智能体依历史 $H_{t-1}$ 提出配方 $r_t\sim\pi(\cdot\mid H_{t-1})$,执行产生检查点 $M_t=\mathrm{Exec}(r_t)$,冻结评估器返回分数 $\hat{p}_t=\mathrm{Eval}_{\mathcal{B}}(M_t;\xi_t)$,检查点池 $P_t=P_{t-1}\cup\{M_t\}$ 随之增长,最终目标是在池中找潜能力 $c(M)$ 最高者。系统由两个并发循环构成:每个研究智能体的研究循环(inspect阅读记录→develop分析决策→athanor(action)执行)与环境的服务循环(训练、评估、去污染、存储),两者共享同一份持久研究记录;每个命令立即返回,作业后台执行,结果一到达就推送进智能体会话。
核心创新是“智能体原生”设计,与给智能体套研究脚手架的既有系统有本质区别,体现为三条原则。其一,研究决策与执行分离:智能体决定 $r_t$,环境承担资源分配、任务执行、检查点存储、评估与恢复,评估器在沙箱之外冻结运行,智能体无法影响度量自己的标尺。其二,研究状态外化:请求、结果、检查点谱系(lineage)、会话转录与笔记版本全部存于智能体上下文之外的持久记录,会话可随时恢复或迁移到新节点,多个智能体得以作为团队读写彼此的证据——这是长程搜索和团队协作的前提。其三,保持回路高效:训练作业常需数小时,逐个等待会让GPU大量闲置,Athanor允许多个实验“同时在飞”,作业归属环境而非会话,会话结束作业不死。环境本身不做任何研究决策:不选方向、不审批实验、不解读结果,作者明确报告按配方填表和审批制会约束强智能体的判断。
方法步骤详情
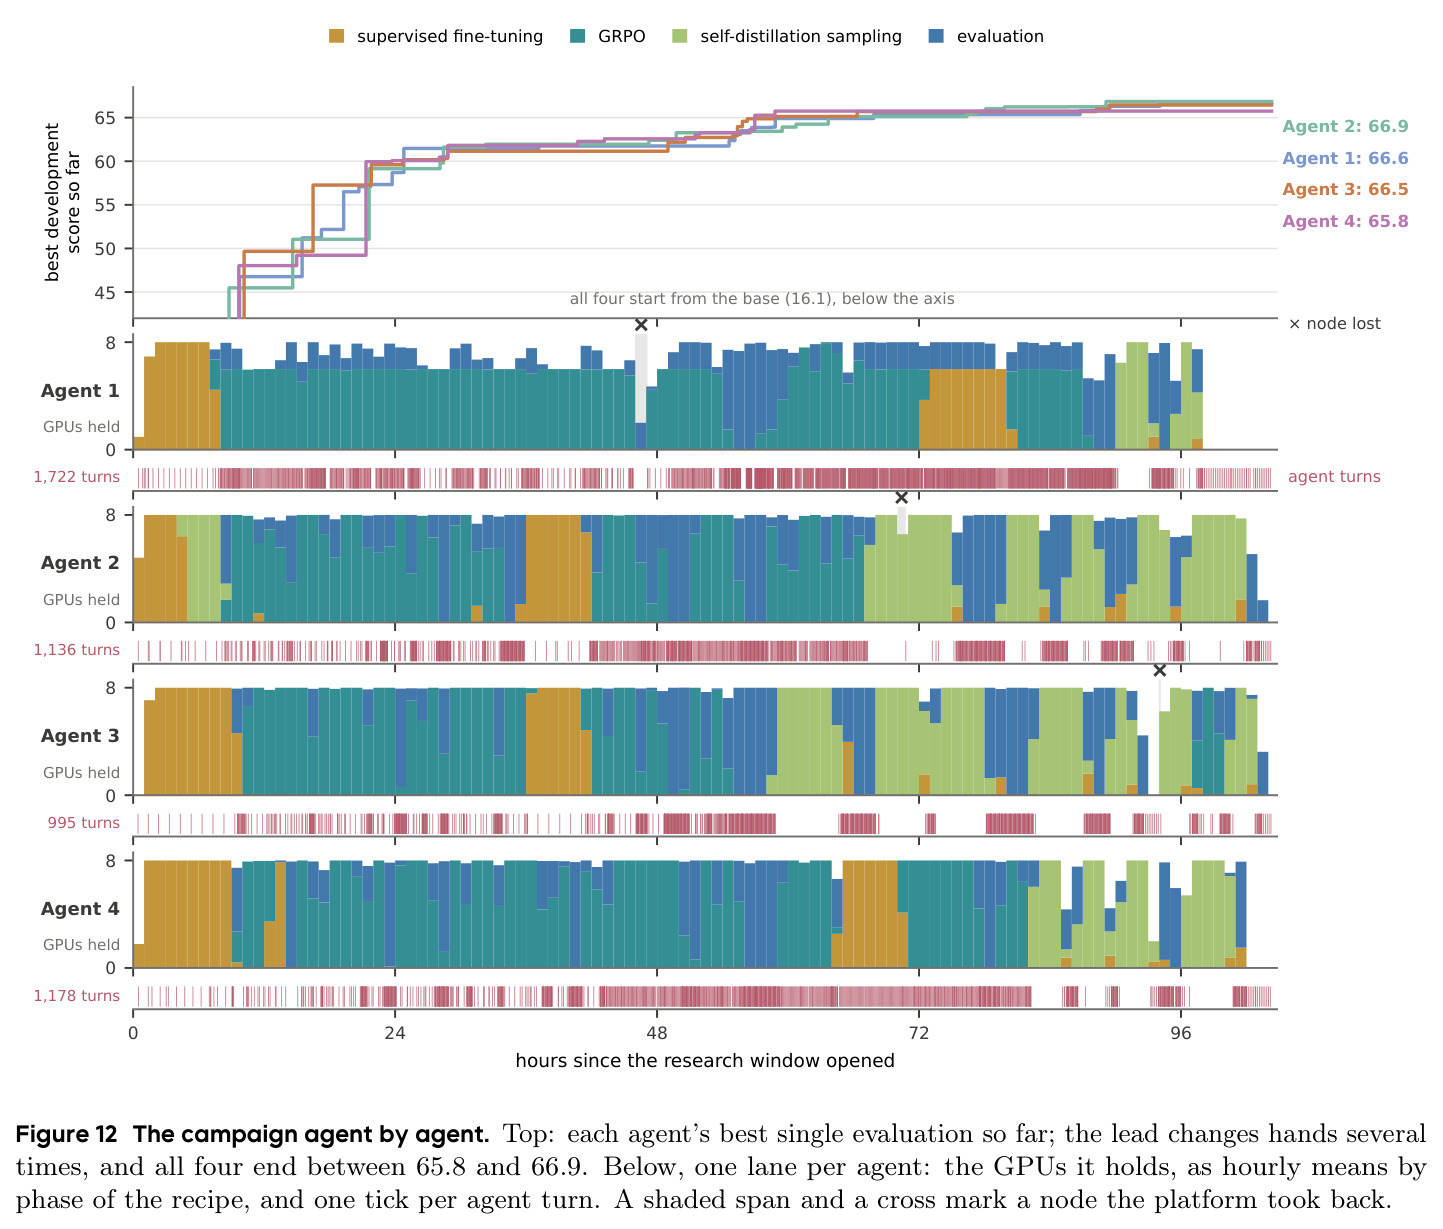
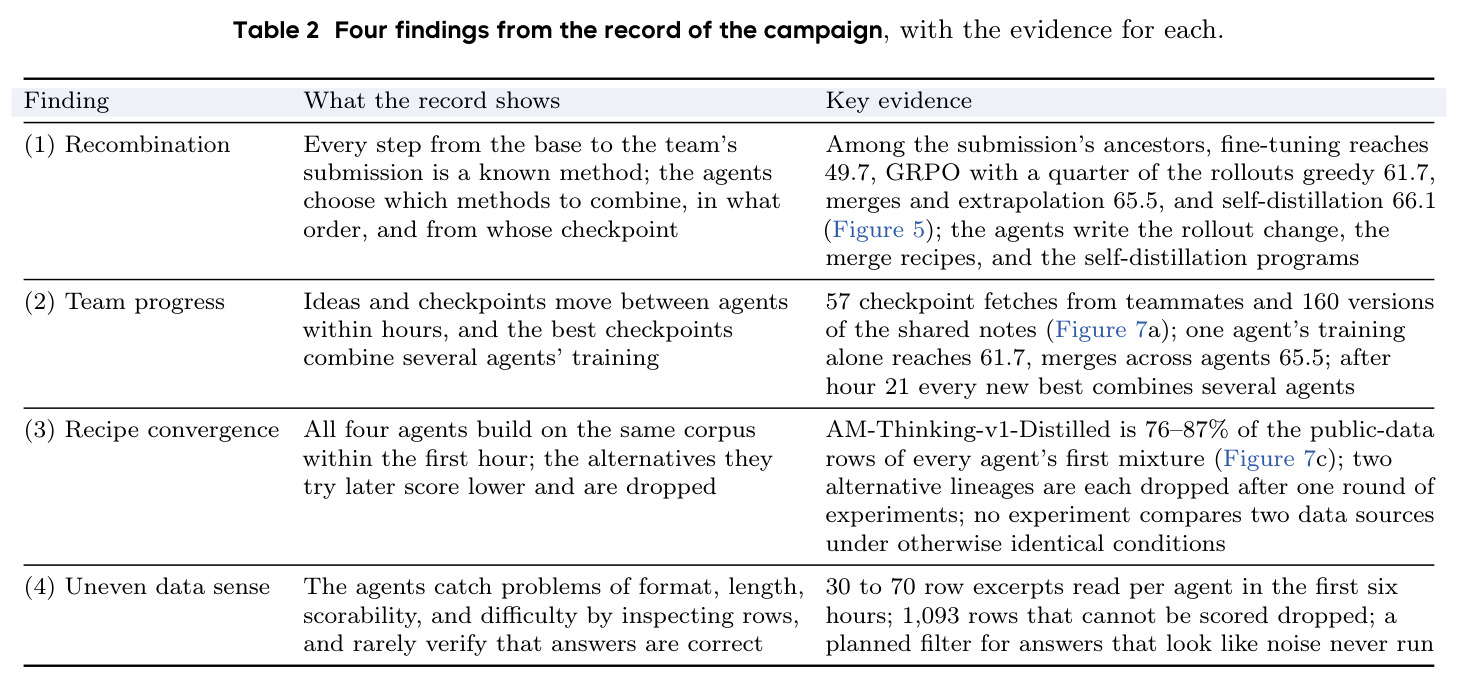
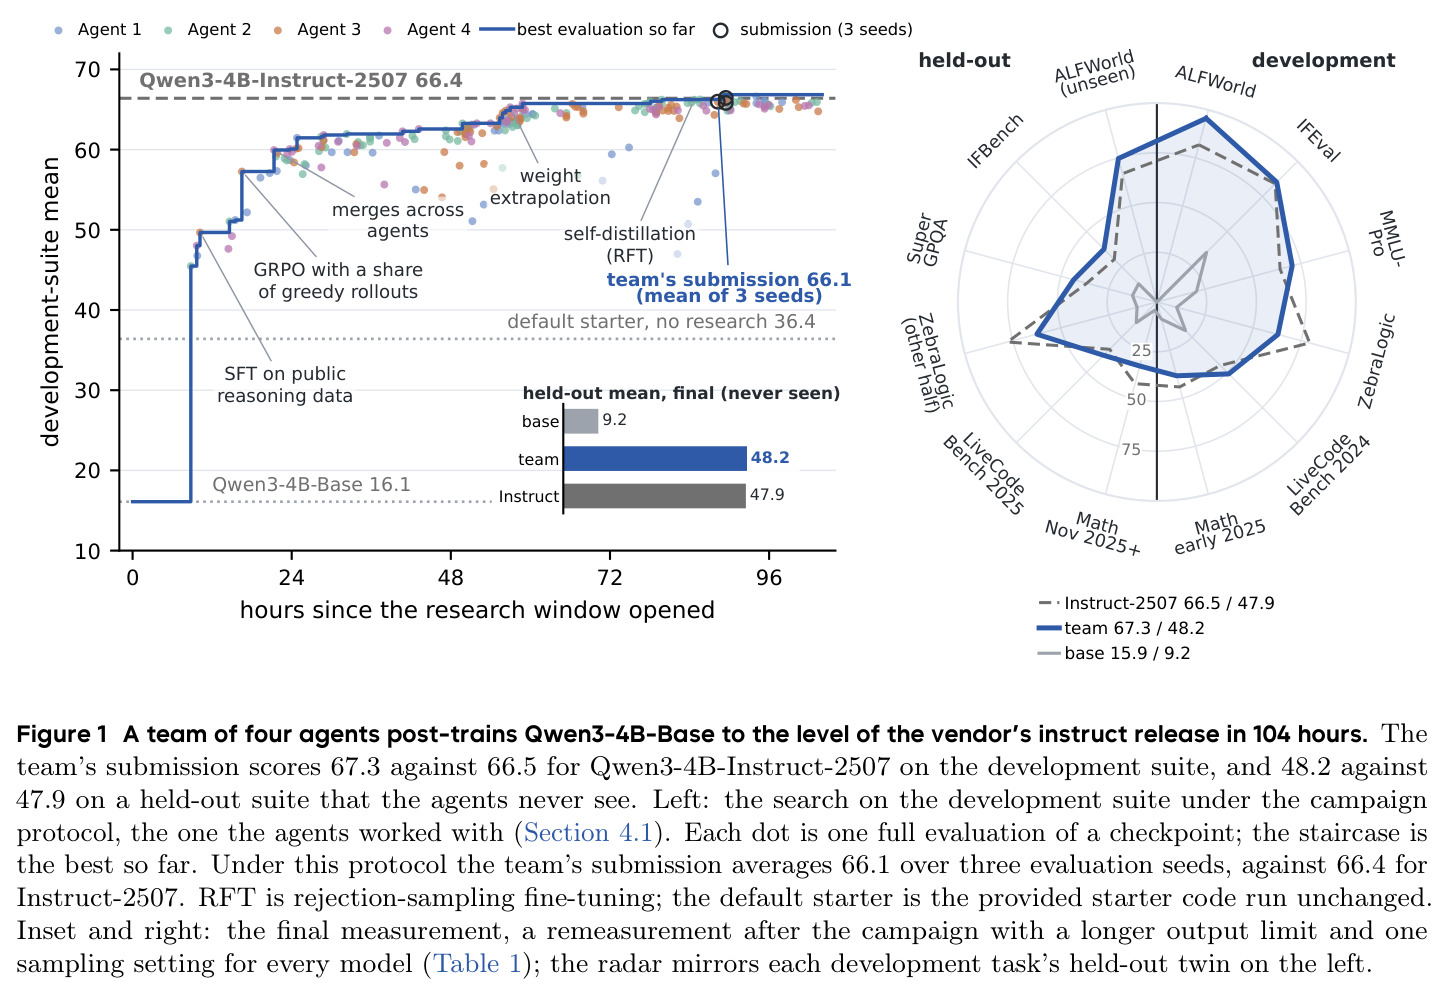
战役侧:四个Claude Opus 5.5智能体(Claude Code)各占一个8卡80GB节点,目标只有一句话“把Qwen3-4B-Base后训练后在开发套件上尽量高分”;启动代码(可改可弃)基于verl与mergekit,覆盖SFT、GRPO、交互环境RL、在线策略蒸馏、谜题生成、ALFWorld轨迹回放与权重合并。智能体通过四个动词操作GPU:athanor job启动训练、eval请求全量评估并拿回每题得分、data引入公开数据(自动先去污染)、artifact存取或提交检查点。团队实际收敛出的配方四阶段:①SFT——第一小时内各建30–60万行混合数据(76–87%来自AM-Thinking-v1-Distilled蒸馏语料,另加ALFWorld轨迹),训一轮,16.1→49.7;②GRPO——Agent 3发现贪心解码陷入重复循环而常规GRPO无效(循环答案在采样rollout中罕见),改为每条rollout以1/4概率贪心解码,循环得零分形成负优势,验证集循环数86→18,分数49.7→57.3(后至61.7);③跨智能体合并——平均三个队友模型再按 $\theta=\theta_{\text{base}}+f(\theta_{\text{merged}}-\theta_{\text{base}})$、$f=1.2\sim1.3$ 外推,以知识换逻辑,→65.5;④自蒸馏RFT——每题采4答案保留最短正确者微调,两智能体各跑后平均,→66.1提交。
技术新颖性
技术新颖性不在发明新训练算法——最终配方全部由已知方法(SFT、GRPO、合并、RFT)重组——而在系统与科学层面。第一,把后训练研究“可编程化”:启动作业、评估检查点、引入数据成为原子操作,智能体用通用代码工具组合它们,消除了以往智能体为每个实验重建基础设施、数小时调试训练栈的摩擦。第二,研究记录作为一等公民:journal(时间序日志)、lineage(检查点谱系)、transcript(完整会话文本)、workspace历史四类条目使任何分数都能回溯到基座与每一步训练/合并;Trace 1式的因果发现(从被截断答案诊断重复循环→修改rollout策略→全队六小时内采纳)正依赖于此,只存分数的记录无法支撑。第三,“元循环”改进理念:每场战役后阅读智能体轨迹寻找摩擦点,改进的是环境工具而非研究流程。据作者所知,这也是首个智能体团队自主把原始基座训到厂商instruct水平并在密封留出集上确认的公开演示。
实验结果
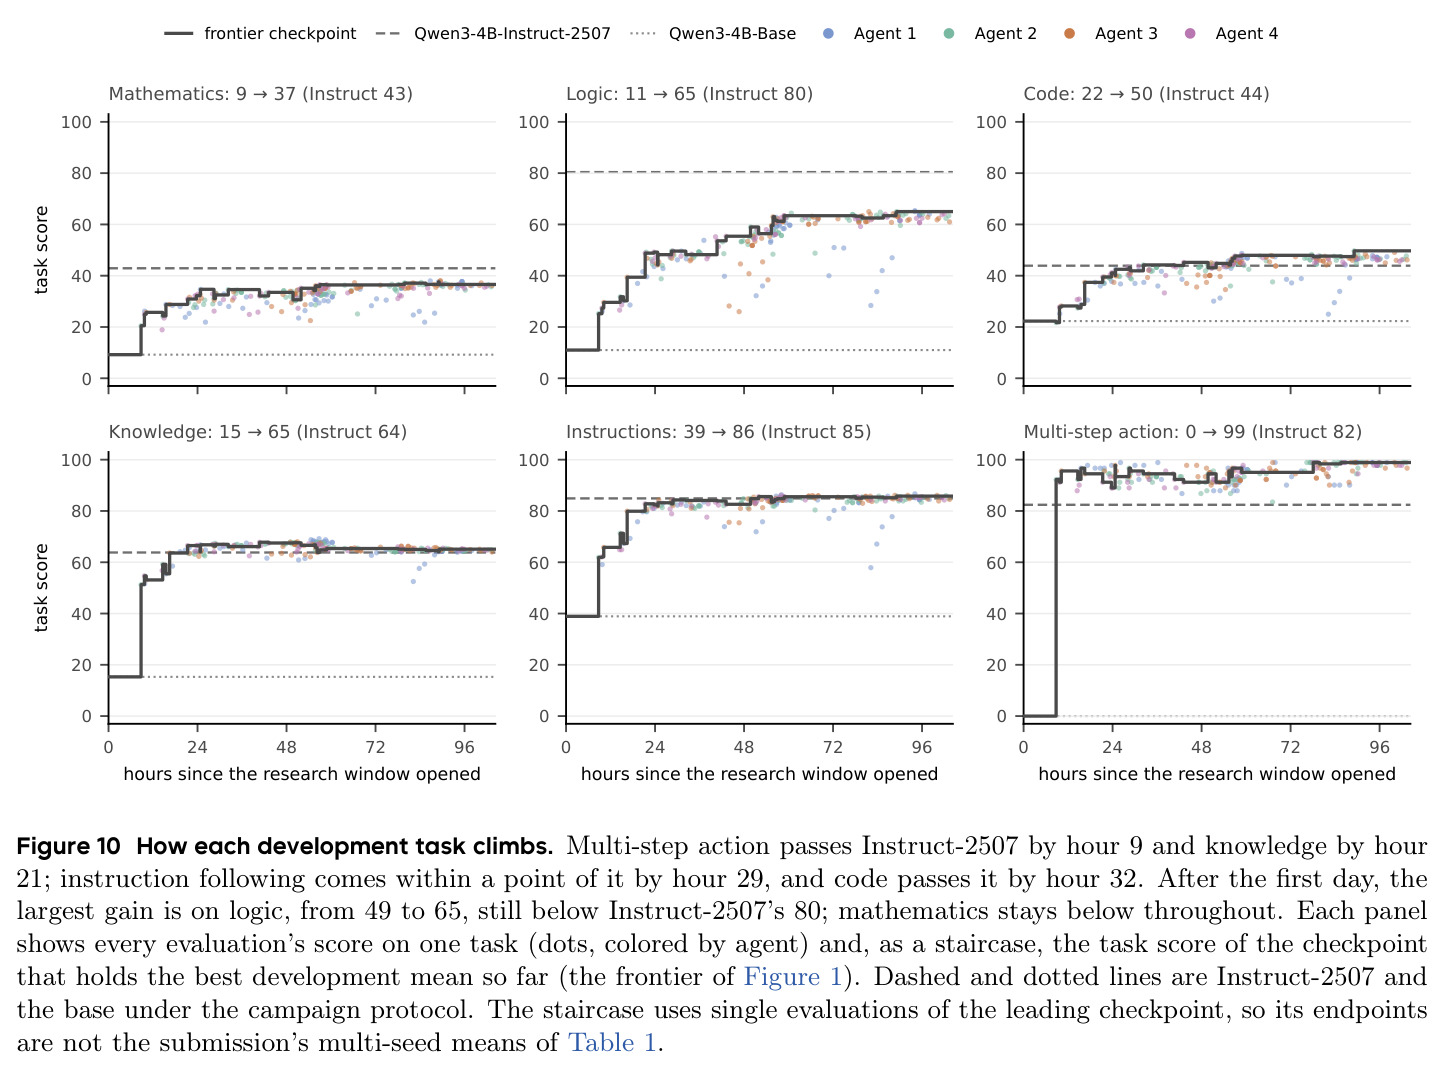
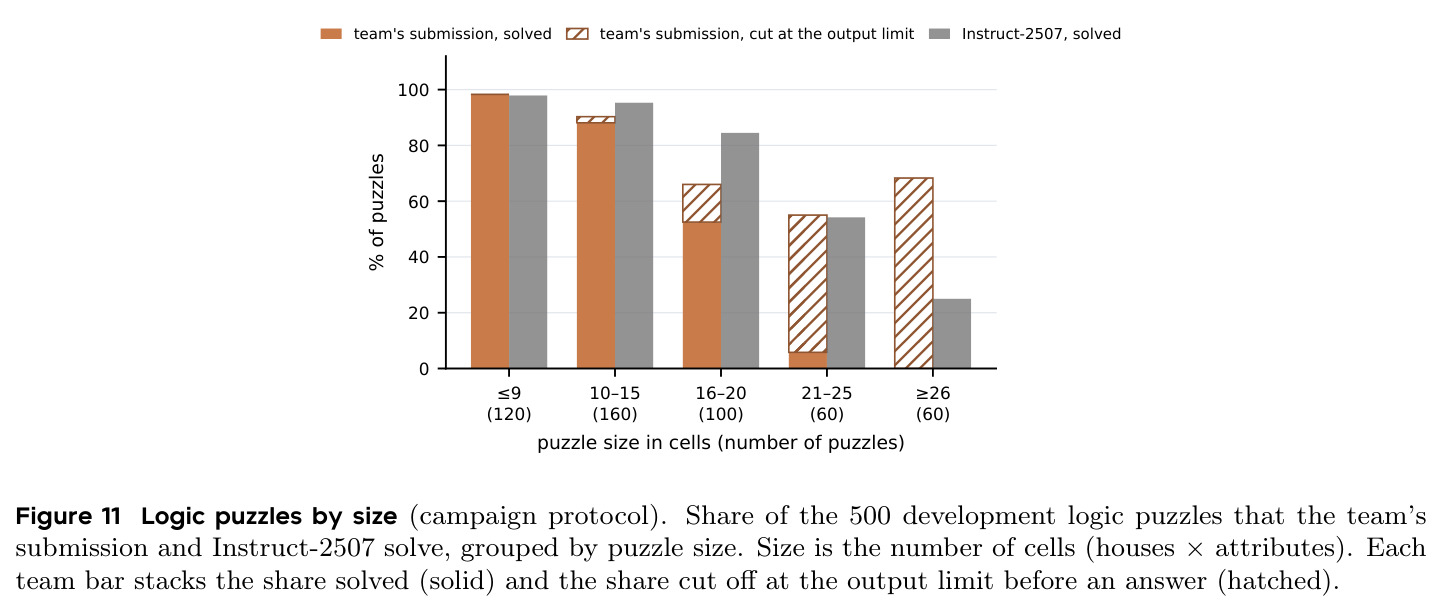
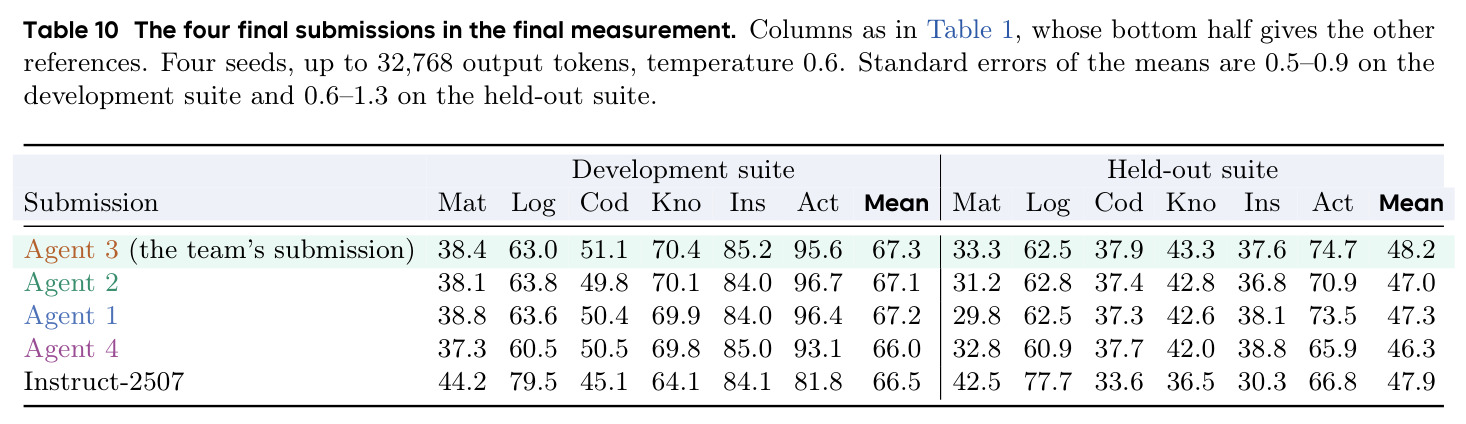
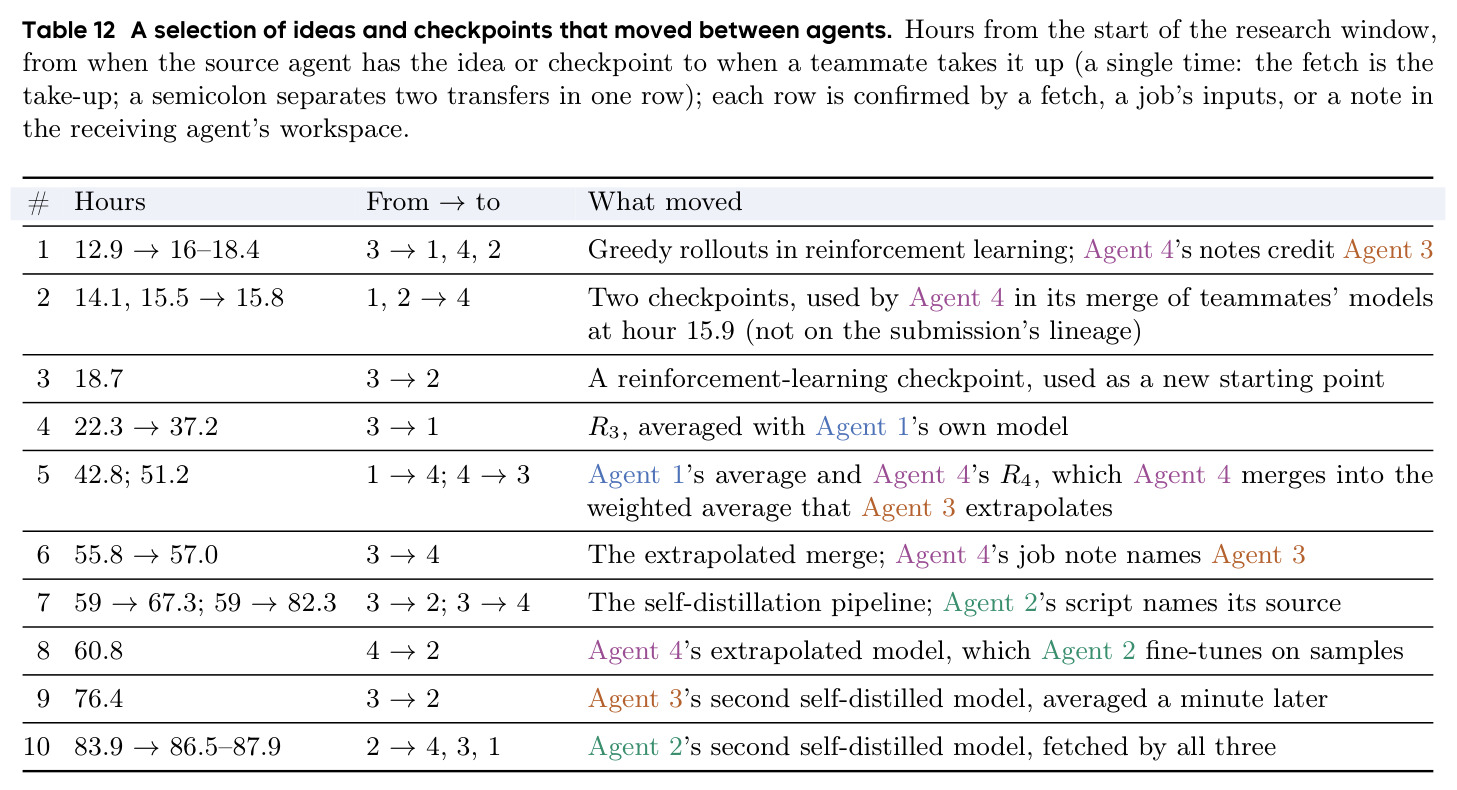
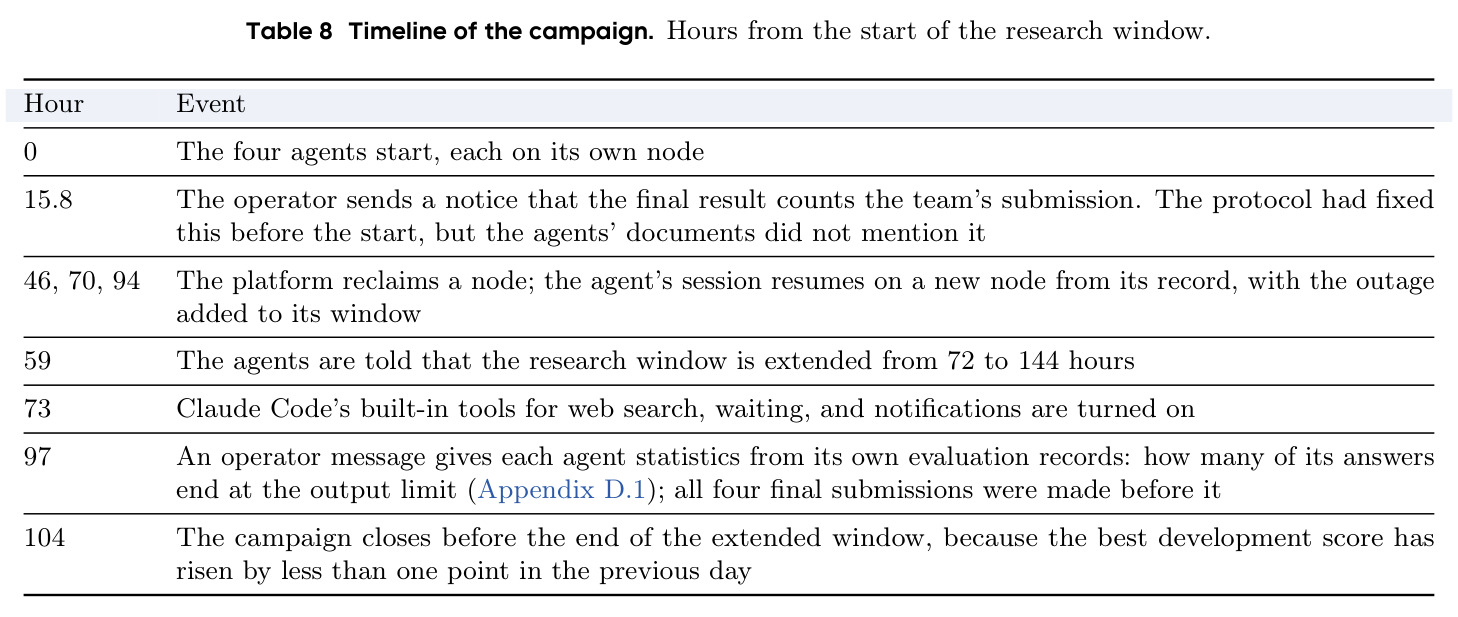
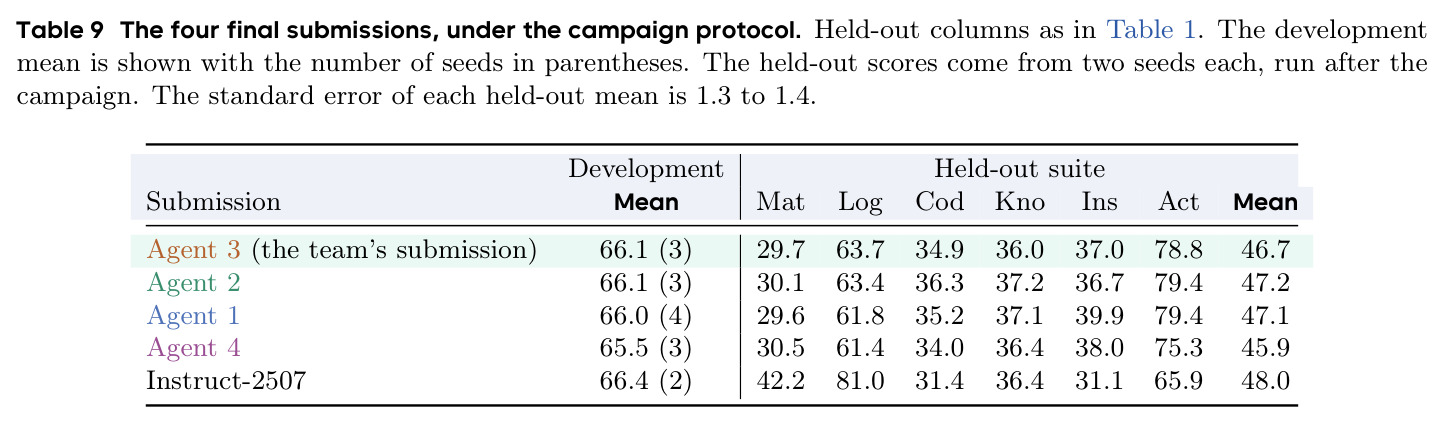
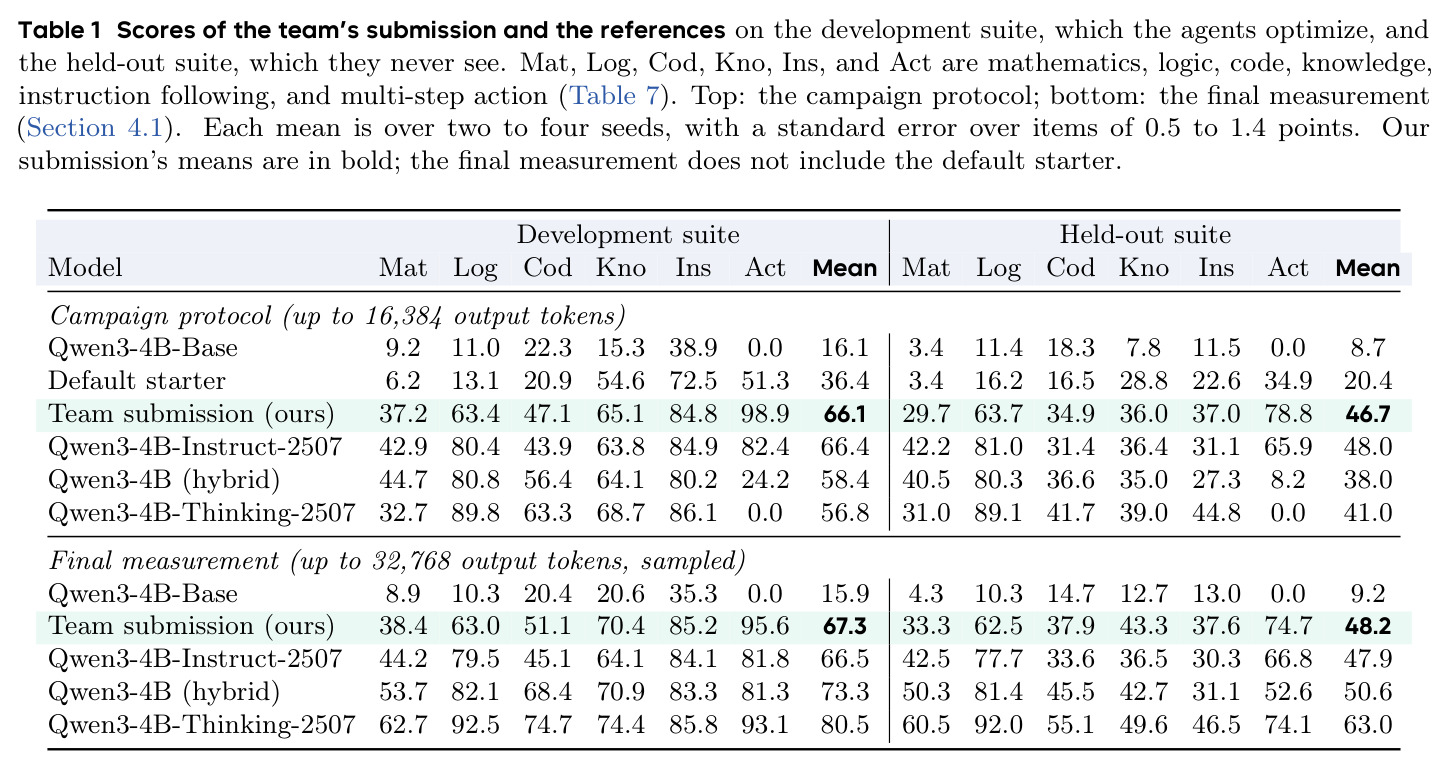
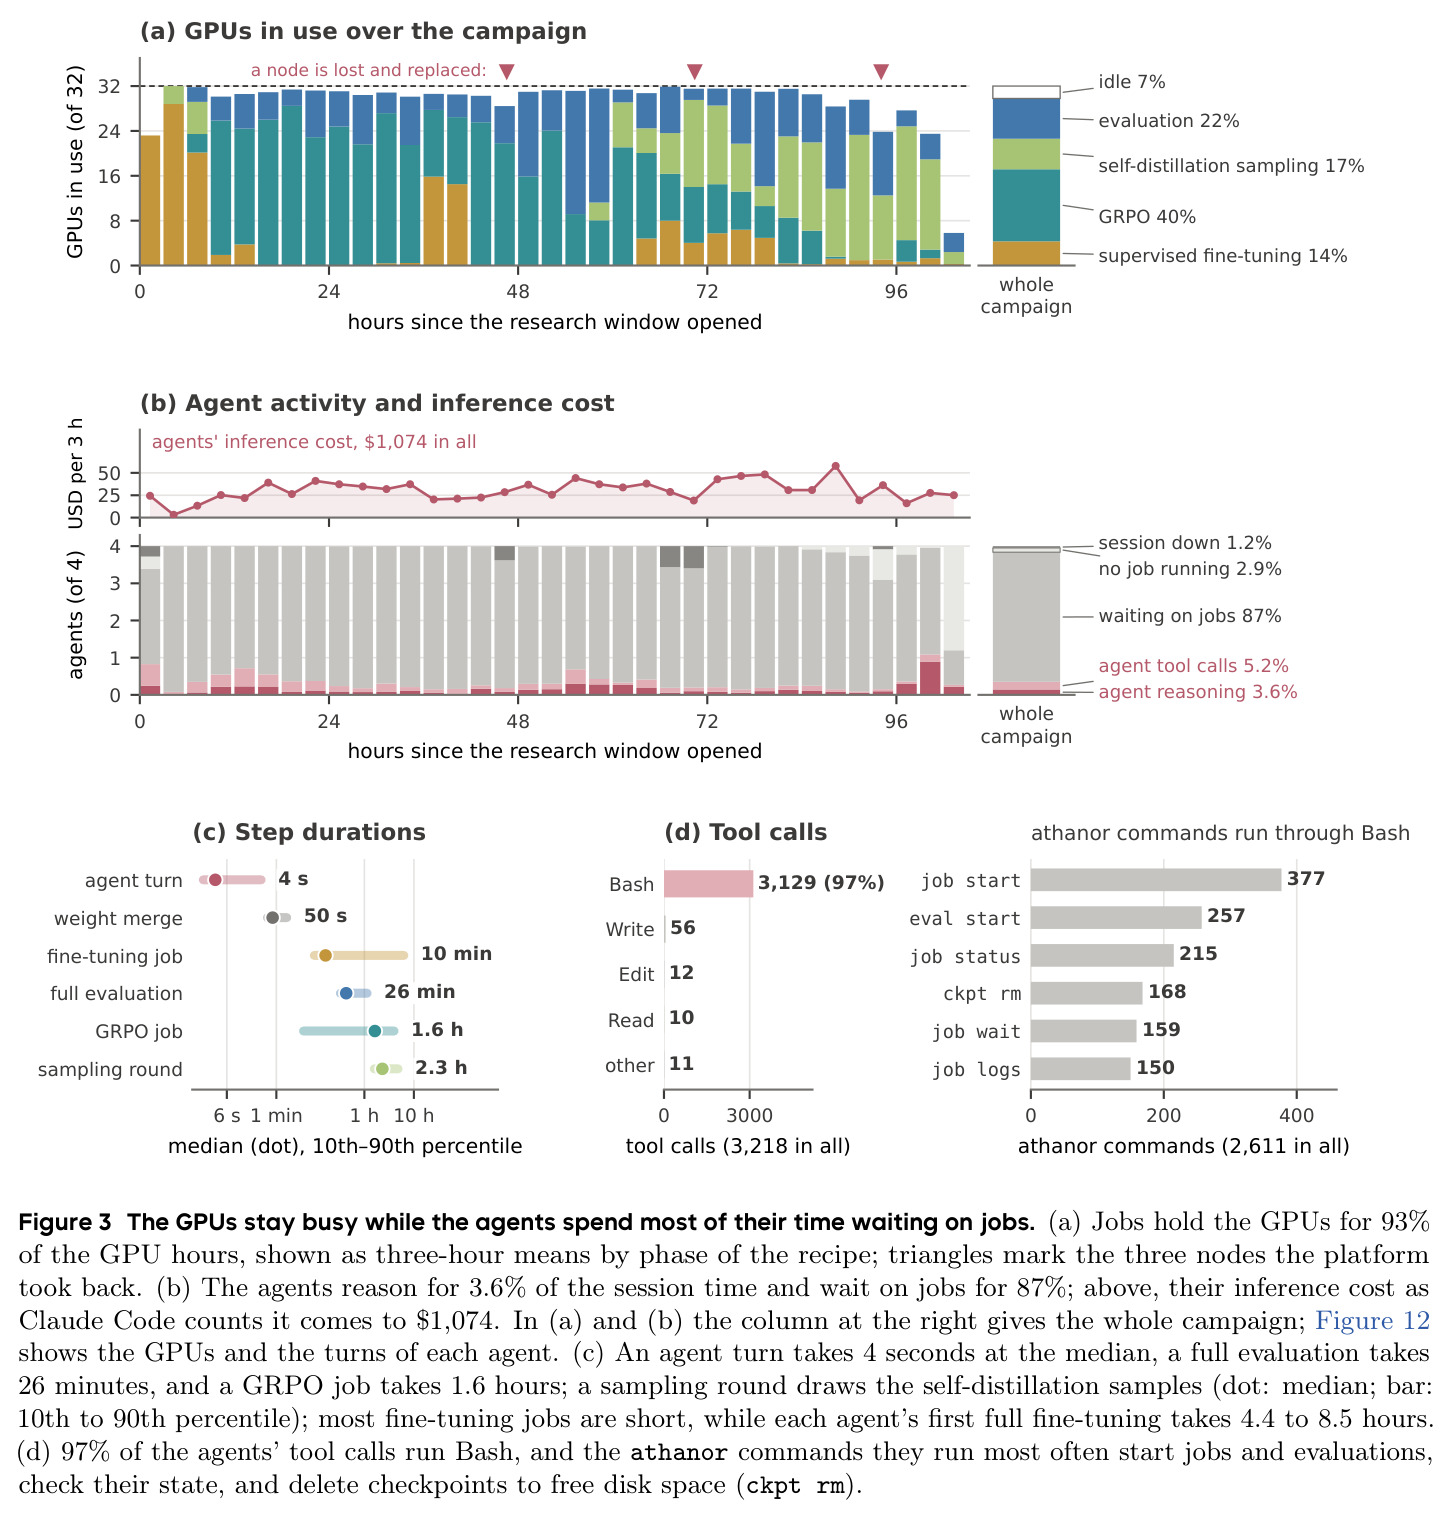
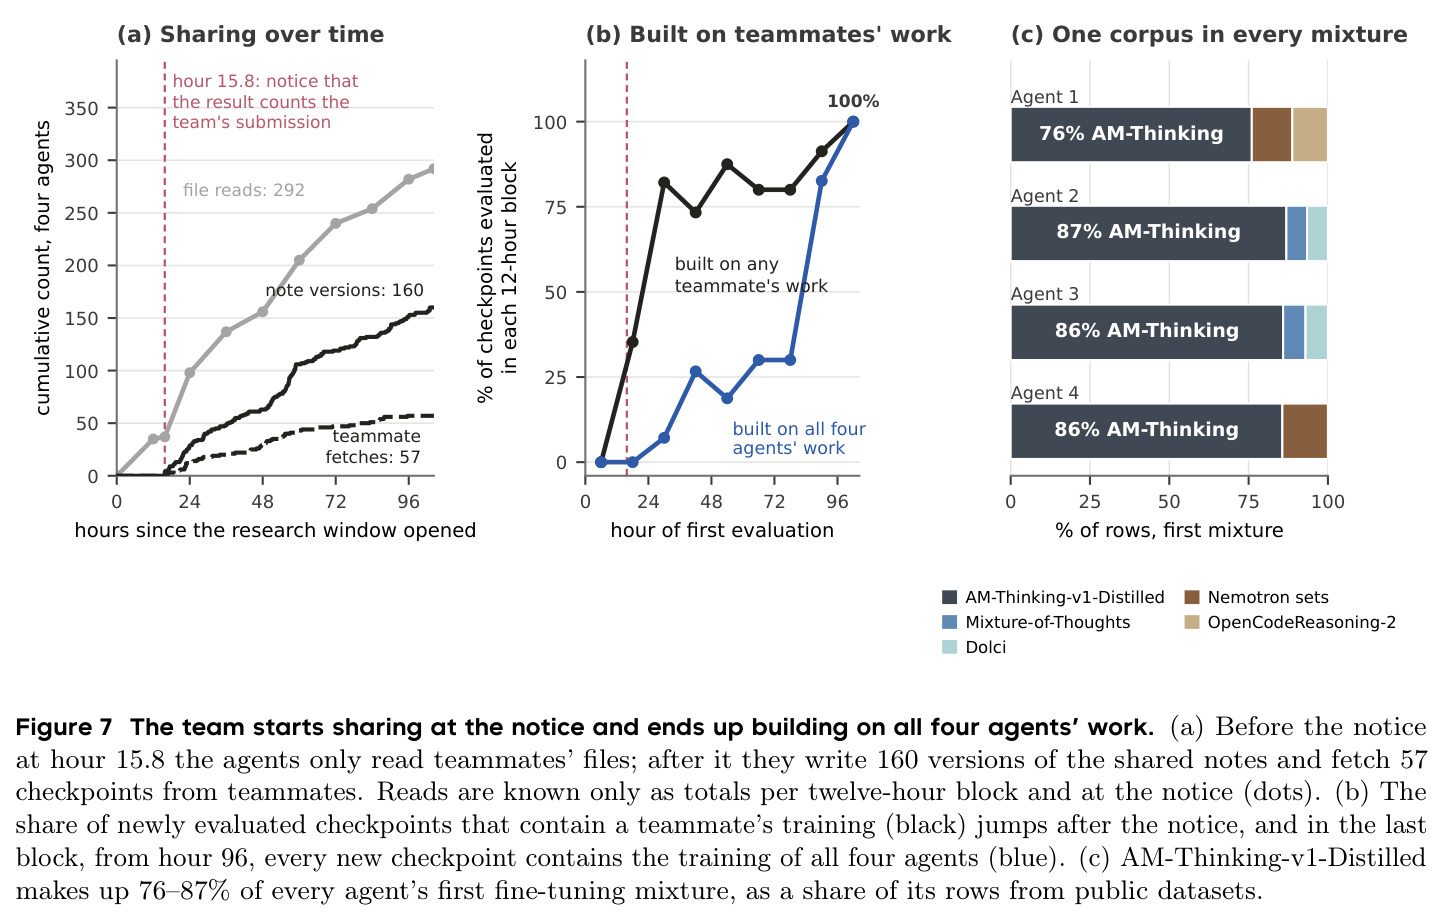
主结果(最终测量,32,768输出token、统一采样):团队提交模型把Qwen3-4B-Base从开发套件15.9提到67.3、留出套件从9.2提到48.2,达到乃至超过官方Qwen3-4B-Instruct-2507(66.5/47.9),配对95%置信区间(−0.8~+2.4与−2.0~+2.6)均含零;战役协议下为66.1±0.8对66.4、留出46.7±1.3对48.0,提交在留出集上关闭了基座到Instruct差距的97%(默认启动代码只关闭30%)。任务画像:多步动作98.9对82.4、代码47.1对43.9占优,逻辑63.4对80.4、数学37.2对42.9落后(18%/24%的答案被输出上限截断),若无动作任务则落后3.7分。执行效率:作业占93%可用GPU小时(3,086/3,315),GRPO独占40%;智能体87%时间在等作业、仅3.6%(约15小时)在推理思考,GPU等智能体不足1%;三次节点被平台收回仅损失23 GPU小时,500个作业中26个失败。成本约$11,800:GPU按$3.49/卡时计$10,800,四个智能体推理仅$1,074(9%);分数到50只花$1,100、到60花$2,400。团队动力学:“计团队成绩”通知后56秒发生首次跨队友检查点获取,此后160版共享笔记、57次检查点获取;21小时起每个新最优都结合多个智能体的训练,287条谱系边中139条经过队友检查点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六能力开发套件(最终测量) | 六任务平均分 | 67.3 | Qwen3-4B-Instruct-2507 66.5;基座15.9 | 超过官方instruct版0.8分,较基座+51.4 |
| 留出孪生套件(最终测量) | 六任务平均分 | 48.2 | Instruct-2507 47.9;基座9.2 | 与instruct版持平略超;关闭基座-专家差距的97% |
| 多步动作ALFWorld(开发/留出) | 成功率 | 98.9 / 78.8 | Instruct-2507 82.4 / 65.9 | +16.5 / +12.9,且对未见任务类型迁移成功 |
| 代码LiveCodeBench(开发) | 准确率 | 47.1 | Instruct-2507 43.9 | +3.2 |
| 逻辑ZebraLogic(开发) | 准确率 | 63.4 | Instruct-2507 80.4 | −17.0(落后项,主因是大尺寸谜题而非截断) |
局限与改进
作者承认:结果来自单场战役、单一4B基座、四个完全相同的智能体;四个提交共享工作而非独立重复,无法估计战役间方差,也没有“不共享”对照来量化团队增益;配方能否迁移到更大模型或其他模型族未测;团队只达到厂商instruct版,未及两个推理版(最终测量下hybrid 73.3/50.6、Thinking-2507 80.5/63.0);且虽未调用教师模型,公开微调数据本身多是发布者从更强模型蒸馏而来,结论只是“智能体能用公开资源做到”。我的补充观察:逻辑/数学短板并非全由截断造成(放宽token后逻辑仅63.4→63.0),团队没有尝试按题目难度分配推理预算或压缩思维链;搜索对单次评估的选择偏差敏感,需额外23次复评修正(19次首评偏高,符号检验 $p=0.003$);执行栈也有浪费——GRPO等待最长rollout造成155 GPU小时利用率低于10%,作业与评估冷启动另耗约90 GPU小时。
独立分析的弱点
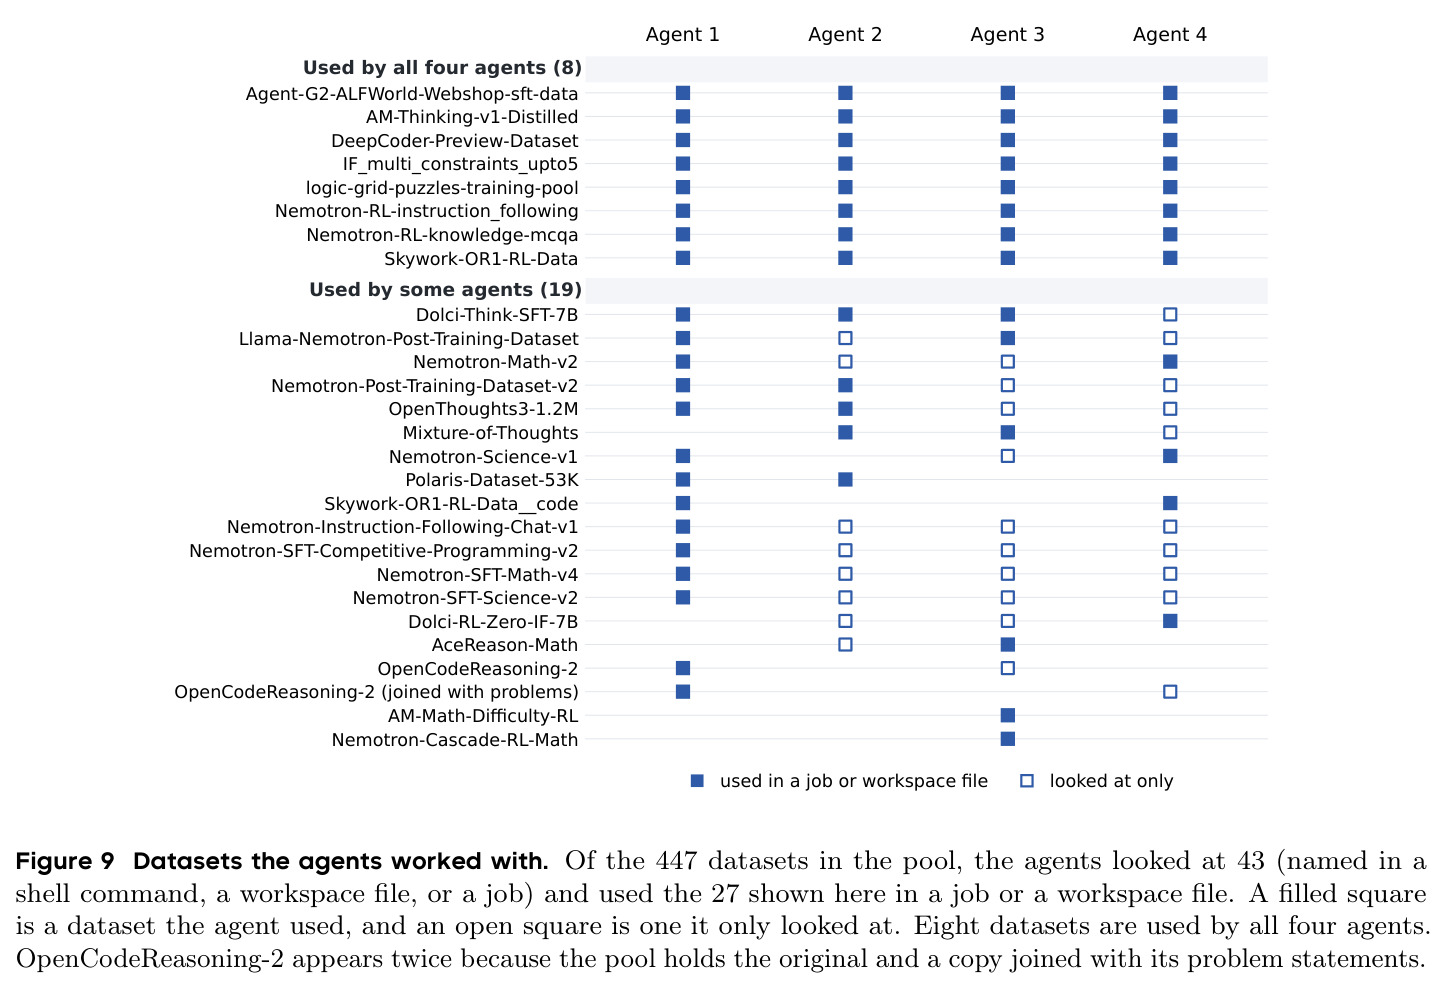
弱点一:数据正确性检查缺失。智能体仔细检查格式、长度、可评分性与难度——前六小时每人读30–70行样本、丢弃1,093条无法评分的指令行、修复把所有谜题误判为重复的去重bug——却几乎从不验证答案对错:有智能体发现部分标准答案“像噪声”,计划了过滤却从未执行。改进方向:环境提供廉价的答案一致性抽检工具,或把答案校验设为RFT前的硬性检查点。弱点二:想法多样性不足。四个同源智能体第一小时即收敛到同一语料(占各混合76–87%),447个数据集只看43个、用27个,两条另立数据谱系失败后无人再试,呈典型的共享“想法盆地”。改进:混入不同家族/强度的异构智能体,或设置强制探索预算。弱点三:单次评估天然偏高(首评平均高出0.4分、至多1.1分),依赖智能体自发多种子复评。改进:环境对逼近历史最优的候选自动追加评估种子。弱点四:GRPO同步rollout与作业冷启动合计浪费约245 GPU小时。改进:异步/部分rollout与环境预热缓存。
未来方向
作者展望:把整个研究闭环逐步交给AI——智能体自建评测套件、自建下一代autoresearch环境、运行数据飞轮(生成-验证-清洗自己的训练题),并把每场战役留下的完整研究记录(决策+证据+结果)用作训练自主研究模型的数据;同时提出autoresearch scaling问题:研究产出(最优检查点能力 $c(M_T^\star)$ 与沉淀的理解)如何随智能体推理与训练算力增长——本文曲线首日即达60分,余下三天仅添约7分,说明当前收益受想法多样性而非算力限制。基于本文可延伸:用异构智能体打破同质化收敛;为数学/逻辑引入长度自适应推理预算;自动化去污染与防“讨好评估器”的检查;扩展到无规则奖励的能力域(需警惕学习型评估器被操纵);在更大基座与混合模型团队上验证配方与团队动力学的可迁移性。
复现评估
系统宣称开源,训练栈基于公开的verl与mergekit,启动代码覆盖SFT/GRPO/合并/RFT,核心语料AM-Thinking-v1-Distilled等均为公开数据。复现的主要门槛是资源与长程编排:32张80GB GPU跑104小时(按$3.49/卡时约$10,800)加四个Claude Opus 5.5会话($1,074),总预算约$12,000;节点被平台收回等故障要求断点恢复能力,这正是Athanor的核心价值,自建同等编排层会显著抬高难度。智能体行为强依赖模型版本(Claude Opus 5.5 + Claude Code),换用其他模型可能搜索路径迥异、结果方差未知。评测协议(16,384/32,768 token上限、贪心或温度0.6/top-p 0.95/top-k 20、六任务配对与去污染规则)在正文与附录中交代详尽,评估器冻结可重建。总体判断:高成本但路径清晰的复现,有算力预算的团队可望复现量级结果,但智能体涌现出的具体技巧(1/4贪心rollout、外推系数等)难以逐字复刻。
论文图表