MAI-Gym:跨移动与电脑环境的 GUI 智能体评测与强化学习训练一体化开放平台 MAI-Gym: An Open All-in-One Platform for GUI Agent Evaluation and RL Training across Mobile and Computer Environments
开源一体化平台统一GUI智能体评测与在线RL训练,9B模型登顶同规模开源
前置知识
在线强化学习与可验证奖励(Online RL with Verifiable Rewards)
指策略在真实环境中不断产生新轨迹、用可自动核验的奖励信号更新自身的训练方式。与在固定演示数据上做 SFT 不同,每次参数更新都需要当前策略重新与环境交互采样。可验证奖励指成功与否能由规则、代码或测试自动判定(如数学答案对错、代码测试是否通过),无需人工或模型主观打分,因此奖励可靠且可大规模产生。
本文的全部基础设施(环境重置、并行实例、奖励验证器)都是为了让 GUI 任务也能像数学、代码那样支撑大规模在线 RL,这是理解其系统设计的出发点。
GRPO(Group Relative Policy Optimization)
一种免价值函数网络的策略优化算法:每个任务由策略尝试 G 次(一组),用组内奖励的均值作基线、标准差归一化,得到每条轨迹的优势 $A_i = (r_i - \mathrm{mean}(r_{1:G})) / (\mathrm{std}(r_{1:G}) + \delta)$,再套 PPO 式裁剪目标更新。组内奖励完全相同的任务优势为零、不产生梯度,因此 rollout 应花在策略「有时能做对」的任务上。
GRPO 是本文主训练配方,其「组内零优势即无梯度」的特性直接催生了论文的策略自适应任务采样设计,也解释了为何任务池规模如此重要。
Agent Harness(智能体执行框架)
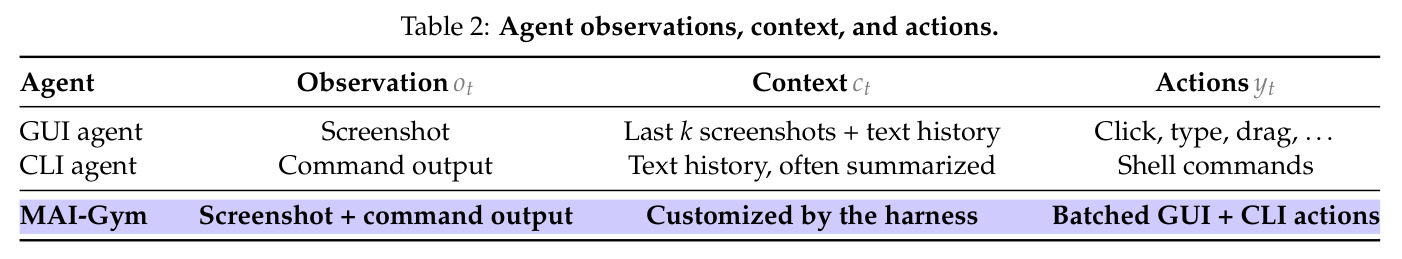
harness 是策略模型与环境之间的胶水代码:把指令、交互历史和当前观察(截图+命令输出)拼装成上下文,调用模型,解析输出为动作并执行。截图如何预处理、历史保留多少张、提示模板怎么写、动作怎么解析,全由 harness 决定。同一个模型换不同 harness,基准分数可以明显不同。
「评测与训练各写一份 harness 会漂移」是本文的核心痛点,其最关键的设计决策(共享 rollout 路径)就是针对这个问题。
KV 缓存前缀复用(Prefix Caching)
推理引擎可以把已计算过的 token 的 KV 缓存保存下来,当新请求的前缀与缓存中的 token 序列完全一致时直接复用,省去重复的预填充计算。前提是新提示必须以旧提示的全部 token 开头;只要开头变了,缓存就全部失效。
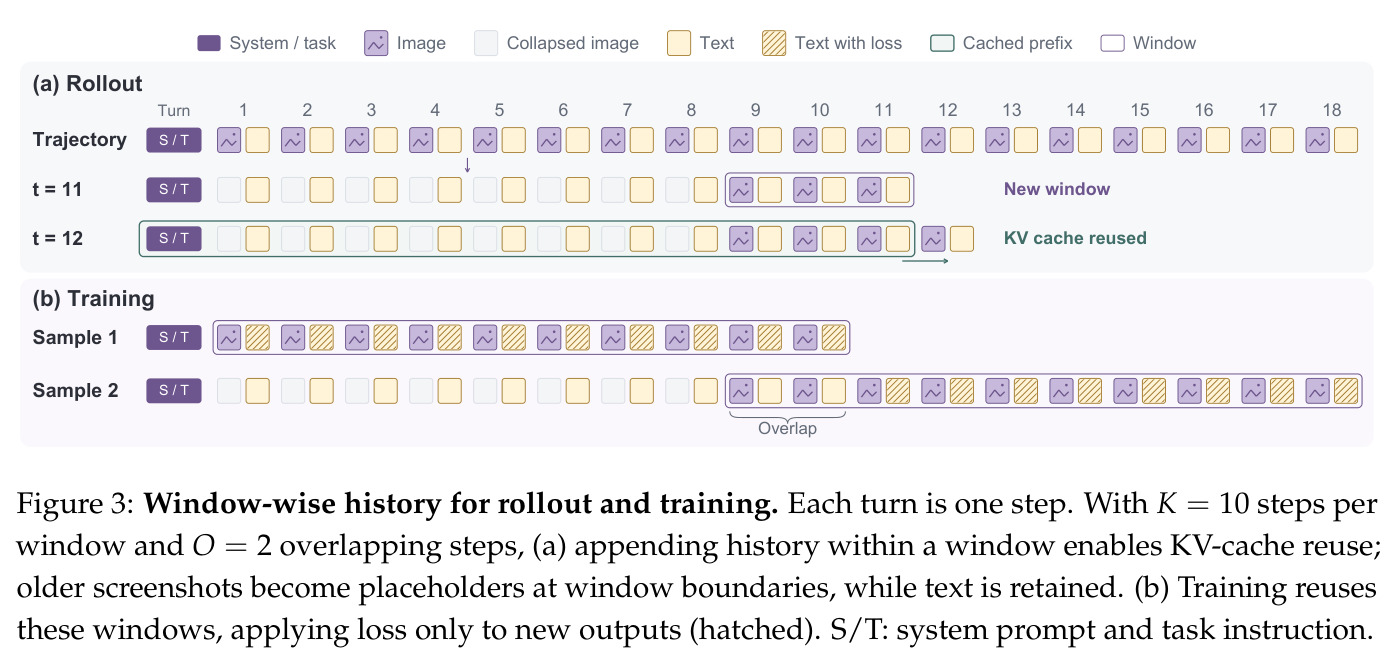
GUI 多轮对话中常见的「保留最近 k 张截图」策略每步都改变提示开头,导致缓存反复失效;本文的窗口式历史正是为修复这一问题而设计,是理解其效率分析的前提。
Sim-to-Real 迁移(模拟到真实迁移)
先在受控的模拟/克隆环境中训练,再考察学到的能力能否迁移到真实环境。迁移程度取决于模拟器与真实环境的保真度差距;机器人领域常见「模拟里很强、真机上拉胯」的现象,因此需要在真实环境上量化验证。
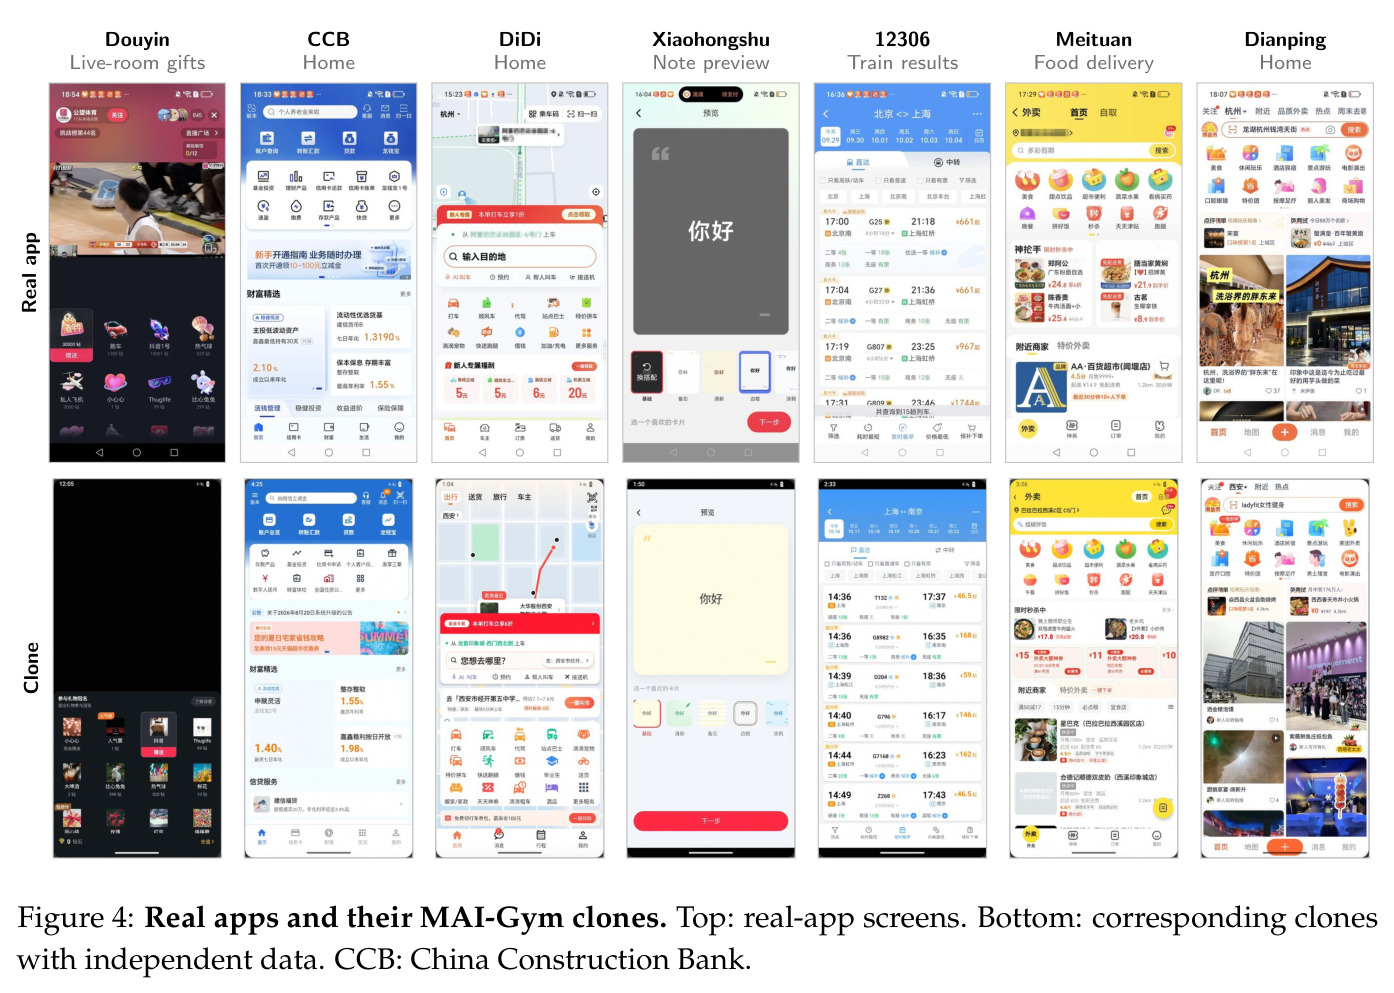
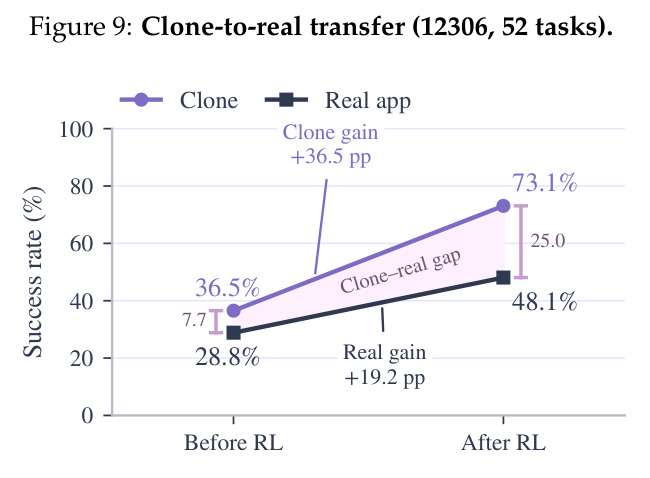
本文构建真实应用的克隆供 RL 安全练习,并用 12306 的 52 个配对任务首次系统测量了 GUI RL 的克隆到真机迁移效果,这是全文最有说服力的实验之一。
研究动机
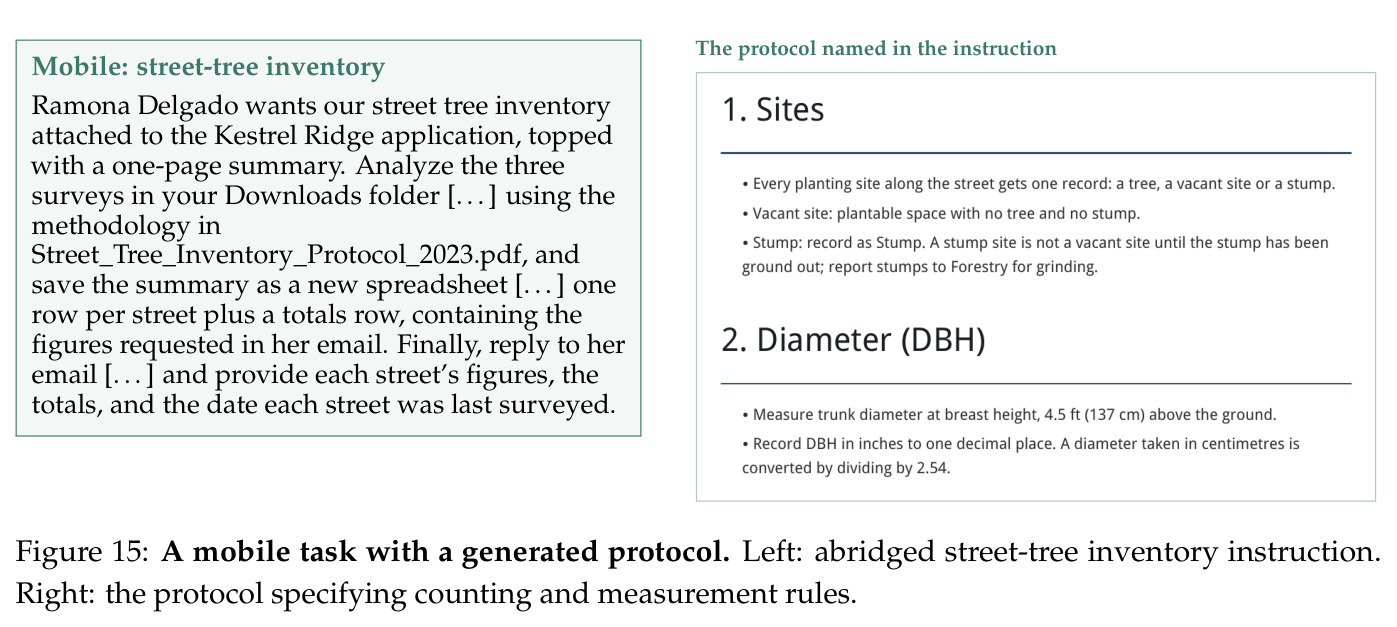
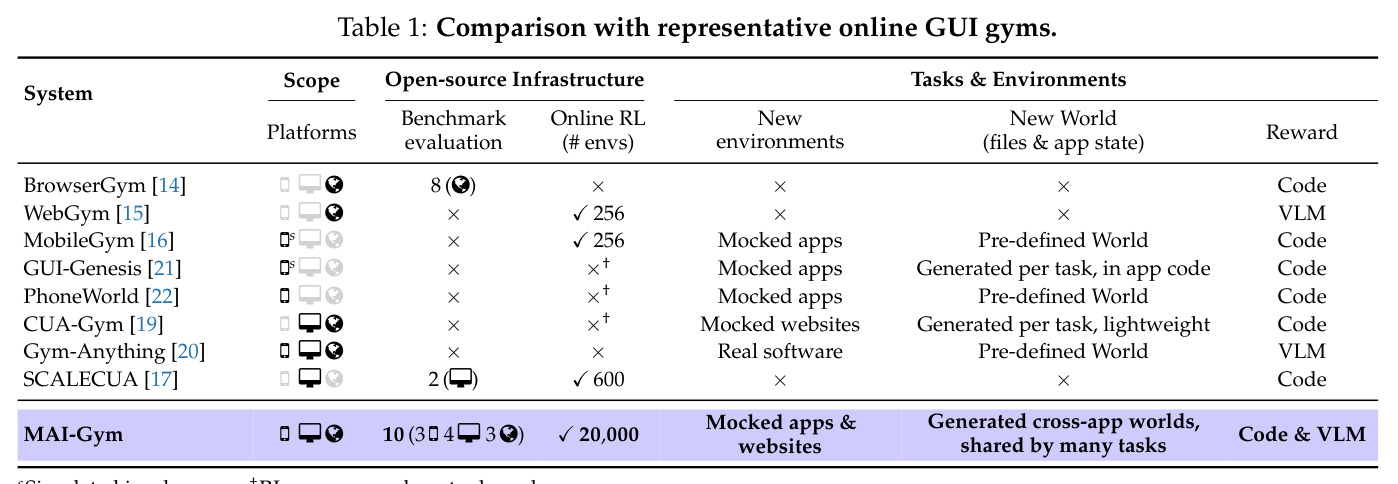
可验证奖励的在线 RL 已在数学、代码和工具调用上进展迅速,但复制到 GUI 智能体面临两个硬约束。其一,GUI 环境昂贵且难以一致维护:智能体作用于整个屏幕并改动设备文件与设置,每次尝试都需要一台处于已知初始状态的独立手机、电脑或浏览器实例,一次任务要消耗几十次多模态模型调用才换来一个奖励,大规模训练需同时维持数千个实例并反复重置;评测与训练若各写一份智能体代码,截图预处理、历史截断、提示模板与动作解析会逐渐漂移,测出的分数混入 harness 差异,训练奖励与评测分数出现无法解释的落差。其二,真实 GUI 工作流依赖跨应用一致的环境状态:如「用附件发票总额回复邮件」要求邮件、附件、发票内容同时存在且互洽,而现有任务合成多依赖孤立输入文件或全应用共享样例;涉及转账、下单的真实应用既不安全也无法反复练习。已有 gym 只解决一半:基础设施型各自覆盖单一平台、开放训练代码者并行环境最多约 600 个;数据型则不发布训练代码也跑不了既有基准。
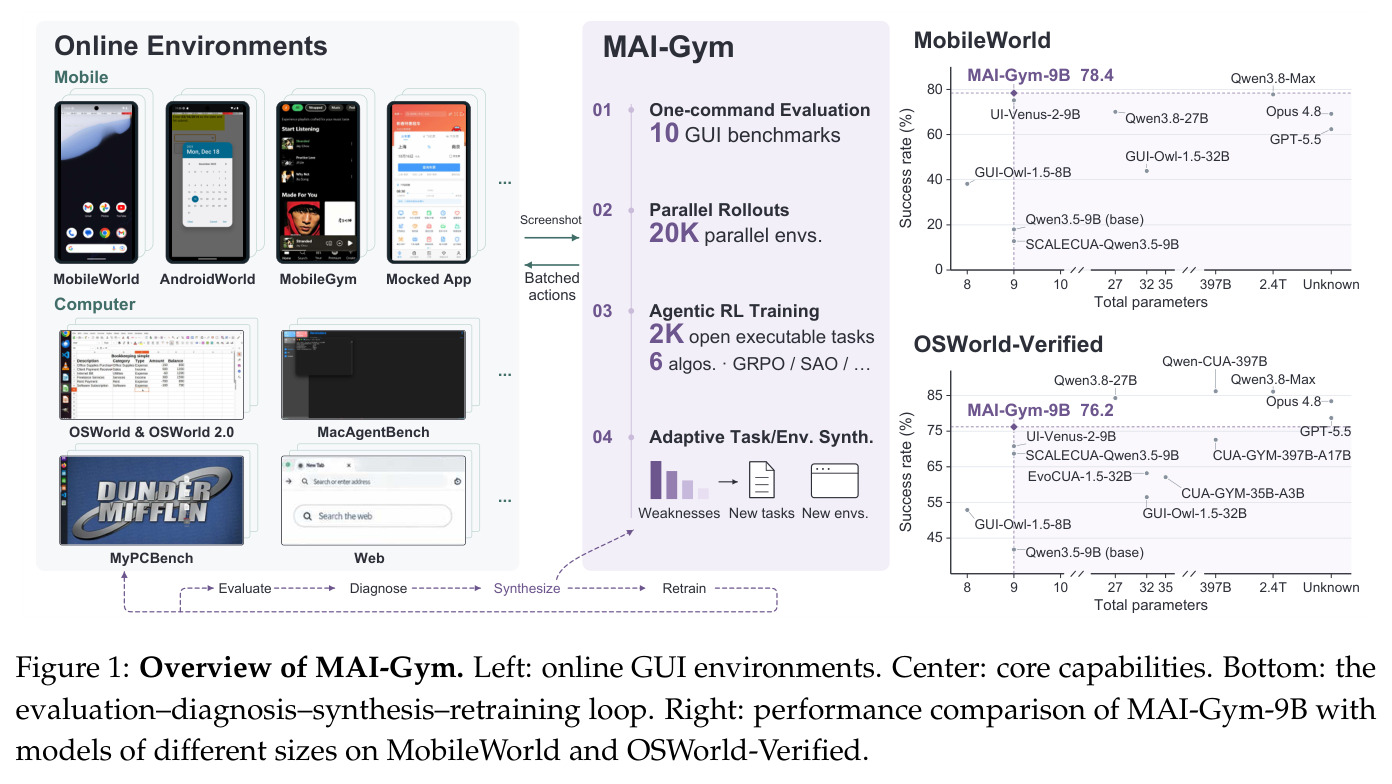
本文的目标是本文要构建一个开源的一体化平台 MAI-Gym,把 GUI 智能体的评测、数据收集与在线 RL 训练统一到移动、电脑、Web 三类环境上。具体目标包括:用同一条 rollout 路径和同一份 agent harness 保证「被评测的智能体就是被训练的智能体」;一条命令即可在十个既有基准(移动 3、电脑 4、Web 3)上评测,并行环境实例可扩展到 20,000 个;提供自动化合成能力,包括可重置的模拟应用(真实应用克隆与全新应用两类)、跨应用互洽的任务世界,以及经过执行验证的代码验证器和失败驱动的任务生成。在此之上训练 9B 的统一智能体 MAI-Gym-9B,要求它在任务不重叠的 MobileWorld 和 OSWorld-Verified 上取得 10B 以下开源 GUI 智能体中的最优成绩(78.4% 与 76.2%),并量化回答「在克隆应用中训练能否迁移到真实手机应用」这一关键问题。
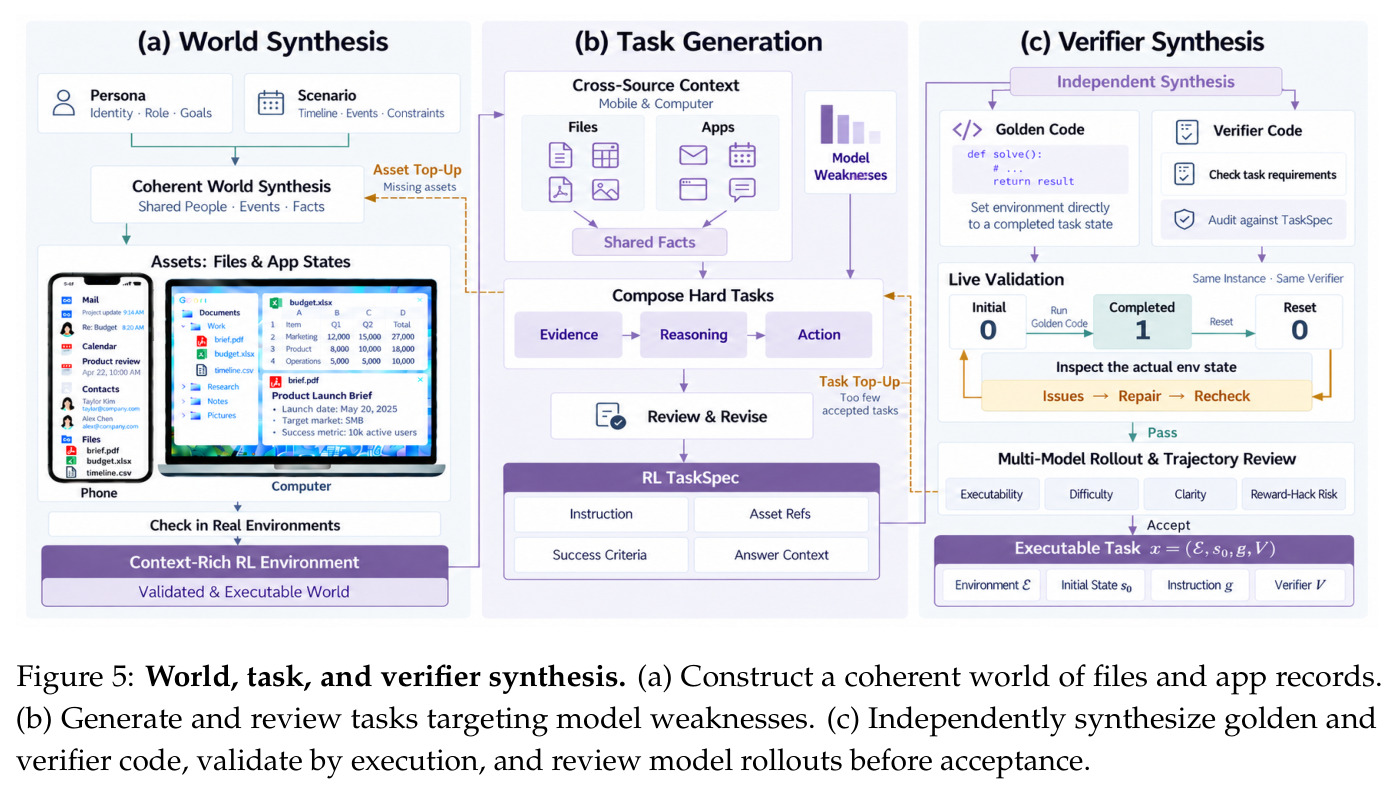
与已有工作不同的是,MAI-Gym 的独特之处在于把「可扩展执行」与「自动化环境/任务合成」拧成一个闭环,而不是只做其中一半。具体切入点有四个:一是共享 rollout 路径——评测、收集、训练复用同一套观察处理、上下文构造与动作执行代码,对 harness 的任何修复同时到达三种负载,这直击「测的不是练的」这一被反复观察到却少有系统正面解决的问题;二是先构造跨应用互洽的世界(人设+场景生成共享人物、事件、事实的文件与应用记录)再写任务,让任务像真实请求那样需要检索和整合多应用证据,而非孤立的操作指令;三是「规格先行」的验证器合成——先固定任务需求(含策略不可见的答案上下文),再独立生成 golden 代码与验证器代码并做奖励审计,通过「初始 0 分→完成 1 分→重置 0 分」的三段执行测试才接受,避开 VLM 裁判易被策略钻空子的缺陷;四是用真实应用的克隆(12306、建行等七个)安全练习交易类工作流,并首次在真机上系统测量克隆训练到真实应用的迁移。
核心方法
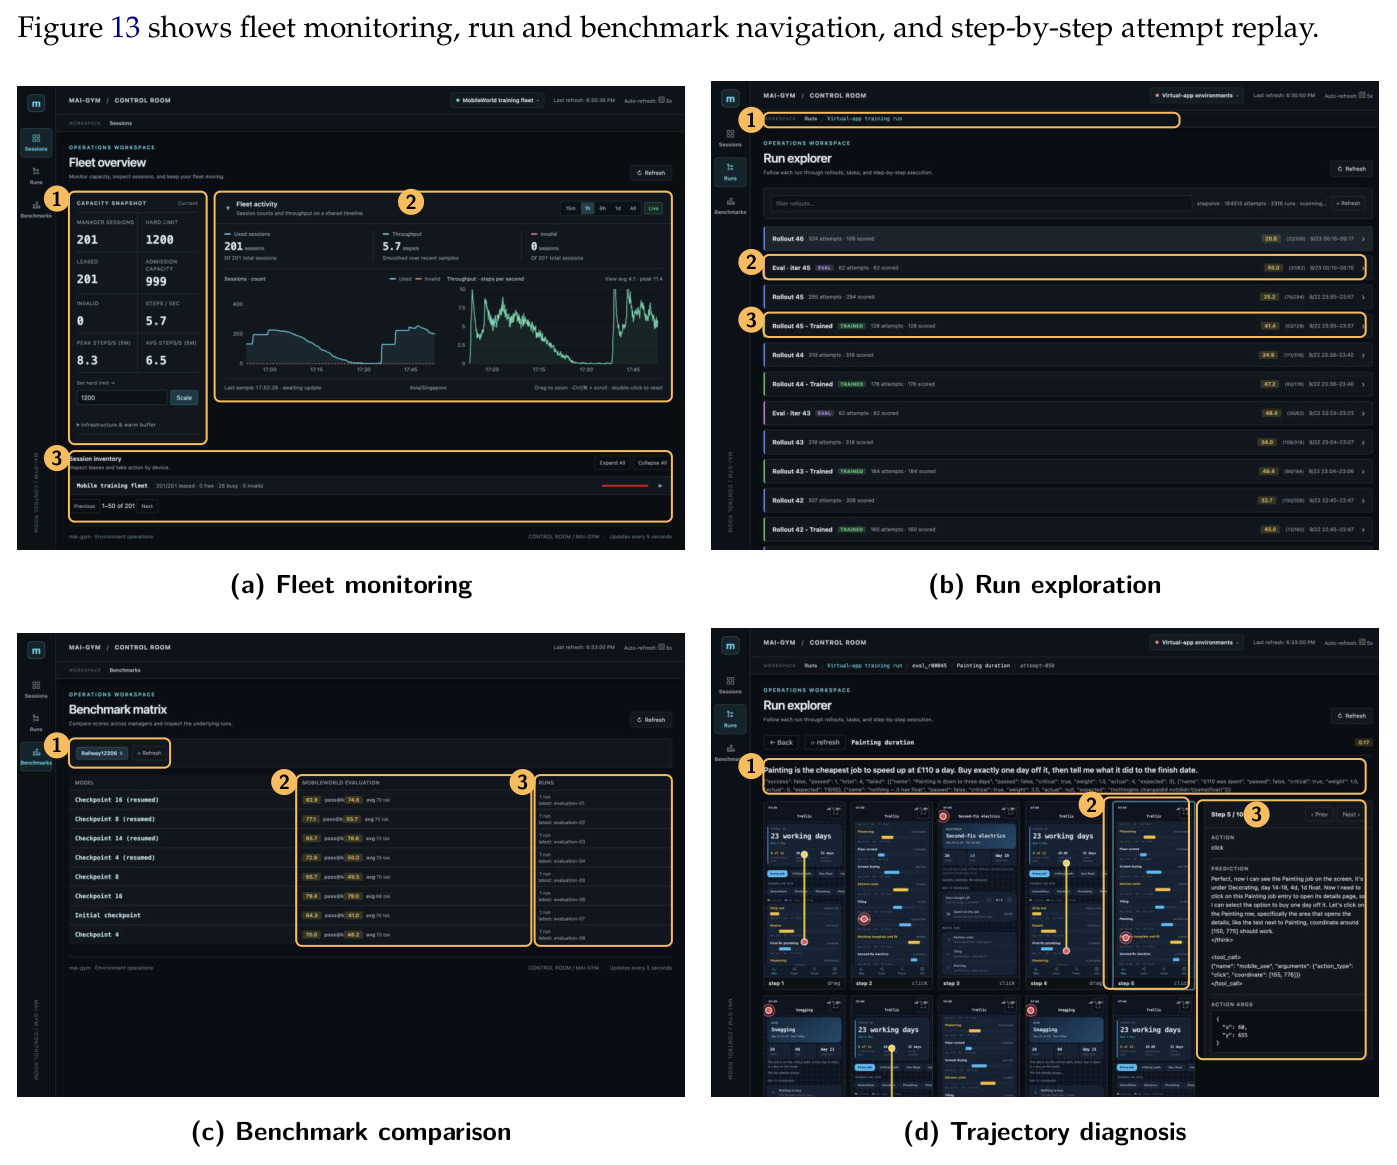
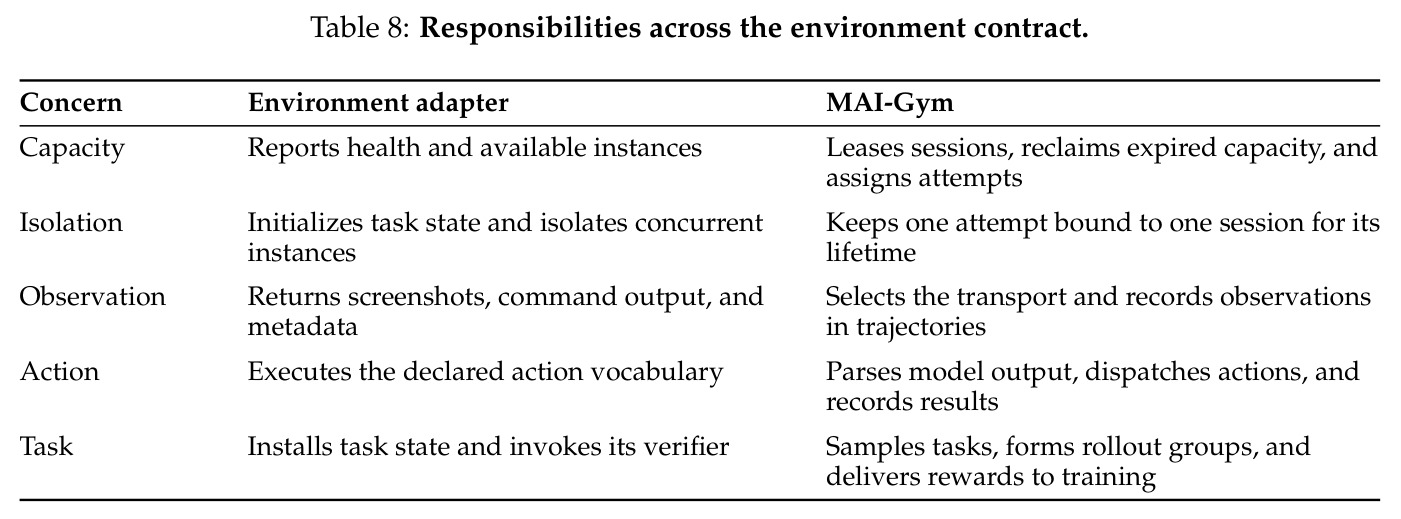
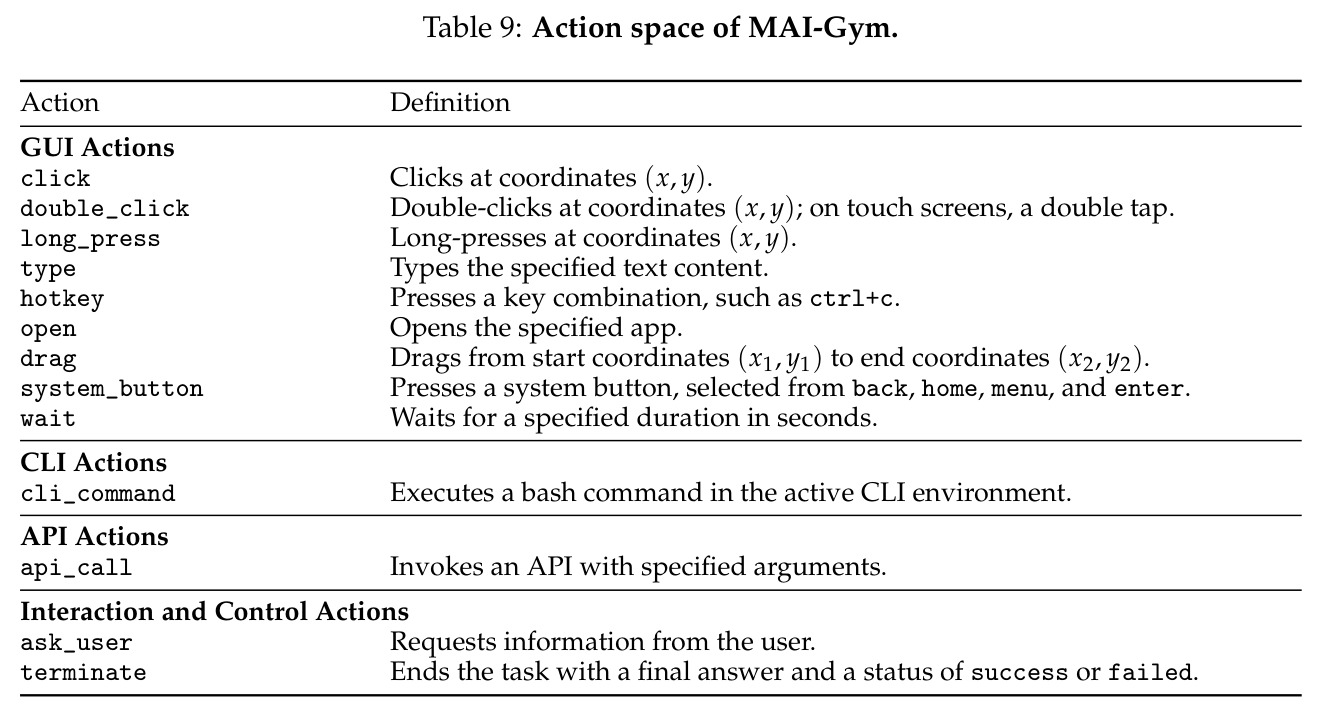
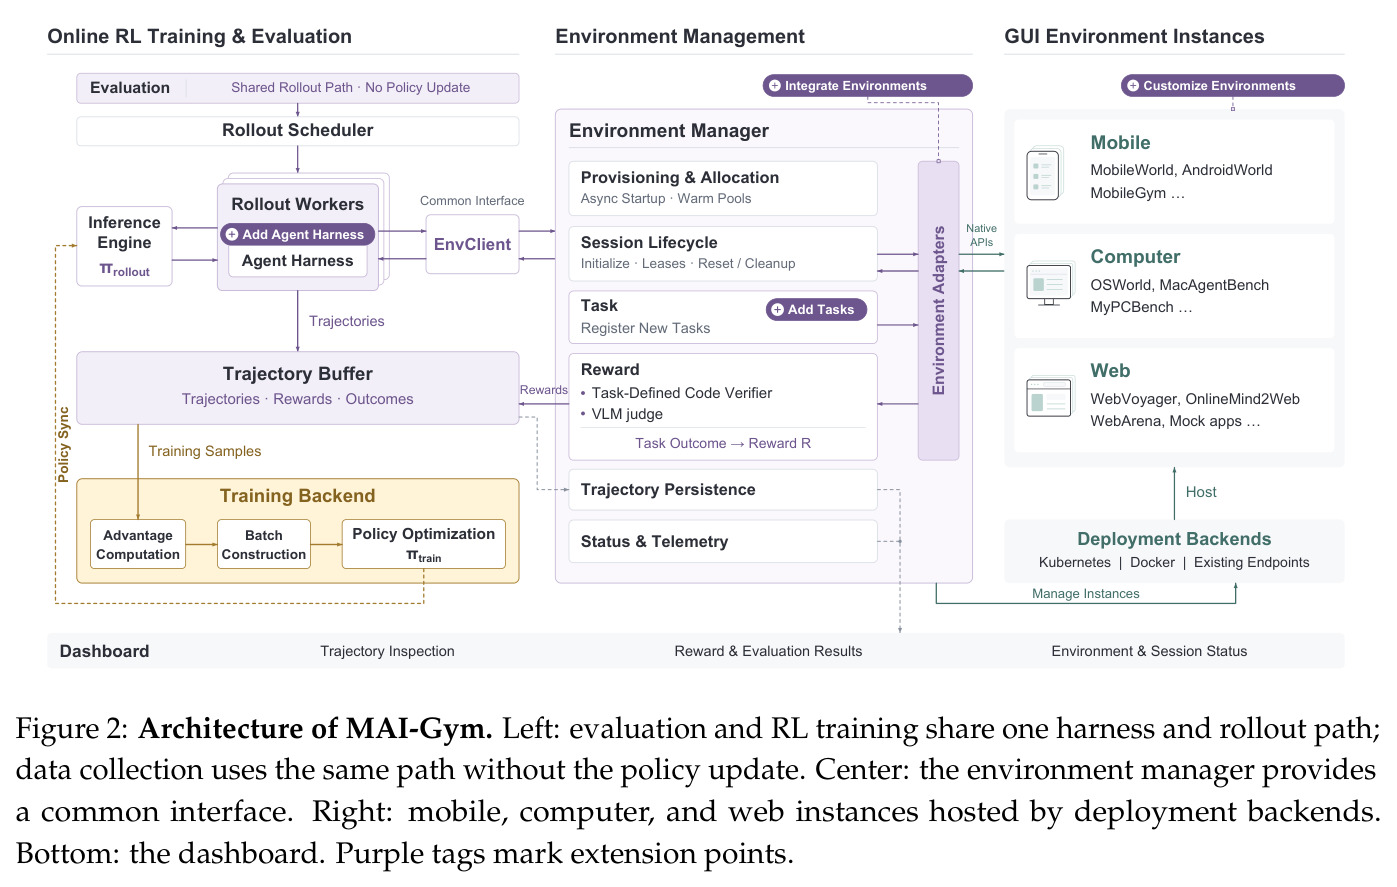
可以把 MAI-Gym 想象成一所 GUI 智能体的「训练中心」:考试系统(评测)、错题分析(诊断)、定制练习册(环境与任务合成)和教练(在线 RL)共用同一套教材与考场,形成「评测→诊断→合成→重训」的改进循环。技术上分两部分。地基是系统架构与可扩展 rollout:评测、数据收集、训练共享一条 rollout 路径和一份 harness——调度器给任务尝试排队,rollout worker 经 EnvClient 领取环境实例并驱动 harness,每步向推理引擎请求一次决策,轨迹与奖励写入缓冲区,三种负载只是对轨迹的用法不同。环境管理器向上暴露请求实例、观察、重置、步进、评估五个操作,向下用适配器对接部署后端:移动端用 ReDroid 把手机跑成宿主机内核上的普通容器(绕开容器集群缺失的嵌套虚拟化),重置即恢复黄金 /data 快照;桌面是加了严格就绪检查的虚拟机;Web 用无头 Chromium。上层是合成与训练:mocked 应用提供新环境 $E$,跨应用世界提供互洽初始状态 $s_0$,任务与验证器合成提供指令 $g$ 和可靠奖励,最后由基于 slime(Megatron-LM + SGLang)的训练器执行 GRPO 等在线 RL。
核心创新有三点,最关键的是「一条 rollout 路径、一份 harness」。同一模型在不同 harness 下得分可以不同,而常见做法让评测、收集、训练各持一份会漂移的智能体代码——比如训练时保留最近 5 张截图、评测时保留 10 张,评测的就不再是训练的那个智能体。MAI-Gym 让三种负载复用同一套观察处理、上下文构造与动作执行,修复一次全部生效,从根本上保证「测的就是练的」。第二是窗口式历史:把连续步打包成 $K=10$ 步、重叠 $O=2$ 步的窗口,窗口内新截图与文本只追加、KV 缓存前缀可复用,窗口边界才把旧截图折叠为占位符而保留文本,提示前缀每 $K-O$ 步才变一次;训练时每个窗口成为一个因果序列、只对新步施加损失,同时解决推理效率与训练-推理一致性。第三是合成的可靠性设计:任务规格(含策略不可见的答案上下文)先于验证器固定,两次独立调用分别生成把环境直接置为完成态的 golden 代码与检查文件、计算值、应用更新的验证器代码,二者互不参考;奖励审计查漏后,执行测试要求验证器初始态得 0、golden 后得 1、重置后再得 0,再让多个模型走 GUI 复核可执行性与防作弊性;奖励只来自验证器执行。
方法步骤详情
完整流程六步。① 一键评测:`mai-gym eval` 让本地或 API 模型在十个基准上并行评测,保留各基准原步数上限、验证器与指标,另报 pass@n 与 pass^n,环境故障自动重跑且不计入模型分数。② 智能体驱动诊断:编码智能体(Claude Code/Codex)经诊断端点调取轨迹与奖励,从单步动作、整条轨迹、任务所需知识三层对比成败案例,产出弱点报告。③ 环境合成:编码智能体从零构建 mocked 应用——12306、建行、滴滴、美团、大众点评、抖音、小红书七个真实克隆(后端可重置,测试员逐步比对克隆与真机屏幕),加 42 个运行于 Chromium 的确定性状态机新应用(840 任务、3,196 项检查)。④ 跨应用世界构造:由人设与场景生成共享人物、事件、事实的文件与应用记录,经初始化模板载入环境并校验,形成可复现的 $s_0$。⑤ 任务与验证器合成:从世界共享事实生成串联检索-推理-操作的任务并按诊断报告定向补弱;规格先行后独立生成 golden 与验证器代码,执行「初始 0→golden 1→重置 0」测试并经模型 rollout 复核后接受。⑥ 在线 RL:`mai-gym train` 读 YAML 启动,GRPO 组大小 8、逐 token 损失、KL 系数 $10^{-3}$、学习率 $10^{-6}$;策略自适应采样以 $\eta=0.8$ 区分已掌握(预算 2 次)与从未解决(预算 4 次)任务;窗口式打包训练;以 k3 KL 估计量逐 token 守门训练-推理一致性。MAI-Gym-9B 由 Qwen3.5-9B 经 SFT 热身后,用 5,000 条合成任务做移动+电脑联合 RL,512 卡、峰值 2 万并发环境、约 96 小时。
技术新颖性
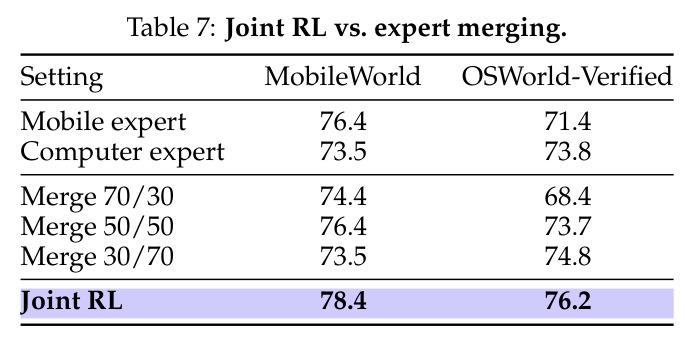
与最近工作的本质区别分三层。基础设施层:BrowserGym、WebGym、MobileGym、SCALECUA 各覆盖单一平台,开放训练代码者并行环境上限约 256-600;MAI-Gym 同时覆盖三平台、集成十个基准、把在线 RL 推到 20,000 并发实例,并第一个把「评测=训练 harness」做成架构约束而非工程自觉。数据合成层:VLM 裁判路线(ZeroGUI、AutoPlay、OS-Genesis)扩展容易但假阳性奖励会被 RL 策略利用;代码断言路线(GUI-Genesis、AutoWebWorld 等)可靠却局限在简化应用内,任务多源自单一输入文件或共享样例。MAI-Gym 在完整 MobileWorld/OSWorld 环境中结合「规格先行+双路独立代码生成+执行验证+模型 rollout 复核」,并以跨应用互洽世界替代孤立任务。训练层:UI-TARS-2、UI-Venus-2 等统一模型普遍按域训练专家再参数平均合并,本文证明单次联合 RL 直接优于任何合并配比。此外,构建真实交易类应用的克隆并真机量化 sim-to-real 迁移,在 GUI RL 文献中属首次。
实验结果
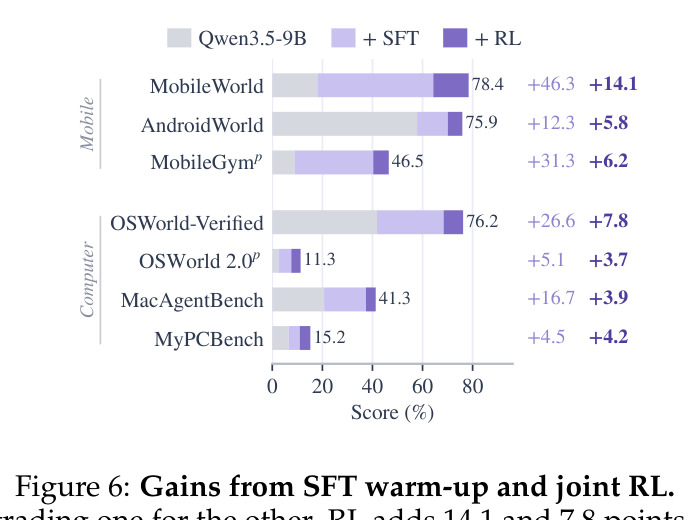
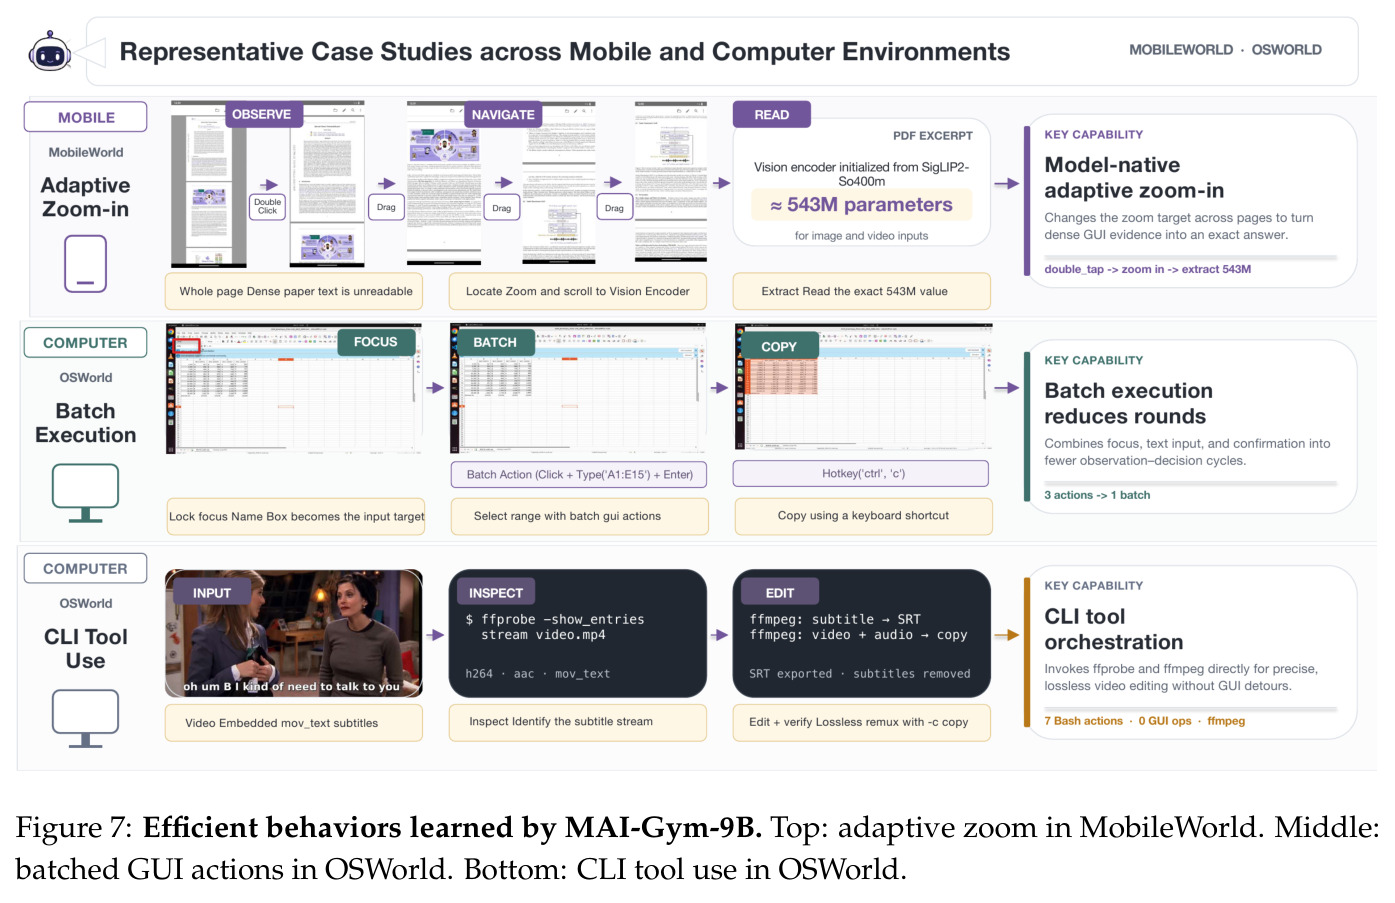
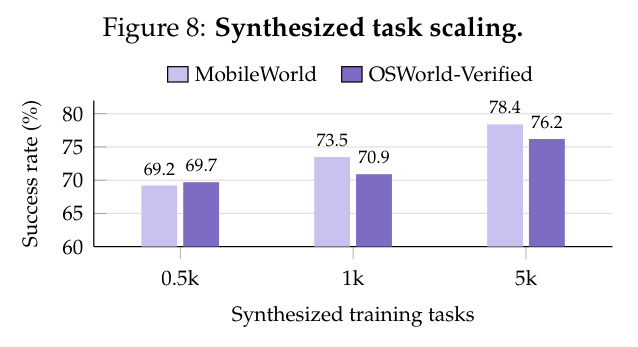
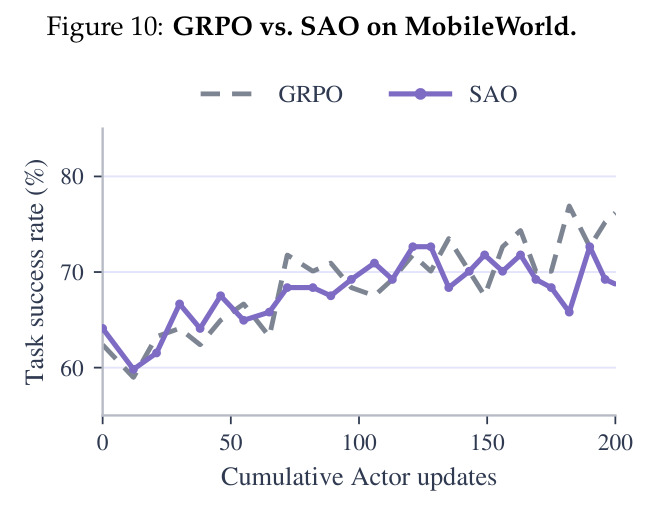
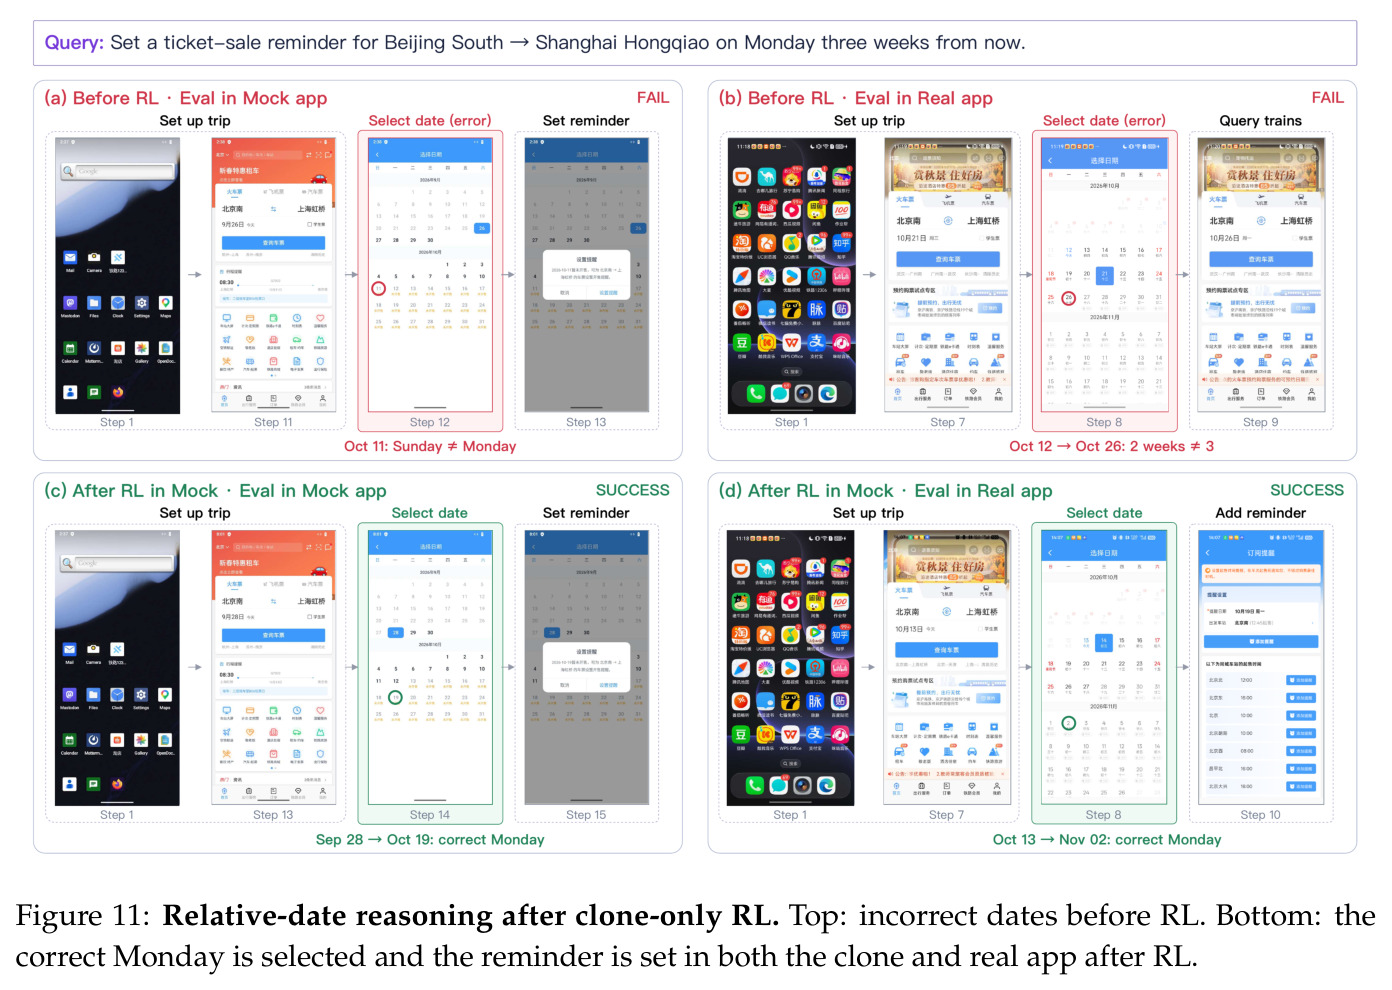
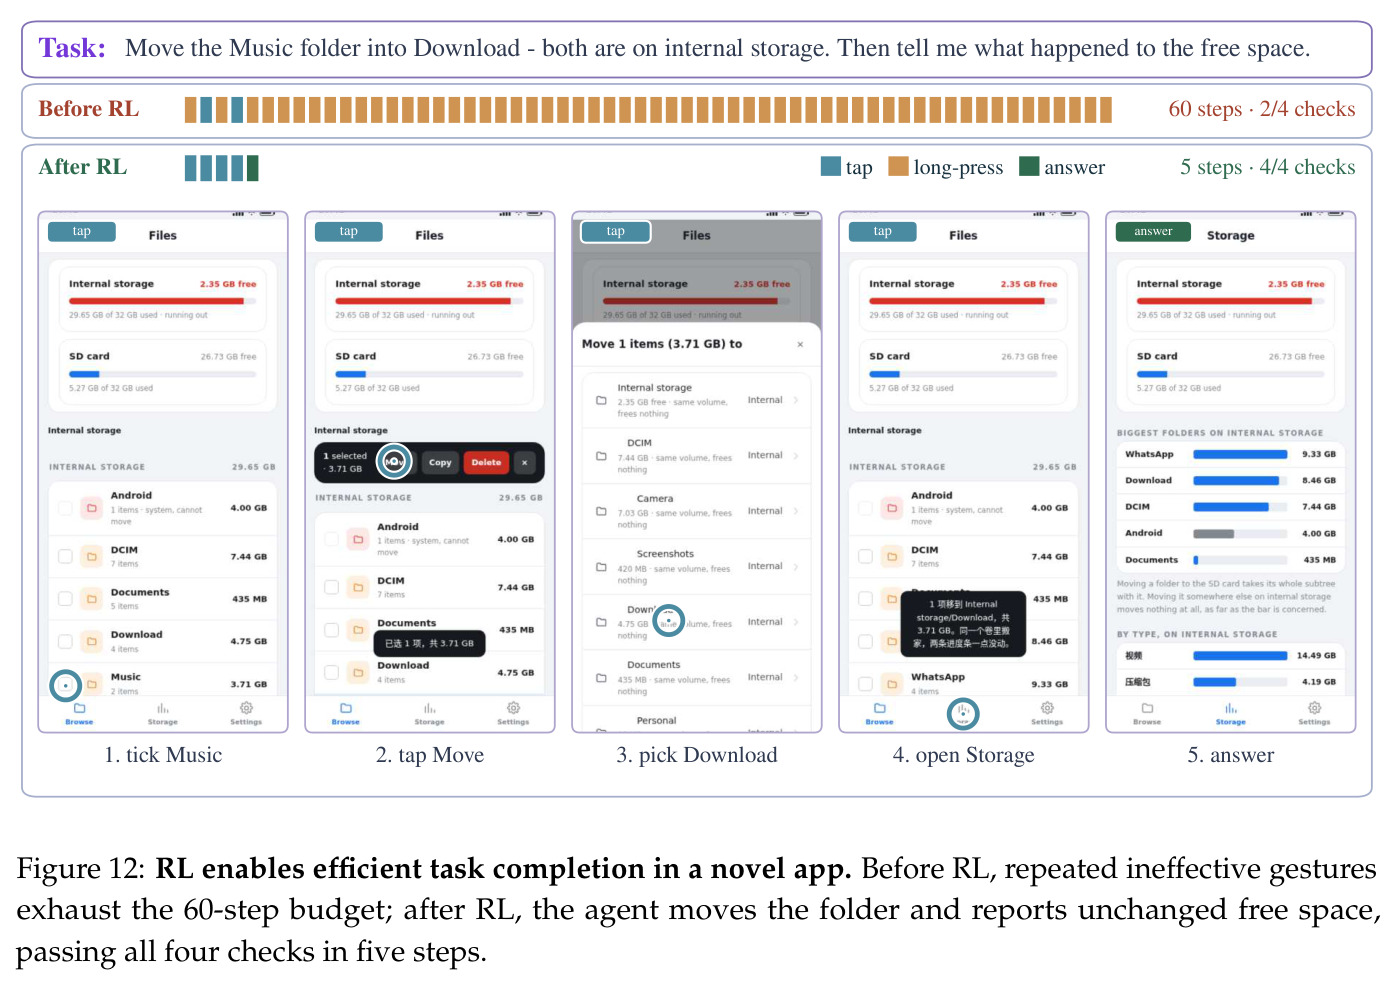
主结果分四层。① 基准成绩:MAI-Gym-9B 在任务不重叠的 MobileWorld 与 OSWorld-Verified 上达 78.4% 与 76.2%,为 10B 以下开源 GUI 智能体新 SOTA——领先同规模 UI-Venus-2-9B(75.2/70.8)3.2 与 5.4 分,比 GUI-Owl-1.5-8B(38.2/52.9)高 40.2 与 23.3 分,也超过更大的 GUI-Owl-1.5-32B(43.9/56.5)、EvoCUA-1.5-32B(63.2)与 CUA-GYM 系列;在 MobileWorld 上超过 Claude Opus 4.8(69.2)、GPT-5.5(62.4)与 Qwen3.8-Max(77.8),OSWorld-Verified 上距 GPT-5.5(78.7)仅 2.5 分(Qwen3.8-Max 86.1、Qwen-CUA 86.2 仍更高)。② 环境外推:五个训练环境外的基准上,AndroidWorld 75.9、MobileGym 46.5、OSWorld 2.0 为 3.7/11.3、MacAgentBench 41.3、MyPCBench 15.2,均领先有结果的同规模开源模型;RL 相对 SFT 热身在全部五个外推基准都有增益(MobileWorld +14.1、OSWorld-Verified +7.8、Env-OOD 平均 +4.2)。③ 消融:单次联合 RL(78.4/76.2)优于任何专家合并配比(最好 76.4/74.8,且无配比双域领先);合成任务 500→5,000 使 MobileWorld 69.2→78.4、OSWorld-Verified 69.7→76.2;GRPO 与 SAO 早期接近、SAO 终点略低,其省下的采样等待被双倍 critic 计算抵消。④ 迁移与效率:12306 克隆内 RL 使克隆成功率 36.5%→73.1%,52 个配对任务真机从 28.8%→48.1%(+19.2pp),并学到跨应用一致的相对日期推理;全新应用 62 个 held-out 任务成功率 25.8%→45.2%,耗尽步数尝试 27→5,平均轨迹 33.3→16.4 步。模型还学会 ffprobe/ffmpeg 命令行、批量 GUI 动作与双击缩放读小字。基础设施:千级环境拉起移动 328.4 秒(比串行 KVM 估计快至少 6 倍)、桌面 88.9 秒;窗口式历史使前缀缓存命中 42.5%→85.9%,训练 token 每轨迹 -84.7%,单次更新 2166.4→810.9 秒。
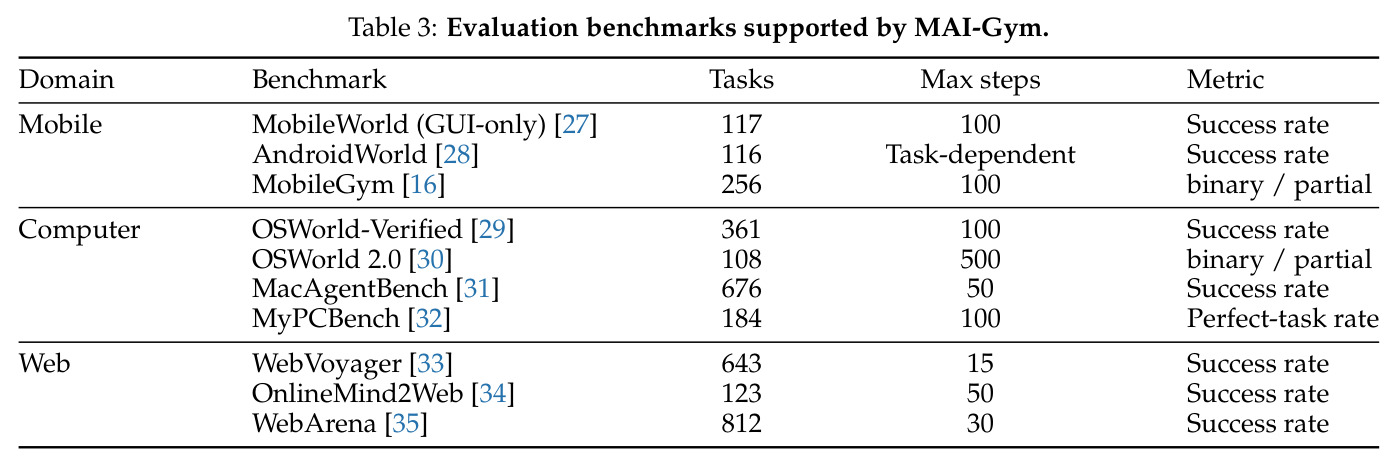
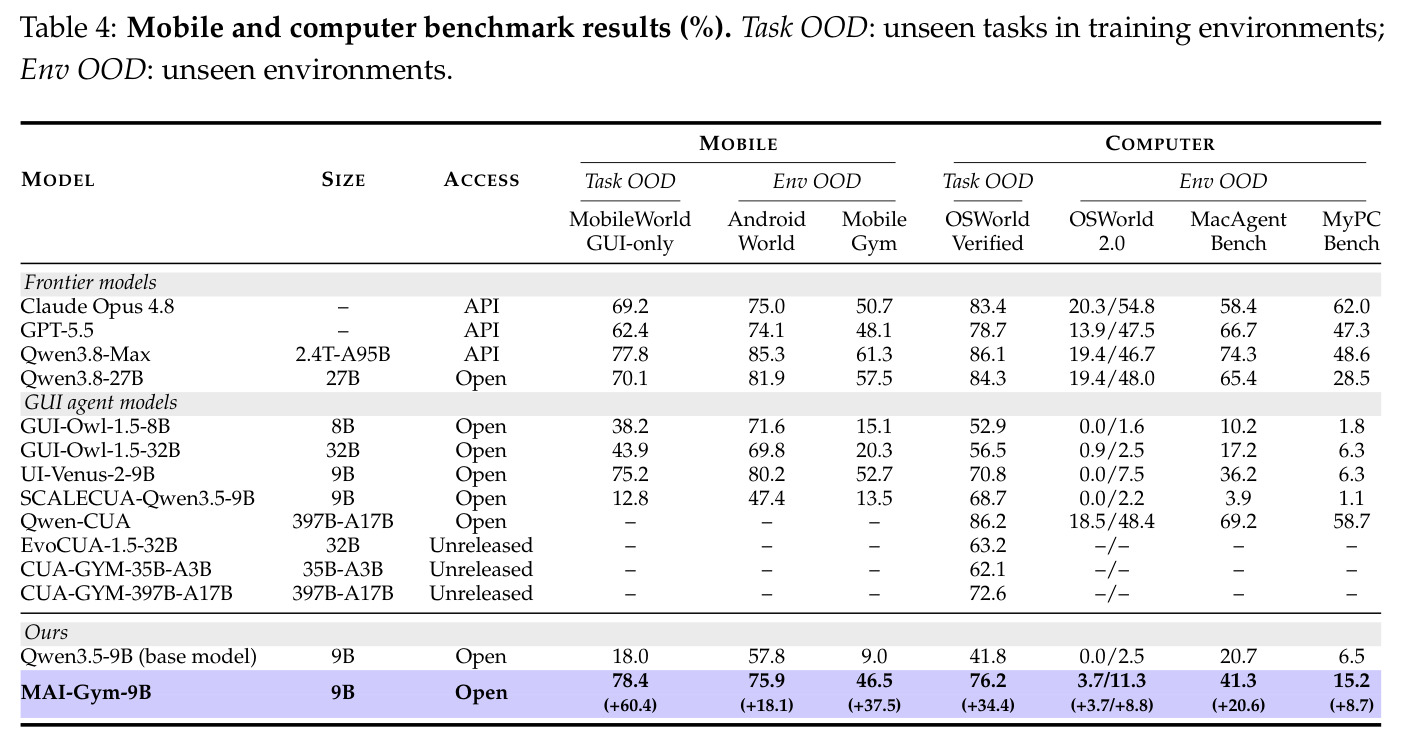
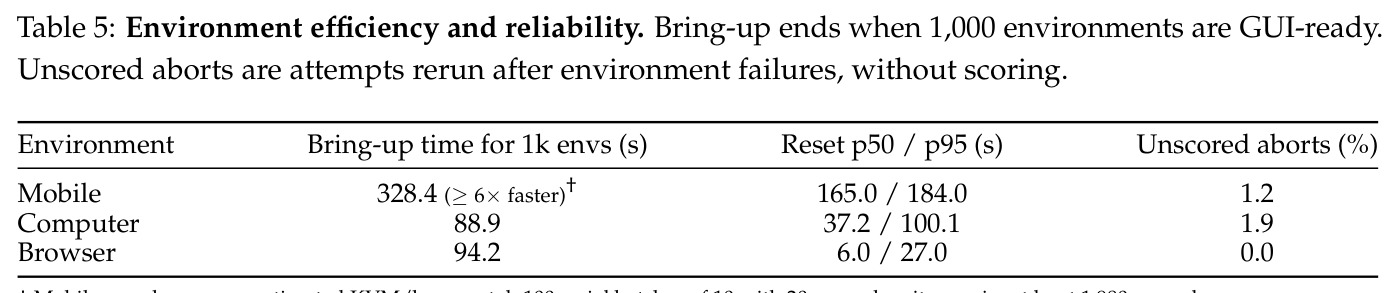
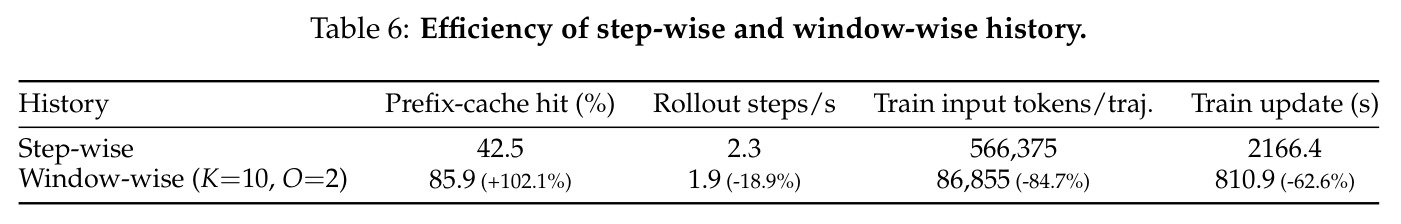
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 移动端任务执行 MobileWorld(Task-OOD,训练任务零重叠) | 成功率 (%) | 78.4 | UI-Venus-2-9B 75.2;Claude Opus 4.8 69.2;Qwen3.5-9B 基座 18.0 | 较同规模开源最佳 +3.2pp,较基座 +60.4pp,超过 Opus 4.8 达 9.2pp |
| 电脑任务执行 OSWorld-Verified(Task-OOD) | 成功率 (%) | 76.2 | UI-Venus-2-9B 70.8;GPT-5.5 78.7;Qwen3.8-Max 86.1 | 较同规模开源最佳 +5.4pp;距 GPT-5.5 仅 2.5pp(10B 以下开源 SOTA) |
| 电脑环境外推 MyPCBench(Env-OOD) | Perfect-task rate (%) | 15.2 | Qwen3.5-9B 基座 6.5;GUI-Owl-1.5-32B 6.3 | +8.7pp,为有结果的同规模开源模型最佳 |
| 12306 克隆→真机迁移(52 个配对任务,物理手机) | 真机任务成功率 (%) | 48.1(仅在克隆内 RL) | RL 前 28.8 | +19.2pp;克隆内同期 36.5%→73.1%(+36.5pp) |
| 全新应用泛化(252 任务训练 / 62 held-out 任务评测) | 成功率 (%) | 45.2 | RL 前 25.8 | +19.4pp;耗尽步数尝试 27→5,平均轨迹 33.3→16.4 步 |
| 合成任务规模缩放(固定 rollout 预算) | 成功率 (%):500 vs 5,000 任务 | MobileWorld 78.4 / OSWorld-Verified 76.2(5k) | MobileWorld 69.2 / OSWorld-Verified 69.7(0.5k) | +9.2pp / +6.5pp |
| 多轮推理与训练效率(窗口式 vs 逐步历史,K=10/O=2) | 前缀缓存命中率 (%);训练更新时间 (s) | 85.9%;810.9 秒 | step-wise 42.5%;2166.4 秒 | 缓存命中 +102.1%,训练 token -84.7%,更新时间 -62.6%(rollout 吞吐 -18.9%) |
局限与改进
作者承认的局限:克隆训练的迁移不完整——12306 上克隆-真实差距反而从 7.7 扩大到 25.0 个百分点,克隆收益不能完全预测真机表现;诊断→合成→重训的自改进循环尚未做多轮评估。我的观察:其一,环境外推明显弱于任务外推——OSWorld 2.0 仅 3.7/11.3、MyPCBench 15.2,而 397B 的 Qwen-CUA 在 MyPCBench 达 58.7,说明 9B 模型从 RL 获得的多是训练环境内的应用操作先验;其二,训练只做了移动+电脑,Web 域虽在架构与基准上支持但没有 RL 训练结果,「all-in-one」在训练侧未完全兑现;其三,42 个新应用都是 Chromium 里的确定性 HTML5 状态机,界面复杂度与状态空间远低于真实应用,「从奖励学会陌生应用」的结论可能被简化模拟器放大;其四,基线分数大多取自公开榜单与他人 harness,论文只复跑 8 项,跨 harness 严格可比性有折扣;其五,评测用温度 0、每任务 3 次尝试,与部分基线协议未必一致。
独立分析的弱点
独立分析四点。① 环境知识依赖过重:Task-OOD 与 Env-OOD 的巨大落差(OSWorld-Verified 76.2 对 MyPCBench 15.2、OSWorld 2.0 仅 3.7)暗示 RL 学到的很大部分是特定应用与桌面的操作先验;改进方向是在世界合成中加大操作系统版本、应用家族、布局与主题的随机化,并强制任务通过跨应用证据链而非界面记忆求解。② 验证器可被策略性钻空:golden 代码执行测试能过滤坏验证器,但挡不住「让最终状态检查通过却不走正常 GUI 流程」的捷径(如直接写文件满足检查);训练推进后策略会主动找漏洞,可加入轨迹级必要动作检查、关键中间状态断言或对抗性探测任务。③ 合成吞吐与训练消耗不匹配:在线 RL 消耗任务极快,2,000 条已验证任务对应一次 5,000 任务训练仍靠批量预生成;可把失败驱动的生成器嵌入训练循环,按策略成功率实时产出「前沿难度」任务,形成任务流而非任务池。④ 克隆保真度缺乏量化:克隆-真实差距从 7.7 扩大到 25.0pp 说明保真度不足且不可控;可为克隆建立自动化的行为等价性回归测试(状态转移、响应延迟、错误提示),并对差距大的流程在真机安全子集上做少量在线适配。
未来方向
作者提出的方向:把「评测→诊断→合成→重训」跑成多轮自改进闭环并评估其收益曲线与递减点(论文只支持运行、未评估);平台已被用于训练 Qwen-UI-Agent,后续会在更大模型家族上验证配方可扩展性;把 Web 域纳入与移动/电脑同等的 RL 训练。基于成果可延伸的方向:① 用世界合成的复杂度旋钮(应用数量、事实链长度、跨 app 步数)构造难度课程,研究任务难度与泛化的定量关系;② 将 VLM 裁判与代码验证器组合,覆盖「界面观感正确」这类最终状态难以编码的软性目标,同时用代码检查约束其假阳性;③ 跨设备协同任务(手机查信息、电脑写文档、云端同步)这类真实工作流的训练与评测;④ 在非确定性的真实网站(而非无头 Chromium 里的本地应用)上检验窗口式训练与 k3 一致性守门是否依然稳健;⑤ 系统比较 GRPO/DAPO/GSPO/SAO 在 GUI 长多模态轨迹上的 scaling 行为,把论文中 GRPO 与 SAO 的单点对比扩展成算法选择指南;⑥ 探索把克隆-真实差距作为显式信号,指导编码智能体迭代精修克隆。
复现评估
开源程度很高:框架(评测 harness 与在线 RL 训练代码)、全部合成技能(环境/世界/任务/验证器合成的编码智能体指令)、49 个 mocked 应用(7 个真实克隆 + 42 个新应用及 840 个任务)、2000 条带执行验证器的任务(MobileWorld 与 OSWorld 各 1000)以及 MAI-Gym-9B 权重都在 GitHub(Tongyi-MAI/MAI-Gym)发布。直接使用成本很低:用发布的 checkpoint 与任务即可复跑评测,七个基准 × 3 次尝试约 3 小时;移动端用 ReDroid 以普通容器运行、不要求嵌套虚拟化,桌面可用 Docker 或既有端点。完整复现训练门槛高:论文级配置需要 512 张 GPU、峰值 20,000 并发环境、约 96 小时,另需维护桌面虚拟机农场与真机(12306)测试;学术团队的现实路径是按论文的 500→5,000 缩放实验用固定小预算做消融级复现,或只复用其合成技能为自己领域的应用生成任务,性价比最高的用法是把发布的任务与验证器当作现成 RL 数据源。
论文图表