Orbia:生成视频能否构成一致三维世界的系统性评测基准 Orbia: Do Generated Videos Form a Consistent 3D World?
首个以探索-回访协议系统评测交互式世界模型3D一致性的基准
前置知识
交互式视频世界模型
以一张初始图像 $I_0$、场景描述 $s$ 和用户控制输入 $U$(文本指令、离散动作或相机位姿)为条件,自回归地生成可继续探索视频的生成模型,形式化记为 $\hat{V}=M(I_0,s,U)$。用户像玩游戏一样持续输入控制并不断看到新画面,模型相当于一个可以漫游的生成式环境。
Orbia 评测的 27 个模型全部属于此类,理解文本/动作/相机三种条件接口才能看懂适配器设计与控制对齐评测的含义。
相机位姿与跨视角对应
相机位姿用 camera-to-world 矩阵 $P_t=[R_t|\mathbf{p}_t]$ 描述。已知两个视角的位姿与深度,就能把一个视角的像素反投影到 3D 再投影到另一视角,建立逐像素跨视角对应,进而检验两个视角对同一表面报告的深度、外观是否一致。
Orbia 的跨视图深度/特征一致性、重投影深度比较、区域尺度一致性和表面 F-score 全部建立在这一几何机制之上。
深度尺度歧义与 AbsRel
单目恢复的深度只有相对意义,存在全局尺度歧义。通行做法是用中位数比例 $a^*=\mathrm{median}_u D(u)/\bar{D}(u)$ 对齐后计算 $E=\frac{1}{|\Omega_D|}\sum_u \frac{|a^*\bar{D}(u)-D(u)|}{D(u)+\epsilon}$(AbsRel)。尺度对齐消除全局歧义但保留局部误差。
本文几何保真、回访深度一致性、跨视图深度一致性都用 AbsRel;理解'共享场景级尺度'才能明白为何能保留物体间相对尺度差异。
3D高斯泼溅与留出视角渲染
3DGS 用一组带颜色与不透明度的各向异性高斯表示场景,可实时渲染任意新视角。本文让 DA3 从 64 个上下文帧前馈预测高斯场景,再渲染 16 个未参与重建的留出(held-out)视角,与对应生成帧比较 PSNR/SSIM/LPIPS:若各帧不构成同一 3D 场景,重建就无法解释留出视角。
这是 Tier 5 中唯一检验'一个场景解释全部视图'的整体性测试,能发现成对帧比较遗漏的沿轨迹累积的不一致。
语义特征与感知保真度度量
DINOv2 自监督特征经掩码区域池化后做余弦相似度,衡量语义内容是否相同;PSNR/SSIM 衡量像素级一致,LPIPS 衡量感知差异。三者可能严重脱节:场景语义相同但纹理、物体外观全变,DINO 仍很高而 LPIPS 很差。
Orbia 在回访比较中同时使用三者,MiniMax-H3 的 DINO 77.27 对同视角 LPIPS 仅 17.32 的反例说明只看语义相似度会被'换了皮的同一场景'欺骗。
研究动机
视频生成正从视觉合成走向世界模拟,支撑交互游戏、开放域探索、生成式渲染与具身仿真等应用。这些应用要求不同时间、不同视角的观察彼此兼容于一个持久的 3D 世界:玩家离开再回来应看到同一环境,渲染器揭示的表面应相互一致,具身智能体应能复用先前观察到的空间关系。但视觉上逼真的帧本身并不保证这种结构性可靠。现有评测各管一段:WorldScore、WBench、WorldMark 检查局部或场景级几何自洽;MIND、WRBench、MemoBench、LoopBench、CycleBench 用同视角外观比较、点云比较或 VLM 判断来测记忆与回访;WorldLens 把驾驶世界模型扩展到重建、动作跟随与人类偏好。关键问题是:几何一致不等于内容保持——场景骨架对了、地标可能没了;成功回访也不等于探索全程一致。系统性、定量地把 3D 结构与内容保持联合评估的基准仍然空缺,这正是本文的核心追问:生成视频到底构不构成一个一致的 3D 世界?
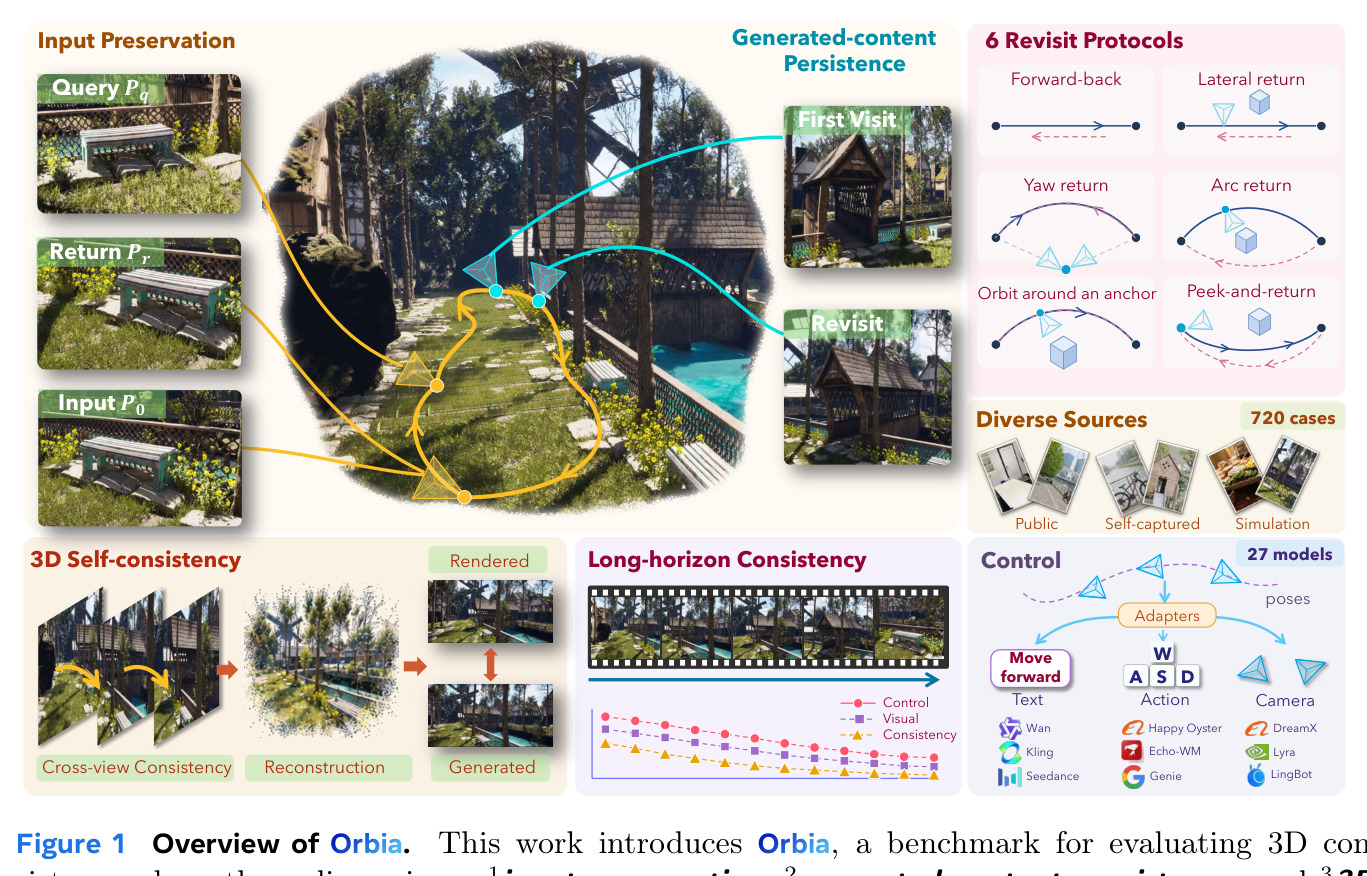
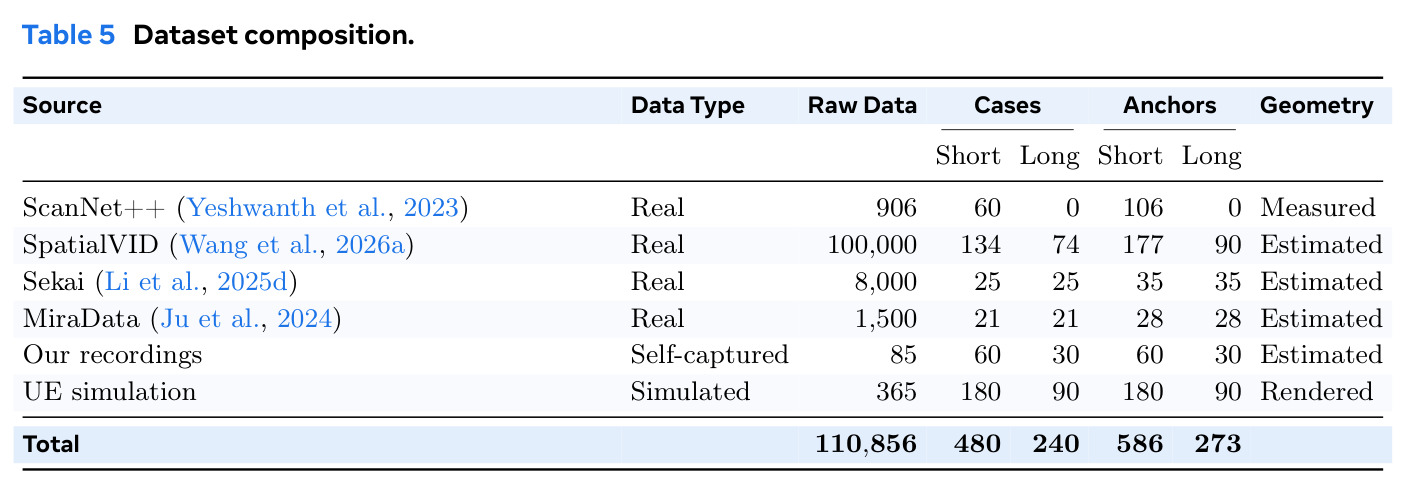
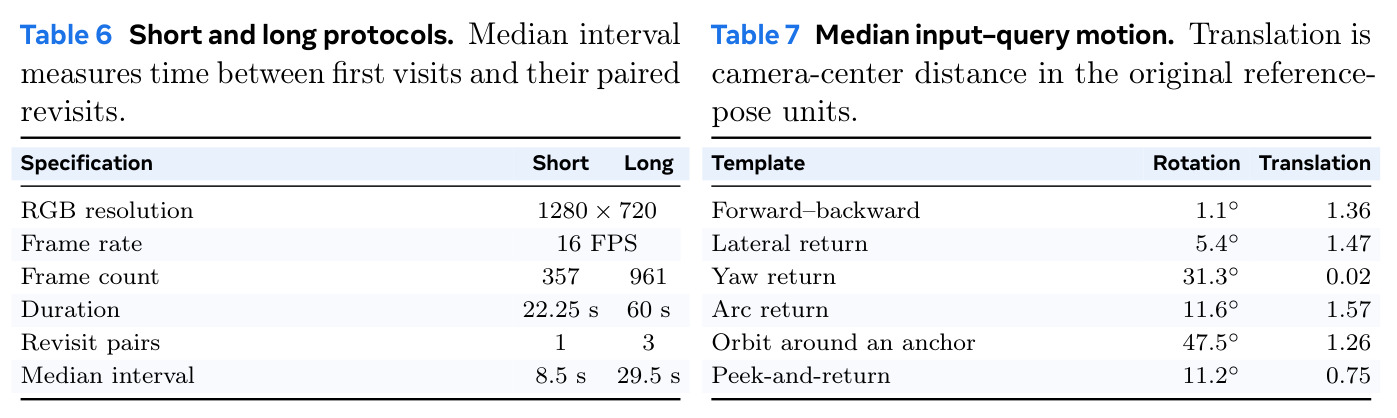
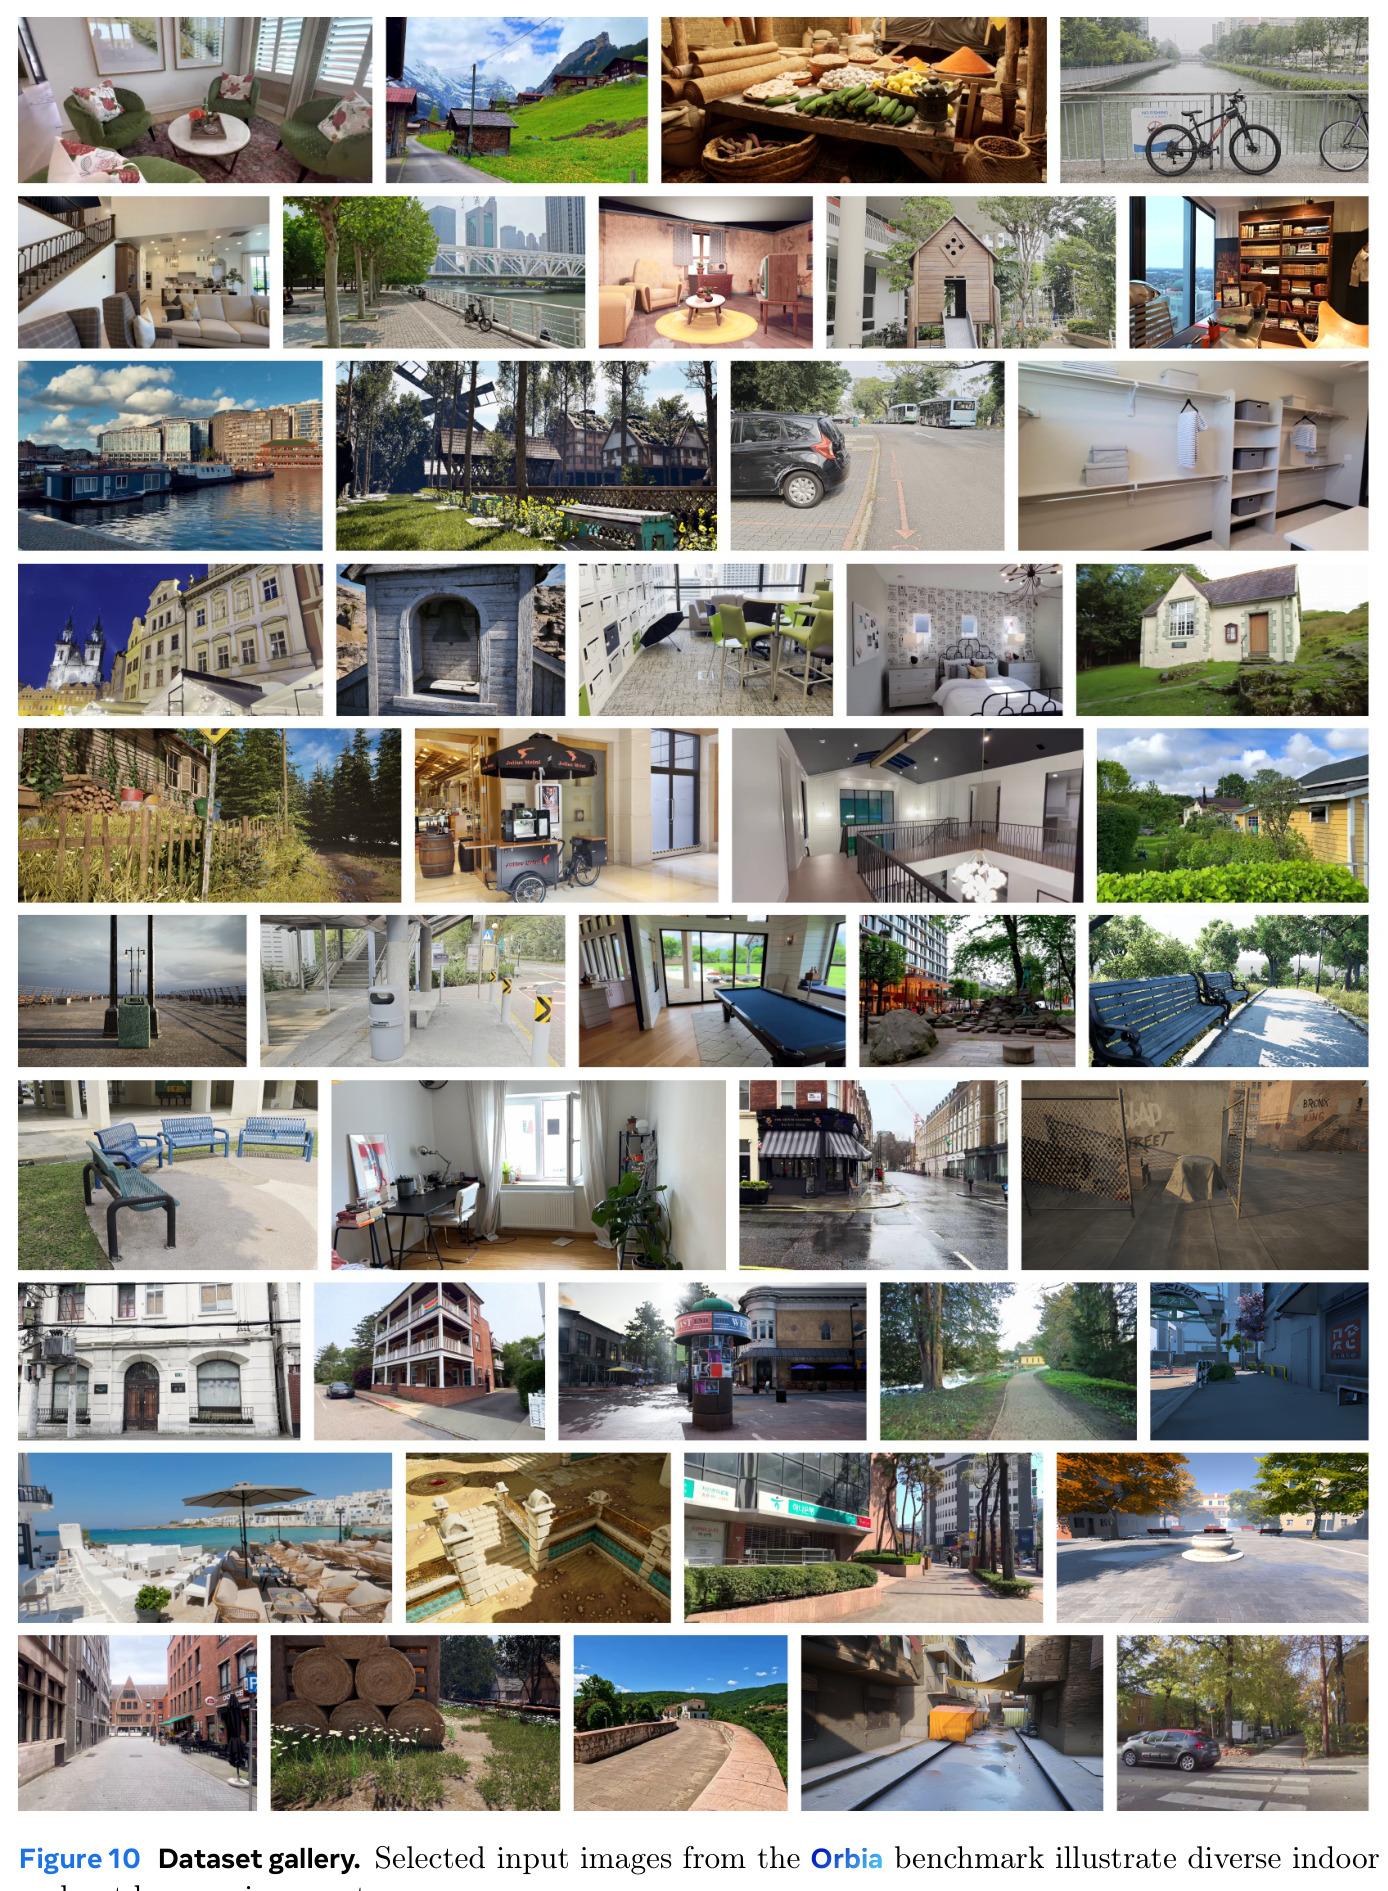
本文的目标是本文构建首个专门针对交互式世界模型 3D 一致性的系统定量评测基准 Orbia。具体目标有四:其一,把'3D 一致性'分解为三个可分别度量的维度——输入保持(模型是否保住输入图像所示环境)、生成内容持久性(模型离开后再回到自己新揭示的区域时内容是否还在)与 3D 自洽(生成的各视角是否描述同一个 3D 场景);其二,建立统一标注流水线,整合 ScanNet++、SpatialVID、Sekai、MiraData 四个公开数据集、自拍摄场景与 UE 仿真,从约 11 万源样本与 300 多小时标注整理出 720 个带配准 RGB-D 参考与锚点标注的案例;其三,设计六种探索-回访协议并配对扩展到 60 秒长视频,测试长时程漂移与重复回访下的遗忘;其四,用模型专属适配器把同一批轨迹翻译成文本、动作、相机三种接口,公平评测 27 个模型,并系统分析一致性如何与控制精度、视觉质量、探索时长相互关联。
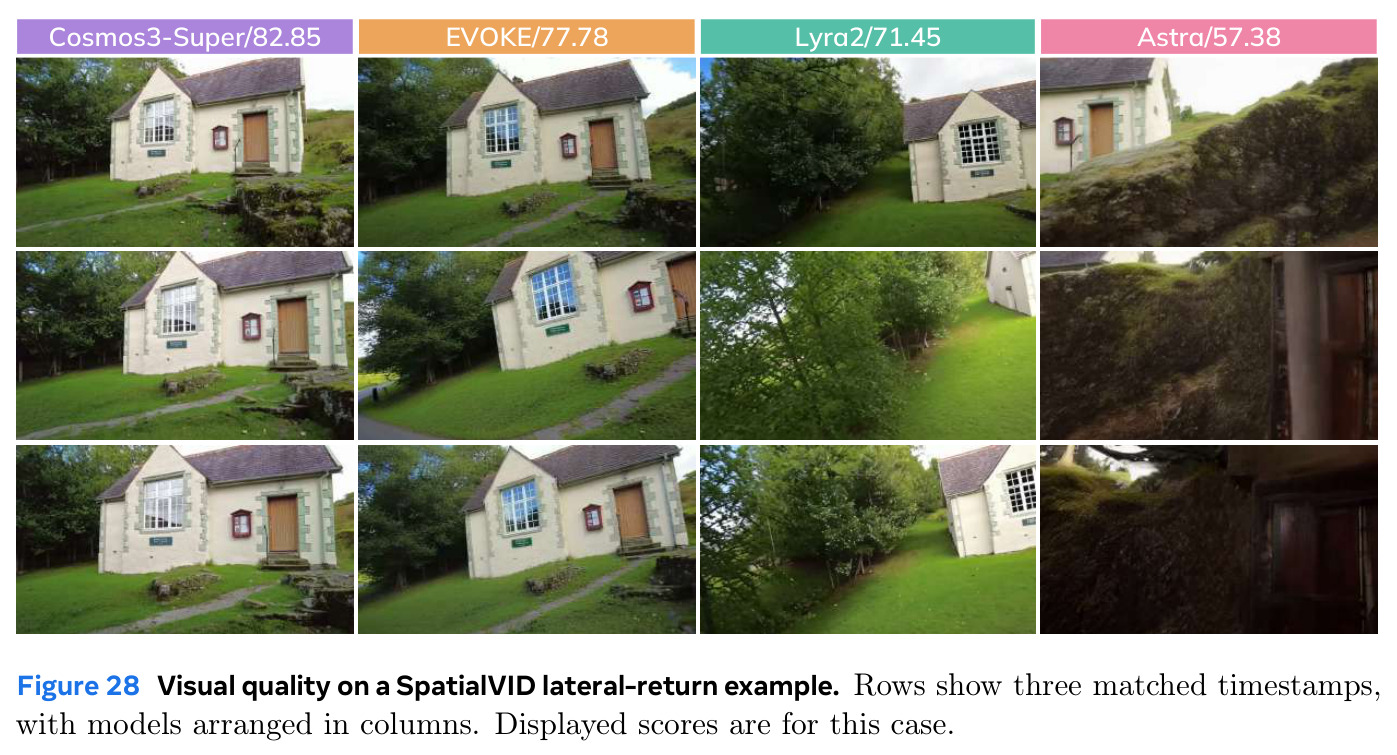
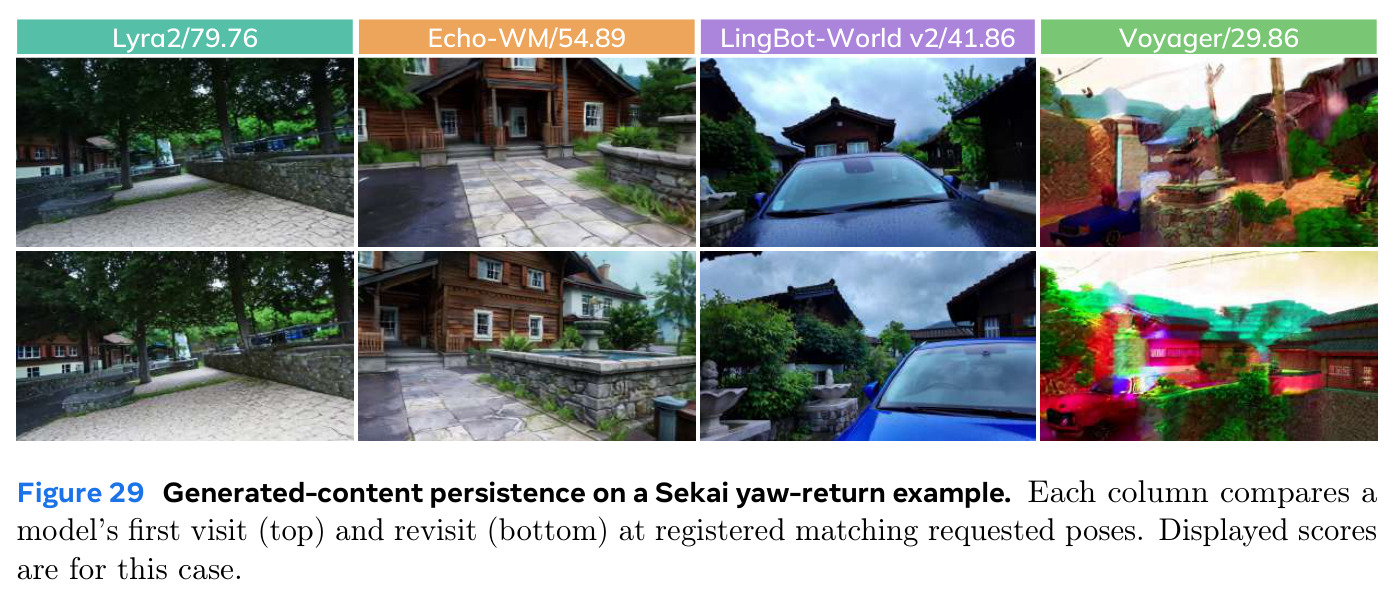
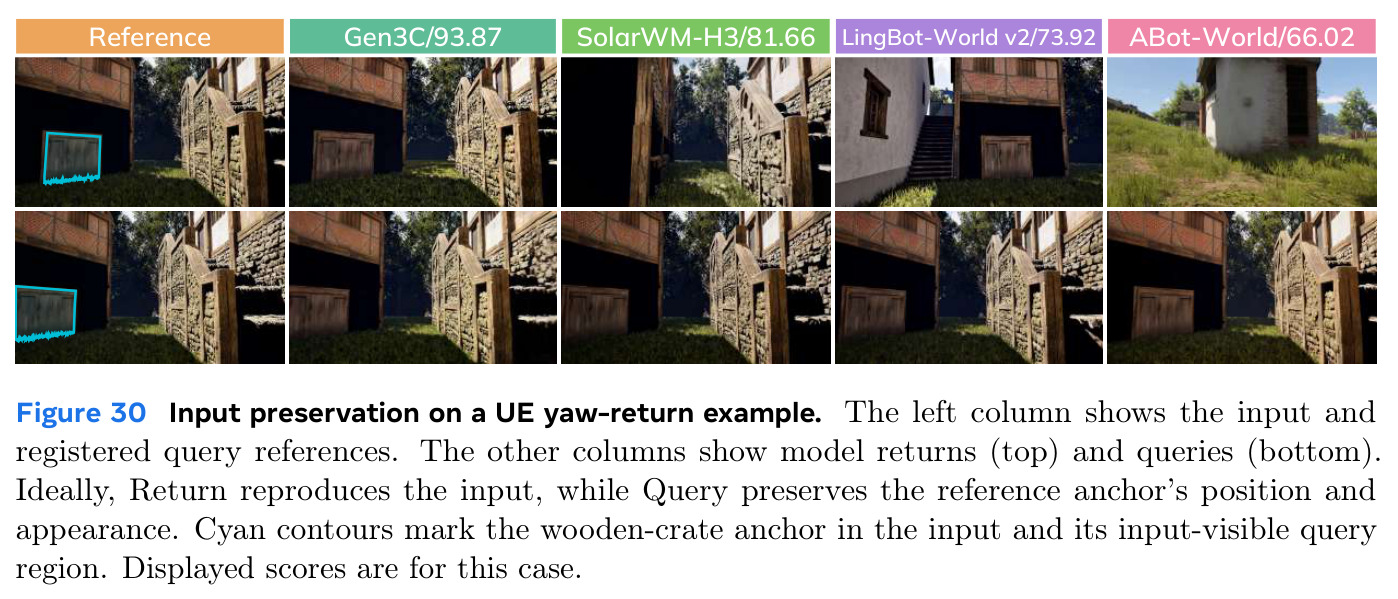
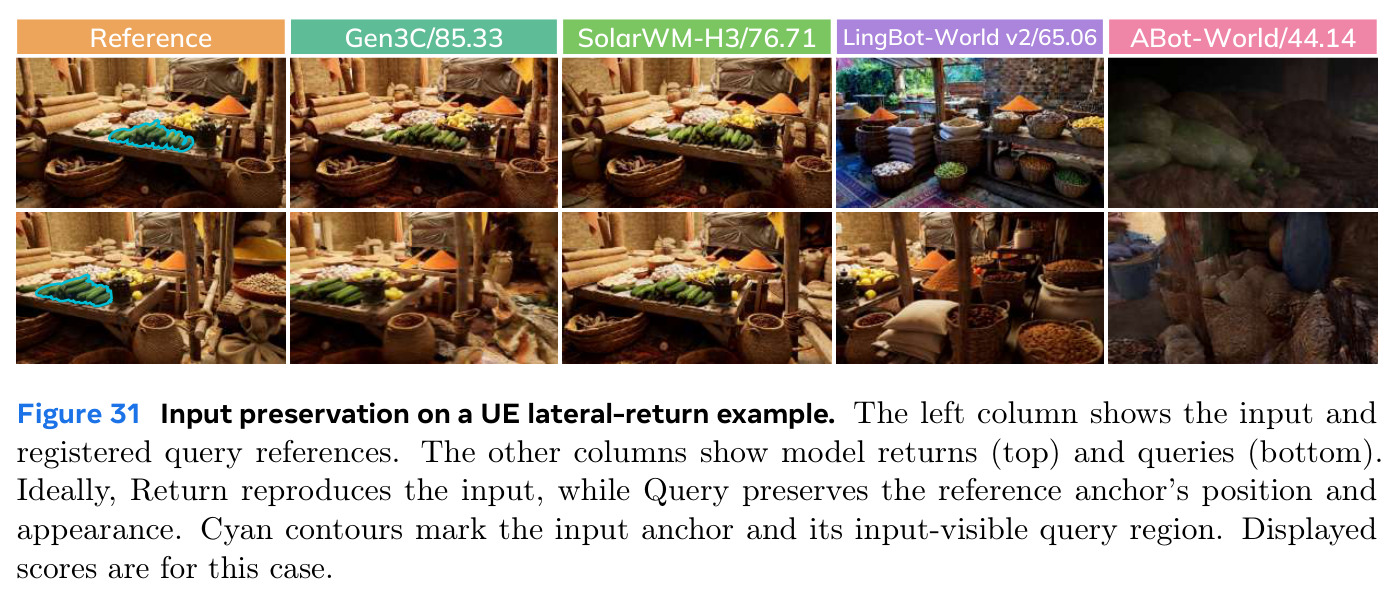
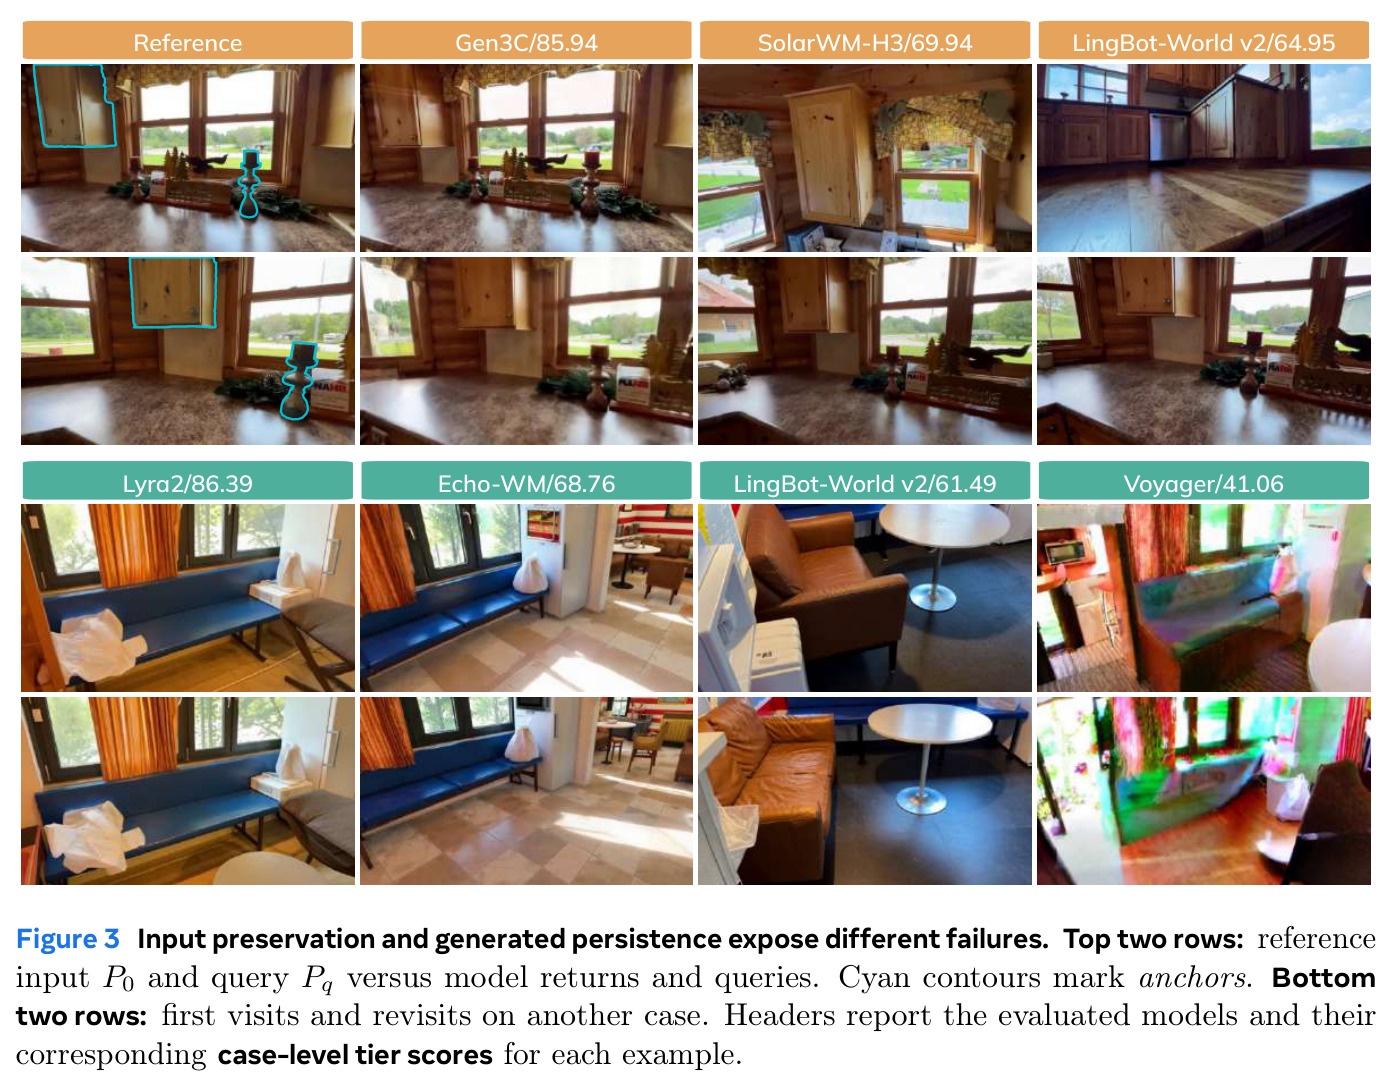
与已有工作不同的是,本文最独特的切入是按'参考从哪来'来切分一致性。对输入可见的内容,有真实注册的 RGB-D 参考和逐个标注的锚点,可度量保真度;对输入之外的区域是模型自由创作、无真值可言,本文以模型自己的'首次生成观察'作为参考,检验回访时是否还是那个内容;对生成视频内部,则完全不用请求的相机轨迹,只用恢复出的相机做跨视图对应与留出渲染,检验各视角是否拼成同一个 3D 场景。这种三分法把'忠实于观察证据''记住自己生成的内容''视角之间几何兼容'三个此前被混在一起或只测其一的要求彻底分开。配套的独特设计包括:逐锚点评分防止小地标丢失被全图平均掩盖(锚点中位面积仅占输入画面 5.2%);480 个短案例与 240 个 60 秒扩展的长短配对设计量化长时程退化;以及跨接口适配器让文本、动作、相机三类模型在同一条轨迹上公平可比。
核心方法
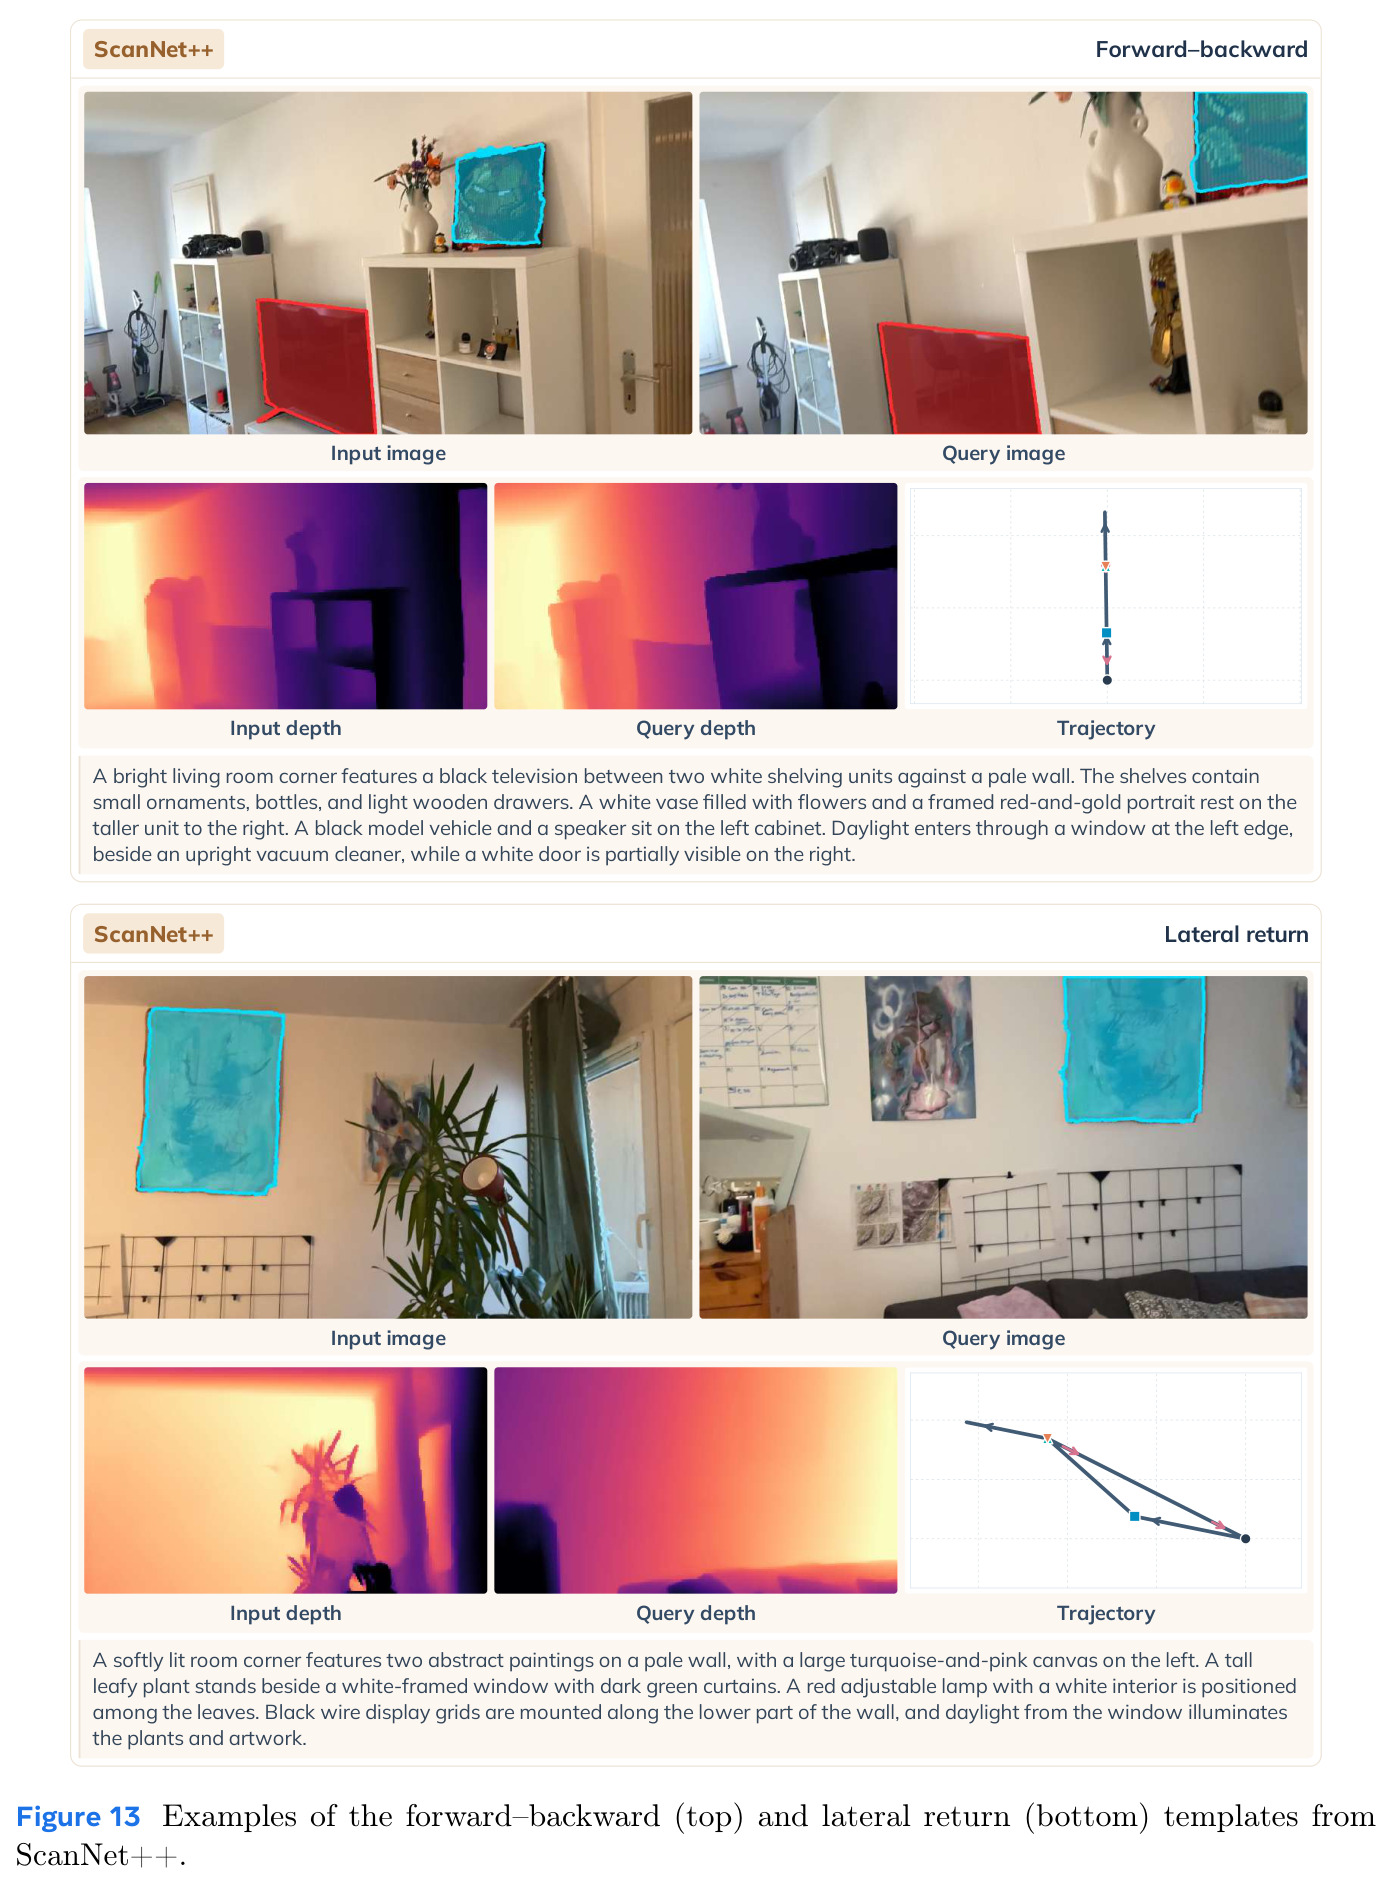
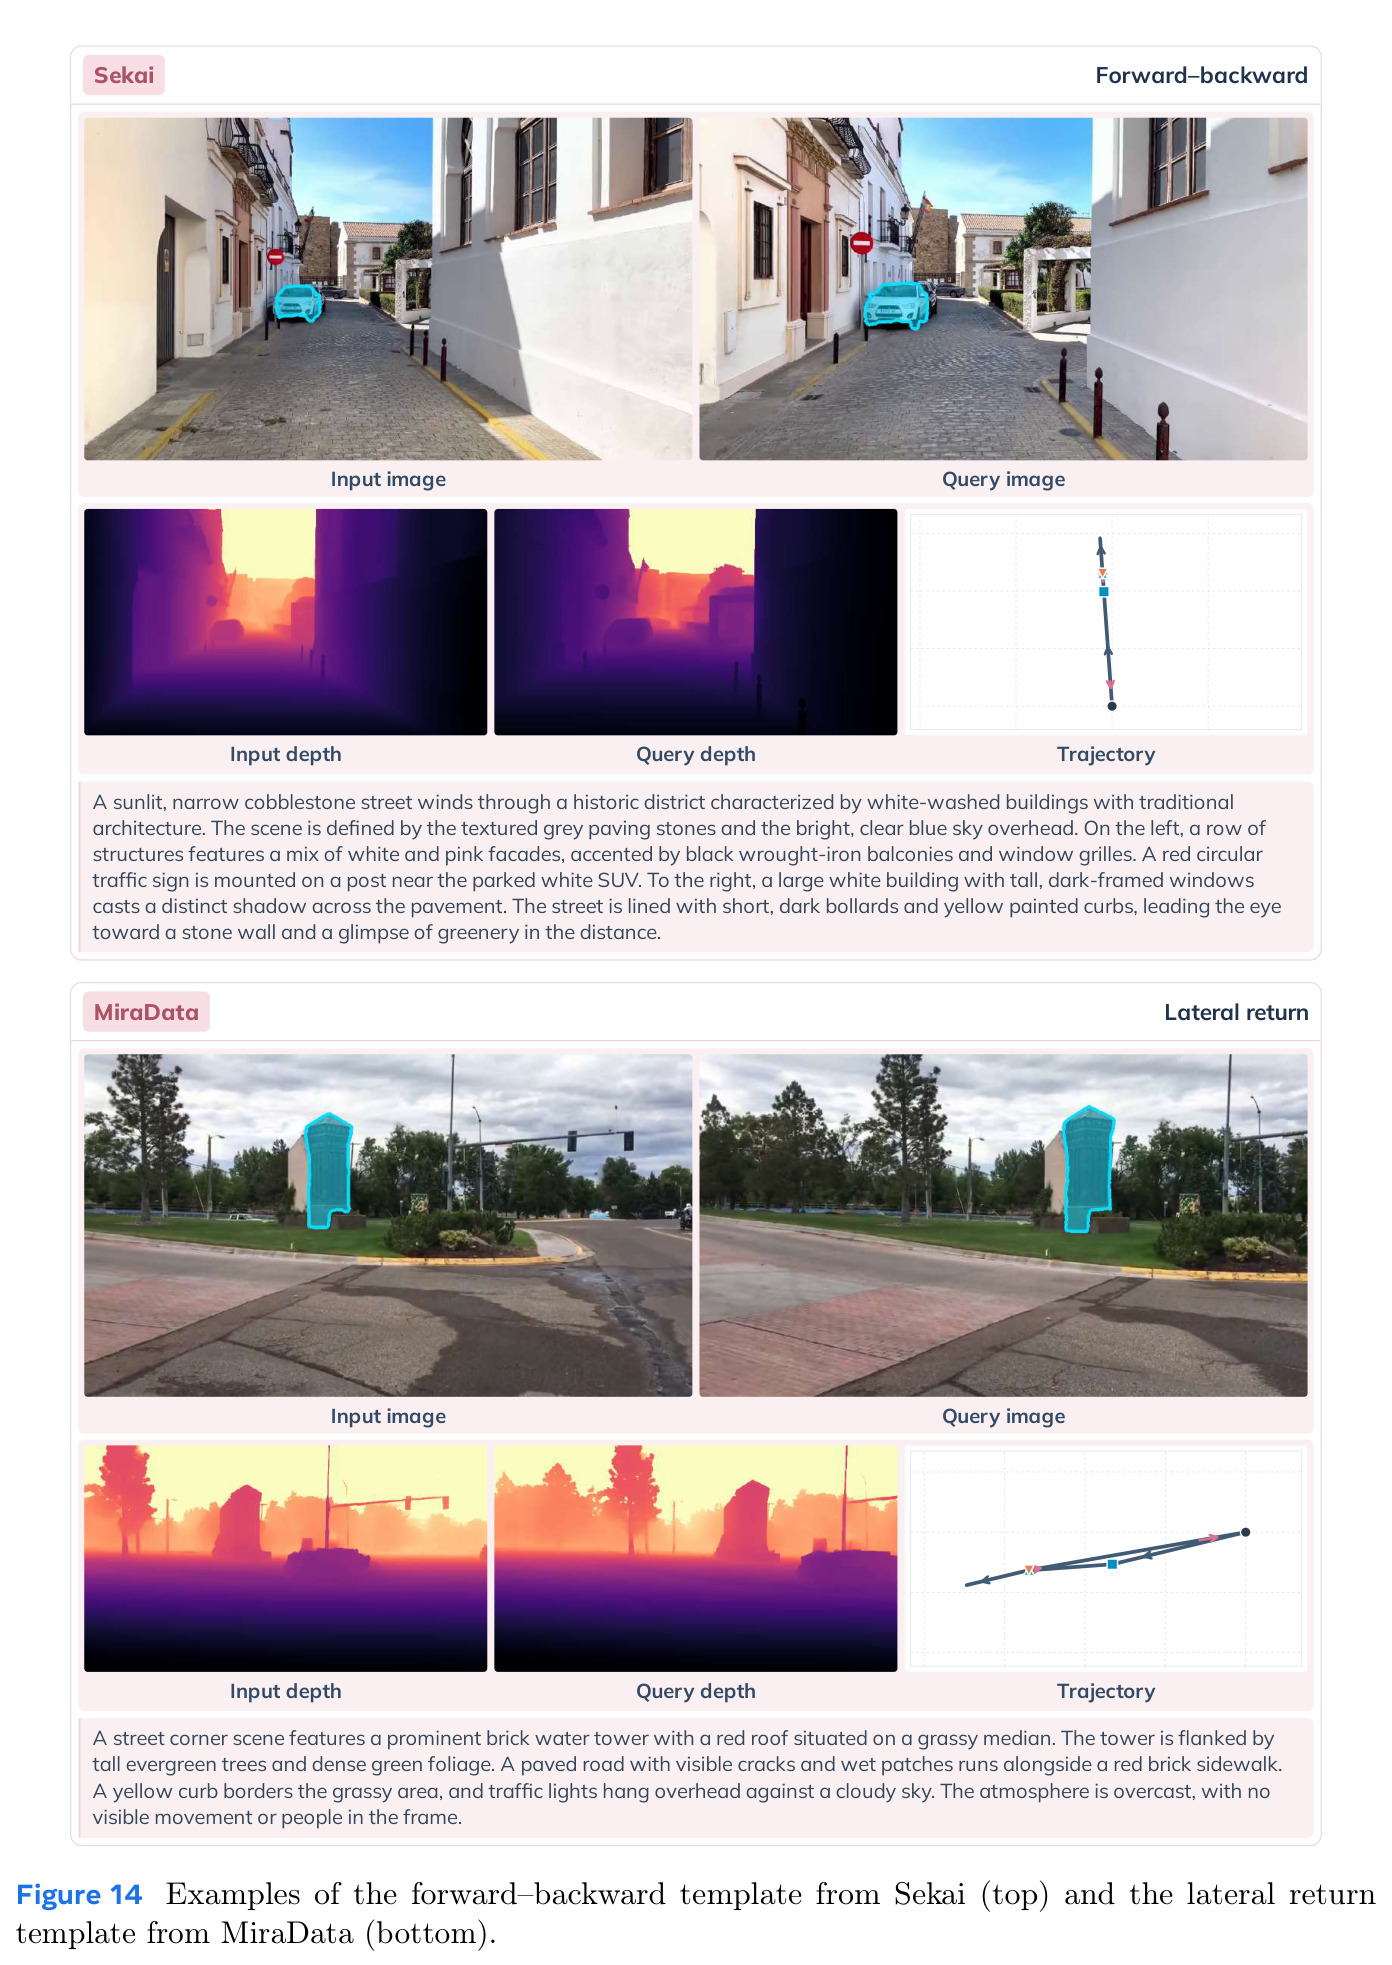
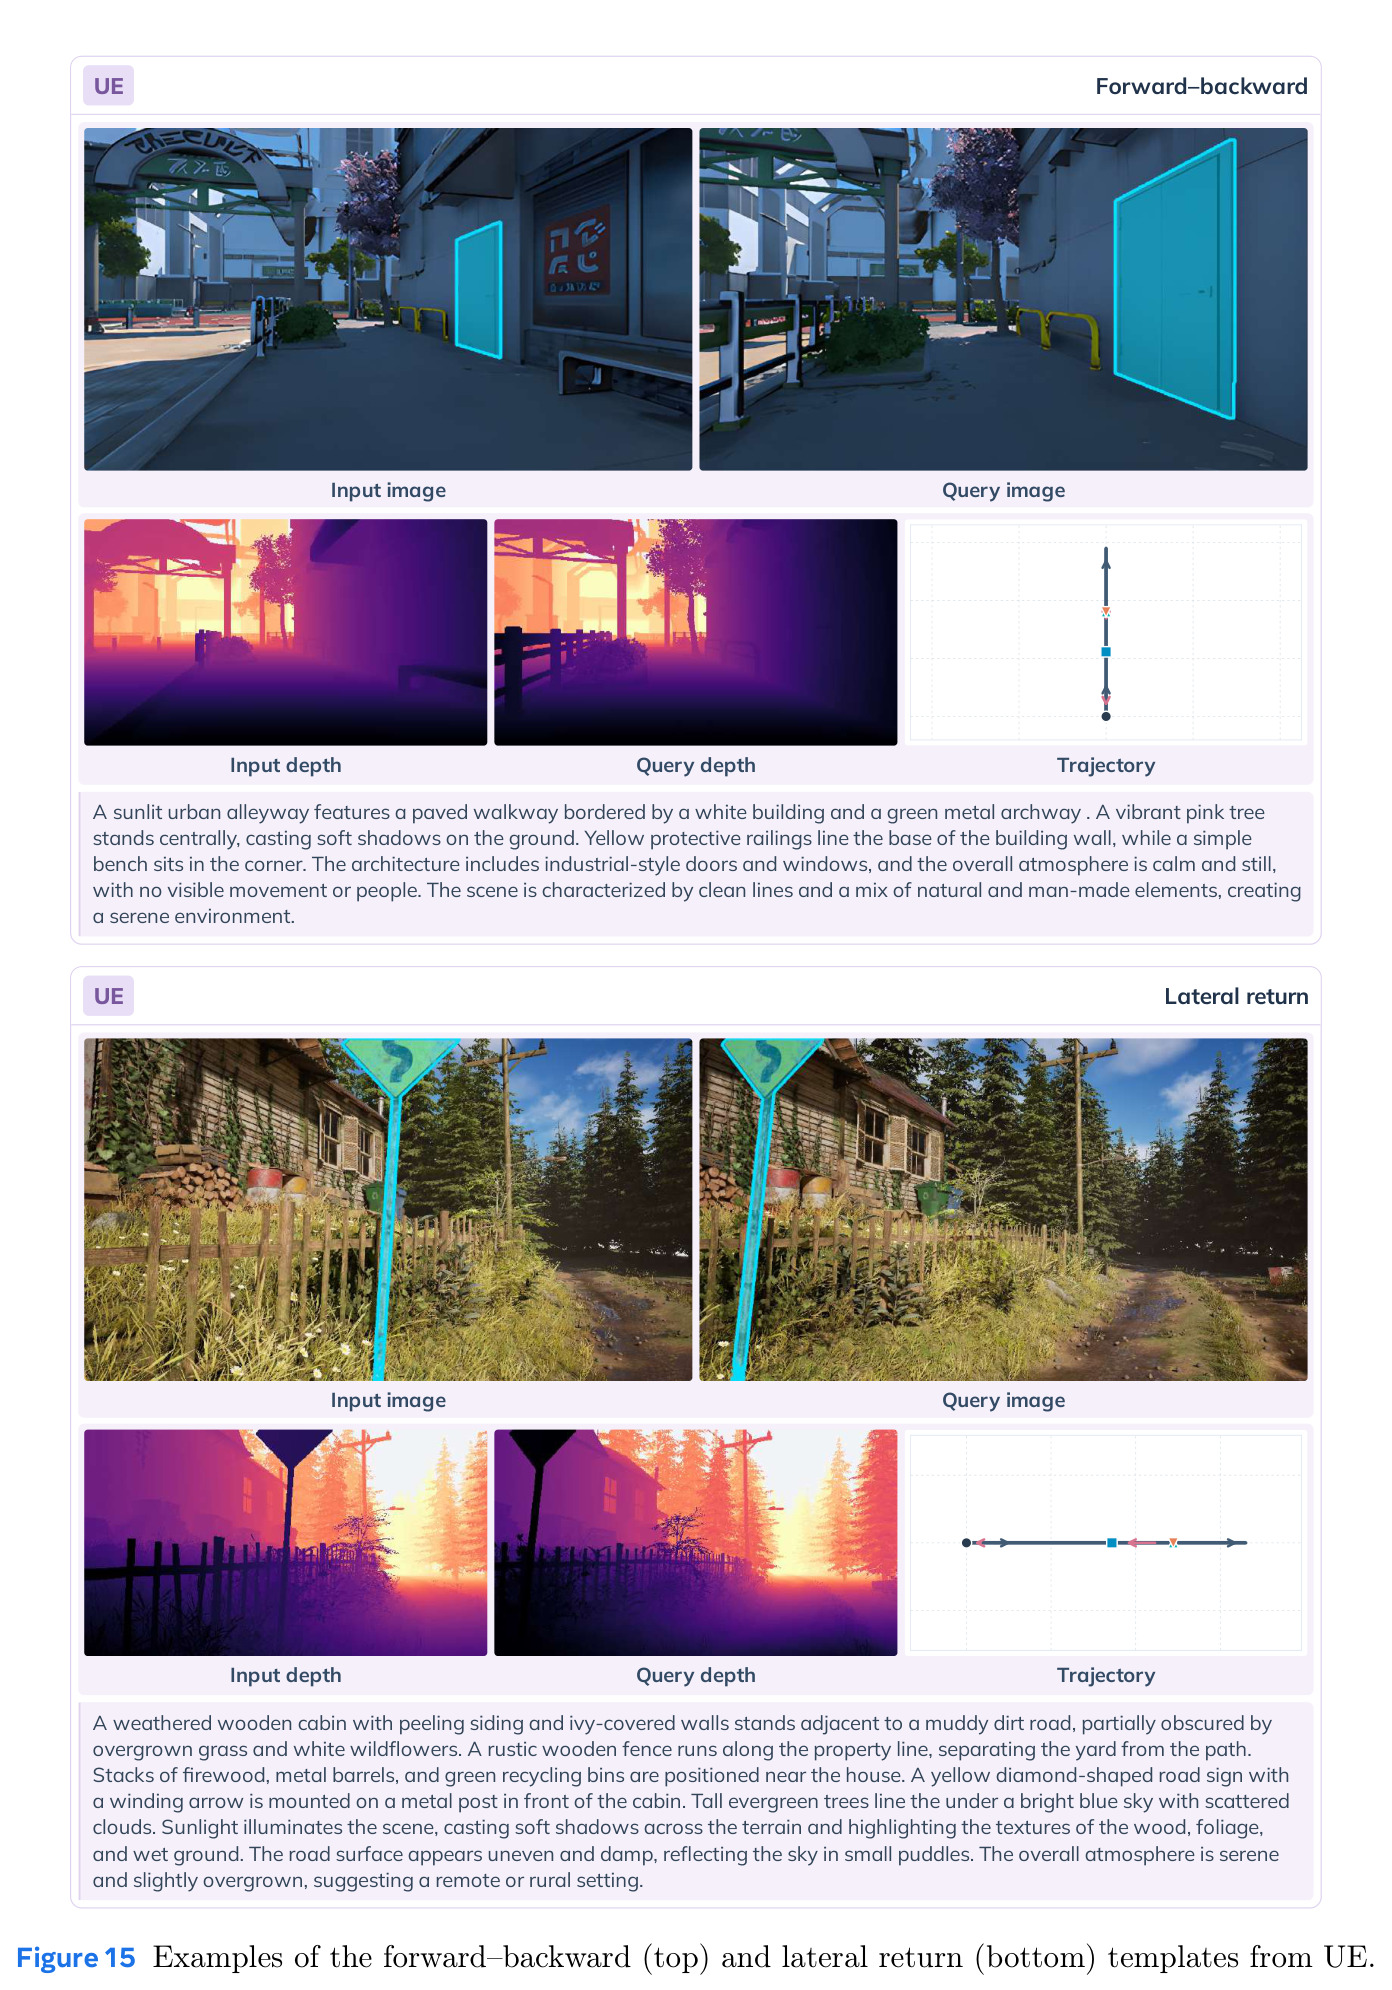
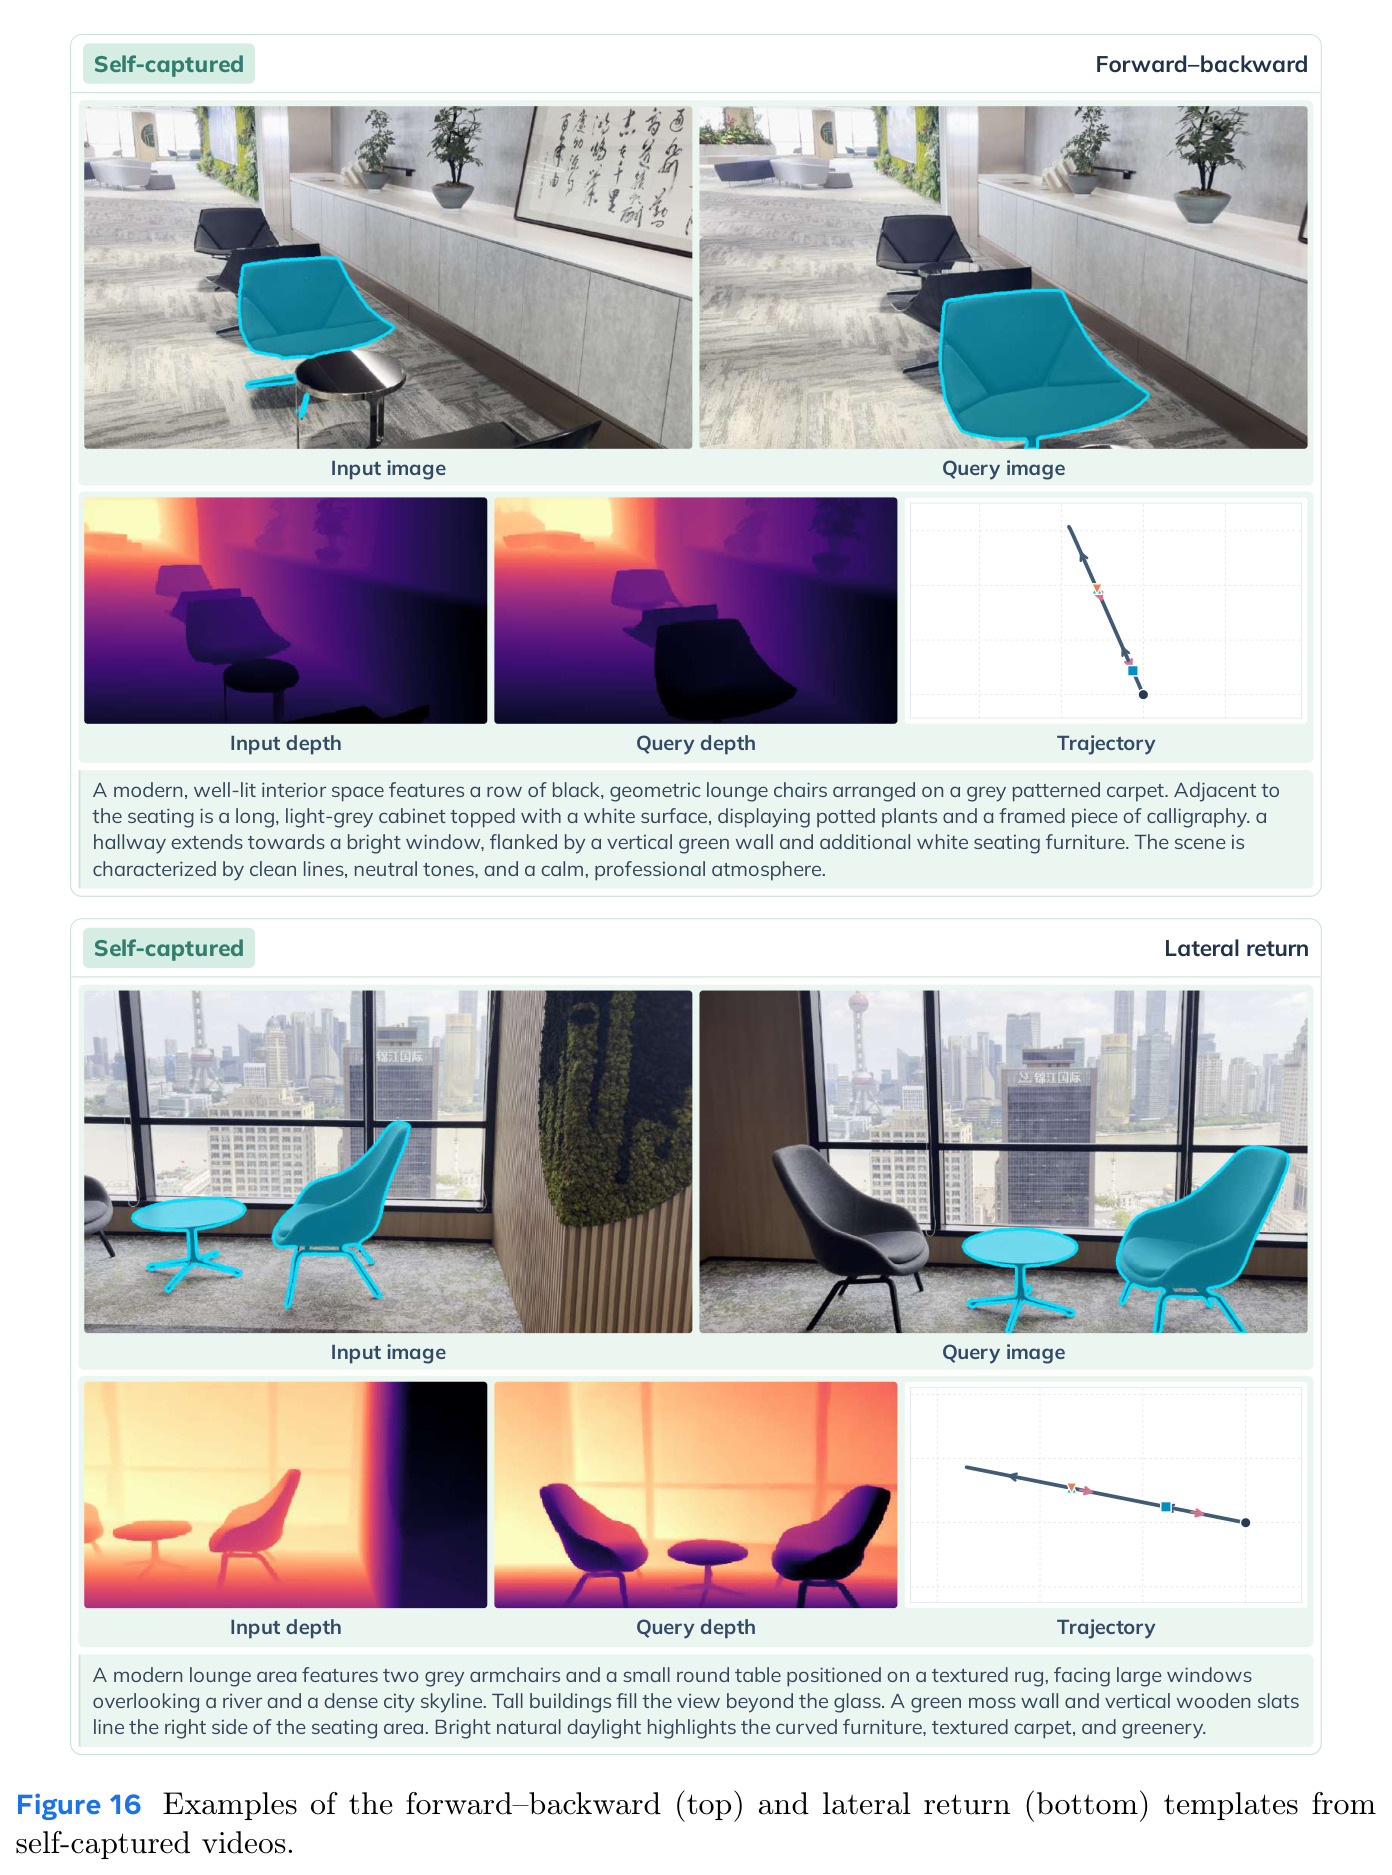
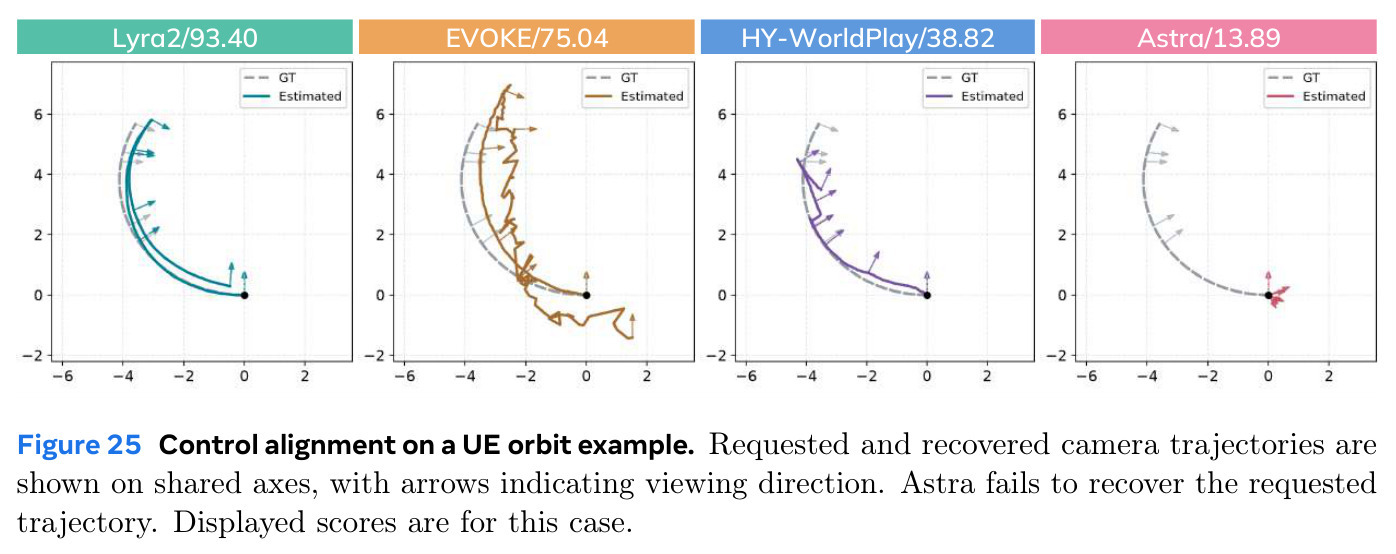
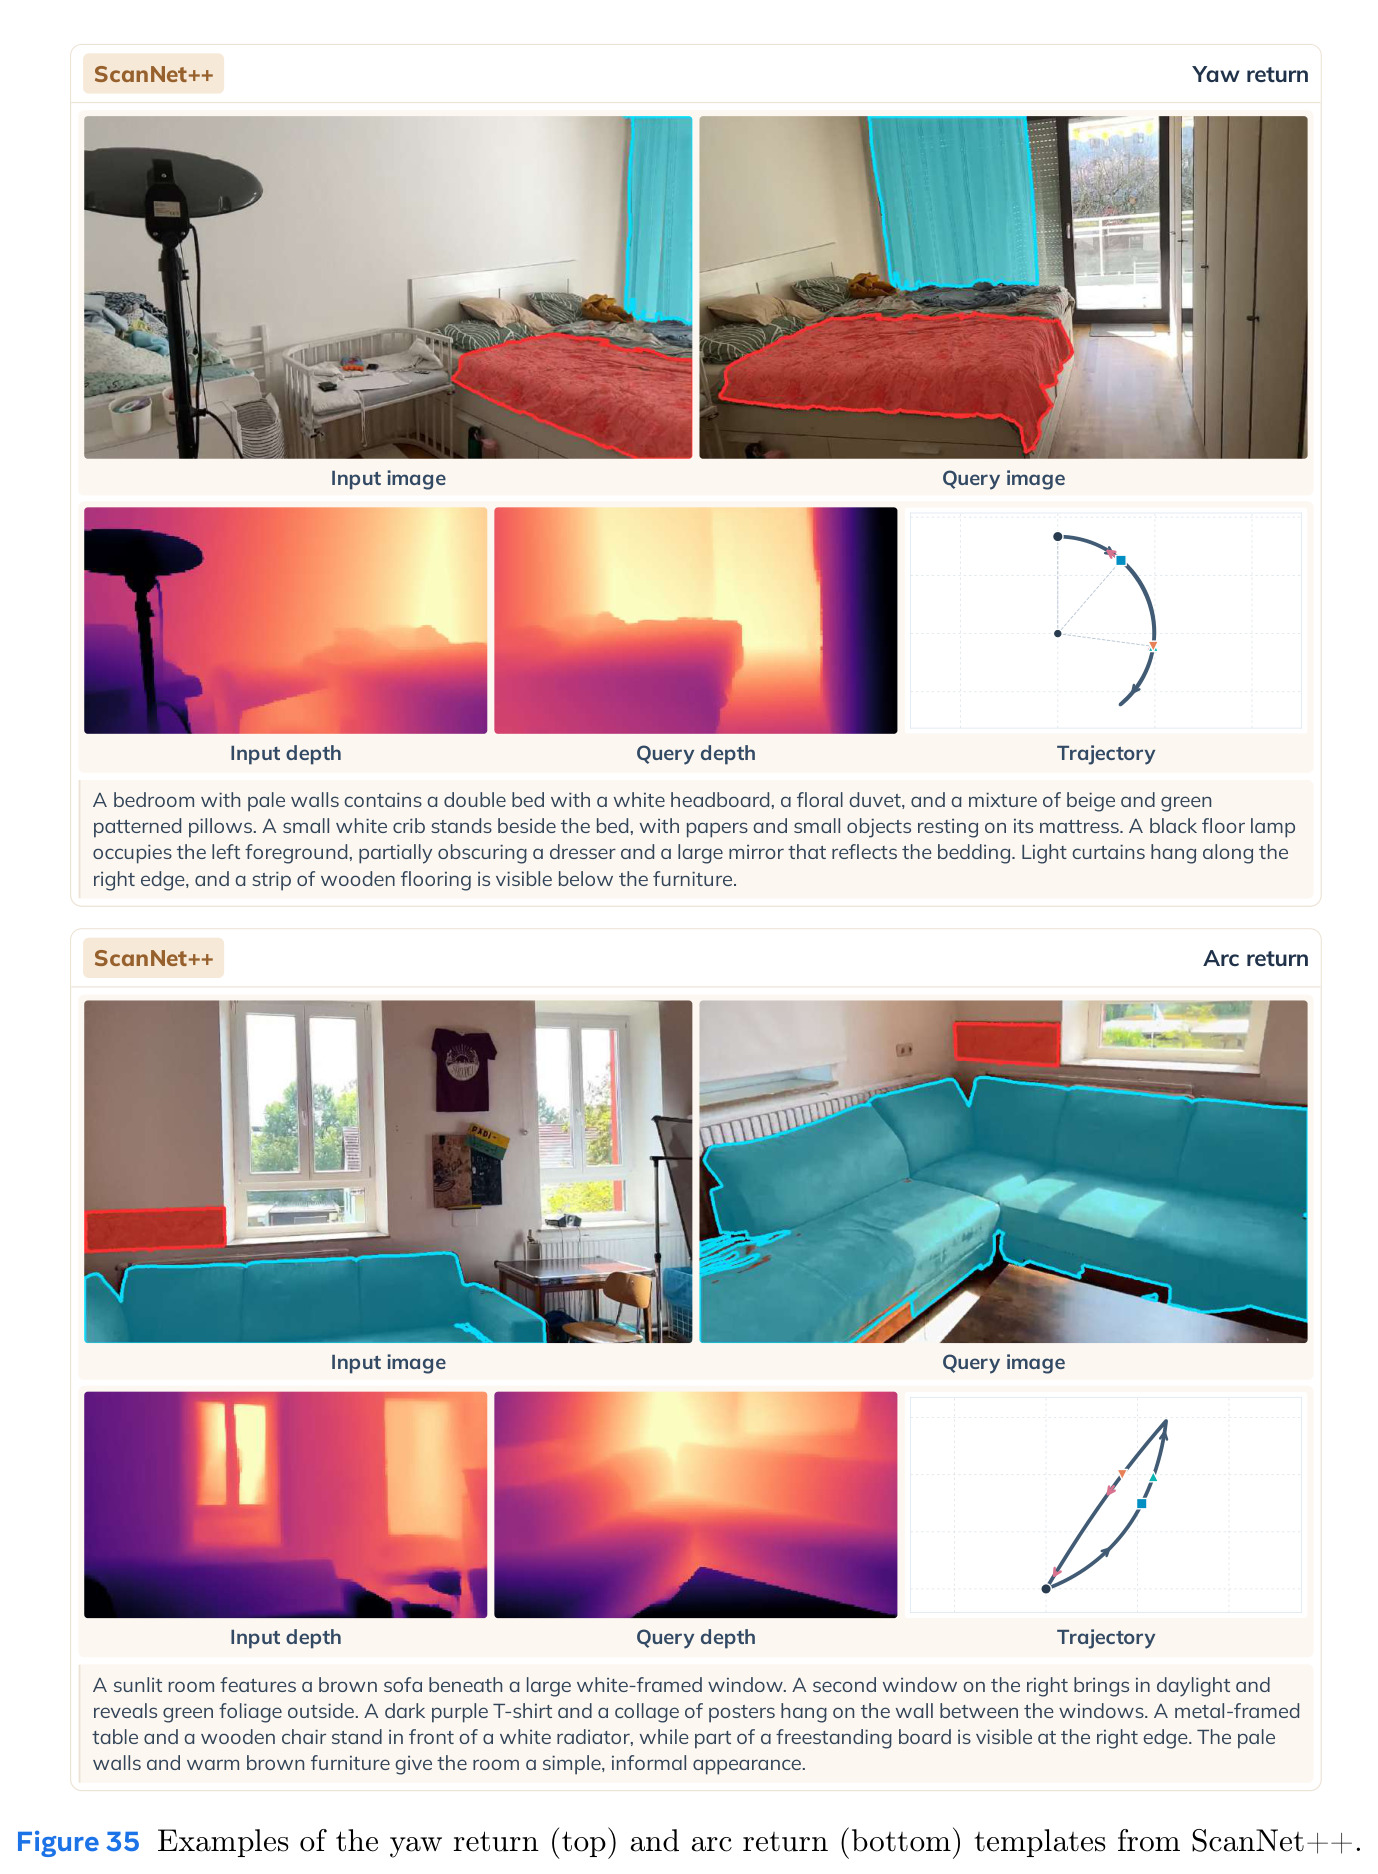
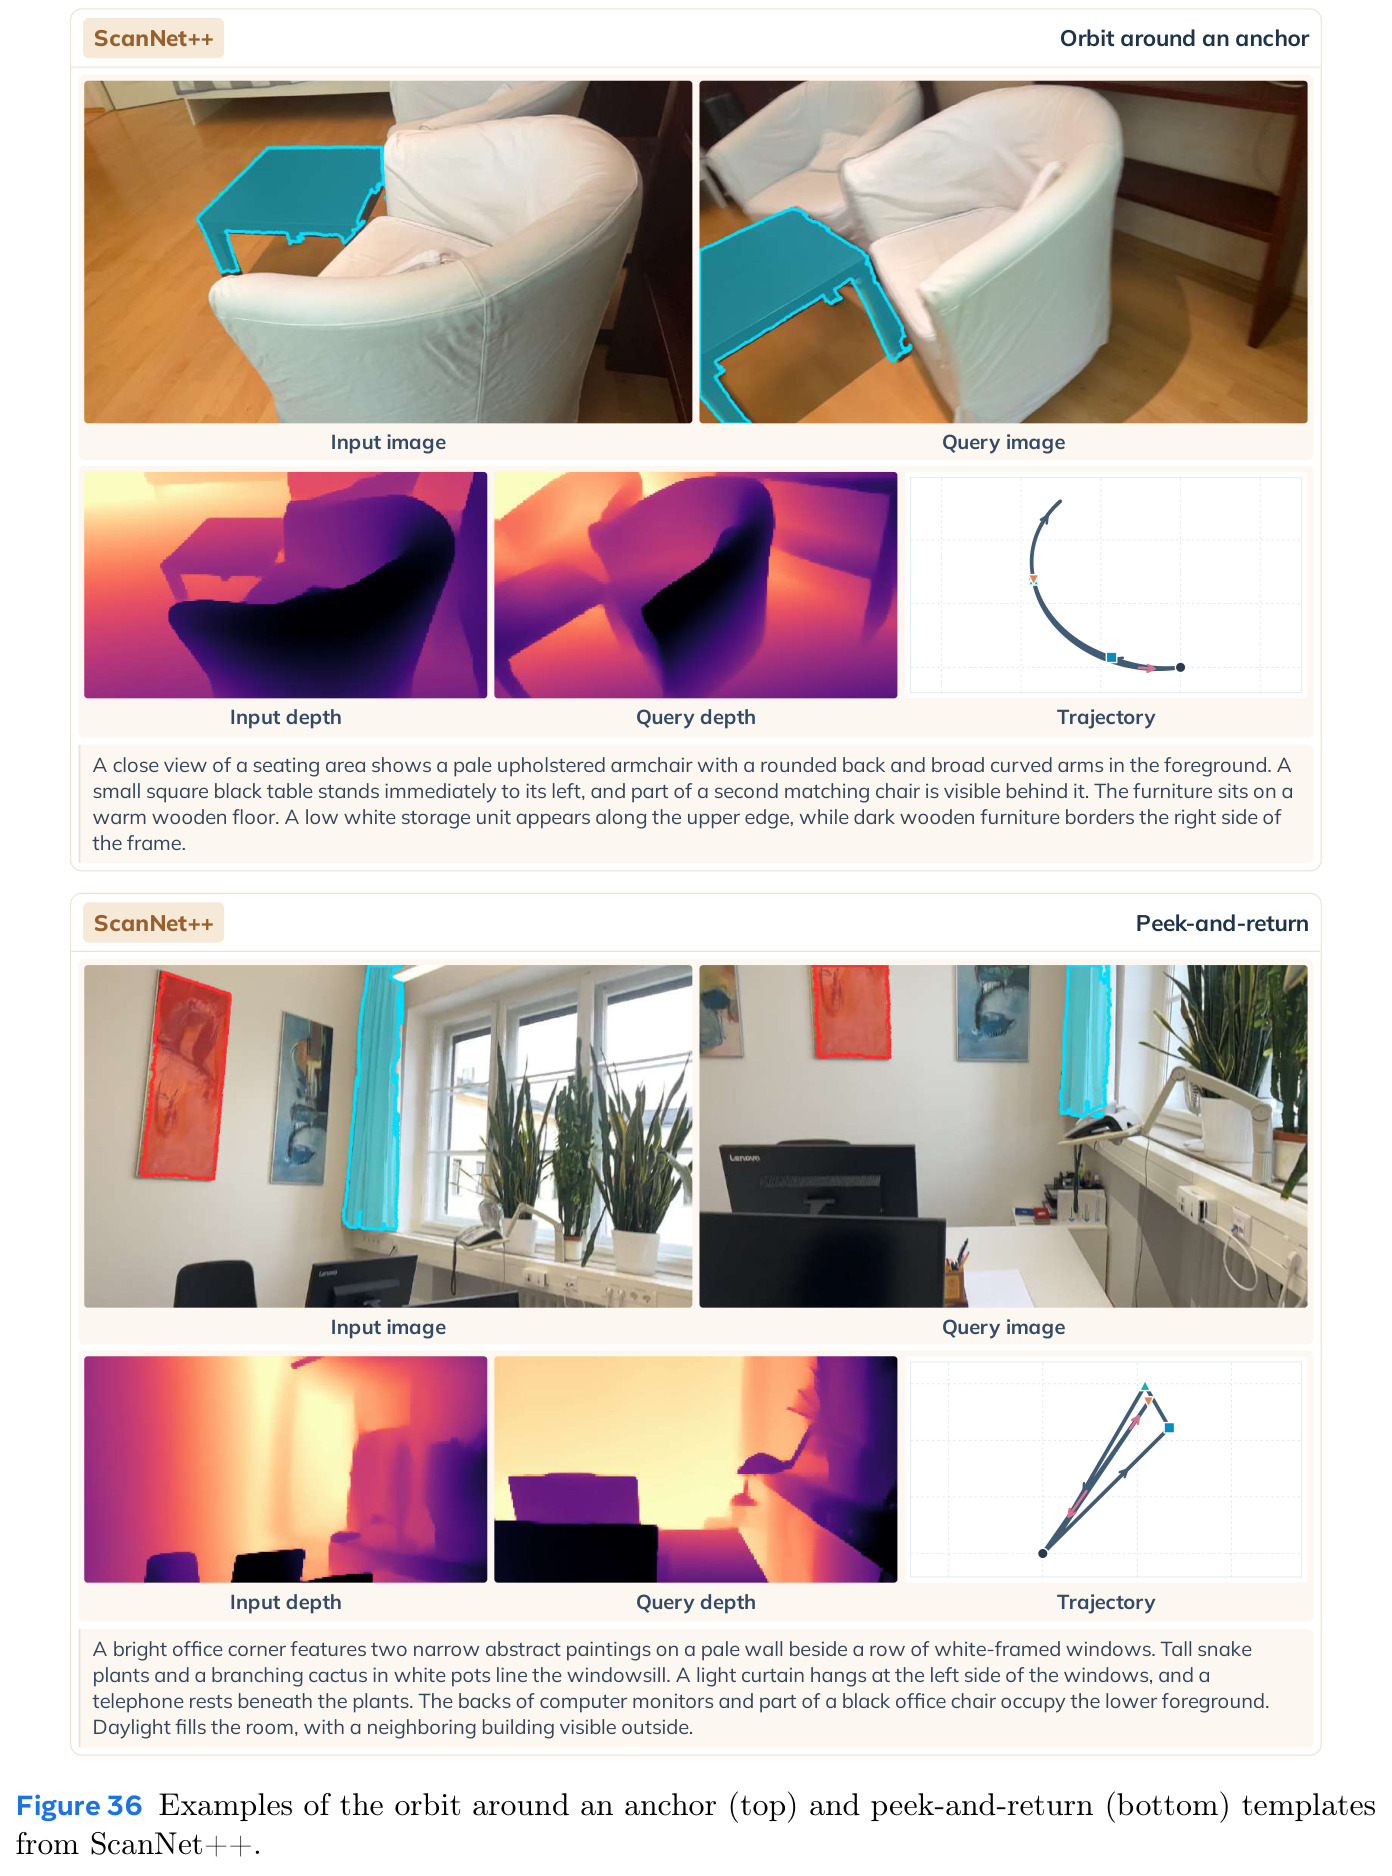
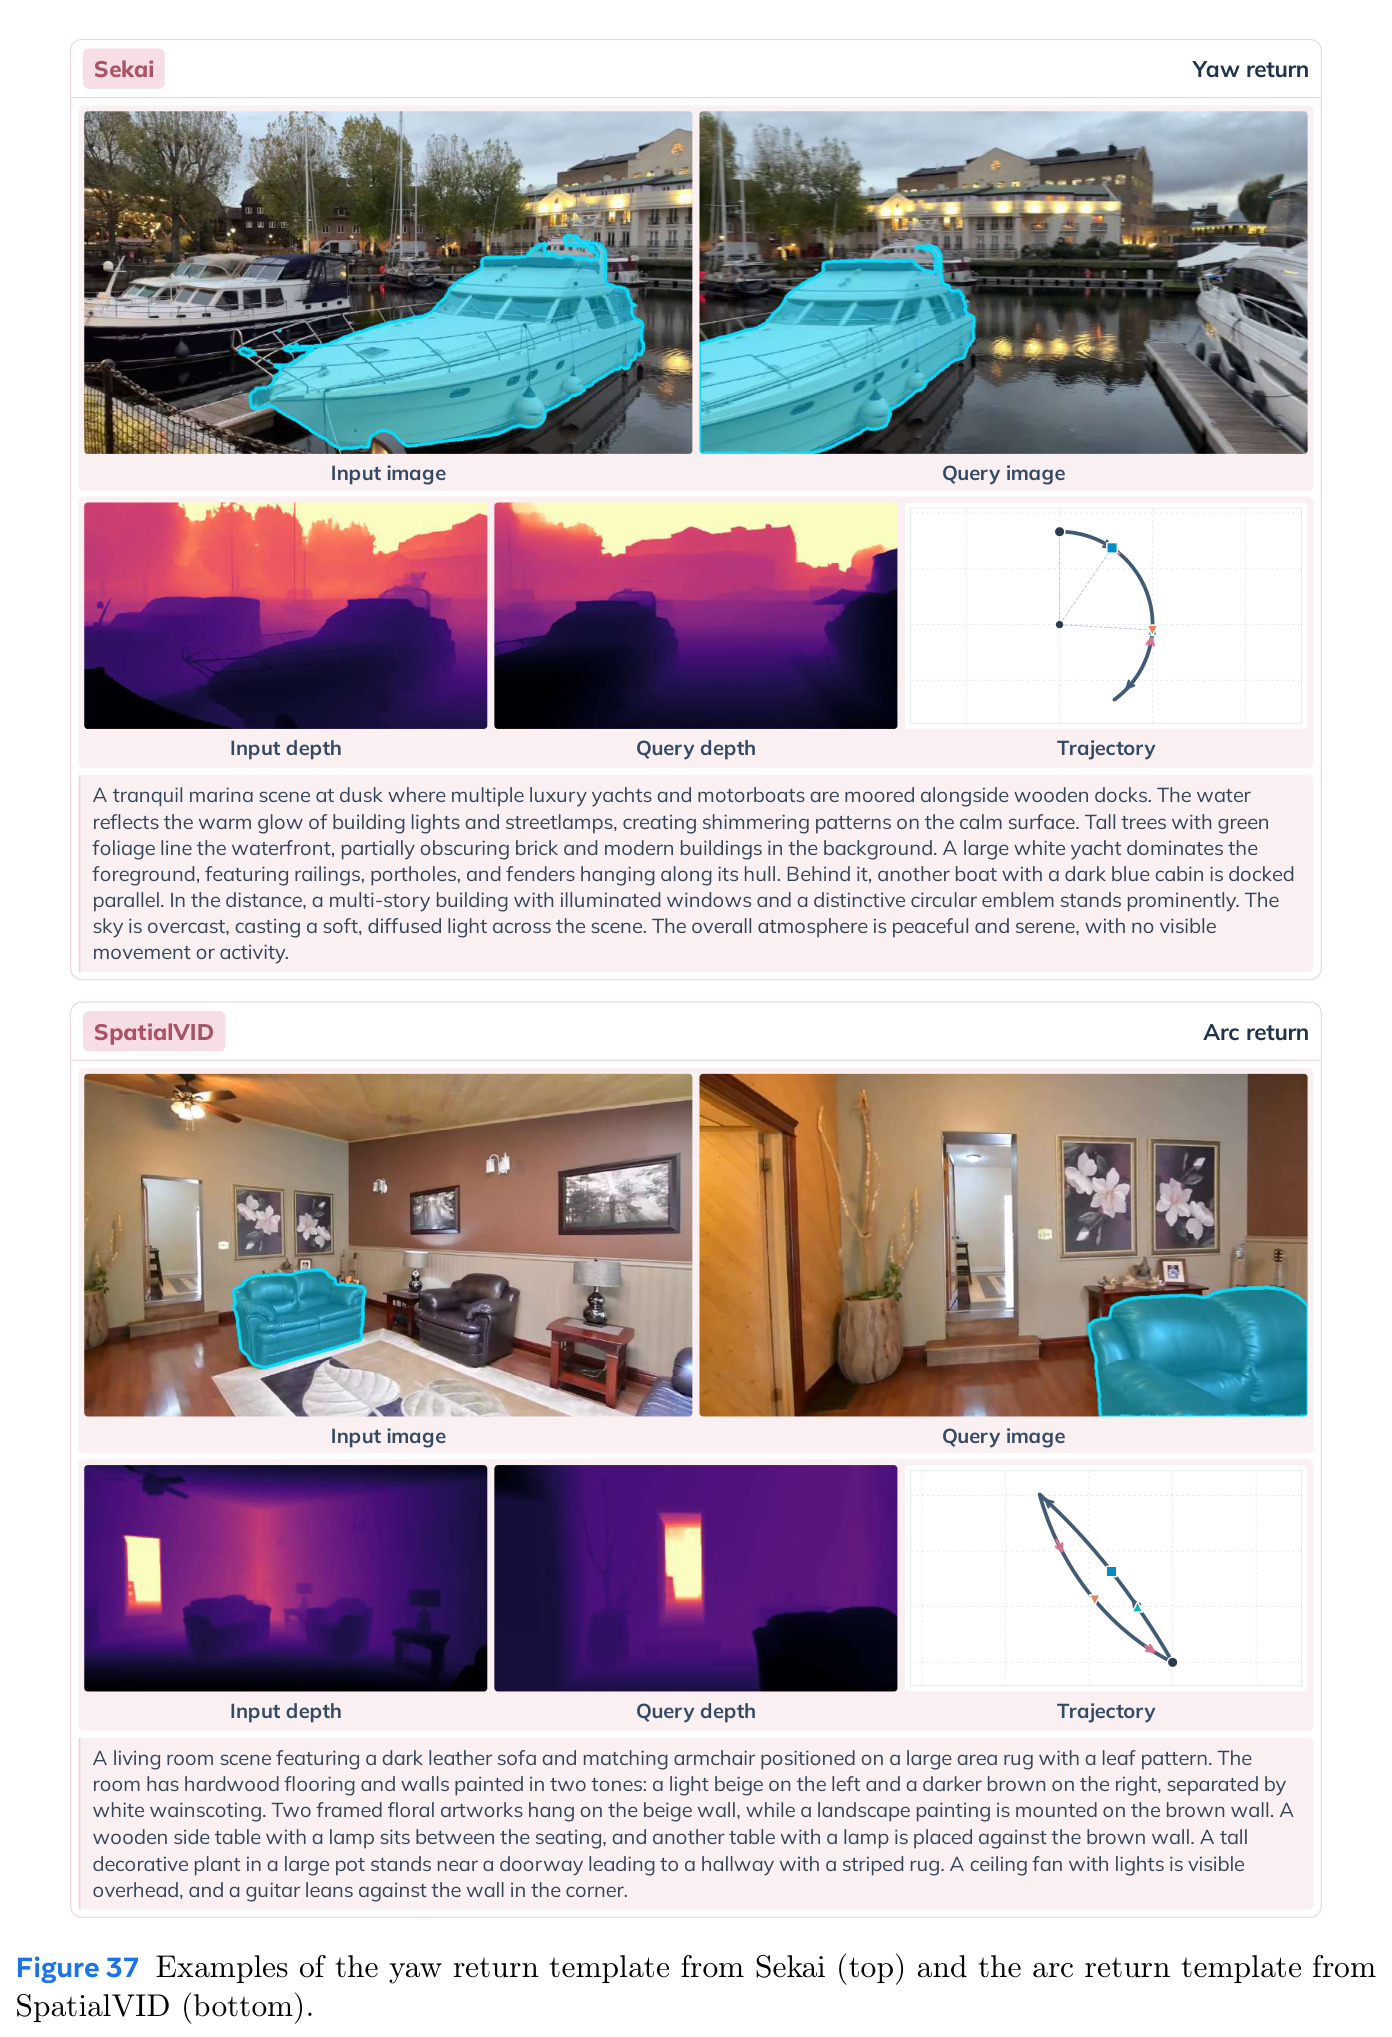
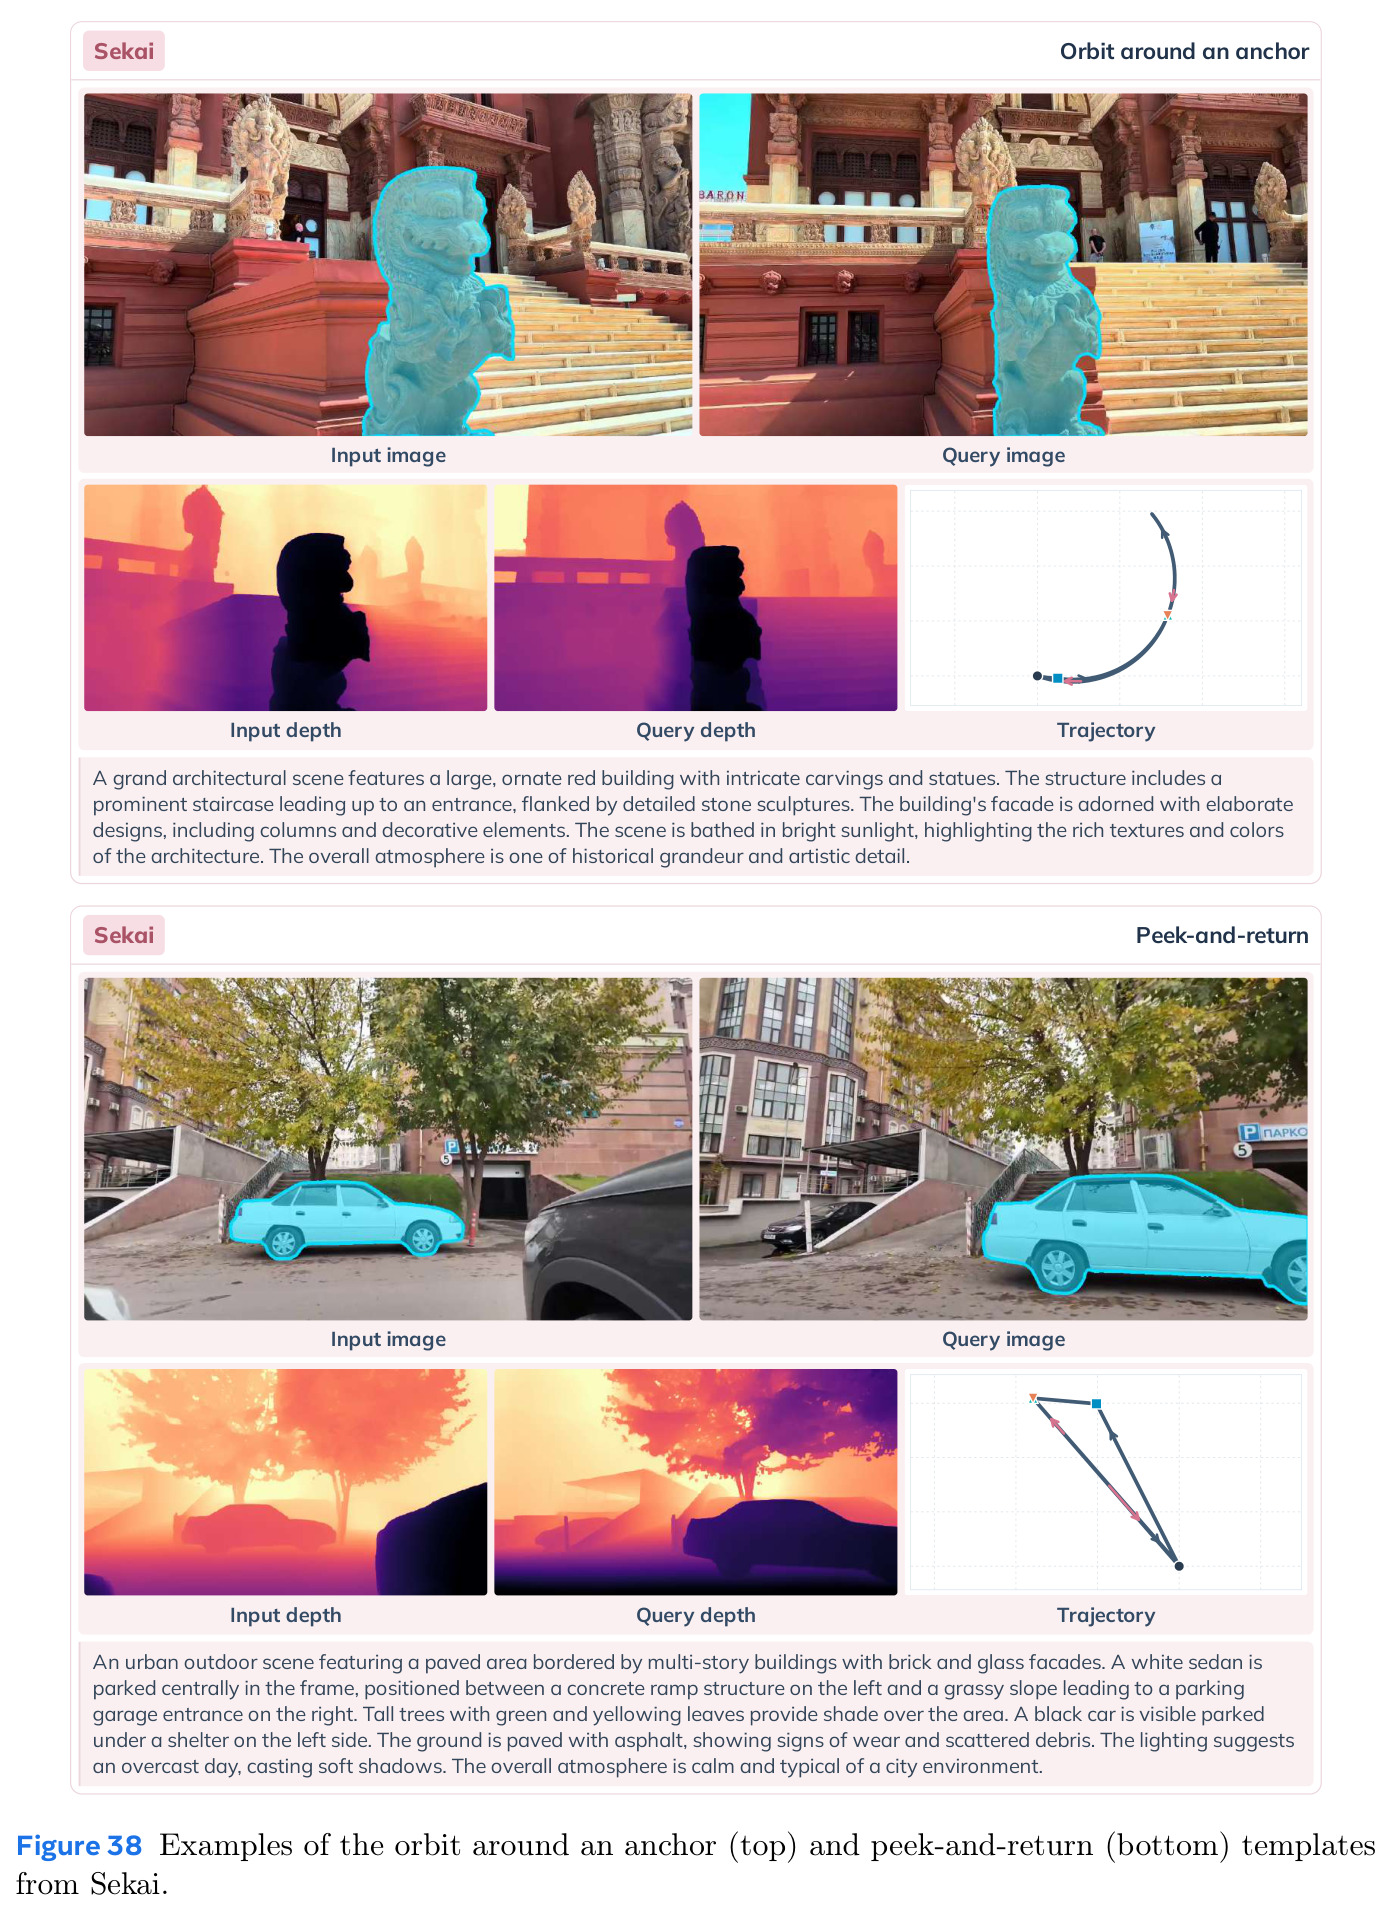
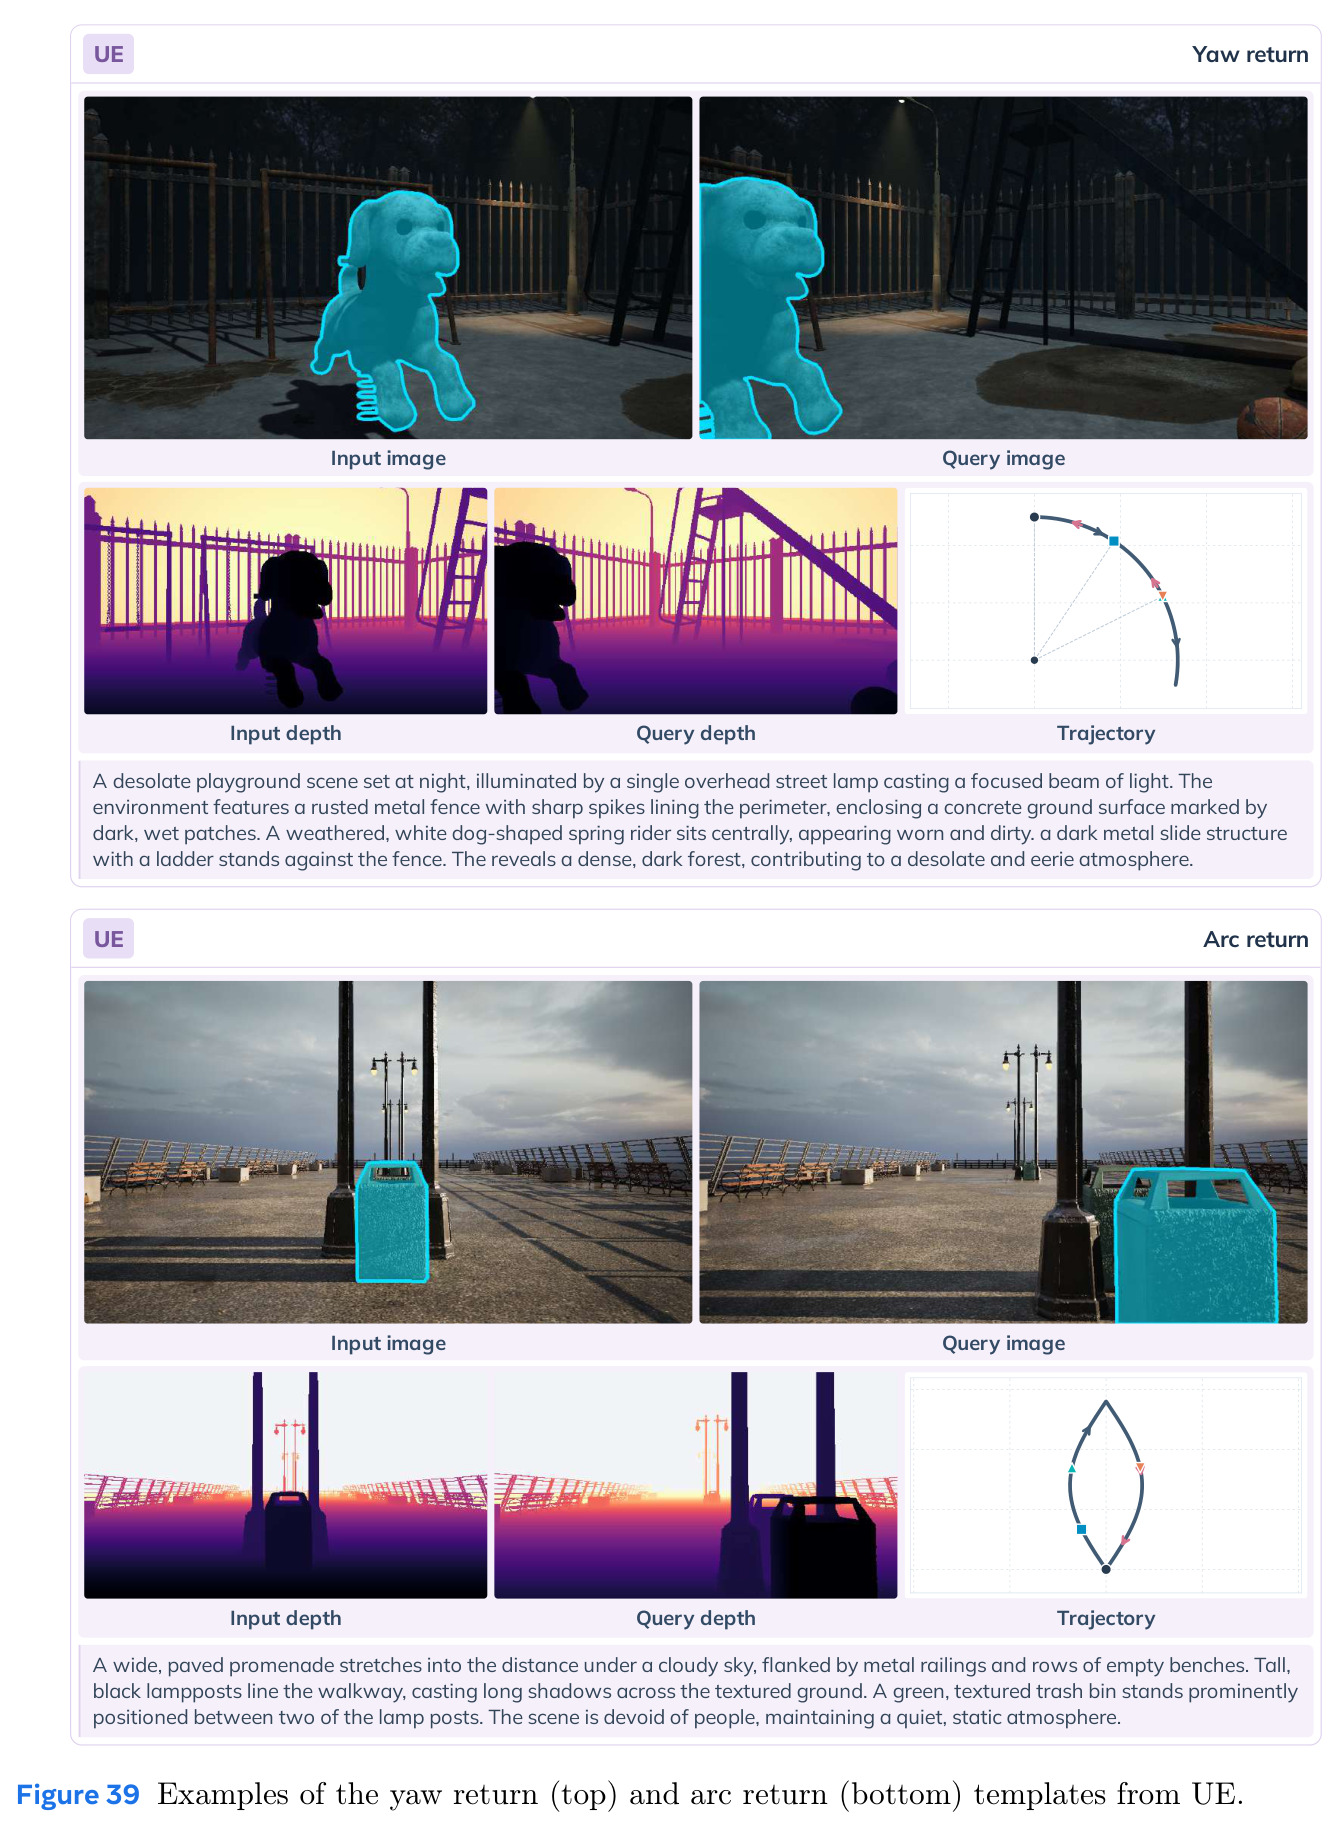
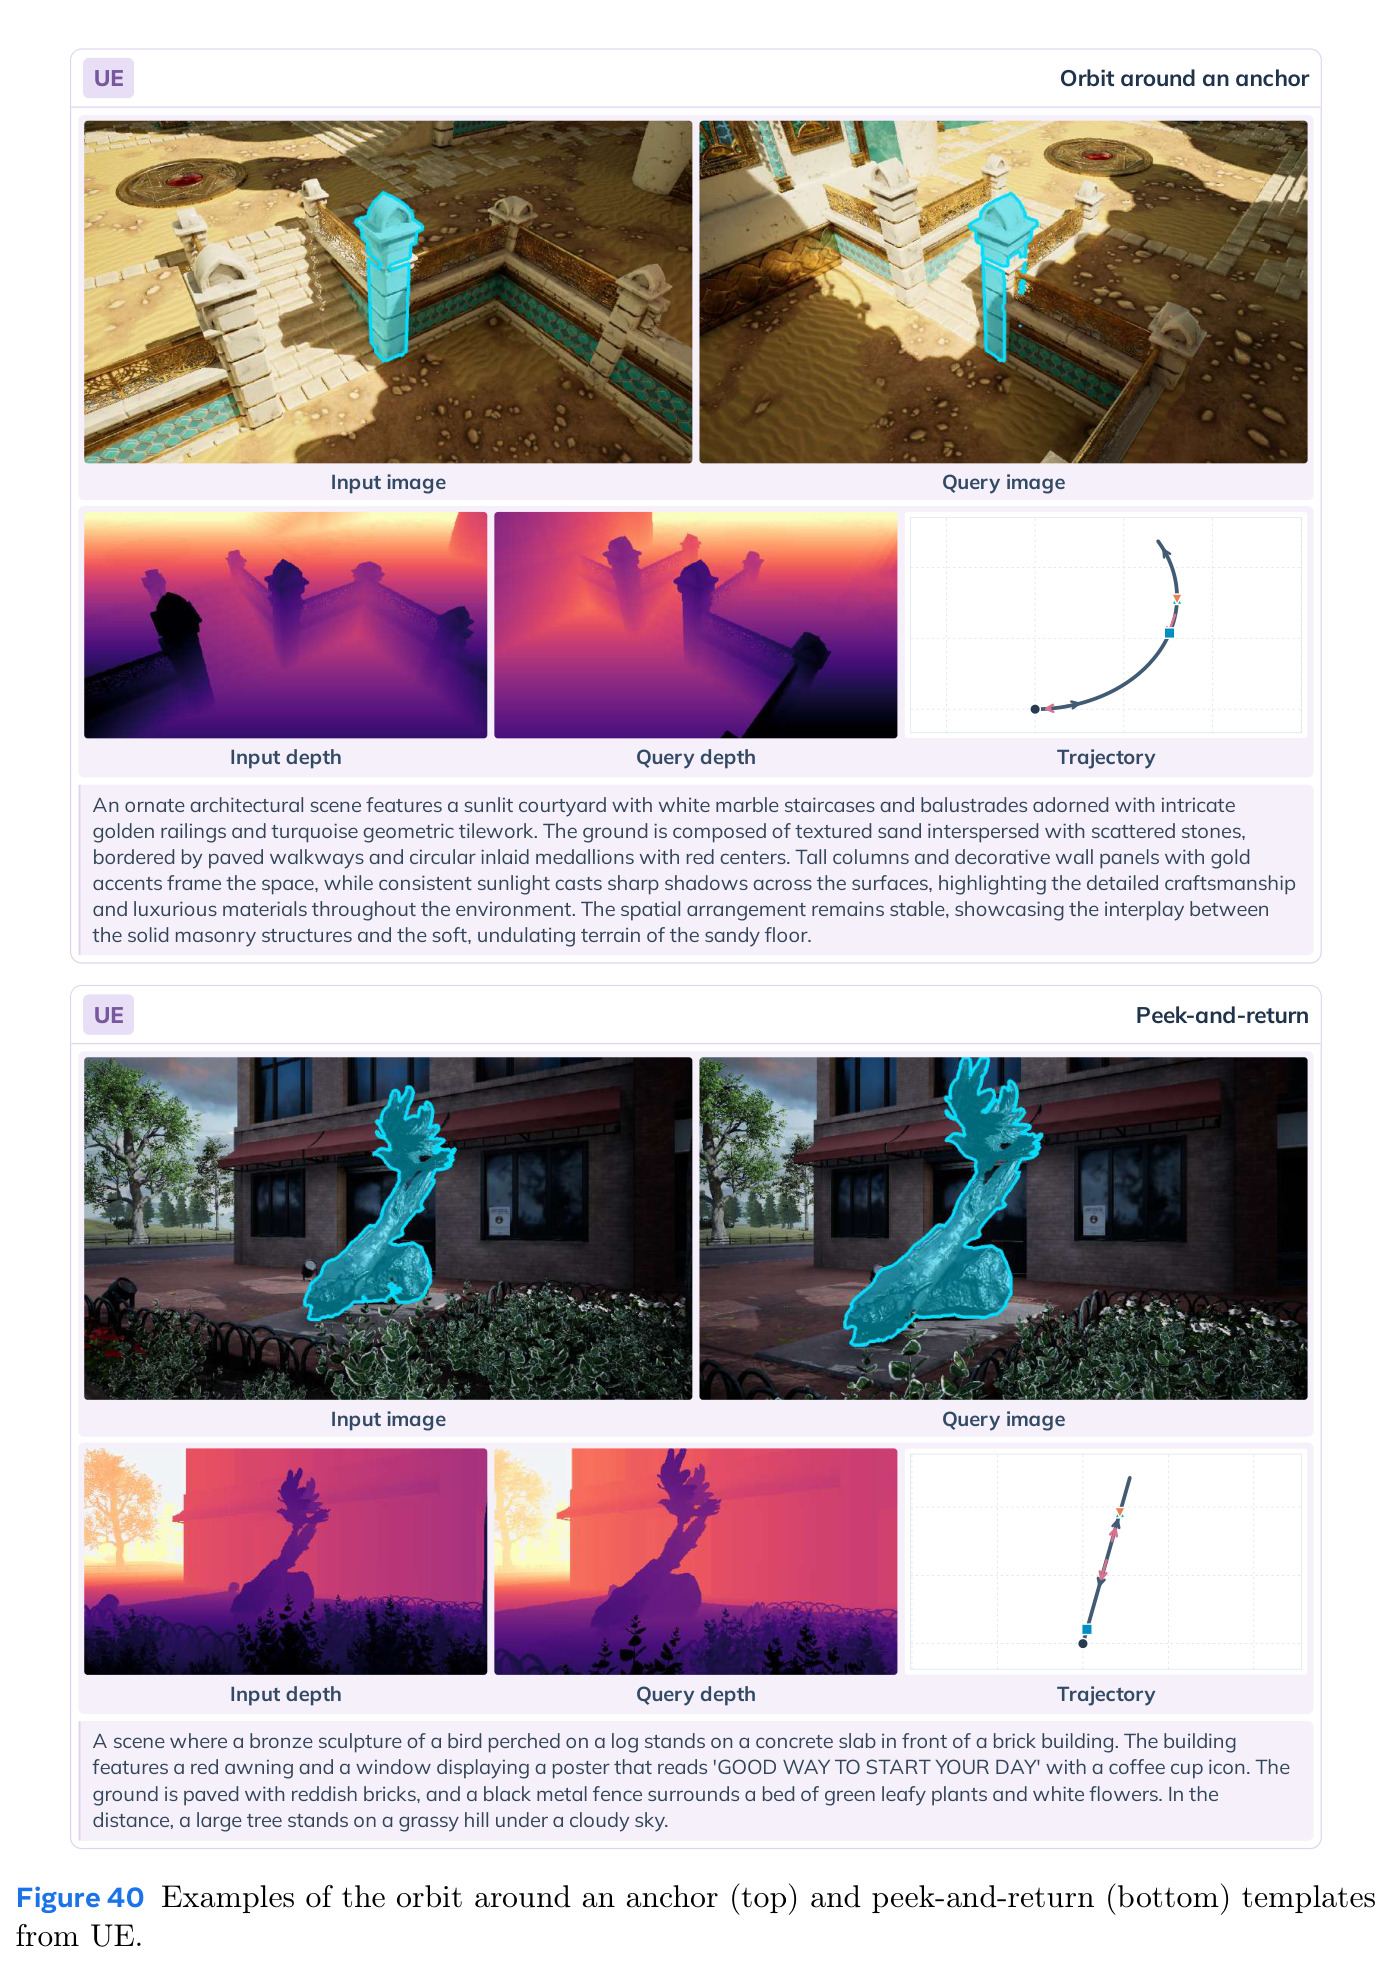
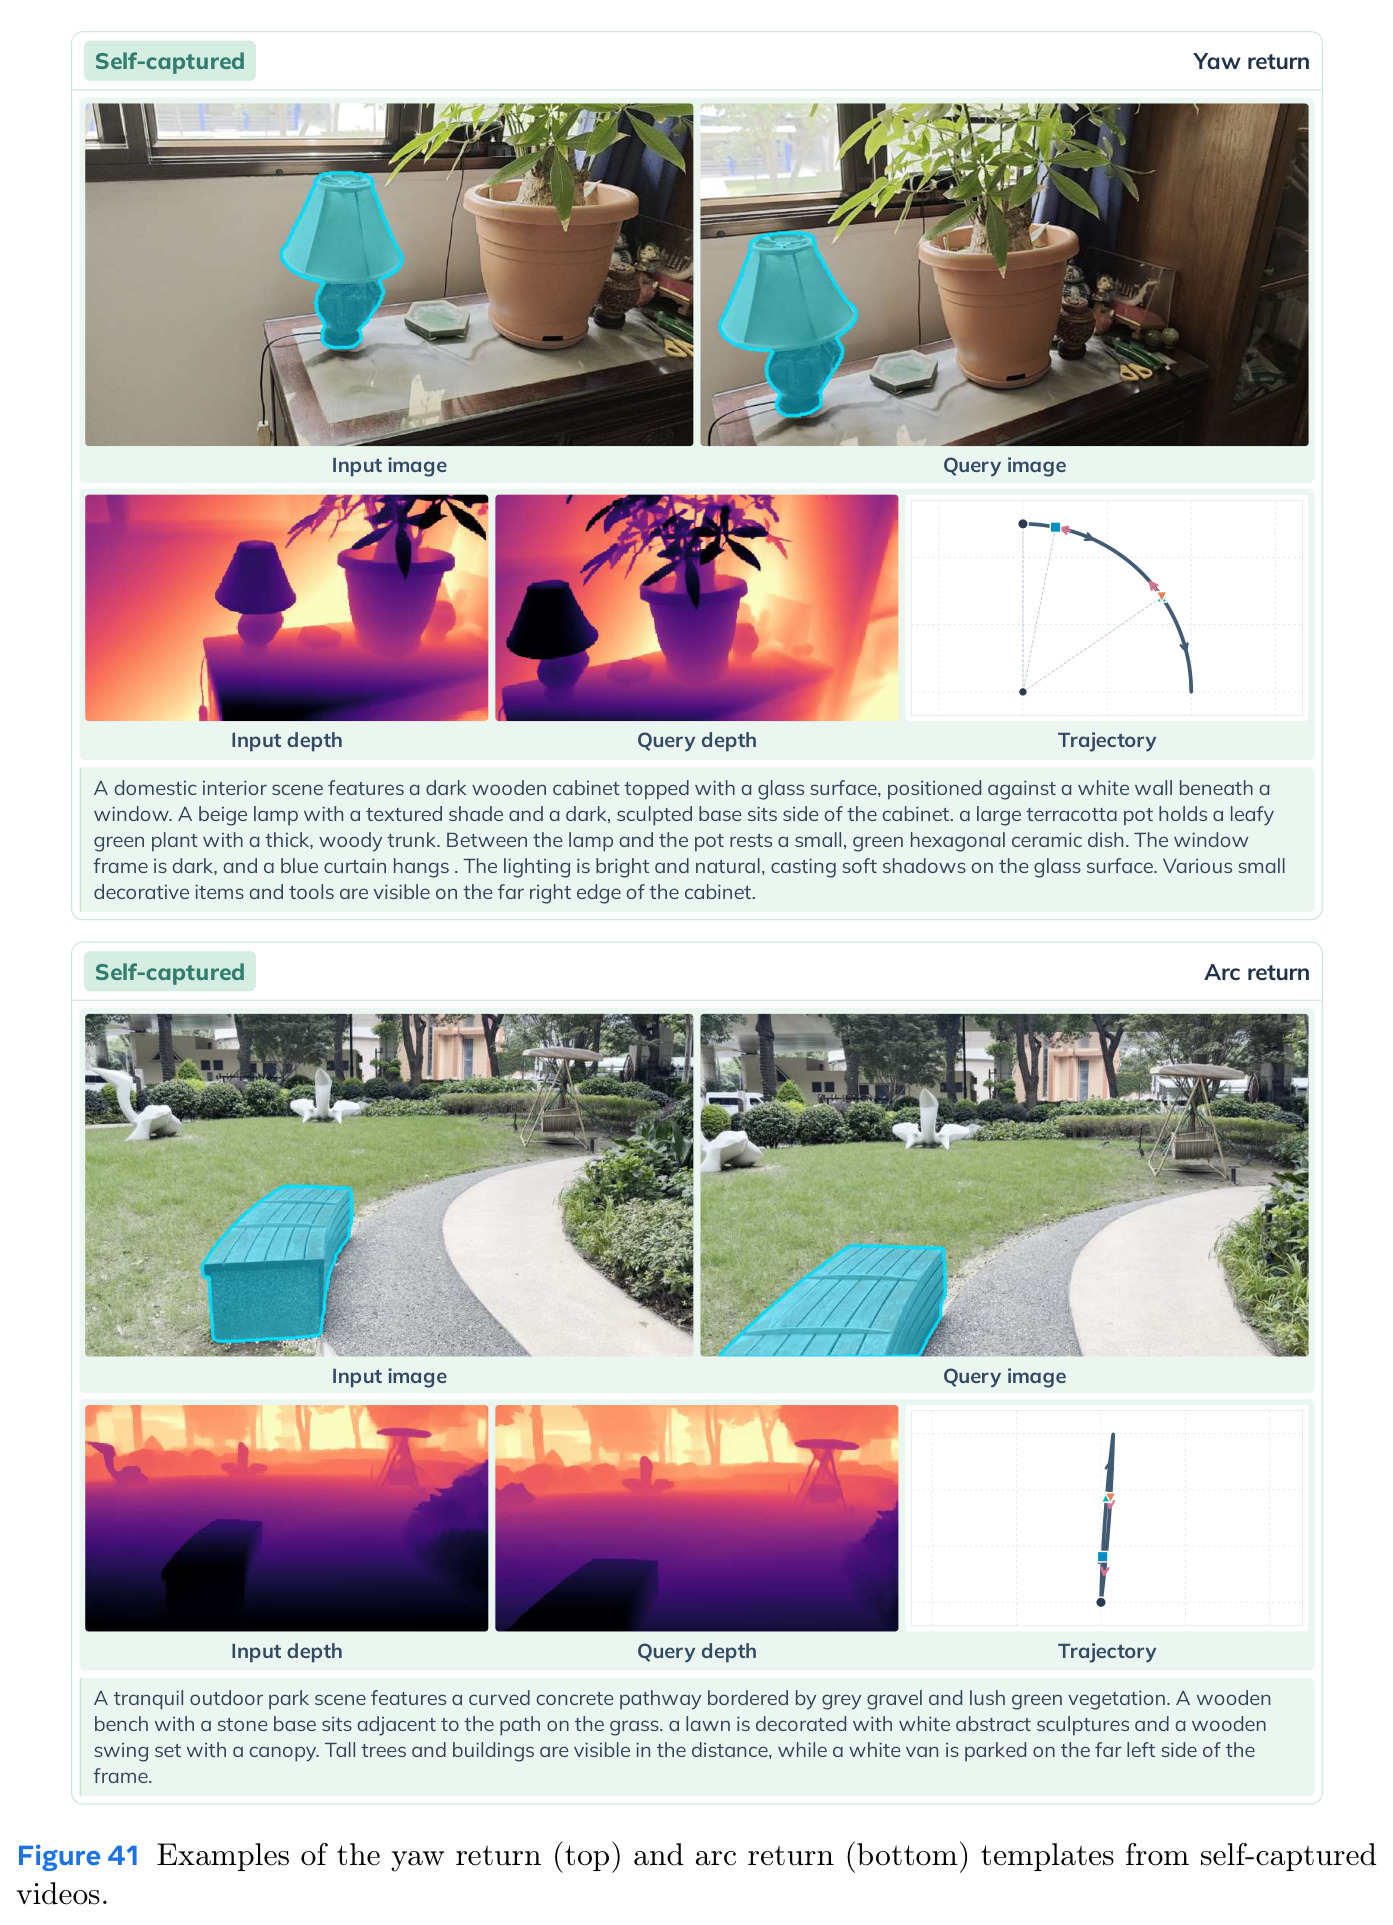
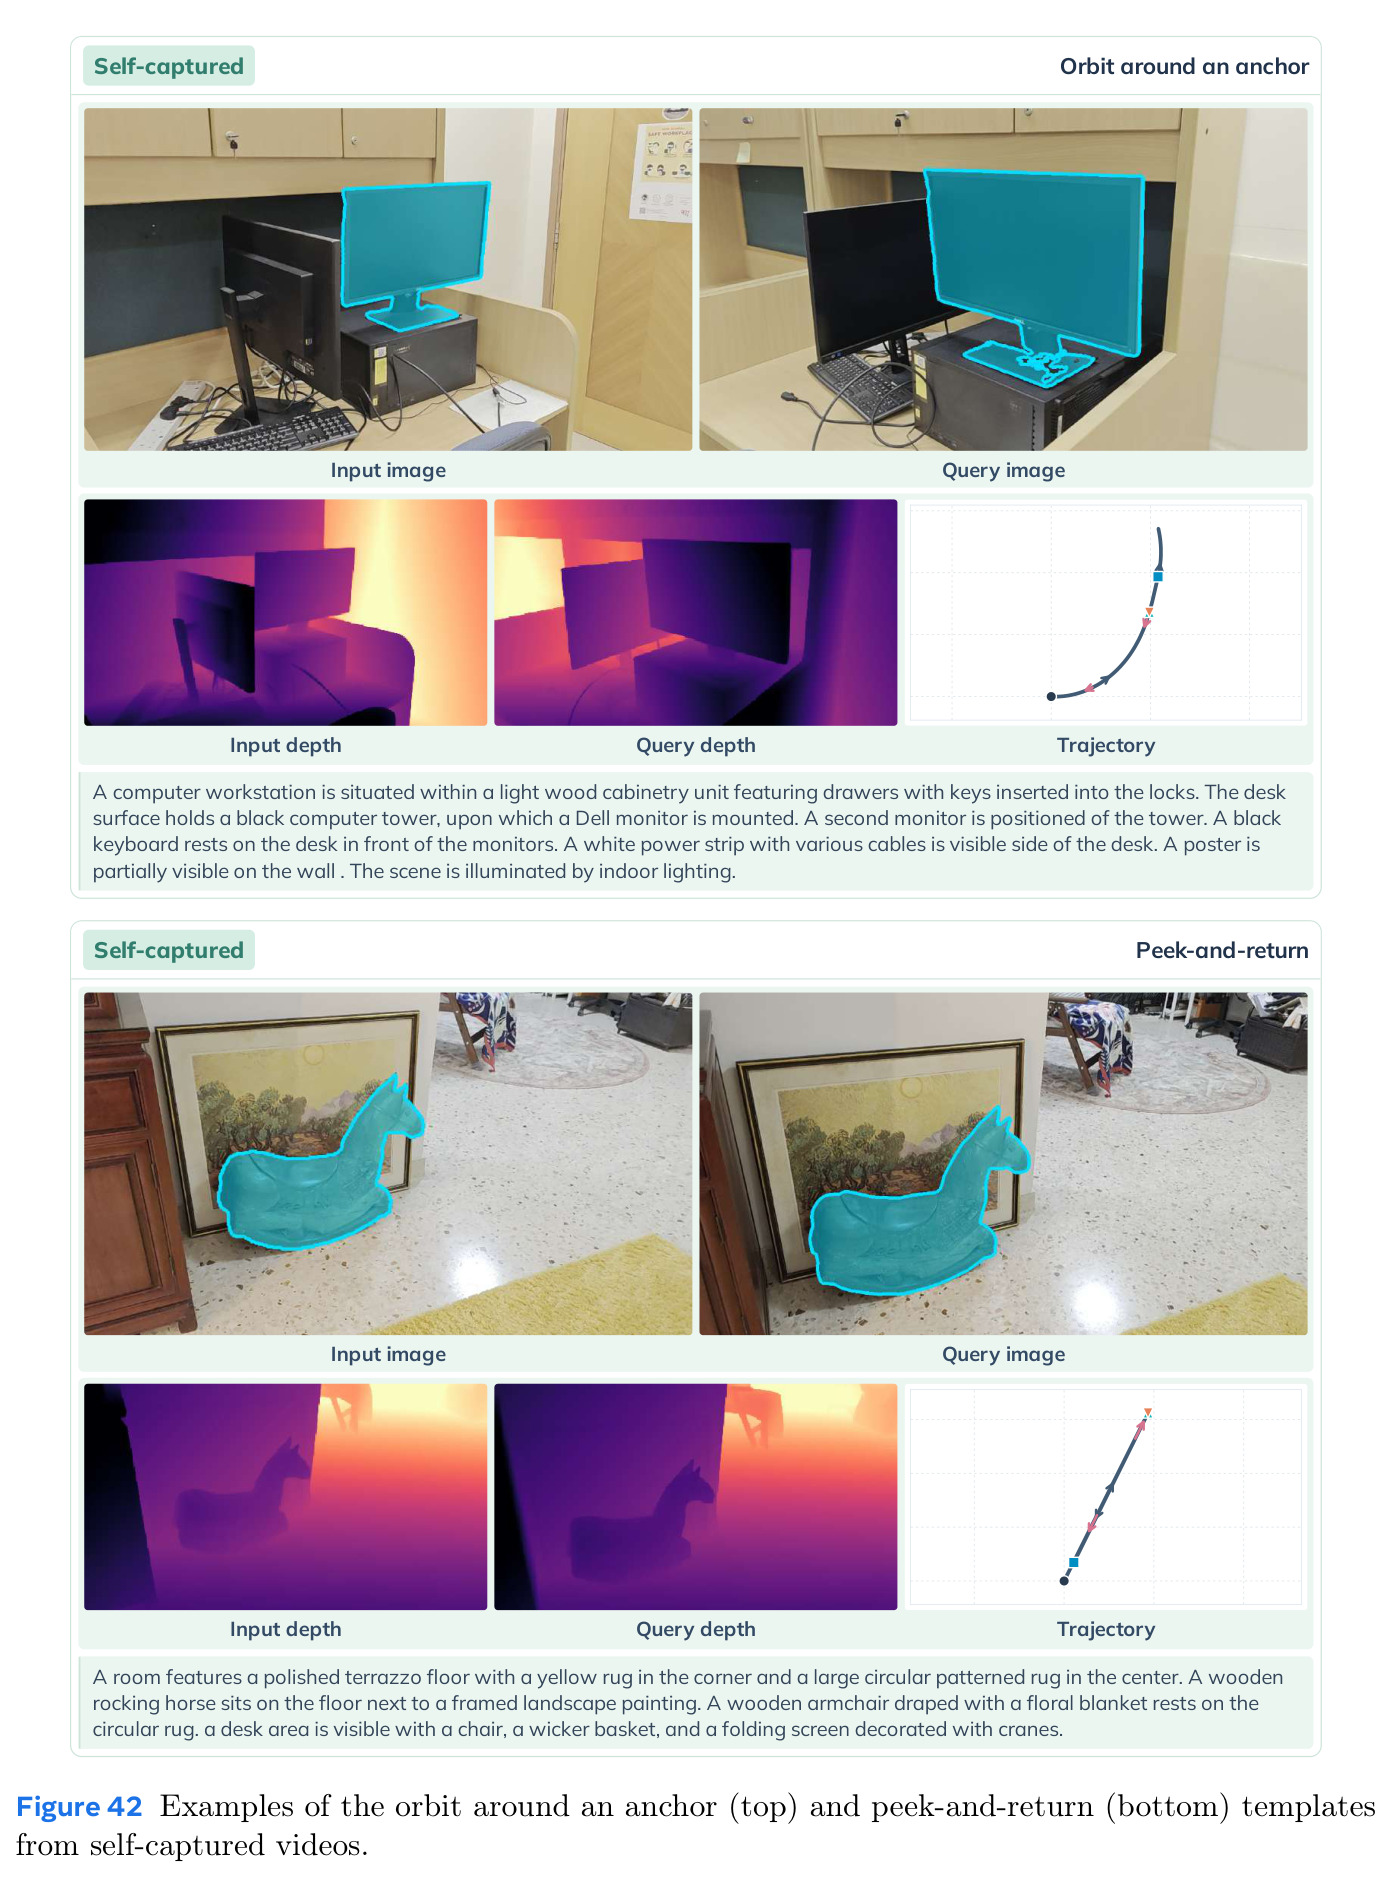
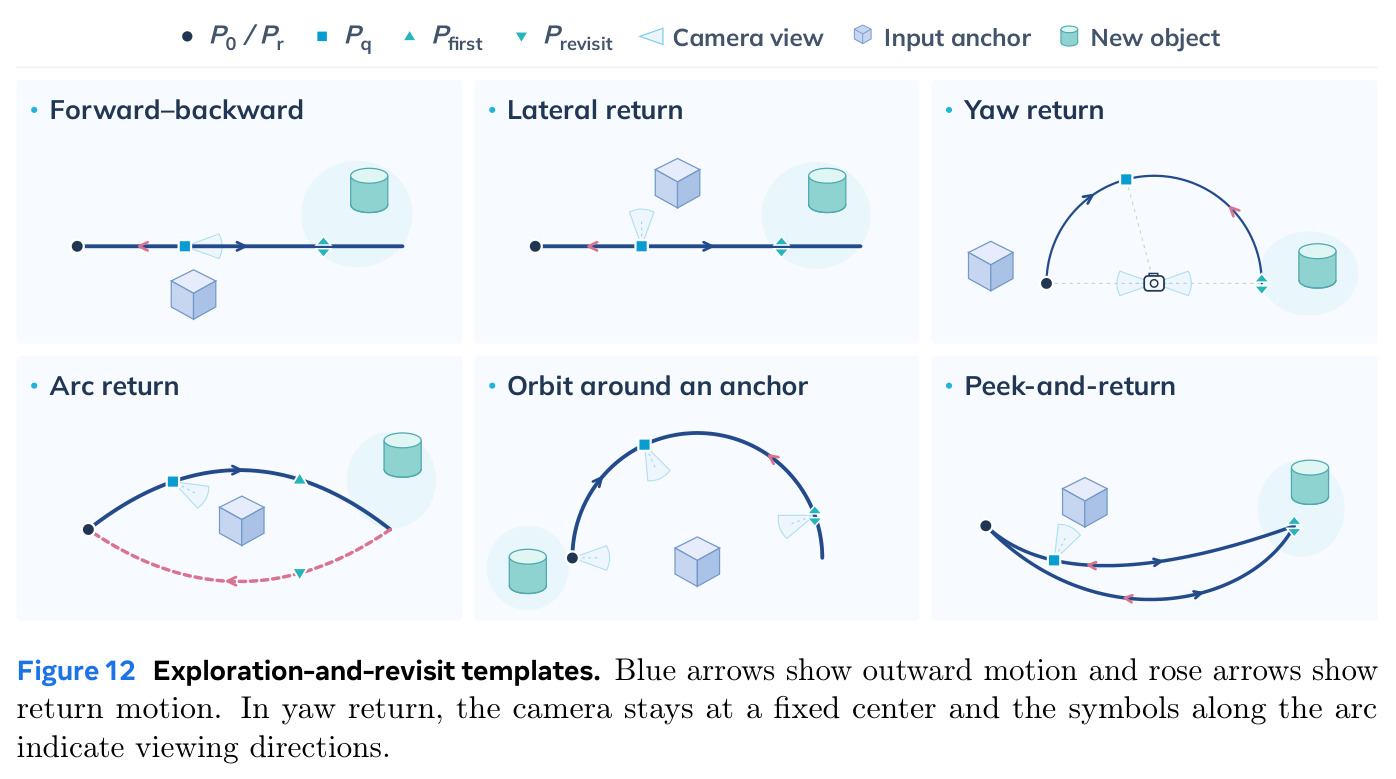
直觉上,Orbia 让模型像玩家一样探索一个场景再折返,追问三件事:走时还在的东西回来还在吗(输入保持)?自己新看到的区域再回去时没变吗(生成内容持久性)?各视角拼起来是不是同一个 3D 场景(3D 自洽)?技术上,每个案例从初始位姿 $P_0$ 出发,途经查询位姿 $P_q$、首访 $P_{\text{first}}$ 与回访 $P_{\text{revisit}}$,最终回到 $P_r=P_0$。评测时用 DA3 从生成视频恢复深度与位姿,在三类检查点分别对照注册 RGB-D 参考、模型自身先前输出与视频内部对应。六个轨迹模板——前进-后退、横移返回、偏航返回、弧线返回、绕锚点环绕、窥视-返回——覆盖不同视差与朝向变化;60 秒扩展把回访从 1 次增至 3 次。评分共六层:控制对齐($T1$)、视觉质量($T2$)、三个一致性维度($T3$–$T5$)与时间稳定性($T6$),总分 $S_{\text{overall}}=0.25S_{T1}+0.25S_{T2}+0.10(S_{T3}+S_{T4}+S_{T5})+0.20S_{T6}$,其中 $S_{T3}=0.30S_{\text{return}}+0.40S_{\text{query}}+0.30S_{\text{identity}}$。
核心创新在于三个维度各自采用不同的'参考基准',从而把不同性质的要求分开检验。输入保持用真实世界的注册 RGB-D 作参考,并把显著性静态物体标注为锚点逐个计分——一个被弄丢或变形的地标在整帧平均中几乎不可见(锚点中位仅占画面 5.2%),逐锚点评分使这类最显眼的失败直接可测;深度对齐使用共享场景级尺度,保留物体与周围环境的相对尺度差异。生成内容持久性承认新区域没有真值:模型可以自由创作,唯一必须成立的是'回访时看到的是自己当初生成的东西',于是以首次生成观察作参考,并通过把首访深度按恢复相机投影到回访视角来对齐同一表面,使回访位姿不同也能比较。3D 自洽完全不看请求轨迹:模型可能沿错误路径生成彼此一致的视图,因此控制对齐与自洽分别计分;区域尺度一致性与留出高斯渲染进一步检验'一个场景能否解释所有视图'。相比用 VLM 判记忆或仅做同视角比较的已有做法,这套证据链更几何化、更可诊断。
方法步骤详情
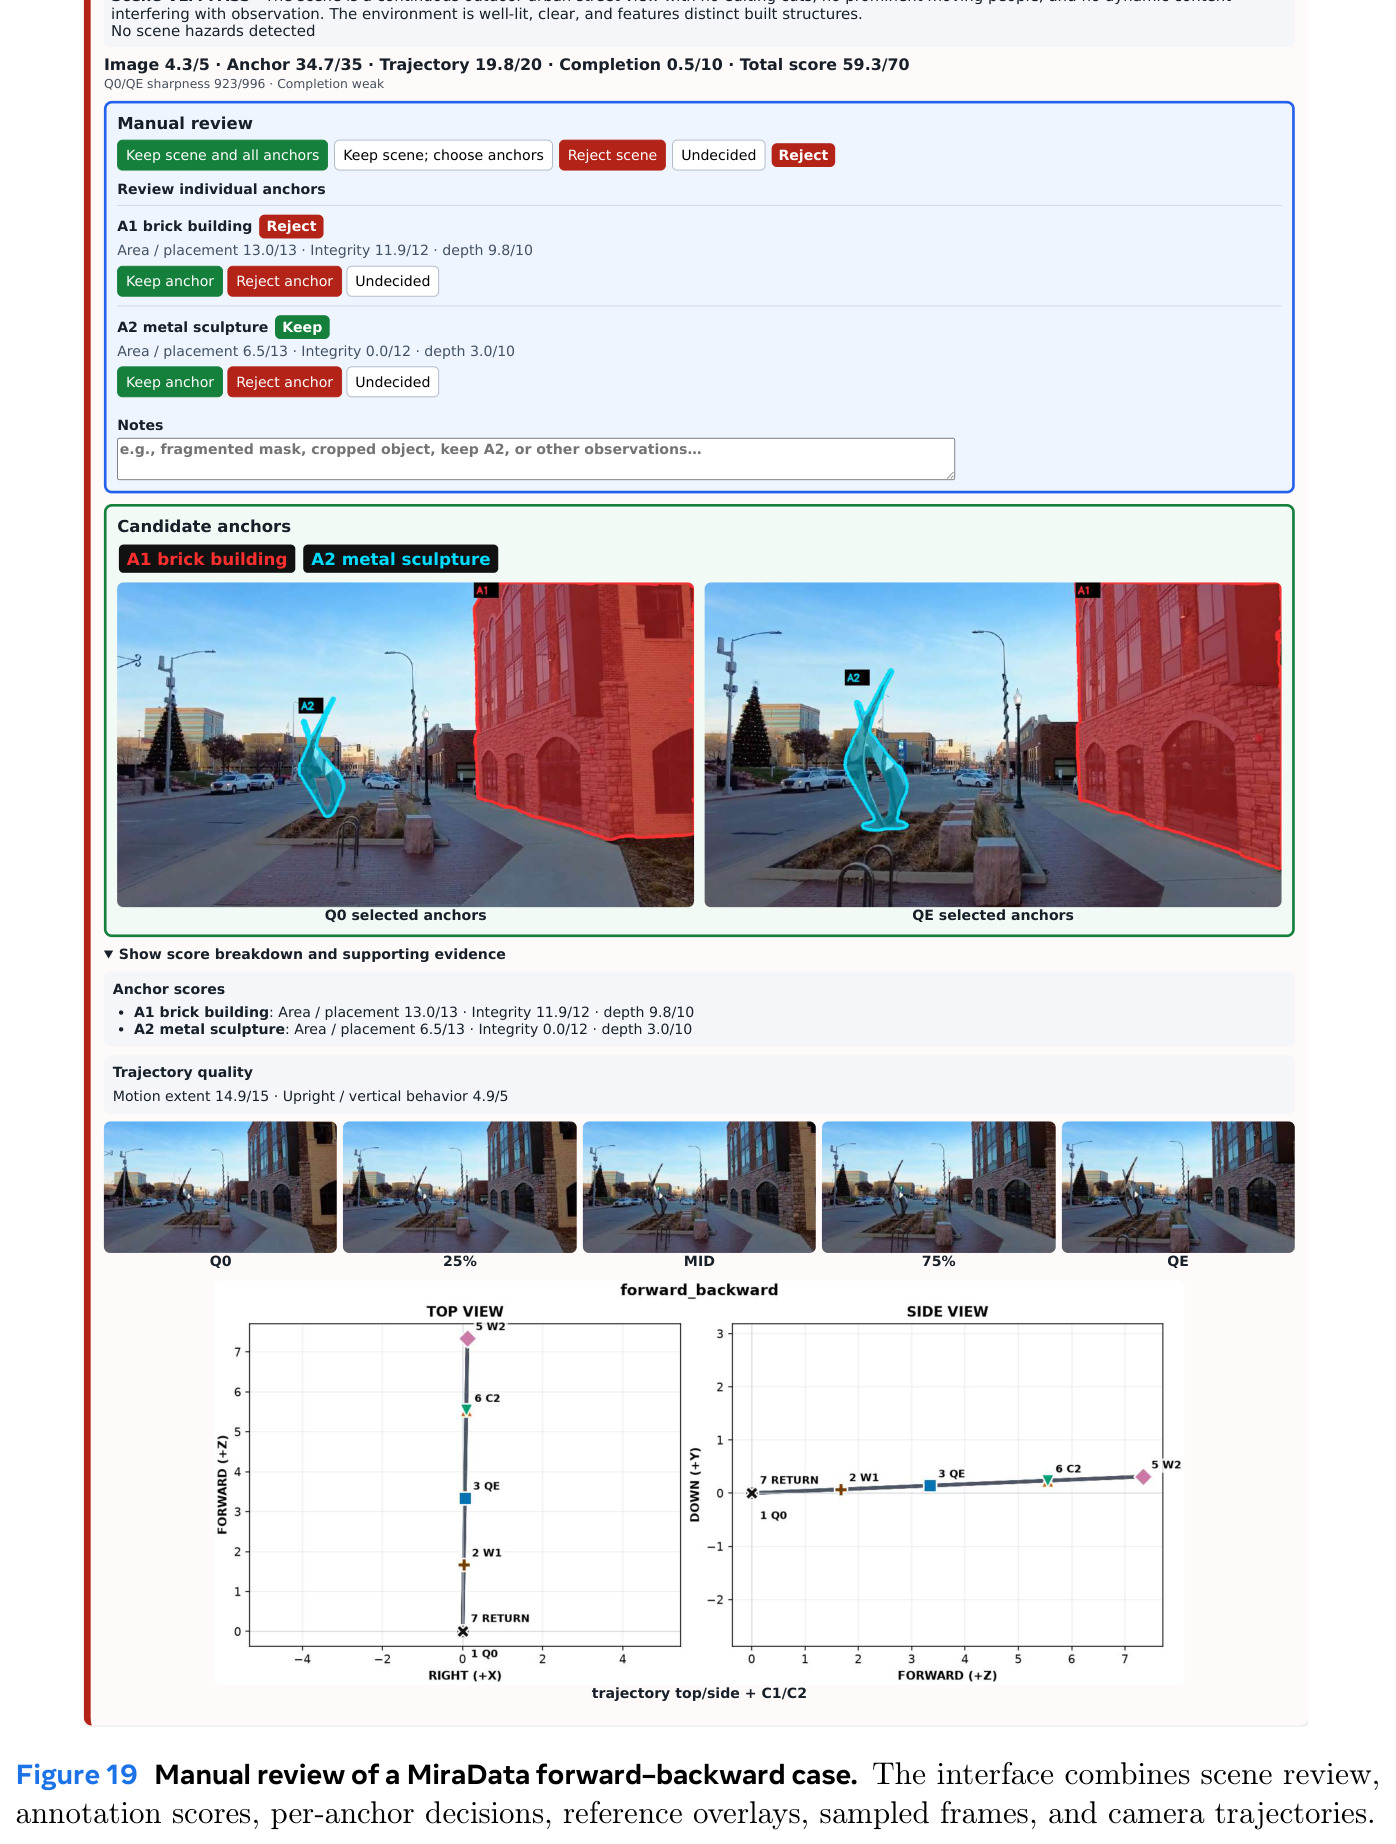
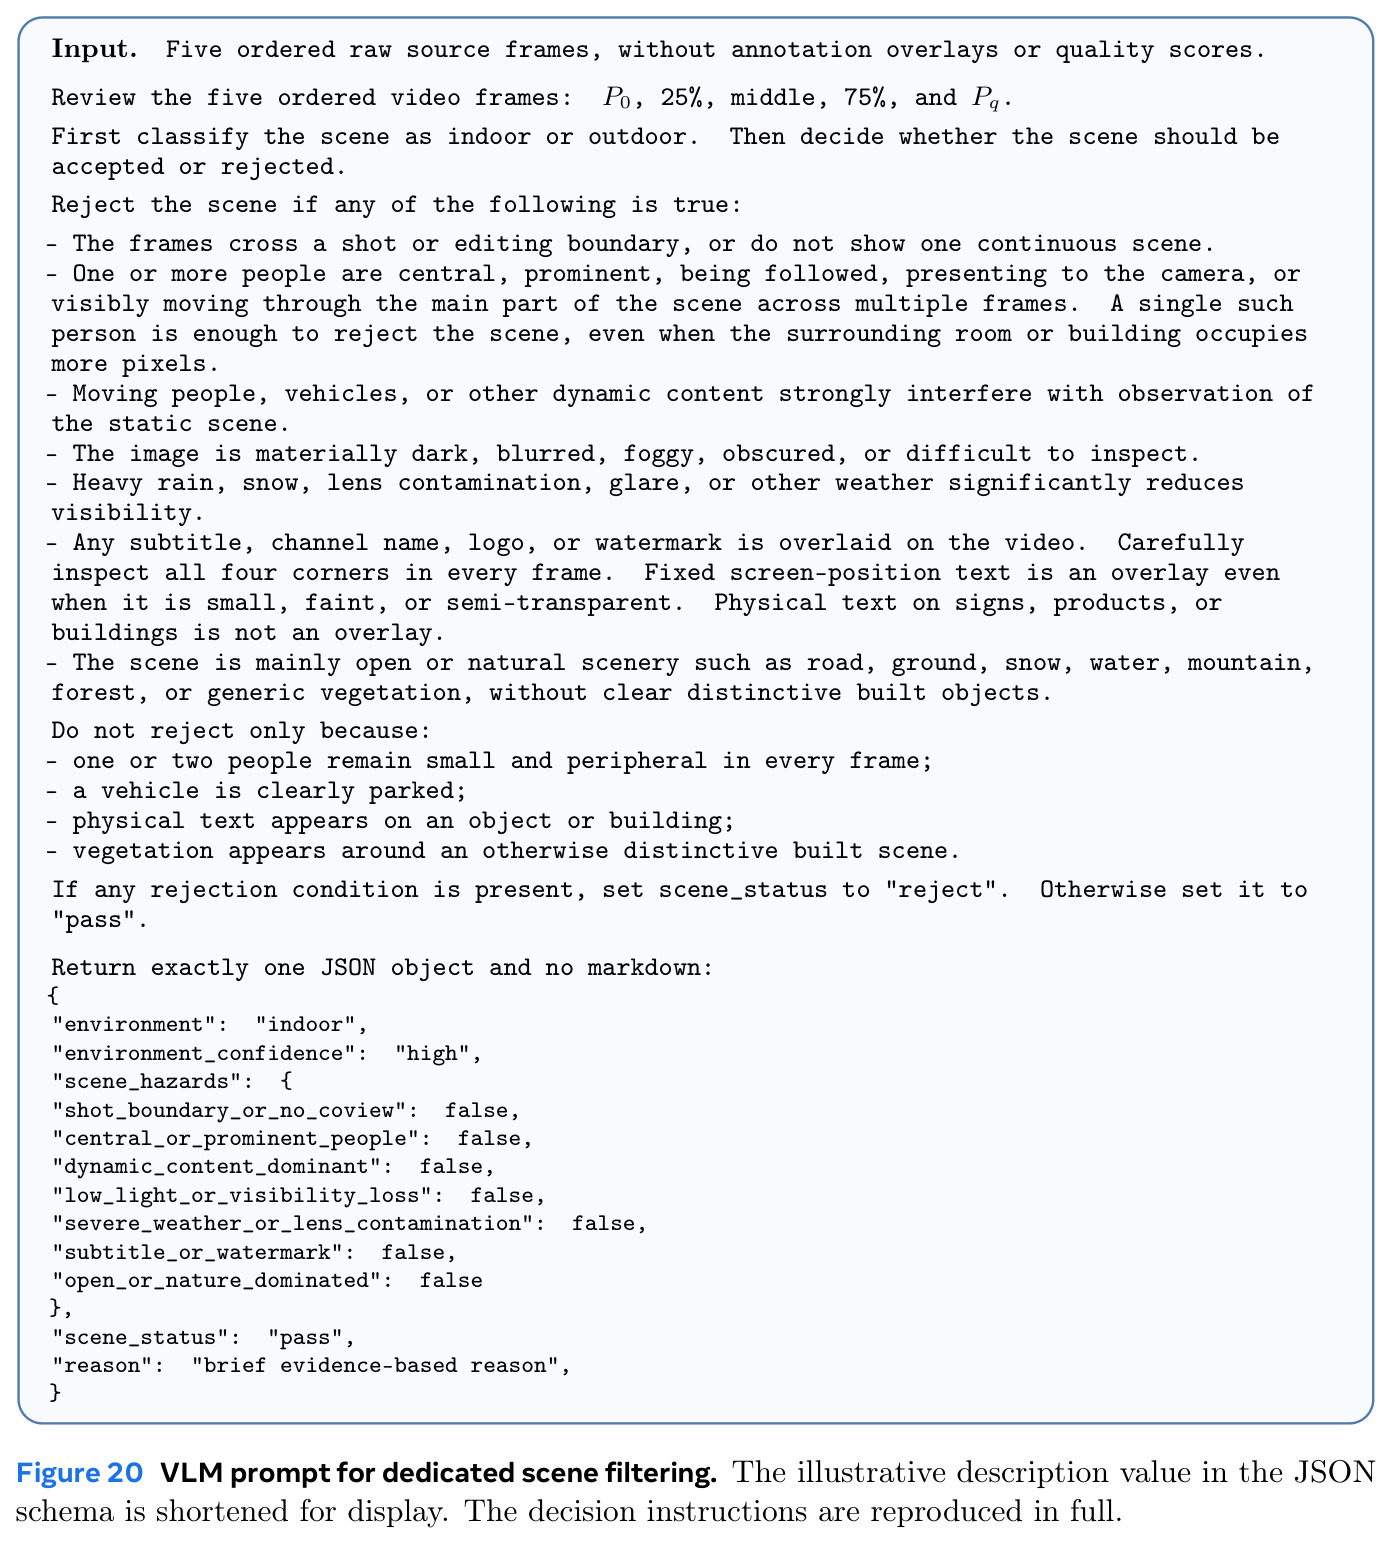
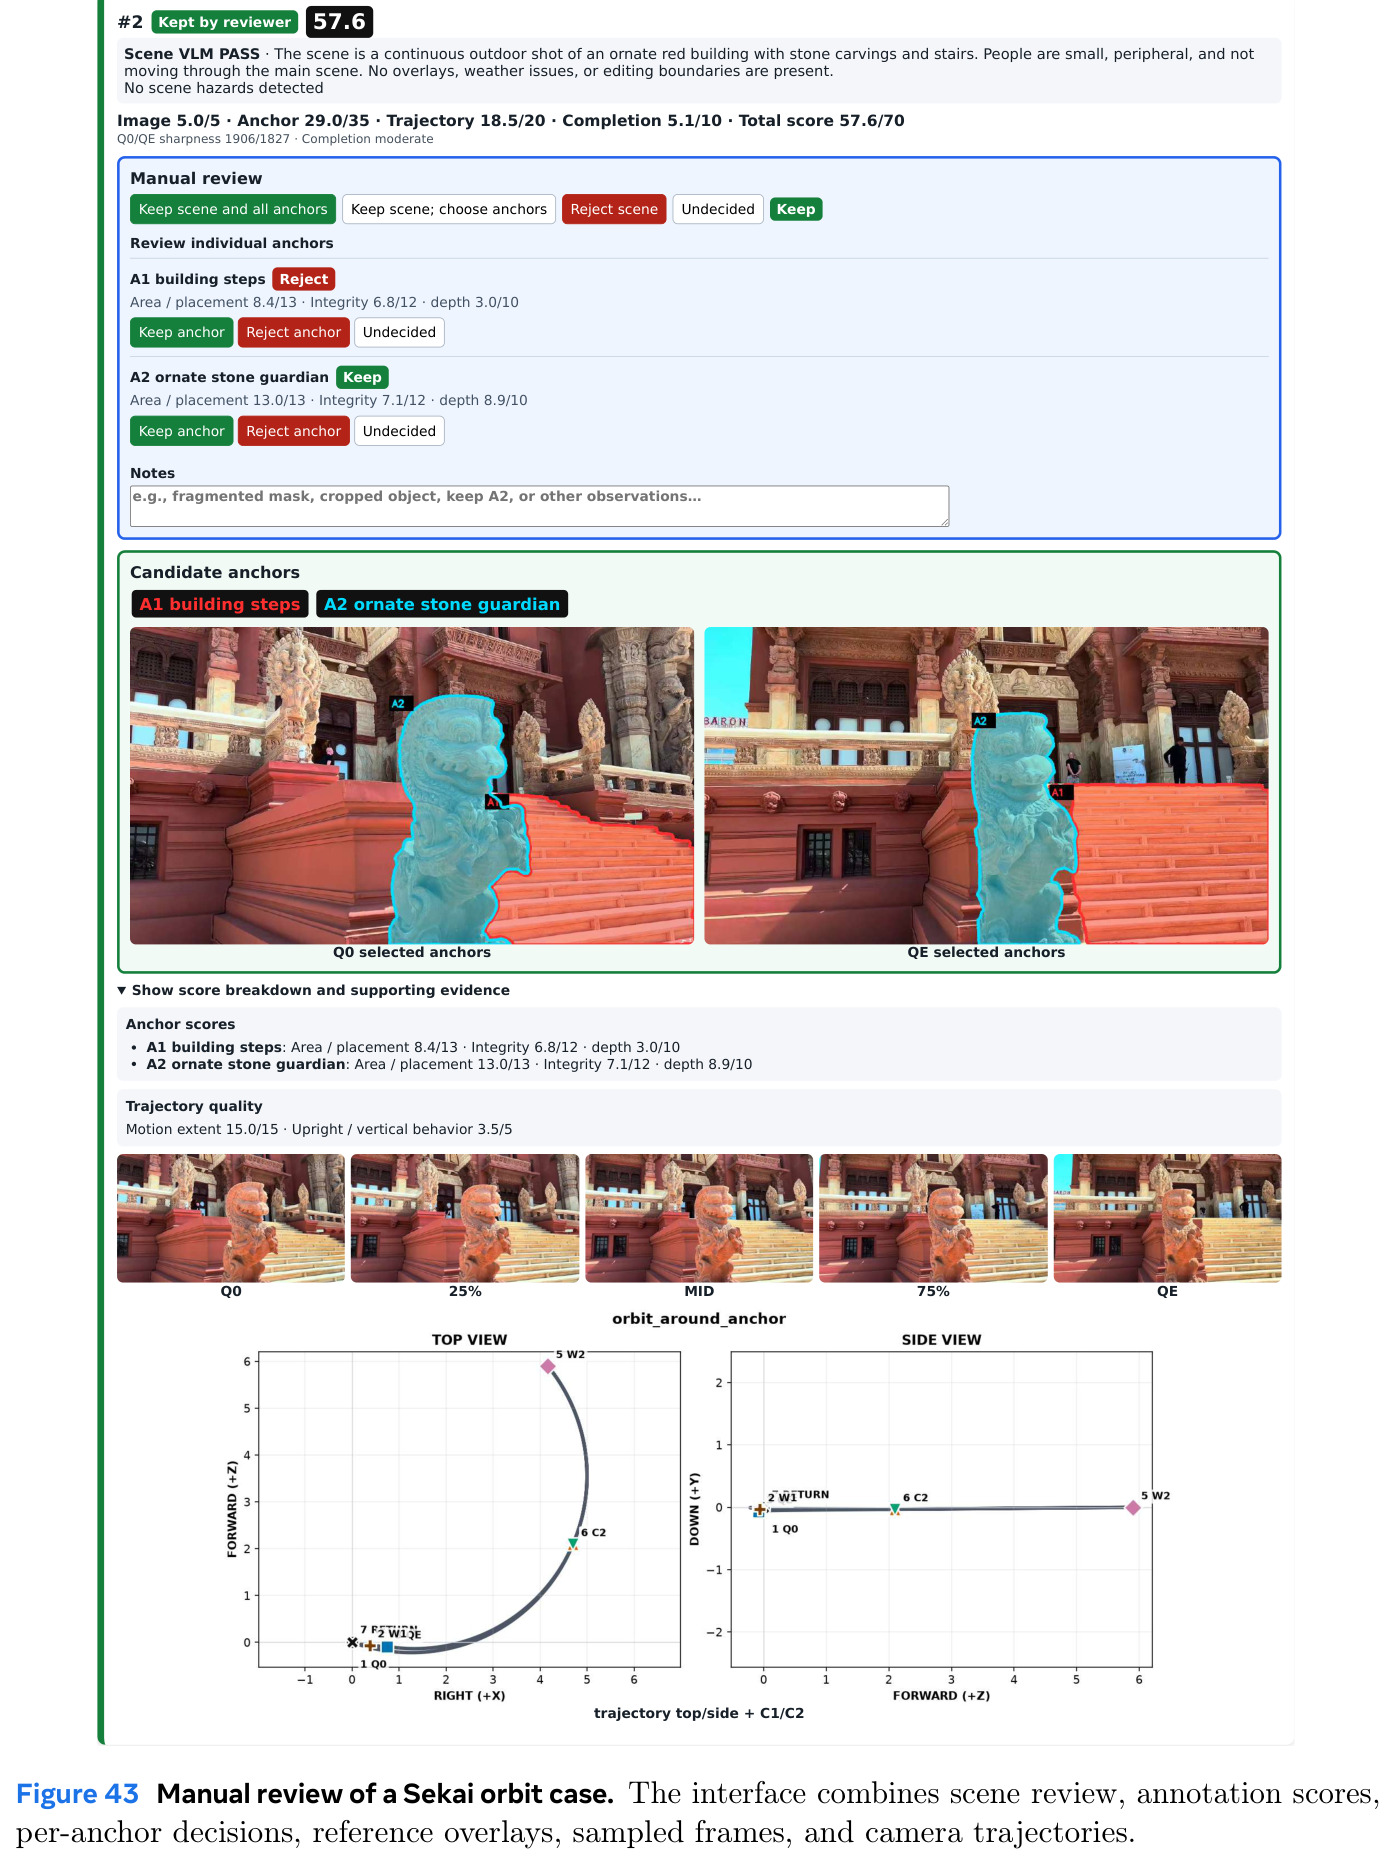
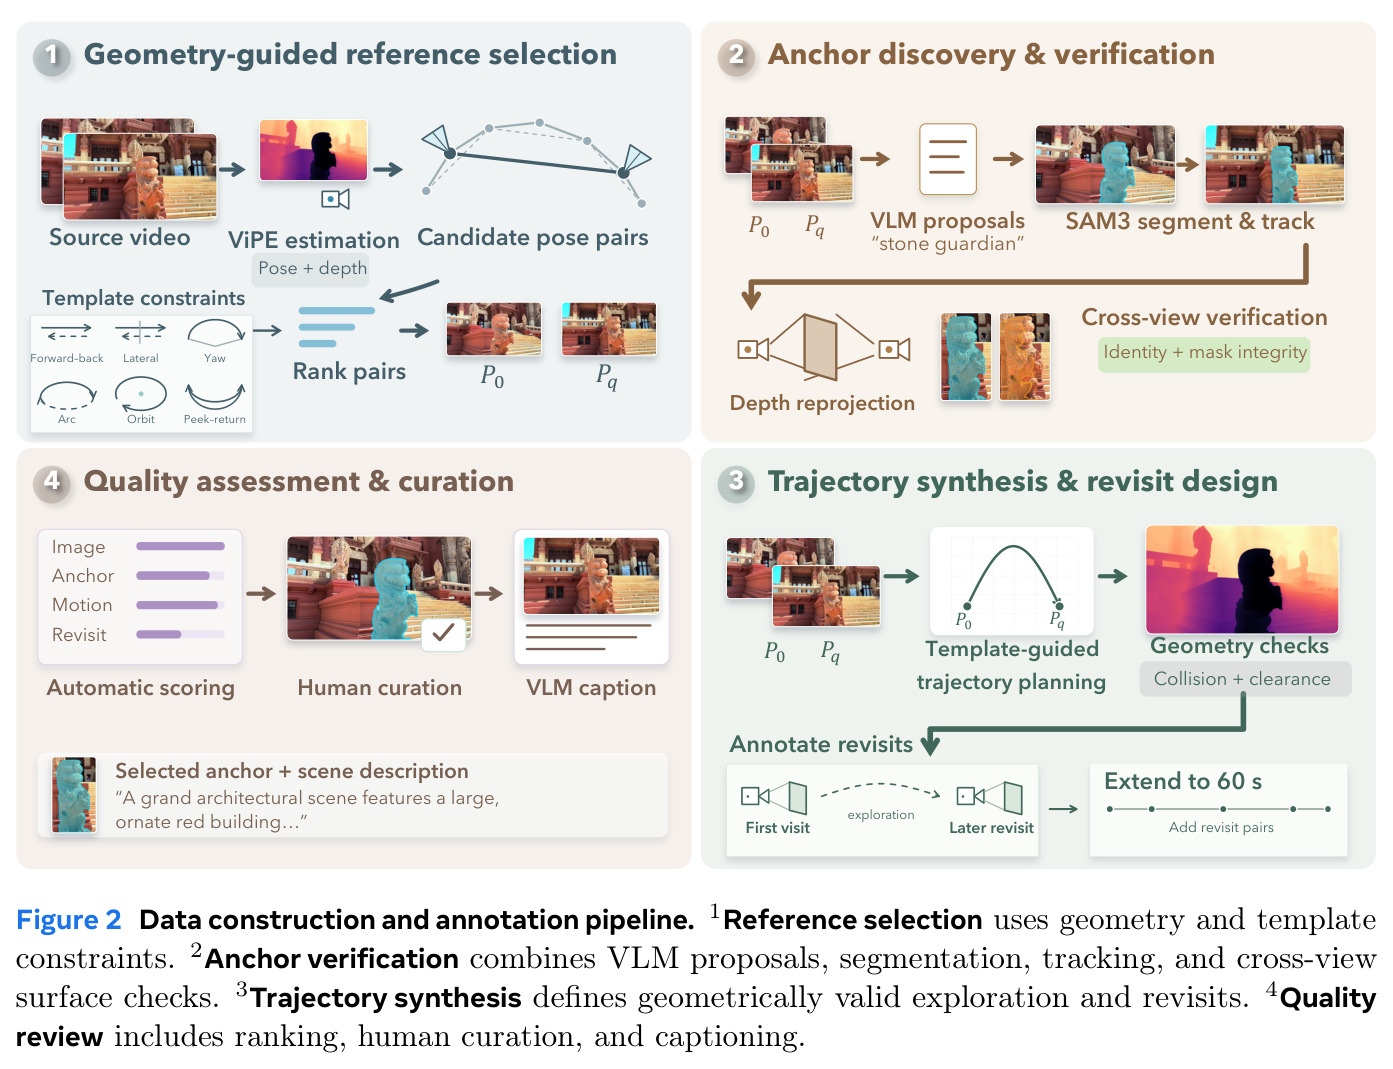
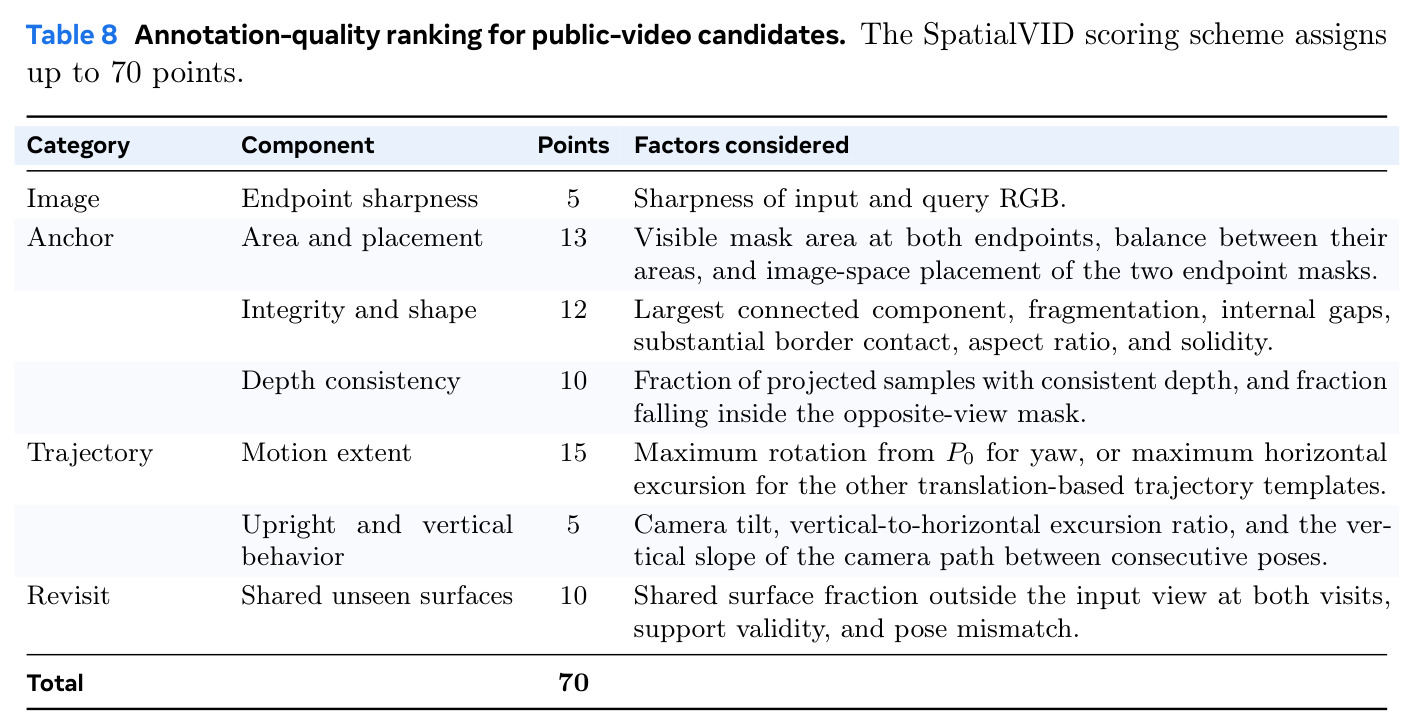
数据构建分四阶段:(1) 几何引导的参考选择——用 ViPE 补全缺失位姿与深度,按模板旋转/平移约束筛选并排序输入-查询对 $(P_0,P_q)$;(2) 锚点发现与验证——VLM 提议有界静态地标,SAM3 在两端点独立分割并按面积、连通性、完整性过滤,跟踪验证跨视角同一性,深度反投影检验查询视角的可见性与深度一致;(3) 轨迹合成与回访设计——拟合模板参数生成经过 $P_0,P_q$ 并回到 $P_0$ 的轨迹,做碰撞与间隙检查,按位姿邻近性、相对输入的新颖性与共享可见表面挑选回访对 $(P_{\text{first}},P_{\text{revisit}})$,分钟级版本保留原输入并增加 2 次回访;(4) 质量评估与人工整理——按清晰度、锚点可见性、掩码完整性等自动排序,人工审核修正或剔除,VLM 生成事实性场景描述。处理约 11 万源样本、投入 300+ 小时得 720 案例。评测流水线:DA3 Giant 1.1 恢复位姿/内参/深度(240 帧内联合处理,更长用 120 帧流式块 + 30 帧重叠 + SALAD 回环闭合),64 上下文帧前馈预测高斯场景、gsplat 渲染 16 个留出视角,DINOv2 提取特征,SAM3.1 跟踪锚点身份,最后按各层公式归一化并加权聚合。
技术新颖性
技术新颖性体现在度量设计而非新模型。其一,回访比较通过投影对齐升级了记忆测试:把首访深度按恢复相机重投影到回访视角,只比较共同可见表面,使回访位姿不同也可几何对齐,比同视角外观比较或全局 VLM 判断更严格。其二,表面一致性用双向最近点 $F_\tau=\frac{2p_\tau r_\tau}{p_\tau+r_\tau}$,阈值 $\tau=\max(0.02,\,0.05d_{\text{med}})$ 随场景中位深度自适应。其三,区域尺度一致性把图像分 4$\times$4 网格统计深度比 $\rho_j$ 的对数离散度,能捕捉'前景家具与背景墙需要不同相对尺度'这类全局对齐掩盖的失配。其四,留出渲染测试一个高斯场景能否解释上下文之外的 16 个视图,捕捉沿轨迹累积的不一致,而浅层帧对比较测不到。其五,适配器体系把 27 个接口各异的模型放到同一轨迹上,控制对齐用位姿误差与离散动作精确率分别度量,跨视图对应按 8 帧与 32 帧两种时间间隔分组,兼顾局部稳定性与较大视角变化。
实验结果
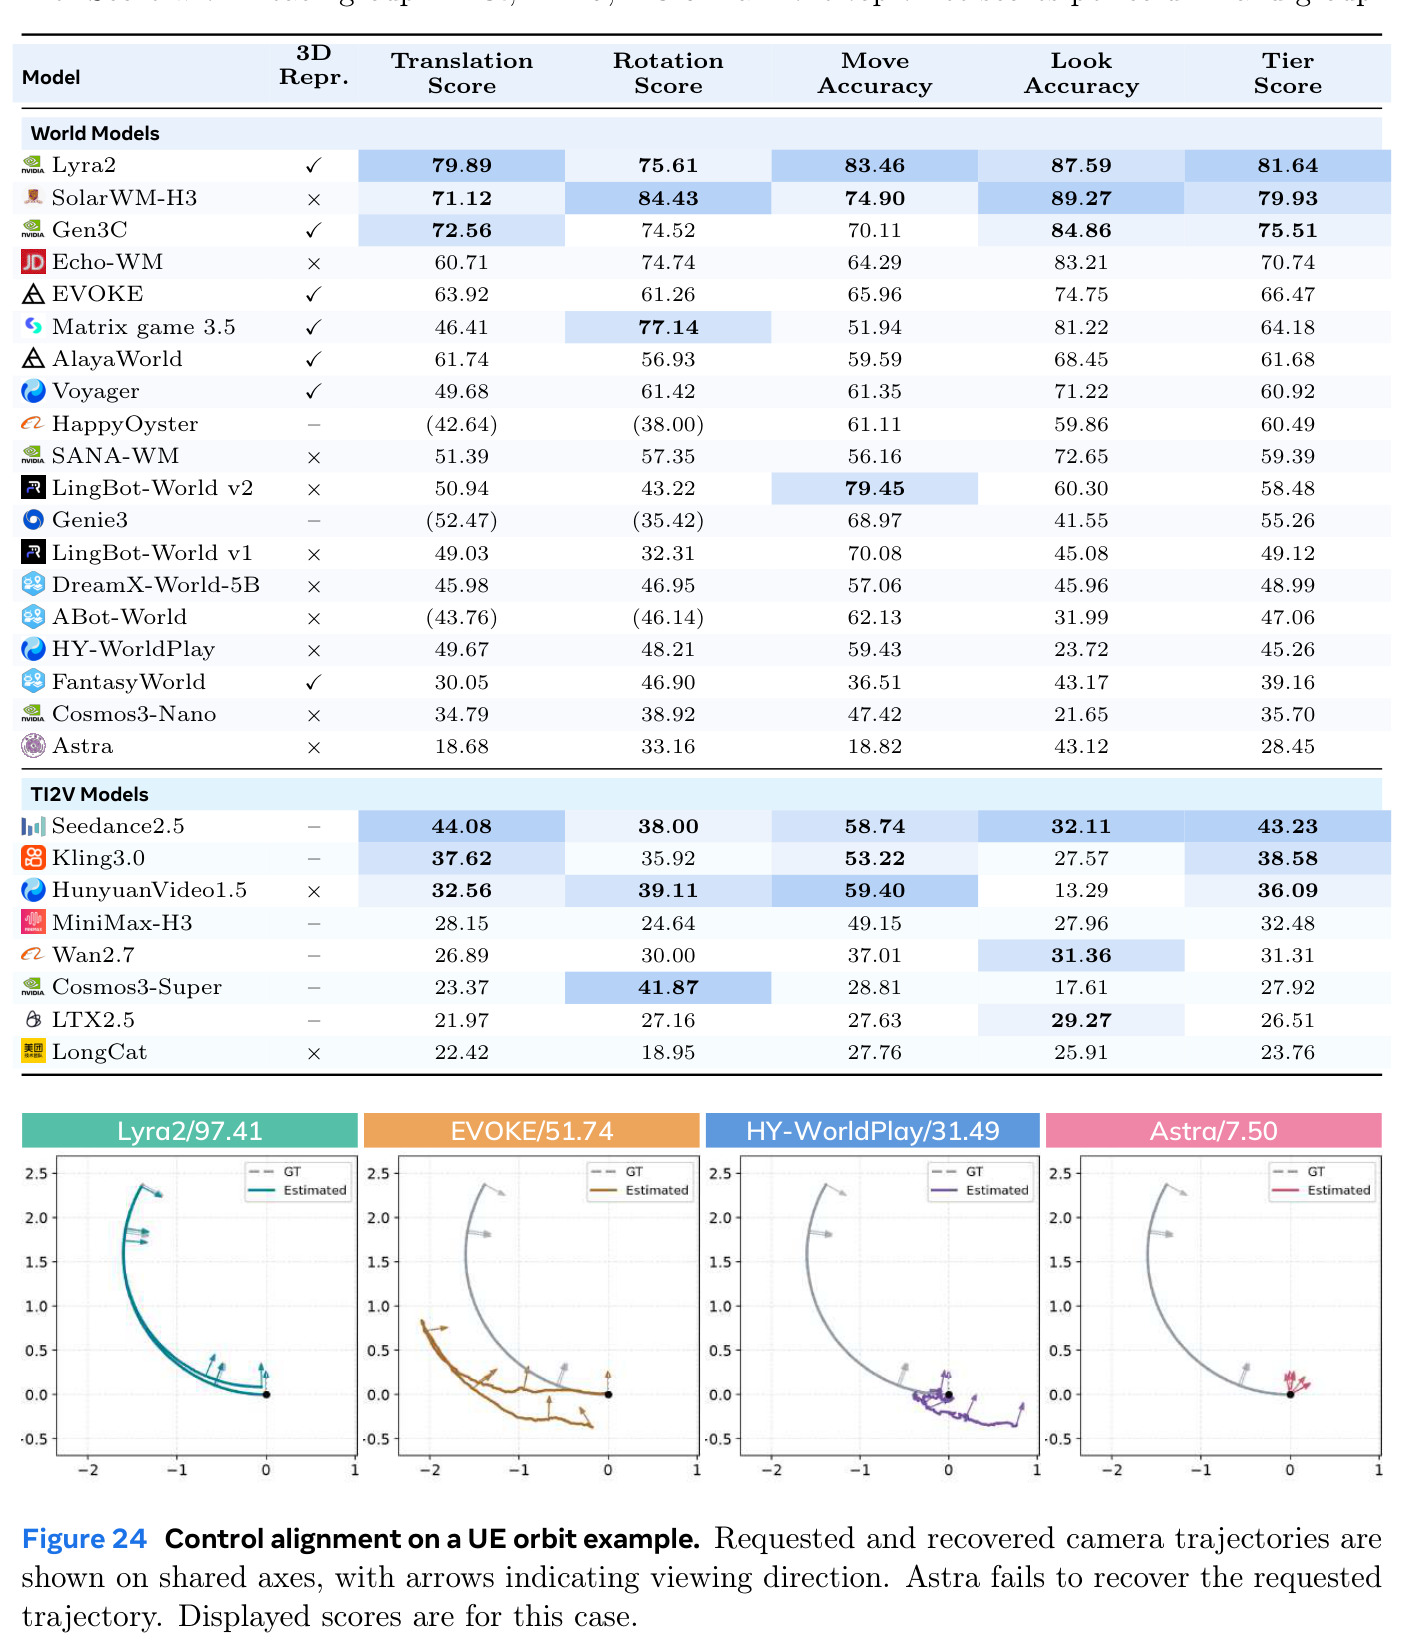
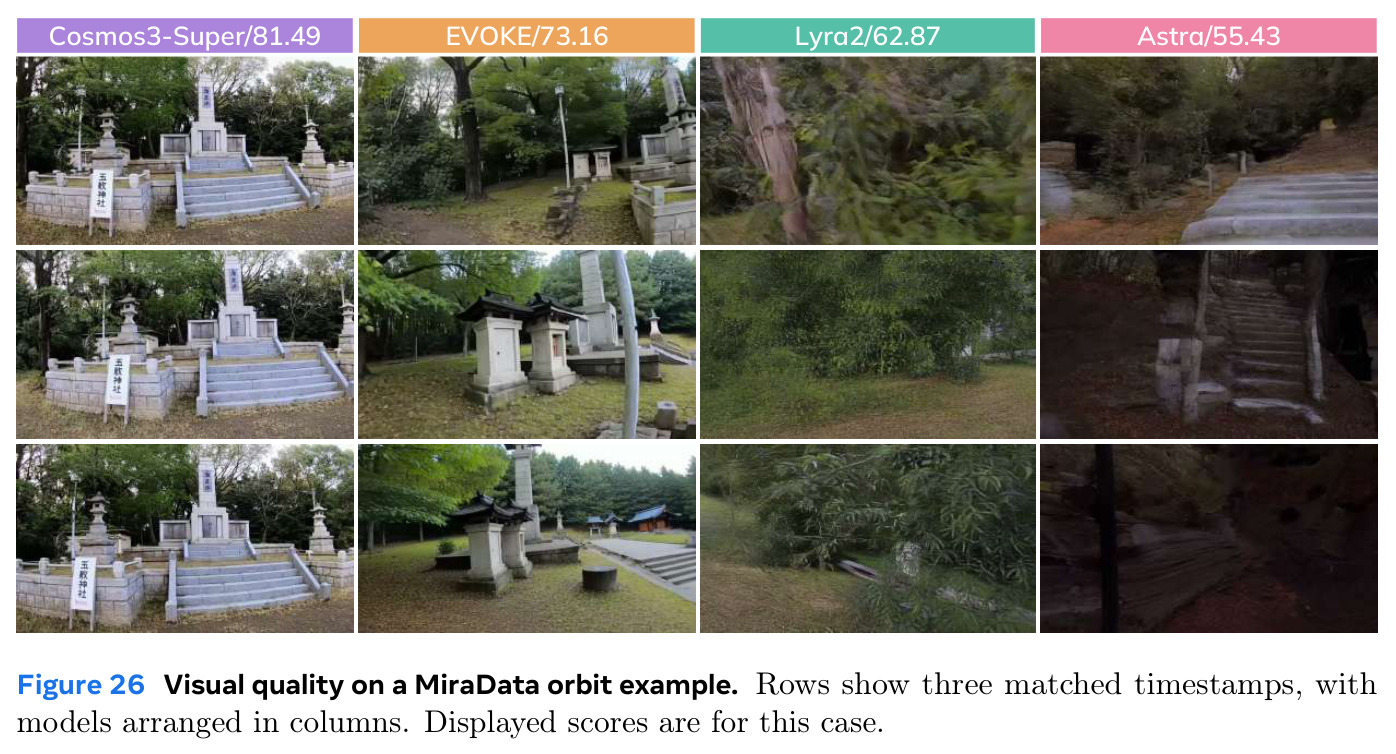
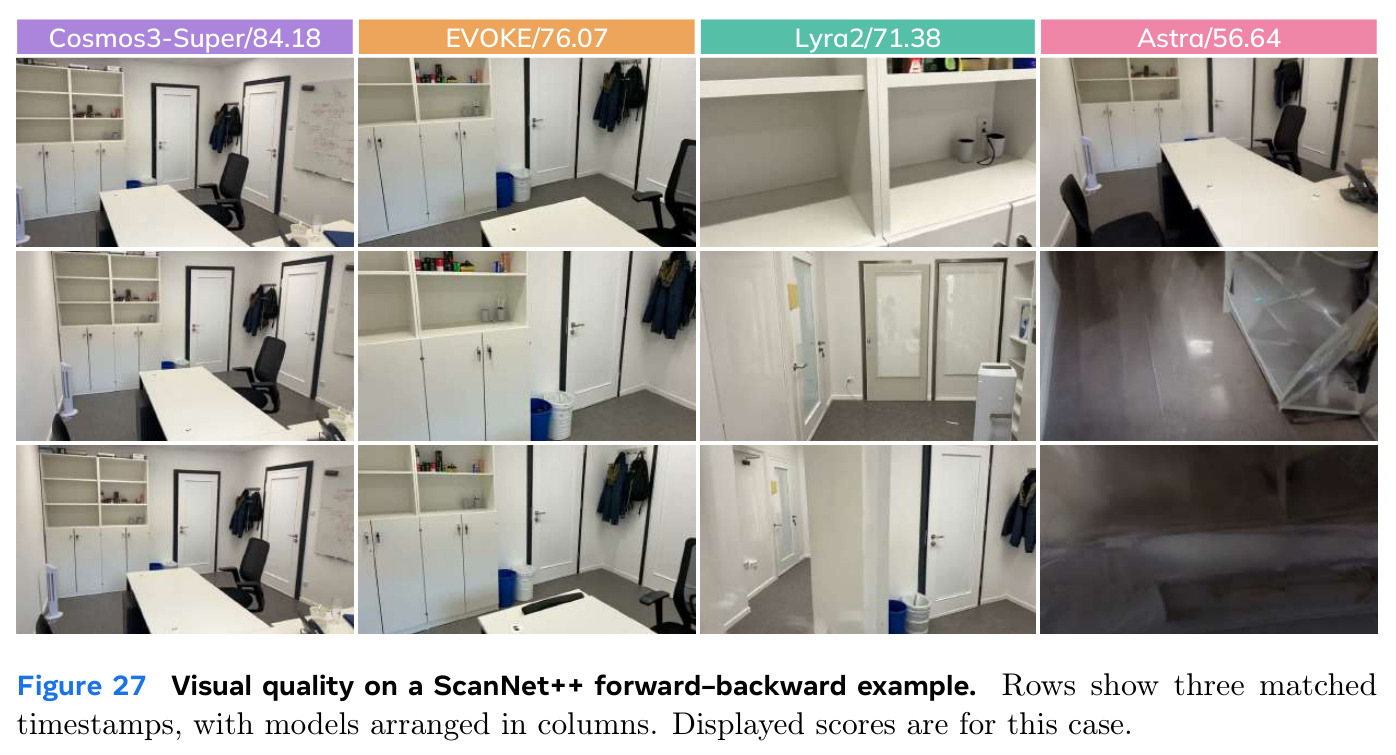
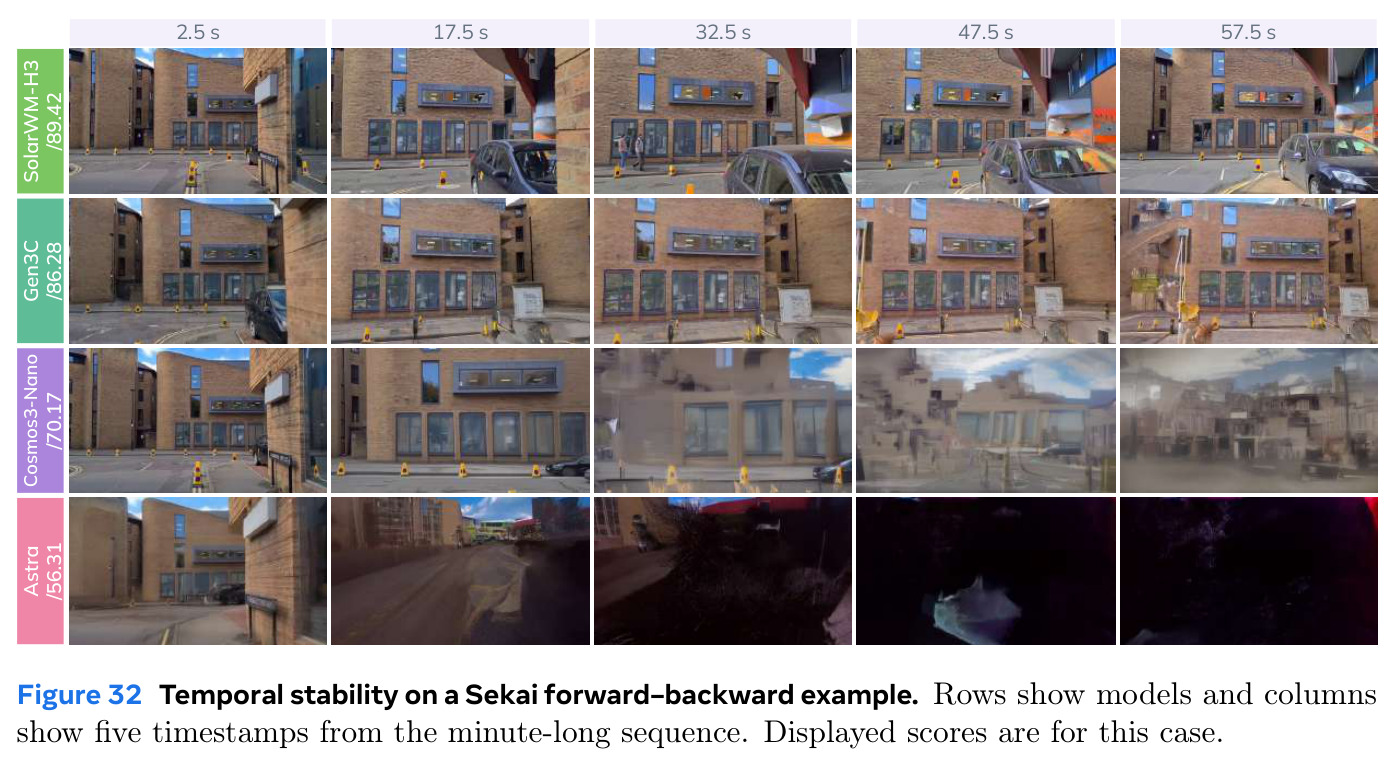
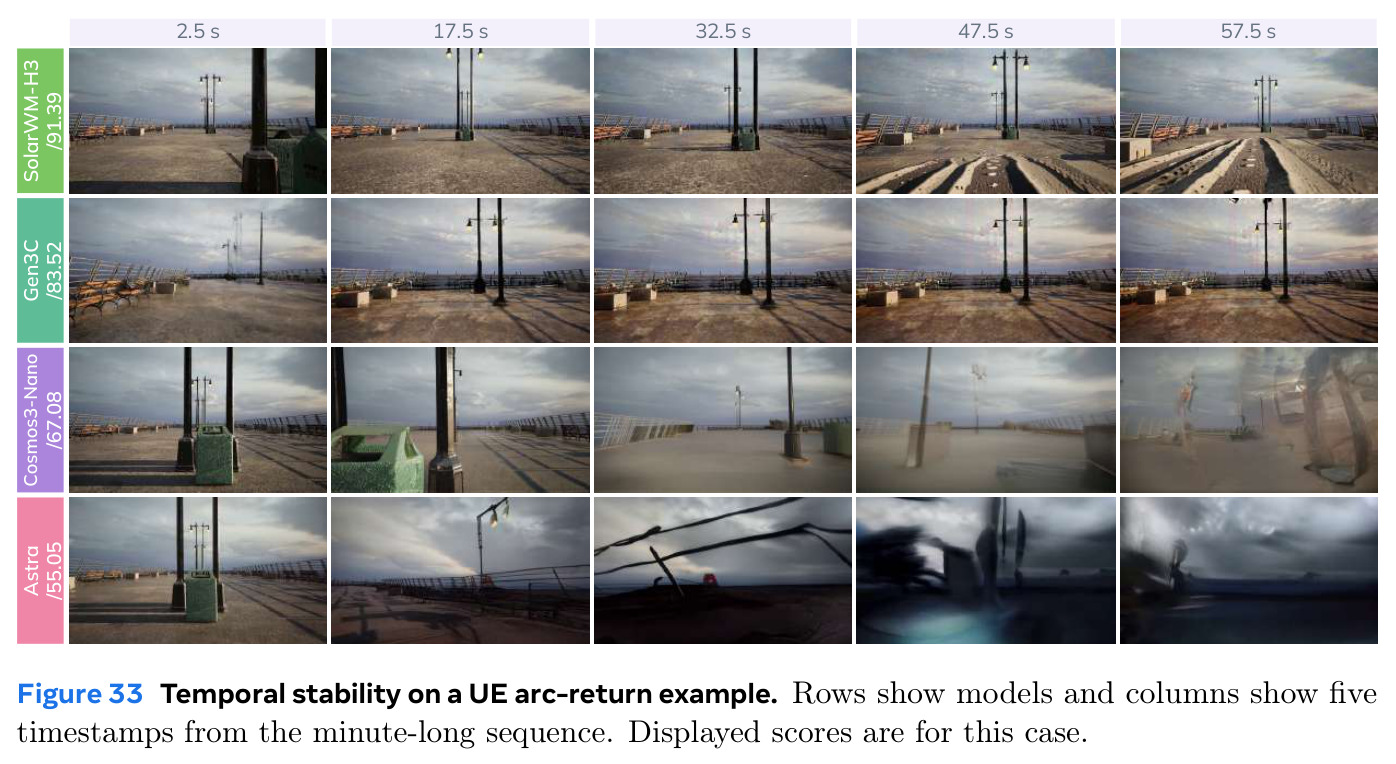
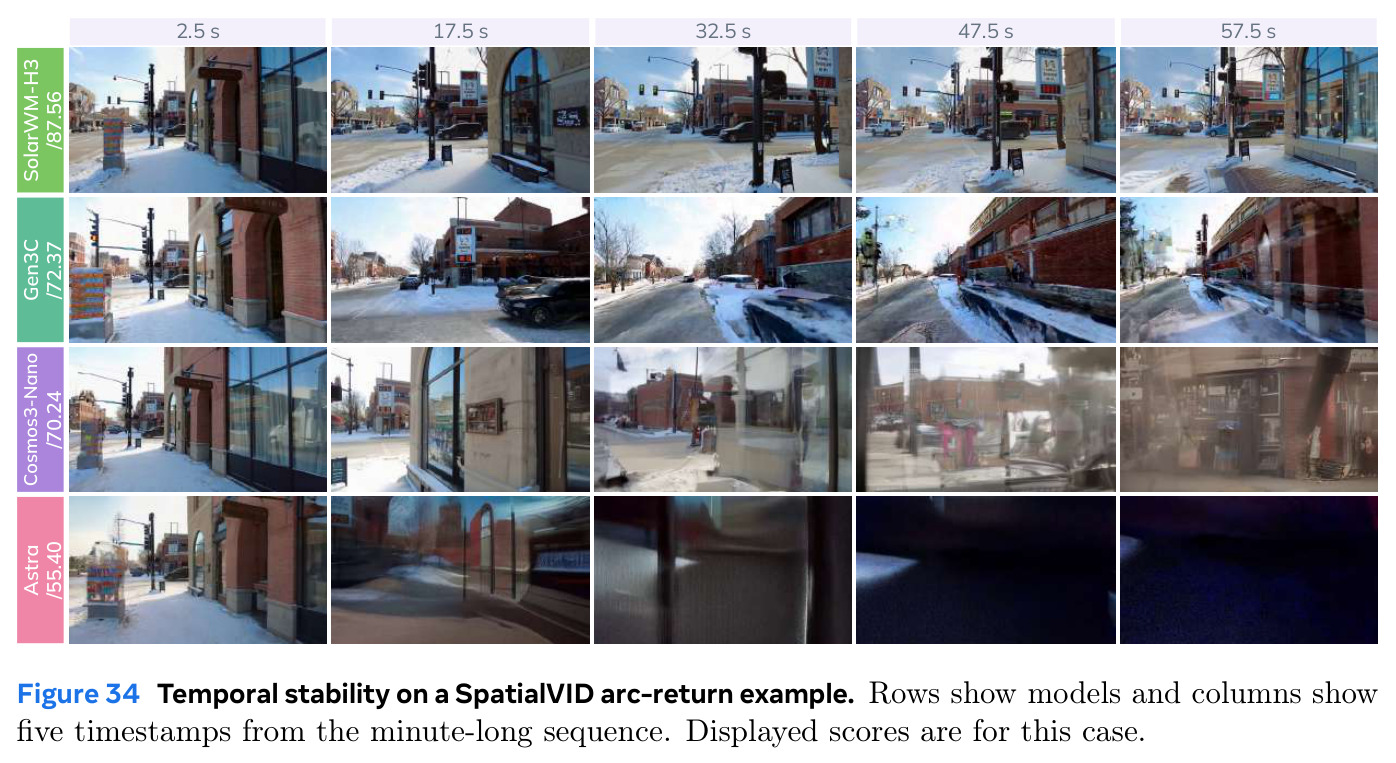
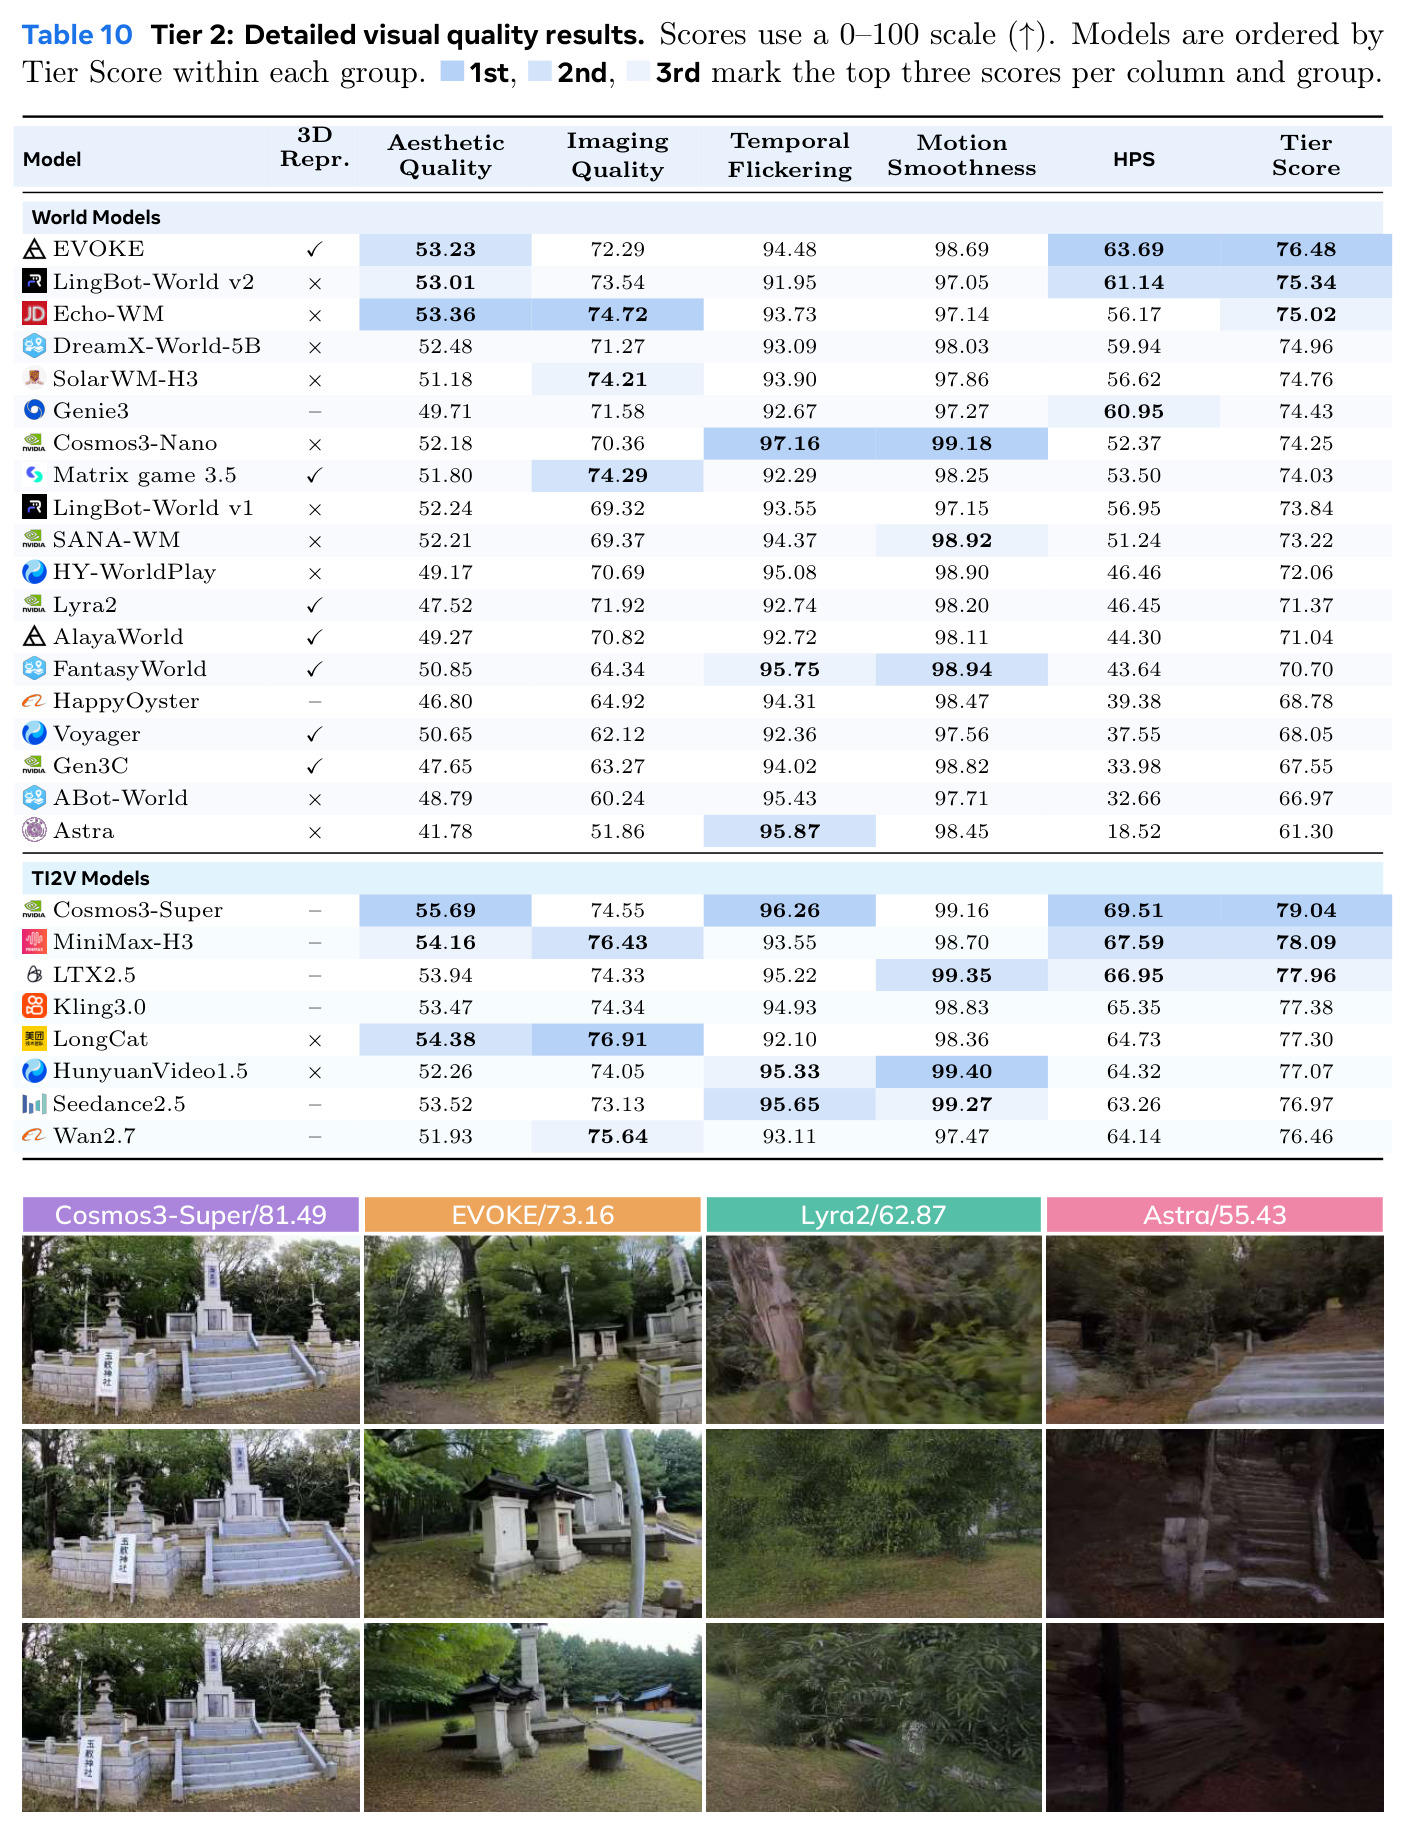
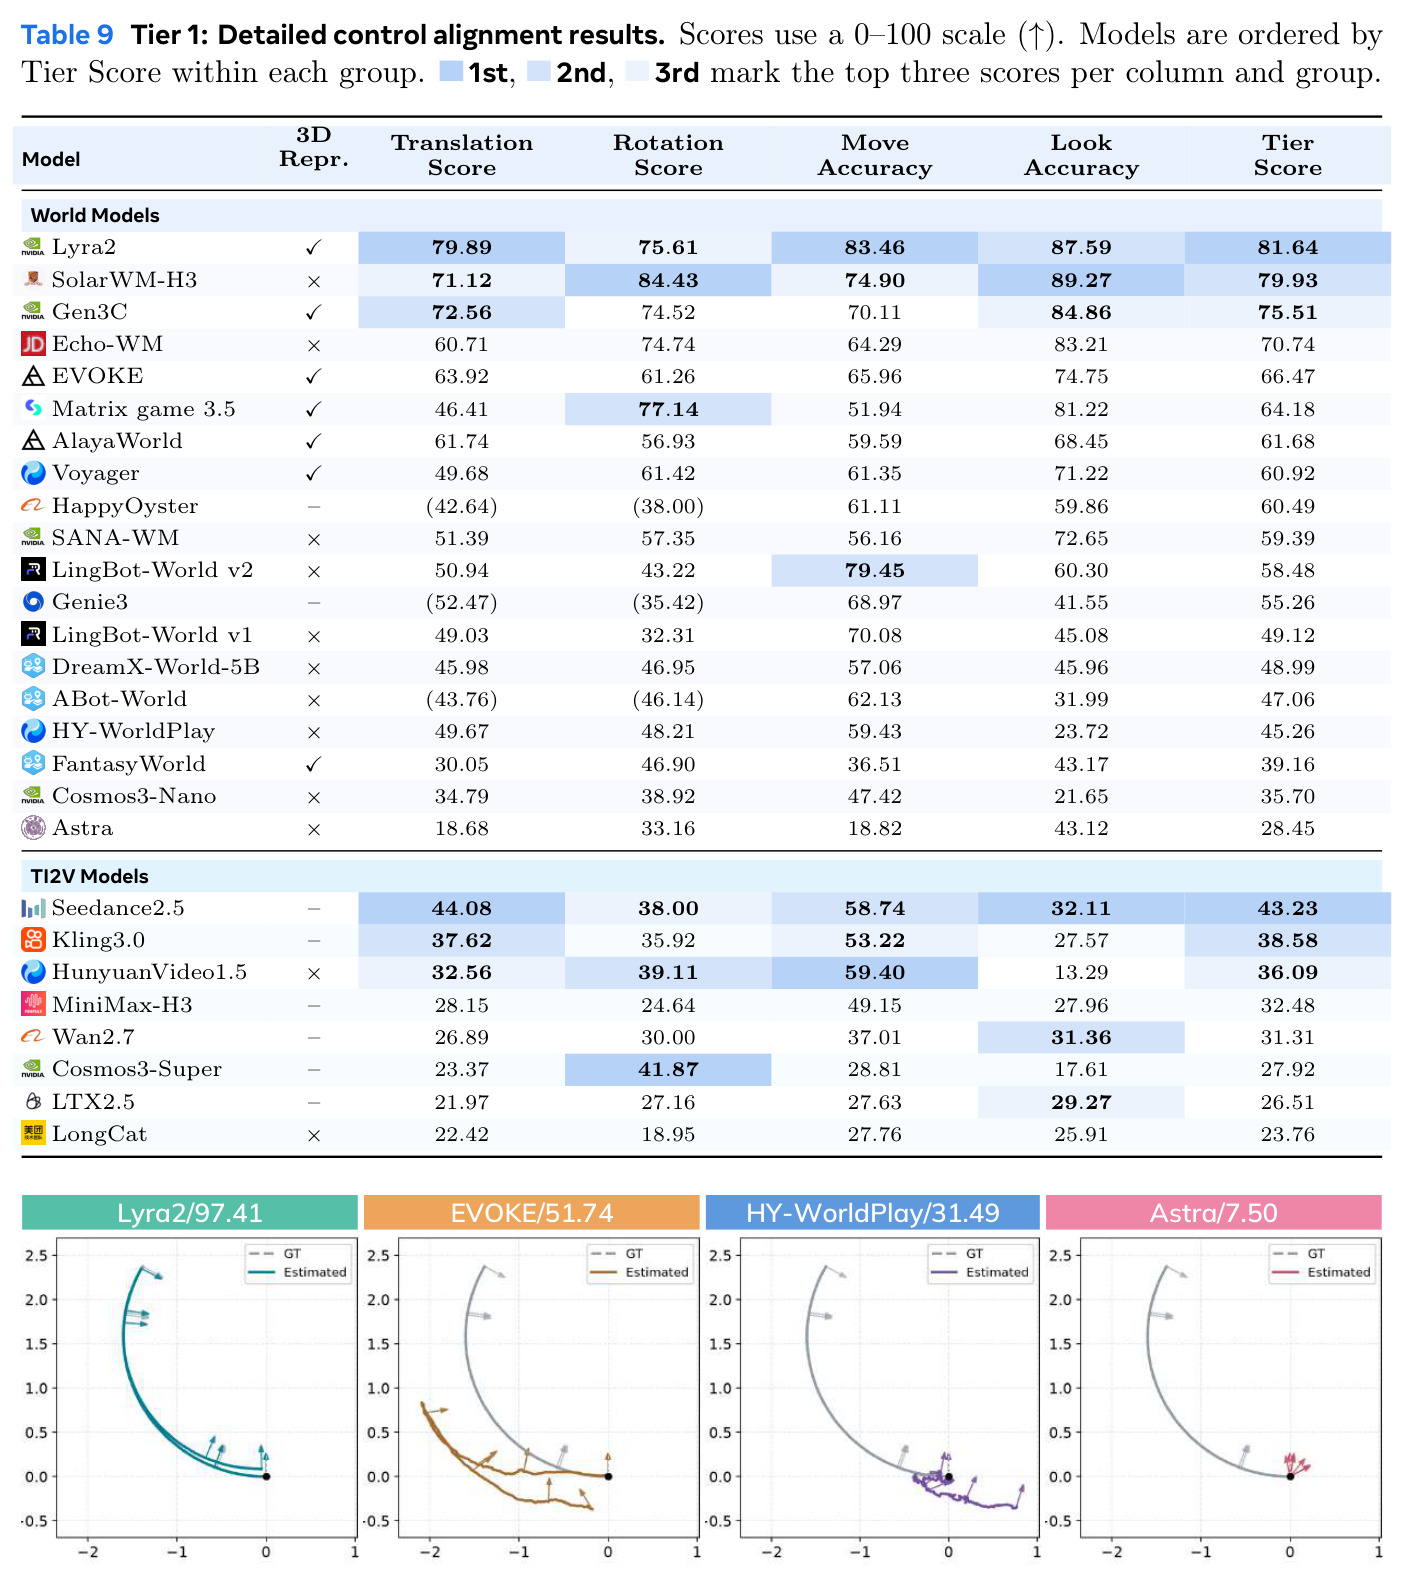
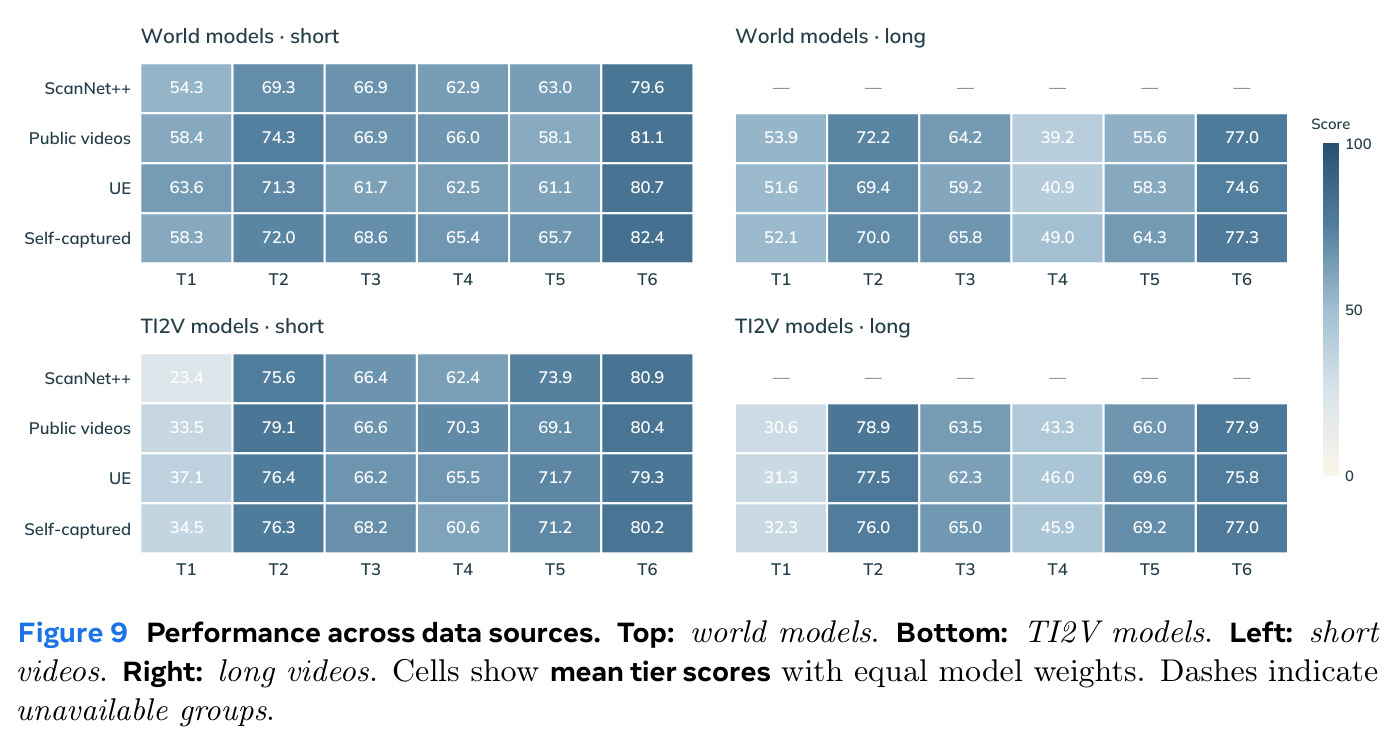
对 27 个模型(19 个世界模型 + 8 个 TI2V)的评测给出多个反直觉结论。世界模型组 SolarWM-H3 以 76.32 居总榜第一(持久性 70.28、时间稳定性 84.05 均列组内第一),Lyra2(74.77,控制 81.64 第一)、EVOKE(72.70,画质 76.48 第一)分列二三;Gen3C 输入保持第一(75.23),HY-WorldPlay 3D 自洽第一(70.34);TI2V 组 Seedance2.5 总分 67.44 最高,Cosmos3-Super 领跑画质(79.04)、持久性(69.75)、3D 自洽(74.55);无一模型六层全冠。组间对比:控制差距最大,世界模型均值 57.29 对 TI2V 的 32.48(差 24.80 分);TI2V 画质更高(77.53 对 71.80)且 3D 自洽更高(69.88,反超 10.14 分),说明控制差并非源于不会生成一致场景。相关性:画质与三一致性均值秩相关仅 0.33/0.21;TI2V 画质与控制负相关(短 -0.43),短 TI2V 画质与输入保持 -0.62;控制与 3D 自洽近乎无关(0.09/-0.04);输入保持与持久性模型级相关 0.87 但模型内案例级仅 0.35。长时程:五个头部世界模型控制平均降 26.98 分(SolarWM-H3 91.91→64.50),TI2V 画质仅降 2.08 而局部几何降 7.13;持久性各模板降约 15–27 分。人类对齐实验(90 案例、20 标注者)Spearman 0.859–0.921。
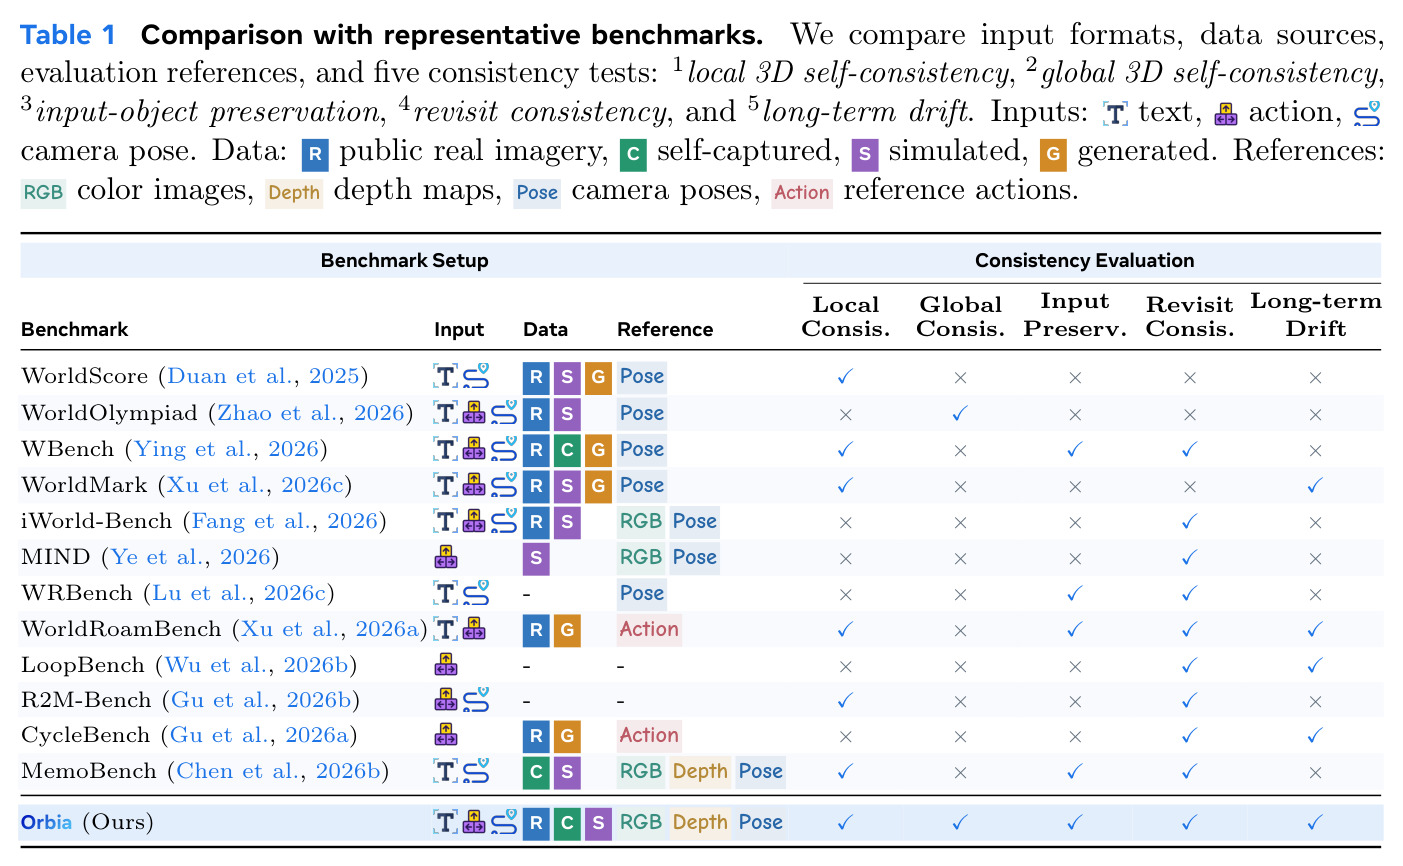
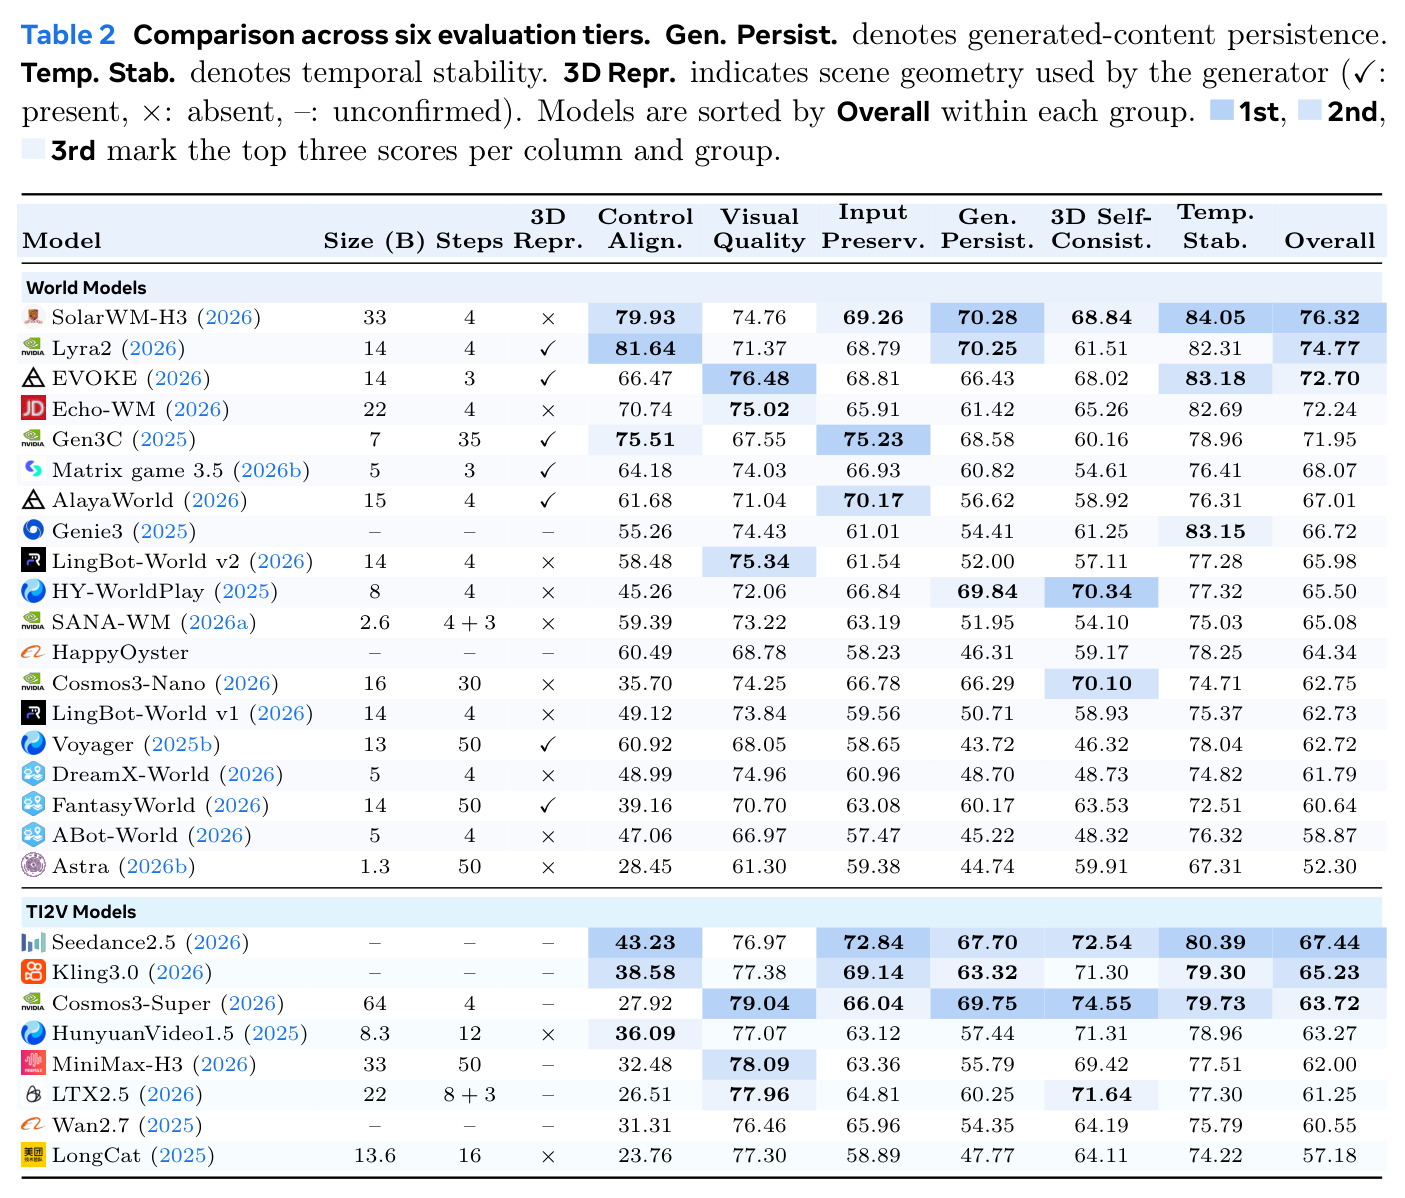
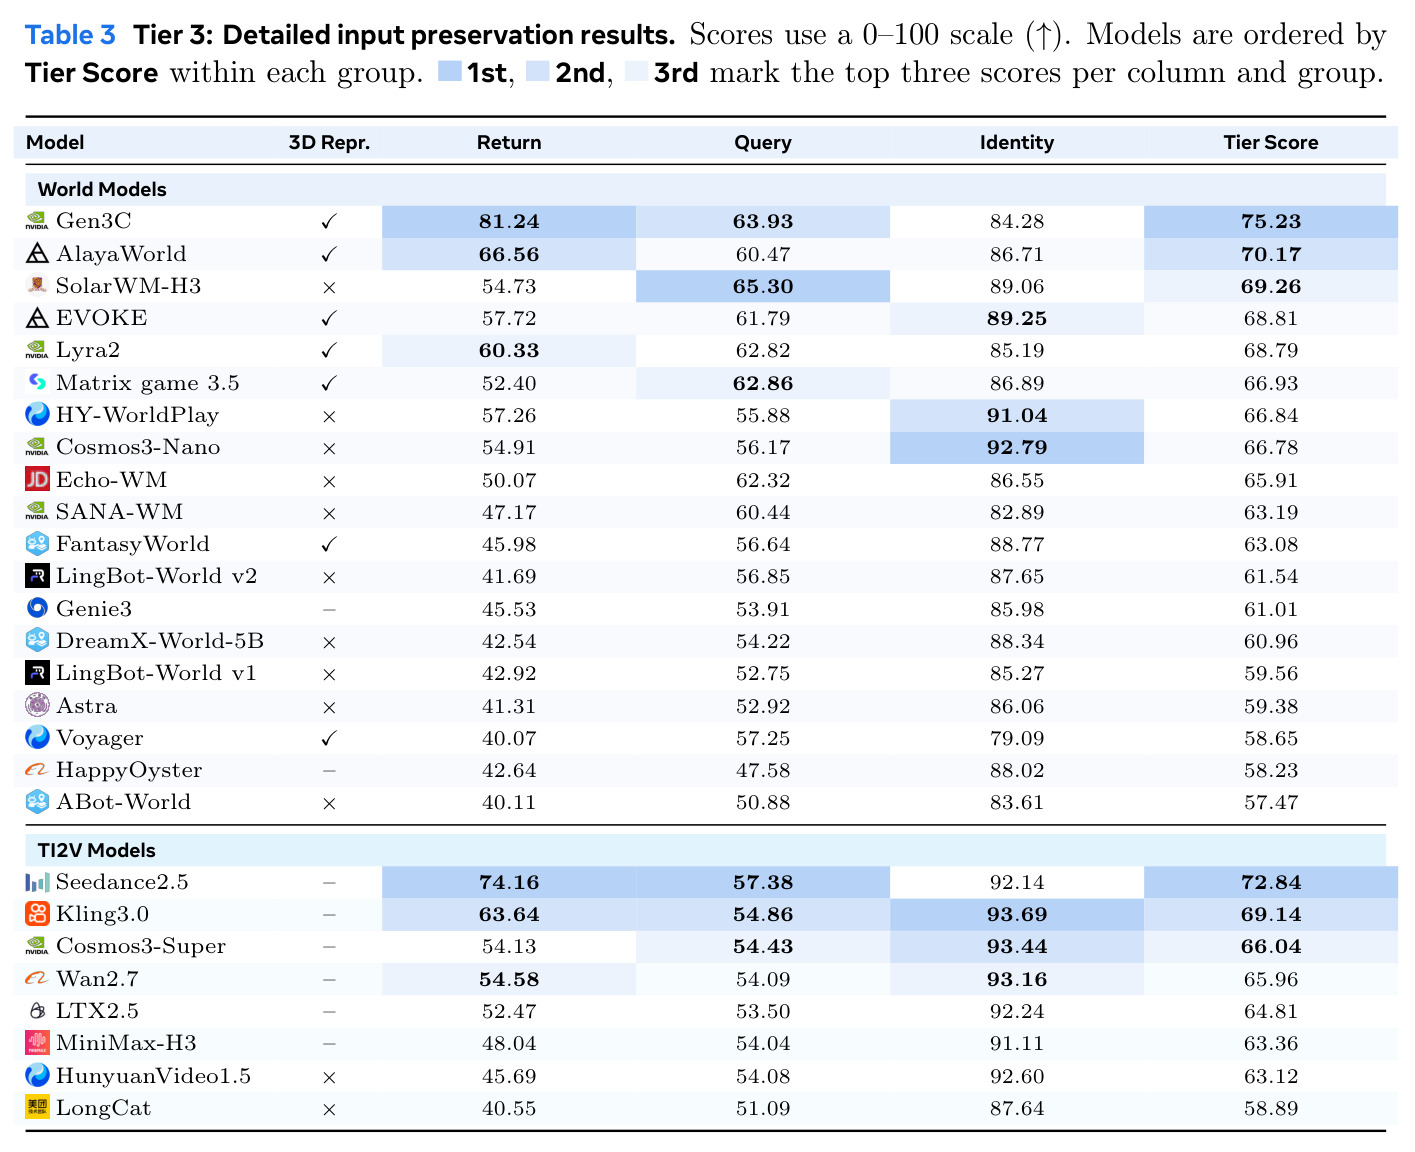
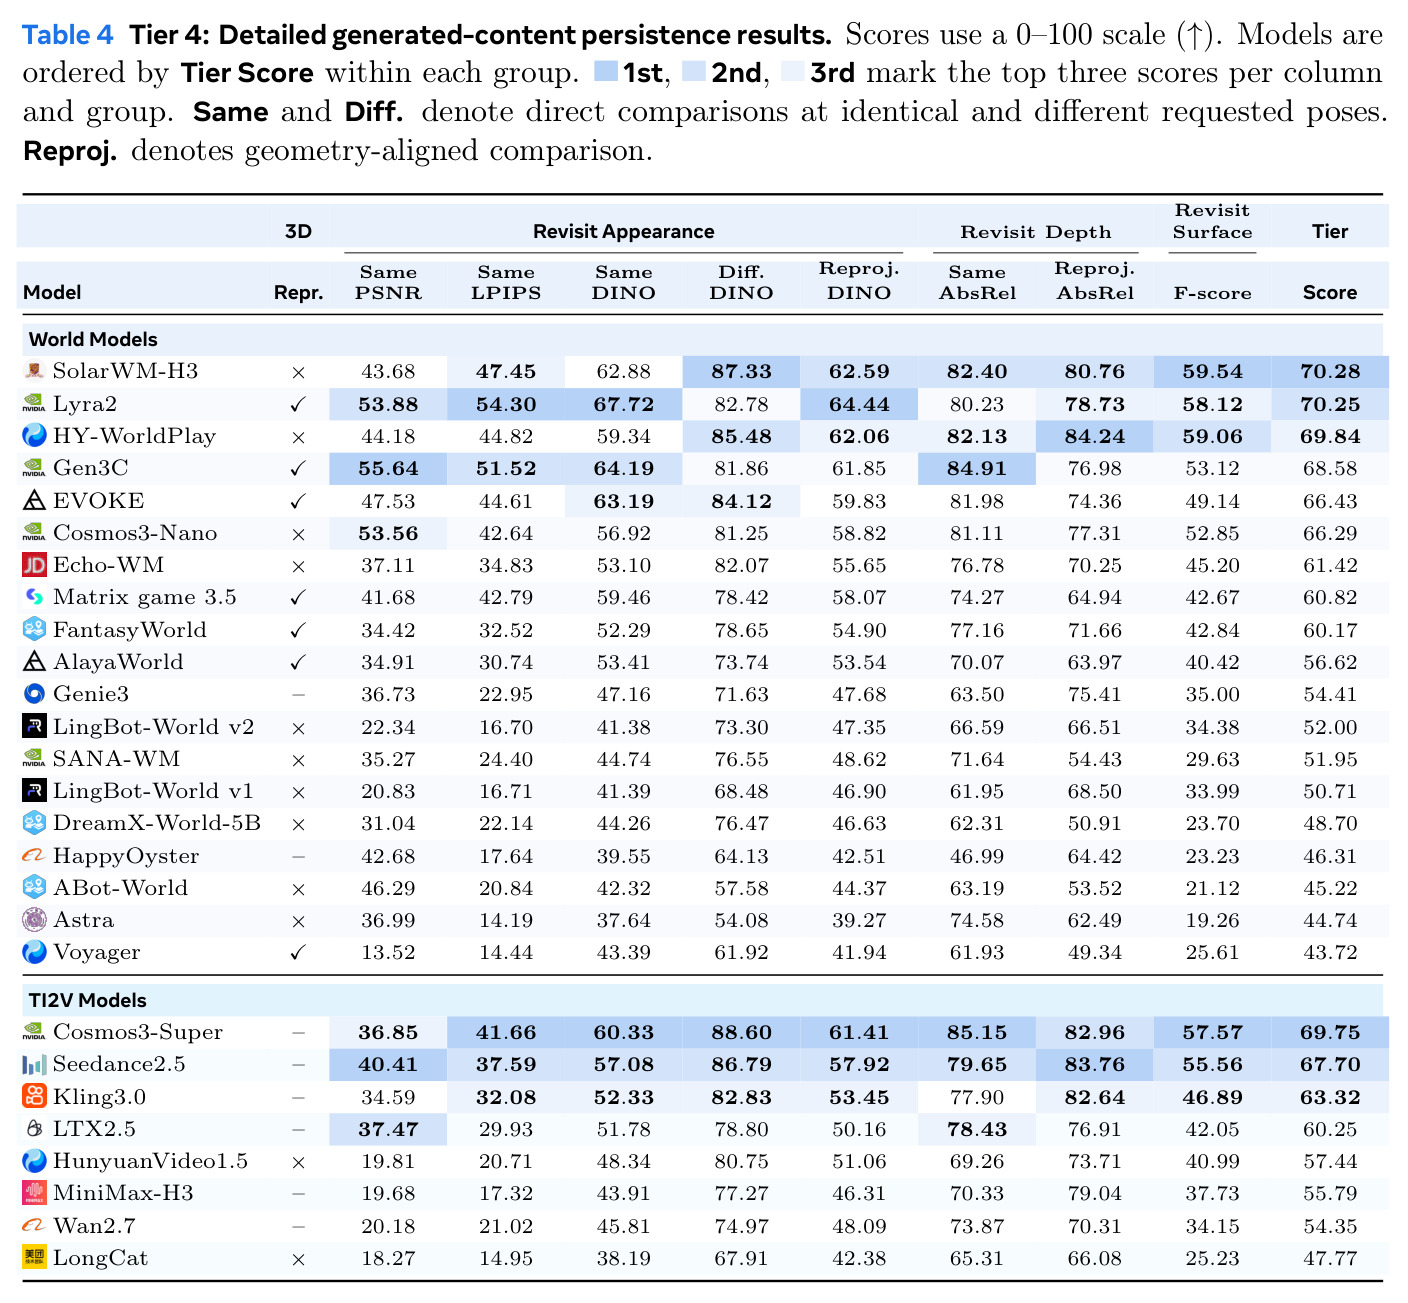
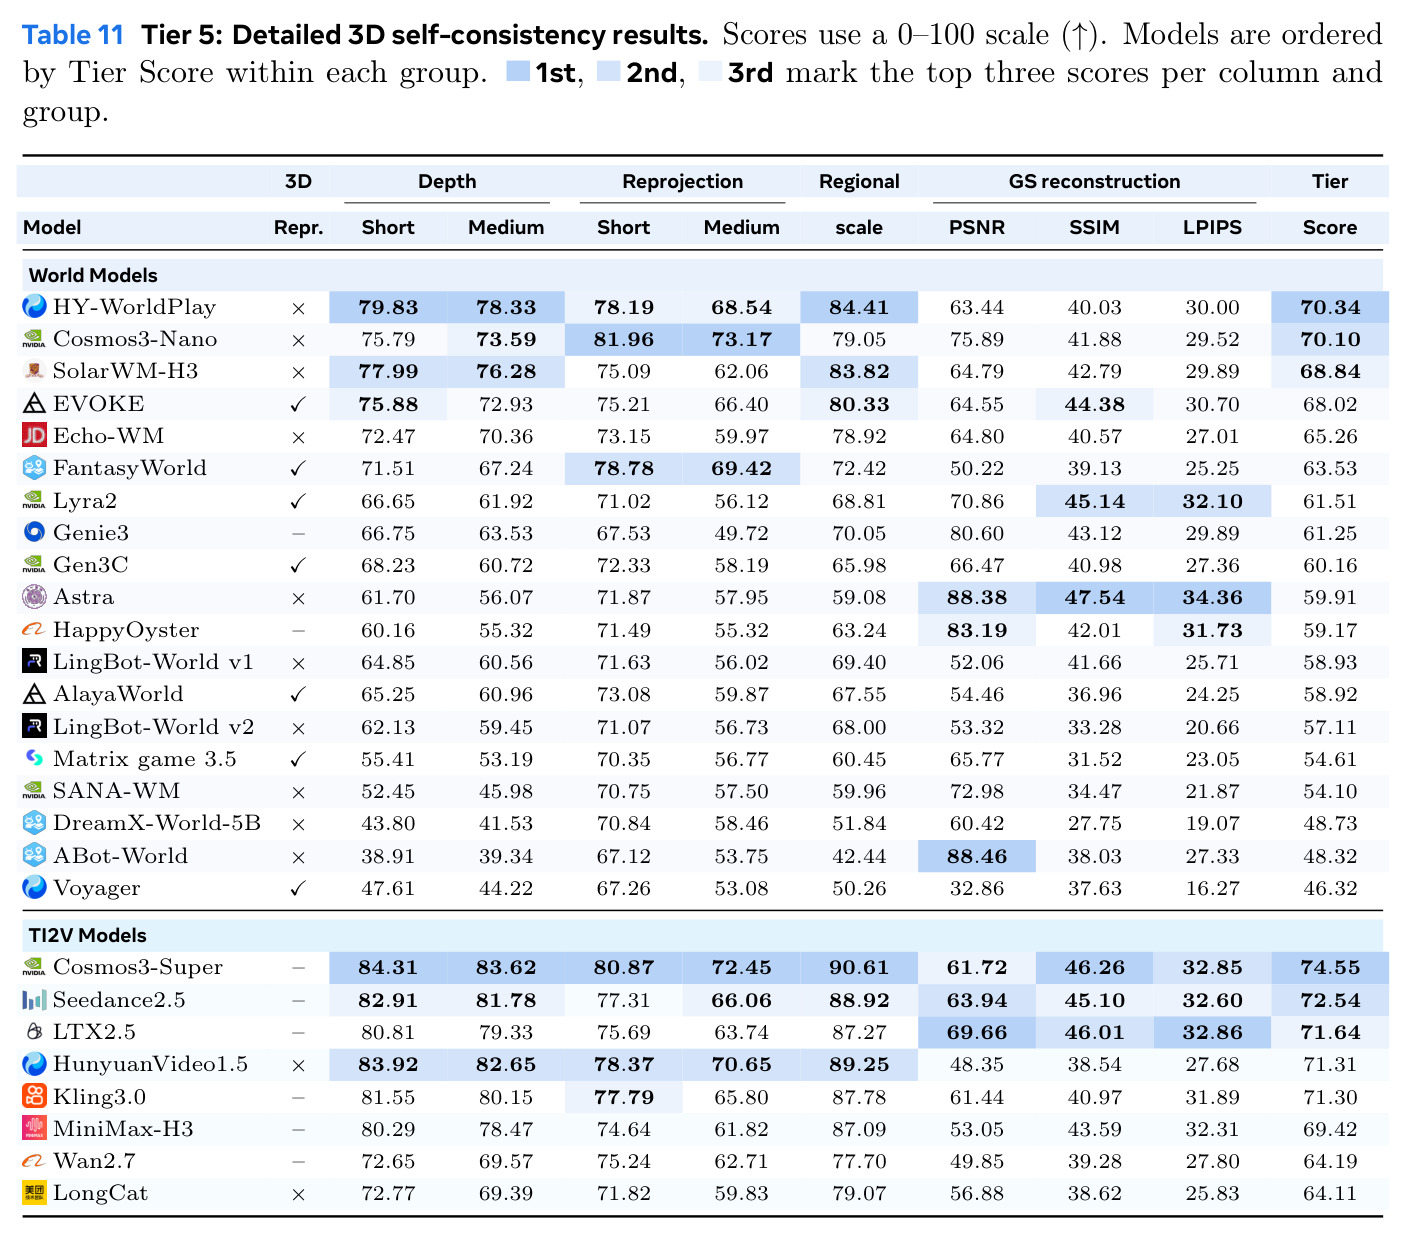
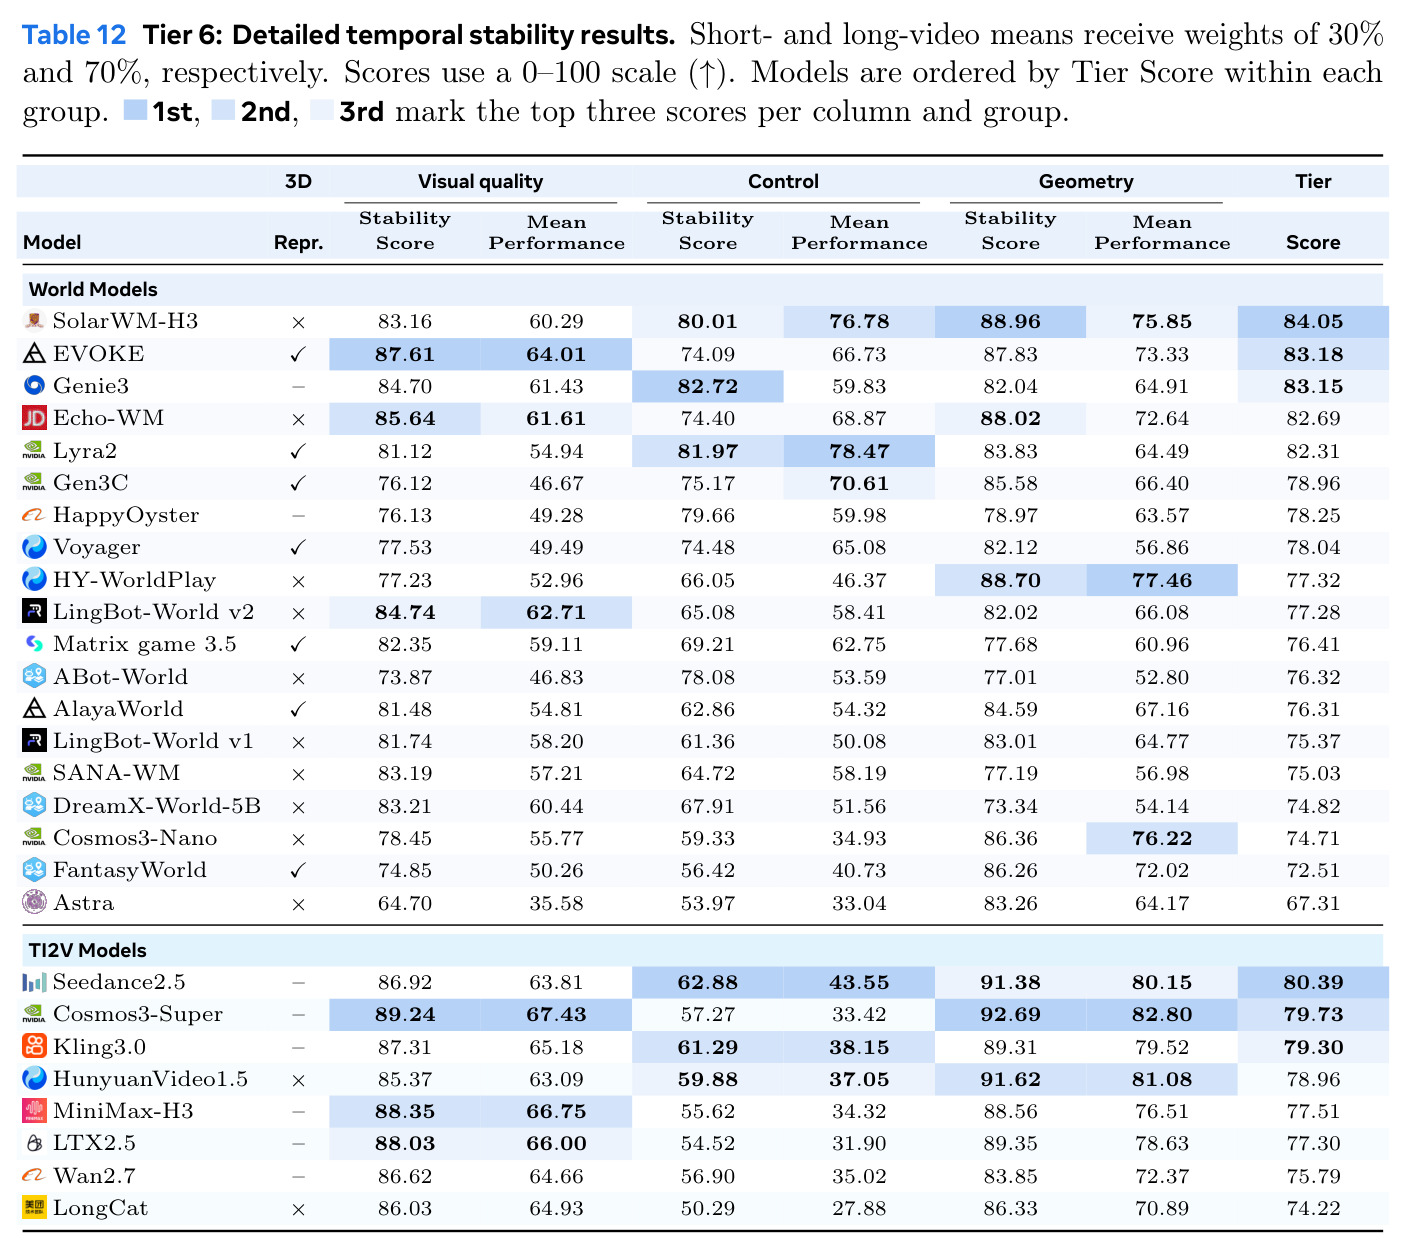
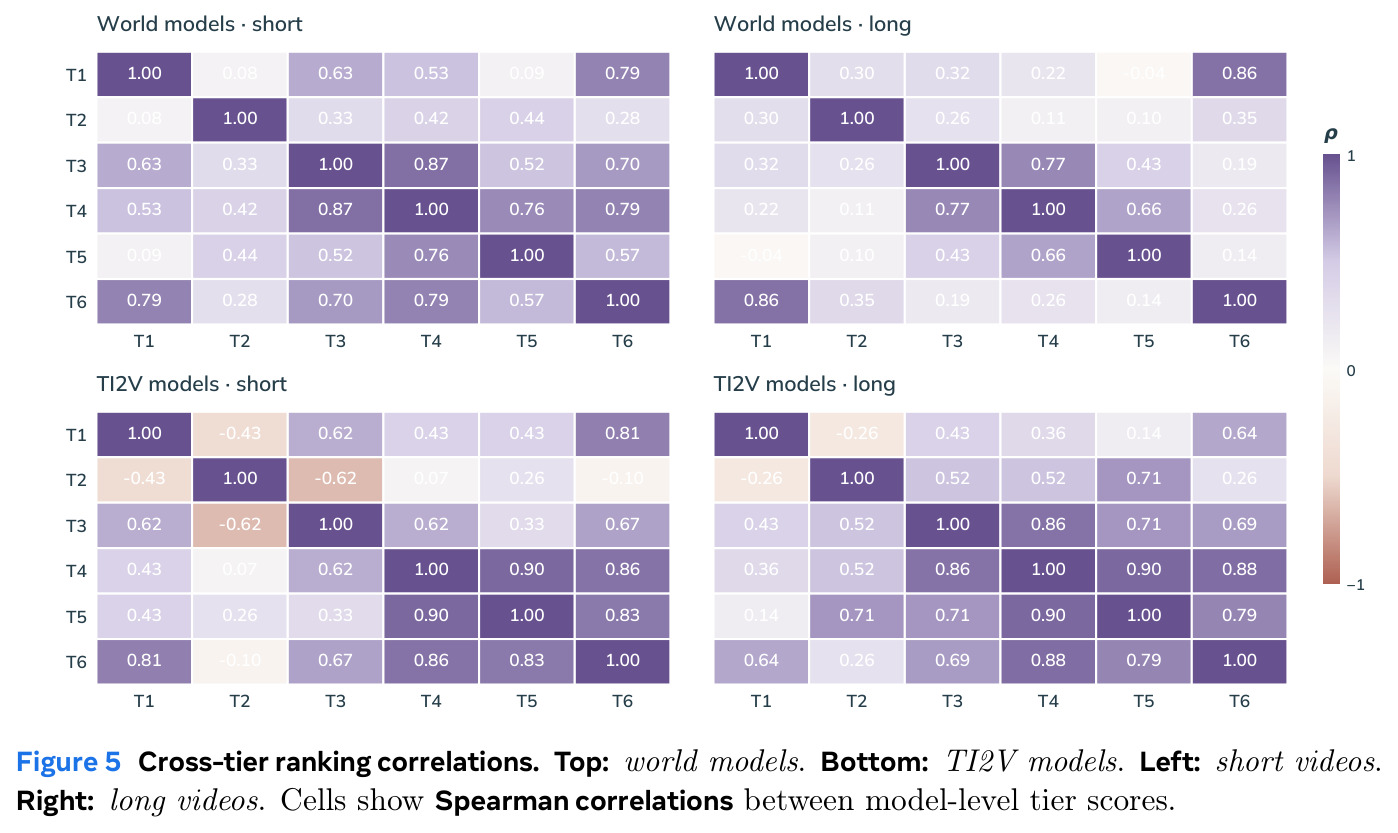
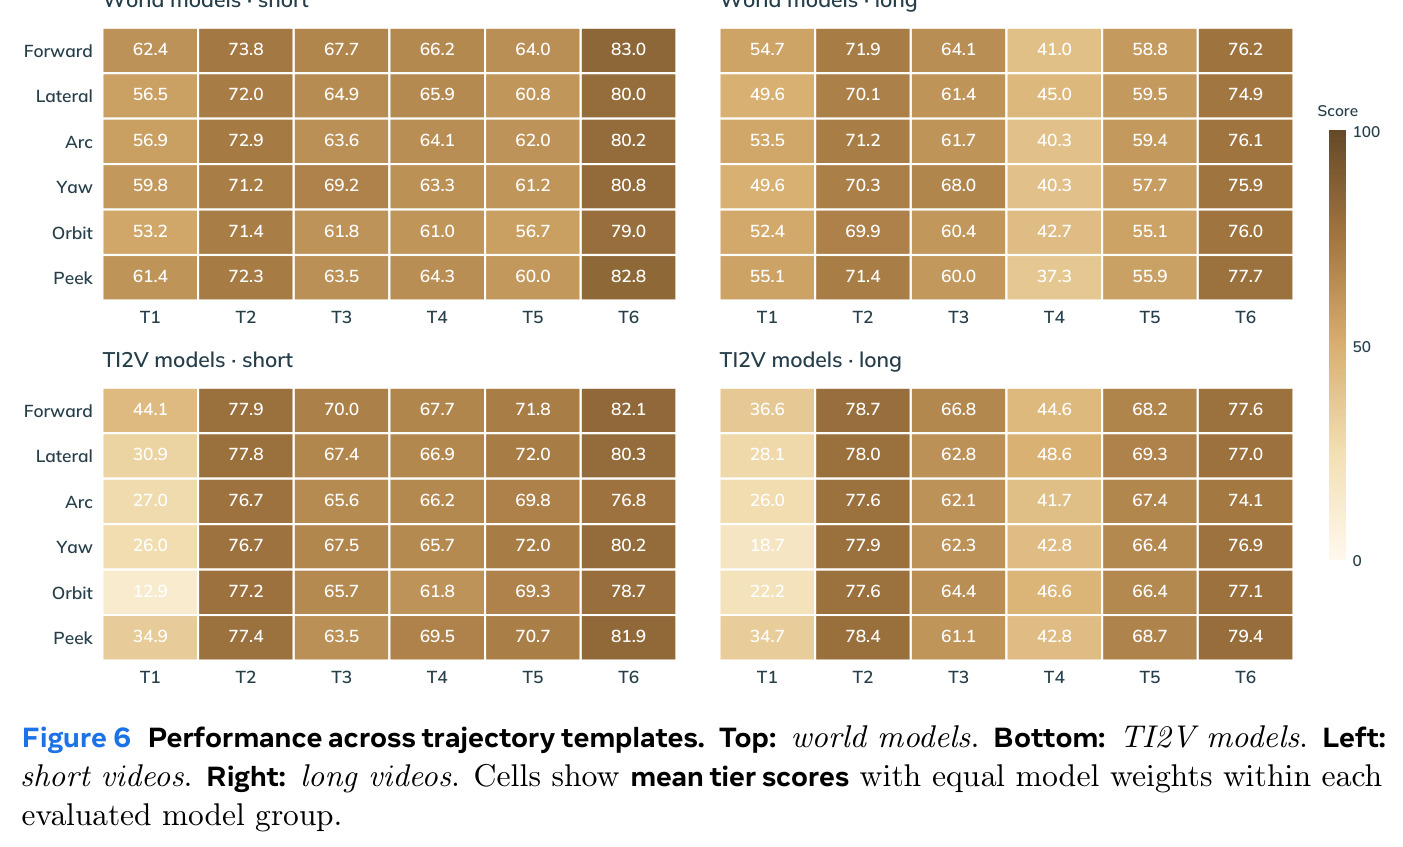
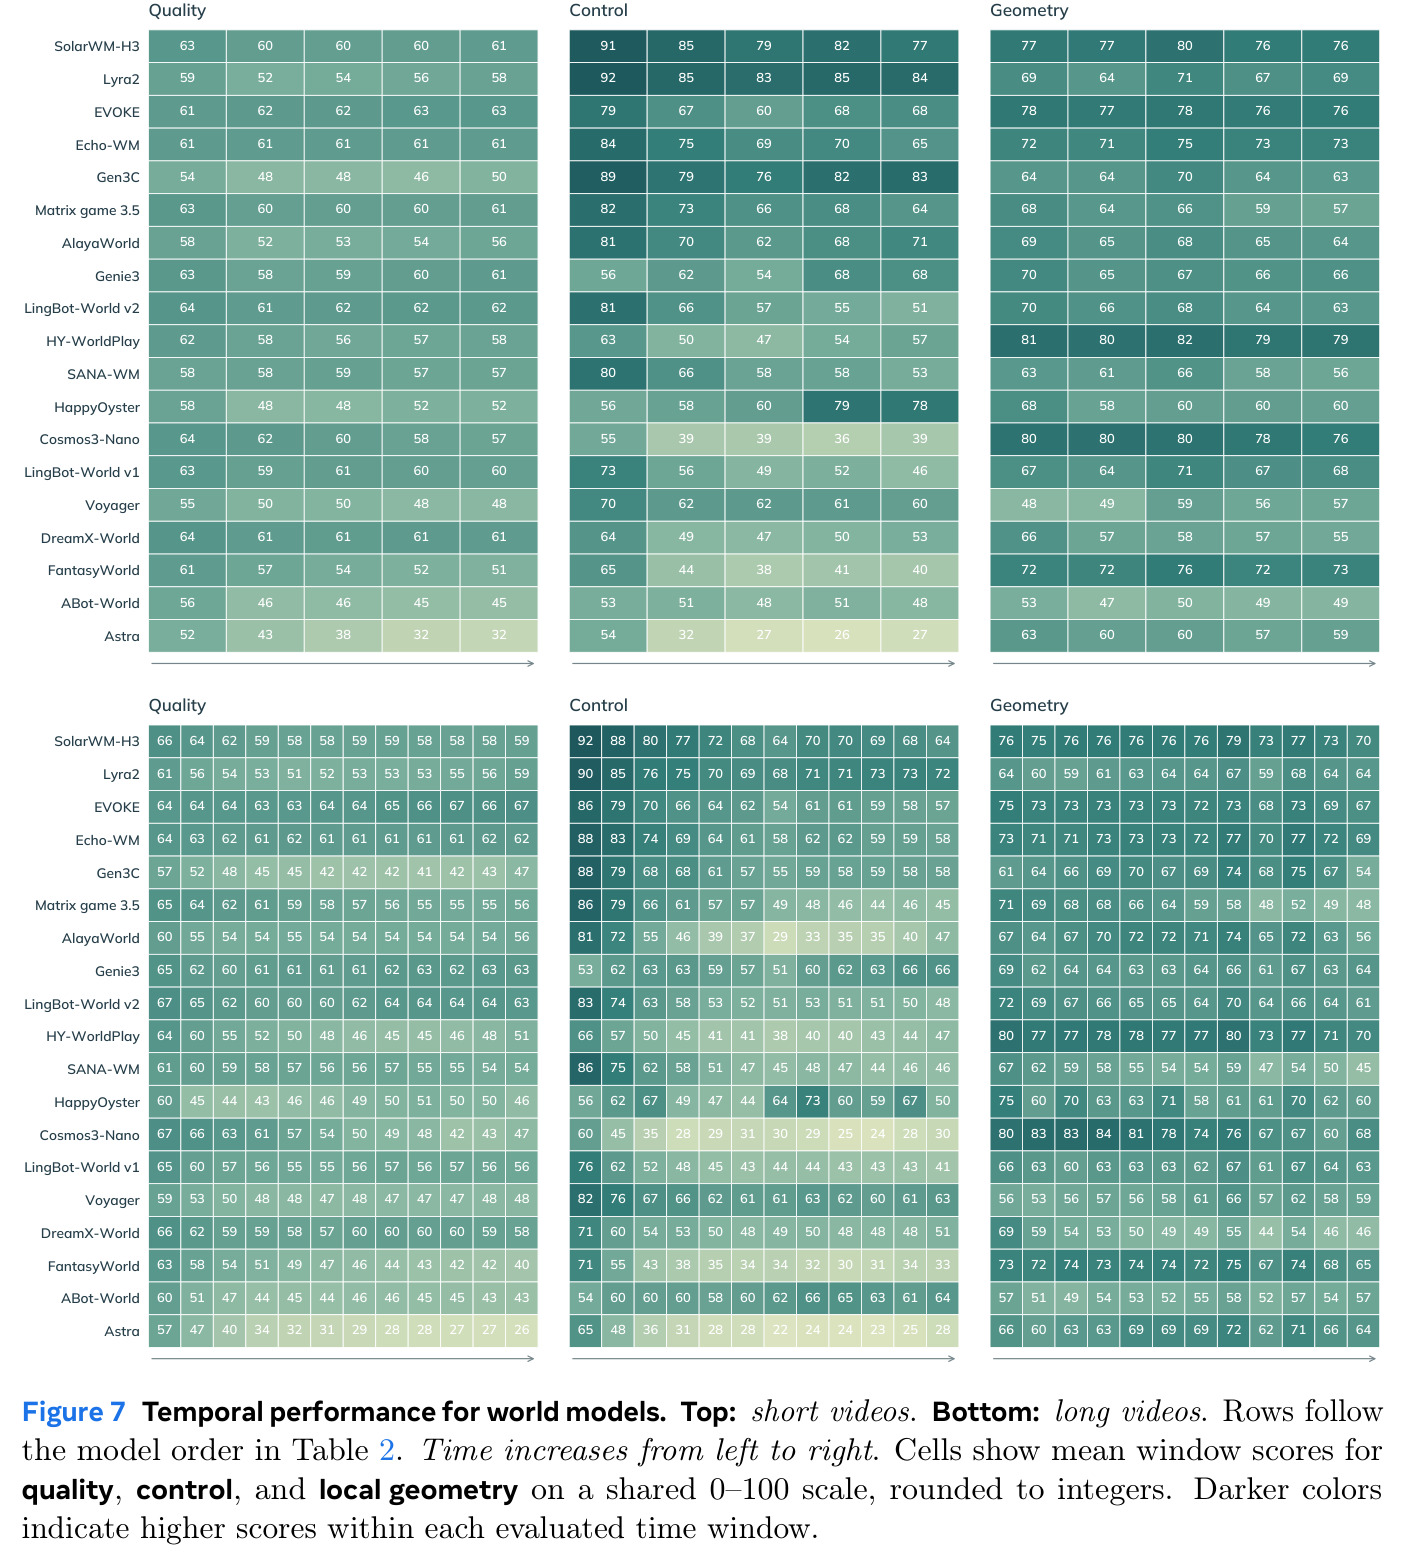
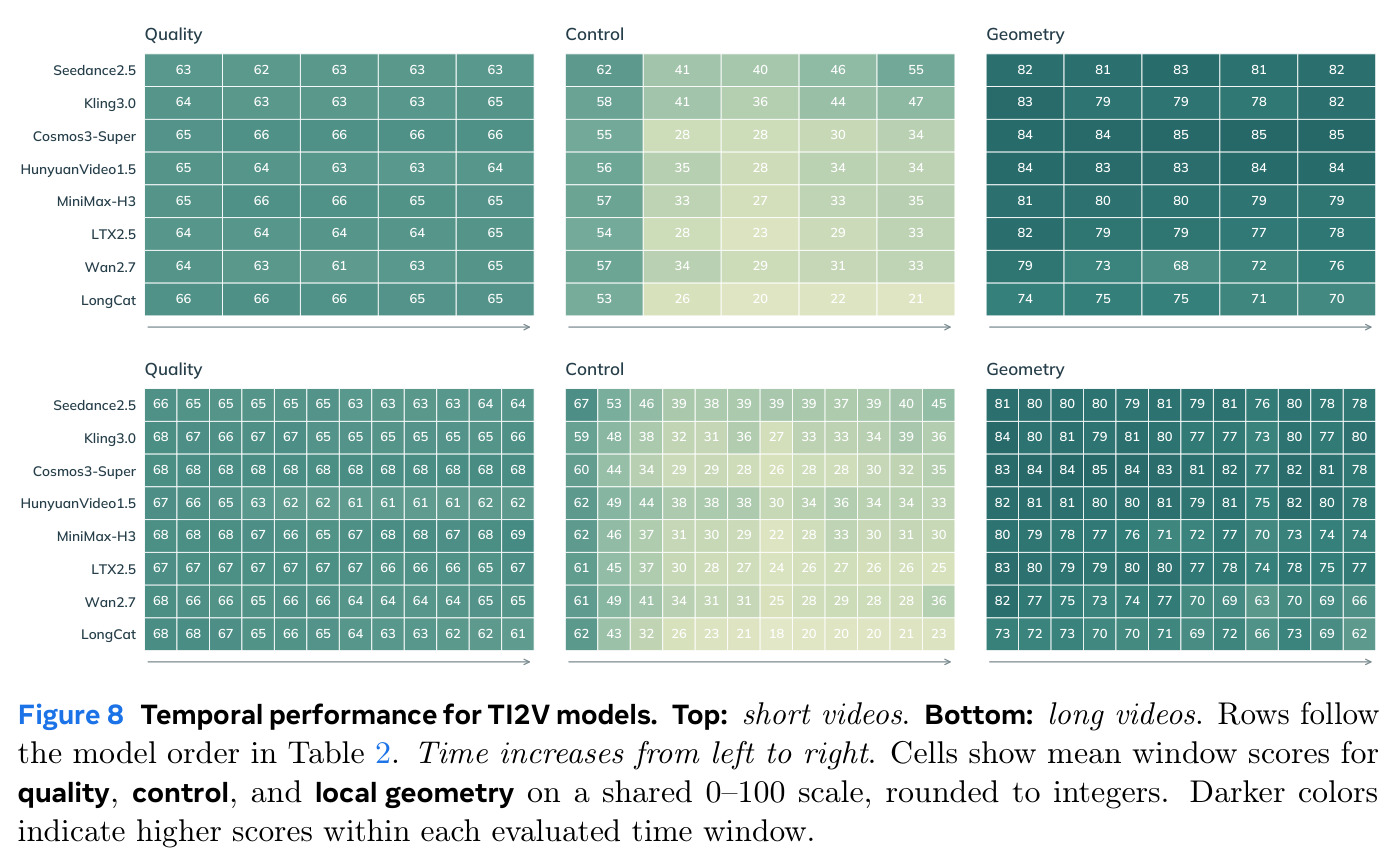
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 世界模型综合评测 | Overall(0-100,越高越好) | SolarWM-H3 76.32(榜首) | 次名 Lyra2 74.77;组内最低 Astra 52.30 | 领先次名 1.55 分,组内跨度 24.02 分 |
| 相机/动作控制对齐(组间对比) | Control Align. | 世界模型组均值 57.29(最佳 Lyra2 81.64) | TI2V 组均值 32.48(最佳 Seedance2.5 43.23) | 组间差距 24.80 分,为六层中最大能力鸿沟 |
| 3D 自洽性(组间对比) | 3D Self-Consist. | TI2V 组均值 69.88(Cosmos3-Super 74.55) | 世界模型组均值 59.74(最佳 HY-WorldPlay 70.34) | TI2V 反超 10.14 分 |
| 输入保持(世界模型组) | Input Preserv. | Gen3C 75.23 | 组均值 64.30;TI2V 最佳 Seedance2.5 72.84 | 高于组均值 10.93 分,也超过最佳 TI2V |
| 分钟级长视频生成内容持久性 | Gen. Persistence(短→长) | 前进-后退 66.21→40.96(世界模型) | 窥视-返回 64.29→37.32 | 六个模板均下降 15–27 分,长探索显著加剧遗忘 |
| 长时程控制稳定性 | 首末 5 秒窗口控制分变化 | 五个头部世界模型平均 -26.98 分 | TI2V 三强(Seedance2.5/Kling3.0/Cosmos3-Super)-23.25 分 | 两组中控制都比画质、几何退化更严重 |
| 评测与人类偏好一致性 | Spearman 秩相关 | 0.859–0.921(六层;90 案例、6 模型、20 标注者) | —(校验实验,无基线) | 自动评分与人类排序高度一致,时间稳定性层一致性最高 |
局限与改进
作者承认的局限散见各处:动作条件模型(ABot-World、Genie3、HappyOyster)无法接受逐帧位姿,轨迹须编译成离散指令,其控制分只计 Move/Look 精确率,属诊断性评测,与位姿控制模型不严格可比;分数归一化用固定线性映射,六层权重(25/25/10/10/10/20)属设计选择。我自己的观察:其一,几乎所有几何指标依赖 DA3 恢复的位姿与深度,评估器误差会系统传导,风格化或域外渲染可能让 DA3 失准从而误罚模型;其二,'持久性'以首次生成观察为参考,若首次生成已经幻觉,回访一致反而得高分,错误被'合法化';其三,锚点限定静态地标,基准不覆盖动态物体与可交互改变状态的世界;其四,ScanNet++ 源没有长视频配对(Table 5 中其长视频列为 0),分钟级结论部分依赖公共视频与 UE;其五,60 秒、最多 3 次回访对'长期记忆'仍是温和检验;其六,720 案例、859 锚点规模适中,六种模板都是规则平滑轨迹,覆盖不了自由探索的分布外行为;其七,留出渲染指标以 DA3+3DGS 的重建能力为前提,重建器上限会影响该指标的区分度。
独立分析的弱点
独立分析的弱点与改进方向:(1) 评估器单点依赖——位姿与深度全靠 DA3,可引入多评估器集成并按置信度加权,同时报告指标对评估器的敏感性曲线;(2) 持久性参考循环——首次生成即错的场景会被判为'持久',可对每个新区域多次采样,以多首访一致性、与场景描述的语义交叉验证来甄别幻觉;(3) 静态世界假设——游戏与具身应用需要物体永久性与状态改变(门开了、箱子被推走),可扩展动态锚点与'干预-回访'协议;(4) 模板规则性强——六种模板均为平滑相机运动,可加入急转、快速位移、高遮挡密度路径,检验更接近真实交互的失败模式;(5) 评测成本高——每个视频需 DA3 位姿恢复 + 高斯重建 + DINO 特征全套流程,可发布轻量代理指标或蒸馏评估器降低社区复用门槛;(6) 归一化映射固定——不同误差量纲的线性映射影响跨层可比性,可公开映射标定细节并提供在线重标定工具。这些弱点均有明确工程路径,不动摇基准的总体框架。
未来方向
作者明确希望 Orbia 推动具有持久空间记忆、能遵循相机命令、并在探索全程保持一致场景的世界模型;数据显示显式 3D 记忆路线在控制与内容保持上占优——Lyra2 用逐帧几何检索相关历史帧并建立对应,EVOKE 把观测几何存入外部世界状态库并按当前位姿渲染,Gen3C 维护 3D 缓存以渲染结果引导生成,是直接的改进方向。基于本成果可延伸:把六层分数作为后训练奖励(RLAIF 或可微代理损失),针对性优化持久性与长时程稳定性;研究控制与一致性的联合训练,因为二者秩相关接近零(0.09/-0.04)表明当前模型并未兼顾;把评测从 60 秒扩展到数分钟、更多回访、动态物体与状态改变场景;为 TI2V 模型设计轻量空间记忆或条件注入机制以弥合 24.80 分的控制差距;以及把 Orbia 协议迁移到具身仿真下游任务,检验一致性提升能否转化为策略学习与导航收益。
复现评估
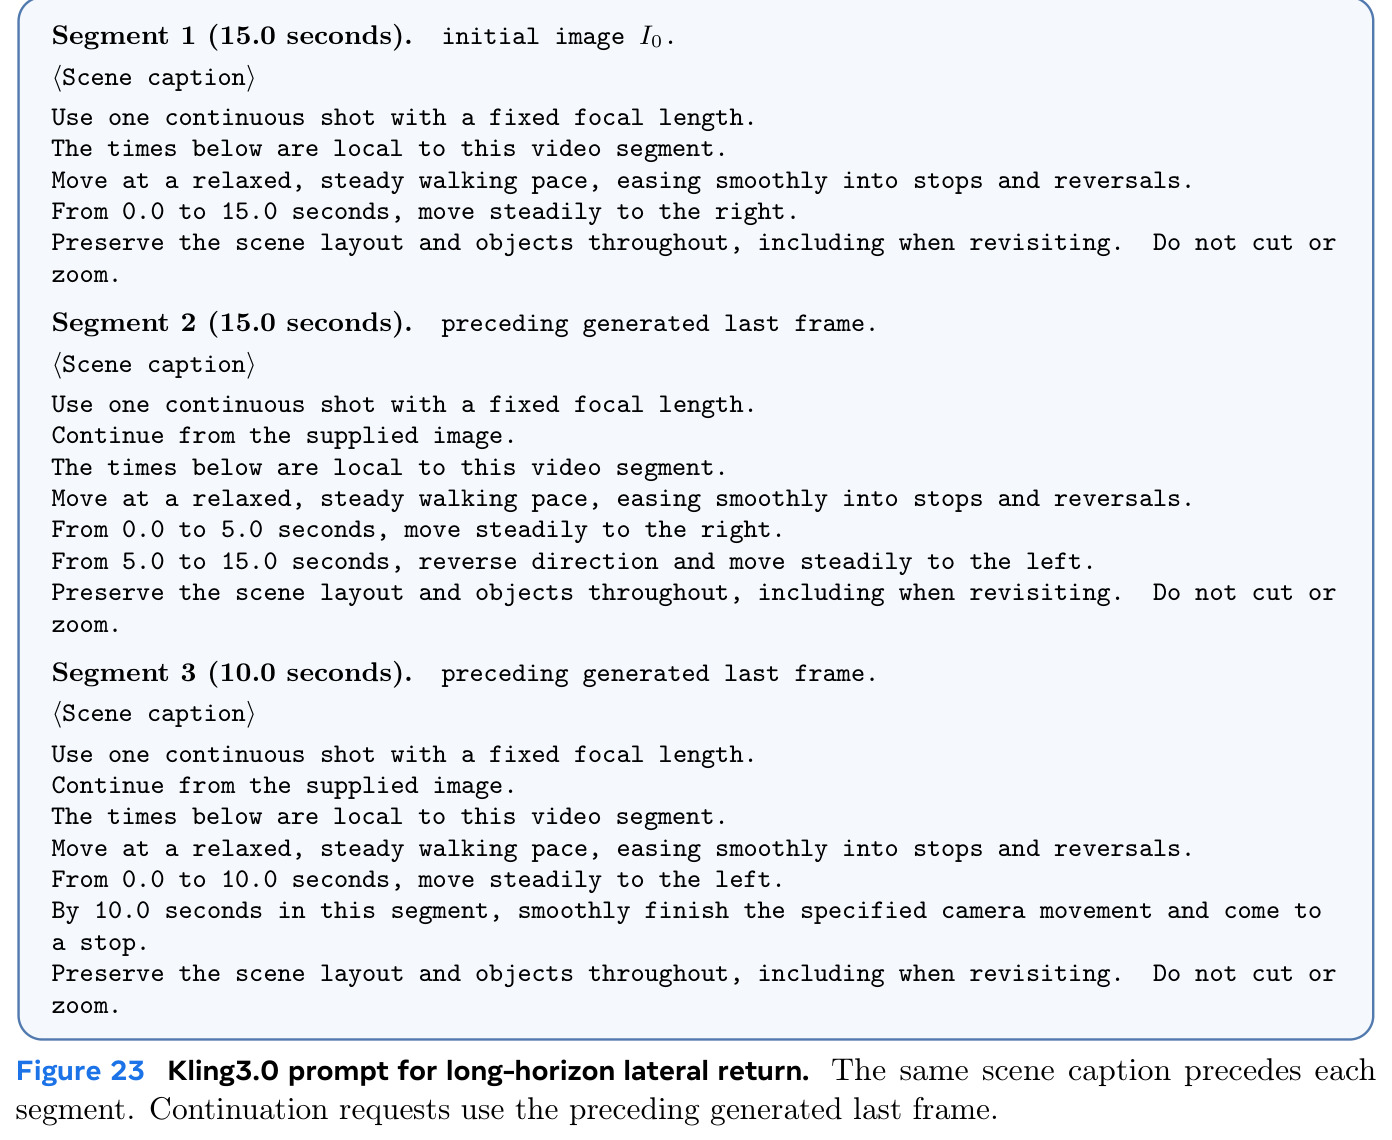
复现条件较好。基准完全开源:项目页 orbia-bench.github.io,代码在 GitHub worldbench/Orbia,数据集在 HuggingFace Orbia/Orbia,包含 720 个案例(720p、16 FPS)、859 个锚点掩码、配准 RGB-D 参考、请求轨迹、场景描述与长短配对划分。论文附录公开了完整评测协议:六层指标的公式与归一化方法、DA3 Giant 1.1 的配置(处理分辨率 504、120 帧流式块 + 30 帧重叠 + SALAD 回环)、DINOv2/SAM3.1/gsplat/HPSv3/VBench 组件参数,以及 27 个模型的适配器细节(如 SolarWM-H3 的 4 步去噪 + 5 潜帧块,Kling3.0 的分段文本提示模板,ABot-World 的 20°/17° 转向响应标定)。主要成本在模型侧:需跑通 27 个模型(最大 64B、最多 50 步扩散)的推理,部分闭源模型依赖官方接口;若从零重建数据需 300+ 小时人工审核,成本高,但直接使用发布数据复现评测表完全可行。单模型评测在单机多卡即可完成,总体难度中等。
论文图表