Player-1:从合成经验中学习游戏操控 Player-1: Learning to Play from Synthetic Experience
SFT初始化后,在16个可验证奖励合成环境中做PPO,让游戏操控超越演示并泛化到未见游戏。
前置知识
计算机使用智能体(Computer-Use Agent, CUA)
以屏幕截图为观测、输出键盘和鼠标动作来完成多步数字任务的智能体(如 UI-TARS、Qwen-CUA)。典型做法是用归一化的绝对坐标点击/拖拽界面元素,并配合逐步视觉推理决定下一步操作,把“感知屏幕→推理→操作”闭合成循环。
Player-1 的底座就是 CUA 模型(Qwen3.5),论文的整个动作空间是在 CUA 的点击/滚动/绝对坐标之上做扩展的,理解“CUA 为什么玩不了游戏”才能理解本文的动机。
监督微调(SFT)与视觉语言模型(VLM)
VLM 是对齐了视觉与语言能力的基座模型;SFT 则用(输入,目标输出)配对数据做交叉熵训练,让模型掌握特定行为格式。本文每条 SFT 样本为 $(q, I_t, C_H(h_{<t}), z_t, a_t)$,同时监督视觉推理文本 $z_t$ 和动作 $a_t$。
6,044 条演示轨迹如何变成训练信号、为何需要动作平衡采样(左键在原始数据中占比不足 1%),都要靠 SFT 的基本框架来理解。
可验证奖励强化学习(RLVR)与 PPO
RLVR 指奖励由程序化规则直接从环境状态计算(如数学答案对错、游戏分数),无需学习型奖励模型或人类标注。PPO 是策略梯度算法,通过裁剪概率比率 $\mathbb{E}[\min(\rho_t A_t, \text{clip}(\rho_t, 1\pm\epsilon) A_t)]$ 限制单步更新幅度,保证训练稳定。
本文第二阶段就是在 16 个合成环境里用游戏状态分数做 RLVR + PPO,“超越演示”的全部增益来自这一步,是论文的核心引擎。
广义优势估计(GAE)与优势归一化
GAE 用 $\hat{A}_t = \sum_l (\gamma\lambda)^l \delta_{t+l}$(其中 $\delta_t = r_t + \gamma V(s_{t+1}) - V(s_t)$)估计优势函数,在偏差与方差间折中;优势归一化(减均值、除标准差)把更新量标准化,防止不同任务奖励尺度差异导致策略更新忽大忽小。
16 个环境的奖励量纲差异巨大,论文式 (1) 的“先全局、再按环境”两级优势归一化是多环境 PPO 能稳定训练的关键细节。
域随机化(Domain Randomization)
训练时主动随机化环境的视觉外观、物理参数和控制动力学,迫使策略无法记忆单一画面或手感,只能学到对变化不变的能力,是 sim-to-real 迁移的经典技术。例如本文的视角增益按 $\text{Tri}(0.8, 1, 1.2)$ 采样、实体色相均匀偏移 $\{0,60,\dots,300\}\u00b0$。
Player-1-GYM 的外观/相机/场景/控制四维随机化正是该思想在游戏操控上的系统应用,是增益能泛化到训练套件之外的重要原因。
研究动机
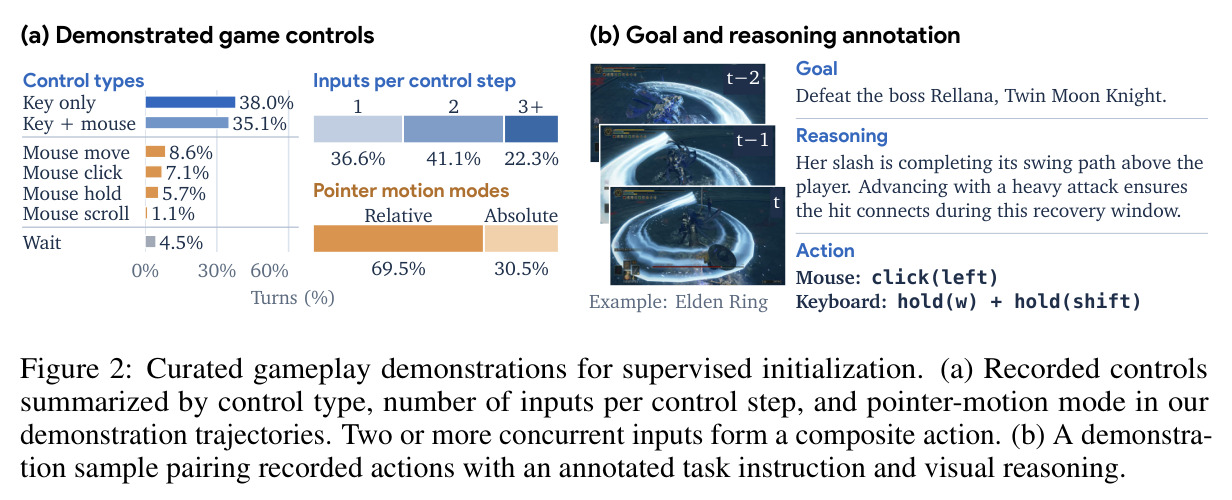
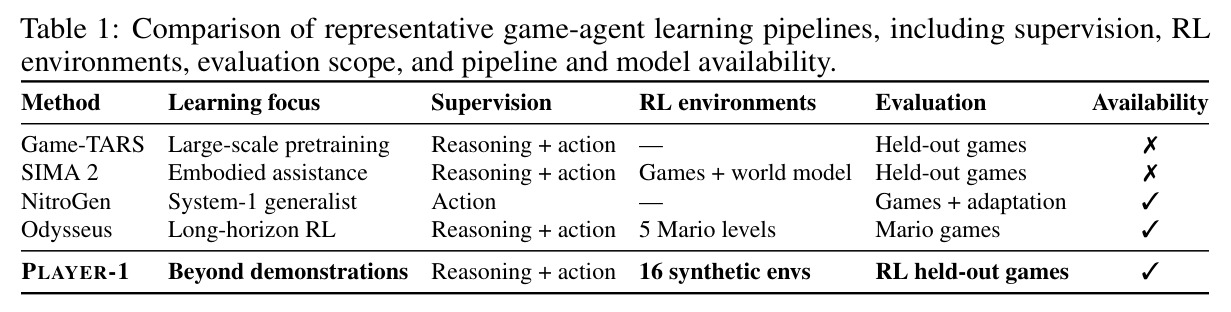
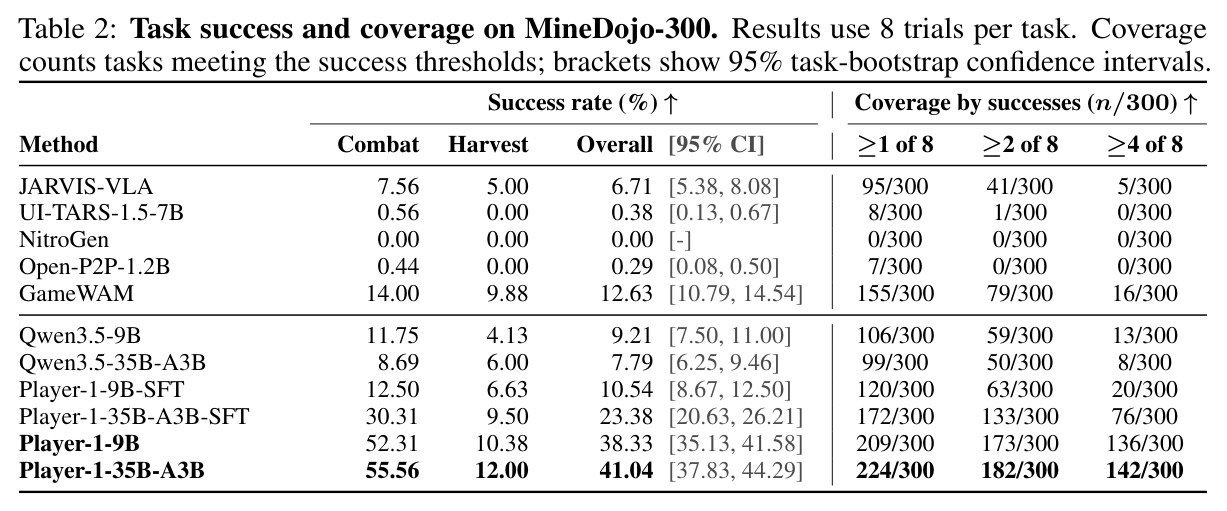
现有游戏智能体主要依赖大规模人类演示做行为克隆或预训练(Game-TARS、NitroGen、SIMA 2 等),但演示只覆盖开放任务中智能体可能遇到状态的极小一部分;而要做交互式(RL)训练,商用游戏环境封闭、程序化奖励难以规模化实现。同时,计算机使用智能体(CUA)的动作空间是为 GUI 设计的:绝对坐标点击、拖拽、滚动,无法表达游戏要求的精确瞄准(相机连续旋转)、持续输入(长按 W 奔跑)和并发操作(边移动边转身开火)。实际数据层面,各公开数据集(VPT、D2E、Pixel2Play、Gaming 500h)的输入约定、时间分辨率、鼠标灵敏度互不兼容,直接混用会产生噪声标签。结果就是:即使底座模型很强,Qwen3.5-9B 在 MineDojo-300 上也只有 9.21% 的任务成功率,最强专用模型 GameWAM 也仅 12.63%,离可用还差得很远。
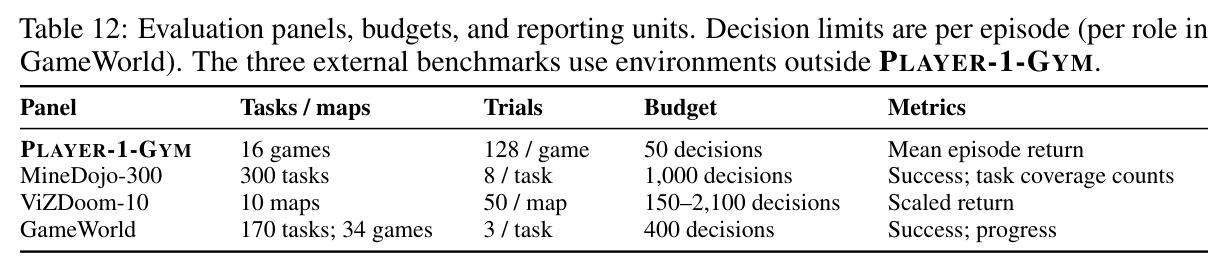
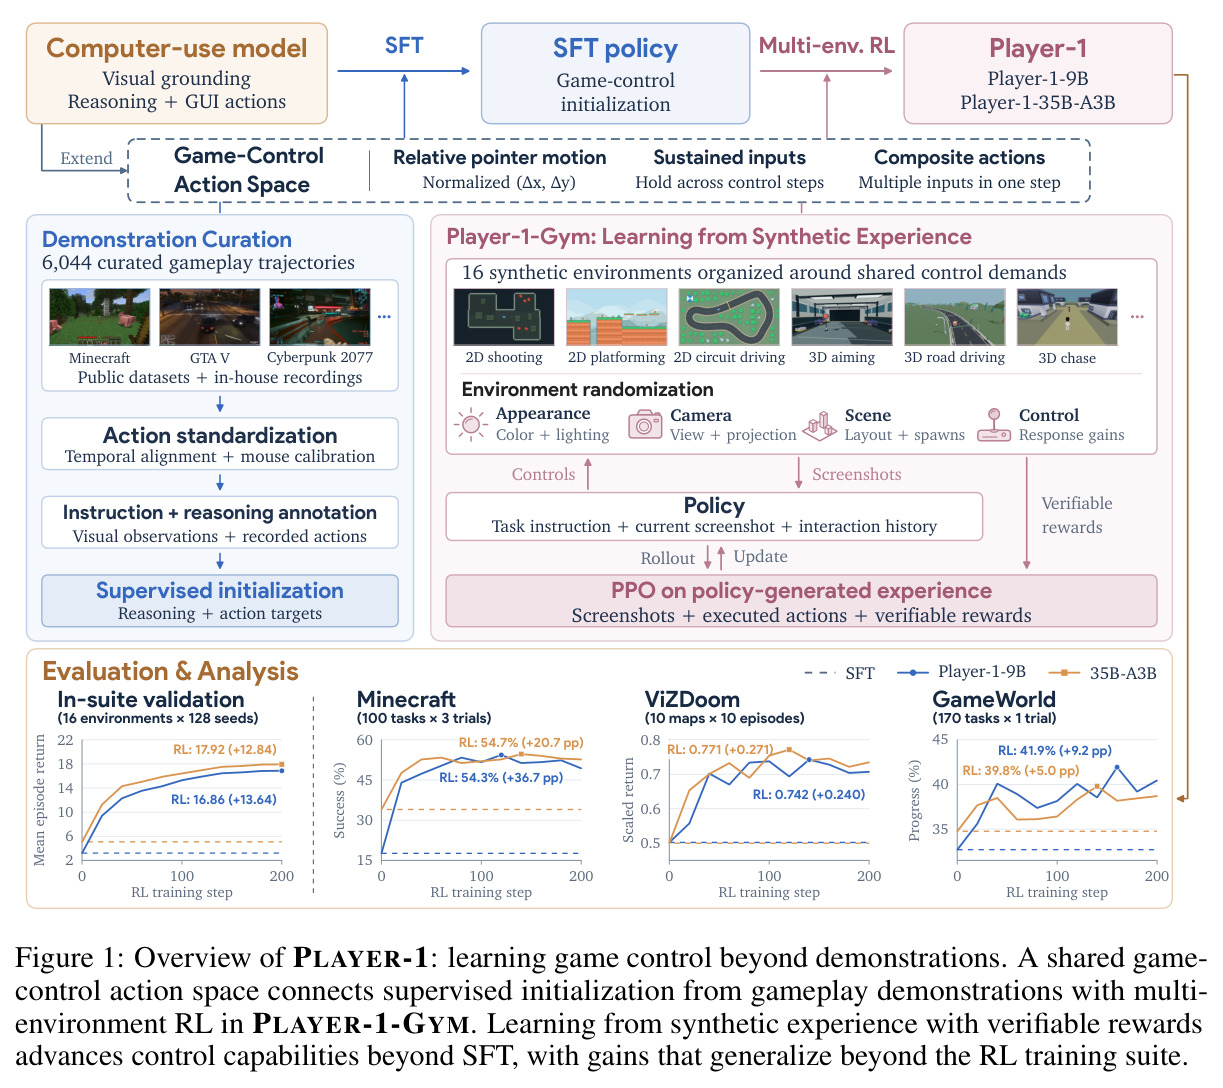
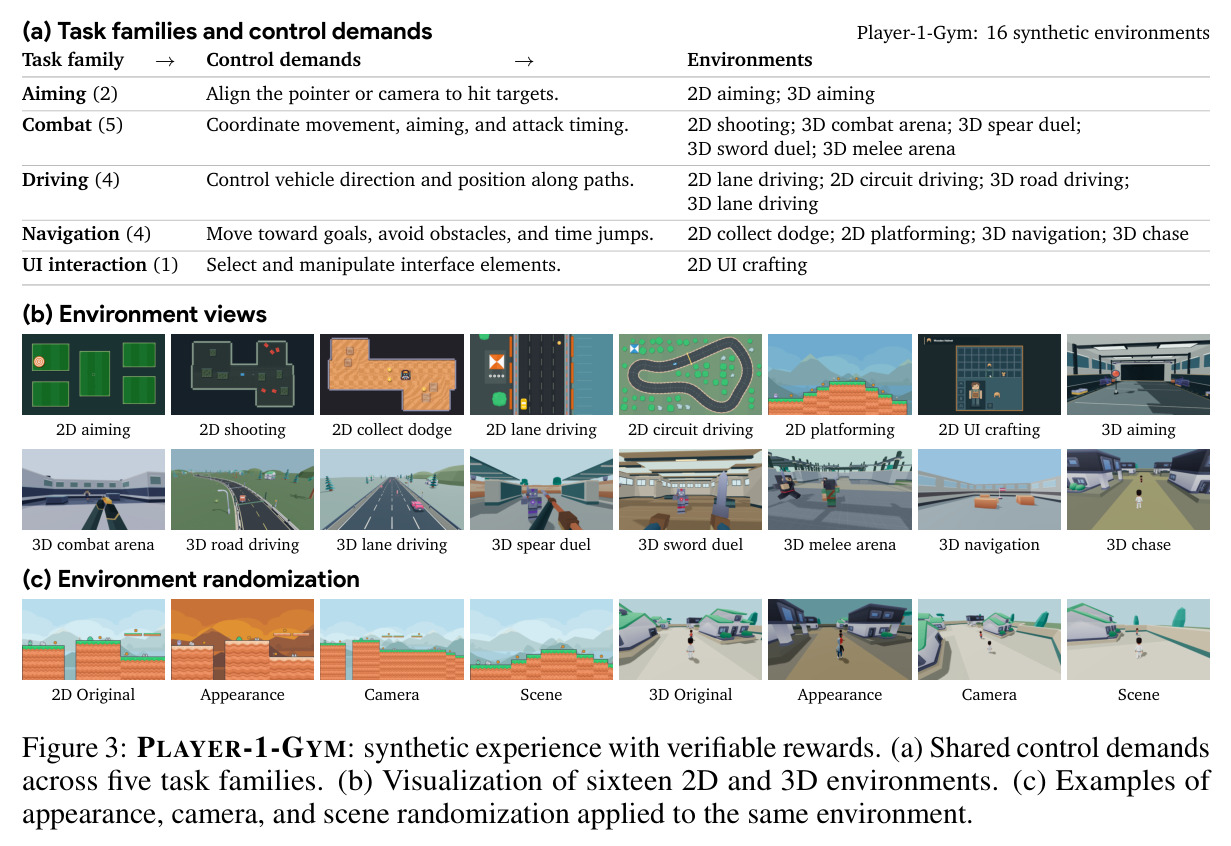
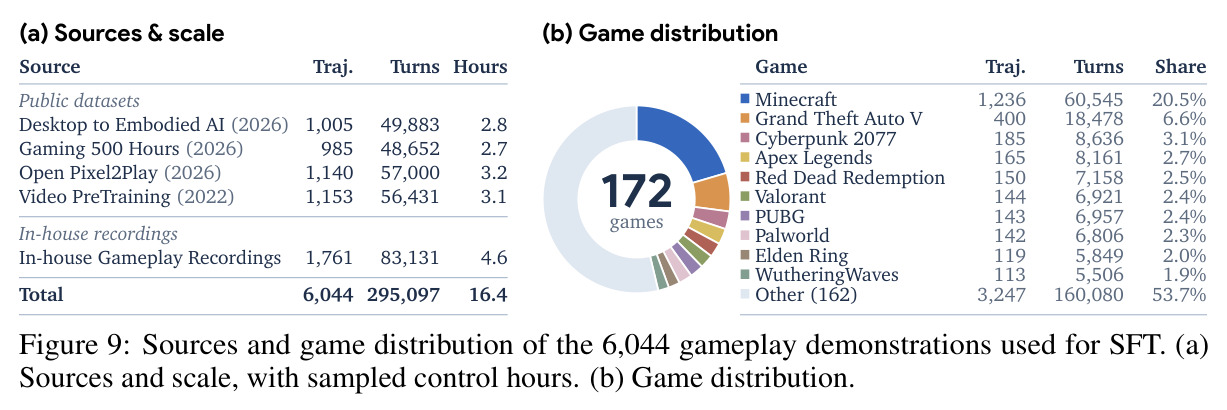
本文的目标是本文要构建一个“后训练”框架 PLAYER-1,让通用计算机使用模型掌握可迁移的游戏操控能力,并回答一个中心问题:合成经验能否把游戏操控推进到监督初始化之上,且增益泛化到 RL 训练套件之外?具体分两步:第一阶段用 6,044 条策展游戏演示轨迹(295,097 个交互回合、覆盖 172 款游戏)做 SFT,把录制动作与任务指令、逐步视觉推理配对,初始化操控先验;第二阶段构建 PLAYER-1-GYM——16 个围绕跨游戏共享操控需求(瞄准、战斗、驾驶、导航、UI 交互)设计的合成环境,用程序化可验证奖励与四维随机化做多环境 PPO。最终在 MineDojo-300、ViZDoom-10、GameWorld 三个外部基准以及未见过的商业游戏上验证。
与已有工作不同的是,本文的独特切入角度有三点。其一,不在目标游戏里做 RL,而是把“操控需求”而非“游戏本身”作为组织训练环境的单位:瞄准、战斗、驾驶、导航、UI 交互五大家族抽象成 16 个自研 2D/3D 合成环境,从根本上绕开了“在每款商业游戏里写奖励函数”的不可扩展性。其二,系统性扩展 CUA 动作空间(相对鼠标位移控制相机、跨控制步的持续按住、单步内多输入并发的复合动作),在 GUI 点击与动态游戏控制之间架起桥梁,并用 GUI 指针回归把异源数据集的鼠标灵敏度校准到像素等效坐标。其三,与 SIMA 2(真实游戏+世界模型)、Odysseus(仅 5 个 Mario 关卡做 RL)不同,本文明确主张“合成环境的覆盖广度本身是可扩展的泛化来源”,并用固定预算下 2/4/8/16 环境的缩放实验直接验证了这一主张。
核心方法
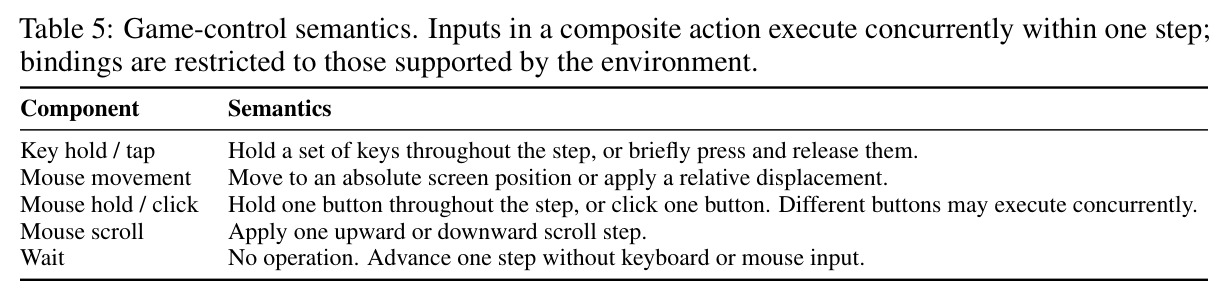
直觉是:人类玩家换游戏时复用的是“怎么瞄准、怎么走位、何时按键”这类通用操控技能,而非某个游戏的攻略。PLAYER-1 把它工程化为三步。第一步统一动作空间:鼠标支持绝对坐标($x,y \in [0,1000]$)与相对位移($\Delta x, \Delta y \in [-1000,1000]$,用于无指针的相机控制);按键支持 tap 与跨控制步的 $hold(b; \Delta t)$(一个控制步 200ms);并允许复合动作,即单步内多输入并发 $input_1 \parallel \cdots \parallel input_m$。第二步,把 6,044 条异源演示对齐到 200ms 控制步网格、按像素等效校准鼠标灵敏度,用 Gemini 3.8 Flash 标注指令与逐步推理,SFT 初始化 Qwen3.5 底座。第三步,在 16 个 Three.js 合成环境中做 PPO:奖励为分数增量 $r_{e,t} = S_e(s_{t+1}) - S_e(s_t)$,配合外观/相机/场景/控制四维随机化与按环境归一化的 GAE 优势。架构上 9B actor 为 dense、35B-A3B 为 MoE,共用 dense 9B critic。
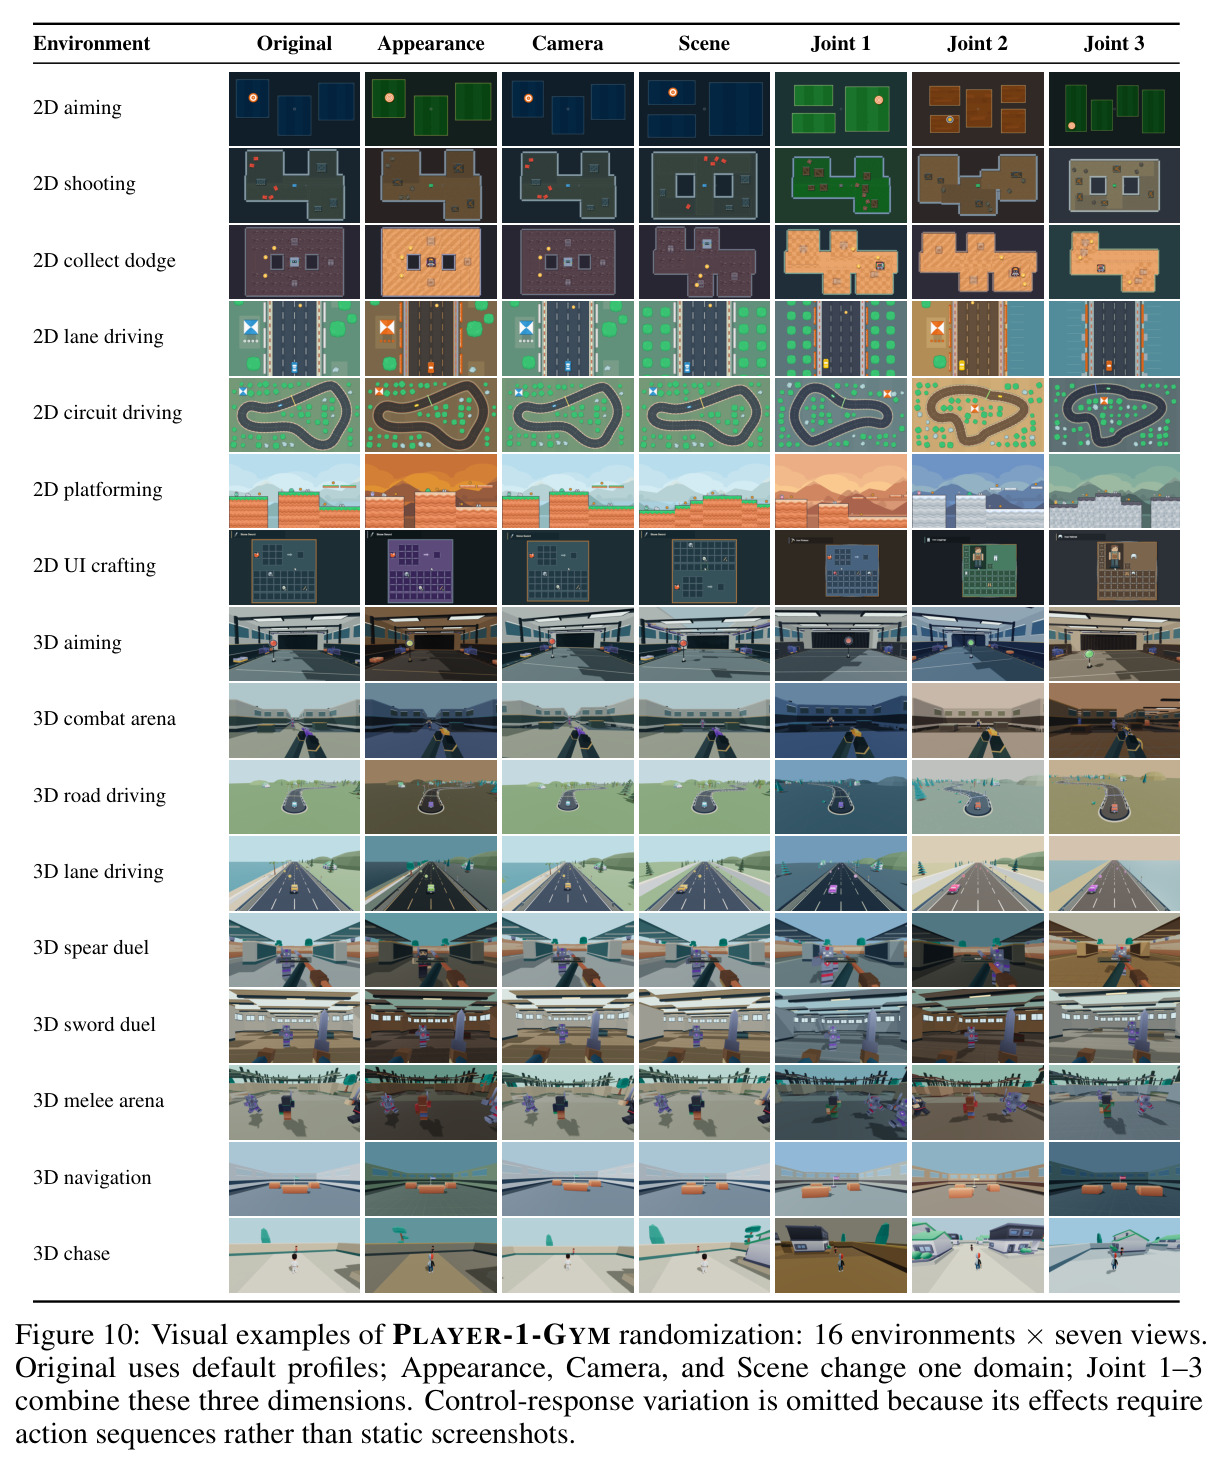
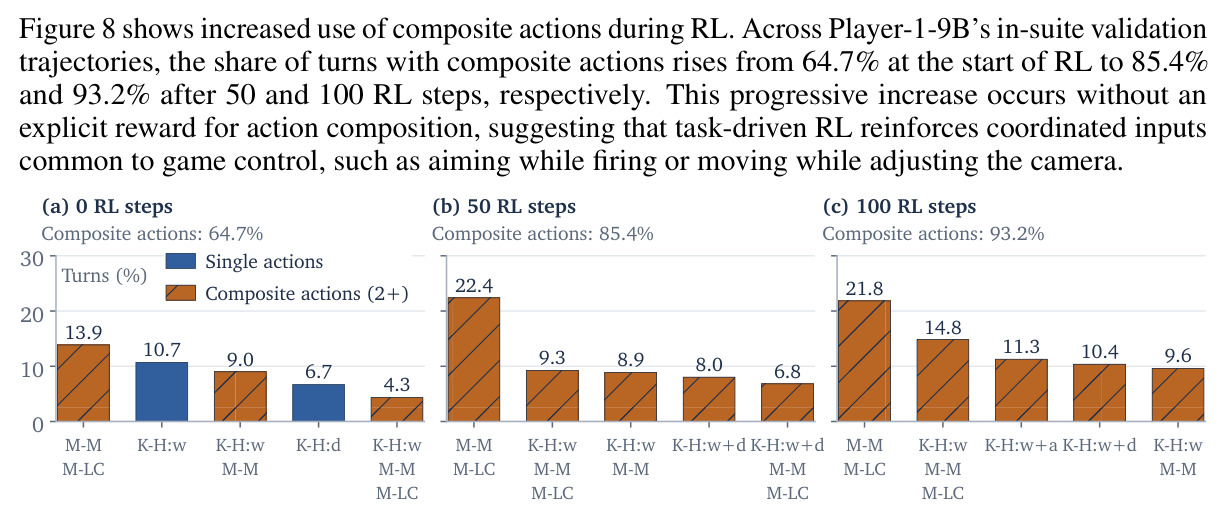
核心创新是把“合成经验”确立为可扩展的操控训练资源,与行为克隆和在单个游戏里做 RL 都有本质区别。奖励来自程序化游戏状态(分数增量即奖励、无学习型裁判),特权状态不暴露给策略,策略只看截图和文本;随机化覆盖四个维度——外观(色相偏移、饱和度 $U(0.95,1.25)$、光照)、相机(FOV 偏移 $U(-8,8)^\circ$、机位高度与俯仰)、场景(布局、出生点、任务配置)、控制(视角增益 $\text{Tri}(0.8,1,1.2)$、移动、驾驶、转向、跳跃冲量 $\text{Tri}(0.975,1,1.025)$),迫使策略学到对视觉风格、视角几何和操控手感都不敏感的技能。另一个关键设计是动作空间在 SFT 与 RL 间共享:SFT 教会模型何时使用复合动作,RL 在同一空间上继续自我提升——实验观察到复合动作占比在 RL 中从 64.7% 自发升至 93.2%,说明任务驱动的 RL 无需显式奖励就会强化“边移动边开火”这类协调输入模式。
方法步骤详情
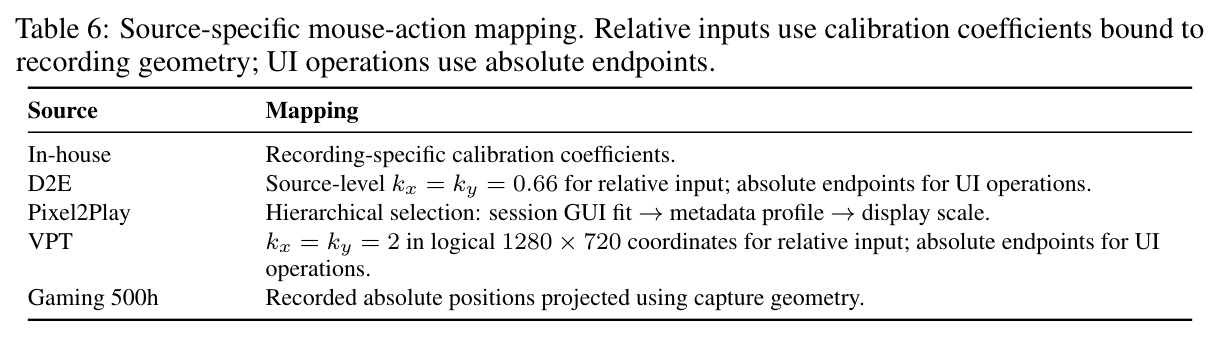
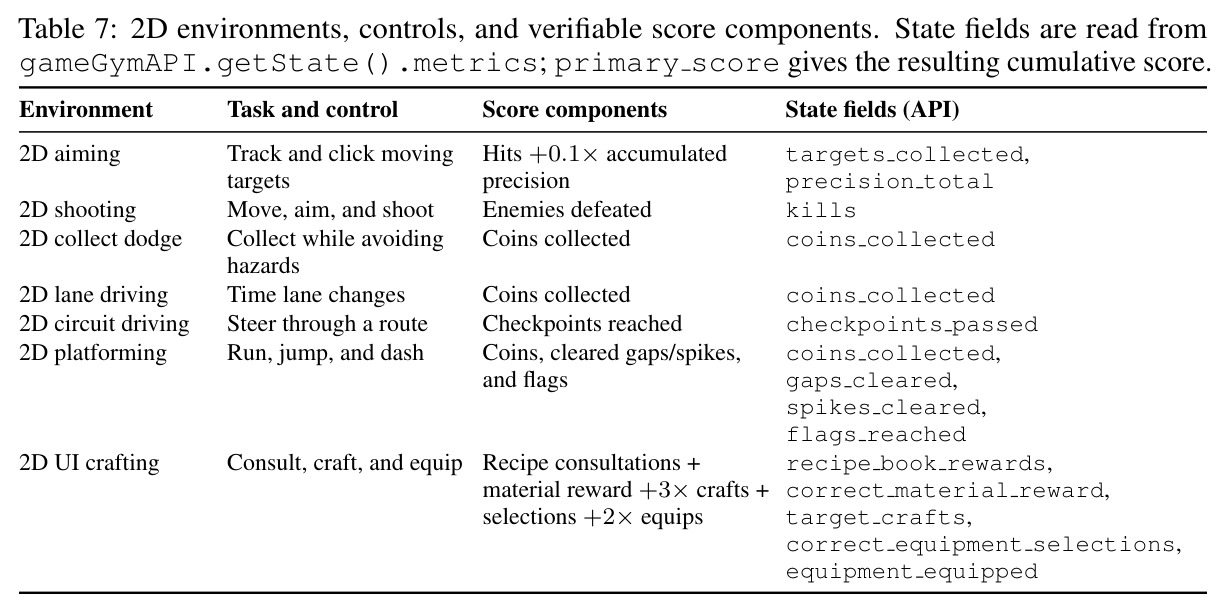
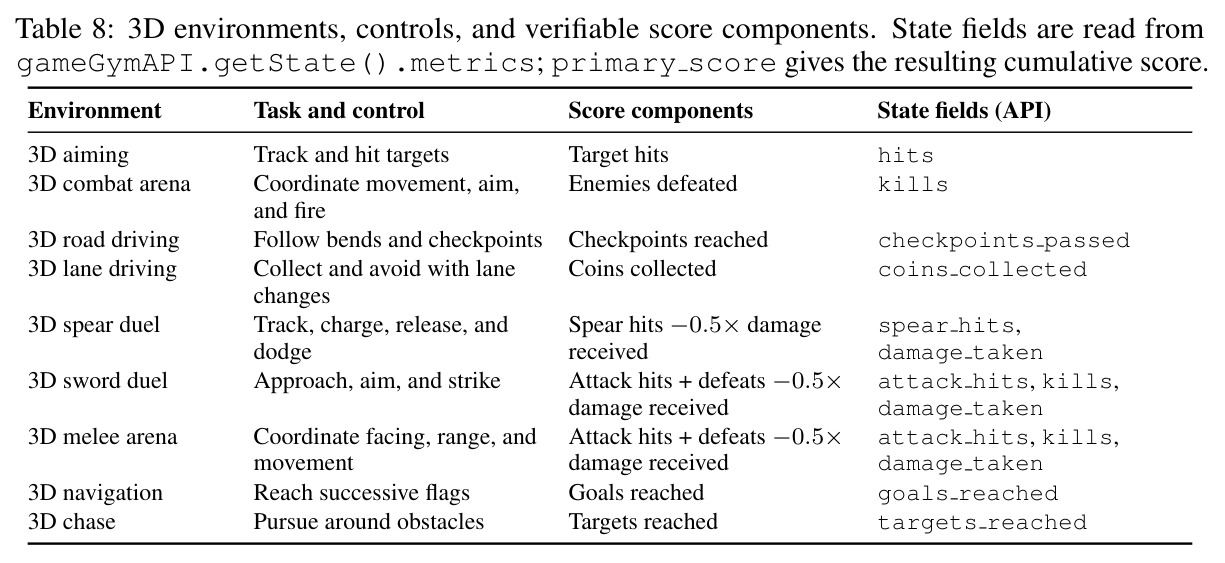
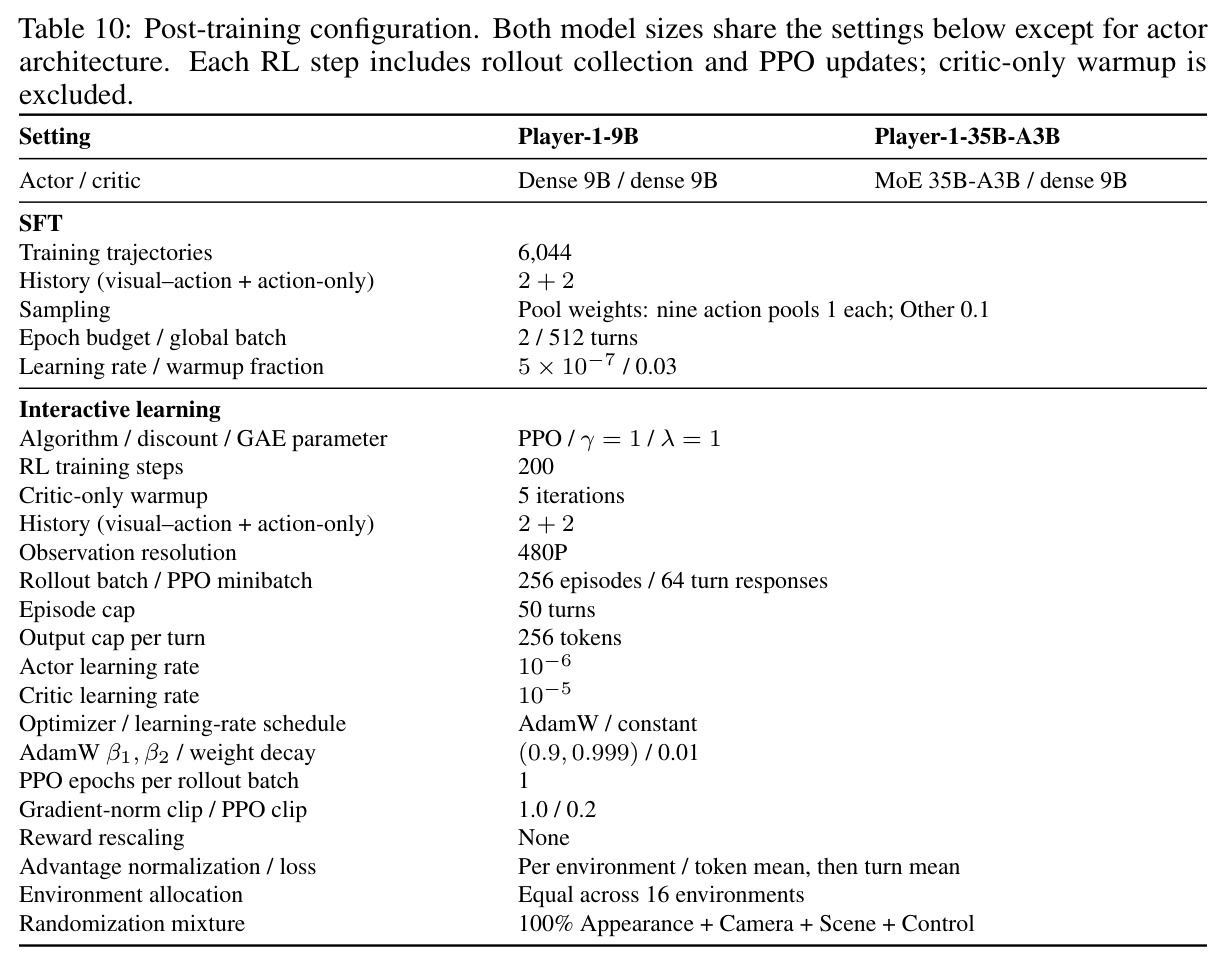
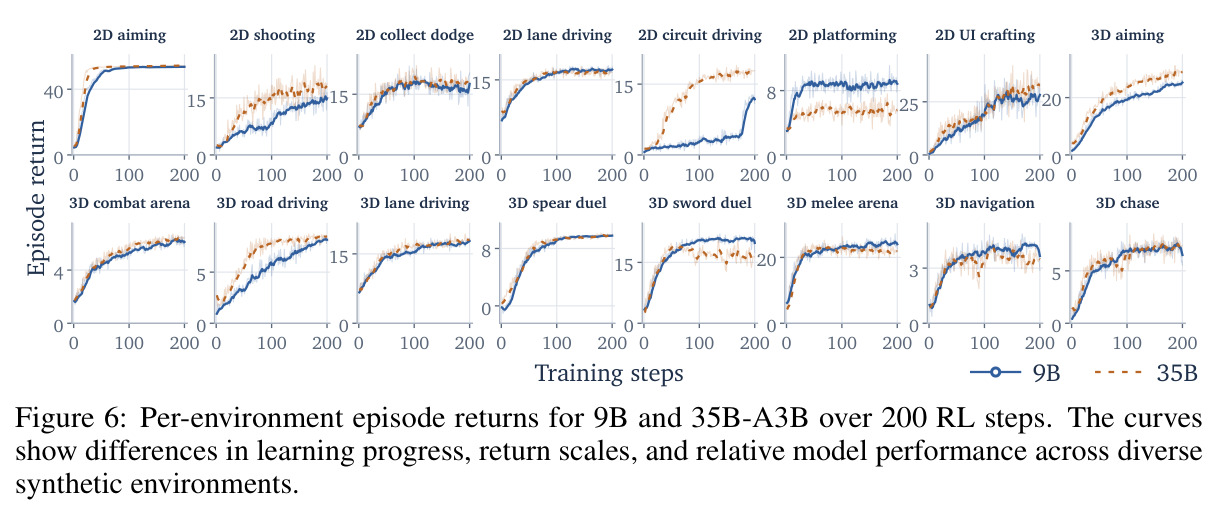
步骤一(动作扩展):定义相对鼠标位移、持续按住与复合动作的执行语义。步骤二(演示策展):从 VPT、D2E、Pixel2Play、Gaming 500h 与自采共 2,544 个会话、172 款游戏收集 6,044 条轨迹;时间对齐把源区间投影到 200ms 网格(按键 <100ms 记 tap、更长记 hold,鼠标按压 ≤300ms 记 click);空间对齐用同会话 GUI 指针回归校准 $\Delta x = \text{round}(1000 k_x r_x / W_m)$;再用 Gemini 3.8 Flash 标注任务指令与逐步推理。步骤三(SFT):输入为指令、截图与 2+2 历史,监督推理与动作;2 epoch、lr $5 \times 10^{-7}$、九类动作池平衡采样。步骤四(RL):每步 256 条 rollout 均分 16 环境、每回合 ≤50 回合;奖励 $\tilde{r}_{e,t} = r_{e,t} - p_{invalid} - p_{length}$,$\gamma = \lambda = 1$ 的 return-to-go 保留跨回合信用;优势先全局再按环境归一化;PPO clip 0.2,共 200 步。步骤五:在三个外部基准分别以 8/50/3 次试验评测。
技术新颖性
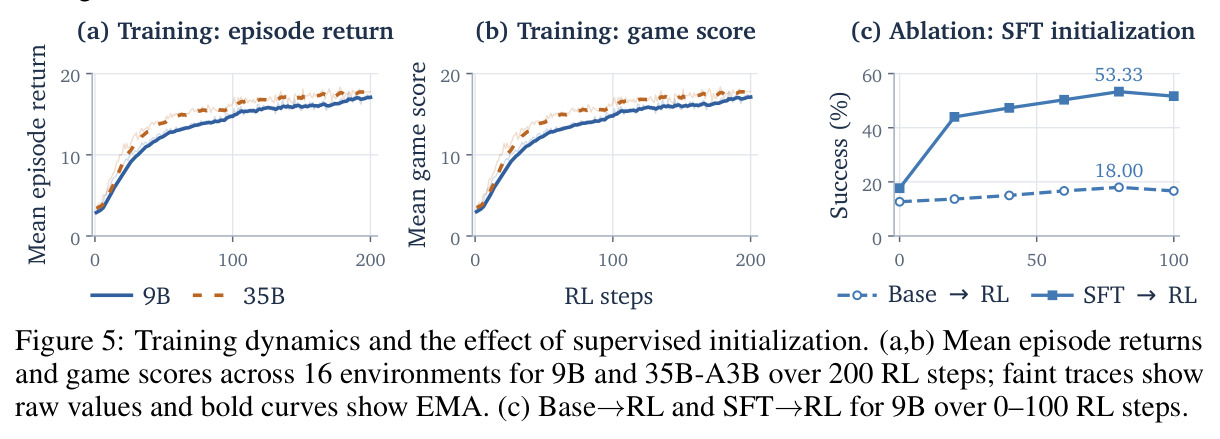
表征层面:相对鼠标位移 + 持续输入 + 复合动作的统一动作空间是连接 CUA 与游戏控制的关键桥梁——此前工作要么用游戏专用接口(JARVIS-VLA、GameWAM 用度数相机动作),要么只支持绝对点击(UI-TARS 系);跨数据源的像素等效鼠标校准(GUI 指针拟合系数,越界投影直接丢弃而非裁剪)也是少见的数据工程细节。环境层面:以“操控需求”而非“游戏类型”组织合成环境套件,配合四维随机化与可验证分数奖励,与 Agent-World 的通用任务合成、Genie 3 世界模型路线都不同;16 个环境跑在同一自研 Three.js 运行时上,观测/动作接口一致,便于扩展。训练层面:按环境归一化 GAE 优势解决多环境奖励尺度差异,损失先在回合内对 token 平均、再对回合平均(式 4),使各环境按其回合数成比例贡献梯度;消融进一步表明 SFT 初始化是 RL 起飞的前提(Base→RL 100 步仅 16.67% vs SFT→RL 51.67%,相差 35 个百分点),说明该框架的增益来自“演示初始化 + 合成经验”的组合而非 RL 本身。
实验结果
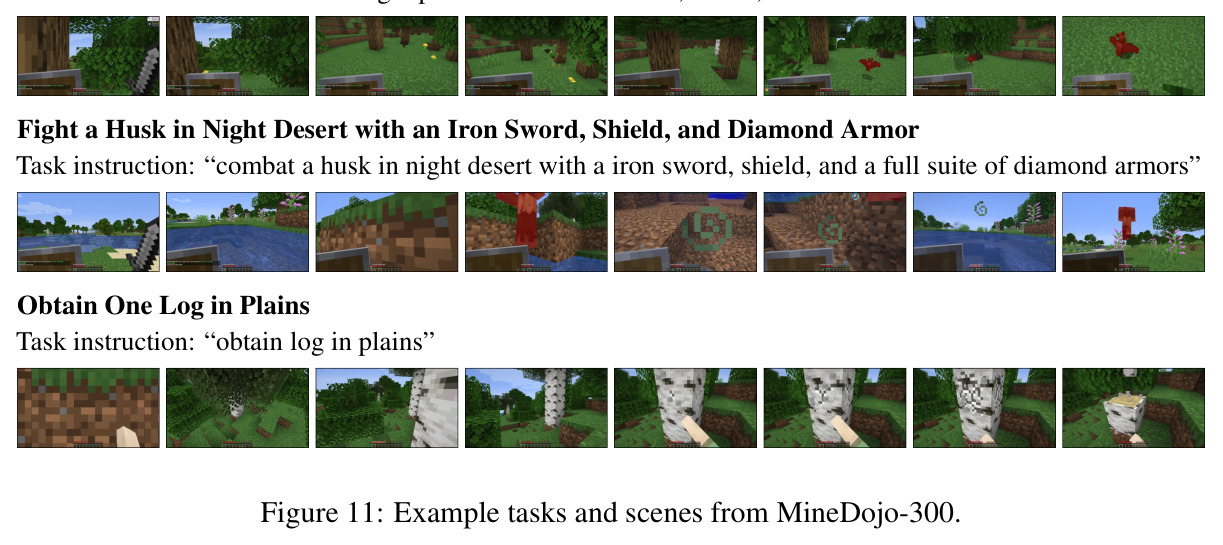
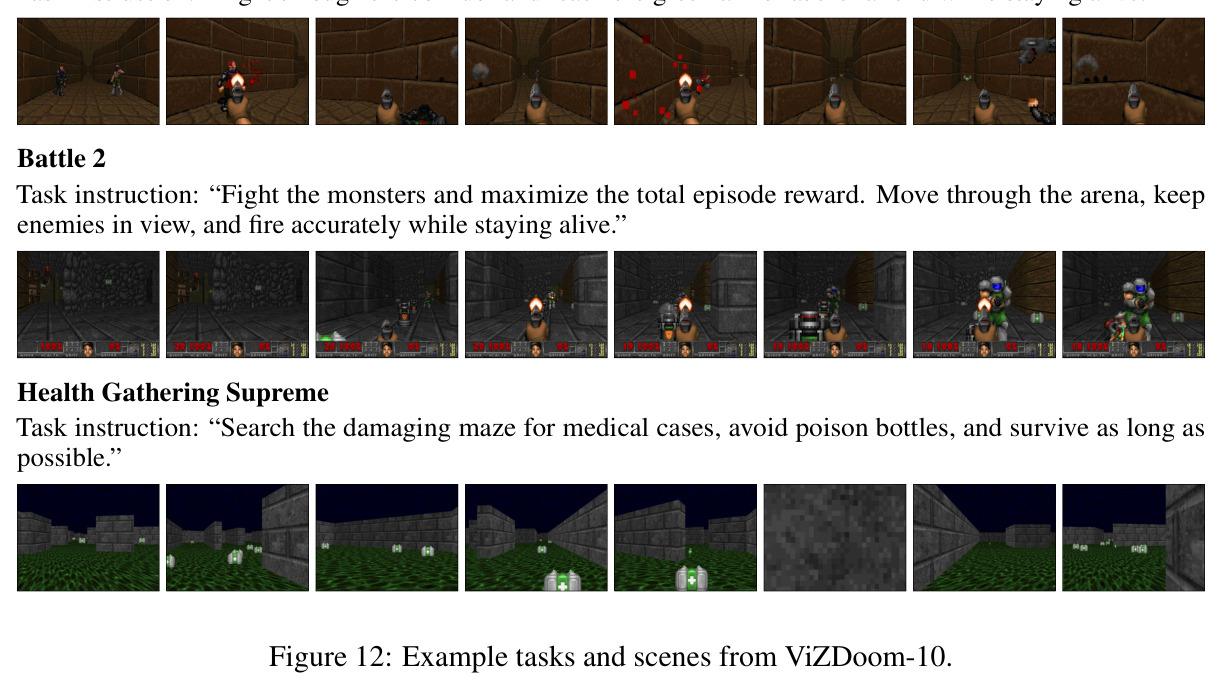
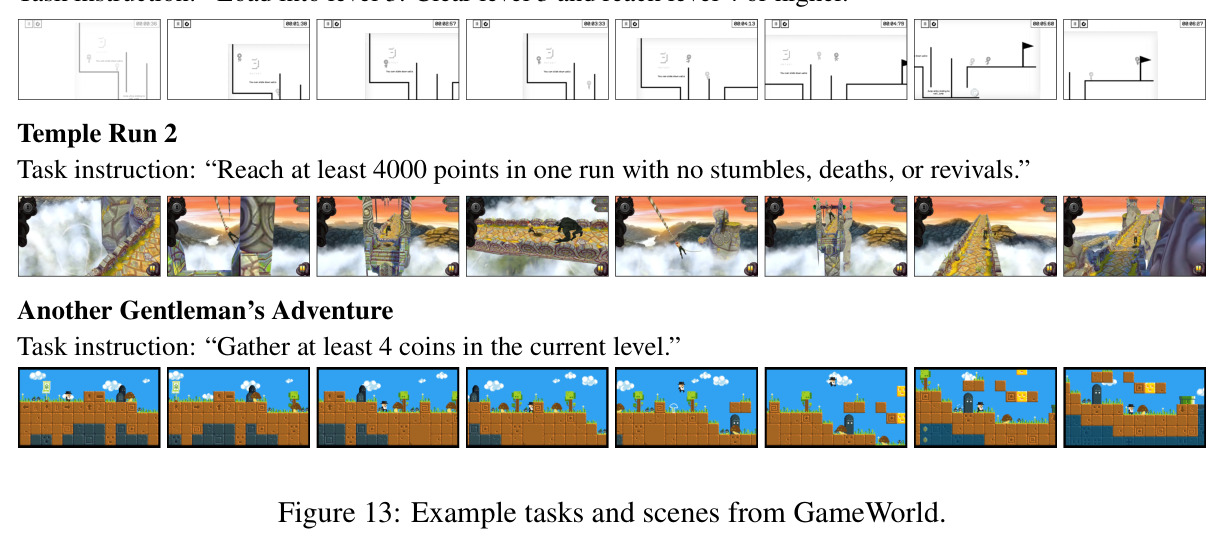
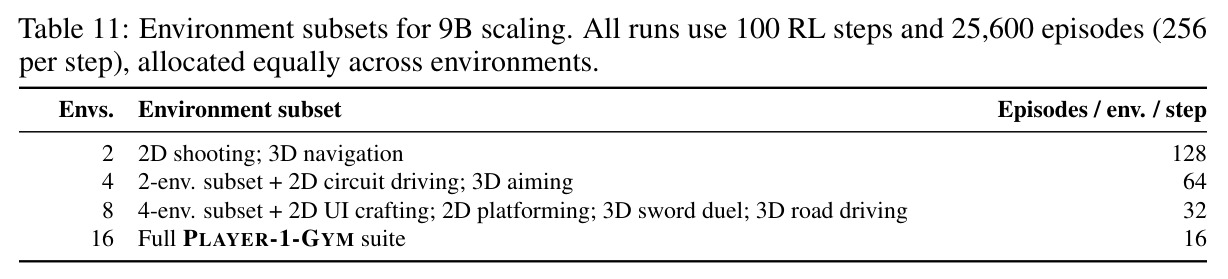
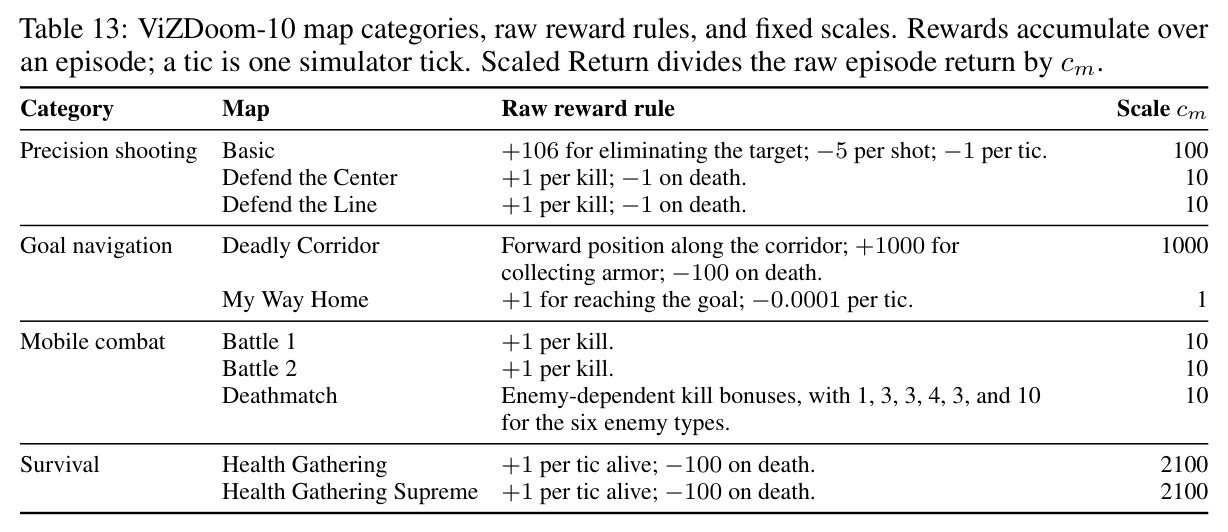
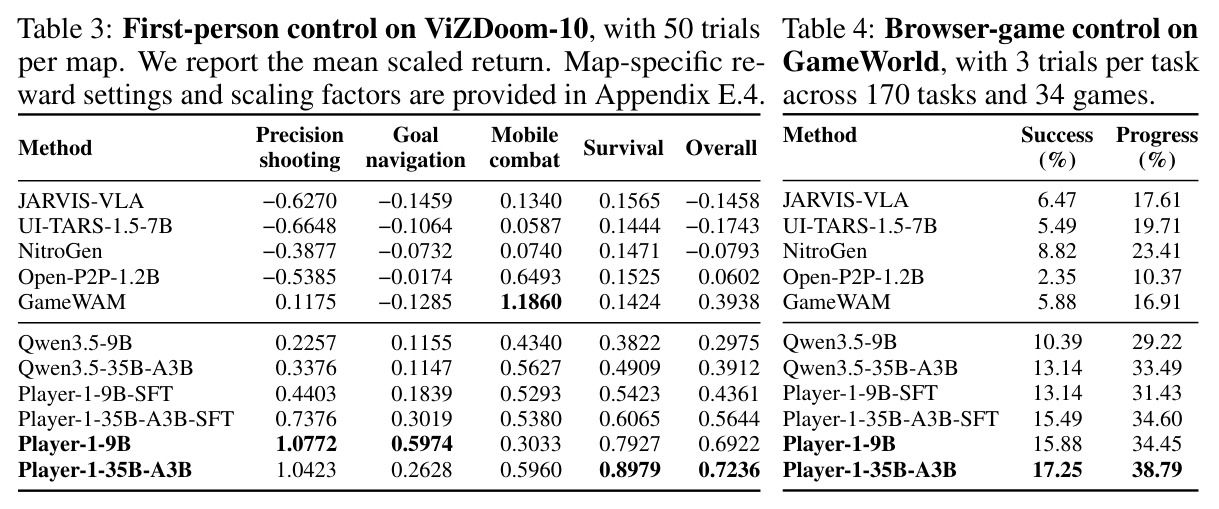
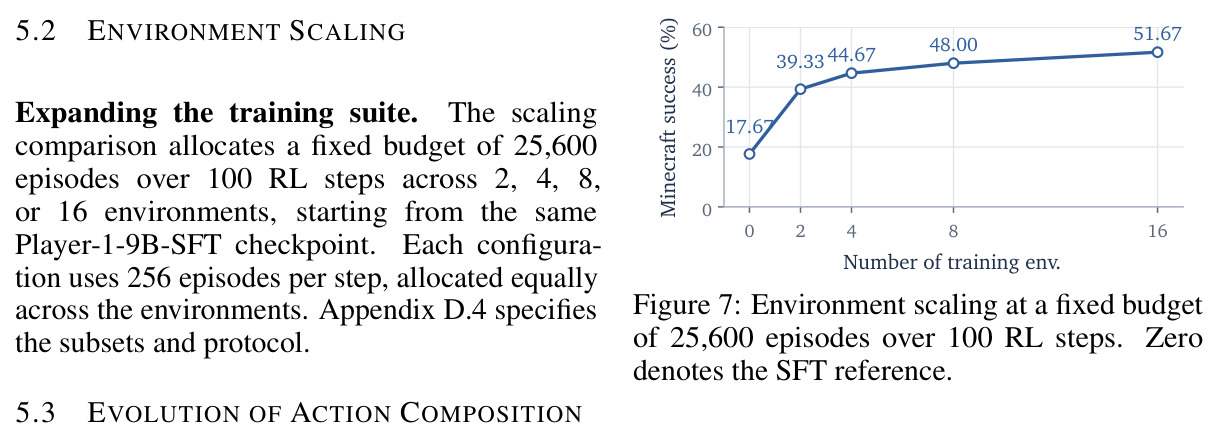
逐一分析。(1) MineDojo-300:Player-1-9B 成功率从 SFT 的 10.54% 升至 38.33%(+27.79pp),35B-A3B 从 23.38% 升至 41.04%(+17.66pp),远超最强外部基线 GameWAM 的 12.63%;≥4/8 次成功的任务覆盖从 20 涨到 136/300(9B)、142/300(35B);战斗类暴涨(9B 52.31%、35B 55.56%)而采集类仅 10.38%/12.00%。(2) ViZDoom-10(训练套件之外):9B 平均 scaled return 从 0.4361 升至 0.6922,35B 达 0.7236,比 GameWAM 的 0.3938 高 83.7%;精度射击与生存提升最大,但 9B 移动战斗从 0.5293 降到 0.3033。(3) GameWorld:9B 成功 13.14%→15.88%、进度 31.43%→34.45%,35B 达 17.25%/38.79%,全部强于最佳基线 NitroGen(8.82%/23.41%)。(4) 分析实验:SFT→RL 100 步把 Minecraft 开发集成功率从 17.67% 推到 51.67%,Base→RL 只到 16.67%;固定预算下环境数 2/4/8/16 对应 39.33/44.67/48.00/51.67%;复合动作占比从 64.7% 升至 93.2%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MineDojo-300(Minecraft 任务 directed control) | 任务成功率 (%) | 38.33(Player-1-9B,SFT 后 10.54) | 12.63(GameWAM,最强外部基线) | +25.70pp 对最强基线;对自身 SFT +27.79pp |
| MineDojo-300(35B-A3B 规模) | 任务成功率 (%) | 41.04(Player-1-35B-A3B,SFT 后 23.38) | 23.38(Player-1-35B-A3B-SFT) | +17.66pp(RL 阶段增益) |
| ViZDoom-10(第一人称控制,训练套件外) | 平均 scaled return | 0.7236(Player-1-35B-A3B);0.6922(Player-1-9B) | 0.3938(GameWAM,最强外部基线) | +83.7% 对 GameWAM;9B 对自身 SFT +0.2561 |
| GameWorld(34 款浏览器游戏,训练套件外) | 成功率 (%) / 进度 (%) | 17.25 / 38.79(Player-1-35B-A3B);15.88 / 34.45(9B) | 8.82 / 23.41(NitroGen,最强外部基线) | 成功率约翻倍对 NitroGen;对自身 SFT +1.76∼4.19pp |
| 环境数量缩放(固定 25,600 episodes 预算) | Minecraft 成功率 (%) | 2 环境 39.33 → 16 环境 51.67 | 17.67(SFT 参考,0 环境) | 覆盖从 2 扩到 16 环境再 +12.34pp,验证覆盖度即泛化 |
局限与改进
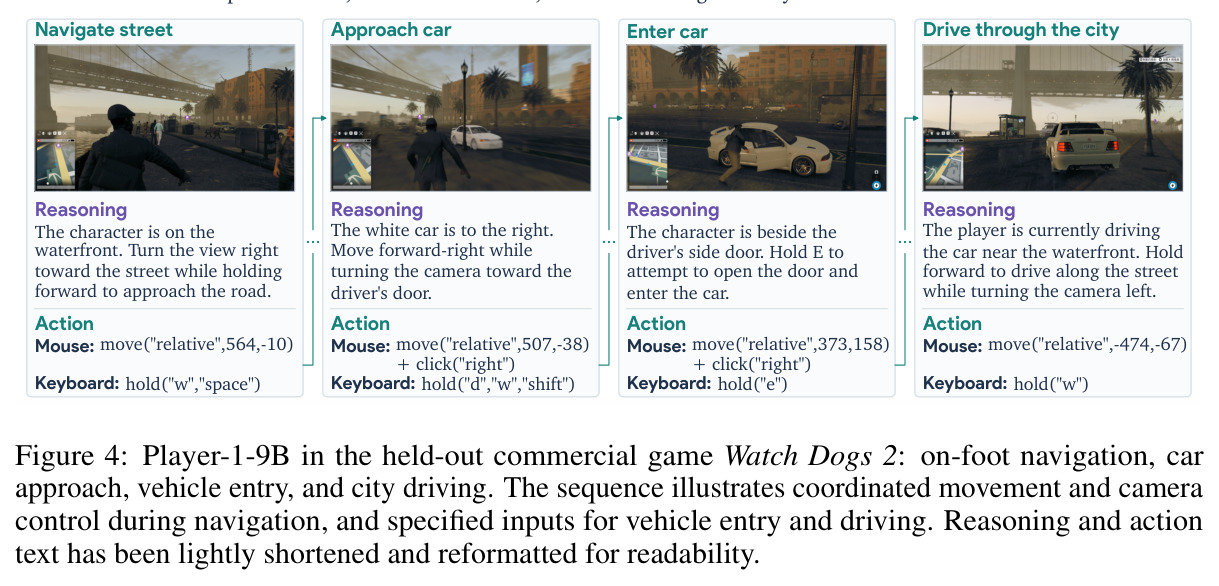
作者承认且数据可见的局限:(1) 采集类(Harvest)任务提升有限,9B 仅 10.38%(GameWAM 为 9.88%),RL 增益高度集中在战斗类——16 个合成环境中瞄准+战斗占 7 个,长程收集与制作类技能覆盖不足;(2) GameWorld 上增益温和(9B 成功率 +2.74pp),对界面复杂、规则各异的浏览器游戏迁移有限;(3) 存在类别间权衡:9B 在 ViZDoom 移动战斗从 SFT 的 0.5293 降至 0.3033,35B 的目标导航从 0.3019 微降到 0.2628,多环境联合训练并非处处为正;(4) 商业游戏迁移只有 Watch Dogs 2 的定性演示,无量化指标;(5) 评测成本极高——全协议每模型约 314 万决策回合、按 GPT-6 Astra 牌价估算约 11 万美元,因此未与专有 API 模型比较。我的补充观察:合成环境的物理与视觉复杂度远低于真实游戏,迁移的大概率是低层控制先验而非高层规划;奖励全为计数型分数增量,存在刷分捷径风险;相机适配器增益固定 0.00196 弧度/像素,对不同手感游戏的适配未做系统研究。
独立分析的弱点
(1) 演示数据偏薄:6,044 条轨迹按“回合×200ms”折算仅约 16.4 小时采样控制时长,摊到 172 款游戏平均每款不足 6 分钟,长尾的 162 款游戏合计占 53.7%,标注质量与动作覆盖难以保证——可按控制需求主动补采,或用模型自身在合成环境生成带注释的合成演示。(2) UI 交互环境只有 1 个(2D UI crafting),与真实游戏的背包、制作树、NPC 对话差距过大,很可能是 MineDojo 采集类任务疲软的根因——应增加物品管理、多步制作、菜单导航类环境。(3) 奖励即时且 $\gamma=\lambda=1$ 无折扣,50 回合上限内的后期信用分配可能引入噪声——可对比折扣回报或轨迹级优势估计。(4) 两种 actor 共用 dense Qwen3.5-9B critic,35B-A3B(MoE)actor 的价值估计容量可能不匹配,制约大模型的 RL 上限——可尝试 MoE critic。(5) 复合动作组合空间随输入数指数增长,探索完全依赖 SFT 先验(Base→RL 几乎不涨,12.67%→16.67%)——可引入动作先验或课程式逐步开放复合动作。
未来方向
作者明确指向的方向:继续扩大训练环境套件(2→16 环境在固定预算下单调增益,暗示 16 之外仍有空间);更系统的迁移分析;与 world model 路线(如 SIMA 2 的 Genie 3)互补结合。基于本文成果可自然延伸的研究:(1) 自进化环境合成——检测策略弱点(如 Harvest 弱、移动战斗退化),按操控需求自动生成针对性新环境,形成“策略-环境”共同进化闭环;(2) 层次化架构——用 LLM 规划器做任务分解,把 Player-1 作为低层操控控制器调用,攻克 MineDojo 长程任务树;(3) 把“瞄准-移动-时机”同构性推广到具身智能/机器人操作,检验合成操控经验是否跨具身形态迁移;(4) 因果性地研究复合动作使用与成功率的关系,设计显式的协调输入奖励或课程;(5) 建立商业游戏量化评测协议(多款 3A 游戏、固定任务集),替代目前单一的定性 Watch Dogs 2 案例并研究相机增益自适应。
复现评估
开源情况良好:代码在 github.com/TencentARC/Player-1,项目页 player-1-project.github.io,模型基于公开的 Qwen3.5-9B / Qwen3.5-35B-A3B。SFT 数据中 VPT、D2E、Pixel2Play、Gaming 500h 均为公开数据集,但自采的 1,761 条轨迹(占 29%)未必放出;标注依赖 Gemini 3.8 Flash 有 API 成本;附录 B 给出完整的时间对齐规则与逐源鼠标校准方法。PLAYER-1-GYM 为自研 Three.js 运行时,附录 C 表 7–10 详列 16 个环境的任务、奖励分量与四维随机化分布,规格足够重建。算力门槛高:SFT 需 32×H200 约 24 小时,200 步 RL 需 64×H200 约 36 小时,rollout 需 512 个并发 Playwright 浏览器环境;完整评测每模型约 314 万决策回合。综合评级:复现难度中高——文档与代码披露充分,门槛主要在 H200 集群和浏览器 rollout 基础设施;只复现 9B、缩减环境数(2 个环境也能到 39.33%)可大幅降低成本。
论文图表