MolLean:一种过程可验证的化学推理语言 MolLean: A Process-Verifiable Language for Chemical Reasoning
用 Lean 内核逐步验证分子状态转移,让化学思维链的每个声明可检查、可修订
前置知识
Lean 定理证明器
Lean 是微软开发的交互式定理证明器与编程语言。其核心特点是证明的构造与检查分离:模型或人类写出候选证明,内核按严格的类型论规则逐步检查每一步推导是否成立,不成立则拒绝并给出错误位置。数学形式化的 AI 工作(如 AlphaProof)正是利用这一机制为 LLM 提供客观的步骤级反馈。
MolLean 的化学内核直接构建在 Lean 4 之上,价态、连通性等结构检查都由 Lean 证明与执行,理解这一『提议-检查』范式是理解全文的基础。
思维链与过程可靠性
思维链(Chain-of-Thought, CoT)让 LLM 在给出最终答案前显式输出中间推理步骤。但中间步骤的正确性并无保证:即使答案正确,推理过程也可能包含编造的声明(如声称分子含有并不存在的官能团)。过程可靠性指推理轨迹中每一步声明是否成立,与最终答案正确性是两个独立的维度。
本文的出发点正是化学 CoT 中的幻觉结构声明问题,其核心指标『过程健全性』(soundness)就是过程可靠性的形式化度量。
分子图与 SMILES 表示
分子可以表示为带标记的图:原子为节点(标记元素、形式电荷、自由基、芳香性),化学键为边(标记键级)。SMILES 是用字符串线性编码该图的通用记法。价态规则约束每个原子可形成的键数(如碳最多 4 键),Tanimoto 相似度基于 Morgan 指纹衡量两个分子子结构集合的重叠程度。
MolLean 的状态就是分子图的集合,七种原语操作对应图编辑,优化任务评分使用半径 2、2048 位的 Morgan 指纹 Tanimoto 相似度。
MCP 与工具增强推理
MCP(Model Context Protocol)是让 LLM 在生成循环中调用外部工具的标准接口:模型根据 function-calling schema 发起调用,工具返回结果后模型继续决策。与一次性生成不同,有状态工具接口允许模型先查询当前状态再决定下一步操作,被拒绝的调用不改变状态。研究表明外部工具反馈比模型自我纠错更可靠。
MolLean-MCP 是论文的三种推理接口之一,它把语言中的转移、检查、读出暴露为有状态工具,是交互式验证反馈的载体。
研究动机
化学推理任务中,LLM 的思维链虽然让中间步骤可见、便于化学家审查,但中间声明本身毫无约束:模型可以引用分子中不存在的官能团、在编辑中弄丢一条键、或者声称某性质改善了却从未真正建立这一事实。已有分析(Li et al., 2026b)发现即使最终答案正确,模型也会编造结构声明;更广泛的评测 ChemBench(Mirza et al., 2025)显示模型化学能力参差不齐且普遍过度自信。这类错误针对的是『声明的化学内容本身』,与因果不忠实性(解释歪曲了答案的实际产生过程,Turpin et al., 2023)互补:即便解释忠实地反映了生成过程,其中的化学断言仍可能是假的。化学 agent(ChemCrow、Coscientist)虽有工具,但连续操作之间缺乏共享的分子参照物和显式的接受条件,一个编辑操作到底作用于哪个分子、什么才算成功,全靠自然语言约定。
本文的目标是作者提出核心问题:一个化学推理语言必须表示什么,才能让它的步骤可验证?目标是构建一种以持续维护的分子状态为基础的过程可验证语言:每个操作都引用当前状态,验证器判定其可采纳性,只有被接受的转移才提交新状态;读出与断言在不修改状态的前提下观察它。同时要把原生可查的结构性质(原子计数、价态、芳香性)与依赖外部测量的声明(RDKit 描述符、知识查询)在证据形式上显式分开,并提供整轨执行与交互式调用两种反馈机制,让被拒绝的承诺可以被系统性地修订。
与已有工作不同的是,既有工作分为两条互不相通的路线。其一是化学工具 agent:ChemCrow 与 Coscientist 证明了工具对化学 agent 的价值,但操作序列没有统一的形式合同,反馈语义模糊;XDL 能表达合成流程,却面向实验室编译而非推理验证。其二是形式化方法:Lean 数学证明(Draft-Sketch-Prove、LeanDojo)和程序增强生成(PAL、Program of Thoughts)让步骤可执行可查,但处理的是数学对象而非分子图。MolLean 的独特切入点是:把图变换、结构观测、经验估计和候选选择统一进一种语言,用类型化见证协议把外部测量结果接入 Lean 谓词检查,并显式区分『过程健全』与『任务保真』这两个常被混为一谈的评价维度。
核心方法
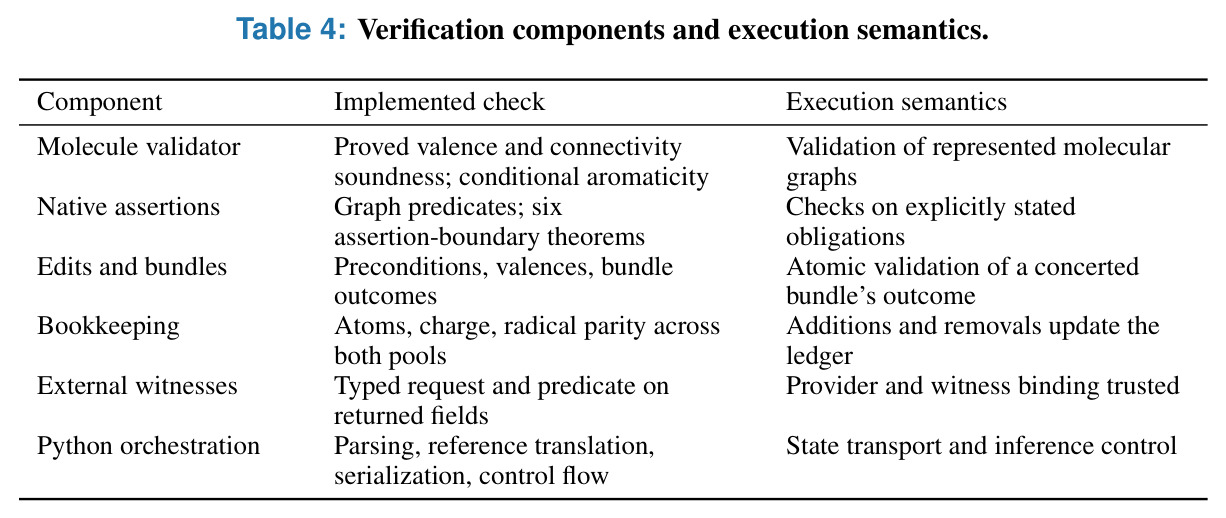
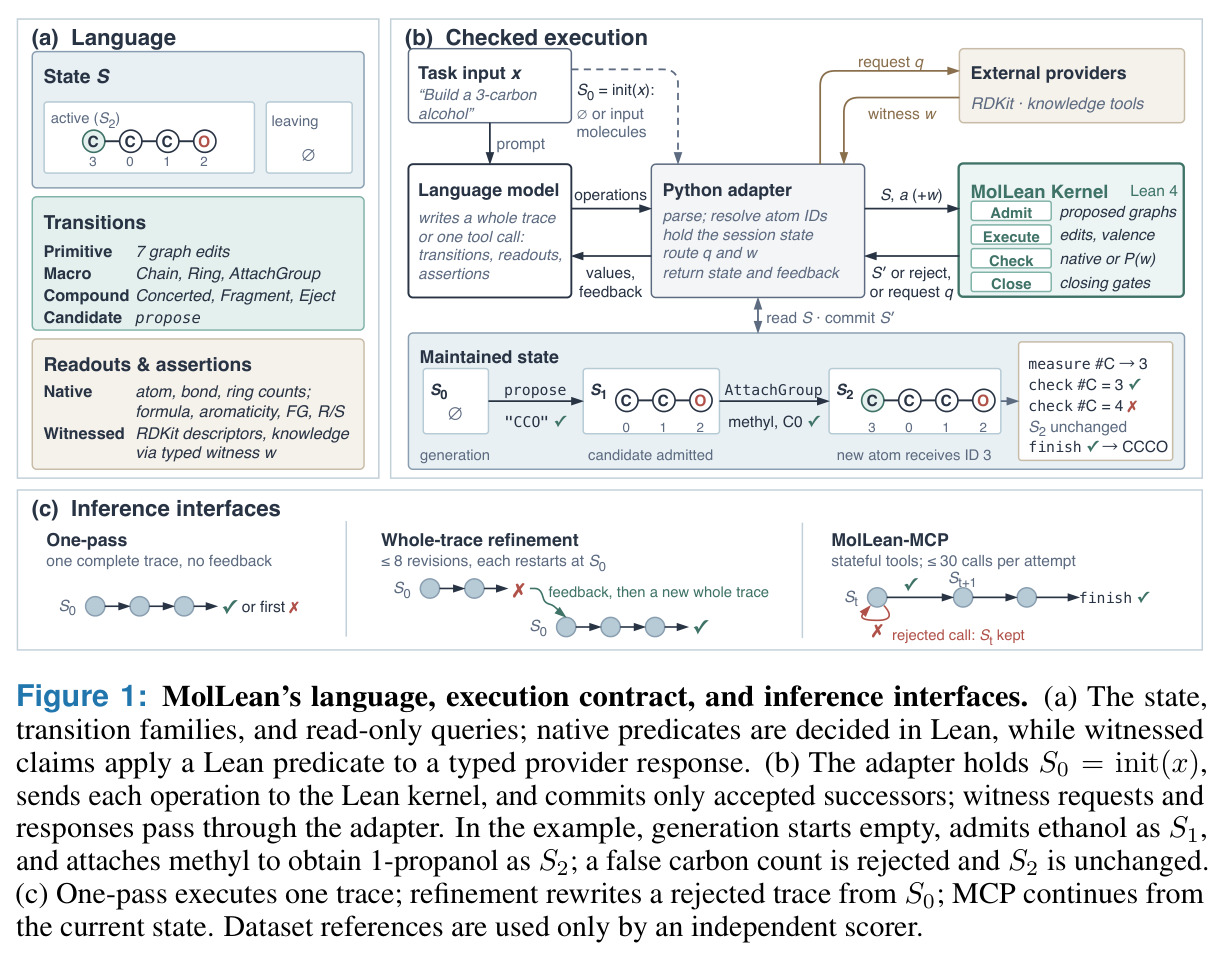
直觉上,MolLean 把『模型写化学推理』变成『模型写程序、Lean 内核来跑』:模型不再自由文字地声称分子结构变化,而是声明一个个显式操作,内核逐步检查。语言围绕三个概念组织:状态 $S$(活跃分子、离去池、原子引用、记账计数器,分子是带元素/键级/电荷/自由基/芳香性标记的图);转移 $a_t$(构造、修改或重组分子);读出与断言(观察状态而不改动它,断言约束读出结果,如要求某计数或性质改进)。形式化为一层执行合同:$V_{\Gamma,W}(S_{t-1}, a_t) = \text{accept}(S_t, o_t)$ 若 $a_t$ 在 $S_{t-1}$ 中通过检查,否则 $\text{reject}(r_t)$ 且状态保持 $S_{t-1}$ 不变——被拒绝的操作不留任何痕迹,这一语义是后续两种反馈机制的关键。工程上 Lean 4 实现化学核心( admits 提议的图、执行编辑与价态检查、原生或 $P(w)$ 断言),Python 适配器负责解析、持有会话状态、解析原子 ID 引用,并在模型、内核与外部见证提供者(RDKit、知识工具)之间路由请求 $q$ 与见证 $w$。
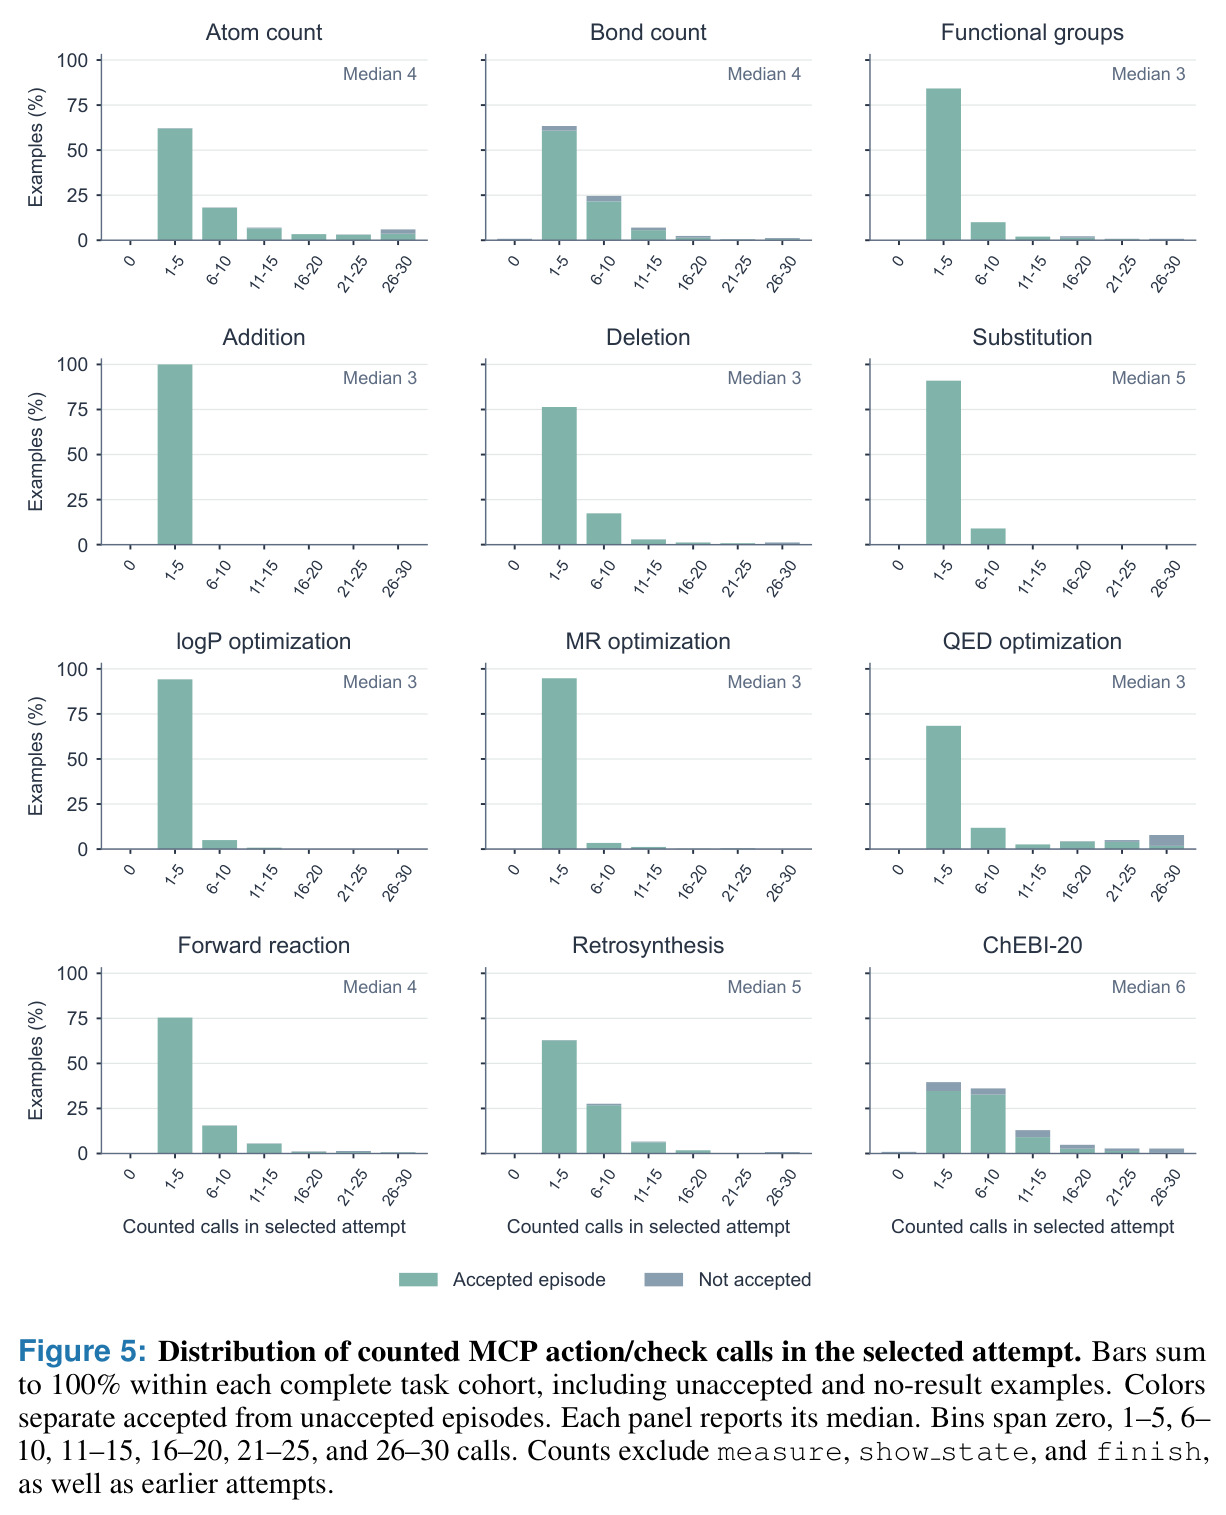
第一,状态接地与拒绝不变语义:操作引用当前维护的分子状态,一个被接受的编辑为后续检查提供参照物(后续原子 ID 指向它),被拒绝的编辑则完全不改变状态,因此验证直接施加在模型自己声明的承诺上。第二,类型化见证协议:对断言 $a$,按 $q = \text{request}(S, a)$、$w = W(q)$、$\text{accept}(a) \Leftrightarrow P_a(w) = 1$ 三步,把『获取证据』与『检查声明』分开——Lean 请求类型化字段并对提供者的回答应用谓词。原子/键/环计数、分子式、芳香性、内置官能团模式、R/S 手性标注这七类是原生检查,在 Lean 内直接判定;RDKit 描述符和知识查询则通过见证协议接入。第三,同一执行语义上的两种反馈制度:整轨精炼(Refinement)被拒后从 $S_0$ 重写整条轨迹,最多 8 次;MolLean-MCP 通过有状态工具在当前状态上继续,最多 2 次尝试、每次 30 次计费调用,finish 触发关闭门。这与 Self-Refine 的模型自评反馈有本质区别:反馈来自内核的确定性检查。
方法步骤详情
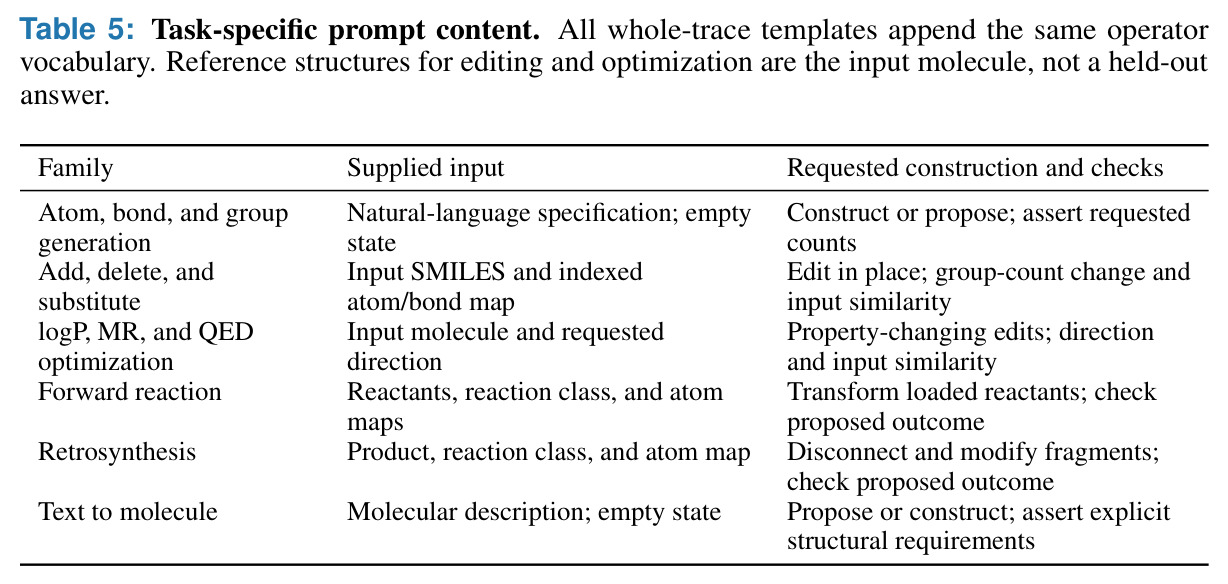
执行从 $S_0 = \text{init}(x)$ 开始,生成任务可从空状态出发,编辑任务加载输入分子。第一步,模型声明粒度不等的操作:七种原语(加/删原子、成键/断键、更新键级/电荷/自由基)各自检查前置条件与受影响原子的价态;构造宏 Chain、Ring、AttachGroup 减少索引管理;复合动作 Concerted 把一组编辑原子化应用后再统一检查价态;propose 一步引入经结构检查的候选分子;Fragment 把桥键拆成活跃分子,Eject 把分离组分移入离去池;命名反应展开为这些操作。第二步,内核逐操作验证:记账覆盖两池的图原子、形式电荷与自由基宇称,电荷与自由基守恒是关闭义务;末端可实现性检查价态、连通性、芳香性与闭壳层规则,任一失败即拒绝并返回原因 $r_t$。第三步,读出与断言:measure 返回数值,check 检验提议值;原子计数等由 Lean 谓词直接判定,PropertyChange 和 FGCountDelta 通过见证协议绑定到任务初始分子的基线,且只使用公开任务规范。第四步,三种推理接口:One-pass 提交一条完整轨迹直到首次拒绝;Refinement 从同一 One-pass 完成出发,返回拒绝反馈与索引状态,最多 8 次整轨重写,每次从 $S_0$ 重启,接受即停;MolLean-MCP 以 function-calling schema 暴露有状态工具,模型可先查询状态再操作,被拒调用状态不变,finish 调用关闭门。整个验证只对照输入或模型自提候选,数据集参考答案只进入独立评分器。
技术新颖性
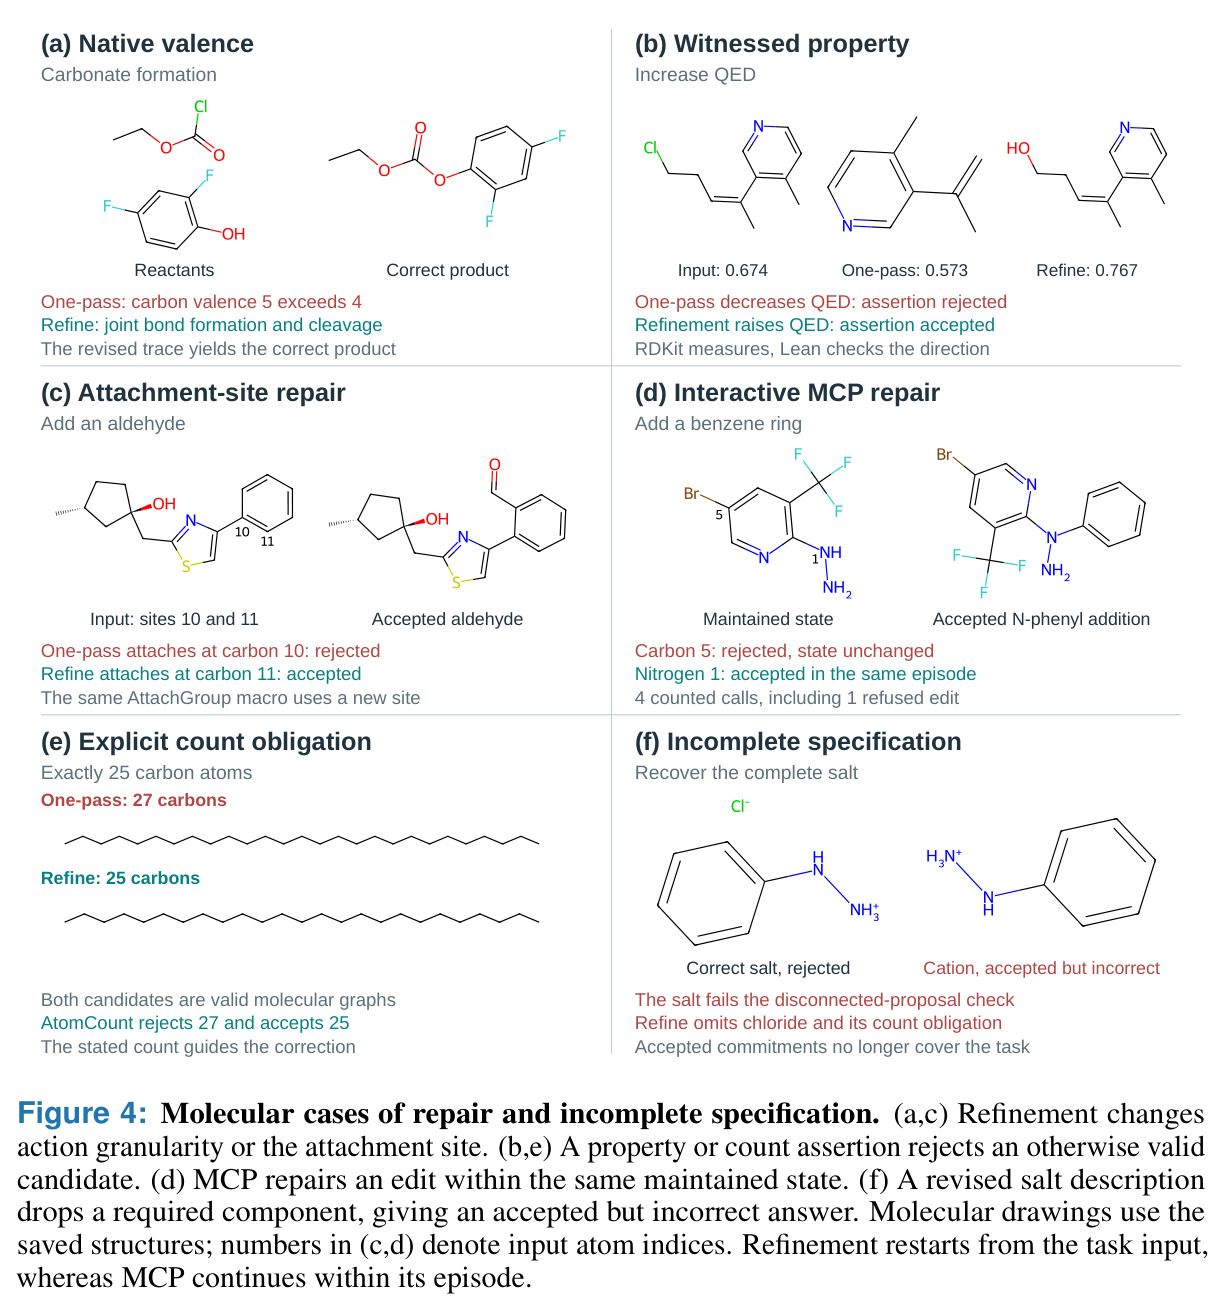
技术新颖性体现在四点。其一,化学状态机 + 形式化内核的组合是新的:Lean 实现了价态与连通性验证的健全性证明、条件性芳香性结果及六个原生断言边界(附录 A),使化学检查本身有形式化保证,而非任意脚本。其二,类型化见证协议解决了形式验证如何接纳外部经验测量的问题——外部世界的数据不能被『证明』,只能被类型化地请求与谓词化地检查,这一分离让描述符依赖的断言(如 QED 从 0.674 升到 0.767)也进入同一验证框架。其三,粒度设计服务于验证单元:Concerted 捆绑让碳酸酯形成这类『先成键必须同时断键』的编辑通过(否则碳价态瞬时为 5 被拒),propose 宏则一步完成结构检查的候选引入。其四,评价框架上的概念贡献:把过程健全性 $s_{\Gamma,W}(\tau;x) = \mathbb{1}[\text{所有声明操作被接受且} G_\Gamma(S_T)=1]$ 与答案正确性 $c(\hat{y};x,y)$ 分开报告,并明确 $s=1 \not\Rightarrow c=1$,指出了『验证器接受的轨迹可能忠实执行了错误目标』这一被先前工作忽视的失效模式。
实验结果
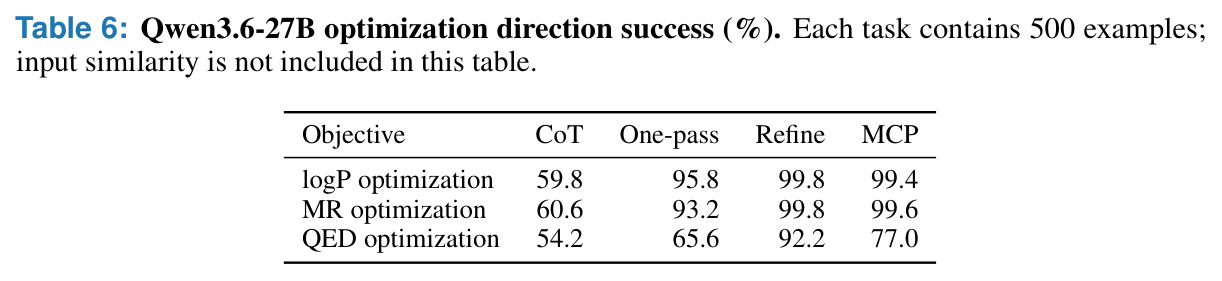
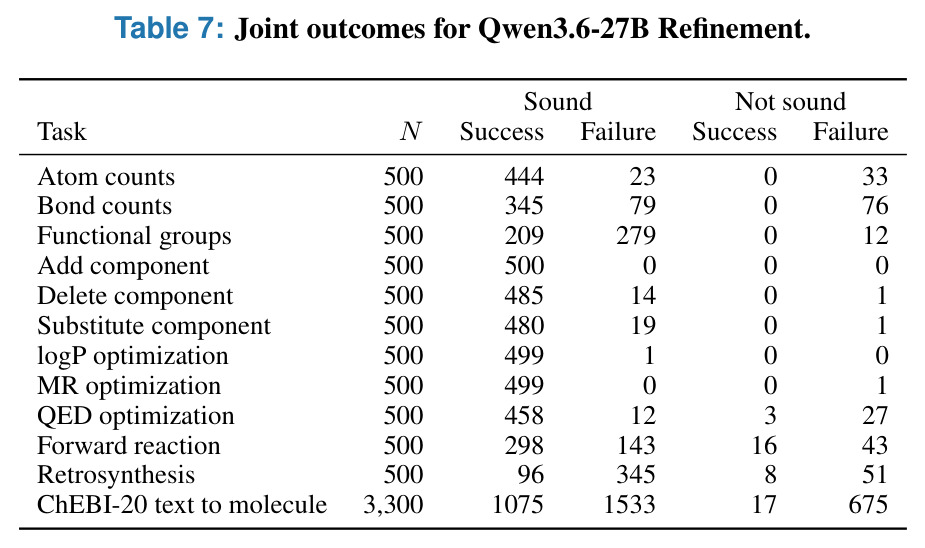
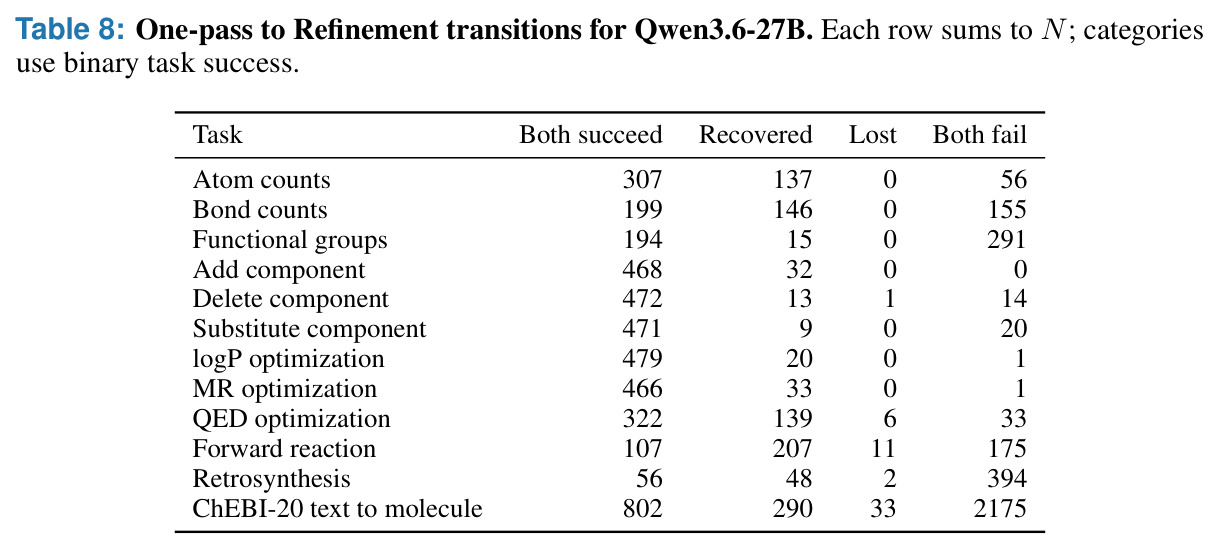
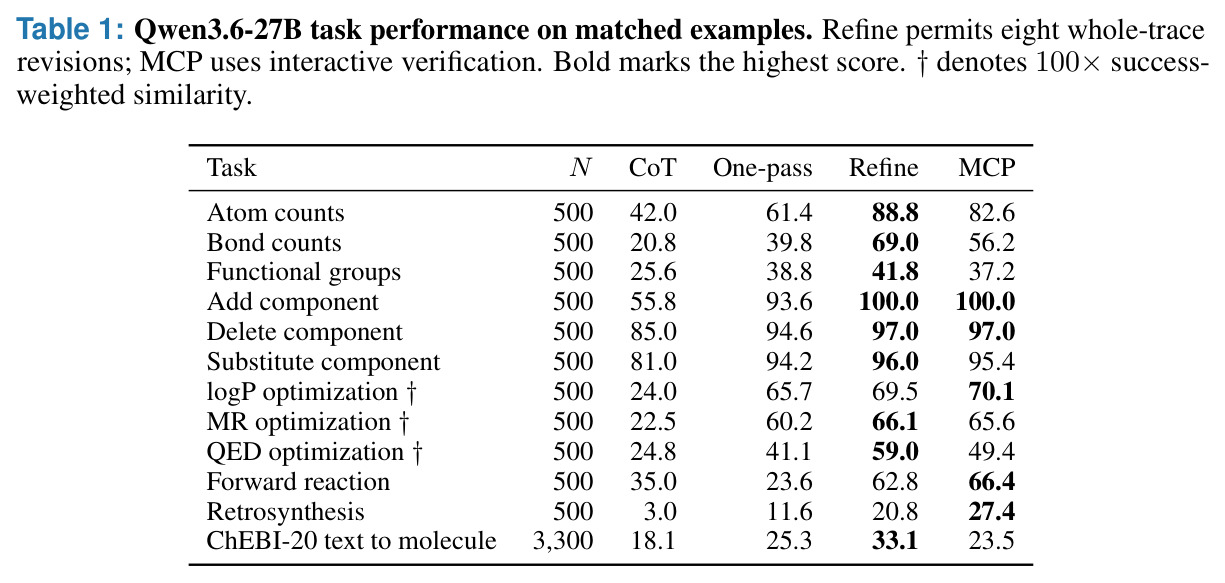
评测覆盖 8,800 个匹配样例、12 类任务:九类 S2-Bench 任务(各 500 例)、USPTO-50k 正向反应与逆合成(各 500 例)、完整 ChEBI-20 测试集(3,300 例),主模型 Qwen3.6-27B。发现一:Refine 在全部 12 个任务上超过直接 CoT,增益 12.0–48.2 个百分点,配对 bootstrap 区间(4,000 次重采样)全部排除零;原子计数 42.0%→88.8%,键计数 20.8%→69.0%,组分添加 55.8%→100.0%,ChEBI-20 18.1%→33.1%,逆合成 3.0%→20.8%。One-pass 已在 11 个任务超 CoT,唯独正向反应 23.6% 低于 CoT 的 35.0%,Refine 将其拉到 62.8%,说明初始计划偏离验证义务时反馈最宝贵。发现二(恢复/损失配对分析):正向反应恢复 207 个失败答案、仅损失 11 个成功;逆合成 48/2;ChEBI-20 恢复 290、损失 33,净增 257 个正确答案;多数增益在前 2 次修订内到位(正向反应 $k{=}2$ 时已达 58.0%)。发现三(健全性与正确性分离):Refine 在 12 任务上健全性全部提升,MCP 在 10 项匹配或超过 Refine(正向 98.6%、逆合成 98.0%);但逆合成健全性 88.2% 而正确率仅 20.8%,ChEBI-20 健全 79.0% 而正确 33.1%——细看 ChEBI-20 的 3,300 例:1,075 例健全且正确、1,533 例健全但错误、17 例无认证正确、675 例皆非;对比之下原子计数任务 467 个被接受轨迹中 444 个(95.1%)满足任务标准,说明计数能直接映射为谓词,而文本描述需要模型自行选出正确的结构义务。发现四(接口互补):MCP 反应最强(正向 66.4%、逆合成 27.4%),Refine 在原子计数(88.8% vs 82.6%)、键计数(69.0% vs 56.2%)、QED 优化(59.0 vs 49.4)和 ChEBI-20(33.1% vs 23.5%)领先,两者在组分添加上同为 100.0%。发现五(小模型):Qwen3-4B 上 Refine 将原子计数 15.8%→56.8%、组分添加 13.4%→91.4%、替换 15.2%→53.4%、logP 分数 14.7→60.0,但参考型任务近乎失效:逆合成全协议 0.0%,ChEBI-20 仅 1.4%,正向反应 1.6%。
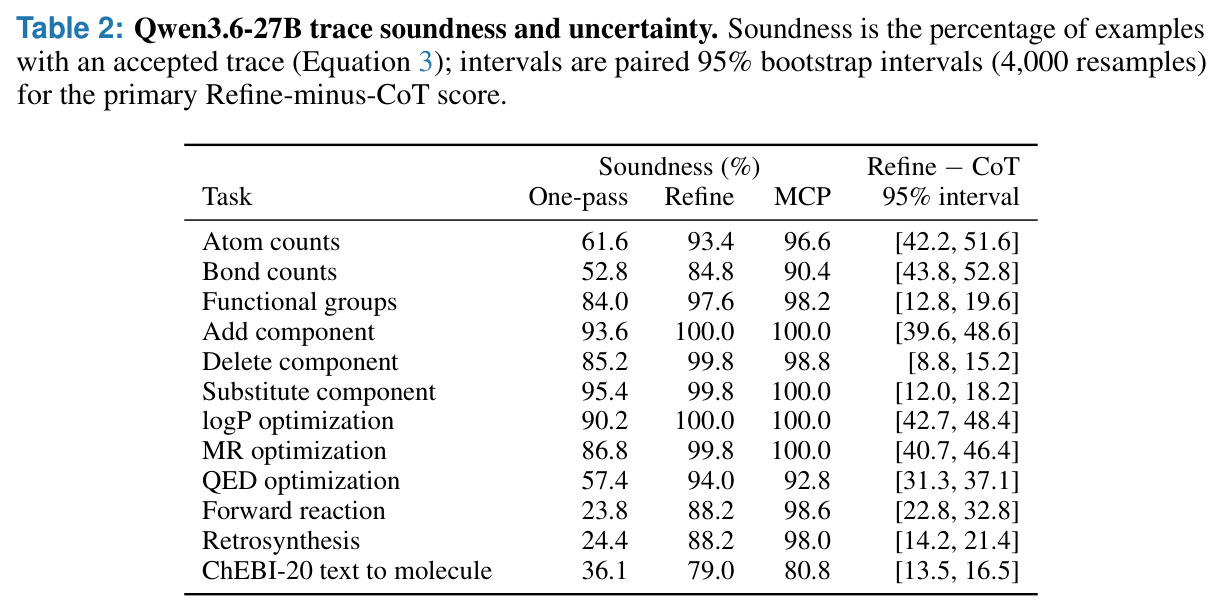
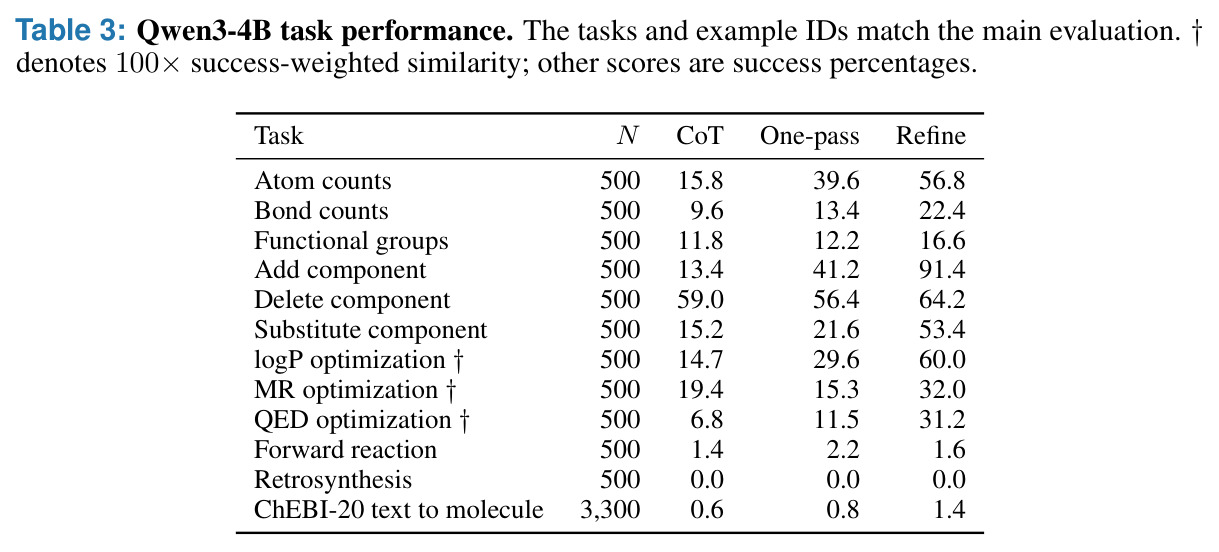
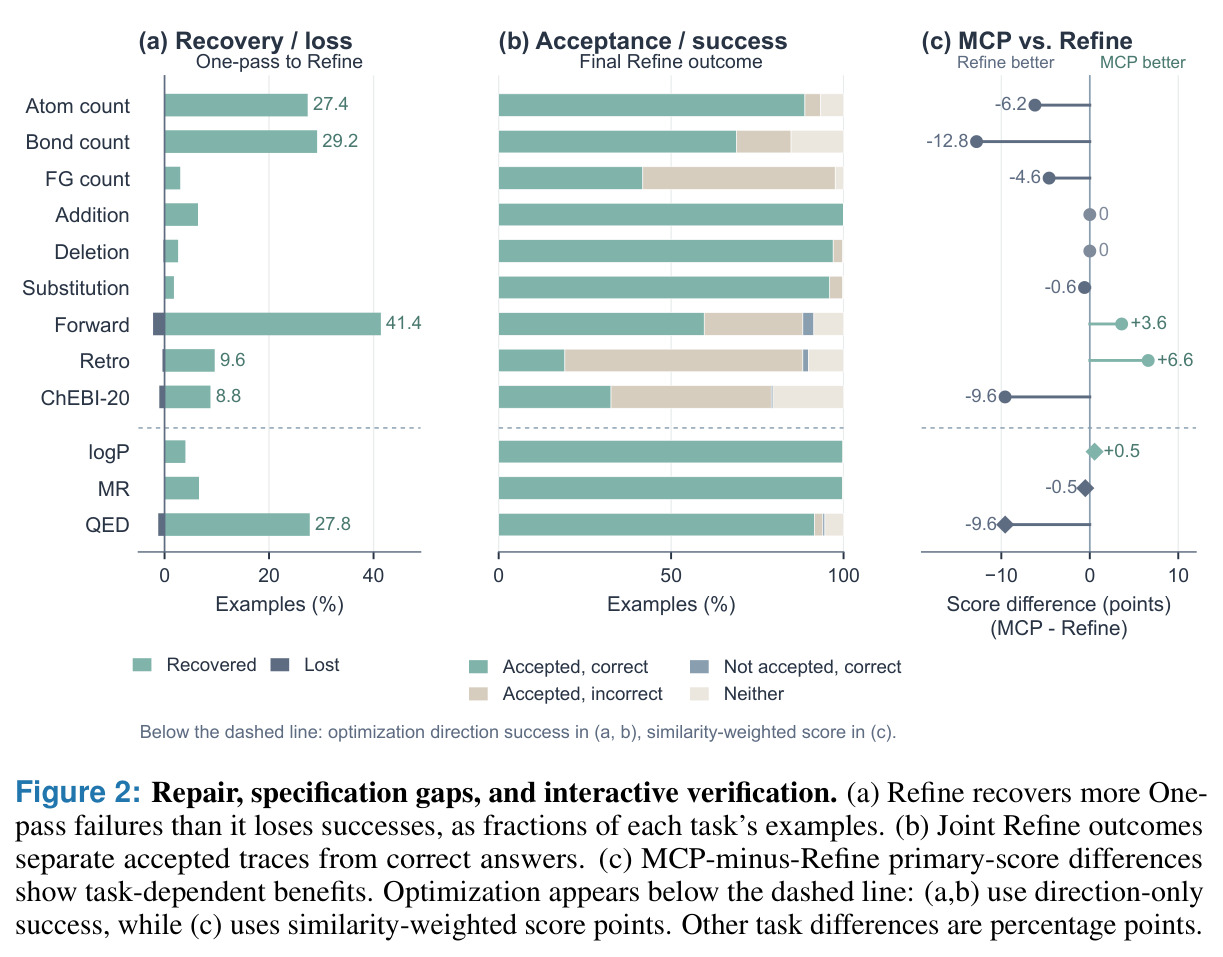
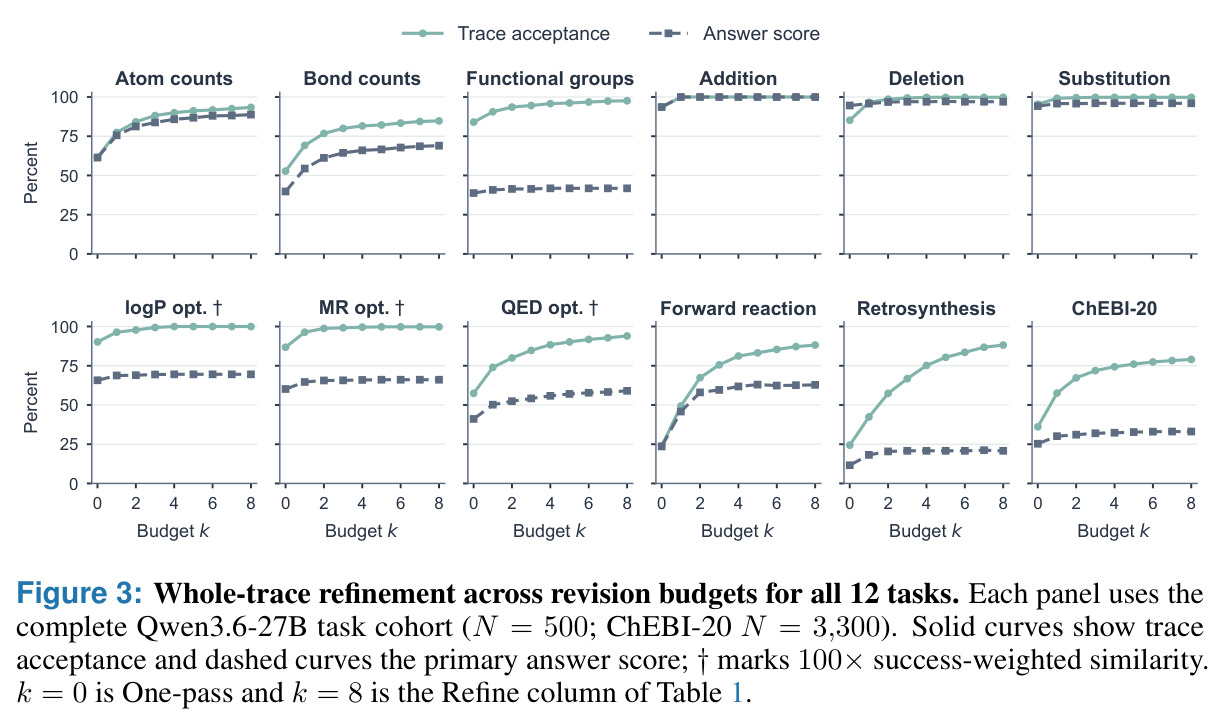
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ChEBI-20 文本到分子生成(3,300 例) | InChIKey 首块(骨架)匹配准确率 | Refine 33.1%,One-pass 25.3%,健全性 79.0% | 直接 CoT 18.1% | +15.0 个百分点(Refine vs CoT),配对 bootstrap 区间 [13.5, 16.5] |
| USPTO-50k 正向反应预测(500 例) | 组分骨架键集合完全匹配 | MCP 66.4%,Refine 62.8%,MCP 健全性 98.6% | 直接 CoT 35.0%(One-pass 仅 23.6%) | MCP +31.4 个百分点;Refine 从 One-pass 恢复 207 例、仅损失 11 例 |
| USPTO-50k 逆合成(500 例) | 骨架集合完全匹配准确率 | MCP 27.4%,Refine 20.8%,Refine 健全性 88.2% | 直接 CoT 3.0% | Refine +17.8 个百分点,MCP +24.4 个百分点 |
| 原子计数生成(S2-Bench,500 例) | 结构计数成功标准 | Refine 88.8%,接受轨迹中 444/467(95.1%)满足任务标准 | 直接 CoT 42.0% | +46.8 个百分点,是全部 12 任务中的最大增益之一 |
| logP 优化(500 例) | 成功加权 Tanimoto 相似度 $\mathbb{1}[\text{性质改善}]\times\text{Tanimoto}$,100 倍报告 | MCP 70.1,Refine 69.5,健全性 100.0% | 直接 CoT 24.0 | +46.1 分(MCP vs CoT),方向性成功率增益一致 |
| Qwen3-4B 组件添加(500 例) | 官能团变化成功标准 | Refine 91.4% | 直接 CoT 13.4% | +78.0 个百分点,验证引导的精炼可迁移到小模型的结构任务 |
局限与改进
作者明确承认的核心局限是指令到约束的接地(specification grounding):健全的轨迹可能忠实执行了错误目标,案例 (f) 中模型先提出正确的盐却被『不连通提议』检查拒绝,精炼后干脆省略氯离子及其计数义务,得到被接受但错误的阳离子——验证器无法发现义务本身偏离了用户指令。ChEBI-20 上 79.0% 健全对 33.1% 正确的巨大落差正是这一瓶颈的量化体现。我自己的观察:其一,验证器只能检查结构合法性与声明的义务,无法验证化学可行性(USPTO 反应类别是作为输入喂给每个协议的),反应准确率更多依赖模型记忆而非验证;其二,参考型任务对小模型几乎完全失效(逆合成 0.0%),说明这套范式验证『推理形式』而不能替代候选生成能力;其三,成本不可忽视——每例最多 8 次整轨重写或 2 次×30 次工具调用,推理开销远高于一次性 CoT,论文未报告延迟与 token 成本;其四,实验只覆盖 Qwen 系列两个模型和单一验证器版本,未测试验证器规则被模型针对性利用(reward hacking)的鲁棒性,优化任务的成功判定也依赖 RDKit 近似描述符而非实验测量。
独立分析的弱点
弱点一:规格接地缺口。1,533 个健全但错误的 ChEBI-20 输出表明,模型表达的关闭义务常常只覆盖指令的一部分(如盐例子中丢失氯离子)。改进方向:引入指令到约束的自动编译层,把自然语言任务显式解析为义务清单并强制全部声明,或在精炼时要求模型对每个用户要求给出对应的显式断言,验证器检查义务覆盖率。弱点二:验证器无法覆盖化学语义。结构合法 ≠ 合成可行,正向反应预测中验证器只能保证产物是合法分子。改进方向:把逆合成工具(如 ASKCOS)或量子化学计算作为更深层见证源接入见证协议,检查反应性而非仅价态。弱点三:小模型在参考型任务上彻底失效(Qwen3-4B 逆合成 0.0%、ChEBI-20 1.4%),验证无法弥补候选生成知识的缺失。改进方向:为弱模型外挂检索或性质引导的候选提议器,让验证专注于过滤而非生成。弱点四:精炼语义要求每次从 $S_0$ 重启,改一步需重放全轨迹;MCP 虽支持增量编辑但受 30 次调用预算限制。改进方向:支持从被拒步骤的前缀继续(已接受前缀理论上可复用),降低重写成本。弱点五:报告的优化任务指标基于 RDKit 描述符方向性判定,与真实实验性质可能背离,模型可学会迎合描述符的代理目标。
未来方向
作者在结论中提出的方向是把指令接地为显式约束:让验证不仅检查轨迹自身义务,还检查义务是否覆盖了用户指令,这需要任务指令的形式化解析。基于本文成果可延伸的方向:其一,用被接受的轨迹作为过程奖励信号训练策略模型——98%+ 的可验证健全轨迹是干净的 RL 数据源,类似数学证明领域的做法;其二,扩展见证协议覆盖更深层的化学见证:合成可达性、反应选择性、构象与立体化学的 3D 验证,当前仅保留 R/S 标注;其三,把 MolLean 轨迹编译为 XDL 式实验室指令,打通『可验证推理 → 自动化执行』闭环;其四,测试更大规模与不同家族的模型,以及多个验证器版本间的迁移,评估规则被利用的风险;其五,交互界面的调用预算自适应——按任务难度动态分配 30 次调用,案例 (d) 显示 MCP 常在 4 次调用内完成修复,预算可能过量;其六,把健全性-正确性联合分布(健全但错误的 1,533 例)作为诊断工具推广到其他形式化推理领域。
复现评估
复现条件较好。代码已在 GitHub 开源(https://github.com/phenixace/Open-MolLean),包含 Lean 4 化学内核与 Python 适配器;所有评测数据均为公开基准:S2-Bench(Li et al., 2026a)、USPTO-50k(Schneider et al., 2016,使用确定性反应级划分)、完整 ChEBI-20 测试集(3,300 例),论文明确协议间使用相同匹配样例便于配对比较。模型 Qwen3.6-27B 与 Qwen3-4B 为开源权重,27B 级别推理约需单张 80GB GPU 或多卡/量化,4B 级别单卡即可;验证器执行是确定性的,不涉及训练,主要算力消耗在推理循环。附录 A 给出 Lean 证明的健全性性质清单,附录 D.2 提供推理设置(采样参数、提示与预算),附录 E 提供配对计数与交互长度分布。复现难度中等:整轨协议较直接,主要工程量在 MolLean-MCP 的会话管理与 function-calling schema 对齐,以及原子 ID 引用解析的正确性;若只复现 Table 1/2 的 One-pass 与 Refine 两列,难度较低。
论文图表