Doc2Harness:评测大模型长程框架工程能力的确定性基准 Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents
让大模型按文档从零构建编码智能体框架,再用脚本化模型确定性评分
前置知识
Harness(智能体框架)
包裹在大模型外围、决定编码智能体实际如何运作的软件基础设施:管理交互循环、工具执行、上下文与权限控制、会话状态、失败恢复和结果验证,决定了模型能力有多少真正传导到环境。典型代表有 Claude Code、Codex CLI、OpenCode、Aider 等。论文的核心立场是:agent 的表现同样取决于 harness 的质量,而非仅仅取决于模型本身。
本文评测的对象正是 harness 本身——被测模型要从文档独立构建一个完整可用的 harness,不理解这一概念就无法理解 benchmark 测的到底是什么能力。
契约骨架(Contract Skeleton)
论文从 mini-swe-agent 简化改造而来的初始代码框架:仅 5 个 Python 源文件约 70 行,外加安装脚本、入口脚本和项目配置,只保留三个不可变的外部契约接口(CLI、无头入口、驱动自动化评测的 API),内部实现全部删除。被测模型需要在此基础上写出完整实现,代表性别选 harness 约 16,000 行,即约 99.6% 的代码由模型完成。
骨架决定了被测模型要写多大比例的代码,也是其产出能否被四个通道确定性观测的前提,直接定义了任务难度。
Mock Model(脚本化模拟模型)
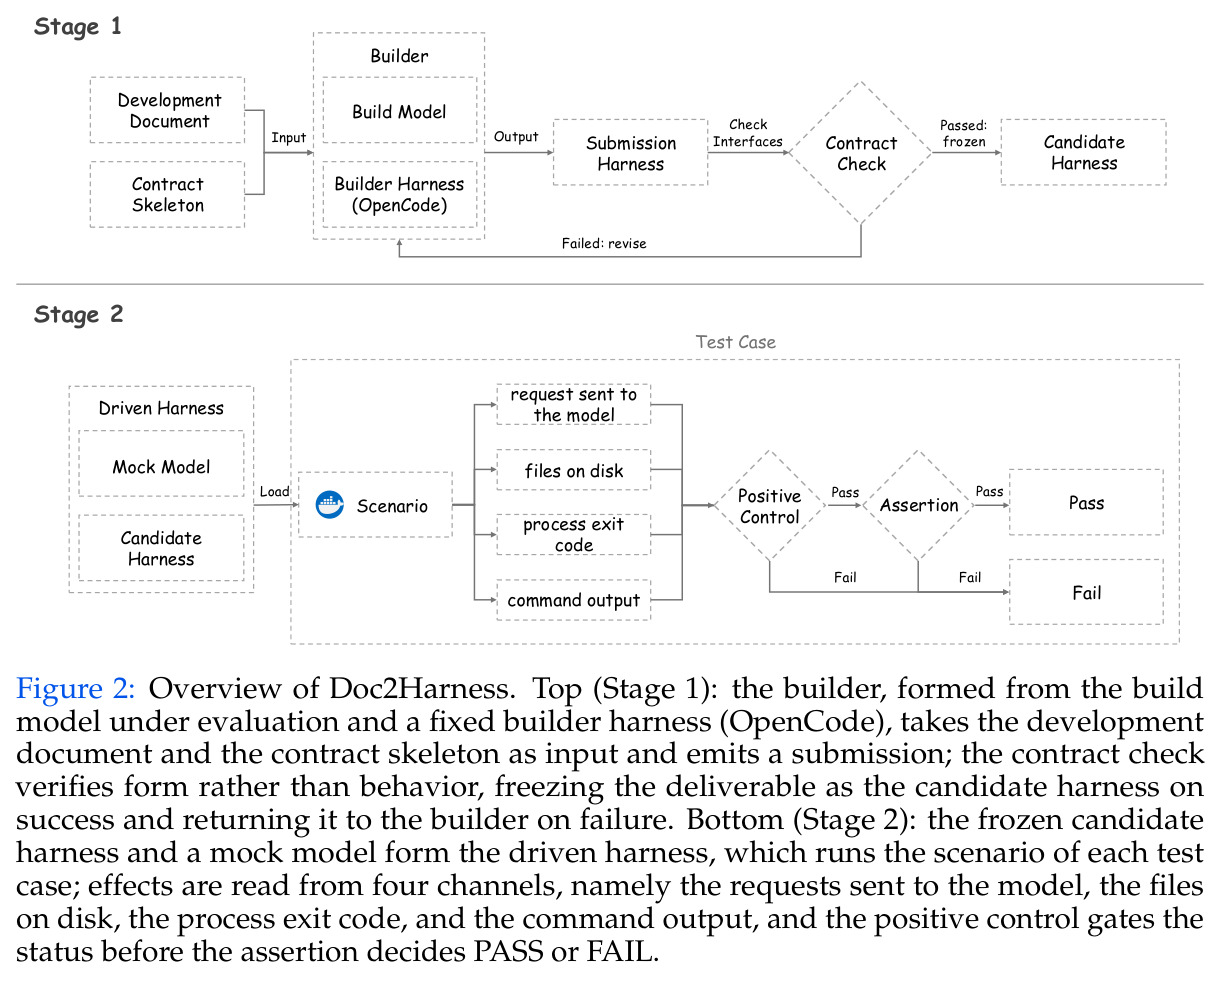
Stage 2 中驱动候选 harness 的假模型:按预设脚本逐轮返回固定响应,而非真实 LLM。一个测试用例就是一次完整会话。由于响应完全确定,评分不受真实模型输出的随机性干扰,候选 harness 可以作为黑盒被可复现地裁决——这正是把 harness 工程从『模型×框架』耦合中剥离出来的关键机制。
它使得『评的是 harness 本身而非模型组合』这一核心设计成立,也是本文区别于下游任务式评测的根本所在。
空洞通过与正向控制
空洞通过指测试通过但被测功能根本没执行:例如断言『越权文件内容不出现在发给模型的请求中』,若 read 工具根本读不了任何文件,断言同样成立。正向控制与原用例共享场景和 fixture(预置文件与初始状态),只改变输入或访问路径,验证观测前提确实成立,共三类:共通道、同形式、反向。控制失败则整组用例无论自身状态一律记 FAIL。
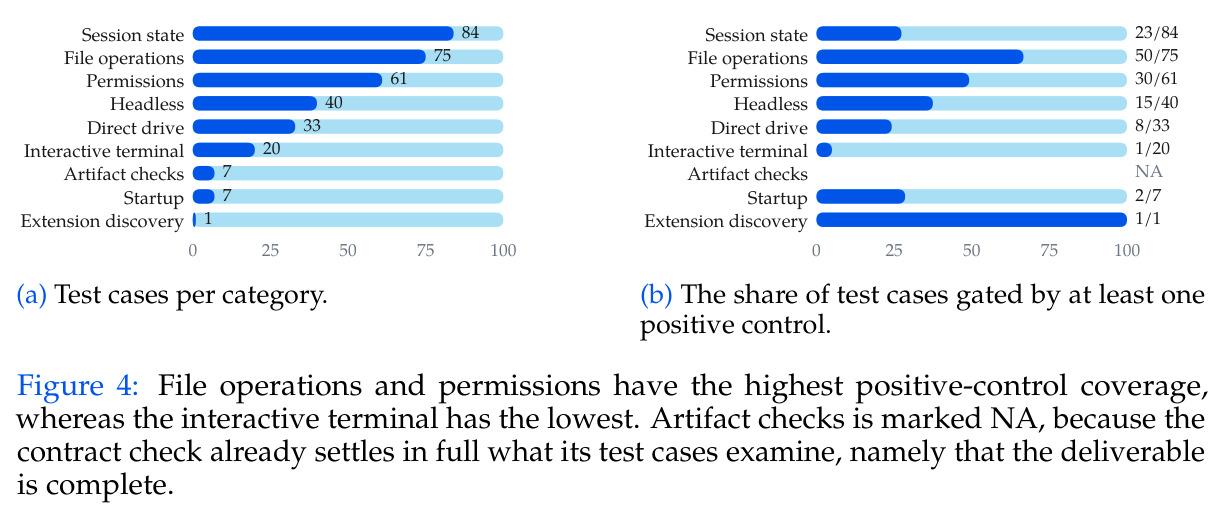
328 个用例中 130 个由正向控制把关,这是理解本文评分为何可信、为何能判定否定式约束的核心设计。
KR-20 信度系数
Kuder-Richardson Formula 20,衡量由二值(通过/失败)题目组成的测验的内部一致性,取值 0 到 1,越高说明各题测量的是同一个潜在能力。论文对 57 个候选 harness 在全部用例上的 KR-20 为 0.913,且六个主类目两两相关全为正(均值 +0.521),支持『被测的是接近一维的综合能力』的判断。
它解释了作者为何敢用一个标量 pass rate 给 19 个模型排序,也是评估任何新基准质量的基本功。
研究动机
现有代码基准几乎都把 harness 当作固定的测量仪器,只测下游任务成败:SWE-bench Pro、NL2Repo-Bench、Commit0 等依赖任务自带的交互式单元测试判定模型改代码是否合格。这套标准无法迁移到 harness 工程本身:其一,harness 里一个功能有多种实现方式,而单元测试只能透过固定接口观察行为;其二,harness 自己不完成任何下游任务,其正确性必须靠用模型驱动它运行才能评估。数据层面还有污染问题:SWE 基准用的开源仓库多是成熟项目,大概率在训练语料中反复出现,而 harness 是近几年才出现且高频更新的产物,更能考察泛化。随着递归自我改进(agent 修改治理自身行为的 harness)成为前沿方向,harness 工程能力却始终没有直接的测量手段。
本文的目标是本文要构建第一个能确定性评测『长程 harness 工程』能力的基准 Doc2Harness:给定一份整合了十二个前沿 harness 行为的开发文档和一个只声明接口的契约骨架,让被测模型在固定 builder 框架内于隔离容器中独立写出完整的候选 harness;随后把冻结的候选 harness 放入逐用例隔离的容器,由脚本化 mock model 端到端驱动完整会话,从发给模型的请求、磁盘文件、进程退出码、命令输出四个可观测通道,对 328 个测试用例做逐条行为裁决,用通过率间接刻画被测模型的 harness 工程能力,并保证评测确定、可复现、能排除空洞通过。
与已有工作不同的是,与已有工作的本质区别有三点。第一,交付物不对应任何已存在的实现:开发文档把 Claude Code、Gemini CLI、Aider、Cursor 等十二个前沿 harness 的功能清单合并、消歧成一套自洽条款,而以往仓库级生成任务都是复刻已发布的库,天然存在记忆泄漏风险。第二,候选 harness 由按预设脚本响应的 mock model 驱动,而非真实模型跑下游任务,评测完全确定,被评的是 harness 本身,也规避了『多给测试时搜索预算就能涨分』这一文献中公认的混淆。第三,候选 harness 作为黑盒被完整会话端到端执行,效果从四个通道读取,使『被拒绝的操作必须不发生』这类否定式约束也能逐条款裁决,并用正向控制排除空洞通过——此前没有任何基准做到条款级的行为符合性判定。
核心方法
整体是两阶段流水线。直觉上,先把『写 harness』变成输入输出都可控的封闭任务,再把『评 harness』变成不依赖任何 LLM 的确定性测量。Stage 1(构建):被测模型装入固定的 builder harness——统一用 OpenCode 1.17.0 单文件可执行版,避免 Claude Code、Codex CLI 等厂商自家框架偏袒自家模型——在全新空容器(仅开放指定模型网关、无外网)中读开发文档、从约 70 行的契约骨架出发写完整实现;限时 2 小时、至多 3 次提交、至多 24 轮续写;每次提交只做形式检查(可编译安装、必备命令齐全、无占位桩、三个契约接口在位),通过即冻结为候选 harness,失败则退回继续改。Stage 2(评测):冻结的候选 harness 复制进逐用例隔离的容器,由脚本化 mock model 驱动跑一遍完整会话,单例限时 900 秒超时记 FAIL,从四个通道读取效果,328 个用例的通过率即最终分数。
核心创新是『文档到行为』的评测闭环加正向控制。与 SWE 基准靠随任务附带的单元测试判分不同,本文先从十二个前沿 harness 的用户文档提炼出以『语法—语义—预期行为』为基本单元的条款式开发文档,要求每个条款的效果都可经四个通道之一从外部观测、且不约束实现方式;再让 mock model 按脚本驱动候选 harness 完整会话,把每个条款的符合性变成可裁决的断言。针对『断言要求某效果不出现,可能只因功能根本没跑』的空洞通过问题,设计三类正向控制:共通道控制确认工具结果确实进入被观测通道,同形式控制排除条款约束之外的失败(如用 bash 读同一符号链接验证其确实可解析),反向控制排除一刀切拒绝合法输入(如拒绝所有符号链接)。控制失败则整组用例强制记 FAIL。这让否定式安全与权限约束首次可以逐条成立或被证伪。
方法步骤详情
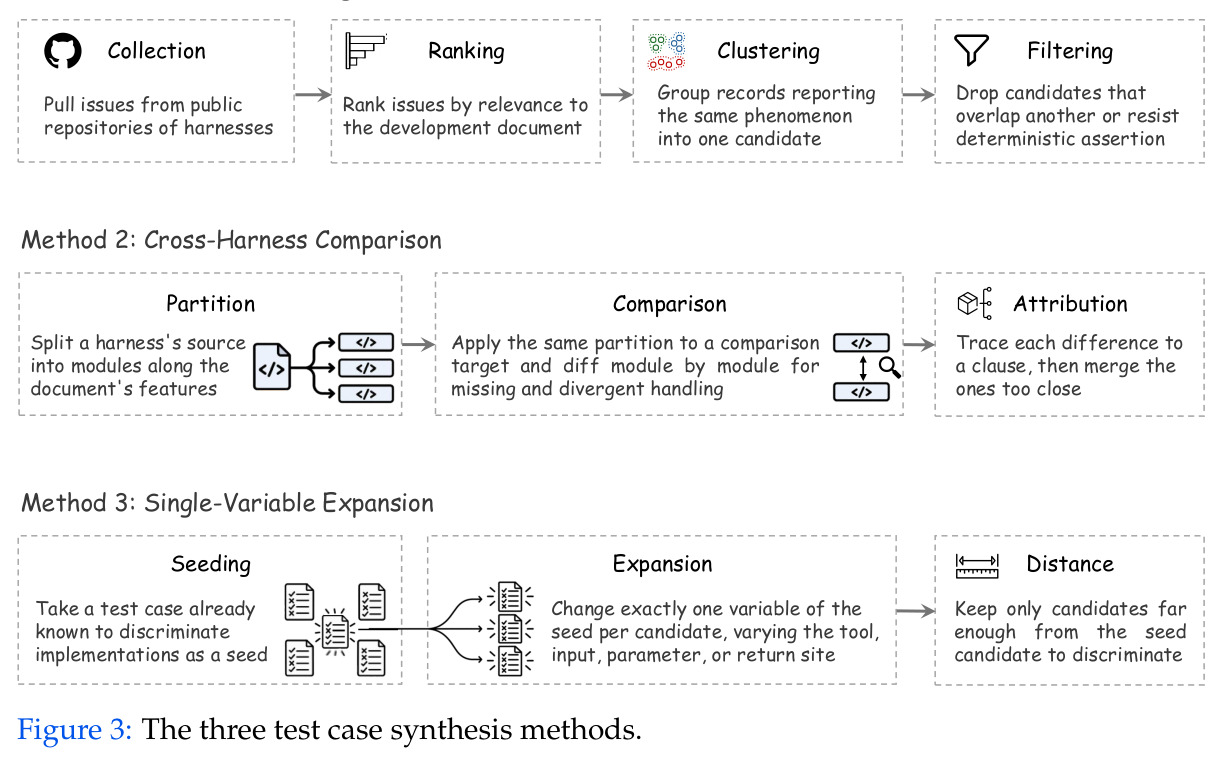
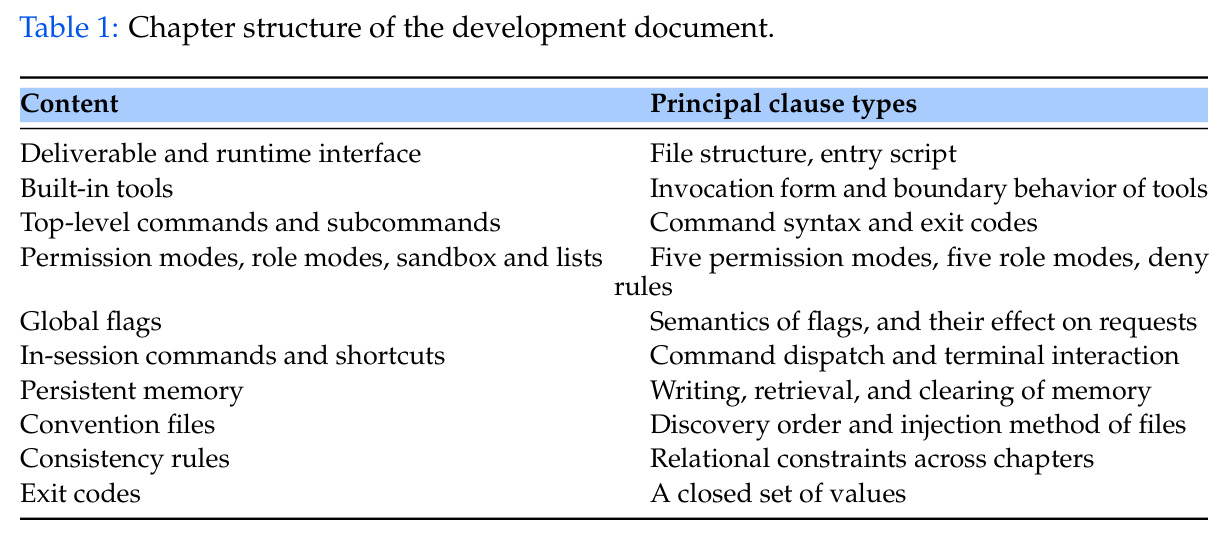
开发文档构造分三步:爬取 Claude Code、Gemini CLI、Aider、Cursor 等十二个前沿 harness 的用户文档提炼功能清单;转写成覆盖运行时接口、内置工具、命令与子命令、五种权限/角色模式、全局旗标、会话内命令、持久记忆、约定文件、退出码、评测 API 的条款;最后消歧——合并语义重叠命令(/compact 与 /summarize 统一为 /compact),拆分同名异义概念(plan 的只读约束归权限、提案职责归角色)。测试用例按边际产出用三种方法交替合成:公开 issue 挖掘(四个仓库共 21,083 条 issue 按相关性排序、聚类去重、可确定性断言过滤);跨 harness 对比(按文档特征分模块与成熟实现逐模块 diff、归因到条款);单变量扩展(以有区分力的种子用例为基础,每次只改工具、输入形式、错误参数、返回位置之一,再做距离检查)。最后配置正向控制:328 例中 130 例至少被一个控制把关(114 例一个、15 例两个、1 例三个),控制不计入分母。
技术新颖性
新颖性体现在评测对象与评测机制两层。对象上,交付物是全新软件:代表性别选 harness 约 30 个 Python 文件、约 16,000 行,其中约 99.6% 超出契约骨架、由被测模型写出,远超 Commit0 等仓库复刻任务的自由度,也无法靠记忆现成实现得分。机制上,一是用 mock model 把『模型×harness』解耦,分数只反映候选 harness 质量;二是四通道观测让否定式条款(如符号链接路径逃逸必须被阻止、值 0 不得被当作缺省)可判定;三是用例合成本身有明确方法论——issue 挖掘、跨实现对比、单变量扩展构成的产出驱动循环,并把基准的区分力当作可度量对象:57 个构建中共 56 个 floor 用例、16 个 ceiling 用例、256 个真正起区分作用的用例;四是把源码架构与得分联系起来,发现跨切面功能集中在更少模块的 harness 得分更高。据作者所知,这是第一个能确定性测量长程 harness 工程能力的基准。
实验结果
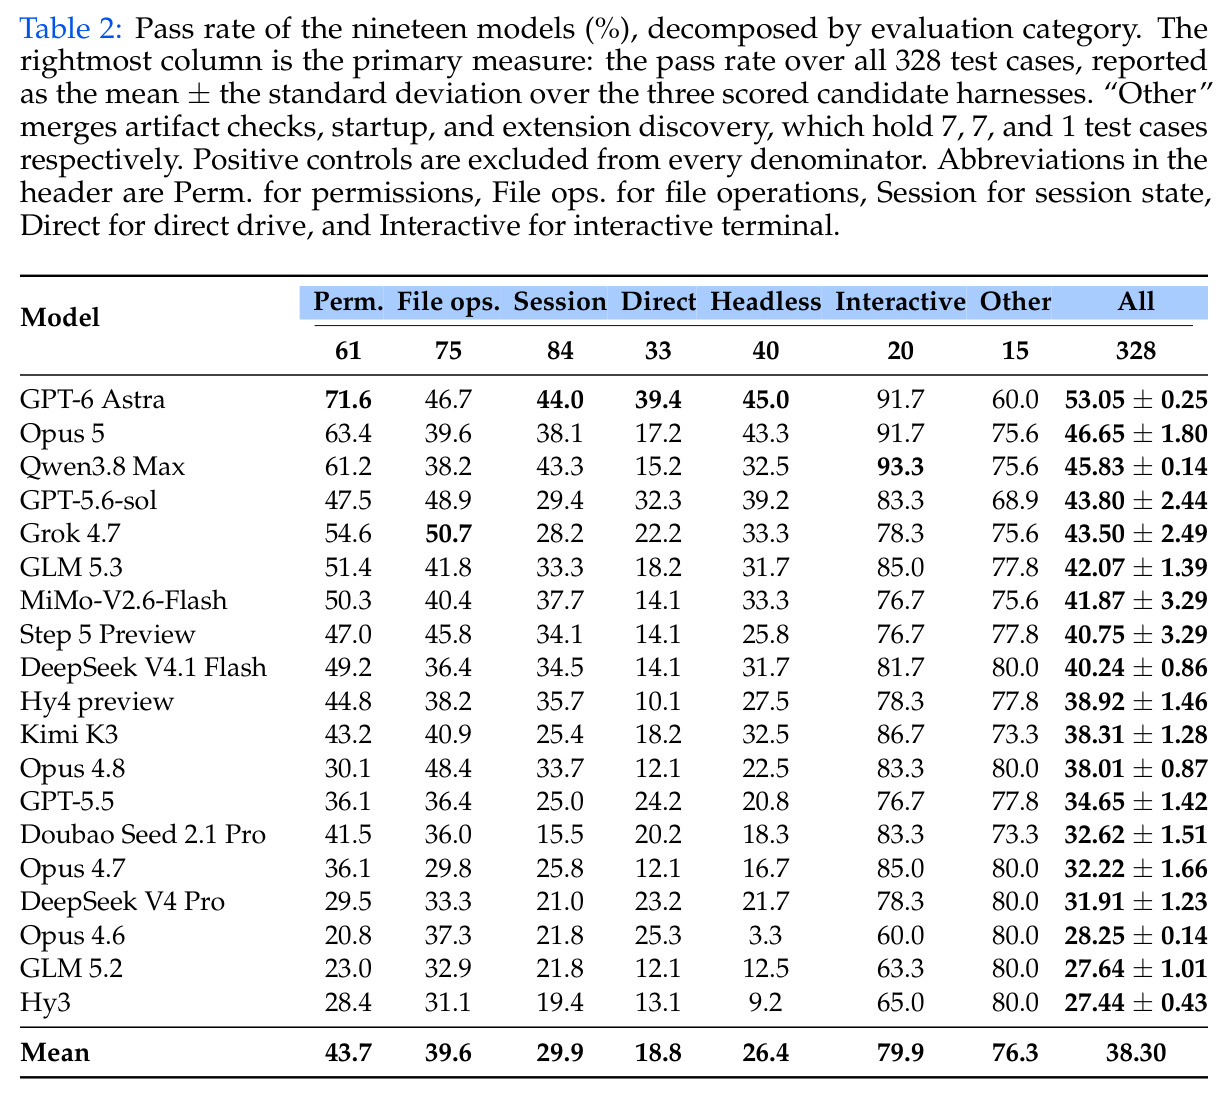
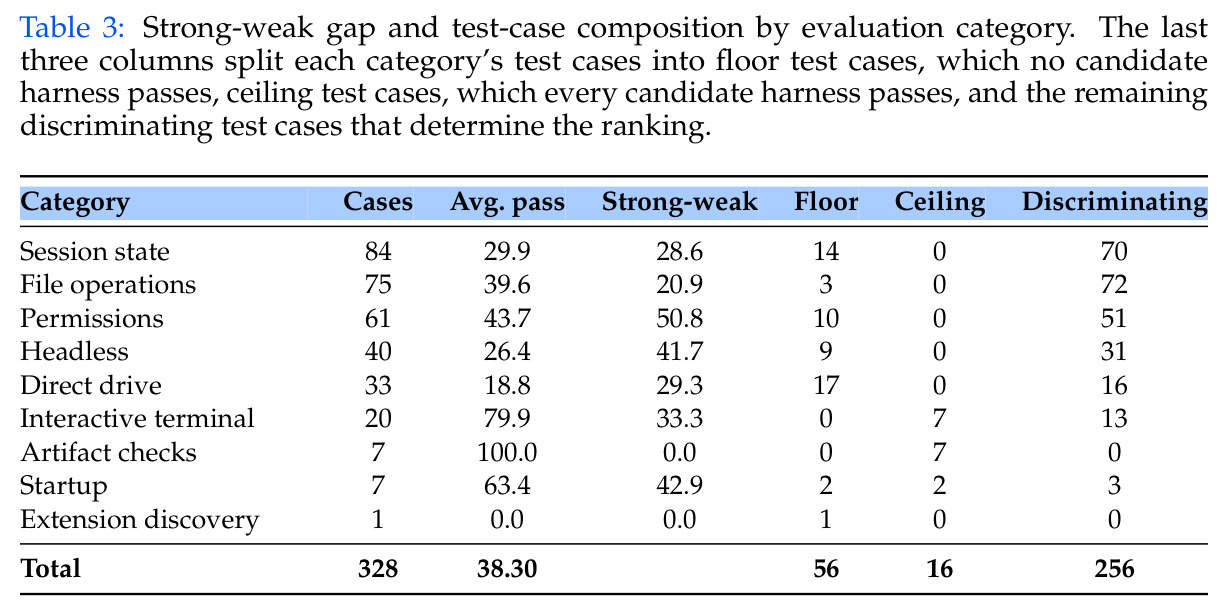
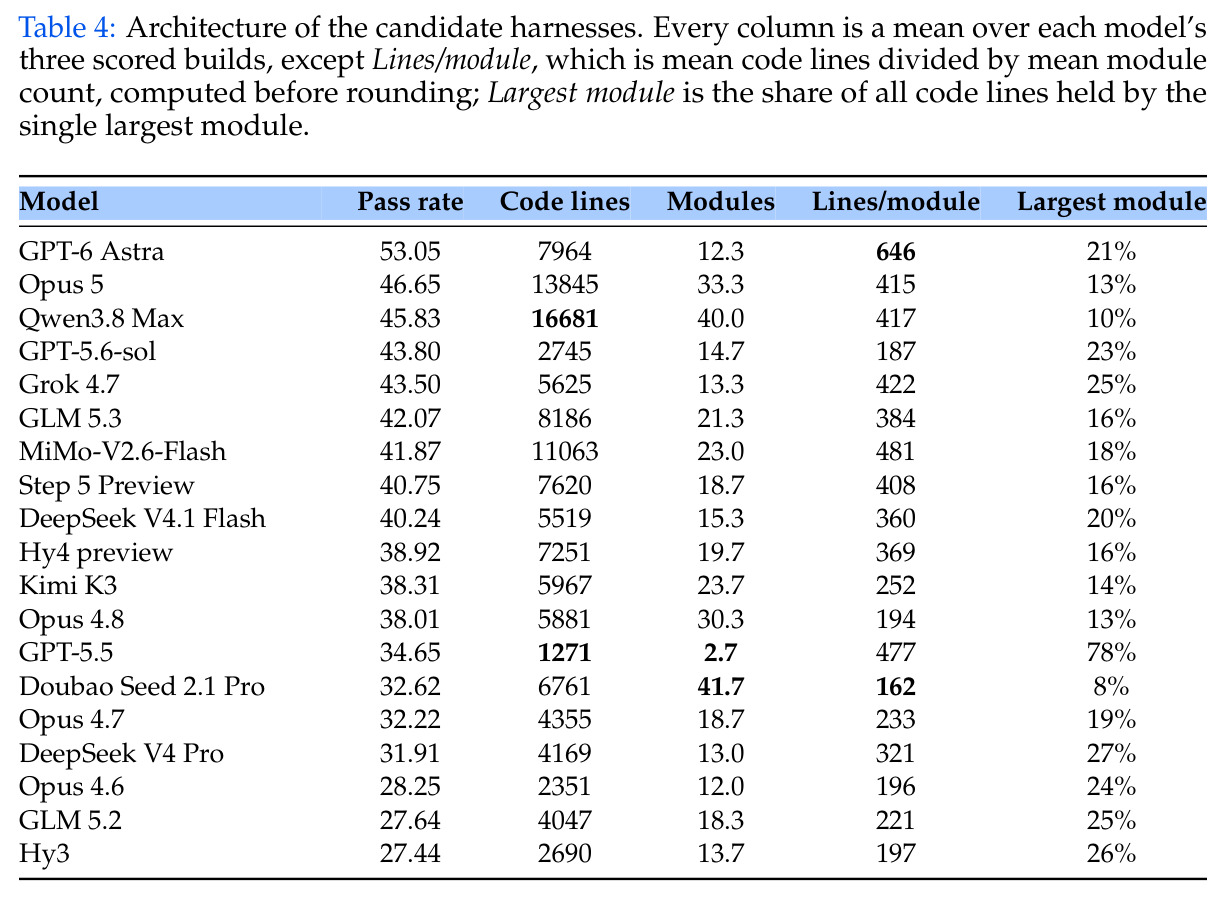
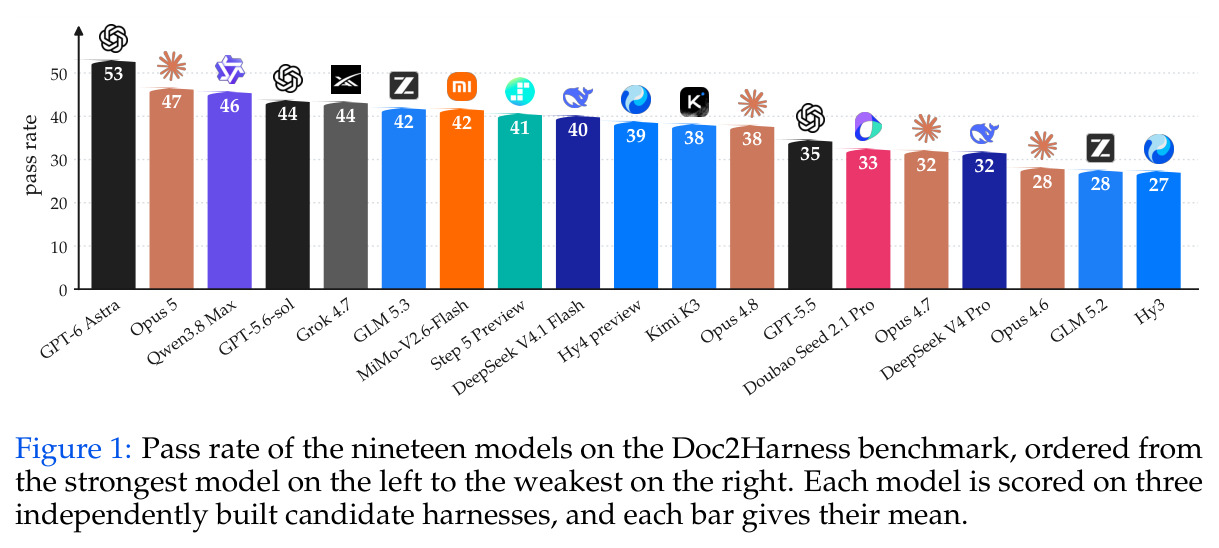
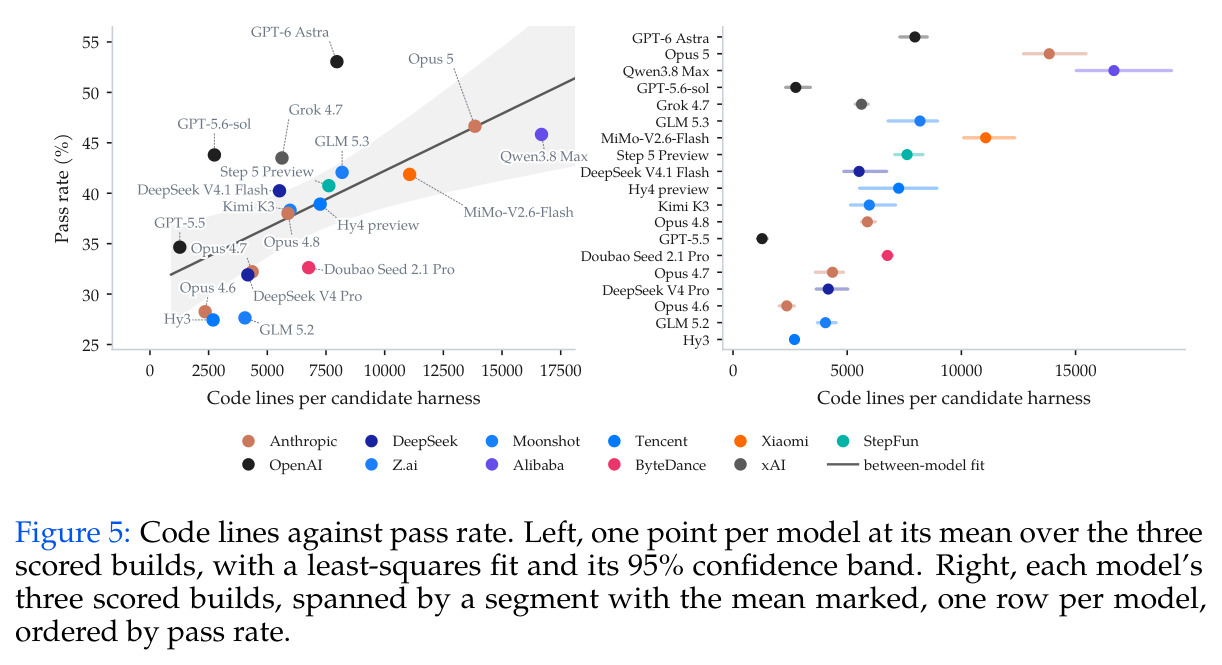
十九个模型、三次独立构建、328 个用例:GPT-6 Astra 以 53.05%±0.25 居首,最弱 Hy3 仅 27.44%±0.43,相差约 26 个百分点,最强也近半失败,未饱和且有区分力。前两名分歧在边界条款:普通场景 Opus 5 领先(80.68% 对 72.46%),边界场景 GPT-6 Astra 反超(48.97% 对 37.02%)。分类目:权限类区分力最强(均值 43.7%、强弱差 50.8 分、51/61 有区分力),文件操作均值 39.6% 但强弱差仅 20.9 分,交互终端 79.9% 接近饱和,直驱最难(均值 18.8%、17 例 floor 无人通过);全体 56 floor、16 ceiling、256 例真正决定排名。排名跨类目最多波动 16 位,但六个主类目两两相关全为正(均值 +0.521)、KR-20 达 0.913,指向单一综合能力。架构上:代码行与通过率相关 $r=0.614$;控制代码行后模块数与通过率偏相关 $r=-0.423$,每模块行数偏相关 $r=+0.504$,即碎片化有代价;代码规模 95.9% 的方差来自模型身份。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全量 328 测试用例:从开发文档+契约骨架构建候选 harness 并通过黑盒评测 | 通过率(3 次独立构建的均值±标准差) | GPT-6 Astra 53.05±0.25% | 最弱模型 Hy3 27.44±0.43%;全体 19 模型均值 38.30% | 首名领先末名约 25.6 个百分点,最强模型仍失败近半用例,套件未饱和 |
| 权限类目(61 例,含 deny 规则与五种权限模式) | 类目通过率 | GPT-6 Astra 71.6%(类目均值 43.7%) | 最弱 Opus 4.6 仅 20.8% | 强弱差 50.8 分、51/61 用例有区分力,是全套件区分力最强的类目 |
| 边界场景子集(对比前两名) | 通过率 | GPT-6 Astra 48.97% | Opus 5 37.02% | GPT-6 Astra 反超 11.95 分;普通场景则落后 Opus 5 8.22 分(72.46% 对 80.68%) |
| 直驱类目(33 例,无交互会话直接驱动) | 类目通过率 | GPT-6 Astra 39.4%(类目均值仅 18.8%) | 类目内 17 例为 floor,所有候选 harness 均未通过 | 最难类目,均值比第二难的会话状态(29.9%)还低 11.1 分 |
局限与改进
作者承认的局限:协议只测单次构建——至多 3 次提交、没有迭代『构建—评测—修复』循环,契约检查只验形式不验行为,早提交者的通过率只能是下界;候选 harness 冻结后无法衡量基于行为反馈的改进,而这恰是递归自我改进的核心。另外单变量扩展产生的变体用例彼此相关,一个缺陷可能同时打挂多个相关用例。我的补充观察:mock model 只能沿预设脚本路径驱动,无法考察真实模型在环时的上下文压缩质量与动态错误恢复;每个用例只有一次 900 秒内执行、二值判定,忽略『慢而正确』与部分正确;交互终端(79.9%)与工件检查(100%)两类已近失效,扩展发现仅 1 例,用例分布头轻脚重;开发文档固化了十二个 harness 的现有设计共识,可能系统性奖励『像现有 harness』的实现,而非真正更优的新设计。
独立分析的弱点
独立来看有几处弱点。其一,测试用例间相关:单变量扩展从同一种子派生多个变体,距离检查只能剔除过近者,一个缺陷可同时打挂多个变体,通过率可能高估或低估真实能力,改进方向是按种子聚类后报告『缺陷级』而非『用例级』得分。其二,形式检查先于行为评分,提交时机策略(早交保底还是晚交打磨)会系统性影响分数,论文未分析提交次数与通过率的关系,也未报告 3 次提交配额的实际使用分布。其三,模块数负相关是观察性结论,控制代码行后的偏相关 $r=-0.423$ 仍可能被模型编码风格混淆(某些模型惯写大文件),可引入受控干预:让同一模型以不同模块划分重写再评。其四,三次构建的平均变异系数 12.7% 虽小,但对高风险选型决策而言样本仍偏少。其五,900 秒超时一律记 FAIL,无法区分『慢而正确』与『卡死』,可引入分级超时或部分得分。其六,固定 OpenCode 作为 builder 本身可能偏好某种代码组织方式,与被测的模块化结论存在潜在循环。
未来方向
作者指出应把协议从单次构建扩展到迭代『构建—评测—修复』循环,衡量候选 harness 冻结后基于行为反馈的改进,这是递归自我改进能力的关键前置。在此基础上可延伸:让 agent 在多轮失败后自主修改自己的 harness 并重测,直接度量自我改进增益而非一次性构建能力;把开发文档做成版本化序列,测模型对接口演化的适配力;用跨 harness 对比的思路反向生成『反事实文档』,检验模型是在泛化还是拟合文档措辞;把 256 个有区分力用例按种子聚类,发布缺陷级诊断报告,帮助厂商定位系统性短板(如权限与直驱类目的 17 个 floor 用例);交互终端类目接近饱和,可替换为更难的边界与安全场景;模块化负相关的发现值得产品化为 agent 框架工程指南——跨切面功能集中实现、少拆文件——并检验该结论是否迁移到人类团队维护的大型 harness 代码库。
复现评估
复现要点:论文给出项目页 geyuyao.com/doc2harness,但正文未明确承诺开源 328 个测试用例、开发文档全文与契约检查器,若不开源,重建这些资产是最大成本,需要自行实现 mock model 脚本协议与四通道观测(模型请求、磁盘文件、退出码、命令输出)。硬件门槛不高:单台 AMD EPYC 7K83(48 逻辑核、128GB 内存)即可承载两阶段;Stage 1 用 OpenCode 1.17.0 单文件可执行版,每构建限 2 小时、至多 3 次提交、24 轮;Stage 2 每用例独立容器限 900 秒。57 个候选 harness 合计约 18,700 次容器级评测,可并行但总量可观。评测本身完全确定、无评测模型调用成本,主要开销是被测 19 个前沿模型的推理费用与构建时间。综合评估:有资产开源则复现难度中等,全靠自建则属工程量大头,协议描述(预检、隔离、冻结、正向控制)已足够细,具备复现可行性。
论文图表