什么让社交智能体的交互有效?从配对世界的可验证结果中学习 What Makes a Social Agent's Interactions Effective? Learning from Verifiable Outcomes in Paired Worlds
用配对世界验证对话结果,并把终局奖励按轮次重新分配来训练社交智能体
前置知识
社交智能体与 SOTOPIA 评测
社交智能体指在角色扮演式自由对话中需要理解他人目标、隐私信息与社交规范的 LLM。SOTOPIA 是该领域代表基准:给两个智能体分配公开情境与私有角色卡,让它们自由对话,结束后由 LLM judge 按 0-10 分评估目标完成度、可信度等七个维度。后续工作(如 SOTOPIA-RL)甚至直接训练智能体去提高这些评分。
本文的核心批评正是这类评分从不检验对话最终敲定的计划是否可行,作者把 SOTOPIA 评分保留为对照指标并展示其与结果验证的背离,理解它是理解全文动机的基础。
可验证奖励
指用程序规则而非人工或另一个模型打分来判定结果正确性。谈判基准 Deal or No Deal 检查分物方案是否满足双方私有估值,τ-bench 检查客服对话后数据库终态是否正确。规则验证无噪声、可复现、成本低,既能当评测指标,也能直接当 RL 奖励。
HICO-Bench 的 Feasibility 检查与 PaCPO 的全部奖励信号都建立在可程序化验证之上,这是论文能宣称每笔信用都无模型噪声的前提。
稀疏终局奖励与信用分配
当奖励只在回合最后一步给出时,早期动作的贡献难以判定,这就是信用分配问题。已有方案包括逐步打标签的过程监督、用采样续集估计步骤价值的 VinePPO、以及跨 rollout 比较同状态步骤的 GiGPO/GraphGPO。但自由对话中相同状态几乎不重现,LLM 逐步打分噪声又大,使对话场景的信用分配尤其困难。
PaCPO 要解决的全部问题就是:验证结果只出现在对话末尾时,如何把功劳精确记到正确的轮次上。
势函数奖励塑形
Potential-based reward shaping 在每步奖励上加塑形项 $r'_t = r_t + \gamma\Phi(s_{t+1}) - \Phi(s_t)$,其中 $\Phi$ 是状态的势函数。当 $\gamma=1$ 且势函数起止为零时,塑形项沿回合求和会 telescope 相消,回合总回报严格不变,因此不改变最优策略(Ng et al., 1999)。
PaCPO 的奖励重分配公式 $r'_{i,t} = r_{i,t} + \Phi_{i,t} - \Phi_{i,t-1}$ 就是这一技术的直接应用,保证只是把终局奖励摊到各轮、总收益不增不减。
LoRA 低秩适配
Low-Rank Adaptation 冻结预训练模型全部权重,只在注意力与 MLP 层旁路注入低秩矩阵,即 $\Delta W = BA$,其中 $B\in\mathbb{R}^{d\times r}$、$A\in\mathbb{R}^{r\times k}$ 且秩 $r$ 远小于维度 $d$,只训练这两个小矩阵,大幅降低显存与算力需求。
论文所有 RL 实验(PPO/GRPO/PaCPO)都在 Qwen3-8B 上以 LoRA 方式训练,伙伴模型冻结为另一份 Qwen3-8B,理解该设置对估计复现成本很重要。
研究动机
现有社交智能体评测几乎只依赖 LLM judge 给对话过程打分。SOTOPIA 用 LLM 评目标完成度、可信度等维度,后续工作还直接训练模型去刷这些评分。这种做法从不检查对话最终敲定的计划是否真的可行:如果 Maya 询问同事 Leo 能否帮忙准备明天的客户汇报,而实际上 Maya 自己能出席、只想让人帮忙检查预算页,那么 Leo 一句体贴的“别担心,我来讲”听起来很支持,却承诺了一个必然失败的计划——关键事实(Maya 能否出席)是她的隐私,必须通过对话引出。分摊账单、约时间、审批请求都有同样结构。谈判类基准(Deal or No Deal、τ-bench)虽能自动验证结果,却只覆盖固定领域目标。论文用数据量化了这一缺陷:13 个模型中,目标完成度评分不低于 8/10 的对话里,35.99% 在结果验证中失败;Qwen3-8B 的 Feasibility 通过率有 49.58%,Verified Success 却只有 20.42%。
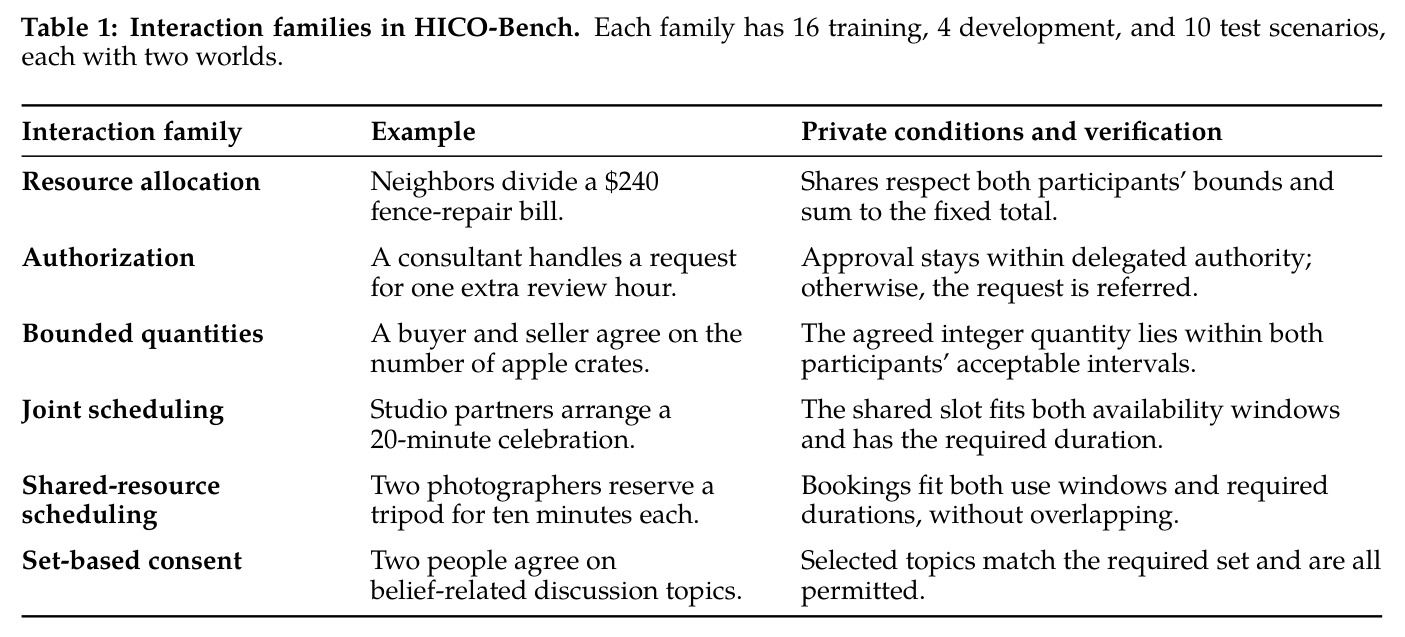
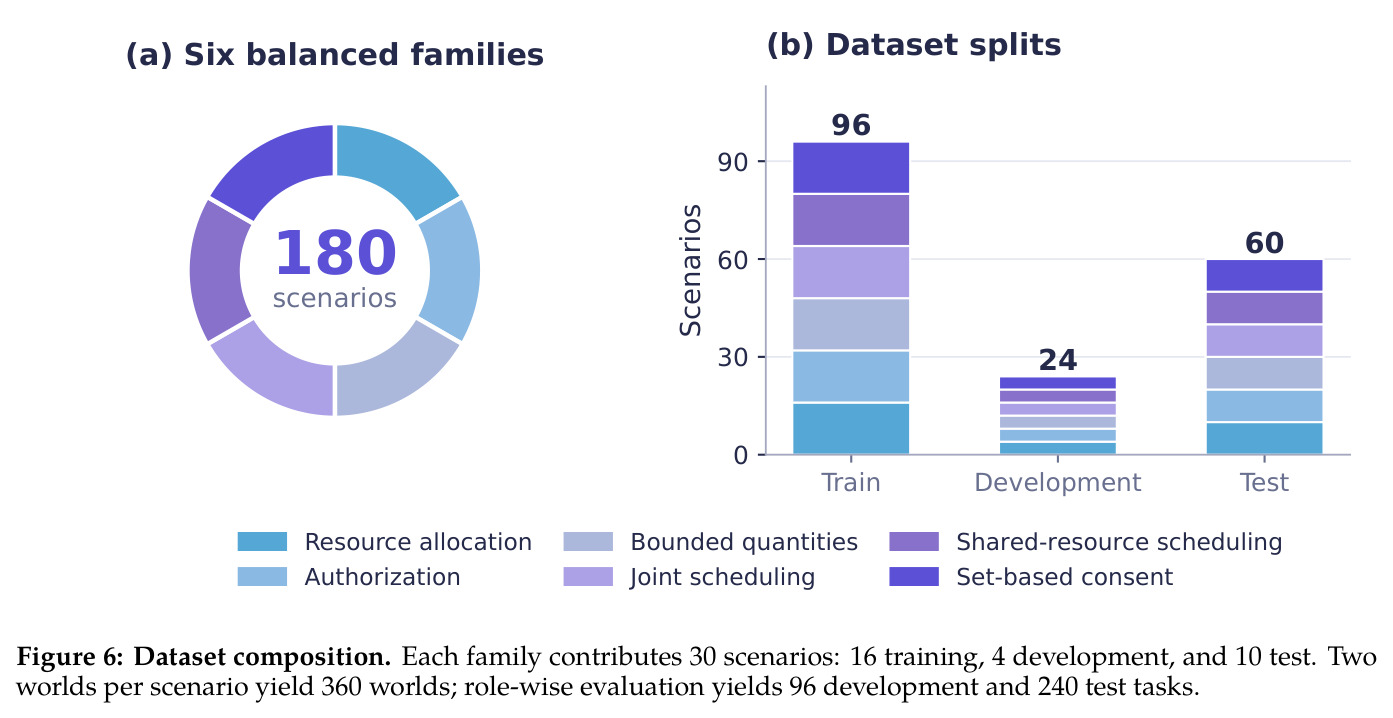
本文的目标是本文要同时解决评测与训练两个问题。评测上,构建 HICO-Bench(Hidden Information and Checkable Outcomes):180 个日常协调场景,覆盖资源分摊、授权审批、有界数量、共同日程、共享资源排期、集合式同意六个族;对话结束后双方各自独立填写结构化计划记录,程序检查 Feasibility(两条记录一致且满足双方隐私条件),LLM judge 检查 Integrity(对话内容真实支撑所记录的计划),两者同时通过才算 Verified Success。每个场景有两个仅相差一个隐私条件的“世界”,正确计划在两世界互斥。训练上,验证结果只在对话终局到达,作者提出 PaCPO,利用配对世界做逐轮信用分配,把 Qwen3-8B 的 Verified Success 从 20.4% 提升到 28.3%,超过同等预算的 PPO(25.0%)与 GRPO(26.3%)。
与已有工作不同的是,独特切入是“配对世界”这一设计同时服务评测与信用分配。评测上借鉴对比集思想:两个世界共享公开背景,只差一个隐私条件,且可行计划集合互不相交,于是在两个世界给出完全相同回应的智能体必然至少失败一个世界,从而迫使模型学会澄清而非拍胸脯。训练上,作者观察到决定性事实披露之后,智能体在两个世界形成的“暂定计划”应当分化,因此每轮在对话之外探测暂定计划并交叉检查 $M^t_{ij} = V(w_i, \hat{c}_{j,t})$:当本世界计划可行、而另一世界的计划不可行时,该轮获得正向信用。相比 SOTOPIA-RL 把噪声大的 LLM 评分摊派到各句,或 GiGPO 依赖相同状态跨轨迹重现(自由对话中几乎不发生),PaCPO 的每一笔信用都来自规则检查器,完全可验证。
核心方法
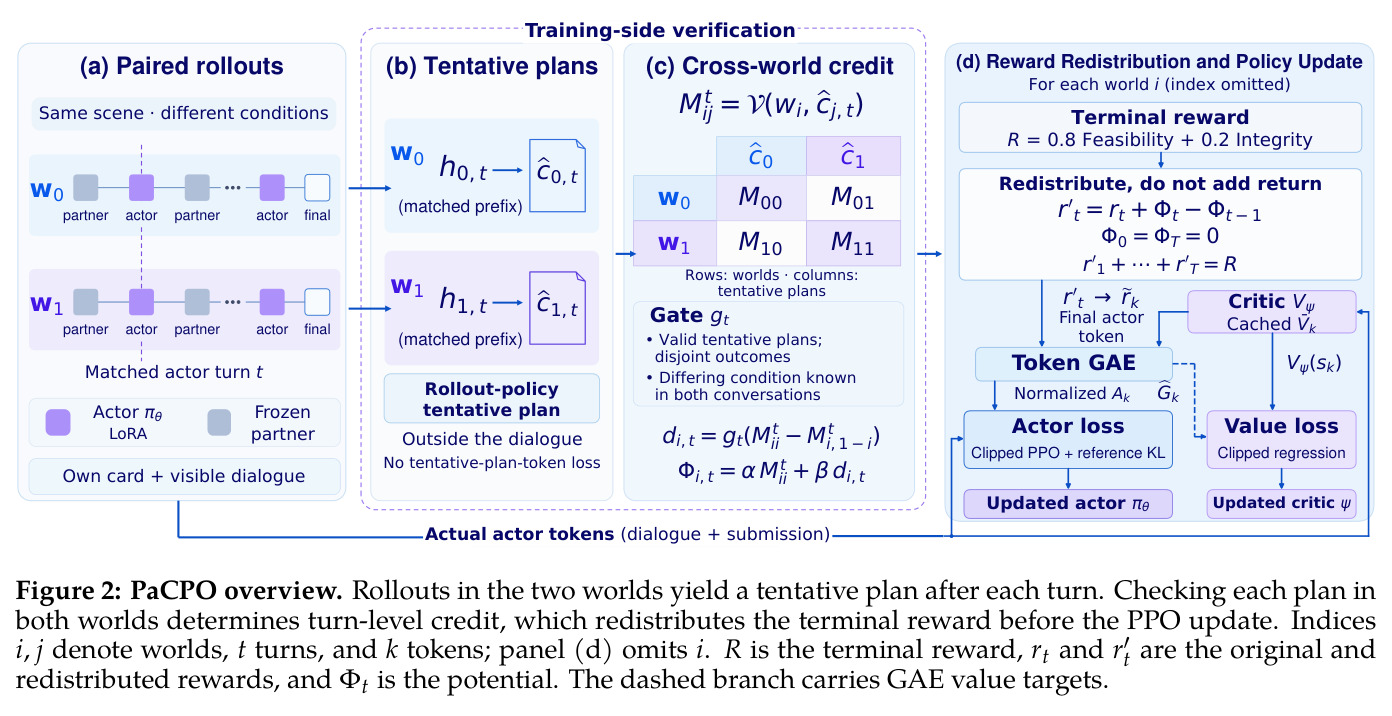
直觉是:好的协调对话会随关键隐私信息的披露逐渐收敛到贴合当前世界的计划,因此可以检测“计划何时正确分化”并给那一刻记功。PaCPO 不添加新奖励,仍只优化终局奖励 $R = 0.8F + 0.2I$,只把它重新分配到各轮。技术路线:每个场景在两个世界各 rollout 一条对话(被测角色对冻结伙伴);每轮 $t$ 后在对话之外探测暂定计划 $\hat{c}_{i,t} \sim \pi_{\theta_{old}}(\cdot \mid p, v_i, h_{i,t}, C)$;用 2×2 矩阵交叉检查两个暂定计划在两个世界的可行性;构造势函数 $\Phi_{i,t} = \alpha M^t_{ii} + \beta d_{i,t}$($\alpha=0.25$、$\beta=0.10$),按 $r'_{i,t} = r_{i,t} + \Phi_{i,t} - \Phi_{i,t-1}$ 重分配;因 $\Phi_{i,0} = \Phi_{i,T_i} = 0$,塑形项求和 telescope 归零,总回报严格不变。最后把 $r'_{i,t}$ 放在该轮最后一个 token 上,用 PPO 加 GAE 更新。
核心创新是“跨世界配对信用”:把同一场景的两个世界当作天然的反事实对照。定义门控 $g_t$,仅当三个条件同时满足才开启:两个暂定计划均合法、两个世界不存在共同可行计划、且那个不同的隐私条件在第 $t$ 轮前已对被测角色可得(在自己角色卡上,或被伙伴在对话中说出——由冻结的 LLM 标注器在训练中标记)。门控开启时配对信用为 $d_{i,t} = g_t (M^t_{ii} - M^t_{i,1-i})$,它度量“本世界形成的计划贴合本世界,而另一世界的计划不贴合”的分化程度。以 Maya/Leo 为例:Maya 披露能否出席后,Leo 在 $w_0$ 提出 Maya 主讲、在 $w_1$ 提出 Leo 主讲,则 $M^t = \begin{pmatrix} 1 & 0 \\ 0 & 1 \end{pmatrix}$,$d_{0,t} = d_{1,t} = 1$;若两个世界给出相同计划则信用为零。这间接奖励了“问对问题/引出关键事实”的行为,而不需要直接给提问本身打分。
方法步骤详情
流程分四步。第一步配对 rollout:同一被测角色在 $w_0$、$w_1$ 各与冻结伙伴对话一条,双方可见信息只有公开背景 $p$、自己的角色卡 $v_i$ 与历史 $h$;结束时按公开模板 $C$ 独立填写结构化记录 $c_1, c_2$。第二步逐轮探测暂定计划:每轮 $t < T_i$ 后在对话之外让策略生成“如果现在结束我会填的记录”$\hat{c}_{i,t}$,不写进对话。第三步计算信用:程序检查 $M^t_{ij} = V(w_i, \hat{c}_{j,t})$,结合门控得 $d_{i,t}$ 与势函数 $\Phi_{i,t} = \alpha M^t_{ii} + \beta d_{i,t}$;条件是否披露由冻结 LLM 标注器标记。第四步更新:设 $r_{i,T_i} = R_i$、其余为 0,按公式 (7) 得 $r'_{i,t}$,逐轮总和严格等于 $R_i$;将其置于该轮最后一个 token,用 token 级 GAE 与 PPO clip 加参考 KL 更新,暂定计划 token 不计损失。训练配置:Qwen3-8B 加 LoRA,每轮 RL 用 384 条对话覆盖全部 96 个训练场景,训练 judge 为本地 Qwen3.8-27B。
技术新颖性
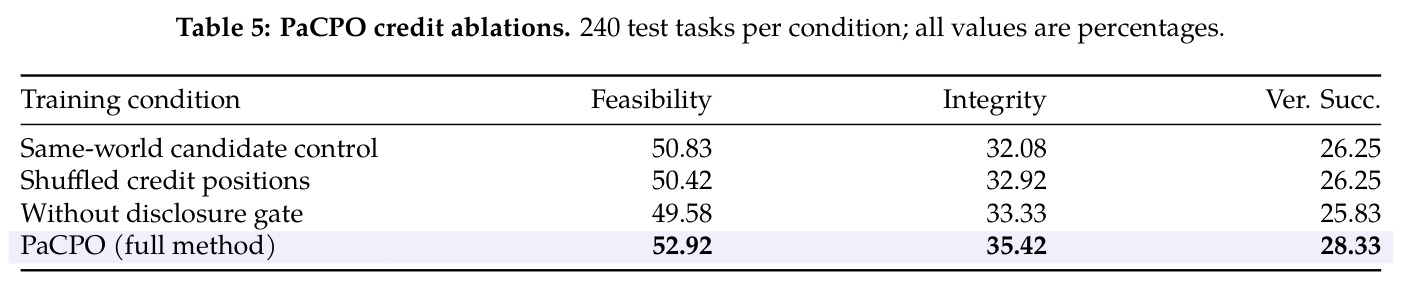
与已有工作的本质区别有三点。其一,信用信号完全可验证:SOTOPIA-RL 与 SAVOIR 依赖 LLM judge 把对话评分摊派到各句,噪声大且易被奖励黑客利用;PaCPO 的每笔信用来自规则检查器 $V$,无模型噪声。其二,不要求状态重现:GiGPO、GraphGPO 需要在多条 rollout 中找到共享同一状态的步骤来两两比较,而自由对话中相同状态几乎不出现;配对世界在构造上保证了可比性——同一被测角色、同一公开背景、只差一个隐私条件。其三,重分配而非增发:基于势函数塑形的策略不变性保证,总回报不变,只是把终局奖励中属于“披露条件导致计划正确分化”的部分提前记到相应轮次。表 5 的消融印证了每个组件都必要:把另一世界的计划换成同世界的第二个计划得 26.25%,打乱信用对应轮次得 26.25%,去掉披露门控掉到 25.83%(降幅最大),完整方法 28.33%。
实验结果
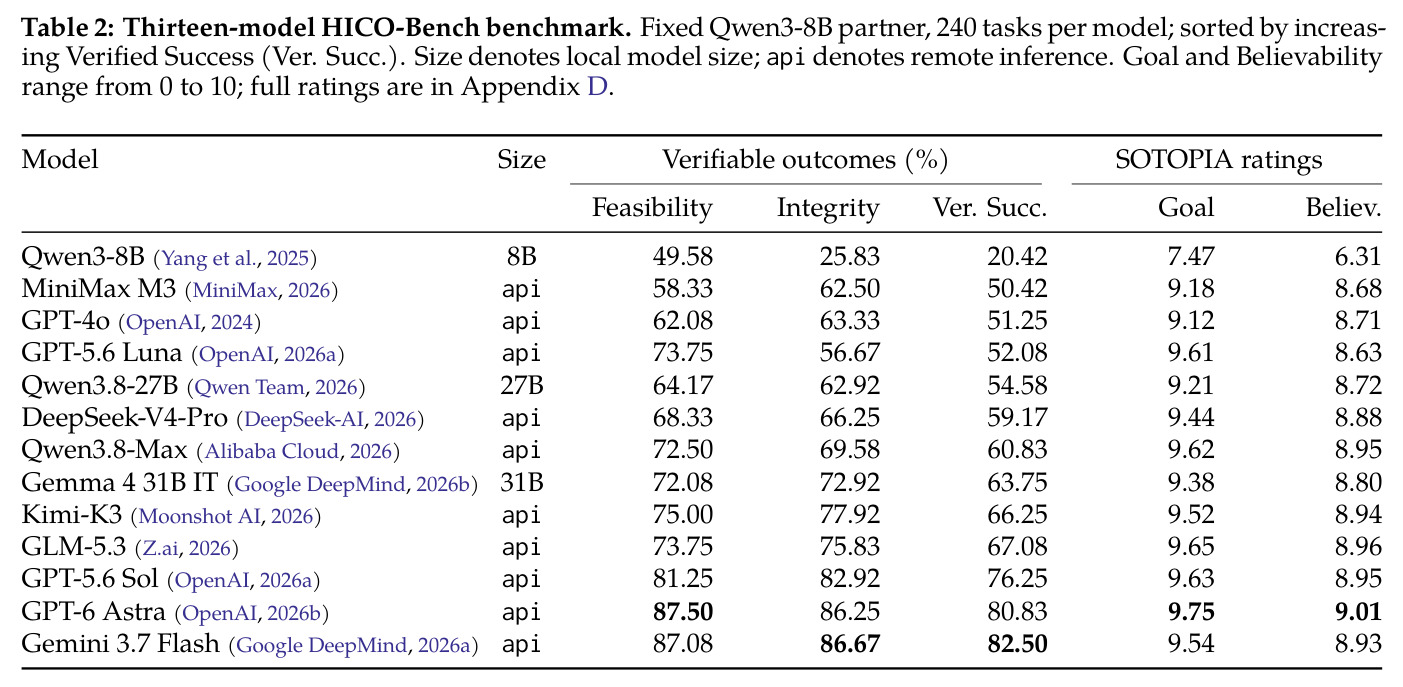
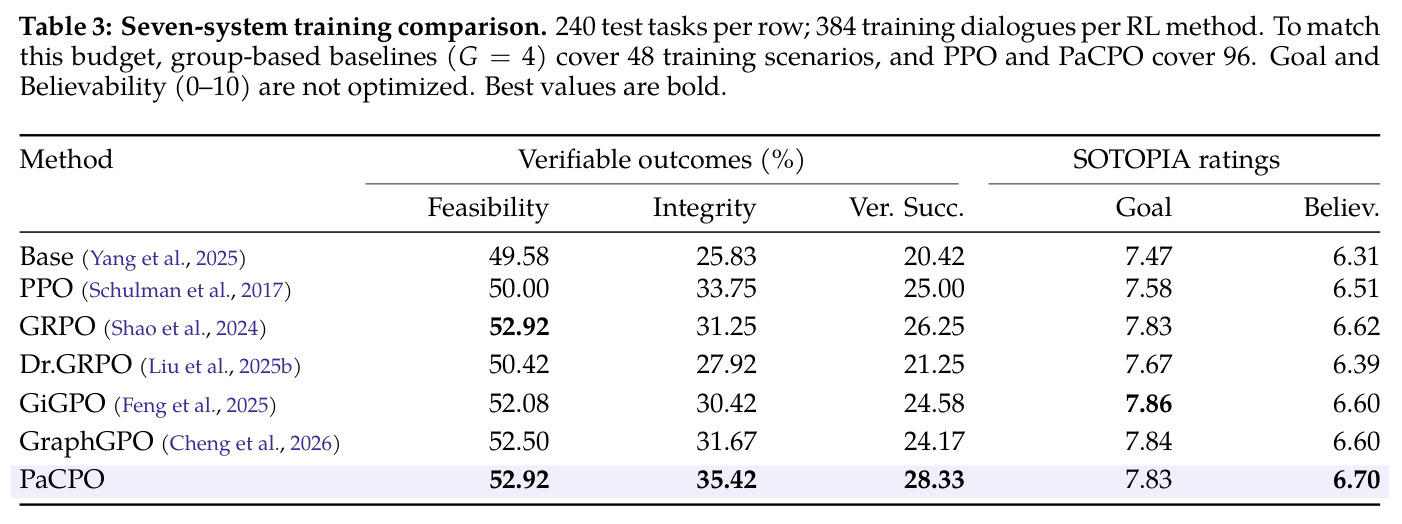
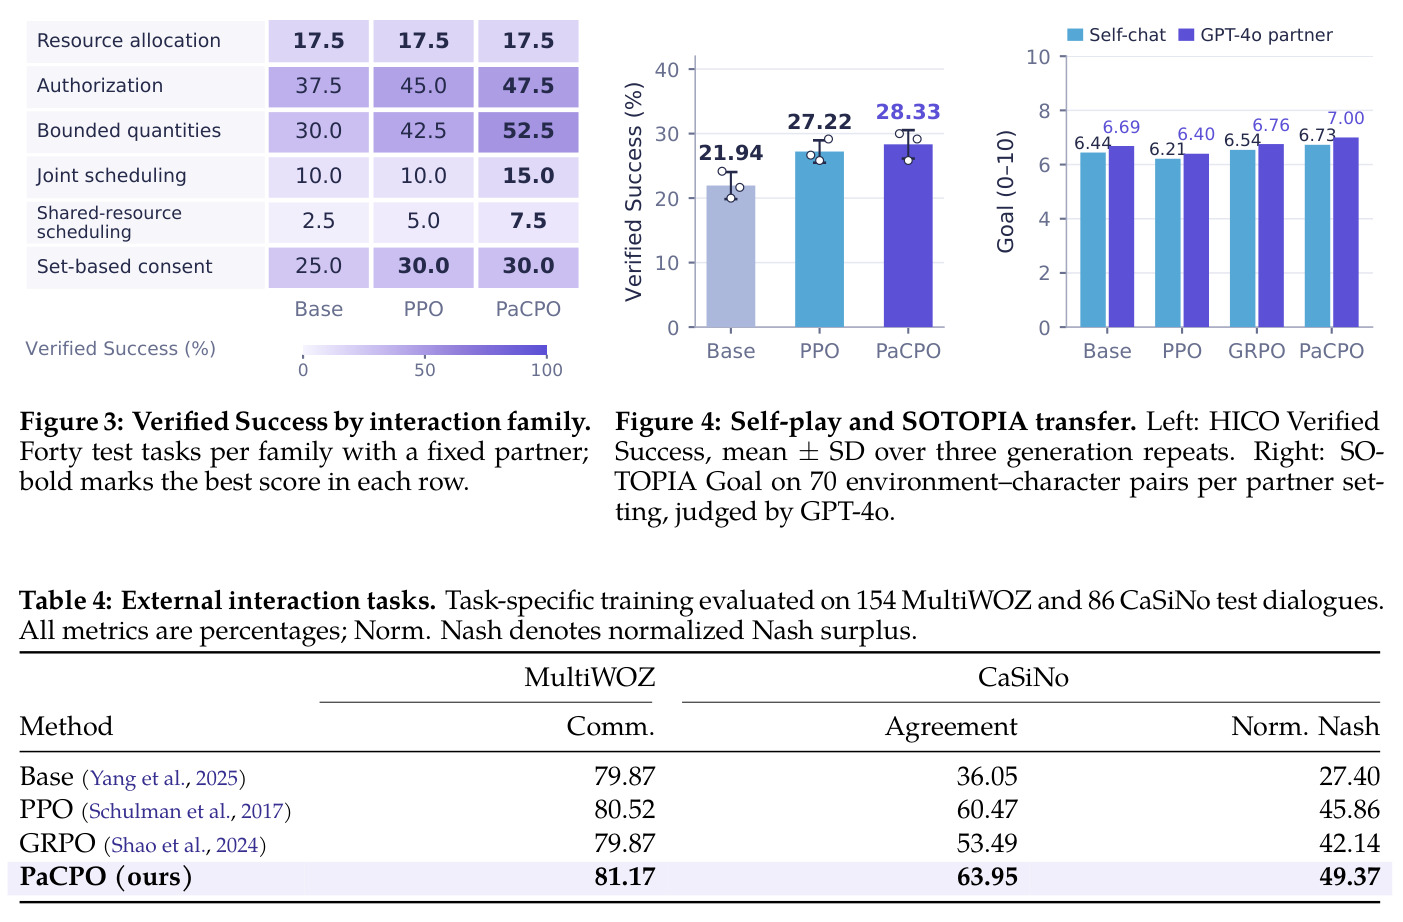
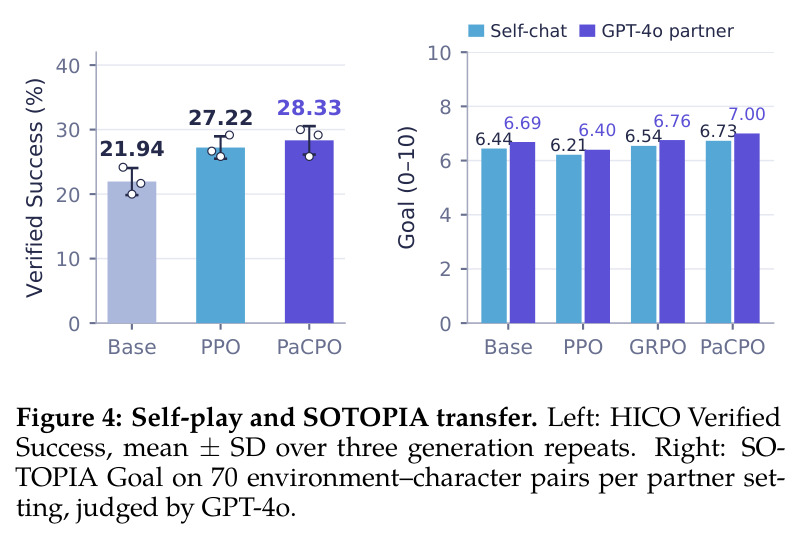
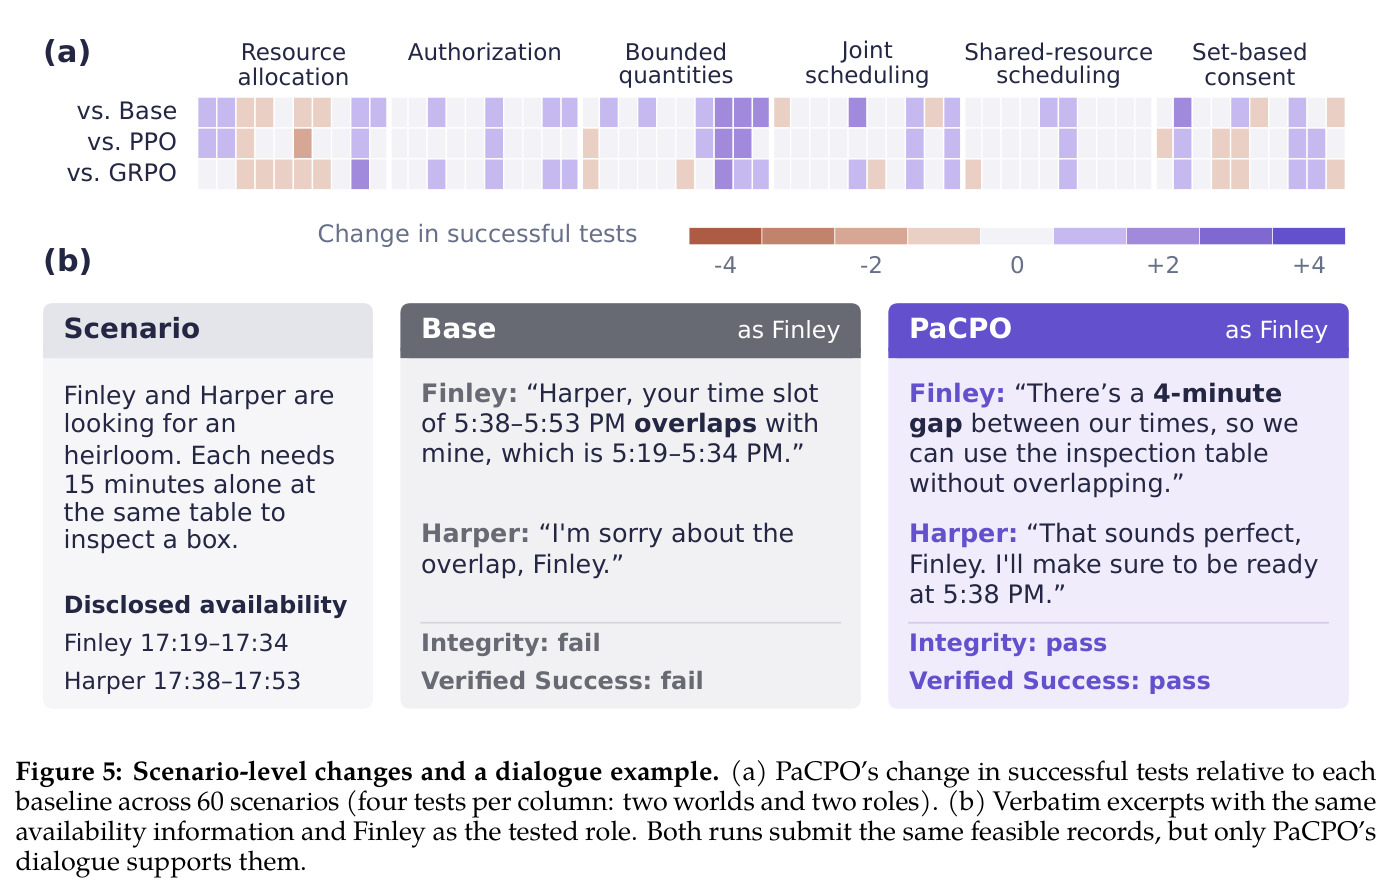
多模型评测(表 2):13 个模型在 240 个测试任务上 Verified Success 从 Qwen3-8B 的 20.42% 到 Gemini 3.7 Flash 的 82.50%;GPT-5.6 Luna 的 Goal 评分 9.61 高于 Gemini 的 9.54,Verified Success 却只有 52.08%,说明评分与验证排序背离。训练对比(表 3):同等 384 条对话预算下 PaCPO 达 28.33%(Feasibility 52.92%、Integrity 35.42%),超过 GRPO 26.25%、PPO 25.00%,较基座 +7.92 点;未优化的 Goal/Believability 也从 7.47/6.31 升至 7.83/6.70。分族看(图 3)有界数量 +22.50 点、授权 +10.00 点最大,资源分摊停滞在 17.5%。自博弈 PaCPO 28.33%,超基座 6.39、超 PPO 1.11 点;迁移 SOTOPIA 两伙伴设定均领先。外部任务(表 4)CaSiNo 协议率 63.95%(PPO 60.47)、Nash 剩余 49.37,MultiWOZ 81.17%。人工试点与 Feasibility 一致率 100%、与 Integrity 82.22%;judge 间一致率 90.0%(κ=0.78)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HICO-Bench(240 测试任务,固定 Qwen3-8B 伙伴) | Verified Success (%) | PaCPO 训练 Qwen3-8B 达 28.33 | Base 20.42;PPO 25.00;GRPO 26.25 | 较 Base +7.92 点,较最强 RL 基线 GRPO +2.08 点 |
| HICO-Bench 多模型评测 | Verified Success (%) | 最强模型 Gemini 3.7 Flash 达 82.50(GPT-6 Astra 80.83) | GPT-5.6 Luna 仅 52.08 但 Goal 评分更高(9.61 对 9.54) | 揭示对话评分与可验证结果可相差 30 点以上 |
| CaSiNo 谈判(86 条测试对话) | Agreement (%) / Norm. Nash | PaCPO 63.95 / 49.37 | Base 36.05 / 27.40;PPO 60.47 / 45.86 | 协议率 +3.48 点、Nash 剩余 +3.51(对 PPO) |
| MultiWOZ 约束沟通(154 条测试对话) | Comm. (%) | 81.17 | Base 79.87;PPO 80.52 | +1.30 点,收益小于谈判任务 |
| HICO-Bench 自博弈(3 次生成重复) | Verified Success 均值 (%) | PaCPO 28.33 | PPO 27.22;Base 21.94 | 较 Base +6.39 点、较 PPO +1.11 点 |
局限与改进
作者承认:基准目前只覆盖六类结果结构明确的协调族,向更松散的开放交互扩展仍是开放问题;Integrity 依赖 LLM judge,虽有跨模型一致率 90.0%(κ=0.78)与 82.22% 的人工一致率,仍是潜在噪声源与被操纵面。我的补充观察:其一,训练 judge(本地 Qwen3.8-27B)与评测 judge(Qwen3.8-Max)同属一个模型家族,可能存在系统性偏好;其二,整体上限不高——最强模型也只有 82.5%,而资源分摊族三个方法都卡在 17.5%,无法排除验证器过严或场景歧义的问题;其三,验证只接受预定义模板的结构化记录,真实协调的结果形式更多样;其四,评测中被测角色对固定 Qwen3-8B 伙伴,虽有自博弈与 SOTOPIA 迁移补充,伙伴多样性仍有限;其五,逐轮探测暂定计划带来可观的额外推理开销,训练成本详情被移到附录 E.2。
独立分析的弱点
第一,奖励权重与塑形系数均为手工设定:终局奖励 $R = 0.8F + 0.2I$ 以及 $\alpha=0.25$、$\beta=0.10$ 都未报告敏感性分析,不同配比下 Feasibility 与 Integrity 的权衡可能明显不同,改进方向是做网格搜索或按失败类型自适应加权。第二,Integrity 的四类违规(未纠正的事实错误、无进展的重复、记录与口头矛盾、格式泄漏)全靠单个 LLM 引用证据判定,长对话可能稀释违规信号、措辞可能掩盖矛盾,可引入多 judge 投票或针对每类违规的专用对抗探针。第三,门控把“条件已在自己卡上”与“被伙伴说出”同等对待,无法区分模型是靠主动提问还是靠运气获得信息,可对主动引出关键事实的轮次给予区分性信用。第四,被测角色的奖励在两世界独立计算,未建模伙伴也在适应的对称学习情形,可扩展联合训练。第五,资源分摊族 17.5% 的平台期提示需要审计该族场景与验证规则的质量,排除标签噪声。
未来方向
作者明确提出:把程序化验证扩展到结果不那么结构化的交互(开放式建议、情感支持类对话),并扩大人工验证规模。基于本文成果还可延伸:其一,把配对世界推广到三方及以上协调与联盟形成,研究多条件差异下信用如何在轮次与事实间分解;其二,用 PaCPO 的逐轮信用蒸馏过程奖励模型(PRM),推理时免去逐轮探测暂定计划的开销;其三,对现成对话离线生成配对版本做反事实数据增强,摆脱 rollout 依赖;其四,把差异隐私条件从一个扩展到多个,检验门控与势函数设计的可扩展性;其五,结合澄清问题的自动检测,定量分析 PaCPO 学到的提问策略与信息增益的关系;其六,在 30B 以上开源模型与更多协调族上验证方法的规模效应与外推性。
复现评估
复现友好度较高。论文承诺发布场景谱系、双世界角色卡、验证器及其正反例测试、全部提示词与评分细则、训练配置和 checkpoint ID;附录 A/B 给出场景族与判定标准,附录 E 给出算法与训练成本,附录 H/I 给出外部评测协议。算力需求适中:Qwen3-8B 加 LoRA、每方法仅 384 条训练对话,单机多卡即可承担;主要外部成本是评测 judge 的 API 费用(Qwen3.8-Max、GPT-4o、Kimi-K3),训练期 Integrity judge 为本地 27B 模型。最大工作量在数据构造:180 个场景乘以两个世界,且必须保证两世界无可共同满足的计划,验证器还需在正确与错误计划上做过测试;若作者如期开源,直接复现训练约需数天,从零构造同类基准则需要较多人工写作与 LLM 辅助。风险点是 Integrity 依赖具体 judge 版本与提示词,一旦更换,数字可能漂移,复现时应严格固定。
论文图表
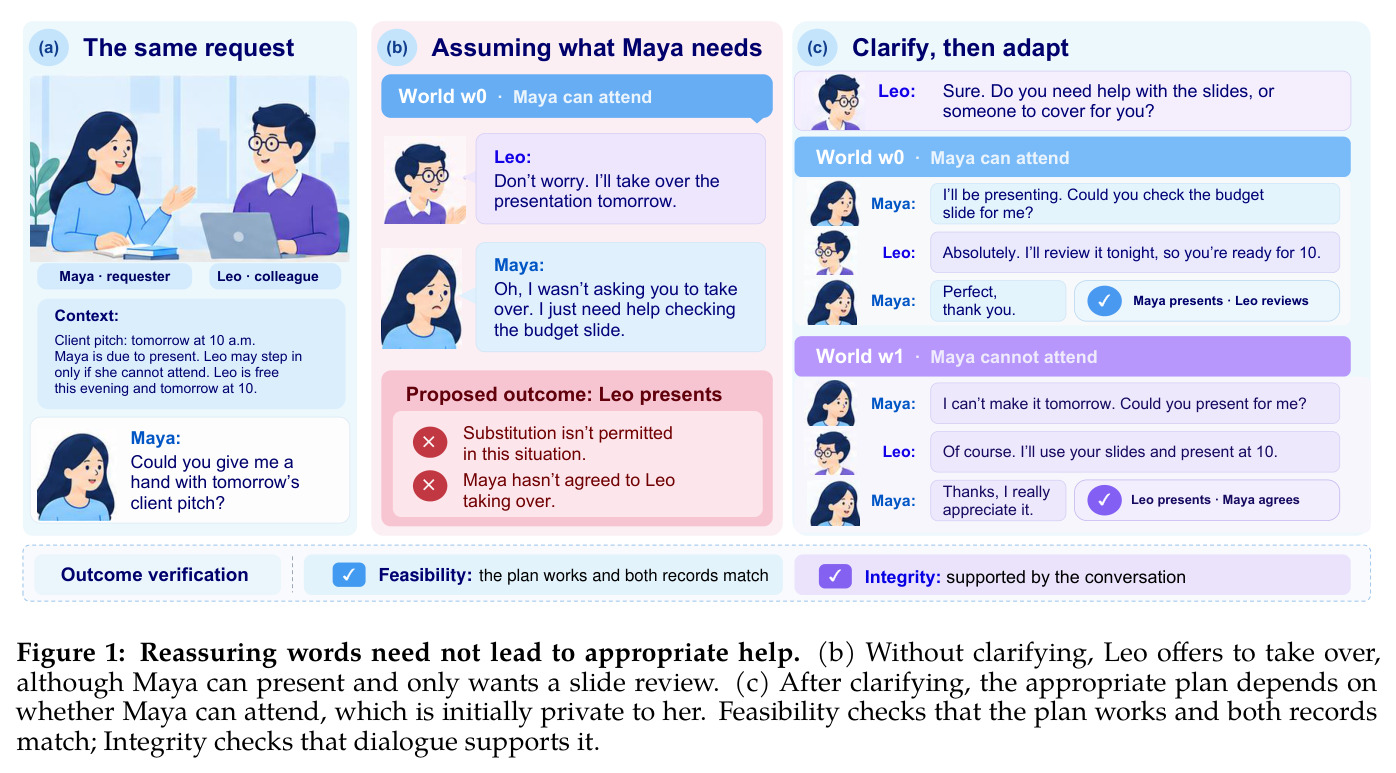
以 Maya 请求 Leo 协助客户汇报为例的三联图:(a) 同一请求在不同世界有不同正确答案;(b) 不澄清的 Leo 直接说“我来讲”,但 Maya 能出席、只想让人检查预算页,计划失败(标记 ✕);(c) 先澄清再行动,$w_0$ 中 Maya 主讲、Leo 检查幻灯,$w_1$ 中 Leo 代讲、Maya 同意,均通过验证。底部说明两项检查:Feasibility 验证计划可行且双方记录一致,Integrity 验证对话支撑所记录的计划。
这是全文的动机实例,直观展示“听起来体贴的回复可能产出失败计划”以及配对世界如何逼出澄清行为,不看这张图就无法理解 Feasibility/Integrity 与配对设计的意义。