LatentLoop:用非对称算力分配扩展循环 MoE 模型 LatentLoop: Scaling Looped MoE Models with Asymmetric Compute Allocation
压缩首次循环序列、省下算力加宽模型,同预算下循环MoE更准更省
前置知识
MoE(稀疏混合专家)
稀疏混合专家 Transformer 用可学习的路由器为每个 token 从大量专家前馈网络中只激活少数几个(本文 8 个),使存储参数量与每 token 计算量解耦:专家总数可以远大于激活数,从而在计算预算不变时扩大模型容量。Qwen3、Switch Transformer 等都属于这一类架构。
本文的预算匹配正是依赖 MoE『存储专家数可调、激活数不变』的特性来分别对齐参数与算力,LatentLoop 的参数共享策略也围绕 MoE 路由与专家权重展开。
循环 Transformer(Looped Transformer)
把一组层(本文是中间一半层)的参数在多个『访问(visit)』中重复执行,用参数复用换取有效深度,代表工作有 Universal Transformer、Huginn、Ouro。循环 MoE(如 SMELT)把它与稀疏专家结合,在参数量、KV cache、FLOPs 全部匹配的预算下仍能取得增益。
LatentLoop 直接以 SMELT 的两访问循环 MoE 为基线,所有改进都发生在『同一个中间块被访问两次』的框架之内。
残差流与残差缩放
Transformer 每层以 $h' = h + f(h)$ 的形式更新残差流;给更新项乘一个可学习系数 $?lpha$ 就是残差缩放,可控制该分支对表示的影响强度。本文给每次访问配一个标量系数 $\alpha_v$,发现第一次访问收敛到约 0.27–0.36,第二次接近 1。
这个不对称观察是整篇论文动机与方法设计(压缩首次访问、可学习写回系数)的直接实验依据。
缩放律与计算最优前沿
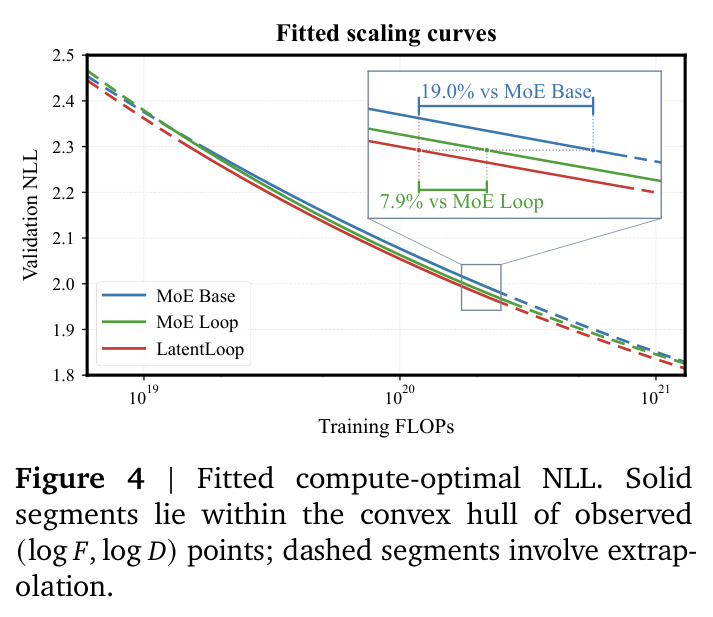
用幂律 $\hat{L}(F,D) = E + A(F/10^9)^{-\alpha} + K(D/10^{10})^{-\beta}$ 拟合验证损失随训练 FLOPs $F$ 和 token 数 $D$ 的变化,再在固定总算力 $C = FD$ 下求最优的 $F$ 与 $D$ 分配,得到『计算最优前沿』,用于横向比较不同架构的算力效率。
论文『节省 19.0%/7.9% 训练算力』的结论正是由这条拟合曲线在 NLL=1.988 处的横向比较得出的。
KV cache 与预算匹配
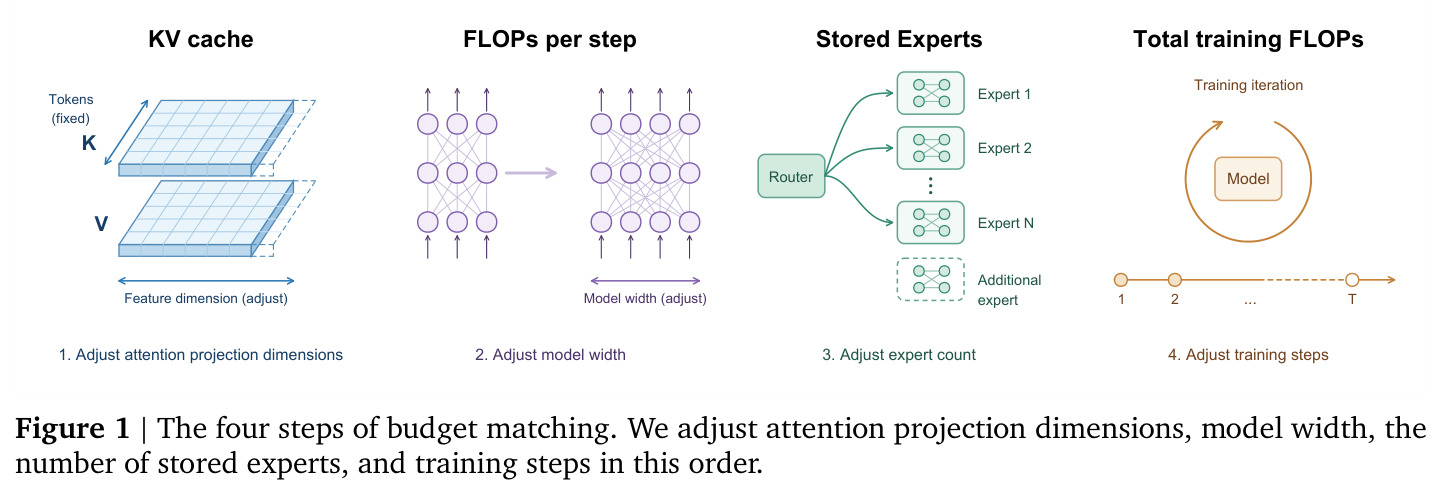
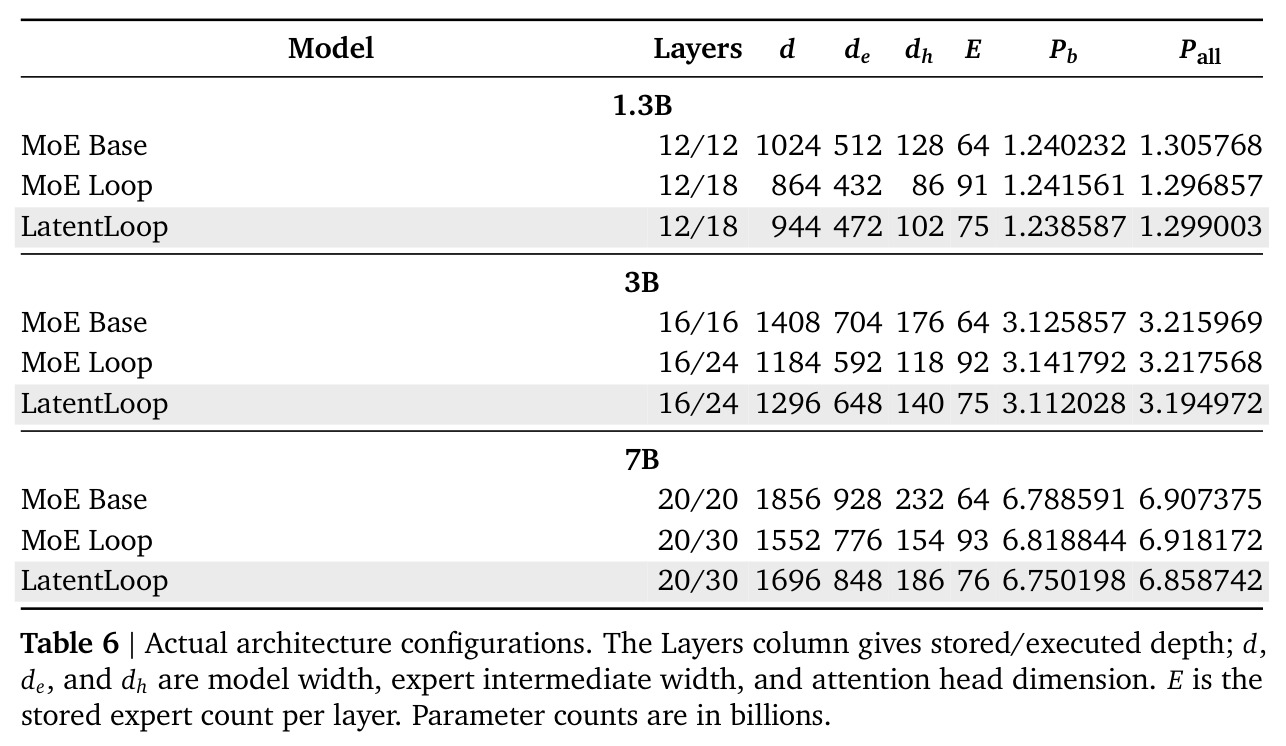
KV cache 缓存注意力的键值向量以避免重算,其大小与序列长度、层数和 KV 头维度成正比,是推理显存的主要瓶颈之一。预算匹配指比较架构时依次调节注意力投影维度、模型宽度、存储专家数和训练步数,使 KV cache、每 token FLOPs、参数量与总训练 FLOPs 的偏差都控制在约 1% 内。
这是本文所有对比实验公平性的基石,理解它才能明白『同预算下更准』的确切含义。
研究动机
循环 Transformer 通过重复使用共享层来增加有效深度,在参数量固定时确实能提升语言建模与推理能力;但每一次循环都要付出真实的计算代价,参数相同并不等于算力相同,因此固定参数量下的优势不能说明真实的资源效率。近期工作 SMELT 把循环与 MoE 结合,在存储参数、KV cache、每步 FLOPs 和总训练 FLOPs 都严格匹配(偏差 1% 内)的预算下证明了循环 MoE 的优势,但该设定把两次访问完全对等对待:相同的序列长度、完全共享的参数、残差系数都固定为 1。这种对称假设可能浪费算力——如果两次访问本来就扮演不同角色,把宝贵的计算均匀洒在两次访问上未必最优。此外,此前不少循环模型(Huginn、Ouro 等)只在固定参数量下比较,等于悄悄给了循环模型更多计算,结论难以回答『同等总算力谁更强』。
本文的目标是本文的目标是在 SMELT 式严格预算匹配(存储骨干参数、KV cache、每 token FLOPs、总训练 FLOPs 的最大偏差分别控制在 0.6%、0.8%、0.9%)下,进一步压低循环 MoE 的验证 NLL 并提升下游性能。路线分三步:先探测两次循环是否天然偏好不同的更新强度——为每次访问引入可学习残差系数 $\alpha_v$;若确认不对称,就探索把首次访问的计算降下来、把省出的预算按匹配规则重新分配到模型宽度;最后解决随之而来的两个设计问题:潜空间增量写回全分辨率序列时如何校准尺度,以及两次访问处理不同分辨率时参数共享策略是否应调整。最终要在 1.3B–7B 三档、共 15 个预算配置、最大训练算力超过 $10^{21}$ FLOPs 的规模上,验证非对称算力分配是一致有效的缩放方向。
与已有工作不同的是,本文的独特之处在于『先测量、再设计』的研究路径。作者不直接堆机制,而是先用可学习残差系数做探针:1.3B 和 3B 两个循环基线训练后,两次访问的系数分别收敛到约 (0.27, 0.87) 和 (0.36, 1.09),第一次访问天然想要小得多的更新幅度;固定系数实验进一步显示,把首次访问系数降到 0.25 反而让验证 NLL 降低约 0.008/0.003,而同样降低第二次访问则明显变差。由『第一次访问的更新本就该小』自然推出『它的计算也可以少』,从而引出非对称算力分配。与 SpiralFormer 这类在循环模型中做序列压缩的工作相比,本文落在 MoE 架构与严格预算匹配框架内:把压缩省出的 FLOPs 重新投资为更宽的骨干,并系统研究写回校准与选择性参数共享,而不是学习多分辨率调度。
核心方法
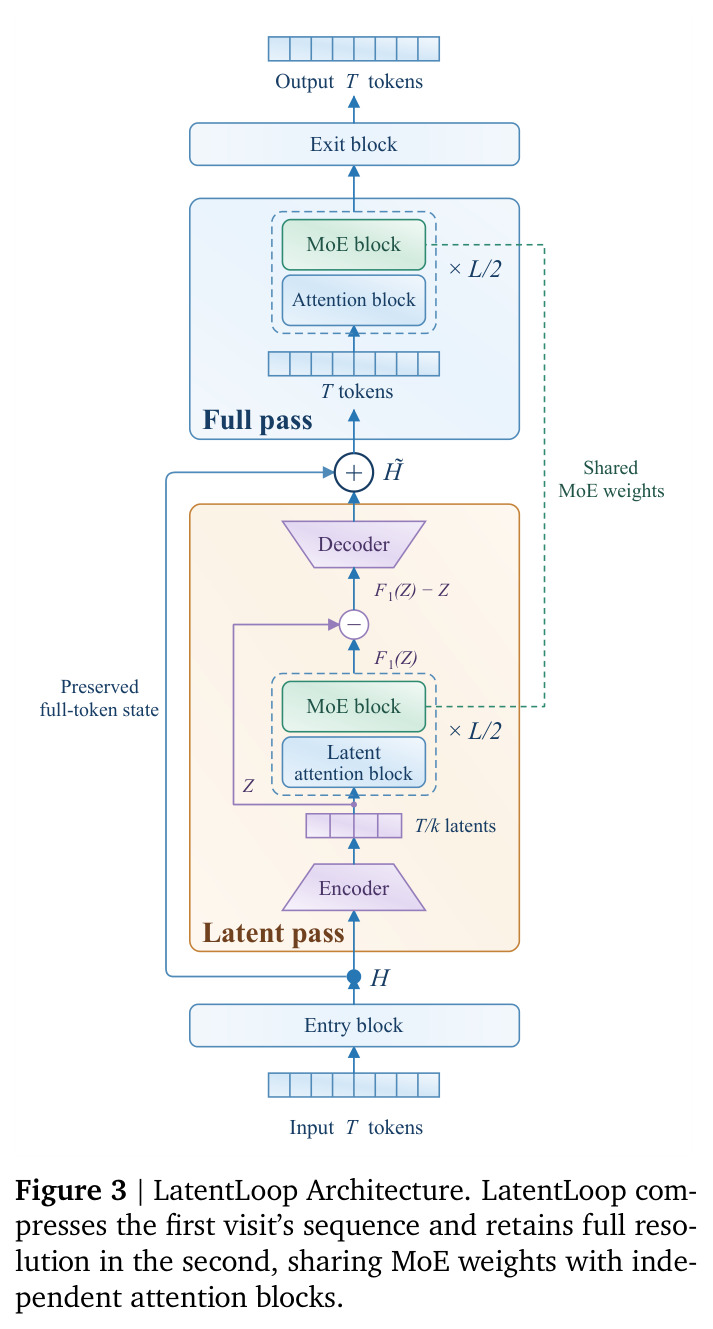
既然两次循环天然不对称,就让第一次访问在压缩后的潜空间里轻量工作,第二次在完整序列上精细加工,省下的计算按预算匹配规则换成更宽的模型。形式化地,设入口块输出 $H \in \mathbb{R}^{T \times d}$,压缩因子 $k=2$ 时均值编码器 $Z_j = (H_{2j-1} + H_{2j})/2$ 得到长度 $l = T/k$ 的潜序列;第一次访问 $F_1$ 在 $Z$ 上执行共享中间块,得潜增量 $\Delta = F_1(Z) - Z$;缩放解码器按 $\mathrm{Dec}(\Delta)_{kj+s} = w_s \odot \Delta_j$ 把增量因果对齐写回,得 $\tilde{H} = H + \mathrm{Dec}(\Delta)$;第二次访问 $F_2(\tilde{H})$ 的输出送入出口块。写回系数 $w_0, w_1 \in \mathbb{R}^d$ 仅增 $2d$ 个参数。MoE 路由与专家两次访问共享以保留参数复用,注意力块各自独立;为塞进参数预算,每层存储专家从 76 减到 75,激活的 8 个专家不变。
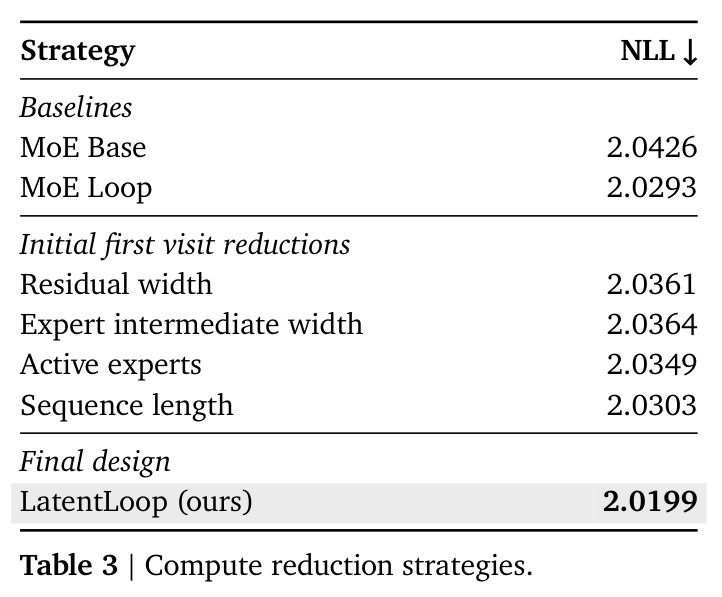
核心创新是把『残差尺度不对称』这一经验观察转化为『算力分配不对称』的架构原则。与已有工作的本质区别有三点。其一,SMELT 等循环 MoE 对两次访问一视同仁(同序列、全共享参数、残差系数为 1),LatentLoop 首次用数据证明两次访问偏好不同更新幅度,并据此把首次访问压缩为潜序列;Wang et al. 的对称 $1/N$ 缩放(如 (0.5, 0.5))在两个尺寸上都逊于非对称的 (0.25, 1)。其二,在四种首次访问降算方案中(残差宽度减半 NLL 2.0361、专家中间宽度减半 2.0364、激活专家 8→4 得 2.0349、序列压缩得 2.0303),序列压缩胜出的原因在于它在每个潜位置仍保留全部模型宽度和 8 个激活专家,不限制每个 token 可用的容量,而省出的算力换成更宽的骨干,等于『少算一些位置、每个位置算得更宽』。其三,参数共享是选择性的:占绝大多数参数的 MoE 共享、轻量的注意力解绑,且实验表明这种解绑只在压缩设定下才有收益。
方法步骤详情
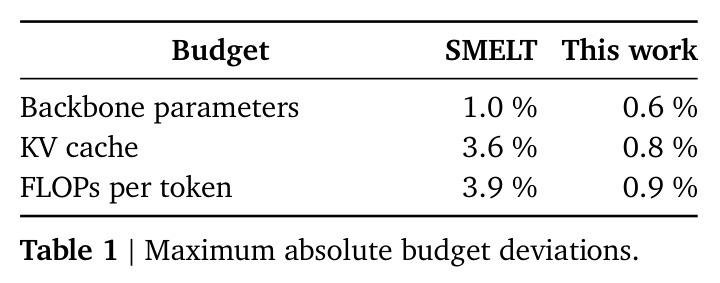
第一步:预算匹配,依次调注意力投影维度对齐 KV cache、调模型宽度对齐每 token FLOPs、调存储专家数对齐参数预算、取整数步数对齐总训练 FLOPs,最大偏差仅 0.6%/0.8%/0.9%,优于 SMELT 的 1.0%/3.6%/3.9%。第二步:训练基线 MoE Base(64 存储专家/层,执行一次)与 MoE Loop(中间一半层共享参数访问两次)。第三步:引入残差探针 $h' = h + \alpha_v f_\ell(h)$ 联合优化,1.3B/3B 系数收敛到约 (0.27, 0.87)/(0.36, 1.09);再用固定系数网格 $\{0.125, 0.25, 0.5, 2\}$ 验证不对称。第四步:比较四种首次降算策略,序列压缩胜出。第五步:组装 LatentLoop——均值编码、缩放解码器写回、MoE 共享、注意力独立、专家 76→75。第六步:在 15 个配置上训练并拟合缩放律 $\hat{L}(F,D) = E + A(F/10^9)^{-\alpha} + K(D/10^{10})^{-\beta}$,再评 9 基准 0/5-shot 与消融。
技术新颖性
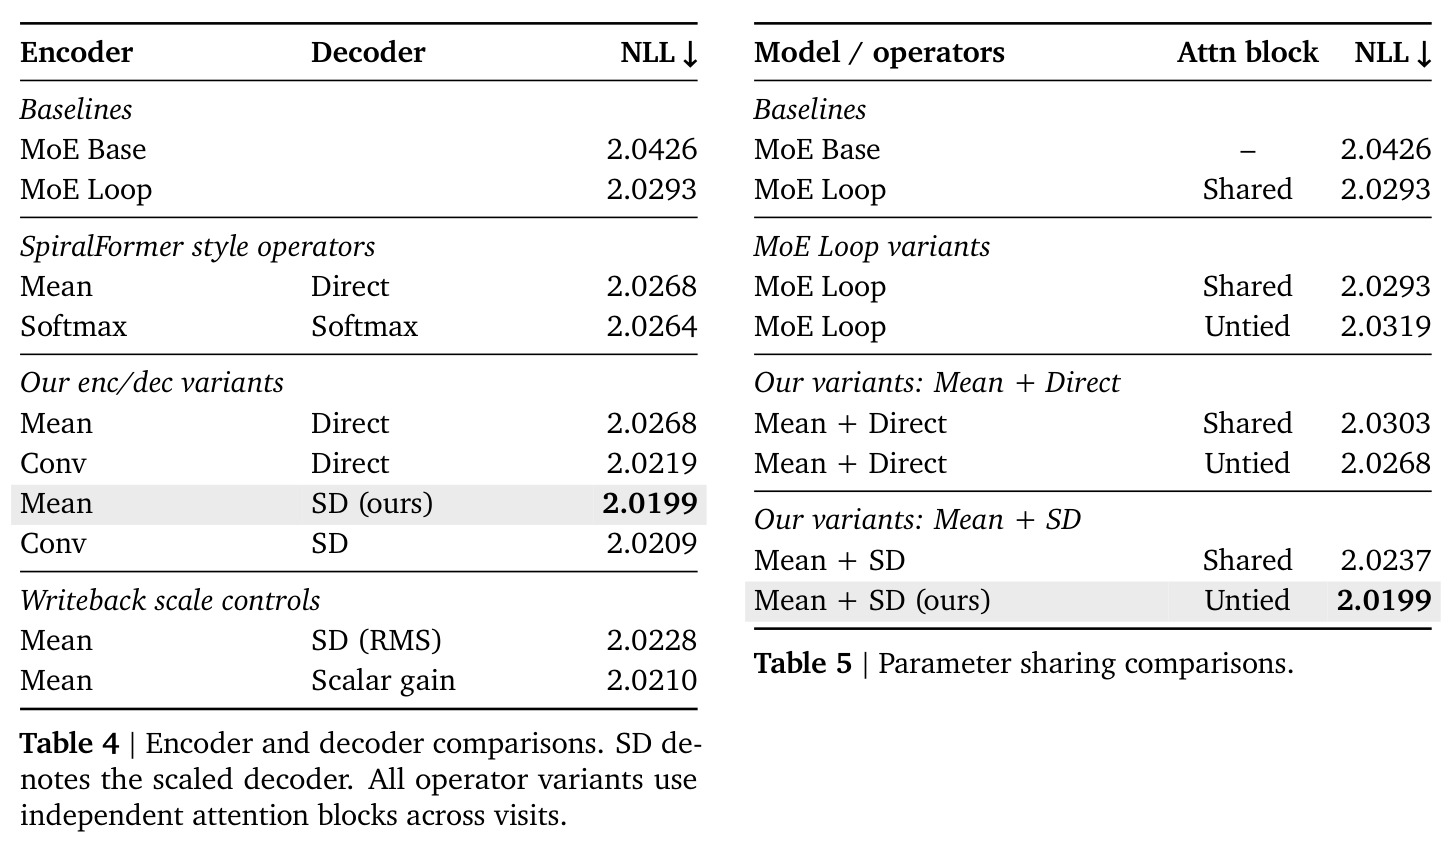
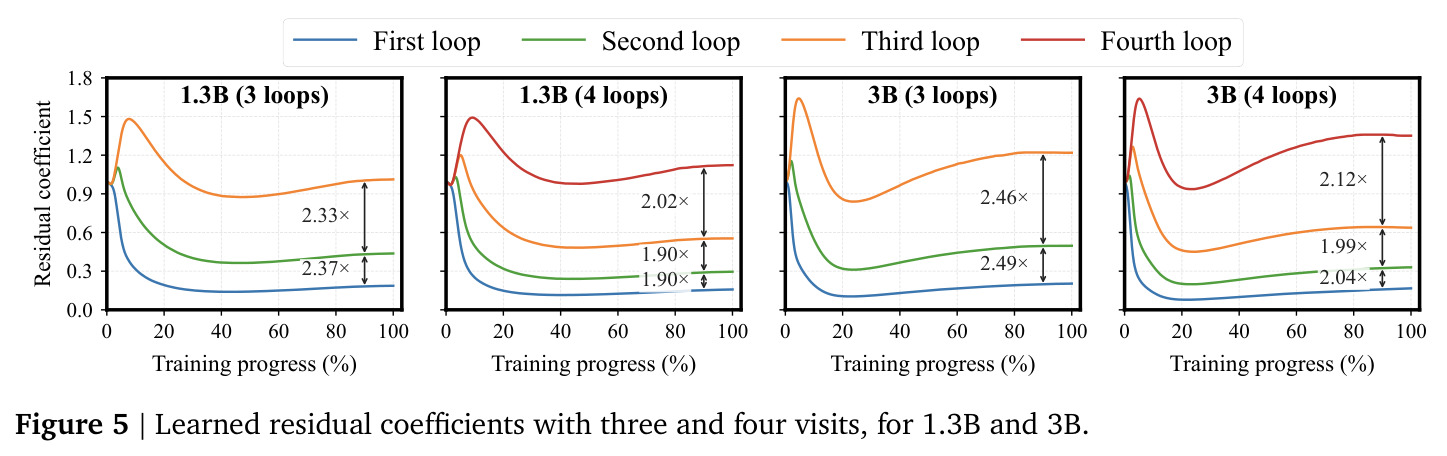
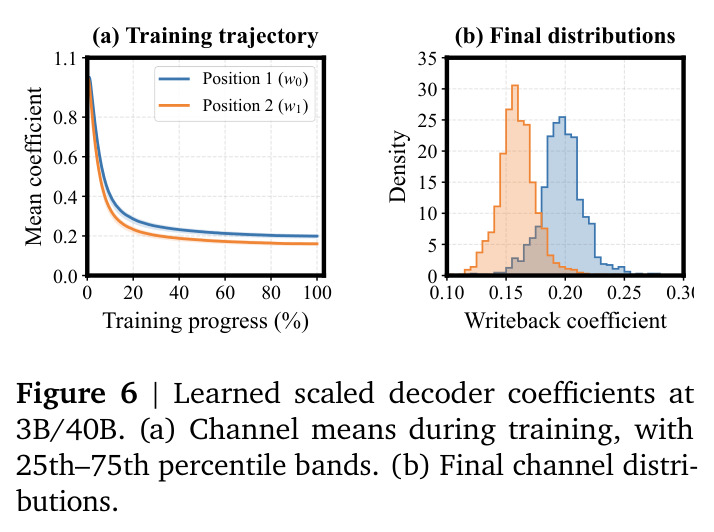
技术新颖性有四层。第一,可学习残差系数作为架构诊断工具:每次访问只加一个标量 $\alpha_v$,零参数代价地揭示循环角色不对称,并推广到 3/4 次循环——系数随访问序号递增,训练末期相邻比值约 2.4×(3 次)与 2.0×(4 次)。第二,缩放解码器(SD):为每个通道和接收位置学一个写回系数($k=2$ 时仅 $2d$ 参数),学习后通道均值约 0.199/0.160,远低于初始化 1,且更近的接收位置 $2j$ 系数更高——其源对包含自身当前状态、信息更可靠;消融显示单标量增益已恢复大部分改进(2.0210,对比直接写回 2.0268),通道级再添一点(2.0199),固定整体 RMS 的变体(2.0228)说明『整体尺度可学』才是关键。第三,选择性共享:压缩设定下注意力解绑使 NLL 从 2.0237 降至 2.0199,普通 MoE Loop 解绑反而从 2.0293 恶化到 2.0319;同期工作的解绑收益可能源于未削减专家数、参数未对齐。第四,四步预算匹配(偏差不超过 0.9%)让全部结论建立在真正同等的资源之上。
实验结果
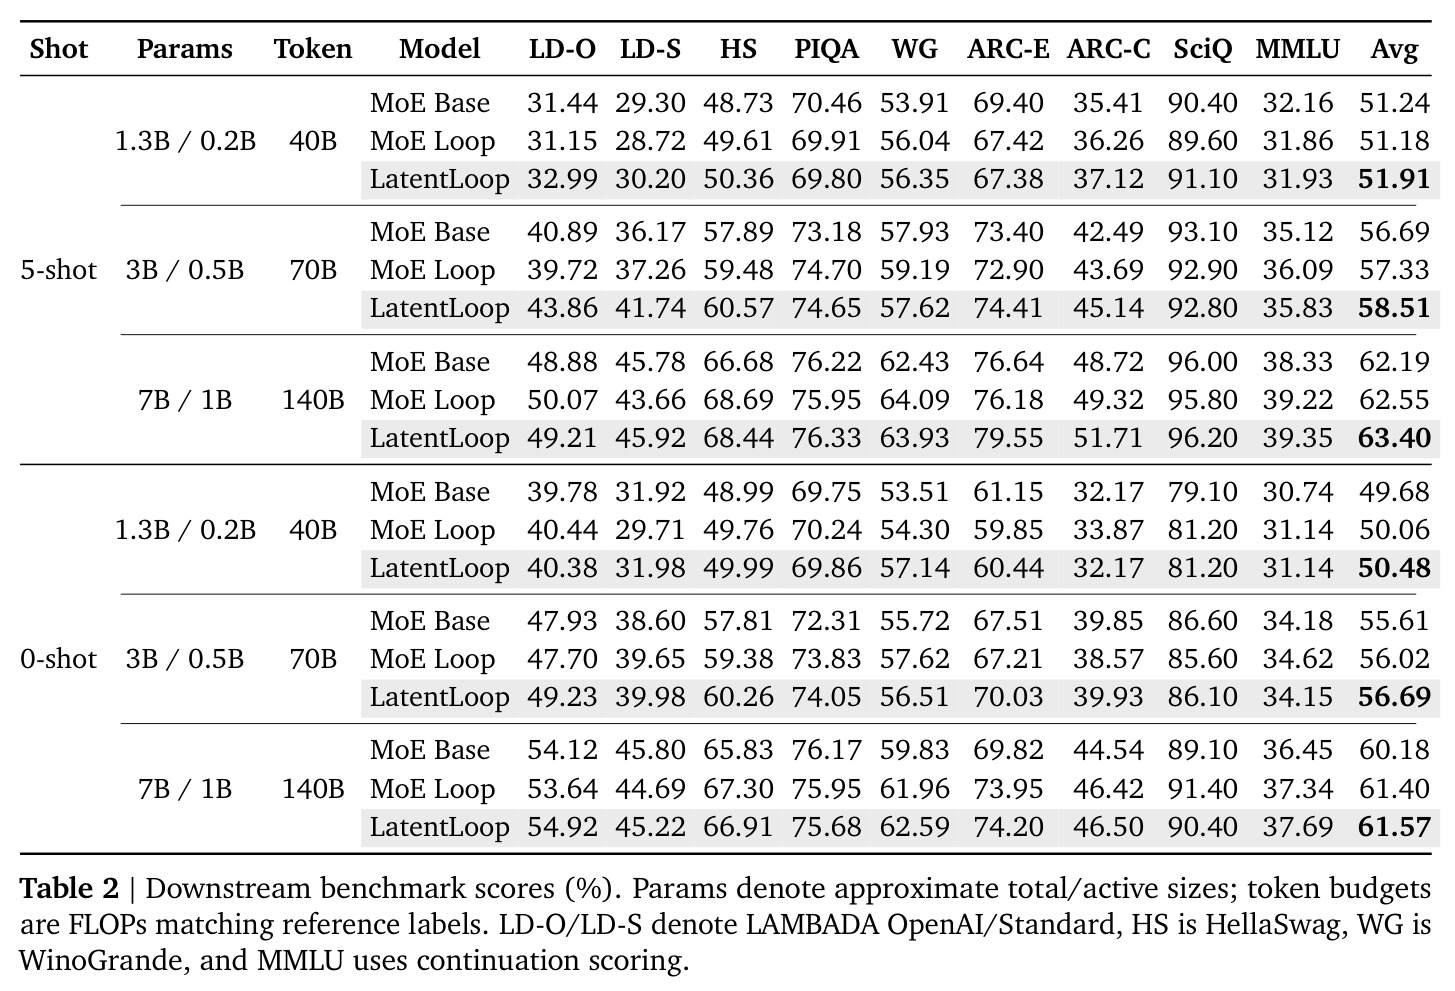
主实验覆盖 1.3B–7B 三档共 15 个预算配置,最大训练算力超 $10^{21}$ FLOPs,LatentLoop 在全部 15 个端点的验证 NLL 都低于两个基线;拟合缩放律后,在 NLL=1.988 处只需约 $1.85 \times 10^{20}$ FLOPs,较 MoE Base 省 19.0%、较 MoE Loop 省 7.9%。下游 9 个基准上,LatentLoop 在全部 6 个尺寸×shot 组合平均分最高:5-shot 相对 Loop 增益 0.73–1.18 个百分点、相对 Base 0.67–1.82,0-shot 分别为 0.17–0.67 与 0.80–1.39;如 5-shot 3B:58.51 对 56.69/57.33。3B/40B 消融:序列压缩在四种首次降算策略中最优(2.0303,其余 2.0349–2.0364;基线 2.0426/2.0293);最终设计 2.0199,缩放解码器贡献 2.0268→2.0199,注意力解绑贡献 2.0237→2.0199。学到的写回系数均值 0.199/0.160,印证首次访问应轻量。
局限与改进
作者承认的核心局限是:残差系数不对称背后的机理仍未被理解——为什么第一次访问想要更小的更新、为什么 3/4 次循环时系数随访问序号递增且相邻比值稳定在约 2.4×/2.0×,论文只留下观察而未给出解释。我自己的观察还有几点:其一,压缩因子固定为 $k=2$,未探索 $k=4$、8 或自适应压缩率,非对称收益与压缩率的关系未知;其二,实验全部基于 FineWeb-Edu 单一数据流和 TinyLlama 分词器,未验证分布偏移、多语言或代码场景的普适性;其三,下游平均分优势不大(0.17–1.82 个百分点),部分单项互有胜负,例如 7B 5-shot 的 WinoGrande 上 LatentLoop 63.93 略低于 MoE Loop 的 64.09,稳定性存疑;其四,写回系数分析只覆盖 $k=2$ 的两位置情形,潜位置更多时逐位置系数的扩展性未讨论;其五,效率结论基于理论 FLOPs,未报告真实训练/推理吞吐与端到端时延。
独立分析的弱点
第一,机理黑箱:整个方法建立在『首次访问偏好小更新』的现象之上,但没有解释为什么——是与注意力汇、信息瓶颈还是表示精炼的阶段性有关?改进方向是用探针与路由/注意力分析刻画每次访问的功能角色,把现象升级为理论。第二,收益幅度有限:相对 MoE Loop 只省 7.9% 算力,1.3B 档 5-shot 平均分仅高 0.73 个百分点,部分单项持平甚至更差。改进方向是利用 3/4 次循环的系数几何递增规律,设计多级非对称压缩(不同访问不同压缩率)。第三,压缩均匀且固定 $k=2$:对所有位置一视同仁,可能损害信息密集片段。改进方向是内容自适应压缩或按熵分配潜位置预算。第四,专家数 76→75 的补偿方式较粗糙,专家削减量与注意力解绑之间的最优权衡没有系统扫描。第五,只报告理论 FLOPs 节省,未实测吞吐,19.0% 的算力节省未必转化为等比的实际加速。第六,验证规模止步于 7B 与 $10^{21}$ FLOPs,缩放律外推段(图中虚线)未经实测支撑,更大规模的有效性仍是猜想。
未来方向
作者明确提出要解释多访问残差系数的模式(3 次约 2.4×、4 次约 2.0× 的相邻比值),并研究各次访问的具体机制以指导更优的算力分配。在此基础上可以延伸出多个方向:一是把两访问非对称推广为 $N$ 次访问的递进压缩金字塔,第 $v$ 次访问使用压缩率 $k_v$、残差系数按几何比例初始化;二是把静态写回系数升级为由轻量网络生成的依赖位置的动态系数,缓解均匀压缩对信息密集 token 的损伤;三是与推理时自适应计算结合,让简单样本提前退出、把省下的访问留给难样本;四是在代码、多语言、长文本等分布上重复缩放实验,检验非对称分配的普适性;五是联合调优压缩率、专家削减量与宽度增量三者的配比,当前只比较了少数离散组合;六是把『MoE 共享、注意力独立』的选择性共享结论与 MoRE、LoopMoE 等专家复用方法正交组合,进一步压缩参数或提升容量。
复现评估
论文给出了 Project Page 与 Code 链接,若代码及配置(附录 A 的 15 个配置、附录 B 的实现细节)确实开源,复现基础较好:训练数据是公开的 FineWeb-Edu 固定流,分词器用 TinyLlama,验证集为 0.1B token,评测统一采用 lm-evaluation-harness 的 0/5-shot 协议,完全标准化。难点在算力:15 个配置覆盖 1.3B–7B、最大训练超 $10^{21}$ FLOPs,即便最小的 1.3B/20B token 档也远超个人或小实验室的能力,完整复现缩放曲线需要数百到数千 GPU 卡·天。合理的低成本路径是只复现 3B/40B 消融组合(Table 3–5 中十余个 NLL 2.0 量级的点),或直接用作者发布的 checkpoint(若有)验证下游分数。缩放律拟合流程(Huber 损失、$\delta=10^{-3}$、48 组 L-BFGS-B 初值)在论文中有完整公式与超参,可独立实现。总体评估:协议清晰、可复现性设计良好,瓶颈纯粹在算力而非信息缺失。
论文图表
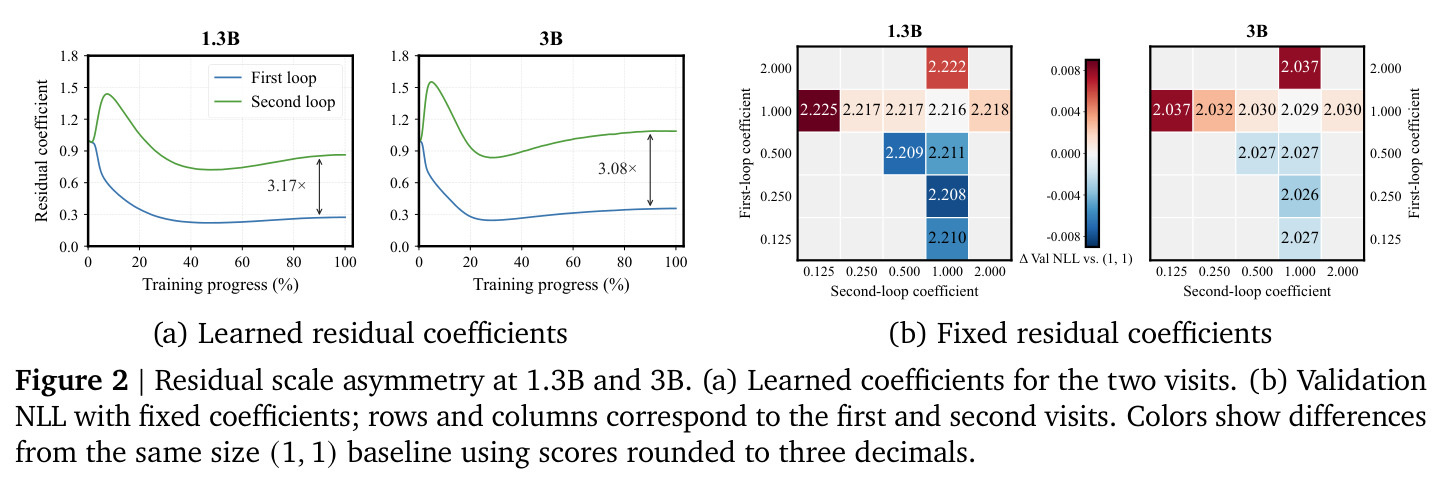
(a) 显示可学习残差系数随训练进程的曲线:第一次访问的系数降至 0.27–0.36,第二次保持在 1 附近(0.87–1.09);(b) 是固定系数网格的验证 NLL 热图,行列为第一/第二次访问的系数取值,显示缩小第一次系数(如 (0.25, 1))反而降低 NLL 约 0.008/0.003,缩小第二次则变差。
这张图是整篇论文的动机实验:不对称现象的两组独立证据都在这里,是『首次访问可以做得更轻』这一核心论断的直接依据。